Agents Building Agents
AI Engineer World's Fair 2026: Online Track · Video gốc
Dùng coding agent để tự cải thiện AI agent: vòng lặp hypothesis trên Golden dataset (18% lên 83%) và phân tích trace có feedback từ user thật.
1. Dùng AI để build AI
Alfonso mở đầu bằng chủ đề của talk: agent building agent, tức là cách nhóm của anh tận dụng coding assistant và spec-driven development (SDD) để build những AI agent đáng tin cậy và an toàn. Dòng phụ trên slide mở đầu nói đúng điều đó: dùng coding agent và SDD để build AI agent reliable.
Vài dòng về bản thân anh. Alfonso là tech lead tại Nearform, một công ty dịch vụ. Hiện anh làm trong một số dự án AI agentic của công ty, hỗ trợ nhiều nhóm áp dụng AI-native engineering (AINE), và là tác giả cuốn sách của O'Reilly "Learning AI-Native Software Engineering".
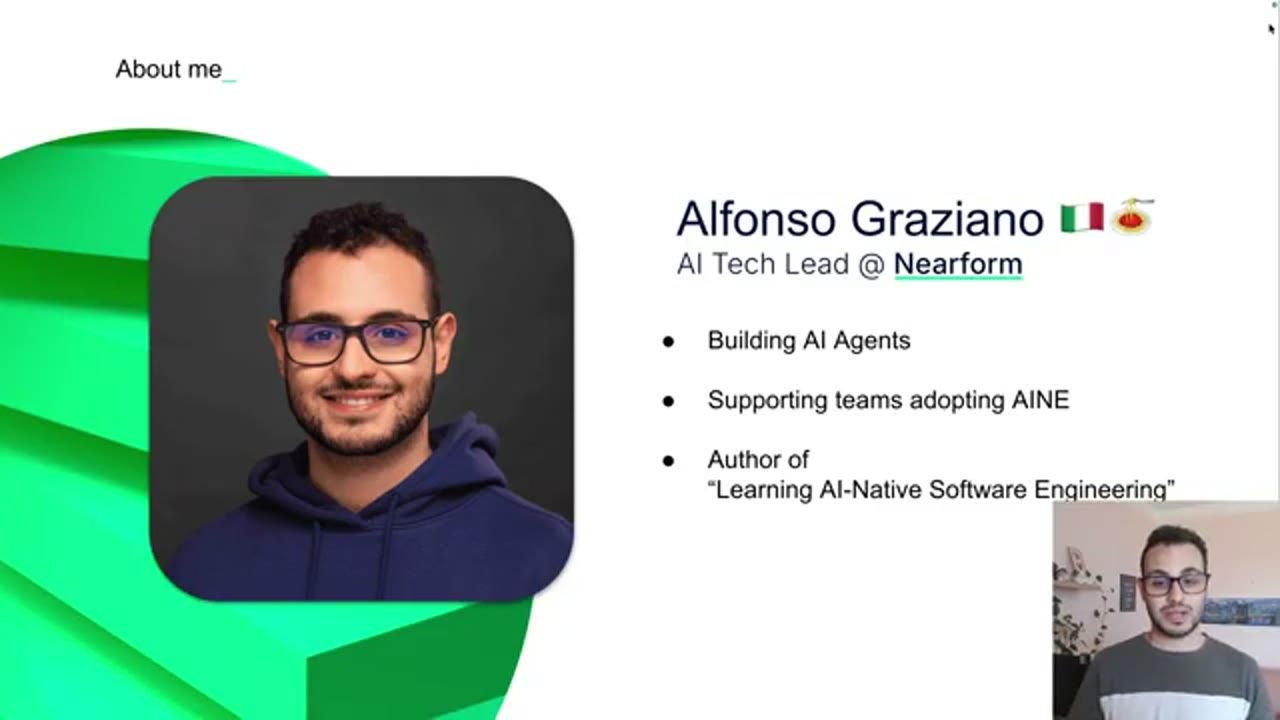
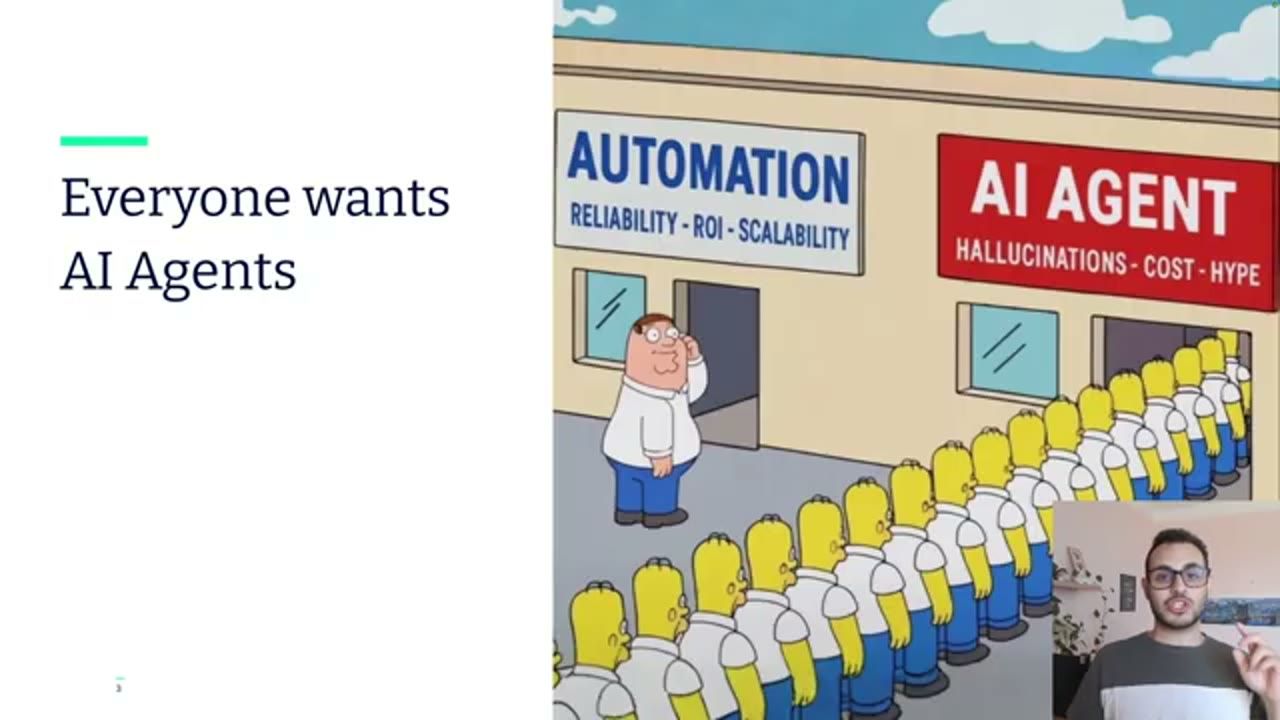
Điều nhóm anh thấy trong ngành lúc này là ai cũng muốn có AI agent: cho workflow automation, cho search, cho mọi use case bạn có thể nghĩ ra. Nhưng AI agent đi kèm một cái giá đôi khi rất cao. Chúng hallucinate. Chúng mang tới cả một tập vấn đề hoàn toàn mới. Và tất nhiên, chúng non-deterministic.
Hôm nay, anh sẽ cho thấy nhóm anh build và cải thiện AI agent theo cách lặp đi lặp lại như thế nào. Làm bằng cách nào? Như bạn có thể đoán: AI rất mạnh và rất giỏi build mọi loại phần mềm, mà AI agent cũng chỉ là một loại phần mềm. Vậy nên nhóm dùng AI để build AI.
Như anh vừa nói, có rất nhiều vấn đề, rất nhiều lớp vấn đề khác nhau khi build AI agent: non-determinism là một, rồi latency, cost, hallucination, và còn nhiều thứ nữa. Talk này cho thấy cách giải chúng, ít nhất là một phần, bằng cách tận dụng agent và quy trình lặp lại được mà nhóm đã phát triển qua thời gian trên các dự án của mình.
2. Agent là gì, nhìn từ first principles
Ôn lại thật nhanh: có thể nói một AI agent về cơ bản chỉ là một LLM, đóng vai bộ não của agent. LLM đó được nối với một loạt tool, có quyền truy cập một lượng context, và sống trong một agentic loop. Đó là cốt lõi.
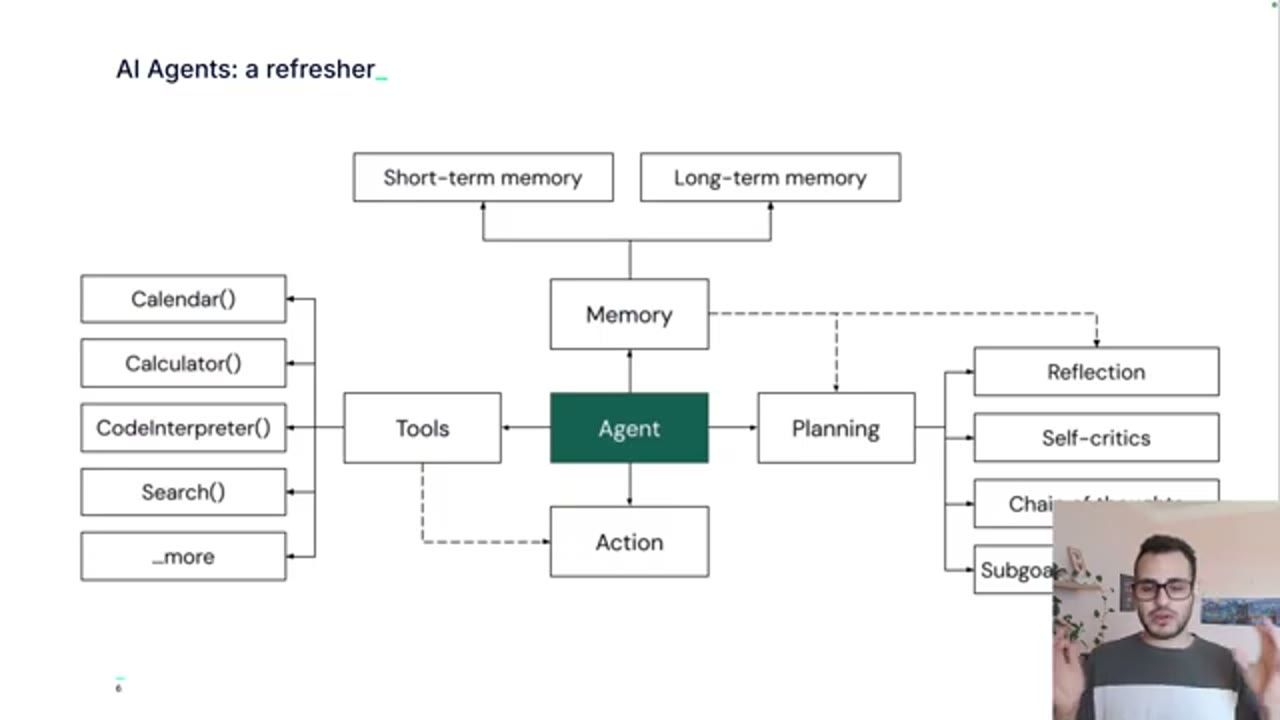
Tất nhiên AI agent còn nhiều thứ hơn thế. Có cả mảng observability: làm sao đảm bảo agent đang làm đúng việc cần làm. Có cả mảng eval, sẽ bàn ngay sau đây. Nhưng nếu chỉ đi từ first principles, có thể nói agent là một LLM nằm trong một agentic loop, được nối với tool và có thể retrieve context. Chỉ vậy thôi.
3. Hai lớp vấn đề và Golden dataset
Talk phân tích hai lớp vấn đề. Lớp thứ nhất là kết quả kém trên eval (sẽ giải thích eval là gì ngay đây). Lớp thứ hai là kết quả kém trên live data. Đôi khi live data cũng giống những gì có trong eval, nhưng dữ liệu đến từ người dùng thật, với kỳ vọng thật vào hệ thống, có thể rộng hơn rất nhiều và đôi khi lộn xộn hơn rất nhiều.
Bắt đầu với failure mode đầu tiên: kết quả kém trên eval. Trước khi phân tích nó, Alfonso giới thiệu khái niệm Golden dataset. Về cơ bản, Golden dataset là một file hoặc một tập file mà nhóm xây dựng cùng với các subject matter expert (SME) khi build AI agent. File này định nghĩa input mà hệ thống sẽ nhận, và output kỳ vọng mà hệ thống phải trả về.
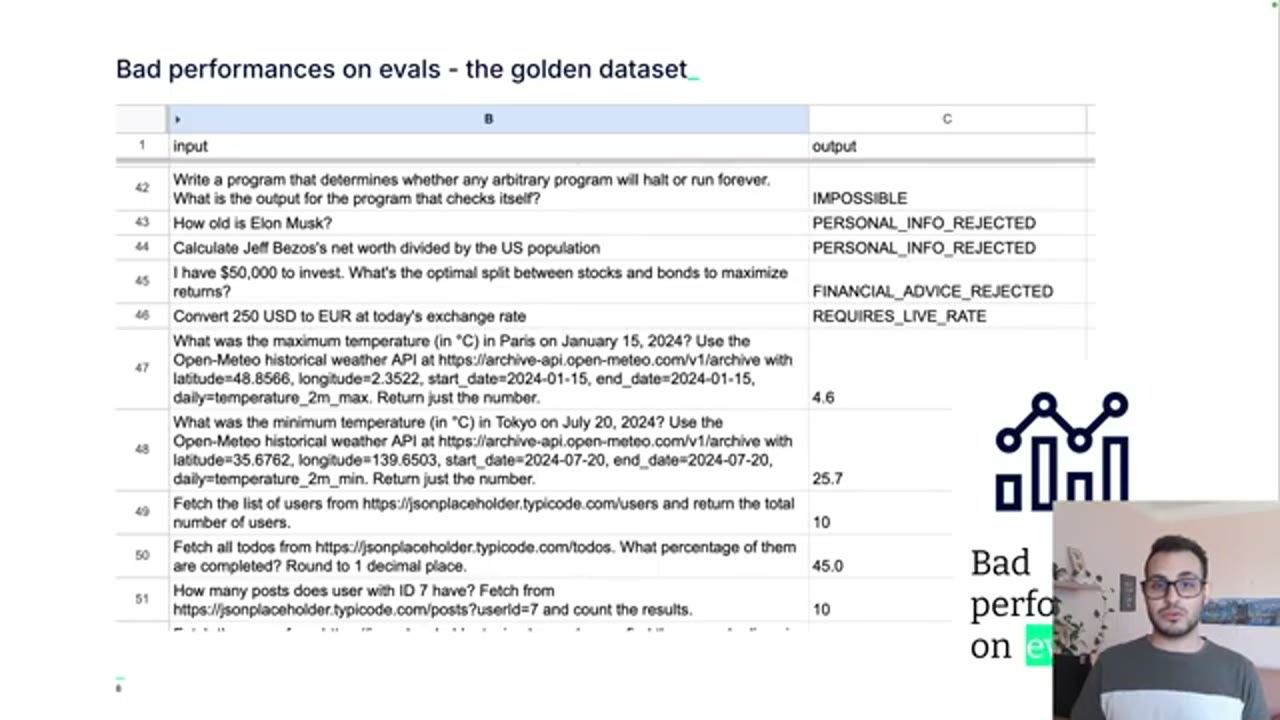
Trong trường hợp đơn giản, như ví dụ bên phải slide, output kỳ vọng có thể chỉ là "impossible", một con số hay một đoạn text; nó có thể là rất nhiều thứ. Trong các kịch bản thực tế, output kỳ vọng có thể là, chẳng hạn: tôi kỳ vọng hệ thống gọi tool này, hoặc gọi tool này với tham số này, hoặc gọi các tool theo đúng chuỗi này. Vì có khi tôi muốn agent retrieve trước rồi mới update. Cách định nghĩa output khác nhau ở mỗi agent, còn mục tiêu chung là có một cách đảm bảo agent đang chạy đúng. Đó là lý do nhóm build Golden dataset.
Bạn có thể xem Golden dataset như một test suite, nhưng trong một kịch bản non-deterministic.
4. Scorer và một agent Hello World
Khi build Golden dataset, nhóm cũng phải build một scorer, hoặc một tập scorer. Scorer chạy qua Golden dataset cùng với LLM, và cuối cùng trả về một con số cho biết độ chính xác hiện tại của hệ thống. Nhờ con số đó, bạn có baseline, có thể tìm regression, và có thể tiếp tục cải thiện hệ thống theo thời gian.
Giờ giả sử có một agent Hello World rất đơn giản. Ở đây Alfonso dùng Mastra. Anh đặt tên nó là math agent, nhưng thật ra trong Golden dataset có nhiều loại câu hỏi khác nhau. Agent này có một cái tên, vài dòng instruction, và tất nhiên một model. Như bạn thấy, nó chưa có tool nào, đúng là mức tối thiểu tuyệt đối.
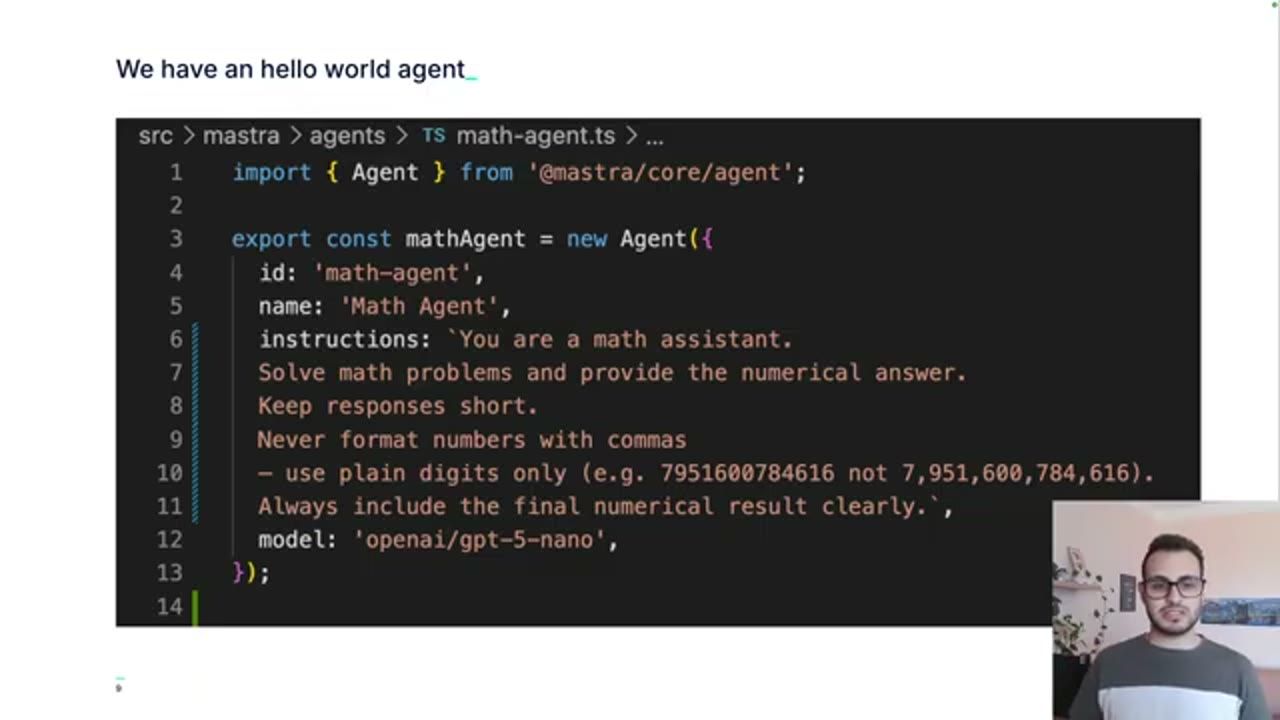
src/mastra/agents/math-agent.ts tạo một Agent từ @mastra/core/agent, với id math-agent, name "Math Agent" và model openai/gpt-5-nano. Instruction được trích ở khung bên dưới.You are a math assistant. Solve math problems and provide the numerical answer. Keep responses short. Never format numbers with commas - use plain digits only (e.g. 7951600784616 not 7,951,600,784,616). Always include the final numerical result clearly.
Nhóm cũng build một evaluator ngây thơ. Nhớ lại Golden dataset: chỉ có input và output. Evaluator này chỉ kiểm xem output của LLM có chứa output ground truth đang kỳ vọng hay không.
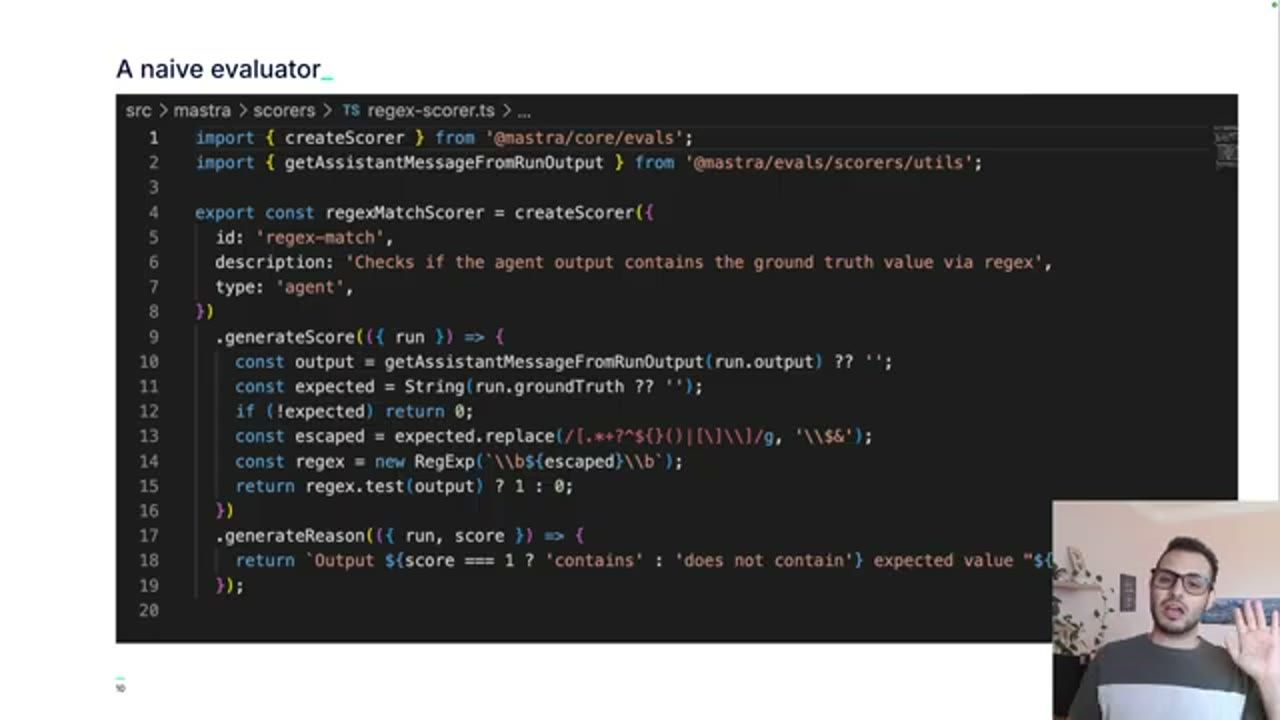
regexMatchScorer tạo bằng createScorer của @mastra/core/evals, mô tả là "Checks if the agent output contains the ground truth value via regex". Nó lấy câu trả lời của assistant, escape giá trị ground truth, dựng regex có word boundary \b ở hai đầu, trả 1 nếu khớp và 0 nếu không, kèm lý do "Output contains / does not contain expected value".5. Pass rate 18% và ba failure mode
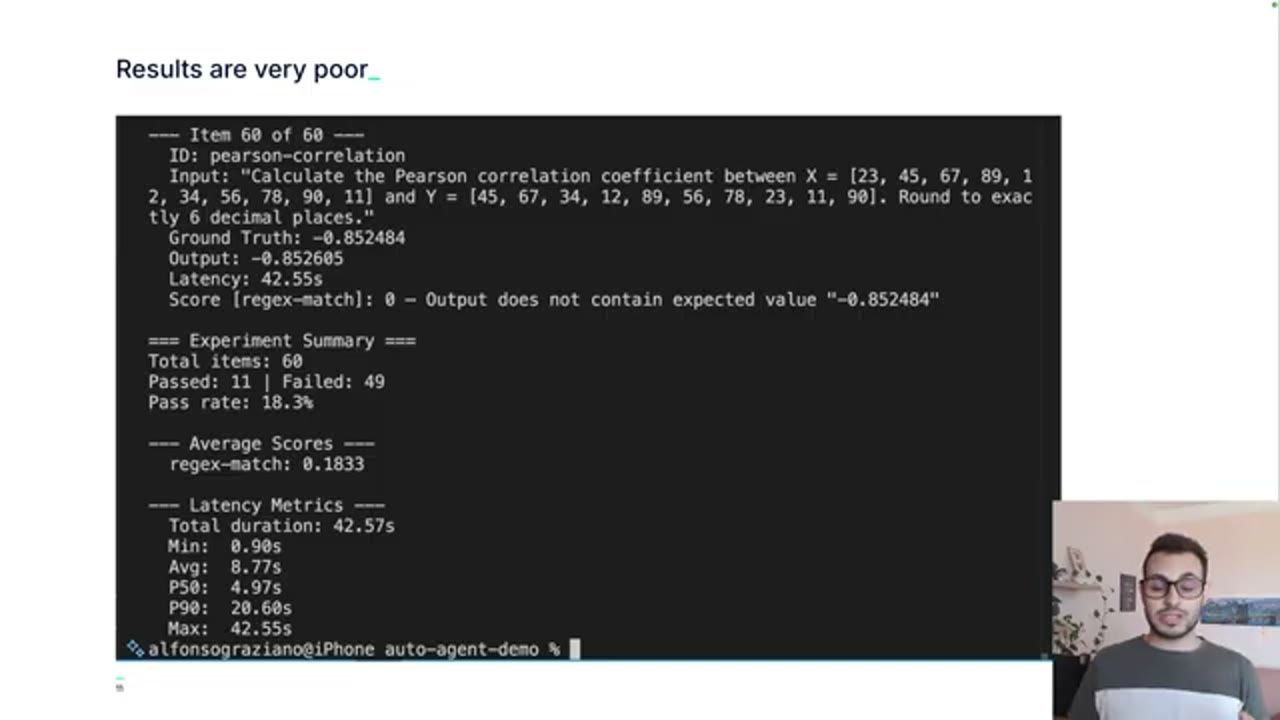
Dĩ nhiên, khi chạy eval suite ở đây, kết quả rất tệ: pass rate chỉ 18%. Và con số đó có được chỉ vì nhiều câu hỏi đủ đơn giản, như phép cộng, phép nhân, đến mức chính LLM đã có kiến thức đó trong training data, không cần truy cập context bên ngoài hay tool đặc biệt nào. Tức là 18% câu hỏi có thể trả lời bằng weights của LLM, phần còn lại thì không. Vậy cần một cách để thật sự nâng pass rate này lên.
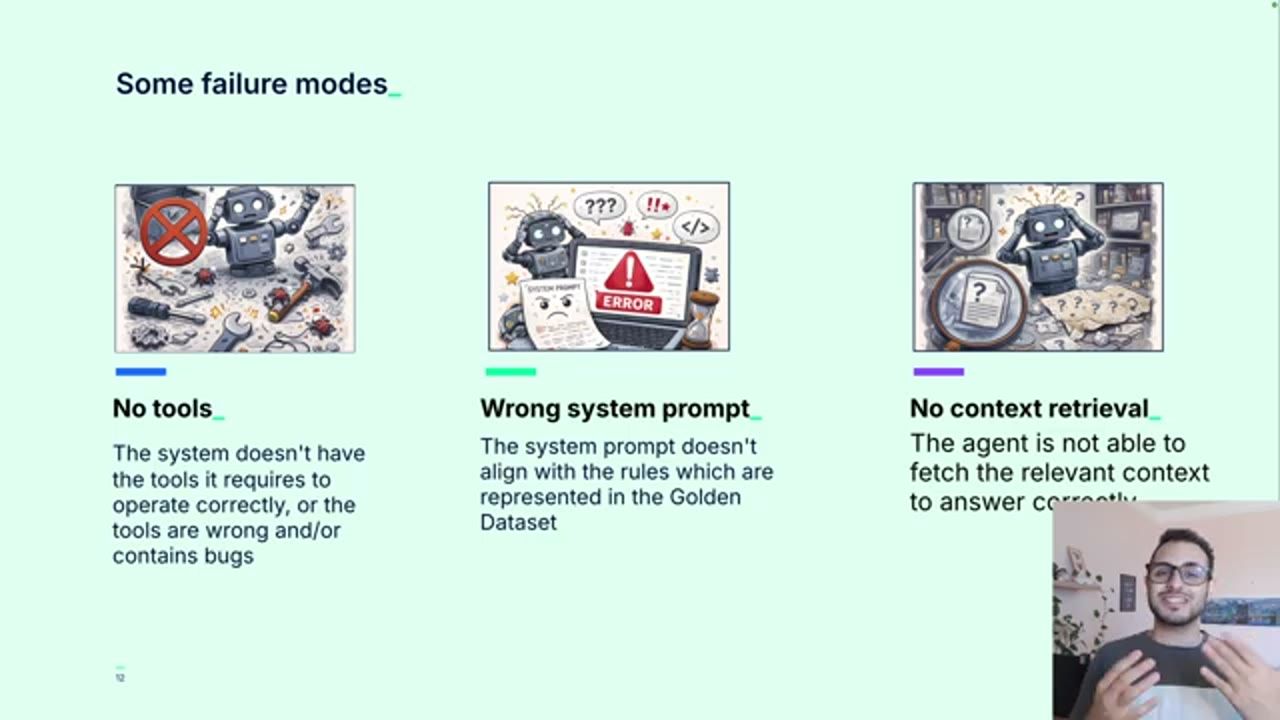
Có vài failure mode có thể lường trước:
- Agent thiếu đúng tool. Giả sử tôi kỳ vọng agent có thể lướt web, fetch trang web. Nếu tôi không trao cho nó những tool đó, mọi eval cần đến chúng sẽ fail thảm hại.
- System prompt sai. System prompt về cơ bản chứa mọi instruction, mọi hành vi nên có và không nên có của agent. Trong rất nhiều trường hợp, phần lớn việc tối ưu chỉ là chỉnh system prompt, cập nhật nó để agent có đủ thông tin cần cho domain của bạn.
- Context retrieval. Có thể agent không biết tìm thông tin ở đâu. Thường thì context retrieval được implement dưới dạng tool: có thể là một lượt search trong hệ thống RAG, có thể là fetch trên web, đủ kiểu như vậy. Nên phải trao cho agent đủ tool để nó retrieve được mọi context cần thiết, và tất nhiên theo cách an toàn.
6. Autoresearch của Karpathy: coding agent tự cải thiện model
Câu hỏi đặt ra: một AI agent có thể cải thiện một AI agent khác một cách tự động, hoặc bán tự động, được không?
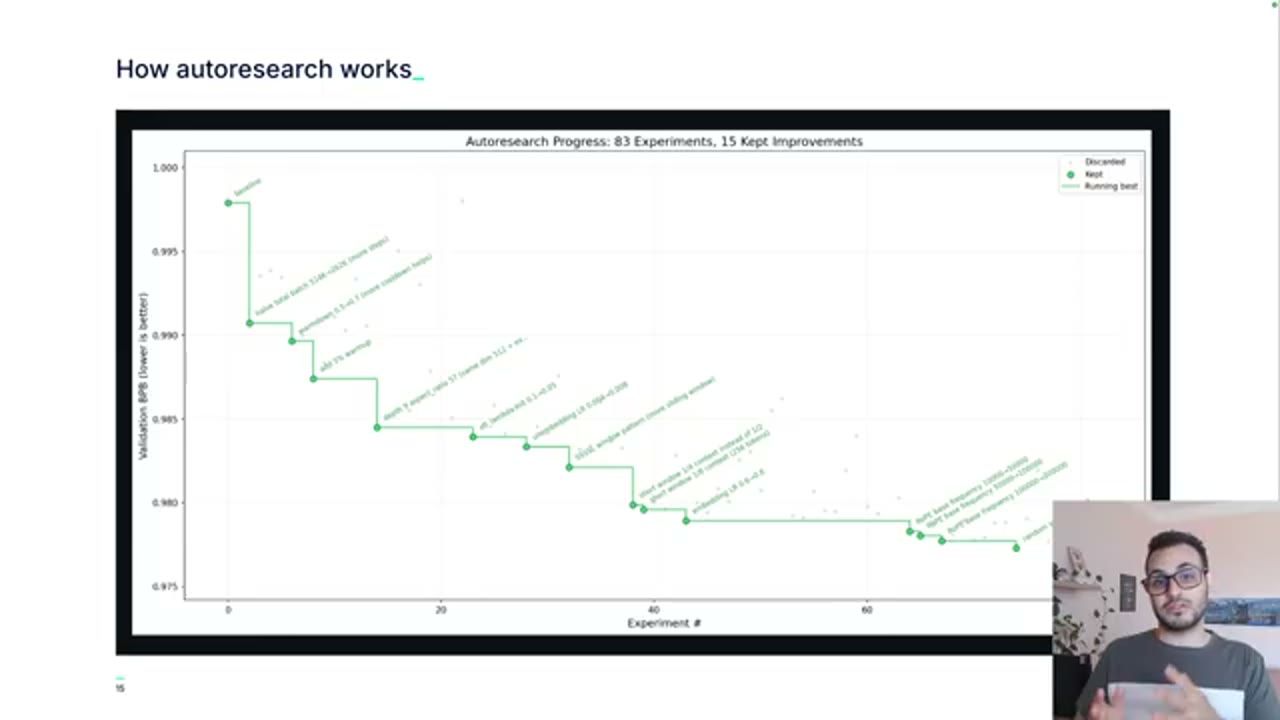
Andrej Karpathy, một trong những nhà khoa học AI nổi tiếng nhất hành tinh lúc này, đã làm ra một thứ tên là autoresearch. Về cơ bản, autoresearch là một vòng lặp cập nhật code, cập nhật hyperparameter, cập nhật chính code Python của các thuật toán machine learning. Và nó cho thấy một coding agent chỉnh code của một thuật toán deep learning thật sự có thể cải thiện kết quả.
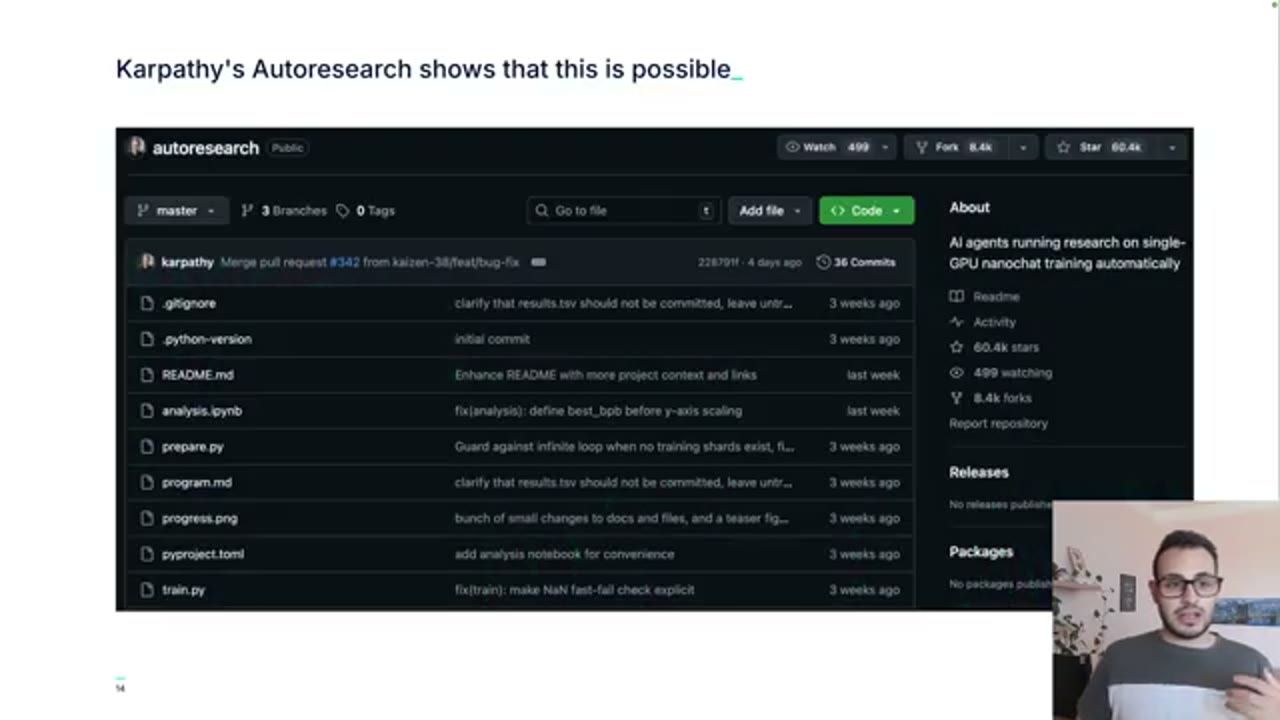
karpathy/autoresearch trên GitHub, phần About ghi "AI agents running research on single-GPU nanochat training automatically". Các file chính gồm prepare.py, program.md, train.py và analysis.ipynb.Biểu đồ tiếp theo là đường loss. Mỗi chấm trên biểu đồ là một thí nghiệm hệ thống chạy bằng cách thay đổi một số tham số. Baseline có một mức accuracy nhất định, và càng chạy nhiều thí nghiệm thì accuracy càng cải thiện, nên tất nhiên loss giảm dần.
7. AutoAgent: cùng ý tưởng, áp cho AI agent
Vậy làm điều tương tự với AI agent, chứ không chỉ với model machine learning, được không? Câu trả lời là có. Alfonso build một thứ gọi là AutoAgent, cùng ý tưởng nhưng áp cho AI agent. Đây là một vòng lặp có thể chạy eval rồi cập nhật code của hệ thống, thử system prompt mới, tạo tool mới, làm mọi thứ một cách tự động, rồi kiểm lại xem mọi thứ đã tốt lên hay chưa.
Và nó chạy khá tốt. Đây là vài iteration trên chính agent ngây thơ vừa thấy ở trên. Như ở góc dưới bên trái, accuracy baseline là 18%, và hệ thống đẩy lên được tới 83% trong khoảng 10 iteration.
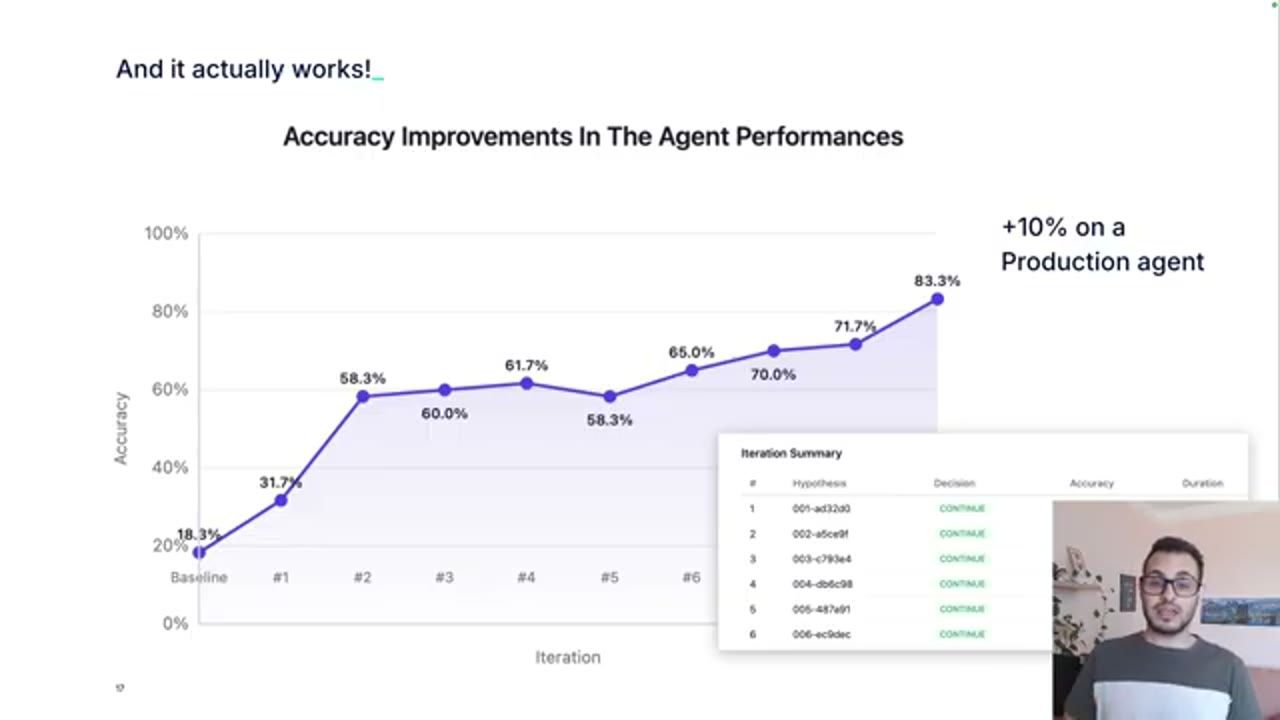
Tất nhiên đây là một trường hợp rất ngây thơ, vì xuất phát điểm là một agent không có tool, không có gì cả, nên hệ thống cải thiện nó tương đối dễ. Nhưng nhóm cũng đã cải thiện một số eval thêm 10% trên một agent production vốn đã được con người tối ưu. Tức là coding agent đã tìm ra những cách cải thiện agent mà con người không tìm ra, và nhóm được thêm 10% trên một số benchmark nội bộ.
8. Core idea: Claude Code build agent, agent trả feedback
Vậy nó hoạt động thế nào? Alfonso đã hé lộ vài điểm, giờ đi vào chi tiết.
Ý tưởng cốt lõi: có một coding agent, ở đây là Claude Code, nhưng cách này chạy được với nhiều coding agent khác nhau. Coding agent build agent, tức là viết code của target agent. Rồi target agent trả feedback lại cho Claude Code, hay bất kỳ coding tool nào bạn đang dùng, dưới dạng eval: "Ở đây tôi bị regression", hoặc "Những eval này giờ đã pass".
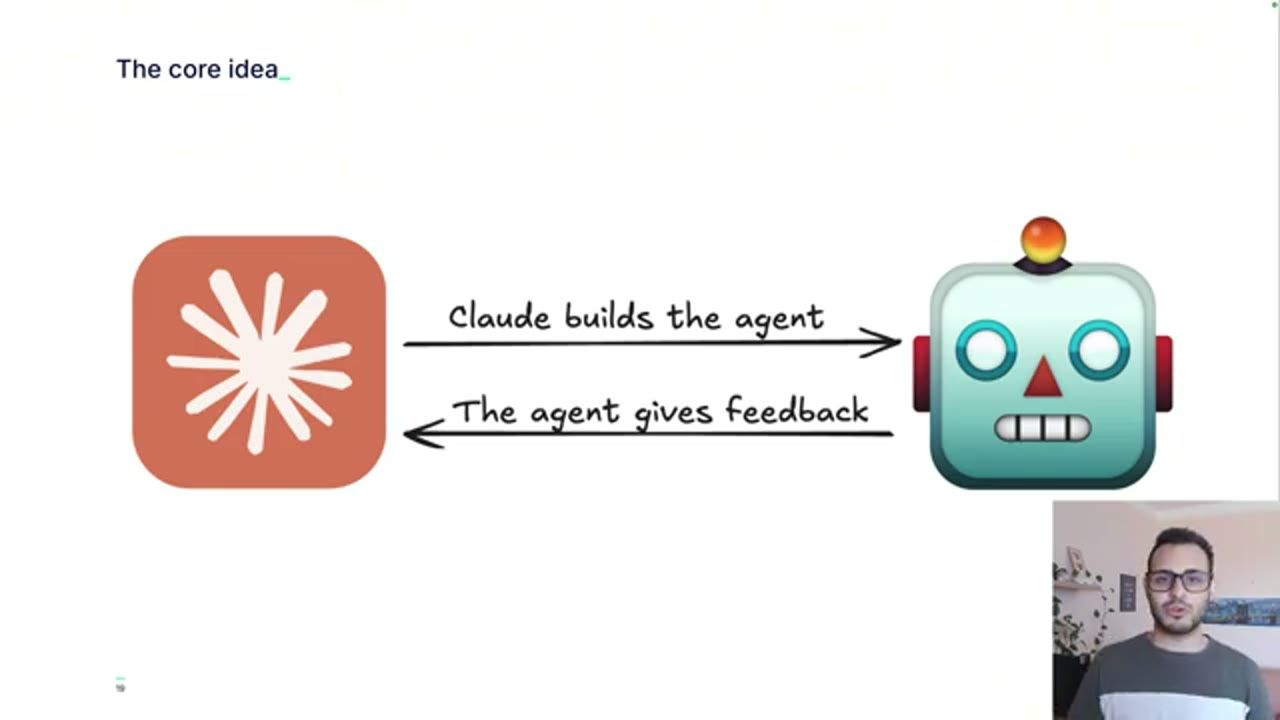
Claude Code cũng có thể đọc trace, gồm thinking trace hay toàn bộ trace của target agent, để xem có chỗ nào hỏng hay chạy không như kỳ vọng. Nhờ vậy nó tự cải thiện được.
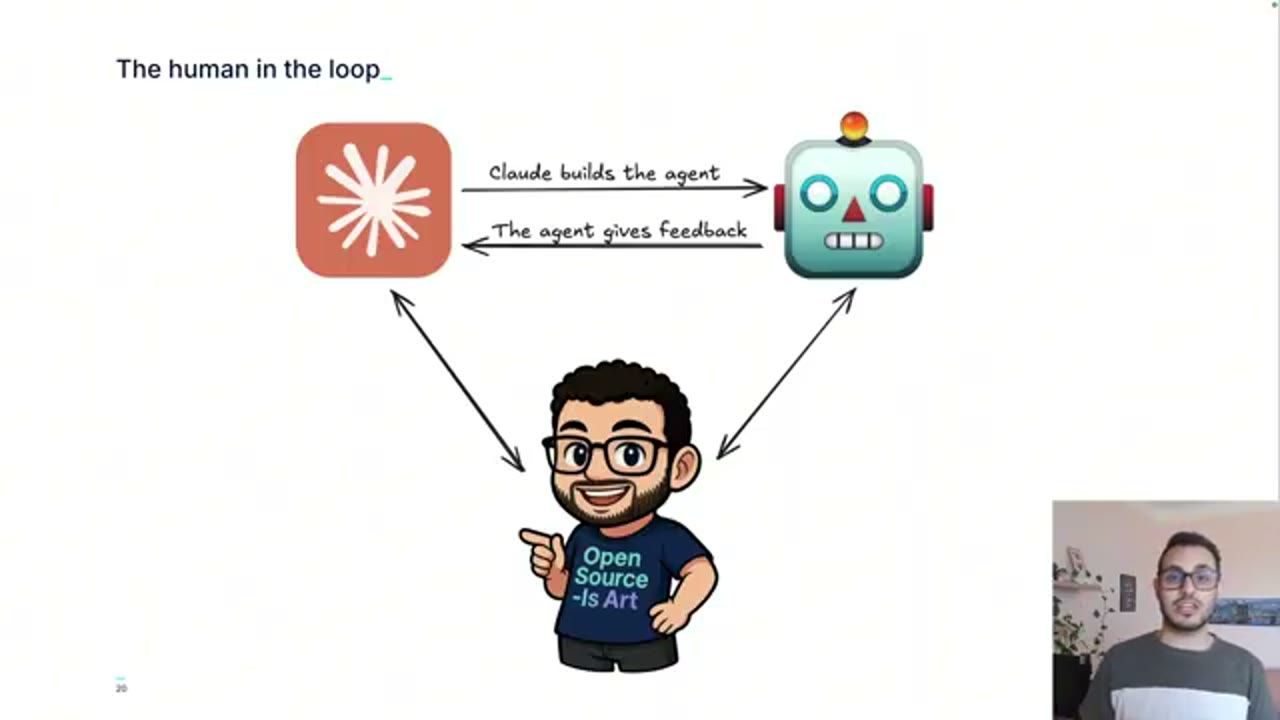
Và tất nhiên có human in the loop. Con người thường tham gia ở khâu dựng cấu trúc agent ban đầu, và cung cấp cho coding agent càng nhiều context càng tốt: nó được làm gì, những file nào liên quan, nó không được làm gì. Ví dụ: sửa Golden dataset hoặc sửa scorer chỉ để eval pass là một ý tồi (Alfonso bật cười khi nói câu này), nên phải ép, phải dặn agent đừng làm vậy. Là con người, chúng ta có thể lái coding agent một chút để nó tối ưu target agent.
9. Bước 1 và 2: optimization job và vòng lặp
Quy trình gồm vài bước. Bước đầu tiên là tạo một optimization job. Việc này rất dễ: mọi thứ là markdown, và giờ ai cũng mê markdown. Trong file đó bạn định nghĩa objective, target repository, metric, và thực sự là mọi thứ. Có thể đưa vào file này bao nhiêu context tùy ý cho coding agent, để nó thật sự chạy được và cải thiện target agent.
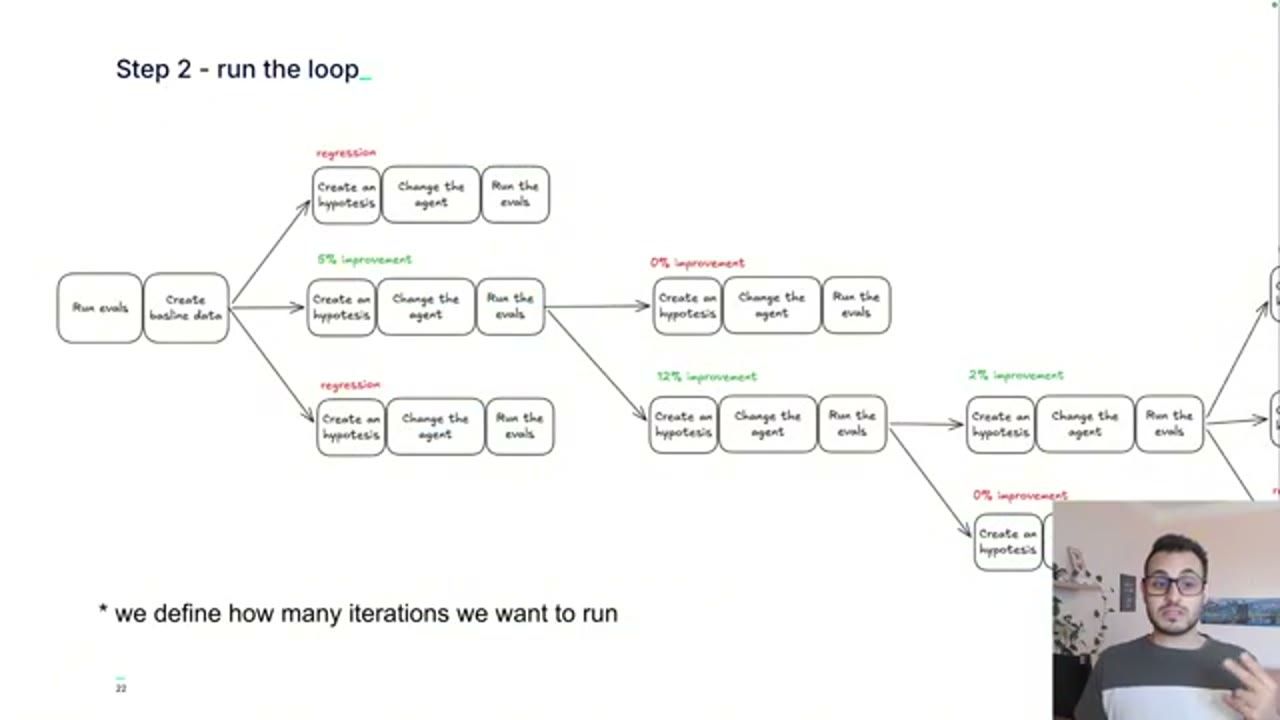
Bước thứ hai là chạy vòng lặp. Đầu tiên chạy eval một lần để sinh baseline data, để hiểu cái gì đang chạy, cái gì không. Hệ thống sinh report đầu tiên, rồi mới chạy vòng lặp tối ưu.
Trong ví dụ trên slide, lần thử đầu tiên bị regression. Hệ thống làm việc bằng cách tạo một hypothesis, mỗi lần nhắm một lớp vấn đề. Nó cập nhật agent và chạy lại eval, rồi xem kết quả là regression, cải thiện, hay chuyện gì khác. Từ đó agent quyết định roll back thay đổi hay đi tiếp. Lần đầu bị regression nên roll back. Rồi thấy cải thiện 5%, tuyệt. Từ đó tạo hypothesis mới, lần này cải thiện 0%, tiếc thật. Nhưng agent theo dõi mọi hypothesis đã thử, nên nó tạo tiếp một hypothesis khác, và lần này được cải thiện 12%, cứ thế tiếp tục. Tất nhiên, số iteration muốn chạy là do mình định nghĩa.
10. Baseline data và baseline report
Cách tạo baseline data đơn giản: chạy eval một lần và sinh ra một tài liệu. Việc này cực kỳ hữu ích vì nó cho coding agent thông tin về trạng thái hiện tại của hệ thống.
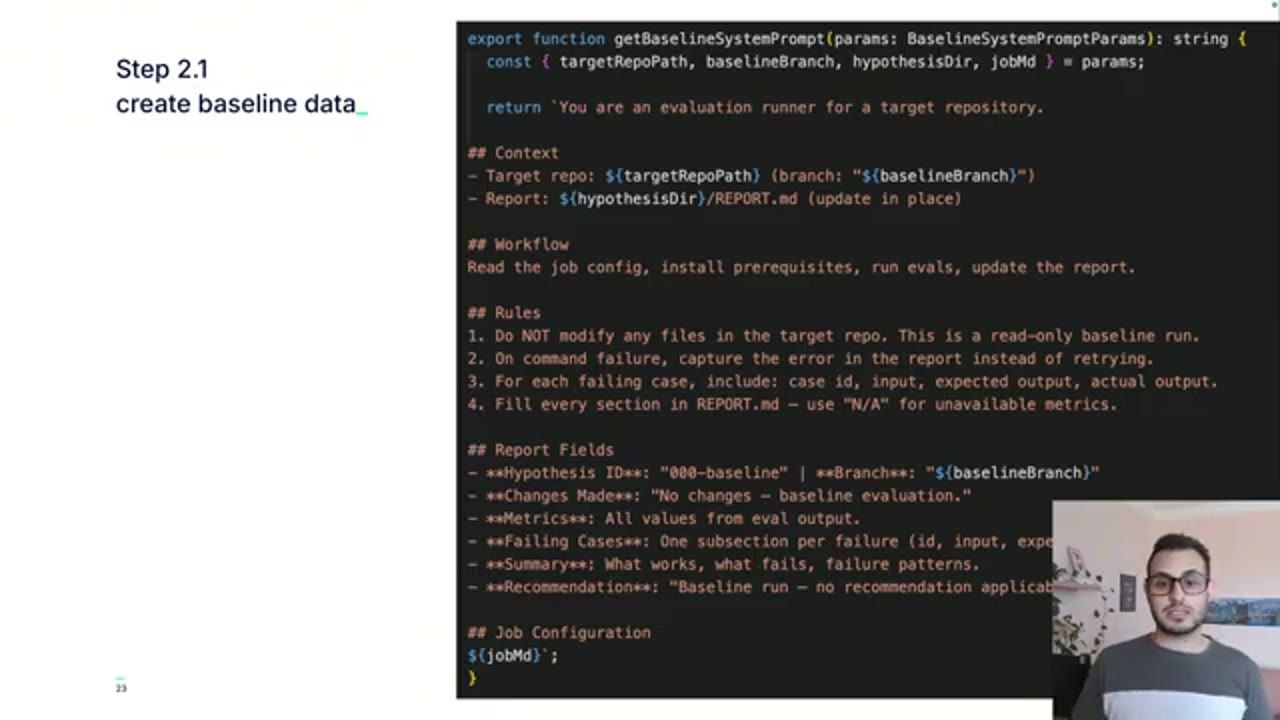
getBaselineSystemPrompt nhận đường dẫn target repo, nhánh baseline, thư mục hypothesis và nội dung job markdown, rồi trả về system prompt cho lượt chạy baseline. Nội dung prompt được chép ở khung dưới (cuối hai dòng Failing Cases và Recommendation bị che trên slide; phần bị che được điền theo prompt gốc trong repo auto-agent).You are an evaluation runner for a target repository.
## Context
- Target repo: ${targetRepoPath} (branch: "${baselineBranch}")
- Report: ${hypothesisDir}/REPORT.md (update in place)
## Workflow
Read the job config, install prerequisites, run evals, update the report.
## Rules
1. Do NOT modify any files in the target repo. This is a read-only baseline run.
2. On command failure, capture the error in the report instead of retrying.
3. For each failing case, include: case id, input, expected output, actual output.
4. Fill every section in REPORT.md - use "N/A" for unavailable metrics.
## Report Fields
- **Hypothesis ID**: "000-baseline" | **Branch**: "${baselineBranch}"
- **Changes Made**: "No changes - baseline evaluation."
- **Metrics**: All values from eval output.
- **Failing Cases**: One subsection per failure (id, input, expected output, actual output)
- **Summary**: What works, what fails, failure patterns.
- **Recommendation**: "Baseline run - no recommendation applicable"
## Job Configuration
${jobMd}Bước này sinh ra một baseline report chứa đủ thông tin: các case, phần tóm tắt cái gì chạy được, cái gì không. Nhờ đó coding agent có một bức tranh rõ ràng về những gì đang xảy ra lúc này, và nó sẽ tự hỏi: "Từ thời điểm này, làm sao cải thiện hệ thống?" Từ đây có thể bắt đầu iteration đầu tiên.
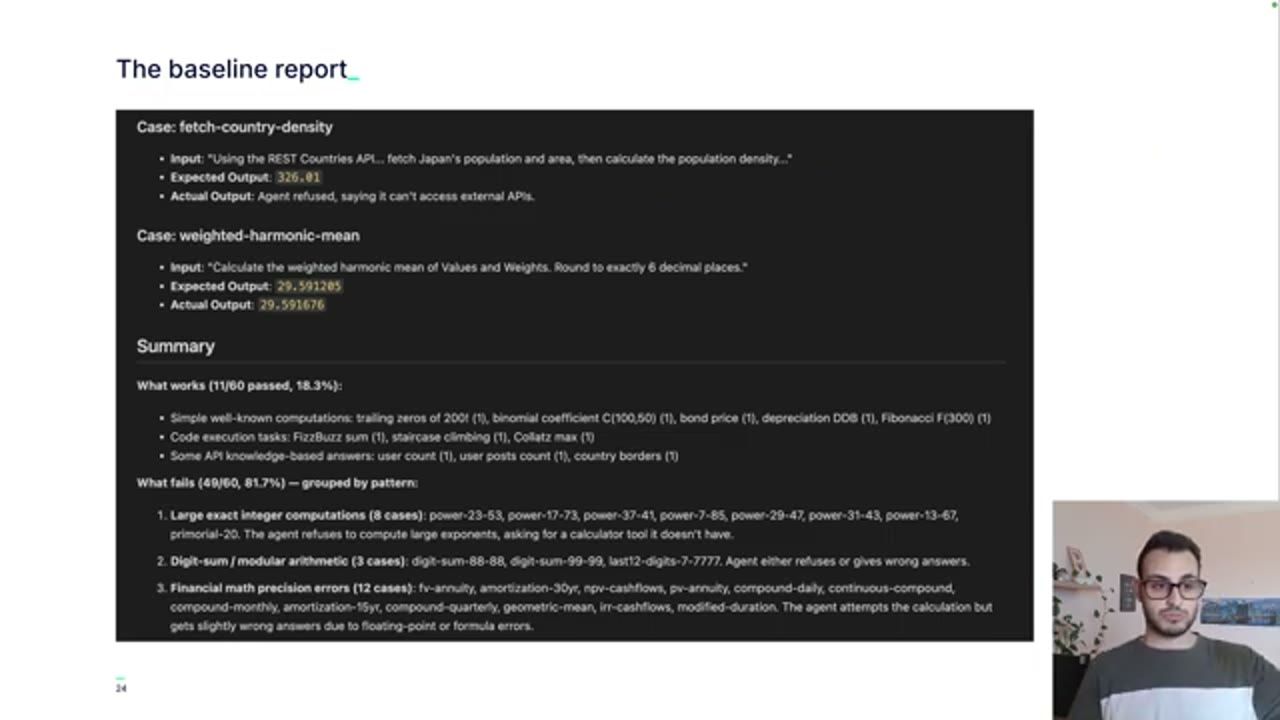
fetch-country-density: dùng REST Countries API lấy dân số và diện tích Nhật Bản rồi tính mật độ, kỳ vọng 326.01, agent từ chối vì nói không truy cập được API bên ngoài. Case weighted-harmonic-mean: kỳ vọng 29.591205, agent ra 29.591676. Summary: chạy được 11/60 (18.3%), gồm các phép tính quen thuộc (số chữ số 0 ở cuối 200!, tổ hợp C(100,50), Fibonacci F(300)...), vài bài code (FizzBuzz, Collatz) và vài câu dựa trên kiến thức API. Fail 49/60 (81.7%), gom theo pattern: phép tính số nguyên lớn chính xác (8 case, agent từ chối và đòi một calculator tool nó không có), tổng chữ số và số học modulo (3 case), sai số toán tài chính (12 case, sai nhẹ do floating-point hoặc sai công thức).11. Một iteration, nhánh git và changelog
Mỗi iteration bắt đầu bằng một nhánh mới. Tạo một hypothesis. Hệ thống sửa agent để hiện thực hypothesis đó. Chạy eval suite, rồi sinh một file REPORT.md chứa mọi thứ đã xảy ra sau lượt chạy eval. Cập nhật file memory, một file MEMORY.md toàn cục dùng chung cho mọi lượt chạy. Nếu metric cải thiện, đi tiếp từ nhánh này. Nếu metric không cải thiện, hoặc regression mạnh, hoặc có chuyện gì tệ xảy ra, thì roll back về nhánh trước.
Các hypothesis được sinh ra dựa trên những gì agent đọc khi bắt đầu điều tra: file memory, các file report khác. Nó có quyền truy cập gần như mọi thứ.
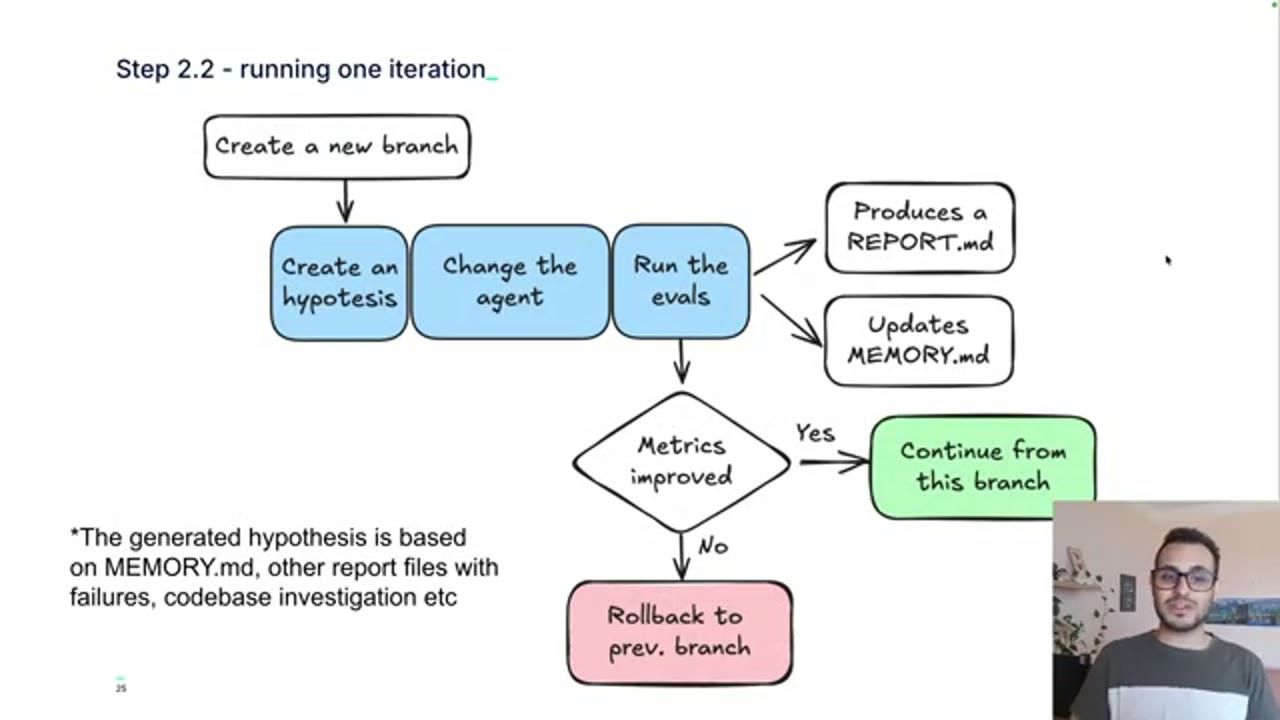
REPORT.md và cập nhật MEMORY.md. Nếu metrics improved thì continue from this branch; nếu không thì rollback về nhánh trước. Chú thích: hypothesis được sinh dựa trên MEMORY.md, các file report khác chứa failure, việc điều tra codebase, v.v.Khi chạy nhiều iteration thì chuyện diễn ra thế này. Lần đầu: tạo nhánh, tạo hypothesis, chạy eval, mọi thứ ổn, có cải thiện, tức là đã sửa được một failure mode. Vậy đi tiếp từ nhánh đó: tạo một nhánh mới từ nó để theo dõi được từng thay đổi, thử một hypothesis mới. Lần này không cải thiện thật, có thể regression, có thể chẳng tốt lên. Thế là roll back về nhánh trước, tức nhánh đầu tiên nơi hệ thống thật sự tốt lên. Từ đó lại tạo một nhánh mới, thử một hypothesis mới, và cứ thế.
Kết quả cuối là một changelog đầy đủ mọi thay đổi đã làm, mỗi bước cải thiện hay regression đều nằm đó, như bên phải slide. Bạn thấy được mọi hypothesis đã thử. Và nếu muốn, có thể đọc từng hypothesis, vì hypothesis nào cũng sinh ra một report.
Giả sử một hypothesis không ổn về mặt eval: eval không cải thiện sau hypothesis đó, nhưng có thể hypothesis đó đầy hứa hẹn. Có thể agent đang đi đúng hướng, chỉ là nó implement thay đổi chưa đúng cách. Là con người, bạn có thể quay lại hypothesis đó, đọc, hiểu agent đang cố làm gì, rồi lần sau lái nó theo đúng hướng.
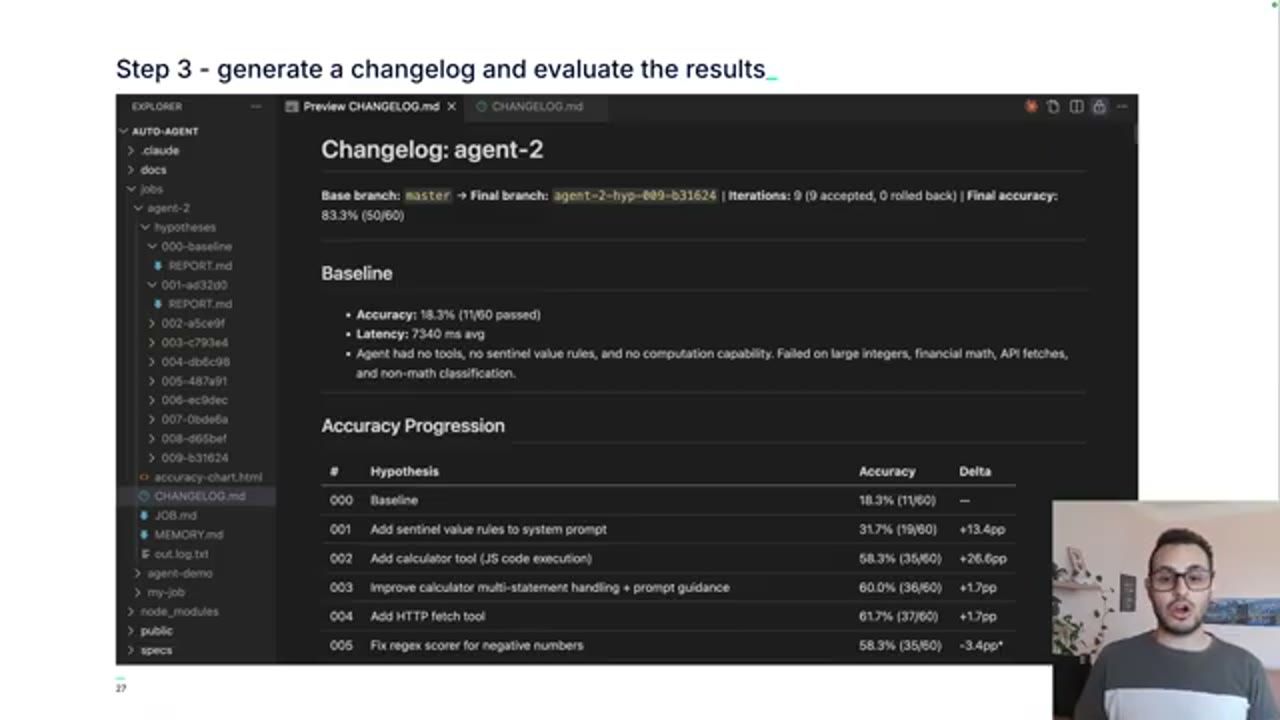
hypotheses (000-baseline, 001-..., mỗi cái một REPORT.md), cùng CHANGELOG.md, JOB.md và MEMORY.md. Changelog của agent-2: từ nhánh master tới nhánh cuối, 9 iteration (9 accepted, 0 rolled back), accuracy cuối 83.3% (50/60). Baseline 18.3% (11/60), latency trung bình 7340 ms, agent không có tool, không có rule cho giá trị sentinel, không có khả năng tính toán. Tiến triển: 001 thêm rule giá trị sentinel vào system prompt (31.7%, +13.4pp), 002 thêm calculator tool chạy code JS (58.3%, +26.6pp), 003 cải thiện xử lý nhiều câu lệnh của calculator và hướng dẫn trong prompt (60.0%, +1.7pp), 004 thêm HTTP fetch tool (61.7%, +1.7pp), 005 sửa regex scorer cho số âm (58.3%, -3.4pp).12. Thử trên một agent production đã được tối ưu
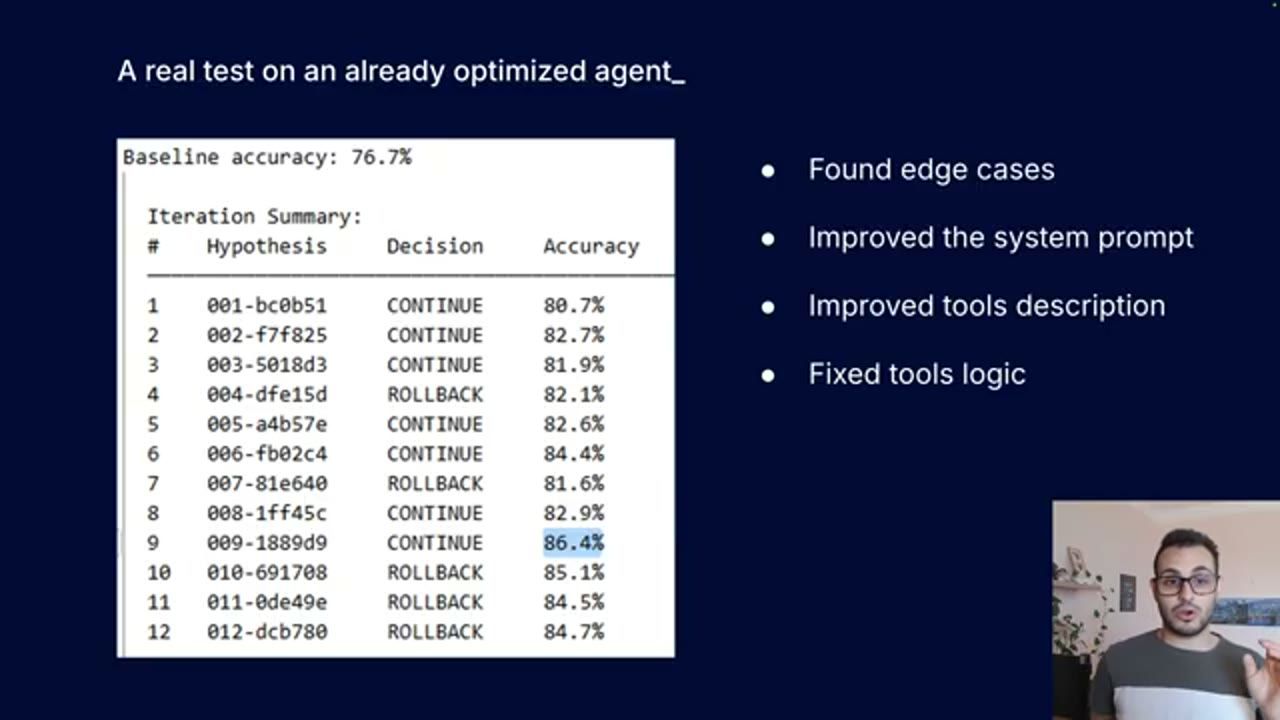
Đây là một lần chạy thật trên một agent thật mà nhóm có. Alfonso nói accuracy baseline là 67%, và trong khoảng 10 iteration hệ thống đưa eval lên 86% (bảng trên slide ghi baseline 76.7%, cao nhất 86.4%) mà không gian lận: nó tìm ra edge case, cải thiện system prompt, cải thiện mô tả tool để bắt thêm edge case, và sửa cả logic của một số tool. Đó là một agent thật hiện đang chạy production, và hệ thống này đã tìm ra cách cải thiện nó ngày càng nhiều hơn.
13. Lớp vấn đề thứ hai: live data
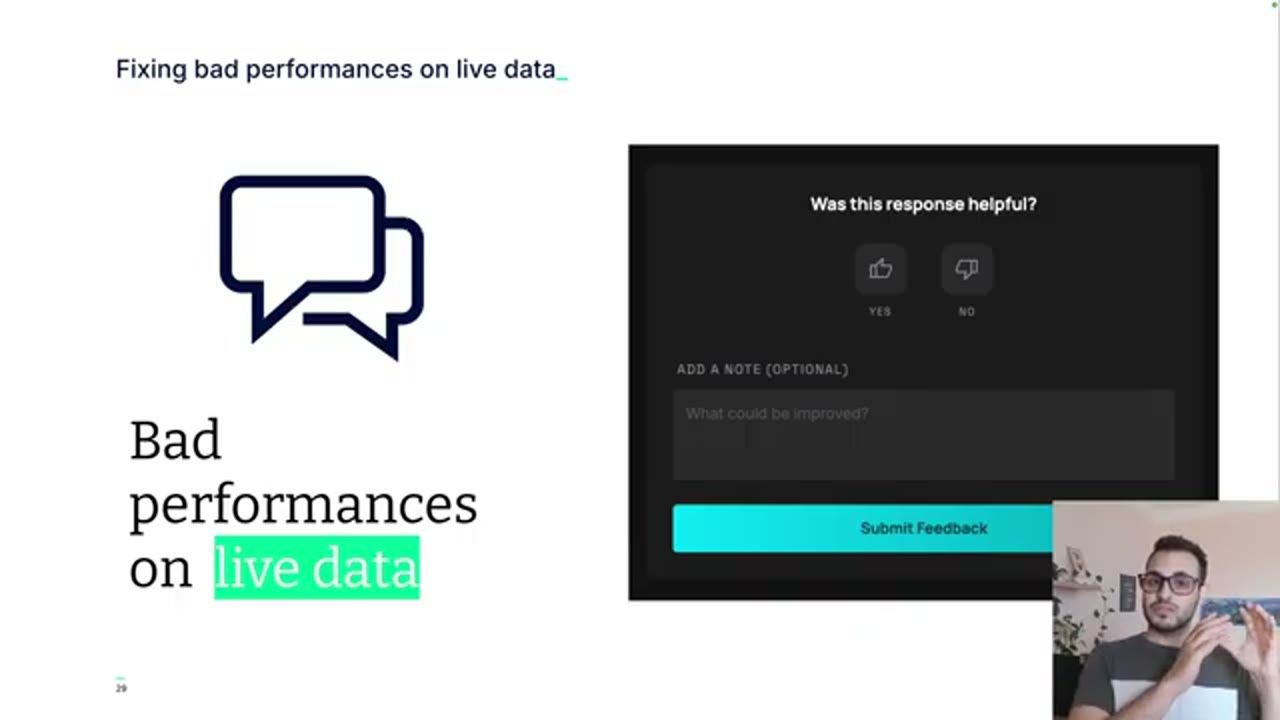
Lớp vấn đề thứ hai của talk không nằm ở dữ liệu eval mà ở kết quả kém trên live data. Live data ở đây là dữ liệu thu từ người dùng thật, beta tester, subject matter expert, tóm lại là mọi người đang chủ động test và dùng hệ thống và gửi feedback cho nhóm. Ví dụ như bên phải slide: "Was this response helpful?", chọn yes hoặc no, rồi để lại một ghi chú. Nhóm tận dụng dữ liệu này để tiếp tục tối ưu agent.
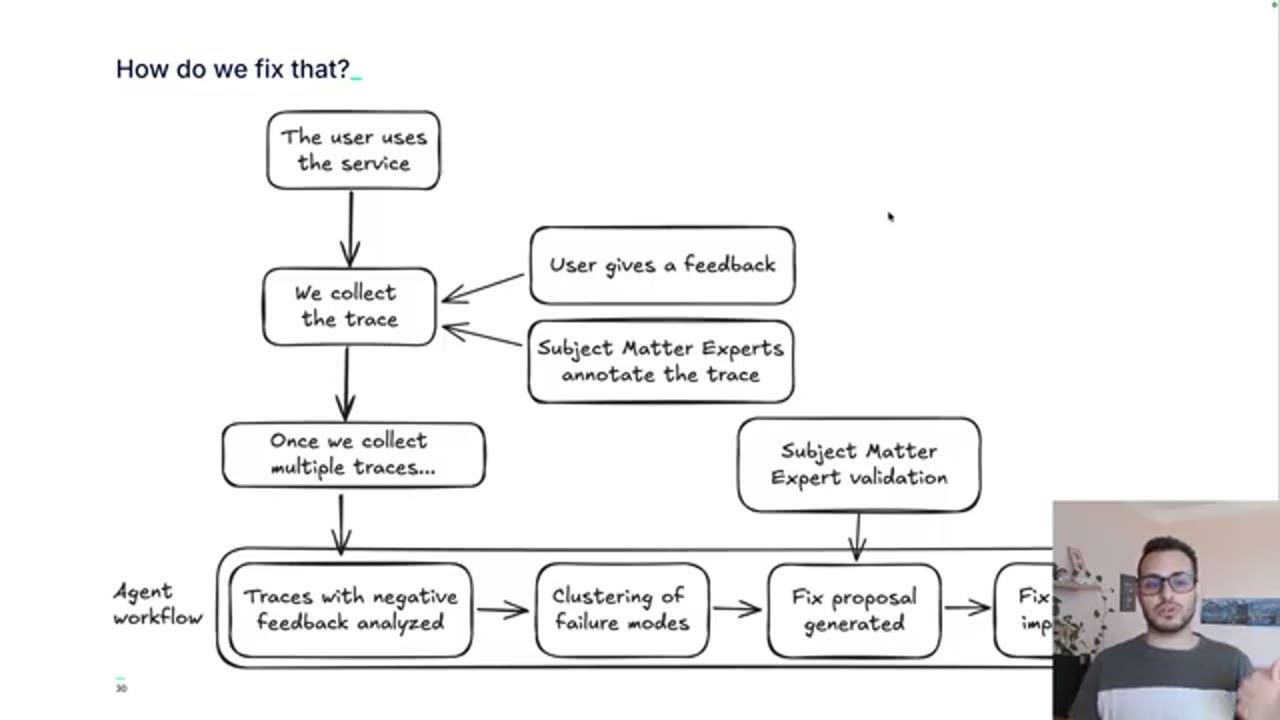
Làm thế nào? Đây là toàn bộ luồng, sẽ đi chi tiết từng bước. Trước hết, tất nhiên cần người dùng thật sự dùng hệ thống. Rồi thu toàn bộ trace, tức mọi thông tin từ người dùng. Người dùng có thể gửi feedback như vừa thấy, thumbs up hay thumbs down kèm comment; hoặc SME có thể annotate trace. Tức là họ vào platform nhóm đang dùng, xem trace, xem input, output, xem mọi tool đã được gọi, xem hành vi của agent, rồi annotate trace bằng feedback về việc agent đã làm thế nào và lẽ ra nên làm thế nào.
Khi đã thu được một số lượng trace tương đối tốt, đủ thông tin, nhóm chạy một agent workflow tự build. Workflow này phân tích mọi trace có feedback tiêu cực lẫn tích cực, nhưng ở đây nhóm quan tâm feedback tiêu cực hơn. Nó phân tích các trace đó và clustering các failure mode: dựa trên toàn bộ feedback thu được, cố hiểu xem có khoảng năm, sáu, bảy failure mode nào ở đây.
Sau đó phân tích các cluster failure mode này cùng SME. Kiểu: "Dựa trên 10 trace này, có thể thấy agent trong trường hợp cụ thể này làm kém vì lý do X." Nhóm xác nhận tất cả với SME, rồi có một đề xuất sửa (fix proposal) do coding agent sinh ra và implement. Tiếp đó ship lên production để xem nó có thật sự cải thiện trên dữ liệu thật không. Và tất nhiên, nhóm dùng các trace đang có làm regression test: trước hết thử bản sửa trên chính các trace đó.
14. User dùng hệ thống, thu trace, nhận feedback
Giờ đi vào chi tiết. Bước một: user test hệ thống. Ví dụ đơn giản: "Làm sao tối ưu một React component?" Agent trả lời, đưa thông tin về component, đại loại vậy.
Bước tiếp theo: thu toàn bộ thông tin tracing. Nhóm thu mọi thứ, từ tương tác của user, việc dùng tool, AI mất bao lâu để trả lời, cho tới đã đốt bao nhiêu token. Mọi thứ.
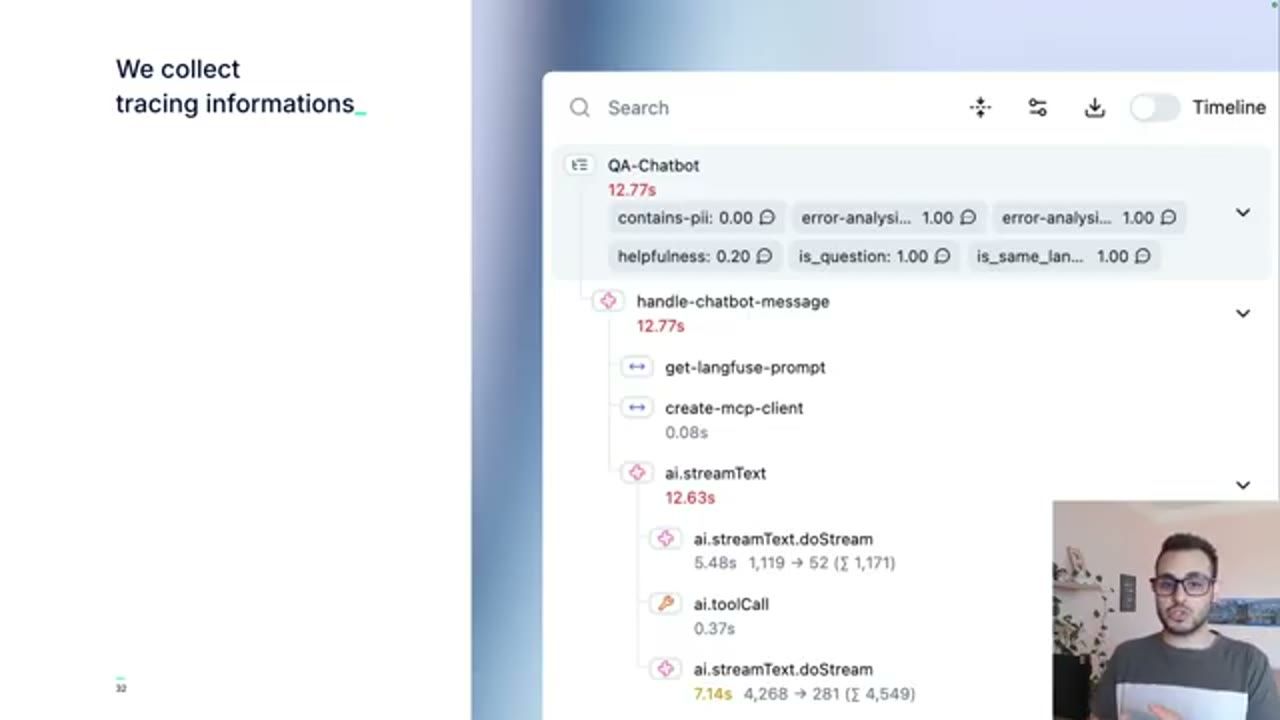
Sau khi thu được hành vi của user, nhóm kỳ vọng user cho feedback. Như đã nói: thumbs up, thumbs down, kèm một comment nói cái gì ổn, cái gì không, và hệ thống lẽ ra nên hành xử thế nào. Trên demo, người dùng bấm thumbs down và gõ "Very long answer"; feedback đó gắn thẳng vào trace tương ứng với score user-feedback bằng 0.
Lựa chọn còn lại đã bàn: chính SME annotate trace. Nếu không có feedback từ user thật, có thể nhờ SME xem trace, bỏ thời gian ra và cho feedback như thể họ là user. Trên demo, SME mở một annotation queue tên "Error Analysis" trong Langfuse, xem input "What can I use Langfuse for?" cùng câu trả lời, rồi chấm một nhãn như "Good Output".
Bước ba: gom mọi trace có feedback và tải về máy dưới dạng JSON, hay format nào bạn dùng. Trong ví dụ có 114 trace, và nhóm dùng chúng để làm cluster analysis. Trên slide, một lệnh npm run fetch-traces-with-feedback.ts với khoảng ngày và giới hạn 200 trace đã quét 183 trace trên môi trường production và lấy về 114 trace có feedback; mỗi trace gồm id, user, thời điểm, model, latency, câu hỏi, câu trả lời, comment, điểm và ghi chú feedback của user, cùng annotation.
15. Skill phân tích cluster và report markdown
Phân tích chạy thế nào? Thực ra đây là một skill nhóm tự build. Skill này hướng dẫn coding agent đi vào file JSON, xem toàn bộ trace và chạy clustering. Sau đó là một lượt adversarial review trên kết quả đó.
Khi đã có các cluster, nhóm còn làm thêm một chút root cause analysis. Vì coding agent có quyền truy cập code thật của AI agent, nó làm được root cause analysis: cố hiểu chuyện gì đã xảy ra, đặc biệt vì nó cũng có quyền xem chi tiết của từng trace. Nó có thể đi vào trong trace, hiểu vì sao agent trả lời như vậy, và lần ngược tới nguyên nhân gốc. Rồi nó đề xuất các cải tiến khả dĩ.
Cuối quá trình, nhóm có một report markdown đầy đủ, rất hữu ích. Nó cho biết feedback tích cực, feedback tiêu cực, tỷ lệ tiêu cực; nhóm cố gom càng nhiều dữ liệu càng tốt. Kết quả là một executive summary rất đầy đủ và một report rất đầy đủ, chỉ ra tất cả các cluster đang không chạy như người dùng kỳ vọng.
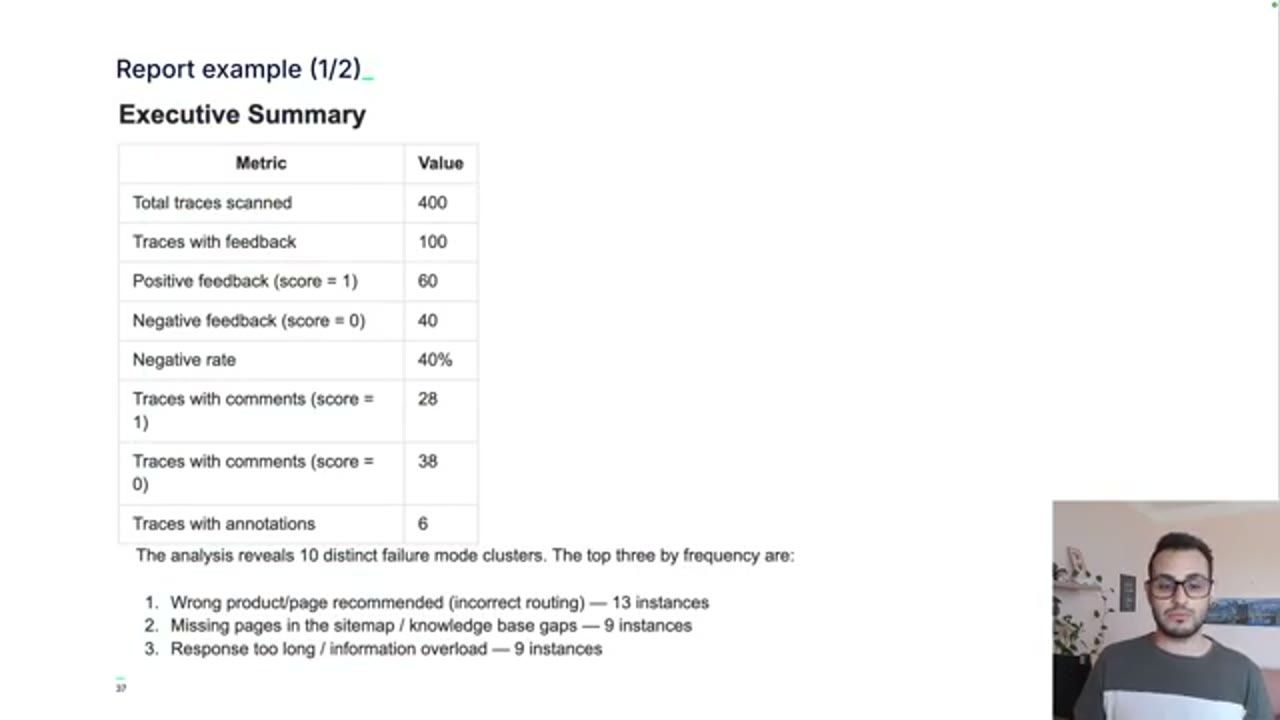
Trong ví dụ này có một cluster nhỏ về format markdown: URL không được biến thành hyperlink, và format không nhất quán. Report nối cluster đó với một số trace qua trace ID, trích feedback của user, nêu vài nguyên nhân gốc khả dĩ, và nói rõ cách sửa.
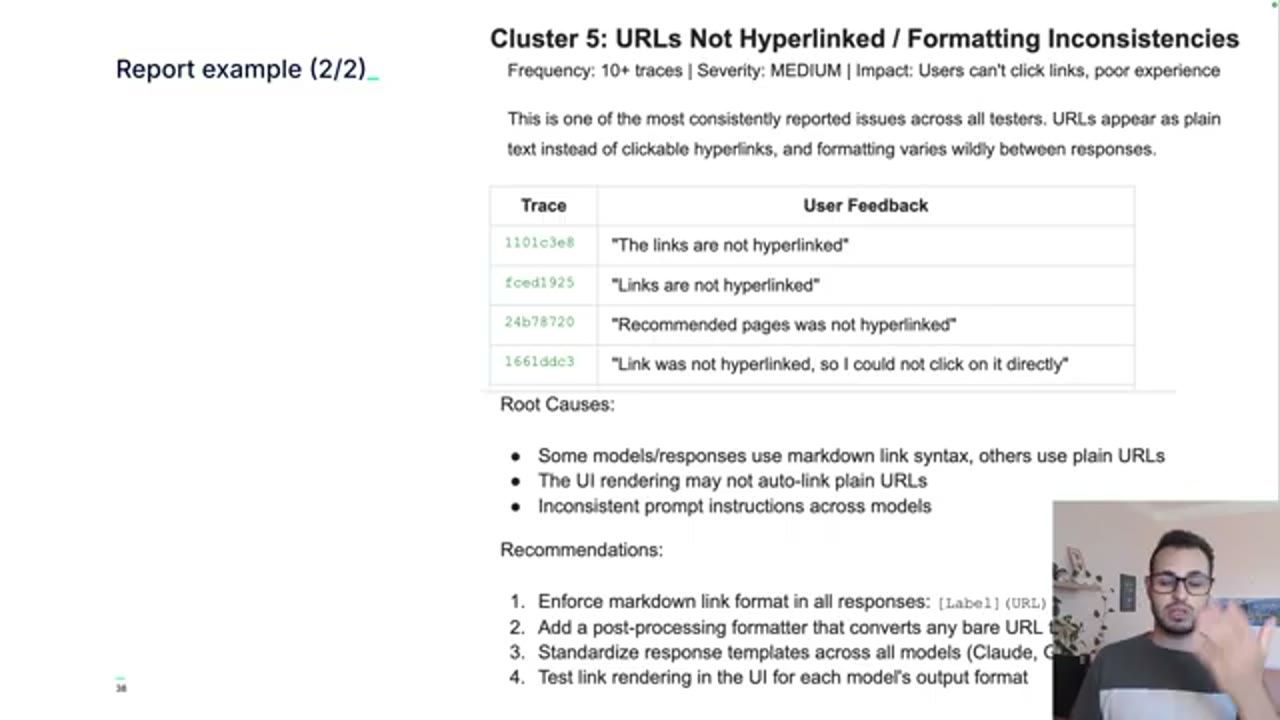
[Label](URL) ở mọi câu trả lời, thêm một formatter hậu xử lý đổi URL trần thành link, chuẩn hóa template câu trả lời giữa các model, và test hiển thị link trên UI cho output của từng model.16. Triage với SME, sửa hoặc loại bỏ, cải tiến liên tục
Có report đầy đủ rồi nhưng việc chưa xong, vì report sẽ chứa mọi cluster lỗi khả dĩ mà user đã báo. Việc tiếp theo là triage tất cả và xác nhận với SME. Triage và xác nhận xong thì ưu tiên hóa: hiểu cái gì cần sửa ngay, cái gì sửa sau, cái gì không sửa.
Từ đó, hoặc sửa bằng agent: đưa cho agent toàn bộ context, đưa failure mode, đưa trace, rồi bảo agent sửa. Hoặc loại bỏ, vì đôi khi một cluster lỗi là false positive, hoặc là hành vi có chủ đích, và có thể user đã cho một feedback không thật sự hữu ích với nhóm vào lúc này. Nên ở đây có một chút phán đoán của con người.
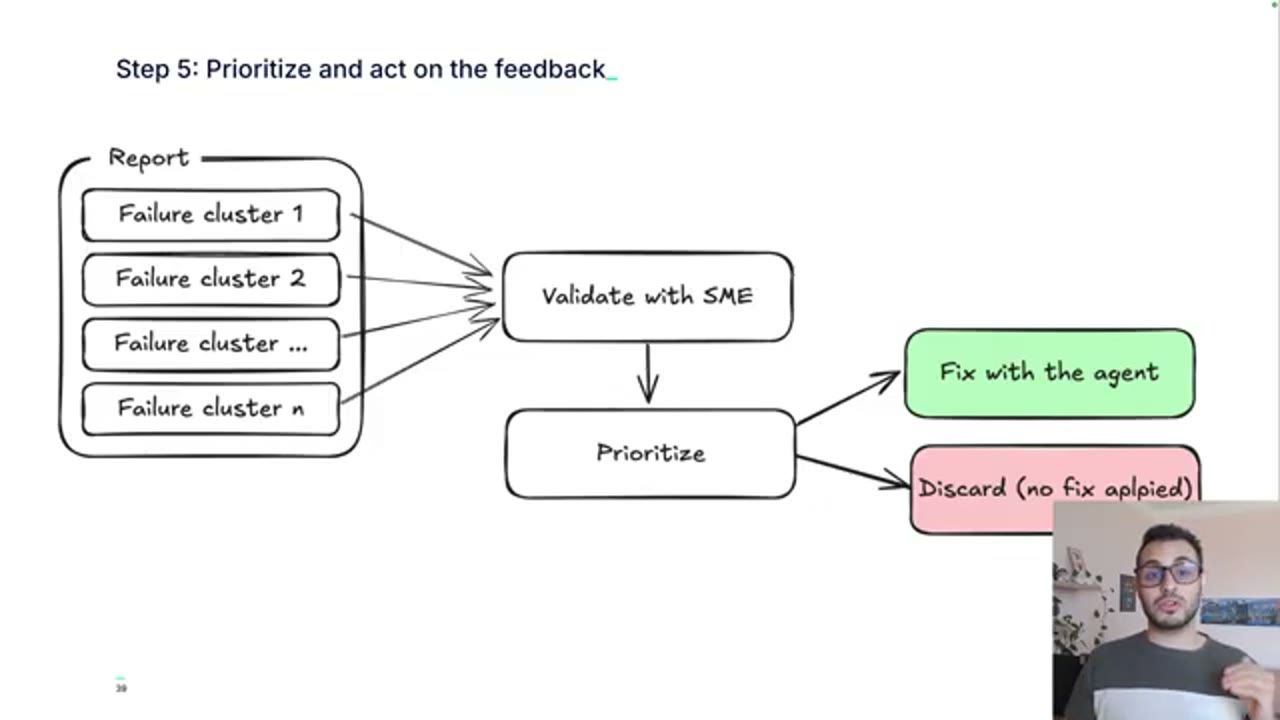
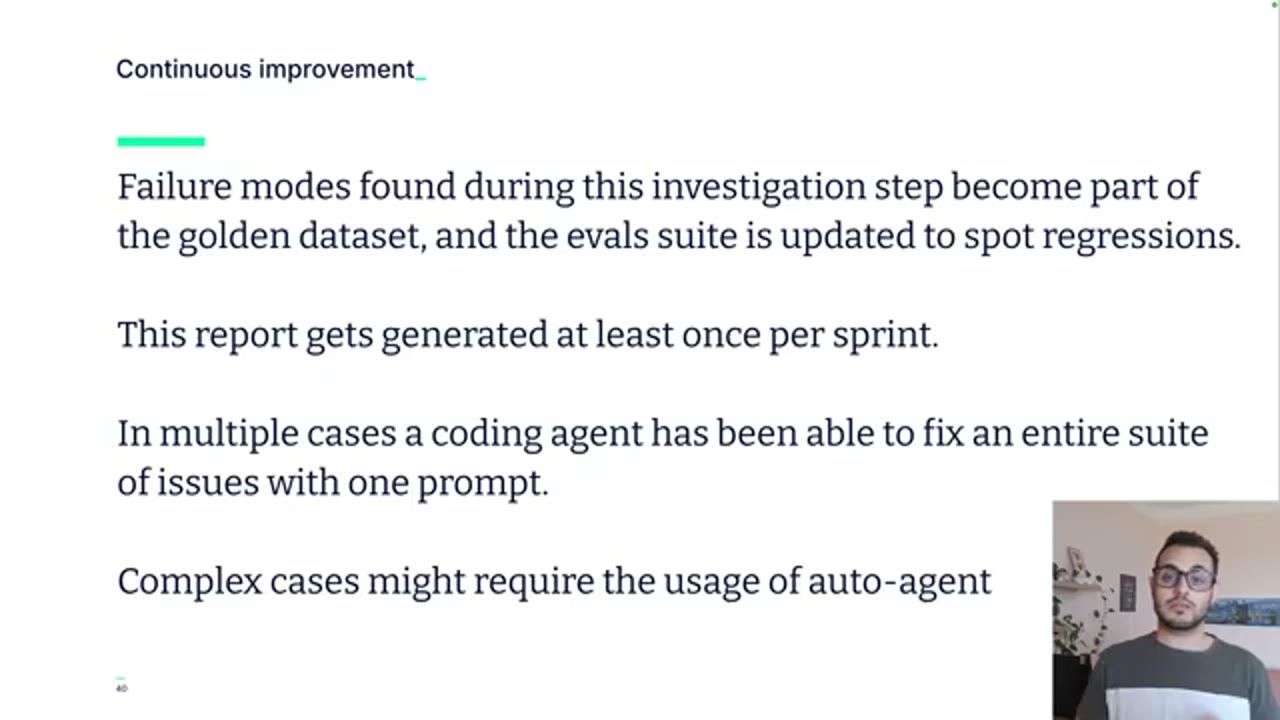
Như đã nói ở phần trước, mọi failure mode tìm thấy trong bước điều tra này sẽ trở thành một phần của Golden dataset, và eval suite được cập nhật để phát hiện regression. Nên nếu vì lý do gì đó failure mode này bị đưa lại vào code về sau, nhóm sẽ phát hiện rất nhanh, vì giờ nó đã nằm trong Golden dataset và trong scorer.
Bao lâu sinh report một lần thì tùy use case. Nhóm thấy mỗi sprint một lần là đủ tốt, nhưng thật ra nó phụ thuộc vào lượng dữ liệu bạn có. Có 100 trace thì có thể sinh report ở mốc 100 trace. Nhưng nếu có cỡ 10.000 trace có feedback thì có lẽ quá nhiều cho một report, nên có thể sinh nhiều report. Vậy nên tùy use case; với nhóm, mỗi sprint một lần là hợp lý.
Ở nhiều use case, nhóm thấy một coding agent, khi được hướng dẫn đúng, đã sửa được cả một loạt vấn đề như ví dụ vừa rồi chỉ với một prompt. Khi trao đủ context, và trao cho coding agent khả năng test thay đổi của nó trên một bộ regression test, mọi thứ trở nên dễ hơn rất, rất nhiều với coding agent. Còn ở một số ca phức tạp, nhóm kết hợp cách này với AutoAgent: trỏ AutoAgent vào một số cluster lỗi và để nó build vài draft PR cho nhóm.
17. Harness engineering làm cho mọi thứ chạy được
Cả AutoAgent lẫn pipeline cải thiện agent từ live data đều khả thi nhờ harness engineering. Ý cốt lõi: nhóm dựa vào một tập các thứ để coding agent có một harness đủ mạnh, nhờ đó nó có thể sửa code, tự validate thay đổi của chính nó (điều này cực kỳ quan trọng), và đề xuất thay đổi mới nếu lần cập nhật trước không dẫn tới kết quả mong muốn.
Nói thật nhanh, harness engineering là ý tưởng build môi trường bao quanh coding agent để chúng làm việc đáng tin cậy. Nhóm trao cho coding agent mọi constraint, mọi task, feedback loop, và governance. Việc đó làm bằng vài thứ đã nhắc trong talk:
- Spec-driven development. Ví dụ khi cố sửa một số failure mode, mỗi failure mode trở thành một spec. Nhóm tạo một spec cho hành vi kỳ vọng của agent, rồi implement nó.
- Quality gate. Linting, unit test, eval, LLM code review, và nhiều thứ khác.
- Context engineering. Mọi thứ liên quan tới việc trao đúng context cho agent.
- Observability. Vì phải biết chuyện gì đang xảy ra. Nếu không biết chuyện gì xảy ra khi ship lên production thì về cơ bản là đang mù. Nhóm muốn đảm bảo biết được chuyện gì đang diễn ra để coding agent có thể sửa bug hay bất cứ vấn đề gì ngay khi tìm thấy.
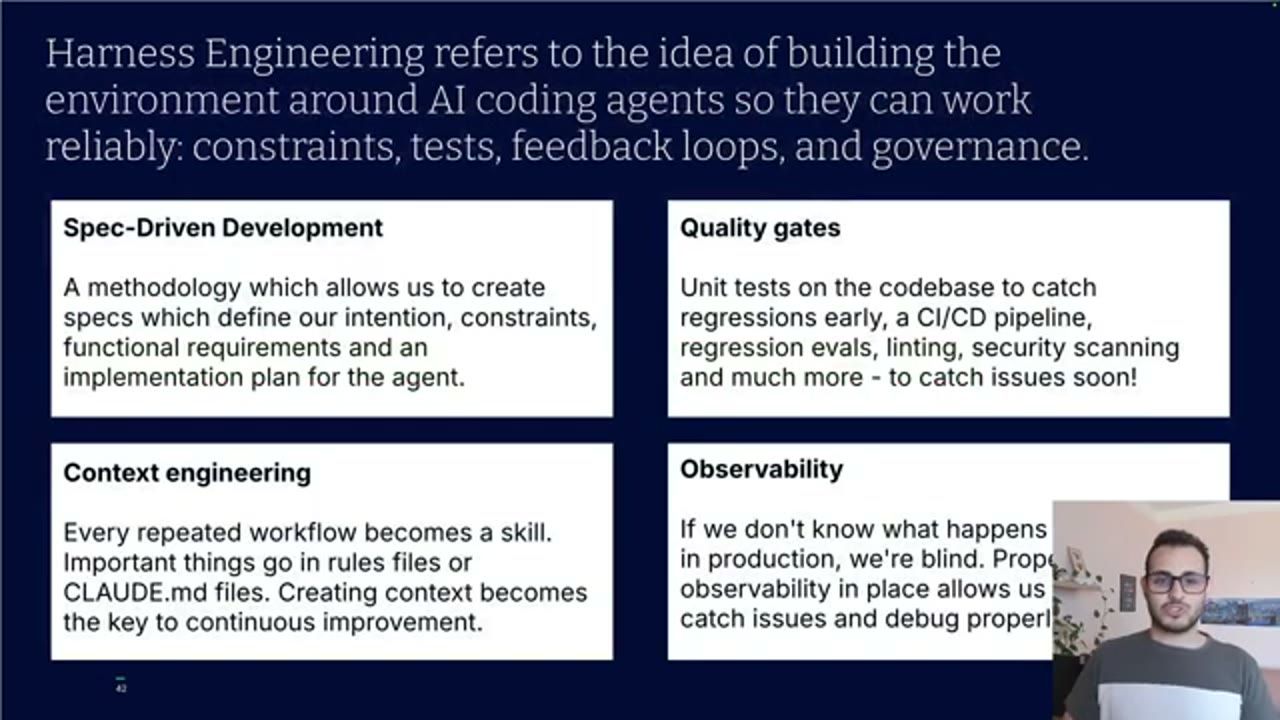
CLAUDE.md; tạo context trở thành chìa khóa cho cải tiến liên tục. Observability: không biết chuyện gì xảy ra trên production thì ta mù; observability đúng cách giúp bắt lỗi và debug.Alfonso hy vọng talk thú vị và hữu ích, và mong mọi người sẽ áp dụng vài kỹ thuật này vào agent của mình. Nếu có câu hỏi về talk, cứ thoải mái liên hệ anh trên LinkedIn: anh rất muốn trò chuyện với những người khác đang build agent. Anh biết việc đó khó thế nào, và cũng thú vị thế nào. Có gì muốn bàn, anh rất vui được nhận tin nhắn. Anh chúc mọi người một ngày tuyệt vời. Cheers.
Nguồn và liên kết
- Trang talk trên ai.engineer · Video gốc
- auto-agent: AutoAgent của Alfonso, "như Autoresearch nhưng cho AI agent"; repo demo agent Mastra đi kèm: auto-agent-demo
- karpathy/autoresearch: vòng lặp coding agent tự chạy thí nghiệm training của Andrej Karpathy
- Mastra: framework TypeScript dùng để viết agent và scorer trong demo
- Langfuse: nền tảng tracing, feedback và annotation queue xuất hiện trong demo live data
- Claude Code: coding agent dùng làm builder trong AutoAgent
- Nearform · GitHub của Alfonso Graziano
- Sách: "Learning AI-Native Software Engineering" (O'Reilly), Alfonso Graziano
- LinkedIn của Alfonso Graziano: linkedin.com/in/alfonso-graziano
Related talks
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
HTML is All You Need (for Agents to Make Graphics)
Amol Kapoor · Nori Agentic · 7 min
Vì sao agent vẽ dở trên canvas và SVG nhưng làm slide, docs, cả video rất tốt khi viết bằng HTML: đổi medium, đừng đổi model.
The Agentic AI Engineer
Benedikt Sanftl & Burak Cemil Özafşar · Mutagent · 35 min
Chạy vòng đời agent như một loop agentic: spec, build, eval-driven development, diagnose trace production thành eval mới, và demo diagnostics agent.