Dựng trạm AI local chạy offline cho cả nhà và văn phòng
Chạy AI offline trên máy riêng với LM Studio, Whisper và Open WebUI: chọn model theo bộ nhớ card, đọc tài liệu riêng, nhiều người dùng chung.
✓ Đã duyệt độc lập · cập nhật 21/10/2026 · 11 min
1. Một con AI đọc kịch bản mà không cần mạng
Video mở ra bằng một màn hình chat. Thanh Trần đính kèm một kịch bản cũ của anh, một file Markdown về chuyện Claude hay báo hết lượt giữa chừng, rồi hỏi con AI: theo bài này, vì sao mình hay bị Claude báo hết lượt giữa chừng? Con AI đọc kịch bản và trả lời câu hỏi về nó, dựa đúng vào nội dung bài: nào là hiểu sai về cơ chế reset theo cửa sổ 5 giờ, nào là Claude không tính theo ngày mà theo một rolling window 5 tiếng liên tục.
Điểm đáng chú ý là con AI này không cần có mạng (theo video đăng ngày 21/10/2026). Anh tắt Wi-Fi đi, nó vẫn trả lời y như vậy. Không có ChatGPT nào ở đây, cũng không có cloud. Không có gói thuê bao tháng, cũng không có khoản tiền API nào cả. Toàn bộ con AI đang nằm trong chiếc máy đặt ngay bên cạnh anh, và dữ liệu của anh không rời khỏi căn phòng đó một chữ nào.
Trong video, anh hướng dẫn dựng một trạm AI y như vậy. Phần cơ bản người xem hoàn toàn có thể làm trên chiếc máy mình đang có. Và ở cuối video, anh cho cả nhà dùng chung trạm AI đó bằng điện thoại.
2. Vì sao dữ liệu nên ở lại trên máy, và chiếc máy trong video
Lý do anh làm video này rất đơn giản. Giả sử bạn có một bản hợp đồng, một bảng lương hay một kho ghi chú khách hàng, bạn muốn AI đọc giúp, nhưng lại không dám dán nó lên một dịch vụ AI trên mạng. Nhiều công ty còn cấm hẳn việc này (theo anh, tính đến video đăng ngày 21/10/2026).
Cách giải quyết gọn nhất là để AI chạy ngay trên máy của bạn. Không có gì gửi đi thì không có gì phải lộ. Nhưng muốn như vậy thì cần phần cứng.
Đây là video hợp tác với AMD, và AMD gửi cho anh chiếc máy dùng trong video để anh thử xem AI chạy tại chỗ làm được tới đâu. AMD gọi dòng máy này là Threadripper AI Station R9700. Theo cấu hình anh ghi trong phần mô tả video (đăng ngày 21/10/2026), bên trong là CPU AMD Ryzen Threadripper PRO 9985WX 64 nhân và hai card đồ họa AMD Radeon AI PRO R9700, mỗi card 32GB bộ nhớ.
Anh nói trước cho rõ: đây là máy trạm, không phải dòng máy phổ thông. Nhưng với cách làm anh hướng dẫn trong video, máy nhỏ hơn vẫn có thể làm theo được (theo video đăng ngày 21/10/2026). Máy mạnh hơn chỉ khác ở đúng một chỗ: nó chạy được những con AI to hơn và phục vụ được nhiều người hơn.
3. Một con AI chỉ là một cái file
Nhiều người vẫn nghĩ AI là thứ nằm trên máy chủ của một công ty nào đó. Thực ra không hẳn như vậy. Nói đơn giản nhất, một con AI chỉ là một cái file. Có những công ty bỏ ra rất nhiều tiền để huấn luyện ra nó, rồi phát miễn phí cho mọi người tải về (theo video đăng ngày 21/10/2026). Tải về rồi thì nó là của bạn.
Trên màn hình là danh sách các con AI kèm con số bên cạnh tên. Con số đó là dung lượng file: một con gần 18GB, một con hơn 70GB, còn một con chỉ hơn 7GB.
Không phải con nào cũng vậy, nhưng nhìn chung file càng to thì con AI càng khôn (theo video đăng ngày 21/10/2026). Và file to thì cần card đồ họa có nhiều bộ nhớ để chứa. Anh dặn người xem nhớ câu này, vì lát nữa anh sẽ quay lại giải thích tiếp.
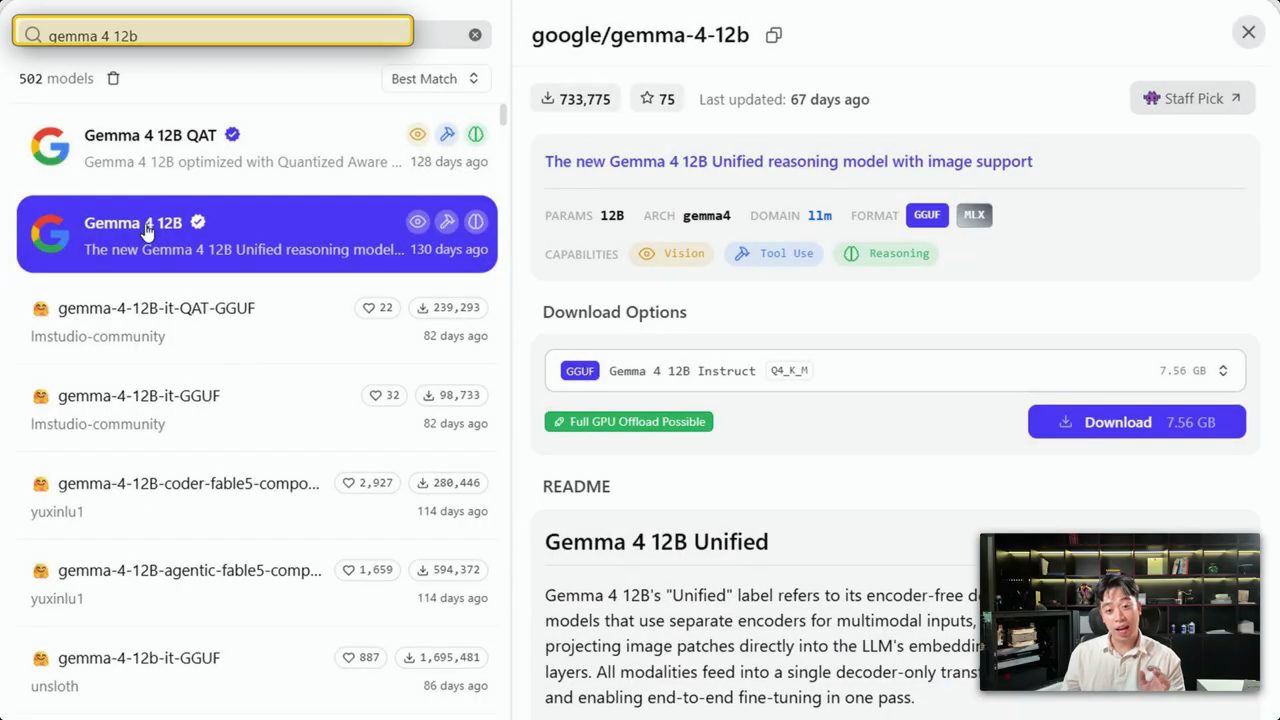
4. Cài LM Studio và thử Gemma 4 12B
Phần mềm anh dùng là LM Studio. Theo video đăng ngày 21/10/2026, nó miễn phí và không cần tạo tài khoản. Ai đã xem loạt video trước của anh thì chắc đã quen; ai chưa xem thì có thể quay lại xem.
Cách tải: vào trang tải của LM Studio, kéo xuống một chút rồi bấm nút Download LM Studio for Windows. Theo video đăng ngày 21/10/2026, cái nằm trên cùng trang là một sản phẩm khác (trên màn hình ghi "Download LM Studio Bionic"), anh dặn đừng tải nhầm.
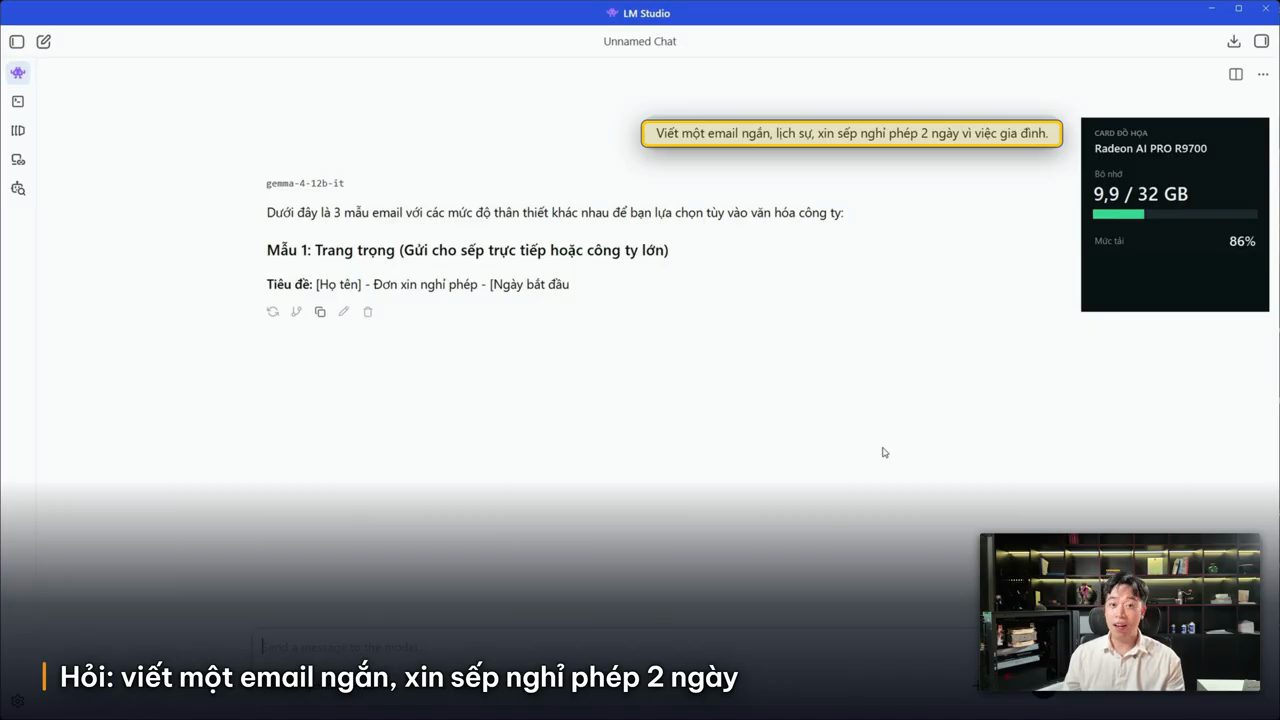
Cài xong thì tải con AI đầu tiên. Anh chọn Gemma 4, bản 12 tỷ tham số, file nặng hơn 7GB. Theo video đăng ngày 21/10/2026, con này không cần máy trạm: máy tính có card đồ họa rời là chạy được. Tải xong, anh nạp nó lên card và hỏi thử một câu tiếng Việt: viết một email ngắn, lịch sự, xin sếp nghỉ phép 2 ngày.
Viết một email ngắn, lịch sự, xin sếp nghỉ phép 2 ngày vì việc gia đình.
Chữ ra nhanh hơn cả tốc độ đọc kịp: khoảng 67 token mỗi giây, theo số đo của anh (video đăng ngày 21/10/2026). Nhưng nhìn kỹ câu trả lời thì có vấn đề. Anh xin một email ngắn, nó lại đưa ra hẳn ba mẫu email, kèm thêm một mục lưu ý. Nhanh, nhưng chưa đúng việc anh nhờ.
5. Đổi sang Qwen3.8 27B: chậm hơn nhưng hiểu đúng việc
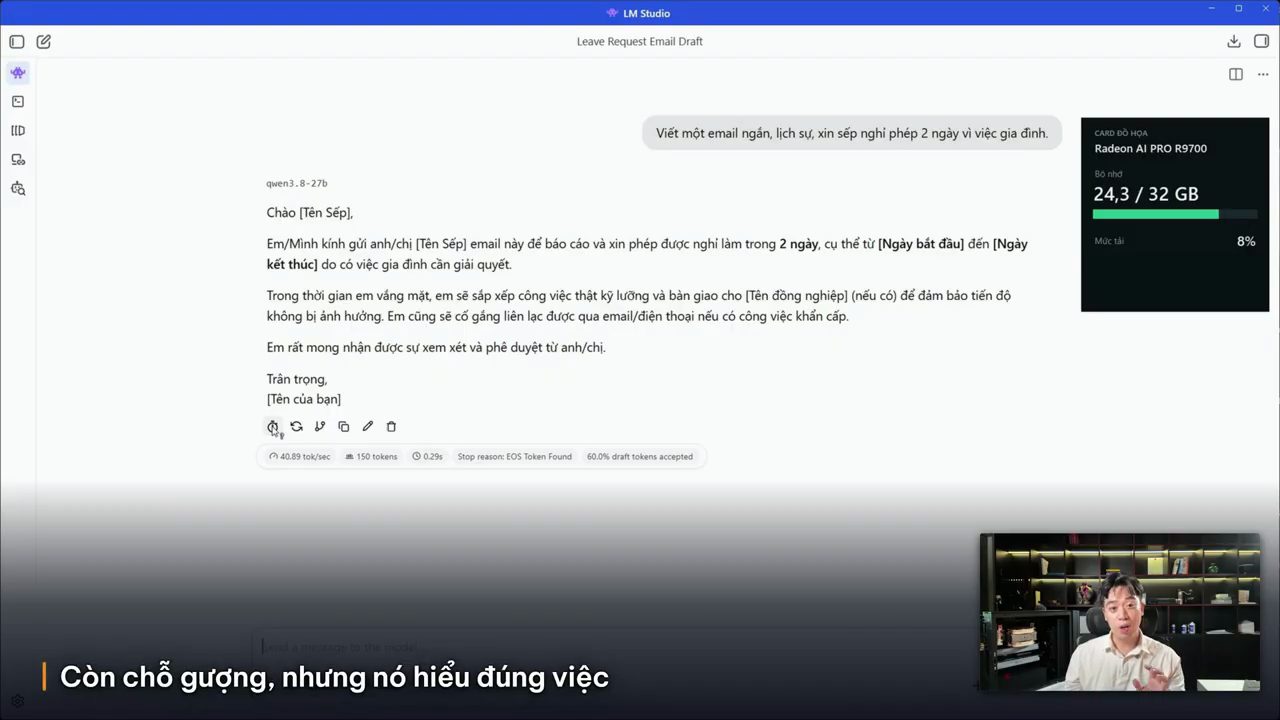
Giờ anh đổi sang một con to hơn: Qwen3.8, bản 27 tỷ tham số. Con số ở góc phải màn hình cho thấy nạp lên là nó đã chiếm hơn 24GB bộ nhớ card (số đo của anh, video đăng ngày 21/10/2026). Những card ít bộ nhớ sẽ không chứa nổi. Còn trên chiếc máy này, nó nằm gọn trong một card 32GB.
Cùng câu hỏi đấy, lần này anh nhận được đúng một email gọn, đúng như anh xin. Câu chữ vẫn còn một hai chỗ gượng và anh vẫn phải sửa tay, nhưng nó đã hiểu đúng việc.
Tốc độ của con này chậm hơn con nhỏ: khoảng 40 token mỗi giây, theo số đo của anh (video đăng ngày 21/10/2026). Nhưng vẫn nhanh hơn tốc độ chúng ta đọc. Và đây chính là chỗ phần cứng tạo ra khác biệt: không phải nhanh hơn bao nhiêu phần trăm, mà là bạn chạy được con AI to cỡ nào.
6. Khi AI bịa bằng giọng tự tin, và nút Think
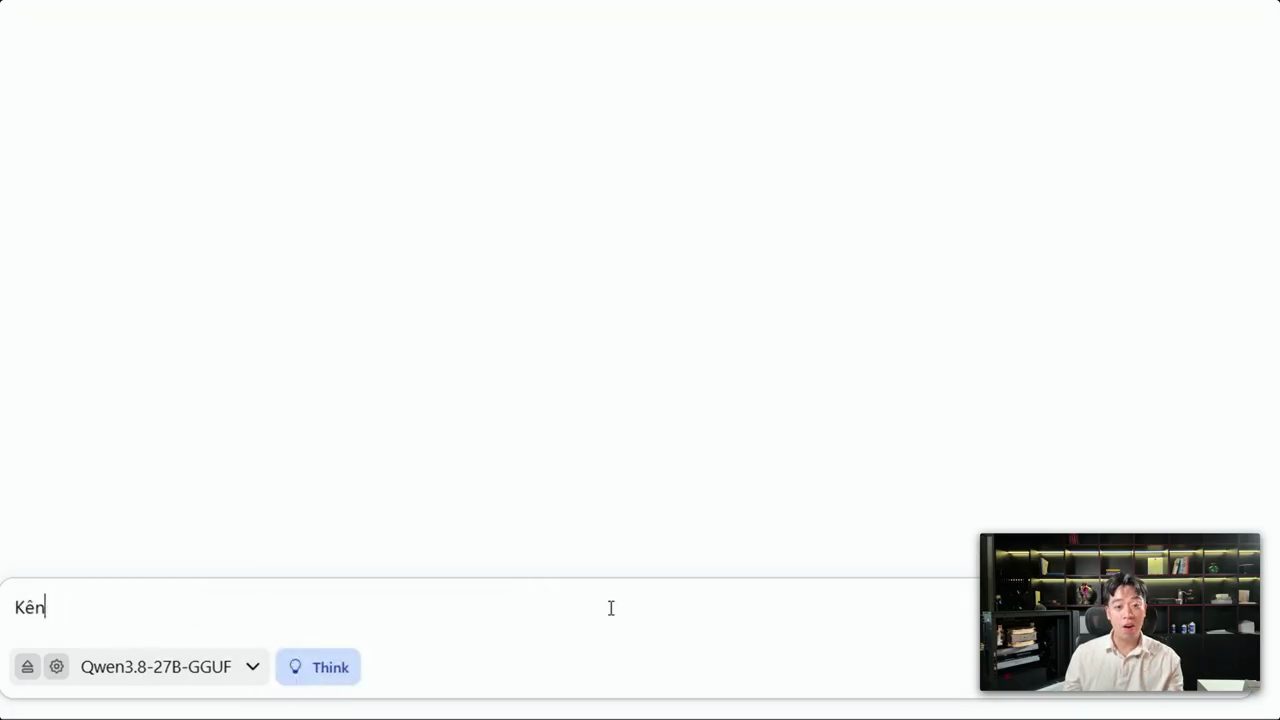
Tiếp theo anh hỏi một câu khó hơn: kênh AI 5 Phút là của ai? Nó trả lời ngay, rất trôi chảy: kênh này do một người khác sáng lập, kèm tên cụ thể và giới thiệu người đó là chuyên gia công nghệ. Nghe thì rất thuyết phục, nhưng thực ra có vấn đề: kênh này là kênh của anh, và anh tên là Thanh.
Nó không biết, nhưng lại không nói là không biết. Nó tự bịa, và bịa bằng đúng cái giọng tự tin như lúc nó nói đúng. Ở lần thử trước với đúng câu này, nó còn bịa ra một cái tên khác hẳn.
Rồi anh chỉ vào một nút nhỏ trong ô chat, tên là Think. Bật nút này lên thì con AI sẽ nghĩ trước khi trả lời. Anh bật nó và hỏi lại đúng câu vừa rồi. Nó suy nghĩ mất hơn 8 giây (theo số đo của anh, video đăng ngày 21/10/2026), rồi nói thẳng là nó không có thông tin xác thực về kênh này. Sau đó nó mới đoán theo cái tên, và nói rõ là nó đang đoán.
Cùng một con AI, nhưng nếu cho nó thời gian nghĩ thì nó thật thà hơn hẳn. Anh đã thử cả hai lượt và hai lượt đều như vậy (theo lần thử của anh, video đăng ngày 21/10/2026), dù anh không dám chắc lần nào cũng thế. Và dù bật hay tắt, giới hạn của nó vẫn nằm ở đó: con AI chỉ biết những gì nó được dạy. Nó không biết công ty của bạn, không biết khách hàng của bạn, và không biết bạn.
7. Đưa tài liệu riêng cho AI đọc
Muốn AI biết những thứ đó thì bạn phải đưa tài liệu cho nó đọc. Và đây chính là lúc chạy offline đáng tiền nhất, vì thứ bạn sắp đưa cho nó là thứ bạn không muốn đưa cho ai khác.
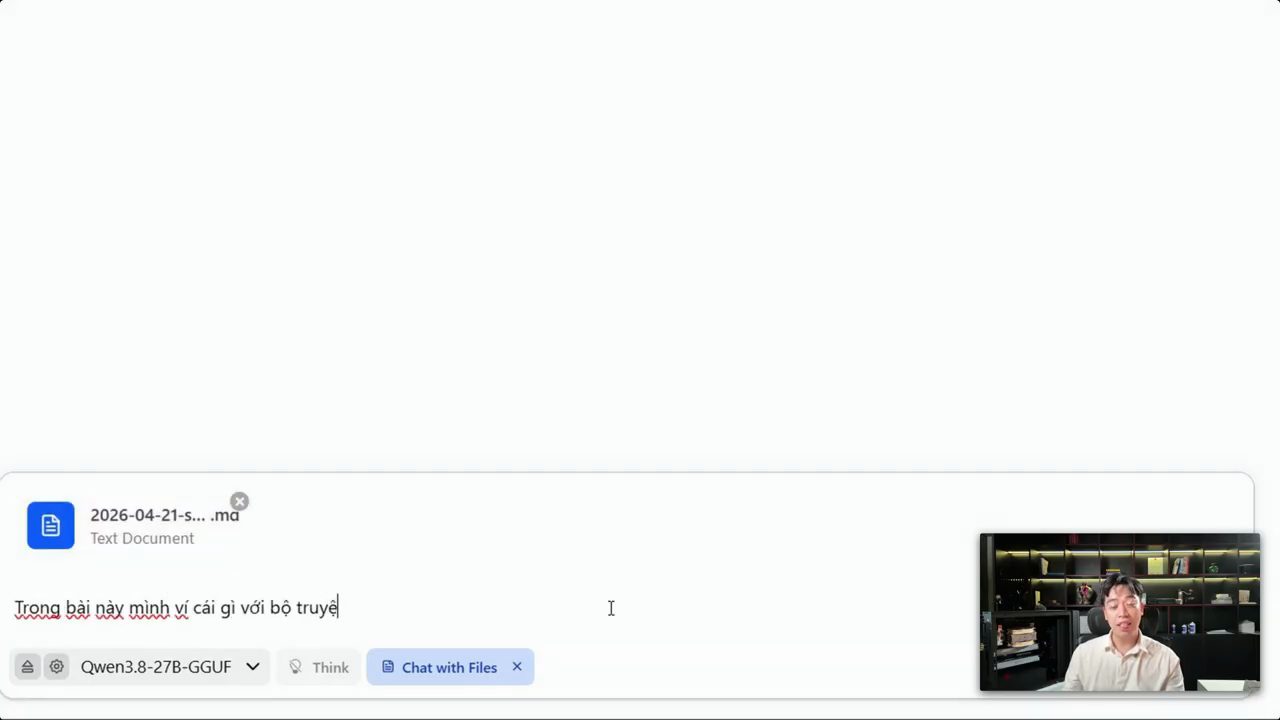
Anh lấy một kịch bản cũ của mình, đính kèm vào khung chat và hỏi: trong bài này mình ví cái gì với bộ truyện Harry Potter? Nó trả lời đúng luôn: trong bài, anh ví 1 triệu token bằng cả bộ Harry Potter cộng lại.
Trong bài này mình ví cái gì với bộ truyện Harry Potter?
Rồi anh thử một câu khó hơn: tóm tắt bài này thành 5 ý, mỗi ý một dòng. Nó trả lời đúng 5 dòng. Bài này do anh viết nên anh kiểm được: không ý nào bị bịa, cả 5 ý đều có trong bài. Và không một chữ nào trong bài rời khỏi máy tính.
Tóm tắt bài này thành 5 ý, mỗi ý 1 dòng.
Bây giờ bạn có thể thay kịch bản của anh bằng thứ của mình: hợp đồng thuê nhà, báo cáo quý hay biên bản họp. Cách làm y hệt.
8. Cả kho hơn 100 kịch bản: hỏi một câu, ra hai kết quả
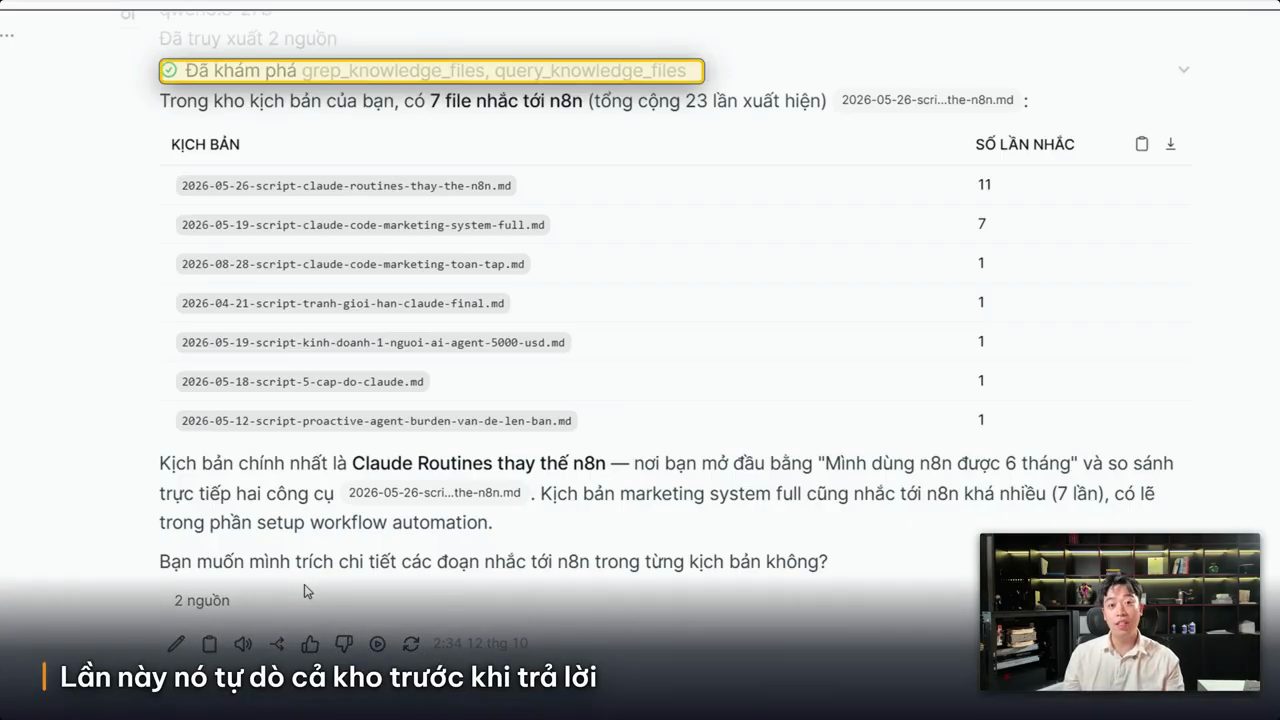
Một file thì dễ. Vậy cả một kho thì sao? Anh đã nạp hơn 100 kịch bản của kênh vào một kho tài liệu. Phần mềm chứa kho này anh để tới cuối video mới nói kỹ. Rồi anh hỏi nó một câu mà chính anh cũng không nhớ nổi: những kịch bản nào của mình có nhắc tới n8n?
Lần đầu nó trả lời: có 2 kịch bản. Nghe thì không có vấn đề gì, nhưng kiểm lại thì 2 cái nó đưa ra là 2 đoạn của cùng một bài. Tức là nó chỉ tìm được đúng một bài.
Anh mở một cuộc trò chuyện mới và hỏi lại y nguyên câu đó. Lần này, như dòng trên màn hình cho thấy, nó tự đi dò cả kho trước khi trả lời: 7 bài, kèm số lần nhắc trong từng bài. Anh dò lại bằng cách tìm chữ trong cả thư mục và ra đúng 7 bài (theo số đo của anh, video đăng ngày 21/10/2026), đúng cả số lần. Nó chỉ sai một chữ cái trong một tên file.
Cùng một câu hỏi mà ra hai kết quả. Anh thử tiếp, tổng cộng 6 lần thì có 5 lần nó ra đủ 7 kết quả; chỉ có lần đầu tiên nó ra một bài (theo số đo của anh, video đăng ngày 21/10/2026). Vì vậy, với kiểu câu "liệt kê hết cho tôi", anh khuyên không nên tin vào một lần hỏi: hãy hỏi lại hoặc tự kiểm. Bởi thi thoảng nó trả lời thiếu, mà giọng vẫn chắc nịch y như lúc trả lời đúng.
9. Bóc băng file gần 11 phút thành chữ bằng Whisper
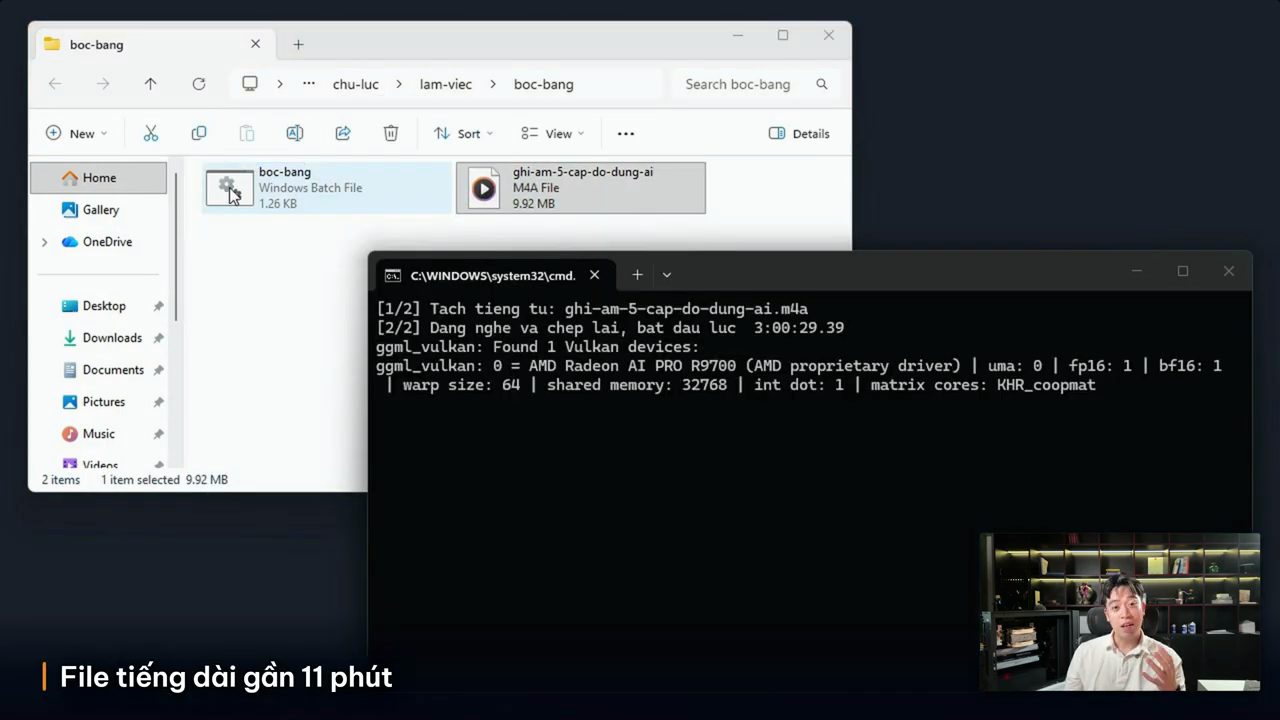
Việc thứ hai thì ai làm nội dung cũng cần: biến tiếng nói thành chữ viết. Anh lấy file tiếng của một video cũ, dài gần 11 phút, kéo thả vào công cụ. Trên màn hình, một dòng cho thấy nó đang chạy trên card Radeon, và chữ ra từng câu kèm luôn mốc thời gian.
Khoảng 50 giây là xong: file gần 11 phút tiếng nói thành chữ trong chưa tới một phút, theo số đo của anh (video đăng ngày 21/10/2026). Phần mềm anh thử là Whisper, theo video đăng ngày 21/10/2026 cũng miễn phí. Với nó, họp xong là có ngay biên bản, quay xong là có ngay phụ đề, mà không cần tải file đi đâu hết.
Vậy nó có sai không? Có. Theo lần thử của anh (video đăng ngày 21/10/2026), dễ sai nhất là tên riêng. Ví dụ anh nói "Claude Code" thì nó chép lại thành những cách viết khác nhau tùy chỗ; đến cả cái tên "AI 5 Phút" của anh nó cũng chép sai. Nên bản ghi nào anh cũng khuyên đọc lướt một lần trước khi dùng.
Một lưu ý nhỏ: nếu làm file dài, nên tắt một thiết lập mặc định, không thì có khi nó lặp đi lặp lại một câu tới hết file. Anh để cách làm trong phần mô tả video: thêm tham số -mc 0 vào lệnh whisper-cli. Whisper cần file WAV 16 kHz (theo mô tả video, 21/10/2026), nên phải đổi bằng ffmpeg trước. Hai lệnh anh ghi trong mô tả:
ffmpeg -i file.mp4 -vn -ac 1 -ar 16000 -c:a pcm_s16le file.wav
whisper-cli -m ggml-large-v3.bin -f file.wav -l vi -mc 0 -otxt -osrt
Cũng theo mô tả (video đăng ngày 21/10/2026), bản whisper-cli chạy trên card AMD anh lấy qua Lemonade Server: cài Lemonade rồi gõ lệnh dưới đây. Model ggml-large-v3.bin tải từ trang whisper.cpp trên Hugging Face.
lemonade backends install whispercpp:vulkan
10. Bốn người dùng cùng lúc trên một card
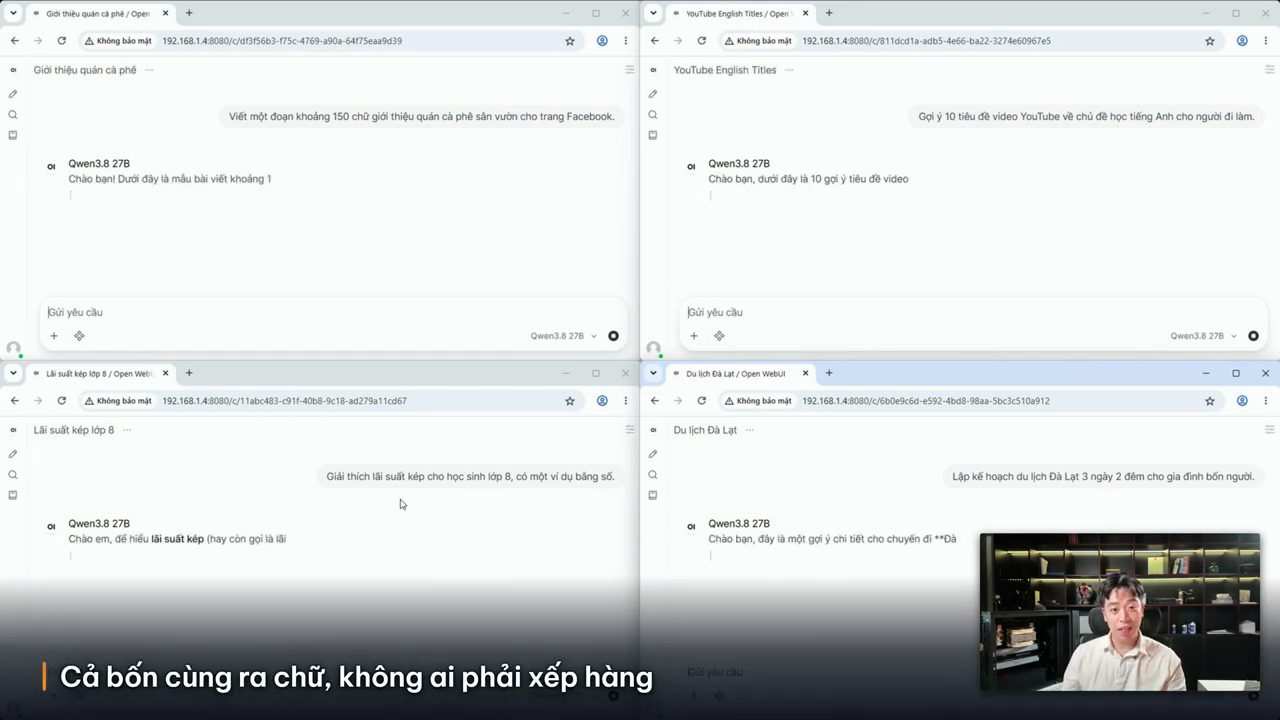
Từ đầu tới giờ mới chỉ có một người dùng. Nhưng một chiếc máy như thế này đâu phải để một người dùng. Anh mở luôn 4 cửa sổ, coi như 4 người, mỗi người một tài khoản, mỗi người hỏi một câu khác nhau. Anh cho máy bấm gửi cả 4 câu cùng một lúc, vì tay anh không thao tác kịp.
Chờ khoảng 5 giây, cả 4 cùng ra chữ, không ai phải xếp hàng (theo số đo của anh, video đăng ngày 21/10/2026). Chữ đương nhiên ra chậm hơn lúc dùng một mình, nhưng vẫn kịp đọc. Đó là một card gánh 4 người.
11. Máy có hai card: dùng để làm gì
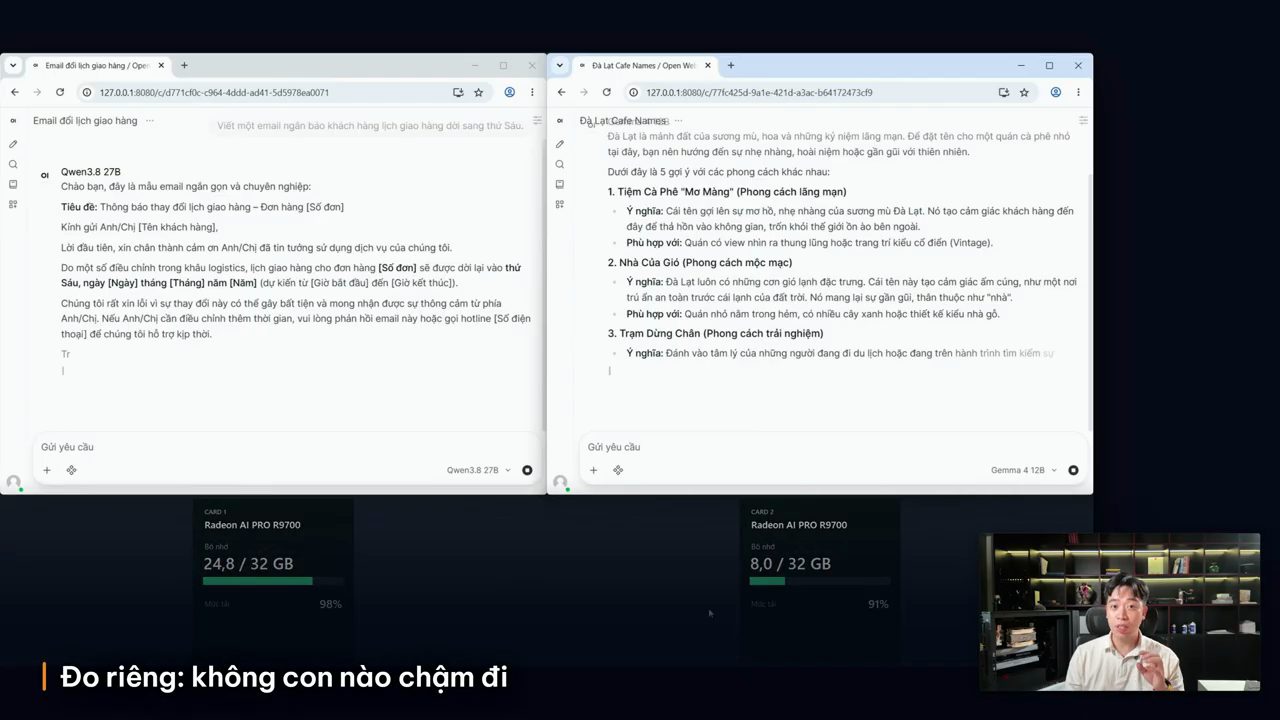
Tất cả những gì anh thử tới đây mới chỉ chạy trên một card, trong khi máy có tận hai card. Và anh nói trước điều nó không làm được: card thứ hai không làm con AI trả lời nhanh hơn. Anh đã thử: cùng một con AI nhỏ, khi chia ra hai card thậm chí còn chậm hơn một chút (theo lần thử của anh, video đăng ngày 21/10/2026).
Card thứ hai đáng tiền ở hai việc khác. Việc thứ nhất là mỗi card một con AI: bên này là con to nằm ở card 1, bên kia là con nhỏ nằm ở card 2. Khi anh gửi hai câu hỏi cùng lúc, cả hai cùng chạy chữ; hai ô phía dưới màn hình cho thấy hai card cùng làm việc, mỗi card lo một con. Anh có đo riêng: theo số đo của anh (video đăng ngày 21/10/2026), không con nào chậm đi so với lúc chạy một mình.
Việc thứ hai: còn nhớ con AI hơn 70GB ở đầu video? Anh dùng bản gọn hơn của chính nó, Laguna S 2.1, chỉ hơn 50GB nhưng vẫn to hơn một card 32GB (theo số anh nêu trong video đăng ngày 21/10/2026). Nếu chỉ có một card thì không chứa nổi. Anh bấm nạp, và ô bộ nhớ bên phải cho thấy card 1 đầy lên trước, rồi tới card 2: con AI này nằm trên cả hai card. Anh hỏi lại câu xin nghỉ phép khi nãy, và nó viết ra đủ một email tiếng Việt.
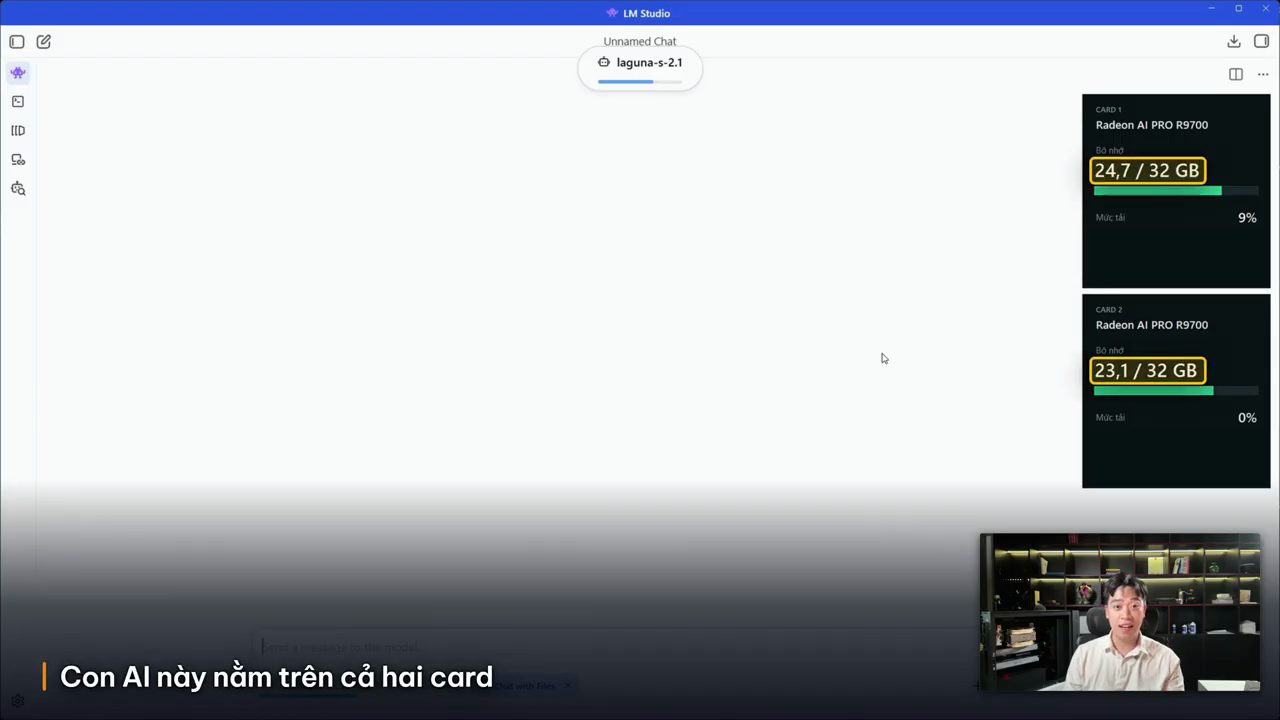
Đây chính là câu anh bảo người xem nhớ lúc đầu: file to thì cần nhiều bộ nhớ card. Một card không đủ thì hai card cộng lại. Và càng nhiều card thì càng nhiều người có thể dùng chung. Theo AMD (video đăng ngày 21/10/2026), một máy dòng này lắp nhiều card phục vụ được khoảng 100 người. Con số đó anh chưa tự thử: máy anh đang cầm có hai card, và anh mới thử 4 người dùng chung một card.
12. Nói thật về giới hạn
Anh chia sẻ thật vài điều để người xem khỏi kỳ vọng sai.
Thứ nhất, theo video đăng ngày 21/10/2026, AI chạy trên máy riêng chưa bằng những con AI mạnh nhất trên mạng. Với công việc hằng ngày thì nó đủ: đọc tài liệu, tóm tắt, viết nháp hay bóc lời ra text. Còn với những việc suy luận thật khó thì những con lớn trên mạng vẫn mạnh hơn.
Thứ hai, AI chạy bằng card đồ họa, và thứ quan trọng nhất của card đó là bộ nhớ (theo video đăng ngày 21/10/2026). Nên nếu dựng máy để chạy AI, anh khuyên dồn tiền vào card có nhiều bộ nhớ.
13. Open WebUI: cả nhà dùng chung bằng điện thoại
Giờ anh quay lại điều đã hứa ở đầu video. Anh cài thêm một phần mềm tên là Open WebUI, theo video đăng ngày 21/10/2026 cũng miễn phí. Nó biến chiếc máy thành một trang web chat chỉ chạy trong mạng nhà anh. Kho tài liệu và 4 cửa sổ khi nãy cũng chính là Open WebUI.
Trong phần mô tả video (đăng ngày 21/10/2026), anh ghi cách cài Open WebUI mà anh dùng, không cần Docker và cần Python 3.12: cài bằng pip, bật Model Server trong LM Studio, rồi mở PowerShell và chạy các lệnh sau. Sau đó mở trình duyệt vào http://localhost:8080 và tạo tài khoản quản trị ở lần đầu.
pip install open-webui
$env:OPENAI_API_BASE_URL="http://127.0.0.1:1234/v1"
$env:OPENAI_API_KEY="lm-studio"
$env:ENABLE_OLLAMA_API="False"
open-webui serve --host 0.0.0.0 --port 8080
Có một bước dễ quên (theo video đăng ngày 21/10/2026): tài khoản mới tạo sẽ không nhìn thấy con AI nào cả. Anh là quản trị, nên anh vào phần cài đặt, mục Mô hình, đổi con AI từ Riêng tư sang Công khai. Từ đó ai có tài khoản cũng dùng được.
Rồi anh cầm điện thoại, mở trình duyệt và gõ địa chỉ của chiếc máy (theo mô tả, nhớ có http:// ở đầu, và điện thoại phải cùng mạng Wi-Fi với máy). Trình duyệt sẽ ghi "Không bảo mật"; anh dặn đừng giật mình. Trang này chạy trong mạng nhà bạn, không đi qua internet, nên nó không có chứng chỉ như các trang web công khai. Chỉ cần nhớ đừng mở nó ra ngoài mạng nhà.
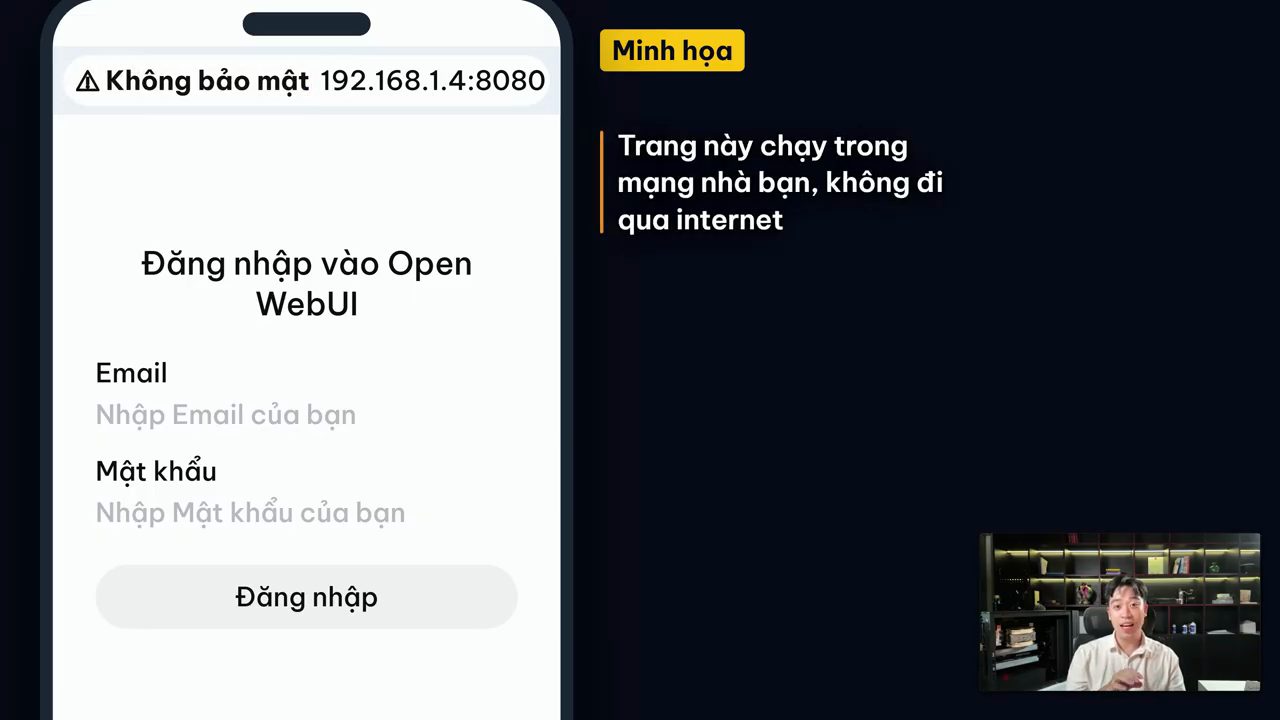
Anh đăng nhập, giao diện quen thuộc như các trang chat AI khác, và hỏi một câu. Câu trả lời không đến từ đám mây nào cả mà đến từ chính chiếc máy trong phòng anh. Người nhà anh dùng được, nhân viên trong văn phòng anh cũng dùng được, mỗi người một tài khoản, cùng dùng chung một con AI mà không ai phải trả tiền hàng tháng (theo video đăng ngày 21/10/2026).
14. Tóm lại: ứng dụng AI và hệ thống AI
Đó là khác biệt giữa một ứng dụng AI và một hệ thống AI. Ứng dụng thì chỉ có một người dùng trên một máy. Còn hệ thống thì cả nhóm dùng chung, và quan trọng là dữ liệu không đi đâu cả.
Tóm lại video: mỗi con AI là một cái file, tải về là của bạn. Chạy trên máy bạn thì dữ liệu ở lại với bạn. Máy càng nhiều bộ nhớ card thì chạy được những con càng khôn và phục vụ được càng nhiều người.
Với người chỉ chat thông thường, máy đang có cộng với một con AI nhỏ là đủ để bắt đầu. Còn nếu bạn làm những nghề cần giữ kín tài liệu, hoặc là một doanh nghiệp vừa và nhỏ muốn bắt đầu với AI chạy tại chỗ, AI local, thì một trạm AI riêng như thế này đáng để tính đến. Về tiền (theo video đăng ngày 21/10/2026), bạn chỉ bỏ ra một lần lúc mua máy; sau đó chỉ còn tiền điện, không gói tháng, không tính tiền theo từng câu hỏi. Cả nhóm dùng càng nhiều thì càng nhanh về vốn so với thuê AI trên mạng.
Cấu hình chiếc máy trong video anh để ở phần mô tả để người xem tham khảo. Anh hỏi người xem đã chạy AI local chưa, đang chạy trên máy riêng bằng công cụ gì, và mời comment cho anh biết. Anh nhắc theo dõi kênh AI 5 Phút, nơi anh giải thích mọi thứ đang xảy ra trong thế giới AI bằng ngôn ngữ đơn giản nhất, rồi hẹn gặp lại ở video tiếp theo.
Nguồn và liên kết 9 nguồn
- Tên gốc: AI local cho cả nhà, văn phòng, không cần mạng: dựng trạm AI riêng chạy ngay trên máy mình
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=nT18oTSaRR8 youtube.com
- Kênh YouTube Thanh Trần - 5 Phút AI (Thanh Trần): youtube.com/channel/UCTumIe5W_2OoKUEDAq3xsKQ youtube.com
- LM Studio, trang tải chính thức: lmstudio.ai/download lmstudio.ai
- Open WebUI, repo chính thức trên GitHub: github.com/open-webui/open-webui github.com
- whisper.cpp, bản C/C++ của Whisper: github.com/ggml-org/whisper.cpp github.com
- Model Whisper dạng ggml (gồm ggml-large-v3.bin) trên Hugging Face: huggingface.co/ggerganov/whisper.cpp huggingface.co
- Lemonade Server, nơi anh lấy bản whisper-cli chạy trên card AMD: lemonade-server.ai lemonade-server.ai
Related talks
Jev giúp Claude Code nhanh và rẻ hơn thế nào
Jay Enriquez · Jay E | RoboNuggets · 12 min
Jev, System 1 model chỉ trả lời đúng/sai, chọn mục hoặc chấm điểm, ghép với Claude để chọn model, chọn skill, phân loại hàng loạt và tìm ảnh theo nghĩa.
Ôn thi offline: cho AI đọc trọn giáo trình
Thanh Trần · Thanh Trần - 5 Phút AI · 26 min
Chỉnh context length trong LM Studio để AI đọc trọn chương giáo trình, dựng thư viện theo môn bằng AnythingLLM, ra đề cương và trắc nghiệm offline.
Microsoft đưa agent OpenClaw vào công ty bạn: năm thói quen để dùng tốt
Nate B Jones · AI News & Strategy Daily | Nate B Jones · 26 min
Theo video đăng ngày 02/10/2026, Copilot Autopilot đưa agent nền OpenClaw vào Outlook, Teams, Excel; Nate nêu năm thói quen để lấy việc thật từ AI công ty cho phép.