Tin AI tuần: Images 2.6, Gemini Omni 1.2 Flash và nhiều cập nhật khác
Matt Wolfe điểm tin AI tuần: thử Images 2.6, Gemini Omni 1.2 Flash, P-H3-Image, Pika H3 Flex, cuộc gọi của Grok Bot và Meta Muse, cùng các tin rapid fire.
✓ Đã duyệt độc lập · cập nhật 06/11/2026 · 25 min
1. Images 2.6 của OpenAI và ảnh GIF động trong ChatGPT
Matt Wolfe mở đầu bản tổng hợp tin AI trong tuần bằng model tạo ảnh mới của OpenAI. Theo video đăng ngày 06/11/2026, tuần này OpenAI giới thiệu Images 2.6, có trong cả ChatGPT lẫn API, và theo lời anh thì model này nhanh hơn và cho ra hình ảnh chuyên nghiệp hơn. Anh nói trong đoạn demo nhỏ của OpenAI có thể thấy nó chạy nhanh gần gấp đôi. Trang giới thiệu anh mở trên màn hình (bài đề ngày 04/11/2026) ghi Images 2.6 có trong ChatGPT, Codex và API, và ở một đoạn khác ghi Images 2.6 tạo ảnh nhanh hơn 50% so với trước; trong API có hai bản GPT-Image-2.6 Flare và Sunburst để developer chọn (tính đến 11/2026).
Theo Matt (video đăng ngày 06/11/2026), "màn ảo thuật" lớn của model mới là nó tạo được ảnh GIF động cho bạn (anh đọc chữ GIF theo hai cách, và nói đọc kiểu nào tuỳ bạn). Anh vào ChatGPT và gõ một prompt:
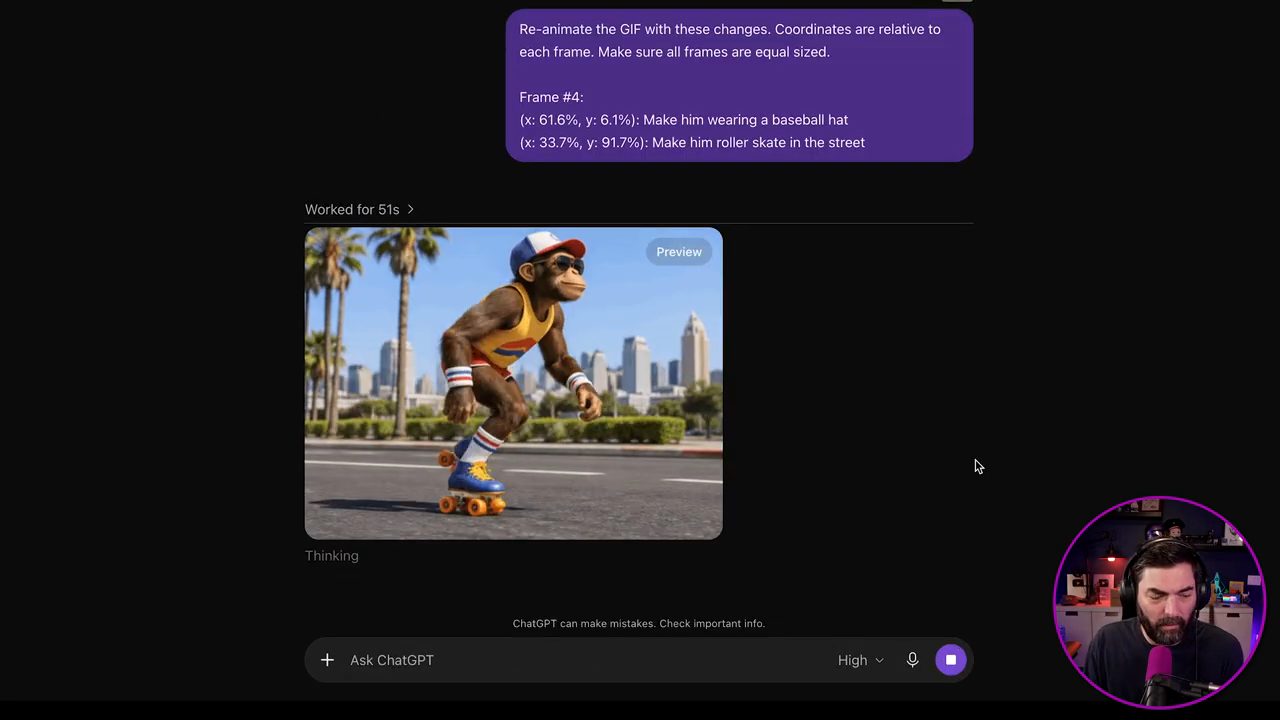
Make an animated gif of a monkey roller skating
Khoảng 20 giây sau, theo lời anh (demo trong video đăng ngày 06/11/2026), đã có con khỉ trượt patin. Bấm vào ảnh thì có tuỳ chọn chỉnh sửa. Anh để ý nền ảnh trông như San Diego, và đoán có lẽ ChatGPT dựa vào memory, vì nó biết anh sống ở San Diego.
Tiếp theo anh thử sửa: cho con khỉ đội mũ bóng chày, và cho nó trượt dưới lòng đường. Anh đặt hai prompt chỉnh sửa lên hai chỗ trên ảnh rồi gửi cả hai cùng lúc. Theo lời anh, khoảng 30 giây sau con khỉ đã đội mũ bóng chày và trượt dưới lòng đường thay vì trên vỉa hè; khung chat trên màn hình lúc đó ghi "Worked for 51s". Anh kết luận việc chỉnh sửa có vẻ chạy tốt, kể cả với ảnh GIF động, và cảm giác nhanh hơn một chút (demo trong video đăng ngày 06/11/2026). Anh nói mình bất ngờ, vì làm GIF có nghĩa là model có lẽ phải tạo ra, anh không chắc, chừng tám ảnh khác nhau rồi ghép chúng lại, vậy mà nó làm hết trong khoảng 30 giây hoặc ít hơn.
Để xem tạo một ảnh thường mất bao lâu, anh gõ prompt sau, bấm gửi và bấm đồng hồ bấm giờ cùng lúc:
Create an image of the San Diego skyline at sunset with sailboats on the water
Theo số đo của Matt (video đăng ngày 06/11/2026), ảnh đường chân trời San Diego lúc hoàng hôn với thuyền buồm trên mặt nước ra sau 20 giây, chính xác là 20,4 giây. Anh thấy ảnh khá ổn và thời gian "không tệ", rõ ràng nhanh hơn so với model ảnh trước đây.
Anh nói (video đăng ngày 06/11/2026) tuần này có rất nhiều cập nhật, nhưng theo anh chúng đều là cập nhật nhỏ, nên anh không cần đi quá sâu vào cái nào. Vì vậy cả tập sẽ gần như là một tập rapid fire, dù sau đó anh vẫn có thêm một phần rapid fire riêng.
2. P-H3-Image của Pruna AI: một model ảnh open weight
Model ảnh thứ hai mà Matt thấy đáng nhắc nhanh là P-H3-Image của công ty Pruna AI (theo video đăng ngày 06/11/2026). Theo lời anh, Pruna lấy model H3, một model video state-of-the-art, rồi biến nó thành một model ảnh gọn nhẹ, và không chỉ là một model ảnh bình thường, mà là một model ảnh mở thật sự. Bài đăng của Pruna AI trên màn hình ghi họ open-source P-H3-Image, một model tạo và chỉnh sửa ảnh xây từ H3, tạo hoặc sửa ảnh nhanh hơn 5 lần với 8 bước thay vì 50, và nhỏ hơn H3 7 lần (bài đăng hiển thị trong video đăng ngày 06/11/2026).
Theo Matt (video đăng ngày 06/11/2026), vì là open weight nên về lý thuyết bạn có thể tải về và chạy trên máy của mình nếu đủ RAM, hoặc chạy trên một dịch vụ cloud nào đó; bạn có thể fine-tune, sửa đổi, làm gì tuỳ ý với nó.
Anh lướt qua các ảnh ví dụ: bên trái là Qwen-Image 2.1, bên phải là P-H3-Image; có một ảnh chân thực về một ông lão đánh cá, một ảnh phong cách anime, rồi thêm nhiều ảnh ví dụ khác nữa. Theo lời anh (video đăng ngày 06/11/2026), weights cần tải về nặng khoảng 55 GB, nhưng có các bản quantized nhỏ hơn mà bạn cũng có thể chạy (tính đến 11/2026). Anh nói có vài biến thể: bản 16-bit, bản 8-bit, và bản anh đọc là "8-bit VAE"; biểu đồ "Weights on disk" trên màn hình ghi ba bản P-H3-Image là bf16 (55 GB), int8 (30 GB) và w4a8 · int8 VAE (20 GB), so với 143 GB của H3.
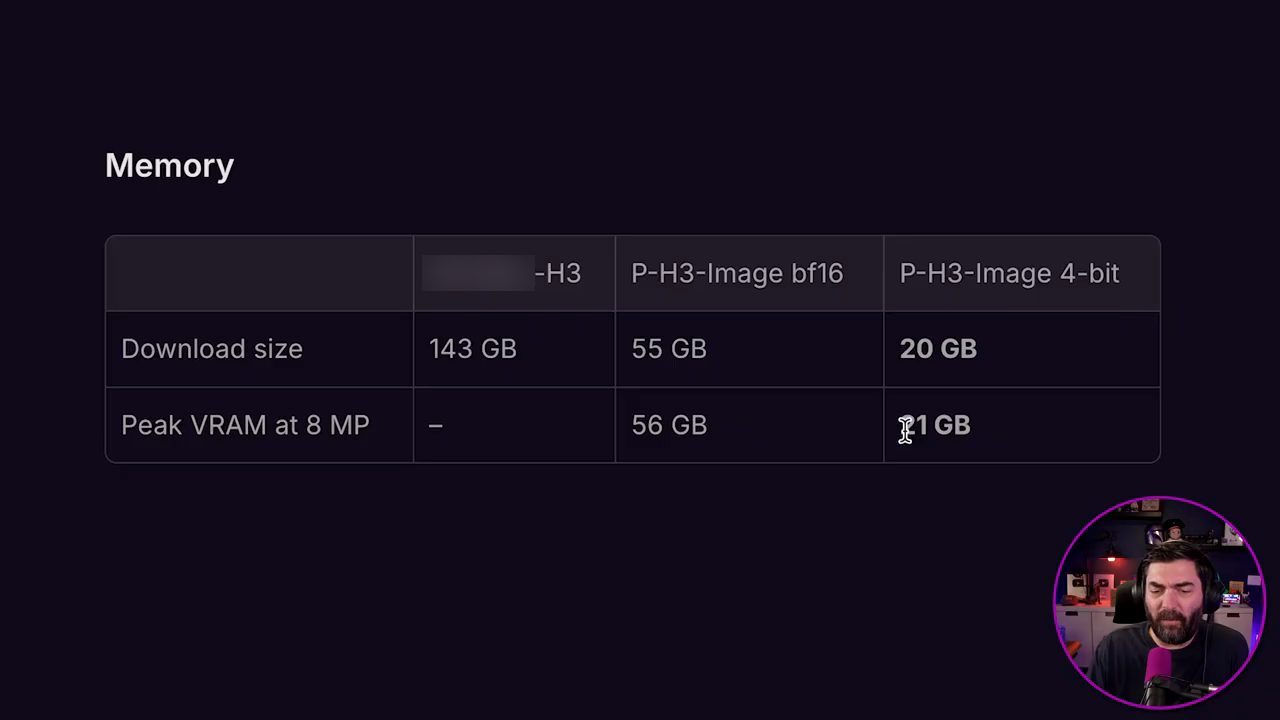
Về yêu cầu bộ nhớ, Matt đọc từ bảng (video đăng ngày 06/11/2026): để tạo một ảnh 8 megapixel cần khoảng 56 GB VRAM với bản 16-bit và 21 GB với bản 4-bit. Theo anh, nghĩa là bản 4-bit quantized này bạn hẳn là chạy được trên GPU loại phổ thông, chẳng hạn một card 5090 hay 4090. Còn bản đầy đủ thì cần phần cứng mạnh hơn: theo anh có vẻ phải là một máy Mac Ultra M3 hoặc M5 có 128 GB unified memory trở lên, hoặc một máy như DGX Spark; nói chung cần một cấu hình khá tốt để chạy bản đầy đủ.
Anh cho biết trang của Pruna có hướng dẫn cách chạy model trên máy của bạn, và model cũng có trên Hugging Face, nơi bạn tải weights về. Theo lời anh, nếu tải toàn bộ về máy thì tổng cộng gần 100 GB (tính đến 11/2026). Pruna còn có một Hugging Face Space; anh giải thích Space nghĩa là họ đã dựng model trên GPU của Hugging Face để mọi người dùng thử ngay trên Hugging Face, nên theo video đăng ngày 06/11/2026 bạn có thể dùng thử miễn phí trên web, dù có thể chậm hơn tuỳ số người đang dùng cùng lúc.
Anh nhập prompt "The San Diego skyline at sunset with sailboats on the water" và ảnh được tạo ngay trong Hugging Face. Nhận xét của anh (demo trong video đăng ngày 06/11/2026): chất lượng ảnh còn xa mới bằng ChatGPT, ảnh trông chẳng giống đường chân trời San Diego chút nào. Nhưng nó là open weight, bạn có thể fine-tune, và nếu máy đủ mạnh thì có thể chạy local nếu muốn.
3. Gemini Omni 1.2 Flash: clip dài hơn, giá thấp hơn
Tin tiếp theo đến từ Google: một model video mới, Gemini Omni 1.2 Flash (bài blog của Google đề ngày 05/11/2026 hiển thị trong video). Theo Matt (video đăng ngày 06/11/2026), thay đổi lớn nhất của Omni 1.2 là tạo được clip dài tới 15 giây; anh nghĩ model trước chỉ tạo tối đa 10 giây, nên mỗi clip có thêm năm giây.
Giá cũng thấp hơn: theo bài viết trên màn hình và lời anh (tính đến 11/2026), Google giảm giá 30% so với Omni 1.1, và giờ khoảng 0,07 đô mỗi giây video 720p.
Anh đi qua các điểm mà Google nêu cho model mới (theo bài của Google, hiển thị trong video đăng ngày 06/11/2026):
- Bám reference tốt hơn: ví dụ có ảnh tham chiếu một người phụ nữ và ba bộ trang phục, bên phải là kết quả cho thấy model giữ được cả hình dáng người phụ nữ lẫn các bộ đồ cô thử (theo bài của Google, video đăng ngày 06/11/2026).
- Kết quả nhất quán hơn: với cùng một ảnh tham chiếu, bên phải đặt Omni 1.1 Flash cạnh 1.2 Flash, và theo Matt bản 1.2 Flash trông gần với ảnh tham chiếu hơn rõ rệt (video đăng ngày 06/11/2026).
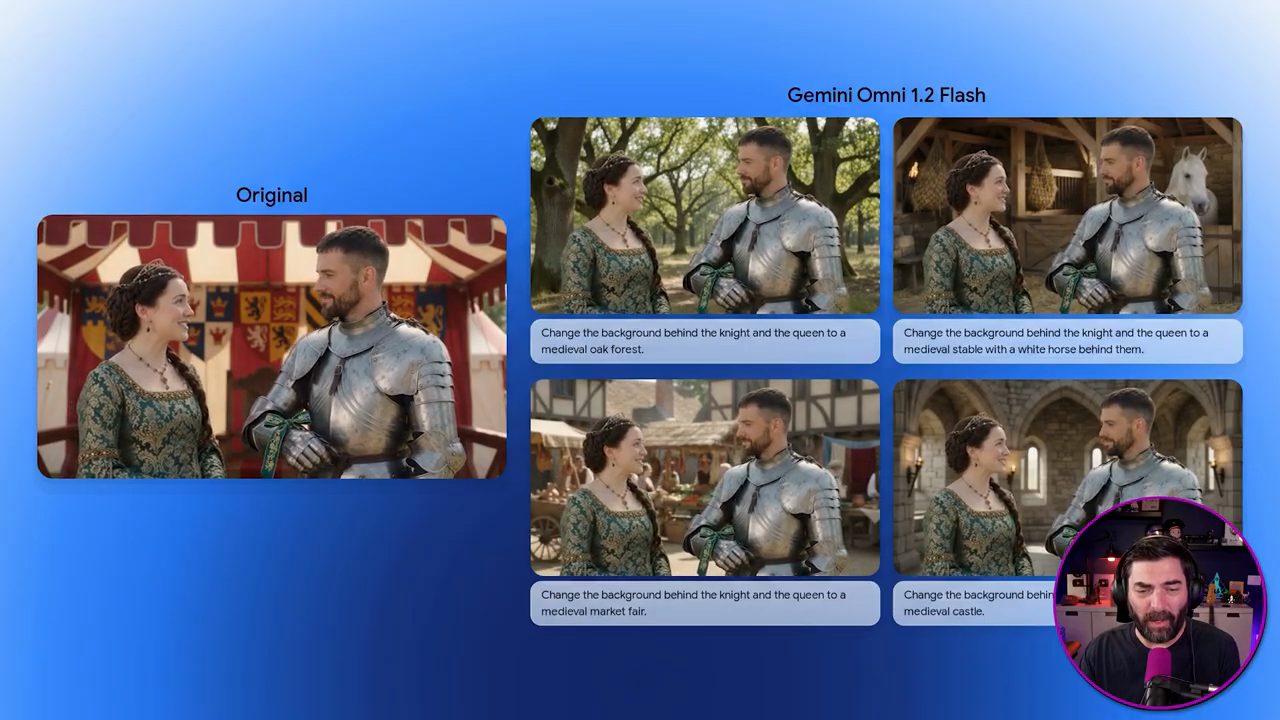
- Chỉnh sửa được cho là tốt hơn nhiều: từ một video gốc, bên phải có bốn biến thể với bốn nền khác nhau, còn những người ở tiền cảnh trông y hệt như trong video gốc, chỉ có nền thay đổi (theo bài của Google, video đăng ngày 06/11/2026).
Theo bài của Google (video đăng ngày 06/11/2026), giọng nói trong video cũng tự nhiên hơn, và Matt mở một clip ví dụ để nghe. Prompt của ví dụ đó trên màn hình:
Create a 15-second 3D animated scene inside the conservatory from Image 1 using these four character, mouth, and voice references. Cosmo complains that the orchid is copying his color palette, Pip replies that it just wants to match his tail, Arthur notes it bloomed last Tuesday, and Mateo tells them not to beef with the plants.
Trong clip, các nhân vật hoạt hình lần lượt nói: một nhân vật nói cây lan đang chép bảng màu của mình và đòi tiền bản quyền, nhân vật khác bảo chắc nó chỉ muốn hợp màu với cái đuôi của Cosmo, một nhân vật nói về mặt kỹ thuật thì cây lan nở ở đây từ thứ Ba tuần trước, và nhân vật cuối bảo đừng gây sự với cây cối. Matt nhận xét "không tệ" (video đăng ngày 06/11/2026).
Các điểm còn lại theo bài của Google (video đăng ngày 06/11/2026): giao diện cinematic dễ điều khiển hơn, và tất nhiên là clip dài hơn, giờ tới 15 giây. Theo Matt, model có trong Gemini API, và trong Flow lẫn Google Vids (tính đến 11/2026).
4. Thử Omni 1.2 trong Google Vids
Theo Matt (video đăng ngày 06/11/2026), điểm hay là Google cho bất kỳ ai dùng model này, kể cả ở gói miễn phí: bạn tạo được tối đa ba video mỗi tháng. Bài của Google trên màn hình (đề ngày 05/11/2026) ghi: bắt đầu từ hôm nay, ai có tài khoản Google hoặc gói Google Workspace đều có thể tạo tối đa ba video 15 giây mỗi tháng trong Vids mà không mất phí. Anh hiểu là phải dùng nền tảng Vids thì mới tạo được ba video đó, và nếu vào vids.new thì dùng model miễn phí được tối đa ba lần mỗi tháng (tính đến 11/2026).
Anh làm thử (demo trong video đăng ngày 06/11/2026). Ở góc dưới bên phải có mục "create from scratch". Anh thêm một avatar, chọn một avatar là ảnh khuôn mặt của chính anh, và nhận xét trong ảnh đó trông như anh không biết mình đang bị chụp, trông như đang bực bội gì đó, nhưng kệ, cứ dùng. Rồi anh thêm một "ingredient", là ảnh một chiếc áo xanh dương. Trong ô prompt, anh viết rằng "@Me" đang mặc chiếc áo đó (anh chèn ảnh áo vào chỗ này), đang nói một câu do anh đặt sẵn, trong khi phía sau có một con gấu tung hứng cưa máy. Anh chỉnh độ dài lên 15 giây, mức tối đa.
Theo lời anh (demo trong video đăng ngày 06/11/2026), video ra khá nhanh, anh ước chừng khoảng một phút, có lẽ dưới một phút một chút. Anh thấy kết quả "không tệ", khá ấn tượng: dài 15 giây, tạo nhanh, và miễn phí vì đây là một trong ba lượt mỗi tháng của anh.
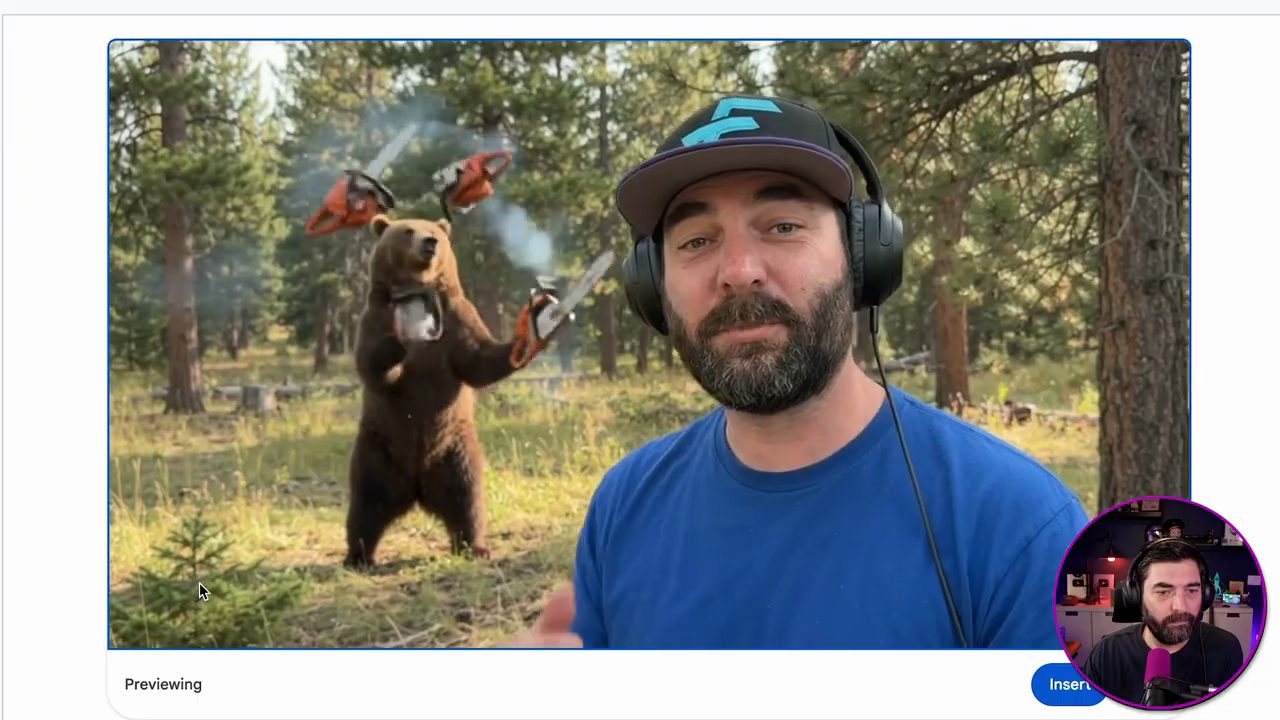
Anh tính thêm (theo giá nêu trong video đăng ngày 06/11/2026): ở mức 7 cent mỗi giây, nếu không phải là lượt miễn phí thì clip 15 giây này sẽ tốn của anh khoảng 1,05 đô.
5. Pika H3 Flex: model video open weight
Đã nói tới model video thì Matt nhắc luôn một model nữa. Theo video đăng ngày 06/11/2026, cuối tuần trước Pika Labs công bố Pika H3 Flex, một model video open weight. Theo lời anh, nó tạo video tới 4K, tạo nhanh hơn thời gian thực, và có thể tạo clip 15 giây kèm soundtrack trong chỉ 7 giây; anh gọi đó là "điên rồ". Bài đăng của Pika trên màn hình (đề ngày 29/10/2026) ghi model ra mắt ở vị trí số 1 trong các model open weight trên bảng text-to-video của DesignArena.
Anh mở bảng xếp hạng video của DesignArena và nói, theo anh thấy, nó gần như vượt mọi thứ, vượt tất cả các model open weight khác (theo video đăng ngày 06/11/2026).
Pika cũng đưa model lên Hugging Face, nơi bạn tải weights về. Theo lời anh (tính đến 11/2026), weights nặng 220 GB, khá lớn, và anh tin là nếu muốn chạy local thì bạn cần một hệ thống khá mạnh. Anh đọc trang model và nói kết quả họ công bố cho việc tạo video trong năm giây được chạy trên một card H100 có 80 GB VRAM, không phải loại GPU phổ thông. Nên theo anh, đây lại là một model mà bạn có lẽ sẽ phải chạy trên cloud, trừ khi bạn có một máy M3 hoặc M5 Ultra với lượng unified memory khổng lồ hoặc dùng một máy như DGX Spark; bạn cần VRAM đủ mạnh để chạy nó (video đăng ngày 06/11/2026). Nhưng nhắc lại, nó là open weight, fine-tune được, và về lý thuyết có thể chạy local.
Giống model open weight trước, Pika cũng có một Hugging Face Space để tạo video trực tiếp trên GPU của Hugging Face và dùng thử miễn phí (tính đến 11/2026). Anh chạy prompt mặc định có sẵn trong Space. Theo lời anh (demo trong video đăng ngày 06/11/2026), mất khoảng 30 giây, và kết quả trông khá tốt; prompt hơi nhàm, nhưng video đẹp.
Rồi "vì kỷ niệm ngày xưa", anh thử prompt "Will Smith eating spaghetti" và chỉnh lên 15 giây. Anh hỏi liệu nó có chặn không, và nó chặn thật. Nhưng anh nhận ra không phải bị chặn vì Will Smith, mà vì thời lượng GPU: hộp báo lỗi trên màn hình ghi "The requested GPU duration (306s) is larger than the maximum allowed" (demo trong video đăng ngày 06/11/2026). Anh hạ xuống tám giây và thử lại.
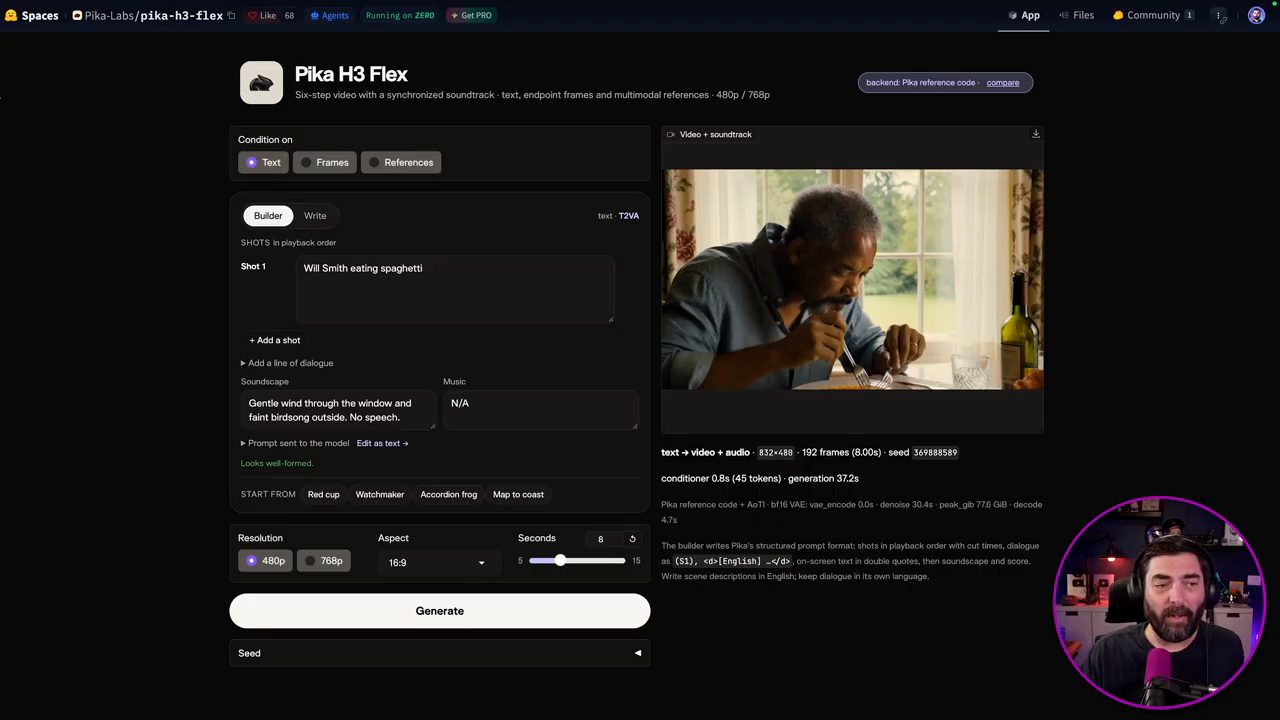
Anh gọi kết quả là "Will Smith phiên bản ông nội". Theo lời anh lần này cũng mất khoảng 30 giây (dòng thông tin trên màn hình ghi "generation 37.2s"), nên có vẻ tăng từ 5 lên 8 giây không làm thời gian tạo tăng thêm bao nhiêu (demo trong video đăng ngày 06/11/2026). Theo Matt, bạn có thể dùng model này miễn phí ngay trên Hugging Face Space; nó có thể sẽ chậm hơn nếu nhiều người dùng cùng lúc, và nếu máy đủ mạnh bạn có thể tải về chạy local (tính đến 11/2026).
6. Meta Muse có voice chat và video call
Tiếp theo là Meta và model Muse của họ. Theo Matt (video đăng ngày 06/11/2026), giờ bạn có thể voice chat trực tiếp với Meta Muse; không chỉ voice chat, bạn còn có thể video call với nó. Anh nói mình đang cố hết sức để không đọc dính thành "Metamuse".
Trong tài khoản Muse của mình, anh tạo một side chat mới, bấm lên góc trên bên phải và thấy giờ đã có nút gọi, rồi gọi cho trợ lý tên "Gary" (demo trong video đăng ngày 06/11/2026). Trợ lý chào: "Hey Matt, happy Thursday afternoon, what's new?". Anh đáp không có gì, và bảo giọng này nghe không giống người tên Gary. Trợ lý xin một giây để kiểm tra giọng đang dùng, rồi nói đã chuyển sang một giọng nam trung niên, cao độ vừa, ấm và mượt, nghe sẽ giống một "Gary" hơn, và hỏi giọng mới thế nào. Anh bảo nghe tuyệt.
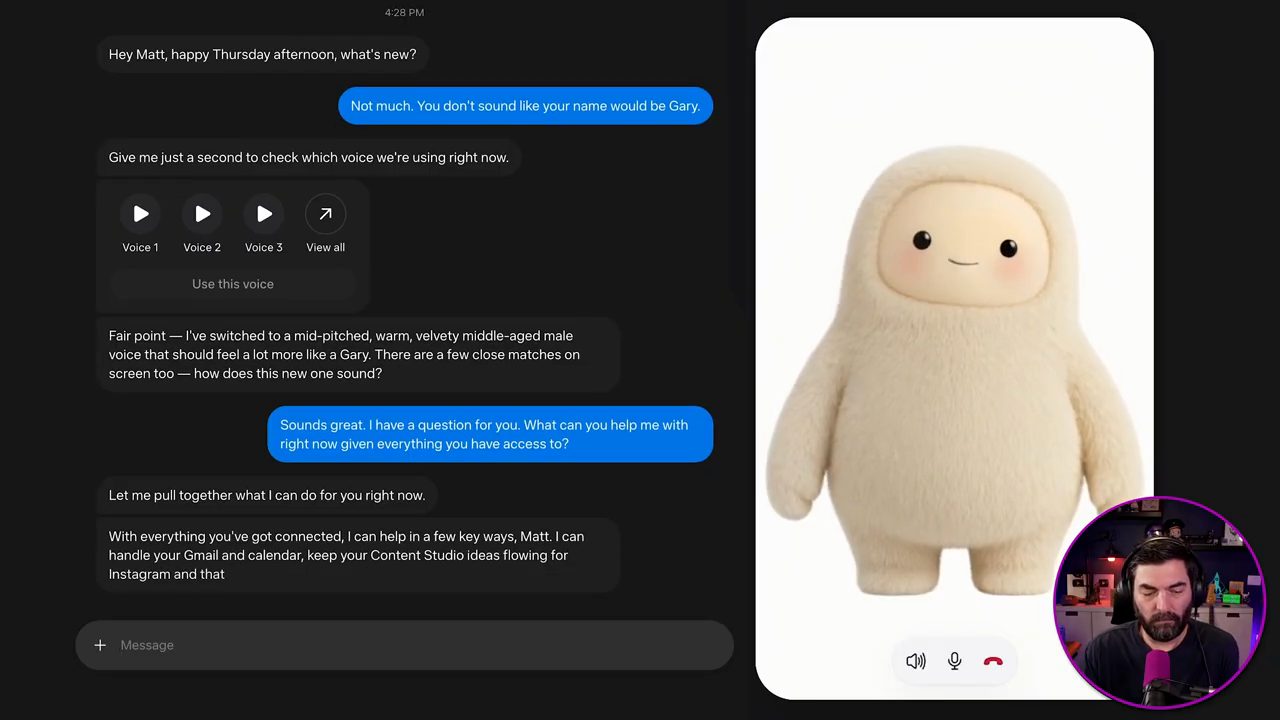
Anh hỏi trợ lý có thể giúp gì ngay lúc này với mọi thứ nó đang được truy cập. Theo câu trả lời trong demo (video đăng ngày 06/11/2026), với những gì anh đã kết nối, nó có thể xử lý Gmail và lịch của anh, giữ cho các ý tưởng trong Content Studio cho Instagram tiếp tục ra đều và hỗ trợ mục tiêu lên 100K, cộng với nghiên cứu, viết nháp và lên lịch; nó hỏi anh muốn kiểm hộp thư hôm nay, xem lịch, hay lấy các ý tưởng Instagram mới nhất trước. Trên màn hình, anh hỏi tiếp các ý tưởng Instagram là gì, rồi nhắn thêm "And just to note, I am speeding it up", và trợ lý đáp nó sẽ theo kịp nhịp của anh. Nó trả lời rằng từ lần làm mới hôm nay có: một bài trải nghiệm thực tế trong ngày với model video mới của Gemini, cuộc tranh luận về hoạt hình AI của Swoozie, một con số về game AI trên Steam xoay quanh Valve và Epic, một bài kiểm tra an toàn nhanh cho người dùng Claude Code, cộng với vài carousel nội dung lâu dài, rồi hỏi anh có muốn lấy toàn văn kịch bản cho bài Gemini trước không.
Matt nói vậy là đủ hình dung: theo anh (video đăng ngày 06/11/2026), giờ ta có thể nói chuyện với Muse thay vì phải gõ, và nó làm được mọi thứ Muse vốn đã làm được. Có thêm một avatar nhỏ để nhìn trong lúc nói chuyện, nhưng anh không thật sự hiểu avatar để làm gì, chỉ biết là nó ở đó. Dùng giọng nói thì cảm giác giống nói chuyện với một trợ lý hơn nhiều so với gõ phím. Anh hình dung mình có thể nói kiểu "đi kiểm tra email và lịch của tôi rồi bảo tôi nên làm gì tiếp", nhưng anh sẽ không làm thế trong video vì có lẽ nó sẽ đọc ra thông tin nhạy cảm.
7. Grok Bot gọi điện thoại thay người dùng
Với người dùng Grok Bot, theo Matt (video đăng ngày 06/11/2026), Grok Bot vừa ra một tính năng mới: nó có thể gọi điện thoại thay bạn. Theo ý kiến của anh, Grok Bot bị đánh giá thấp hơn thực tế rất nhiều. Anh nói nhiều người không chịu dùng những thứ như Grok Bot vì họ không thích Elon, nhưng theo anh nó thật sự là một agent rất, rất tốt, và anh là fan của nó (video đăng ngày 06/11/2026).
Anh chưa thử tính năng gọi điện, nên để cho vui anh muốn nghe xem nó nghe ra sao khi gọi cho chính anh: anh sẽ bảo nó gọi tới số điện thoại của anh và giả như anh là một cửa hàng. Anh mở Grok Bot và hỏi có thật là giờ nó gọi điện được cho anh không; nó trả lời là được (demo trong video đăng ngày 06/11/2026).
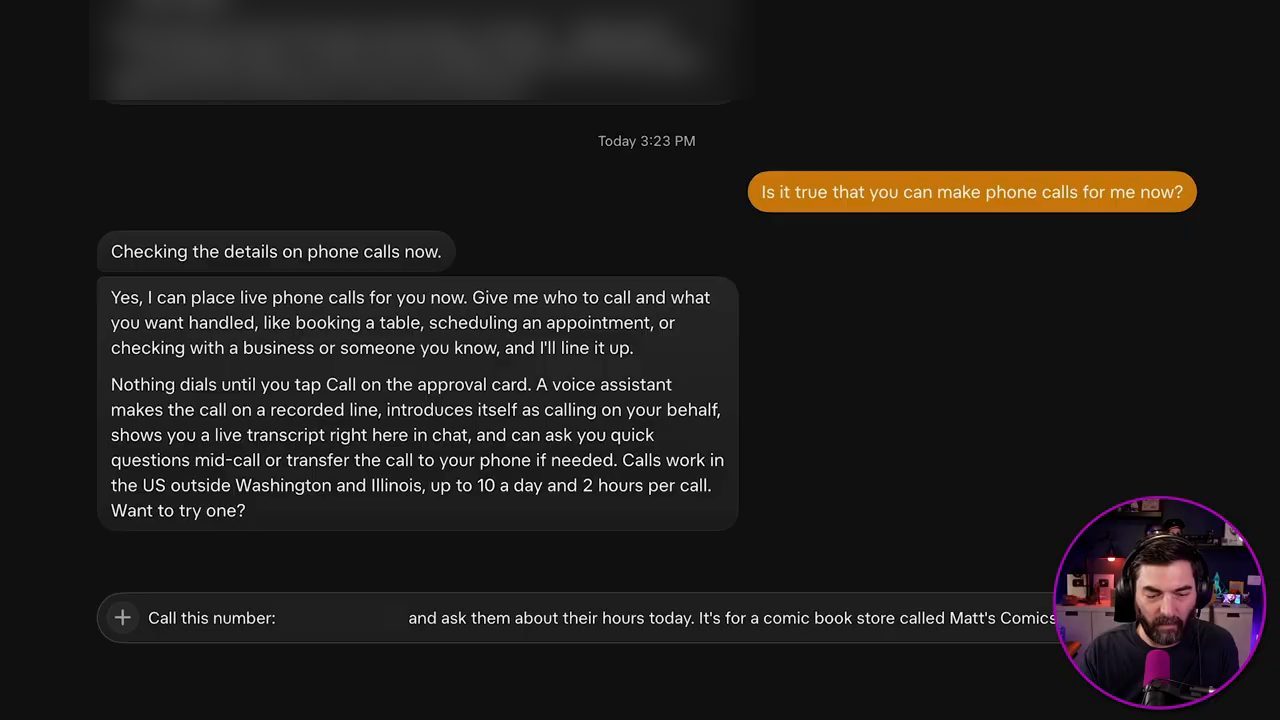
Anh gõ yêu cầu gọi tới một số điện thoại (số được anh làm mờ trong video), hỏi giờ mở cửa hôm nay, và nói đó là một cửa hàng truyện tranh tên Matt's Comics. Theo lời anh (demo trong video đăng ngày 06/11/2026), Grok Bot đã đi tra và báo rằng đó không phải số điện thoại của một doanh nghiệp thật; nó nói nếu đây thật ra là điện thoại của chính anh hoặc của người anh quen và anh đang thử xem cuộc gọi hoạt động ra sao, thì cho nó biết số đó của ai. Anh trả lời: đúng, đó là điện thoại của anh, anh đang thử để nghe cuộc gọi nghe như thế nào. Grok Bot yêu cầu anh xác nhận cuộc gọi, anh bấm gọi, và điện thoại của anh đổ chuông.
Cuộc gọi diễn ra thế này (demo trong video đăng ngày 06/11/2026): Matt nói "Hello?", giọng AI đáp "Hi, I'm here". Anh bảo giọng nó rất nhỏ, xin một giây để bật loa ngoài, rồi hỏi lại nó vừa nói gì. Giọng AI nói không sao, nó vừa nói nó là Leora, virtual assistant của Matt, đang gọi thử, và hỏi giờ anh nghe rõ hơn chưa. Anh bảo giờ nghe rõ rồi và hỏi hôm nay nó thế nào. Nó đáp nó khoẻ, cảm ơn vì đã hỏi, và hỏi lại anh. Anh nói anh khoẻ. Nó nói rất vui, rồi hỏi anh có muốn thử hỏi về giờ mở cửa hôm nay hay chuyện gì khác không.
Anh nói anh chỉ muốn biết nó nghe ra sao khi gọi tới một cửa hàng, và nhờ nó giả như anh là cửa hàng còn nó đang gọi hỏi giờ mở cửa. Nó đồng ý, tự giới thiệu là một virtual assistant gọi trên một đường dây có ghi âm để hỏi giờ mở cửa, rồi hỏi cửa hàng hôm nay mấy giờ mở. Anh đáp "ờ, bọn tôi đang mở cửa đây". Nó nói "Perfect", vậy là đủ rồi, và hỏi anh có muốn thử gì nữa không. Anh bảo vậy là xong, cảm ơn (demo trong video đăng ngày 06/11/2026).
Nhận xét của Matt (video đăng ngày 06/11/2026): nghe không tệ lắm, và khá hay khi agent có thể gọi điện thay mình. Nhưng anh có cảm giác, kiểu 50/50, là ngay khi người nghe máy nhận ra đó là robot thì họ sẽ cúp máy. Anh kể chính anh mỗi khi nghe máy mà nhận ra đó là cuộc gọi tự động thì cúp ngay, không phí thời gian, và anh đoán các cửa hàng có lẽ cũng sẽ làm vậy rất nhiều cho tới khi chuyện này phổ biến hơn. Anh nói để xem, vì nó nghe không tệ.
8. Rapid fire: GPT-6 Cyber và usage của ChatGPT, Codex
Matt nói (video đăng ngày 06/11/2026) anh đã chạy qua mọi thứ khá nhanh, kiểu một tập rapid fire, nhưng vẫn còn vài tin anh muốn kể mà không cần dành nhiều thời gian, và đây mới là phần rapid fire thật.
Theo video đăng ngày 06/11/2026, tuần này OpenAI ra thêm một model nữa là GPT-6 Cyber, nhưng như bạn có thể đoán, không ai được dùng ngoại trừ các chuyên gia an ninh mạng. Và tất nhiên, theo lời anh, nó vượt mọi benchmark về các mảng kiểu an ninh mạng.
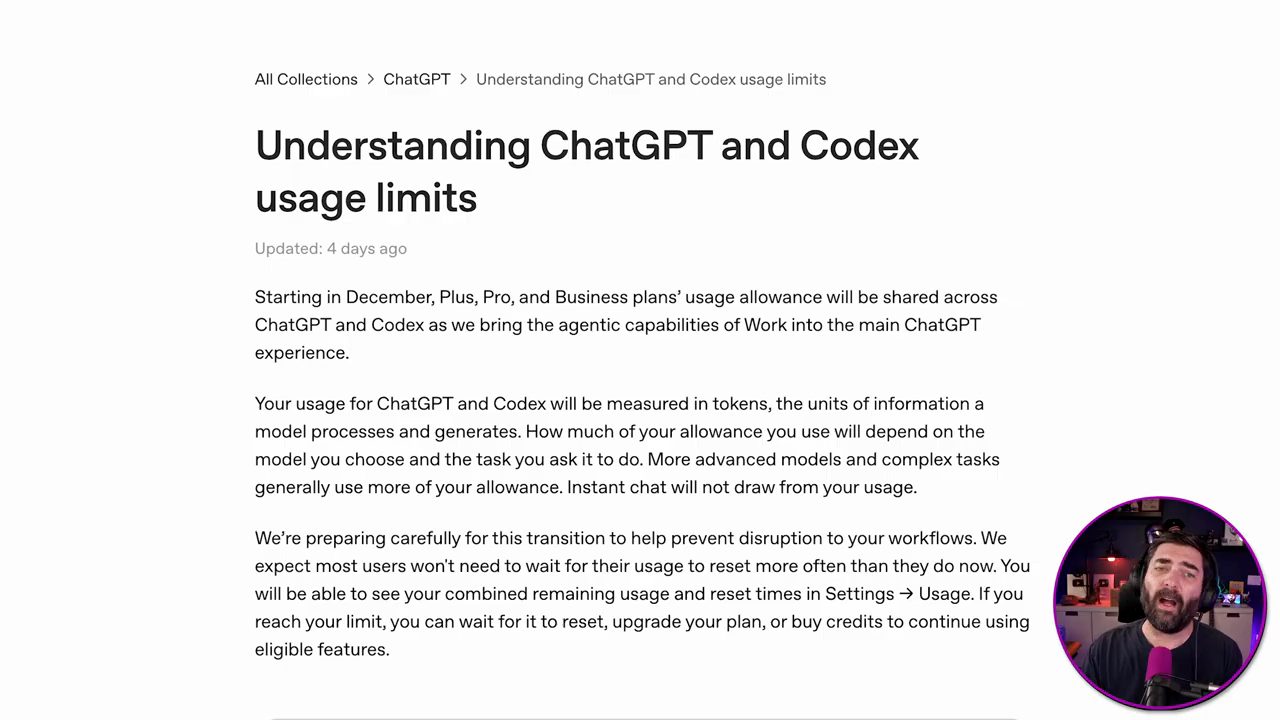
OpenAI cũng cập nhật cách tính usage cho ChatGPT, Work và Codex. Theo Matt (video đăng ngày 06/11/2026), giờ usage kiểu như được gộp chung cho tất cả: hạn mức sử dụng sẽ dùng chung giữa ChatGPT và Codex.
9. Kimi K3.1 Pro công bố weights
Model open weight Kimi K3.1 Pro, mà theo Matt về cơ bản là model open weight state-of-the-art nhất hiện có (tính đến 11/2026), tuần này đã thật sự công bố weights. Tóm tắt của anh (video đăng ngày 06/11/2026): đây gần như là model open weight tốt nhất đang có, chỉ xếp sau Claude Fable 5.1 một chút xíu. Anh nhắc rằng chỉ vài tháng trước, Claude Fable 5.1 là kiểu model tốt nhất mà ai từng thấy, vậy mà Kimi K3.1, một model open weight, giờ về cơ bản là ngang ngửa với nó.
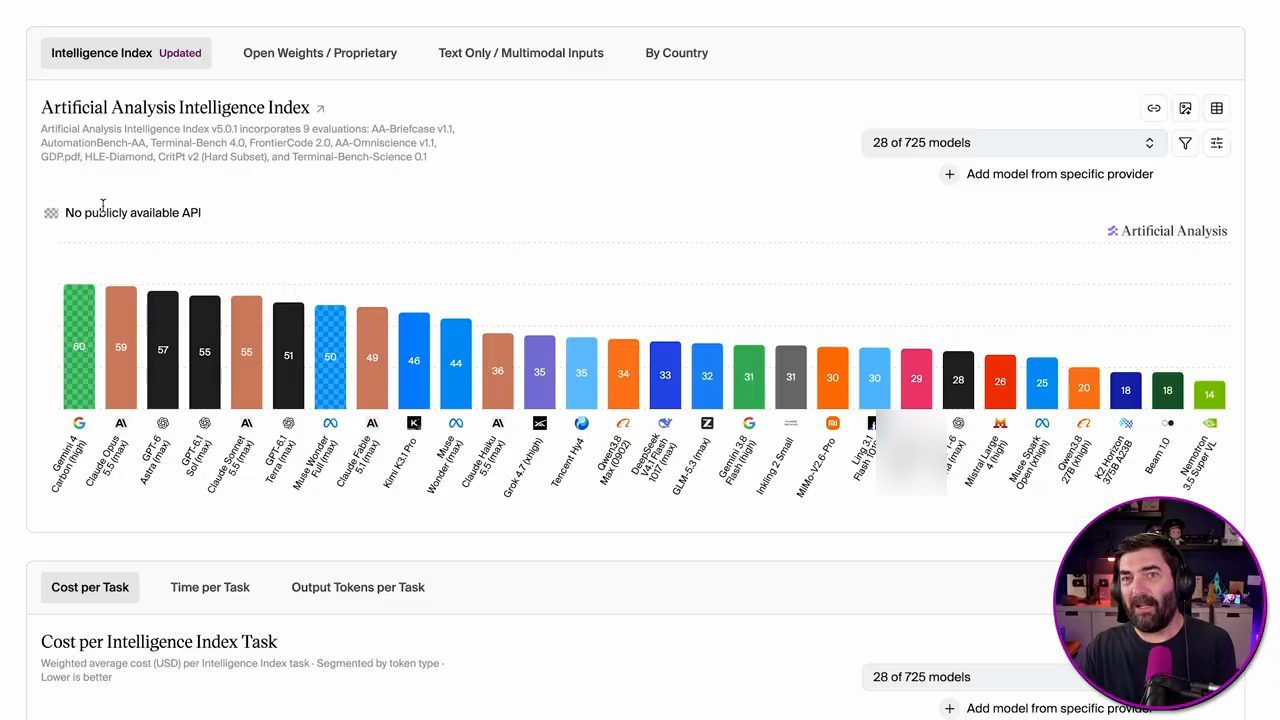
Theo lời anh (video đăng ngày 06/11/2026), model đã ra mắt khoảng một tuần rưỡi trước, nhưng weights của bản open weight thì giờ mới có trên Hugging Face. Weights nặng 1,56 terabyte, và đây là một model 2,8 nghìn tỷ tham số (trang Hugging Face trên màn hình cũng ghi Total Parameters là 2.8T), nên theo anh, lúc này bạn có lẽ sẽ không chạy nó trên GPU ở nhà được.
10. Kết nối tài khoản ngân hàng vào Claude
Theo video đăng ngày 06/11/2026, tuần này Anthropic ra một tính năng mới trong Claude: bạn có thể kết nối tài khoản ngân hàng vào Claude. Theo lời anh, tính năng đang được triển khai trong tuần này cho các gói Pro, Max và Ultra, và dùng Plaid để nối tài khoản Claude của bạn với ngân hàng bạn đang dùng. Bài của Anthropic ghi tính năng tên là Personal Finance, bắt đầu triển khai bản beta trong tuần trên các gói Pro, Max và Ultra ở Mỹ (theo bài trên claude.com, đọc ngày 06/11/2026).
Theo Matt (video đăng ngày 06/11/2026), bạn có thể hỏi kiểu "tháng này tiền của tôi đi đâu hết?" và nó sẽ chia ra cho bạn, hoặc hỏi "còn lại bao nhiêu trước ngày lĩnh lương?".
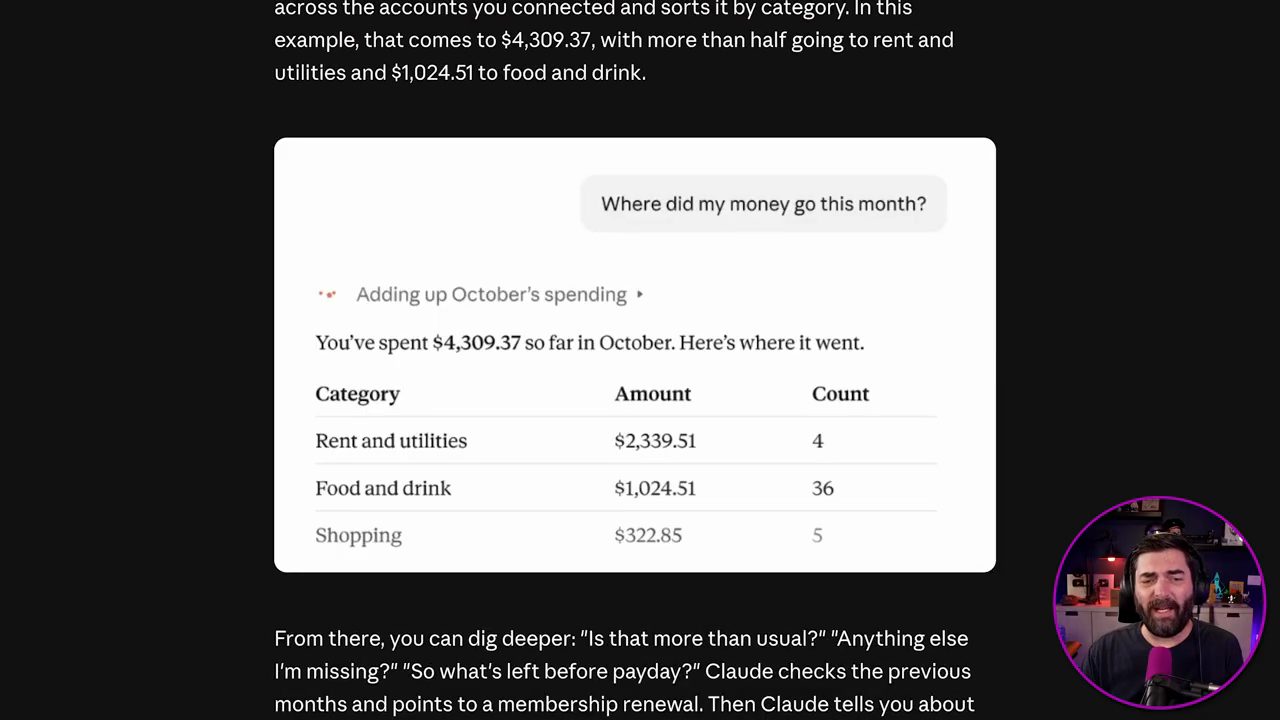
Về quyền riêng tư, Matt nói (video đăng ngày 06/11/2026) họ không train trên bất kỳ thông tin tài chính nào của bạn, và quyền truy cập chỉ là read-only, nên họ không thể làm gì với tài khoản ngân hàng ngoài việc đọc thông tin; họ chỉ được thấy bốn số cuối của số tài khoản, nên thậm chí không thấy được số tài khoản. Phần "Security and privacy" trong bài trên màn hình ghi cụ thể hơn: các cuộc trò chuyện với Claude trong Personal Finance hub không được dùng để train model, còn những gì bạn chia sẻ với Claude bên ngoài hub thì theo privacy settings của bạn; với các tài khoản bạn chọn kết nối, Claude thấy tên ngân hàng, tên, loại và bốn số cuối của từng tài khoản, số dư, hạn mức tín dụng và tới hai năm giao dịch.
Matt cho biết (video đăng ngày 06/11/2026) anh chưa kết nối tài khoản ngân hàng của mình vào Claude, vì anh còn hơi ngần ngại; có thể sau này anh sẽ thử. Nhưng kể cả có làm thì có lẽ anh cũng không đưa nó lên video, vì anh không muốn chia sẻ thông tin đó với người xem, và anh nói "không có ý gì đâu".
11. Selendis, app dựng video AI có Steve Aoki
Theo Matt (video đăng ngày 06/11/2026), có một app AI mới từ một người mà anh chưa bao giờ nghĩ sẽ làm app: Steve Aoki hợp tác với một bên để làm một app tên Selendis, một app dựng video bằng AI. Theo lời anh, app đang ở giai đoạn early access; anh chưa được cấp quyền nên chưa thử được.
Bài đăng của Selendis trên màn hình giới thiệu Archon, một video foundation model biến footage thô thành bản dựng hoàn chỉnh trong vài phút, ghi là được xây bởi Steve Aoki cùng các chuyên gia trong ngành (bài đăng hiển thị trong video đăng ngày 06/11/2026). Theo những gì Matt đọc được, đây là một trình dựng video AI cá nhân, học gu của từng creator từ các quyết định họ đưa ra trong trình dựng, từ kho video cũ của họ, và từ các video tham chiếu mà bạn đưa vào (theo video đăng ngày 06/11/2026).
12. Tab AI Discover của Netflix
Theo video đăng ngày 06/11/2026, Netflix công bố sẽ đưa thêm AI vào nền tảng, hiển thị gợi ý qua một tab mới tên AI Discover. Matt nói anh không rõ tab này khác các danh mục hiện có của Netflix ở điểm nào, nhưng theo anh nó sẽ có những mục như "something light", "family movie night", "quick watches", và Netflix sẽ dùng AI để sắp xếp nội dung theo tâm trạng của bạn, theo thứ bạn muốn xem.
Anh nói anh cũng có cảm giác đó vốn đã là cách các danh mục của Netflix hoạt động rồi, nên anh không biết người dùng có thấy khác biệt lớn không (video đăng ngày 06/11/2026).
13. Gần như không ai dùng agent để đặt DoorDash hay Uber
Hai tin tiếp theo, theo Matt, là hai tin anh thấy thật sự thú vị. Anh nói (video đăng ngày 06/11/2026) chúng ta cứ nghe mãi các use case về AI agent đặt DoorDash hay gọi Uber cho mình. Hoặc ta mở voice mode và nói kiểu "hôm nay tôi thèm taco, gửi ít taco tới nhà tôi, rồi hai tiếng nữa nhớ cho một chiếc Uber tới để tôi ra sân bay kịp giờ". Theo anh, ta thấy những ví dụ như vậy suốt, được coi là các use case "sát thủ" của agent.
Nhưng hoá ra, theo Matt (video đăng ngày 06/11/2026), không ai dùng những tính năng đó. Theo DoorDash, họ mới nhận được vài trăm đơn hàng từ AI agent; con số này được nêu trong cuộc gọi báo cáo thu nhập quý ba. Trong khi đó DoorDash trung bình giao 3 triệu đơn mỗi ngày. Anh nhấn mạnh: 3 triệu là mỗi ngày, còn vài trăm đơn kia không phải mỗi ngày mà là tổng cộng. Nên xét trong bức tranh chung, mọi người không dùng agent cho việc này. Bài báo trên màn hình (đề ngày 30/10/2026) trích lời CEO DoorDash Tony Xu rằng họ đang thấy "có lẽ vài trăm đơn tổng cộng" từ một số agent bên thứ ba, và ghi con số 3 triệu đơn mỗi ngày là từ báo cáo năm 2025 của công ty.
Uber cũng nói điều tương tự. Matt mở một bài trên Yahoo Tech với tiêu đề rằng gần như không ai dùng AI agent để đặt Uber, và cũng xuất phát từ cuộc gọi báo cáo thu nhập quý ba. Theo lời anh (video đăng ngày 06/11/2026), trong 320 triệu chuyến, chỉ có 500 đơn Uber Eats được đặt bởi một AI agent.
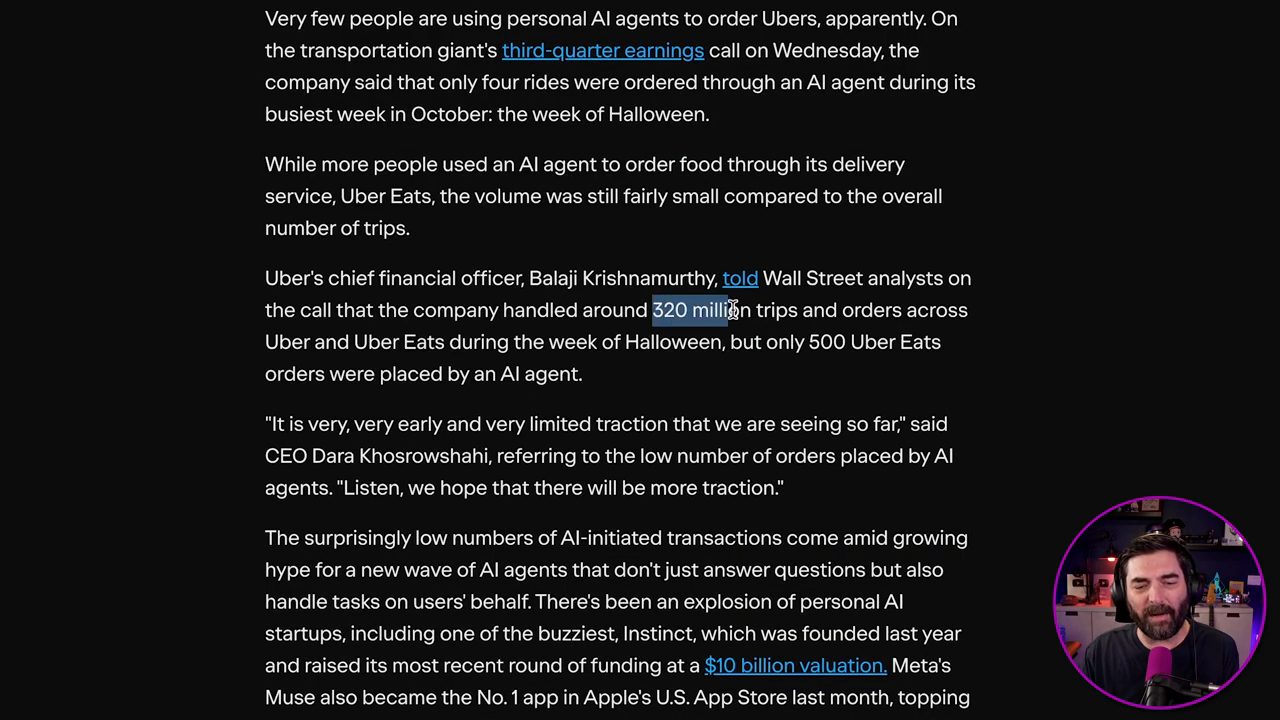
Theo Matt (video đăng ngày 06/11/2026), điểm chung xuyên suốt là mọi người chưa dùng agent để làm những việc như đặt đồ ăn hay gọi xe; chuyện đó chưa thật sự xảy ra.
14. Project Suncatcher: phản hồi AI đầu tiên từ quỹ đạo
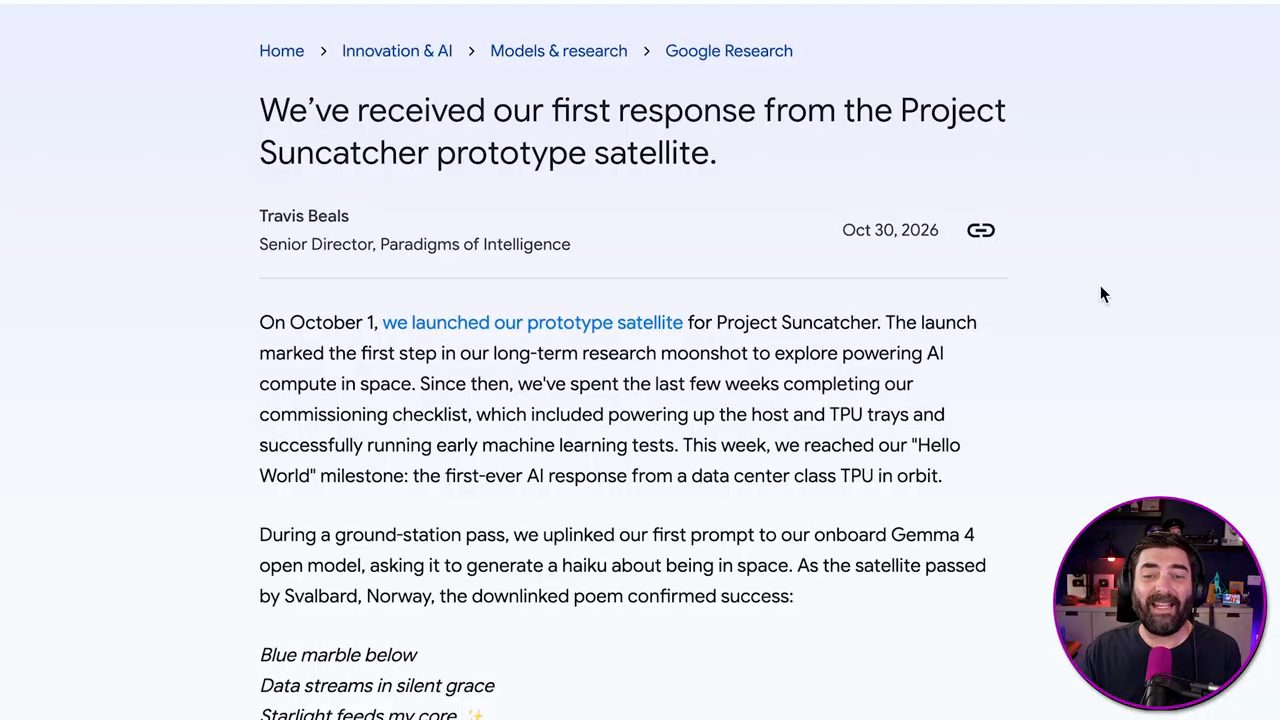
Tin cuối cùng: theo Matt (video đăng ngày 06/11/2026), Project Suncatcher của Google đã có kết quả. Ngày 1 tháng 10, Google phóng vệ tinh nguyên mẫu của Project Suncatcher, mà theo cách anh nói thì về cơ bản là đưa GPU, hay đúng hơn là TPU của Google, lên vũ trụ.
Theo lời anh, tuần này họ đã đạt cột mốc "Hello World": phản hồi AI đầu tiên từ một data center trên quỹ đạo. Anh nói rõ đó mới chỉ là một phản hồi duy nhất, chỉ là một bài thử, chỉ là nguyên mẫu, nên chưa phải ở quy mô lớn gì cả. Nhưng theo anh, họ đã có một vệ tinh hoạt động thật, mang GPU hoặc TPU, gửi dữ liệu về Trái Đất, với các model AI thật sự chạy trên quỹ đạo, và anh thấy chuyện đó "ngầu thật sự" (video đăng ngày 06/11/2026).
15. Vì sao tuần này ít tin lớn
Matt nói đó gần như là toàn bộ tin AI trong tuần. Theo anh (video đăng ngày 06/11/2026), đây là một tuần chậm hơn, nên anh không dành nhiều thời gian cho riêng tin nào, và anh nghĩ có vài lý do.
Theo anh (video đăng ngày 06/11/2026), một lý do là nước Mỹ vừa có bầu cử, và nhiều công ty lớn kiểu như đang chờ xem chuyện gì sẽ xảy ra với cuộc bầu cử. Thị trường chứng khoán cũng đang đi xuống, mà theo anh có lẽ là do kết quả bầu cử.
Một lý do nữa là Anthropic đang ở ngay sát thời điểm IPO. Theo suy đoán của Matt (video đăng ngày 06/11/2026), Anthropic có lẽ đang đợi qua IPO rồi mới công bố điều gì lớn, vì nếu IPO xong rồi ngay sau đó tung ra một thông báo lớn thì điều đó có khả năng làm giá cổ phiếu biến động một chút.
Anh cũng nghĩ OpenAI đang quan sát và chờ xem IPO của Anthropic diễn ra thế nào, và có lẽ điều đó sẽ định hướng cách họ tiến hành IPO của chính mình. Ngoài ra, theo anh (video đăng ngày 06/11/2026), OpenAI có xu hướng chờ một công ty khác ra mắt thứ gì lớn rồi tung ra thứ lớn của mình đúng quanh thời điểm đó để lấn át công ty kia.
Vì vậy theo Matt, hai tuần liền vừa qua chậm hơn là do bất định quanh bầu cử, IPO của Anthropic và những trục trặc của thị trường chứng khoán; tất cả góp phần tạo ra một giai đoạn ít ra mắt lúc này (theo video đăng ngày 06/11/2026).
Khép lại, Matt cảm ơn mọi người đã dành thời gian cùng anh và cùng "nerd out" hôm nay, nói anh thật sự rất trân trọng điều đó, và hy vọng mọi người thấy mình nắm tin hơn nhiều. Rồi anh chào tạm biệt.
Nguồn và liên kết 8 nguồn
- Tên gốc: AI News: New ChatGPT & Google Models (14 Updates Worth Knowing)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=IrAHINf0M6E youtube.com
- Kênh YouTube Matt Wolfe (Matt Wolfe): youtube.com/channel/UChpleBmo18P08aKCIgti38g youtube.com
- P-H3-Image của Pruna AI trên Hugging Face (đọc ngày 06/11/2026): huggingface.co/PrunaAI/P-H3-Image, Space dùng thử: huggingface.co/spaces/PrunaAI/P-H3-Image huggingface.co
- Pika H3 Flex trên Hugging Face (đọc ngày 06/11/2026): huggingface.co/Pika-Labs/Pika-H3-Flex, Space dùng thử: huggingface.co/spaces/Pika-Labs/pika-h3-flex huggingface.co
- Kimi K3.1 Pro của Moonshot AI trên Hugging Face (đọc ngày 06/11/2026): huggingface.co/moonshotai/Kimi-K3.1-Pro huggingface.co
- Bài "Introducing Personal Finance in Claude" của Anthropic (đọc ngày 06/11/2026): claude.com/blog/introducing-personal-finance-in-claude claude.com
Related talks
5 use case GrokBot với nhiều agent nhắn tin cho nhau
Brock Mesarich · Brock Mesarich | AI for Non Techies · 22 min
Năm use case GrokBot: inbox, video, Firecrawl, invoice và meeting agent phối hợp qua group chat, routine, trigger, plugin và Zapier MCP.
Setup Grok Bot từ đầu: bot chief of staff, plugin và năm use case
Alex Finn · Alex Finn · 25 min
Setup Grok Bot: bot chief of staff, brain dump rồi reverse prompt, plugin AgentMail, Vercel, last30days, năm bot use case và khi nào vẫn giữ Hermes.
Grok Bot: 5 use case nên thử cho công việc và cuộc sống
Peter Yang · Peter Yang · 23 min
Build năm bot Grok Bot (Advisor, YouTube Researcher, X Scout, Marie Kondo, Concierge) theo quy trình prompt, lặp, đặt routine; thêm game retro và chuyện niềm tin.