Tin AI tuần: Fable 5.1, Gemini 3.8 Flash, Muse Spark 1.3 và GPT-6 Astra
Matt Wolfe điểm bốn model mới Fable 5.1, Gemini 3.8 Flash, Muse Spark 1.3, GPT-6 Astra qua benchmark và game Megabonk, rồi Atlas, Solaris và các tin nhanh.
✓ Đã duyệt độc lập · cập nhật 19/11/2026 · 31 min
1. Bốn model mới từ bốn lab lớn trong một tuần
Matt Wolfe mở đầu bằng nhận xét rằng tuần này "absolutely insane": theo anh (video đăng ngày 04/09/2026), tuần này có rất, rất nhiều tin thật sự lớn, những đợt ra mắt model rất lớn, cập nhật sản phẩm mới, rất nhiều thứ để nói, và anh không muốn làm mất thời gian của người xem, rồi đi thẳng vào nội dung.
Theo Matt (video đăng ngày 04/09/2026), trong tuần này có tới bốn model state-of-the-art hoàn toàn mới đến từ bốn foundation lab lớn: Claude Fable 5.1, Gemini 3.8 Flash, Muse Spark 1.3 của Meta, và tất nhiên là GPT-6. Anh gọi cả bốn đều là những đợt ra mắt rất lớn.
Anh nói sẽ đưa ra bản TLDR nhanh cho bốn model mới này, và đi theo thứ tự mà chúng ra mắt trong tuần (video đăng ngày 04/09/2026).
2. Claude Fable 5.1 và Mythos 5.1: benchmark và giá
Model đầu tiên là Claude Fable 5.1 cùng Mythos 5.1. Theo Matt (video đăng ngày 04/09/2026), Mythos chỉ dành cho kiểu như những người kiểm thử cybersecurity và những đối tượng tương tự. Trang giới thiệu của Anthropic mà anh mở trên màn hình ghi rằng Claude Fable 5.1 và Claude Mythos 5.1 là cùng một model nhưng có mức safeguard khác nhau: Fable 5.1 có cho mọi người dùng, còn Mythos 5.1 chỉ có qua các chương trình trusted access, với safeguard được thiết kế riêng cho công việc cybersecurity và life sciences (trang hiển thị trong video đăng ngày 04/09/2026).
Theo Matt (video đăng ngày 04/09/2026), khi ra mắt, model này gần như đè bẹp mọi model khác trên các benchmark. Anh đọc từ bảng: ở scientific research, Fable 5.1 đạt 52,6 so với 22,4 của Sol; Opus là 29, còn Fable là 24,7. Ở Terminal-Bench, Fable 5.1 đạt 55,8%, vượt mọi model khác. Anh nói vào ngày nó ra mắt, đây là model tốt nhất từ trước tới nay, bỏ xa các model còn lại.
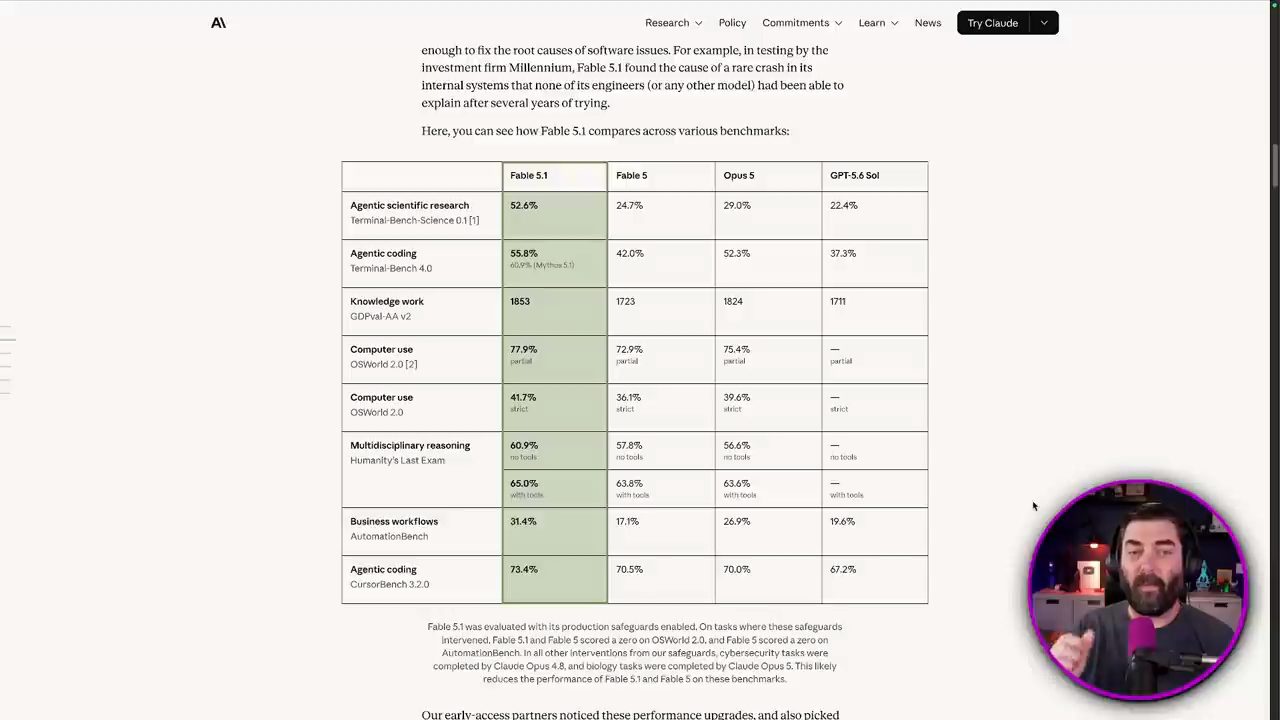
Matt nêu thêm vài điểm đáng chú ý. Về giá, Anthropic nói Fable 5.1 sẽ có chi phí ước tính thấp hơn 25% so với Fable 5 với các workload thông thường (theo trang của Anthropic mà anh đọc trong video đăng ngày 04/09/2026). Tuy vậy, anh mở Artificial Analysis, nơi có một bài test benchmark đo chi phí cho mỗi task. Theo đó, Fable 5.1 thật ra lại là model đắt nhất mỗi task, ở mức 3,69 đô, trong khi Fable 5, chính model mà Fable 5.1 được cho là rẻ hơn 25%, chỉ ở mức 3,14 đô mỗi task (biểu đồ Cost per Intelligence Index Task trên màn hình, video đăng ngày 04/09/2026).
Theo Matt (video đăng ngày 04/09/2026), model này cũng được cho là sẽ từ chối yêu cầu ít hơn. Anh đọc câu trên trang của Anthropic: họ đã cải thiện safeguard để giảm false positive, và giờ chặn ít hơn 60% false positive so với trước. Trên trang, con số 60% này được ghi cho mảng cybersecurity: "our newest safeguards block 60% fewer false positives than before" (trang hiển thị trong video đăng ngày 04/09/2026).
3. Fable 5.1 trên Busey Bench và Artificial Analysis
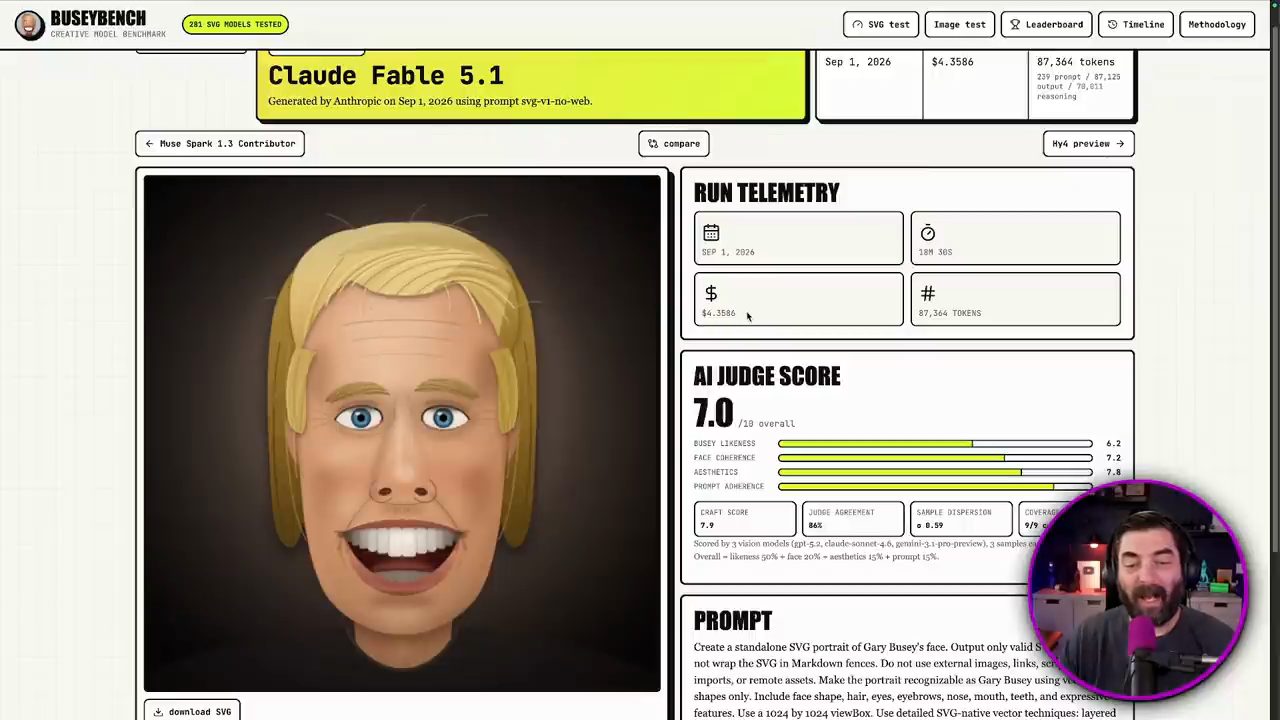
Trên Busey Bench, theo Matt (video đăng ngày 04/09/2026), Fable 5.1 đứng thứ hai, nhưng tốn 4,35 đô để tạo bức ảnh SVG này. Anh nói: đây là một model rất tốt, nhưng thật sự rất đắt. Nó cũng mất 18 phút để tạo đúng một ảnh SVG đó. Trang kết quả trên màn hình ghi chi phí 4,3586 đô, thời gian 18M 30S và điểm AI Judge 7,0 trên 10.
Matt cho biết anh cũng đã prompt tất cả các model mới này làm một bản clone của game Megabonk, chỉ để xem mỗi model cho các game này kiểu thẩm mỹ thiết kế thế nào (video đăng ngày 04/09/2026). Nhưng anh sẽ cho xem phần đó sau khi nói xong cả bốn model, để có thể so sánh chúng cạnh nhau. Anh nói anh cũng có kiểu như một điểm nho nhỏ muốn chứng minh về một chuyện, và điều đó sẽ dễ hiểu hơn khi đặt tất cả cạnh nhau.
Theo Matt (video đăng ngày 04/09/2026), Claude Fable 5.1 khi ra mắt là "the new best of the best", state of the art mới. Thậm chí trên Artificial Analysis, kể cả sau khi các model mới khác lần lượt ra trong tuần, Fable 5.1 vẫn dẫn đầu bảng benchmark của Artificial Analysis.
Anh kể (video đăng ngày 04/09/2026) đây từ rất lâu là một trong những benchmark anh thích xem nhất, vì nó kiểu như một benchmark tổng hợp: nó lấy rất nhiều benchmark khác, đặt trọng số khác nhau cho chúng, rồi cố tìm ra model mà khách quan mà nói là thông minh nhất. Nhưng anh nói giờ anh có vài băn khoăn mới với benchmark này mà lúc trước anh chưa có, và anh sẽ nói tới ở phần sau. Theo Artificial Analysis (video đăng ngày 04/09/2026), Fable 5.1 là model khách quan mà nói thông minh nhất mới, nhưng cũng là model đắt nhất để dùng.
4. Gemini 3.8 Flash: giá thấp, mạnh về coding
Model tiếp theo ra trong tuần là Gemini 3.8 Flash. Theo Matt (video đăng ngày 04/09/2026), đây là một model mới của Google, được thiết kế để khá rẻ và rất, rất nhanh, nhưng vẫn ngang tầm các model state-of-the-art.
Anh đọc bảng benchmark (video đăng ngày 04/09/2026): Gemini 3.8 Flash khá rẻ, 75 cent cho mỗi triệu token input và 3,75 đô cho mỗi triệu token output. So với Opus là 5 đô mỗi triệu input và 25 đô mỗi triệu output. Còn Fable thì thật ra gấp đôi con số đó: theo anh nhớ thì Fable là 10 đô mỗi triệu input và 50 đô mỗi triệu output. Vậy là Gemini 3.8 Flash rẻ hơn rất, rất, rất nhiều so với những model state-of-the-art nhất.
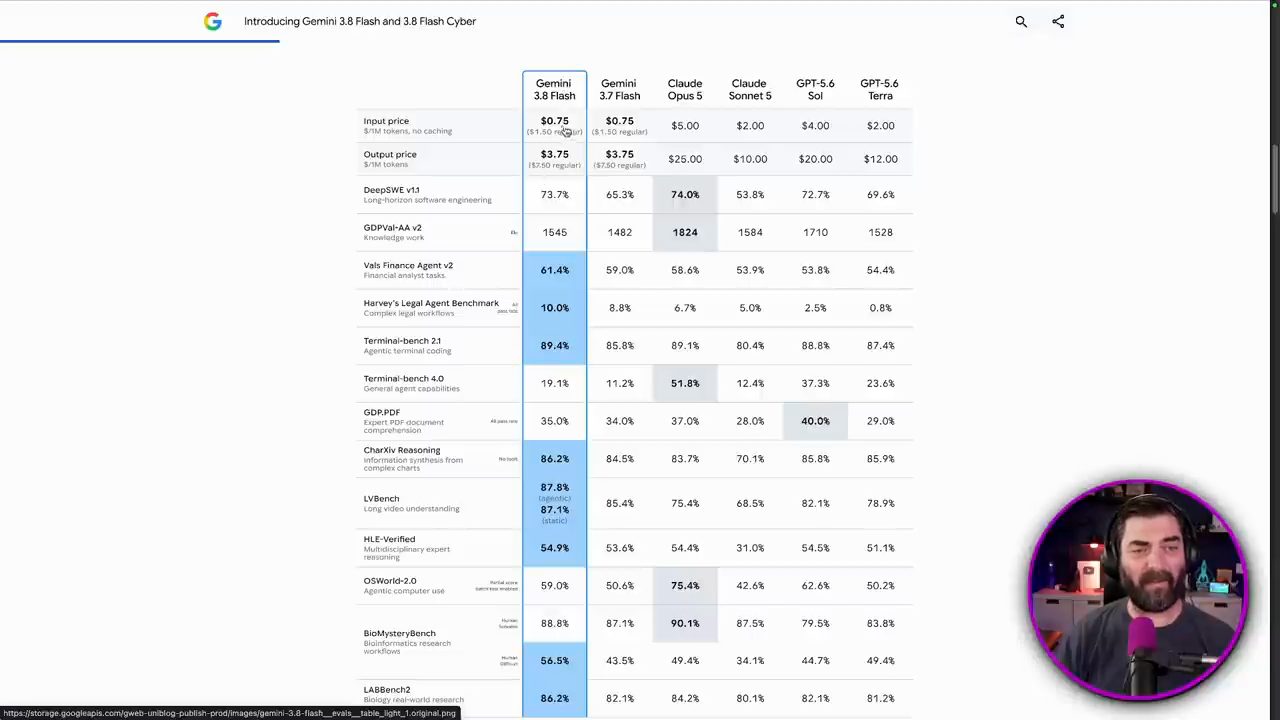
Tuy vậy, theo Matt (video đăng ngày 04/09/2026), model này rất giỏi coding. Anh giới thiệu DeepSWE là một benchmark mà mọi người hay nhìn, vì nó có tương quan khá tốt giữa điểm benchmark và cảm giác thật sự khi dùng các model này để code. Gemini 3.8 Flash đạt 73,7%, trong khi model state-of-the-art tốt nhất trên DeepSWE trước Gemini 3.8 Flash là Claude Opus 5 với 74%: chênh 0,3%, mà tiết kiệm chi phí cực lớn.
Anh nói (video đăng ngày 04/09/2026) model này rất tốt ở cả một loạt benchmark khác, nhưng chỗ anh nhận thấy nó giỏi nhất thật ra là riêng coding. Nó nhanh, khá rẻ nếu so sánh, và kiểu như ngang ngửa với một số model coding tốt nhất mà ta từng thấy.
Anh mở trang DeepSWE (video đăng ngày 04/09/2026): trang này thật ra đặt Gemini 3.8 Flash lên đầu, trên cả Opus 5. Cả hai đều hiện 74%, nhưng chi phí trung bình mỗi task là 2,36 đô cho Gemini 3.8 Flash và 11,84 đô cho Opus 5. Claude Fable thì ở mức 70%. Bảng xếp hạng DeepSWE trên màn hình ghi đúng như vậy: gemini-3.8-flash 74% với 2,36 đô, claude-opus-5 74% với 11,84 đô, claude-fable-5 70% với 21,63 đô.
Theo Matt (video đăng ngày 04/09/2026), khi Claude Fable ra mắt, ai cũng choáng ngợp vì nó là một model tốt tới vậy, kiểu như model tốt nhất mà bất kỳ ai từng thấy, một bước nhảy rất, rất lớn. Và giờ có một model vượt nó, với chi phí trung bình 21,63 đô cho Fable 5 so với 2,36 đô cho Gemini 3.8 Flash. Vậy, về tỉ lệ chi phí trên giá trị, anh cho rằng Gemini 3.8 Flash kiểu như là rất đáng giá, nhất là cho coding.
5. Gemini 3.8 Flash trên Artificial Analysis và Busey Bench
Quay lại Artificial Analysis, Matt chỉ ra (video đăng ngày 04/09/2026) Gemini 3.8 Flash đang ở hạng 11. Nhưng anh lưu ý là bảng này tính tới cả một loạt benchmark khác nhau. Khi kéo xuống mục cost per task, Gemini 3.8 Flash nằm tít bên dưới với 58 cent mỗi task, trong khi Fable 5 ở trên với 3,14 đô và Fable 5.1 là 3,69 đô. Theo anh, xét tỉ lệ chi phí trên giá trị thì lúc này Gemini mang lại giá trị rất lớn (video đăng ngày 04/09/2026).
Trên Busey Bench, theo Matt (video đăng ngày 04/09/2026), Gemini 3.8 Flash đồng hạng ba. Anh nhận xét ảnh "a little bit wonky", hơi kỳ quặc một chút, kiểu như model cố tạo ra một bức ảnh rất hỗn loạn, điên rồ, với mái tóc điên rồ và những thứ tương tự. Nhưng anh so sánh: Fable 5.1 tốn của anh gần 5 đô, còn model này tốn hơn 9 cent một chút; Fable 5.1 mất 18 phút, còn model này mất một phút 32 giây. Trang kết quả của Gemini 3.8 Flash trên Busey Bench ghi chi phí 0,0921 đô, thời gian 1M 32S và điểm 6,6 (trang hiển thị trong video đăng ngày 04/09/2026); trang của Fable 5.1 lúc trước ghi 4,3586 đô.
6. Muse Spark 1.3: những benchmark làm Matt bối rối
Sau Gemini 3.8 Flash, trong tuần còn có Muse Spark của Meta. Matt nói ngay (video đăng ngày 04/09/2026) rằng benchmark của model này làm anh bối rối. Anh mở DeepSWE trên trang của Meta, một trong những eval anh rất, rất thích dùng để xem một model giỏi coding cỡ nào: bảng ghi 75,4, một con số đưa model này lên vị trí cao nhất.
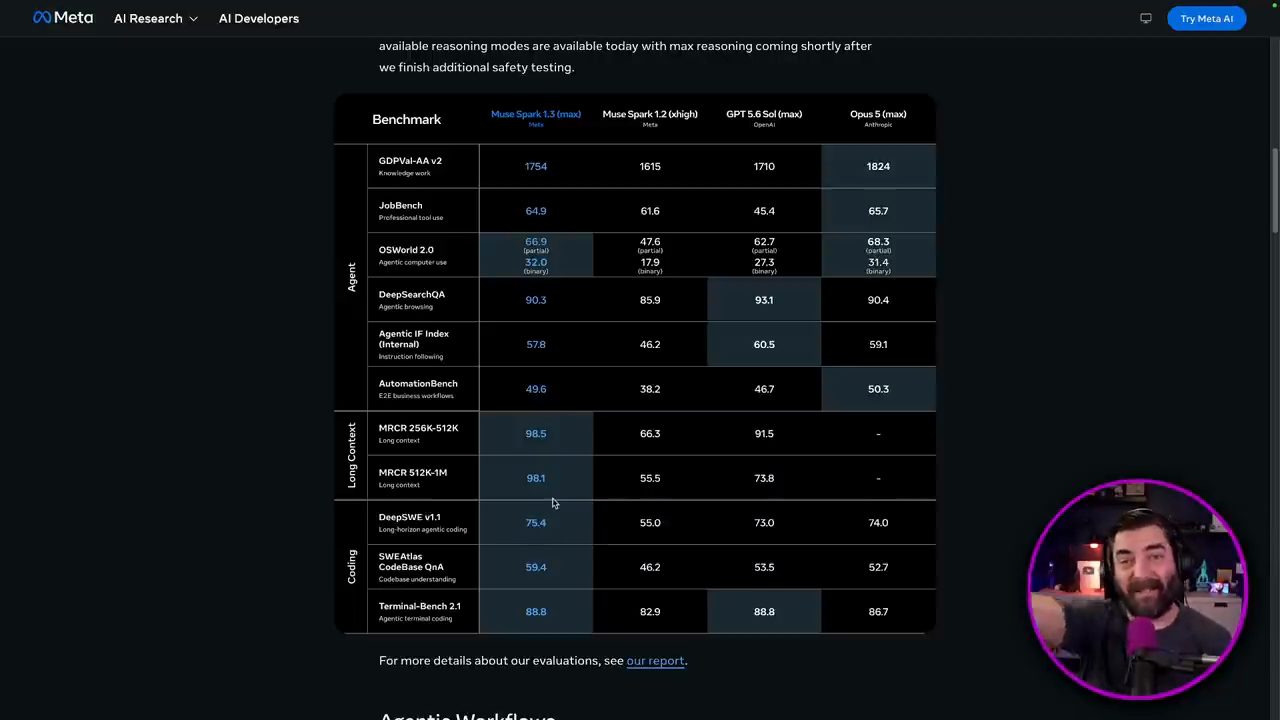
Nhưng khi anh nhìn chính bảng xếp hạng DeepSWE, theo Matt (video đăng ngày 04/09/2026), nó thật ra không liệt kê Muse Spark 1.3. Chỉ có bản 1.2 ở tít bên dưới, còn số một là 3.8 Flash với 74%. Vậy nếu model này đạt 75,4, theo lập luận của anh, nó sẽ là model coding tốt nhất từ trước tới nay.
Anh nói (video đăng ngày 04/09/2026) đây chính là chỗ mà khi anh cho xem các so sánh trong bài test Megabonk của mình, mọi thứ sẽ không hợp lý lắm. Nhưng nếu bạn quan tâm tới benchmark thì các con số này thật sự ấn tượng. Theo anh, chính Muse Spark 1.3 là thứ đang khiến anh thật sự nghi ngờ tính đúng đắn của hầu hết các benchmark gần đây.
Trên Artificial Analysis, theo Matt (video đăng ngày 04/09/2026), Muse có vẻ đứng hạng ba, sau Opus 5 và Fable 5.1, trên GPT-6, và trên Gemini 3.8 Flash một khoảng lớn. Anh nói đây là benchmark còn lại mà anh có xu hướng nhìn nhiều và đặt nhiều giá trị vào. Và việc model này đứng trên Fable 5, trên GPT-6, chỉ sát dưới Opus 5 và Fable 5.1, khiến anh thật sự, thật sự nghi ngờ benchmark này. Về cost per task, anh thấy nó gần như ngang Gemini 3.8 Flash, 55 cent mỗi task (video đăng ngày 04/09/2026).
7. Muse Spark 1.3 trên Busey Bench
Matt mở Busey Bench và dặn (video đăng ngày 04/09/2026): hãy xem các kết quả này với chút hoài nghi, vì đây là AI làm giám khảo, vậy nên chính mắt bạn mới nên là kiểu như người quyết định thật sự. Anh kéo xuống, kéo tiếp, tự hỏi model này có nằm trên trang đầu không, rồi tìm thấy: Muse Spark 1.3 xếp hạng 20 chung cuộc. Nó mất một phút bốn giây để tạo ảnh.
Theo Matt (video đăng ngày 04/09/2026), lần chạy này không tốn tiền, vì lúc này có thể dùng model này miễn phí qua một dịch vụ API trung gian cho model. Trang kết quả trên màn hình ghi chi phí N/A, thời gian 1M 4S và điểm AI Judge 5,8 trên 10.
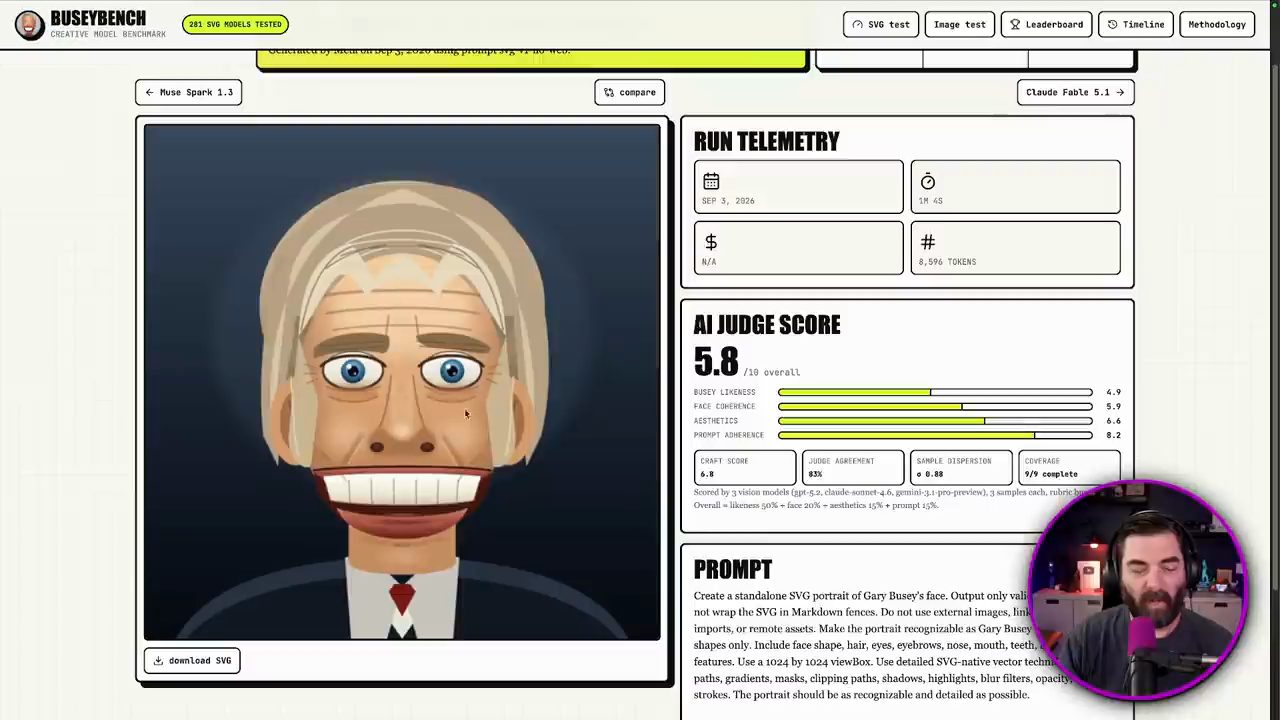
Anh giải thích cho người chưa quen (video đăng ngày 04/09/2026): SVG về cơ bản là những bức ảnh được tạo bằng code. Code chỉ cho nó biết phải vẽ đường ở đâu, dùng màu gì, đổ bóng chỗ nào. Theo anh, về cơ bản đây là một coding benchmark để xem các model dùng code tạo ảnh giỏi đến đâu.
Theo Matt (video đăng ngày 04/09/2026), model đứng đầu DeepSWE và hạng ba trên Artificial Analysis, và đây là bức ảnh nó tạo ra. Anh đặt cạnh Gemini 3.8 Flash, model thấp hơn ở cả hai benchmark đó, và Fable 5.1, model thấp hơn trên DeepSWE: Fable 5.1 cao hơn trên Artificial Analysis nhưng thấp hơn trên DeepSWE, benchmark về coding. Anh hỏi: model này trông có thật sự giỏi coding hơn nhiều không?
Anh nói thêm (video đăng ngày 04/09/2026): đừng hiểu lầm, đây là một model tốt, và lúc này về cơ bản là miễn phí, nên anh không thể phàn nàn chuyện đó. Anh chỉ rất bối rối về cách chấm điểm, và nó khiến anh nghi ngờ tất cả các benchmark này, kiểu, rất nhiều.
8. GPT-6 Astra: DeepSWE, ARC-AGI-3 và Busey Bench
Cuối cùng, trong tuần còn có GPT-6, hay GPT-6 Astra. Theo Matt (video đăng ngày 04/09/2026), model này chưa rollout hoàn toàn cho mọi người, mà kiểu như mới chỉ được mở cho các early tester. Anh nói có thể lúc bạn xem thì đã có nhiều người được truy cập hơn, anh không chắc.
Anh đọc thông báo của OpenAI (video đăng ngày 04/09/2026): GPT-6 Astra bắt đầu rollout hôm nay tới một nhóm giới hạn các tổ chức, và trong những ngày tới sẽ có cho tất cả người dùng ChatGPT Plus, Pro, Business và Enterprise. Đoạn văn trên trang của OpenAI mà anh bôi đen ghi thêm rằng model cũng có qua OpenAI API và AWS (trang hiển thị trong video đăng ngày 04/09/2026).
Vậy là OpenAI đang rollout dần. Theo Matt, tính đến lúc làm video đăng ngày 04/09/2026, phần lớn mọi người vẫn chưa có quyền truy cập. Anh may mắn có được quyền truy cập sớm một chút, để thử, chạy benchmark và tự test, và nói sẽ cho xem những kết quả đó ngay sau đây.
Trên trang của OpenAI, theo Matt (video đăng ngày 04/09/2026), khi kéo xuống phần benchmark, DeepSWE ghi 74,1%. Như vậy lại thêm một model thấp hơn mức của Muse Spark, vốn trên 75%. Theo anh, model này lẽ ra sẽ đứng số một trên DeepSWE, nhưng Muse Spark lại ở trên nó.
Ở benchmark ARC-AGI, Matt gọi kết quả là "pretty insane" (video đăng ngày 04/09/2026): GPT-5.6 Sol đạt 7,8%, còn GPT-6 Astra đạt 99,9% trên ARC-AGI-3. Anh nói OpenAI đã bão hoà benchmark này, và đến lúc này benchmark này coi như vô dụng. Theo anh, đó là những bước nhảy cực kỳ, cực kỳ lớn trong khả năng của model, kiểu như giải quyết vấn đề và những việc tương tự.
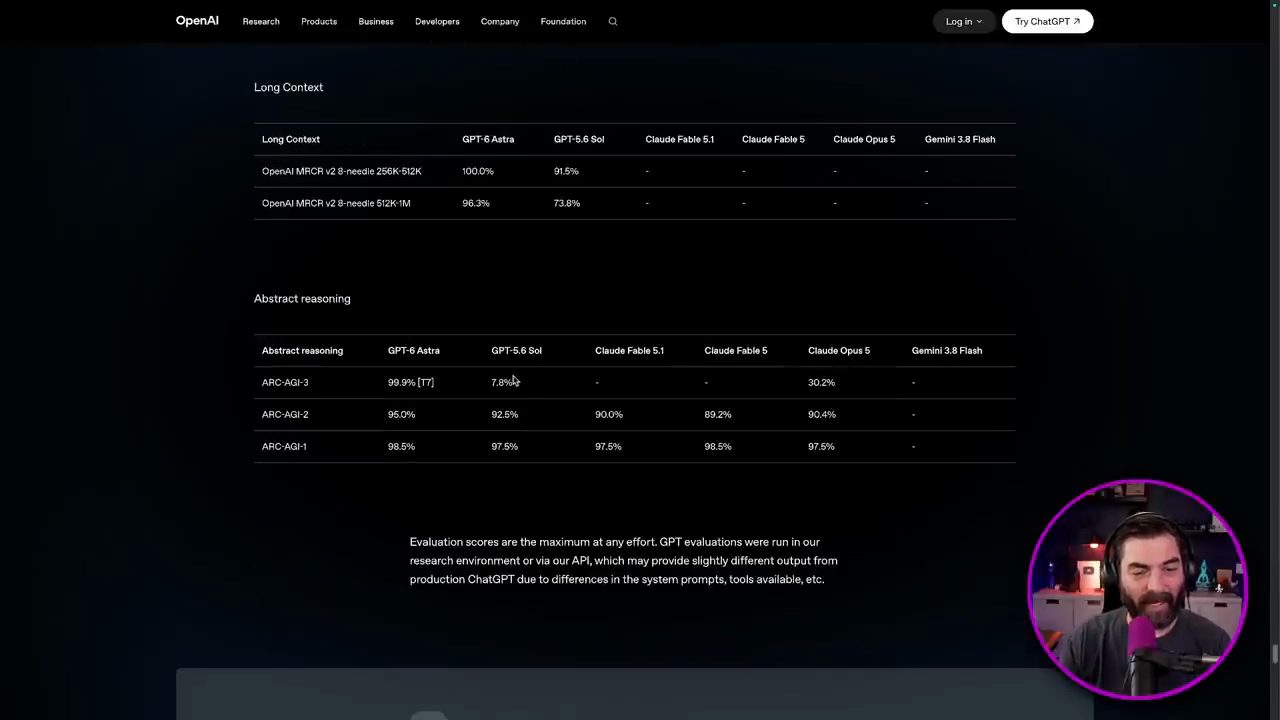
Theo Matt (video đăng ngày 04/09/2026), nếu so lại thì với 74,1% trên DeepSWE, model này sẽ đứng số một trên trang DeepSWE, trên cả 3.8 Flash và Opus 5 ở coding benchmark cụ thể này. Nhưng theo anh, đừng quên rằng Muse Spark 1.3 đạt 75,4, vậy là còn hơn cả GPT-6.
Tuy nhiên, trên Busey Bench, nơi ảnh được tạo bằng code, theo Matt (video đăng ngày 04/09/2026) GPT-6 giờ là model đứng hạng nhất. Anh cho xem ảnh nó tạo: mất chín phút. Ô giá ghi NA, vì anh có quyền truy cập sớm và lần chạy không đi qua API. Nhưng theo trang này, chi phí tương đương API ước tính khoảng 1,94 đô nếu dùng giá API tiêu chuẩn. Phần run notes trên màn hình ghi lần chạy mất 9m 42.7s, với "Estimated API-equivalent cost: $1.94" theo giá API tiêu chuẩn của GPT-6 Astra ngày 03/09/2026 (trang hiển thị trong video đăng ngày 04/09/2026). Anh nói thêm, một lần nữa, model này đạt điểm coding benchmark thấp hơn Spark.
9. So sánh Megabonk: bản của Fable 5.1 và Gemini 3.8 Flash
Đến đây Matt cho xem so sánh giữa các bản clone Megabonk mà anh nhờ tất cả các model này làm (demo trong video đăng ngày 04/09/2026). Đầu tiên là bản Fable làm. Theo anh, trông khá tốt: có nhiều nhân vật để chọn, và các nhân vật thật ra trông khá đẹp. Có một nhân vật trông như con cáo, và quái vật trông cũng ổn: những con bọ nhỏ và quái vật. Anh đổi được góc camera. Anh gọi đây là một game đẹp, và nói mình khá ấn tượng.
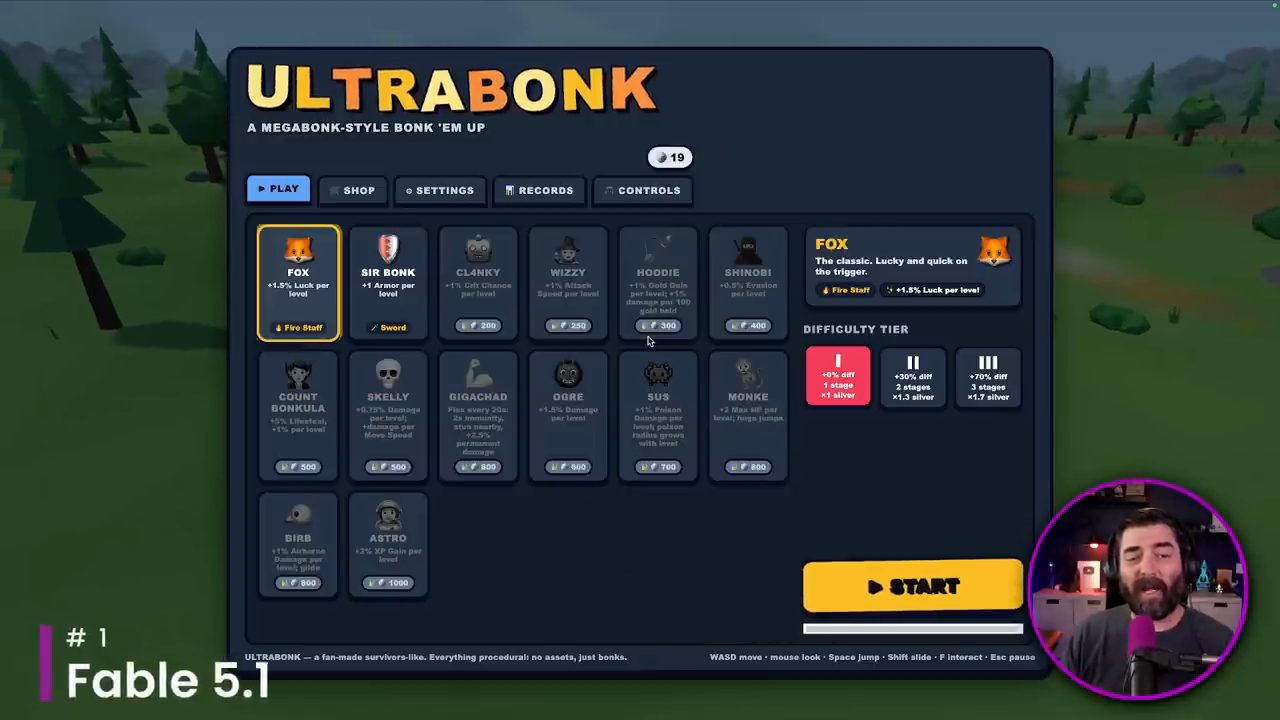
Theo Matt (demo trong video đăng ngày 04/09/2026), màu sắc rất tuyệt. Có vài chỗ kỳ quặc, như mấy thứ nhấp nháy khi anh rê chuột lên, nhưng nhìn chung trông khá tốt. Anh thích việc khi đổi sang shotgun, quái vật kiểu như nổ tung khi anh bắn trúng.
Anh nói (video đăng ngày 04/09/2026) không có gì thật sự để phàn nàn về bản này, ngoài việc nó chạy khoảng hai tiếng để làm game, dùng hết toàn bộ usage trong ngày của anh, rồi chuyển sang dùng extra credit. Cuối cùng làm game này tốn của anh khoảng 120 đô. Vậy là đúng, nó trông đẹp, nhưng tốn hơn 100 đô, và dùng hết usage credit của anh.
Theo Matt (video đăng ngày 04/09/2026), anh đang dùng gói 20x của Anthropic, giá 200 đô mỗi tháng. Model đã dùng hết số credit đó rồi bắt đầu dùng credit bổ sung, vì anh đã cho phép nó cứ tiêu tiền nếu vượt usage. Kết luận của anh: trông tuyệt, nhưng đắt kinh khủng để tạo ra.
Tiếp theo là bản Gemini 3.8 Flash làm, tên Megabonk 3D (demo trong video đăng ngày 04/09/2026). Anh chọn con cáo để xem nhân vật trông thế nào: không giống cáo lắm, trông như một phù thuỷ nhỏ. Nhưng theo anh, bản này trông đẹp hơn rất, rất nhiều so với bản anh có được từ Fable 5 hồi anh làm một thứ tương tự với Fable 5 lần đầu.
Anh không biết chi phí thực tế để tạo bản này (video đăng ngày 04/09/2026), vì anh làm nó bằng Cursor, và nó chỉ dùng Cursor credit của anh. Anh không bị vượt credit; nó dùng một phần rất, rất nhỏ trong số Cursor credit của anh. Anh nói thật sự không có gì để phàn nàn ở đây.
10. Megabonk của Muse Spark 1.3 và GPT-6 Astra
Tiếp đến bản mà Muse 1.3 Spark tạo (demo trong video đăng ngày 04/09/2026). Matt mở game Megabonk của Muse: anh có một khối lập phương với một hình trụ nhỏ, và anh bắn vào những khối lập phương khác. Theo anh, đây là model đang đứng số một trên DeepSWE lúc này, và số ba trên Artificial Analysis. Và đây là bản clone Megabonk nó đưa cho anh khi anh đặt nó ở mức cao nhất cho Muse 1.3. Anh nói: nên bạn có thể thấy vì sao anh rất bối rối với xếp hạng của DeepSWE.
Cuối cùng là bản GPT-6 làm cho anh (demo trong video đăng ngày 04/09/2026): có ba nhân vật knight, ranger và mage. Anh chọn mage, chỉ vì có lẽ đó là phép so sánh gần nhất với các bản kia. Theo anh, bản này với anh có lẽ là bản đẹp mắt nhất. Anh thích cách nhân vật trông, thích cách những con quái nhỏ đang lao tới. Anh nói nó trông giống một game thật hoàn chỉnh nhất trong số này.
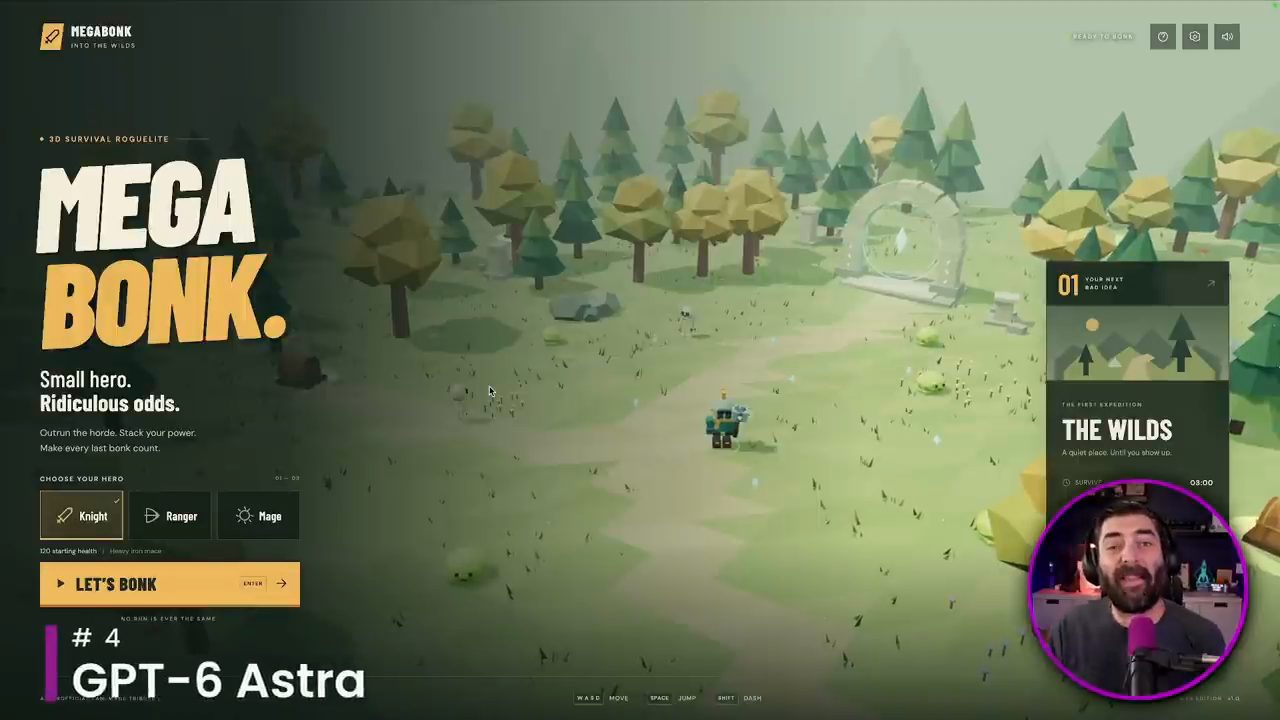
Theo Matt (demo trong video đăng ngày 04/09/2026), bản này được tạo trong khoảng 12 phút, anh nghĩ vậy: anh prompt, và nó tạo rất nhanh. Anh nói nó trông tuyệt: những nhân vật bộ xương nhỏ, những cục blob nhỏ đuổi theo anh, những con dơi trông thật sự giống dơi, nhìn là biết chúng là dơi. Và khi game tiếp diễn, càng lúc càng có thêm nhiều loại quái khác nhau. Anh nói nó trông đẹp, rất, rất dễ chịu cho mắt.
Theo Matt (video đăng ngày 04/09/2026), đó là lý do anh rất bối rối khi nhìn DeepSWE, kiểu một benchmark thiết kế cho coding, lại đặt Muse Spark 1.3 mới là model có kết quả tốt nhất. Artificial Analysis cũng vậy: đặt model này trên GPT-6, trên Gemini 3.8. Anh nghĩ cả hai model đó cho anh kết quả tốt hơn, cả trên Busey Bench lẫn khi anh thử bài test Megabonk của mình.
Anh kết lại phần này (video đăng ngày 04/09/2026): với những benchmark mà anh dựa vào nhiều nhất, anh cảm thấy giờ không thể thật sự tin cả chúng nữa. Anh cảm thấy chúng không còn khớp với trải nghiệm của mình.
11. ChatGPT kết nối nhiều tài khoản Google, voice trong Gmail, Docs và Keep
Matt nói còn nhiều thứ để kể. Theo anh, tin tiếp theo rất ngắn, nhưng là thứ anh thật sự, thật sự vui vì cuối cùng đã có: nếu bạn dùng app ChatGPT và muốn kết nối nhiều hơn một tài khoản Google, giờ cuối cùng bạn đã làm được (video đăng ngày 04/09/2026). Anh nói tin này thật ra đã ra từ tuần liền trước tuần đăng video, và không hiểu sao anh hoàn toàn bỏ lỡ.
Anh cho xem (demo trong video đăng ngày 04/09/2026): mở app ChatGPT, bấm vào plugins, rồi bấm vào Gmail, bấm manage, và có thể thấy anh đang có một email được kết nối, nhưng giờ anh kết nối thêm được một tài khoản khác. Trên màn hình, app đang ở mục Codex, đường dẫn Plugins rồi Gmail, và trong phần Connected accounts có nút "Connect another account". Anh nói anh biết mình không phải người duy nhất hào hứng vì chuyện này.
Google cũng rollout một tính năng mà Matt gọi là kiểu "quality of life" cho Gmail, Docs và Google Keep: giờ có thể dùng voice ngay bên trong các ứng dụng đó (theo video đăng ngày 04/09/2026). Theo anh, về cơ bản những tính năng audio của Gemini mà bạn đã dùng được trong một số app riêng của Gemini, giờ dùng được trong Gmail, Docs và Keep.
Anh mở clip giới thiệu của Google (clip hiển thị trong video đăng ngày 04/09/2026). Trong clip, một người nói: hãy tưởng tượng bạn có thể trò chuyện với hộp thư của mình. Người đó là mẹ của một bé ba tuổi sắp vào pre-K, và hỏi cần mang gì cho ngày đầu tiên đi pre-K của con; câu trả lời trong clip là hai bộ quần áo hợp thời tiết và một tấm ảnh gia đình cho "classroom tree". Một người khác trong clip nói mình là người hay suy nghĩ thành lời, và giờ có Gemini làm bạn đồng hành để brainstorm ngay trong Docs; người đó nhờ Gemini tạo một tài liệu để tổ chức buổi block party sắp tới, và câu trả lời trong clip là đã gom các chi tiết cho buổi block party cuối hè, lên lịch ngày 29/08/2026.
Matt đọc bài của Google (video đăng ngày 04/09/2026): các tính năng trò chuyện mới này rollout trong tuần, nên có thể bạn đã có chúng trong tài khoản lúc xem video, nhưng chúng dành cho người đăng ký AI Plus, Pro và Ultra, nên bạn phải ở kiểu một gói trả phí mới dùng được. Đoạn bài trên màn hình ghi cụ thể hơn: các tính năng có trong Gmail và Keep cho người đăng ký Google AI Plus, Pro và Ultra, trong Docs cho người đăng ký Pro và Ultra, và tất cả sẽ sớm có cho khách hàng doanh nghiệp của Google Workspace (bài hiển thị trong video đăng ngày 04/09/2026).
12. Video AI tạo nhanh hơn thời gian phát và livestream "slop" vô tận
Matt chuyển sang một cập nhật trong thế giới mà anh gọi là "AI video slop, I guess" (video đăng ngày 04/09/2026). Anh nói đó không phải chữ của anh: chính những người làm thứ này tự gọi nó là slop.
Theo Matt (video đăng ngày 04/09/2026), một công ty đã ra một model video mới tạo được video 15 giây trong 13 giây, vậy là nó làm ra một video dài hơn thời gian cần để tạo video đó. Bài đăng của Hao AI Lab trên màn hình ghi bản FastH3 v1 open weight tạo video 15 giây 768p trong 13 giây (bài đăng ngày 28/08/2026, hiển thị trong video đăng ngày 04/09/2026).
Matt hỏi: vậy bạn nghĩ người ta đã làm gì với nó? Theo anh (video đăng ngày 04/09/2026), họ bắt đầu làm những stream vô tận, nơi bạn cứ prompt tiếp và video cứ chạy mãi, vì nó tạo nhanh hơn tốc độ phát lại. Một dịch vụ API trung gian cho model đã tạo ra một nền tảng mới cho livestream AI tương tác vô tận (anh nói anh không bao giờ biết đọc tên nó thế nào): bạn chọn một kênh, prompt điều xảy ra tiếp theo, rồi xem nó được tạo ra theo thời gian thực.
Theo Matt (video đăng ngày 04/09/2026), Pieter Levels cũng làm một thứ tương tự, Infinite Slop, tên miền InfiniteSlop.ai trên bài đăng hiển thị trong video. Anh nói có ngày 37.000 người đã xem Infinite Slop; bài đăng trên màn hình ghi "37,000 people watched Infinite Slop yesterday!" (bài đăng đề ngày 30/08, hiển thị trong video đăng ngày 04/09/2026). Theo anh, ý tưởng giống nhau: người xem viết vào phần bình luận điều họ muốn thấy, và video cứ thế tạo tiếp, ra video mới.
Anh cho xem Infinite Slop trông thế nào (demo trong video đăng ngày 04/09/2026): bạn thấy mọi người đang prompt gì, thấy cái đang được tạo, và thấy hàng đợi các prompt sắp lên sóng. Và nó cứ tạo ra hết video slop này tới video slop khác. Một giọng trong clip trên stream nói "it's slopping time". Matt nói lúc đó có 75 người đang xem, và hơn 5.000 người đã xem trong ngày (video đăng ngày 04/09/2026).
Anh nhận xét: "So yeah, that seems like a pretty good use of your time, I guess." Rồi anh nói thêm: chỉ vì chúng ta làm được, có thật là chúng ta nên làm không? (video đăng ngày 04/09/2026)
Matt nói anh đã bảo tuần này có rất nhiều tin, và vẫn còn khá nhiều thứ anh muốn nói, nhưng anh sẽ nói tất cả phần còn lại thật nhanh, theo kiểu rapid fire (video đăng ngày 04/09/2026).
13. Rapid fire: Atlas của World Labs
Matt mở đầu phần rapid fire với một trong những thứ khá hay ho mà anh thấy trong tuần: model Atlas mới của World Labs (video đăng ngày 04/09/2026). Anh nói nó rất hay vì bạn đưa cho nó một ảnh đầu vào, chỉ cho nó một camera path, và nó sẽ tạo ra kết quả dựa trên đó. Về cơ bản, từ ảnh, nó kiểu như tự hình dung ra không gian xung quanh những bức ảnh đó.
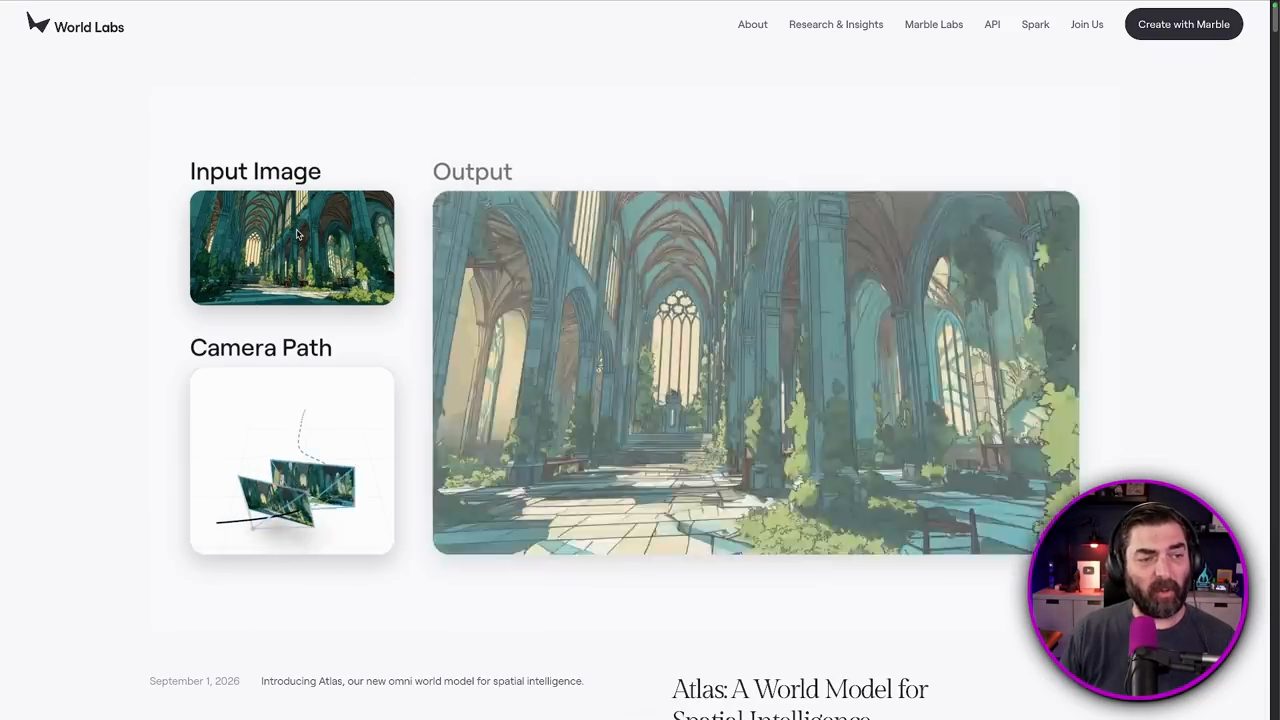
Anh đọc trang của World Labs (trang hiển thị trong video đăng ngày 04/09/2026): Atlas tạo ảnh và video từ một hoặc nhiều ảnh với khả năng điều khiển camera "pixel-perfect". Nó có spatial reconstruction: dựng lại cảnh thật từ một cho tới hàng chục ảnh đầu vào. Trên màn hình, mục Camera-Controlled Generation còn ghi đầu ra tới 1 phút video ở 1440p.
Theo Matt (video đăng ngày 04/09/2026), đây không chỉ là tạo một video, nó không phải là một trình tạo video. Nó tạo ra kiểu như một môi trường. Ta thấy ảnh đầu vào được đưa vào, rồi nó dựng lại mọi thứ chỉ từ một ảnh đó. Ở một ví dụ khác, nó lấy đúng một ảnh, và anh thao tác với nó theo thời gian thực: khi anh di chuột, anh nhìn được từ nhiều góc khác nhau, chỉ từ một ảnh duy nhất. Nếu đưa hai ảnh, nó ghép hai ảnh đó thành một cảnh duy nhất mà bạn di chuyển và thao tác được. Một ví dụ khác theo anh đếm có một, hai, ba, bốn, năm, sáu, bảy ảnh đầu vào khác nhau để tạo ra kết quả này (demo trên trang World Labs, video đăng ngày 04/09/2026).
Anh nói thêm (video đăng ngày 04/09/2026): đây không chỉ là một video, mà là thứ bạn đi lại bên trong, thao tác, đổi góc camera và những việc tương tự. Theo anh, "super, super cool". Tính đến video đăng ngày 04/09/2026, model đang ở dạng early access, nên phần lớn mọi người chưa dùng được. Anh nói anh đã liên hệ xin early access để có thể thử và test, vì anh thấy nó thật sự hay.
Matt nói anh mê những thứ như thế này (video đăng ngày 04/09/2026). Anh hình dung việc chụp thật nhiều ảnh bên trong ngôi nhà của bạn, đưa chúng vào một nền tảng như thế này, và dễ dàng dựng lại bản đồ ngôi nhà. Anh biết bạn đã làm được việc đó bằng những thứ như Gaussian splats, nhưng theo anh có vẻ thứ này làm được với ít ảnh hơn nhiều. Anh nói đây là thứ anh rất háo hức được thử.
Anh nói lại (video đăng ngày 04/09/2026): nó không phải trình tạo video, mà là một trình tạo môi trường thật sự. Bạn cũng có thể làm những hiệu ứng kiểu bullet time rất hay với nó, nên nếu muốn dùng cho video thì cũng có những ứng dụng khá hay. Rồi anh tự nói: phần này lẽ ra là rapid fire, mà anh đang nerd out về nó quá nhiều.
14. Solaris của Runway
Tiếp theo, theo Matt (video đăng ngày 04/09/2026), công ty Runway giới thiệu một thứ gọi là Solaris trong tuần này, có vẻ cho phép bạn kiểu như thao tác video theo thời gian thực. Tính đến video đăng ngày 04/09/2026, đây là một sản phẩm khác đang ở early access, và anh chưa có quyền truy cập, nhưng anh cho xem một số demo.
Anh mô tả các demo của Runway (demo của Runway hiển thị trong video đăng ngày 04/09/2026): một người chụp ảnh selfie, dùng ảnh đó đặt chính họ vào một cảnh, rồi họ kéo thả được giày vào chân mình, kéo thả được những bộ quần áo khác nhau. Một cảnh khác là bên trong một căn phòng, nơi người dùng thao tác và di chuyển đồ vật trong cảnh. Theo anh, điều điên rồ là khi họ di chuyển các chậu cây, bạn sẽ thấy bóng đổ thay đổi theo, và những thứ tương tự.
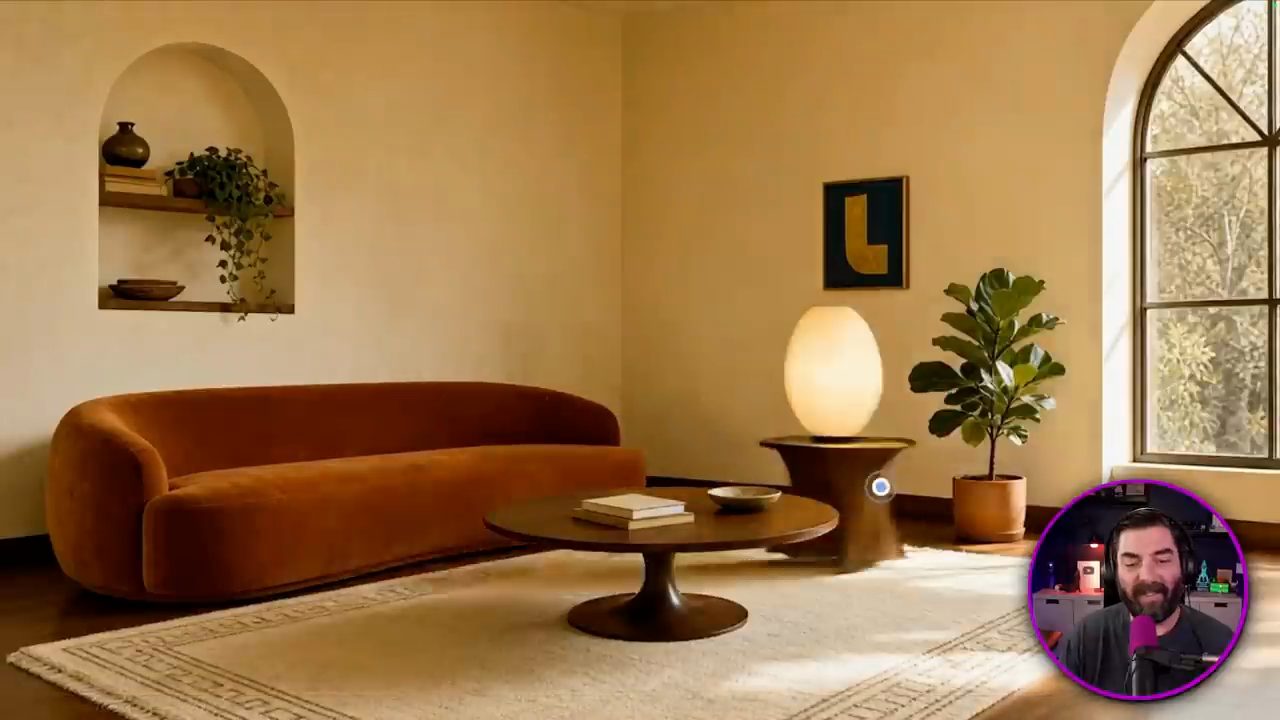
Matt đọc trang của Runway (trang hiển thị trong video đăng ngày 04/09/2026): Solaris được xây trên model tạo video Gen-4.5, được điều chỉnh để hiểu tương tác và phản hồi theo thời gian thực. Solaris coi input của người dùng là điều kiện cho khung hình tiếp theo, giống như cách nó xử lý chữ hay ảnh. Model quan sát các cú click, kéo và những tương tác khác trong lúc tạo, và dùng chúng làm tín hiệu cho những gì xảy ra tiếp theo.
Anh nói (video đăng ngày 04/09/2026) đây là thứ mà có lẽ anh đã đi sâu hơn nếu có quyền truy cập.
15. OpenClaw 2.0 và hai model chuyển giọng nói thành chữ
Với người dùng OpenClaw, theo Matt (video đăng ngày 04/09/2026), OpenClaw vừa ra một phiên bản mới được làm lại hoàn toàn, OpenClaw 2.0. Bài blog trên màn hình có tựa "OpenClaw 2.0, Accidentally", đề ngày 30/08/2026, và mở đầu bằng câu đây là bản cập nhật lớn nhất trong lịch sử OpenClaw, do 933 contributor làm, trong đó 569 người lần đầu đóng góp, gồm hơn 16.000 pull request (bài hiển thị trong video đăng ngày 04/09/2026).
Matt nói về bản thân (video đăng ngày 04/09/2026): với anh, những thứ như Codex và Cursor đã hoàn toàn thay thế OpenClaw, vì giờ chúng có sẵn kiểu như các tính năng agentic bên trong. Nên anh đã không dùng OpenClaw khá lâu rồi.
Tuần này, theo Matt (video đăng ngày 04/09/2026), có không chỉ một mà hai model chuyển giọng nói thành chữ mới. Model thứ nhất của Meta, Muse Voice Transcribe. Anh nói nó làm đúng việc bạn nghĩ: bạn nói, nó chép lại thành chữ. Theo anh, các model loại này ngày càng tốt hơn, và model này rất tốt cho streaming, anh đoán vậy, kiểu như chuyển giọng nói thành chữ theo thời gian thực. Nó ra ngày 01/09.
Rồi chỉ hai ngày sau, ngày 03/09, Microsoft ra MAI-Transcribe-2, mà theo lời Matt (video đăng ngày 04/09/2026) giờ là model nhận dạng giọng nói nhanh nhất, chính xác nhất và rẻ nhất; tiêu đề bài của Microsoft trên màn hình ghi "MAI-Transcribe-2 is the fastest, most accurate and cheapest speech recognition model in the world", đề ngày 03/09/2026. Anh nói đây lại là một model làm đúng việc bạn chờ đợi: chuyển âm thanh của bạn thành chữ, và các model này cứ ngày càng tốt hơn.
16. NVIDIA mua Hugging Face
Theo Matt (video đăng ngày 04/09/2026), NVIDIA đã chính thức mua Hugging Face. Bài trên blog của NVIDIA có tựa "NVIDIA to Acquire Hugging Face", đề ngày 03/09/2026 (bài hiển thị trong video đăng ngày 04/09/2026).
Tóm lại theo cách nhìn của Matt (video đăng ngày 04/09/2026), về cơ bản đây là NVIDIA đặt cược vào open source. Anh nói có những công ty như Meta, OpenAI và Google đều đang cố xây chip của riêng mình, để không phải dùng các công ty như NVIDIA và mua toàn bộ compute từ họ. Thế là, theo cách anh diễn đạt, NVIDIA nói: được thôi, vậy hãy đổ thật nhiều đầu tư vào các model open weight, những model mà mọi người sẽ chạy local, những model rất rẻ để chạy.
Anh tiếp tục diễn đạt lập luận đó (video đăng ngày 04/09/2026): nếu các frontier lab lớn không còn cần compute của NVIDIA nhiều như trước, thì người tiêu dùng phổ thông, các doanh nghiệp và các công ty enterprise muốn xây kiểu như data center on-premises của riêng mình sẽ mua compute của NVIDIA và dùng các model open weight. Anh nói: "In my mind", đó kiểu như là nước đi mà NVIDIA nhắm tới khi mua Hugging Face.
Theo Matt (video đăng ngày 04/09/2026), Hugging Face giống như GitHub cho model weights: mỗi khi có model mới ra, mọi người tải chúng lên Hugging Face. Hugging Face cũng là một nhà cung cấp compute, và bạn có thể vào dùng các model bằng compute của Hugging Face. Anh gọi đây là một thế cục rất thú vị. Anh nói: đây là NVIDIA đặt cược rằng các model open weight sẽ ngày càng lớn hơn và phổ biến hơn trong tương lai, và họ có thể bán phần cứng cho những người cần chúng.
17. Chat với ChatGPT có thể bị đưa ra toà, và New York tạm cấm AI trong trường
Theo Matt (video đăng ngày 04/09/2026), có vẻ các cuộc trò chuyện của bạn với ChatGPT có thể bị đưa ra toà, và chúng không được bảo vệ. Bài của TechSpot trên màn hình có tựa "Your ChatGPT conversations could end up in court, and they're not protected", đề ngày 30/08/2026, với dòng phụ ghi các cuộc trò chuyện với chatbot không có đặc quyền pháp lý như trao đổi với luật sư, bác sĩ và nhà trị liệu (bài hiển thị trong video đăng ngày 04/09/2026).
Matt nói (video đăng ngày 04/09/2026): những cuộc trò chuyện bạn đang có với ChatGPT không riêng tư như bạn nghĩ. Nếu bạn nói về chuyện phạm pháp và có lúc gặp rắc rối, đoạn chat của bạn không nằm ngoài phạm vi ở toà. Anh nói đây chỉ là điều để ghi nhớ cho sau này, nếu bạn đang nói những chuyện kỳ quặc với các model của mình.
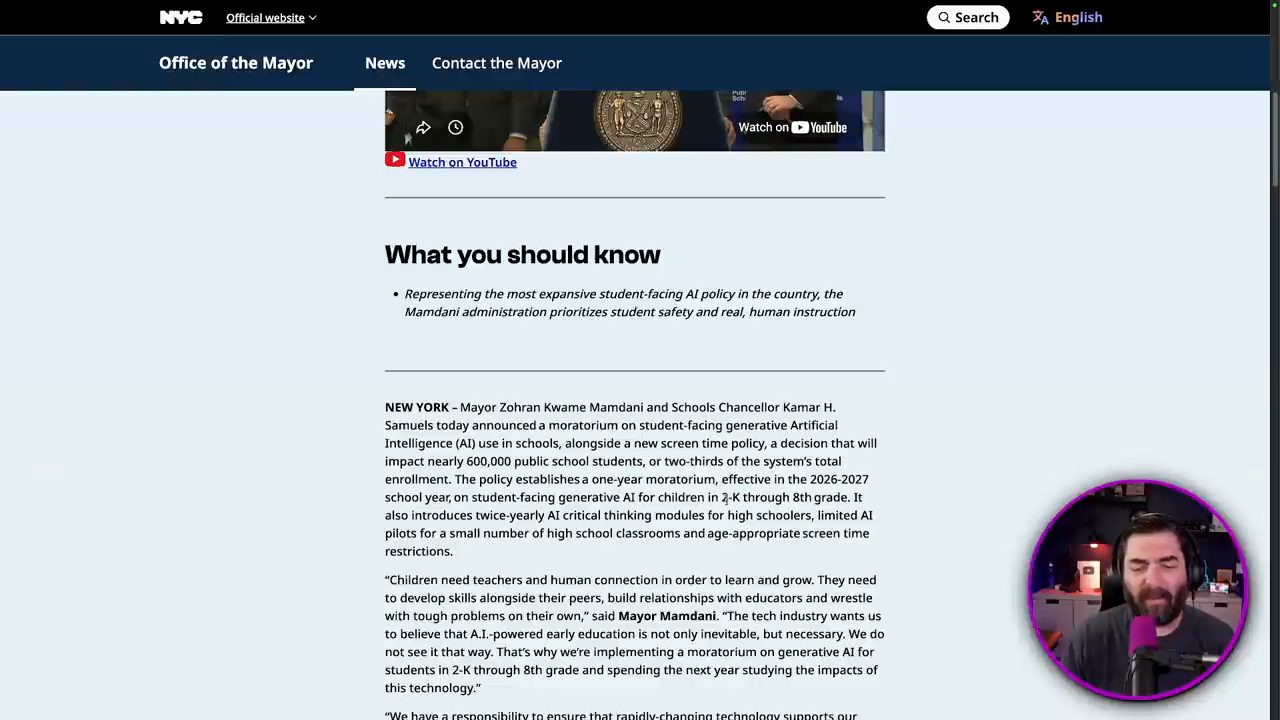
Thị trưởng New York, Mamdani, ra một chính sách AI mới trong tuần, theo Matt (video đăng ngày 04/09/2026): học sinh từ mẫu giáo (K) tới lớp 8 không được dùng AI ở trường. Anh nói rõ: việc trẻ em dùng AI không phải là trái luật, chỉ là chúng không được dùng nó ở trường. Trang của Văn phòng Thị trưởng trên màn hình ghi đây là lệnh tạm hoãn một năm, có hiệu lực trong năm học 2026-2027, với generative AI dành cho học sinh từ 2-K tới lớp 8, ảnh hưởng gần 600.000 học sinh trường công (trang hiển thị trong video đăng ngày 04/09/2026).
Theo cách Matt giải thích (video đăng ngày 04/09/2026), toàn bộ suy nghĩ đằng sau chính sách này là trẻ em cần học những nền tảng cơ bản mà không dùng AI trước khi được tiếp cận AI. Cũng giống như khi bạn học toán cơ bản, như cộng, trừ, nhân, chia, những thứ căn bản, thì thật sự không nên học bằng máy tính bỏ túi. Nhưng khi đã hiểu cách làm, bạn mới đưa máy tính vào để làm dễ hơn và nhanh hơn. Anh nói đó kiểu như là suy nghĩ ở đây, nhưng rõ ràng có rất nhiều ý kiến trái chiều về cách mọi người nhìn nhận chuyện này lúc này.
18. Bàn chải đánh răng AI của Dyson và lời kết
Tin cuối cùng của Matt là về đồ công nghệ, từ công ty Dyson (video đăng ngày 04/09/2026): đúng vậy, công ty làm máy hút bụi và quạt. Theo anh, Dyson vừa làm một bàn chải đánh răng AI, và nói thật là anh hơi muốn có một cái. Nó tên là Dyson CameraJet, có một camera và một tia nước.
Theo Matt (video đăng ngày 04/09/2026), nó dùng AI để bắn nước chính xác vào kẽ răng và kiểu như làm việc xỉa răng giúp bạn, nên bạn vừa đánh răng vừa làm sạch kẽ răng cùng lúc. Nó dùng AI để kiểu như giúp bắn tia nước vào những vị trí tối ưu để làm sạch kẽ răng cho bạn. Anh nói: ít nhất đó là cách anh hiểu.
Anh cho xem ảnh (video đăng ngày 04/09/2026): có kiểu như một bộ cảm biến camera ở đây, có phần bàn chải bình thường, có đèn để camera nhìn thấy, rồi nó bắn nước để làm sạch kẽ răng. Anh nói nếu anh có thể xử lý cả đánh răng lẫn làm sạch kẽ răng trong một lần, và nó dùng AI để đảm bảo làm tốt, thì anh hoàn toàn ủng hộ.
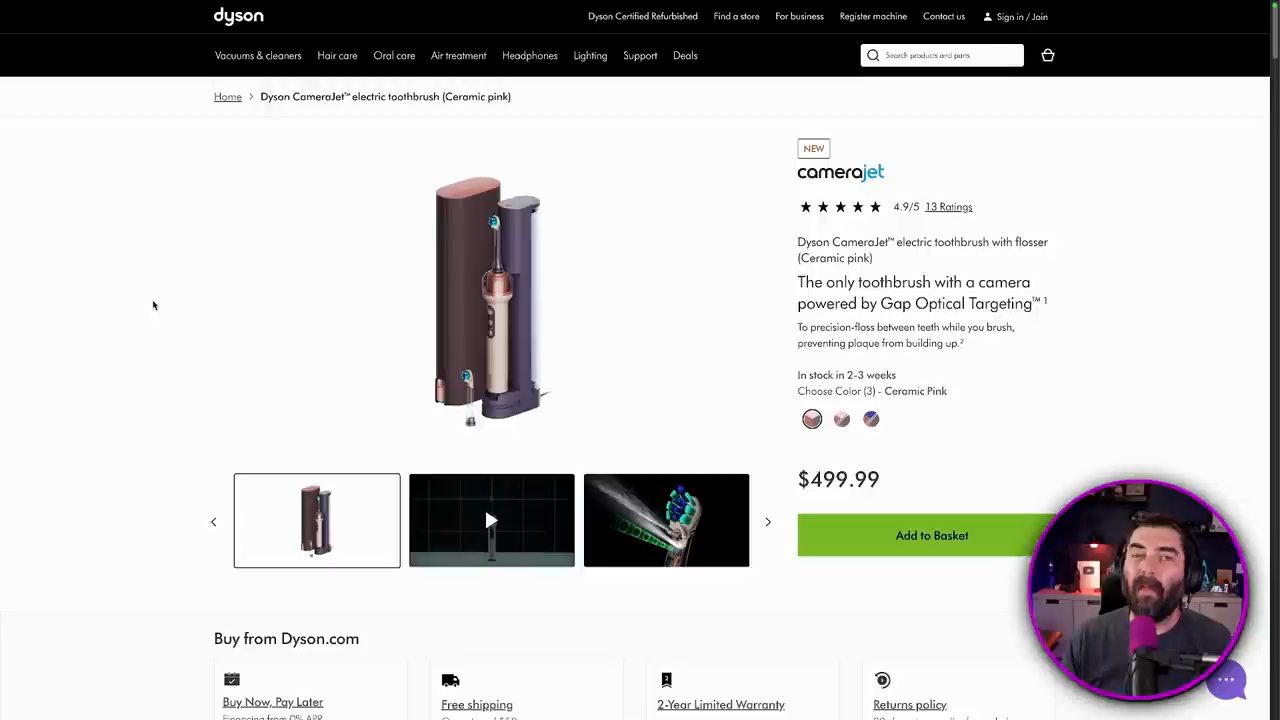
Theo Matt (video đăng ngày 04/09/2026), có một nhược điểm lớn: đây là một chiếc bàn chải 500 đô; trang sản phẩm trên màn hình ghi giá 499,99 đô. Anh nói anh chưa đặt mua, nhưng đang kiểu như nghiêm túc cân nhắc.
Khép lại, Matt nói (video đăng ngày 04/09/2026) tuần này có rất nhiều thứ, và tất cả những đợt ra mắt model này đang trở nên kiểu như mệt mỏi. Nếu bạn thấy kiệt sức vì nó, anh nói anh cũng cảm thấy y như vậy khi cố theo kịp mỗi ngày. Anh kể việc anh làm: theo dõi toàn bộ tin AI, "drinking from the fire hose", thử các thứ, đọc các bài viết, nói chuyện với mọi người, cố xin early access ở bất cứ đâu có thể và cố cập nhật sát nhất có thể.
Anh nói (video đăng ngày 04/09/2026) anh không nghĩ tin tức sẽ chậm lại sớm. Trong tháng này vẫn còn Meta Connect, một sự kiện của Apple, Dev Day của OpenAI và sự kiện Made on YouTube. Anh nói còn rất nhiều thứ đang diễn ra, và mọi người gọi tháng này là "Tech-tember" vì có quá nhiều keynote và sự kiện trong tháng.
Theo Matt (video đăng ngày 04/09/2026), anh dành gần như toàn bộ sức chú ý của một công việc full-time cho chuyện này, để cố làm nó dễ hiểu và dễ tiếp cận với càng nhiều người càng tốt. Anh nói anh thật sự rất thích làm việc này, dù có lúc nó quá tải: rất vui, nhưng cũng có rất nhiều thứ phải theo kịp, và anh không muốn nó khác đi.
Anh cảm ơn mọi người rất nhiều vì đã ở lại và cùng anh "nerd out" hôm nay, hy vọng bạn học được điều gì đó và cảm thấy nắm tin hơn, rồi cảm ơn thêm lần nữa và chào tạm biệt. Sau lời chào, video còn một đoạn ngắn: hình ảnh một bộ giáp và một người đội mũ hiệp sĩ trong phòng thu, tiếng va chạm kim loại, một giọng nói đã qua xử lý vang lên "I am the knight of the round table", và cuối cùng có tiếng nói "and that's how it happened".
Nguồn và liên kết 16 nguồn
- Tên gốc: AI News: The Most Insane Week So Far This Year!
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=GfPZm9yucQo youtube.com
- Kênh YouTube Matt Wolfe (Matt Wolfe): youtube.com/channel/UChpleBmo18P08aKCIgti38g youtube.com
- Bài "Introducing Claude Fable 5.1 and Claude Mythos 5.1" của Anthropic (đọc ngày 19/11/2026): anthropic.com/claude-fable-and-mythos-5-1 anthropic.com
- Bài "Introducing Gemini 3.8 Flash and 3.8 Flash Cyber" của Google (đọc ngày 19/11/2026): blog.google/…/3-8-flash-and-3-8-flash-cyber blog.google
- Bài "Introducing Muse Spark 1.3" của Meta AI Research (đọc ngày 19/11/2026): research.meta.ai/blog/introducing-muse-spark-1-3 research.meta.ai
- Artificial Analysis (đọc ngày 19/11/2026): artificialanalysis.ai artificialanalysis.ai
- Busey Bench (đọc ngày 19/11/2026): buseybench.com buseybench.com
- Bài "Use your voice to get more done in Gmail, Docs, and Keep" của Google (đọc ngày 19/11/2026): blog.google/…/voice-features-gmail-docs-keep blog.google
- Bài "Atlas: A World Model for Spatial Intelligence" của World Labs (đọc ngày 19/11/2026): worldlabs.ai/blog/atlas worldlabs.ai
- Bài "Introducing Solaris" của Runway (đọc ngày 19/11/2026): runway.com/news/research/introducing-solaris runway.com
- Bài "OpenClaw 2.0, Accidentally" trên blog OpenClaw (đọc ngày 19/11/2026): openclaw.ai/blog/openclaw-2-accidentally openclaw.ai
- Bài "Introducing Muse Voice Transcribe" của Meta AI Research (đọc ngày 19/11/2026): research.meta.ai/blog/introducing-muse-voice-transcribe research.meta.ai
- Bài "NVIDIA to Acquire Hugging Face" trên blog NVIDIA (đọc ngày 19/11/2026): blogs.nvidia.com/blog/nvidia-to-acquire-hugging-face blogs.nvidia.com
- Thông cáo của Văn phòng Thị trưởng New York về lệnh tạm hoãn generative AI trong trường (đọc ngày 19/11/2026): nyc.gov/mayors-office/news/2026/09/… nyc.gov
Related talks
Matt Wolfe thử GPT-6 Astra: benchmark, Megabonk, Blender và Unreal Engine
Matt Wolfe · Matt Wolfe · 20 min
Matt Wolfe xem benchmark của GPT-6 Astra, tự thử Busey Bench, Megabonk, một world simulator và computer use trong Blender, Unreal Engine (video 03/09/2026).
Bonsai 2: Qwen 27B nén còn 6 GB có làm được việc agent?
Muhammad Farooq · Prompt Engineering · 14 min
Bonsai 2 nén Qwen3.8-27B bằng ternary quantization còn khoảng 6 GB: hoà ở task ngắn nhưng không build xong app agentic nào, và cách đọc trace để thấy vì sao.
Hướng dẫn đầy đủ về Warp Factories
Benjamin Holmes · Warp · 19 min
Đi hết Warp Factories: dựng factory, agent và automation as code, chạy từ Slack, rồi đo cost per PR, scoring, self-improvement và benchmark.