AI System Design: From Idea to Production
AI Engineer World's Fair 2026: Online Track · Video gốc
Khung bốn phase thiết kế hệ thống AI từ requirement, kiến trúc, eval tới production, áp lên một hệ thống duyệt hồ sơ bảo hiểm y tế.
1. Vibe code rồi ship có đủ không?
Apoorva Joshi tự giới thiệu là một data scientist chuyển sang làm developer advocate, hiện đang ở MongoDB. Những năm đầu sự nghiệp, chị xây các ứng dụng machine learning cho nhiều use case trong mảng cybersecurity. Bây giờ chị dùng chính vốn kiến thức applied machine learning đó để giúp những người xây ứng dụng AI làm thành công sản phẩm của họ với MongoDB và Voyage AI.
Lời hứa của talk: bạn sẽ học cách suy nghĩ về việc xây một hệ thống AI end-to-end, từ ý tưởng tới production. Chị sẽ lấy một use case ngoài đời thật và đi qua mọi bước thiết kế nó, để cuối buổi người nghe mang về một framework lặp lại được, áp dụng cho bất kỳ hệ thống AI nào mình thiết kế.
Chị đặt ngay câu hỏi mà nhiều người đang nghĩ: trong thời đại AI, mình có còn cần nghĩ xem mình xây cái gì nữa không? Cứ vibe code rồi ship là xong, đúng không? Chị nói đó chính là chỗ chị muốn bắt đầu.
Vấn đề của lối nghĩ đó là thế này. Vibe coding chạy rất tốt khi bạn xây cho vui, khi rủi ro thấp, và khi bạn chỉ cần liếc qua là biết output của thứ mình đang xây có đúng hay không. Nhưng ngay khi bạn xây một thứ thật, một thứ người khác phụ thuộc vào, một thứ có hậu quả thật, thì câu "cứ ship đi" thực ra khá nguy hiểm.
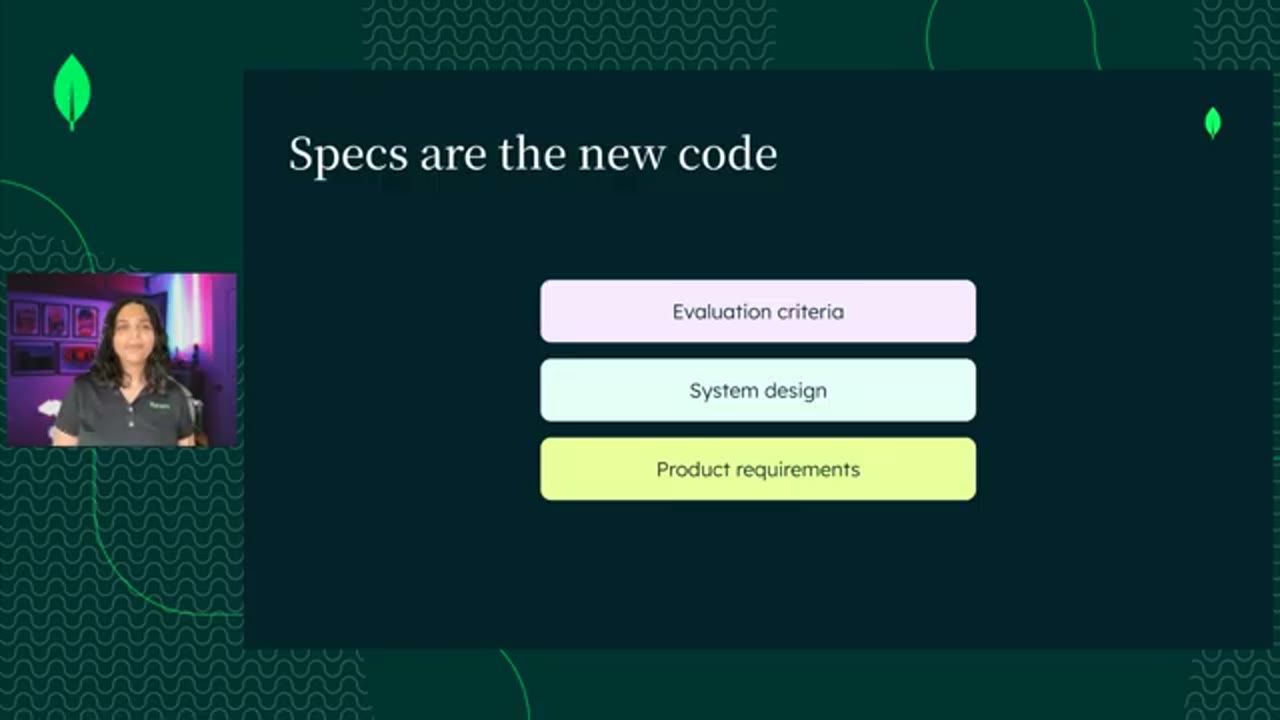
Và không chỉ mình chị nói vậy. Chính những người ở Anthropic và OpenAI, vốn rất lạc quan về AI coding, cũng đang nói điều tương tự; chị trích lại ý từ các talk của họ trong mấy tháng gần đây. Thông điệp chung: specs are the new code, spec mới là code. Cái khó, cái "nghệ thuật", nằm ở việc định nghĩa product requirements, system design và evaluation criteria, để bạn tự tin rằng những "người bạn AI coding" của mình đang xây đúng thứ cần xây. Phần còn lại của talk xoay quanh đúng câu hỏi đó: làm việc này sao cho tốt.
2. Khung bốn phase, từ requirement tới production
Apoorva đề nghị nghĩ về chuyện này như một framework gồm bốn phase:
- Product requirements: bạn thật sự đang xây cái gì, cho ai, và có những constraint nào.
- System design: data, kiến trúc, và các pattern giúp bạn thật sự đáp ứng được những requirement đó.
- Evaluation and monitoring: làm sao biết thứ đang được xây thật sự chạy được, cả trước lẫn sau khi ship.
- Tối ưu (production readiness): không chỉ tối ưu accuracy, mà cả cost, latency và reliability, làm trước khi ship và/hoặc làm tiếp khi bạn phát hiện ra lỗ hổng trong production.
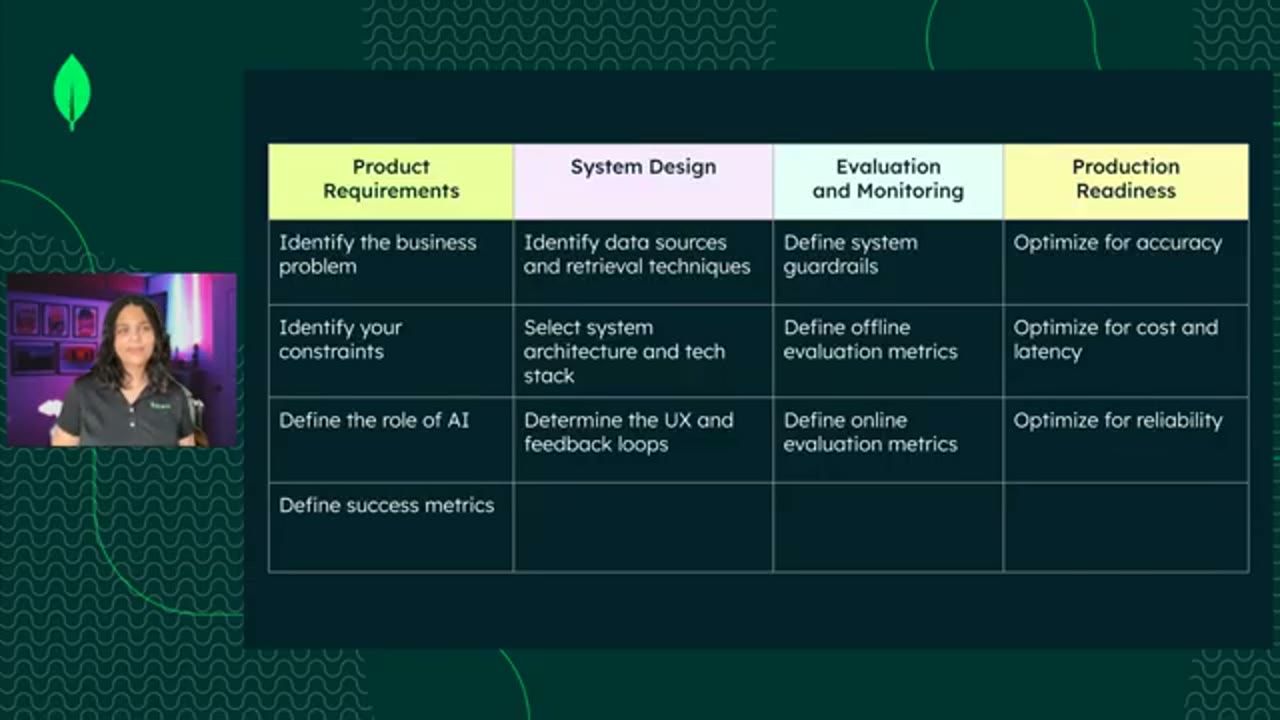
Thay vì nói về framework một cách trừu tượng, chị chọn áp nó lên một use case ngoài đời thật, để người nghe thấy rõ từng quyết định chảy từ phase này sang phase kế tiếp ra sao. Mỗi phần dưới đây là một ô trong bảng trên, và mỗi ô dùng kết quả của các ô trước nó.
3. Use case: hệ thống duyệt hồ sơ bảo hiểm y tế
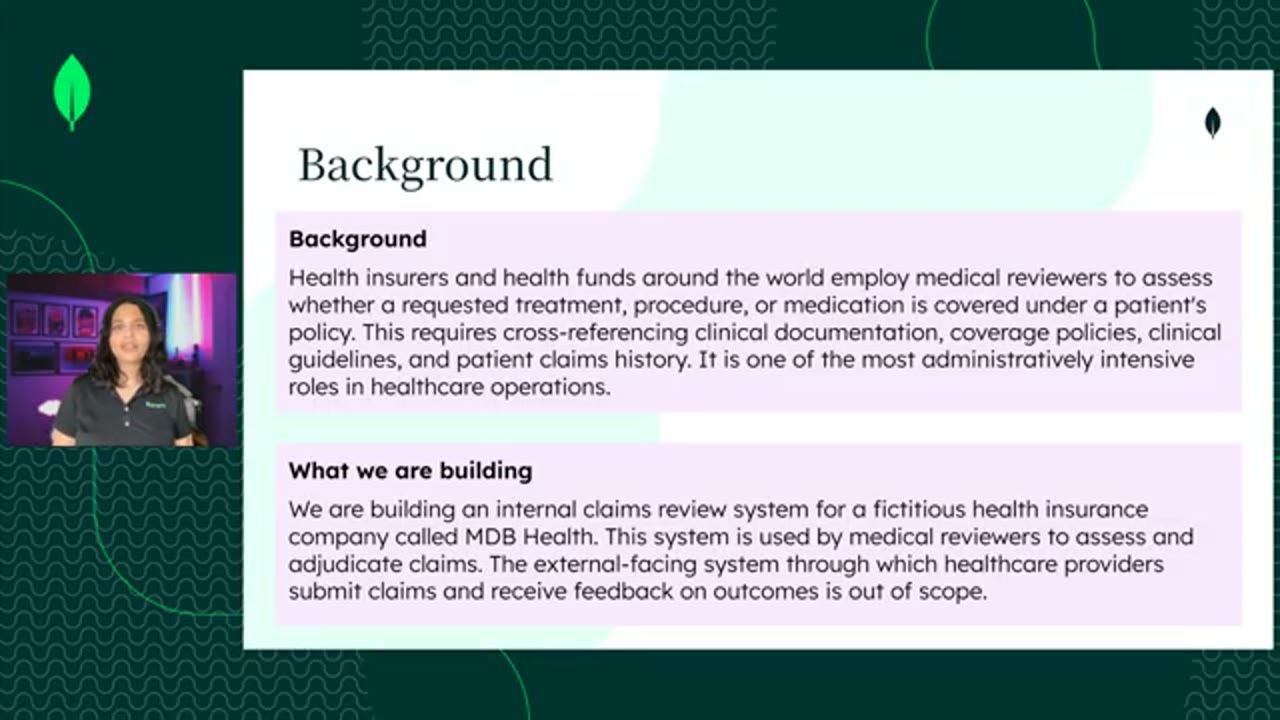
Ví dụ được chọn là một hệ thống health insurance claims review, tức duyệt các yêu cầu chi trả bảo hiểm y tế. Việc xét duyệt (adjudicate) hồ sơ bảo hiểm y tế từ trước tới nay là một quy trình cực kỳ thủ công. Các medical reviewer, những người duyệt có chuyên môn y khoa, phải đối chiếu clinical guideline (hướng dẫn lâm sàng), coverage policy (chính sách chi trả của hãng bảo hiểm), lịch sử bệnh của bệnh nhân và nhiều thứ khác, để quyết định một phương pháp điều trị, một thủ thuật hay một loại thuốc có được hợp đồng bảo hiểm của bệnh nhân chi trả hay không.
Chị nói thêm: nếu bạn sống ở một nơi có y tế miễn phí, thì ở đó vẫn có những thứ được hệ thống y tế chi trả và những thứ không, nên bạn vẫn chịu một phiên bản nào đó của quy trình này.
Mục tiêu khi xây hệ thống là xem liệu có thể cải thiện, hoặc đơn giản hoá, trải nghiệm làm việc của các medical reviewer nhờ AI hay không.
4. Định lượng business problem
Vậy phase product requirements cho ứng dụng này trông ra sao? Việc đầu tiên là định lượng business problem. Một business problem tốt phải tập trung vào một vấn đề cụ thể, nói rõ ai là người dùng của ứng dụng, mô tả tình trạng hiện tại, và định lượng nỗi đau của người dùng. Nó không được kê đơn sẵn hệ thống sẽ là gì: một agent, một multi-agent system, hay thứ gì khác. Chuyện đó để sau.
Business problem của hệ thống duyệt claim có thể viết như sau:
Medical reviewers at MDB Health spend an average of two days processing claim review requests, which is four times the industry standard for non-urgent cases and twelve times the industry standard for urgent ones. Delays at this scale postpone patient care, particularly for time-sensitive treatment.
Dịch nghĩa: medical reviewer ở MDB Health mất trung bình hai ngày để xử lý một yêu cầu duyệt claim, gấp bốn lần chuẩn ngành với ca không khẩn cấp và gấp mười hai lần chuẩn ngành với ca khẩn cấp. Độ trễ ở mức này làm hoãn việc chăm sóc bệnh nhân, nhất là với những ca điều trị nhạy cảm về thời gian.
Apoorva mổ xẻ vì sao câu này đạt:
- User-specific: nó nói rõ hệ thống dành cho medical reviewer.
- Nêu tình trạng hiện tại: một quy trình thủ công khiến họ mất hai ngày cho mỗi lần duyệt claim.
- Đo được: nó đưa ra baseline, gấp bốn và gấp mười hai lần chuẩn ngành.
- Solution agnostic: không hề nói hệ thống phải trông như thế nào.
- Tập trung: nhắm vào một vấn đề cụ thể.
5. Business constraints và performance constraints
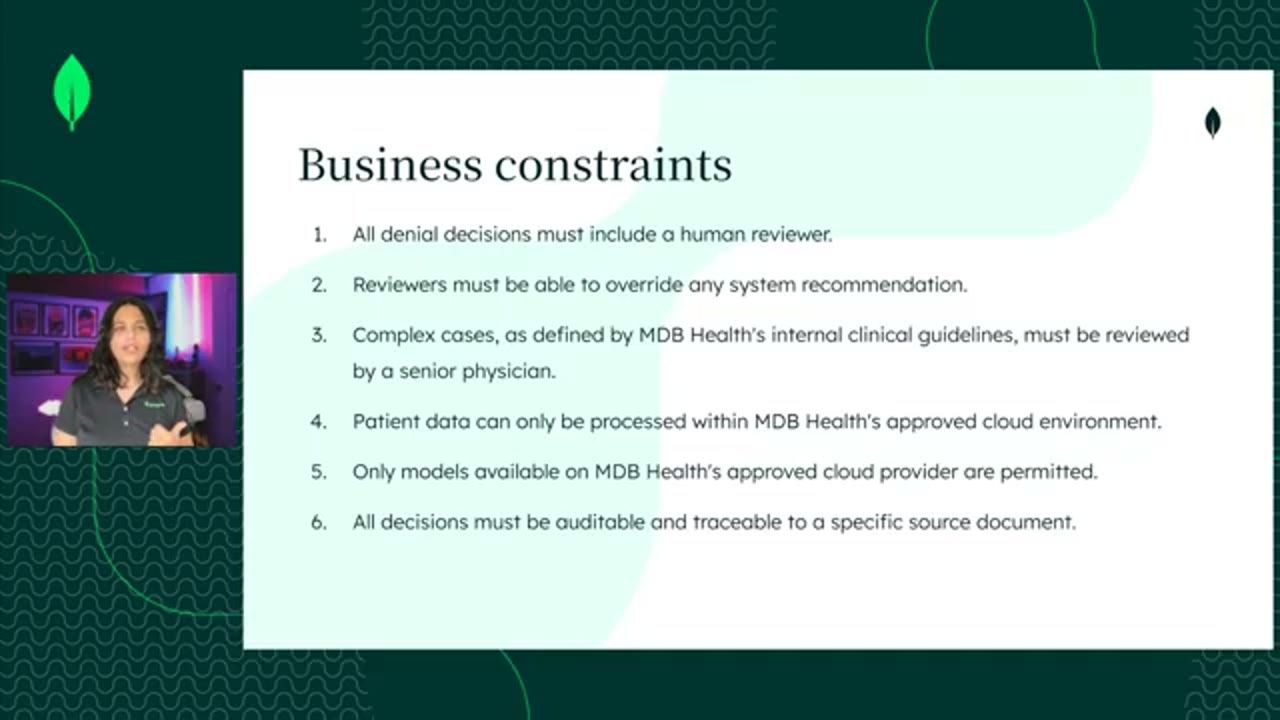
Bước kế tiếp là gom mọi business constraint của ứng dụng: các yêu cầu về regulatory và compliance, ràng buộc về việc dữ liệu có được rời khỏi tổ chức không, ràng buộc procurement (có vendor nào không được phép dùng trong tổ chức không). Tất cả những thứ này nên biết trước, trước cả khi bắt đầu thiết kế hệ thống.
Với ứng dụng của MDB Health, giả sử có các business constraint sau:
- Dữ liệu bệnh nhân phải nằm trong môi trường cloud đã được duyệt.
- Chỉ được dùng những model có sẵn trên cloud đã được duyệt đó.
- Có những ca bắt buộc phải có người duyệt: mọi ca phức tạp phải được một bác sĩ cấp cao (senior physician) xem.
- Mọi quyết định từ chối chi trả (denial) phải được một human reviewer duyệt.
Tức là có những ca không thể tự động hoá hoàn toàn bằng AI. Tất cả những điều này là design input hữu ích, nên càng có sớm càng tốt.
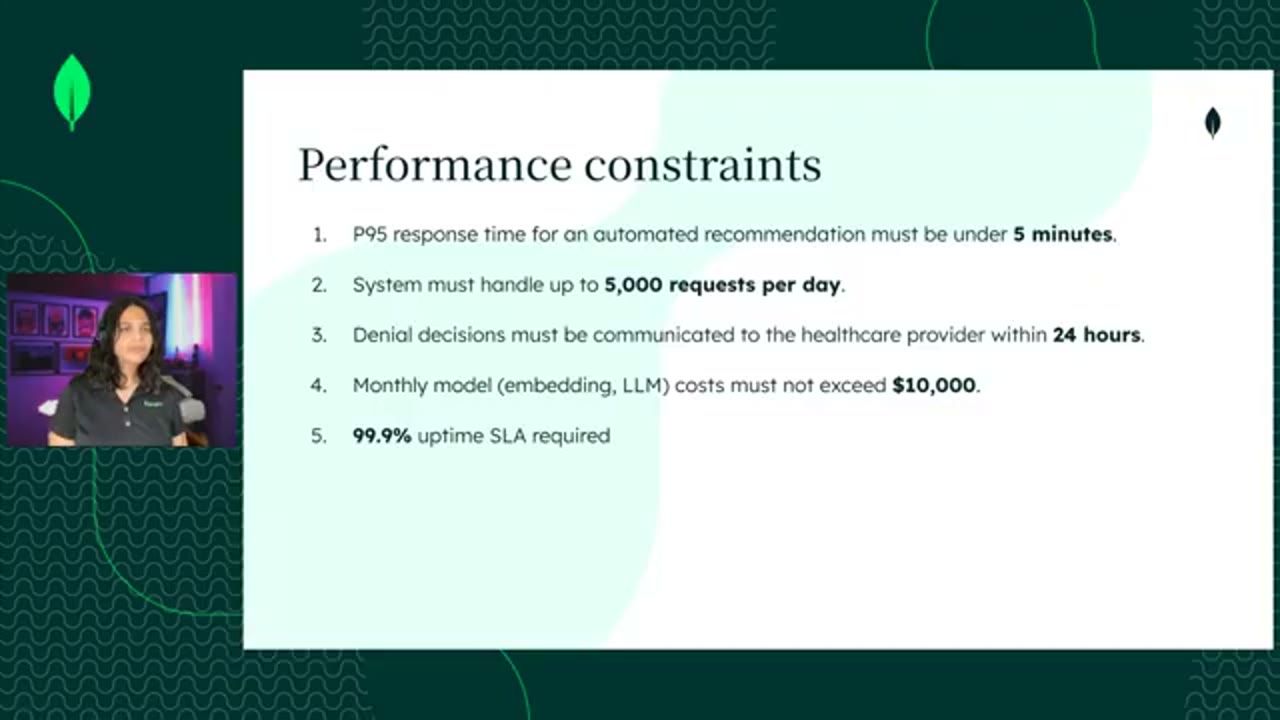
Cũng nên biết trước các performance requirement. Có cần response dưới một mili giây không, hay có chút khoảng thở? Mỗi tháng được chi bao nhiêu cho LLM inference? Có uptime SLA nào phải tuân thủ không?
6. Vai trò của AI và success metric
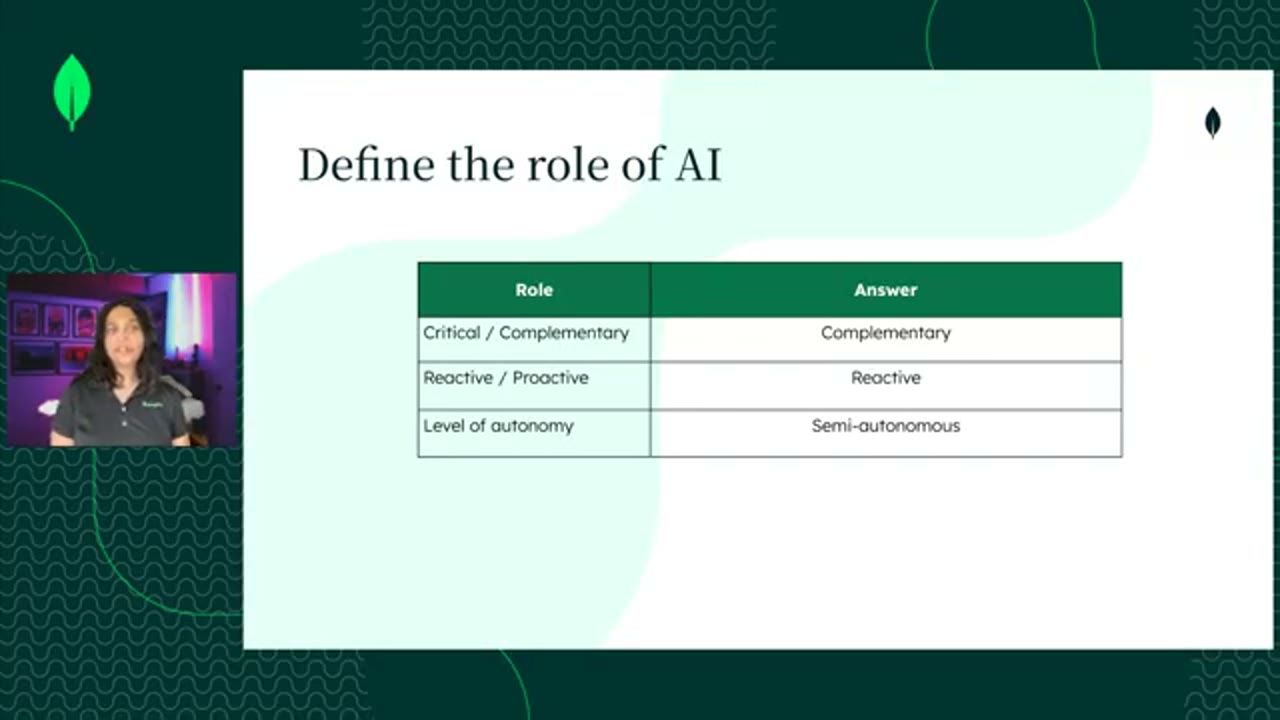
Nếu bạn đang xây một sản phẩm AI, việc xác định vai trò của AI trong sản phẩm rất có ích. Apoorva thích nghĩ về vai trò của AI theo ba chiều:
- Critical hay complementary? AI là phần sống còn của sản phẩm, hay chỉ bổ trợ? Ở đây là complementary, vì việc duyệt claim vẫn đang diễn ra mà không cần AI, chỉ là chậm hơn.
- Reactive hay proactive? Hệ thống được kích hoạt bởi người dùng hoặc một sự kiện, hay nó chủ động làm việc? Ở đây là reactive, vì nó được kích hoạt khi một hồ sơ claim thật sự được nộp.
- Mức độ autonomy của AI trong ứng dụng là bao nhiêu? Vì business constraint đã quy định phải có người duyệt trong một số ca, hệ thống tối đa chỉ có thể là semi-autonomous.
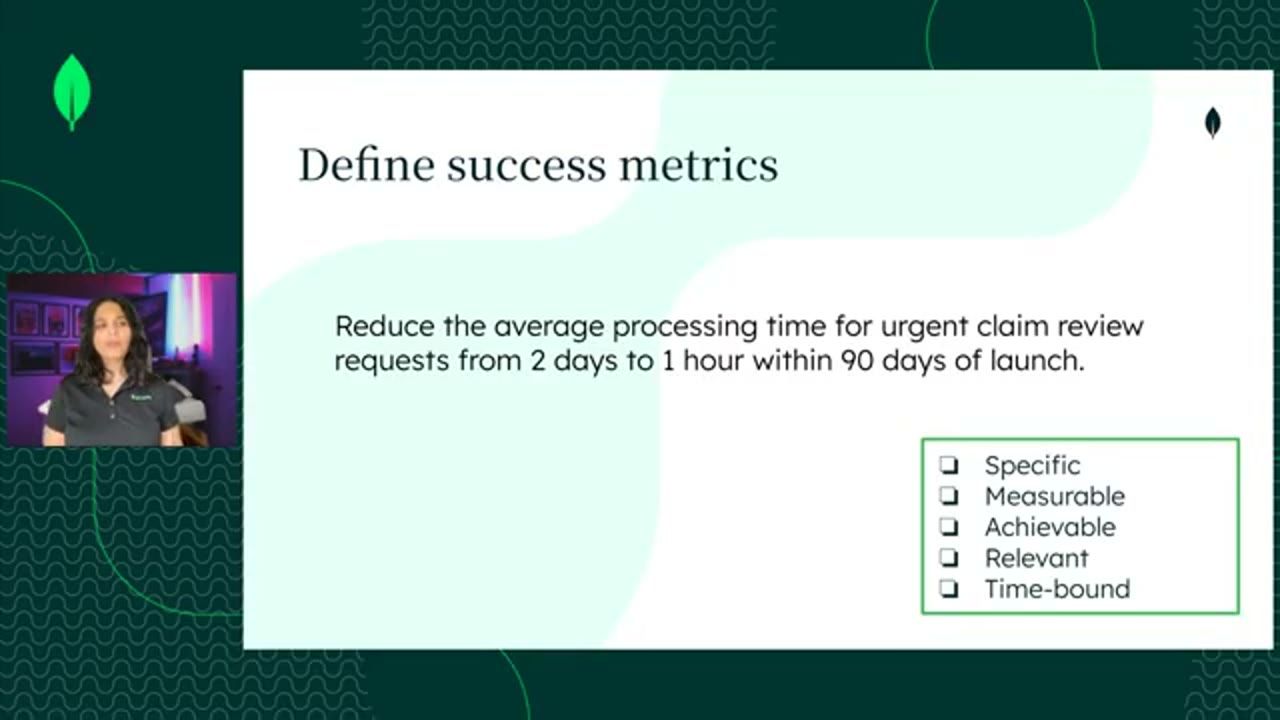
Cuối cùng, trong phần định nghĩa bài toán, bạn cần đặt ra một tới hai success metric gắn với business problem, để nắm được "thành công" trông như thế nào. Một success metric tốt là SMART: specific, measurable, achievable, relevant và time-bound.
Success metric cho ứng dụng duyệt claim:
Reduce the average processing time for urgent claim review requests from 2 days to 1 hour within 90 days of launch.
Tức là giảm thời gian xử lý trung bình của các yêu cầu duyệt claim khẩn cấp từ hai ngày xuống một giờ, trong vòng chín mươi ngày kể từ khi launch. Chị đi qua từng chữ cái:
- Specific: rất cụ thể.
- Measurable: nói rõ thời gian xử lý phải còn một giờ.
- Achievable: có vẻ đạt được, vì sẽ có AI trong vòng lặp, nên hy vọng mọi việc thu thập thông tin và việc đưa ra một đề xuất ban đầu sẽ nhanh hơn.
- Relevant: bám sát và bắt rễ từ business problem ở trên.
- Time-bound: cho một khung thời gian để bắt đầu thấy thành công.
7. Data strategy: nguồn dữ liệu, tần suất cập nhật, xử lý
Tới đây, phần "cái gì" (what) đã xong. Giờ sang phần "làm thế nào" (how), tức phase system design. Thứ đầu tiên cần nghĩ là data strategy. Ứng dụng của bạn cần dữ liệu gì? Bạn có quyền truy cập dữ liệu đó không? Nó nằm ở đâu? Nó đã sẵn sàng để dùng ở dạng thô chưa? Và vân vân.
Với ứng dụng duyệt claim, đây là các nguồn dữ liệu có thể cần, nơi chúng nằm, và định dạng truy cập thô của chúng:
- Clinical guidelines: mô tả cách chăm sóc nào là phù hợp với một bệnh trạng cụ thể.
- Coverage policy của MDB Health: nêu rõ MDB Health sẽ chi trả gì và không chi trả gì.
- Lịch sử claim của bệnh nhân: để biết các bệnh trạng trước đây, những thủ thuật đã làm, làm khi nào, và vân vân.
Giả sử clinical guideline và coverage policy được lưu dưới dạng PDF trong một thứ như Confluence, còn claim được lưu trong MongoDB ngay khi chúng được xử lý.
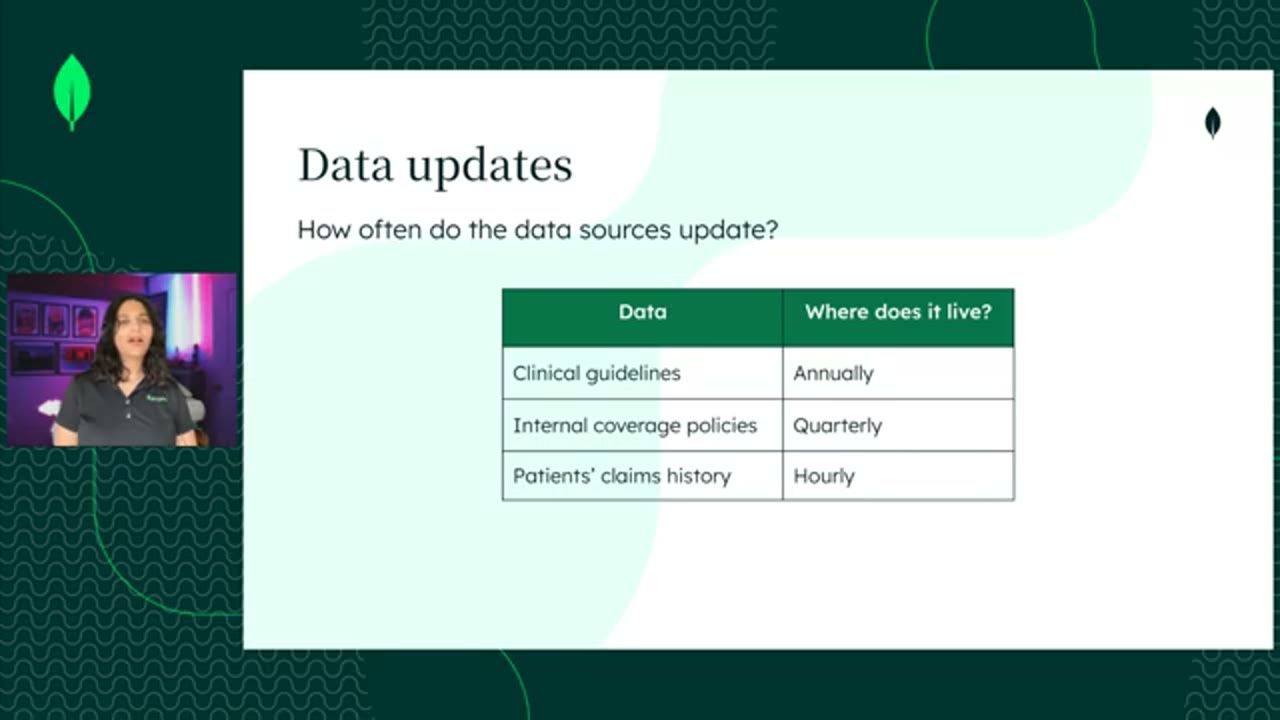
Thứ kế tiếp cần nghĩ là tần suất cập nhật dữ liệu: các nguồn dữ liệu thay đổi bao lâu một lần? Nếu bạn có bất kỳ bước xử lý dữ liệu nào trên các nguồn thô này, mà thường là có, thì các pipeline đó phải chạy đúng nhịp để theo kịp. Nếu không, hệ thống sẽ làm việc trên thông tin cũ, và điều đó không ổn, nhất là trong một use case rủi ro cao như thế này.
Với hệ thống duyệt claim: clinical guideline có lẽ cập nhật hằng năm; coverage policy nội bộ có thể hằng quý; còn lịch sử claim của bệnh nhân phải được cập nhật mỗi khi có một claim mới được xử lý. Và nhớ lại success metric: mục tiêu là xét duyệt các claim khẩn cấp trong khung một giờ. Vậy nên lịch sử claim nhiều khả năng sẽ được cập nhật hằng giờ.
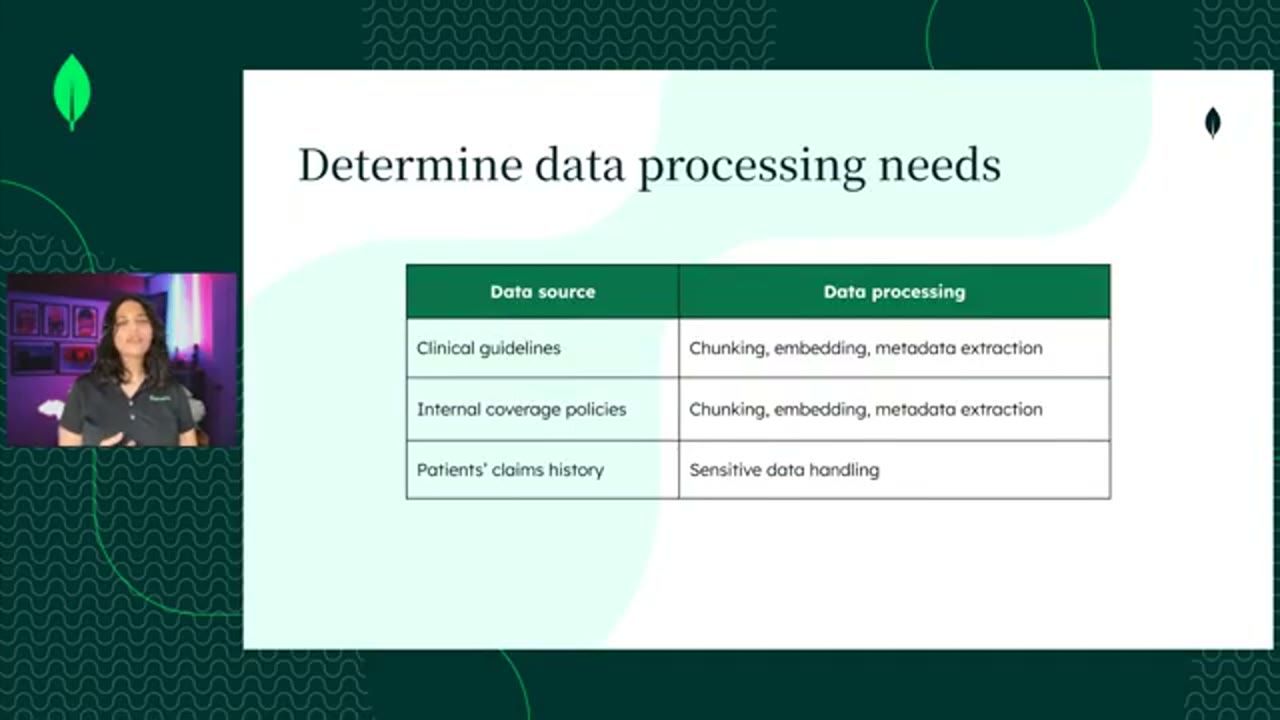
Tiếp theo: dữ liệu có dùng thẳng được trong ứng dụng không, hay cần xử lý? Clinical guideline thường là những tài liệu dài, nên bạn có lẽ muốn chunk chúng, embed các chunk, và trích metadata như tên thủ thuật, ngày công bố, để chúng phù hợp cho retrieval bằng vector search hoặc hybrid search. Coverage policy cũng vậy. Còn lịch sử claim của bệnh nhân, vốn đã được định dạng gọn gàng và lưu sẵn trong MongoDB, có lẽ chỉ cần loại bỏ thông tin định danh cá nhân (PII) trước khi đưa cho LLM.
8. Chọn kỹ thuật retrieval cho từng nguồn
Bước tiếp theo là nghĩ xem kỹ thuật retrieval nào hợp nhất với từng nguồn dữ liệu. Thật ra bạn đã bắt đầu nghĩ về chuyện này ngay từ bước xử lý dữ liệu, nhưng nên chính thức hoá nó.
Clinical guideline và coverage policy rất hợp với vector search. Nhưng chúng có thể chứa thuật ngữ y khoa như diagnosis code (mã chẩn đoán) và procedure code (mã thủ thuật), những thứ mà vector search có thể bỏ lỡ. Các mã này lại được bắt tốt bởi metadata filter hoặc keyword search. Vì vậy với hai nguồn này, bạn nên dùng vector search có metadata pre-filtering, hoặc dùng hybrid search.
Còn để lấy lịch sử claim của bệnh nhân, chỉ cần exact match trên tên hoặc ID bệnh nhân, tuỳ định danh nào hệ thống đang dùng.
9. Lần theo một hồ sơ từ lúc nộp tới lúc ra quyết định
Tiếp theo là nghĩ xem kiến trúc hệ thống trông ra sao. Rất dễ bị cám dỗ nhảy thẳng vào xây một agent, vì đang có quá nhiều hype quanh agent, hoặc để một coding agent tự quyết kiến trúc hệ thống. Nhưng làm vậy, bạn có nguy cơ kết thúc với một hệ thống over-engineered. Điều nên làm là bắt đầu với thiết kế đơn giản nhất, evaluate nó, tìm ra lỗ hổng trong lúc evaluate, rồi iterate từ đó.
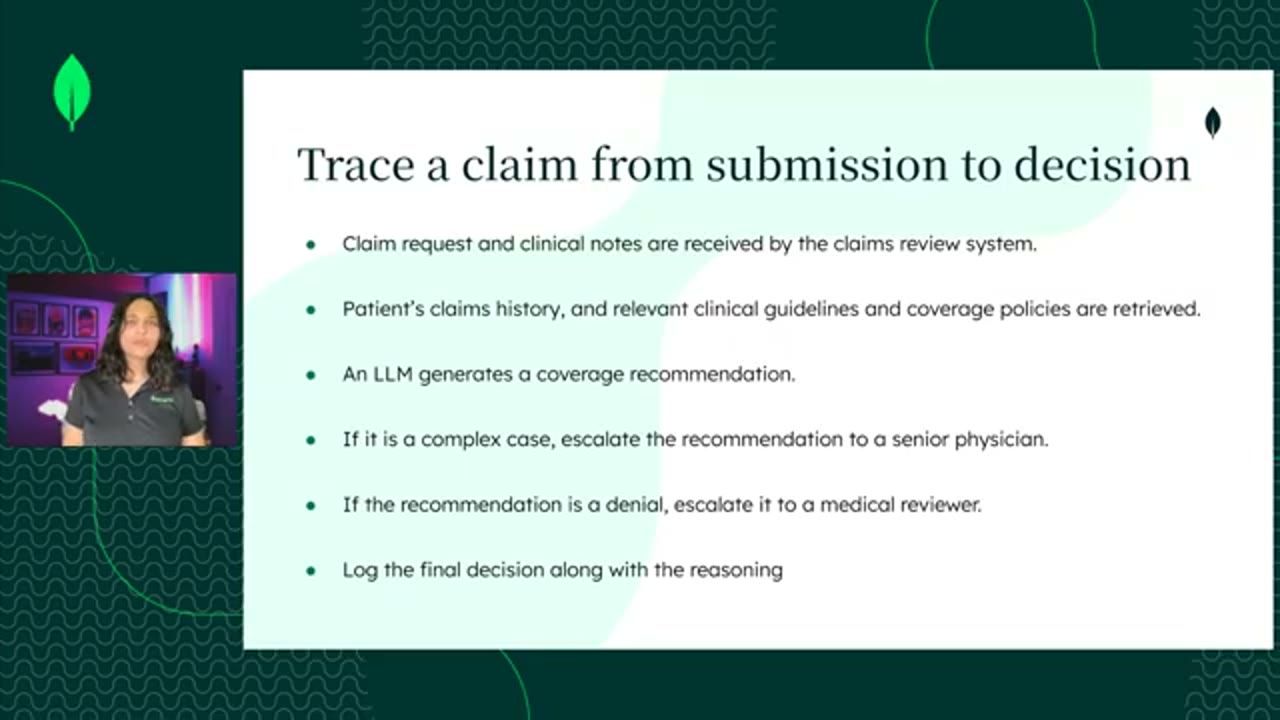
Để quyết định hệ thống trông thế nào, trước hết hãy vẽ ra một claim bảo hiểm đi qua hệ thống ra sao, vì việc đó sẽ định hình kiến trúc:
- Hệ thống nhận yêu cầu claim cùng mọi ghi chú lâm sàng (clinical notes) của bác sĩ.
- Hệ thống truy xuất các clinical guideline và coverage policy liên quan tới claim hiện tại, đồng thời lấy lịch sử claim của bệnh nhân.
- Toàn bộ thông tin đó, cùng với chính claim và các system prompt hướng dẫn LLM cách đưa ra đề xuất, được đưa cho LLM. LLM dùng chúng để tạo ra một đề xuất: claim nên được duyệt hay bị từ chối.
- Nếu là ca phức tạp, hệ thống, hay chính LLM ở bước này, gửi đề xuất ban đầu cho một senior physician.
- Nếu đề xuất của LLM là từ chối claim, nó cũng phải được chuyển lên một human medical reviewer.
- Cuối cùng, quyết định sau cùng được ghi vào MongoDB, nơi đang lưu các document claim, kèm lý do vì sao claim được duyệt hay bị từ chối.
10. Các AI design pattern phổ biến
Trước khi chọn kiến trúc, Apoorva điểm qua những AI design pattern phổ biến nhất trong các hệ thống AI hiện nay, rồi xem pattern nào áp được vào hệ thống của mình.
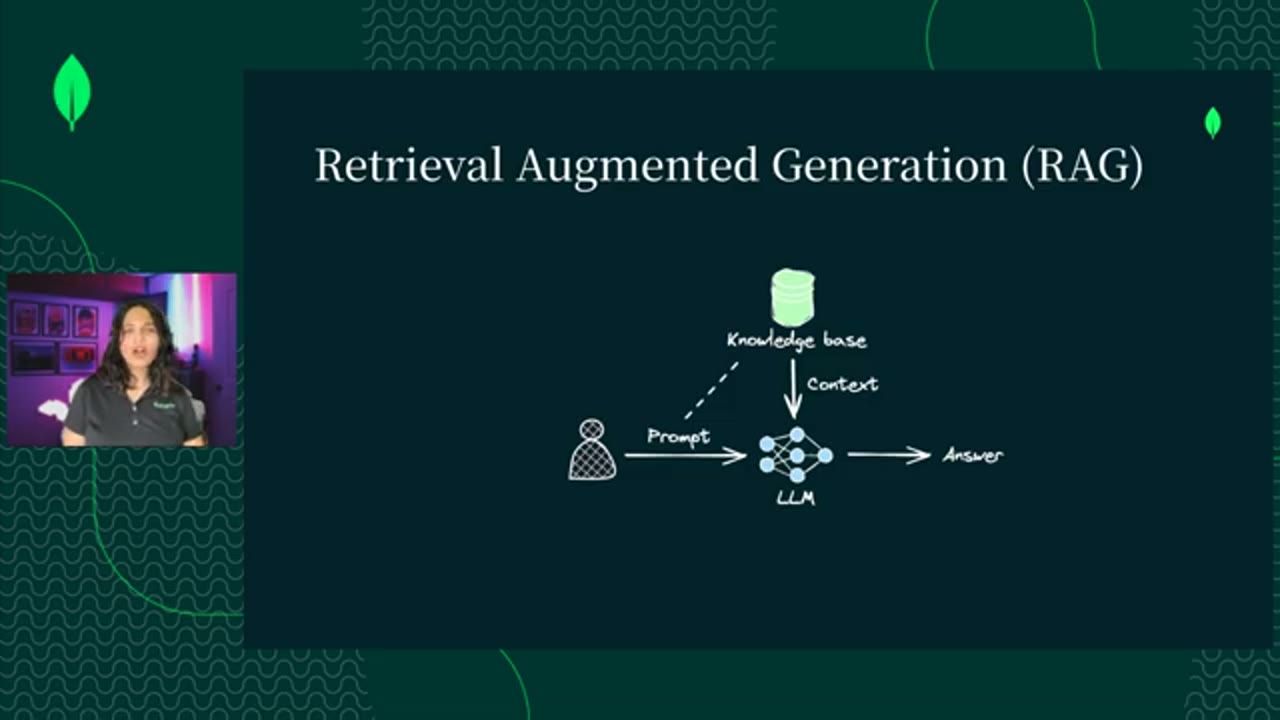
RAG, viết tắt của Retrieval-augmented generation. Chị đoán tới giờ ai cũng biết rồi. Về cơ bản, trong các hệ thống này, bạn chỉ đơn giản là bổ sung kiến thức có sẵn từ lúc pre-train của LLM bằng thông tin lấy từ các nguồn kiến thức bên ngoài.
AI agent: bạn trao cho một LLM, hoặc nhiều LLM trong trường hợp multi-agent system, toàn quyền tự chủ để hoàn thành công việc end-to-end với sự trợ giúp của một bộ tool.
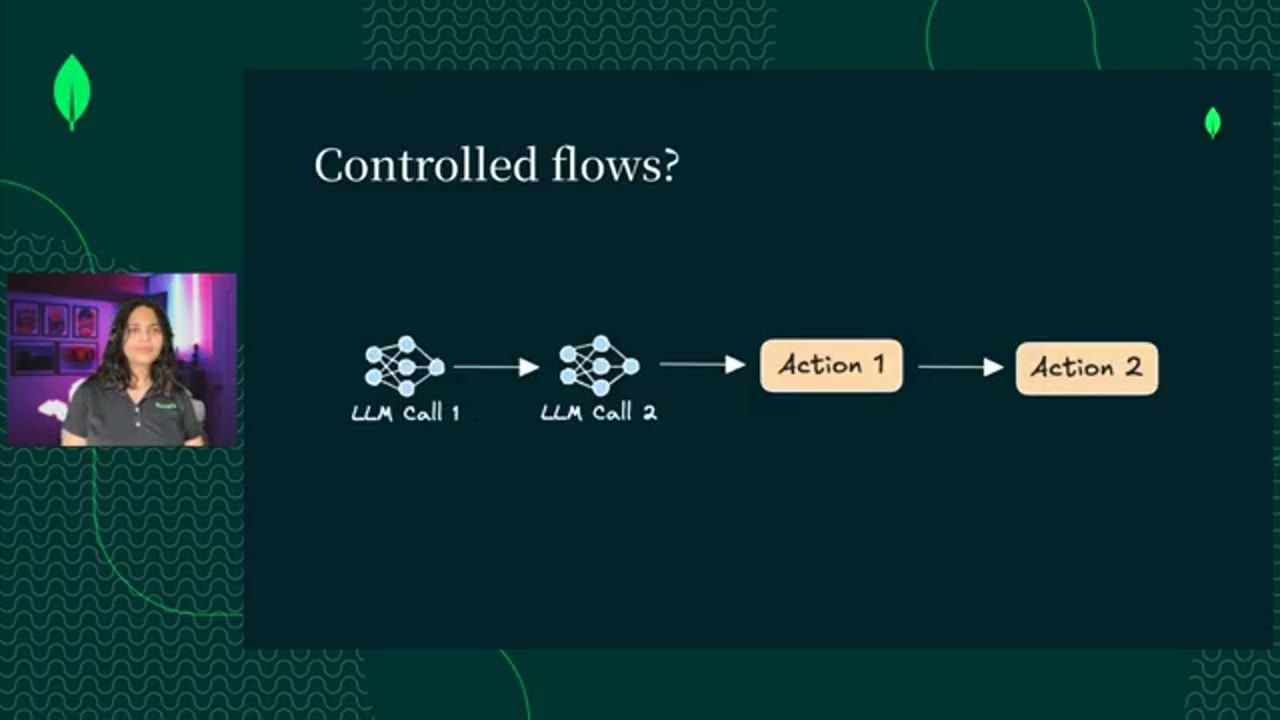
Agentic system: phủ một dải rộng các hệ thống AI semi-autonomous. Một kiến trúc phổ biến cho loại hệ thống này là control flow: LLM thực hiện một số tác vụ bên trong workflow, nhưng chính thứ tự các bước trong workflow đã được định sẵn bởi thiết kế hoặc bởi code.
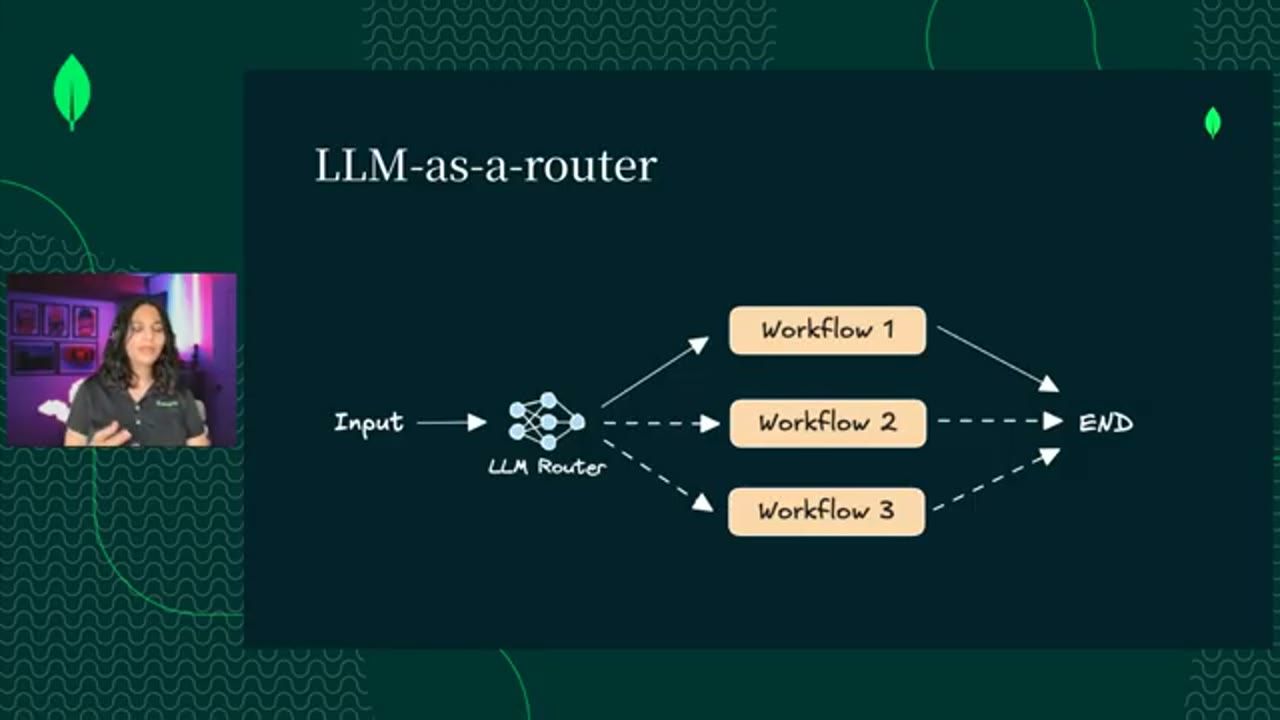
LLM-as-a-router: LLM chỉ có autonomy hạn chế, việc của nó đơn giản là phân loại các request đi vào và route chúng sang những workflow khác nhau ở phía sau.
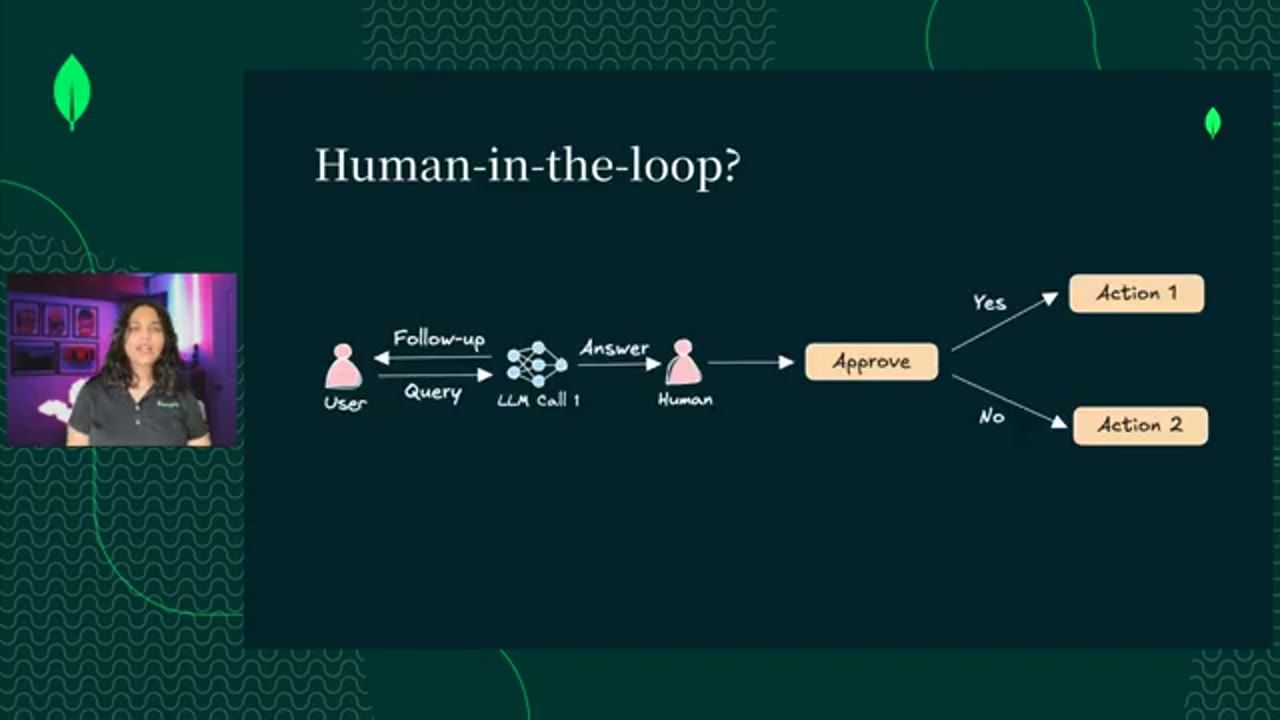
Human-in-the-loop: một LLM hoặc agent có thể làm một số hành động, nhưng cần con người can thiệp ở đâu đó trong quy trình.
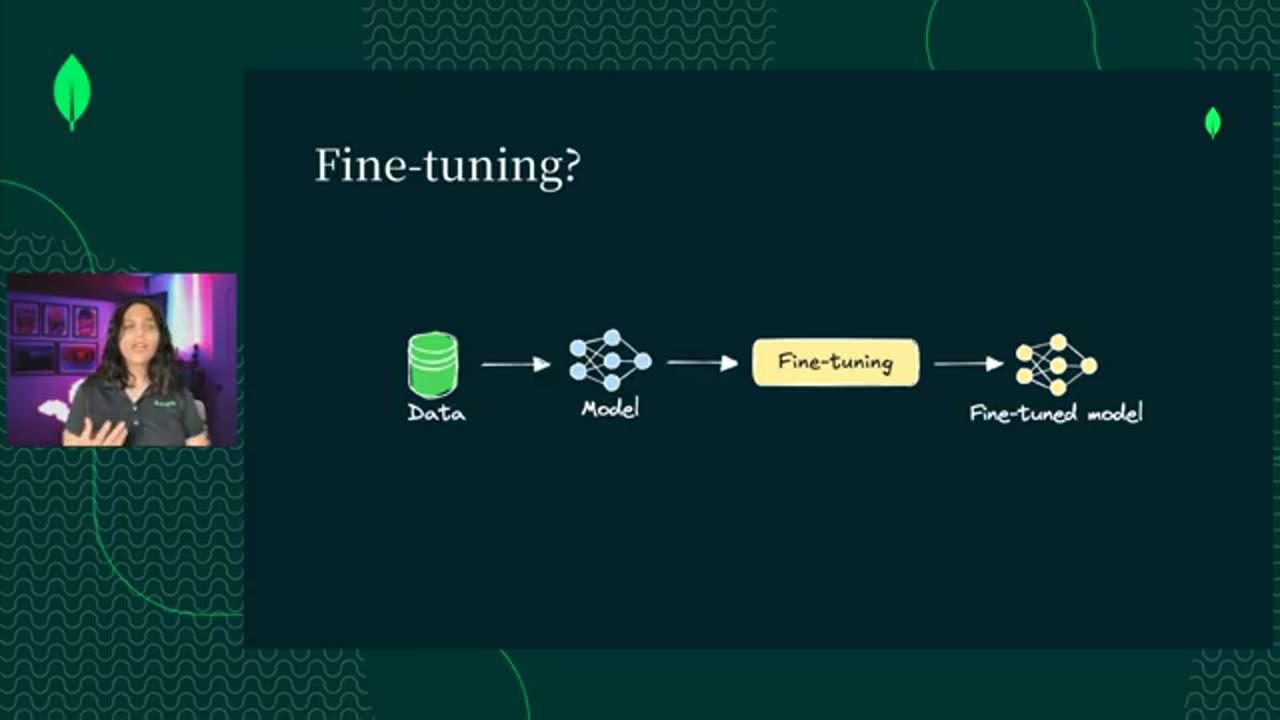
Cuối cùng là fine-tuning. Nếu bạn thấy lỗi của LLM thuộc về hành vi (behavioral), chứ không phải do dữ liệu hay do orchestration, hoặc bạn cần hiệu năng vượt trội trên một tác vụ chuyên ngành, thì fine-tuning là kỹ thuật đáng thử.
Chị không có thời gian đi sâu vào từng pattern trong talk này, nên để lại một tài nguyên cho ai muốn tìm hiểu thêm về các design pattern: bài Agentic Design Patterns của MongoDB (link rút gọn trên slide là mdb.link/agentic-design-patterns). Trang talk chính thức cũng liệt kê trong phần tài nguyên bài Building effective agents của Anthropic, bàn về workflow, routing và agent.
11. Pattern nào hợp với hệ thống duyệt hồ sơ
Đã nghĩ xong workflow của hệ thống, đã điểm qua vài AI design pattern, giờ áp chúng vào để quyết định hệ thống cần cài đặt những pattern nào.
Vì cần truy xuất clinical guideline, coverage policy và những thứ tương tự để làm căn cứ cho quyết định, đây rõ ràng là một thành phần RAG. Vậy hệ thống cần RAG dưới một dạng nào đó.
Workflow khá có cấu trúc: LLM trước tiên đưa ra đề xuất duyệt hay từ chối một claim, và trong những ca rất cụ thể, đã định nghĩa rõ, nó phải chuyển claim lên human reviewer. Nghe giống một controlled workflow.
Bạn cũng có thể lập luận rằng nó hơi giống LLM-as-a-router, nhất là nếu bạn dùng thêm một lần gọi LLM để quyết định thế nào là một ca phức tạp, trừ khi điều đó đã được định nghĩa rõ từ trước. Vậy đây có thể là LLM-as-a-router, nhưng tạm thời cứ chọn control flow.
Và cuối cùng có cả một yếu tố human-in-the-loop, vì human reviewer là một phần thật sự của workflow.
12. UX và cơ chế feedback
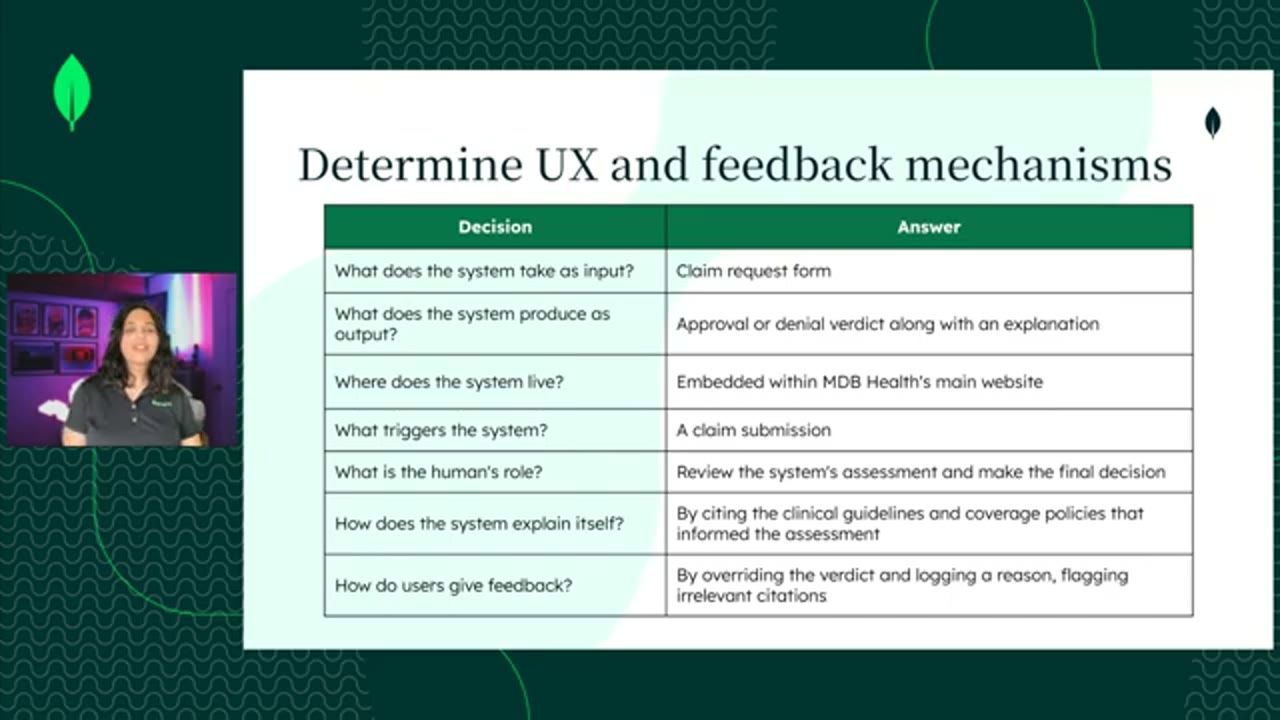
Cũng trong phase thiết kế, bạn cần nghĩ về trải nghiệm của người dùng cuối, và cách thu feedback từ người dùng để cải thiện hệ thống. Apoorva đưa ra một bộ câu hỏi để tự hỏi ở bước này, kèm câu trả lời cho hệ thống duyệt claim:
- Hệ thống nhận input gì? Một form yêu cầu claim dưới dạng nào đó.
- Hệ thống tạo ra output gì? Một phán quyết duyệt hoặc từ chối, kèm lời giải thích vì sao claim được duyệt hay bị từ chối.
- Hệ thống nằm ở đâu? Một app độc lập? Nhúng vào một website có sẵn? Một Slack bot? Với ứng dụng này, nhiều khả năng nó được nhúng vào website chính của MDB Health.
- Cái gì kích hoạt hệ thống? Rất rõ ràng: một lần nộp claim.
- Vai trò của con người là gì? Họ review đánh giá của hệ thống, và trong một số ca thì đưa ra quyết định cuối cùng.
- Hệ thống tự giải thích ra sao? Bằng citation: trích dẫn các clinical guideline và coverage policy đã làm căn cứ cho đánh giá.
- Người dùng gửi feedback thế nào? Nhớ rằng người dùng ở đây là medical reviewer. Họ có thể feedback bằng cách override phán quyết của LLM và ghi lại lý do. Có thể cho họ đánh dấu (flag) cả những citation không liên quan: nếu LLM đang hallucinate ra guideline và policy, hoặc trích sai cái cho một claim cụ thể, thì họ có thể flag lại.
13. Chọn tech stack
Tới đây kiến trúc đã được quyết, nhưng còn phải quyết stack trông ra sao. Một lần nữa, rất dễ bị cám dỗ để một coding agent đề xuất dùng tool nào. Nhưng những gợi ý đó chưa chắc áp dụng được cho hệ thống của bạn, hoặc bạn có thể không được phép dùng chúng vì các constraint đã xác định ở phase product requirements. Ví dụ ở đây có constraint rằng model phải được cloud provider của mình hỗ trợ, và những thứ tương tự.
Apoorva nói chị sẽ không đi sâu vào phần này, vì các constraint trong ví dụ, nói cho cùng, là giả định. Chị chỉ muốn nhắc rằng đây là bước kế tiếp, và liệt kê các quyết định tooling phải làm:
- Dùng model nào.
- Tool xử lý dữ liệu: có khá nhiều tool có sẵn năng lực xử lý dữ liệu out-of-the-box rất tốt.
- Nếu hệ thống có retrieval và bạn dùng vector search: chọn embedding model nào, vector database nào.
- Orchestration framework, và vân vân.
14. Evaluation, monitoring và guardrails
Sang phase thứ ba: evaluation and monitoring. Làm sao biết thứ mình đã xây chạy được, trước và cả sau khi ship? Evaluation là phần trước khi ship, monitoring là phần sau khi ship, và bạn cần cả hai.
Nhưng trước khi vào evaluation metric, Apoorva nói về guardrail, vì đây gần như không phải chủ đề gì trước thời LLM. Lý do guardrail trở thành đề tài bàn luận: khác với phần mềm truyền thống, hệ thống dựa trên LLM là hệ thống xác suất (probabilistic), có thể tạo ra output bất ngờ, sai, thậm chí có hại. Guardrail là nỗ lực giảm thiểu những rủi ro đó và bảo đảm hệ thống hành xử trong những ranh giới chấp nhận được. Và ranh giới đó là gì, bạn phải tự định nghĩa.
- Với input, mục tiêu thường là phát hiện input không hợp lệ, không liên quan, hoặc có hại. Với hệ thống duyệt claim, một input như "Write me a poem" (viết cho tôi một bài thơ) là không liên quan, và hệ thống nên từ chối nó.
- Với output, mục tiêu là phát hiện output không hợp lệ, sai, hallucinate, hoặc có hại. Với ứng dụng này, một response bị coi là không hợp lệ nếu hệ thống không đưa citation cho những gì đã làm căn cứ cho việc duyệt hay từ chối.
15. Offline evaluation metrics
Guardrail compliance không phải thứ duy nhất cần đo. Bạn còn muốn đo chất lượng response, tạo và đo các metric accuracy riêng cho domain, và đo sức khoẻ chung của hệ thống. Với hệ thống duyệt claim, Apoorva đặt mỗi loại một metric:
- Input guardrail compliance: claim rejection rate, hệ thống từ chối claim bao nhiêu lần vì chúng không tuân thủ input guardrail. Nếu nó từ chối quá nhiều, đó là tín hiệu phải điều tra. Nhưng nếu ngay từ đầu bạn không đo, thì bạn chẳng có gì để điều tra cả. "Đấy, đó là lý do bạn cần metric."
- Output guardrail compliance: missing citation rate, LLM tạo ra response không có citation bao nhiêu lần.
- Response quality: faithfulness, tức việc duyệt hay từ chối claim có thật sự bắt rễ từ thông tin đã truy xuất (clinical guideline và policy) hay không.
- Domain-specific: nên định nghĩa ít nhất một metric riêng cho domain hay ứng dụng. Ở đây, claim processing time có thể là một lựa chọn tốt, vì đó chính là north star.
- System-level: thường xoay quanh sức khoẻ tổng thể của hệ thống, như token cost trung bình, token usage, số lượt trung bình trong một cuộc hội thoại. Để không thêm một metric latency nữa, chị chọn cost per recommendation, chi phí cho mỗi đề xuất.
16. Monitoring sau khi ship
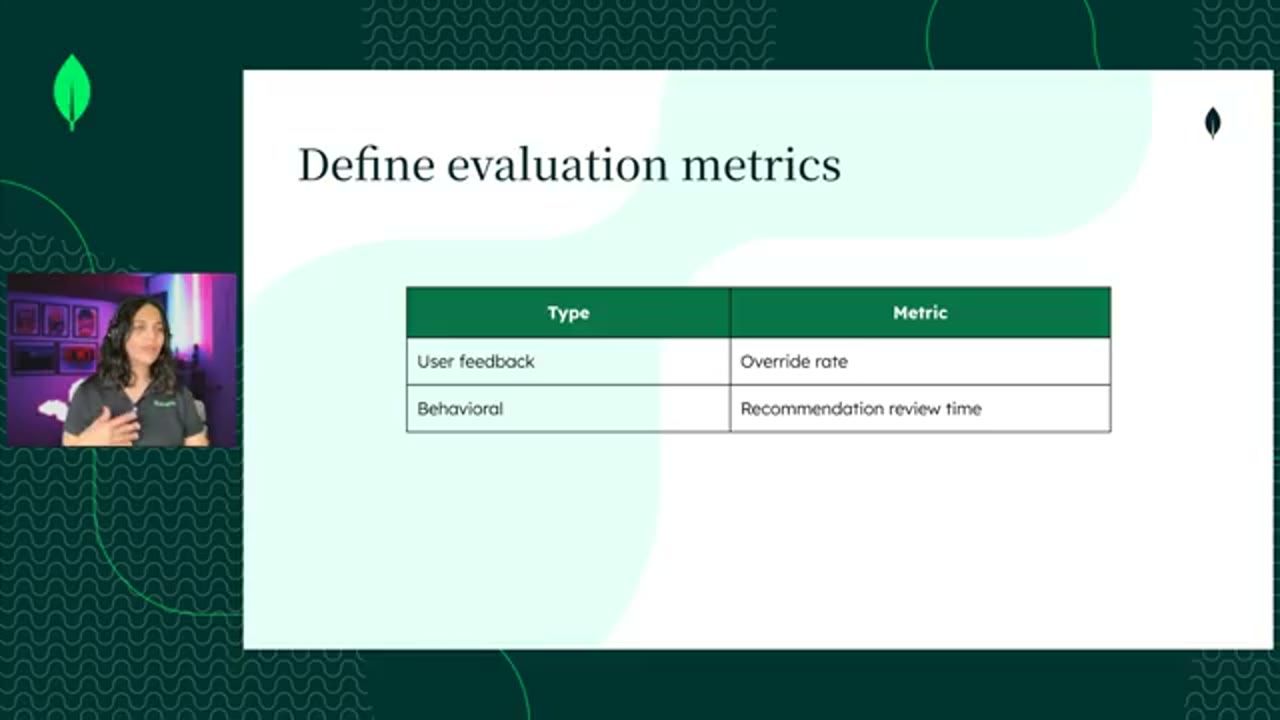
Khi đã evaluate hệ thống và ship sản phẩm tới tay người dùng, tới lượt monitoring: theo dõi hệ thống để bắt regression theo thời gian thực. Trong production, bạn vẫn muốn theo dõi các metric đã dùng cho offline evaluation ở trên. Nhưng bạn còn có thể theo dõi thêm những metric đóng vai trò chỉ báo ngầm (implicit indicator) cho mức độ thành công của sản phẩm, cho việc người dùng hài lòng với sản phẩm tới đâu, và cho sức khoẻ tổng thể của hệ thống.
Với ứng dụng duyệt claim, có hai ví dụ:
- Override rate: human reviewer override phán quyết của AI thường xuyên tới mức nào. Bạn muốn tỷ lệ này thấp, vì nếu nó cao thì nghĩa là hệ thống không làm được việc của nó. Nếu có lúc bạn thấy nó tăng vượt một ngưỡng nhất định, bạn cần vào điều tra.
- Recommendation review time: một người mất bao lâu để review đề xuất của AI. Nếu mất quá lâu, điều đó có thể nghĩa là các response dài dòng, hoặc khó hiểu.
Đây là những chỉ báo tốt để theo dõi khi sản phẩm đã lên production.
17. Production readiness: accuracy, cost, latency, reliability
Giả sử bạn đã có một prototype chạy được, đã evaluate, accuracy trông ổn. Tới lúc lên production rồi, đúng không? Khoan: còn cost, latency và reliability thì sao? Những ràng buộc này trở nên tuyệt đối không thể thương lượng khi bạn đưa sản phẩm lên production. Nên giữa lúc "accuracy trông ổn" và lúc "lên production", có thể bạn còn phải làm thêm vài vòng iterate, evaluate và test nữa. Apoorva điểm qua kỹ thuật tối ưu cho từng mặt.
Tối ưu accuracy
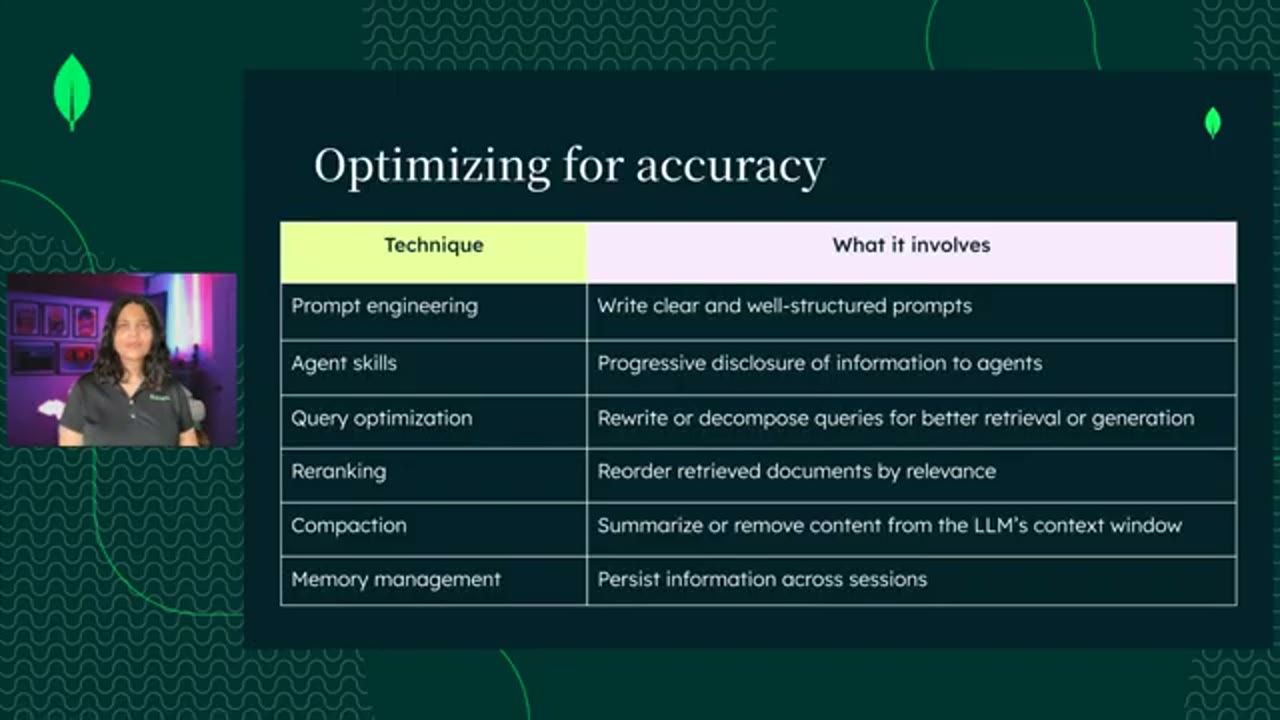
Trong các ứng dụng dựa trên LLM, tối ưu accuracy rốt cuộc là tối ưu thông tin nào lọt vào context window của LLM. Chị để bảng kỹ thuật lại cho người nghe tham khảo sau, và chỉ nói nhanh kỹ thuật nào hợp với ứng dụng duyệt claim:
- Prompt engineering, tất nhiên.
- Reranking là một lựa chọn tốt, vì retrieval là một thành phần lớn của hệ thống. Một reranker bảo đảm thông tin được truy xuất hiện ra đúng thứ tự mức độ liên quan, điều quan trọng khi làm việc với LLM.
- Memory: hệ thống đã lưu lịch sử bệnh nhân vào MongoDB, nên ứng dụng đã có một dạng memory. Nhưng bạn cũng có thể nghĩ thêm về những loại thông tin khác đáng lưu lại qua các phiên.
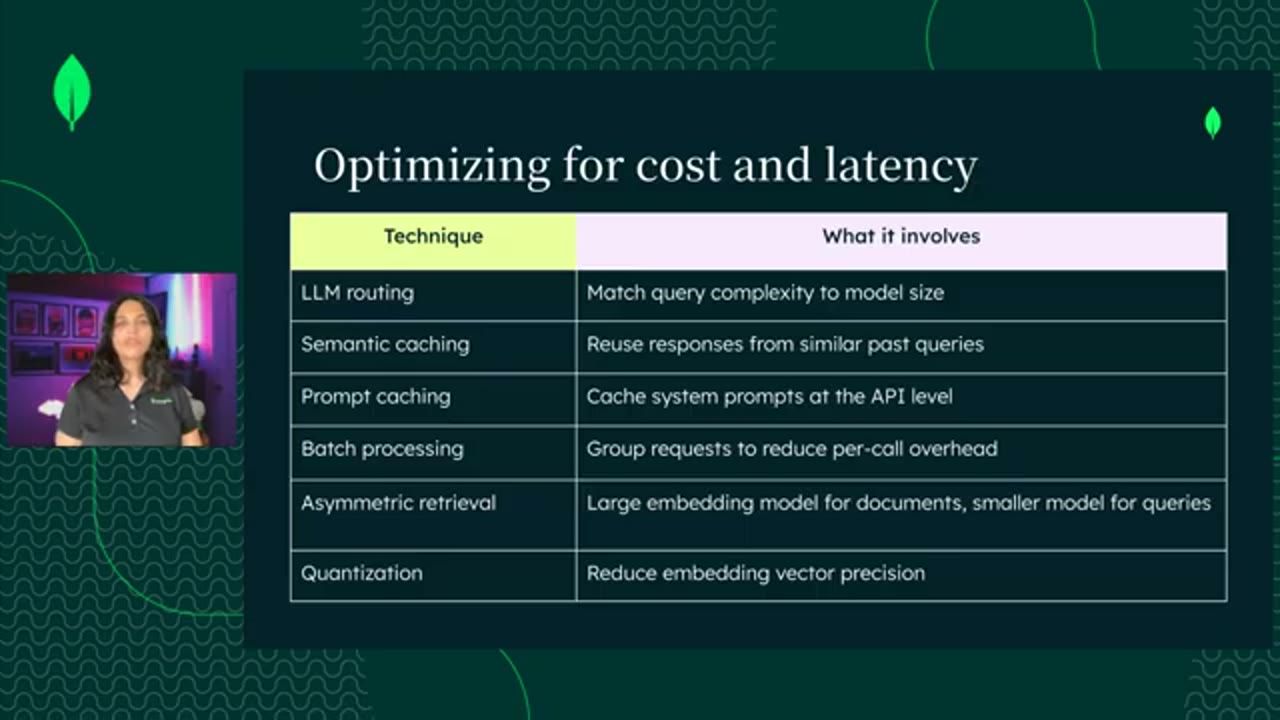
Tối ưu cost và latency
Với use case này, semantic caching có thể hữu ích để đẩy nhanh quyết định dựa trên những claim tương tự trong quá khứ. Batch processing cũng có thể dùng, để xử lý claim theo lô thay vì từng cái một.
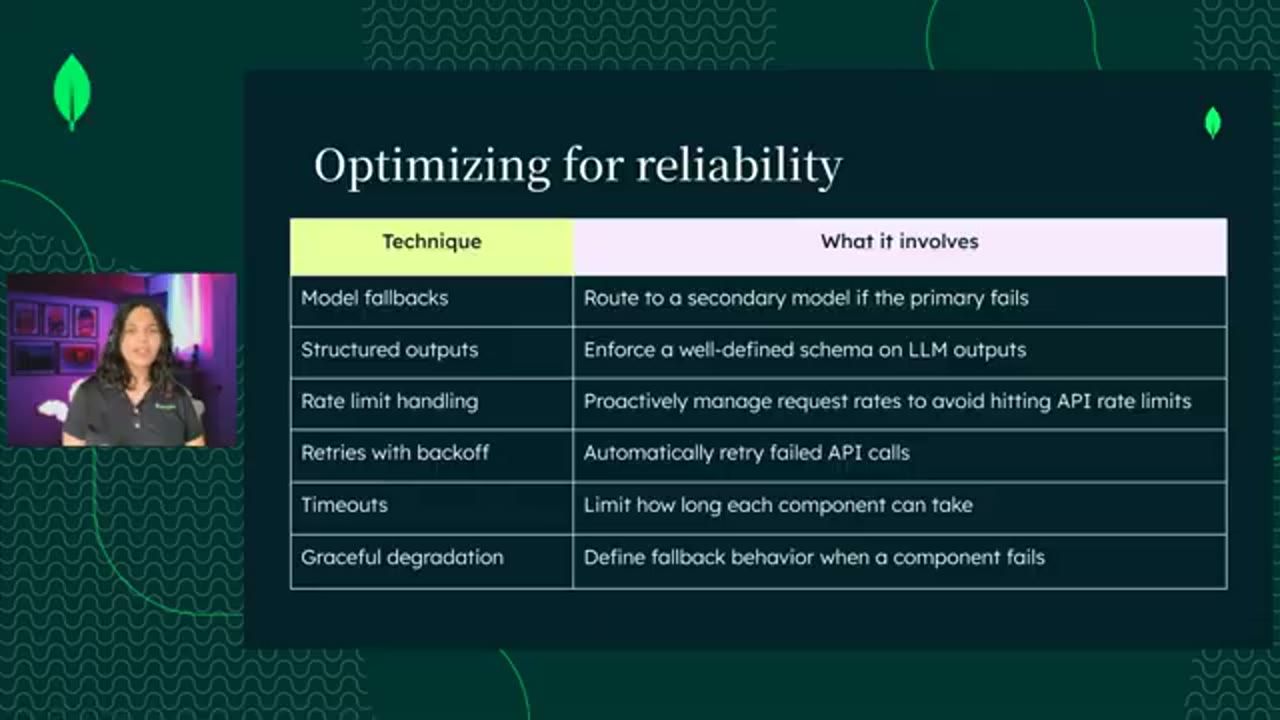
Tối ưu reliability
Phần lớn kỹ thuật trong bảng reliability đều hữu ích cho use case này, vì chúng chủ yếu xử lý chuyện API lỗi. Nhưng Apoorva muốn nhấn riêng structured outputs: đây là cách tốt để bảo đảm hệ thống luôn tạo ra một output có cấu trúc, chứa không chỉ quyết định mà cả các citation. Điều này nối thẳng về output guardrail ở phần trước: response thiếu citation là không hợp lệ.
18. Ba điều mang về
Talk tới đây là hết, nhưng Apoorva để lại vài takeaway.
Thứ nhất: nghĩ thật kỹ về requirement của sản phẩm trước khi để AI sinh ra bất kỳ dòng code nào. Product spec bây giờ mới là phần khó, không còn là code nữa. Latency budget, mức trần chi phí, mọi yêu cầu regulatory, tất cả đều định hình mọi quyết định kiến trúc phía sau. Vậy nên hãy xác định business constraint và performance constraint trước khi bắt đầu thiết kế ứng dụng.
Thứ hai: thiết kế hệ thống đơn giản nhất đáp ứng được nhu cầu. Evaluate nó, rồi iterate từ đó. Lỗi phổ biến nhất chị thấy là over-engineer giải pháp trước khi biết cái gì thật sự đang hỏng, hoặc thậm chí không hề evaluate xem cái gì đang hỏng.
Thứ ba, và điều này dẫn về evaluation: xây evaluation ngay từ đầu. Bạn không thể cải thiện thứ bạn không đo được.
Chị để lại link tới GenAI Cookbook của MongoDB, nơi có rất nhiều ví dụ về các kỹ thuật retrieval khác nhau, các agentic design pattern, và một số kỹ thuật evaluation và optimization chị đã nói trong talk. Rồi chị cảm ơn mọi người đã dành thời gian nghe, và hẹn gặp ở hội nghị.
Nguồn và liên kết
- Trang talk trên ai.engineer · Video gốc
- GenAI-Showcase: repo ví dụ GenAI của MongoDB (GenAI Cookbook), gồm RAG, agentic pattern, evaluation
- Agentic Design Patterns: bài tổng quan về agentic system của MongoDB, tài nguyên chị để lại ở phần design pattern
- Anthropic: Building effective agents, về workflow, routing và agent
- MongoDB Vector Search: hybrid search
- Voyage AI: embedding model và reranker, thuộc MongoDB
- GitHub của Apoorva Joshi
Related talks
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
Agents in Production: How OpenGov Built and Scaled OG Assist
Gabe De Mesa · OpenGov · 19 min
OpenGov chạy OG Assist trong production: agent loop Effect-native thay LangGraph, A2A, evals, human approval, sandbox, rolling summary và tracing.