Skill-creator mới: test, đo và tối ưu Claude skill
Skill-creator mới của Anthropic: hai loại skill, chạy evals và A/B test mù có/không skill, benchmark, tối ưu description để skill trigger ổn định.
✓ Đã duyệt độc lập · cập nhật 09/10/2026 · 13 min
1. Anthropic nâng cấp skill-creator
Ray Amjad mở đầu bằng tin chính của video: Anthropic vừa làm cho việc tạo skill tốt hơn trở nên dễ hơn nhiều, cả cho Claude Code lẫn cho Cowork. Toàn bộ video là để đi qua những thay đổi đó.
Trước khi vào nội dung, anh nhắc nhanh rằng khoá học Claude Code của anh đang giảm giá nhân dịp Claude Code tròn một tuổi.
Theo bài blog, những cập nhật này có sẵn trong Claude.ai và Cowork, dưới dạng plugin cho Claude Code, và trong repo skill chính thức của Anthropic. Ý chính là mang một phần sự chặt chẽ của phát triển phần mềm (testing, benchmarking, cải tiến lặp lại) vào việc viết skill, mà không bắt ai phải viết code.
2. Vấn đề: viết skill theo cảm tính
Hiện nay, theo Ray, phần lớn mọi người phát triển Claude skill hoàn toàn dựa trên "vibes", tức cảm giác. Cách làm quen thuộc là thế này: họ đi qua một quy trình một lần cùng Claude Code, rồi nói "này, biến cái này thành một skill đi". Có thể họ đưa thêm tài liệu tham khảo, như một bài blog, một tài liệu nội bộ hay thứ gì đó khác, để Claude viết skill tốt hơn. Sau đó họ thử skill vài lần cho chắc là nó chạy, thấy "ừ, có vẻ ổn", rồi ship cho cả team dùng hoặc đưa lên mạng.
Ray công nhận nhiều người đã làm ra những skill rất tốt theo cách này, ví dụ repo marketing skills trên GitHub mà anh mở trên màn hình. Nhưng cách đó có vài vấn đề.
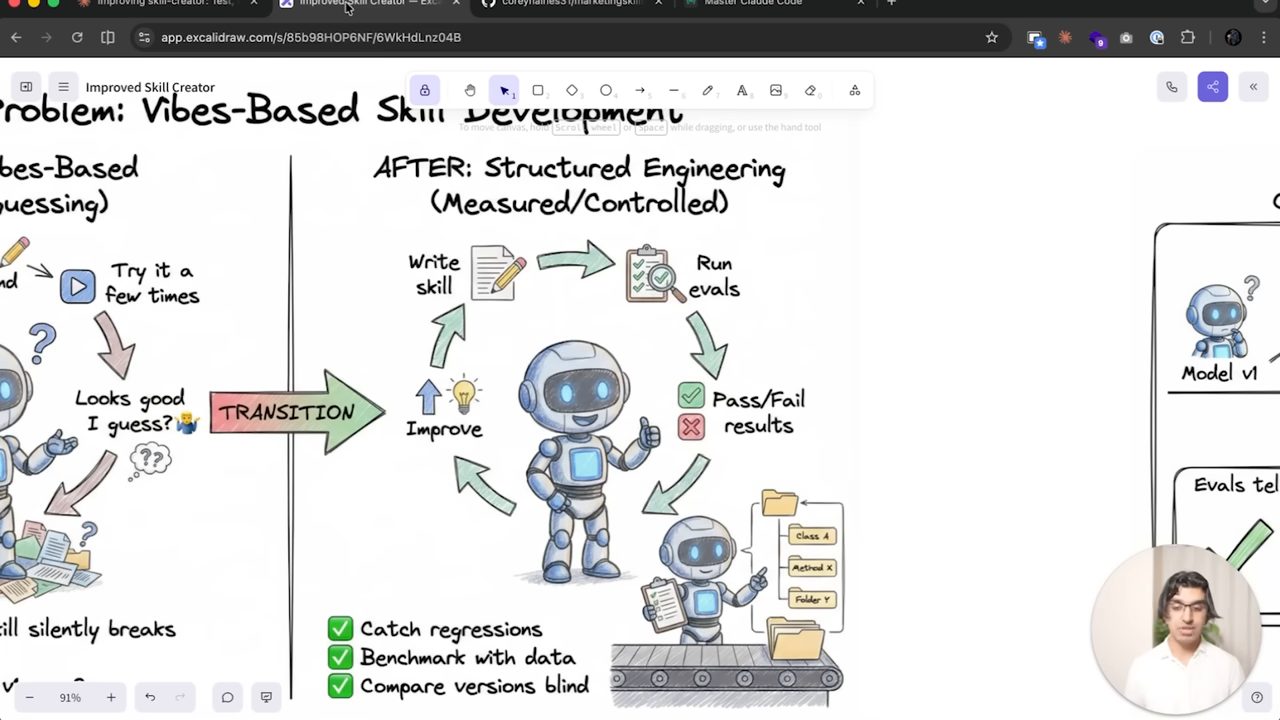
Vấn đề thứ nhất: mỗi khi có một model mới, rất có thể skill của bạn không còn giúp gì cho Claude Code nữa. Lý do là nhiều ý tưởng và chức năng bạn đã nhét vào skill nay đã nằm sẵn trong model, hoặc model tự làm còn tốt hơn skill. Khi đó, việc gọi skill lại kìm model lại, không để nó phát huy hết khả năng thật.
Vấn đề thứ hai: hiện bạn không thực sự biết một thay đổi trong skill có làm output tốt hơn hay không. Bạn sửa một dòng, thử lại, và chỉ có cảm giác.
3. Skill-creator mới làm được gì
Điều Anthropic làm là cải tiến hàng loạt skill skill-creator của họ (một skill dùng để tạo skill). Bản mới giúp bạn viết skill dễ hơn, kiểm xem skill có thực sự tạo ra khác biệt không, chạy evals để chắc rằng skill được gọi (trigger) một cách đáng tin cậy, cùng nhiều thứ khác.
Ray sẽ đi qua một ví dụ ở phần sau, nhưng tóm lại quy trình mới gồm ba bước:
- Dùng skill-creator mới để giúp bạn tạo một skill.
- Chạy evals của riêng bạn để chắc skill được trigger ổn định, đúng theo cách bạn muốn.
- Chạy một A/B test để chắc rằng skill bạn vừa làm thật sự tạo ra khác biệt.
Theo Anthropic, skill nói chung rơi vào hai nhóm khác nhau, và nhóm nào cũng cần test, nhưng vì những lý do khác nhau. Ray đi qua từng nhóm.
4. Loại một: capability uplift, skill có hạn dùng
Nhóm đầu tiên là capability uplift (nâng năng lực). Ý là ở thời điểm hiện tại, model có thể chưa đủ giỏi trong một mảng nào đó. Ví dụ nó chưa biết xử lý Swift concurrency cho đúng, hay nó rất tệ trong việc điền form PDF hoặc làm file PowerPoint. Loại skill này đưa cho model thông tin còn thiếu, hoặc cung cấp kỹ thuật và pattern để model đạt được mục tiêu của bạn.
Ví dụ, trong repo chính thức của Anthropic có một loạt skill để xử lý file Word, PDF và PowerPoint. Lý do Anthropic làm skill PDF là vì hiện nay các model chưa thật sự giỏi các việc liên quan tới PDF.
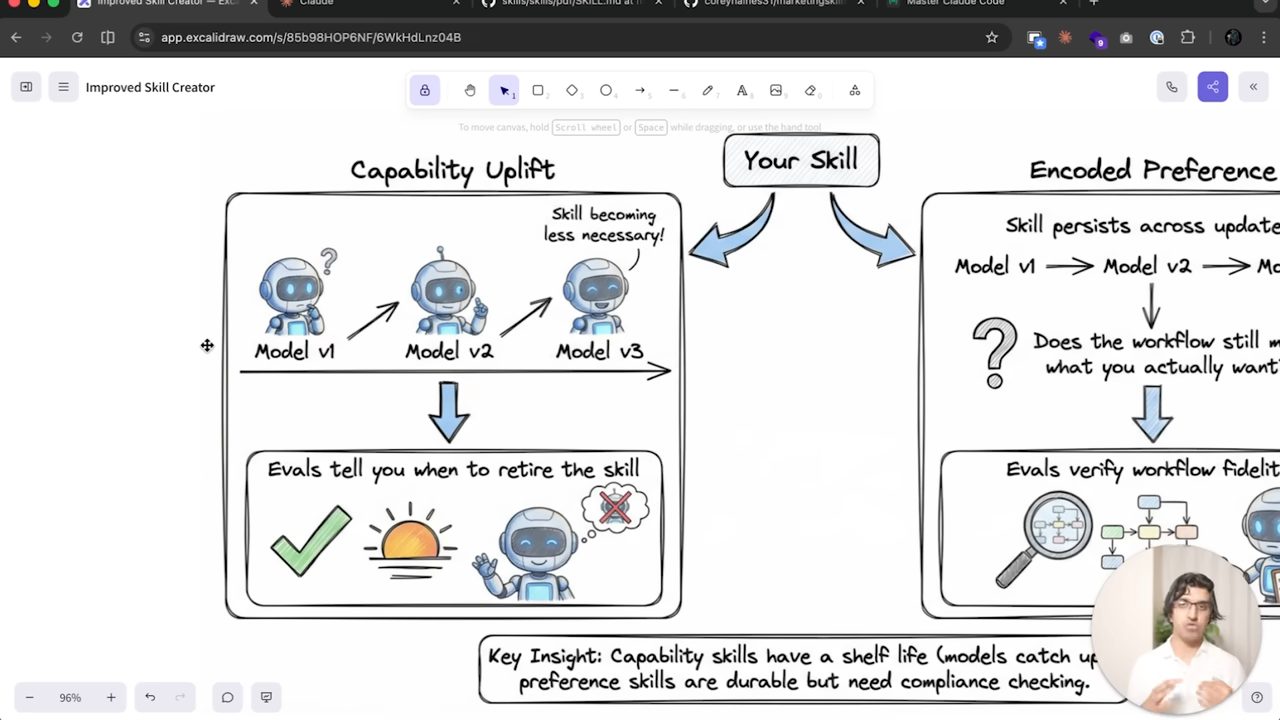
Nhưng rất có thể Opus 4.7 hay Opus 5 sẽ xử lý PDF giỏi hơn nhiều, và lúc đó bạn không cần skill nữa. Vì vậy các skill capability uplift, tức những skill lấp thông tin còn thiếu hoặc dạy model kỹ thuật, thường có "ngày nghỉ hưu" (retirement date) của riêng nó. Skill-creator có thể giúp bạn xác định có nên bỏ skill đó đi hay chưa, dựa trên việc năng lực của model gốc đã bắt kịp mức của skill hay chưa.
5. Loại hai: encoded preference, skill mã hoá workflow của bạn
Nhóm thứ hai là skill mã hoá workflow hoặc sở thích (preference) của bạn. Lý do có thể là compliance, hoặc đơn giản là hệ thống của bạn được thiết kế theo một cách nhất định. Ở nhóm này, Claude vốn đã làm được từng phần việc; skill chỉ sắp các phần đó theo đúng quy trình của bạn.
Ví dụ nhanh của Ray là skill windows-release cho ứng dụng HyperWhisper, app chuyển giọng nói thành chữ của anh. Khi muốn ra một bản Windows mới, chẳng hạn sau một lần cập nhật, anh chỉ cần gọi skill này, và nó đi qua toàn bộ workflow anh đã định nghĩa từ trước.
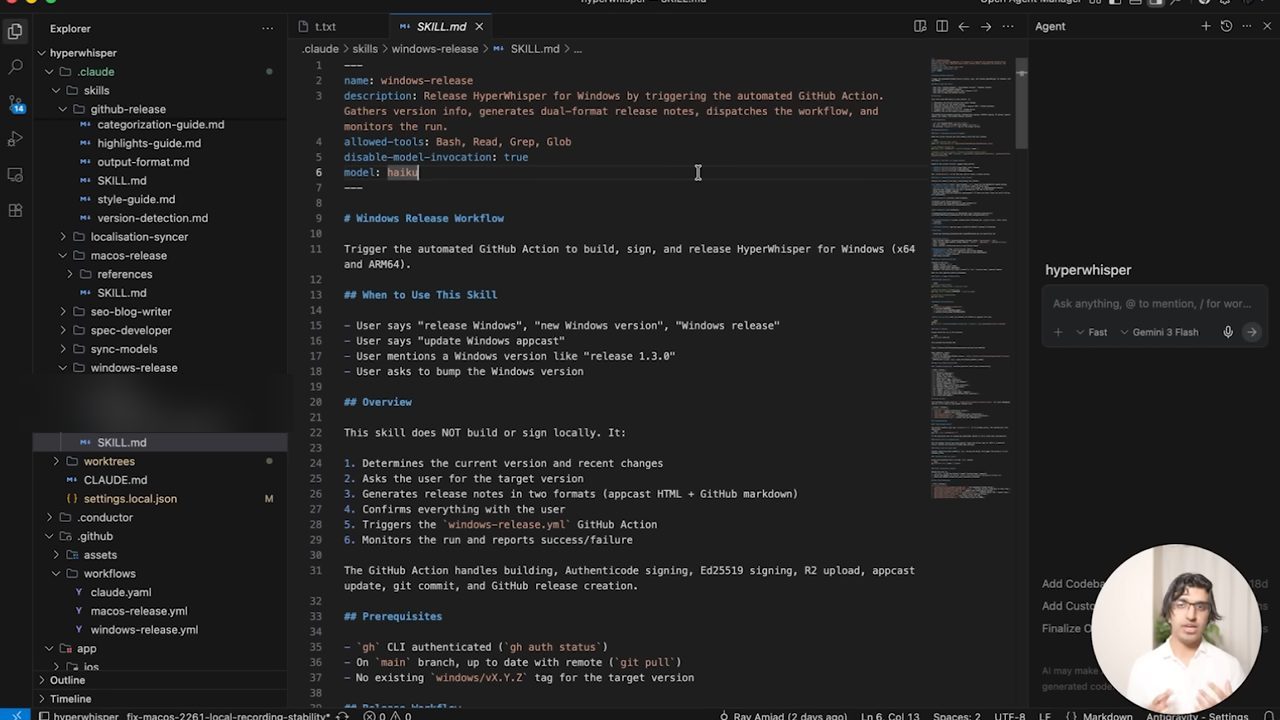
SKILL.md của skill windows-release: description nói nó phát hành HyperWhisper cho Windows bằng cách kích hoạt GitHub Action tự động, thu thông tin version, tạo release notes hai định dạng, dispatch workflow và theo dõi lần chạy. Phần "When to Use This Skill" liệt kê các câu như "release Windows", "new Windows version"; phần Overview gồm sáu bước, từ xác định version hiện tại tới báo thành công hay thất bại.Phần frontmatter trên màn hình cho thấy cấu trúc một skill kiểu này:
---
name: windows-release
description: Release HyperWhisper for Windows by triggering the automated GitHub Action. Gathers version info, generates dual-format release notes, dispatches the workflow, and monitors the run.
allowed-tools: Bash, Read, Grep, Glob
disable-model-invocation: true
model: haiku
---
Dù vậy, Ray nhấn mạnh: khi phát triển một skill như thế, bạn vẫn muốn chắc chắn nó được trigger ổn định và làm đúng điều bạn mong đợi, nhất là khi skill khá phức tạp.
6. Ví dụ cho hai loại và chuyện skill PDF của Anthropic
Ray đưa thêm ví dụ cho từng nhóm. Capability uplift có thể là điền form PDF, dùng OCR để biết phần nào của form cần điền, và tạo những tài liệu phức tạp như file PowerPoint hay file Word.
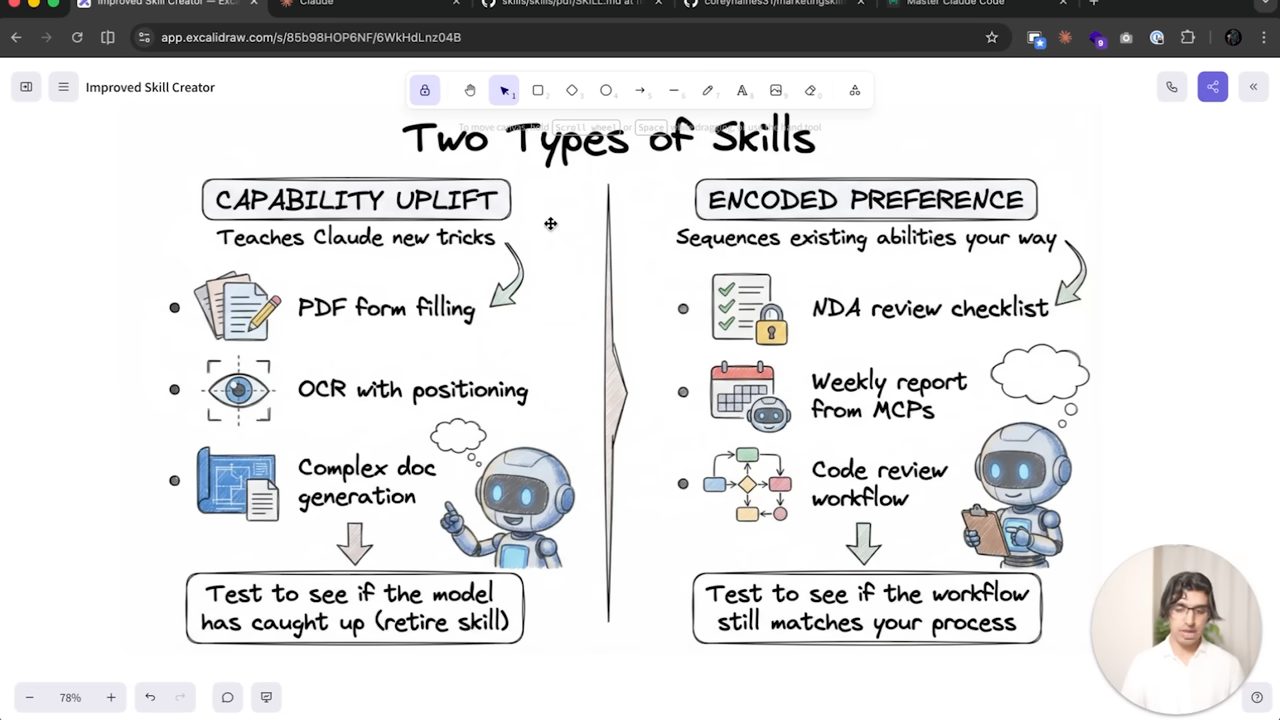
Skill thuộc nhóm encoded preference thì có thể là một checklist review NDA; một skill khác gom dữ liệu từ tất cả các MCP server của bạn, như PostHog hay Jira, thành một báo cáo hằng tuần; hoặc một skill khác có luồng rất cụ thể cho code review.
Rồi Ray kể một ví dụ từ chính Anthropic. Họ thấy skill PDF của mình gặp khó với những form không có trường điền được (non-fillable). Claude phải đặt chữ vào đúng toạ độ mà không có trường nào để dựa vào, và nó luôn đặt chữ sai chỗ. Họ dùng cách làm mới để cô lập lỗi đó, cải tiến skill, và cuối cùng skill chạy ổn định. Theo bài blog, bản sửa neo vị trí điền vào toạ độ của phần chữ đã trích ra từ form; trên màn hình, ảnh "Before" có chữ lệch, đè lên các dòng, còn ảnh "After" có chữ nằm gọn trong từng ô.
7. Cài plugin và so sánh skill-creator cũ với mới
Giờ tới ví dụ thực tế. Đầu tiên, bạn vào /plugins và kiểm tra đã cài plugin skill-creator chưa. Ray tìm nó trong danh sách, rồi cài ở mức project (trong trường hợp của anh). Sau khi khởi động lại Claude Code, anh gõ /skill-creator và thấy có tới hai cái: một là bản cũ anh đã cài vài tháng trước, nằm ở mức user. Anh xoá bản ở mức user đi, và nó biến mất khỏi danh sách.
Để so sánh, anh hỏi cả hai phiên bản cùng một câu, kiểu "này, bạn làm được gì":
/skill-creator What can you do
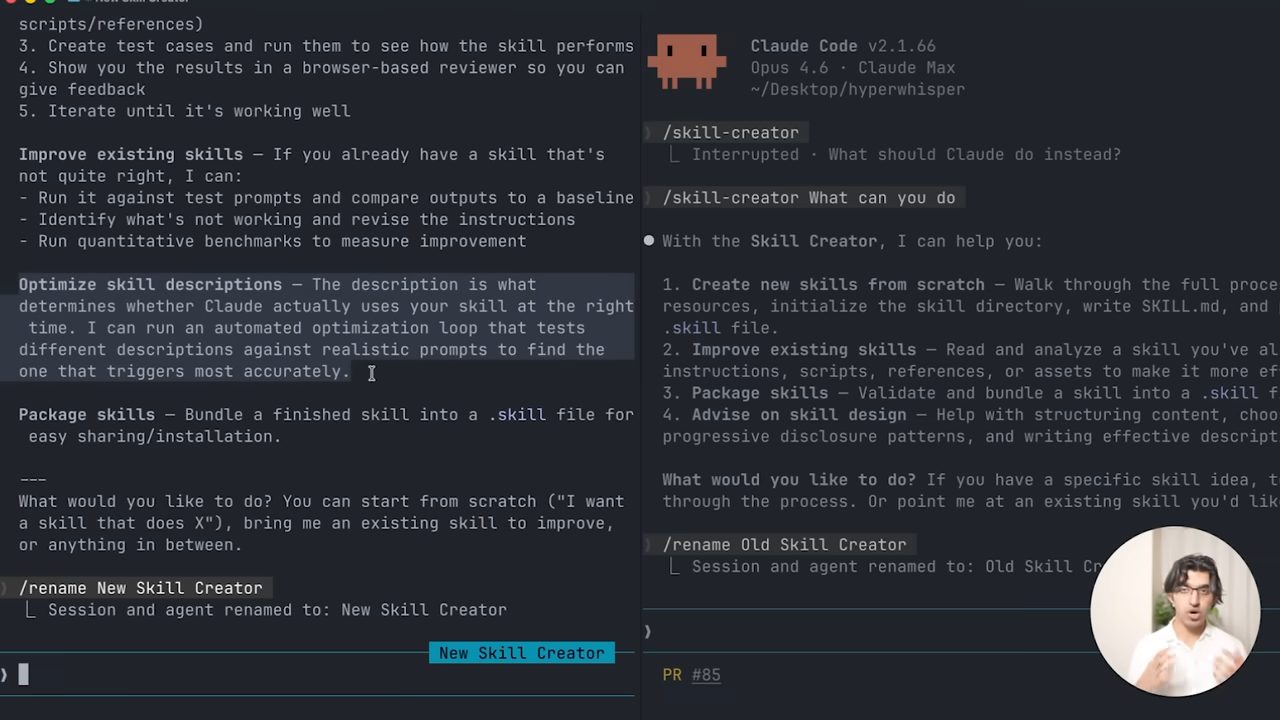
So sánh nhanh: cả hai đều tạo được skill từ đầu, nhưng bản mới còn tạo test case để xem skill hoạt động thế nào. Ở phần cải thiện skill có sẵn, bản mới có thêm vài thứ: nó chạy test prompt và so với một baseline, xác định chỗ nào chưa chạy và sửa lại instruction, rồi chạy benchmark cho bạn.
Cuối cùng, bản mới chạy được một vòng lặp tối ưu (feedback loop): nó thử các description khác nhau cho skill để xem description nào trigger ổn định nhất trước những prompt thực tế. Ray nói anh sẽ đi qua toàn bộ quy trình và giải thích cách nó chạy.
8. Demo: tạo một SEO audit skill kèm evals
Ray gọi skill-creator và gõ một yêu cầu rất ngắn:
/skill-creator:skill-creator Make me an SEO audit skill
Anh nói lý tưởng thì nên mô tả kỹ hơn, hoặc đưa tài liệu tham khảo để nó làm ra skill tốt hơn. Nhưng anh cố tình bắt đầu bằng một mô tả đơn giản để dựa vào năng lực của chính model.
Trong lúc đặt câu hỏi, skill-creator giờ hỏi thêm: có nên dựng test case để kiểm chứng skill chạy tốt không? Ray trả lời có, và chạy evals luôn. Nó làm xong skill, rồi tạo test case với những prompt thực tế. Đó chính là các eval nó nghĩ ra cho anh. Tiếp đó nó bắt đầu test để chắc rằng skill thực sự tạo khác biệt.
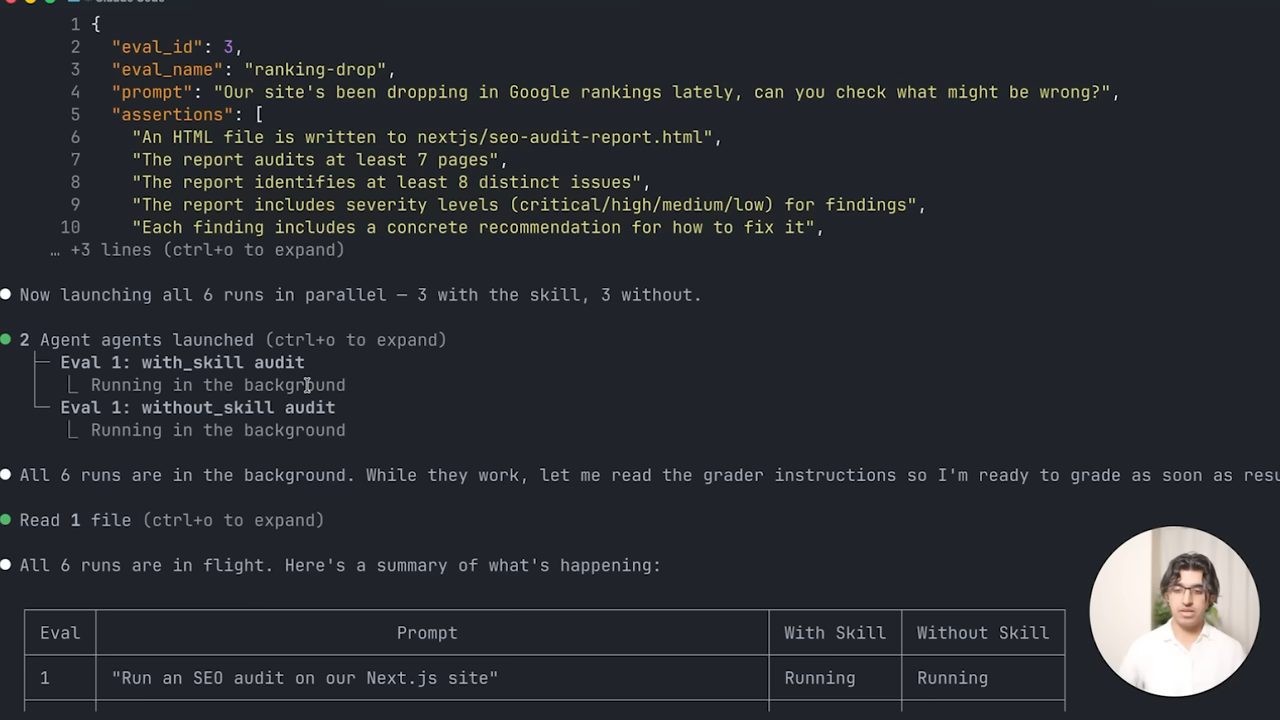
Nó khởi chạy sáu lần chạy song song: ba lần có skill và ba lần không có skill, rồi chấm kết quả theo danh sách kỳ vọng (expectation list) nó đã viết. Ba prompt test lần lượt là chạy SEO audit trên site Next.js, kiểm xem có thiếu structured data hay JSON-LD schema nào không, và câu hỏi về thứ hạng Google bị tụt. Màn hình còn tóm các assertion sẽ chấm: eval 1 có 8 assertion, eval 2 có 5, eval 3 có 6.
Gõ /tasks là thấy các agent đang chạy: sáu local agent, mỗi eval một cặp, một cái không có skill và một cái có skill.
9. A/B test mù: một bên có skill, một bên không
Bạn có thể bấm vào bất kỳ task nào để xem chuyện gì đang diễn ra phía sau. Về cơ bản, với mỗi eval, nó sinh ra hai sub-agent, một có skill và một không có skill. Kết quả quay về session chính, đóng vai comparator. Comparator chỉ so hai output, nhưng nó không biết output nào dùng skill và output nào không.
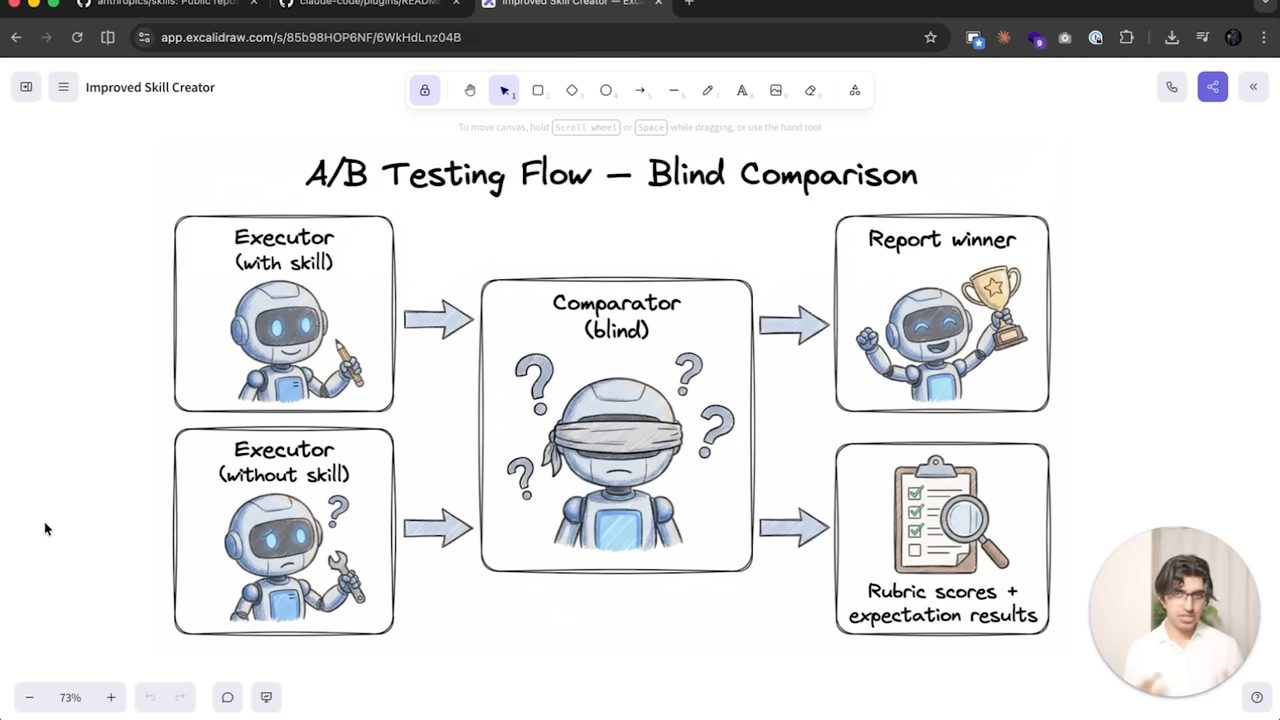
Điều này có ích khi làm skill, vì bạn chắc chắn được skill đang tạo khác biệt nào đó trong codebase của bạn. Nó cũng có ích mỗi khi có model mới: bạn đánh giá lại những skill quan trọng nhất mà mình dùng hằng ngày bằng skill-creator, kiểu "này, chạy một A/B test để xem skill này còn hoạt động tốt không".
Ví dụ, có thể hiện tại Opus 4.6 chưa thật giỏi SEO audit, nhưng Opus 5 thì giỏi. Khi Opus 5 ra, bạn chạy bài so sánh A/B này trên mọi skill đang có, rồi quyết định nên xoá skill, giữ nguyên, hay sửa nó.
Trường hợp của Anthropic: họ benchmark skill PDF khi có và không có skill được nạp, và thấy có skill thì pass rate cao hơn. Trên sơ đồ Ray mở, bài benchmark PDF chạy trên Claude Sonnet 4.5 cho năm bài test (điền form không có trường, trích bảng nhiều trang, gộp và đánh bookmark, điền form có kiểm tra, OCR bản scan thành bản tìm kiếm được): có skill đạt 5/5 (100%), không có skill chỉ 2/5 (40%).
10. Workspace của eval, và hai kiểu eval
Quay lại demo: cả sáu lần chạy đã xong, và nó khởi chạy sáu sub-agent chấm điểm (grader) để chấm song song. Nhìn vào project, nó đã tạo một thư mục seo-audit-workspace. Bên trong là iteration đầu tiên, gồm skill, bản báo cáo nó làm ra, phần chấm điểm theo các eval đã định nghĩa, và cả thông tin thời gian chạy. Cấu trúc đó lặp lại cho cả sáu lần chạy. Trong lúc chờ chấm xong, Ray giải thích thêm về eval.
Có hai kiểu eval. Kiểu thứ nhất là capability eval: output nào tốt hơn? Ví dụ bản SEO audit nào tốt hơn, hay các trường PDF đã được điền đúng chưa.
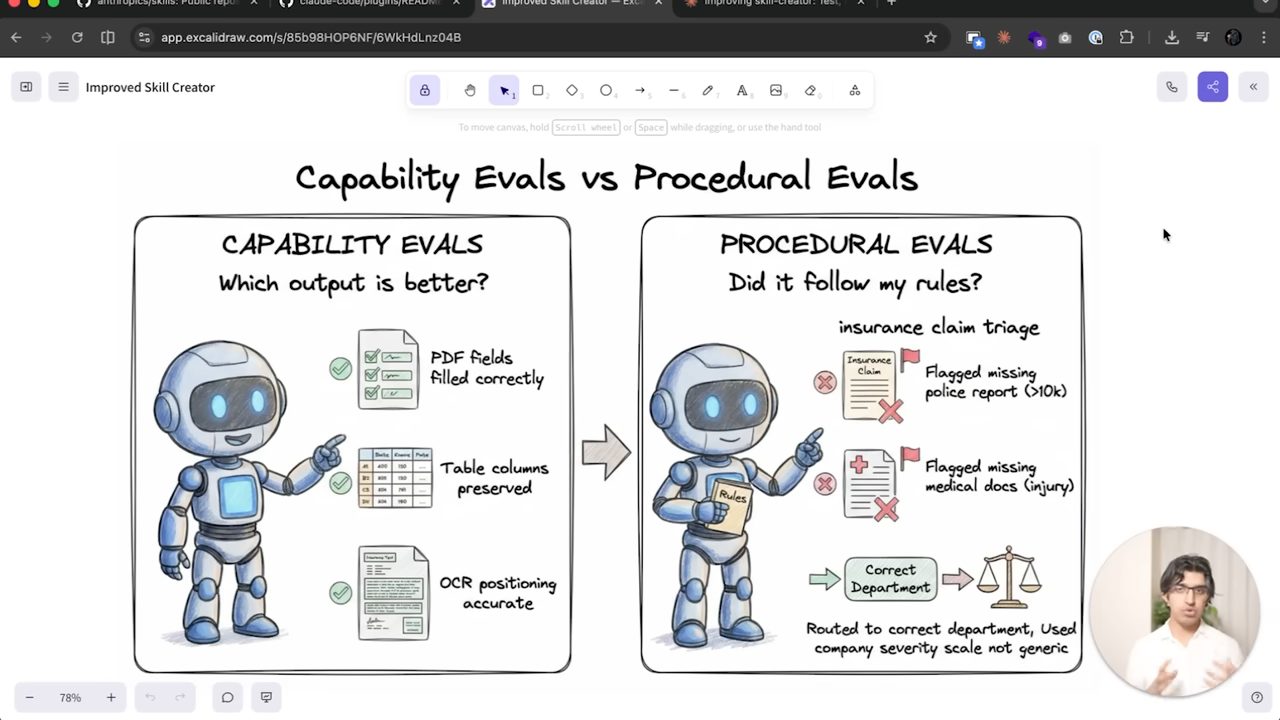
Kiểu thứ hai là procedural eval. Ví dụ bạn có một skill phân loại hồ sơ bồi thường bảo hiểm (insurance claim triage) làm riêng cho tổ chức của mình. Bạn nạp toàn bộ tài liệu nội bộ vào, rồi đưa nó 20, 30 ví dụ kèm kết quả đúng để chạy eval. Chẳng hạn bạn có thể đặt luật: nếu giá trị hồ sơ lớn hơn mười nghìn đô la thì bắt buộc phải có biên bản cảnh sát, và hồ sơ nào thiếu thì bị gắn cờ.
11. Procedural eval cho skill nội bộ và kết quả benchmark
Luật tiếp theo trong ví dụ: nếu đó là hồ sơ thương tích (injury claim) thì còn cần thêm hồ sơ y tế. Với framework mới này, bạn có thể đưa cho skill-creator chính skill phân loại hồ sơ bảo hiểm của bạn, đưa thêm một loạt ví dụ, rồi để nó tự động chấm điểm và cải tiến skill.
Lúc này demo SEO đã trả về kết quả benchmark. Theo lời Ray: khi bật skill, tỷ lệ thành công cao hơn 13,5%; thời gian trung bình để hoàn thành việc nhanh hơn, tức thấp hơn, 22%; và bật skill thì tốn nhiều token hơn một chút.
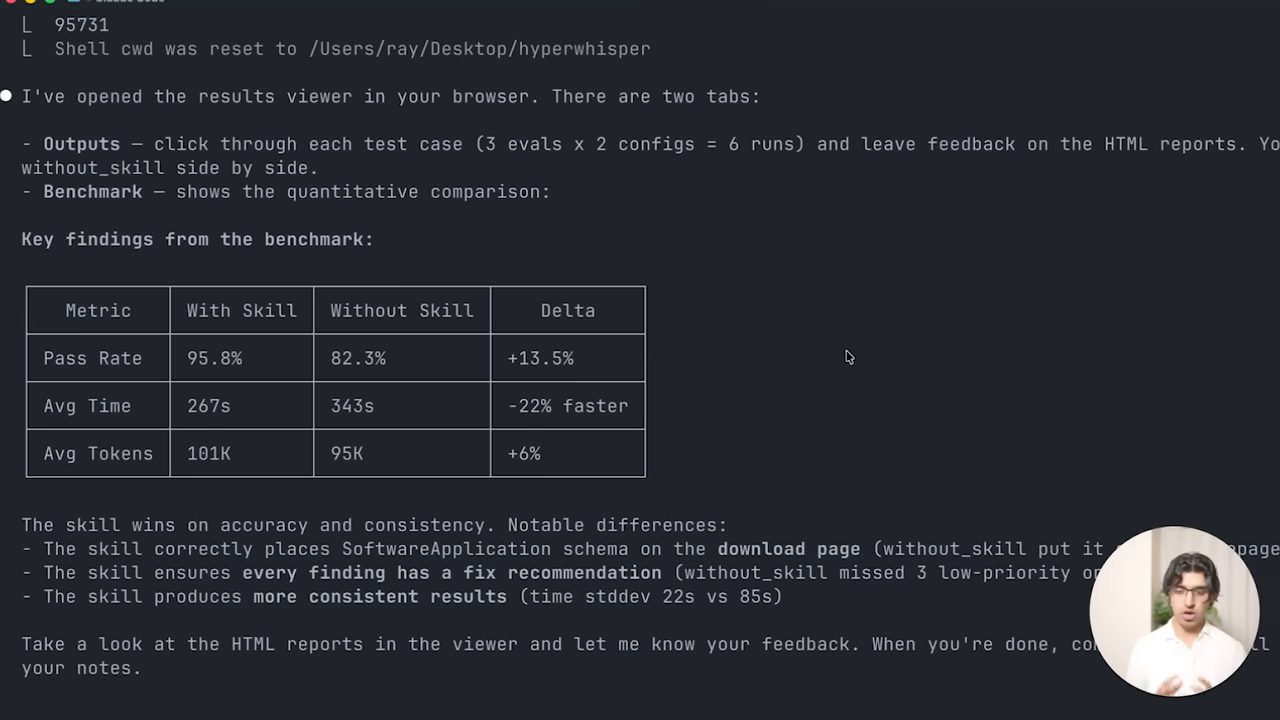
Nó cũng nói có vài báo cáo HTML để xem trong trình xem kết quả (viewer), nhưng lúc đầu chưa tự mở browser cho Ray. Một lát sau thì nó mở.
12. Trang review: chấm tay rồi đưa feedback lại cho Claude
Trang review hiện ra trong browser với hai tab. Tab Outputs cho xem từng output; ở đây mỗi output là một file HTML dài, tức bản báo cáo SEO, cùng điểm mà grader đã chấm cho output đó. Bạn có thể để lại feedback của riêng mình ngay ở đó, chuyển sang output tiếp theo và review tiếp. Review hết thì bấm "Submit All Reviews".
Tab Benchmarks cho xem lại các con số benchmark vừa thấy, những assertion nào đạt khi có skill và khi không có skill, cùng vài ghi chú phân tích cuối. Trên màn hình, bảng Benchmark Results ghi pass rate 96% ± 6% có skill so với 82% ± 14% không skill, thời gian 267,5 so với 342,5 giây, và phần "Per-Eval Breakdown" chia nhỏ theo từng eval.
Nếu bấm submit, trang tải về một file feedback.json. Bạn chỉ cần kéo thả file đó lại vào Claude và nói đại ý "ok, sửa theo mấy góp ý này".
13. Tối ưu description để skill được gọi đúng lúc
Khi bạn có skill, chính phần description của skill quyết định nó có được trigger hay không. Sẽ có lúc bạn thấy skill không được gọi một cách ổn định. Khi đó, bạn có thể nhờ Claude Code, cùng skill-creator, cải thiện chuyện trigger.
Ví dụ, Ray có một skill tên sync-models: nó lấy danh sách model post-processing mới nhất từ API của các nhà cung cấp cloud rồi đồng bộ vào codebase macOS và Windows của HyperWhisper. Anh mở một tab mới, chạy Claude, gọi skill-creator và hỏi:
can you optimize the description of my sync model skill to make sure it triggers more reliably
Skill-creator nghĩ ra những prompt mẫu mà người dùng có thể nói, gồm những prompt mà skill nên được trigger, và những prompt mà skill không nên được trigger. Rồi nó đưa ra một trang review mới, "Eval Set Review: sync-models", hiện description hiện tại ở đầu trang và danh sách câu hỏi với một công tắc "Should Trigger" cho từng câu. Ví dụ các câu nên trigger: "OpenAI vừa ra gpt-5.2 và gpt-5.2-mini hôm qua, thêm vào app được không?", "kiểm xem có model mới nào từ Anthropic hay Gemini mà dropdown post-processing đang thiếu không", hay "lâu rồi chưa sync danh sách model, cập nhật cho cả hai nền tảng đi".
Trên trang này, bạn review các prompt, quyết định từng cái có nên trigger skill hay không, thêm query của riêng mình. Xong thì bấm export, rồi kéo file lại vào Claude Code và nhấn enter. Theo màn hình, các câu "không nên trigger" là những câu dễ nhầm: các mô hình Whisper chạy local, thêm một nhà cung cấp mới (thay đổi cấu trúc chứ không phải sync), lỗi giao diện, hay cập nhật thủ công.
14. Vòng tối ưu train/test cho description
Giờ nó chạy vòng lặp tối ưu. Có 20 query; nó huấn luyện trên 60% và giữ lại 40% để test. Ray so sánh: về cơ bản giống machine learning nói chung, bạn có một test set và một training set. Trên màn hình, kết quả tách ra là 12 query train và 8 query test.
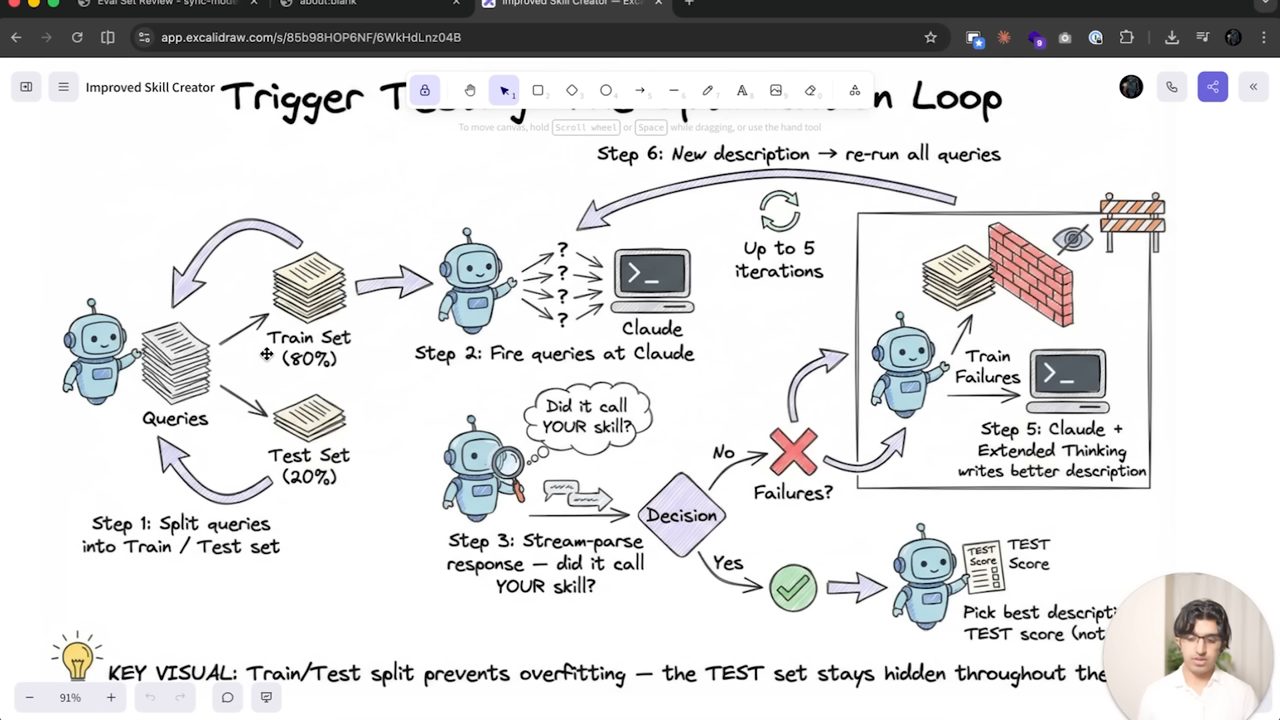
Cách nó chạy: các query được chia thành training set và testing set. Claude bắn các query trong training set vào, rồi kiểm xem skill có thực sự được gọi, tức được trigger, hay không. Nó không chạy hết cả skill, chỉ kiểm có trigger hay không. Quá trình lặp lại tối đa năm lần cho tới khi ra được description tốt hơn.
Lúc này màn hình báo kết quả ban đầu: recall chỉ 6%, gần như mọi query lẽ ra phải trigger đều thất bại. Lý do là description quá chung chung cho skill này; Claude nghĩ nó tự xử lý được các việc đó mà không cần tham khảo skill. Vì vậy nó sẽ viết một description tối ưu hơn rồi chạy thêm một vòng để kiểm. Description mới liệt kê rõ các câu trigger ("add the new GPT models", "sync models", "check for new models"...), nêu tên cả năm nhà cung cấp, chỉ tới các file cụ thể như PostProcessingModels.swift và LanguageModelInfo.cs, bao các tình huống model bị khai tử, và giải thích giá trị của skill.
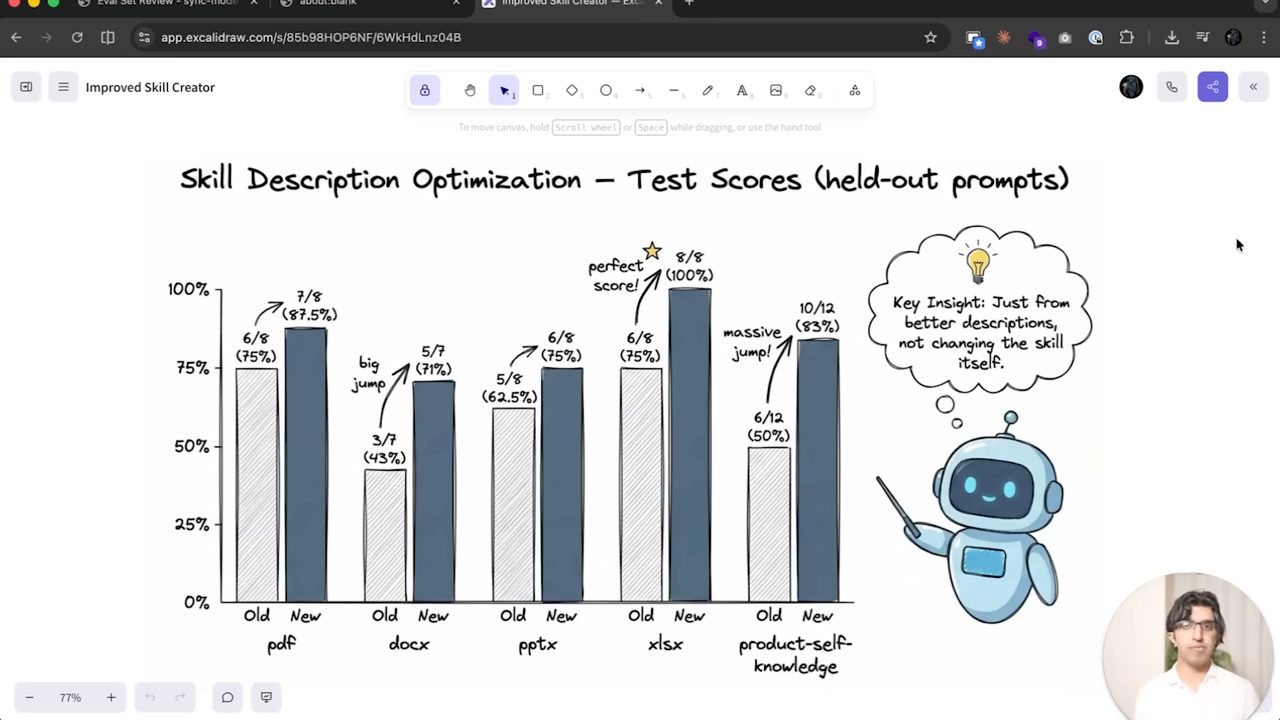
Ray nói trong bài blog của Anthropic, họ thấy quy trình này giúp skill trigger ổn định hơn. Bài blog ghi họ chạy nó trên các skill tạo tài liệu và thấy trigger tốt hơn ở 5 trên 6 skill công khai.
15. Có đáng công không, và nên làm gì tiếp
Ray thấy khá thú vị khi Anthropic đầu tư mạnh như vậy vào skill. Sau khi xem video, bạn có thể nghĩ "cái này tốn công quá, sao phải bận tâm?". Nhưng theo anh, thực tế là nếu bạn có một skill dùng nhiều lần mỗi ngày và sẽ còn dùng trong tương lai gần, thì một chút thời gian bỏ ra để chắc rằng (A) nó thật sự cho kết quả tốt hơn và (B) nó được trigger ổn định sẽ được đền đáp về lâu dài. Lý do anh đưa ra: ngày nay người ta thấy công việc của một số người về cơ bản đang được thay bằng vài Claude skill.
Bản thân Ray sẽ chạy nó trên một số skill khác trong các project của mình để làm chúng tốt hơn. Anh khuyên bạn cũng chạy trên project của mình, nhất là với những skill dùng thường xuyên nhất, và với những skill làm từ vài tháng trước. Lý do: rất có thể đến giờ skill đó không còn cần nữa, vì hành vi cốt lõi của model đã tự chứa toàn bộ chức năng của skill.
Nó cũng hữu ích khi bạn publish skill hoặc tải skill từ trên mạng về: bạn có thể kiểm bằng skill-creator để chắc rằng skill đó thật sự tạo khác biệt trong codebase của bạn.
Ở khung cuối của sơ đồ Excalidraw, Ray để một hình "The Bigger Picture: From Instructions to Specifications": hôm nay, file SKILL.md mô tả HOW (từng bước bảo Claude làm gì) còn file eval mô tả WHAT (output tốt trông thế nào), hai tài liệu tách rời; trong tương lai, khi model ngày càng thông minh, khoảng cách thu hẹp và eval trở thành chính skill: bạn mô tả điều mình muốn, model tự tìm ra cách làm. Dòng cuối của hình: CLAUDE.md, skills, hooks và evals là một hệ thống, trong đó evals là vòng feedback còn thiếu. Ý này khớp với phần "Looking ahead" trong bài blog của Anthropic.
Video kết thúc bằng lời mời đăng ký newsletter về Claude Code và khoá học của Ray, nơi anh chia sẻ những gì đang học và tìm hiểu, kèm các bài về context engineering, workflow hằng ngày và kỹ thuật prompt.
Nguồn và liên kết 8 nguồn
- Tên gốc: Anthropic Just Dropped Claude Code Skills 2.0
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=qXWz-V_XMOc youtube.com
- Kênh YouTube Ray Amjad (Ray Amjad): youtube.com/channel/UCLA7cJBnqr0nLF2bQBD9uUg youtube.com
- Bài blog của Anthropic, "Improving skill-creator: Test, measure, and refine Agent Skills" (hai loại skill, evals, benchmark mode, comparator agent, tối ưu description): claude.com/blog/improving-skill-creator-test-measure-and-refine-agent-skills claude.com
- Repo skill chính thức của Anthropic (có skill PDF, Word, PowerPoint và skill-creator): github.com/anthropics/skills · skill-creator: github.com/anthropics/skills/tree/main/skills/skill-creator github.com
- Repo marketing skills Ray lấy làm ví dụ: github.com/coreyhaines31/marketingskills github.com
- HyperWhisper, app chuyển giọng nói thành chữ mã nguồn mở của Ray dùng trong demo: github.com/ray-amjad/hyperwhisper-app github.com
Related talks
Toàn bộ hướng dẫn Skills của Anthropic trong 22 phút
Mark Kashef · Mark Kashef · 22 min
Đi qua bản hướng dẫn 33 trang của Anthropic về skill: anatomy, ba tầng progressive disclosure, viết description, năm design pattern, test và phân phối.
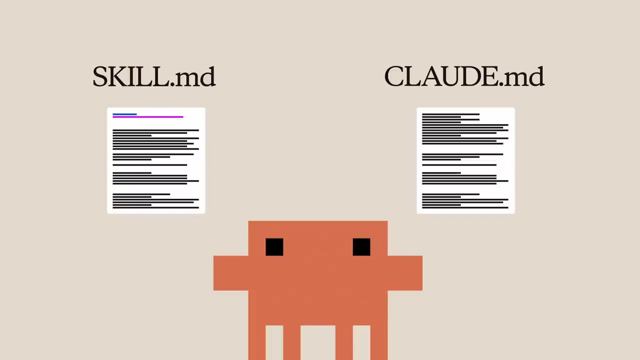
Skill là gì?
Claude · Claude · 3 min
Skill là file SKILL.md dạy Claude một việc một lần: Claude chọn skill qua description, đặt ở đâu, khác CLAUDE.md và slash command ra sao.
Nắm 95% Claude Code skills trong 28 phút
Nate Herk · Nate Herk | AI Automation · 27 min
Skill là gì, SKILL.md và supporting files, progressive context loading, framework sáu bước, live build một skill infographic, bảng debug và skill global.