Anthropic chạy hơn 1.000 agent trong 8 ngày, còn agent của bạn vẫn cần được giải thích lại
Nate B Jones bàn điều giúp agent chạy dài làm đúng việc (video 20/11/2026): đúng context, coi thông tin dự án như code, skill và permission chung cho team.
✓ Đã duyệt độc lập · cập nhật 20/11/2026 · 21 min
1. Các phòng lab báo AI chạy hàng trăm giờ, nhiều ngày
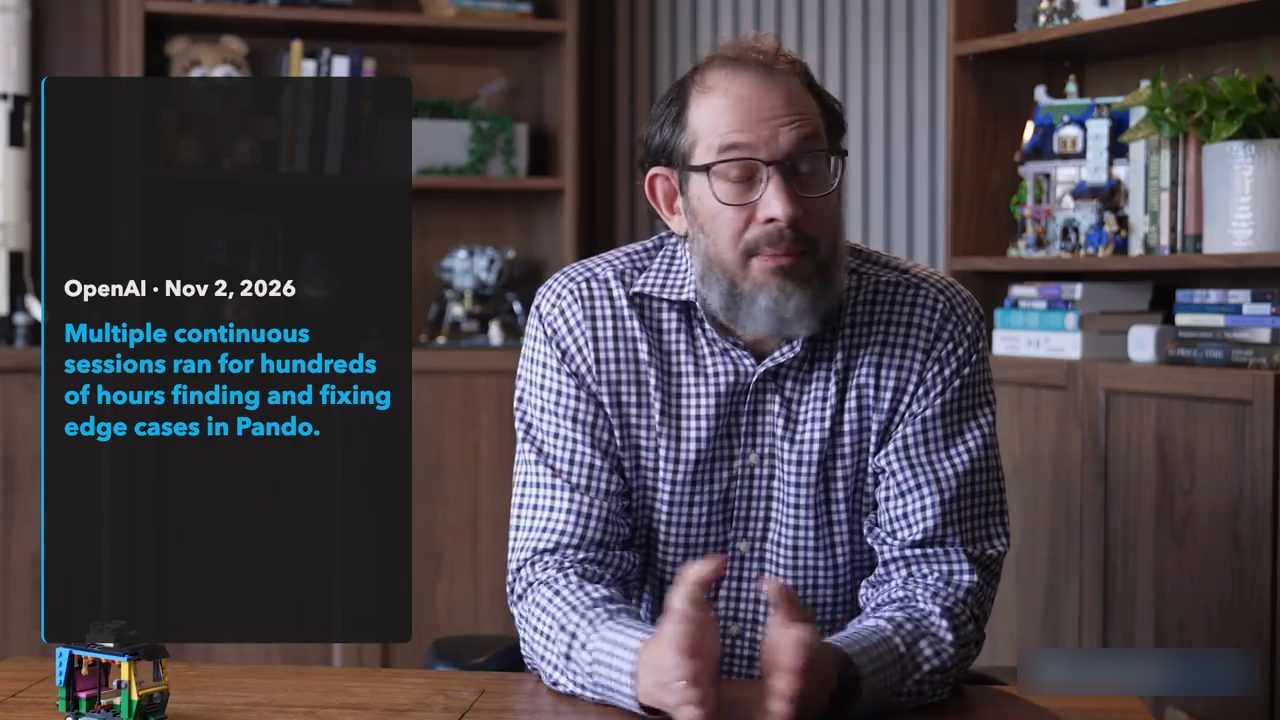
Nate B Jones mở đầu bằng một tin (video đăng ngày 20/11/2026): ngày 2/11, OpenAI báo rằng các phiên AI đã chạy hàng trăm giờ để tìm và sửa vấn đề trong hệ thống quản lý code mới của OpenAI. Trong khi đó, theo anh, AI của bạn và của anh đôi khi vẫn cần được giải thích cùng một điều lặp đi lặp lại. Anh nói phần lớn chúng ta còn cách hàng trăm giờ một quãng dài.
Theo lời anh (video đăng ngày 20/11/2026), video này là về cách để AI làm đúng nhiều hơn phần việc bạn quan tâm, mà không phải liên tục lặp lại chỉ dẫn và không phải sửa đi sửa lại cùng những lỗi cũ. Anh nói đó là chìa khoá cho những lần chạy dài thành công.
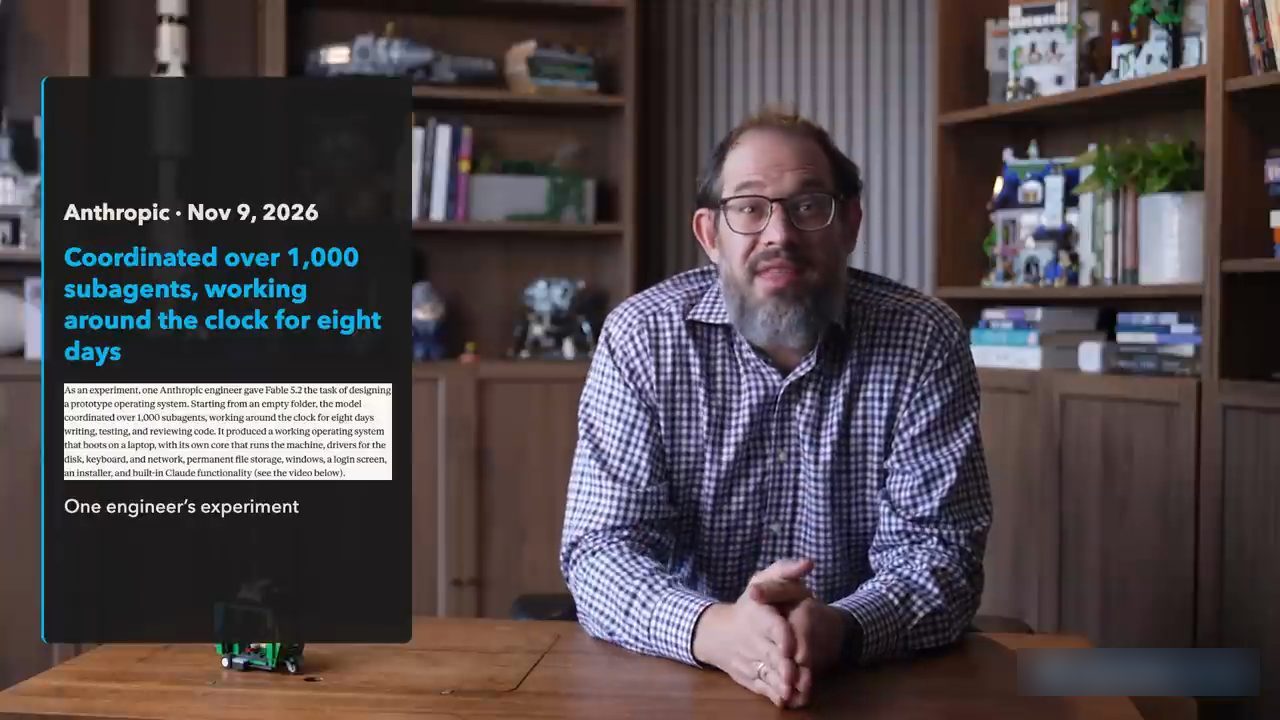
Anh kể tiếp (video đăng ngày 20/11/2026): Anthropic cũng báo một điều rất giống với Fable 5.2. Anh nói đây không chỉ là chuyện của OpenAI. Theo lời anh, Anthropic có hơn một nghìn agent làm việc trong tám ngày để xây một hệ điều hành nguyên mẫu (prototype operating system).
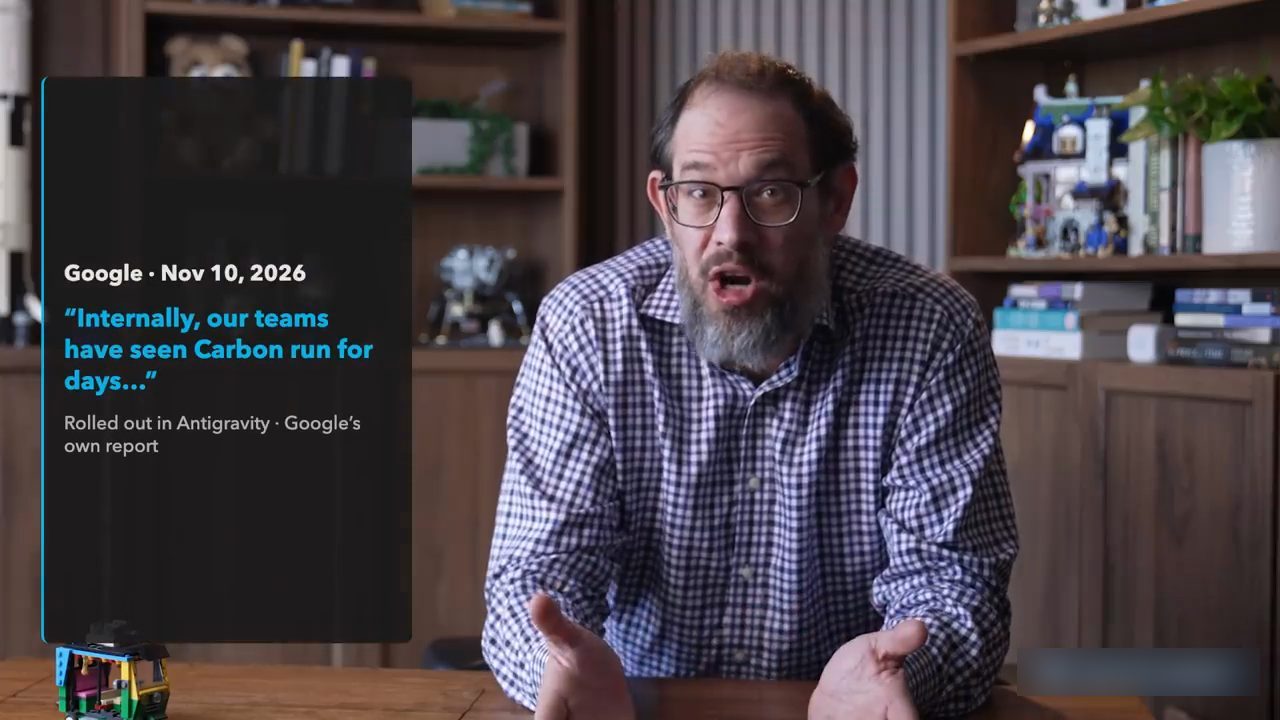
Với Google, anh nói (video đăng ngày 20/11/2026) cũng có chuyện tương tự: Gemini 4 Carbon vừa ra mắt, và nó đã làm việc nhiều ngày trên những bài toán kỹ thuật khó. Theo anh, ta biết các hệ thống AI này có thể làm việc trong thời gian dài nếu ta thiết lập chúng đúng, và video này là về điều đó.
2. Một lần chạy cả đêm có thể để lại cả ngày dọn dẹp
Theo Nate (video đăng ngày 20/11/2026), một AI làm việc cả đêm có thể để lại cho bạn cả một ngày dọn dẹp. Bạn vẫn phải kiểm lại giá. Bạn vẫn phải sửa những gì nó đã hứa. Bạn vẫn phải giải thích lại quyết định mà bạn đã đưa ra từ hôm qua.
Anh cho biết điều này đến từ kinh nghiệm của chính anh (video đăng ngày 20/11/2026). Anh đã từng để AI chạy và bực mình khi sáng ra nó mang về một thứ anh không hề yêu cầu. Khi nó làm quá tay một tính năng anh không muốn. Khi nó làm thiếu một thứ anh quan tâm. Khi nó không nhớ đúng cách triển khai một hướng đi anh đã đưa, và mãi sau anh mới nhận ra hướng đi đó mơ hồ. Anh nói anh không muốn bạn phải lặp lại chính mình, và anh cũng không muốn phải lặp lại chính mình.
3. Lần chạy research của anh đi chệch hướng
Nate kể (video đăng ngày 20/11/2026) anh gặp đúng chuyện này khi đang xây một bộ câu hỏi để kiểm tra AI trên chính công việc của anh. Codex tìm ra hơn 339 nguồn anh đang dùng và viết ra hơn một nghìn câu hỏi để anh suy nghĩ. Anh nói như thế là nhiều, đúng không?
Anh kể tiếp (video đăng ngày 20/11/2026): anh bảo nó cứ tiếp tục, và sau đó một agent bị kẹt, lặp đi lặp lại cùng một việc trong lúc cố đồng bộ toàn bộ file của anh. Đến lúc đó, thứ anh cần đã thay đổi. Anh muốn 50 câu trả lời giá trị nhất cho các câu hỏi của mình. Anh muốn bằng chứng mạnh hơn. Anh không muốn phải trả lời một nghìn câu hỏi.
Anh nói (video đăng ngày 20/11/2026) anh đã cố hiểu cho ra đống context đó, nhưng rốt cuộc anh dừng lần chạy lại và chỉ gửi cho agent kế tiếp một ghi chú ngắn để nó hiểu cho ra tất cả những thứ đó.
4. Không phải chuyện thiếu dữ liệu, mà là bản giao việc
Theo Nate (video đăng ngày 20/11/2026), đây không phải là vấn đề có sẵn dữ liệu hay không. Phần research đã có đó. Anh có hàng nghìn file trên máy. Thứ anh cần là một bản giao việc (assignment) được cấu trúc tốt hơn, để một lần chạy dài như thế thật sự có lý. Anh nói anh đã học thêm được việc gì đáng làm trong suốt lần chạy đó, và agent kế tiếp cần thêm chỉ dẫn trước khi làm thêm việc.
Anh cho rằng (video đăng ngày 20/11/2026) đây là một thách thức dai dẳng khi ta đẩy những khối lượng công việc lớn hơn. Nếu một agent cứ tiếp tục đi theo một quyết định mà anh thậm chí không nhớ đã đưa ra từ trước trong một dự án rất lớn, rốt cuộc anh trả giá hai lần, đúng không? Anh trả, nhiều khi theo đúng nghĩa đen, bằng token cho lần chạy, rồi anh trả bằng thời gian khi sửa kết quả và nhận ra đây không phải thứ anh muốn.
Theo anh (video đăng ngày 20/11/2026), khi bạn bước vào những dự án rất lớn, nơi bạn đang cố hiểu mọi chuyện, đang cố nghĩ thấu chúng, chưa biết hết câu trả lời và cần AI làm một người cùng suy nghĩ (thought partner), thì việc chuyển những gì bạn đang học dần cho agent ngay trong lúc làm là thật sự, thật sự quan trọng.
5. Đưa đúng context tới trước AI
Làm sao để tới được đó? Theo Nate (video đăng ngày 20/11/2026), một phần của câu trả lời là thật sự kỷ luật trong việc bảo đảm đúng context được đặt trước AI vào lúc nó cần. Khi nói context đúng, anh không chỉ muốn nói các sự kiện (facts), dù chúng quan trọng. Anh muốn nói những quyết định bạn đưa ra trên đường đi, những ví dụ bạn phát triển khi cùng AI nghĩ qua bài toán, và những chỉ dẫn thay đổi dần trong lúc làm khi bạn đổi ý.
Theo anh (video đăng ngày 20/11/2026), làm vậy để một người mới vào team của bạn, nếu bạn đang làm trong một team, có thể thật sự nhìn vào bản ghi của những lần chạy lớn đó, thấy góc nhìn riêng của bạn về những dự án lớn hơn thay đổi theo thời gian, và bắt kịp. Anh nói đây thật ra là cách các phòng lab làm với nhân viên mới để đào tạo họ: họ bảo nhân viên mới hỏi Codex, hỏi Claude, để học từ dữ liệu và context có sẵn khi chúng thay đổi theo thời gian trên những dự án lớn hơn, và bắt kịp với tư cách con người.
Anh nói (video đăng ngày 20/11/2026) agent cũng học theo cách đó. Nên theo anh, hãy nghĩ về thứ bạn đưa cho các dự án lớn hơn không phải như một bức ảnh chụp một lần ý kiến của bạn, mà như một thứ bạn sẽ phải đưa góc nhìn theo thời gian cho AI, theo cách nó đọc được, hiểu được, để nó có thể dẫn dắt quyết định đó hiệu quả hơn.
6. Coi thông tin dự án như code
Quay lại ví dụ dự án research của anh, Nate nói (video đăng ngày 20/11/2026) chỉ bảo "thôi, đưa nó cho một AI khác, đưa cho Claude, đưa cho Gemini, biết đâu sẽ được" thì không hiệu quả. Theo anh, vấn đề thật sự là bản giao việc đã không được cấu trúc đúng, và anh và nhóm đã học dần theo thời gian cách cấu trúc nó tốt hơn. Anh cần rõ ràng về điều anh muốn nhận được từ nó. Anh cần rõ ràng về giai đoạn khám phá (discovery phase) khác với giai đoạn tinh chỉnh (refinement phase). Anh cần chuyển toàn bộ những gì đã học, cùng phần việc anh đã làm xong, sang một agent khác cho một lần thử khác.
Theo anh (video đăng ngày 20/11/2026), trong thế giới đó, việc bạn nghĩ về thông tin dự án như code là thật sự, thật sự then chốt. Hãy nghĩ tới việc đặt nó ở chỗ agent tìm thấy được: đặt chỉ dẫn, đặt các bước kiểm lỗi, đặt những quyết định đang thay đổi, như thể chúng là code trong một repo mà agent có thể tới đó lấy. Kể cả khi việc đó chẳng liên quan gì tới code, kể cả khi tất cả những gì bạn làm là đề xuất cho khách hàng (client proposal).
Ví dụ anh đưa ra (video đăng ngày 20/11/2026): bạn đã thống nhất một lời đề nghị và một mức giá, nhưng AI của bên nhận thầu (contractor) đang dùng một bản đề xuất cũ làm mẫu. Bản nháp mới có thể trông ổn, đúng không? Nhưng giờ trong đó có một mức giá sai. Anh nói đó chỉ là một ví dụ. Nhưng anh đã thấy lặp đi lặp lại rằng những lỗi phiên bản (versioning error) kiểu này len vào khi bạn thiếu kỷ luật và không đối xử với cả thông tin phi kỹ thuật của mình giống code hơn.
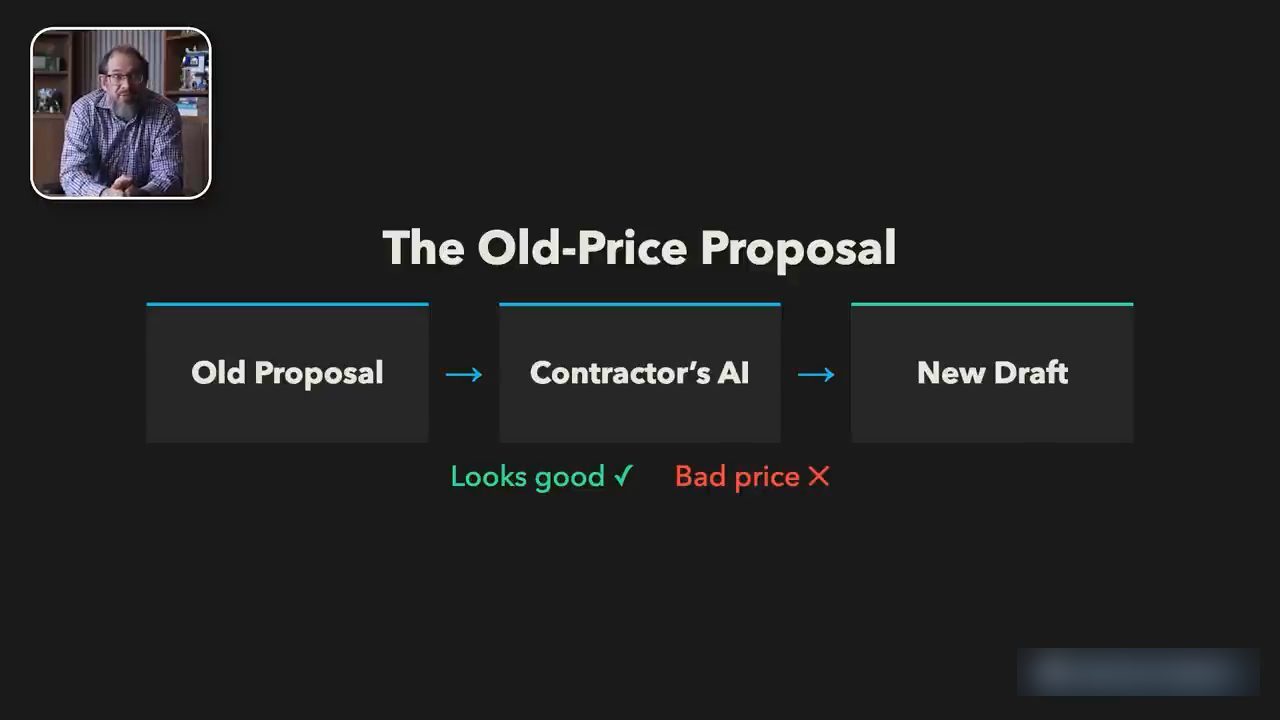
Vì sao lại như vậy? Nate nói (video đăng ngày 20/11/2026), thẳng thắn mà nói, vì trong kỷ nguyên Claude Code mà tất cả chúng ta khởi động từ tháng 1, các LLM được RLVR. Chúng được huấn luyện trên các domain kiểm chứng được (verifiable domain) như code. Theo anh, đối xử với một phần knowledge work giống code nhiều, để bạn có nó trong một repo và AI có thể đi qua (traverse) nó, hiểu các file và mọi thứ đi kèm, là điều hợp lý với AI. Nó làm công việc của bạn dễ hơn.
7. Nhiều AI, cùng một chỗ chứa dữ liệu
Theo Nate (video đăng ngày 20/11/2026), cách này còn có lợi khi bạn có hệ thống nhiều agent (multi-agent system). Giả sử bạn đang làm việc này, đồng nghiệp của bạn cũng đang làm, một người bạn ở phòng ban khác cũng đang làm. Mỗi người dùng một LLM khác, một dịch vụ khác. Tất cả đều đang làm. Anh nói nếu các bạn cùng làm trên một tập dữ liệu ở cùng một chỗ, "một repo, nếu bạn muốn gọi vậy", thì bạn sẽ ở một vị trí tốt hơn nhiều, vì bạn có thể tới lấy dữ liệu đó bất kể bạn mang LLM nào vào.
8. Skill viết cho team, không phải cho riêng bạn
Theo Nate (video đăng ngày 20/11/2026), cũng chính điều đó là lý do anh thật sự khuyến khích các team đang nghĩ tới việc làm chuyện này một cách nghiêm túc hãy đặt skill và những thứ khác mà họ tin là công thức (recipe) để dùng dữ liệu của mình cho đúng, để chuẩn bị mọi thứ theo brand guideline, vào ngay trong knowledge base. Anh nói đừng phụ thuộc vào thiện chí của từng cá nhân chúng ta trong việc cài đúng y hệt một skill. Và chắc chắn đừng để mọi người trong team tự viết skill riêng của mình hết lần này tới lần khác. Theo anh, chuyện đó xảy ra nhiều.
Anh nói (video đăng ngày 20/11/2026) đó là thứ rốt cuộc bạn phải gỡ ra trong quá trình đưa kỷ luật vào và scale các hệ thống AI. Vì về cơ bản bạn có một đống AI tự chế (homebrewed) với những cách tiếp cận bài toán hơi khác nhau, và rốt cuộc nhiều khi không tham chiếu tới cùng một dữ liệu. Nên theo anh, cực kỳ quan trọng là nghĩ về không gian bài toán như một không gian có hình dạng của code (code-shaped), và đặt dữ liệu bạn đang xử lý, kể cả cho knowledge work, vào một chỗ trung tâm được cấu trúc để agent có thể chạy qua, traverse nó một cách hiệu quả.
Theo anh (video đăng ngày 20/11/2026), khi bạn bắt đầu nghĩ về bài toán theo cách đó, bạn sẽ nghĩ về skill khác đi. Skill thường được nghĩ như siêu năng lực để "tôi" dùng AI của mình. Anh cho rằng chúng mạnh hơn nếu bạn nghĩ về chúng như siêu năng lực giúp một AI, bất kể ai trong công ty đang dùng nó, làm việc trên phần knowledge work bạn có ở một chỗ cụ thể. Như vậy skill là một bộ chỉ dẫn để bất kỳ ai, vào với bất kỳ LLM nào, xử lý một loại bài toán cụ thể theo một cách nhất quán. Anh nói đó là một cách tiếp cận rất khác.
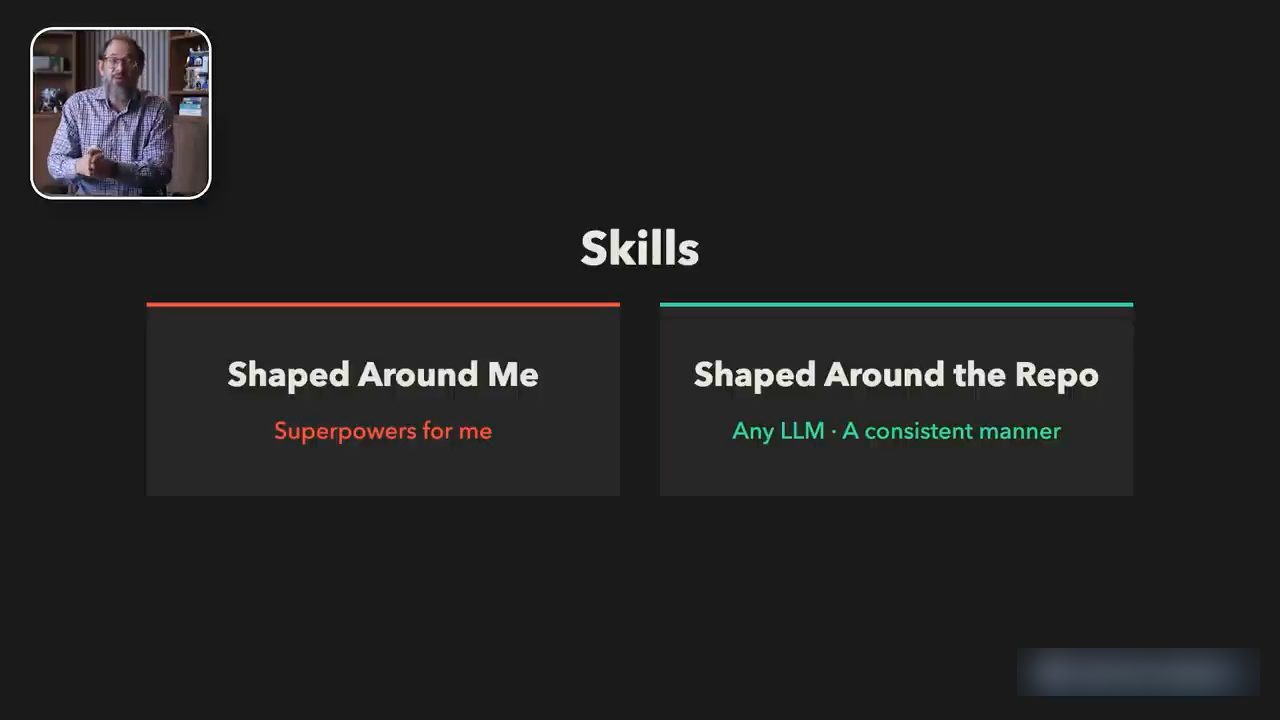
Theo Nate (video đăng ngày 20/11/2026), nếu ta nghĩ về skill như thứ có hình dạng của chính chúng ta (us-shaped), ta sẽ có nhiều nét riêng lẻ (idiosyncrasy) trong cách tiếp cận mọi thứ. Anh nói skill thật ra được xây rất, rất khác khi bạn nghĩ về chúng trước hết như thứ có hình dạng của repo (repo-shaped), trước hết được định hình theo bài toán bạn đang giải với tư cách một công ty hay một team, và chỉ sau đó mới là thứ ai đó cần truy cập được để LLM của họ xử lý.
Anh lấy ví dụ (video đăng ngày 20/11/2026): bạn có một cách riêng để viết PRD, một cách riêng để chuẩn bị đề xuất, một cách riêng để chuẩn bị deck. Theo anh, tất cả những thứ đó là thứ nên được tập trung một chỗ và nên là thứ chung. Và nó trông thật sự, thật sự khác khi bạn viết nó để bất kỳ LLM hay agent nào chạy qua cũng dùng được nó trên phần dữ liệu nằm ngay bên cạnh để làm việc.
9. Meta skill và bắt lỗi trước khi tới khách hàng
Theo Nate (video đăng ngày 20/11/2026), cách này cho phép bạn làm những thứ như meta skill, nơi bạn thật sự có thể có những skill trong repo được thiết kế để hỗ trợ các workflow của con người mà bạn quan tâm. Bạn có thể có những skill nhắc agent báo cho con người: "này, đến lúc bạn làm một lượt chỉnh sửa (edit pass) cho phần này rồi, vì tôi vừa thấy một bản V12 được đưa vào, và bạn cần xem qua trước khi ta đi tiếp".
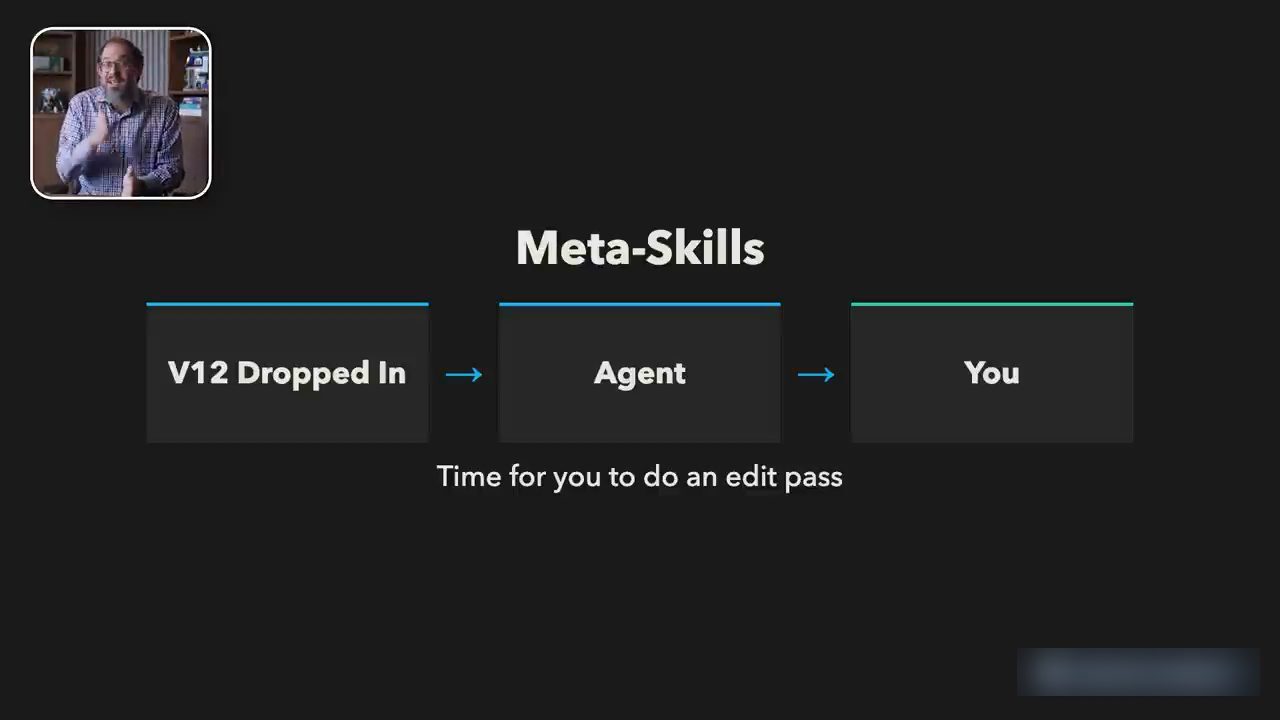
Anh nói (video đăng ngày 20/11/2026) đó là loại việc giả định có một hệ thống nhiều agent, và bạn không thật sự có được nó nếu nghĩ về chuyện này theo kiểu cá nhân. Theo anh, cách tiếp cận này, cách tập trung dữ liệu này, có nhiều hệ quả, và chính nó là thứ cho phép bạn bắt những lỗi kia trước khi chúng tới tay khách hàng.
10. Theo Nate, AI không phải một mini-me
Theo Nate (video đăng ngày 20/11/2026), bạn không cần một cuốn hướng dẫn cho từng người để họ làm việc của mình với AI. Anh nói ý tưởng AI là một mini-me là không đúng. Thay vào đó, bạn cần ở vị trí mà tất cả có thể cộng tác trên cùng những cấu trúc dữ liệu để làm ra công việc nhất quán cho team và cho công ty. Và điều đó cho phép một mức độ sở hữu và trách nhiệm (ownership, accountability) của con người.
Anh nói (video đăng ngày 20/11/2026) anh biết mình đã nói về agent nhiều, nhưng điều này thật ra hỗ trợ công việc của chúng ta, vì nó cho phép ta tập trung vào giá trị của sản phẩm cuối (final deliverable) thay vì ám ảnh xem mình có năng suất hơn một chút với một skill khác hay không. Anh nói anh thấy nhiều "skill theater", nhiều "mini-me theater", nhiều người cố nói rằng setup cá nhân của họ năng suất hơn, trong khi thật ra những setup đơn giản hơn, chỉ đặt dữ liệu vào một chỗ, cho agent xử lý không gian đó, rồi tập trung hoá nhiều skill bạn cần để xử lý các không gian bài toán này và để những skill đó hỗ trợ workflow, là thứ bắt đầu scale được.
Theo anh (video đăng ngày 20/11/2026), khi đó bạn có thể tập trung vào việc chịu trách nhiệm với khách hàng (client, customer). Để bạn không rơi vào tình huống nói: "à, AI viết cái đó, không phải tôi". Anh nói không: bạn viết nó, bạn sở hữu nó. Theo anh, đó là loại việc con người cần làm nhiều hơn.
11. Role và permission trong một repo chung
Nate nói tiếp về một hệ quả khác (video đăng ngày 20/11/2026). Anh nói ta đã bàn chuyện này có hình dạng của team, và về việc hỗ trợ workflow của team. Theo anh, phân quyền và ra quyết định (permissioning, decisioning) cũng dễ hơn ở hình dạng này, khi repo là đối tượng trung tâm trong hệ thống dữ liệu của bạn. Lý do anh đưa ra là khi đó bạn có thể mã hoá vào hệ thống hành vi mong đợi của các role khác nhau đang truy cập nó.
Theo anh (video đăng ngày 20/11/2026), trong những hệ thống tinh vi hơn, bạn hoàn toàn có thể siết chặt điều đó bằng guardrail để bảo đảm mỗi agent chỉ có những permission bạn cho phép. Anh nói có nhiều hệ thống enterprise đang đi theo hướng đó, nơi họ có cấu trúc định danh và phân quyền (identity, permission) được siết chặt hết, để agent chỉ làm được một số việc nhất định.
Nhưng theo Nate (video đăng ngày 20/11/2026), kể cả trong một môi trường đơn giản hơn, bạn vẫn đi được một quãng dài nếu bạn ghi rõ bên trong repo đó agent của PM làm gì, agent của kỹ sư làm gì, agent của một contractor được phép làm gì. Điều đó cho phép bạn bắt đầu nhìn vào role và permission cụ thể mà các agent này có để thay đổi thứ gì trong repo, để bạn không thể bị ai đó ghi đè (overwrite) chỉ vì họ tình cờ xem được repo bằng agent của bạn. Anh nói đó là thứ mọi người không nghĩ tới nhiều lắm.
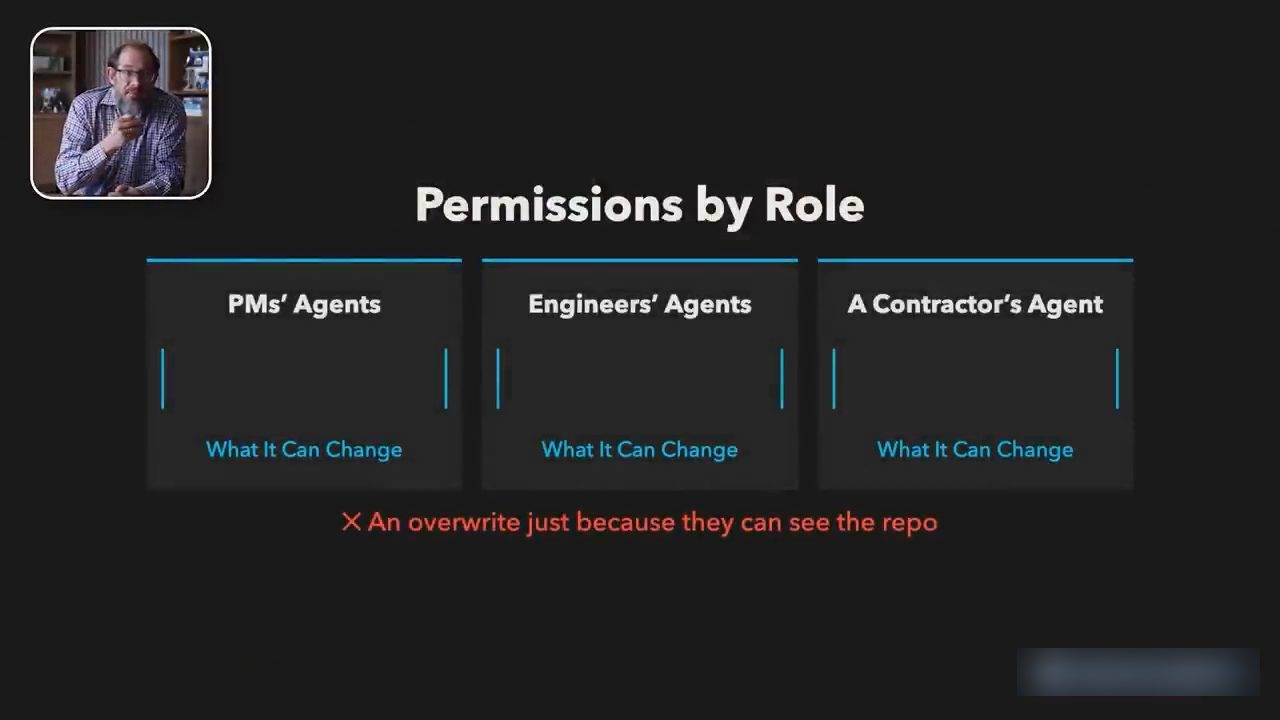
Anh nói rõ (video đăng ngày 20/11/2026) anh không ở đây để bảo bạn rằng đặt một file markdown mô tả role và những gì bạn được làm là giải pháp. Nó không phải là giải pháp duy nhất. Anh tin chắc vào guardrail cho agent. Anh tin vào phân quyền, định danh. Theo anh, có cả một ngành công nghiệp khổng lồ giúp các doanh nghiệp thiết lập những thứ đó.
Nhưng anh cũng biết thực tế (video đăng ngày 20/11/2026): không phải ai cũng trả nổi chuyện đó. Không phải ai cũng thiết lập được. Đó không phải thứ có sẵn ngay (out of box) cho tất cả mọi người. Theo anh, trong lúc chờ, ta cần những giải pháp giúp ta đi được 80, 90 phần trăm quãng đường rồi để con người giám sát từ đó. Anh nói loại giải pháp này đơn giản, scale được, và nó thật sự đưa bạn đi được một quãng dài tới đó.
12. Tránh va chạm khi nhiều agent cùng làm
Nate chuyển sang một số hệ quả và thách thức đi kèm cách tiếp cận này (video đăng ngày 20/11/2026). Khi có nhiều agent và nhiều người cùng làm trên một hệ thống, bạn xử lý cái mà trong code ta gọi là merge conflict thế nào? Bạn xử lý race condition thế nào? Anh nói một cách nói ít cầu kỳ hơn, ít mang tính kỹ thuật hơn, là: bạn xử lý thế nào khi nhiều người cùng chạm vào một thứ và xung đột nảy sinh khi các bạn sửa chồng lên nhau?
Theo anh (video đăng ngày 20/11/2026), có cách làm tệ và có cách làm tốt. Anh nói, không may là các phòng lab đã viết về cả hai cách. Họ đã nói về ý tưởng rằng nếu bạn chỉ để agent túa ra (swarm) và kiểu như cộng tác trên việc này mà không có cấu trúc, thì làm vậy rất khó. Bạn gặp nhiều race condition. Bạn gặp nhiều va chạm (collision).
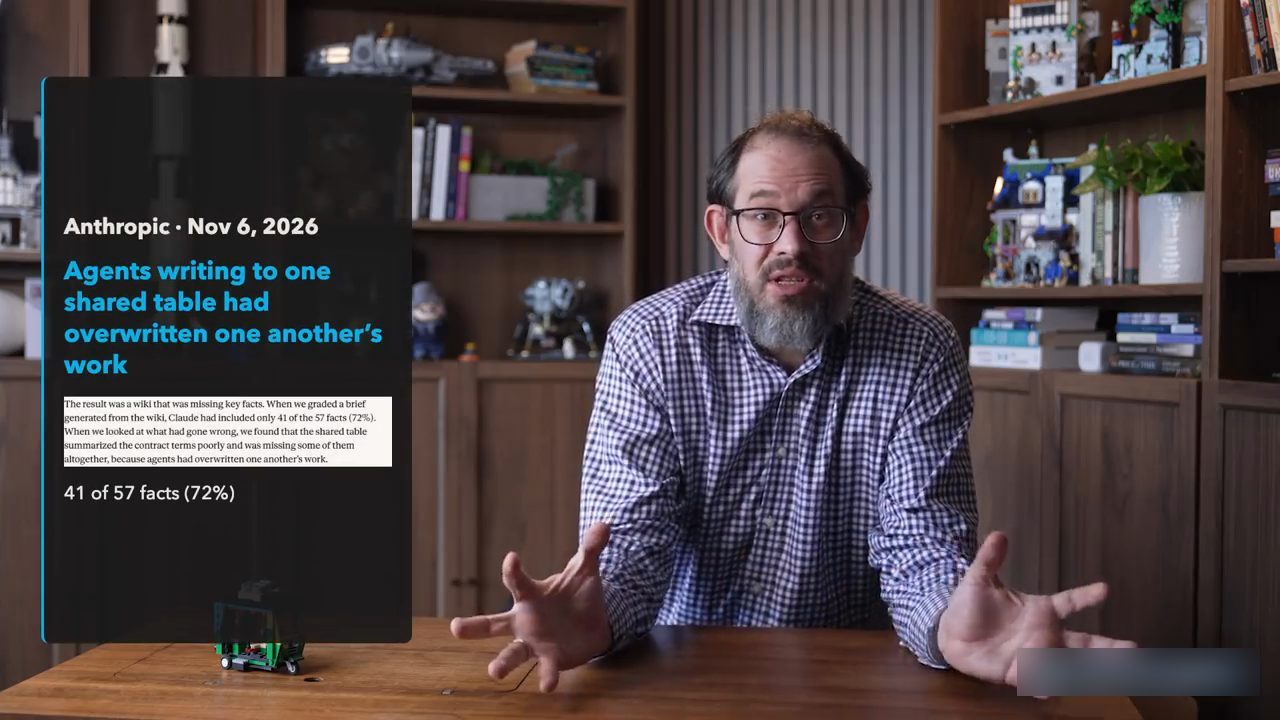
Theo Nate (video đăng ngày 20/11/2026), một trong những điều tích cực đã xuất hiện, một cách làm khác, là thứ mà giới kỹ thuật gọi là tách biệt mối quan tâm (separation of concerns). Ở đó bạn chia nhỏ ra và nói: với mỗi phần việc ta đang làm, ta có một trang riêng. Trang đó nằm trong một thư mục riêng về một chủ đề cụ thể ta đang làm. Anh nói điều đó đúng bất kể bạn đang làm loại việc gì.
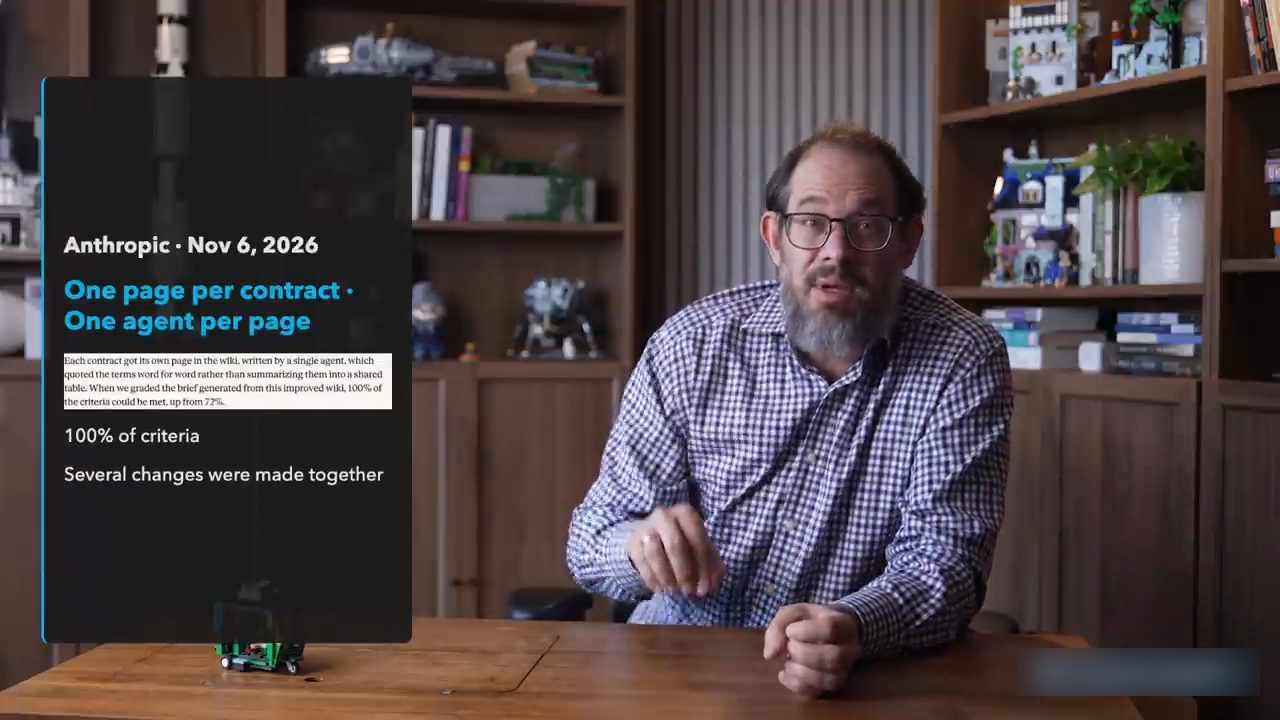
13. Một trang cho mỗi phần việc
Theo Nate (video đăng ngày 20/11/2026), về cơ bản điều này tương tự như fork một số phần của repo ra để bạn có thể làm trên chúng trong một môi trường work tree. Trong môi trường knowledge work, bạn chỉ đơn giản là tạo một trang cho phiên bản này. Agent của bạn đã được huấn luyện, bởi các skill nằm trong repo mà anh đang nói tới, để nói: "được rồi, Nate đang làm phiên bản 15. Ta bắt đầu một deck mới cho phiên bản 15. Ta sẽ không dùng lại phiên bản 14. Ta fork nó ra. Nate sẽ làm trên đó. Nó sẽ nằm trong cùng thư mục. Và khi Nate làm xong, tôi được các skill trong repo huấn luyện để đi báo Jane bên này rằng nó đã sẵn sàng cho Jane xem."
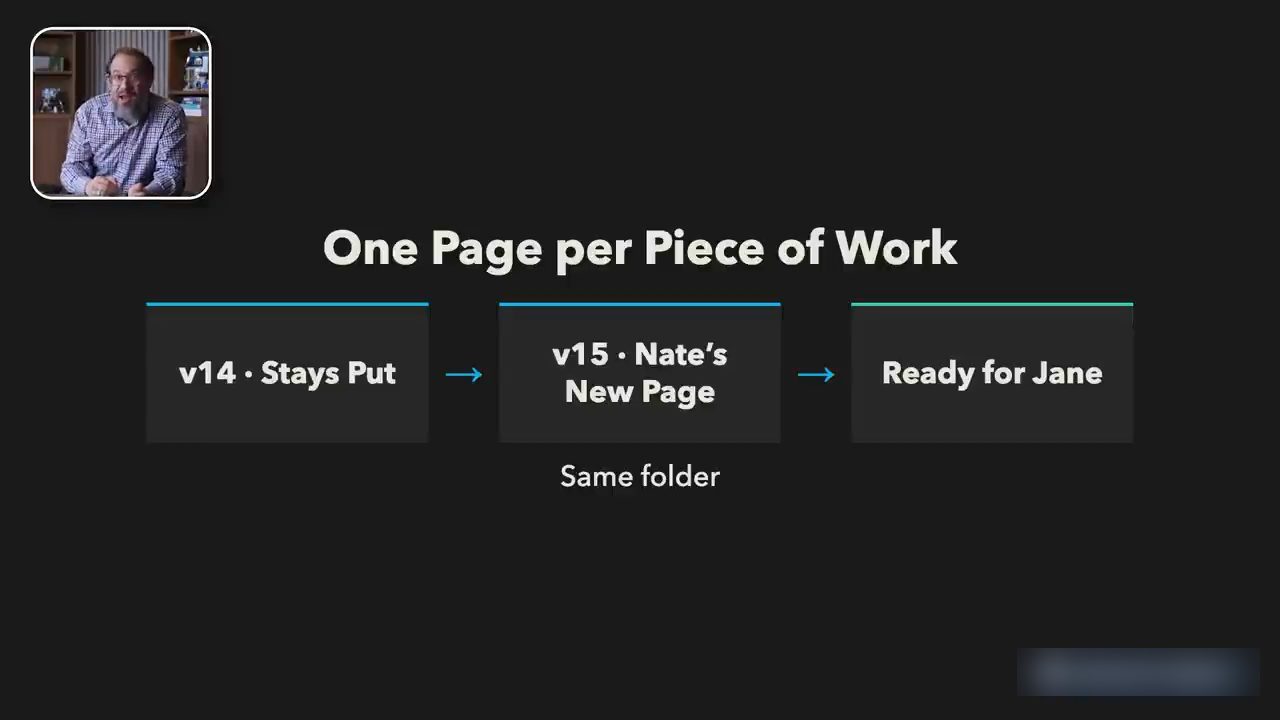
Anh nói (video đăng ngày 20/11/2026) loại kỷ luật này thật sự quan trọng. Và theo anh, tập trung các cấu trúc dữ liệu cho phép bạn áp đặt kỷ luật đó và giảm thiểu những va chạm kiểu này.
14. Đánh giá xem cách này có hiệu quả không
Nate muốn nói một chút về cách đánh giá thành công ở đây (video đăng ngày 20/11/2026). Khi ta làm loại việc này, làm sao bạn biết nó thật sự tốt hơn? Câu trả lời dễ là hỏi: mọi người có tiết kiệm được thời gian không? Anh nghĩ câu trả lời đó hơi rẻ một chút.
Anh nghĩ (video đăng ngày 20/11/2026) một câu trả lời tốt hơn là hỏi: bạn có thật sự ít bị ngắt quãng bởi những thứ bạn không quan tâm hơn không? Bạn có ít va chạm hơn, như vừa bàn không? AI của bạn làm được gì có rõ ràng hơn không, vì AI của bạn đang tham chiếu tới những thứ trung tâm của team như mục tiêu, skill, charter, thứ bạn đang theo đuổi, chiến lược, vân vân, theo cách nó hiểu hiệu quả? Bạn có phải giải thích bản thân ít hơn không? Bạn có nắm được những điều then chốt cần nắm nhanh hơn không? Có nhiều signal quay về với bạn hơn và ít noise hơn không, vì bạn có đúng skill trong repository để nói: "này, khi những xung đột kiểu này nảy sinh, nếu tôi thấy bản ghi của một hợp tác với khách hàng (client engagement) đi qua mà có hai hay ba deliverable xung đột với nhau, với mục tiêu và mốc thời gian khác nhau, tôi cần đưa nó lên cho một role cụ thể trong team xử lý"?
Theo anh (video đăng ngày 20/11/2026), đó là thứ bạn thật sự có quyền làm và áp đặt ở cấp trung tâm, một khi bạn đã tập trung dữ liệu này và bắt đầu tập trung các skill để làm việc trên nó.
Anh nói thêm (video đăng ngày 20/11/2026): đúng vậy, anh đưa cả thư từ với khách hàng (client correspondence) vào, vì việc chạy một job định kỳ để kéo thư từ của những khách hàng bạn quan tâm và đặt thẳng vào repo, để agent cũng xem được, là tương đối dễ. Theo anh, việc đó không khó. Và nó cho phép bạn dựa vào đó để đi tiếp khi bạn bắt đầu xây.
Và như thế, theo Nate (video đăng ngày 20/11/2026), bạn nên đánh giá việc này bằng cách xem những câu hỏi mà agent đưa lên cho bạn có hữu ích hơn không. Và nếu agent của bạn hoàn toàn không hỏi bạn câu nào, thì đó là một câu hỏi dành cho bạn. Anh nói đó là thứ bạn nên xử lý. Đó là một dấu hiệu cho thấy bạn đang phải tự lái từng việc nhỏ nhất, và có lẽ bạn đang quá căng thẳng và quá tải.
15. Có mất việc không, và một đêm làm việc của agent
Nate nói (video đăng ngày 20/11/2026) bạn có thể tự hỏi: nếu chuyện này diễn ra tốt, tôi có mất việc không? Tôi có tự động hoá mất phần thật sự quan trọng của mình không? Câu trả lời của anh là hoàn toàn không.
Theo anh (video đăng ngày 20/11/2026), khả năng của chúng ta trong việc hiểu và xử lý vấn đề cho khách hàng là thứ làm công ty và team của chúng ta mạnh. Đó là thứ ta muốn giải phóng bản thân để có nhiều thời gian hơn cho nó. Và cách duy nhất để làm được điều đó là nếu ta thật sự cấu trúc được công việc của agent để nó không đẩy thêm việc cho ta.
Anh nói (video đăng ngày 20/11/2026) đó là điều giải phóng ta để thật sự làm những lần chạy agentic dài hơn, để nói: "này AI, tôi về đây. Bạn có tám tiếng để làm việc này, hay 10 tiếng, hay bao nhiêu cũng được. Đây là ba việc mà tôi nghĩ là ưu tiên hàng đầu. Nhưng bạn cũng xem lại những gì người khác đã làm trong repo, thêm vài ưu tiên vào đó, xử lý tất cả trong đêm, và tôi muốn thấy các bản nháp trên bàn mình vào buổi sáng." Theo anh, bạn có niềm tin rằng việc đó sẽ được làm tốt, vì bạn đã chọn và dựng nên một cấu trúc giúp AI làm tốt việc đó.
16. Bắt đầu một mình với một việc bạn cứ phải giải thích lại
Theo Nate (video đăng ngày 20/11/2026), nếu bạn đang muốn bắt đầu: hãy chọn một việc mà bạn cứ phải giải thích và sửa lại. Đưa cho AI thông tin thật và cập nhật (real current information) và những chỉ dẫn đã lưu lại, rồi thử lại trong một cuộc chat mới. Bạn có làm cho AI học được điều gì không? Anh nói đó chỉ là một thí nghiệm ở cấp cá nhân mà bạn có thể chạy. Bạn không cần phải thuyết phục CTO đồng ý với cả một cấu trúc dữ liệu tập trung và mọi thứ đi kèm để thử việc đó.
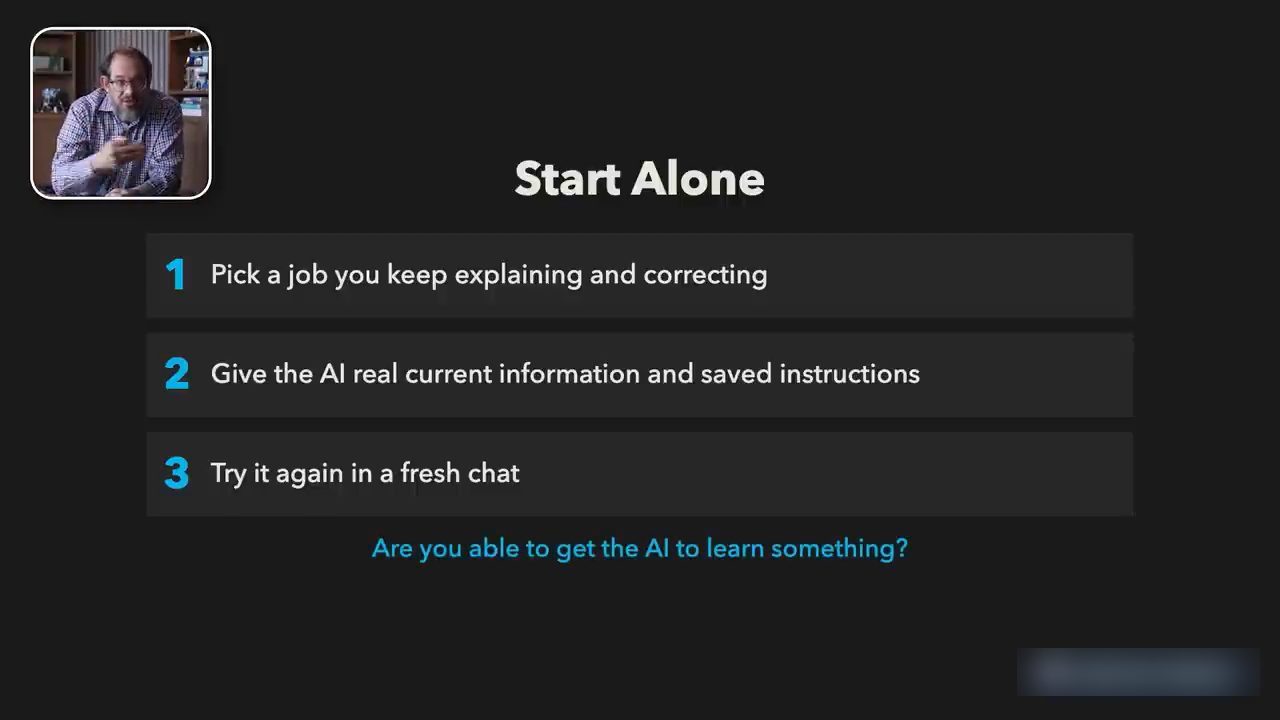
Theo anh (video đăng ngày 20/11/2026), bạn có thể học cách dùng AI hiệu quả hơn chỉ bằng việc giỏi hơn trong khâu chuyển cho nó những chỉ dẫn đang thay đổi, và chủ ý hơn về việc đó. Anh nói một phần bí quyết của anh khi làm việc với model mới là anh chủ ý học từ kinh nghiệm cũ với các model, không lặp lại cùng những sai lầm, tự phê bình thành tiếng khi nói ra những gì mình đang học, và hỏi model: "bạn có thể mở ra hướng mới ở đây không?"
Theo Nate (video đăng ngày 20/11/2026), nếu bạn muốn thôi phải sửa những thứ có cảm giác như cùng một chuyện lặp đi lặp lại, và nếu bạn chưa có quyền khởi động một cấu trúc lớn hơn mà mọi người cùng đóng góp vì bạn không ở vị trí đó trong công việc, thì hãy bắt đầu từ đó. Hãy bắt đầu bằng việc cố làm cho AI học được từ cách bạn suy nghĩ.
17. Nghĩ về nó như một bài toán của cả team
Theo Nate (video đăng ngày 20/11/2026), team leader và CTO cần hiểu rằng cách họ cấu trúc dữ liệu là một câu hỏi ảnh hưởng tới năng suất của cả tổ chức, và đó là thứ họ cần nghĩ thấu thật sự có chủ ý. Anh nói anh mới chỉ chạm tới bề mặt.
Theo anh (video đăng ngày 20/11/2026), với phần lớn chúng ta, ta đang cố tìm cách thiết lập những hệ thống này để chúng chạy scale được, chạy đúng, mang lại giá trị thật, và đó là toàn bộ ý nghĩa của việc này. Nếu không, ta chỉ đang làm "productivity theater".
Anh gọi đây là một lời kêu gọi nghĩ về bài toán theo cách khác (video đăng ngày 20/11/2026). Đừng nghĩ về nó như một bài toán năng suất cá nhân. Đừng nghĩ về nó như chỉ có bạn và AI của bạn. Theo anh, đúng là bạn có thể năng suất hơn. Bạn hoàn toàn có thể dạy AI của mình hiệu quả hơn bằng cách đưa cho nó những chỉ dẫn tốt hơn, thay đổi dần khi bạn học thêm. Hoàn toàn được. Nhưng ở bất cứ chỗ nào có thể, hãy nghĩ về nó như một bài toán lớn hơn của team, để bạn cấu trúc dữ liệu của team theo cách cho phép các agent cộng tác hiệu quả. Anh nói đó là tương lai, và đó là thứ mở khoá những lần chạy lớn hơn này.
Nguồn và liên kết 5 nguồn
- Tên gốc: Anthropic Ran 1,000 AI Agents For 8 Days. Yours Still Needs The Same Thing Explained Again.
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=v5I0nOoqAV4 youtube.com
- Kênh YouTube AI News & Strategy Daily | Nate B Jones (Nate B Jones): youtube.com/channel/UC0C-17n9iuUQPylguM1d-lQ youtube.com
- Anthropic, "The components of agent memory", ghi ngày đăng Nov 6, 2026; bài kể các agent ghi vào một bảng chung khiến bản brief chỉ có 41 trong 57 fact (72%), và sau khi mỗi hợp đồng có một trang riêng thì 100% tiêu chí được đáp ứng (đọc ngày 20/11/2026): anthropic.com/research/components-of-agent-memory anthropic.com
Related talks
Thôi viết prompt cho Claude, hãy làm harness engineering
Austin Marchese · Austin Marchese · 16 min
Bốn layer của harness engineering, tám thành phần của một harness, và cách dựng internal knowledge harness đầu tiên trên Claude Code với giao diện web local.
Vì sao tôi tự xây Agentic OS và nó hoạt động thế nào
Rayan · Build n Bloom · 15 min
Tour một agentic OS tự xây trên Claude Code và Obsidian: research engine, launch kit, skill, vault memory, missions và giới hạn của sự tự động.
Bốn chữ C của một AI second brain: Context, Connections, Capabilities, Cadence
Cole Medin · Cole Medin · 21 min
Cole Medin đi qua bốn chữ C để dựng hoặc audit một AI second brain chạy bằng Claude Code và folder Markdown, mỗi chữ C kèm một bài kiểm tra.