Bạn đang dùng subagent sai cách, theo bài viết của Anthropic
Khi nào nên gấp subagent vào main agent loop, chia việc theo context thay vì problem type, và hai anti-pattern khi dùng coding agent.
✓ Đã duyệt độc lập · cập nhật 26/10/2026 · 27 min
1. Bài viết của Anthropic và subagent là gì
Ray mở đầu: vài ngày trước khi video này đăng (26/10/2026), Anthropic ra một bài viết hoàn toàn về thiết kế subagent, và về việc nhiều kỹ sư có thể đang dùng subagent sai cách trong workflow của chính mình. Anh muốn đào sâu vào bài này vì theo anh, đây lại là một ví dụ rất hay của "bitter lesson" (bài học cay đắng) khi áp vào chuyện điều phối agent (agent orchestration).
Thông điệp chính của bài, theo cách Ray tóm lại trong video đăng ngày 26/10/2026: nếu bạn build một agent có cả một loạt subagent, thì nhiều subagent trong số đó có lẽ nên được "gấp" (fold) ngược lại vào main agent loop. Bài viết chủ yếu nói về agent hướng tới khách hàng, ví dụ agent hỗ trợ khách hàng (support agent), nhưng Ray cho rằng các ý tưởng này vẫn áp dụng khá tốt cho coding agent.
Anh nói trước lộ trình: đi qua những gì Anthropic tìm thấy, subagent tốt cho việc gì, cái bẫy mà nhiều công ty rơi vào, vì sao một vòng lặp đơn (single loop) lại chạy được; còn nửa sau sẽ tập trung vào chuyện áp dụng cho coding agent và một số anti-pattern mà anh đang thấy (video đăng ngày 26/10/2026).
Để nhắc lại, theo định nghĩa Ray đưa ra: một subagent là một agent có context window riêng, bộ tool riêng và bộ hướng dẫn (instructions) riêng. Subagent có thể được một kỹ sư con người định nghĩa sẵn từ trước, hoặc được tạo theo nhu cầu (on demand) bởi một agent điều phối chính (main agent coordinator) ngồi ở trên cùng, tạo ra chúng rồi giao việc cho chúng (video đăng ngày 26/10/2026).
Theo Ray (video đăng ngày 26/10/2026), subagent thường rất giỏi ở hai việc. Thứ nhất là review và verification, khi bạn muốn một "đôi mắt mới" (fresh pair of eyes) kiểm tra lại công việc. Thứ hai là làm việc song song (parallel work), khi bạn muốn vài việc thật sự độc lập với nhau được làm cùng lúc.
2. Ba trường hợp nên giữ một subagent
Để nghĩ xem khi nào nên dùng subagent, Ray gợi ý xét chiều ngược lại: khi nào nên giữ một subagent. Theo bài viết của Anthropic (đọc ngày 26/10/2026), như Ray trình bày, có ba trường hợp.
Trường hợp thứ nhất: khi một single-agent loop gặp sự suy giảm hiệu năng đo được (measurable performance degradation). Ray nhấn mạnh chữ then chốt là "đo được": không phải kiểu "tôi lỡ nói một điều hai lần", mà là có một sự sụt giảm thật trong các eval của bạn (video đăng ngày 26/10/2026).
Trường hợp thứ hai: khi bạn có nhiều task độc lập cần chạy song song, mỗi task có một context window mới, sạch, và có thể vứt đi ngay khi task xong (theo bài viết của Anthropic, đọc ngày 26/10/2026).
Trường hợp thứ ba: khi một agent đơn lẻ khó chọn đúng tool, hoặc system prompt của bạn có những chỉ dẫn thật sự mâu thuẫn với nhau (video đăng ngày 26/10/2026).
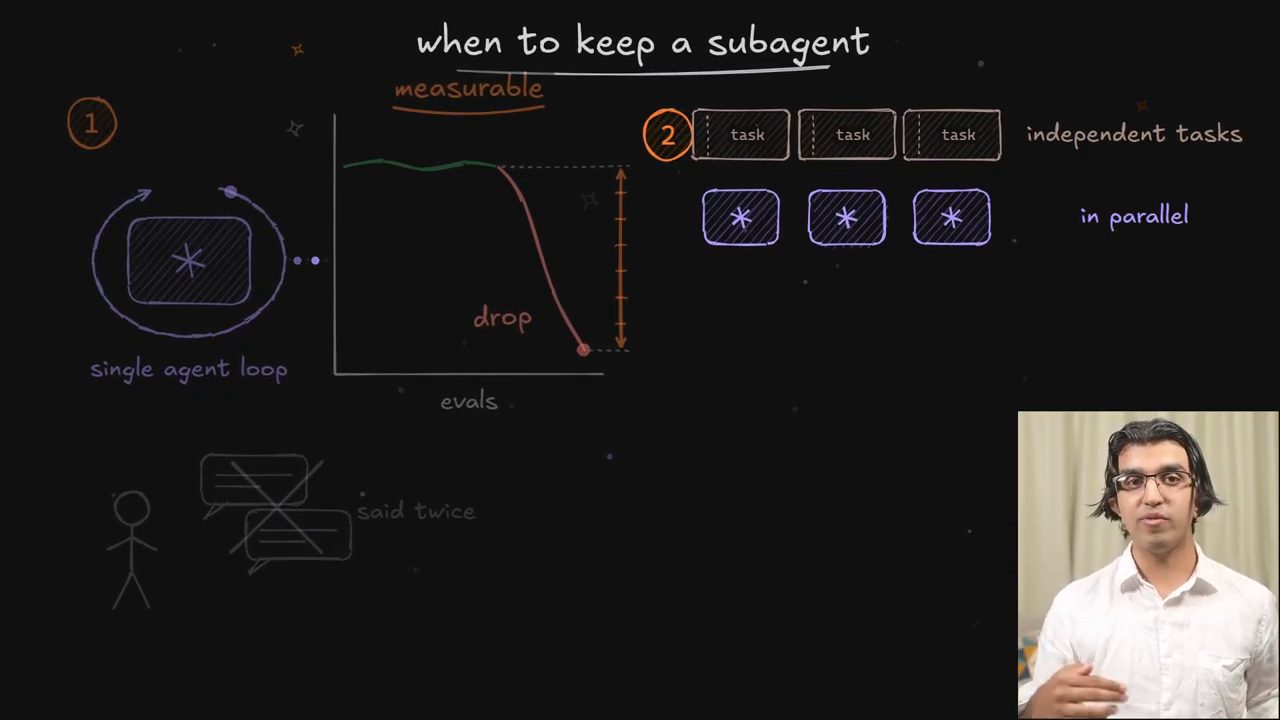
Ray để ý bài viết nhắc tới eval khá nhiều. Theo anh kể, bài khuyên dùng skill /claude-api với lệnh build eval để giúp bạn dựng các eval này; trên màn hình lúc đó là dòng /claude-api build-eval cạnh một biểu đồ cột có nhãn "evals" (bài viết đọc ngày 26/10/2026 cũng liệt kê /claude-api build-eval trong bộ Claude API skills mà Anthropic phát hành).
Điều mà team Applied AI ở Anthropic cứ liên tục thấy, theo Ray thuật lại từ bài viết (đọc ngày 26/10/2026): các doanh nghiệp giao cho mỗi team, hoặc mỗi loại vấn đề (problem type), một subagent riêng, và rốt cuộc kiến trúc agent trở thành bản sao sơ đồ tổ chức (org chart) của chính họ.
3. Conway's law: kiến trúc agent thành bản sao sơ đồ tổ chức
Ray gọi đó là Conway's law đang diễn ra trong thực tế. Nếu bạn chưa nghe tới, đại ý đây là lý thuyết cho rằng các tổ chức sẽ thiết kế ra hệ thống sao chép lại cấu trúc giao tiếp của chính tổ chức đó.
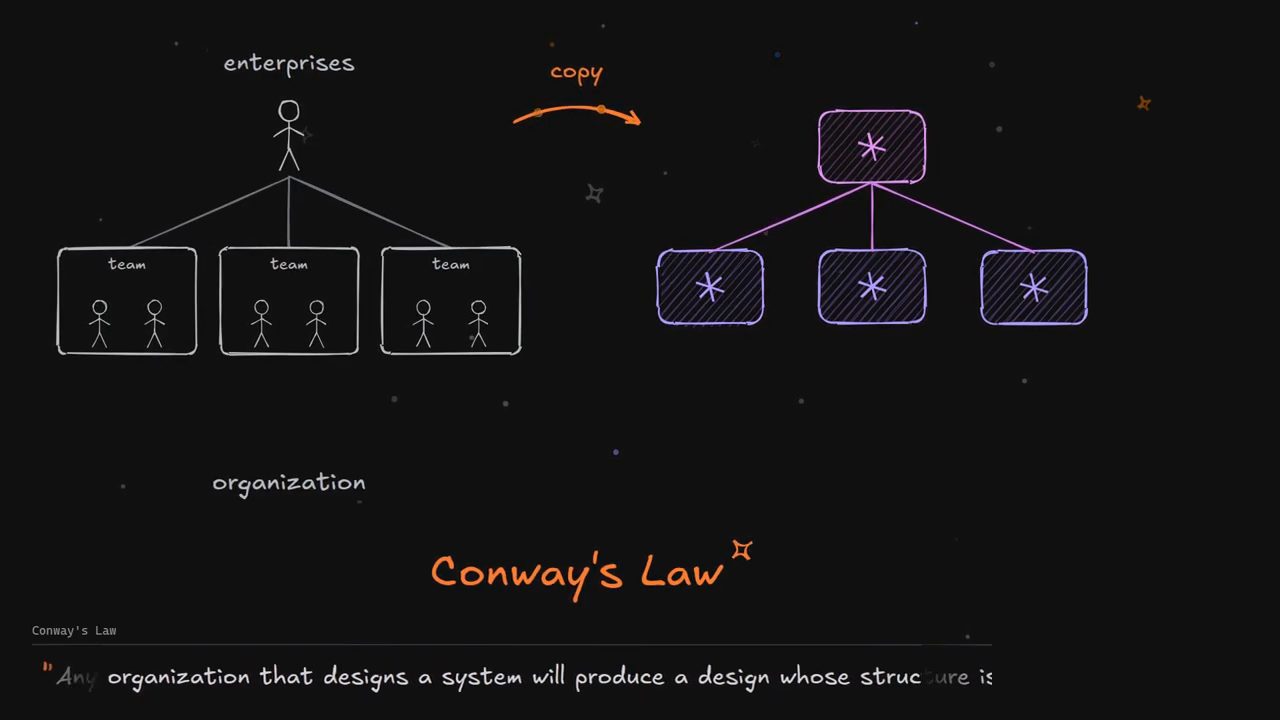
Ray cho xem một sơ đồ hay về Conway's law, về cơ bản nói rằng cấu trúc của phần mềm sẽ phản chiếu cấu trúc của tổ chức đã build ra nó. Ví dụ, một tổ chức có nhiều team nhỏ phân tán dễ tạo ra một kiến trúc service dạng module (modular), trong khi các team lớn ngồi cùng một chỗ (co-located) dễ tạo ra một khối monolithic.
Chuyển sang thiết kế subagent và multi-agent: nếu bạn có sáu team, thì nhiều khả năng bạn sẽ có sáu agent, bất kể công việc, bài toán, có thật sự chia ra thành sáu phần hay không. Ray nói chuyện này thường xảy ra theo một kịch bản giống như sau (video đăng ngày 26/10/2026).
4. Kịch bản quen thuộc: mỗi team một subagent
Một công ty muốn build một agent cho khách hàng của mình, để khách nói chuyện qua một ô chat (chat box) nào đó. Đằng sau, ô chat này thực chất đang kéo dữ liệu từ rất nhiều sản phẩm. Vậy nên phía sau một agent duy nhất đối diện khách hàng ấy, thật ra có cả một loạt subagent, vì mỗi sản phẩm do một team khác nhau sở hữu (video đăng ngày 26/10/2026).
Mỗi team rốt cuộc build subagent riêng của mình. Rồi có một team platform trung tâm build một orchestrator ở trên cùng, làm nhiệm vụ định tuyến (route) giữa các subagent và chuyển thông tin qua lại (video đăng ngày 26/10/2026).
Ray lấy ví dụ một công ty e-commerce. Team shipping có thể build một shipping agent với prompt riêng và tool riêng cho API của các hãng vận chuyển (carrier API), mã vận đơn (tracking number) và ngày giao hàng. Team orders build agent riêng với tool riêng cho database đơn hàng. Rồi có thể team refunds build một agent riêng có khả năng thật sự chuyển tiền, với bộ permission và các bước phê duyệt (approval steps) riêng. Cuối cùng, khi khách hàng nói chuyện với support agent, agent đó sẽ điều phối cả một loạt agent billing, shipping, returns, accounts ở phía sau (video đăng ngày 26/10/2026).
5. Năm failure mode mà bài viết nêu ra
Theo Ray, bài viết của Anthropic (đọc ngày 26/10/2026) chỉ ra năm vấn đề của cách làm này.
Thứ nhất là quản lý context (context management). Giờ đây agent điều phối phải quyết định context nào được chuyển qua lại giữa các agent, và các chi tiết có thể bị rơi mất trong quá trình qua lại đó (theo bài viết của Anthropic, đọc ngày 26/10/2026).
Thứ hai là cái bài viết gọi là subagent sprawl (subagent mọc tràn lan). Team nào cũng ship subagent riêng, nên bạn sẽ có một refunds agent, một returns agent, rồi một returns-and-refunds agent, vì không ai buồn kiểm tra, và có người không biết hai cái đầu đã tồn tại. Vấn đề nảy sinh ở chỗ: khi có những subagent trông như trùng trách nhiệm, kiểu refunds và returns, coordinator sẽ phải tốn rất nhiều token và thời gian để suy luận xem nên chuyển cái gì cho cái nào, và có phải chuyển thông tin qua lại giữa chúng hay không. Ray dẫn bài viết: các công ty có thể kết thúc với hàng trăm subagent chồng chéo, không có tiêu chuẩn chung, không có một người chịu trách nhiệm duy nhất (theo bài viết của Anthropic, đọc ngày 26/10/2026).
Thứ ba là "Frankenprompt". Mỗi team thêm một câu vào system prompt của subagent mình, nên bạn có một đống quy tắc mâu thuẫn nhau và về cơ bản không có một giọng điệu nhất quán (consistent voice) nào cả (theo bài viết của Anthropic, đọc ngày 26/10/2026).
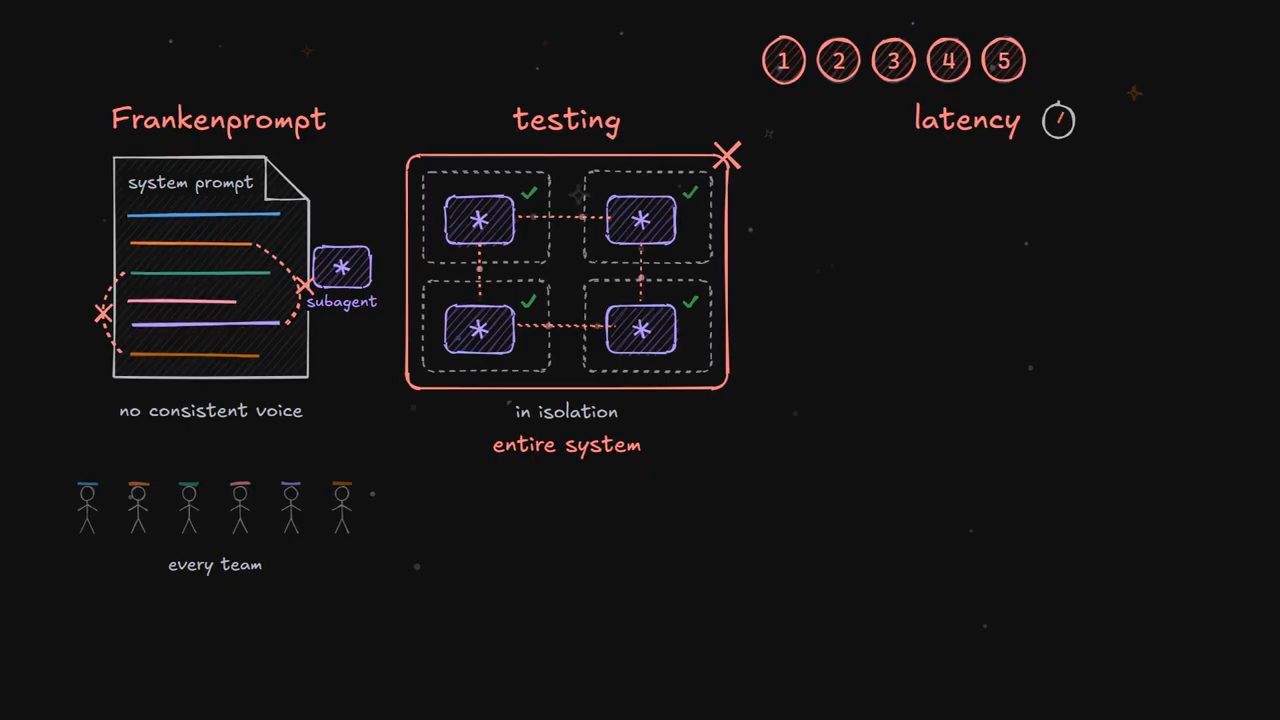
Thứ tư là chuyện test. Theo cách Ray trình bày, mỗi team test agent của mình một cách riêng lẻ, và không ai test toàn bộ hệ thống cùng nhau. (Trong bài viết, đọc ngày 26/10/2026, mục này có tên "Unvetted, overly localized evals": mỗi team thêm eval riêng, tối ưu quá mức cho subtask của mình, và không ai sở hữu hay duy trì cả bộ.)
Thứ năm là latency. Ray nói thường thì bạn sẽ thấy một multi-agent harness phức tạp, khi đem so với một single agent loop, có thể chạy lâu hơn nhiều và còn cho kết quả tệ hơn (theo Ray, video đăng ngày 26/10/2026). Anh kể trong một số hệ thống multi-agent do chính anh thiết kế, anh cũng nhận thấy những vấn đề rất giống vậy.
6. Hệ thống dựng video nhiều agent của Ray
Ray kể: video anh đang trình bày này tất nhiên được Claude làm animation. Nhưng trước đây, anh có một flow khá kỳ quặc: anh bảo Claude chia toàn bộ video thành một loạt clip 30 giây, 60 giây, rồi animate và edit từng clip một (video đăng ngày 26/10/2026).
Animation ra ở cuối thì rất giật cục (janky), thường mắc một loạt lỗi, và các đoạn không ăn khớp với nhau, vì không có một agent nào nhìn thấy được toàn cảnh. Còn khi anh có một coordinator nhìn được toàn cảnh, thì rất nhiều thông tin bị mất khi chuyển qua lại giữa các agent đang làm từng đoạn riêng (video đăng ngày 26/10/2026).
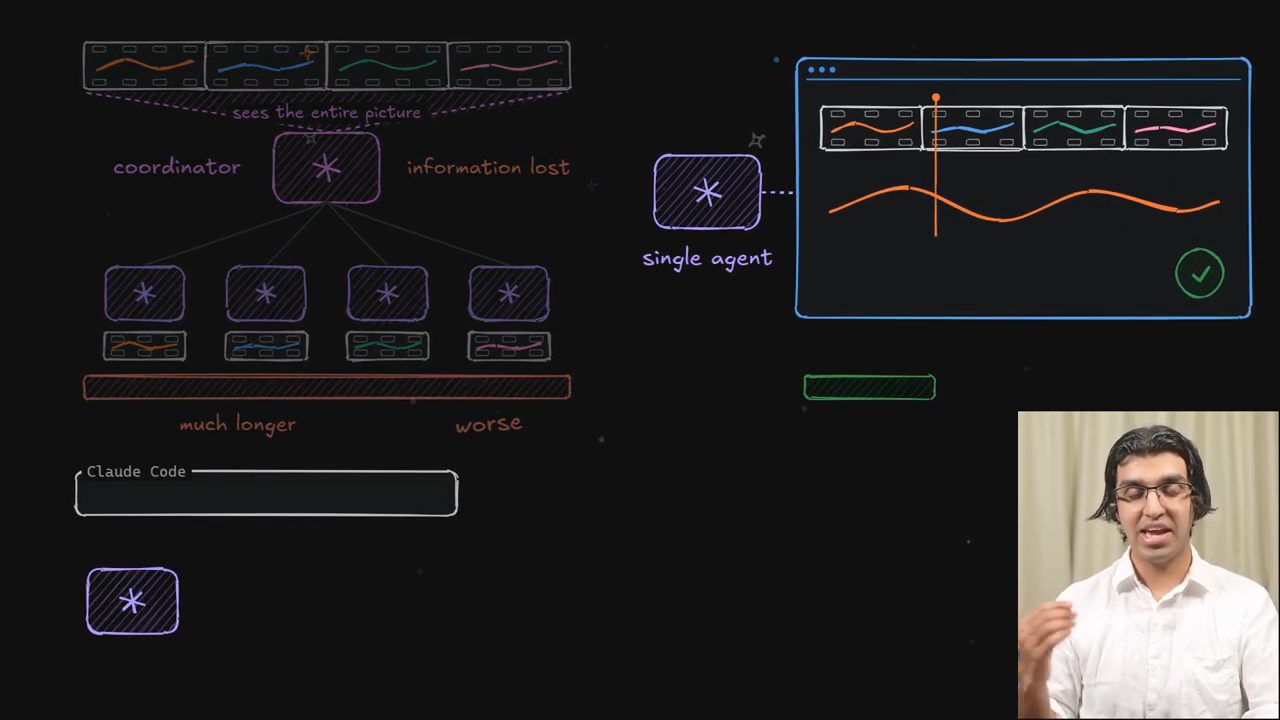
Theo trải nghiệm của Ray (video đăng ngày 26/10/2026), cách chia đoạn đó cũng mất nhiều thời gian hơn hẳn để thực sự làm xong bản edit, và bản edit ra tệ hơn so với khi anh chỉ bảo "này, làm bản edit trong một agent duy nhất đi".
Ray nói bạn có thể đã gặp điều tương tự: có lẽ bạn từng bảo Claude Code "chia việc này ra cho khoảng 10, 20 subagent đi", rồi tất cả chúng quay về và bạn nhận một kết quả tệ hơn nhiều so với khi để một session duy nhất implement (trải nghiệm Ray kể trong video đăng ngày 26/10/2026).
7. Lựa chọn thay thế: agent loop với progressive disclosure
Vậy lựa chọn thay thế là gì? Theo bài viết của Anthropic (đọc ngày 26/10/2026), như Ray thuật lại, đó là một agent loop với progressive disclosure (tiết lộ dần dần). Agent chỉ thấy các mô tả ngắn về skill và tool của nó, và chỉ nạp bản đầy đủ khi cần tới.
Với skill, đó là progressive disclosure của context. Với tool, đó là tool search tool có sẵn trong Claude Code (theo Ray, video đăng ngày 26/10/2026): thay vì nạp toàn bộ định nghĩa tool ngay từ đầu, tất cả đều được hoãn lại (deferred), và agent có thể gọi một tool duy nhất là tool search để tìm tool liên quan.
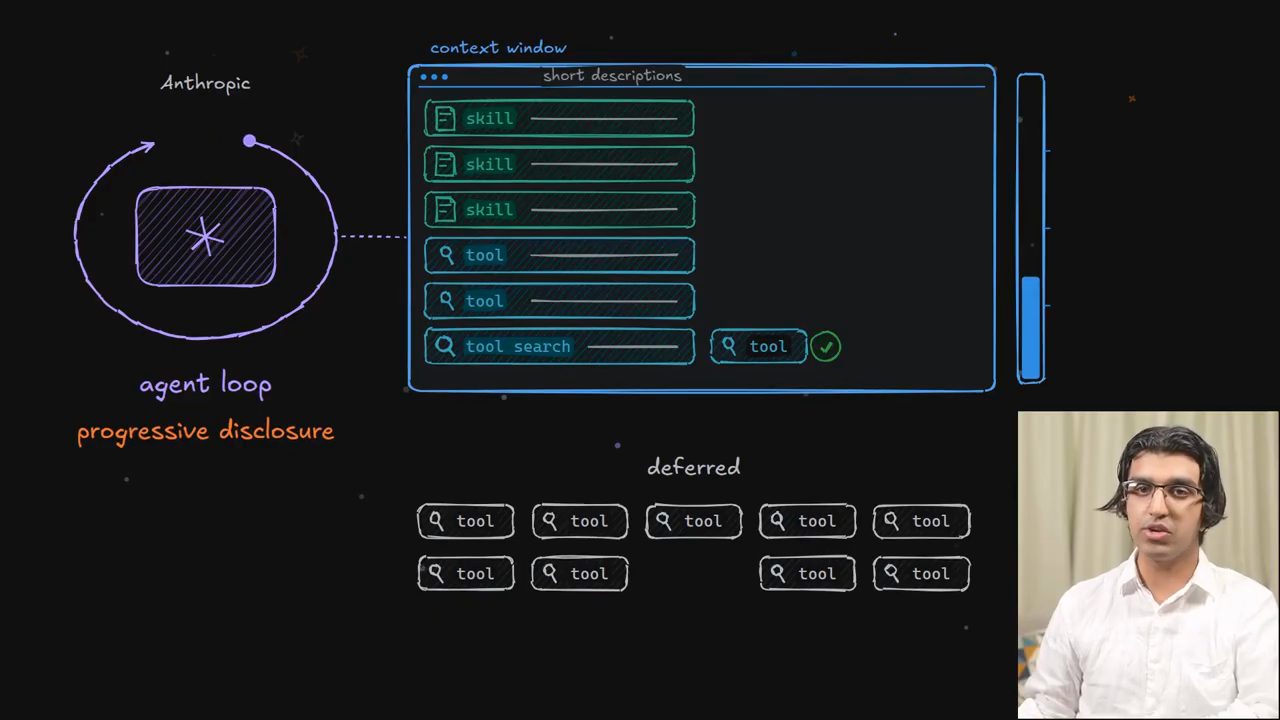
Ray nói bài viết đưa ra ba lý do vì sao cách này hiệu quả. Lý do thứ nhất: shared context (context dùng chung) có thể cho câu trả lời tốt hơn. Với các agent chạy dài, ta muốn context từ nhiều task khác nhau nằm trong main context window, vì một agent đã thấy kết quả của mọi bước trước đó có thể nối các điểm lại với nhau (connect the dots). Điều đó dẫn tới output phong phú hơn và insight tốt hơn, thay vì dùng một tập các bản tóm tắt do subagent trả về. Nó cũng có nghĩa là dùng ít context window hơn và ít lần bàn giao làm mất thông tin (lossy handoff) hơn (theo bài viết của Anthropic, đọc ngày 26/10/2026).
8. Shared context và chuyện "dumb zone" 150.000 token
Một phản bác thường gặp với ý tưởng này: nếu giờ ta muốn mọi thứ từ mọi task nằm chung một context window, liệu có bị context bloat (context phình to) hay context rot (context mục rữa) không?
Ray kể, vì lý do này hay lý do khác, người ta hay nhắc tới con số 150.000 token: vượt qua mức đó là bạn bỗng nhiên rơi vào một "dumb zone" (vùng ngu). Anh nói anh chưa thấy bằng chứng nào cho con số này đến từ các lab. Con số đó có thể đúng với kiểu Opus 4 hay Opus 4.1, nhưng anh thường thấy với Opus 5.5, anh có thể đẩy context window lên khoảng 400.000, 500.000 token một cách thường xuyên mà vẫn nhận được kết quả tốt (trải nghiệm của Ray, video đăng ngày 26/10/2026).
Theo Ray (video đăng ngày 26/10/2026), với các frontier model ngày nay, ta thấy phần context window có thể dùng được ngày càng nhiều hơn so với các model trước, và anh nghĩ điều này sẽ càng đúng theo thời gian khi model tốt lên. Đó là lý do vì sao để context từ nhiều task khác nhau nằm trong main context window lại hợp lý hơn.
Lý do thứ hai bạn không cần quá lo, theo bài viết mà Ray dẫn (đọc ngày 26/10/2026): progressive disclosure có thể ngăn context bloat. Nếu bạn có các file skill và file SKILL.md của bạn dài khoảng 1.000 dòng, thì khi tách nó ra thành các file nhỏ hơn để tận dụng progressive disclosure, bạn sẽ thấy Claude Code chạy tốt hơn nữa. Ray nói bài viết cho rằng Claude Code đã trở nên rất thành thạo trong việc dùng progressive disclosure, nạp đúng context vào đúng lúc (theo Ray, video đăng ngày 26/10/2026). Vậy nên, theo anh, miễn là bạn không có những file "quái vật" (monster files) kiểu này trong codebase thì nói chung không cần lo chuyện này.
9. Model giỏi hơn và tự kiểm tra công việc
Lý do cuối cùng, và theo Ray là một trong những lý do hiển nhiên nhất: model đã giỏi hơn. Bài viết (đọc ngày 26/10/2026) nói model đã trở nên có khả năng quản lý nhiều thứ trong một vòng lặp đơn hơn rất nhiều so với điều mà phần lớn các team từng nghĩ.
Ray dẫn team Applied AI: trong những lần migration họ giúp khách hàng, một cấu trúc multi-agent cứng nhắc thường chính là thứ ngăn một model mới hơn làm được nhiều phần việc hơn (theo bài viết của Anthropic, đọc ngày 26/10/2026). Anh nói sẽ quay lại ý này ở phần sau khi áp các ý tưởng vào AI coding.
Ray nói thêm: ta cũng đang thấy rằng, khi có đúng tool, các model gần đây sẽ tự kiểm tra công việc trong lúc làm (theo Ray, video đăng ngày 26/10/2026). Ví dụ, có thể bạn vẫn luôn viết một quy tắc trong agent của mình, kiểu "verify the refund actually went through" (kiểm tra xem khoản hoàn tiền đã thật sự được thực hiện chưa). Giờ thì về cơ bản bạn không phải viết điều này nữa: nếu bạn cho nó một tool để tự lấy trạng thái refund, bạn sẽ thấy model tự động kiểm tra xem refund đã đi qua chưa, miễn là nó có quyền dùng đúng tool đó.
Giờ quay lại tình huống có một loạt subagent, mỗi cái có bộ tool riêng. Nếu một coordinator quản lý hai agent, và một subagent học được điều gì đó trong khi subagent kia học được điều khác, thì chúng phải chuyển thông tin qua lại thông qua coordinator. Và nếu coordinator đã viết ra một kế hoạch về cách làm hay cách implement, nó phải sửa kế hoạch đó rồi báo cho từng subagent một điều mới (video đăng ngày 26/10/2026).
10. Personas: Ray tự thử và quay về setup cũ
Ray nhắc tới một tweet mà anh thấy rất hay: một kỹ sư Anthropic viết rằng anh ấy không muốn quản lý các agent với những persona khác nhau; nếu trí tuệ thật sự là siêu việt thì không cần tới vai trò (roles); những người tổng quát giỏi (smart generalists) mới là người làm chủ thế giới. Rồi một kỹ sư Anthropic khác trả lời: hoàn toàn đồng ý, tôi nghĩ việc dùng các persona khác nhau sẽ trở thành một anti-pattern trong tương lai gần (video đăng ngày 26/10/2026).
Dù vậy, thay vì tin hết mọi thứ đọc được trên mạng, Ray muốn tự thử, và anh khuyến khích người xem cũng làm như vậy. Trong một khoảng thời gian ngắn, anh chuyển "software factory" của mình sang một phiên bản dùng persona và vai trò. Anh trò chuyện với một agent "chief of staff", agent này lại trò chuyện với một QA agent, một security agent, một analyst, một builder, một reviewer, một growth agent và còn một loạt agent khác nữa (video đăng ngày 26/10/2026).
Anh thử gộp một số vai trò lại với nhau, và cũng thử bỏ bớt agent, nhưng nhìn chung, dù cố thế nào, nó cũng không cho kết quả tốt hơn. Anh nhờ Claude phân tích các session trước đó, so setup cũ với setup mới, và Claude kết luận: đúng, có rất nhiều "ceremony" (thủ tục rườm rà). Theo bản phân tích đó (Ray trình bày trong video đăng ngày 26/10/2026), sản lượng sản phẩm (product output) giảm, chất lượng mỗi PR không đổi, chi phí mỗi PR đi ngang; một loạt lớp mới không thêm được gì, và còn có thêm một "khoản thuế điều phối" (coordination tax) mới chồng lên.
Vậy nên Ray quay về setup cũ cho software factory của mình, và anh quyết định: persona đơn giản là không đáng. Có thể trong tương lai chúng sẽ đáng, khi agent làm việc theo nhóm tốt hơn, nhưng anh thấy khá có khả năng là ta sẽ không cần định nghĩa persona nào cả (video đăng ngày 26/10/2026).
Ray nói rõ đây là chuyện với Opus 5.5 (tính đến video đăng ngày 26/10/2026). Có thể sau vài thế hệ model nữa, kiểu Opus 6 hay Opus 7, bạn chỉ cần trò chuyện với một agent đóng vai chief of staff, rồi nó tự tạo ra các persona khác nhau và cũng tự xóa chúng khi thấy chúng không còn hữu ích nữa. Anh muốn có một khung tư duy (framework) để hiểu vì sao các chiến lược multi-agent này đang thất bại.
11. Swarm Scaling và tham số lambda
Thứ giúp Ray hiểu điều này rõ hơn là bài viết "Swarm Scaling" của Toby Ord, và anh khuyên nên đọc. Trong bài, Toby Ord đi qua một loạt biểu đồ, rồi viết rằng các nhà kinh tế học có một cách nghĩ hay về chuyện này. Họ đã nghiên cứu việc cho nhiều người cùng làm một task có thể giúp nó xong sớm hơn, nhưng thường phải trả giá bằng tổng số giờ công (person-hours) nhiều hơn.
Một cách nghĩ tiện lợi, theo trích đoạn Ray đọc từ bài viết: N người làm cùng nhau làm được khối lượng bằng một người làm trong N mũ lambda lần thời gian. Lambda là tham số đo mức độ có thể song song hóa của task; họ gọi nó là tham số "giẫm chân nhau" (stepping on toes parameter). Nếu lambda bằng 1, bạn có một task song song hóa hoàn hảo, không ai giẫm chân ai và không mất hiệu suất. Nhưng trên thực tế, lambda thường nằm giữa 0 và 1: thêm người thì vẫn giúp được, nhưng lợi ích giảm dần (diminishing returns) (video đăng ngày 26/10/2026).
Ví dụ, nếu lambda bằng 0,5 thì 100 người làm cùng nhau làm được khối lượng bằng một người làm trong 100 mũ 0,5 lần thời gian, tức là chỉ 10 lần (video đăng ngày 26/10/2026).
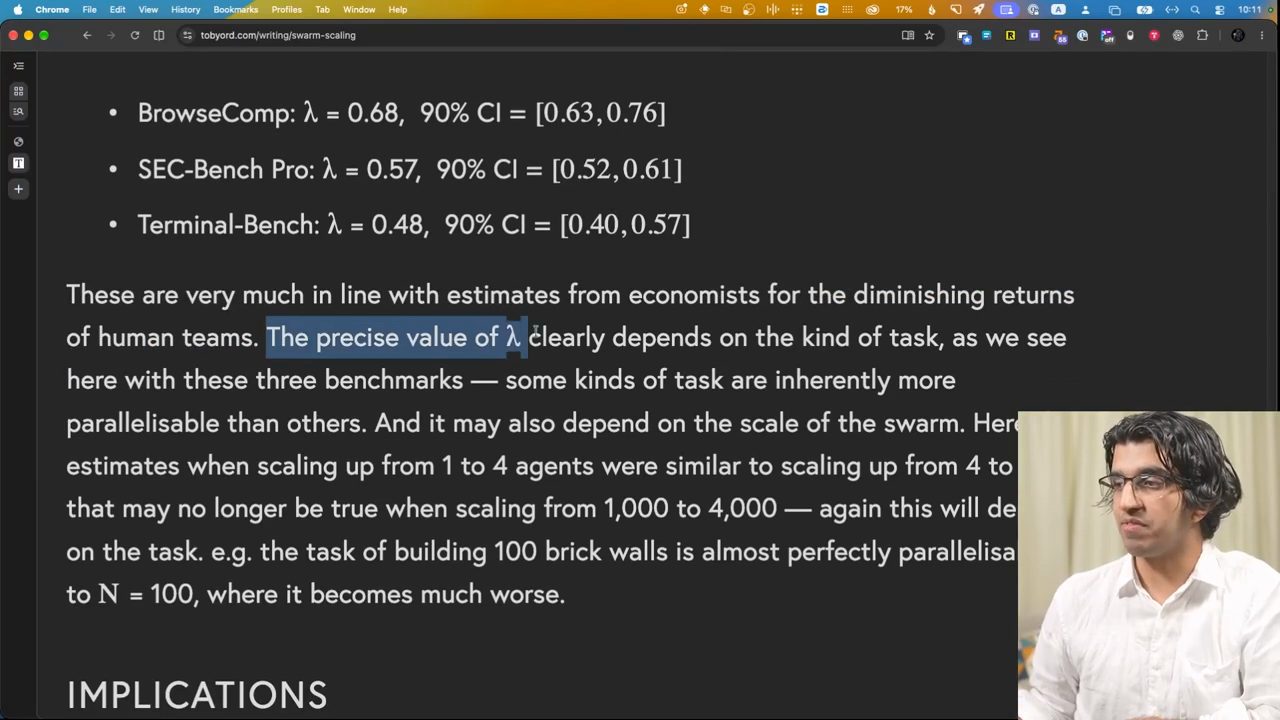
Ray nói thêm: dù người ta chưa thật sự đo lambda cho chuyện các agent làm việc cùng nhau, Toby Ord đã đưa ra một loạt ước lượng kèm khoảng tin cậy. Ray nói với các benchmark liên quan tới coding như Terminal-Bench, lambda vào khoảng 0,5; trên màn hình bài viết ghi Terminal-Bench λ = 0,48. Bài viết viết rằng các con số này rất khớp với ước lượng của các nhà kinh tế học về lợi ích giảm dần của team người. Giá trị chính xác của lambda rõ ràng phụ thuộc vào loại task, như ba benchmark này cho thấy, và có những loại task về bản chất dễ song song hóa hơn những loại khác (video đăng ngày 26/10/2026).
Ray khuyên đọc phần còn lại của bài. Theo anh, đại ý Toby Ord bàn về chuyện ta nên đo lambda với các model AI mới, vì nếu chúng có lambda cao hơn và song song hóa nhiều task tốt hơn, ví dụ lambda 0,9 hay 1, thì chúng có thể thắng các team người nhờ song song hóa tốt hơn. Theo Ray, tính đến video đăng ngày 26/10/2026, lambda của các model AI khá giống team người, và cũng như bạn sẽ không muốn một team 15 đến 20 người cùng làm một feature, bạn cũng không muốn thế với AI agent của mình.
Ray nói có thể nếu lambda tăng lên khoảng 0,9, anh sẽ quay lại setup trước, vì khi đó coordinator sẽ làm tốt hơn trong việc biết trước ai cần task gì, nên nó song song hóa task tốt hơn để xong nhanh hơn. Nhưng theo Ray (video đăng ngày 26/10/2026), có vẻ các model AI lúc đó khá kém trong việc biết một task có thể song song hóa tới mức nào, và đó là lý do các coordinator cho những AI persona hay AI team này không làm tốt. Anh có thể xem lại setup này trong tương lai nếu lambda đạt mức cao hơn, kiểu 0,8 hay 0,9, nhưng anh nghĩ tính tới thời điểm video (26/10/2026), bạn sẽ thấy các hệ thống multi-agent này không làm tốt bằng.
12. Subagent cũ đi đâu: skill, tool và approval gate
Quay lại bài viết gốc của Anthropic về việc fold subagent: vậy một refund agent, một order agent, một shipping agent rốt cuộc sẽ đi đâu? Theo bài viết (đọc ngày 26/10/2026), như Ray thuật lại, chúng nên được định nghĩa dưới dạng skill, nhưng được nạp dần (progressively loaded) bên trong main agent loop.
Còn những giới hạn cứng (hard limits) mà bạn có, như approval gate (cổng phê duyệt), thì nên chuyển vào tool theo cách nào đó (theo bài viết của Anthropic, đọc ngày 26/10/2026). Một cách Ray đưa ra là dùng thứ gì đó như executor.sh, một MCP gateway, và anh tự host (self-host) nó (video đăng ngày 26/10/2026).
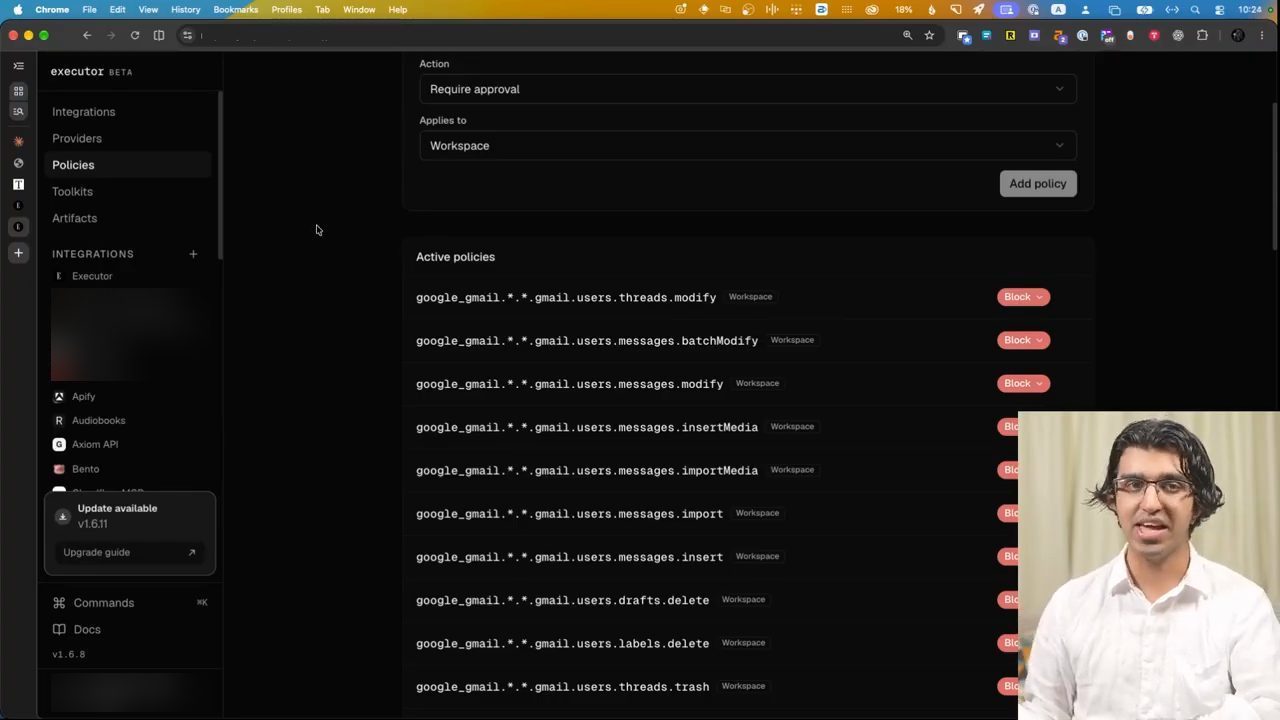
google_gmail.*.*.gmail.users.messages.modify hay ...drafts.delete đều ở trạng thái Block.Trong executor.sh, Ray cho xem tất cả MCP server của anh nằm ở cột bên trái, và có một mục policies. Ở đó anh có thể tạo các policy để một số hành động cần phê duyệt (approval), một số được tự động duyệt, và một số bị chặn (demo trong video đăng ngày 26/10/2026). Anh cho xem anh đã chặn nó làm những việc như gửi email và đại loại vậy. Theo Ray, nếu bạn có một gateway kiểu này, bạn có thể build một hệ thống xoay quanh nó, sao cho mọi hành động nhạy cảm đều cần phê duyệt.
Còn các subagent trước đây như ordering, shipping, refunds thì làm thế nào? Theo bài viết (đọc ngày 26/10/2026), prompt của subagent nên trở thành một skill, còn các API call của nó nên trở thành tool mà main agent dùng được, kèm các permission phê duyệt phù hợp.
Ray nhấn mạnh: tất nhiên các skill này nên được viết sao cho bạn không có một file SKILL.md "quái vật" dài dằng dặc, mà được chia ra thành nhiều file nhỏ hơn, do chính file SKILL.md tham chiếu tới. Như vậy ta đang tận dụng progressive disclosure. Nói cách khác, thay vì một shipping agent hay một refunds agent, ta có một shipping skill và một refunds skill (video đăng ngày 26/10/2026).
13. Hai pattern subagent vẫn hiệu quả và ví dụ team invites
Ray nói rõ: Anthropic không bảo bạn xóa hết subagent. Theo bài viết (đọc ngày 26/10/2026), vẫn có những pattern subagent đơn giản chạy rất tốt. Pattern thứ nhất là generator-verifier: một agent làm việc, và một agent mới tinh kiểm tra lại.
Pattern thứ hai là orchestrator-subagent, trong đó bạn không chia theo loại vấn đề (problem type) như đã nói ở trên, mà chia theo context (theo bài viết của Anthropic, đọc ngày 26/10/2026). Ray đoán người xem đang thắc mắc: chia theo context khác chia theo problem type ở chỗ nào?
Anh đưa ra một ví dụ nhanh. Giả sử bạn đang thêm một flow mời thành viên (team invites) vào ứng dụng: bạn mời một thành viên qua email, họ nhận một đường link, rồi họ gia nhập workspace của bạn.
Nếu chia theo problem type, bạn sẽ làm theo kiểu org chart: một backend agent build endpoint mời và token, một frontend agent build modal mời và trang chấp nhận (accept page), một tester agent viết toàn bộ test, và một security agent review. Theo Ray, cách này lại quay về chuyện có một org chart, hay có các persona khác nhau (video đăng ngày 26/10/2026).
Vấn đề ở tình huống này là cả bốn subagent đều cần cùng một kiến thức: chúng cần spec, định dạng token, và việc lời mời hết hạn sau bảy ngày. Bạn hoặc phải bỏ rất nhiều thời gian định nghĩa tất cả từ đầu, nhưng dù cố thế nào bạn cũng không thể định nghĩa hết mọi thứ từ đầu, và nhiều agent trong số này sẽ học được điều mới trong lúc implement. Thông tin đó phải đi ngược về agent khác, và trên đường đi ấy, có khả năng một thứ gì đó bị rơi mất trong các lần bàn giao (handoff) (video đăng ngày 26/10/2026).
Ví dụ Ray đưa ra: backend agent có thể giữa chừng quyết định lưu email ở dạng chữ thường (lowercase), còn frontend agent không bao giờ nghe về chuyện đó. Rồi cuối cùng bạn có thể gặp một tình huống kỳ lạ: "Ray" viết hoa chữ R và "ray" viết thường trong email bị coi là hai người khác nhau (video đăng ngày 26/10/2026).
14. Chia theo context: implementer, reviewer, verifier, research agent
Nếu chia theo context thay vì problem type, bạn sẽ hỏi với mỗi task: nó thật sự cần biết những gì? Ví dụ, nếu có một implementer duy nhất, nó có thể implement endpoint, modal, accept page và mọi thứ khác trong cùng một context window. Quyết định nó đưa ra trước đó, như lưu email dạng lowercase, sẽ được áp dụng ở mọi chỗ. Theo Ray (video đăng ngày 26/10/2026), cách này cho một bản implement tốt hơn về tổng thể so với có một frontend agent và một backend agent.
Tiếp tục chia theo context: một code review agent là một agent riêng với context window riêng, và nó không cần biết lập luận (reasoning) của implementer, nếu không nó có thể thừa hưởng luôn các điểm mù (blind spots) của implementer. Nên nó nhận một cửa sổ mới, chỉ có, giả sử, spec gốc và diff (video đăng ngày 26/10/2026).
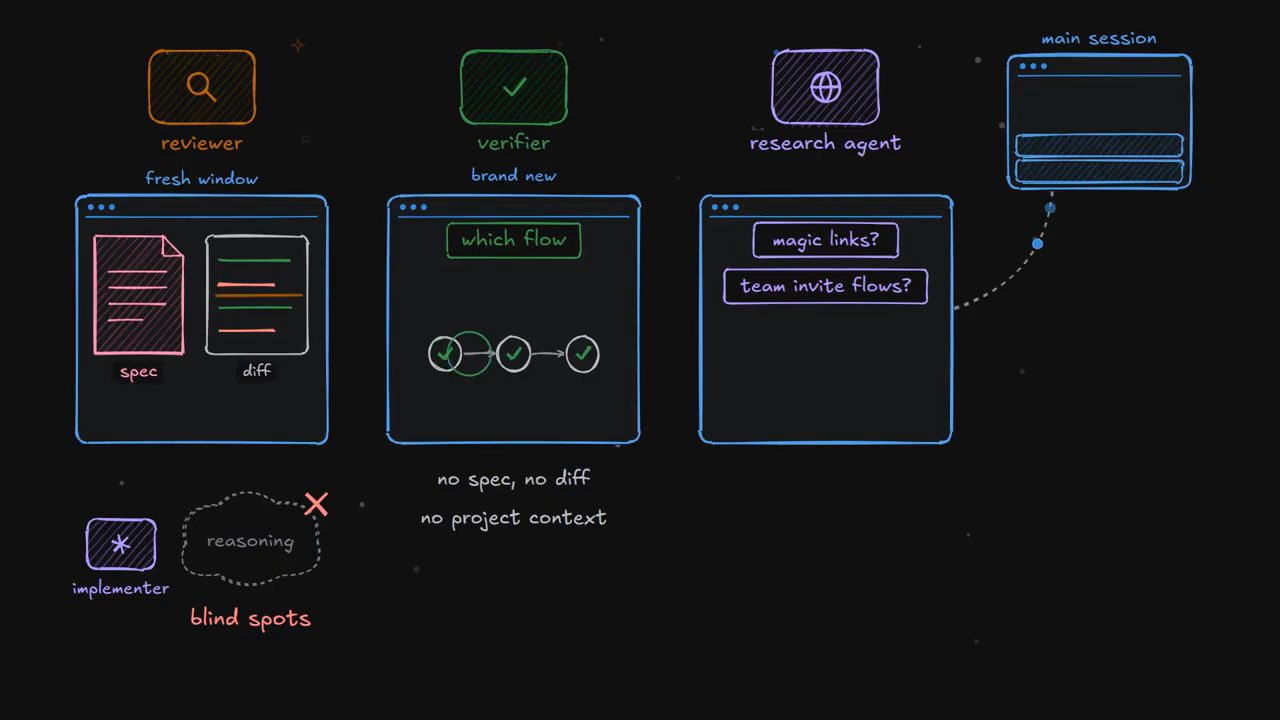
Tương tự, theo Ray (video đăng ngày 26/10/2026), một verifier không cần diff, thậm chí không cần spec; nó chỉ cần biết flow nào phải kiểm tra. Trong trường hợp đó, nó không thật sự cần context nào từ project của bạn, và có thể ở trong một context window mới tinh, tự làm phần tìm hiểu của nó.
Cũng vậy, nếu chia theo context và bạn có một research agent, đang tìm hiểu câu hỏi "các ứng dụng khác implement magic link hay flow mời thành viên như thế nào", thì agent này không cần gì từ main session hay từ project của bạn. Nó chỉ cần tìm câu hỏi đó trên mạng rồi trả về bản tóm tắt (video đăng ngày 26/10/2026).
Nhìn rộng ra, theo Ray: nếu chia theo problem type, ta đang hỏi "đây là loại việc gì? Front-end, back-end, security hay thứ khác?". Còn nếu chia theo context, ta hỏi "những gì main session đã biết sẽ giúp ích cho task này, gây hại cho nó, hay chẳng ảnh hưởng gì?". Ray cho rằng vấn đề nhiều người gặp với persona và các setup multi-agent là họ thường chia phần lớn công việc theo problem type thay vì theo context (video đăng ngày 26/10/2026).
Ray nói nhiều phần trong bài viết được viết với agent hỗ trợ khách hàng trong đầu, nhưng anh nghĩ các ý tưởng này cũng áp dụng cho coding agent, và anh muốn nói về hai sai lầm phổ biến anh thấy mọi người mắc phải (video đăng ngày 26/10/2026).
15. Sai lầm thứ nhất: chia spec thành hàng loạt ticket
Sai lầm đầu tiên và lớn nhất, theo Ray, trông thế này: bạn viết một spec cùng agent của mình, rồi nhờ một agent khác chia nó thành cả loạt ticket, có thể 5, 10, 20 ticket, rồi implement từng ticket trong một context window mới, trong một subagent mới. Trong một số trường hợp, cách này có thể bỏ sót điều gì đó quan trọng: agent số bảy có thể bỏ lỡ điều mà agent số ba đã học được, rồi implement sai (video đăng ngày 26/10/2026).
Ngược lại, thay vì ticket, nếu mọi thứ trong spec được implement bên trong context window của một implementer, thì khi nó thấy spec sai ở chỗ nào đó, hoặc học được điều gì không có trong spec (vì dù cố tới đâu, spec luôn có những thứ bạn bỏ sót), nó có thể tự sửa trong cùng context window và mang các chỉnh sửa đó theo (theo Ray, video đăng ngày 26/10/2026). Như vậy ta tránh được kiểu nén mất thông tin (lossy compression) và các lần bàn giao mất thông tin mà bài viết đã nói tới.
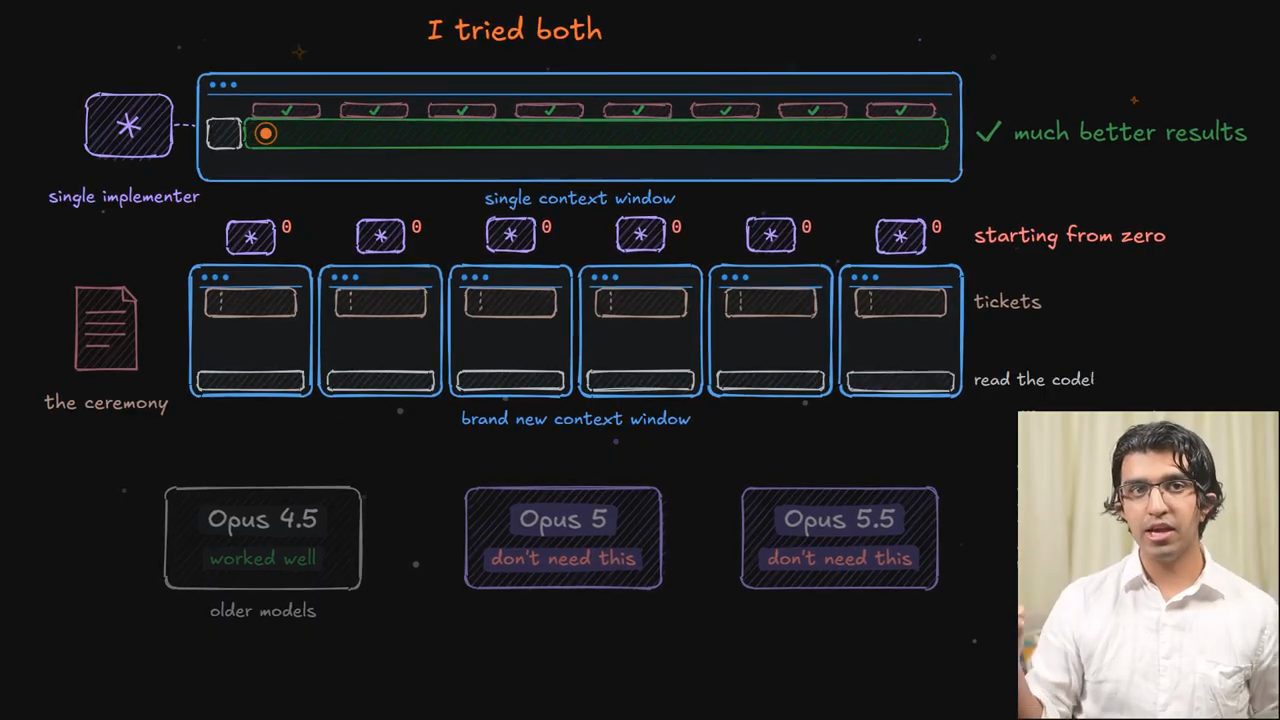
Ray nói anh đã tự thử cả hai cách, và nói chung anh thấy để một implementer duy nhất implement trọn một spec từ đầu tới cuối trong một context window cho kết quả tốt hơn nhiều so với đi qua cả "ceremony" chia thành một loạt ticket rồi mỗi ticket một context window mới (trải nghiệm của Ray, video đăng ngày 26/10/2026). Cách làm ticket này có thể đã chạy tốt với các model cũ như Opus 4.5, nhưng theo Ray, với Opus 5 và 5.5 thì nói chung bạn không cần nó nữa.
Anh nói thêm: trên giấy, về mặt khái niệm, cách này trông rất gọn gàng, nhưng mỗi agent đều bắt đầu từ con số không. Nó phải đọc codebase, tìm hiểu mọi thứ được setup ra sao, học lại đúng những điều mà mọi agent trước nó đã học (video đăng ngày 26/10/2026).
Ray kể vài ngày trước khi video đăng (26/10/2026), anh đi một sự kiện OpenAI Dev Day ở Tokyo và được nói chuyện với nhiều kỹ sư trong team Codex. Không kỹ sư nào trong số những người anh nói chuyện làm theo kiểu chia việc thành ticket rồi implement từng cái một.
Anh nối chuyện này với phần đầu: anh từng có setup nhiều agent để edit video, chia video thành một loạt đoạn rồi edit song song, và cách đó cho kết quả tệ hơn so với để một agent duy nhất trong một context window làm cả bản edit. Theo Ray, ý tưởng đó áp dụng y như vậy cho việc implement (video đăng ngày 26/10/2026).
16. Vì sao người ta vẫn chia ticket, compaction và back pressure
Theo Ray (video đăng ngày 26/10/2026), khi chia thành một loạt ticket, bạn sẽ có bản implement tệ hơn với các frontier model lúc đó, dùng nhiều token hơn và mắc nhiều lỗi hơn so với để mọi thứ trong một implementer agent duy nhất, vì kiểu nén mất thông tin đã nói ở trên. Có thể nếu giá trị lambda thay đổi, ta sẽ quay lại cách làm này, nhưng anh nói nhìn chung anh thấy nó không hiệu quả.
Vậy tại sao người ta vẫn làm thế? Ray nghĩ chủ yếu là vì họ tin model không thể implement trọn một spec lớn trong một lượt, nên họ băm nó thành một loạt ticket nhỏ, hy vọng mỗi phần vừa với "smart zone" của model và việc implement không rơi vào "dumb zone". Anh cho rằng quan niệm sai về một "dumb zone" ở mức 150.000 token đối với các frontier model (tính đến video đăng ngày 26/10/2026) đang dẫn người ta đi lạc, khiến họ dựng rất nhiều "ceremony" không thật sự cần thiết trong setup của mình.
Tất nhiên, bạn có thể có một spec khổng lồ, implement trong một context window có thể lên tới khoảng 400.000 token. Khi đó, theo Ray, thay vì để cửa sổ auto-compaction ở mức 1 triệu token, bạn có thể đặt nó ở khoảng 400.000 đến 500.000 token (video đăng ngày 26/10/2026).
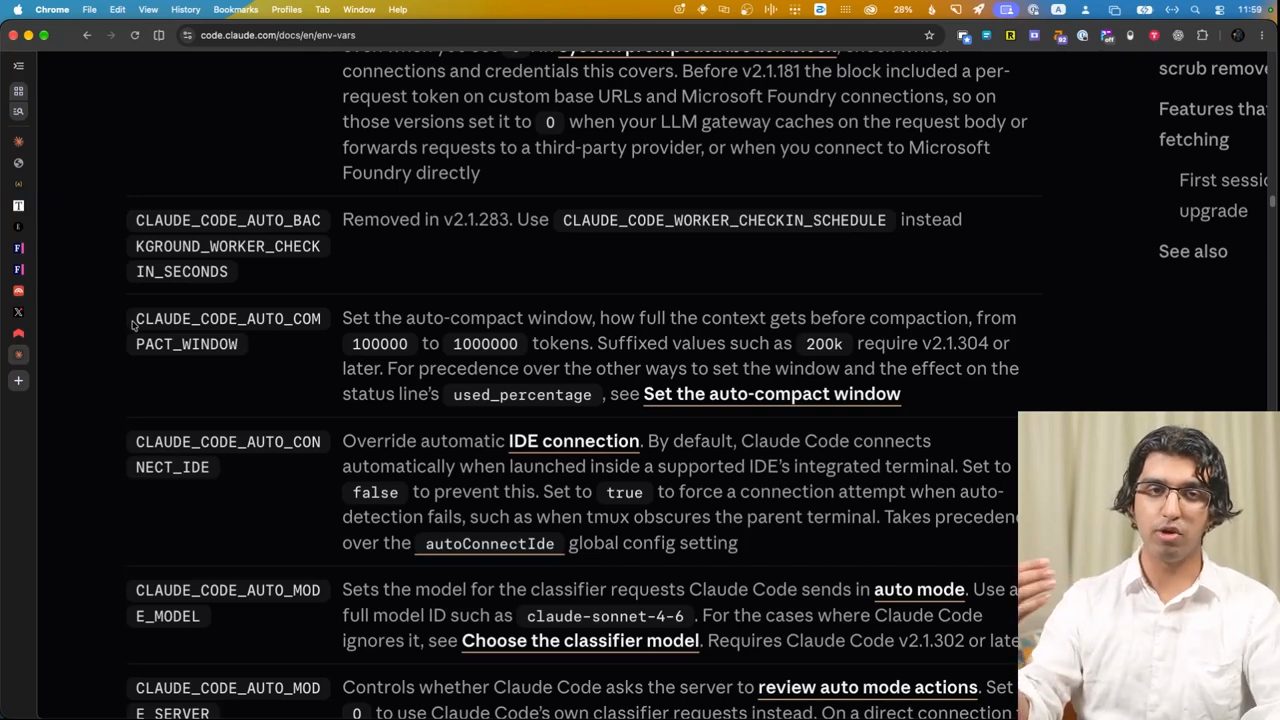
CLAUDE_CODE_AUTO_COMPACT_WINDOW đặt cửa sổ auto-compact, tức context đầy tới đâu thì compaction, trong khoảng 100000 đến 1000000 token; giá trị có hậu tố như 200k cần bản v2.1.304 trở lên (trang tài liệu đọc ngày 26/10/2026 ghi giống vậy).CLAUDE_CODE_AUTO_COMPACT_WINDOW
Ray nói thêm, theo trải nghiệm của anh (video đăng ngày 26/10/2026), compaction lúc đó đã rất tốt: anh thường chạy kiểu "mono-threading", tức có một session duy nhất đã compact khoảng 20 đến 30 lần, chạy suốt nhiều tuần, và nó vẫn hoạt động rất tốt.
Kể cả khi đó là một bản implement khổng lồ và nó compact chẳng hạn một lần, bạn có thể lo rằng bản implement chưa hoàn chỉnh. Đây là lúc việc chia theo context window thay vì theo problem type trở nên rất hữu ích, và đó là lý do theo Ray bạn nên có một review agent riêng để làm code review, và một agent riêng để verification, thật sự điều khiển trình duyệt và xem mọi thứ có chạy đúng không (video đăng ngày 26/10/2026).
Cuối cùng, theo Ray, bất kỳ khoảng hở nhỏ nào trong bản implement của builder sẽ bị verification agent bắt được, rồi nó chuyển lại cho builder kiểu "này, bạn bỏ sót cái này, làm cái này đi". Kiểu back pressure (áp lực ngược) giữa builder, reviewer và verifier này đang sửa được những gì bị bỏ sót (theo Ray, video đăng ngày 26/10/2026).
17. Sai lầm thứ hai và setup của Ray
Anti-pattern thứ hai Ray thấy (video đăng ngày 26/10/2026), khi người ta dùng cách chia ticket hay cách chia vai trò: về cơ bản họ nói "ok, giờ tôi có một loạt ticket, tôi sẽ bảo nó implement song song. Tôi sẽ có một coordinator ở trên quản lý tất cả ticket, và việc implement sẽ nhanh hơn nhiều".
Nhưng theo Ray, vì với các model tính tới video đăng ngày 26/10/2026 lambda vẫn còn khá nhỏ, coordinator làm khá tệ trong việc biết các thứ có thật sự độc lập hay không. Thường thì dù các ticket trông độc lập trên bề mặt, chúng lại dính vào nhau theo một cách kỳ lạ mà bạn không thật sự nhìn thấy, và đó là lý do để mọi thứ implement trong một context window duy nhất vẫn cho kết quả tốt hơn.
Rồi Ray quay lại những gì anh thật sự làm (tính đến video đăng ngày 26/10/2026). Khi có một spec làm cùng agent, spec đó đi tới một implementer duy nhất, được implement trong trọn một context window, và có thể compact chẳng hạn một lần nếu bản implement thật sự lớn, thay vì đi tới kiểu năm ticket agent khác nhau.
Sau khi implementer xong, vì anh đã định nghĩa rõ một mục "done when" (xong khi nào) trong spec, việc chuyển sang code review trong một context window mới tinh, vì như anh nói, ta chia theo context chứ không theo problem type. Agent review chỉ thấy spec và diff, tìm mọi lỗi mà implementer có thể đã mắc, rồi chuyển lại cho chính implementer đó để sửa. Ray gọi đây là một kiểu áp lực đối kháng (adversarial pressure). Sau đó là áp lực đối kháng từ các verification agent (video đăng ngày 26/10/2026).
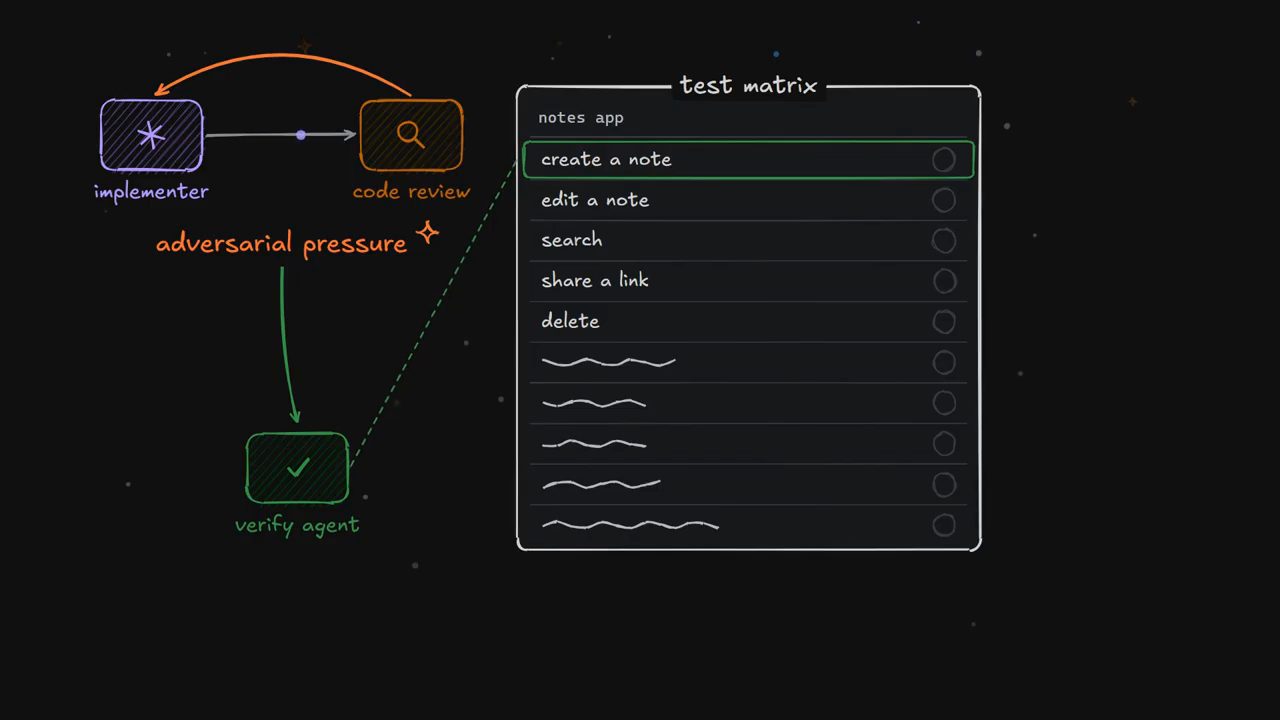
Cụ thể, Ray đã định nghĩa toàn bộ các cách người dùng có thể tương tác với ứng dụng trong một test matrix nào đó. Ví dụ với một ứng dụng ghi chú (notes app), đó có thể là tạo ghi chú, sửa ghi chú, tìm kiếm, chia sẻ link, xóa, và những thứ tương tự. Tất cả sẽ được một verify agent kiểm tra: nó kiểm tra cả 10 user flow để chắc chúng chạy, và reset database, reset môi trường giữa mỗi lần kiểm. Với Ray, việc này chạy bên trong một cloud agent (setup của anh tính tới video đăng ngày 26/10/2026).
Anh còn tiến thêm một bước: nhiều user flow trong số đó thật ra độc lập và có thể được verify song song. Theo Ray (video đăng ngày 26/10/2026), nhiều dịch vụ sandbox, kể cả dịch vụ sandbox do chính anh làm, cho phép fork một sandbox đang chạy. Nghĩa là anh có thể fork main session khoảng 10 lần cho 10 user flow khác nhau, cho tất cả được verify song song, mỗi cái trong sandbox riêng với database riêng, Redis riêng và những thứ tương tự, để kiểm tra feature đã được build đúng chưa.
Tất cả kết quả được gom lại, kiểu "những user flow này fail, những cái này pass", chuyển lại cho builder, và những flow fail sẽ được verify lại sau khi builder sửa. Ray nói đó là cái nhìn tổng quan ở mức cao về setup của anh (video đăng ngày 26/10/2026).
18. Đơn giản hơn theo thời gian và hai skill của Ray
Ray hình dung rằng khi model ngày càng tốt hơn, setup này sẽ còn đơn giản hơn theo thời gian chứ không phức tạp hơn. Theo anh (video đăng ngày 26/10/2026), có thể việc model không làm được code review ngay trong main session là một giới hạn của các model lúc đó, và có thể Opus 6 sẽ làm được; khi đó implement và review có thể gộp làm một, và có thể trong tương lai, về cơ bản một agent sẽ làm toàn bộ mọi thứ trong một context window duy nhất.
Để kết luận, Ray khuyên đọc bài viết của Anthropic, thử fold các subagent vào main agent loop, rồi so sánh kết quả, và anh nghĩ bạn sẽ bất ngờ. Theo anh, với bitter lesson, khi model ngày càng thông minh hơn, bạn nên cắt giảm lượng "ceremony" trong setup của mình. Trong skill, bạn không nên định nghĩa những setup multi-agent phức tạp hay những thứ tương tự: nếu agent quyết định nó cần dùng một subagent, nó sẽ tự động làm thế (theo Ray, video đăng ngày 26/10/2026). Ngoài ra, anh chỉ khuyên chia theo context và giữ nó là một single agent loop; và có thể một thế hệ model nữa, ta sẽ có một agent duy nhất làm được mọi thứ, kể cả review, trong cùng một context window.
Ray kể mọi người hay hỏi anh có định chia sẻ các engineering skill của mình không. Anh nói anh từng hơi ngần ngại, vì skill của anh thật sự rất đơn giản: anh chỉ có hai engineering skill, là task lifecycle và idea to spec. Repo ray-amjad/skills (đọc ngày 26/10/2026) có thư mục task-lifecycle và idea-to-spec cùng vài skill khác, README ghi đây là những skill "made to be deleted when models improve". Anh nói anh đang cố cắt chúng ngắn lại, ngắn nữa, cho tới khi rốt cuộc có thể xóa đi, vì model rồi sẽ giỏi tới mức bạn không cần những skill này nữa.
Theo Ray, nhiều người nghĩ "ok, chỉ cần tải thêm một engineering skill, hay tải đúng những cái phù hợp, là model sẽ chạy tốt hơn nữa", nhưng phần lớn mọi người lại thấy model chạy tốt hơn khi về cơ bản xóa bớt nhiều skill phình to và được thiết kế quá mức (over-engineered) mà họ đã cài (nhận định của Ray, video đăng ngày 26/10/2026). Thành thật mà nói, anh nghĩ khi model tốt hơn, sẽ chỉ còn một skill hay thứ gì đó tương tự trong cả repo, và có thể rốt cuộc họ sẽ xóa luôn repo vì các skill không còn cần nữa.
Ray nói gần như mỗi lần có model mới ra, anh lại cố "bitter lesson" chính mình: xóa skill, làm lại chúng, làm chúng ngắn hơn nhiều, xóa subagent, cố đơn giản hóa toàn bộ flow. Lý do anh đưa ra: anh thấy những chiếc "nạng" (crutches) ta thêm vào để model chạy tốt hơn rốt cuộc không còn cần khi model mới ra, và phần lớn mọi người không bỏ những chiếc nạng đó đi, mà chúng lại có thể kìm chân một model mới (video đăng ngày 26/10/2026).
Nguồn và liên kết 12 nguồn
- Tên gốc: Anthropic Says You're Using Subagents WRONG
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=ybx0mmd22pQ youtube.com
- Kênh YouTube Ray Amjad (Ray Amjad): youtube.com/channel/UCLA7cJBnqr0nLF2bQBD9uUg youtube.com
- Bài viết của Anthropic "Building agents: When to fold subagents into your main agent loop" (ngày đăng ghi October 22, 2026; nêu ba trường hợp nên giữ subagent, năm failure mode, ba lý do của progressive disclosure và bộ Claude API skills như
/claude-api build-eval; đọc ngày 26/10/2026): claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop claude.com - Rich Sutton, "The Bitter Lesson" (đọc ngày 26/10/2026): incompleteideas.net/IncIdeas/BitterLesson.html incompleteideas.net
- Atlassian, bài giải thích Conway's law (đọc ngày 26/10/2026): atlassian.com/blog/teamwork/what-is-conways-law-acmi atlassian.com
- Toby Ord, "Swarm Scaling" (tham số lambda và ước lượng cho BrowseComp, SEC-Bench Pro, Terminal-Bench; đọc ngày 26/10/2026): tobyord.com/writing/swarm-scaling tobyord.com
- Executor, MCP gateway có bản desktop, CLI hoặc self-hosted (trang chủ đọc ngày 26/10/2026): executor.sh executor.sh
- Tài liệu biến môi trường của Claude Code, gồm
CLAUDE_CODE_AUTO_COMPACT_WINDOW(đọc ngày 26/10/2026): code.claude.com/docs/en/env-vars code.claude.com - Skill task-lifecycle của Ray Amjad (build, PR, review, fix, verify với một builder duy nhất và reviewer, verifier mới; đọc ngày 26/10/2026): github.com/ray-amjad/skills/tree/main/skills/task-lifecycle github.com
- Repo skill của Ray Amjad (đọc ngày 26/10/2026): github.com/ray-amjad/skills github.com
Related talks
Nền văn minh AI của tôi thực sự vận hành thế nào
Mike Schwarz · OPENRIG · 30 min
Dùng world building làm context engineering: bản đồ, route, Markdown có địa chỉ, độ chín tri thức và lore để agent hết phát minh lại bánh xe.
Anthropic khuyên gộp subagent vào một agent có skill
Rob O'Shaughnessy · Rob Shocks - Switch Dimension · 10 min
Hướng dẫn của Anthropic (22/10/2026) về gộp subagent vào một agent loop có skill, cách fold và test, khi nào giữ subagent, và cắt gọn skill, CLAUDE.md.
Toàn bộ hướng dẫn Skills của Anthropic trong 22 phút
Mark Kashef · Mark Kashef · 22 min
Đi qua bản hướng dẫn 33 trang của Anthropic về skill: anatomy, ba tầng progressive disclosure, viết description, năm design pattern, test và phân phối.