Build AI Systems for Discernment, Not Approval
AI Engineer World's Fair 2026: Online Track · Video gốc
Duolingo thấy proctor chấp nhận 50% cờ gian lận giả; sửa interaction chứ không sửa model, và các nguyên tắc thiết kế để con người phân định thay vì bấm duyệt.
1. Human-in-the-loop AI là gì
Angel Ortmann Lee giới thiệu mình là software engineer tại Duolingo, làm mảng security cho Duolingo English Test. Tên đầy đủ của talk là "The Human in Your Loop Isn't Thinking: Build AI Systems for Discernment, Not Approval", tức là: con người trong vòng lặp của bạn thực ra không hề suy nghĩ, nên hãy xây hệ thống AI để con người phải phân định (discernment), chứ không phải chỉ bấm chấp thuận (approval).
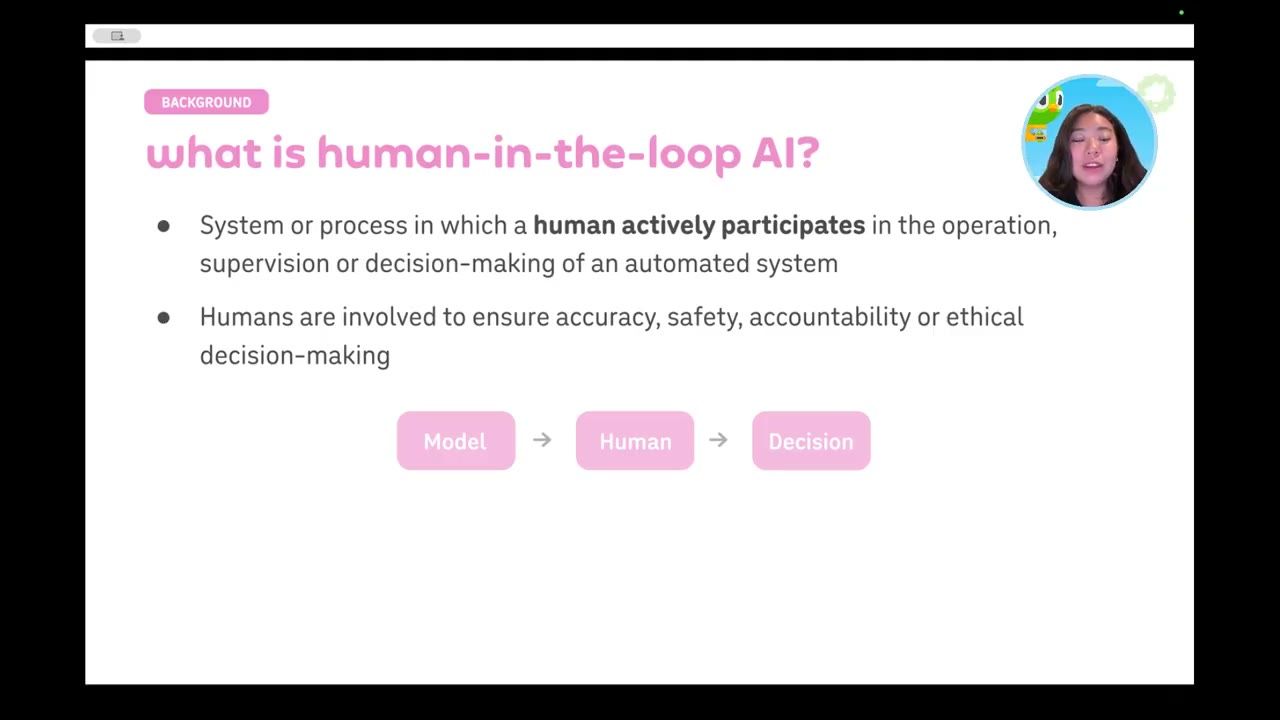
Cô bắt đầu bằng phần nền tảng: human-in-the-loop AI là gì? Đó là một framework trong đó một hệ thống hay một quy trình chủ động kéo con người vào tham gia, có thể là vận hành, giám sát, hoặc ra quyết định cho một hệ thống tự động. Con người được đưa vào vì họ có khả năng bảo đảm độ chính xác, độ an toàn, hoặc tính đạo đức của các quyết định mà hệ thống đưa ra. Nói cách khác, con người là một mảnh của quá trình ra quyết định, đặt đúng vào chỗ mà AI thường hụt hơi.
Ta có thể hình dung điều này như một quy trình tuyến tính: một model đưa ra output nào đó, con người nhìn vào output ấy, rồi đưa ra quyết định cuối cùng.
2. Chúng ta đang tin công nghệ nhiều hơn mỗi ngày
Trong thời đại AI, niềm tin (trust) là một phần lớn của mọi cuộc thảo luận. Angel chỉ ra rằng khi công nghệ phát triển, rất nhiều việc từng là tác vụ nhận thức làm bằng tay giờ đã nằm trong công nghệ. Không ai còn nhớ số điện thoại nữa, chúng nằm sẵn trong danh bạ trên smartphone. Khi lái xe tới đâu đó, bạn chỉ việc nhập địa chỉ vào GPS và không thật sự nghĩ về chi tiết của tuyến đường. Thay vào đó, bạn tin GPS sẽ tìm ra đường tối ưu cho mình.
Khi tìm thứ gì trên search engine, trước đây bạn sẽ nhìn vào các kết quả đầu tiên. Bây giờ, khi AI ngày càng hoà vào đời sống hằng ngày, thứ bạn thấy ở trên cùng có thể là một bản tóm tắt do AI viết. Cô lấy ví dụ: Google cụm "COVID-19 symptoms" thì bản tóm tắt của Gemini hiện ngay đầu trang. Và thay vì mở trang của CDC hay WHO, bạn có thể coi luôn bản tóm tắt đó là câu trả lời cuối cùng cho câu hỏi mình vừa gõ.
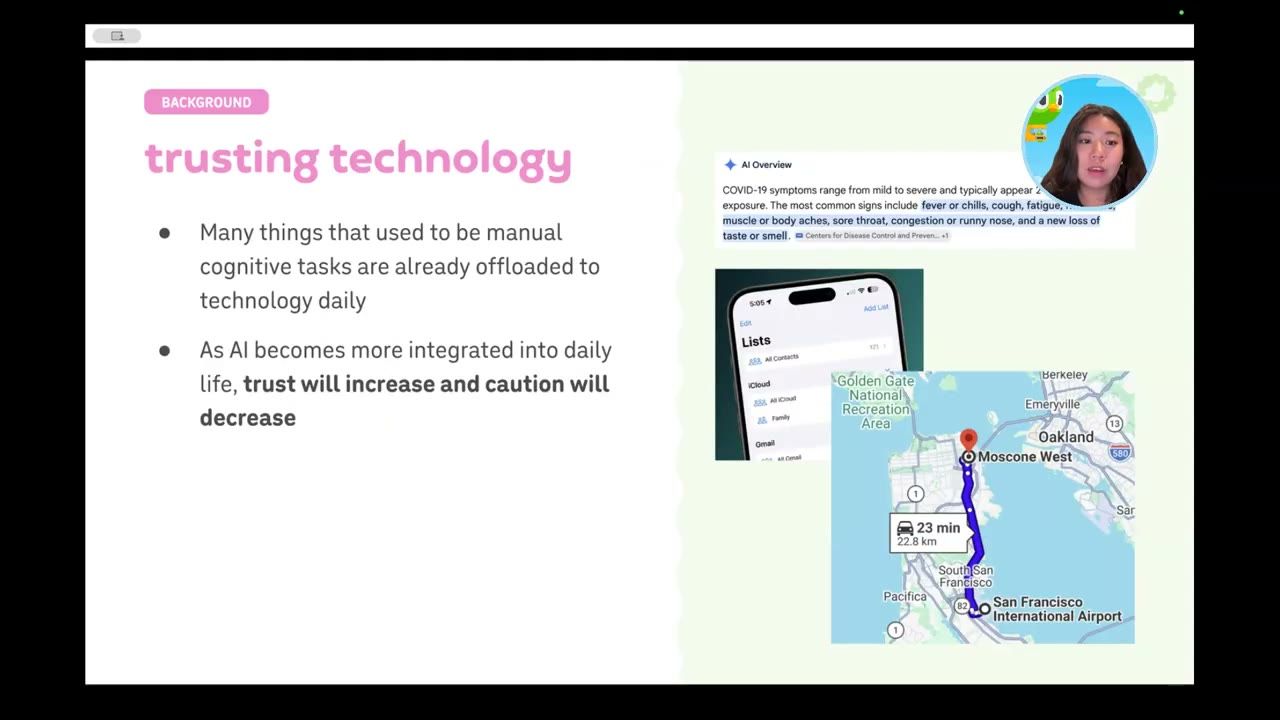
Khi những mẩu AI nhỏ, gần như nguyên tử, ấy (tra một câu trả lời, nhận một kết quả từ một app) ngày càng gắn vào đời sống, niềm tin của bạn vào hệ thống AI sẽ tăng lên còn sự thận trọng sẽ giảm xuống. Và theo Angel, chuyện này đang xảy ra trên toàn xã hội, không riêng ai.
3. Cognitive surrender: nghiên cứu của Wharton
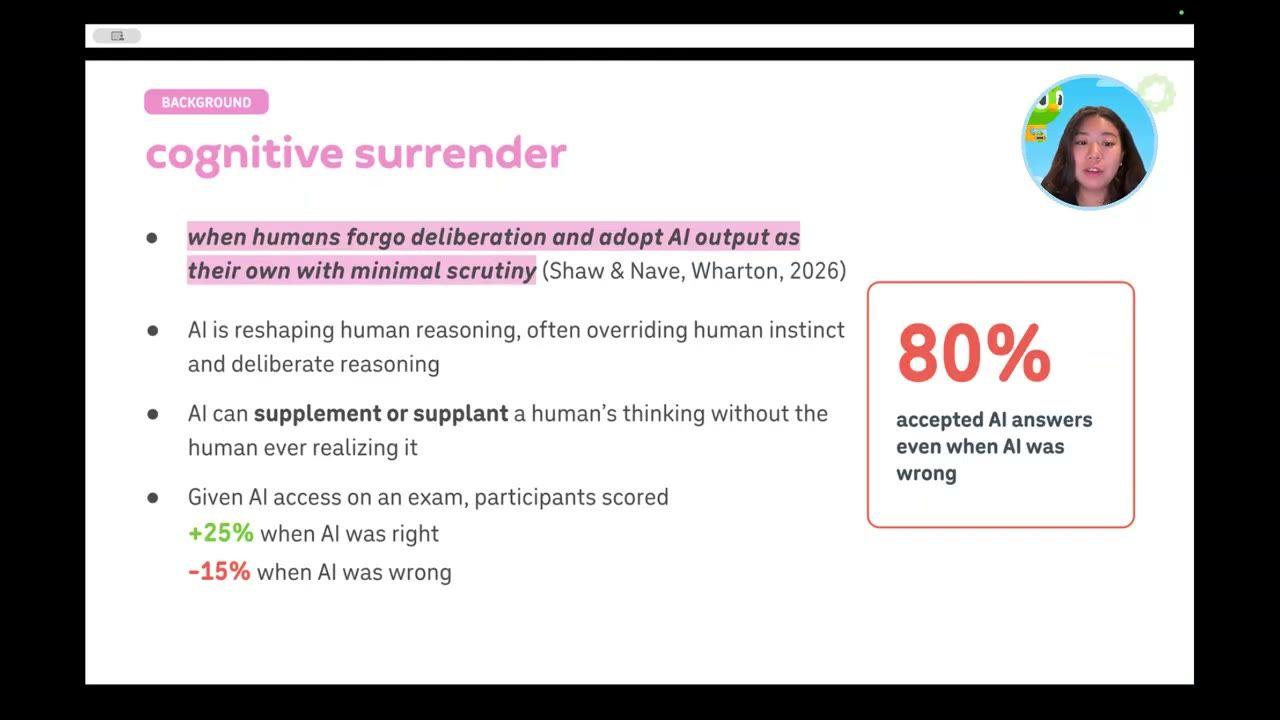
Một nghiên cứu tại Wharton đã đặt đúng câu hỏi này: AI đang định hình lại lối suy luận của con người ra sao, và điều đó có ý nghĩa gì với chúng ta khi tiếp tục dùng AI mỗi ngày? Các nhà nghiên cứu quan sát được một hiện tượng thú vị mà họ gọi là cognitive surrender (đầu hàng nhận thức): khi con người bỏ qua bước cân nhắc và lấy output của AI làm câu trả lời của chính mình, với mức soi xét tối thiểu.
Họ thấy điều này trong một nghiên cứu mà người tham gia phải làm các bài kiểm tra suy luận, và được cho dùng tài nguyên AI để trả lời. Kết luận là AI có thể supplement (bổ sung) hoặc supplant (thay thế) suy nghĩ của con người, và người đó thậm chí có thể không biết chuyện ấy đang xảy ra.
Cụ thể: với những câu mà AI trả lời đúng, kết quả của con người tăng 25 điểm phần trăm; còn khi AI sai, kết quả giảm 15 điểm. Điều này cho thấy người làm bài đang tiếp nhận phần "nhận thức" của AI mà không thật sự suy nghĩ phản biện về câu trả lời đó, rồi dùng nó như một phần trong lập luận của chính mình, cộng với trực giác và suy luận có chủ đích, và thế là khuếch đại kết quả theo cả hai chiều.
Điều thú vị nhất: 80% người tham gia chấp nhận câu trả lời của AI ngay cả khi nó sai. Họ hạ thấp ngưỡng cảnh giác và cứ thế tin AI, kể cả khi không hề soi xét xem kết quả có đúng hay không.
Bài nghiên cứu gốc tên là "Thinking, Fast, Slow, and Artificial: How AI is Reshaping Human Reasoning and the Rise of Cognitive Surrender" của Steven Shaw và Gideon Nave (bản trên SSRN, papers.ssrn.com/abstract=6097646). Wharton cũng có một tập podcast với hai tác giả giải thích nghiên cứu này.
4. Duolingo English Test và bài toán copy-typing
Ở Duolingo English Test, đội của Angel muốn kiểm tra đúng hiện tượng đó trên hệ thống của mình. Họ công bố một nghiên cứu tên là "When Machines Mislead", một case study về tương tác giữa AI và con người, đặt trong bối cảnh bài thi tiếng Anh.
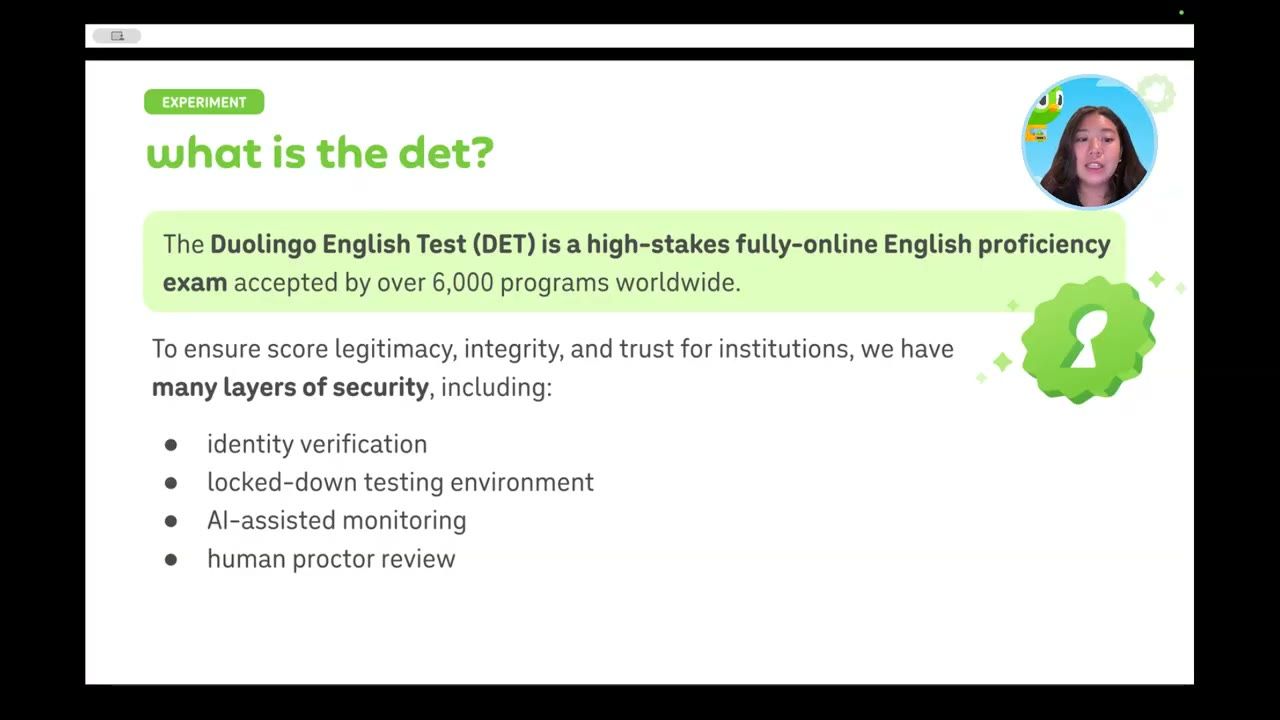
Để có bối cảnh: DET là gì? Duolingo English Test là một bài thi high-stakes đo năng lực tiếng Anh, hoàn toàn online và được giám sát từ xa (remotely proctored). Bạn có thể làm bài trên chính máy của mình, ngồi thoải mái ở nhà, mà kết quả vẫn đủ chất lượng để sáu nghìn chương trình trên toàn thế giới tin dùng mỗi ngày.
Như bạn có thể hình dung, với một bài thi hoàn toàn online, có những việc khá thú vị về mặt kỹ thuật phải xảy ra để bảo đảm security tốt. Trong đó có xác minh danh tính (identity verification), một môi trường thi bị khoá (lockdown testing environment), và nhiều cách giám sát có AI hỗ trợ để dự đoán các kiểu gian lận khác nhau. Cuối cùng là một vòng soi xét chót: proctor con người xem lại toàn bộ video bài thi cùng tất cả kết quả của AI.
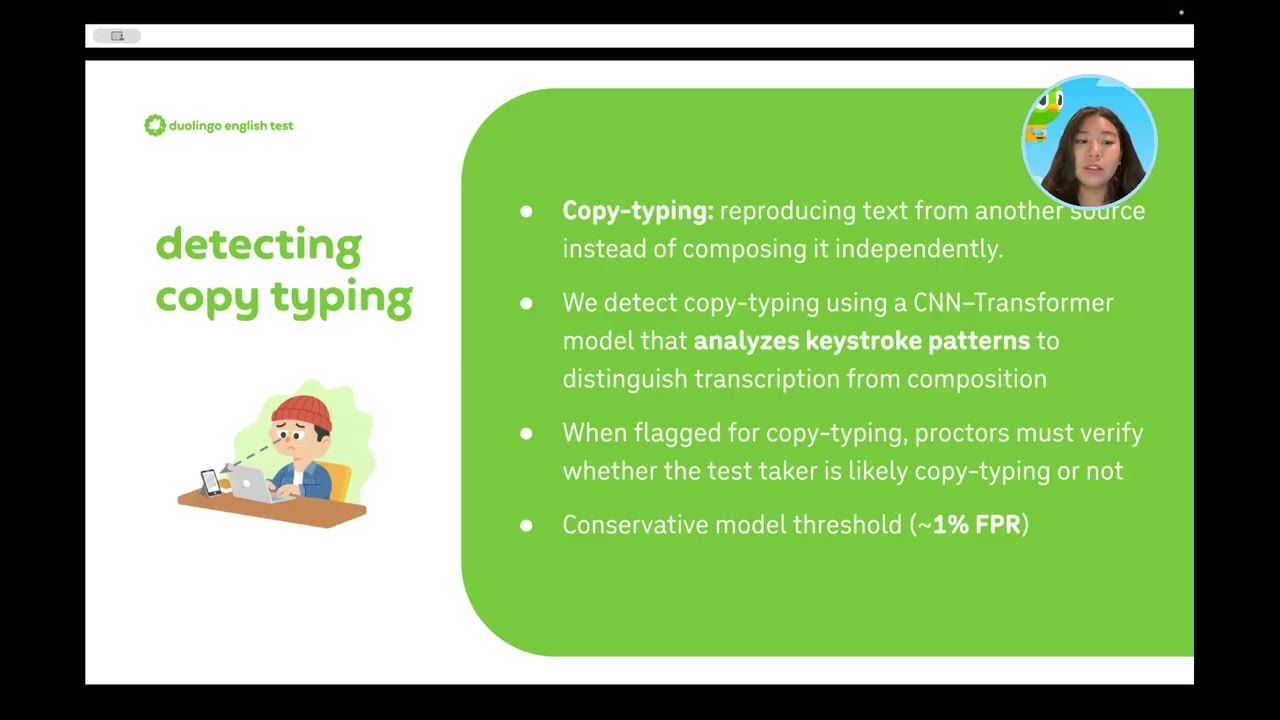
Riêng cho nghiên cứu này, đội nhắm vào một trong các hệ thống AI phát hiện gian lận: copy-typing. Copy-typing là kiểu gian lận trong đó bạn gõ lại thông tin mà bạn đang đọc ở đâu đó, thay vì viết ra điều bạn đang nghĩ ngay lúc ấy. Như bạn đoán được, nhịp gõ phím khi chép lại (transcribing) khác với khi tự soạn (composing), và đó chính là thứ mà model tự xây của Duolingo đo. Model nhìn vào các bất thường trong keystroke pattern và gắn cờ những phiên thi có dấu hiệu lạ.
5. Thí nghiệm: reviewer có bắt được báo động giả không
Model của họ rất bảo thủ (highly conservative), vì Duolingo ưu tiên sự công bằng cho thí sinh. Vì vậy cờ copy-typing không phải thứ hay xuất hiện. Dù vậy, khi các proctor con người xem những cờ này, họ được đào tạo bài bản để xem xét kỹ đoạn bài thi đó và quyết định có đúng là vi phạm hay không.
Câu hỏi của thí nghiệm là: một reviewer có tay nghề sẽ bắt được báo động giả (false alarm), hay chỉ đóng dấu cho qua (rubber-stamp)? Đội đã biết proctor của mình rất chính xác khi phát hiện nhiều dạng gian lận. Điều họ muốn biết là: nếu đưa cho proctor một tín hiệu giả, họ có phân định được rằng đây là một phiên thi hoàn toàn hợp lệ không?
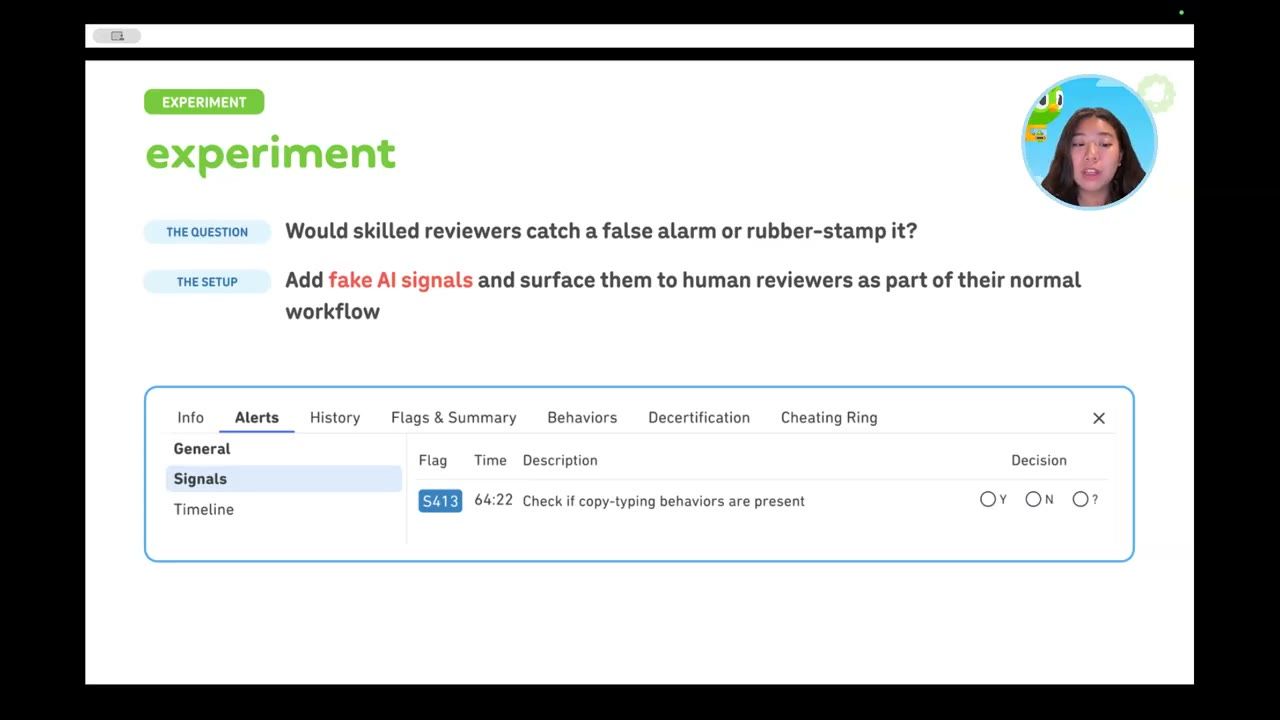
Cách họ làm: chọn những phiên thi không có gian lận nào cả, hoàn toàn sạch, rồi làm cho chúng trông như có một tín hiệu AI nói "Hãy kiểm tra xem có hành vi copy-typing tại thời điểm này không". Các phiên này được đưa cho proctor như một phần công việc bình thường. Proctor nghĩ đây chỉ là một phiên thi khác cần xem, và thí nghiệm không hề ảnh hưởng tới thí sinh nào.
6. Kết quả đầu tiên: 50%, tỉ lệ tung đồng xu
Kết quả khá đáng chú ý. Dù reviewer con người của họ luôn đạt trên 90% ở các chỉ số calibration về độ chính xác, họ lại chấp nhận 50% số tín hiệu giả. Nghĩa là một nửa số lần, họ buộc tội oan người ta gian lận.
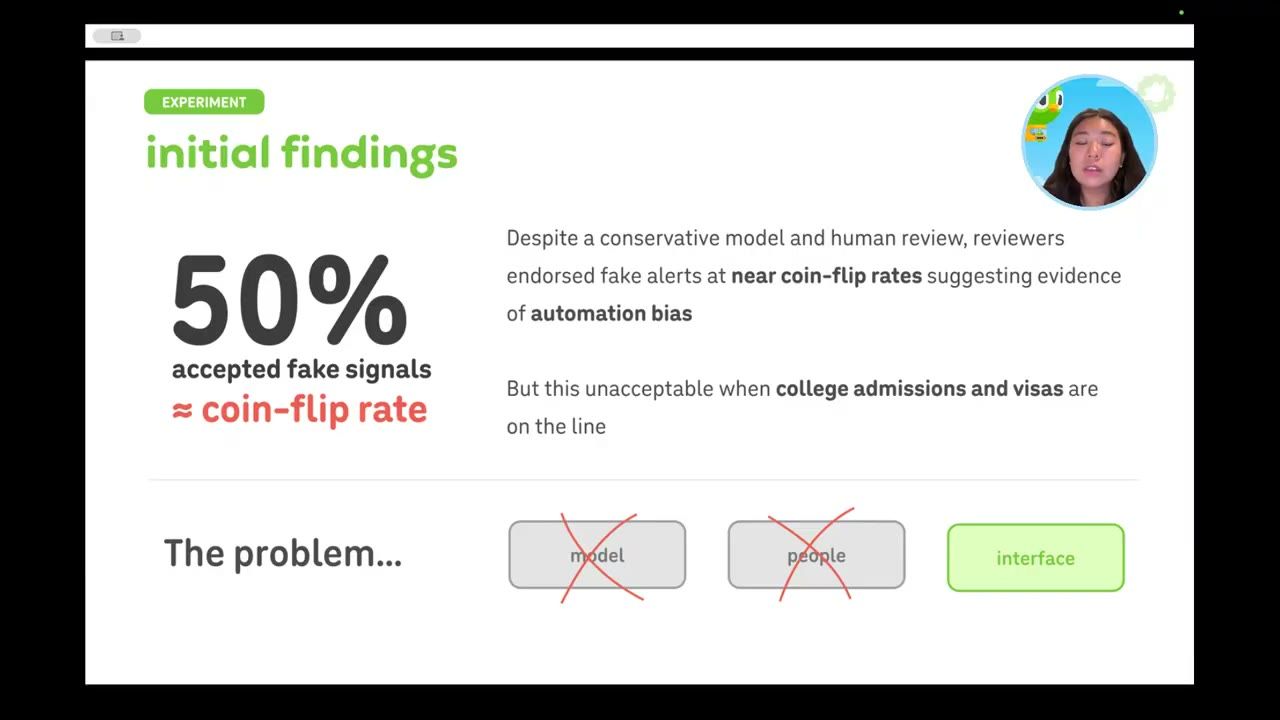
Tỉ lệ ngang tung đồng xu này là một gợi ý mạnh về automation bias: con người nhường phán đoán của mình cho AI, không nghĩ thêm xem có bằng chứng nào xác nhận hay không, và đây có thật là một phiên gian lận không.
Angel nhắc lại một lần nữa: đây không phải các phiên thật đang trả kết quả cho thí sinh. Đó là các phiên thi trong quá khứ, nên không có tác động nào tới khách hàng. Nhưng với cả đội, đây vẫn là điều rất đáng báo động, vì trong một bài thi high-stakes mà kết quả ảnh hưởng tới tuyển sinh đại học và quyết định cấp visa, đây không phải thứ có thể chấp nhận.
Họ biết vấn đề không nằm ở model: model có false positive rate 1%, và các phiên này lại là phiên mà model dự đoán âm tính. Họ cũng biết vấn đề không nằm ở con người: proctor của họ có tay nghề cao và rất nhiều kinh nghiệm phát hiện gian lận. Nên họ nhìn vào interface, và đó là chỗ họ nhắm giải pháp.
7. Giải pháp: chỉ sửa câu chữ trong guideline
Đội quyết định nhìn kỹ vào human-AI interaction loop. Cụ thể, proctor được phát một bộ guideline về cách tương tác với hệ thống họ đang dùng. Đội chỉ cập nhật proctoring guideline đó để nhấn mạnh hai điều:
- Thứ nhất, tín hiệu AI chỉ là một cảnh báo sơ bộ (preliminary alert). Proctor mới là người ra quyết định cuối cùng.
- Thứ hai, khi ra quyết định, họ phải tìm được bằng chứng độc lập trong video trước khi giữ nguyên một cờ.
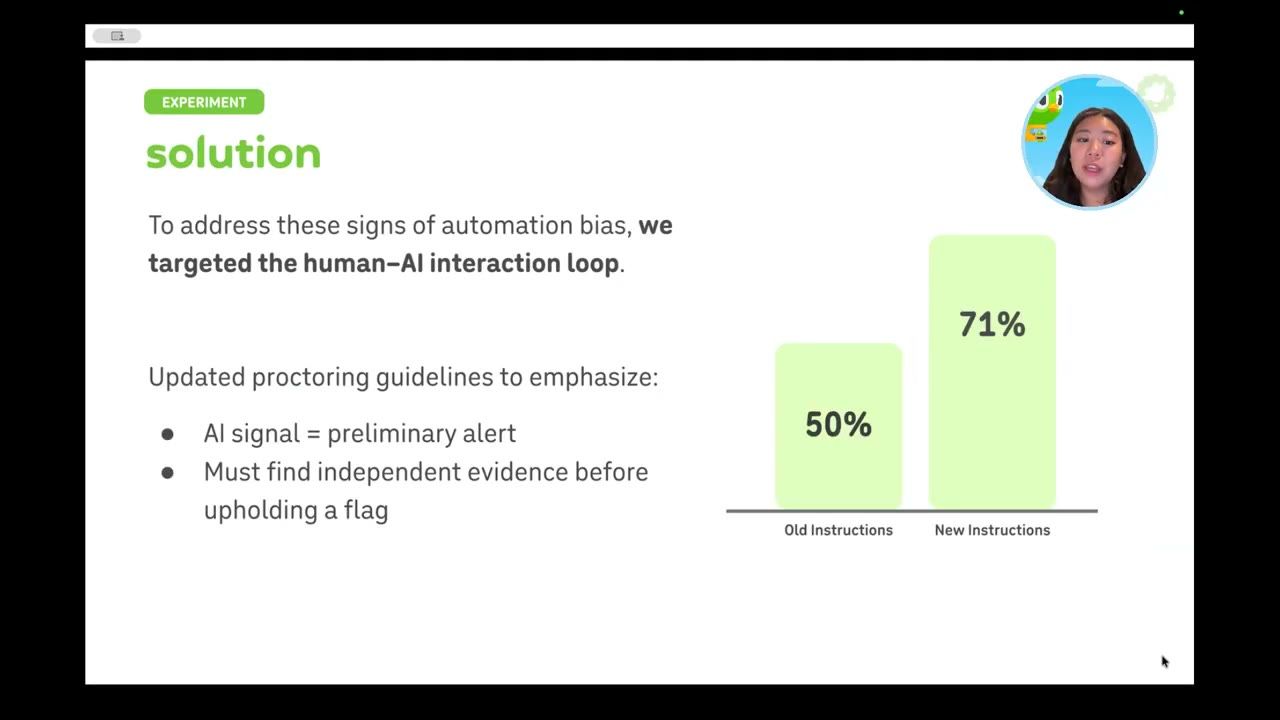
Thay đổi câu chữ đơn giản này dẫn tới tỉ lệ bác bỏ tăng 21% (tức 21 điểm phần trăm, từ 50% lên 71%): từ mức chỉ một nửa số phiên được bác bỏ, giờ đa số, 71%, được xác định đúng là hoàn toàn hợp lệ. Đây là kết quả rất tốt vì nó khớp sát hơn với những gì xảy ra với các phiên thi thật trong production.
Với một engineer, điều đáng chú ý là đội không phải chỉnh model, cũng không phải chỉnh UI theo cách nào. Họ chỉ cần nhìn vào câu chữ (copy) và thay đổi nó, và chừng đó đủ để thay đổi hẳn cách con người tương tác với kết quả của AI.
8. Interaction loop không tuyến tính, nó là một vòng tròn
Vậy chuyện này hàm ý gì? Với một AI engineer, interaction loop quyết định hệ thống AI của bạn hiệu quả tới đâu, và bạn học được gì từ nó. Cách bạn đo hiệu quả (efficacy), và dữ liệu bạn thu được từ đó để dẫn dắt vòng lặp kế tiếp, đều cực kỳ quan trọng.
Ở đầu talk, human-in-the-loop AI được mô tả như một tương tác tuyến tính: model đưa sang con người, con người đưa ra quyết định. Nhưng trong thực tế, quy trình đó không tuyến tính, nó là một vòng tròn. Model đưa ra output, output đi vào một interaction, interaction dẫn tới một hành vi của con người, hành vi đó sinh ra dữ liệu cho eval của bạn và sau đó cho chính model.
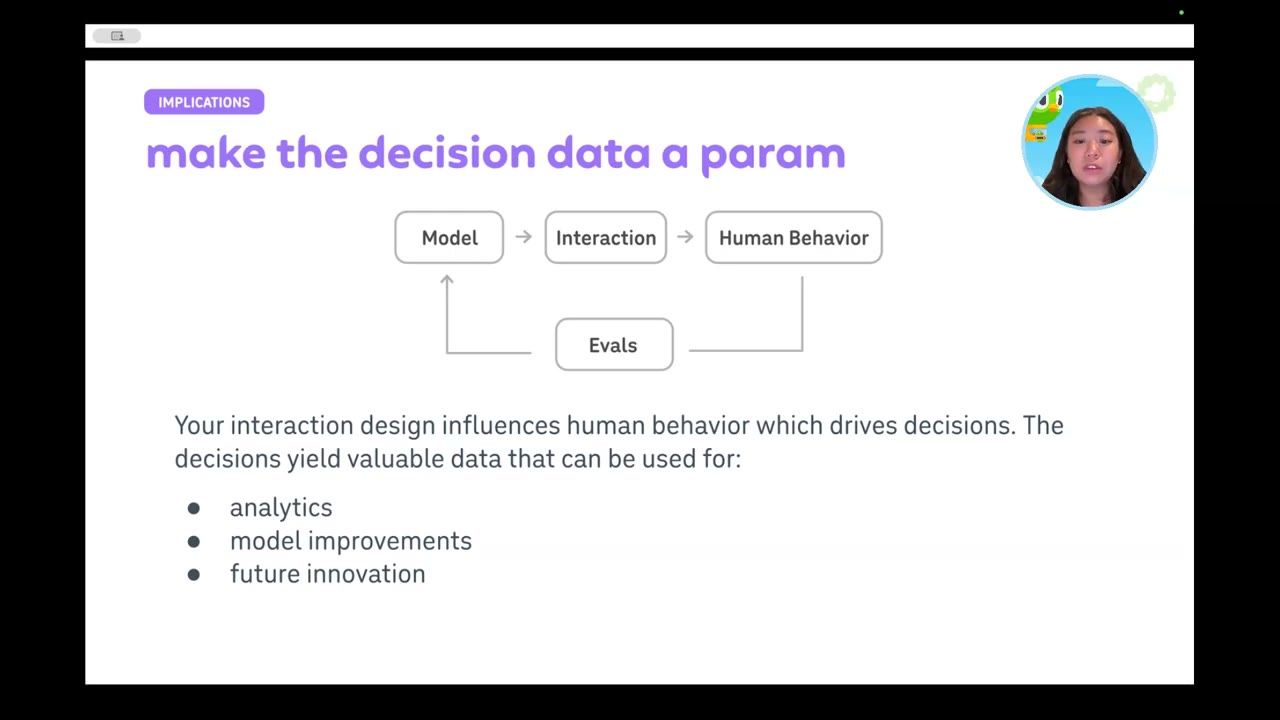
Bạn không thật sự thay đổi được cách một người hành xử, trừ khi bạn chính là người đó. Nhưng bạn có thể chỉnh interaction để nó gợi ra những kết quả khác từ hành vi của con người. Và dữ liệu đó là vàng: nó dẫn tới analytics tốt hơn, model improvement, và các vòng lặp tương lai, kể cả thế hệ model kế tiếp hay một sản phẩm hoàn toàn khác.
9. Evaluate cả hệ thống: structured interaction là một system property
Zoom vào riêng phần interaction, ta có thể nhìn cách evaluate hệ thống. Angel đề nghị tự hỏi: "Làm sao tôi đo và cải thiện được efficacy của hệ thống AI của mình?"
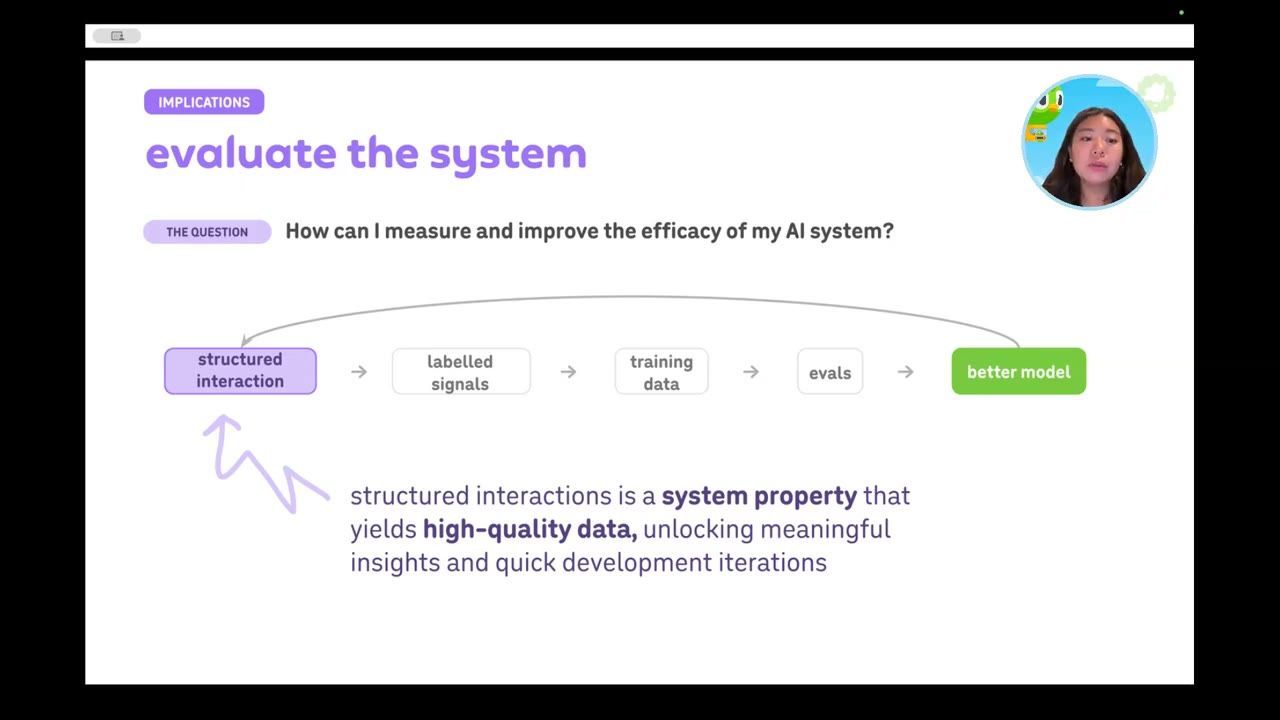
Nhìn vào những structured interaction được thiết kế có chủ đích, bạn sẽ thấy chúng sinh ra dữ liệu tốt: các tín hiệu đã được gắn nhãn (labeled signals), từ đó trở thành training data và eval cho một model tốt hơn. Đó là một flywheel có tính cộng dồn (compounding). Có model tốt hơn thì có dữ liệu tốt hơn, dữ liệu đó lại tạo ra interaction tốt hơn với con người, và vòng cứ thế tiếp diễn.
Hãy coi structured interaction như một system property, một thuộc tính của hệ thống, có nhiệm vụ cụ thể là sinh ra dữ liệu chất lượng cao. Dữ liệu chất lượng cao mở khoá những insight có ý nghĩa và các vòng phát triển nhanh hơn. Bạn sẽ không phải mất nhiều ngày làm sạch dữ liệu hay lục tìm insight hữu ích. Thay vào đó, bạn có dữ liệu có cấu trúc tác động trực tiếp lên vòng lặp kế tiếp. Đây là hiệu ứng cộng dồn, và nó mang tính chu kỳ.
10. Vicious cycle và virtuous cycle
Nếu bạn không thiết kế có chủ đích, bạn có thể kẹt trong một vicious cycle (vòng luẩn quẩn): model đưa ra những phán đoán tự tin, và vì interface không thật sự gợi ra sự cân nhắc từ con người, họ chỉ đóng dấu cho qua, và tín hiệu "đúng" đó được log lại như sự thật. Theo thời gian, model càng tự tin hơn, con người không được khuyến khích suy nghĩ thêm nên càng nhường AI, và AI trở thành người ngồi ở ghế lái.
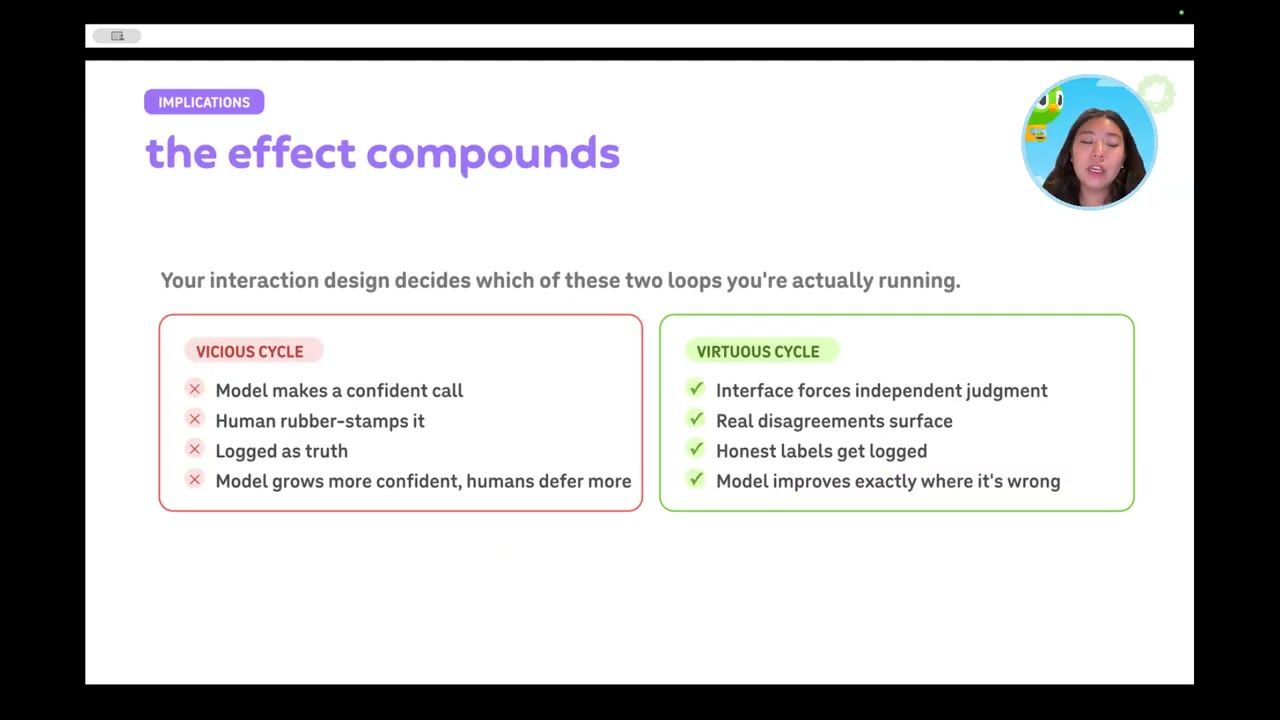
Thứ bạn muốn là một virtuous cycle (vòng tích cực). Nếu interface buộc con người phán đoán độc lập, họ sẽ thật sự suy nghĩ phản biện về quyết định của mình, và những bất đồng thật (real disagreements) sẽ lộ ra. Nghĩa là bạn có các nhãn true positive và true negative trung thực được log lại, để model tiếp tục cải thiện đúng ở những chỗ nó sai.
11. Ví dụ 1: headphone detection, hai câu hỏi trong một nút bấm
Angel chuyển sang các ví dụ. DET có những cờ gian lận khác cũng do AI dẫn dắt, chẳng hạn headphone detection. Bên trái slide là một pattern không tốt mà đội từng có: "Model phát hiện headphone tại thời điểm này, bạn có gắn cờ ở đây không?", và chỉ hỏi một câu yes/no đơn giản.
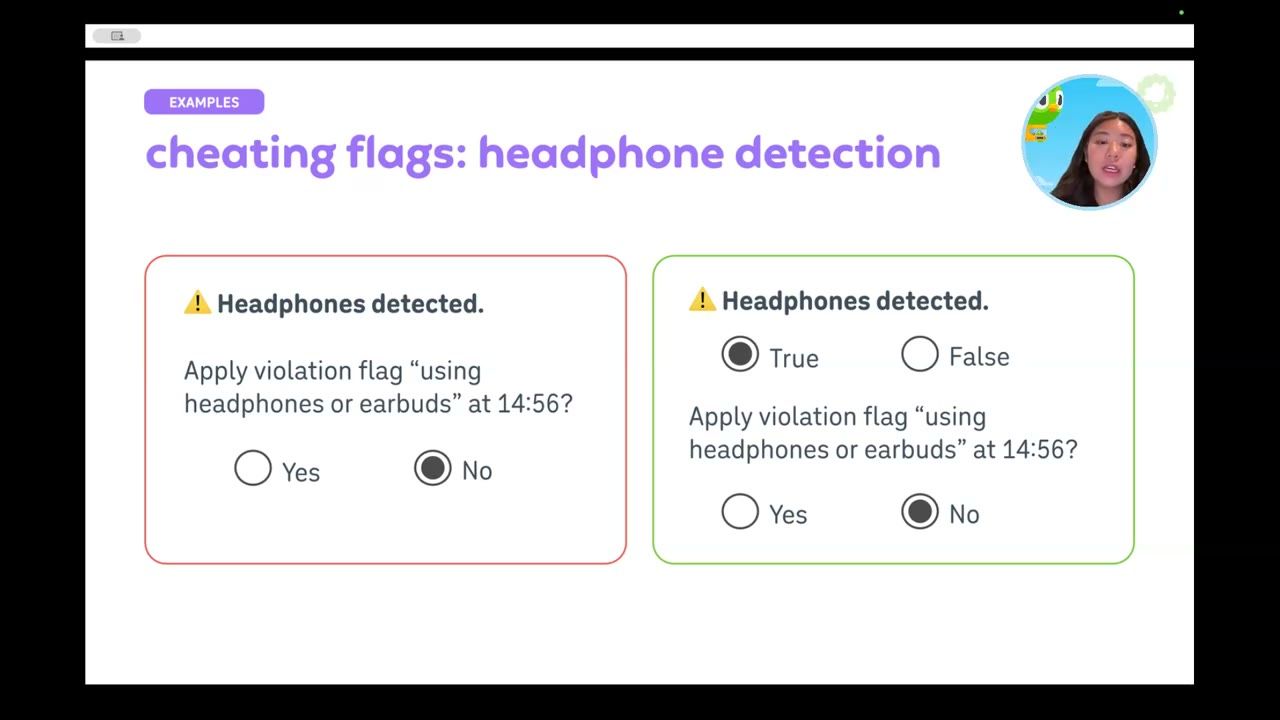
Họ nhận ra thực ra có tới hai câu hỏi ẩn trong một call-to-action duy nhất đó. Một là: "Đã phát hiện headphone, điều đó đúng hay sai?", tức là model có dự đoán đúng rằng trong đoạn video này có một nhóm pixel trông như headphone không. Hai là: ta có áp cờ rằng người này vi phạm vì dùng headphone sai quy định tại thời điểm đó không?
Vì sao điều này quan trọng? Ví dụ có người đeo máy trợ thính. Khi đó model đã dự đoán đúng là có headphone hay earbud, đó là một tín hiệu thật. Nhưng ta không hề muốn phạt người này vì đeo máy trợ thính, nên ta không muốn gắn cờ vi phạm. Trước đây, để không buộc tội oan ai, proctor sẽ chọn "No", nhưng đó lại là một tín hiệu xấu đưa ngược về model, vì nó nói rằng model đã nhìn sai. Tách thành hai phần là rất quan trọng: ta có thêm dữ liệu, dữ liệu chất lượng hơn, và không làm hại model về lâu dài.
12. Ví dụ 2: writing tutor, từ choáng ngợp tới dễ chịu
Ví dụ tiếp theo là một writing tutor. Bên trái là một pattern mà interaction gây choáng ngợp, bên phải là một pattern dễ chịu (delightful).
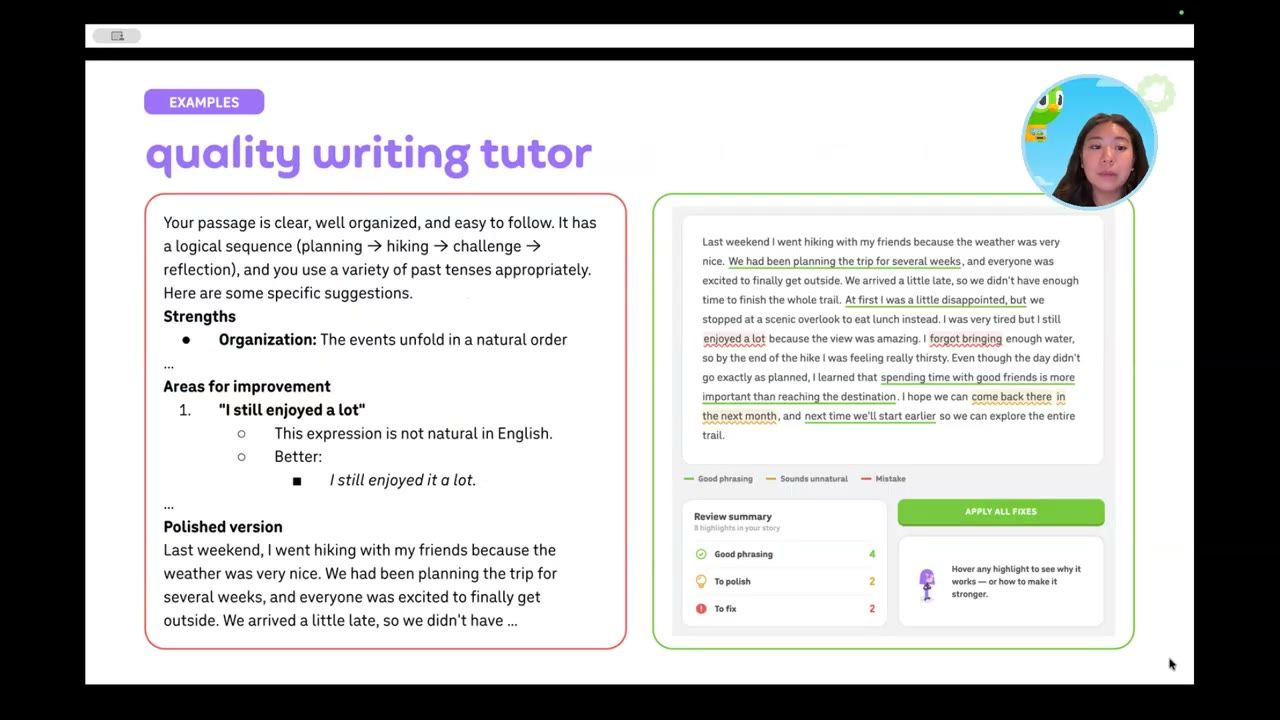
Phía bên trái là Angel đang nói chuyện với một LLM. Cô yêu cầu nó đóng vai writing tutor và góp ý cho một đoạn văn cô viết. Đoạn văn được viết cố ý như của một người đang học tiếng Anh, nên có vài lỗi hay vài câu gượng. Đó là một đoạn khá ngắn, vậy mà LLM trả về khoảng 400 dòng chữ, rất choáng ngợp và khó đọc. Đầu tiên nó khen, sau đó đưa vài góp ý, rồi viết lại toàn bộ đoạn văn dù cô không hề yêu cầu.
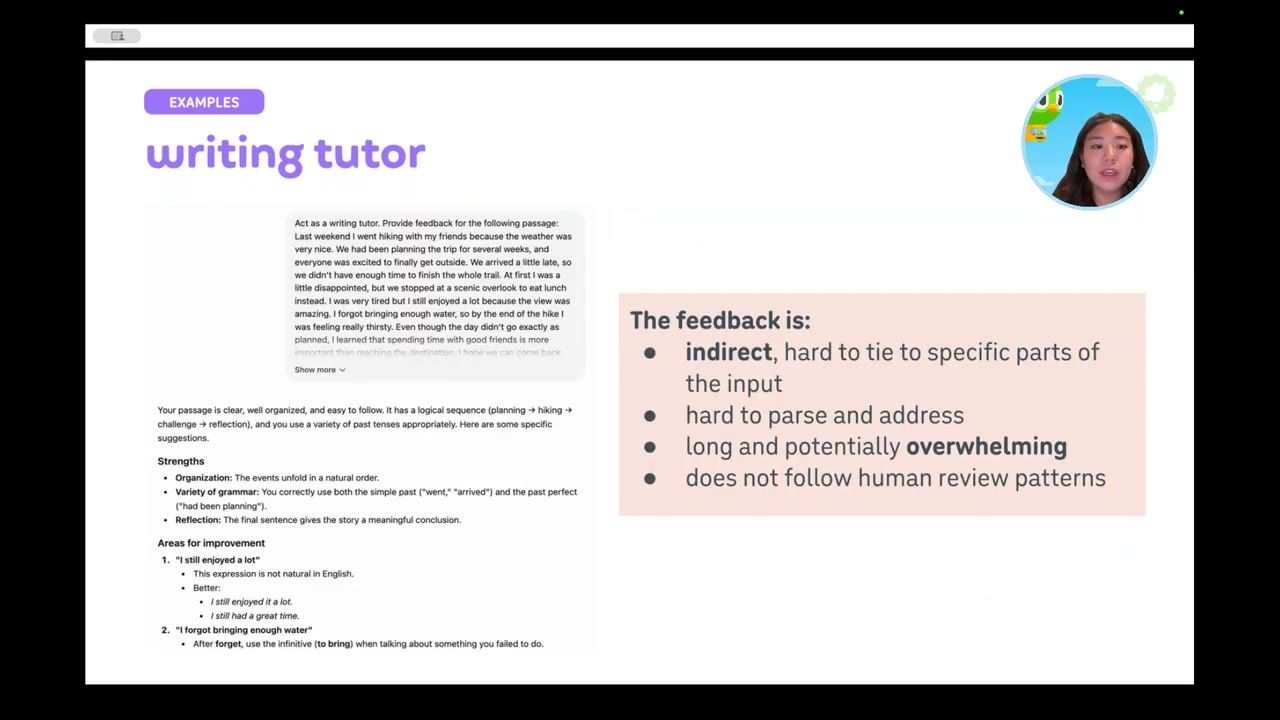
Phản hồi đó không trực tiếp. Rất khó gắn từng góp ý với một phần cụ thể của đầu vào, và nó dài tới mức khó mà thật sự cải thiện kỹ năng viết qua kiểu interaction này. Quan trọng nhất, nó không tự nhiên. Nếu bạn gửi email cho một người bạn: "Này, xem giúp mình cái này mình viết nhé?", bạn sẽ không mong họ gửi lại một bài luận dài gấp đôi, kể hết những chỗ bạn làm đúng và sai, rồi tặng kèm một phiên bản mới hoàn toàn.
Thay vào đó, bạn có lẽ muốn nó trông như thế này: một ảnh chụp writing tutor theo phong cách Duolingo, nơi văn bản được đánh dấu trực tiếp. Màu xanh lá báo chỗ viết tốt, kèm góp ý khi bạn rê chuột vào. Màu vàng báo chỗ hơi gượng hay hơi lệch. Màu đỏ là lỗi thật sự. Rê chuột lên bất kỳ chỗ đánh dấu nào, bạn nhận được góp ý trực tiếp, ngắn gọn, làm được ngay, và có thể chấp nhận gợi ý ngay tại chỗ. Quan trọng nhất là mọi góp ý đều gắn trực tiếp với một phần của văn bản.
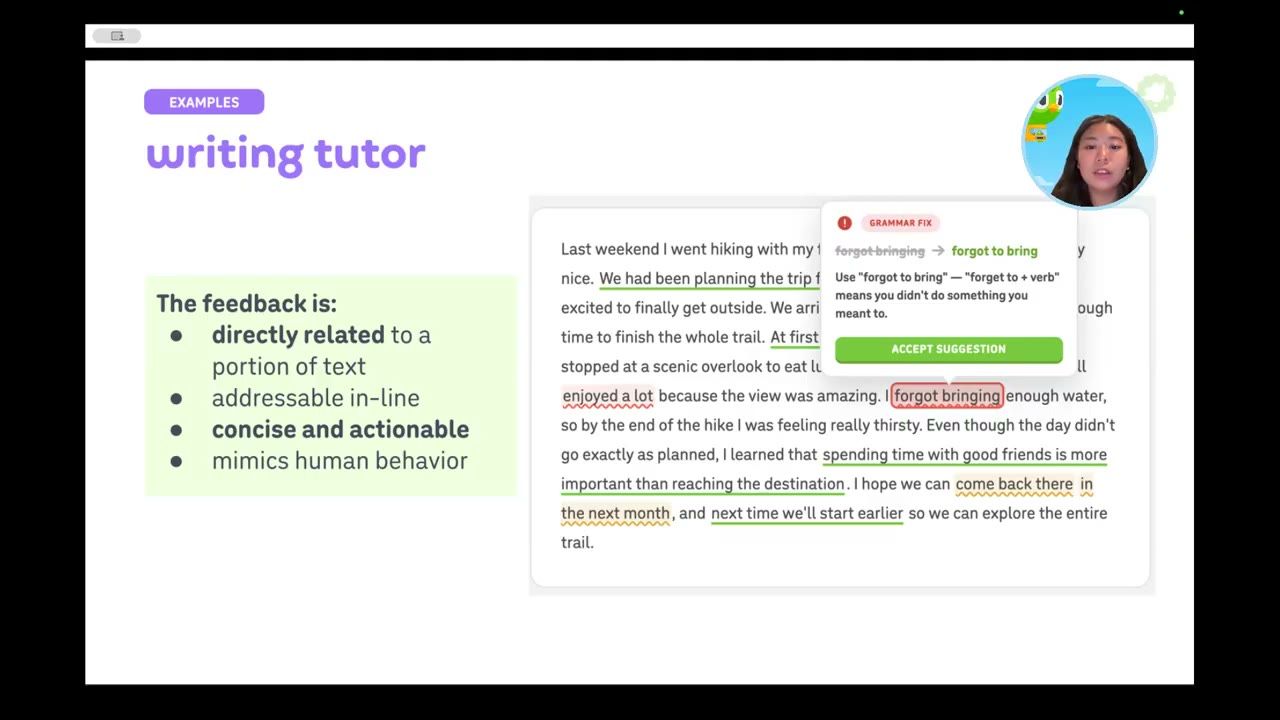
Cách này mô phỏng sát hành vi con người hơn. Như trong môi trường học thuật, nếu bạn đưa bài luận cho một bạn cùng lớp, bạn mong họ góp ý ngay trên dòng, đánh dấu lên chữ của bạn, chứ không phải trả lại một bài luận khác. Điều này hữu ích vì theo thời gian, nhận được những góp ý như vậy, bạn cải thiện kỹ năng viết từng bước nhỏ. Theo Angel, đây là điều rất quan trọng khi đưa ra (surface) đúng cùng một AI output cho người dùng.
13. Ví dụ 3: coding agent nên giống một junior dev
Ví dụ cuối, và có lẽ sát nhất với khán giả là engineer: coding agent. Có rất nhiều coding agent ngoài kia, với rất nhiều UI khác nhau, và mỗi người có sở thích riêng. Nhưng Angel thấy hai pattern mà nhiều coding agent dùng ngay khi mới cài thường rơi vào.
Pattern thứ nhất: bạn bảo nó làm gì đó, nó đụng vào rất nhiều file và đưa bạn một diff khổng lồ, về cơ bản làm hết yêu cầu trong một lượt. Điều này thường dẫn tới việc bạn approve tất cả thay đổi rồi mới xem lại, có khi trên GitHub, để biết nó đã làm những gì. Pattern thứ hai: nó ping bạn một notification mỗi lần sửa một file hay một function, và bạn phải bấm yes, yes, yes liên tục chỉ để đi tới kết quả.
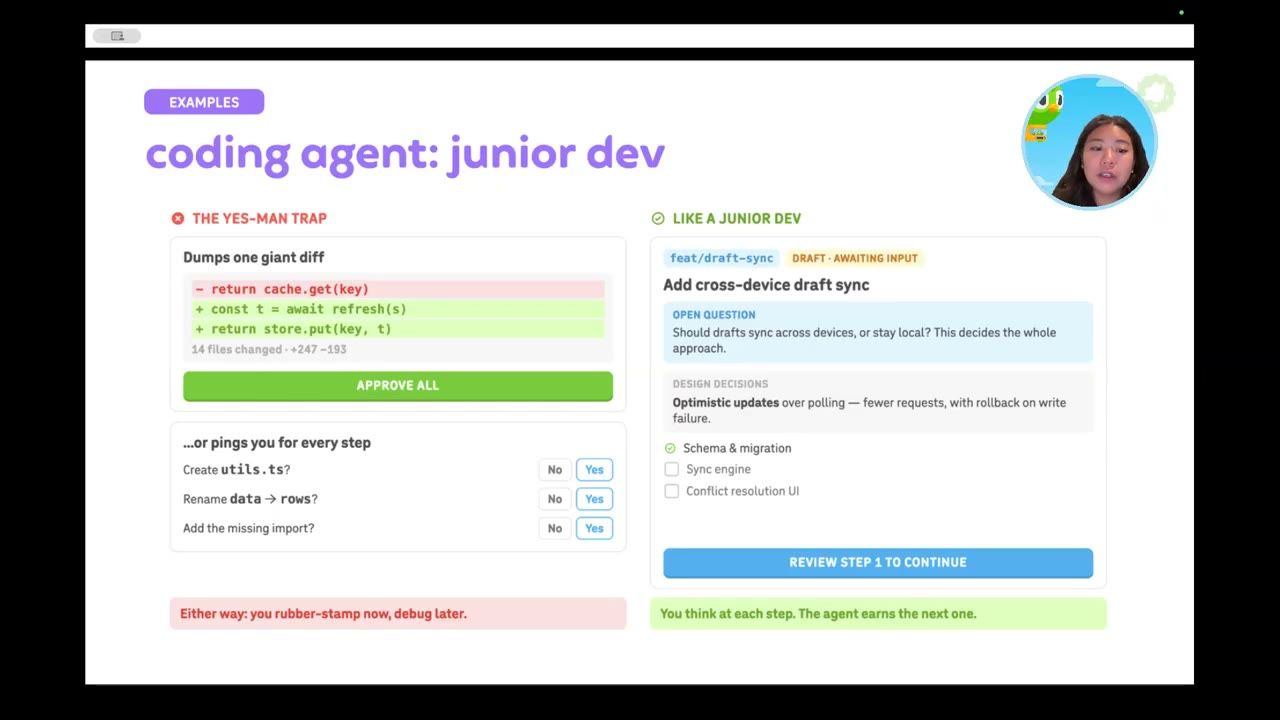
Dù kiểu nào, trong cả hai trường hợp bạn đều chỉ đang làm con dấu cao su. Bạn chấp nhận hết thay đổi rồi xem lại tất cả trong một lần và debug sau. Mọi thứ hỏng đều là trách nhiệm của bạn: tìm ra, sửa, re-prompt, hoặc tự làm bằng tay. Đó không phải trải nghiệm dễ chịu.
Thay vào đó, bạn có lẽ muốn một coding agent hành xử như một junior developer. Bạn sẽ không muốn một junior dev mới vào team nói "Ừ, để em làm" rồi biến mất cả ngày và quay lại với một PR 1.000 dòng. Bạn cũng không muốn một junior dev cứ năm phút lại tới bàn bạn hỏi một câu. Bạn muốn một người biết lập kế hoạch, hỏi câu hỏi tốt, ghi lại các design decision, đưa bạn một spec tốt, và chia PR thành những phần có ý nghĩa và review được.
Như vậy, với bạn trong vai mentor, hay ở đây là một developer đang làm việc cùng coding agent, trải nghiệm trở nên dễ chịu vì mọi thứ dễ review. Bạn thấy được các giả định (assumption) được nêu ra và có thể trả lời câu hỏi về chúng, bạn dễ dàng thấy plan và các quyết định agent đang đưa ra trước khi có gì đó hỏng. Các bước cũng vừa sức, và bạn không bị ping quá nhiều lần.
Sang phía dữ liệu: nếu agentic coder dẫn dắt một interaction trong đó developer được khuyến khích chỉ lướt nhanh mọi thứ mà không thật sự phân định, thì bạn chỉ thu được các tín hiệu nhị phân accepted và rejected, thường nghiêng về accepted, và chúng không cho bạn nhiều thông tin vì chỉ gắn với một khối code nào đó.
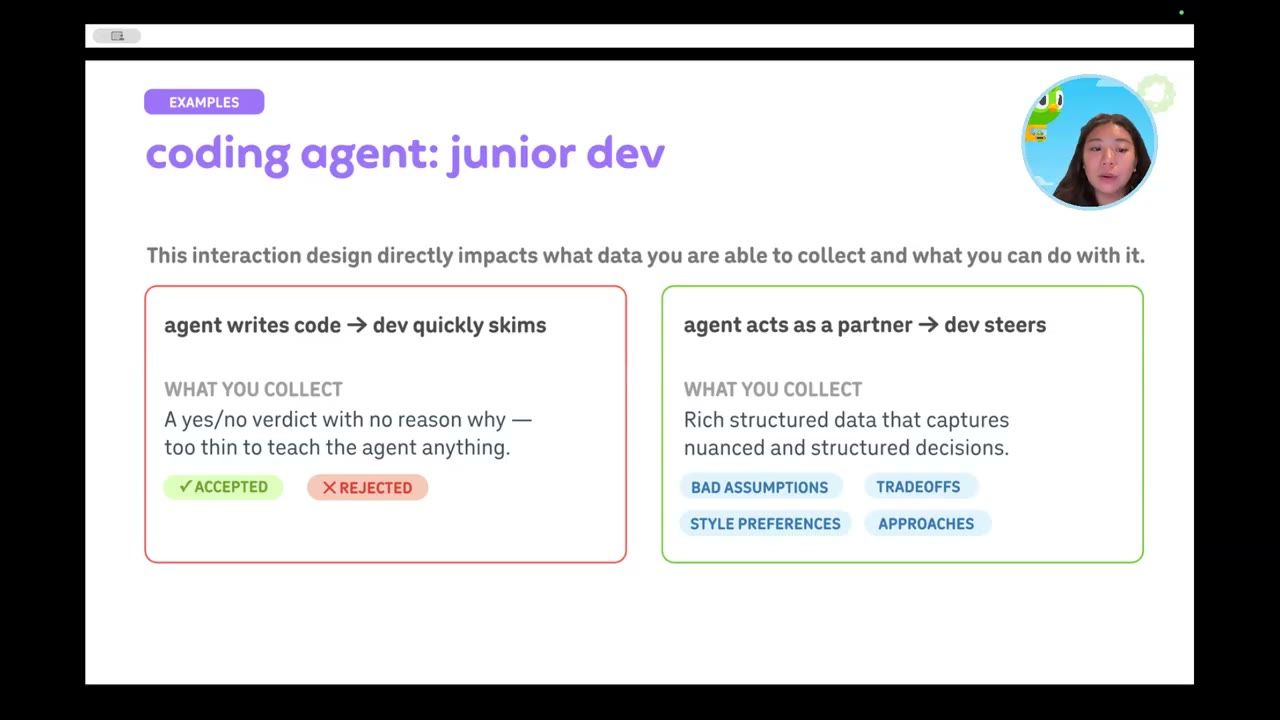
Ngược lại, nếu agent đóng vai partner và developer là người cầm lái, bạn có dữ liệu phong phú vì nó được cấu trúc riêng quanh từng phần của chu kỳ phát triển, và nó ghi lại các quyết định tinh tế, có cấu trúc, về từng phần của task mà agent đang làm. Ví dụ, nó có thể ghi lại những giả định sai, các trade-off agent đã chọn, sở thích về style, và cách tiếp cận mà developer đang theo. Tất cả những mẩu dữ liệu đó lại tiếp tục làm cho hệ thống AI, ở đây là hệ thống coding, tốt hơn.
14. Nguyên tắc 1: engineer the reasoning
Angel chuyển sang các design principle. Nguyên tắc đầu tiên: bạn có thể engineer the reasoning, thiết kế lối suy luận. Hãy nghĩ xem bạn muốn gợi ra reasoning pattern nào từ con người, và interface của bạn thách thức họ theo cách đó ra sao.
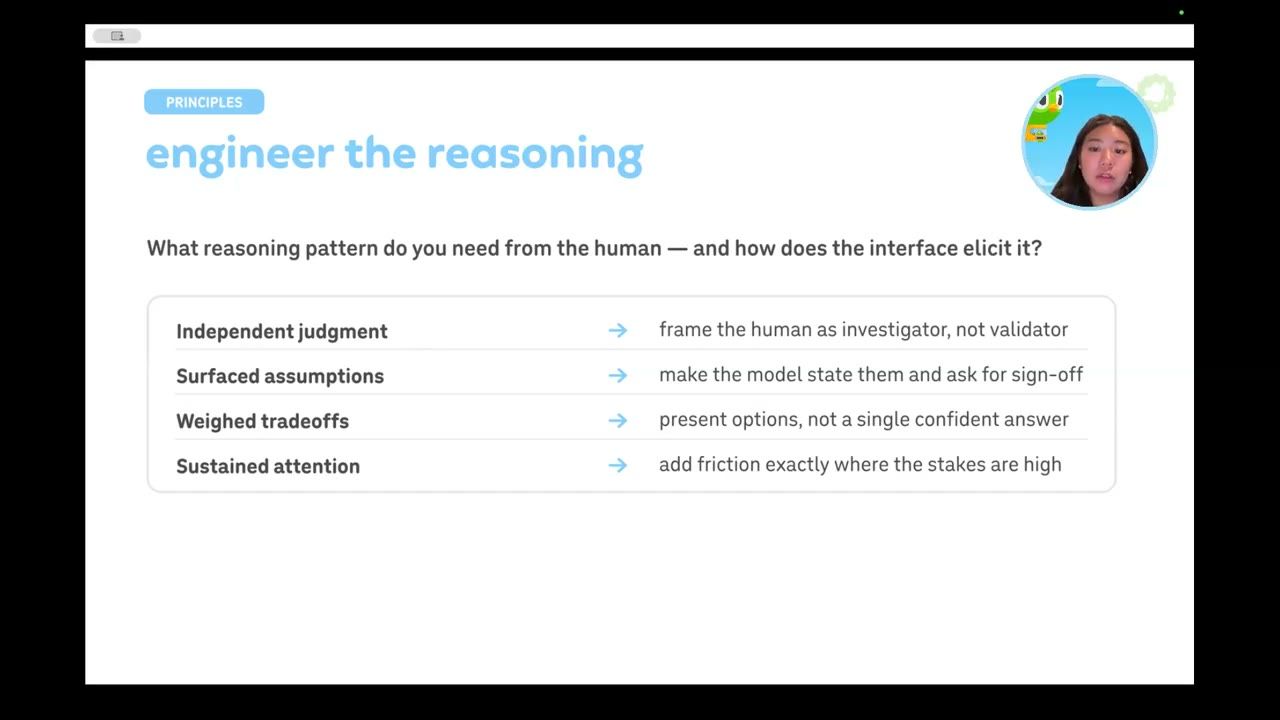
Independent judgment. Nếu hệ thống của bạn cần tối ưu cho phán đoán độc lập, hãy đóng khung lại để con người là một investigator (điều tra viên), không chỉ là một validator (người xác nhận). Đừng chỉ hỏi "Này, cái này trông ổn không?", mà hãy biến nó thành một nỗ lực có suy nghĩ, có tham gia thật.
Surfaced assumptions. Nêu giả định ra là việc rất giá trị khi bạn quan tâm nhiều tới chất lượng của một task chạy dài. Nếu model nói rõ giả định từ sớm và xin sign-off, bạn tránh được hiểu lầm về sau, hoặc khỏi phải quay lại sửa những giả định sai.
Weighed trade-offs. Cân nhắc trade-off cũng rất quan trọng, vì rất thường xuyên một LLM đưa ra một lựa chọn và cho rằng đó là tốt nhất mà không thật sự cân nhắc các trade-off, tức các design decision nó đang ngầm đưa ra phía sau. Trình bày các lựa chọn cùng lý do cho phép người dùng tiếp tục nắm quyền kiểm soát output, và họ có thể lên tiếng từ sớm để có đúng thứ họ thật sự muốn.
Sustained attention. Cuối cùng, để giữ sự tập trung bền, bạn muốn đặt friction (ma sát) đúng ở chỗ rủi ro cao.
15. Nguyên tắc 2: match the friction to the stakes
Nếu bạn muốn người dùng chậm lại và suy nghĩ có chủ đích, friction là bạn của bạn. Điều này dẫn tới nguyên tắc tiếp theo: match the friction to the stakes, cho mức ma sát khớp với mức rủi ro.
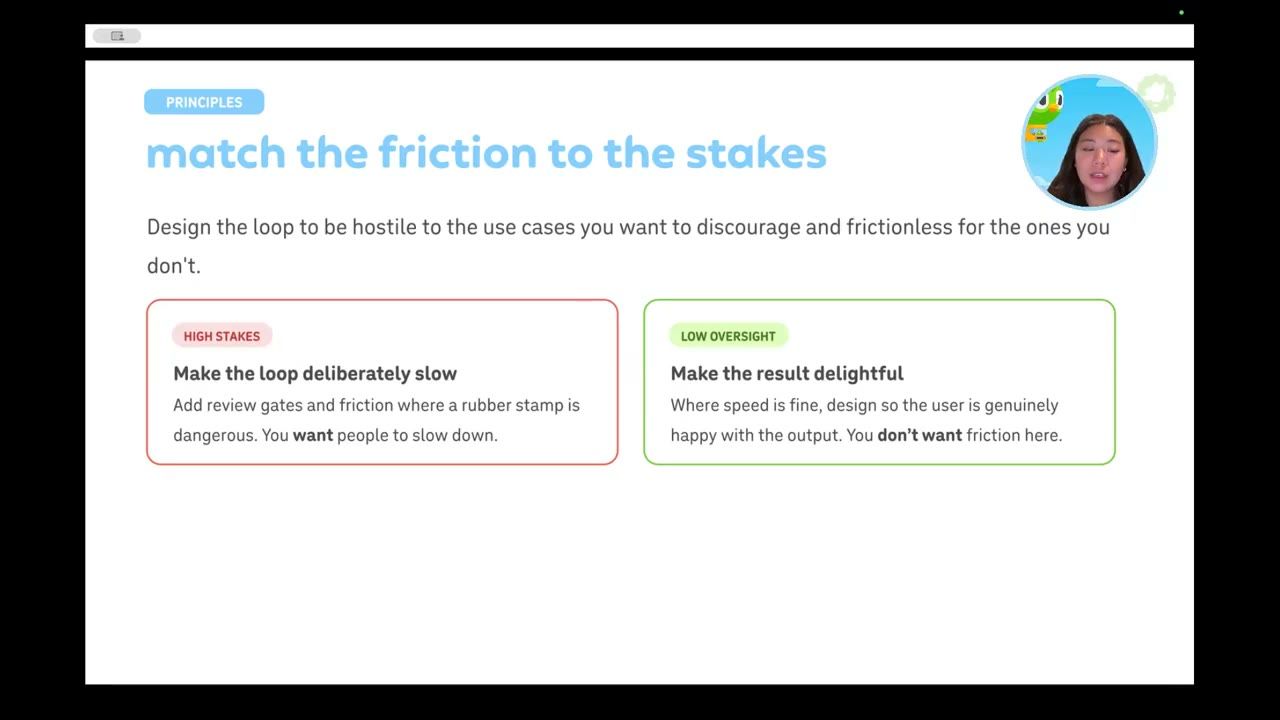
Trong một ví dụ high-stakes như của Duolingo, nơi Duolingo English Test thật sự quan trọng với con người và kế sinh nhai của họ, đội muốn reviewer con người chậm có chủ đích và rất cẩn trọng với từng quyết định. Nghĩa là thêm các review gate có cấu trúc tốt và thêm friction để họ chậm lại, nghĩ về những điều này, và không bao giờ trở thành con dấu cao su. Bạn muốn người ta chậm lại, và muốn output giữ chất lượng cao. Bạn không muốn nhiễu, bạn muốn sự rõ ràng. Vậy nên bạn phải chủ động nghĩ xem mình muốn đặt friction nào, những gờ giảm tốc nào trên đường, đặt thế nào, và các checkpoint ở đâu.
Với những hệ thống mức giám sát thấp, chẳng hạn một trải nghiệm vui vẻ khi bạn chỉ đang chat với AI, bạn muốn nó gần như không có ma sát. Thiết kế của bạn phải tối ưu cho một người dùng vui vẻ, hài lòng với output, không cảm thấy có nhiều điểm dừng hay những tình huống khó tương tác với hệ thống. Ở đó bạn muốn nó liền mạch tuyệt đối.
16. Nguyên tắc 3: every interaction is already a label
Nguyên tắc tiếp theo: mỗi interaction vốn đã là một nhãn. Thay vì phải chọn ra một phần dữ liệu rồi thuê người annotate để có một data set tốt hơn, sạch hơn, bạn có thể bắt đầu nghĩ rằng chính từng điểm tương tác đó đã cung cấp nhãn và tín hiệu cho vòng lặp kế tiếp.
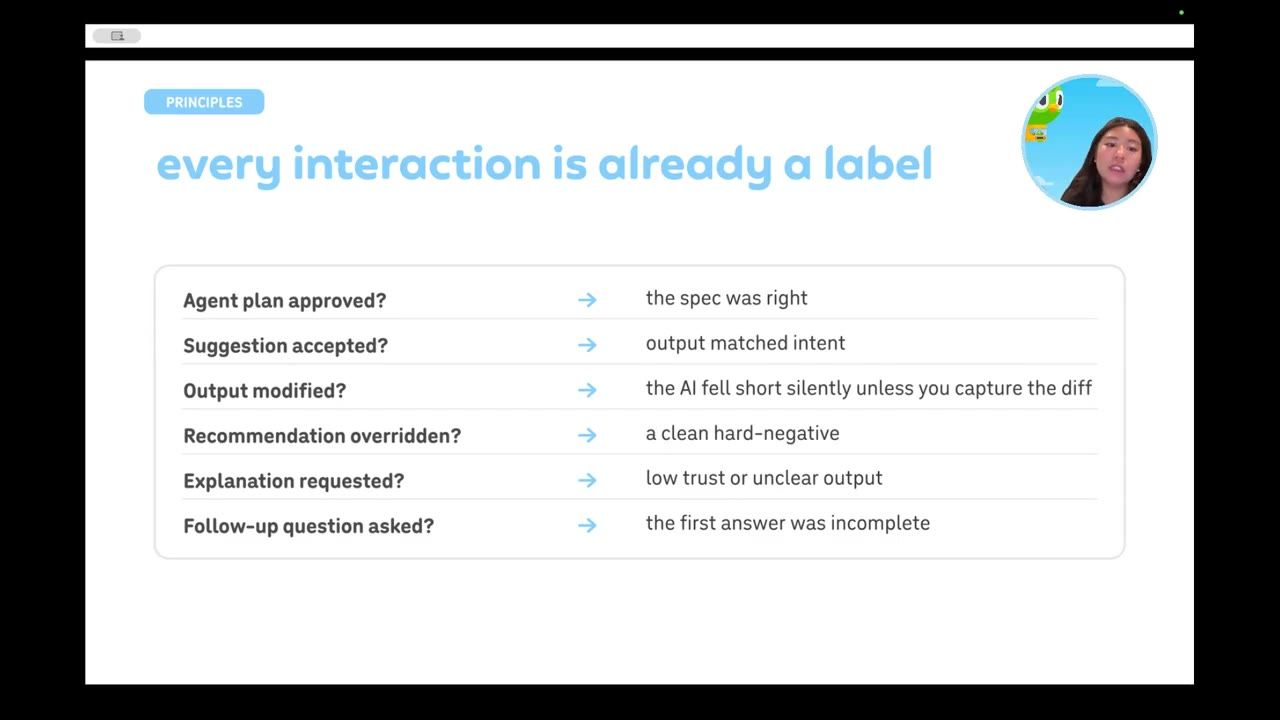
Nếu agent plan được approve hay một gợi ý được chấp nhận, nghĩa là bạn đã làm đúng và output khớp với ý định của người dùng. Còn nếu output bị sửa hay một recommendation bị bác bỏ, điều đó nhiều khả năng báo hiệu có gì không ổn.
Nhưng rất nhiều hệ thống không ghi lại cái diff đó, và đó là chỗ model hụt: thứ bạn nhận về từ quyết định chỉ là yes hoặc no. Con người bấm yes, rồi tự vào sửa tay một chỗ, hoặc xoá sạch đi. Nếu bạn không ghi lại diff đó, vốn có thể cho thấy AI đã hụt hoặc sai hoàn toàn, thì thứ bạn ghi lại là một tín hiệu giả, và nó có thể làm bẩn data set của bạn. Thay vào đó, hãy nghĩ cách đo được cái diff đó.
Cuối cùng, còn những câu hỏi mà con người có thể đặt ra, ví dụ xin giải thích hay hỏi follow-up. Điều này có thể nghĩa là người dùng có niềm tin thấp vào hệ thống, hoặc AI đã có gì đó sai. Vì vậy hãy nhìn vào loại câu hỏi người dùng đang hỏi và sắc thái (sentiment) của chúng.
17. Nguyên tắc 4: stop asking how to evaluate the model
Nguyên tắc tiếp: đừng hỏi "evaluate model thế nào" nữa. Thay vì xây xong hệ thống rồi mới hỏi "Giờ mình thu được dữ liệu gì để biết cái này có tốt không?", hãy chủ động nghĩ từ đầu xem điều gì định nghĩa thành công cho hệ thống AI của bạn. Hãy nghĩ xem bạn sẽ đo nó bằng metric cụ thể nào, và cần dữ liệu gì để cải thiện hệ thống ngay từ lúc bắt đầu.
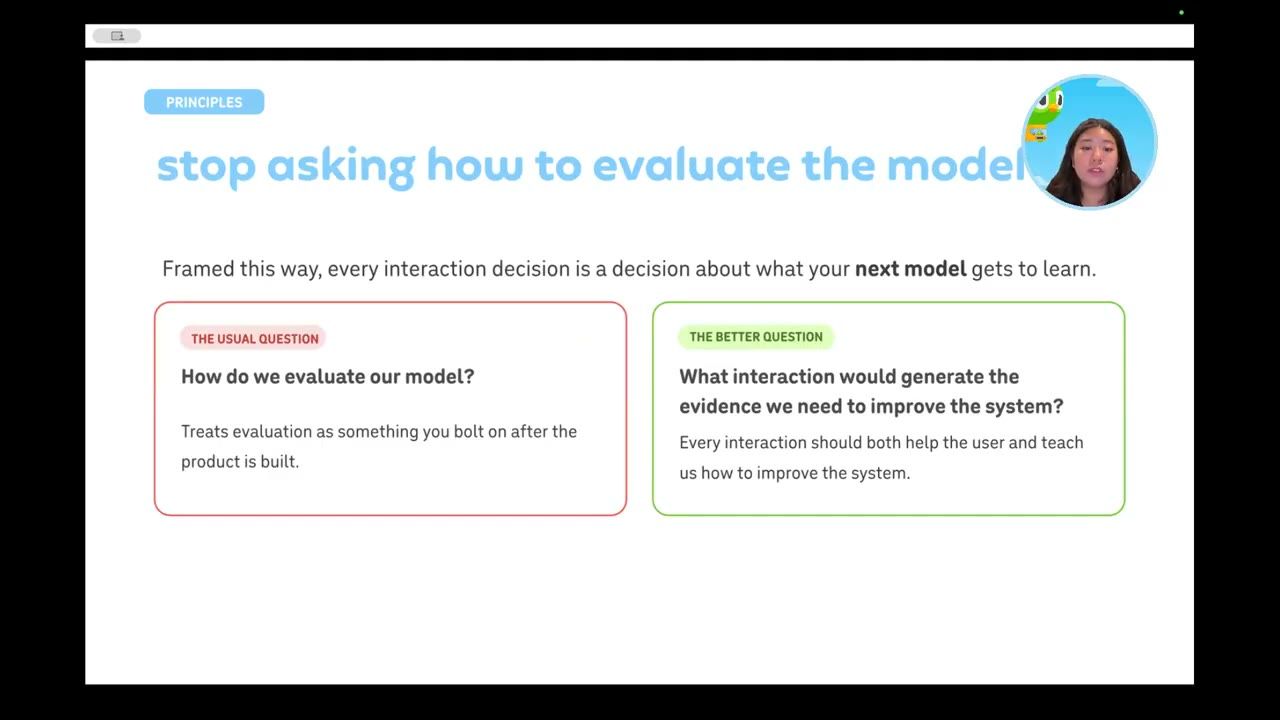
Những quyết định đó sẽ định hướng cách bạn thiết kế interaction, để bảo đảm bạn có bằng chứng cứng cho bước kế tiếp. Mỗi interaction nên vừa giúp người dùng, vừa dạy bạn cách cải thiện hệ thống, và biến người dùng thành partner của AI.
18. Engineering the interaction và lời kết: design for discernment
Điều này dẫn tới ý cuối cùng: tất cả những thứ trên đều dẫn bạn tới việc engineer chính interaction. Có nhiều cách để làm điều đó, Angel đã nói qua, nhưng có bốn nguyên tắc chính.
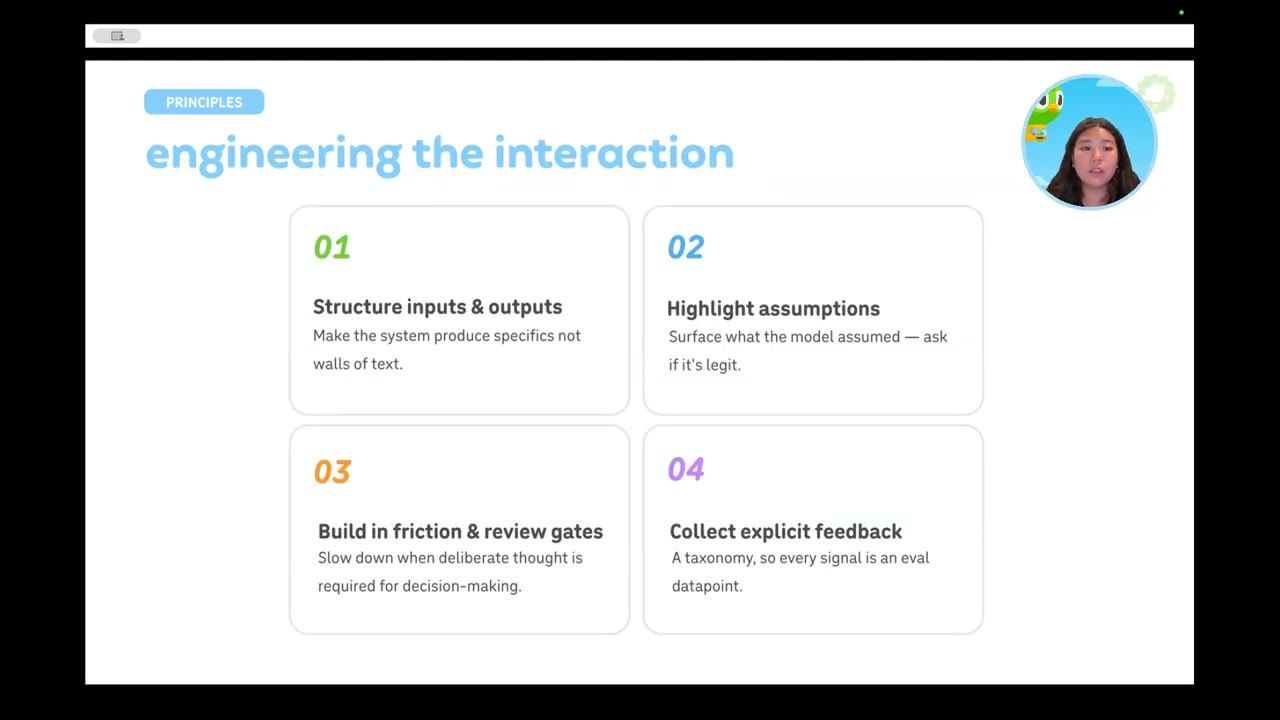
Thứ nhất, structured inputs và outputs. Như vậy bạn không chỉ có "vibes" hay những bức tường chữ khổng lồ, mà có những thứ cụ thể. Hãy nghĩ tới các form người dùng điền, structured output dưới dạng bảng, các markup UI như ví dụ writing tutor, hay một công cụ design nơi bạn có thể chọn từng phần tử cụ thể. Tất cả đều là những interaction có mục tiêu rõ giữa con người và AI, bảo đảm kết quả tốt hơn.
Thứ hai, highlight assumptions. Nếu model đang đưa ra giả định, việc chủ động nêu chúng ra và hỏi xem có hợp lý không sẽ giúp bạn tiết kiệm token về sau, vì con người không phải sửa, tranh cãi, hay chỉnh lại output của model. Thay vào đó, hệ thống chủ động, và những giả định ấy là những mẩu thông tin cốt lõi định hướng các quyết định về sau.
Thứ ba, build in friction và review gate. Sự chậm lại có chủ đích, để có suy nghĩ chất lượng, là điều cần cho quyết định tốt và dữ liệu tốt. Khi bạn đưa friction và review gate vào, người ta bắt đầu nghĩ rõ ràng như thể đó thật sự là việc của chính họ, chứ không phải thứ AI đang thay họ làm.
Cuối cùng, collect explicit feedback. Như đã nói, mỗi interaction là một mẩu dữ liệu, nên mọi tín hiệu đều đi vào thế hệ model kế tiếp. Thu thập feedback rõ ràng, không chỉ là thumbs up, thumbs down, mà là feedback ở đúng điểm chạm, với đúng mức tinh tế, là thứ có thể trực tiếp thúc đẩy cải tiến.
Vậy nên, theo Angel, bạn nên thiết kế cho sự phân định (design for discernment). Đôi khi cách sửa không phải là một model tốt hơn hay thêm người giám sát, mà chỉ đơn giản là engineer chính interaction. Cô cảm ơn khán giả và kết thúc talk.
Sources and links
- Trang talk chính thức trên ai.engineer
- Video gốc của talk
- Duolingo English Test
- Steven Shaw và Gideon Nave, "Thinking, Fast, Slow, and Artificial: How AI is Reshaping Human Reasoning and the Rise of Cognitive Surrender", SSRN (papers.ssrn.com/abstract=6097646)
- Knowledge at Wharton: How AI is reshaping human intuition and reasoning (Gideon Nave và Steven Shaw)
- Các bài nghiên cứu của Angel Ortmann Lee trên ACL Anthology
Related talks
Using RL-based Agent to Detect and Remediate ETL Pipeline Failures
Anna Marie Benzon · University of the Philippines Diliman · 15 min
Agent tự xử lý lỗi ETL trên AWS: rules xác lập facts, Q-learning chọn action có giới hạn, safety layer bên ngoài giữ quyền escalate; MTTR từ ngày xuống phút.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.