Building Great Agent Skills: The Missing Manual
AI Engineer World's Fair 2026: Online Track · Video gốc
Checklist bốn bước để viết agent skill tốt: chọn trigger, chia steps và reference, lái agent bằng leading words, và tỉa skill bằng deletion test.
1. Không tới được San Francisco, và một loại "hell" mới: skill hell
Matt mở đầu bằng một lời chào "Hello, friends" và một lời xin lỗi. Anh đã rất mong được có mặt ở AI Engineer World's Fair, nhưng chuyện gia đình chen vào nên anh không thể tới. Dù vậy, anh nói sẽ không để khán giả ra về tay không: đây chính là talk mà lẽ ra anh sẽ nói ở San Francisco, được ghi lại để gửi tới mọi người.
Talk có tên The Missing Manual: How to Write Great Skills, tạm hiểu là "cuốn cẩm nang còn thiếu: cách viết skill thật tốt". Luận điểm mở đầu của anh: khả năng phân biệt một skill tốt với một skill tồi đang ngày càng quan trọng, và sẽ còn quan trọng hơn nữa.
Để dẫn vào vấn đề, Matt đùa rằng dân developer có vẻ rất giỏi tìm ra những "địa ngục" khác nhau để tự chui vào. Vài năm trước là tutorial hell: bạn lao vào cả đống tutorial để học một thứ, không ghép được các mảnh lại với nhau, và cứ thế, "ugh", bị cuốn vào một vòng lặp không thoát ra được. Rồi tới framework hell: cứ mười phút lại có một JavaScript framework mới được công bố, và bạn lúc nào cũng phải học "the hot new thing".
Và giờ, theo Matt, chúng ta có thêm một phiên bản địa ngục nữa: skill hell. Skill hell là khi bạn có trong tay đủ loại skill, miễn phí, tải về được, đóng góp vào được, tự mày mò được. Nhưng bạn không thật sự hiểu các mảnh ăn khớp với nhau ra sao. Bạn không phân biệt nổi skill tốt với skill tồi. Kết quả là người ta cố ghép các "framework" skill này lại, cố thử mọi thứ đang có cùng một lúc, và họ không làm nổi, hay nói đúng hơn là họ không nhận được kết quả mà chính các skill đó hứa hẹn.
Điều này đúng ở cấp cá nhân, và cũng đúng ở cấp tổ chức. Các tổ chức chưa có cách, cũng chưa có hiểu biết, để xây skill tốt: làm sao lấy các operating procedure (quy trình vận hành) của mình và biến chúng thành những việc một agent làm được. Nếu không làm được việc đó, rất khó gặt được "bounty", phần lợi ích mà skill có thể mang lại.
2. "Just one more skill, bro" và cảm giác có lỗi của tác giả mattpocock/skills
Matt tóm cả tâm lý đó trong một câu đùa: "Just one more skill, bro." Thêm một skill nữa thôi mà, có vẻ đó là điều mọi người đang tự nói với nhau. Cứ thêm skill, như thể skill tiếp theo sẽ giải quyết mọi thứ.
Anh thừa nhận mình cũng thấy có chút tội lỗi ở đây. Lý do: anh có repo Matt Pocock Skills, tức repo skill của anh, và đó là một trong những bộ engineering skill phổ biến nhất hiện nay. Vì thế anh muốn giúp chính những người đang dùng skill của mình thoát khỏi skill hell.
Câu hỏi đặt ra cho phần còn lại của talk: làm sao để thoát ra? Thật ra thì cái gì đang thiếu ở đây?
3. Thứ còn thiếu: một rubric để nhìn ra skill tốt, và checklist bốn bước
Theo Matt, thứ chúng ta đang thiếu là: chúng ta chưa biết điều gì làm nên một skill tuyệt vời. Chúng ta chưa thể nhìn vào một skill và nói "Okay, skill này đang làm những điều tốt này và những điều tệ kia". Không có một rubric chung, không có một framework nào để nhìn vào một skill rồi làm nó tốt lên.
Đó là thứ anh sẽ trao cho khán giả trong talk này: một skill checklist. Một danh sách những điều bạn có thể soi vào bên trong một skill để chắc rằng nó đang làm đúng điều nó nói, cùng những cách cải thiện nó và những cách để viết skill.
Checklist có bốn phần:
- Trigger: skill được gọi ra (invoke) như thế nào, và những quyết định thiết kế bạn phải đưa ra ở đó.
- Structure: cấu trúc bên trong của skill, skill thực sự được ghép lại và bày bố ra sao.
- Steering: làm sao lái agent bằng skill, làm sao để skill bảo được agent phải làm gì.
- Pruning: làm sao để skill nhỏ nhất có thể. Vì khi đã có một skill chạy được, ta cần, như Matt nói, về cơ bản là tối giản nó: tỉa bỏ mọi thứ không liên quan, tỉa bỏ mọi "no-op".
4. Skill Writing Great Skills, và bước 1: Trigger
Matt chỉ ra một "lợi thế" nho nhỏ của việc anh không có mặt trong phòng: bạn có thể đi thử ngay. Anh đã mã hoá toàn bộ những gì sắp nói thành một skill mới trong repo của mình, tên là Writing Great Skills. Nếu bạn đang có một use case cần tới nó ngay, anh nói đùa, cứ đóng trình duyệt này lại, "get out of here", vào repo skill của anh và dùng skill đó để cải thiện skill của bạn hoặc viết skill mới thật tốt.
/writing-great-skills: skill đóng gói toàn bộ checklist của talk, nằm trong repo mattpocock/skills.Rồi anh bắt đầu đi qua checklist, từ mục số một: trigger, cách skill được gọi ra.
Để nói về trigger, Matt làm một phép so sánh. Skill của anh thường xuyên bị đem ra so với một bộ engineering skill cực kỳ phổ biến khác tên là Superpowers. Câu anh hay được hỏi nhất là: "Skill của anh so với Superpowers thế nào? Khác nhau ở đâu?" Để trả lời câu đó, cần hiểu sự khác nhau giữa user-invoked skill và model-invoked skill.
5. User-invoked và model-invoked: description là một context pointer
Với bất kỳ skill nào, bạn luôn có thể gọi nó bằng tay. Skill nằm trên file system của bạn; agent chỉ việc mở skill ra và hiểu bên trong có gì. Bạn luôn làm được điều đó bằng cách nói với agent. Không phải lúc nào nó cũng trông như một dấu gạch chéo kiểu /my-skill, tuỳ harness, nhưng bạn luôn có thể user-invoke skill của mình.
/my-skill: cách gọi skill bằng tay quen thuộc. Mỗi harness có cú pháp riêng, nhưng người dùng luôn có thể tự gọi một skill.Cách thứ hai là để chính agent gọi skill. Đó là model-invokable skill, hay model-invoked skill. Bạn có một description: description của skill luôn nằm trong context của agent. Agent nhìn vào đó và nghĩ "Okay, dựa trên description này, mình sẽ invoke skill", rồi nó đọc file SKILL.md, nơi chứa phần "thịt" của skill, vào context window. Đó là cách một skill được invoke, và đó là chuyện xảy ra khi một skill được invoke.
Như vậy description đóng vai trò một context pointer: nó nằm trong context của agent và chỉ sang một file khác, nơi agent có thể tới nếu muốn thêm context.
Context pointer này không bắt buộc phải nằm trong context của agent. Nó có thể vô hình với agent, và khi đó ta có một user-invokable skill. Tức là có những skill chỉ người dùng gọi được, vì chúng không có context pointer này. Pointer là tuỳ chọn.
Matt mở repo của mình ra làm ví dụ. Skill codebase-design là một model-invokable skill: nó có description, và description đó đi vào context window của agent. Còn skill Grill Me thì có dòng disable-model-invocation: true. Nghĩa là đoạn description nhỏ đó chỉ hiện cho người dùng, agent không nhìn thấy nó.
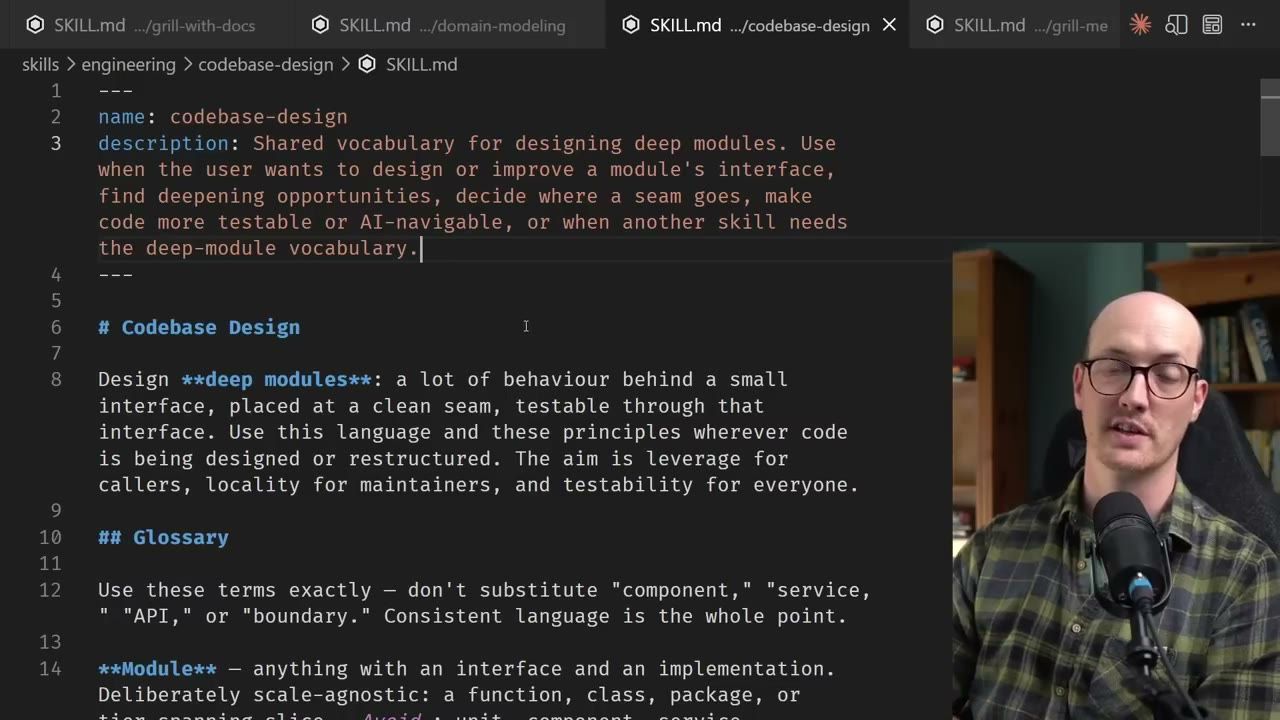
codebase-design trong repo của Matt. Phần frontmatter có name và một description dài ("Shared vocabulary for designing deep modules. Use when the user wants to design or improve a module's interface..."); chính description này là thứ nằm trong context của agent. Các tab bên cạnh là grill-with-docs, domain-modeling và grill-me.Nói cách khác, chỉ một dòng disable-model-invocation: true trong frontmatter là đủ biến một skill thành user-invoked: description vẫn còn đó, nhưng chỉ người dùng đọc thấy.
6. Tip #1: context load của agent và cognitive load của người dùng
Từ đó ra tip số một: quyết định skill của bạn là user-invoked hay model-invoked.
Bạn có thể nghĩ model-invoked skill tốt hơn, đúng không? Vì như thế cả model lẫn người dùng đều gọi được nó, linh hoạt hơn. Nhưng mỗi lần bạn thêm một model-invoked skill vào môi trường của agent, bạn tăng thứ Matt gọi là context load lên agent đó. Nó thêm một description mới, tốn token ở mọi request, và cũng thêm một thứ khác để agent phải nghĩ tới. Nếu bạn có 100 model-invoked skill, sẽ có 100 description nằm trong context của agent.
Vậy có vẻ hợp lý là nên giảm bớt số model-invoked skill, hoặc dùng toàn user-invoked skill. Nhưng user-invoked skill có một loại "tải" khác: càng nhiều user-invoked skill, cognitive load lên người dùng càng cao. Nói cách khác, người dùng càng phải nhớ nhiều thứ trong đầu, thì càng đòi hỏi nhiều kỹ năng ở "người lái".
So sánh Matt Pocock Skills với Superpowers dưới góc này: Superpowers chủ yếu là model-invoked skill, đúng như cái tên, nó trao cho agent "siêu năng lực". Còn với skill của mình, Matt thích được kiểm soát hoàn toàn. Điều đó giúp anh giữ context load trên agent nhỏ nhất có thể, nhưng đổi lại đặt nhiều cognitive load hơn lên chính anh. Anh phải hiểu các skill thật sâu thì mới khai thác được tối đa.
7. Context pointer kéo theo unpredictability
Vậy tại sao Matt chọn như vậy, tại sao anh thích user-invoked skill hơn? Vì mỗi model-invoked skill đi kèm một cái giá về unpredictability, tính khó đoán. Mỗi khi có một context pointer chỉ từ tài nguyên này sang tài nguyên khác, model hoàn toàn có thể chọn không đi theo nó. Kể cả khi skill đó khớp hoàn hảo với task, model vẫn có thể chọn không invoke.
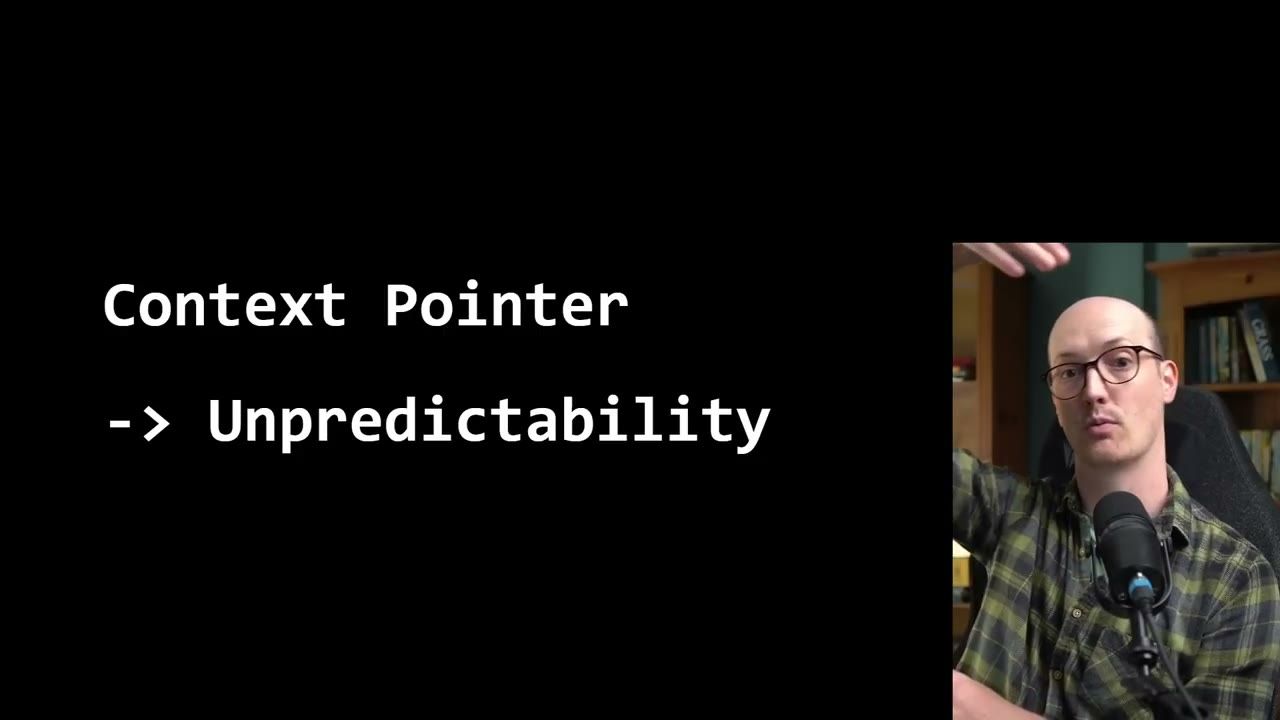
Matt thích loại bỏ lớp unpredictability đó, chấp nhận đặt thêm chút cognitive load lên người dùng. Thứ anh nhận được là loại bỏ hẳn một lớp vấn đề, khiến nó không còn là vấn đề nữa. Bởi vì sự khó đoán này buộc người ta phải eval skill của mình để chắc chắn chúng được gọi đúng lúc, một việc mà anh gọi là "really nasty", và là vấn đề anh muốn tránh.
Nhưng điều anh muốn khán giả thấy là: model-invoked skill và user-invoked skill đều có cái giá riêng. Nên chọn bên nào không phải là một quyết định dễ. Đó là phần trigger, cách skill được gọi ra.
8. Bước 2: Structure, hai đơn vị steps và reference
Tiếp theo là structure, cách bố trí bên trong của skill. Matt nghĩ rằng có hai đơn vị chính cần đặt vào hầu hết các skill: steps và reference.
- Steps là quy trình từng bước mà skill sẽ đi qua.
- Reference là mọi thông tin hỗ trợ giúp đi qua các bước đó.
Có những skill không có steps, chỉ toàn reference, và có những skill không có reference, chỉ là một chuỗi bước đơn giản. Nhưng nếu bạn bắt đầu nghĩ về skill như được ghép từ hai đơn vị này, việc chẻ skill ra sẽ dễ hơn rất nhiều.
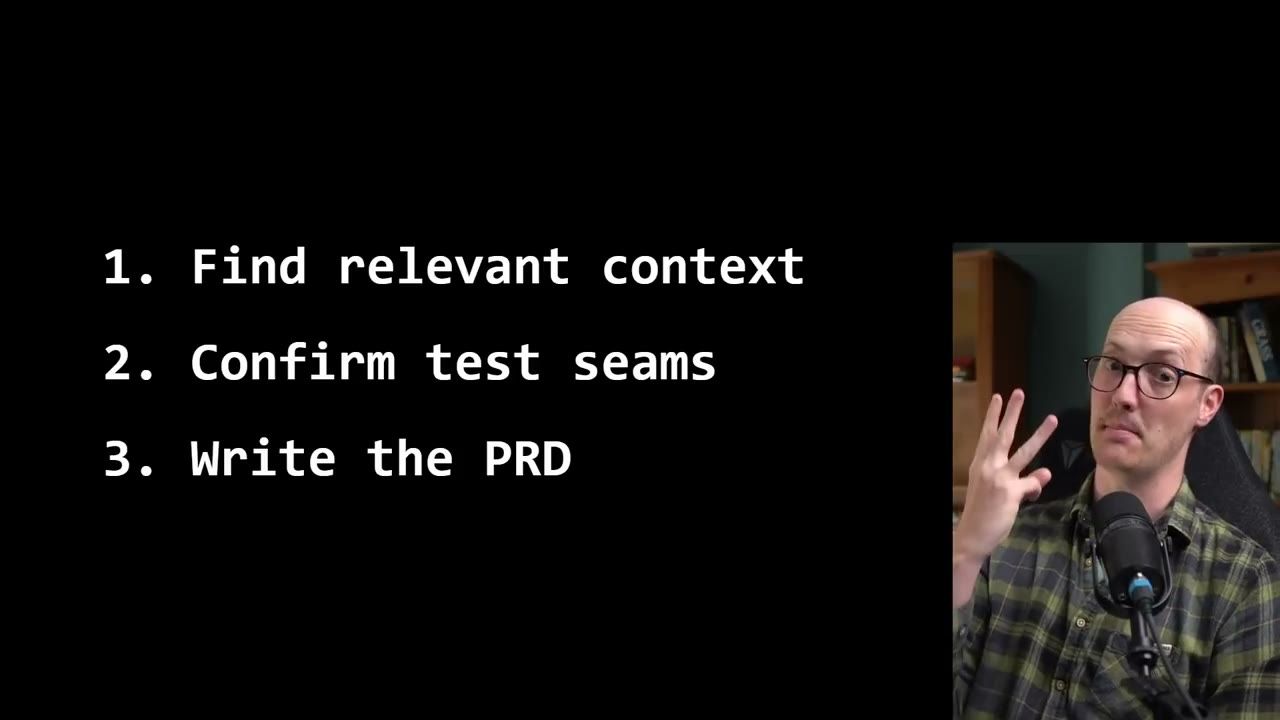
Ví dụ: một skill của Matt tên To PRD tạo ra một product requirements document (PRD) từ chính context window hiện tại. Nó có ba bước:
- Tìm context liên quan.
- Xác nhận các test seam với người dùng. Đây là một checkpoint human-in-the-loop nhỏ, chỉ để chắc rằng không có gì kỳ quặc với chuyện testing, một việc Matt thấy thật sự quan trọng.
- Viết PRD.
Để phục vụ ba bước đó, skill có hai mẩu reference: một đoạn ngắn giải thích "test seam là gì", và một template PRD, đơn giản là một Markdown template theo đúng nghĩa đen, dùng để viết PRD.
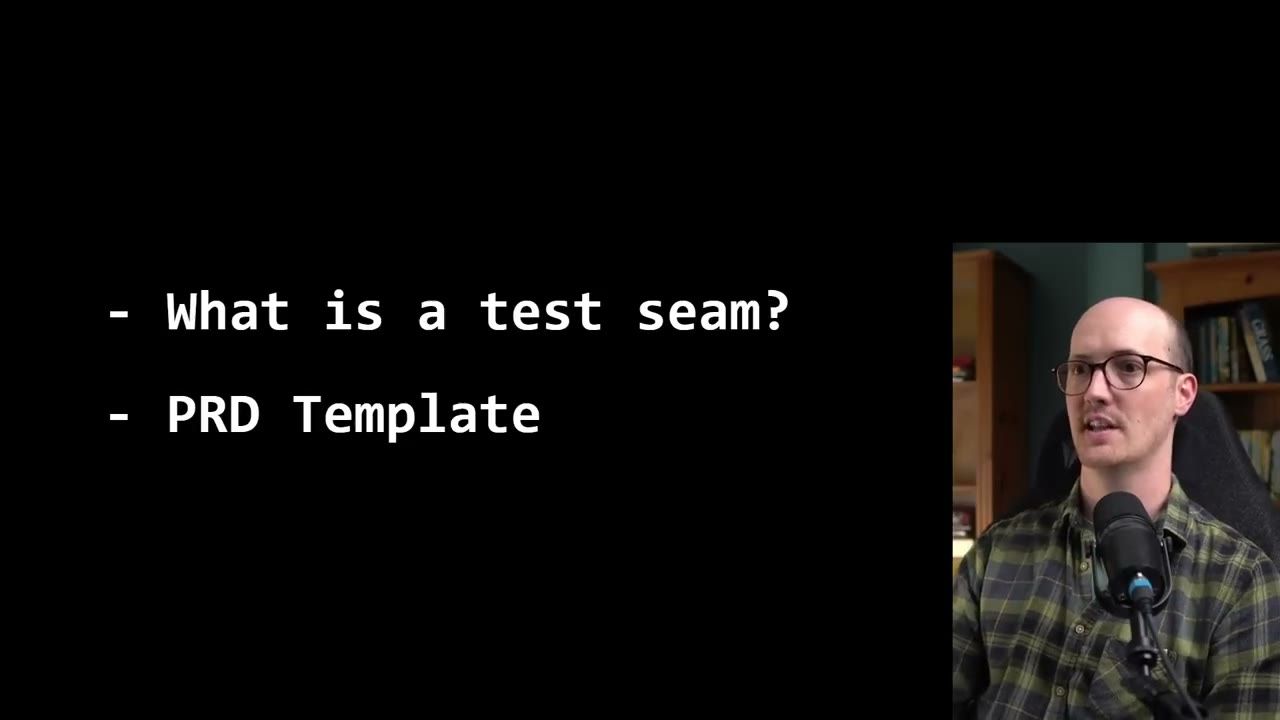
Theo Matt, đây là một cách rất tốt để viết skill từ đầu: xác định xem bạn có cần steps không, viết các step ra, rồi xác định những step đó cần reference gì, và đặt reference vào một chỗ riêng trong skill dành cho reference.
9. Tip #3: SKILL.md càng nhỏ càng tốt, và nhìn theo branch
Nhưng có một ràng buộc rất quan trọng cần nghĩ tới, chính là tip số ba: làm cho file SKILL.md chính nhỏ nhất có thể.
Mỗi skill gồm description, rồi tới một file SKILL.md, rồi tới mọi reference rẽ nhánh ra từ đó. Nếu giữ SKILL.md nhỏ, bạn tiết kiệm theo nhiều cách. Skill nhỏ dễ maintain hơn, dễ audit hơn, ít chữ phải nghĩ tới hơn. Và mỗi chữ bạn gọt đi là một token, thật ra là nhiều token, được gọt khỏi chi phí của skill. Matt tin rằng skill nhỏ thật sự quan trọng, cho cả người maintain lẫn người dùng.
Một cách rất hữu ích để làm skill nhỏ lại là nghĩ về các branch của skill, tức những cách khác nhau mà skill có thể được dùng. Nếu có một mẩu reference chỉ dùng ở một branch, đó là ứng viên để đưa ra khỏi SKILL.md chính.
Quay lại To PRD: có hai mẩu reference, "test seam là gì" và template PRD. Template PRD thì cần ở mọi lần chạy, vì lần nào ta cũng tạo một PRD. Thông tin về test seam có lẽ cũng cần mọi lần, vì lần nào cũng hỏi về test seam. Vậy To PRD chỉ có một branch, mọi reference đều thuộc branch đó, nên chúng nhiều khả năng cũng thuộc về chính file SKILL.md.
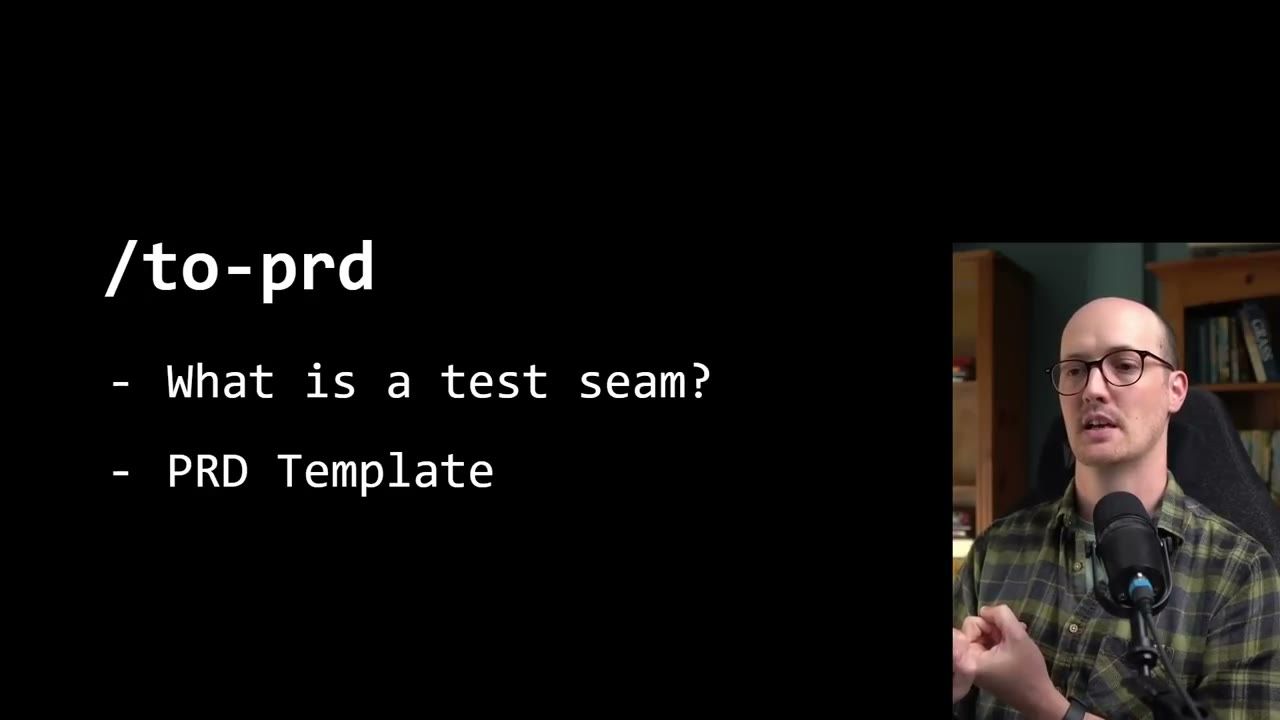
/to-prd: chỉ một branch, nên cả "What is a test seam?" lẫn "PRD Template" đều nên nằm ngay trong SKILL.md.10. Tip #4: giấu reference của từng branch sau context pointer
Nhưng nhìn sang một skill khác của Matt là domain modeling, câu chuyện khác hẳn. Domain modeling làm hai việc. Nó cập nhật một glossary cục bộ tên là CONTEXT.md, và nó cũng tạo các architectural decision record (ADR). Tức là nó làm hai việc khác nhau. Hoặc nó cũng có thể chọn không làm việc nào cả, và khi đó nó không cần template CONTEXT.md, cũng không cần template ADR.
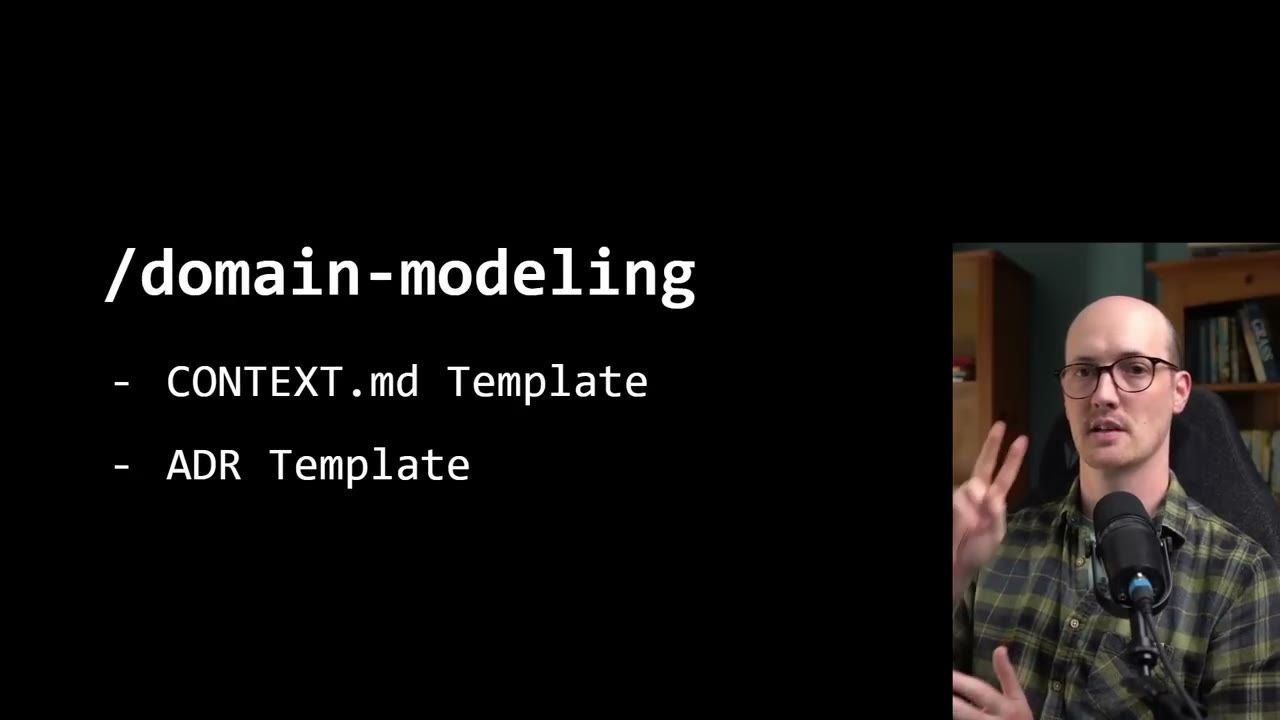
/domain-modeling có hai mẩu reference, CONTEXT.md Template và ADR Template, mỗi mẩu chỉ cần cho một branch.Nói cách khác, domain modeling có hai, có khi ba branch. Điều đó có nghĩa là ta không cần nhét template ADR hay template CONTEXT.md vào skill chính. Chúng có thể được chuyển ra những vùng riêng.
Cách làm: trong file SKILL.md, đặt template đó sau một context pointer, và pointer trỏ tới một file Markdown riêng nằm trong thư mục của skill. Context pointer đó nói đúng một câu kiểu: "Nếu cần template, hoặc nếu cần cập nhật file CONTEXT.md, hãy tới file này." Matt gọi đó là một external reference: reference nằm ngoài SKILL.md mà bạn trỏ tới dễ dàng, và agent kéo vào rất dễ vì nó được đóng gói cùng skill.
Đây là một kỹ thuật để làm SKILL.md nhỏ nhất có thể, điều mang lại rất nhiều lợi ích. Matt gói nó thành tip số bốn: hide branching reference material behind context pointers, giấu reference của các branch sau context pointer. Nói cách khác, nếu bạn thấy skill sẽ được dùng theo nhiều cách khác nhau, hãy lấy phần reference liên quan tới các branch đó và giấu chúng sau context pointer.
Tổng kết phần structure: phải nghĩ tới việc làm SKILL.md "super-duper small"; nghĩ tới các branch trong skill và chuyển tài liệu ra sau context pointer; và nghĩ tới steps với reference, hai đơn vị chính bên trong một skill.
11. Bước 3: Steering và kỹ thuật leading words
Tiếp theo là steering, những cách thực sự khiến agent làm điều ta muốn. Với Matt, steering quy về một kỹ thuật rất hay, và đây là điều chính anh muốn khán giả mang về từ talk này.
Kỹ thuật này sửa vấn đề sau, failure mode số một: agent không làm điều tôi muốn. Bạn ghi rõ một điều trong skill, bạn nghĩ mình đã nói rõ ràng, rồi nó cứ thế không làm.
Theo Matt, lý do chính khiến chuyện này xảy ra là bạn không dùng một kỹ thuật gọi là leading words. Ý tưởng của leading words, hay Leitwort nếu bạn thích lý thuyết văn học, là có những từ nén rất nhiều nghĩa vào một không gian rất nhỏ.
Leading words cực kỳ mạnh với agent vì: bạn đặt leading word vào chính skill, trong văn bản, rồi agent sẽ lặp lại leading word đó cho chính nó trong lúc vận hành, trong thinking tokens, và trong output gửi bạn. Và vì nó cứ nhấn lại từ đó, mà từ đó, nếu chọn đúng, mô tả điều bạn muốn ở agent, nên nó thay đổi hành vi của agent.
12. Ví dụ: agent code theo từng layer, và leading word "vertical slice"
Để cụ thể hơn, Matt đưa ra một vấn đề kinh điển với agent: chúng code layer by layer. Nếu bạn giao một mảng việc lớn, chúng thường code hết toàn bộ tầng database, rồi toàn bộ schema, rồi toàn bộ API endpoint, rồi toàn bộ front end. Chúng không làm điều mà con người hay làm: tìm feedback sớm, cho một thứ nhỏ chạy được trước, rồi mở rộng ra từ đó.
Ta có thể khuyến khích agent bằng cách nói thẳng: "Đừng code từng layer. Hãy tạo một lát nhỏ trước rồi đi tiếp từ đó." Nhưng nếu thay vào đó ta dùng một leading word thì sao? Leading word ở đây là "vertical slice". Ta muốn cắt công việc thành các lát dọc thay vì các lát ngang. Vertical slice là thuật ngữ khá phổ biến trong phát triển phần mềm, nên hy vọng nó sẽ kích hoạt các "prior" của agent và agent hiểu ta muốn gì.
Matt nhấn mạnh rằng không phải skill chỉ có hai chữ "vertical slice". Điều ta làm là nén rất nhiều nghĩa vào một cụm từ khá ngắn, rồi lặp lại nó xuyên suốt skill.
Điểm hay của kỹ thuật này là bạn biết được nó có tác dụng hay không. Bạn viết "vertical slice" trong skill, rồi bạn thấy trong reasoning trace agent nói "Okay, chúng ta sẽ làm việc này như một thin vertical slice", và khi đó bạn sẽ có implementation plan tốt hơn.
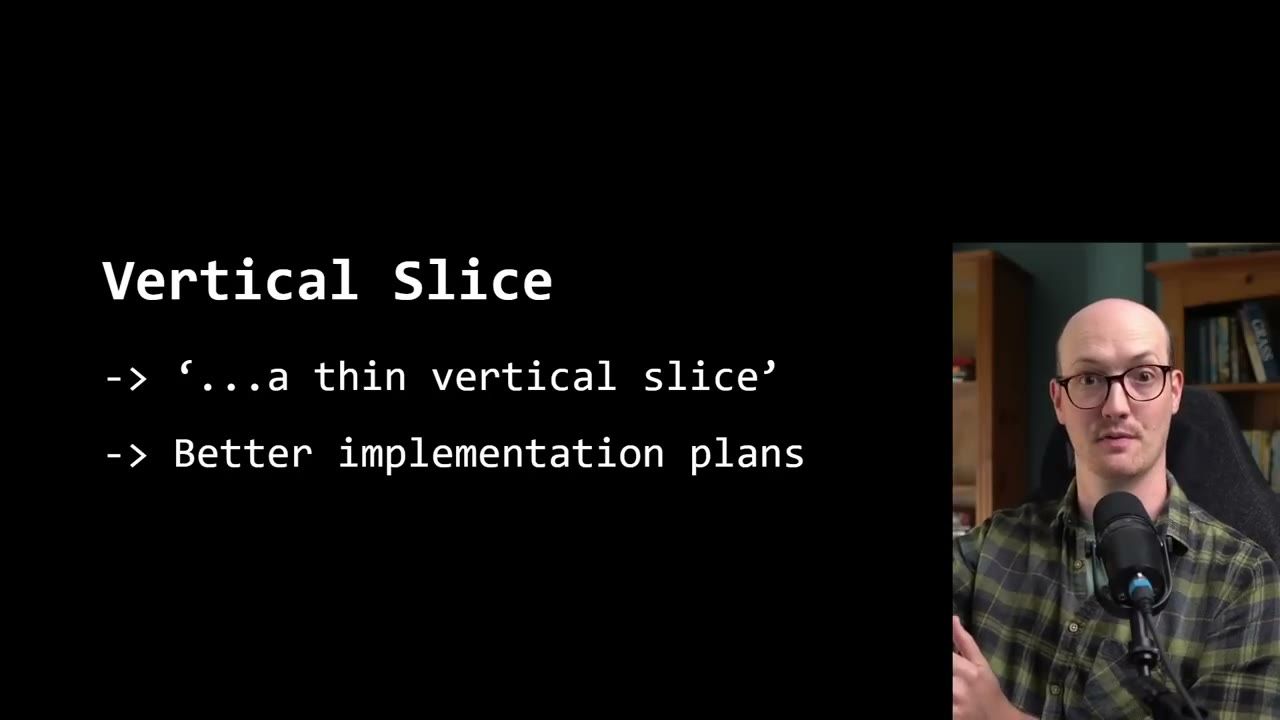
Ai được Matt giải thích kỹ thuật này cũng có kiểu phản ứng: "Ồ, tôi làm thế lâu rồi. Tôi vẫn dùng mấy cụm từ nhỏ để khuyến khích agent làm điều tôi muốn." Tất cả những gì anh đề nghị là: dùng chúng một cách nhất quán trong skill, và theo dõi thinking trace để thấy agent tiếp nhận cách làm của bạn.
Thường thì nếu agent không làm điều bạn muốn, bạn cần làm leading words nhất quán hơn, mạnh hơn, và tìm thêm những từ khác. Bởi vì, như Matt nói, tiếng Anh là một "API" khá rộng xét về số "function" bạn có thể gọi, số thứ bạn có thể thử, và có rất nhiều ứng viên leading word ngoài kia. Agent thật ra cũng khá giỏi trong việc giúp bạn nghĩ ra chúng.
13. Agent làm chưa đủ legwork: plan mode, grill-with-docs và to-prd
Một đòn bẩy nhỏ khác với agent nhắm vào failure mode số hai: đôi khi agent không làm đủ legwork, tức chưa chịu bỏ đủ công sức. Ý Matt là: giả sử ta đang ở một step, có thể là hỏi các câu làm rõ, hoặc khám phá codebase, và agent làm chưa đủ. Nó không đầu tư đủ công sức vào đúng step đó.
Một ca kinh điển, và là thứ Matt thấy ở gần như mọi nơi nó tồn tại, là plan mode. Trong plan mode có hai step: hỏi các câu làm rõ (clarifying questions), rồi tạo plan. Và điều anh thấy ở mọi bản implement plan mode anh từng thử là bước hỏi câu làm rõ không bao giờ làm đủ legwork. Agent thấy mục tiêu cuối cùng của nó là tạo plan, nên nó chỉ làm một chút legwork ở bước hỏi, hỏi bạn vài câu, rồi hăm hở đi tạo plan ngay.
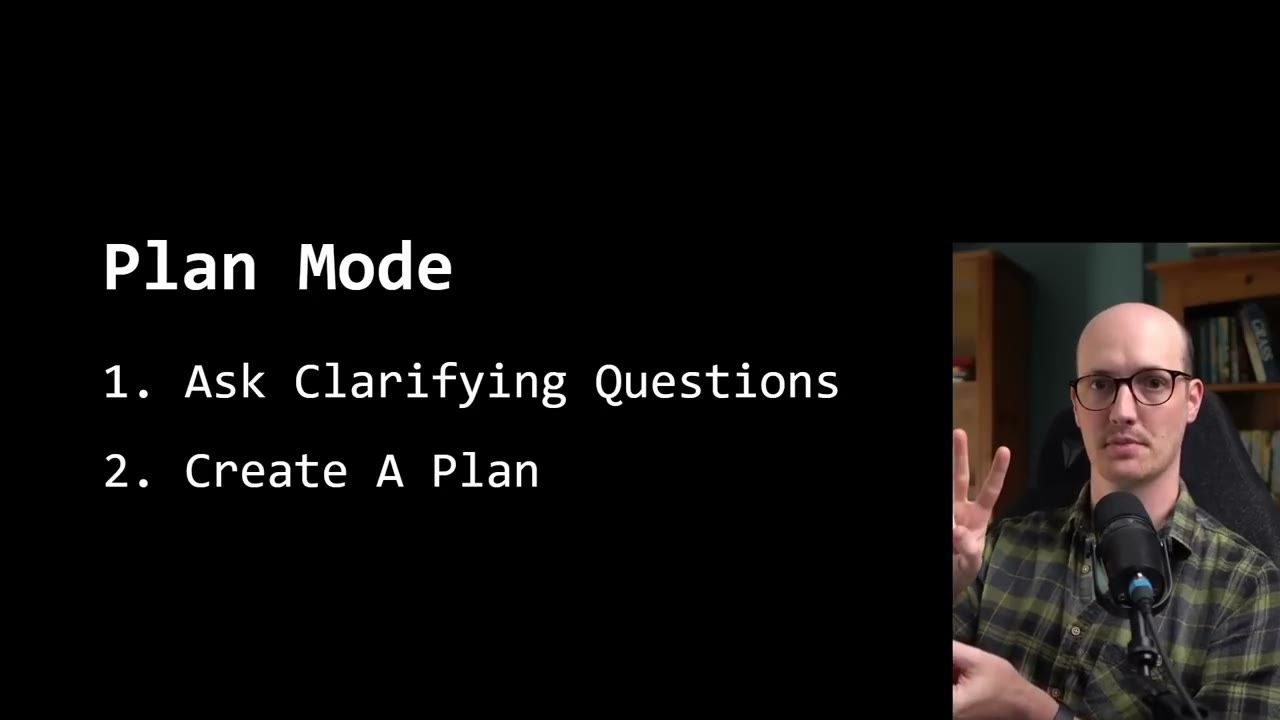
Giải pháp của Matt: thay vì dùng plan mode, anh có một skill tên Grill with Docs, về cơ bản là pha hỏi câu làm rõ của anh. Và anh tách phần lập plan ra thành một skill riêng. Giờ Grill with Docs là một skill độc lập, trong đó agent chỉ thấy đúng phần đó của quy trình. Khi Grill with Docs xong, ta mới chuyển sang To PRD. Tức là vẫn có step một và step hai, nhưng agent chỉ thấy từng step một.
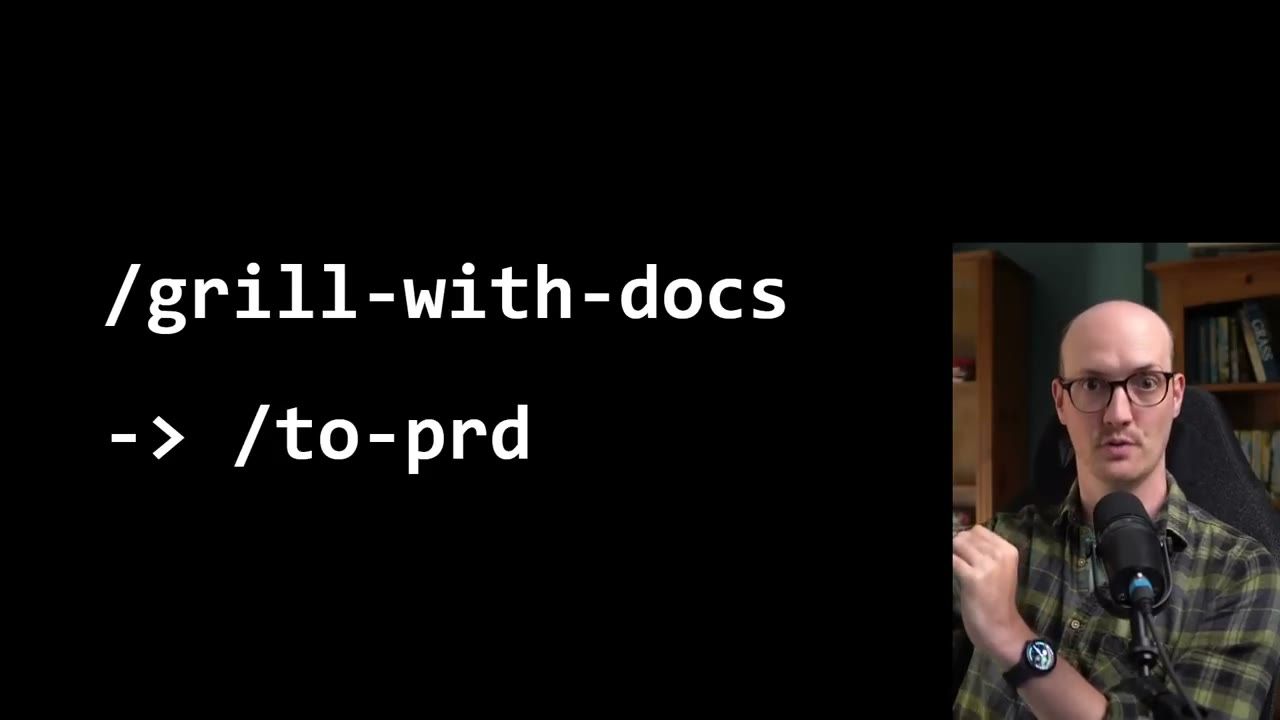
/grill-with-docs rồi mới tới /to-prd: hai pha của plan mode được tách thành hai skill riêng, chạy nối tiếp.Đây là một kỹ thuật rất hay để tăng legwork ở step hiện tại: giấu mục tiêu tương lai, giấu các step tương lai. Không phải lúc nào cũng cần tách skill thành từng step riêng, nhưng trong những ca cụ thể mà bạn thật sự muốn có thêm một khối legwork, theo Matt, không có kỹ thuật nào bằng. Nó chạy rất, rất tốt.
Đó là phần steering: dùng leading words để gói điều bạn muốn vào những token nhỏ, dùng lại được, và đảm bảo agent làm đúng lượng legwork ở mỗi step.
14. Bước 4: Pruning, massive skills, lặp lại và sediment
Giờ tới pruning. Theo Matt, pruning thật ra chỉ là một loạt failure mode bắn nhanh, những thứ bạn có thể làm sai.
Cái đầu tiên khá hiển nhiên: ta không muốn massive skills, skill khổng lồ. Skill khổng lồ thường là triệu chứng của một vấn đề khác, tức triệu chứng của một trong các failure mode còn lại.
Cái thứ nhất khá đơn giản: don't repeat yourself. Phải để ý sự trùng lặp. Nhìn chung Matt muốn mọi phần của skill có một single source of truth. Tức là nếu có một mẩu reference như template PRD, hay nhỏ hơn nữa như "test seam là gì", hãy đảm bảo bạn không lặp nó ở nhiều chỗ, hay mô tả cùng một thứ ở nhiều step tại nhiều nơi. Mỗi phần chỉ có một nguồn sự thật, và bạn không lặp lại chính mình, kể cả giữa các file reference với nhau.
Cách tiếp theo khiến skill phình to là sediment, lớp trầm tích. Sediment là chuyện kinh điển mỗi khi nhiều người cùng làm trên một bộ tài liệu: ai cũng đóng góp vào một file Markdown chung. Mọi người thêm phần của mình, không ai đủ dũng cảm xoá hay sửa phần của người khác. Và bạn kết thúc với một lớp trầm tích khổng lồ, thường là tài liệu không liên quan tới skill, đặc biệt là những thứ không được bố trí đúng chỗ.
Với một skill nhiều sediment, việc đầu tiên là nhìn lại structure. Phải đảm bảo những thứ được thêm vào có liên quan tới mọi branch. Nếu không, chuyển chúng vào đúng branch. Nếu hoàn toàn không liên quan thì có lẽ cứ bỏ đi. Còn nếu có những thứ đã hoàn toàn cũ (stale), thì "kill it dead", xoá hẳn.
15. No-ops và deletion test
Failure mode tiếp theo đặc biệt phổ biến khi chính agent viết skill cho bạn: no-ops. Đó là những thứ trong skill trông như có tác dụng nhưng thật ra không hề ảnh hưởng tới hành vi của agent trong ngữ cảnh của skill.
Ví dụ của Matt: giả sử ta có một skill implement, và có nguyên một đoạn văn bảo agent viết commit message dài và chi tiết. Chuyện gì sẽ xảy ra nếu bạn xoá đoạn đó đi? Agent có lẽ vẫn viết một commit message dài và tử tế. Vậy đoạn đó là no-op. Đó chính là deletion test: thử xoá một đoạn và hỏi hành vi của agent có đổi không. Nếu không đổi, đoạn đó không đáng để giữ.
Người ta hỏi Matt rất nhiều rằng làm sao skill của anh nhỏ được như vậy. Câu trả lời chỉ là dùng đúng những kỹ thuật này: dùng deletion test, nén mọi thứ vào leading words, không để gì không liên quan trong skill, và không để sediment.
16. Toàn bộ checklist, và lời chào
Cuối cùng Matt đi lại toàn bộ checklist một lượt:
- Trigger: kiểm tra trigger, đảm bảo skill được kích hoạt đúng lúc. Xem mình đang đặt context load lên agent hay cognitive load lên người dùng.
- Structure: nghĩ về các branch; cấu trúc skill thành steps và reference; đảm bảo phần tài liệu chỉ liên quan tới một branch nằm ngoài SKILL.md chính.
- Steering: nén văn bản thành leading words, và theo dõi chúng xuất hiện lại trong reasoning trace. Đồng thời nghĩ về legwork: có nên chẻ skill nhỏ hơn nữa để nó tập trung vào pha hiện tại bằng cách giấu pha tương lai đi không?
- Pruning: chạy một lượt tỉa cuối cùng trên toàn bộ skill, để ý sediment, để ý "crud" (rác), và đặc biệt để ý no-ops.
Cách tốt nhất để bắt đầu với framework này là dùng chính skill Writing Great Skills. Bạn có thể lấy nó từ mattpocock/skills, tải về, dùng nó để cải thiện skill của bạn, và có khi dùng nó để chạy qua một số skill do cộng đồng viết, để kiểm tra xem những skill bạn đang kéo về có thật sự tốt không.
/writing-great-skills trong repo mattpocock/skills, điểm bắt đầu để áp checklist này vào skill của bạn.Nếu muốn theo dõi những gì Matt làm, anh có một newsletter trên aihero.dev. Kế hoạch của anh cho vài tháng tới là ra mắt một AI coding crash course, một khoá nhập môn cho nhiều thứ anh vừa nói, và cách để bắt đầu làm engineering cùng AI.
Anh hy vọng những gì vừa chia sẻ đủ để giúp mọi người thoát khỏi skill hell, hoặc ít nhất là bắt đầu được hành trình gian nan ("the bitter journey") để ra khỏi đó. Matt nói anh rất tiếc vì không thể có mặt trực tiếp, cảm ơn mọi người đã xem, và hẹn gặp lại rất sớm.
Nguồn và link
- Trang talk chính thức trên ai.engineer · Video gốc
- Repo skill của Matt Pocock, nơi anh phát hành các skill nhắc tới trong talk: github.com/mattpocock/skills
- Superpowers, bộ skill được so sánh trong phần Trigger: github.com/obra/superpowers
- AI Hero, newsletter và khoá học của Matt: aihero.dev
- Leitwort, khái niệm "leading word" trong lý thuyết văn học: Leitwortstil (Wikipedia)
Related talks
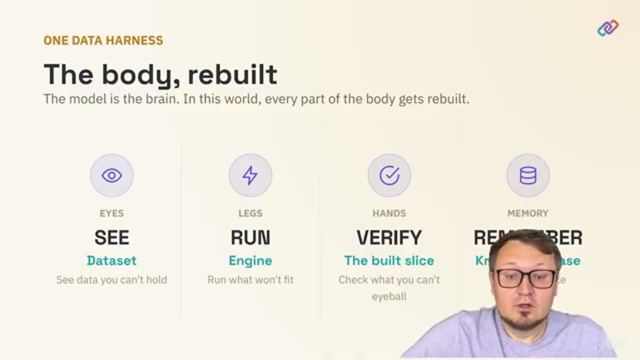
When Agents Meet Physical Data: The Other Physics of Agent Harnesses
Dmitry Petrov · DataChain · 28 min
Vì sao coding agent hỏng với video và sensor data, và cách dựng data harness bốn phần: see, run, verify, remember, với demo DataChain và Claude Code.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.