Can Oncology Workflows Run Without Human Touch?
AI Engineer World's Fair 2026: Online Track · Video gốc
Bốn agent tự động hoá prior authorization cho thuốc ung thư: deterministic check trước, bằng chứng nhiều nguồn để có confidence, reasoning layer cho ca khó.
1. RISA và bài toán prior authorization trong ung thư
Anant Shankhdhar giới thiệu mình là AI engineer tại RISA, và chủ đề của anh là tự động hoá các workflow trong ngành ung thư (oncology) từ đầu tới cuối. Ở RISA, nhóm đang tự động hoá nhiều workflow khác nhau trong oncology. Một trong số đó là prior authorization (thường gọi tắt là prior auth hay PA): xin phép trước từ công ty bảo hiểm cho các loại thuốc mà bệnh nhân ung thư cần dùng. Ở Mỹ, nhiều thuốc điều trị ung thư đắt tiền chỉ được bảo hiểm chi trả khi phía bệnh viện đã nộp hồ sơ và được bên trả tiền (payer) chấp thuận trước.
Trước khi đi sâu, anh dành một chút thời gian để cho mọi người hình dung toàn bộ workflow này trông như thế nào, vì phần còn lại của talk sẽ lần lượt đi qua từng bước của nó.
2. Vòng đời một order prior auth
Bước thứ nhất là intake: nhận các order (y lệnh dùng thuốc) đổ về mỗi ngày. Bước thứ hai là kiểm tra xem bệnh nhân có thực sự đủ điều kiện được nhận thuốc hay không, dựa trên mức quyền lợi bảo hiểm mà họ đang có. Bước này gọi là eligibility and benefits verification, viết tắt EV hoặc BV.
Bước tiếp theo là xác định xem trong số các thuốc của bệnh nhân, thuốc nào cần authorization. Mỗi thuốc sẽ rơi vào một trong các pathway sau:
- NAR, tức no auth required: thuốc này không cần xin phép gì cả.
- Auth on file: thuốc đã được cấp phép từ trước, cho một khoảng thời gian nào đó, nên giấy phép đang còn hiệu lực trong hồ sơ.
- Auth required: thuốc cần được xin phép, nghĩa là phải làm và nộp hồ sơ authorization cho thuốc này.
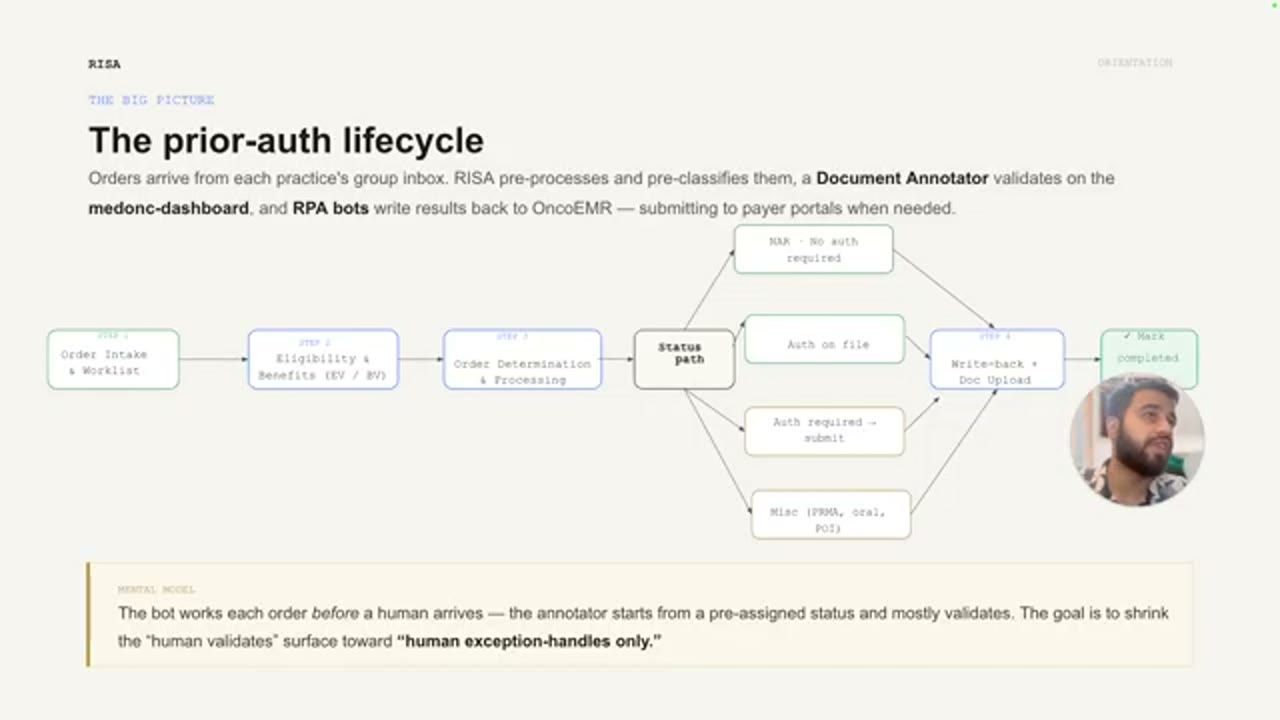
Đó là workflow. Điểm mấu chốt nằm ở chỗ: dù các bot của RISA đã chạy và tự làm những bước này, cuối cùng vẫn cần một người review trước khi nộp các order đó đi.
3. Nhiệm vụ: no touch, và bốn agent
Anant được giao một bài toán cụ thể: chạy một phần các order này đi thẳng tới bước nộp hồ sơ mà không cần bất kỳ người nào chạm vào. Muốn vậy, anh phải xác định được một cách tự tin những order nào có thể đi tiếp mà không cần người kiểm, rồi build toàn bộ luồng xử lý cho chính những order đó. Vì thế confidence là metric then chốt mà cả nhóm nhắm tới: không phải "làm được bao nhiêu" mà là "chắc chắn tới đâu để dám bỏ người ra khỏi vòng".
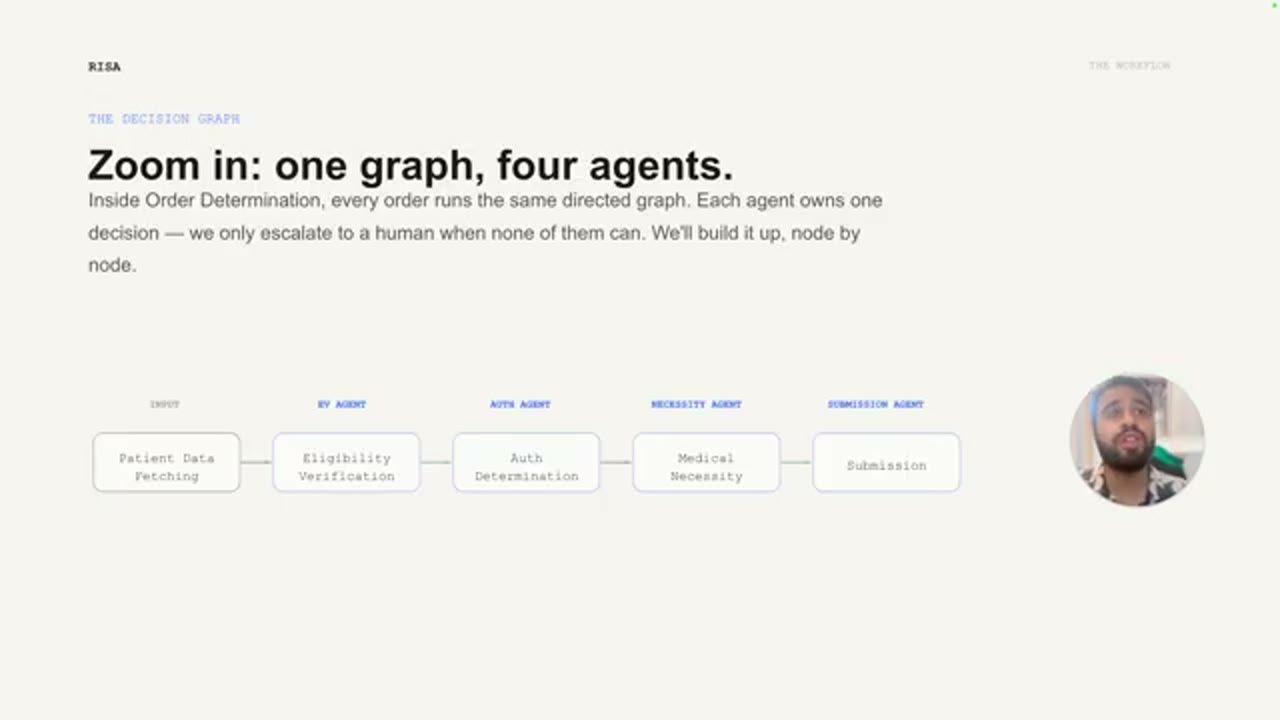
Cách nhóm làm là dùng bốn agent:
- EV agent lo eligibility and benefits verification: lấy dữ liệu bệnh nhân và quyết định xem có ổn để đi tiếp hay không.
- Auth agent xác định trạng thái của từng thuốc: có cần authorization hay không.
- Necessity agent là "bộ não lâm sàng" của hệ thống. Với những ca cần authorization, nó đánh giá xem thuốc đó có đúng cho bệnh nhân hay không, dựa trên các chỉ số sinh tồn và tình trạng của người bệnh.
- Cuối cùng là submission agent, phụ trách bước nộp hồ sơ.
4. EV agent: dữ liệu bảo hiểm nằm rải rác khắp nơi
Bắt đầu với bước đầu tiên: làm sao làm được việc này mà không có human in the loop? Vấn đề đầu tiên là thông tin bảo hiểm, giấy tờ bảo hiểm, mọi thứ đều nằm rải rác trên hàng chục portal, API và tài liệu khác nhau, và rất khó tìm được chúng ở một chỗ. Muốn khởi động pipeline, nhóm cần lấy thông tin từ cả portal lẫn API.
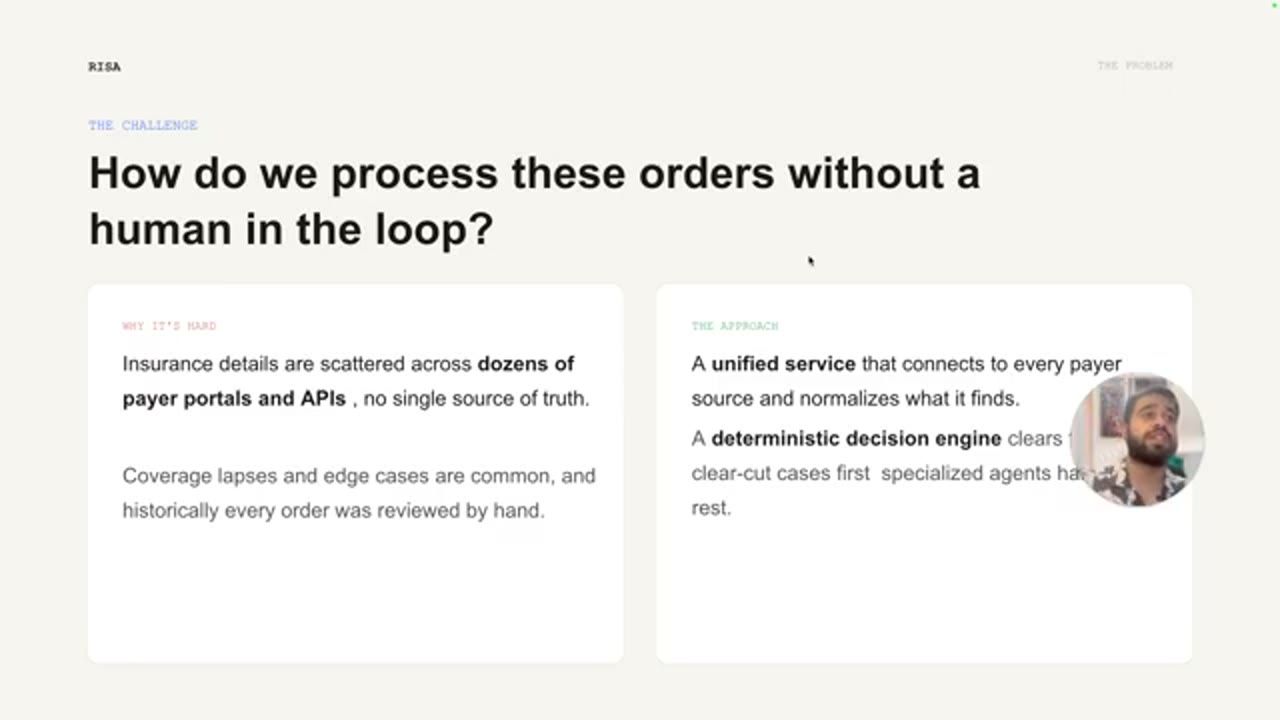
Để làm được, nhóm build một unified service kết nối tới các nguồn khác nhau của payer và trả kết quả ở một định dạng chuẩn hoá, thống nhất, để các bước sau dùng tiếp. Nhóm cũng thêm một deterministic decision engine để flag những ca không thể đi tiếp. Nhờ vậy, một phần các order đã được giải quyết một cách deterministic, không cần ai nhúng tay.
5. Coverage orchestrator, API path và RPA path
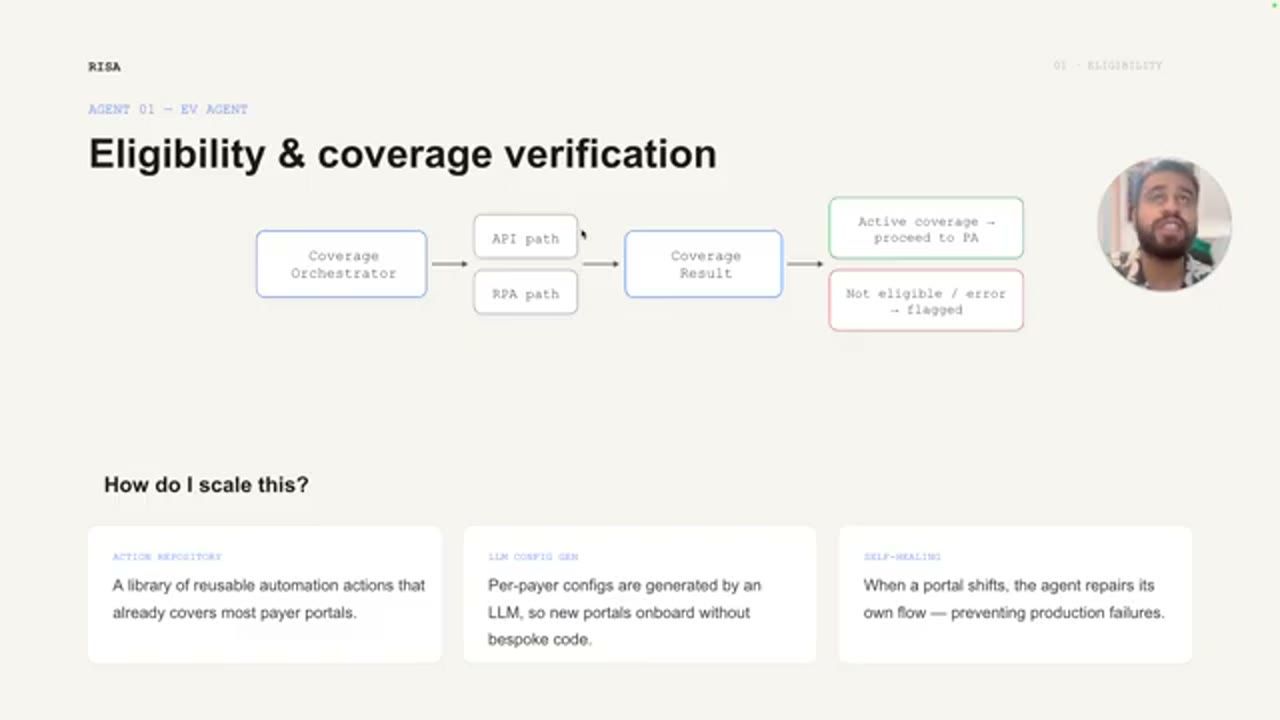
Cách nó vận hành: có một coverage orchestrator quyết định bệnh nhân này sẽ đi đường API hay đường RPA. RPA (robotic process automation) ở đây chính là phần automation: bot tự thao tác trên portal của payer như một người dùng. Hệ thống thực hiện các thao tác RPA hoặc gọi API, rồi nhận output ở một định dạng cố định gọi là coverage result. Kết quả này được đưa vào deterministic engine để xác định coverage còn active hay không. Nếu còn, order đi tiếp trong chuỗi; nếu không, dừng ngay tại đó.
6. Scale RPA bằng action repository, LLM config và self-healing
Một trong những vấn đề nhóm gặp ở bước này: nếu build theo kiểu truyền thống thì phải làm custom integration cho từng loại portal khác nhau, và đó không phải một quy trình scale được. Cách nhóm giải quyết là đưa LLM vào vòng lặp, theo ba lớp:
- Trước hết, nhóm làm một repository rất lớn gồm các custom action cùng những action phổ biến cần dùng khi build RPA.
- Rồi nhóm build cơ chế config generation dựa trên LLM: LLM thực hiện các action này và dựng ra config để một portal cụ thể chạy được. Việc này giảm thời gian phát triển đáng kể.
- Cuối cùng, các automation kiểu này rất mong manh, có thể vỡ ngay trong lúc chạy. Vì vậy nhóm có một self-healing loop: nó phát hiện những ca bị vỡ ngay trong giờ production rồi tự khắc phục, nhờ đó ngăn được các lỗi xảy ra.
Đó là bước thứ nhất. Xong bước này, order đi tiếp sang phần sau của chuỗi.
7. Node thứ nhất của graph: verify eligibility
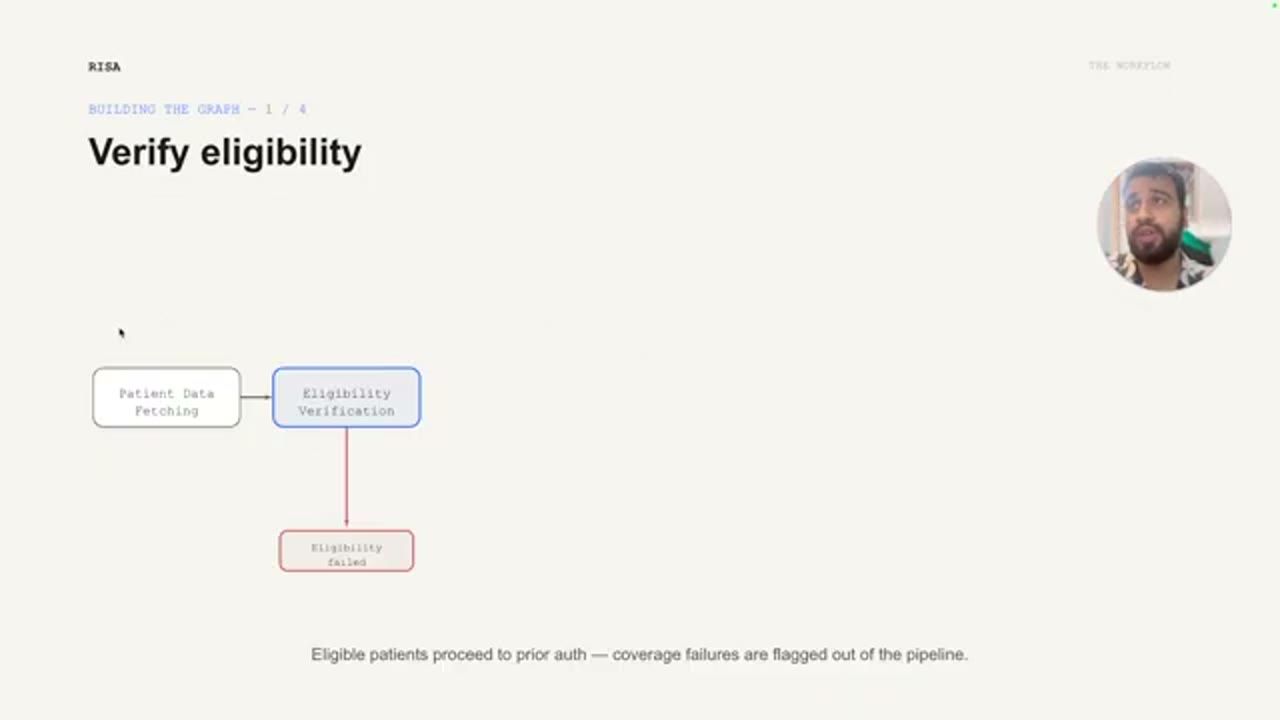
Quay lại sơ đồ graph: dữ liệu bệnh nhân được lấy về, rồi hệ thống thực hiện eligibility verification và xem kết quả có ổn hay không. Nếu fail, dừng ở đó; nếu không, đi tiếp.
8. Auth agent: thuốc nào thật sự cần authorization
Bước tiếp theo là xác định thuốc nào cần authorization. Khi nghĩ về chuyện bỏ người ra khỏi vòng lặp, Anant nhận thấy một ca đơn giản: nếu một thuốc đã được cấp phép rồi (auth on file), hoặc thuốc không cần cấp phép (NAR), thì có thể giải quyết được một phần của order. Tức là phần đó của order không cần con người giám sát nữa.
Bước đầu, nhóm build một pipeline LLM extraction đơn giản: nhận ghi chú của bệnh nhân (patient notes), cho LLM trích xuất, rồi phân loại các thuốc vào ba nhóm trên, với mặc định là auth required. Nhóm nghĩ cách này sẽ chạy được, nhưng rồi lại gặp vấn đề.
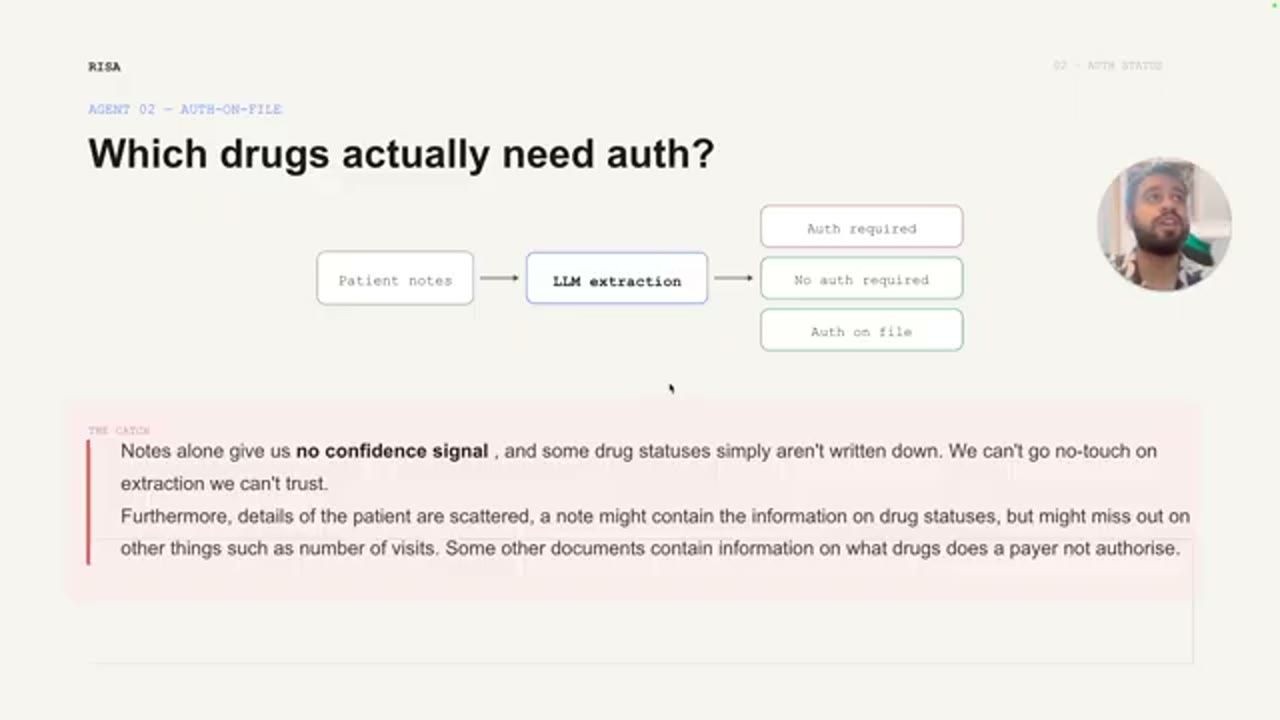
Vấn đề phổ biến thứ nhất: các note đang dùng không đủ dữ liệu, nên pipeline mắc một số lỗi. Thứ hai, LLM extraction về bản chất là một quá trình non-deterministic, nghĩa là output ra từ đây không thể tin một cách mù quáng. Vẫn cần một người review hết. Cách này có thể tăng hiệu suất, nhưng không loại được con người ra khỏi vòng.
9. Confidence đến từ việc kết hợp nhiều nguồn bằng chứng
Nhóm tự hỏi: nếu thêm bằng chứng thì sao? Nếu LLM nói một thuốc là no auth required, mà mình có thông tin khác đứng sau xác nhận điều đó, thì mình có thể nói điều đó một cách tự tin. Tương tự với các ca auth on file. Để làm vậy, nhóm tận dụng thêm hai nguồn dữ liệu.
Nguồn thứ nhất là authorization letters, tức thông tin từ trước. Qua các lần điều trị trước của một bệnh nhân, có sẵn những thư cấp phép cho thấy các thuốc này đã thực sự được authorize. Giờ đây, thay vì chỉ có một nguồn, nhóm có hai nguồn cùng cho một thông tin; và ở chỗ nào hai nguồn khớp nhau, có thể khẳng định với confidence rằng thuốc này đã được cấp phép.
Nguồn thứ hai dành cho ca NAR, no auth required. Ở đây nhóm tìm được những nguồn khác: từ portal hoặc từ một số tài liệu, có thể biết theo từng tháng những thuốc nào mà payer, tức công ty bảo hiểm, không áp yêu cầu authorization. Nhóm dùng thông tin đó để build một payer rule knowledge base, về cơ bản là một cơ sở dữ liệu SQL, được dựng từ các lần kiểm tra portal cùng với LLM extraction.
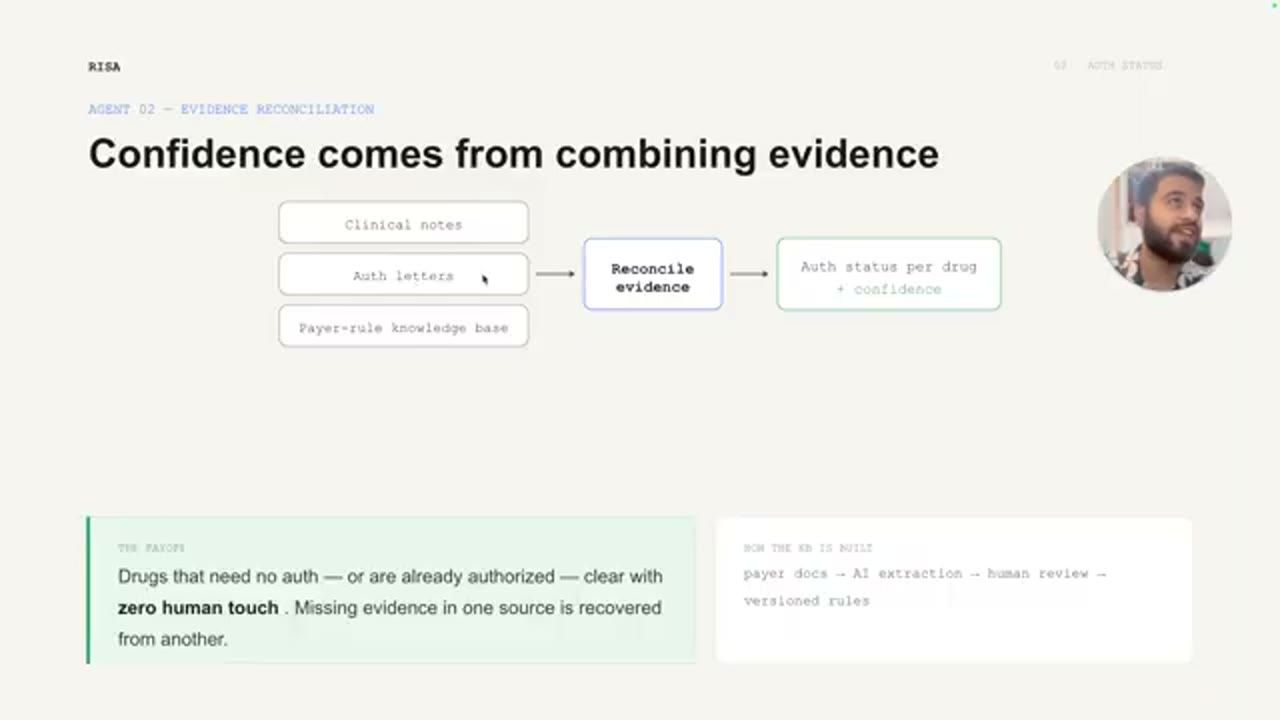
Dùng tất cả những thông tin này, hệ thống reconcile bằng chứng và trích xuất auth status với confidence cao hơn. Nếu pipeline kết luận một thuốc không cần authorization hoặc đã được cấp phép, thì kết luận đó có bằng chứng vững đứng sau và confidence cao hơn. Và tất nhiên mọi thứ đều configurable: nếu có sự cố gì xảy ra, nhóm luôn có thể "rút phích" những ca đó.
Một điều tốt nữa đến từ đây: nhóm nhận ra có những order có thể loại bỏ hoàn toàn nhờ hai loại thuốc này. Có order thực ra không cần authorization chút nào, vì mọi thuốc trong đó hoặc không cần cấp phép, hoặc đã được cấp phép từ trước. Điều này cho phép đạt no touch trên trọn một tập order.
10. Payer rule knowledge base được xây thế nào
Anant dành một slide cho cái nhìn tổng quan ngắn về cách nhóm xây payer rule knowledge base phục vụ các ca NAR. Có ba nguồn đổ vào:
- Tài liệu của payer chứa thông tin này theo từng khoảng thời gian. Nhóm build một bước LLM extraction có thể cấu hình được, nên cấu hình cho nhiều loại tài liệu khác nhau, trích xuất ra ràng buộc theo từng thuốc: với payer này, thuốc này sẽ được đối xử như thế nào trong một khoảng thời gian.
- Thông tin lịch sử: nhóm biết một tổ chức nhất định xử lý một thuốc nhất định theo một cách nhất định, nên lưu lại thông tin đó và dùng nó.
- Kiểm tra portal định kỳ để lấy thêm thông tin này.
11. Node thứ hai: determine auth status, và những order biến mất
Bước này đẩy kim đồng hồ đi thêm được một đoạn. Giờ đây, ngoài eligibility verification ban đầu, hệ thống có thêm những bước kiểm tra deterministic này. Những gì không verify được đã bị flag từ trước, còn những gì đi tiếp thì được xác định trạng thái cho từng thuốc, và nhờ đó một số order được loại hẳn ra khỏi hàng đợi cần người xử lý.
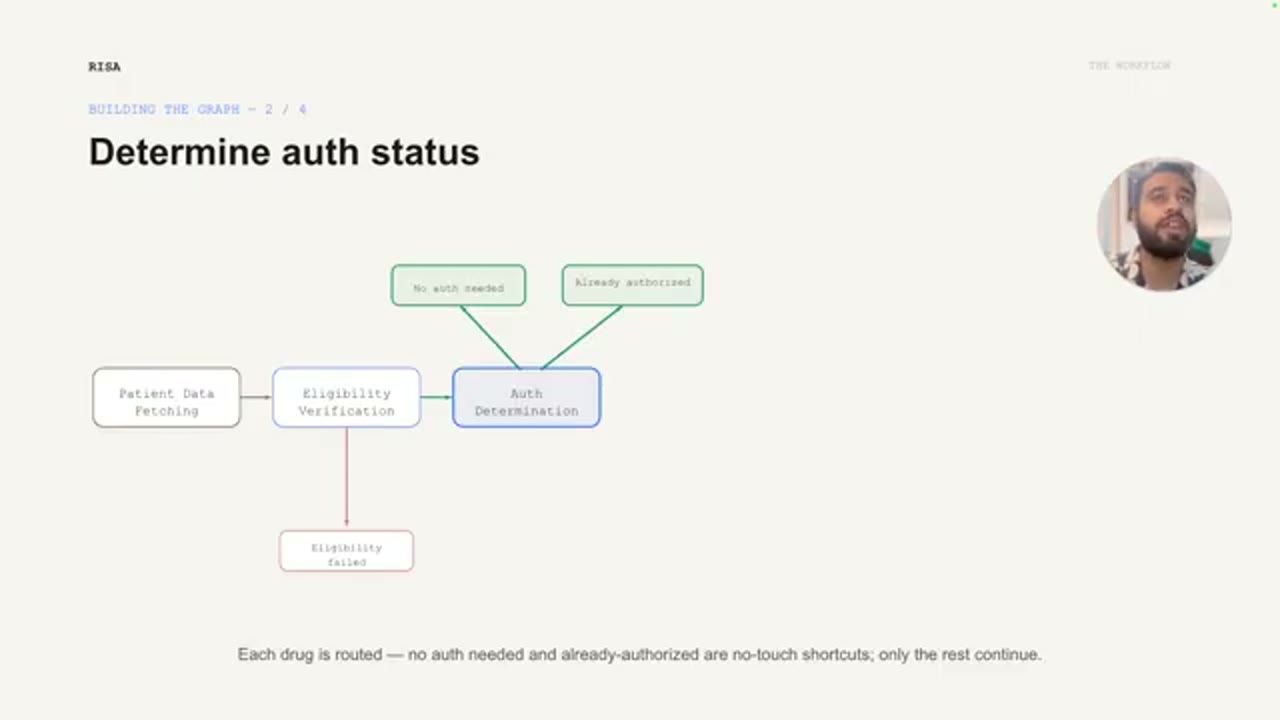
Đã xử lý xong hai loại thuốc, giờ đi tiếp sang loại thứ ba.
12. Những quyết định cần clinical reasoning
Vấn đề tiếp theo nhóm gặp: có những quyết định thực sự cần suy luận lâm sàng (clinical reasoning). Cho tới đây, những thuốc được chuyển sang no touch đều là thuốc mà thông tin có sẵn trực tiếp, hoặc có gián tiếp qua một nguồn khác. Nhóm không cần làm bất kỳ kiểu reasoning hay hỏi đáp nào cho chúng.
Nhưng với những thuốc thực sự auth required, nhóm cần kiểm tra xem bệnh nhân có thật sự đủ điều kiện dùng thuốc đó hay không, và còn phải đưa ra bằng chứng hỗ trợ: thông tin đó lấy từ đâu mà ra.
13. Medical necessity agent: reasoning layer cho long tail
Để làm việc này, nhóm build agent thứ ba: medical necessity agent. Agent này trả lời cả câu hỏi lâm sàng đơn giản lẫn phức tạp cho từng bệnh nhân, và gắn một confidence score cho mọi câu trả lời. Nhờ vậy, nhóm chỉ escalate những ca thực sự cần tới một bác sĩ lâm sàng. Nhóm đã làm khá nhiều việc trong mảng này, và có cả một bài báo khoa học về nó, được dẫn ngay trên slide.
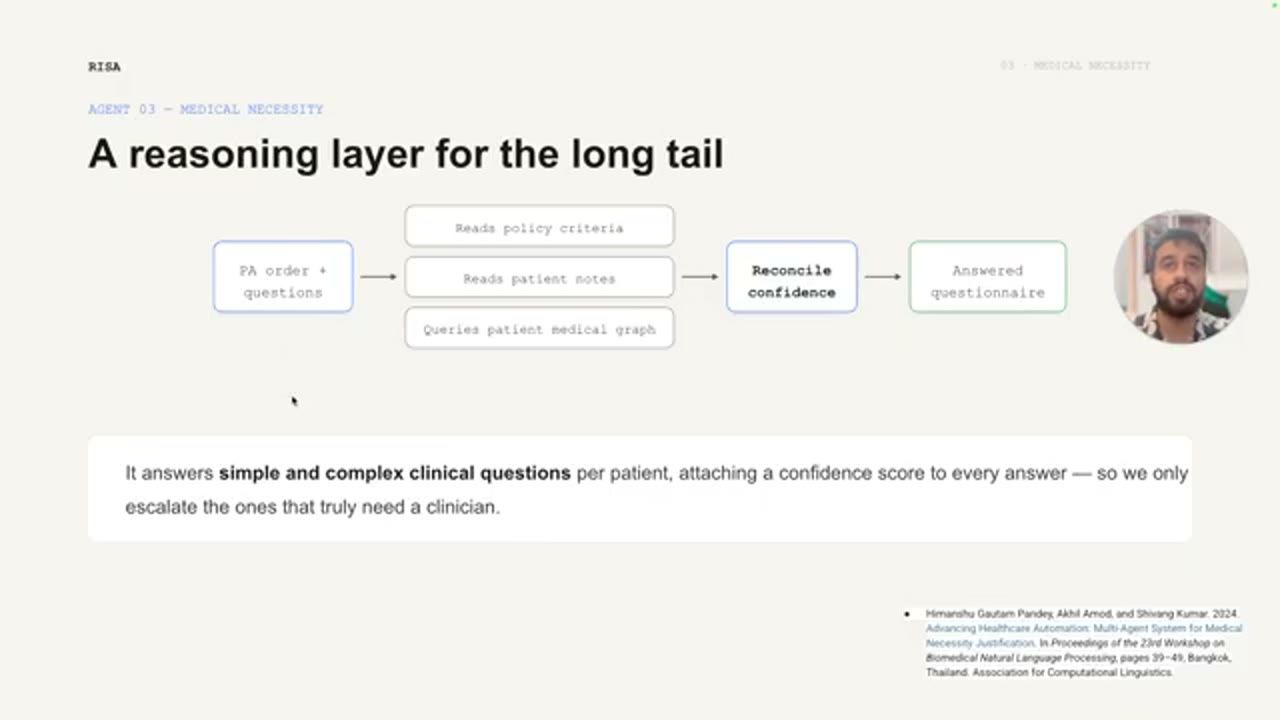
Agent này hoạt động như sau. Có một order mới, và với mỗi order, agent đọc ba thứ:
- Patient notes, ghi chú của bệnh nhân.
- Policy criteria: các tiêu chí phải thoả mãn thì thuốc này mới được xử lý tiếp.
- Từ các tiêu chí đó, agent query patient medical graph, một graph các biomarker đã được trích xuất cho từng bệnh nhân. Từ graph này, agent xác định những biomarker nào đang có và tình trạng của bệnh nhân ra sao.
Rồi agent đưa toàn bộ thông tin này cho một LLM để nhận về một bảng câu hỏi đã được trả lời (answered questionnaire), kèm mọi dữ kiện ủng hộ và mọi dữ kiện mâu thuẫn. Nếu có đủ thông tin liên quan, hoặc xác định được với confidence cao, ca đó đi tiếp. Với những ca không đủ thông tin, nhóm giữ lại để escalate lên người.
Phần mô tả video do RISA viết nói thêm về cách agent này làm việc: nó tách các guideline phức tạp thành những tiêu chí yes/no đơn giản, đánh giá song song từng tiêu chí trên dữ liệu bệnh nhân, rồi tổng hợp kết quả; confidence score quyết định ca đó tự đi tiếp hay cần bác sĩ review. Bài báo được dẫn là "Advancing Healthcare Automation: Multi-Agent System for Medical Necessity Justification" (BioNLP 2024).
14. Node thứ ba: evaluate medical necessity
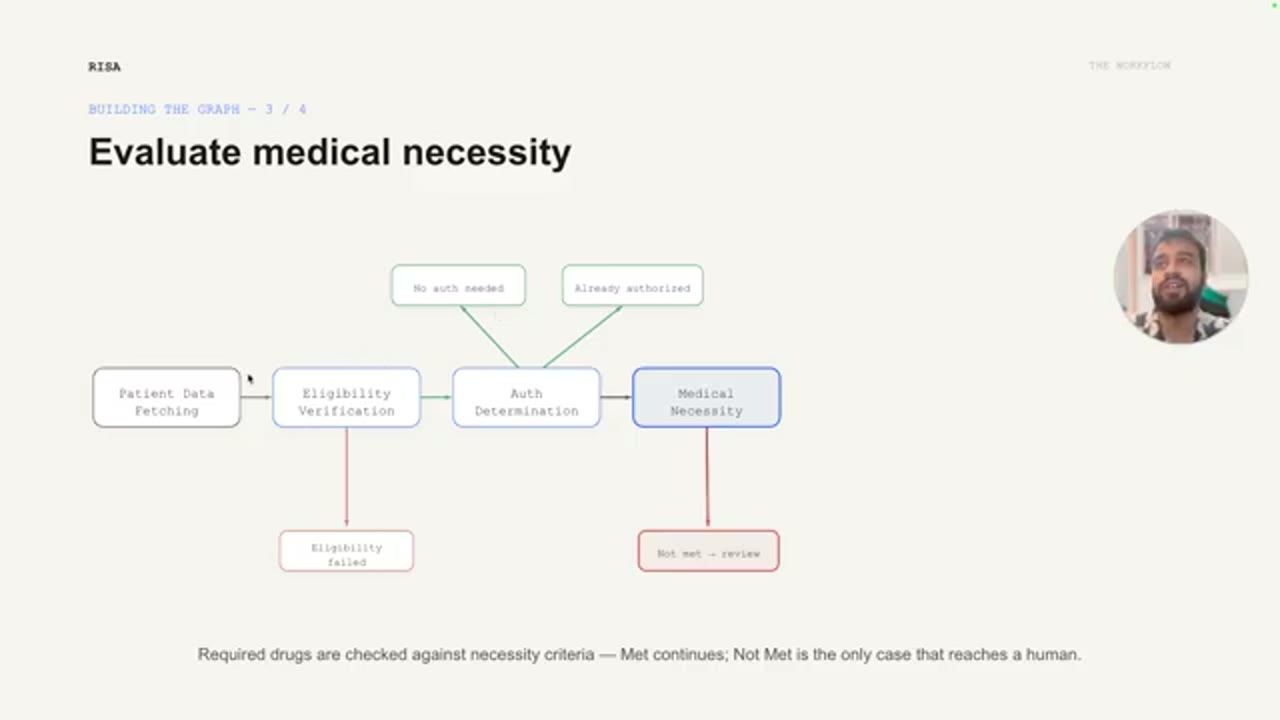
Đó là bước kế tiếp. Nhìn lại cả quãng đường tới đây: bắt đầu từ bước lấy dữ liệu bệnh nhân, làm eligibility verification, flag những order không đủ điều kiện và cho phần còn lại đi tiếp. Rồi trích xuất những thuốc không cần auth và những thuốc đã có thư cấp phép, tách ra những ca có thể đi tiếp mà không cần người can thiệp. Sau đó mới tới bước đánh giá medical necessity. Những ca nào không đạt (not met) cũng được chuyển sang review.
15. Submission agent và toàn bộ graph
Cuối cùng, hệ thống gom toàn bộ thông tin này lại và nộp ngược về cho các payer. Đây là chỗ submission agent vào cuộc. Submission agent khá giống EV agent: nhóm có integration tuỳ biến cho từng payer đang làm việc, được build bằng config do LLM sinh ra cùng với repository các tool đã nói ở trên.
Ghép lại, đây là toàn bộ graph nhóm có được sau cả hành trình. Phần màu xanh là những ca đi trọn mà không có human touch: eligibility verification pass, rồi hoặc là đã tìm đủ thông tin để thuốc không phải đi qua bước đánh giá medical necessity, hoặc là đi qua medical necessity evaluation, rồi tới submission.
Phần mô tả video do RISA viết cho thêm vài chi tiết về submission agent: hơn 100 browser chạy song song trên Kubernetes, mỗi cái điền form và nộp yêu cầu trên portal của các công ty bảo hiểm; với những portal hỏi câu hỏi lâm sàng ngay trong lúc nộp, agent gọi medical reasoning agent theo thời gian thực để sinh câu trả lời. Ở công suất tối đa, hệ thống xử lý hàng nghìn hồ sơ mỗi giờ.
16. Mỗi agent đứng được một mình
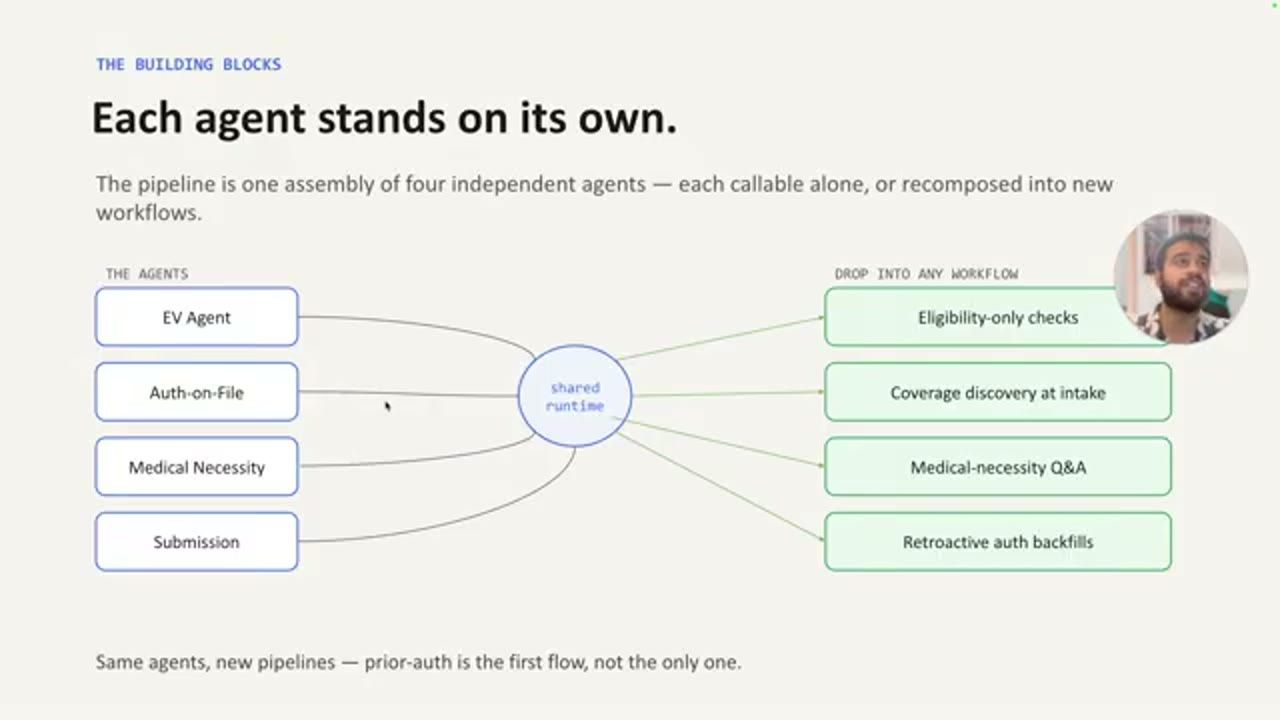
Anant muốn nhắc thêm một điều: dù ban đầu được build cho đúng ca prior auth này, các agent hiện đang được dùng trên nhiều workflow khác. Nhóm đã mở rộng chức năng thành dạng tổng quát hơn, ví dụ medical necessity agent giờ có thể trả lời câu hỏi đặc thù cho bất kỳ loại workflow nào liên quan tới bệnh nhân. Các agent khác cũng tương tự.
17. Kết luận: no touch trên phần ngày càng lớn của mỗi order
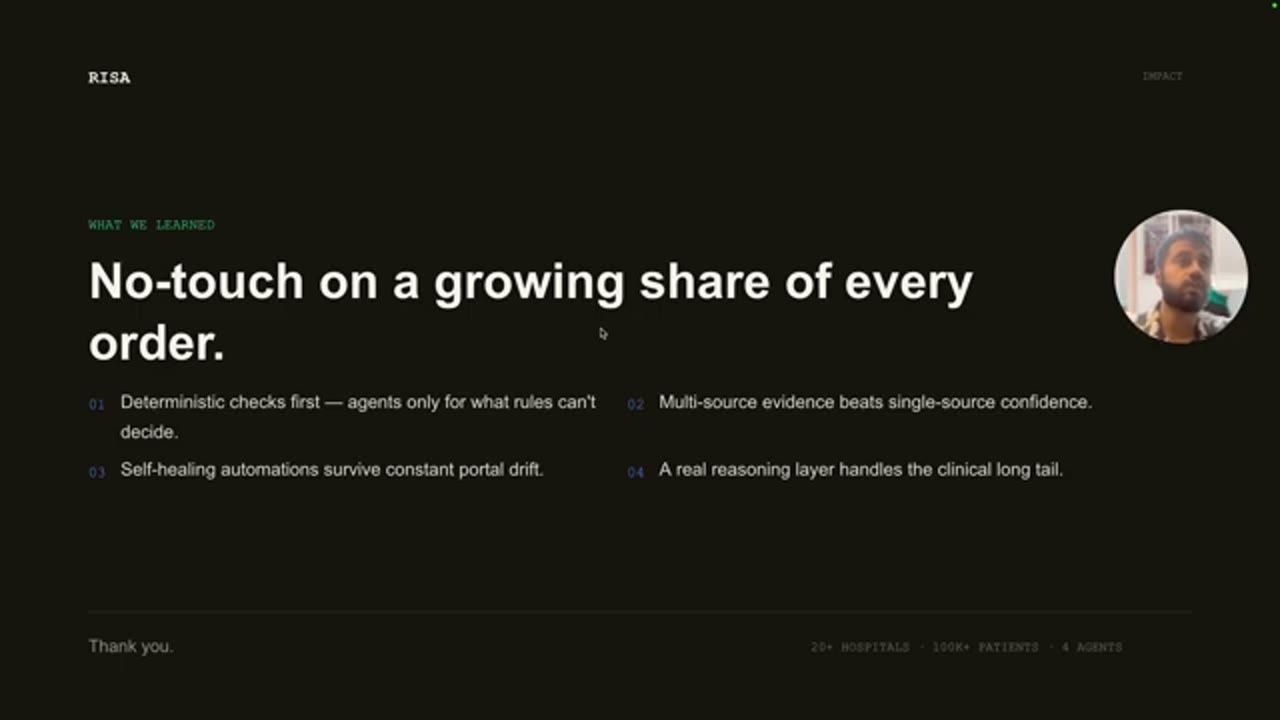
Kết lại, Anant nói phần no touch đang lớn dần trên mỗi order. Bốn bài học:
- Nhóm bắt đầu bằng deterministic check, và chỉ dùng agent cho những gì rule không quyết được.
- Nhóm dùng bằng chứng từ nhiều nguồn để thắng cách dựa vào một nguồn duy nhất, nhờ đó thêm confidence cho các ca.
- Nhóm thêm self-healing để scale được các RPA.
- Và cuối cùng thêm một reasoning layer để xử lý những ca thật sự cần authorization.
Anant cảm ơn mọi người đã dành thời gian, và chào tạm biệt.
Nguồn và liên kết
- Trang talk trên ai.engineer · Video gốc
- RISA Labs · RISA API Hub: tổng quan các workflow API của RISA, có tài liệu và sandbox
- Advancing Healthcare Automation: Multi-Agent System for Medical Necessity Justification: Himanshu Gautam Pandey, Akhil Amod, Shivang Kumar, BioNLP Workshop 2024
- UnitedHealthcare 2026 Administrative Guide: ví dụ một tài liệu payer mô tả yêu cầu authorization, thời hạn hiệu lực và điều kiện chi trả
- GitHub của Anant Shankhdhar · LinkedIn: linkedin.com/in/anantshankhdhar
Related talks
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
Agents in Production: How OpenGov Built and Scaled OG Assist
Gabe De Mesa · OpenGov · 19 min
OpenGov chạy OG Assist trong production: agent loop Effect-native thay LangGraph, A2A, evals, human approval, sandbox, rolling summary và tracing.