Claude Code skill từ nguyên lý gốc
Skill là gì từ gốc, các lever frontmatter ít ai dùng, và mổ xẻ một skill audit skill đẩy mọi việc cơ học vào script, để agent chỉ làm phần phán đoán.
✓ Đã duyệt độc lập · cập nhật 18/10/2026 · 16 min
1. Skill là phần đơn giản nhất của Claude Code
Roman mở video bằng một nhận xét: từ khi ra đời, skill đã là tính năng được yêu thích nhất của Claude Code, và ai cũng nói về nó như một kiểu ảo thuật. Nhưng theo anh, skill là phần đơn giản nhất của Claude Code, không có gì đơn giản hơn. Nó chỉ là một file markdown được dán vào context. Và chính vì đơn giản như vậy nên gần như ai cũng dùng nó chưa tới. Phần lớn mọi người dừng lại ở việc đầu tiên skill làm được, tức là lưu một prompt, rồi không bao giờ đụng tới những "lever" (cần gạt) biến skill thành một thứ linh hoạt hơn nhiều.
Trong video, anh hứa sẽ định nghĩa chính xác skill là gì từ những nguyên lý gốc (first principles), cho xem kiến trúc bên dưới, và chỉ cách build skill hiệu quả. Xem hết, người xem sẽ hiểu và tự tạo được những skill rẻ hơn, nhanh hơn, ổn định hơn, làm được bất kỳ loại knowledge work nào họ chọn.
Anh tự giới thiệu: anh là Roman, từng công bố một bài báo thuộc nhóm top 3% tại NeurIPS, hội nghị AI lớn nhất thế giới. Bây giờ anh đang theo đuổi một sứ mệnh: đẩy coding agent tới giới hạn tuyệt đối của chúng.
2. Định nghĩa skill và user invocation qua slash command
Roman nhắc lại định nghĩa: skill là một file markdown mà người dùng hoặc chính agent có thể dán vào context của agent. Skill được kích hoạt theo hai cách: model invocation (model tự gọi) và user invocation (người dùng gọi).
Cách đơn giản nhất là user invocation. Hãy tưởng tượng bạn muốn lưu một prompt và bơm nó vào LLM mỗi khi gõ một lệnh nhất định, ví dụ /analyze. Ngay khi bạn gõ lệnh đó, prompt đã lưu được dán thẳng vào context window của Claude Code, kèm theo bất kỳ phần prompt nào bạn viết thêm sau slash command. Anh nói: rất đơn giản.
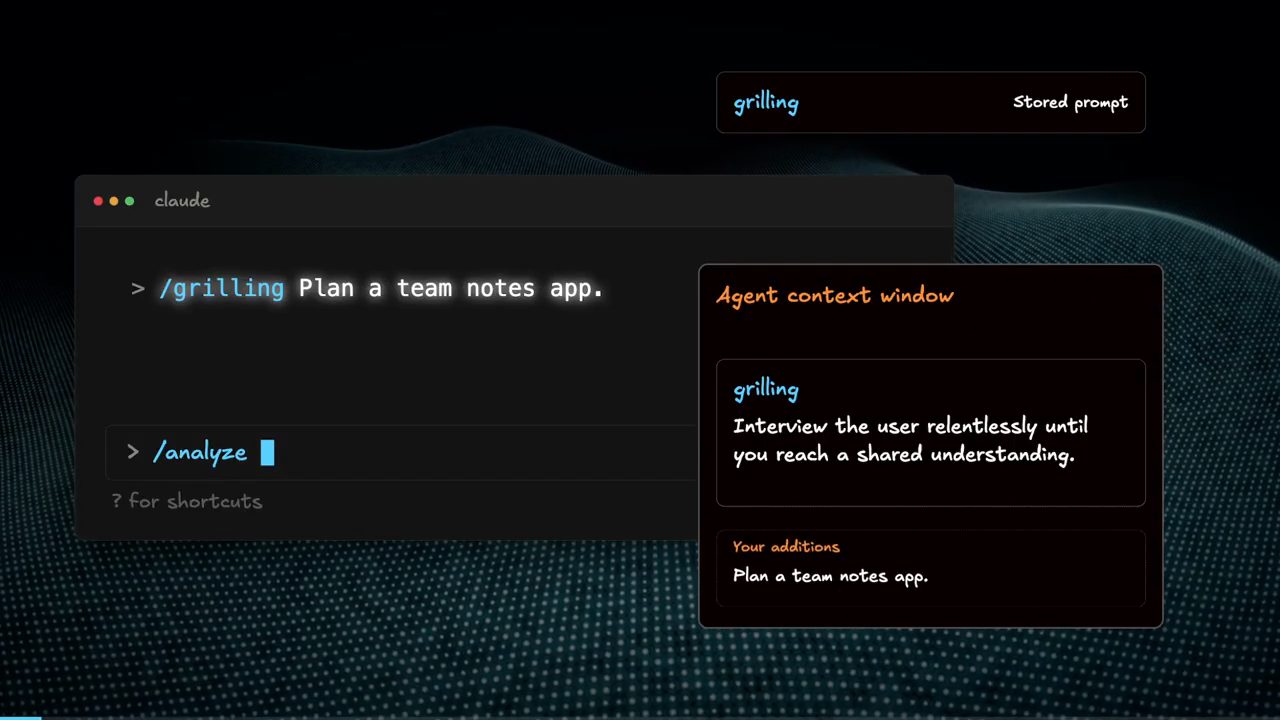
/grilling Plan a team notes app. thì prompt đã lưu ("Interview the user relentlessly until you reach a shared understanding.") vào context window của agent, và phần gõ thêm ("Plan a team notes app.") nằm ngay sau nó dưới nhãn "Your additions".3. Model invocation và progressive disclosure
Kiểu thứ hai là model invocation. Giả sử ta muốn chính model quyết định khi nào nên nạp một skill vào context của nó. Muốn vậy, model phải biết là nó có thể làm việc đó, biết rằng khả năng đó tồn tại. Nên ngay đầu mỗi session, Claude Code dán vào một dòng "headline" ngắn: skill này là gì và khi nào nên gọi tới nó để được bơm vào. Ta nói điều đó cho LLM để nó có thể tự chọn.
Headline này luôn nằm trong context, còn phần thân (body) của skill chỉ được nạp khi model thật sự với tới nó. Đó là cái gọi là progressive disclosure (tiết lộ dần).
Nhưng đây là con dao hai lưỡi. Càng xếp chồng nhiều skill cho phép model tự gọi trong setup của bạn, những headline luôn bật này càng gây xao nhãng cho model. Vì thế trong phần lớn skill của mình, Roman tắt model invocation, để headline không được nạp vào context chút nào.
Và thế là xong: skill đơn giản đúng nghĩa đen như vậy. Bạn lưu một prompt trong file markdown, rồi hoặc bơm nó vào bằng slash command, hoặc gợi ý cho model biết nó tồn tại và để model tự quyết khi nào bơm vào chính mình.
4. Giá trị nằm ở thứ bạn đặt vào skill
Nếu cơ chế đơn giản tới vậy, thì giá trị không nằm ở cơ chế. Giá trị nằm ở thứ bạn đặt vào chính skill. Theo Roman, skill toả sáng khi nó mang thứ kiến thức chỉ tồn tại trong đầu bạn hoặc trong team bạn: codebase của bạn deploy ra sao, client của bạn cần gì, cách riêng bạn thích làm việc. Không một skill "một cỡ vừa cho tất cả" nào lấy từ GitHub có được những thứ đó. Nên toàn bộ cuộc chơi là biết cách build skill của riêng bạn, cho bạn và cho team bạn.
5. Skill là một folder, không chỉ một file
Roman thêm một chút sắc thái về skill thật ra là gì. Một skill không nhất thiết chỉ là một file. Nó là một folder, và folder đó là cả đơn vị bạn chia sẻ. Bạn có thể đặt script ngay cạnh file markdown, tham chiếu tới chúng trong skill qua một biến, và Claude Code thay biến đó bằng vị trí thật của folder trước khi model đọc dòng đó. Nhờ vậy ta mang theo và tham chiếu script được bất kể skill đang chạy trên máy của ai. Đó là thứ làm skill mạnh tới vậy với team nội bộ.
Không có cơ chế đó, chia sẻ một skill sẽ đồng nghĩa với chia sẻ một folder cộng một đoạn hướng dẫn setup, và mỗi lần gọi script lại hiện một pop-up. Có nó, bạn commit folder vào .claude/skills trong repo, và mọi đồng đội có trọn workflow ngay khi clone.
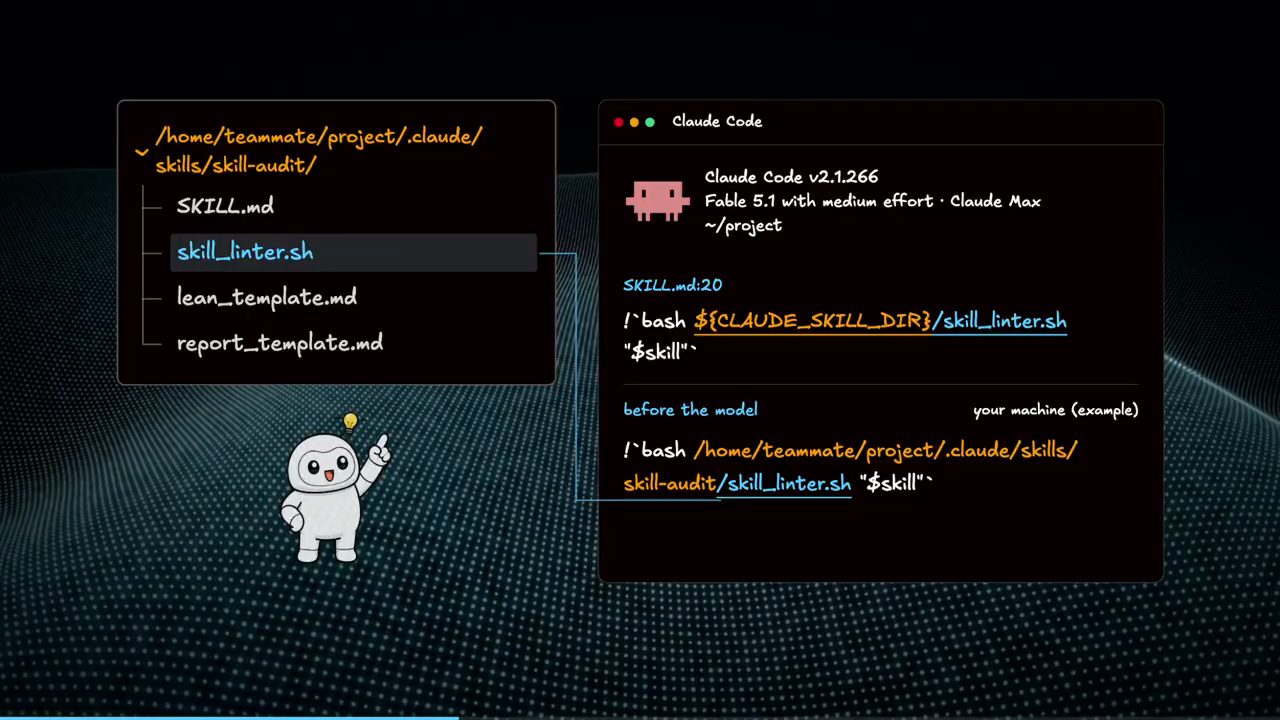
skill-audit gồm SKILL.md, skill_linter.sh, lean_template.md, report_template.md. Dòng 20 của SKILL.md viết ${CLAUDE_SKILL_DIR}/skill_linter.sh; trước khi tới model, biến này được thay bằng đường dẫn thật trên máy đang chạy (ở đây là một máy ví dụ của một đồng đội).Tài liệu Claude Code về skill mô tả biến ${CLAUDE_SKILL_DIR} và cấu trúc folder này ở trang Extend Claude with skills.
6. Probabilistic và deterministic: agent làm keo giữa các script
Tiếp theo Roman nói nhanh về tính deterministic. Về bản chất, skill là probabilistic: không có gì bảo đảm nó chạy đúng, vì nó dựa vào việc agent làm đúng các hành vi. Điều đó là vấn đề vì skill như vậy đắt hơn, kém tin cậy hơn và mất nhiều thời gian hơn. Ngược lại, script thì hoàn toàn deterministic.
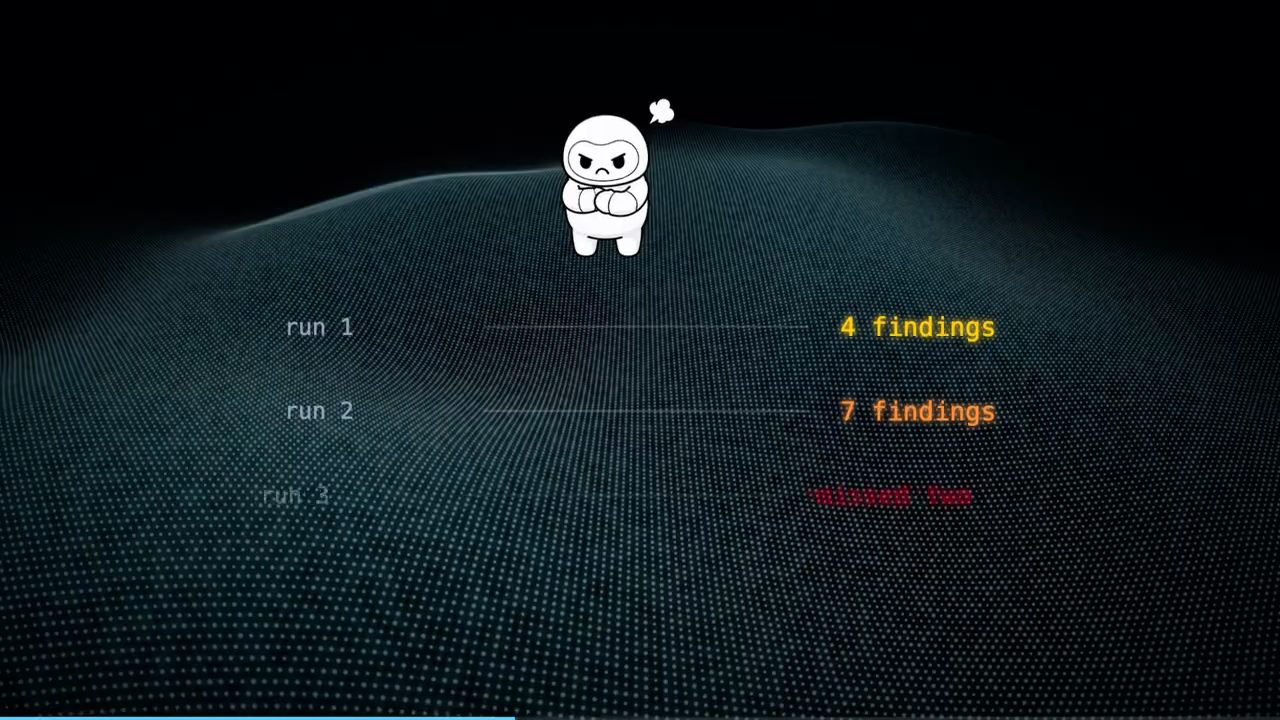
lint.sh: cả ba lần đều ra 12 kết quả, nhãn "deterministic".Lời giải cho việc skill mang tính probabilistic là làm nó deterministic nhiều nhất có thể, bằng cách đưa script vào mọi chỗ có thể, mọi chỗ script khớp với skill. Nên có một quy tắc để cân nhắc khi viết hoặc xem lại một skill: trong skill này có chức năng nào làm được hoàn toàn deterministic bằng một script hay không?
Và đây là cách Roman thật sự dùng skill: cái gì script được thì sẽ là script, còn file markdown dạy agent chạy chúng và quyết định bước tiếp theo. Agent được coi như chất keo nằm giữa các script.
Trên màn hình là một SKILL.md ví dụ theo đúng tinh thần đó, mọi bước cơ học đều là script nằm trong folder skill:
---
name: review-change
description: Review a code change.
---

Run `bash ${CLAUDE_SKILL_DIR}/scripts/diff.sh`.

If the diff changes behavior, run `bash ${CLAUDE_SKILL_DIR}/scripts/test.sh`; otherwise skip tests.

Then run `python3 ${CLAUDE_SKILL_DIR}/scripts/report.py` only if no checks failed; otherwise stop.
7. Lever 1: đặt hook bên trong skill
Đó là phần lõi của skill. Ngoài ra còn vài lever trong frontmatter mà theo Roman gần như không ai đụng tới, và một số thật sự rất hay.
Đầu tiên, bạn có thể đặt hook bên trong một skill, và hook đó chỉ được đăng ký trong những session mà skill đó đã chạy. Ví dụ anh đưa ra là một skill tên /grill-me-record. Bạn lấy skill grill-me gốc của Matt Pocock, trong đó model hỏi bạn liên tục về spec cho tới khi nó hài lòng, rồi cài thêm một hook UserPromptSubmit. Như vậy mỗi lần bạn gửi prompt cho agent, một script chạy. Trước khi bất kỳ đoạn code nào được thực thi, hook đó dùng regex để ghi lại mọi câu hỏi model đã hỏi và mọi câu trả lời người dùng đã đưa, thêm chúng một cách deterministic và tức thì vào một tài liệu trong codebase tên grill-responses.md.
Cách này giải quyết nỗi khổ của rất nhiều người: câu hỏi và câu trả lời bị mất hút trong session của agent. Và nó được giải bằng một pattern đơn giản là đặt hook bên trong skill.
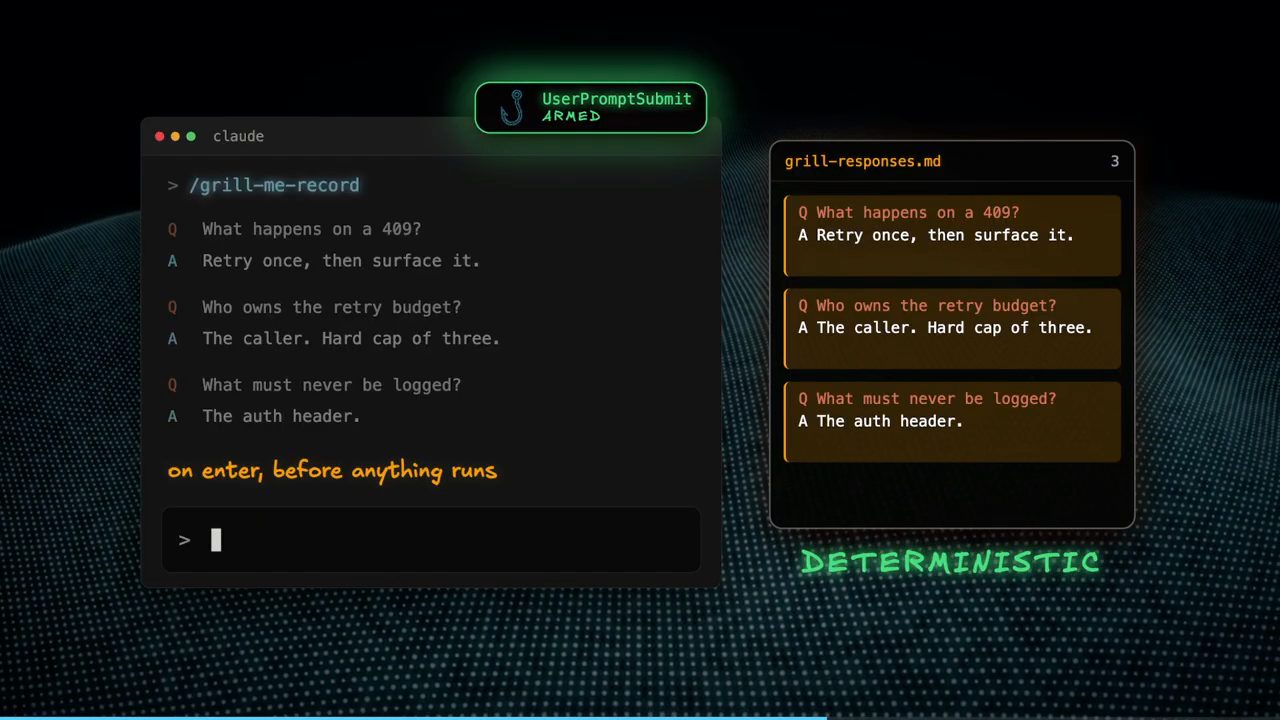
/grill-me-record với ba cặp hỏi đáp (chuyện gì xảy ra khi gặp lỗi 409, ai giữ retry budget, thứ gì không bao giờ được log). Hook UserPromptSubmit đang "ARMED", chạy "on enter, before anything runs", và bên phải cả ba cặp đã nằm trong grill-responses.md.Một điều cần lưu ý: khi một skill đã đăng ký hook, hook đó bật suốt phần còn lại của session, không chỉ trong nhiệm vụ của skill đó. Skill grill-me gốc nằm trong repo skills của Matt Pocock; cách khai báo hook trong frontmatter của skill có ở tài liệu hooks của Claude Code.
8. Lever 2: cho phép và chặn tool
Bạn cũng có thể cho phép hoặc chặn tool cho lượt đầu tiên của agent khi một skill đang hoạt động. Đây là một biện pháp an toàn khi bạn muốn ép một hành vi. Ví dụ, bạn có thể chặn Edit và Write trong một skill mà việc duy nhất của agent là phân tích chỉ đọc (read-only). Như vậy bảo đảm agent sẽ cư xử đúng mực.
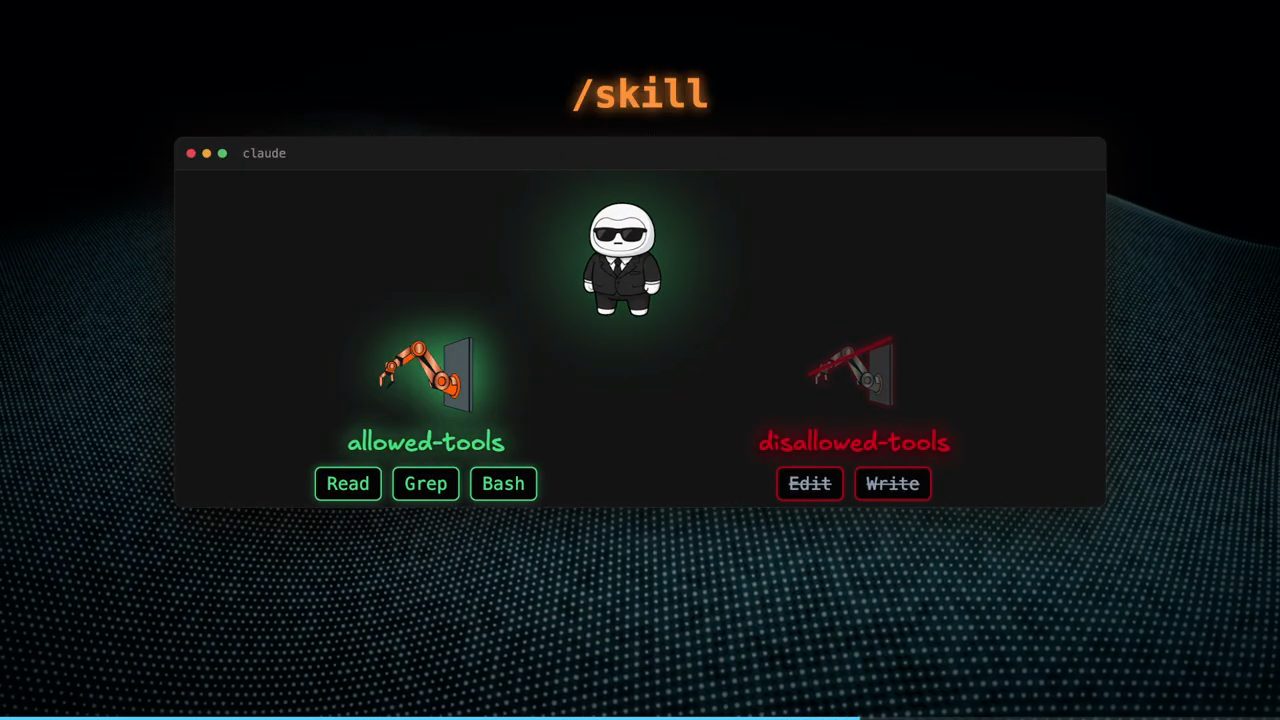
allowed-tools (Read, Grep, Bash) và disallowed-tools (Edit, Write bị gạch). Với một skill chỉ phân tích, chặn ghi file là cách bảo đảm thay vì dặn bằng lời.9. Lever 3: dấu chấm than, dấu @ và arguments
Tiếp theo, trong Claude Code, ký hiệu dấu chấm than biến lệnh thành thực thi bash. Và điều này cũng chạy trong skill, nghĩa là bạn chạy được script ngay lúc skill được nạp (load time). Model không bao giờ nhận được lệnh bạn đã gõ; thay vào đó nó nhận output của lệnh đó, được bơm vào một cách deterministic. Nhờ vậy bạn làm được nhiều logic động hơn bên trong skill với chi phí rẻ hơn nhiều, và nó ép tính deterministic trong skill của bạn.
!`git diff --stat` trong SKILL.md: lệnh chạy lúc nạp skill, và thứ model nhận chỉ là "Here is what changed:" kèm kết quả.Một mẹo khác: ký hiệu @ bơm bất kỳ file nào bạn chọn vào skill. Điều này mạnh vì bạn thay đổi được thứ đưa vào model mà không phải sửa skill mỗi khi có gì đó đổi. Ví dụ, nếu bạn chạy một skill /analyze-codebase, bạn có thể bơm user story của codebase vào bằng cách thêm @docs/USER-STORY.md. Và khi user story đó thay đổi, bạn không phải sửa skill.
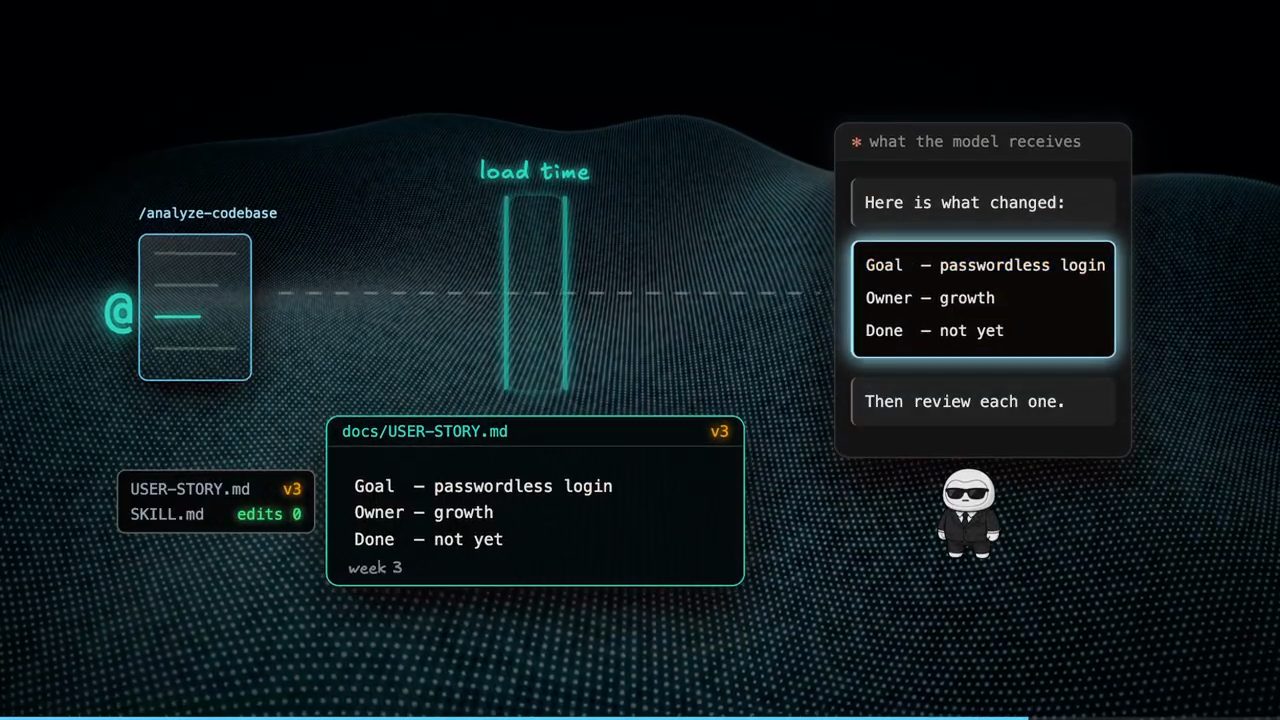
/analyze-codebase dùng @ trỏ tới docs/USER-STORY.md. File user story đã lên bản v3 (tuần thứ 3) trong khi SKILL.md vẫn "edits 0"; model nhận nội dung mới nhất (Goal: passwordless login, Owner: growth, Done: not yet) rồi được bảo xem xét từng mục.Điểm thứ ba: bạn có thể thêm arguments cho skill, cho phép người dùng bơm biến vào một số script nhất định hoặc bơm context vào model. Thêm một mẹo nữa: khi dùng một skill, bạn vẫn có thể viết prompt chồng lên nó, và prompt của bạn sẽ được bơm vào agent ngay sau skill.
10. Mở skill-audit: frontmatter đầy đủ
Vậy một skill thật sự trông như thế nào? Roman bắt đầu với một skill audit skill anh đã tạo, tức một skill dùng để kiểm định skill. Đây là một ví dụ hơi "meta": một skill tuân theo mọi quy ước tốt của skill và có thể dạy bạn vài điều. Bạn cũng có thể tải nó về để nó phục vụ tốt hơn quá trình build skill của bạn: bạn audit được skill của mình.
Điều đầu tiên anh muốn chỉ ra là disable-model-invocation đang bật. Một lần nữa, điều đó có nghĩa là phần frontmatter của skill này, tức phần description, sẽ không nằm sẵn trong context của model mọi lúc. Nếu đặt nó là false thì có.
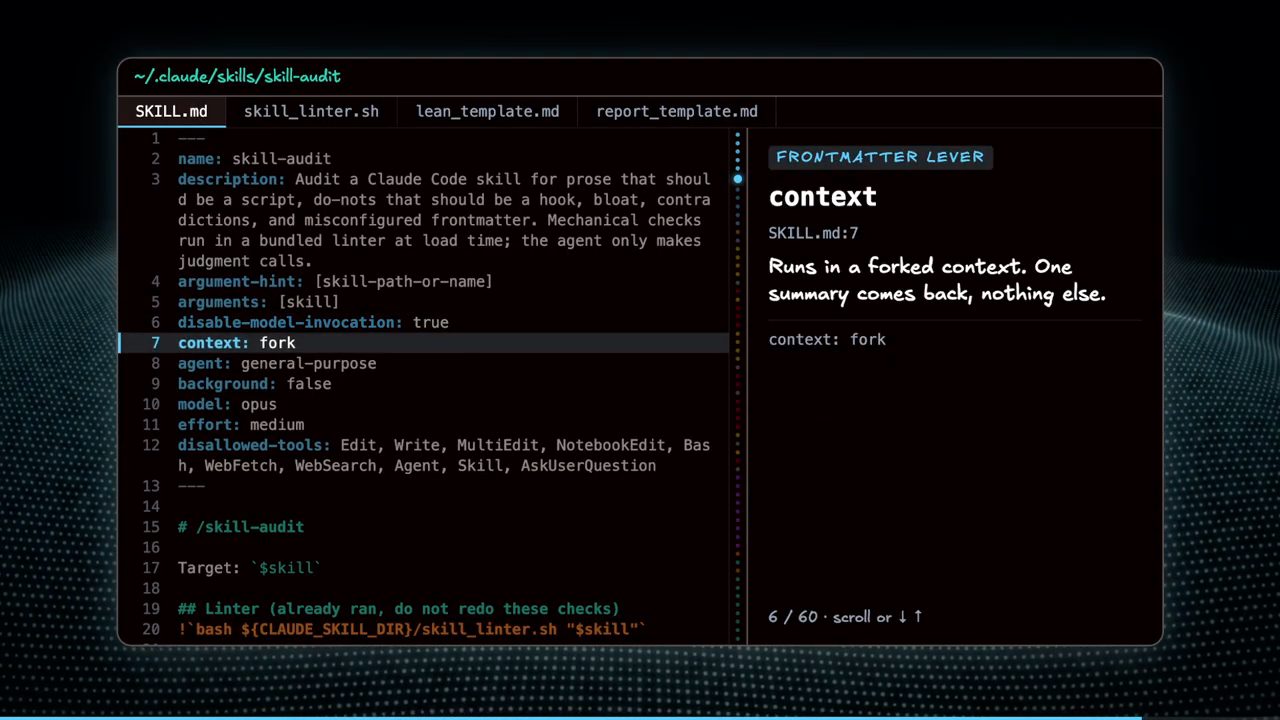
skill-audit trong trình duyệt file của video, dòng 7 context: fork đang được tô; ghi chú bên phải: chạy trong context fork, chỉ một bản tóm tắt quay về, không gì khác.Toàn bộ phần đầu SKILL.md như trên màn hình:
---
name: skill-audit
description: Audit a Claude Code skill for prose that should be a script, do-nots that should be a hook, bloat, contradictions, and misconfigured frontmatter. Mechanical checks run in a bundled linter at load time; the agent only makes judgment calls.
argument-hint: [skill-path-or-name]
arguments: [skill]
disable-model-invocation: true
context: fork
agent: general-purpose
background: false
model: opus
effort: medium
disallowed-tools: Edit, Write, MultiEdit, NotebookEdit, Bash, WebFetch, WebSearch, Agent, Skill, AskUserQuestion
---

# /skill-audit

Target: `$skill`

## Linter (already ran, do not redo these checks)
!`bash ${CLAUDE_SKILL_DIR}/skill_linter.sh "$skill"`
11. Context fork, background, model và effort
Mẹo nhỏ tiếp theo: Roman đặt context là fork. Nên ngay khi bạn chạy skill này, nó sẽ fork đúng context hiện tại của agent, đặt skill vào đó, cho nó chạy trong một sub-agent được fork ra, rồi hợp kết quả trở lại agent chính. Đây có thể là một pattern rất mạnh cho hiệu quả context, khi bạn thật ra không cần skill chạy trong context chính của agent mà chỉ cần output của nó.
Ở đây anh để nó chạy ở foreground, nghĩa là bạn không dùng session bình thường được trong lúc skill chạy. Nếu đặt background là true, agent được fork sẽ chạy nền trong khi bạn tiếp tục session của mình. Với skill này, anh chấp nhận chờ.
Bạn cũng gán được model cho skill. Nên ngay khi anh chạy skill này, nó sẽ fork context, đổi model sang opus, đổi effort sang medium, và giữ ở foreground. Anh cũng chặn càng nhiều tool càng tốt để nó hoàn toàn deterministic, vì đây là skill chỉ đọc: anh không muốn nó sửa skill của mình, nên ép điều đó thành bảo đảm.
/skill-audit theo lời Roman: fork context, đổi model và effort, chặn tool ghi, rồi chỉ output quay về agent chính.12. Thân skill: linter chạy trước khi agent đọc chữ nào
Sang phần thân skill. Điều đầu tiên cần để ý là pattern dấu chấm than để chạy bash script ngay trong skill, trước khi nội dung tới được agent. Việc đầu tiên skill làm là chạy bash script skill_linter.sh trên skill bạn chọn. Skill được chọn do người dùng đưa vào dưới mục Target, dưới dạng argument. Rồi linter chạy trên skill đó.
Vậy skill linter là gì? Đó là một đống logic, trước hết tìm skill từ đường dẫn hoặc tên trong argument. Nếu không có argument nào, nó in hướng dẫn sử dụng (usage) vào context thay vì chạy tiếp. Sau đó nó kiểm xem skill người dùng đưa vào, đúng nguyên văn, có thật sự là một skill trong .claude/skills hay trong plugin không, và nó phải chọn đúng một skill. Khi script đã tìm thấy, mọi kiểm tra bên dưới chạy trên folder đó.
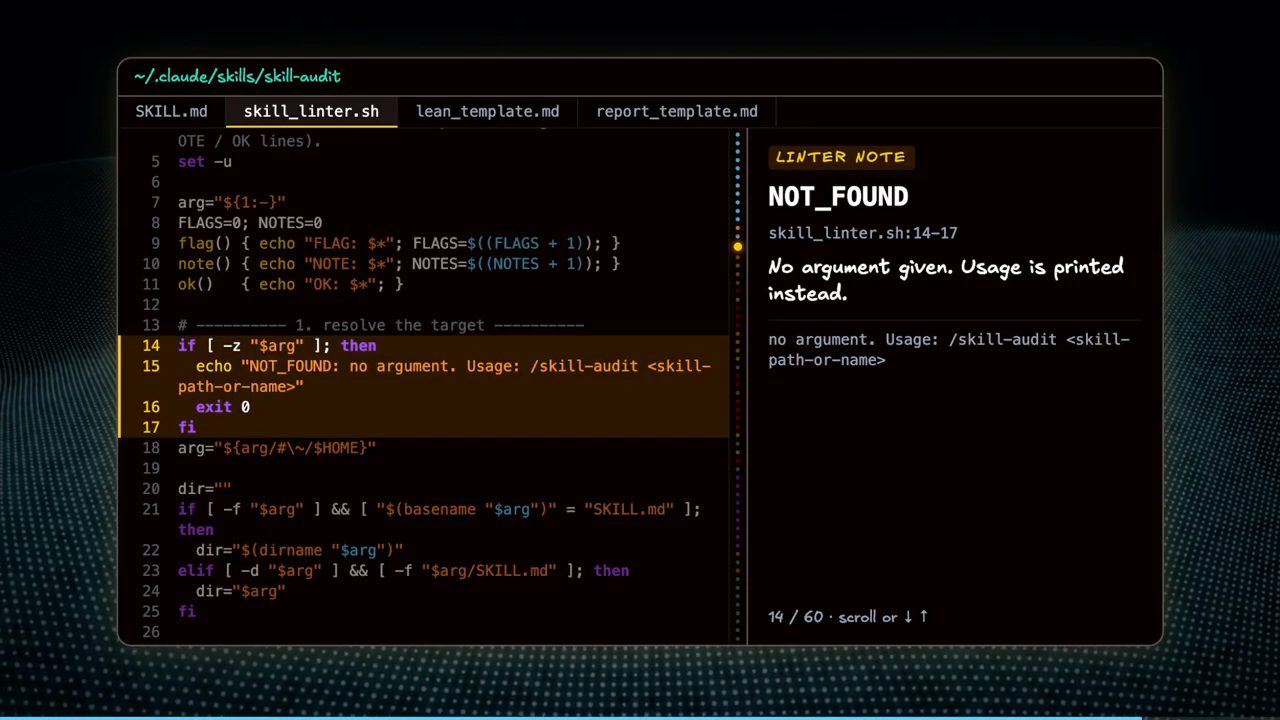
skill_linter.sh: nếu argument rỗng, in "NOT_FOUND: no argument. Usage: /skill-audit <skill-path-or-name>" rồi thoát. Các hàm flag, note, ok phía trên là ba loại dòng linter in ra cho agent.Trong SKILL.md, ngay sau dòng gọi linter là phần "Your job": nếu linter in ra NOT_FOUND hoặc CANDIDATES thì báo lại và dừng, không audit một phỏng đoán.
13. Linter kiểm frontmatter
Giờ tới các kiểm tra deterministic. Đầu tiên, linter đọc frontmatter và kiểm từng key. Nếu không có frontmatter, skill sẽ được nạp mà không có description. Vì frontmatter phải bắt đầu bằng ba dấu gạch ngang ở dòng đầu của skill. Về cơ bản đây là cách bảo đảm skill được viết đúng. Roman chỉ lên màn hình: dòng đầu tiên trong file của anh chính là ba dấu gạch đó. Anh lưu ý điều này có thể thay đổi nếu Anthropic quyết định đổi cách họ làm.
Nếu có một key mà Claude Code không biết, key đó bị bỏ qua trong im lặng, nên linter ghi một note cho agent. Nếu không có description, linter flag điều đó để model biết. Một điều nữa cần cân nhắc: nếu description cộng với phần when-to-use dài quá 1536 ký tự, nó sẽ bị cắt khi đưa cho model, có thể gây nhầm lẫn. Nên khi audit skill, anh muốn kiểm một cách deterministic rằng nó dưới 1536, để không bị cắt mà mình không biết.
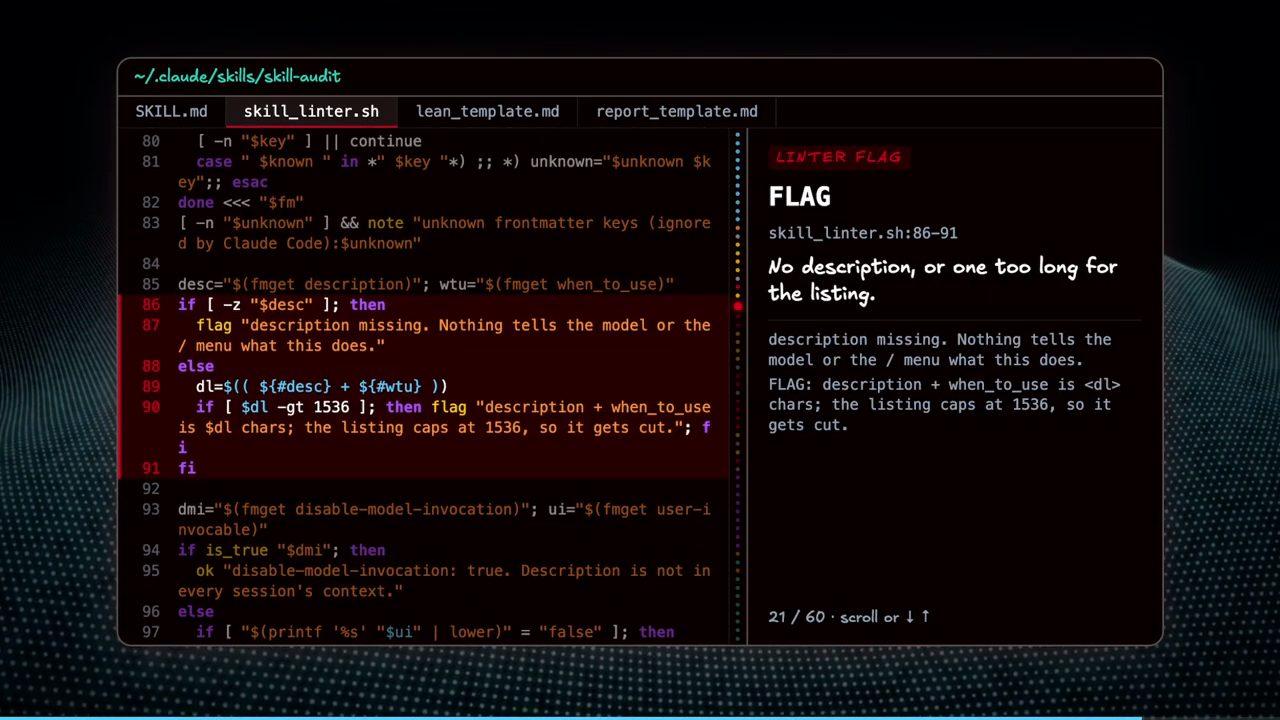
disable-model-invocation.Kiểm tra tiếp theo rất quan trọng với Roman và skill của anh. Mặc định anh luôn đặt disable-model-invocation: true, để bảo vệ sự chú ý (attention) của model. Nên nếu disable-model-invocation là false, anh muốn nó được flag cho agent trong lúc audit, để mình tự quyết.
Tiếp theo là những trường hợp skill nhận argument nhưng không cho người dùng gợi ý gì về argument đó. Và vài thứ khác quan trọng mà bạn và model nên biết: hook của một skill ở trạng thái bật suốt cả session, nên đôi khi điều đó có thể gây nguy hiểm. Ngoài ra, nếu skill đổi model, nó sẽ làm vỡ prompt cache cho lượt đó, khiến lần nạp skill tốn thêm tiền; đổi effort cũng vậy.
Giới hạn 1536 ký tự cho description cộng when_to_use cũng được ghi trong tài liệu skills của Claude Code (kiểm tại thời điểm 10/2026).
14. Linter kiểm kích thước, đường dẫn, quyền và rule stacking
Tiếp theo trong linter là kích thước skill. Trong một số trường hợp, skill dài hơn 500 dòng có thể rất nguy hiểm, vì bạn đang bơm rất nhiều context vào agent. Bạn có thể đặt ngưỡng flag này là 1.000. Dưới 500 dòng là con số Anthropic chính thức khuyến nghị (theo video đăng ngày 15/09/2026). Một điều nữa: nếu tổng cả skill vượt 5.000 token, thì 5.000 token đầu sẽ sống sót qua auto compaction, còn phần còn lại sẽ rơi mất trong im lặng. Theo Roman, những điều này rất quan trọng, ít nhất là phải biết.
Những kiểm tra khác: linter kiểm một cách deterministic mọi đường dẫn script và file đi kèm. Nếu một script được tham chiếu bằng tên trần, nó có thể hỏng trên máy khác, nên điều đó rất cần xem lại. Tương tự với đường dẫn script tương đối: nó sẽ hỏng trên máy khác. Hoặc khi file đi kèm thật ra không tồn tại. Một thứ khác cần flag: nếu model chạy script trong skill mà không có gì cấp quyền trước cho chúng, pop-up xin quyền sẽ hiện mỗi lần, khiến skill gần như không dùng nổi.
Một thứ Roman thích flag là quá nhiều quy tắc tuyệt đối trong một skill. Ví dụ nếu nhiều hơn 15, có thể nên flag cho agent. Rule stacking (chồng quy tắc) rất, rất nguy hiểm khi làm việc với agent, vì agent không thể tuân theo tốt từng quy tắc một. Cuối cùng script chỉ việc in tất cả những điều này ra cho agent.
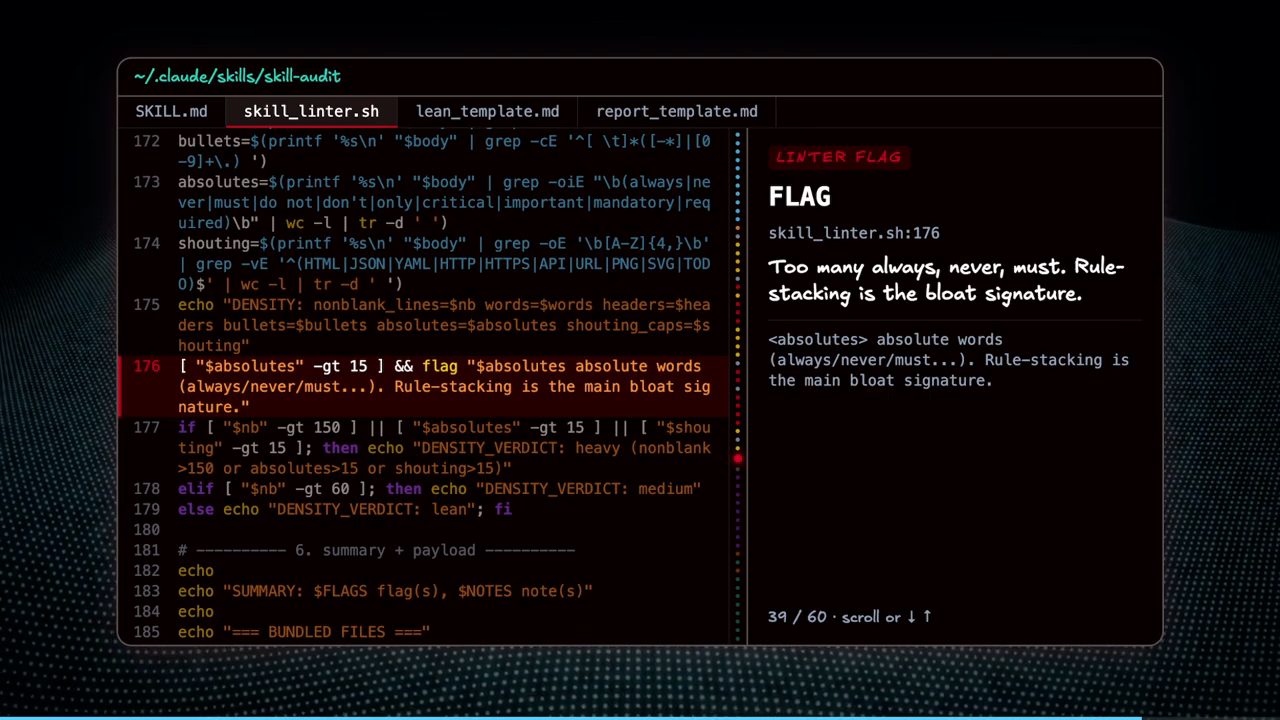
Tài liệu Claude Code hiện cũng khuyên giữ SKILL.md dưới 500 dòng và ghi rằng khi hội thoại được tóm tắt, mỗi skill đã gọi được gắn lại tối đa 5.000 token đầu (Extend Claude with skills, kiểm 10/2026).
15. Những kiểm tra chỉ LLM làm được
Quay lại agent. Đầu tiên agent nhận bản in từ linter, rồi nhận phần prompt này. Prompt về cơ bản là nhìn vào mọi thứ linter đã làm, nhìn vào chính skill, và lần theo những hành vi không thể phát hiện một cách deterministic. Roman nhấn mạnh: mọi thứ anh sắp kể đều là những thứ chỉ một LLM phát hiện được, không đưa vào script được.
- Core behavior. Skill này để làm gì, trong một câu?
- Prose that should be a script. Tìm những đoạn văn xuôi lẽ ra nên là script.
- Do-nots that should be enforced. Những chỗ có thể cài một hook thay cho một quy tắc "do not".
- Temp scripts instead of templates. Skill bảo agent tự tạo một script thay vì điền vào một template. Điều này có thể rất tốn tiền và thời gian.
- Fork. Skill này có nên chạy dưới context fork không, hoặc nên thôi fork nếu fork là sai?
- Contradictions and unclear instructions. Mâu thuẫn hoặc hướng dẫn không rõ trong skill; agent được giao xem xét điều đó.
- Bloat. Rất nhiều lần, khi agent viết skill, chúng nhồi vào cả tấn quy tắc, cả tấn hướng dẫn, những dòng rất đặc. Nên ta muốn xem có làm nó gọn hơn được chút nào không.
Rồi agent đưa ra một verdict dựa trên tất cả những điều này. Trên màn hình, verdict có ba mức: keep nếu không có flag và không có phát hiện nào, condense nếu core behavior đúng nhưng có phát hiện, rebuild nếu core behavior không rõ hoặc các mâu thuẫn làm thay đổi việc skill làm.
Phía dưới, skill bơm vào template cho câu trả lời của model để nó thấy đúng hình dạng. Đó là lean_template.md, nạp bằng một lệnh cat chạy lúc load time. Roman nghĩ ở đây cũng có thể dùng ký hiệu @, thật ra không khác gì mấy. Template nhỏ này là hình dạng mà mọi skill nên đạt tới. Cuối cùng là template mà model sẽ điền vào, report_template.md, cũng được bơm vào. Trên màn hình, nó có các mục như Should be a script, Should be a hook or disallowed-tools, Temp scripts instead of templates, Fork, Contradictions and unclear instructions và Condense; Roman lướt rất nhanh qua phần này.
Và thế là xong: đó là skill audit skill của anh. Anh hy vọng người xem học được cách build skill tốt, hiệu quả bằng cách nhìn vào nó. Skill này có trong cộng đồng miễn phí của anh, nơi bạn có thể dùng nó để audit skill của mình và xem anh đã build nó ra sao.
16. Tóm lại và việc nên làm hôm nay
Roman chỉ ra: nếu nhìn vào thứ anh thật sự đưa cho skill đó, vì đó là toàn bộ skill, anh đã nói cho nó biết cần flag gì, và kiểm tra nào trong số đó là cơ học và thuộc về script. Theo anh, cách chia đó chính là điều lớn nhất trong skill: đó là nơi bạn làm mọi thứ deterministic và được bảo đảm nhiều nhất có thể. Ví dụ, đếm dòng và grep một đường dẫn không phải việc của một language model. Bạn chỉ cần đặt nó vào một script và để nó chạy tức thì.
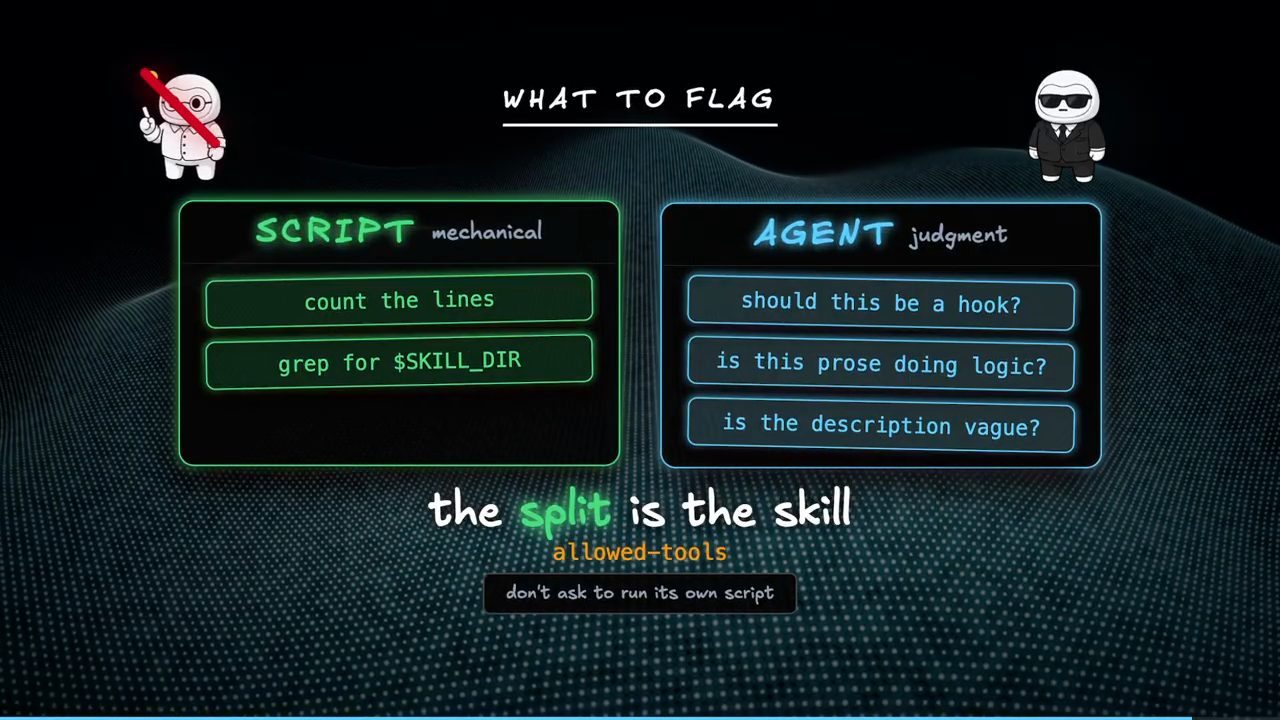
$SKILL_DIR; cột AGENT (phán đoán) gồm có nên là hook không, đoạn văn này có đang làm logic không, description có mơ hồ không. Dòng dưới nhắc allowed-tools để skill không phải xin quyền chạy script của chính nó.Và một lần nữa, hai mặc định không thương lượng của anh: tắt model invocation, trừ khi anh thật sự muốn Claude tự với tới skill; và giữ file ngắn.
Việc nên làm hôm nay theo anh: lấy skill audit skill trong cộng đồng của anh và chạy nó trên mọi skill bạn có. Hoặc đọc từng dòng của từng skill và tự hỏi hai câu: dòng này có thể là một script không? Dòng này có thể là một hook không?
Nguồn và liên kết 7 nguồn
- Tên gốc: Claude Code Skills from First Principles
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=n9CSSSir3fE youtube.com
- Kênh YouTube Agentic Lab (Roman Colman): youtube.com/channel/UCD-gasIQYzXqQ4dr7mGPRfw youtube.com
- Tài liệu Claude Code về skill (frontmatter,
disable-model-invocation,context: fork,${CLAUDE_SKILL_DIR}, chạy lệnh shell lúc nạp skill, giới hạn 1.536 ký tự và 500 dòng): code.claude.com/docs/en/skills code.claude.com - Tài liệu Claude Code về hooks (sự kiện
UserPromptSubmit, hook khai báo trong skill): code.claude.com/docs/en/hooks code.claude.com - Repo skills của Matt Pocock, nơi có skill grill-me: github.com/mattpocock/skills github.com
Related talks
Toàn bộ hướng dẫn Skills của Anthropic trong 22 phút
Mark Kashef · Mark Kashef · 22 min
Đi qua bản hướng dẫn 33 trang của Anthropic về skill: anatomy, ba tầng progressive disclosure, viết description, năm design pattern, test và phân phối.
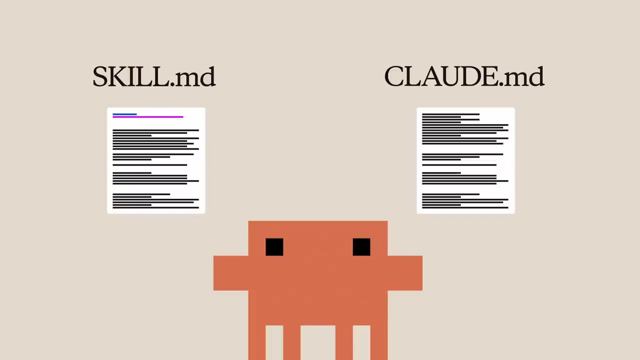
Skill là gì?
Claude · Claude · 3 min
Skill là file SKILL.md dạy Claude một việc một lần: Claude chọn skill qua description, đặt ở đâu, khác CLAUDE.md và slash command ra sao.
Nắm 95% Claude Code skills trong 28 phút
Nate Herk · Nate Herk | AI Automation · 27 min
Skill là gì, SKILL.md và supporting files, progressive context loading, framework sáu bước, live build một skill infographic, bảng debug và skill global.