Vòng lặp Anthropic dùng để làm claude.ai nhanh gấp ba
Vòng lặp Anthropic kể đã làm claude.ai nhanh hơn khoảng 3 lần trong hai tuần: instruction count, CI ratchet, field data, người duyệt mọi thay đổi.
✓ Đã duyệt độc lập · cập nhật 23/10/2026 · 11 min
1. Nhanh gấp khoảng ba lần trong hai tuần, và p75 nghĩa là gì
AICodeKing chào người xem rồi vào thẳng chủ đề. Theo bài viết của Anthropic mà anh dẫn (video đăng ngày 12/10/2026), trải nghiệm web và desktop của Claude đã nhanh hơn khoảng ba lần chỉ trong một đợt sprint kéo dài hai tuần. Anh muốn dành thời gian xem họ đã tiếp cận việc này ra sao, vì theo anh các ý tưởng engineering trong đó vẫn có ích kể cả khi bạn không dùng Claude.
Điểm xuất phát của anh (video đăng ngày 12/10/2026) là thế này: khi bạn nhờ một công cụ AI coding cải thiện một ứng dụng, bạn vẫn cần một cách nào đó để biết các thay đổi của nó có thật sự giúp được gì không. Một lời giải thích đầy tự tin và một thay đổi code lớn không cho bạn câu trả lời đó.
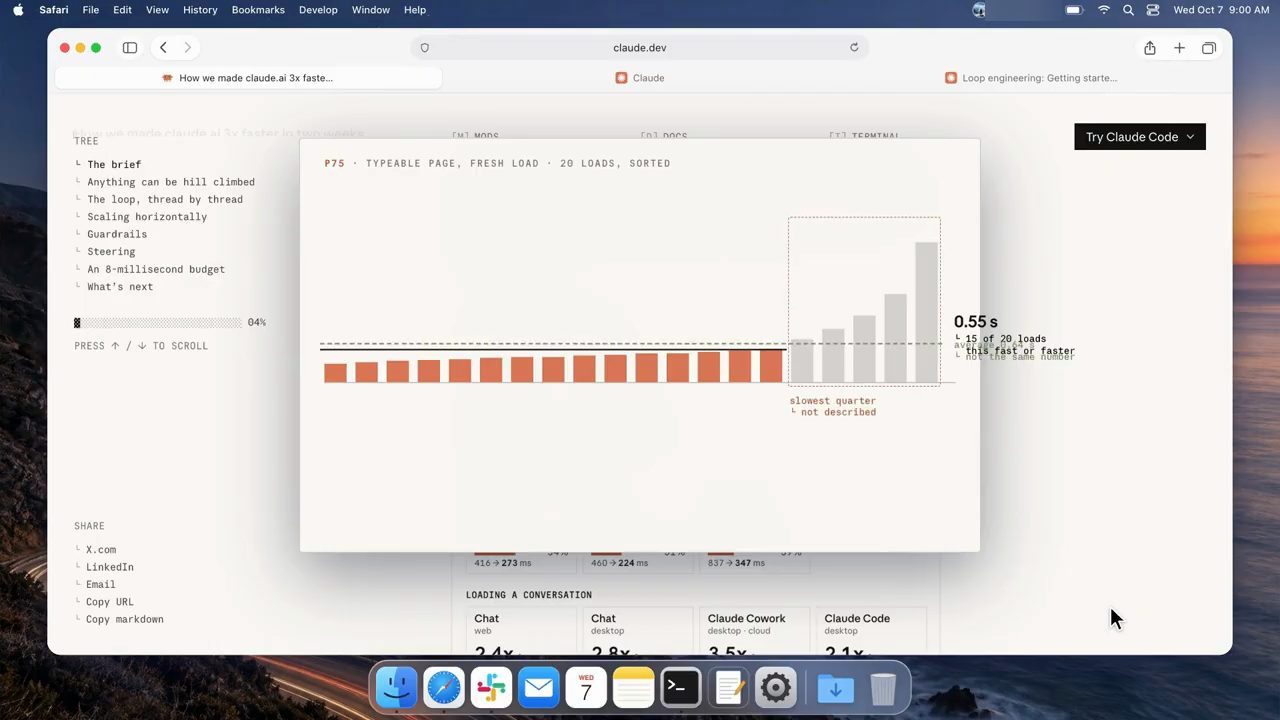
Con số chính trong bài của Anthropic (theo bài viết của Anthropic, video đăng ngày 12/10/2026): ở phân vị thứ 75, thời gian để trang sẵn sàng nhận gõ phím (typing readiness) trên một lần tải mới trang web đã giảm từ 3,1 giây xuống 0,55 giây. AICodeKing giải thích phân vị đó nghĩa là khoảng ba phần tư số lần tải được đo nhanh bằng hoặc nhanh hơn mức đó. Nó không phải là con số trung bình, và nó không mô tả việc những người dùng chậm nhất cũng đạt mức đó. Anh cũng nhấn mạnh rằng việc trang sẵn sàng nhận chữ bạn gõ là một phép đo khác hẳn với tốc độ model sinh ra câu trả lời.
2. Giao cho agent một việc kèm cách tự kiểm tiến độ
Theo cách AICodeKing đọc (video đăng ngày 12/10/2026), điều Anthropic đang muốn truyền đạt ở đây là: hãy giao cho agent một việc, kèm theo một cách để nó tự kiểm tra tiến độ của chính mình. Hướng dẫn rộng hơn của họ về agent loop nói rõ điều này: xác định thế nào là thành công, để agent lặp lại phần việc và phần kiểm tra, và cho nó một điều kiện dừng.
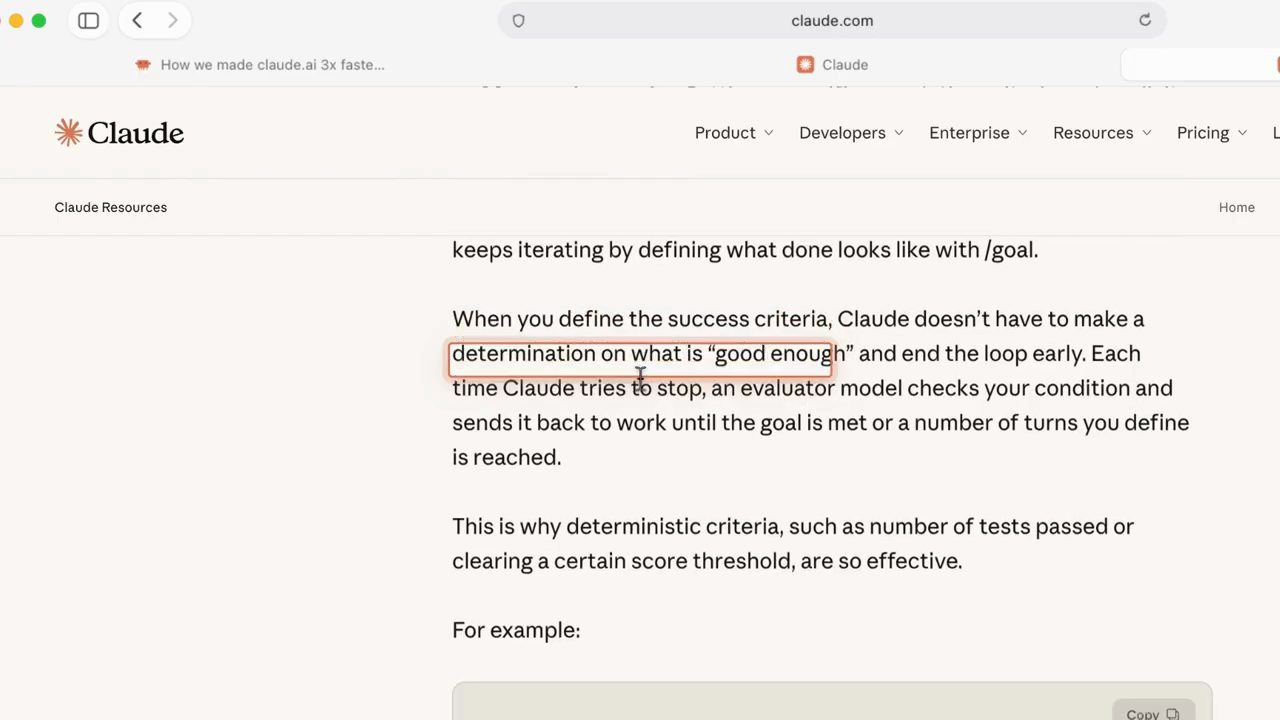
/goal, Claude không phải tự quyết thế nào là "good enough" rồi dừng sớm; mỗi lần Claude định dừng, một evaluator model kiểm điều kiện của bạn và đẩy nó quay lại làm tiếp cho tới khi đạt mục tiêu hoặc hết số lượt bạn đặt.Theo AICodeKing (video đăng ngày 12/10/2026), đó là một cuộc thảo luận hữu ích hơn nhiều so với việc đếm xem AI đã viết bao nhiêu dòng code. Nếu anh đang chờ một tài liệu mở ra, điều anh quan tâm là tài liệu đó có mở sớm hơn không và có còn chạy đúng không. Rồi anh chuyển sang phần technical, sau đó mới nói anh rút ra được gì.
3. Claude Tag trong Slack
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), team của họ dùng Claude Tag trong Slack, chạy với một model nghiên cứu nội bộ, đại khái tương đương Opus 5.5. AICodeKing giải thích Claude Tag là trải nghiệm agent dùng chung của họ bên trong Slack. Theo mô tả trong video đăng ngày 12/10/2026, nó có thể dùng cuộc trò chuyện trong một thread, làm việc với các công cụ được kết nối và làm theo các chỉ dẫn thường trực (standing instructions). Nhờ vậy bạn có thể giao cho agent một trách nhiệm lâu dài, ví dụ theo dõi các issue mới đến, thay vì phải giải thích lại toàn bộ công việc mỗi khi có chuyện xảy ra.
Với một team, theo AICodeKing (video đăng ngày 12/10/2026), anh hiểu sức hấp dẫn của cách này: người báo lỗi và người review bản sửa có thể bàn về cùng một bằng chứng ở cùng một chỗ. Nhưng đưa một agent vào Slack không tự nó làm cho cuộc điều tra trở nên tốt. Bạn vẫn phải cho nó quyền truy cập hữu ích và quyết định nó được phép thay đổi những gì.
4. Hill climbing: thay đổi phải lớn hơn nhiễu
Cụm từ hill climbing xuất hiện trong cuộc thảo luận này. AICodeKing giải thích nó nghĩa là thực hiện một thay đổi, đánh giá kết quả, rồi dùng kết quả đó để quyết định thay đổi tiếp theo nên thử là gì. Bạn cần một mục tiêu đủ cụ thể để đo được, và mức cải thiện phải lớn hơn độ nhiễu trong phép đánh giá của bạn.
Anh lấy ví dụ: hãy tưởng tượng bạn đang cố làm một ô tìm kiếm phản hồi nhanh hơn. Bạn có thể đổi cách nó lọc kết quả, chạy lại đúng lần tìm kiếm đó và so sánh. Nhưng nếu bạn đồng thời cũng đổi tập dữ liệu, trình duyệt và kết nối mạng, thì bạn không biết thay đổi code đáng được ghi công bao nhiêu. Thí nghiệm cần phải hiểu được.
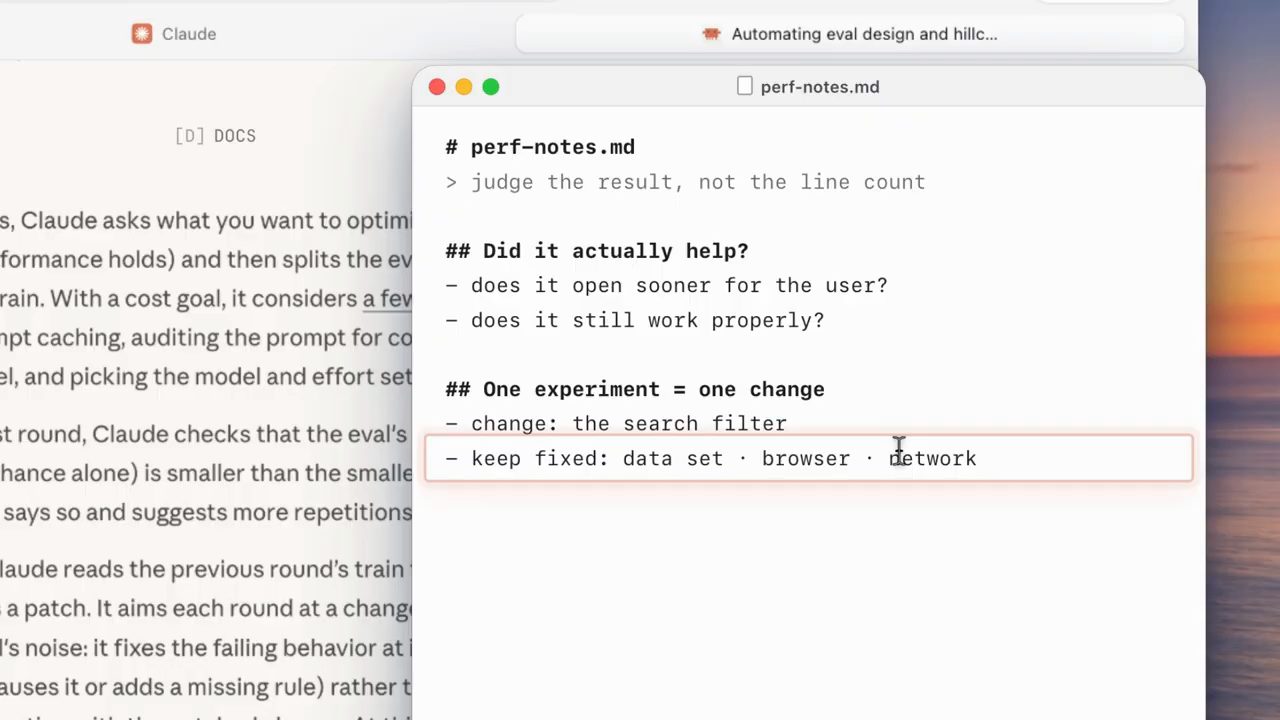
perf-notes.md AICodeKing mở cạnh bài viết về eval design và hill climbing: dòng đầu "judge the result, not the line count", mục "Did it actually help?" với hai câu hỏi (mở sớm hơn cho người dùng không, còn chạy đúng không), và mục "One experiment = one change": chỉ đổi bộ lọc tìm kiếm, giữ nguyên data set, browser và network.Theo bài viết của Anthropic (video đăng ngày 12/10/2026), họ đo instruction count, gắn những con số đó với mức cải thiện thời gian thực tế trôi qua, và áp các mức trần (ceiling) ngày càng thấp hơn trong continuous integration. AICodeKing lần lượt mở từng ý.
5. Wall clock, profiler và instruction count với Callgrind
Wall clock time là thời gian trôi qua trên đồng hồ trong lúc một thao tác chạy. Nó hữu ích vì chờ đợi chính là thứ người dùng cảm nhận, nhưng các phép đo thời gian có thể dao động khi máy đang bận làm việc khác. Một profiler giúp bạn nhìn vào bên trong thao tác đó và tìm xem công việc thật sự diễn ra ở đâu.
Theo giải thích của AICodeKing (video đăng ngày 12/10/2026), công cụ Callgrind của Valgrind có thể đếm số lệnh máy (machine instruction) đã được thực thi, và quy phần việc về từng function cùng các function mà nó gọi. Điều đó cho phép bạn điều tra xem một thao tác cụ thể có đang lặp đi lặp lại những việc không cần thiết hay không. AICodeKing lưu ý instruction count là một phép đo khác với mili giây, và ít lệnh hơn không tự động có nghĩa là cả ứng dụng sẽ cảm thấy nhanh hơn. Với một chương trình và đầu vào cố định, đếm lệnh có thể cho kết quả lặp lại được tốt hơn nhiều so với bấm đồng hồ, nên những thay đổi nhỏ dễ so sánh hơn. Bạn đang đếm phần việc máy thực sự làm, không phải số dòng trong một file mã nguồn.
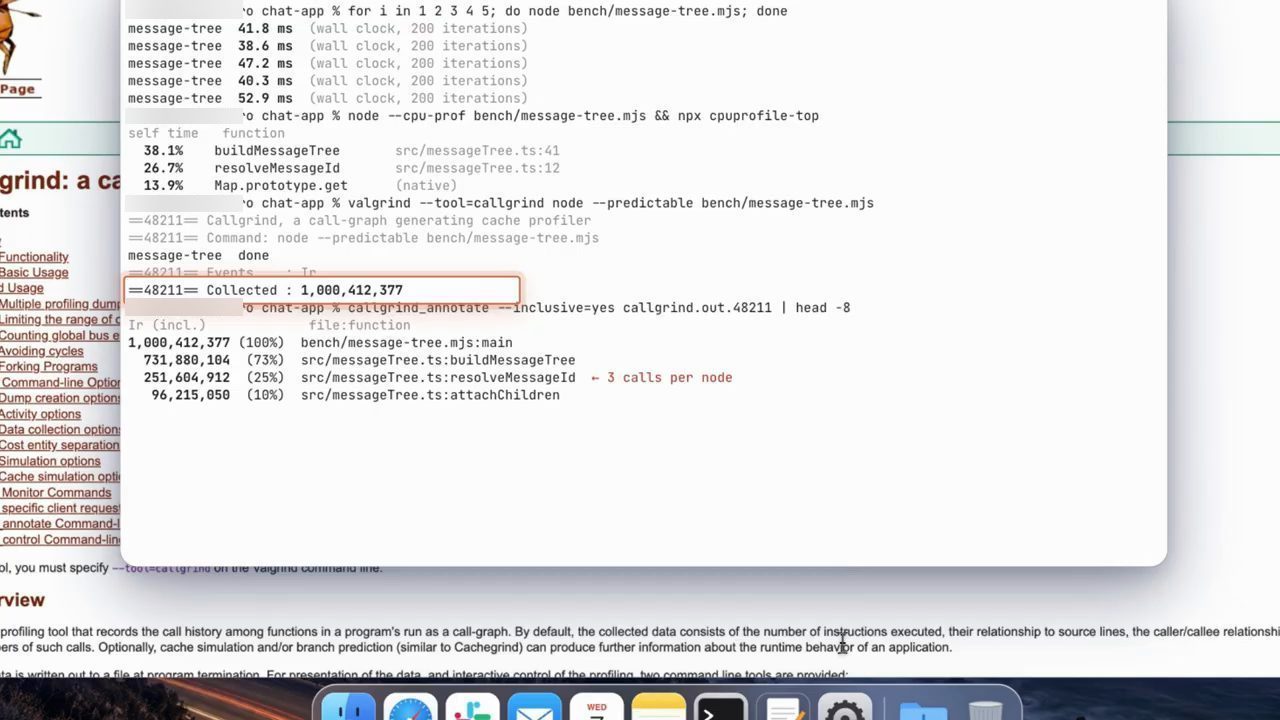
message-tree dao động từ 38,6 đến 52,9 ms; profiler cho thấy buildMessageTree chiếm 38,1% self time; rồi Callgrind thu được 1.000.412.377 lệnh, và callgrind_annotate chỉ ra resolveMessageId chiếm 25%, với chú thích "3 calls per node".Các lệnh chạy trong terminal ở cảnh đó, chép đúng như trên màn hình:
for i in 1 2 3 4 5; do node bench/message-tree.mjs; done
node --cpu-prof bench/message-tree.mjs && npx cpuprofile-top
valgrind --tool=callgrind node --predictable bench/message-tree.mjs
callgrind_annotate --inclusive=yes callgrind.out.48211 | head -8
6. Ví dụ dịch vụ giao hàng và CI ratchet
Theo AICodeKing (video đăng ngày 12/10/2026), để giải thích vì sao ít lệnh hơn chưa chắc đã nhanh hơn với người dùng, anh so sánh với một dịch vụ giao hàng. Bạn có thể làm giấy tờ nhanh gấp đôi, nhưng nếu gói hàng phải nằm chờ xe tải cả một ngày thì khách hàng có thể chẳng thấy khác biệt gì. Trong phần mềm, anh muốn biết function đang được tối ưu có thật sự chịu trách nhiệm cho một phần đáng kể của thời gian chờ hay không.
Continuous integration, hay CI, là nơi các bước kiểm tra tự động chạy mỗi khi code thay đổi. Một bước kiểm tra hiệu năng có thể so sánh phép đo mới với một baseline đã được chấp nhận và gắn cờ một regression. Regression đơn giản là một thay đổi làm cho thứ gì đó tệ hơn trước.
Ý tưởng ratchet là: một cải thiện sẽ trở thành tiêu chuẩn mới. Anh đưa một ví dụ tự đặt ra: giả sử một bài test lặp lại được đếm được một nghìn thao tác và bạn giảm xuống 700, thì bạn cập nhật giới hạn thành 700, để một thay đổi sau này đẩy con số lên lại sẽ bị phát hiện.
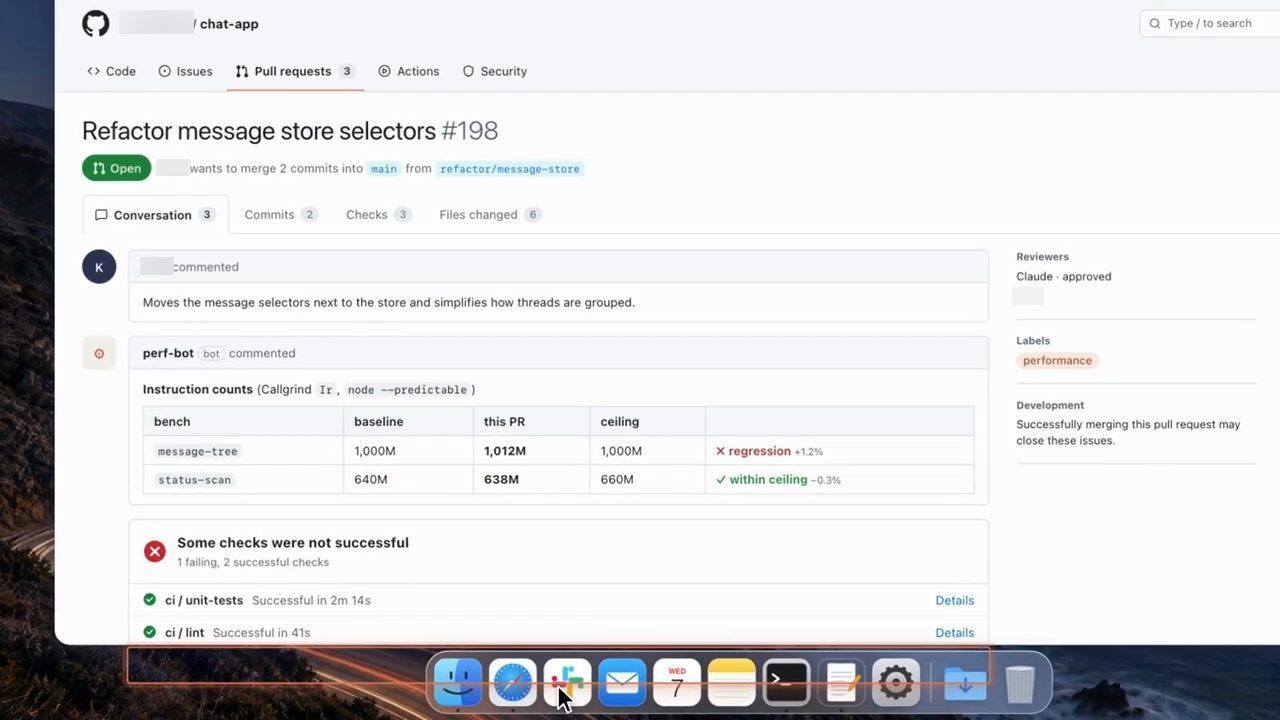
message-tree có baseline 1.000M, PR này 1.012M, ceiling 1.000M nên bị đánh dấu regression +1,2%; status-scan 638M, dưới ceiling 660M. Check tương ứng thất bại, trong khi unit tests và lint vẫn qua.7. Production data: phòng lab và người dùng thật
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), họ kiểm tra production data sau khi deploy và tiếp tục tìm điểm nghẽn tiếp theo. Production data là thứ bạn đo được từ những người đang dùng ứng dụng đã phát hành. Test trong lab cho bạn điều kiện được kiểm soát, còn người dùng thật mang tới đủ loại thiết bị, tốc độ mạng và cách dùng khác nhau. Cả hai đều có ích. Một thay đổi có thể trông rất tốt trên máy test của bạn mà vẫn ít tác động tới những người đang gặp vấn đề.
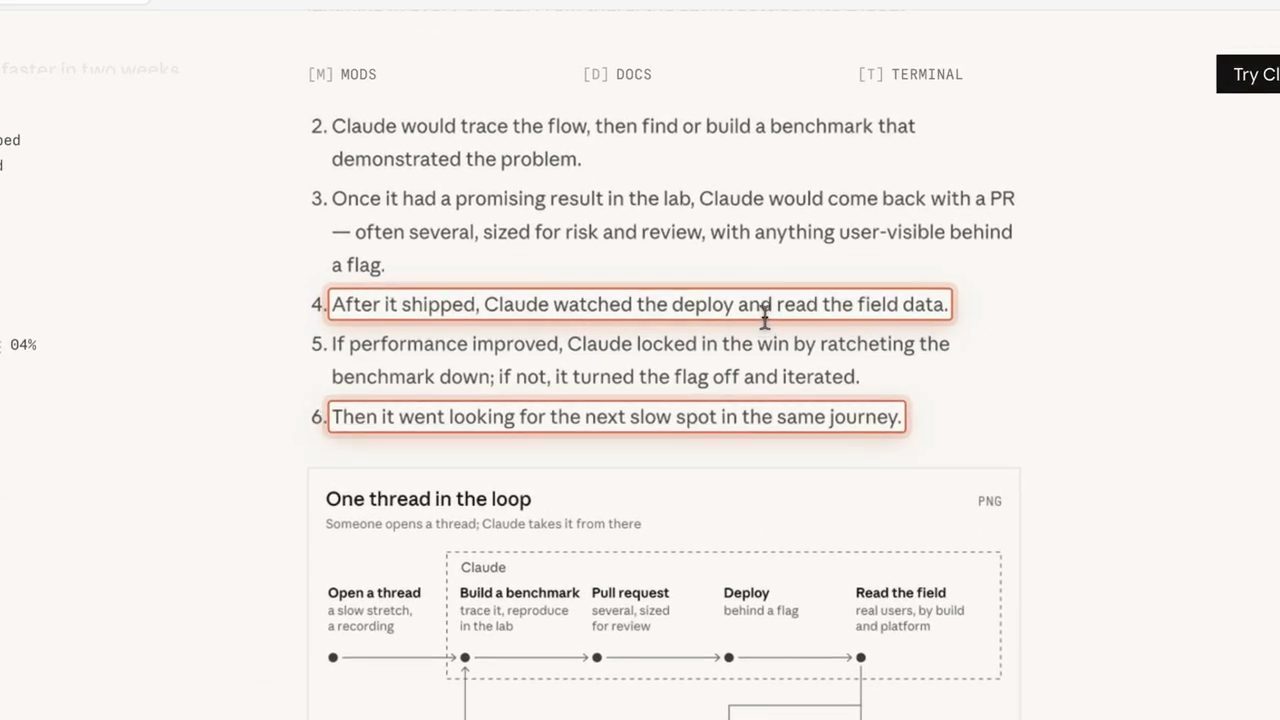
Theo AICodeKing (video đăng ngày 12/10/2026), anh thích điểm này vì như vậy bản sửa đi kèm một cách để nhớ vì sao nó quan trọng. Nếu không, ai đó có thể vô tình gỡ mất phần tối ưu của bạn sáu tuần sau, trong lúc làm một tính năng hoàn toàn khác. Bạn không nên phải trông vào việc mọi người nhớ hết mọi quyết định về hiệu năng.
8. Ô nhập HTML sớm trong lúc React khởi động
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), họ dùng một ô nhập HTML sớm trong lúc React khởi tạo, và giảm số lần sidebar re-render. AICodeKing giải thích: React là một thư viện để xây giao diện. Với một ứng dụng gửi HTML trước, bạn có thể hiện nội dung trước khi toàn bộ JavaScript sẵn sàng. Hydration là quy trình React thông thường để nối logic của component vào phần HTML đã có. HTML ban đầu và output của React cần khớp nhau, nếu không bước chuyển giao có thể gây lỗi. Ô nhập sớm của Claude có bước chuyển giao riêng của nó sang giao diện React đầy đủ.
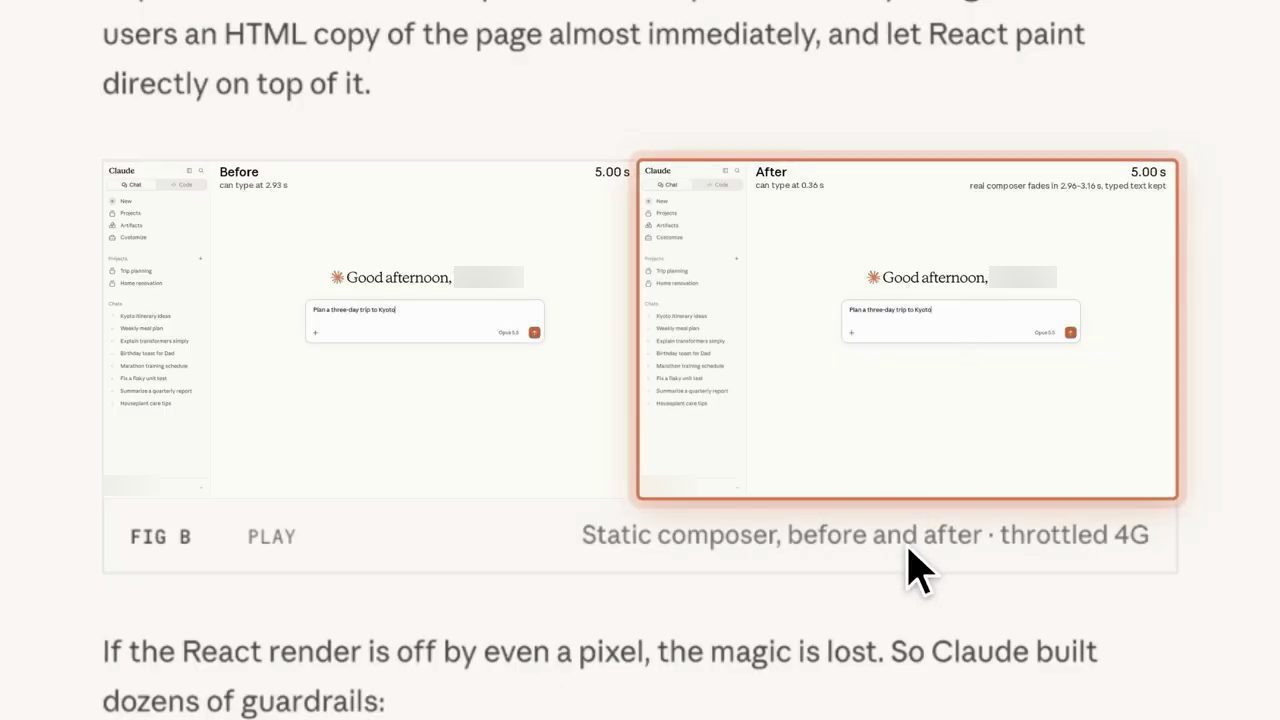
Theo AICodeKing (video đăng ngày 12/10/2026), điều anh quan tâm hơn cả việc ô đó hiện ra sớm là: nếu anh gõ nửa đầu một prompt trong lúc ứng dụng còn đang khởi động, những ký tự đó phải sống sót qua bước chuyển giao. Ô nhập phải giữ focus, và chữ không được nhảy. Một cải thiện tốc độ tải mà làm gián đoạn việc gõ thì khá là khó chịu.
9. React re-render và memoization
Theo giải thích của AICodeKing (video đăng ngày 12/10/2026), một lần React re-render nghĩa là React gọi các component để tính xem giao diện nên trông như thế nào. Nó không nhất thiết có nghĩa là trình duyệt vẽ lại mọi thứ, vì sau đó React mới xác định thay đổi nào cần áp dụng. Nhưng việc chạy logic của component vẫn có thể tốn thời gian, nhất là khi những phần việc nặng lặp đi lặp lại.
Memoization nghĩa là dùng lại một kết quả trước đó khi các đầu vào liên quan chưa thay đổi. Với một giao diện, nó có thể giúp tránh làm lại việc cho một component có nội dung vẫn y như cũ. Tuy vậy bạn phải kiểm tra các đầu vào cho đúng, vì dùng lại một kết quả đã cũ sẽ cho bạn một giao diện không cập nhật khi đáng lẽ phải cập nhật. Tài liệu React mô tả memo là cách bỏ qua việc re-render một component khi props của nó không đổi (đọc ngày 23/10/2026).
AICodeKing đưa ra một tình huống (video đăng ngày 12/10/2026): hãy tưởng tượng bạn đang gõ trong một ô tin nhắn, trong khi một danh sách chẳng liên quan gì lại tự tính toán lại sau mỗi lần nhấn phím. Anh sẽ muốn agent chỉ cho anh thấy vì sao danh sách đó lại dính vào. Đó là một cuộc điều tra cụ thể, và bạn có thể test xem hành vi có thay đổi sau bản sửa hay không.
10. Tái dùng khối trả lời, web worker và 120 fps
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), họ còn dùng lại các khối trả lời đã hoàn tất và chuyển việc tokenize code sang một worker, đạt 120 khung hình mỗi giây trên một chiếc MacBook 120 Hz. AICodeKing giải thích tokenization ở đây nghĩa là chia code thành từng mảnh để syntax highlighter nhận ra những thứ như keyword và string. Đây là phần việc giao diện phải làm để hiển thị code.
Theo giải thích của AICodeKing (video đăng ngày 12/10/2026), một web worker có thể chạy những phần JavaScript phù hợp trên một thread riêng, gửi kết quả trở lại qua message. Nó không thể trực tiếp thao tác với document của trang như main thread. Main thread của trình duyệt đảm nhận rất nhiều việc liên quan đến chạy JavaScript của trang và cập nhật giao diện. Khi một tác vụ chiếm nó quá lâu, các việc khác phải chờ. Điều đó có thể lộ ra thành phím gõ bị trễ hoặc animation bị giật.
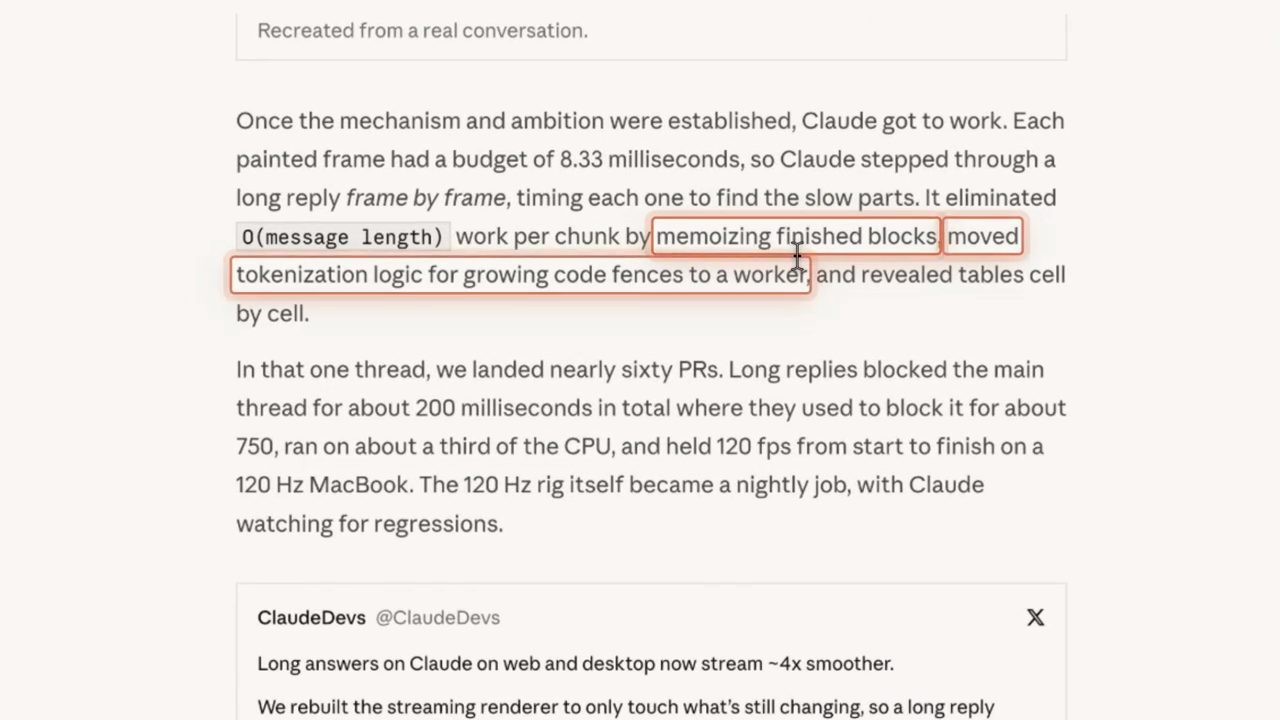
Theo phép tính AICodeKing đưa ra (video đăng ngày 12/10/2026), ở 120 khung hình mỗi giây, giữa hai khung hình chỉ có khoảng 8,3 mili giây. Đó là thời gian dành cho cả khung hình, nên một đoạn JavaScript riêng lẻ không thể thoải mái dùng hết. Tần số làm tươi cao khiến phần việc thừa dễ bị nhận ra hơn, vì khung hình tiếp theo đến hạn quá nhanh.
Với một câu trả lời đang được stream, AICodeKing gợi ý hãy tưởng tượng bạn nhận được câu cuối cùng của một trang rồi lại định dạng lại toàn bộ các đoạn phía trước. Câu trả lời càng dài, cách đó càng đẻ thêm việc. Dùng lại những phần đã hoàn tất là hợp lý, miễn là bạn biết chắc chúng thật sự đã hoàn tất. Nếu không, bạn có thể đổi một vấn đề hiệu năng lấy một lỗi định dạng.
11. Sidebar nhảy mà điểm CLS vẫn "tốt"
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), những lần sidebar bị nhảy vẫn nằm trong ngưỡng CLS được coi là tốt, dù chúng làm phiền người dùng. Layout shift là khi nội dung đang hiện bất ngờ dịch chuyển. Cumulative layout shift, hay CLS, chấm điểm những dịch chuyển này dựa trên các yếu tố như phần màn hình bị ảnh hưởng lớn cỡ nào và mọi thứ dịch đi xa bao nhiêu. Nó có ích để phát hiện trang thiếu ổn định, nhưng một con số điểm không mô tả hết mọi chi tiết trong trải nghiệm của một người.
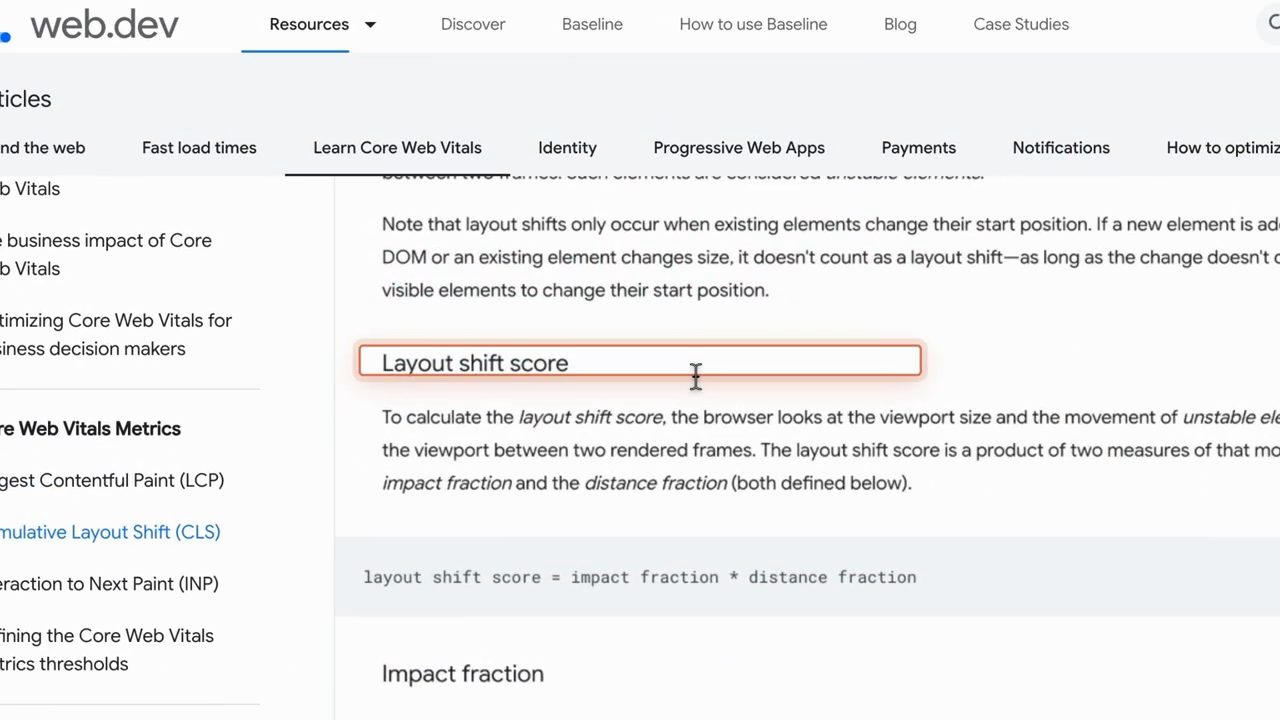
layout shift score = impact fraction * distance fraction. Trang ghi điểm CLS tốt là 0,1 trở xuống (đọc ngày 23/10/2026).AICodeKing đưa ví dụ (video đăng ngày 12/10/2026): giả sử một nút nhỏ dịch chỗ đúng lúc bạn sắp bấm vào nó. Vùng bị ảnh hưởng có thể rất nhỏ, nhưng bạn vẫn bấm nhầm. Vì vậy anh sẽ dùng bản ghi màn hình và tương tác thật bên cạnh một dashboard. Anh cũng muốn có một bài test tái hiện đúng kiểu dịch chuyển mà người dùng đã phàn nàn.
12. Benchmark phải phản ánh việc thật
Hướng dẫn riêng của Anthropic về evaluation cũng nêu một ý liên quan: các tác vụ bạn test nên phản ánh công việc bạn thật sự quan tâm. Một agent có thể cải thiện một benchmark mà không cải thiện việc dùng thật, nếu benchmark quá hẹp. Test trên những ví dụ nằm ngoài tập dùng để tối ưu giúp lộ ra điều đó. Bài viết về eval design và hill climbing trên blog claude.dev mô tả đúng cách giữ lại một tập ví dụ held-out để bắt lỗi overfitting (đọc ngày 23/10/2026).
Theo AICodeKing (video đăng ngày 12/10/2026), đó là phần anh sẽ luôn quay lại nếu anh là người quản lý công việc này. Bạn có thể làm một dashboard trông khoẻ hơn bằng cách đổi thứ được đo, hoặc bằng cách né một ca khó. Anh muốn team giải thích được một điểm số tốt hơn có ý nghĩa gì với người đang dùng sản phẩm.
13. Hơn 150 thread, feature flag và staged rollout
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), họ chạy hơn 150 thread, mỗi thread có người phụ trách, có test và có staged rollout. AICodeKing hiểu vì sao làm song song có ích khi các cuộc điều tra tách biệt nhau. Một agent có thể nghiên cứu phần khởi động trong khi một agent khác xem phần cuộn trang, nhưng nếu cả hai cùng sửa một component dùng chung thì phải có ai đó giải quyết chỗ chồng lấn. Anh dự đoán review và điều phối sẽ trở thành phần lớn hơn của công việc khi số lượng agent tăng lên.
Một feature flag cho phép team bật hoặc tắt một hành vi mà không nhất thiết phải gỡ code. Một staged rollout đưa thay đổi tới một nhóm giới hạn trước, rồi mở rộng sau khi team kiểm tra kết quả. Cách đó cho bạn cơ hội bắt lỗi trong điều kiện thật trước khi thay đổi đến với tất cả mọi người.
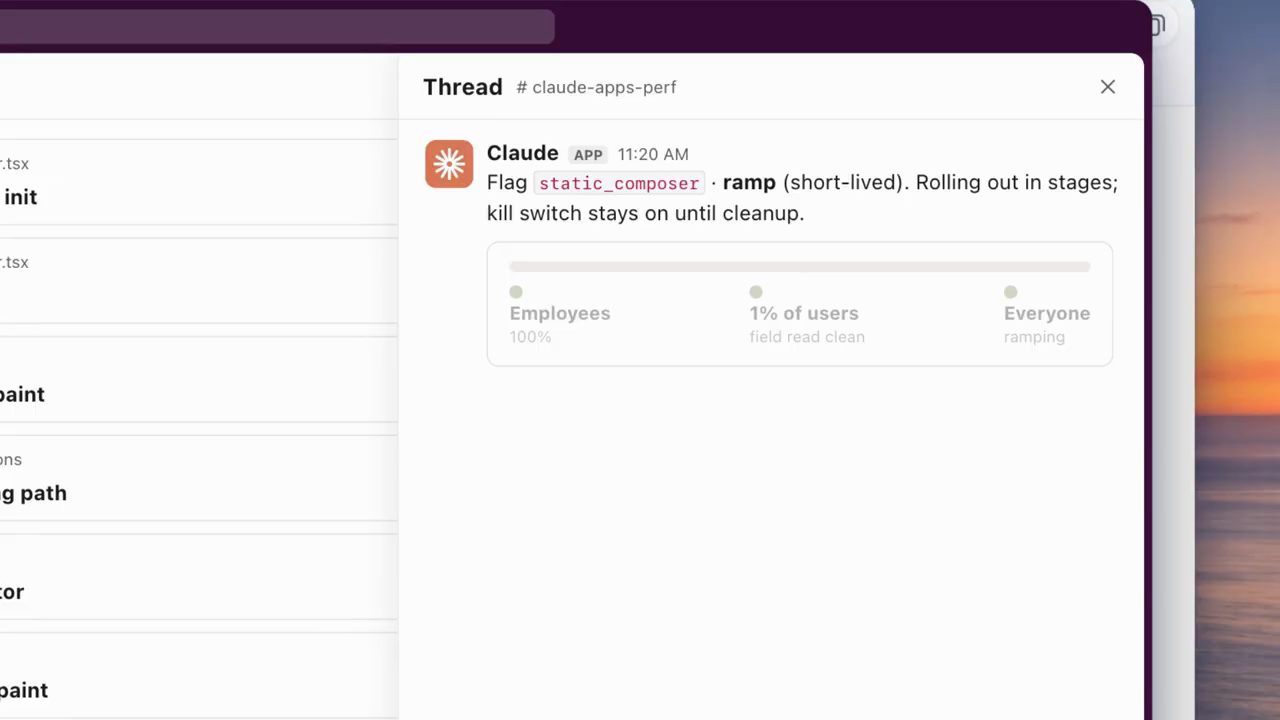
#claude-apps-perf được dựng lại trong video đăng ngày 12/10/2026: Claude báo flag static_composer là loại ramp (ngắn hạn), đang rollout theo giai đoạn, kill switch giữ nguyên tới lúc dọn dẹp. Thanh tiến trình có ba mốc: Employees 100%, 1% of users (field read clean), Everyone (ramping).14. Hơn 3.000 thay đổi và vai trò của con người
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), mọi thay đổi đều cần con người duyệt, và Anthropic báo cáo hơn 3.000 thay đổi đã được merge mà không có sự cố nào ảnh hưởng tới khách hàng, cũng không phải rollback lần nào. AICodeKing thấy đó là một kết quả đáng khích lệ cho đợt sprint này. Anh vẫn sẽ cẩn thận, không coi nó là lời hứa cho một team khác với bộ test khác và một codebase khác. Lượng hỗ trợ dựng quanh agent cũng là một phần của thứ bạn đang đánh giá ở đây.
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), các engineer của họ góp phần tham vọng (ambition), gu (taste) và định hướng (direction): đẩy để cải thiện thêm, đánh giá những thay đổi nhìn thấy được, và giữ các cuộc điều tra tập trung. AICodeKing nghĩ điều đó giao cho con người một vai trò khắt khe. Bạn cần hiểu đủ để thách thức một kết quả yếu, và đủ kiềm chế để chặn một lần viết lại không cần thiết. Anh cũng muốn có ai đó theo dõi trải nghiệm như một tổng thể, vì tối ưu từng component riêng lẻ không bảo đảm toàn bộ ứng dụng cảm thấy liền mạch.
15. Từ chối đề xuất 900 dòng để đổi lấy 2 mili giây
Theo bài viết của Anthropic (video đăng ngày 12/10/2026), họ đã từ chối một đề xuất dài 900 dòng chỉ để tiết kiệm 2 mili giây cho mỗi lần gửi tin. Cá nhân AICodeKing rất thích chi tiết này. Một cải thiện hiệu năng vẫn có chi phí bảo trì. Ai đó phải hiểu đoạn code mới khi nó hỏng, cập nhật nó khi dependency thay đổi, và quyết định xem nó có còn nên nằm đó không. Anh sẽ muốn có một lý do mạnh hơn để chấp nhận chừng đó độ phức tạp cho một khoản tiết kiệm nhỏ như vậy.
16. Thí nghiệm hiệu năng đầu tiên với agent
Theo cách AICodeKing tóm lại (video đăng ngày 12/10/2026), workflow mà Anthropic khuyến khích cho agent nhiều chỗ hơn để lặp, đồng thời làm cho bước kiểm chứng trở nên tường minh. Hướng dẫn về loop của họ cũng khuyên test trên một phần nhỏ công việc trước khi mở rộng, đặt giới hạn rõ ràng và kiểm tra lượng token đã dùng. Những chi tiết đó quan trọng nếu bạn đang trả tiền cho các lần thử lặp lại.
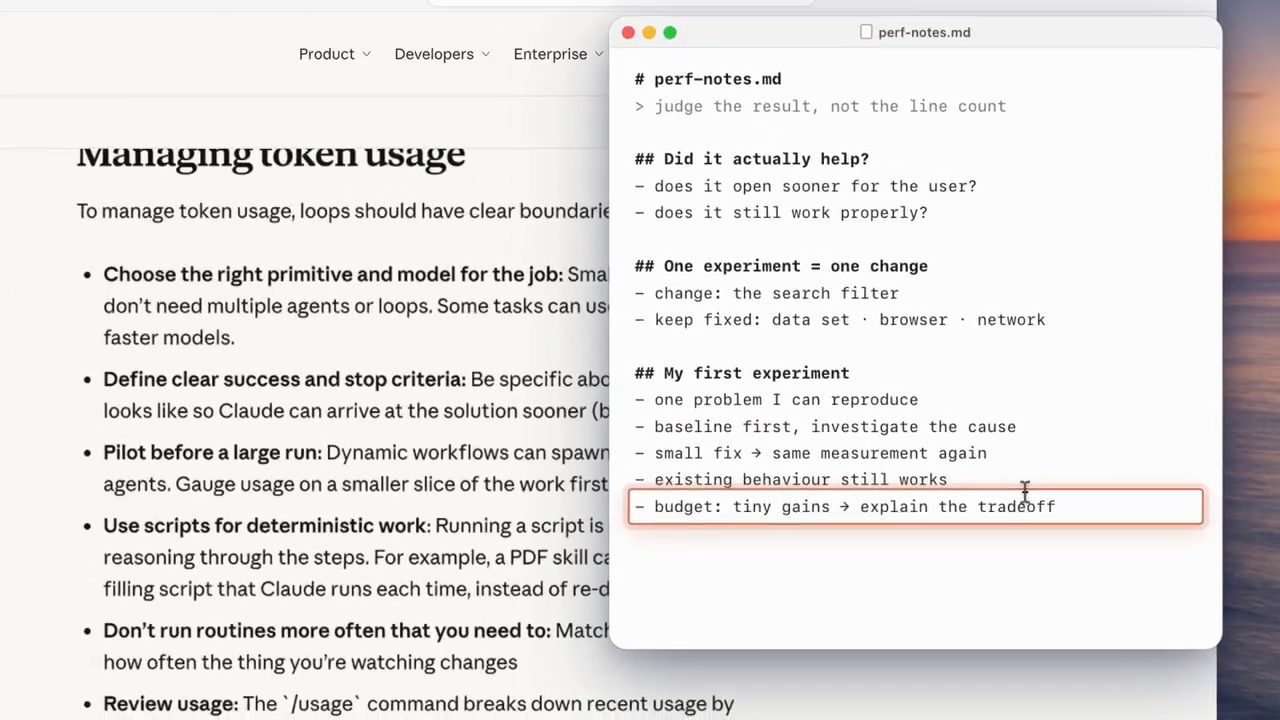
perf-notes.md của AICodeKing với mục "My first experiment", dòng cuối được tô.Với ứng dụng của riêng bạn, theo AICodeKing (video đăng ngày 12/10/2026), anh sẽ bắt đầu bằng một vấn đề tái hiện được. Bảo agent ghi lại baseline và điều tra nguyên nhân trước khi thay đổi gì. Rồi yêu cầu một bản sửa nhỏ, cùng phép đo đó sau khi sửa, và một bước kiểm tra rằng hành vi hiện có vẫn chạy. Danh sách anh ghi trong file ghi chú:
## My first experiment
- one problem I can reproduce
- baseline first, investigate the cause
- small fix → same measurement again
- existing behaviour still works
- budget: tiny gains → explain the tradeoff
Anh (video đăng ngày 12/10/2026) cũng sẽ đặt một ngân sách cho thí nghiệm đầu tiên đó. Bạn có thể tốn rất nhiều thời gian để cải thiện một thứ chẳng ai nhận ra. Nếu agent đã thử vài cách và phần cải thiện còn lại rất nhỏ, anh muốn nó giải thích sự đánh đổi trước khi làm tiếp. Nhiều hoạt động hơn không tự động làm cho dự án có giá trị hơn.
Tổng kết lại (video đăng ngày 12/10/2026), điều anh rút ra là chất lượng của phản hồi (feedback) đáng được chú ý ngang với prompt. Anh thà bỏ chút công sức làm một bài test hữu ích còn hơn cứ hỏi agent mãi xem nó có chắc là app đã nhanh hơn không. Một khi nó chỉ ra được sự khác biệt, anh có một thứ cụ thể để review, và anh có thể quyết định phần cải thiện đó có đáng giữ hay không.
Nhìn chung, anh thấy việc này khá hay. Cuối video, anh mời người xem để lại suy nghĩ trong phần bình luận và hẹn gặp lại ở video sau.
Nguồn và liên kết 13 nguồn
- Tên gốc: Claude's OFFICIAL ENGINEER Mode: The Loop Anthropic Engineer Uses Themselves!
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=0UQme-kv6zg youtube.com
- Kênh YouTube AICodeKing (AICodeKing): youtube.com/channel/UC0m81bQuthaQZmFbXEY9QSw youtube.com
- Bài viết của Anthropic "How we made claude.ai 3x faster in two weeks", đăng ngày 23/09/2026 (đọc ngày 23/10/2026): claude.dev/blog/how-we-made-claude-ai-faster claude.ai
- Hướng dẫn "Getting started with loops" của Claude, gồm mục Managing token usage (đọc ngày 23/10/2026): claude.com/resources/articles/getting-started-with-loops claude.com
- Trang sản phẩm Claude Tag (đọc ngày 23/10/2026): claude.com/product/tag claude.com
- Bài viết "Automating eval design and hillclimbing with Claude", đăng ngày 28/09/2026 (đọc ngày 23/10/2026): claude.dev/blog/automating-eval-design-and-hillclimbing claude.dev
- Valgrind User Manual, chương Callgrind (đọc ngày 23/10/2026): valgrind.org/docs/manual/cl-manual.html valgrind.org
- Tài liệu React về
memo(đọc ngày 23/10/2026): react.dev/reference/react/memo react.dev - MDN, Using Web Workers (đọc ngày 23/10/2026): developer.mozilla.org/.../Using_web_workers developer.mozilla.org
- web.dev, Cumulative Layout Shift (CLS) (đọc ngày 23/10/2026): web.dev/articles/cls web.dev
- web.dev, Why lab and field data can be different (đọc ngày 23/10/2026): web.dev/articles/lab-and-field-data-differences web.dev
Related talks
Playbook AI-native SDLC của Anthropic với Claude Code
Eric Tech · Eric Tech · 21 min
Đi qua playbook AI-native SDLC của Anthropic: intent.md, spec.md, plan.md, TDD và feedback loop, eval trong CI, review PR, hook, deploy và metrics.
Cho Opus 5.5 build cùng một app ở mọi mức effort
Nate Herk · Nate Herk | AI Automation · 27 min
Cùng một prompt dựng hội nghị 3D, chạy Opus 5.5 ở sáu mức effort rồi so chất lượng, thời gian, chi phí API, token và số check (video 24/09/2026).
15 bài học sau hơn 1.000 giờ dùng Claude Code
Nick Saraev · Nick Saraev · 26 min
Mười lăm mẹo dùng Claude Code của Nick Saraev: eval, tự kiểm tra, quản lý context window, MCP sang skill, task song song, handoff note, /btw, fan out và CLAUDE.md.