Context rot: vì sao agent bỏ sót fact quan trọng
Vì sao prompt càng dài model càng đọc kém (context rot), nghiên cứu nói gì, ba cách đo trong app của bạn và năm cách cắt bớt context.
✓ Đã duyệt độc lập · cập nhật 02/11/2026 · 10 min
1. Con bot help desk và câu "Annual plan" ở tin nhắn số 3
Vishesh mở đầu bằng một tình huống minh hoạ (video đăng ngày 31/10/2026): một con bot help desk gửi lại toàn bộ cuộc hội thoại ở mỗi lượt. Tới lúc này đã có 40 tin nhắn. Ở tin nhắn số 3, khách hàng đã nói: "Annual plan" (gói năm). Giờ chị ấy muốn hoàn tiền. Con bot lại trích chính sách của gói tháng.
Theo Vishesh (video đăng ngày 31/10/2026), fact đó nằm ngay trong context. Chỉ là model không dùng tới nó.
Sau đó anh chào người xem, giới thiệu mình là Vishesh, và nói hôm nay sẽ cùng xem vì sao context dài lại gây hại, và cách cắt bớt nó (video đăng ngày 31/10/2026).
2. Context là gì, và nước đi dễ dãi: dán hết vào
Trước hết, context là gì? Theo Vishesh (video đăng ngày 31/10/2026), đó là mọi thứ model đọc trong một lần gọi (one call): system prompt, cuộc chat tới lúc đó, kết quả của tool, tài liệu, tất cả.
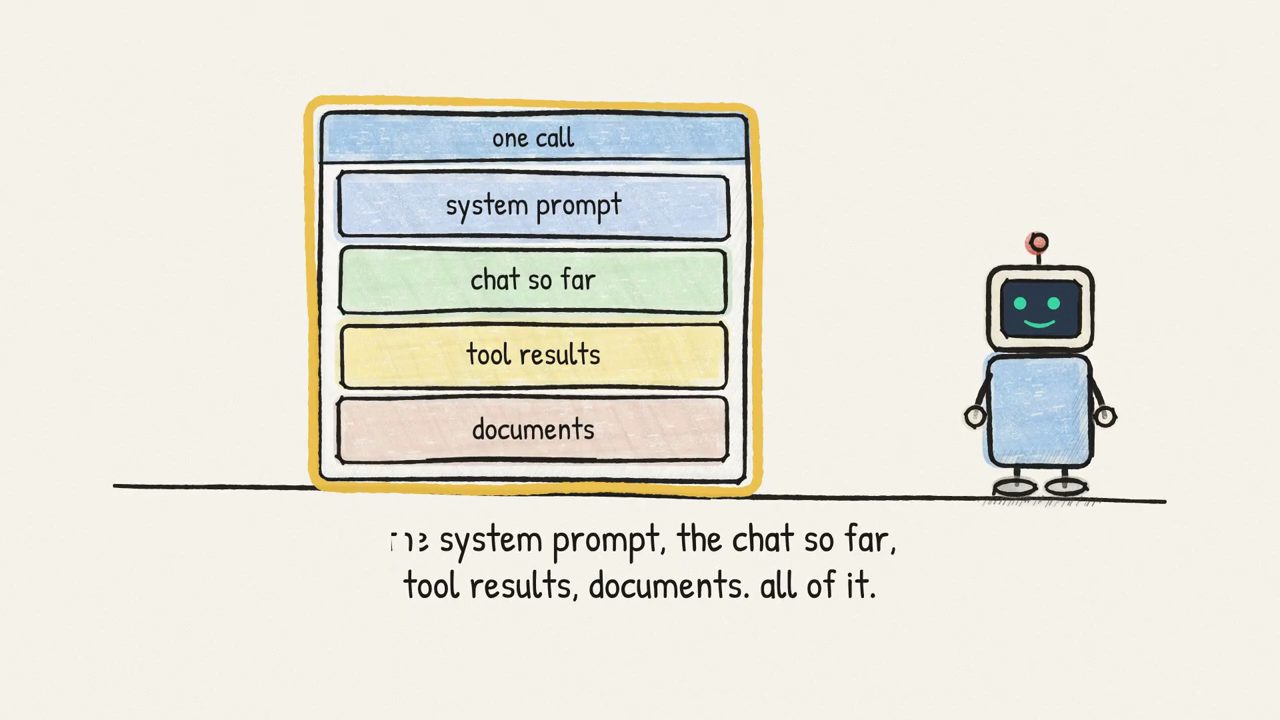
Và theo anh (video đăng ngày 31/10/2026), model không hề nhớ lượt trước. Cả đống đó được gửi lại từ đầu, ở mọi lần gọi.
Trong khi đó, anh nói các context window đã trở nên rất lớn: tính đến lúc video đăng ngày 31/10/2026, một số model nhận tới hàng triệu token. Vì vậy nước đi dễ dãi là dán hết vào: 100 trang tài liệu, các ticket của cả một năm. Nó vừa, thế là cứ thế ship. Anh ví nó như một ngăn kéo đồ linh tinh (junk drawer): về mặt kỹ thuật, mọi thứ đều nằm trong đó.
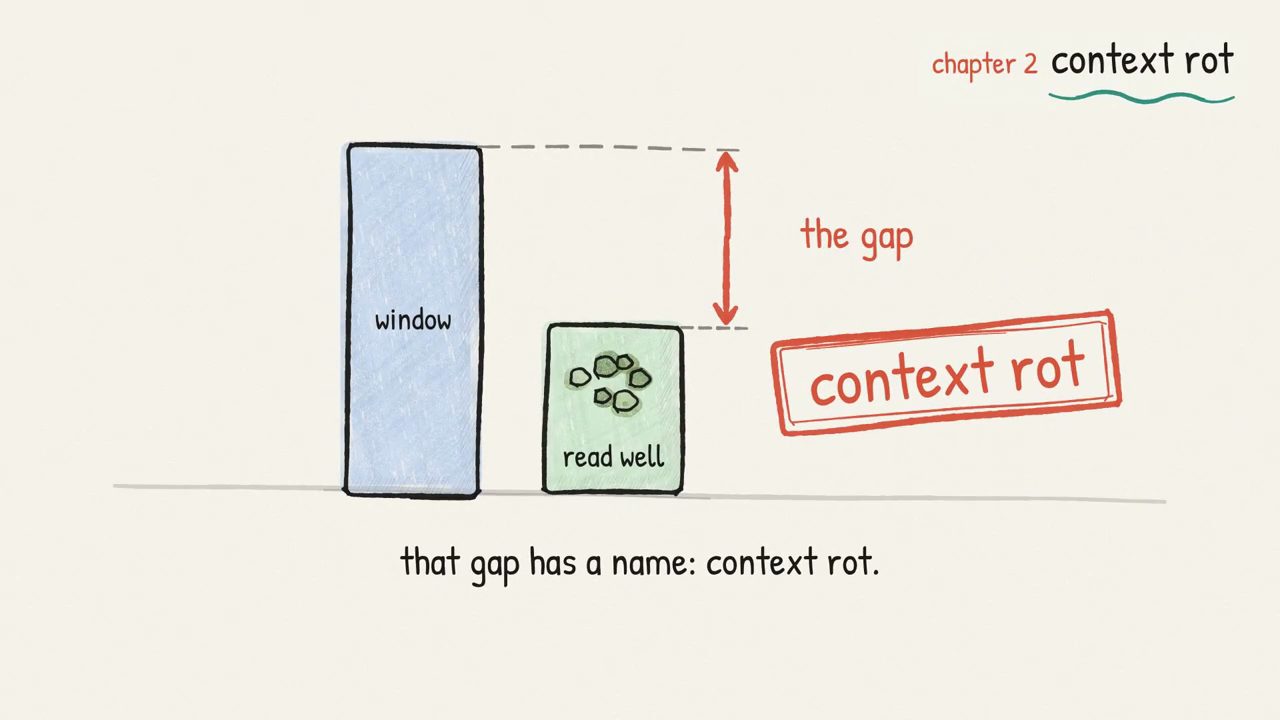
Nhưng theo Vishesh (video đăng ngày 31/10/2026), "vừa với window" và "được đọc tốt" là hai chuyện khác nhau. Theo ý kiến của anh, kích thước window là con số gây hiểu lầm nhiều nhất trên bảng thông số của một model.
3. Context rot: vừa window khác với được đọc tốt
Khoảng cách giữa hai thứ đó có một cái tên: context rot. Vishesh định nghĩa (video đăng ngày 31/10/2026): bạn gửi càng nhiều token, model càng nhớ lại kém chính xác bất kỳ token nào trong số đó.
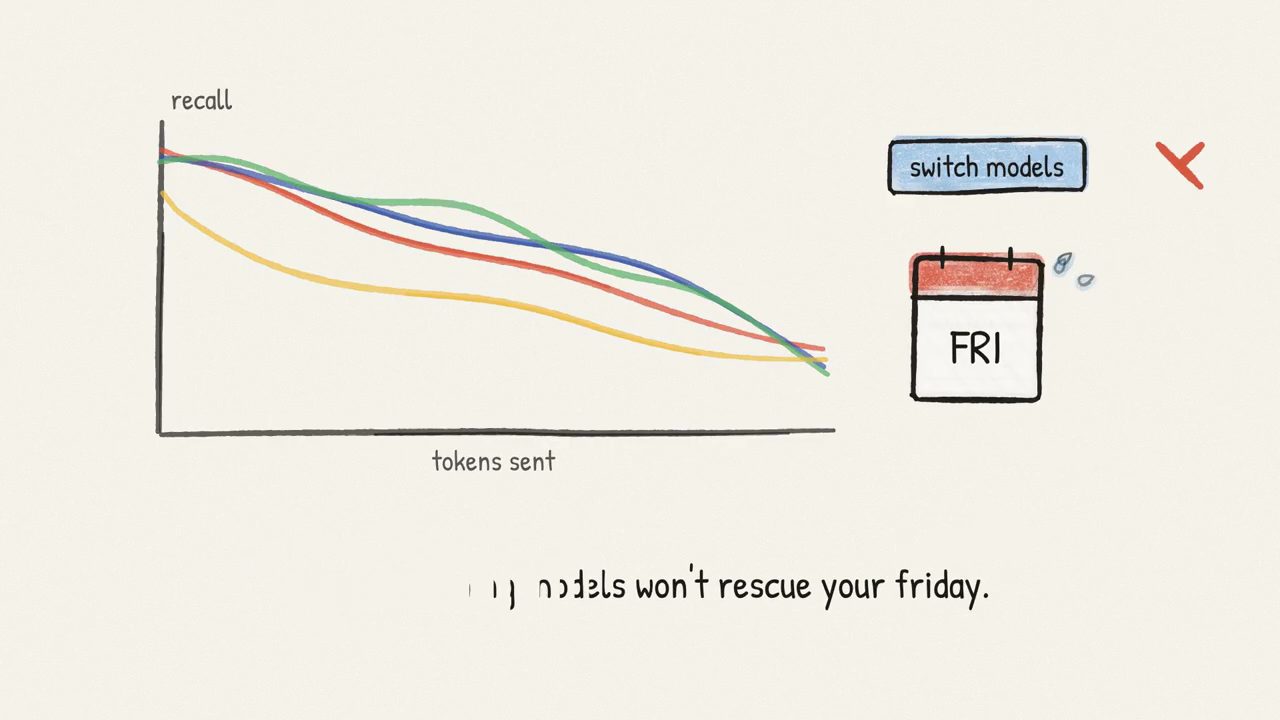
Theo anh (video đăng ngày 31/10/2026), đây không phải lỗi của một model tệ. Nó xuất hiện ở mọi model. Nên không, đổi model sẽ không cứu được ngày thứ Sáu của bạn.
4. Attention budget: vì sao prompt dài bị đọc kém
Để hình dung vì sao, Vishesh dùng cách giải thích của Anthropic (video đăng ngày 31/10/2026). Trong một transformer, mọi token đều có thể nhìn tới mọi token khác. Gấp đôi số token thì số cặp cần cân nhắc tăng khoảng bốn lần. Vì vậy attention bị kéo mỏng ra trên mọi thứ bạn đã dán vào. Ngoài ra, theo anh, model học phần lớn từ các đoạn văn bản ngắn hơn, nên input rất dài là vùng đất ít quen thuộc hơn với chúng. Bài viết của Anthropic về context engineering (đăng ngày 29/09/2025, đọc ngày 02/11/2026) ghi hai ý này: n² cặp quan hệ cho n token, và các mẫu attention được học từ dữ liệu huấn luyện nơi chuỗi ngắn thường phổ biến hơn chuỗi dài.
Theo Vishesh (video đăng ngày 31/10/2026), hãy nghĩ về nó như một attention budget (ngân sách attention). Mỗi token bạn thêm vào tiêu đi một chút ngân sách đó. Anh nói anh thích hình ảnh này vì nó biến mỗi dòng bạn dán vào thành một khoản chi phí.
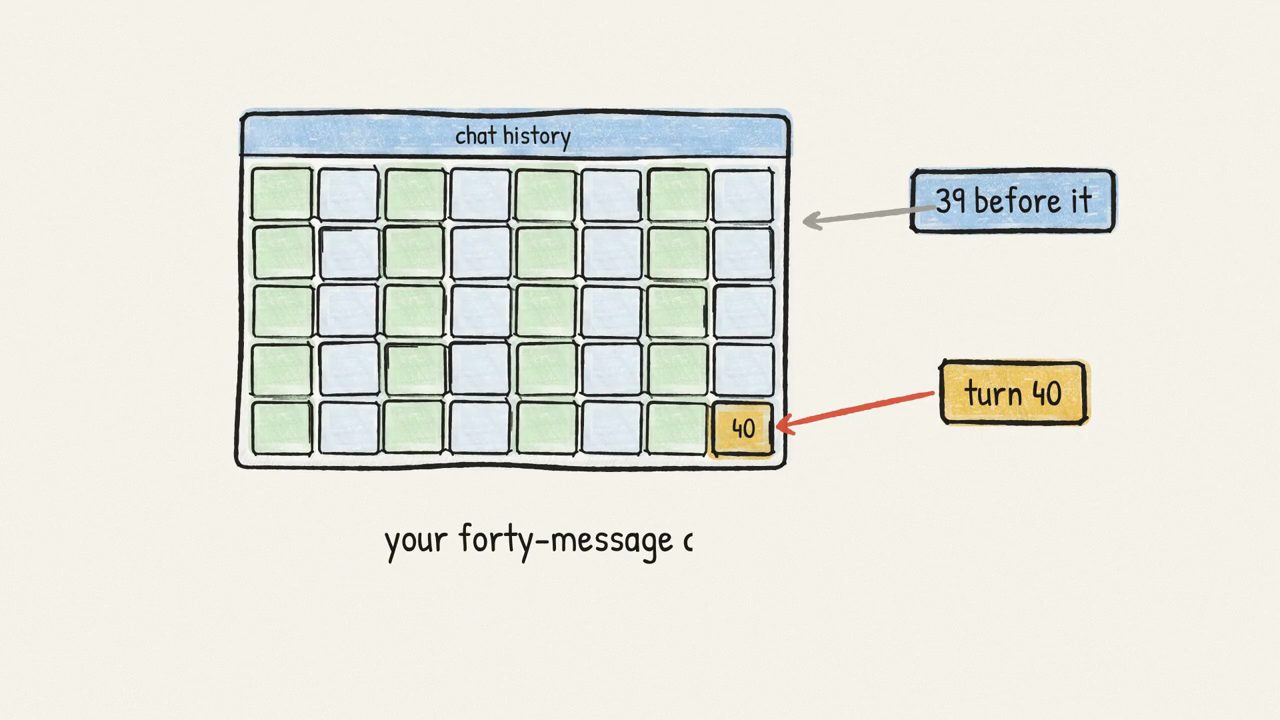
Và theo anh (video đăng ngày 31/10/2026), đống context chỉ có lớn dần. Lượt thứ 40 mang theo cả 39 tin nhắn trước nó. Cuộc chat 40 tin nhắn của bạn không miễn phí: nó là một khoản thuế đánh lên từng câu trả lời.
5. Bằng chứng: Chroma và NoLiMa
Giờ tới bằng chứng. Theo Vishesh (video đăng ngày 31/10/2026), năm 2025 nhóm nghiên cứu của Chroma đã kiểm tra 18 model về chuyện này (báo cáo "Context Rot", tháng 7/2025). Mẹo của họ: giữ nguyên hoàn toàn nhiệm vụ, chỉ thay đổi độ dài của input. Hiệu năng giảm khi input dài ra, kể cả với những nhiệm vụ đơn giản.
Và theo anh (video đăng ngày 31/10/2026, dẫn báo cáo Chroma 2025), nó không giảm theo một đường thẳng gọn gàng. Nó chập chờn như một flaky test, và mỗi model hỏng theo một kiểu riêng.
Một bài test trong báo cáo Chroma (2025) rất giống con bot hỗ trợ trong ví dụ, theo Vishesh (video đăng ngày 31/10/2026): các lịch sử chat dài, và một câu hỏi về chúng. Version 1 chỉ nhận các tin nhắn liên quan, khoảng 300 token. Version 2 nhận toàn bộ lịch sử, khoảng 113 nghìn token. Cùng một câu hỏi, và đáp án có mặt trong cả hai.
Theo Vishesh (video đăng ngày 31/10/2026), mọi model mà nhóm Chroma kiểm tra đều làm tốt hơn rõ rệt ở bản ngắn. Vì sao? Với toàn bộ lịch sử, model phải làm hai việc: tìm đúng phần cần đọc, rồi lập luận trên phần đó.
Một nghiên cứu khác, NoLiMa (2025), kiểm tra 13 model công bố hỗ trợ ít nhất 128 nghìn token. Theo Vishesh (video đăng ngày 31/10/2026, dẫn NoLiMa 2025), ở mức 32 nghìn token, 11 model trong số đó rơi xuống dưới một nửa điểm số mà chính chúng đạt được với prompt ngắn.
Vậy cái context window một triệu token đó? Theo Vishesh (video đăng ngày 31/10/2026), nó giống một phòng chờ một triệu token hơn.
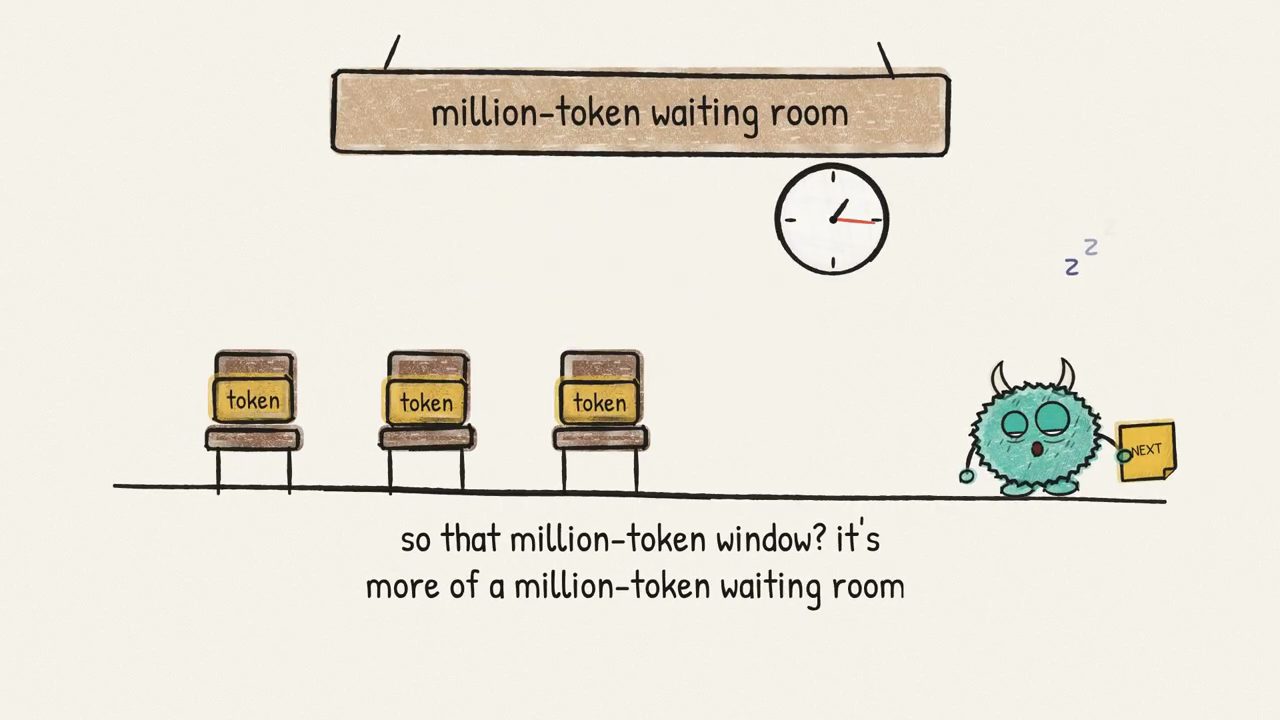
Điều Vishesh rút ra từ đó (video đăng ngày 31/10/2026): đừng tin vào kích thước window. Hãy test đúng độ dài mà bạn thực sự gửi đi.
6. Distractor: đoạn trông giống đáp án nhưng không phải
Quay lại con bot: hãy nhìn thứ nó đã trích, chính sách của gói tháng. Theo Vishesh (video đăng ngày 31/10/2026), đó là một distractor: một đoạn văn bản cùng chủ đề, trông giống đáp án, nhưng không phải.
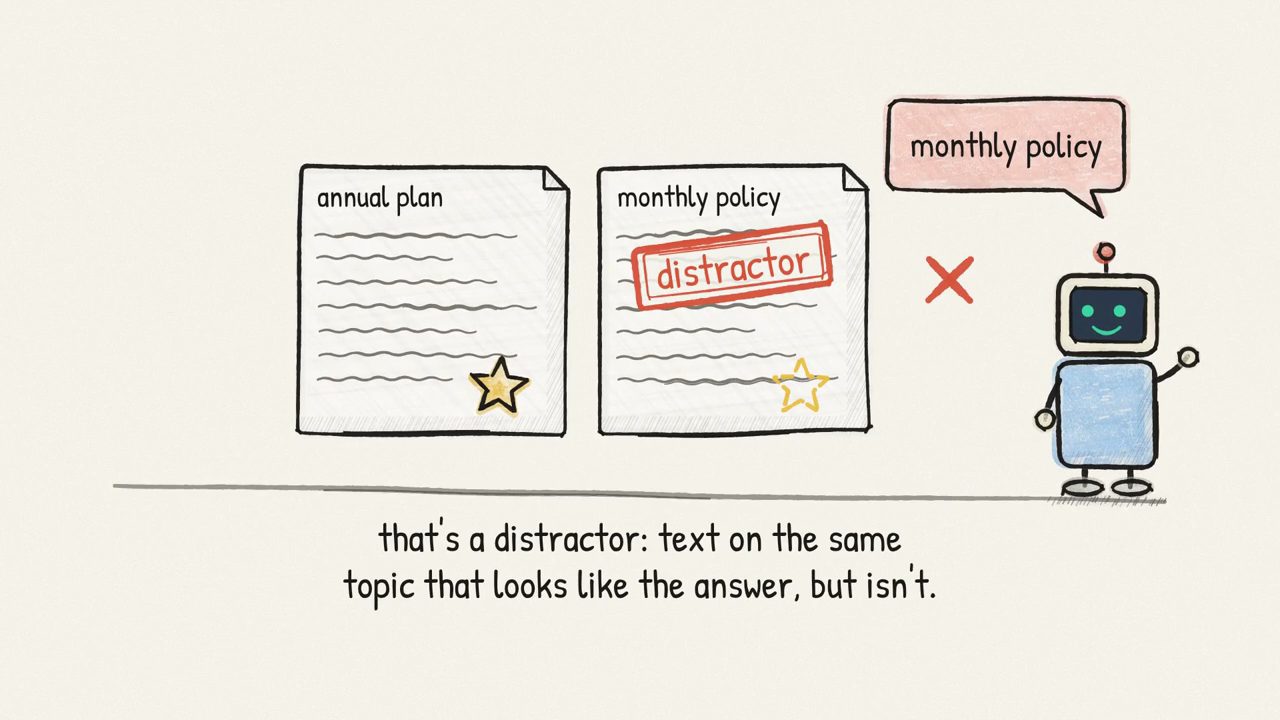
Theo Vishesh (video đăng ngày 31/10/2026, dẫn báo cáo Chroma 2025), Chroma thấy rằng chỉ cần một distractor cũng làm giảm độ chính xác. Bốn distractor làm nó giảm thêm. Và input càng dài, các distractor đó càng gây hại nhiều hơn.
Theo anh (video đăng ngày 31/10/2026), model thất bại theo hai kiểu. Một số model nói rằng chúng không tìm thấy đáp án. Số khác trả lời đầy tự tin, và sai. Giống con bot trong ví dụ.
Theo Vishesh (video đăng ngày 31/10/2026), các cuộc chat dài đầy distractor: những gói cũ, những đơn hàng đã huỷ, cái bug bạn sửa hôm qua. Vì vậy anh sẽ xoá các fact đã cũ chứ không chỉ thêm fact mới. Một fact đã thay đổi có thể trở thành một cái bẫy. Anh ví context của bạn như một group chat: đáp án sai lúc nào cũng có nhiều tin nhắn hơn.
7. Lost in the middle, và cách sắp xếp prompt
Câu hỏi tiếp theo: fact đó nằm ở đâu trong prompt? Theo Vishesh (video đăng ngày 31/10/2026), một bài báo năm 2023, "Lost in the Middle" (Liu và cộng sự), đã di chuyển đáp án tới nhiều vị trí khác nhau bên trong các prompt dài. Ví dụ bạn dán vào 20 bài viết help, và quy định hoàn tiền nằm ở bài số 10.
Theo anh (video đăng ngày 31/10/2026, dẫn bài báo 2023), các model làm tốt nhất khi đáp án nằm ở ngay đầu hoặc ngay cuối. Ở giữa, độ chính xác chùng xuống. Vẽ ra thì đường cong trông như chữ U. Trong một thiết lập, model có đáp án nằm ở giữa còn làm kém hơn so với khi không có tài liệu nào. Đưa đáp án cho nó lại làm nó tệ đi. Vishesh nói thêm: "Peak engineering."
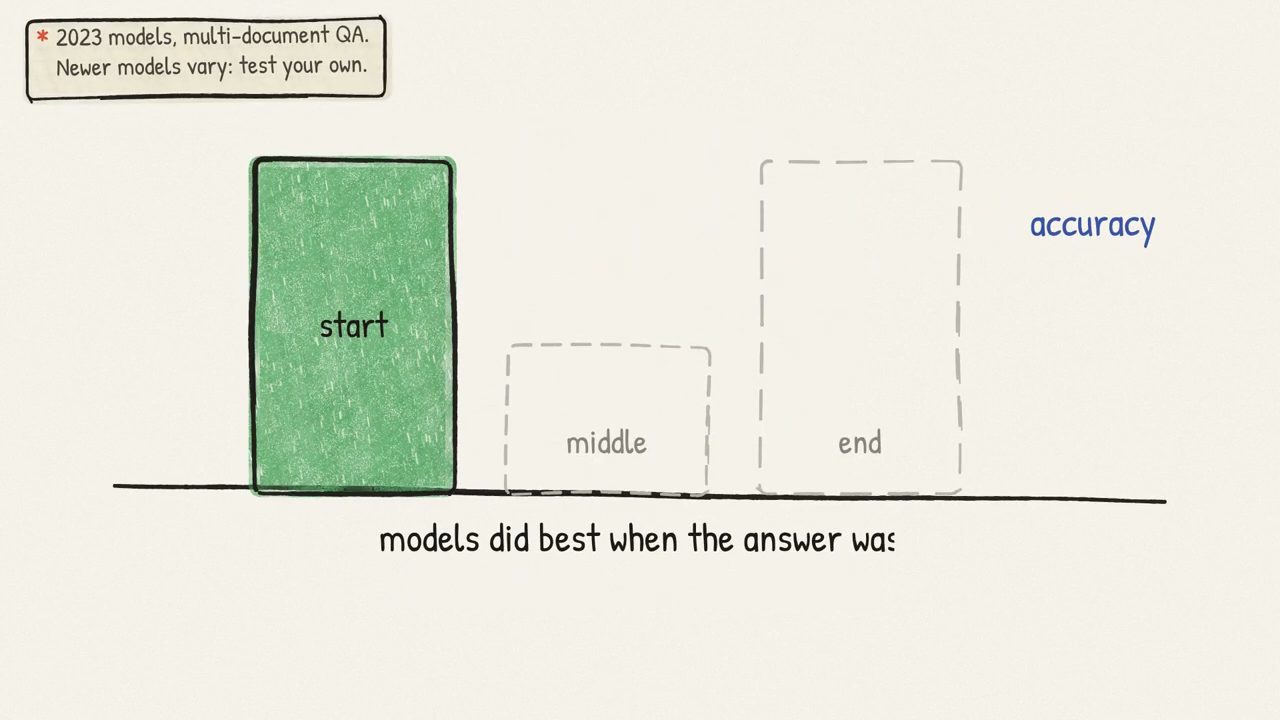
Theo Vishesh (video đăng ngày 31/10/2026), các model mới hơn thì mỗi cái một khác. Khi Chroma (2025) giấu một fact đơn giản trong phần văn bản độn, vị trí của nó không ảnh hưởng gì. Vì vậy hãy test model của bạn.
Theo anh (video đăng ngày 31/10/2026), cách sửa rẻ là bố cục: tài liệu dài đặt ở trên cùng, câu hỏi của bạn đặt ở cuối. Anh dẫn hướng dẫn viết prompt của Anthropic: câu hỏi đặt ở cuối có thể cải thiện câu trả lời tới 30%. Trang prompting best practices của Claude (đọc ngày 02/11/2026) ghi rằng query ở cuối có thể cải thiện chất lượng phản hồi tới 30 percent trong các bài test, nhất là với input phức tạp, nhiều tài liệu.
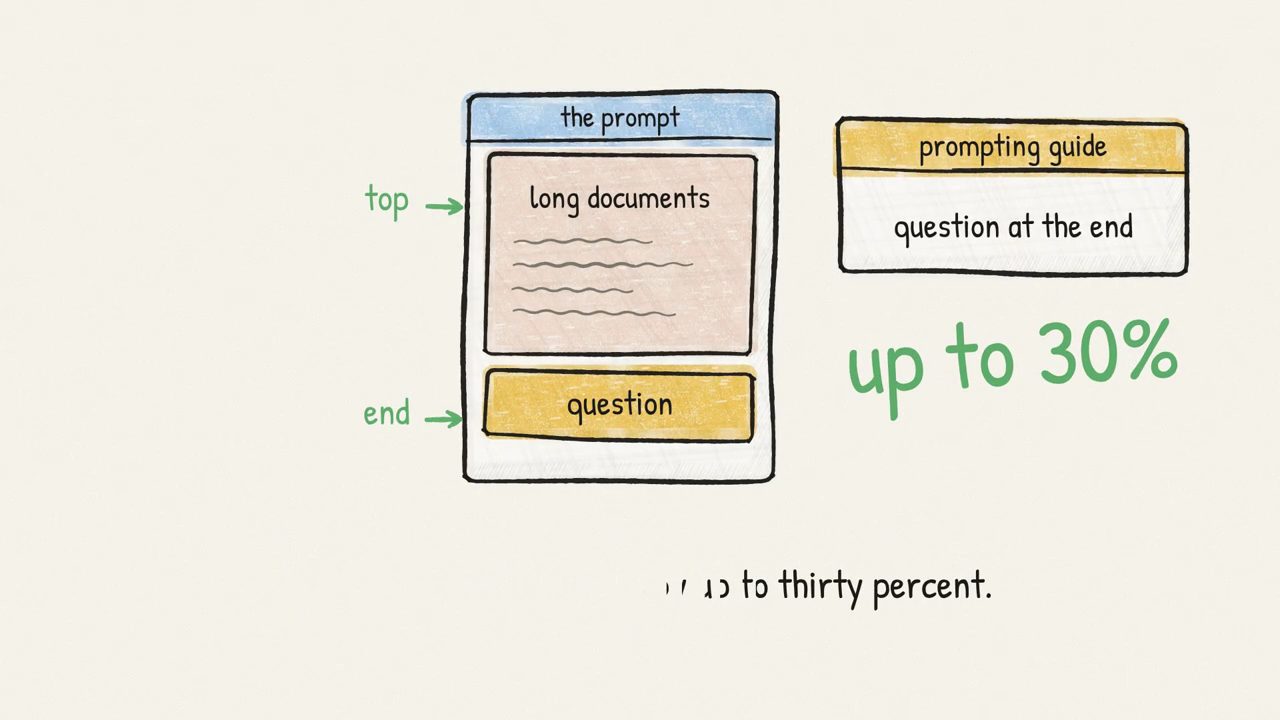
Theo Vishesh (video đăng ngày 31/10/2026), tới 30% chỉ nhờ một lần cắt và dán. Anh nói đây là kiểu cách sửa anh thích nhất.
Với con bot trong ví dụ, Vishesh nói anh sẽ đặt các fact quan trọng về khách hàng trong một khối ngắn, ngay phía trên câu hỏi (video đăng ngày 31/10/2026). Và anh sẽ yêu cầu model trích ra những dòng nó đang dùng trước khi trả lời. Trang best practices của Claude (đọc ngày 02/11/2026) cũng có mục "Ground responses in quotes": với tài liệu dài, yêu cầu Claude trích các phần liên quan trước khi làm nhiệm vụ.
Vậy làm sao biết app của chính bạn có context rot hay không?
8. Đo context rot trong app của bạn: ba phép kiểm tra
Bạn đo nó. Vishesh đưa ra ba phép kiểm tra (video đăng ngày 31/10/2026).
1. Log số input token của mỗi lần gọi. Theo Vishesh (video đăng ngày 31/10/2026), endpoint token counting của Anthropic miễn phí; trang token counting của Claude (đọc ngày 02/11/2026) ghi rằng token counting miễn phí nhưng có giới hạn số request mỗi phút theo usage tier. Vẽ con số đó theo số thứ tự lượt chat. Theo anh, trong một cuộc chat gửi lại mọi thứ, đường này chỉ đi lên.
2. Một needle test, như trong "needle in a haystack" (mò kim đáy bể). Theo Vishesh (video đăng ngày 31/10/2026), bạn giấu một fact mà app bắt buộc phải tìm ra, ví dụ: "this customer is on the annual plan" (khách hàng này đang dùng gói năm). Chôn nó trong phần chat độn lấy từ dữ liệu thật. Thử ba kích thước: 2 nghìn, 20 nghìn và 100 nghìn token. Và ba vị trí đặt fact: đầu, giữa và cuối.
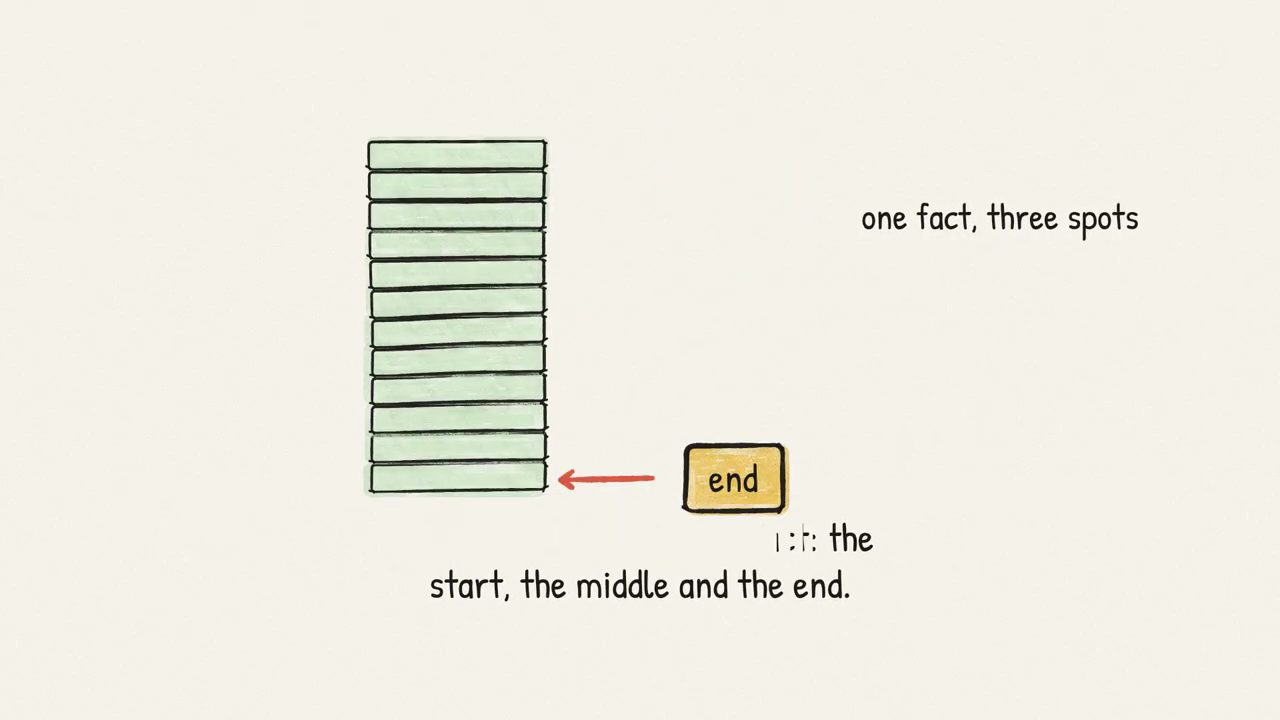
Theo anh (video đăng ngày 31/10/2026), mỗi lần hỏi cùng một câu hỏi và chấm điểm. Chín prompt, một bảng nhỏ. Các model lớn làm needle test cổ điển rất tốt. Nhưng bài test đó chủ yếu so khớp đúng từ ngữ. Vì vậy hãy diễn đạt fact khác với câu hỏi. Ví dụ anh đưa là "annual plan" đặt cạnh một cách nói khác về cùng ý, có cụm "once a year".
3. Một bài test focused so với full trên eval set của bạn. Theo Vishesh (video đăng ngày 31/10/2026), đây là ý tưởng của Chroma, áp dụng lên dữ liệu của bạn. Chạy mỗi câu hỏi hai lần: một lần chỉ với các tin nhắn liên quan, một lần với tất cả. Nếu bản focused thắng rõ rệt, bạn đã tìm thấy context rot của mình. Và cả sprint tiếp theo của bạn.
Theo Vishesh (video đăng ngày 31/10/2026), anh sẽ bắt đầu với phép kiểm tra số 2. Nó tốn một buổi chiều làm việc, và nó chấm dứt các cuộc tranh cãi. Trên hình minh hoạ lúc đó, số 2 được gắn ngôi sao, cạnh chiếc đồng hồ, chữ "an afternoon" và hai bong bóng thoại "tabs!" và "spaces!".
9. Cắt bớt context: năm nước đi
Vậy nên cắt bớt cái gì? Theo Vishesh (video đăng ngày 31/10/2026), mục tiêu là tập token nhỏ nhất mà vẫn làm xong việc. Bài viết context engineering của Anthropic (2025, đọc ngày 02/11/2026) cũng nói về "the smallest possible set of high-signal tokens". Anh đưa ra năm nước đi (move).
Move 1: Retrieve, đừng dán. Theo Vishesh (video đăng ngày 31/10/2026), giữ lại các con trỏ (pointer), như đường dẫn file hay ID của ticket. Agent chỉ nạp nội dung thật khi một bước nào đó cần tới. Với con bot trong ví dụ, đó là một search tool chạy trên các ticket cũ, thay vì dán mọi ticket vào. Trên hình minh hoạ, con trỏ là nhãn docs/refund.md, và dòng chữ ghi agent nạp nội dung thật.
Move 2: Xoá kết quả tool cũ. Theo anh (video đăng ngày 31/10/2026), một kết quả search từ lượt 3 đã là nhiễu khi tới lượt 30.
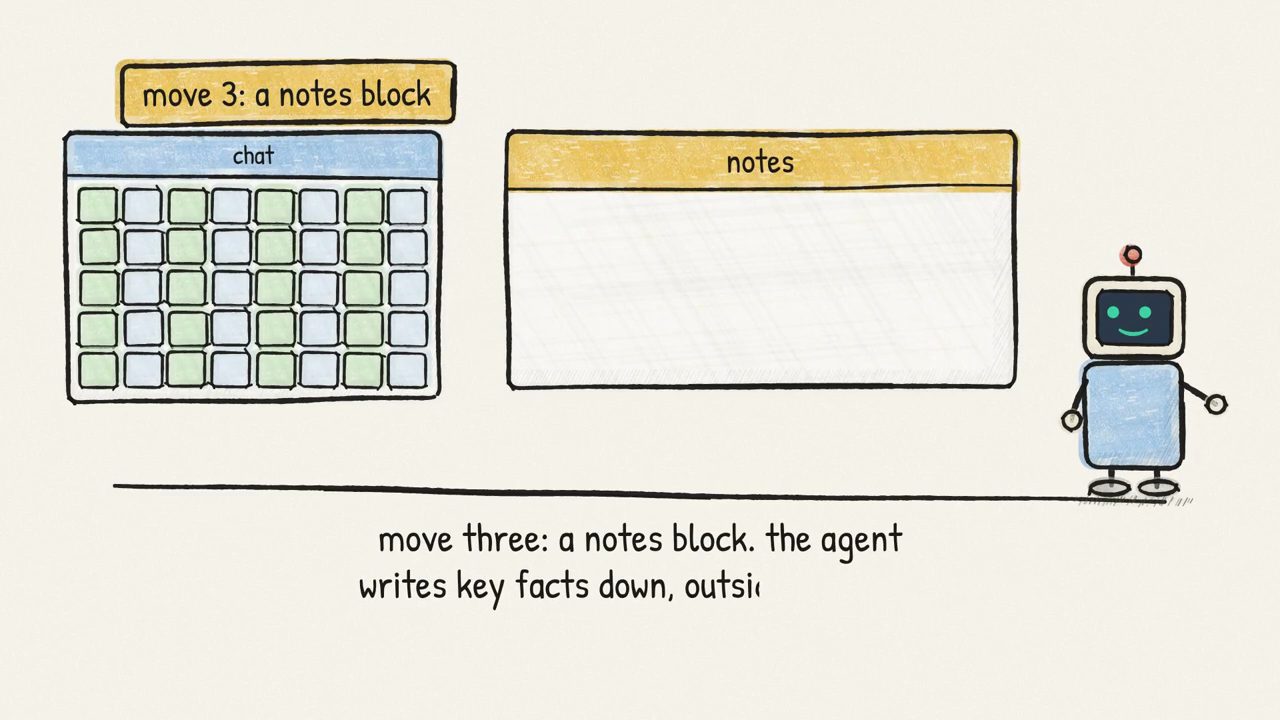
Move 3: Một notes block. Theo Vishesh (video đăng ngày 31/10/2026), agent ghi các fact quan trọng ra một chỗ riêng, bên ngoài cuộc chat. Với con bot: plan, annual; đơn hàng gần nhất, bộ tai nghe màu xanh. Nó đọc ghi chú này, không đọc 40 tin nhắn. Khi một fact thay đổi, cập nhật ghi chú. Fact cũ biến mất, nên nó không thể gây nhiễu được nữa.
Move 4, cho những lần chạy rất dài: compact. Theo anh (video đăng ngày 31/10/2026), tóm tắt lại, rồi chạy tiếp trong một window mới. Cái giá phải trả? Một bản tóm tắt có thể làm rơi đúng chi tiết bạn cần, nên anh sẽ giữ cả notes block.
Move 5: Giao phần đào bới lớn cho một sub-agent có window sạch của riêng nó. Theo Vishesh (video đăng ngày 31/10/2026), sub-agent có thể đọc hàng chục nghìn token rồi gửi lại một bản tóm tắt chừng một hoặc hai nghìn token. Bài viết của Anthropic (2025, đọc ngày 02/11/2026) mô tả cùng con số: mỗi subagent có thể dùng hàng chục nghìn token nhưng chỉ trả về bản tóm tắt thường 1.000 đến 2.000 token.
10. Window to hơn không cứu được, và phần tóm lại
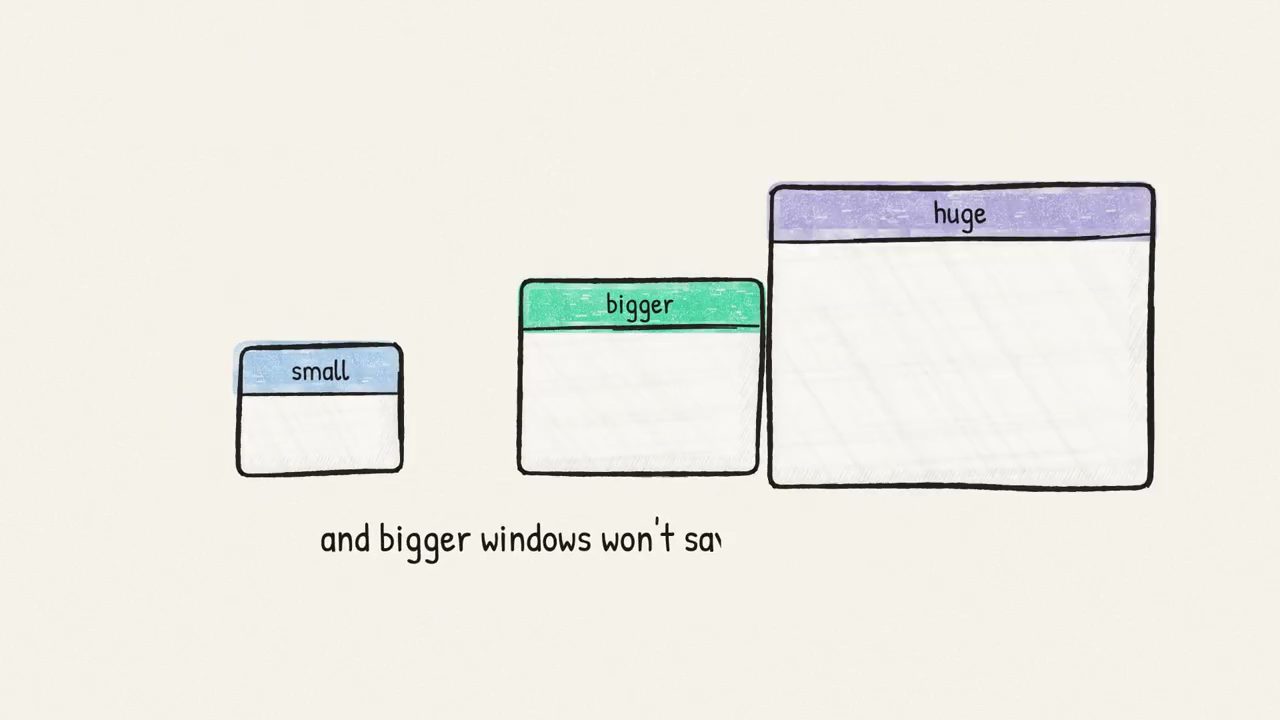
Theo Vishesh (video đăng ngày 31/10/2026), window to hơn sẽ không cứu được bạn. Anthropic cho rằng window ở mọi kích thước đều sẽ gặp vấn đề này. Bài viết context engineering của Anthropic (đăng ngày 29/09/2025, đọc ngày 02/11/2026) ghi rằng nhiều khả năng trong tương lai gần, context window ở mọi kích thước vẫn sẽ chịu vấn đề ô nhiễm context và độ liên quan của thông tin.
Nếu phải chọn một nước đi, Vishesh chọn notes block (video đăng ngày 31/10/2026). Theo anh, nó sửa được cái bẫy fact cũ. Anh ví việc cắt bớt context như dọn bàn làm việc: chẳng ai làm cho tới khi có thứ gì quan trọng bị thất lạc.
Tóm lại, theo Vishesh (video đăng ngày 31/10/2026), context rot là: càng nhiều token, khả năng nhớ lại càng kém, vì attention bị trải mỏng. Distractor và các fact bị vùi sâu làm nó tệ hơn. Đo nó bằng một needle test và một lần chạy focused. Rồi cắt bớt. Còn con bot trong ví dụ? Giờ nó đọc một ghi chú, ghi "annual plan".
Phần của hôm nay đến đây là hết.
Nguồn và liên kết 11 nguồn
- Tên gốc: Context Rot Explained: Why Your Agent Misses the Key Fact
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=ohAjFMv-m2Y youtube.com
- Kênh YouTube doodle-monster (Vishesh Baghel): youtube.com/channel/UCp3DKQ8GkhoH9PmnuIitbtA youtube.com
- Chroma, báo cáo kỹ thuật "Context Rot: How Increasing Input Tokens Impacts LLM Performance" (14/07/2025; 18 LLM, thí nghiệm distractor, LongMemEval focused so với full khoảng 113 nghìn token; đọc ngày 02/11/2026): research.trychroma.com/context-rot research.trychroma.com
- Liu và cộng sự, "Lost in the Middle: How Language Models Use Long Contexts" (arXiv 2307.03172, 2023; đọc ngày 02/11/2026): arxiv.org/abs/2307.03172 arxiv.org
- NoLiMa (arXiv 2502.05167, 2025; 13 LLM hỗ trợ ít nhất 128K token, ở 32K có 11 model rơi xuống dưới 50% mức điểm ngắn; đọc ngày 02/11/2026): arxiv.org/abs/2502.05167 arxiv.org
- Anthropic, "Effective context engineering for AI agents" (29/09/2025; attention budget, just-in-time context, compaction, ghi chú có cấu trúc, sub-agent; đọc ngày 02/11/2026): anthropic.com/engineering/effective-context-engineering-for-ai-agents anthropic.com
- Claude docs, prompting best practices (mục long context: tài liệu dài ở trên, query ở cuối, trích dẫn trước khi trả lời; đọc ngày 02/11/2026): platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices platform.claude.com
- Claude docs, working with messages (Messages API là stateless, luôn gửi toàn bộ lịch sử hội thoại; đọc ngày 02/11/2026): platform.claude.com/docs/en/build-with-claude/working-with-messages platform.claude.com
- Claude docs, token counting (đọc ngày 02/11/2026): platform.claude.com/docs/en/build-with-claude/token-counting platform.claude.com
Related talks
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
20 khái niệm nền tảng để build AI agent production, kèm code
Maryam Miradi · Dr. Maryam Miradi · 26 min
20 khái niệm AI agent qua năm layer: agent loop, planning, memory, sandbox, tool retrieval, multi-agent, guardrails, eval, prompt injection, tracing, mỗi cái kèm code.
Giải thích Harness²: agent tự cải tiến harness mà không cần train
Muhammad Farooq · Prompt Engineering · 12 min
Harness² cho agent tự sửa skill, script, sub-agent và hook trong control loop qua vòng Propose, Probe, Compose, kèm kết quả và chỗ gãy.