Các tầng delegation model trong Hermes Agent
Cách route model trong Hermes Agent: auxiliary models, model routes fast/balanced/deep với Advanced Delegation plugin, profile routes và Kanban.
✓ Đã duyệt độc lập · cập nhật 01/11/2026 · 32 min
1. Vì sao không dùng một model cho mọi việc
Callum Lootsma (kênh Wanderloots) mở đầu bằng kết quả: sau khi dùng Advanced Delegation plugin, anh đã dựng được ba model route khác nhau, và các route này có thể được tự động áp cho subagent mỗi khi anh dùng delegation trong Hermes Agent (theo video đăng ngày 30/10/2026).
Anh đặt vấn đề: ai cũng tập trung vào model tốt nhất, nhưng vì sao ta lại phải dùng một model cho mọi việc? Không phải model nào cũng giống nhau, và chúng cũng không cần phải giống nhau. Theo Callum (video đăng ngày 30/10/2026), một model mạnh có thể hoàn hảo cho một task sâu cần đúng mức reasoning đó, nhưng với một task thường ngày thì nó có thể là quá tay. Kết quả là bạn đốt quota vào những task không cần tới nó, rồi không còn đủ quota cho những task thật sự cần.
Vậy nếu thay vào đó bạn dùng được đúng tổ hợp model khớp với công việc mình đang làm thì sao?
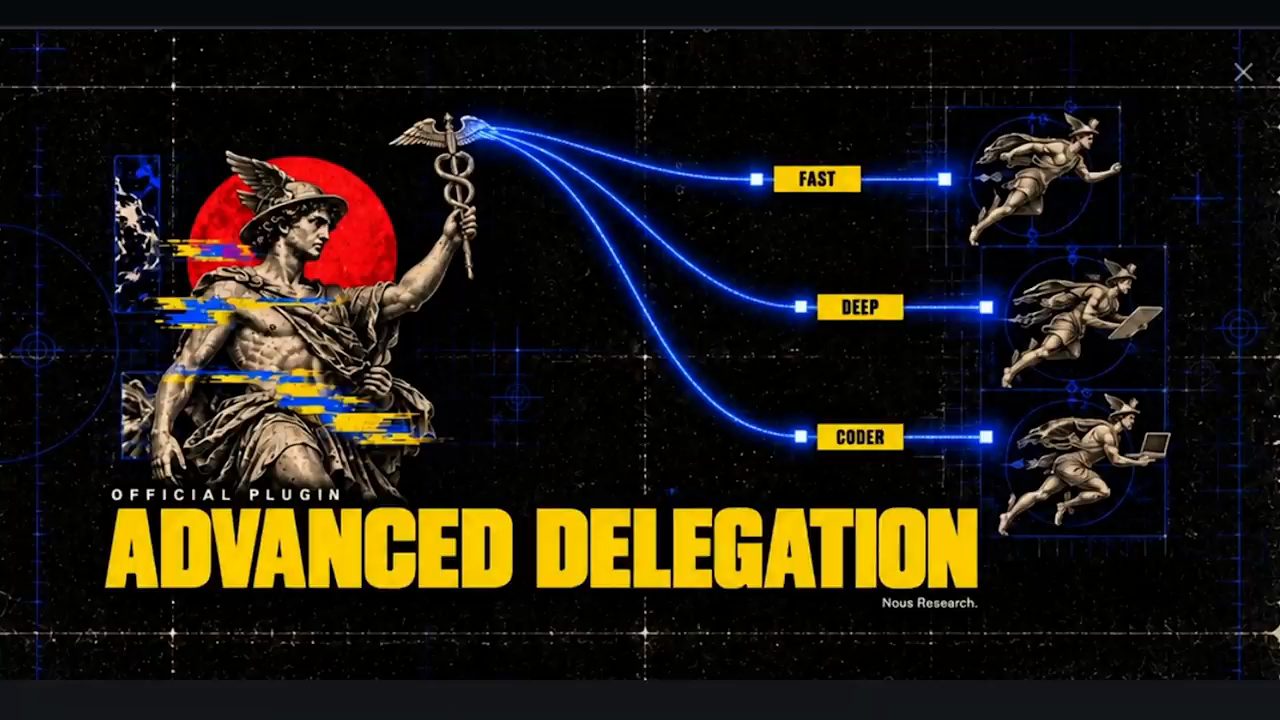
Anh tự giới thiệu: tên anh là Callum, còn được biết tới với tên Wanderloots, và video hôm nay nói về model routing và agent delegation. Anh dùng Hermes làm agent cho video này, nhưng theo anh (video đăng ngày 30/10/2026), khái niệm này, ý tưởng model routing này, áp dụng cho mọi agent.
Theo Callum (video đăng ngày 30/10/2026), cách dễ nhất để nghĩ về model routing và delegation là chia thành ba tầng. Tầng fast dành cho task đơn giản, tầng balanced cho công việc thường ngày, và tầng deep cho lúc cần nhiều reasoning hơn. Các model này có thể đến từ những provider khác nhau, chạy local, hoặc kết hợp cả hai.
Anh nói Advanced Delegation plugin mới của Hermes giúp xử lý kiểu delegation và model routing này dễ hơn bao giờ hết (tính tới video đăng ngày 30/10/2026). Trong video, anh sẽ xem các lựa chọn model routing khác nhau trong Hermes, dựng ba route fast, balanced và deep, rồi thử một tổ hợp model local và cloud trên cùng một câu hỏi research. Sau đó anh so sánh kết quả và chỉ cách tuỳ biến cho công việc của riêng bạn, kèm một số best practice và workflow nâng cao.
2. Không chỉ một provider, không chỉ cloud
Callum nhắc rằng có thể bạn đã quen với chuyện các model chia thành nhiều tầng ở ChatGPT, Claude, Gemini và các provider khác. Nhưng theo anh (video đăng ngày 30/10/2026), với model routing, ta không bị giới hạn ở một provider, và cũng không bị giới hạn ở model cloud: ta có thể đưa cả model local vào cuộc chơi.
Ví dụ của anh (video đăng ngày 30/10/2026): anh có các model local chạy qua Lemonade trên một máy tính khác. Anh có thể dùng chúng song song với các model cloud, và chọn model nào được dùng cho những task nào.
Nhưng thứ hợp với anh chưa chắc đã hợp với bạn. Theo Callum (video đăng ngày 30/10/2026), phần cứng của bạn, các task bạn làm, và mức bạn coi trọng tốc độ, chất lượng, chi phí hay quyền riêng tư đều ảnh hưởng tới việc model nào hợp với workflow của bạn. Vì vậy, chuyện không nằm ở model nào mạnh nhất hay quyền năng nhất, mà ở tổ hợp model nào thật sự làm được công việc cần làm.
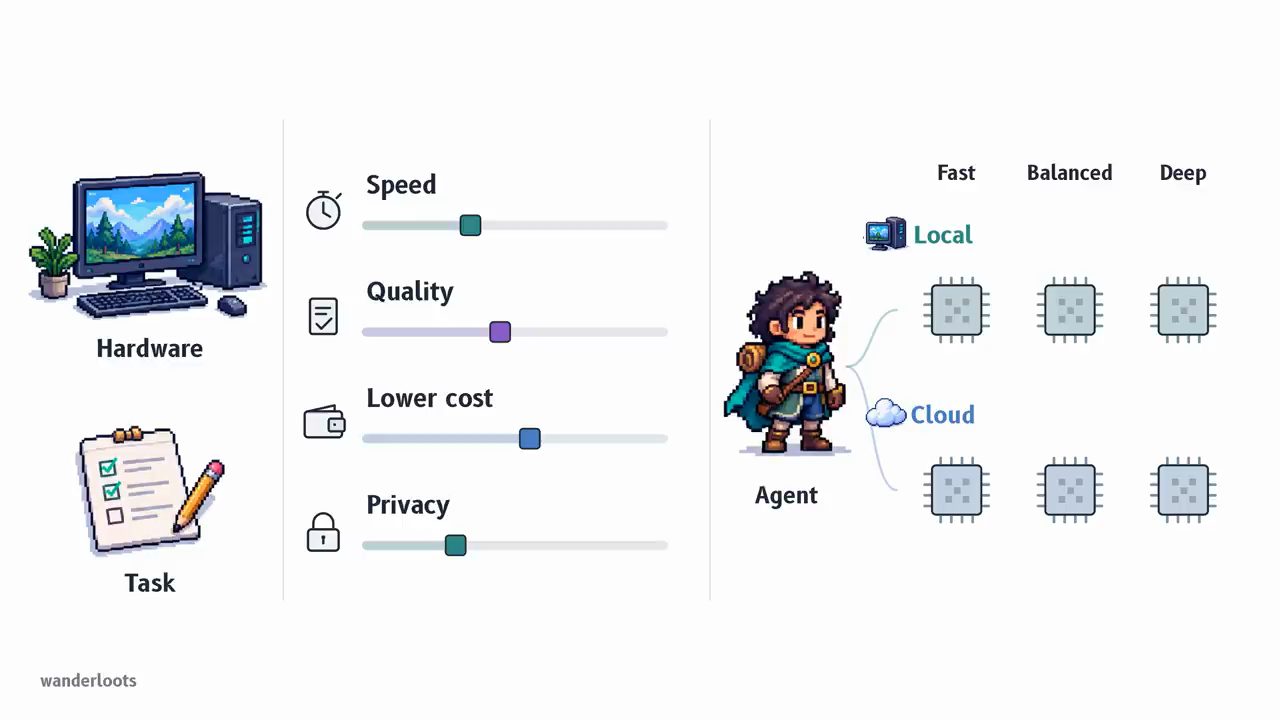
Mục tiêu của anh hôm nay là cho thấy các kỹ thuật model routing và delegation khác nhau, những mảnh ghép, khớp với nhau thế nào, để bạn hiểu rõ hơn cách áp chúng vào workflow của mình và cách tự dựng thí nghiệm để thử. Như vậy bạn sẽ hiểu cách tìm ra cấu hình, tổ hợp hợp nhất với mình. "Giờ hãy xem model routing."
3. Main model, settings và fallback models
Callum chuyển sang Hermes. Thứ đầu tiên anh muốn cho xem là có vài lựa chọn khác nhau để dùng Hermes với model routing (video đăng ngày 30/10/2026).
Lựa chọn đầu tiên, dĩ nhiên, là ô chọn main model ở phía dưới khung chat. Anh bấm vào, chọn model, và có thể đổi mức thinking và speed ngay ở đó (demo trong video đăng ngày 30/10/2026).
Nhưng ta cũng có thể vào Settings. Đây là nơi điều khiển main model cho từng profile khác nhau, cùng mọi thiết lập anh vừa cho xem, và cũng đổi được provider tại đây (theo video đăng ngày 30/10/2026).
Ngoài ra còn có lựa chọn fallback models. Theo Callum (video đăng ngày 30/10/2026), anh nghĩ tính năng này hợp hơn khi bạn có kết nối internet không ổn định, hoặc khi bạn chạy model local: nếu một model hỏng, bạn có một model dự phòng. Hôm nay anh không đi vào phần này, nhưng bạn nên biết đó là một lựa chọn.
Điểm thú vị, theo anh (video đăng ngày 30/10/2026), là khi chạy bình thường, khi chỉ trò chuyện với Hermes như thế này, ta chỉ thật sự chọn được một model mỗi lúc. Nghĩa là phải chọn cloud hoặc local. Nhưng khi đi vào model routing bên ngoài main model, ta bắt đầu có nhiều sắc thái hơn: có cả một dải lựa chọn model, nên ta điều khiển được model chạy từ đâu, chạy ở tầng nào, và chúng phối hợp với nhau ra sao.
4. Ba cách routing: main, auxiliary và delegation
Tổng thể, theo Callum (video đăng ngày 30/10/2026), Hermes có ba lựa chọn chính để route model. Thứ nhất là main model, được áp ở cấp profile. Thứ hai là auxiliary models, chạy theo từng hành động, và mỗi cái có thể cấu hình độc lập. Thứ ba là delegation, làm qua subagent với model routing hoặc profile routing, hoặc làm thẳng qua Kanban. Tóm lại: main, auxiliary và delegation.
Auxiliary models, theo anh (video đăng ngày 30/10/2026), về cơ bản là các helper task chạy trên main model theo mặc định. Tất cả đều được đặt là "main", và đó là những task cứ thế diễn ra khi bạn dùng Hermes. Vậy nên thay vì để Hermes chạy model mạnh nhất của bạn (anh lấy ví dụ GPT Astra hay Claude Fable) chỉ để, chẳng hạn, tìm xem nên dùng skill nào, bạn có thể đổi sang một model khác, ví dụ một model local, và để nó lo các task đơn giản đó, nhờ vậy không đốt quota cloud. Còn nếu bạn đang dùng một model local mạnh, bạn có thể đặt một model thật nhanh ở đây.
Lựa chọn tiếp theo là subagents, và đây là phần chính anh muốn đi vào hôm nay. Theo Callum (video đăng ngày 30/10/2026), nếu bạn chạy Hermes 22.5 trở lên, bạn có một hệ thống mới gọi là routing. Mặc định là cách dựng sẵn, dùng thứ gọi là task delegation: một main agent giao việc từ parent xuống các child agent, và các child gửi tiến độ ngược lại cho main agent.
Vậy thay vì mặc định, nơi mọi subagent chạy trên một lựa chọn duy nhất, ta có thể có dynamic routing: đưa vào một danh sách model, một tấm bản đồ model (model map), và parent agent sẽ giao cho mỗi subagent một model khác nhau. Anh nói điều này sẽ rất quan trọng với quy trình trong video (video đăng ngày 30/10/2026).
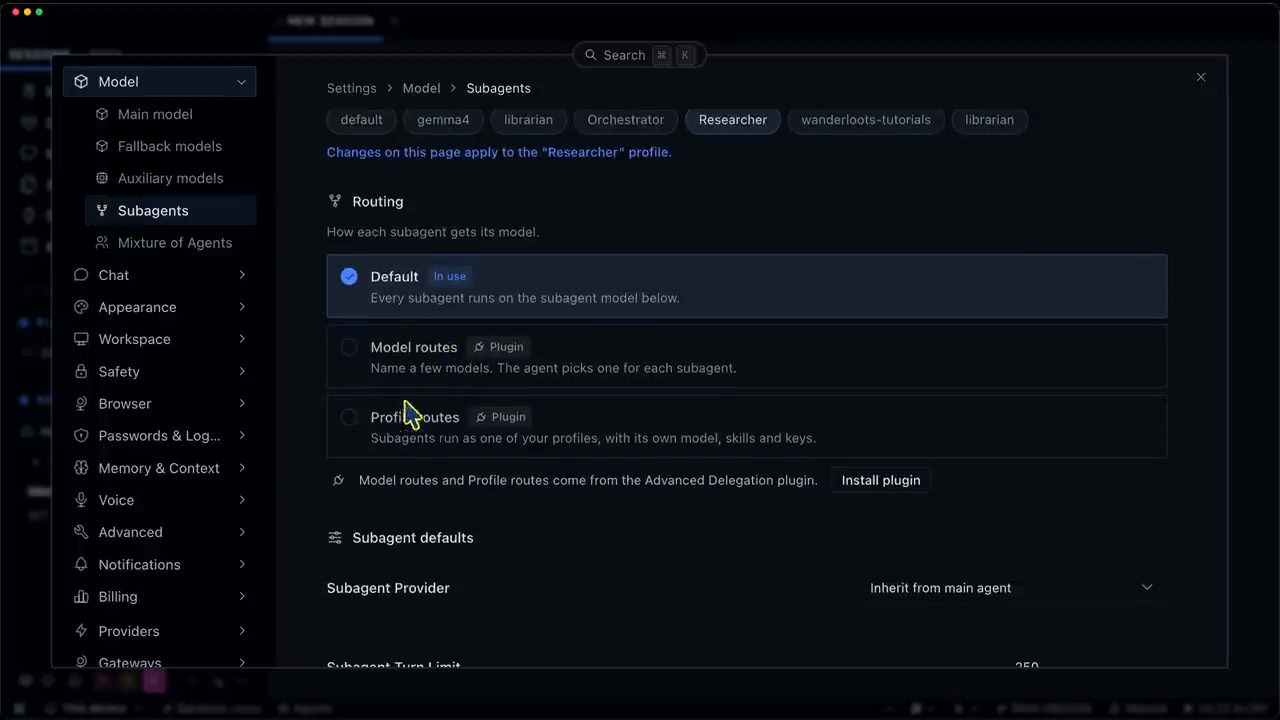
Cách còn lại là profile routing. Ở đây, thay vì một subagent chạy bằng một model khác, ta cho subagent chạy như một trong các profile. Ví dụ của Callum: orchestrator agent của anh có thể giao việc cho một subagent là researcher, và subagent đó mang vào profile researcher, kéo theo mọi năng lực của researcher (theo video đăng ngày 30/10/2026).
5. Giới hạn của profile routing, và Kanban
Tuy nhiên, theo Callum (video đăng ngày 30/10/2026), đi theo hướng profile routing có một số giới hạn: nó mang vào model, skills và keys, nhưng không nhất thiết mang vào memory và custom context của profile đó.
Đó là chỗ ta đi tới dạng delegation cuối cùng: Kanban. Ở Kanban, anh nói ta có thể dựng đủ kiểu orchestration khác nhau, ví dụ một orchestrator agent giao việc cho các profile cụ thể, nhưng lần này mỗi worker trong hệ thống Kanban chạy trọn vẹn cả profile, với mọi memory và context của nó (theo video đăng ngày 30/10/2026). Anh hứa sẽ nói thêm ở phần sau về khác biệt giữa profile và Kanban, vì theo anh khác biệt đó thật ra khá quan trọng.
Nhưng theo anh (video đăng ngày 30/10/2026), bước đầu tiên trước khi làm bất cứ gì là bảo đảm ta có thêm model trong hệ thống. Vậy anh nối một model local mới vào, để chạy một cấu hình lai cloud và local cho video hôm nay.
6. Thêm model: endpoint Lemonade trên máy AMD
Callum chuyển sang làm việc trên profile researcher, nơi danh sách model nằm ở cạnh bên. Theo anh (video đăng ngày 30/10/2026), điểm hay là Hermes có khả năng cho bạn chạy ngay một model local vừa với máy tính của bạn, để mọi thứ chạy trên chính thiết bị của mình. Anh nói thật lòng là model local đang tốt lên rất nhiều (tính tới video đăng ngày 30/10/2026), và Hermes giờ đã giúp bạn dễ thấy model local nào thật sự chạy được trên máy, vì đã đóng gói sẵn llama.cpp, engine chạy model của bạn.
Hôm nay anh không nói về phiên bản dựng sẵn đó của Hermes. Anh muốn thêm một custom model provider mới. Anh đã có sẵn một custom endpoint chạy trên chính máy mình bằng Ollama; hôm nay anh dùng Lemonade, vì đây là một tool mới với anh.
Các bước trong demo (video đăng ngày 30/10/2026): anh bấm New endpoint, đặt tên là "Halo Lemonade", và Hermes báo endpoint truy cập được. Nó tìm thấy mọi model anh đã tải về trên máy AMD Halo của anh. Cho endpoint này, anh chọn model Gemma 4 26B A4B, vì đó là một model rất nhanh theo anh. Rồi anh bấm Save.
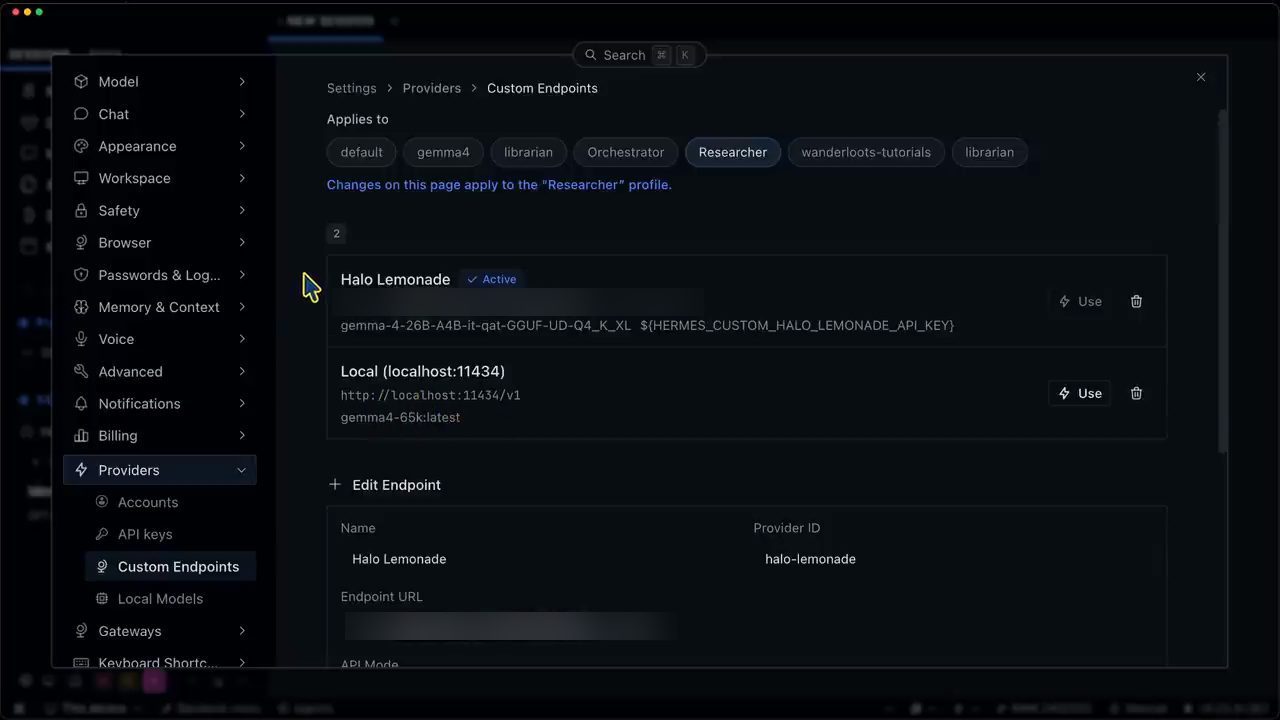
Giờ đã có một custom endpoint mới được lưu (demo trong video đăng ngày 30/10/2026): Halo Lemonade, bên cạnh endpoint Ollama. Endpoint Ollama chạy ngay trên máy của anh, một chiếc Mac Studio, còn Halo Lemonade thực ra chạy trên thiết bị AMD của anh.
Vì vậy, theo Callum (video đăng ngày 30/10/2026), anh không chỉ có ChatGPT, tức gói Codex subscription của anh, là một model cloud, mà giờ còn truy cập được mọi model trên server Halo Lemonade. Có thêm model kết nối rồi, ta có thêm lựa chọn, và đã tới lúc xem cách áp các model đó vào routing của Hermes.
7. Route option 1: auxiliary models
Lựa chọn model routing đầu tiên, như anh đã nói: quay lại Settings, vào Auxiliary models. Ở đây ta cấu hình được các helper task cụ thể, vốn chạy trên main model theo mặc định (theo video đăng ngày 30/10/2026).
Callum giải thích ý anh: giả sử main model là một model cloud, chẳng hạn frontier model của ChatGPT, Anthropic hay Gemini. Anh không nhất thiết muốn phí token, để model mạnh nhất tiêu credit chỉ để đi tìm xem có skill nào sẵn. Vậy anh đổi mục đó và chọn, ví dụ, model Gemma 4 26B A4B làm mặc định. Từ giờ, mỗi lần Hermes đi tìm một skill mới và áp dụng nó, nó sẽ dùng auxiliary model này thay vì main model (theo video đăng ngày 30/10/2026).
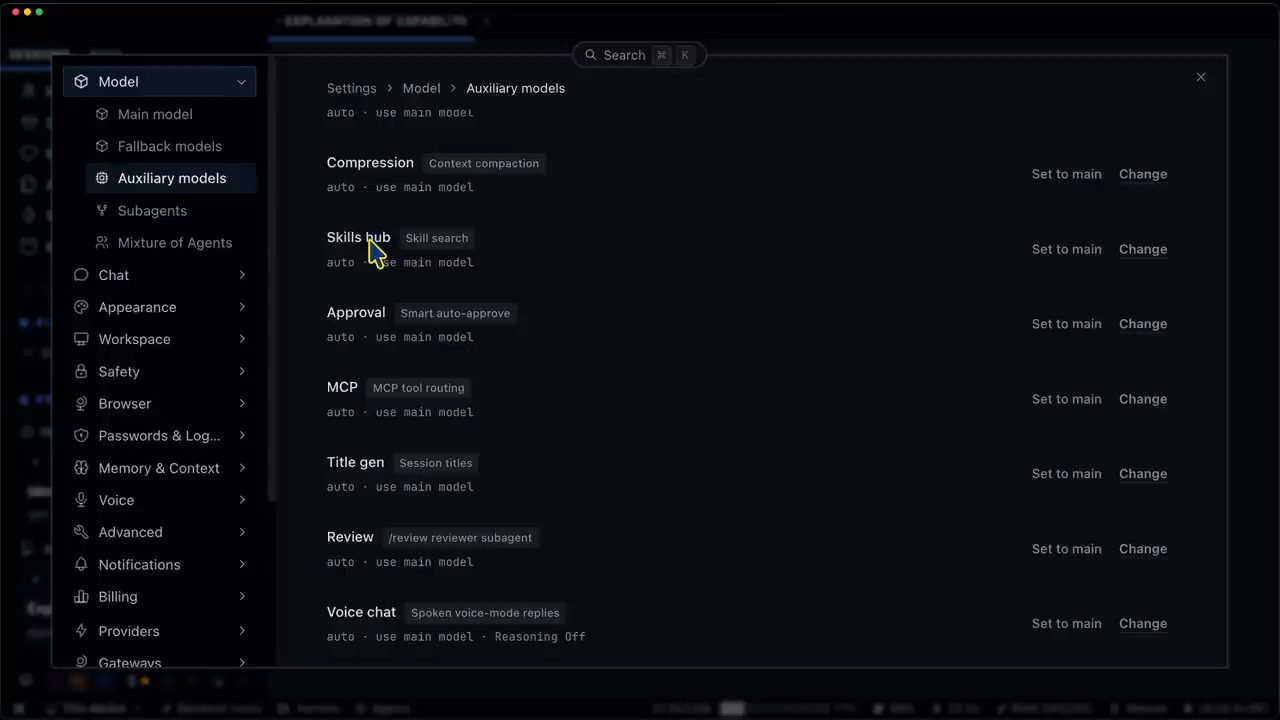
Ta dùng được cách này cho đủ loại việc. Một mục khác là compression, thứ anh nói nhiều người thấy rất hữu ích (theo video đăng ngày 30/10/2026). Bạn có thể dùng một model rất nhỏ, ví dụ model Qwen3.5 9B, một model tương đối nhỏ, và có thể chạy nó rất nhanh. Khi tới lúc compression, thay vì dùng frontier model để nén context (việc có thể tốn rất nhiều token, nhất là khi cuộc hội thoại ngày càng dài), giờ bạn dùng một model local, về thực chất chạy miễn phí, để nén và tóm tắt context. Nhờ vậy bạn giữ quota cho việc thật sự làm công việc, chứ không phải để tóm tắt nó.
Theo Callum (video đăng ngày 30/10/2026), còn nhiều thứ khác ta làm được ở đây. Session title, theo anh về cơ bản là tiêu đề sinh ra ở cạnh bên khi bạn mở một cuộc chat mới, có thể do một model local tạo. Việc nhận diện MCP tool cũng có thể giao cho model local. Bạn cũng có thể chạy một reviewer subagent bằng model khác.
Theo anh (video đăng ngày 30/10/2026), đây là một cách tương đối đơn giản để bắt đầu model routing: lấy những hành động có thể tốn kém mà Hermes làm liên tục, và giao chúng cho một helper model, để main model không phải tiêu vào đó. Ý tổng thể là các thao tác nội bộ thường ngày có thể dùng model rẻ hơn hoặc nhanh hơn mà không phải sinh ra agent mới.
Chọn gì là tuỳ bạn, tuỳ bạn dùng cloud, local hay tổ hợp. Nhưng Callum khuyên nên xem qua tất cả các auxiliary model này, vì theo anh (video đăng ngày 30/10/2026) đây là một trong những cách tốt nhất để bắt đầu tuỳ biến cách dùng model trong Hermes, chỉnh sao cho tiết kiệm được nhiều token và có thể còn nâng chất lượng việc bạn làm. Nói tới đây là đủ về auxiliary model routing.
8. Route option 2: subagents và Advanced Delegation plugin
Giờ quay lại delegation, cụ thể là subagents. Theo Callum (video đăng ngày 30/10/2026), subagent là một kiểu delegation rất cụ thể, và đây là nơi có model routing: parent agent chọn model cho từng subagent.
Điều này đã khác mặc định, vì ở mặc định, tool task delegation dựng sẵn sẽ tự dùng hoặc cùng model với main agent, hoặc một model cụ thể bạn chọn ở đây. Vậy nên bạn không điều khiển được subagent là gì, ngoài việc đặt cho nó một model mặc định ở trên (theo video đăng ngày 30/10/2026).
Nhưng giờ Hermes có Advanced Delegation plugin, mở khoá model routing, cho phép ta tạo một model map. Theo anh (video đăng ngày 30/10/2026), ta có thể đưa vào các model local khác nhau, các model cloud khác nhau, một mixture of agents, và hoàn toàn điều khiển được loại hành động nào sẽ kích hoạt model nào cho subagent. Ví dụ hôm nay anh dùng là fast, balanced và deep, mỗi route một model khác nhau.
Lựa chọn còn lại là profile routes. Ý tưởng là bạn để main parent agent giao việc cho một subagent chuyên biệt đã được cấu hình sẵn trên một trong các profile của bạn. Theo Callum (video đăng ngày 30/10/2026), một lợi thế lớn của profile route là subagent đến kèm model, skills và keys của riêng nó, và cả các năng lực của nó: ví dụ researcher của anh có một custom MCP connector riêng. Tuy nhiên, một giới hạn then chốt là nó không mang theo context của riêng nó.
Rồi anh cài plugin. Có thể bấm thẳng Install Plugin ngay tại trang Subagents, và theo anh cách đó chạy được (demo trong video đăng ngày 30/10/2026), nhưng anh muốn cho xem nhanh plugin trông thế nào trong catalog thật, ở mục Plugins dưới Capabilities.
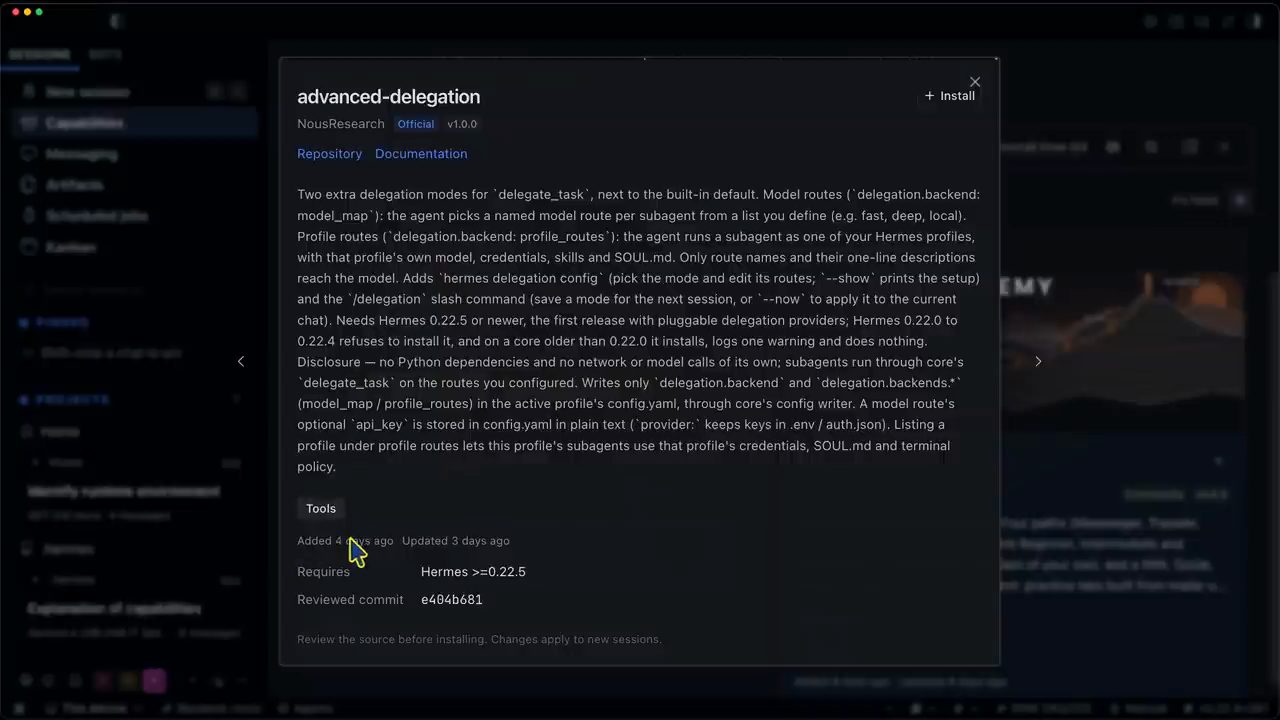
delegate_task bên cạnh mặc định: Model routes (delegation.backend: model_map), agent chọn một route model có tên cho mỗi subagent từ danh sách bạn định nghĩa (ví dụ fast, deep, local); và Profile routes (delegation.backend: profile_routes), agent chạy subagent như một trong các Hermes profile, với model, credentials, skills và SOUL.md của profile đó. Thẻ ghi "Added 4 days ago", "Updated 3 days ago", và Requires "Hermes >=0.22.5".Trên thẻ đó, theo lời Callum (video đăng ngày 30/10/2026), ý tưởng là Hermes có thể chọn các model khác nhau cho các loại task khác nhau, như Fast, Deep và Coder. Plugin làm việc đó bằng cách thêm hai chế độ nữa cho delegate task như anh vừa cho xem. Một yêu cầu then chốt là bạn cần Hermes 22.5 (thẻ ghi "Hermes >=0.22.5"), vì đó là bản có khả năng pluggable delegation provider. Anh nói plugin này thực ra mới được tạo vài ngày trước (tính tới video đăng ngày 30/10/2026), và đây là một plugin chính thức, đến từ Nous Research, điều khiến anh thấy yên tâm hơn.
Trang docs Subagent Delegation của Hermes (đọc ngày 01/11/2026) mô tả cùng hai chiến lược: profile_routes, mỗi child chạy như một Hermes profile với model, credentials, skills và persona của profile đó; và model_map, bạn liệt kê các lựa chọn có tên (fast, deep...) kèm mô tả và provider/model, rồi model chọn một lựa chọn cho mỗi task. Docs ghi cả hai đến từ advanced-delegation plugin chính thức.
9. Cài plugin và bật task delegation
Callum bấm Install plugin. Hermes hỏi muốn cài cho ai; anh chỉ cài vào profile researcher lúc này rồi bấm Install. Anh cho biết mình chỉ cần khởi động lại gateway để lên bản 22.5. Xong, Advanced Delegation plugin đã được cài (demo trong video đăng ngày 30/10/2026).
Quay lại mục Subagents, giờ anh đã bấm được vào Model routes và Profile routes. Điểm then chốt, theo anh (tính tới video đăng ngày 30/10/2026), là không dùng cả hai cùng lúc được: bạn không thể có một orchestrator agent vừa giao việc theo model vừa theo profile, ít nhất là vào thời điểm này.
Còn một bước nữa trong Advanced Delegation: bảo đảm bản thân tool task delegation đã được bật, vì đó chính là thứ được nâng cấp khi bạn bật plugin (theo Callum, video đăng ngày 30/10/2026). Trong demo, anh mở Capabilities, tab Tools của profile researcher, nơi một thẻ chú thích ghi "Enable task_delegation Tool".
Vẫn ở profile researcher, anh dựng Model routes trước.
10. Tạo ba model routes: fast, balanced, deep
Anh bấm Add route và Hermes đưa ra vài gợi ý. Hộp thoại "New model route" ghi rằng agent đọc tên và mô tả để quyết định subagent đi route nào (demo trong video đăng ngày 30/10/2026). Reasoning effort và speed vẫn chọn được, mặc định lấy theo thiết lập chung; còn lựa chọn "inherit from main agent" đã bị tắt.
Route đầu tiên anh đặt tên là fast. Ở ô "When to use it", anh ghi: dùng cho tra cứu nhanh, tóm tắt và phân tích ban đầu. Ở Provider, ta lại được chọn nơi lấy model: có thể chọn một mixture of agents cho kiểu việc này, hoặc chọn từ Halo. Anh dùng model anh đã thử làm route fast từ trước, rồi bấm Add route. Giờ researcher có route model mới này, và có thể vào tuỳ biến, sửa lại sau nếu muốn (demo trong video đăng ngày 30/10/2026).
Route thứ hai tên balanced, ghi chú: khi chất lượng quan trọng hơn tốc độ, nhưng ta vẫn muốn nó tương đối nhanh. Ở route này anh lại chọn Halo, và chọn Qwen 3.8 27B, vì theo anh (video đăng ngày 30/10/2026) đó là một model mạnh hơn nhiều. Bấm Add route. Giờ đã có fast và balanced.
Route cuối cùng tên deep: khi chất lượng là quan trọng, cần reasoning phức tạp, chủ đề nhiều sắc thái và độ chính xác. Để có một ví dụ lai, anh dùng ChatGPT và chuyển sang Astra. Như vậy main agent của anh chạy trên một model như GPT 6.1 Sol, thứ anh nói có giá khoảng một phần năm Astra (theo Callum, video đăng ngày 30/10/2026), và khi thật sự cần reasoning sâu, nó giao việc cho một model Astra. Ở route này anh giới hạn ở Astra High để nó không đi quá xa, và không bật ultra fast, vì theo anh chế độ đó có thể đốt rất nhiều quota. Bấm Add route.
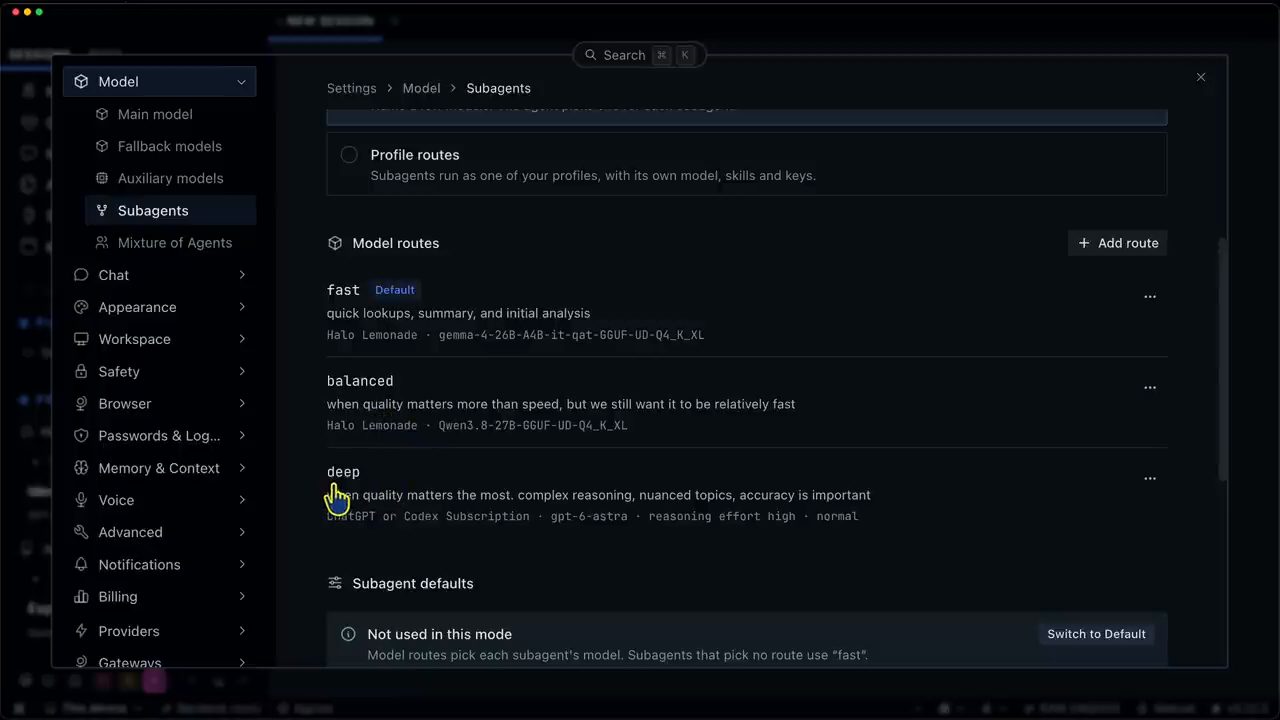
Trong hộp thoại thêm route balanced, danh sách Provider có năm mục: Mixture of Agents, Anthropic, ChatGPT or Codex Subscription, Halo Lemonade, và Local (localhost:11434) (video đăng ngày 30/10/2026).
Với Advanced Delegation plugin, anh đã dựng được ba model route khác nhau có thể tự động áp cho subagent khi delegation. Theo Callum (video đăng ngày 30/10/2026), đây là một route lai: đưa cả model cloud lẫn model local vào để tiết kiệm credit khi xử lý task fast và balanced, còn khi cần chất lượng hơn thì giao xuống một model sâu hơn.
11. Thử nghiệm: một câu hỏi, ba route
Có route rồi, anh chạy thử (demo trong video đăng ngày 30/10/2026). Bài test anh muốn làm: cho researcher sinh ra ba subagent chạy đồng thời bằng Advanced Delegation. Câu hỏi anh đưa: một người bình thường có thể làm những gì tốt nhất để tự cải thiện an ninh của mình trước các vụ hack bằng AI trong tương lai?
Theo Callum (video đăng ngày 30/10/2026), chủ đề này gần đây lên tin tức rất nhiều với một số vụ hack khá lớn. Anh muốn tìm hiểu thêm nên chờ đợi gì ở sự phát triển của AI và an ninh mạng sau này, để có thể làm những hành động thực tế, khả thi ngay từ bây giờ cho bản thân.
Trong prompt, anh yêu cầu ba agent chạy với fast, balanced và deep; tất cả phải làm việc độc lập. Anh đưa kèm hướng dẫn cách chúng tìm paper liên quan, bảo parent chờ báo cáo, rồi với vai trò parent, đánh giá độc lập từng báo cáo, trình bày một bảng so sánh song song và đưa ra bản tổng hợp cuối. Đoạn đầu prompt đọc được trong ô chat (video đăng ngày 30/10/2026):
Research this question: what are the best actions an individual, average person can take to improve their own security against future ai hacks?

I want to compare the research capabilities of three different models.

1. Spawn THREE subagents simultaneously using Advanced Delegation:
Kết quả đầu tiên hiện ra ở cạnh bên: tiêu đề phiên đổi từ "untitled" thành "compare models researching personal AI security". Anh chỉ ra rằng việc đặt tiêu đề đó thật ra dùng một auxiliary model, hiện vẫn để mặc định, nhưng đó là thứ ta đổi được (demo trong video đăng ngày 30/10/2026).
Rồi parent giao việc cho ba model: task 1 cho Gemma 4, task 2 cho Qwen 3, và task 3 cho GPT Astra (demo trong video đăng ngày 30/10/2026). Callum cũng nói nhanh rằng anh đang dùng một custom skill tự build cho researcher agent của mình.
Có thể mở rộng từng subagent để xem chúng đang chạy thế nào. Lúc này cả hai model local vừa bắt đầu lượt tìm kiếm qua MCP (demo trong video đăng ngày 30/10/2026).
12. Chạy nền, spawn tree và số đo thời gian
Quay lại xem các subagent: chúng vẫn đang chạy, đã được khoảng 13 phút. Theo Callum (video đăng ngày 30/10/2026), điều này không có gì bất ngờ với một model local.
Theo anh (video đăng ngày 30/10/2026), đây lại là một lý do có một hệ thống lai thì tiện: nếu có việc làm được ở nền, hoặc bạn gửi đi một loạt task, chúng có thể chạy ở nền rồi trả về báo cáo cho bạn. Hoặc ví dụ bạn muốn chạy một "agentic librarian" để dựng knowledge base: mỗi đêm nó kiểm xem có file mới không, và bạn dùng một agent local để tiếp tục xây wiki. Đó không phải thứ cần theo dõi liên tục; anh có thể đi làm việc khác trong lúc research đang chạy.
Xem kỹ spawn tree (mở bằng cách bấm vào hai agent phía dưới) cũng thú vị, vì thấy được, ví dụ, câu tìm kiếm MCP khác nhau giữa các subagent. Một subagent tìm "individual cybersecurity measures against AI-driven social engineering and deepfakes", còn subagent kia tìm "generative AI-powered phishing deepfake social engineering attacks" (demo trong video đăng ngày 30/10/2026).
Theo Callum (video đăng ngày 30/10/2026), các model khác nhau có cách nhìn khác nhau vào cùng một vấn đề, nên được route giữa chúng rồi so sánh sau đó cho bạn nhiều linh hoạt hơn. Anh ví nó giống như đưa một critic vào quá trình research: không chỉ có một output, mà có output thứ hai, rồi đối chiếu chúng với nhau để bảo đảm chất lượng tốt nhất có thể.
Route fast chạy xong trước, rồi tới lượt chờ route balanced, tức model Qwen 3.8 27B lớn hơn. Theo số đo của Callum (video đăng ngày 30/10/2026), researcher balanced thật ra không chậm hơn researcher fast bao nhiêu, nên nếu làm lại, anh có thể thử một model khác cho route fast xem có chạy nhanh hơn được không.
Thời gian chạy end-to-end được báo về là khoảng 16,1, 19,1 và 2,0 phút, lần lượt cho fast, balanced và deep (số đo trong demo, video đăng ngày 30/10/2026). Trên màn hình, parent ghi: "reported end-to-end runtimes were about 16.1, 19.1, and 2.0 minutes, respectively", kèm nhận xét báo cáo deep là ứng viên mạnh nhất ban đầu vì giữ trong năm paper và tách rõ phát hiện với suy luận, còn hai báo cáo fast và balanced đều vượt giới hạn nguồn.
Theo Callum (video đăng ngày 30/10/2026), đến đây bạn bắt đầu thấy rõ hơn khác biệt giữa chạy trên cloud và chạy local. Nhưng nếu anh có một ý tưởng cho báo cáo research, anh hoàn toàn có thể gửi nó đi, để nó làm trong một giờ, rồi quay lại sau khi làm việc khác. Theo anh, một lợi ích của model local là miễn phí, bạn không phải trả tiền; nó riêng tư, bạn không phải gửi dữ liệu đi nơi khác; nhưng cái giá là tốc độ.
Vì vậy, theo Callum (video đăng ngày 30/10/2026), điều quan trọng là thử nghĩ ra các model route khác nhau, các cách cấu trúc hệ thống khác nhau, để tận dụng model local khi cần mà vẫn có cloud dự phòng nếu bạn có điều kiện và muốn vậy. Theo anh, cân bằng tốt nhất là một tổ hợp lai, trừ khi bạn đặc biệt thận trọng về quyền riêng tư.
13. So sánh chất lượng ba báo cáo
Giờ tới agent tổng hợp: main parent đi qua các báo cáo, so chúng với nhau, rồi chấm xem mỗi báo cáo làm tốt tới đâu (demo trong video đăng ngày 30/10/2026).
Bảng so sánh hiện ra. Agent đánh giá, chạy trên GPT 6.1 Sol, kết luận Agent C, tức route deep, cho báo cáo mạnh nhất: chọn bằng chứng tốt nhất, phân biệt rõ nhất giữa phát hiện và suy luận, đưa lời khuyên dùng được nhất cho một người bình thường, và có thời gian chạy end-to-end được báo về ngắn nhất (demo trong video đăng ngày 30/10/2026).
Callum nói đây không hẳn là một phép so sánh công bằng, vì route đó dùng GPT-6 Astra, theo anh là một trong những model tốt nhất đang có (theo Callum, video đăng ngày 30/10/2026). Nhưng anh muốn tạo một baseline tốt để hiểu các model local so ra thế nào.
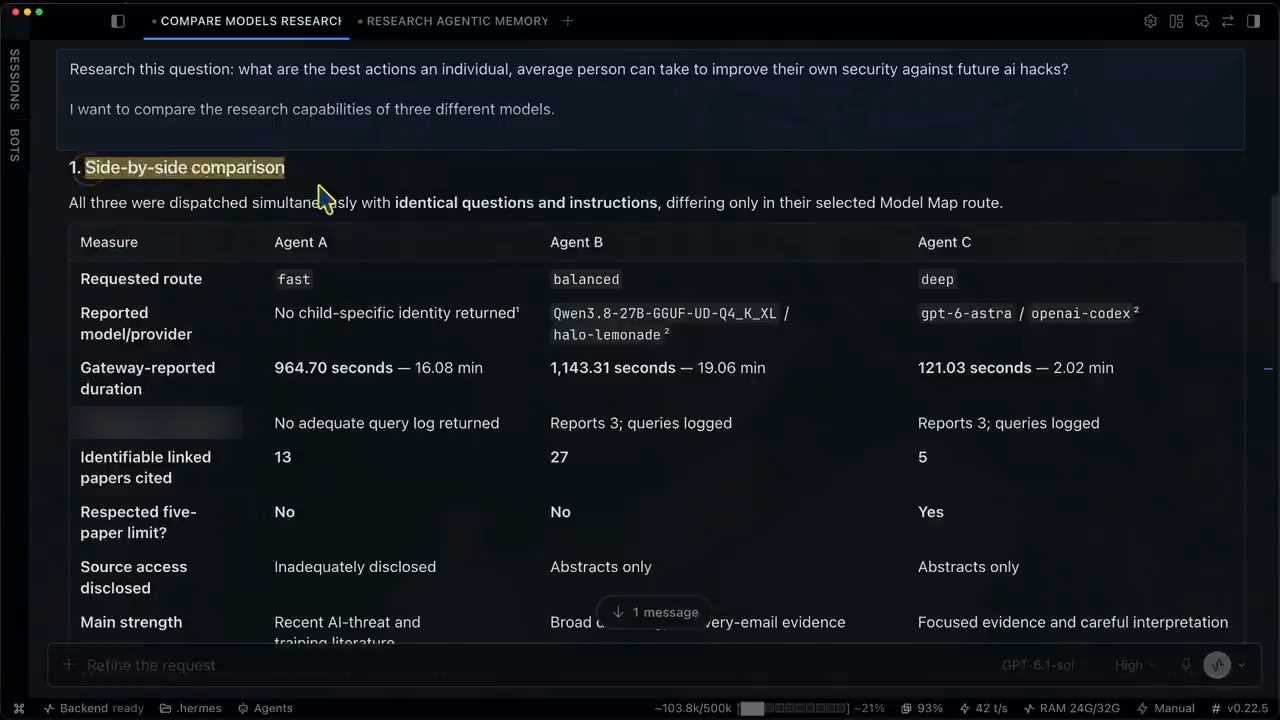
Agent B, route balanced, đứng thứ hai, vì nó tìm được thêm bằng chứng về MFA và account recovery. Callum đoán MFA ở đây là multi-factor authentication. Agent A, route fast, đứng thứ ba vì chi tiết yếu hơn và nói quá một nguồn (demo trong video đăng ngày 30/10/2026). Cả ba agent được giao song song, và thứ duy nhất khác nhau là route trong model map mà mỗi agent được chọn.
Anh cho xem báo cáo. Điều thú vị nữa, theo Callum (demo trong video đăng ngày 30/10/2026): B và A, tức balanced và fast, có một số paper trùng nhau; B và C, tức balanced và deep, cũng có paper trùng nhau. Vậy model balanced tìm được một số paper giống model state-of-the-art, nhưng model fast và model state-of-the-art lại không tìm thấy nguồn nào chung. Anh thấy điều đó rất thú vị.
Anh cũng để ý báo cáo ghi rằng một trong những lỗi chính của model fast là có một chỗ "important overclaim" (demo trong video đăng ngày 30/10/2026).
14. Bản tổng hợp cuối và bước tiếp theo của thử nghiệm
Rồi tới bản tổng hợp cuối về việc một người bình thường nên làm gì (demo trong video đăng ngày 30/10/2026). Theo Callum, vài điểm khá hiển nhiên, nhưng anh nghĩ vẫn đáng được nhắc lại, nhất là với các vụ hack đang diễn ra dạo này (tính tới video đăng ngày 30/10/2026).
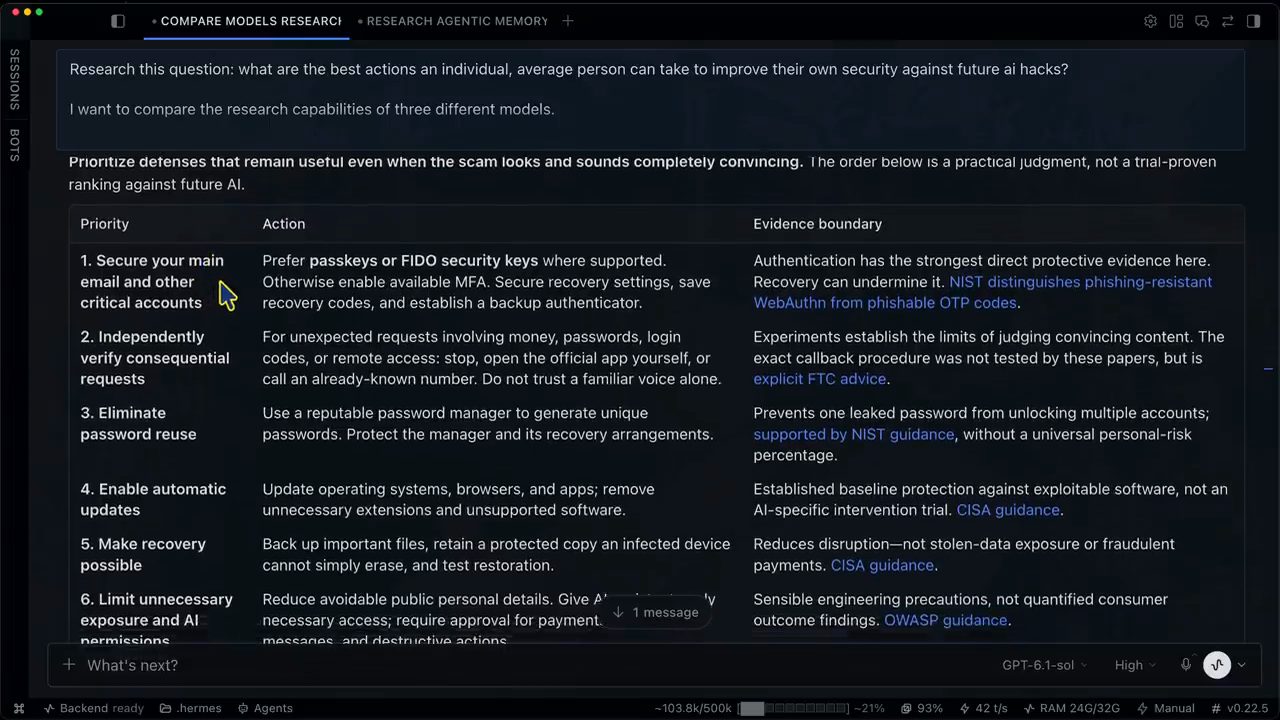
Các hành động Callum đọc lên từ bản tổng hợp trong video đăng ngày 30/10/2026:
- Bảo vệ email của bạn (bản tổng hợp, video đăng ngày 30/10/2026).
- Kiểm tra lại các yêu cầu hệ trọng, tức bất cứ thứ gì liên quan tới tiền, mật khẩu, mã đăng nhập (bản tổng hợp, video đăng ngày 30/10/2026).
- Bỏ hẳn việc dùng lại mật khẩu (bản tổng hợp, video đăng ngày 30/10/2026).
- Bật cập nhật tự động. Callum nghĩ đây là một điểm lớn với một số hệ thống: ví dụ vụ hack PHP đã khiến một lượng hệ thống lớn đến mức phi lý trở nên dễ bị tấn công, nhưng nếu website của bạn bật cập nhật tự động ở nhà cung cấp hosting thì lỗi đó được vá gần như ngay lập tức (theo Callum, video đăng ngày 30/10/2026).
- Giữ một bản backup (bản tổng hợp, video đăng ngày 30/10/2026).
- Hạn chế phơi bày không cần thiết và quyền của AI. Callum nghĩ đây cũng là một điểm lớn khi AI agent ngày càng làm nhiều việc hơn cho ta: chỉ cho chúng hoạt động theo nguyên tắc cần biết và cần truy cập, đừng cho chúng quyền vào mọi thứ (theo Callum, video đăng ngày 30/10/2026).
Anh thấy kết quả khá ổn, dù anh sẽ phải đọc kỹ hơn các báo cáo thật. Nhìn chung, anh thấy đây là một phép so sánh khá thú vị (demo trong video đăng ngày 30/10/2026).
Theo Callum (video đăng ngày 30/10/2026), giờ anh có lẽ sẽ làm lại thí nghiệm này với một model nhanh hơn, vì 16 phút với anh vẫn chưa nhanh lắm. Anh có lẽ sẽ thử một model nhỏ hơn cho việc này; còn route balanced chạy khoảng 20 phút và làm khá ổn thì cũng không tệ. Rồi khi thử và tìm ra thứ thật sự cải thiện chất lượng và tốc độ, anh mới quyết định có cần chạy model deep như thế này mỗi lần hay không.
Hoặc, theo anh (video đăng ngày 30/10/2026), có thể dựng kiểu leo thang sang một subagent khác: nếu hai báo cáo mâu thuẫn nhau, anh có thể đẩy lên một agent thứ ba để kiểm định các báo cáo, giống như điều vừa làm ở đây. Tất cả những việc trên được làm bằng model routes.
15. Profile routes: subagent mang theo cả profile
Thứ tiếp theo có thể thử là profile routes. Như anh đã nói, đây là khi bạn muốn chạy một thứ như orchestrator, rồi để nó giao việc cho một researcher chuyên biệt, một librarian agent hay một coding agent: bạn dựng profile routes và mô tả khi nào dùng mỗi cái. Thay vì gọi các subagent với model khác nhau, nó gọi các subagent với profile khác nhau (theo Callum, video đăng ngày 30/10/2026).
Ví dụ của Callum: anh có orchestrator agent. Trong orchestration, thay vì để các bot nhắn tin cho nhau ở bên cạnh và làm việc theo nhóm trong group chat (anh cho xem cảnh đó), ta có thể để orchestrator agent khởi chạy một subagent mang profile researcher. Điểm then chốt, theo anh (video đăng ngày 30/10/2026), là researcher khi đó có main model riêng, skills và keys riêng, và ví dụ cả các năng lực riêng.
Bấm vào Profile routes, ta đưa ra danh sách profile mà subagent được phép chạy dưới vai đó. Ví dụ đang chạy từ tài khoản orchestrator, anh chọn researcher ở đây và ghi rõ khi nào muốn dùng nó. Tương tự, anh có librarian, profile chạy LLM wiki của anh, và cũng ghi rõ khi nào dùng nó (demo trong video đăng ngày 30/10/2026). Ý tưởng là đưa vào một tấm bản đồ: khi nào các profile được phân bổ, được giao việc dưới dạng subagent.
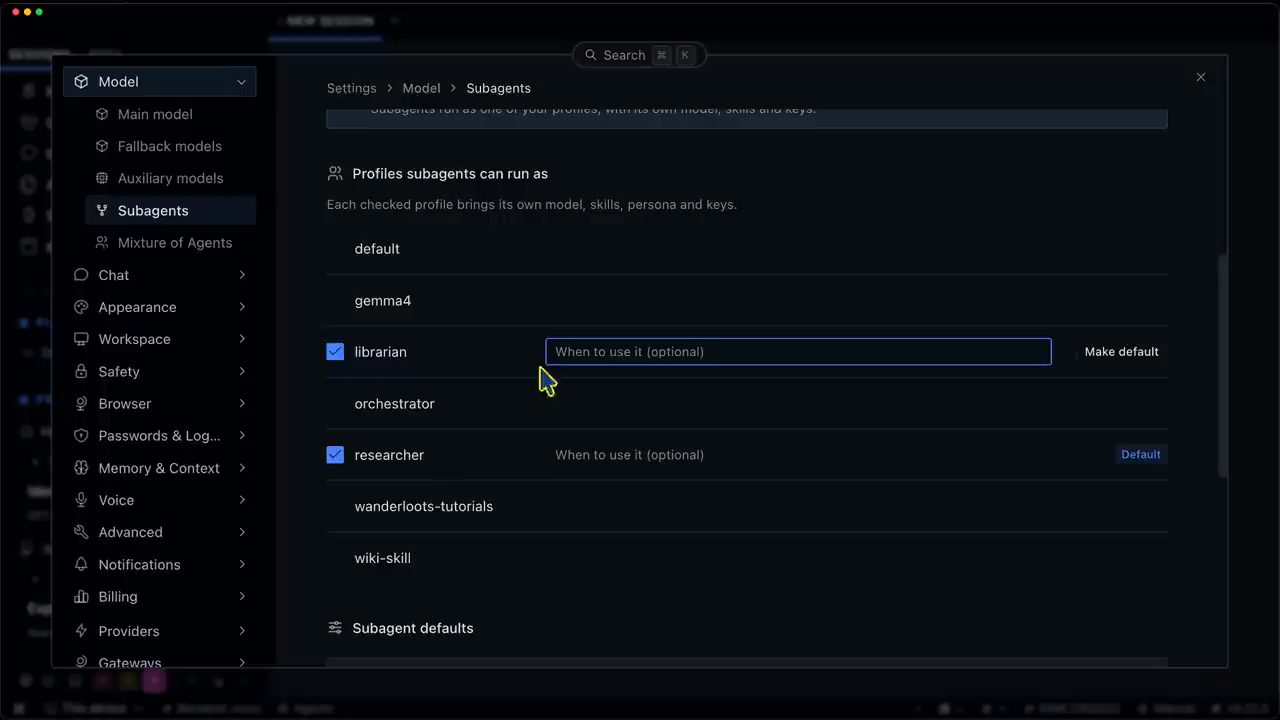
Tuy nhiên, theo Callum (video đăng ngày 30/10/2026), một giới hạn then chốt là nó không mang theo context của riêng nó. Nó có mang vào, ví dụ, soul của researcher, tức cấu hình về tính cách và cách nó thích làm việc, nhưng không mang vào memory của researcher. Mọi context đưa cho researcher, ngoài agents.md và soul.md (anh nói anh tin là vậy), phải được orchestrator truyền xuống.
Trang docs Subagent Delegation của Hermes (đọc ngày 01/11/2026) ghi rằng liệt kê một profile trong profile routes cho phép subagent của profile hiện tại dùng credentials, credential pool, SOUL.md và terminal policy của profile đó.
Nếu muốn đi vào những tình huống tuỳ biến hơn, đưa thêm context và agentic memory cho một profile cụ thể, thì theo anh (video đăng ngày 30/10/2026) đó là lúc cần tới Kanban. Nhưng anh hình dung rằng nếu bạn chỉ có một task làm một lần và chấp nhận để nó dùng, ví dụ, một researcher như vừa làm, thì làm bằng một subagent được giao việc có lẽ là ổn, không cần tới Kanban. Theo anh, Kanban hợp hơn khi bạn cần nhiều hành động nối tiếp nhau, có các trigger khác nhau, các kết quả và các phép so sánh khác nhau. Dựng model routing và profile routing thế nào là tuỳ bạn.
Một ưu điểm khác của Kanban so với từng subagent riêng lẻ như anh đang làm, theo Callum (video đăng ngày 30/10/2026): nếu Hermes agent của anh thoát ngay lúc này, anh có thể mất phần việc của subagent đó, vì nó không có persistence. Còn khi chạy trong Kanban, nó tạo task card trong lúc làm, nên theo dõi được tiến độ trong một database riêng.
16. Kanban kết hợp auxiliary models
Callum quay lại Settings, vào Auxiliary models, nơi cấu hình các helper task vốn chạy trên main model theo mặc định. Ở đây cũng có những mục riêng cho Kanban (theo video đăng ngày 30/10/2026).
Mục thứ nhất là triage specifier: dùng một agent chuyên biệt để nhận diện các task Kanban rồi giao chúng cho đúng profile cần. Mục thứ hai là task decomposer: bạn có thể để một model local xem các task là gì, chia thành subtask, rồi giao chúng cho các task khác. Tất cả diễn ra bên trong Kanban (theo Callum, video đăng ngày 30/10/2026).
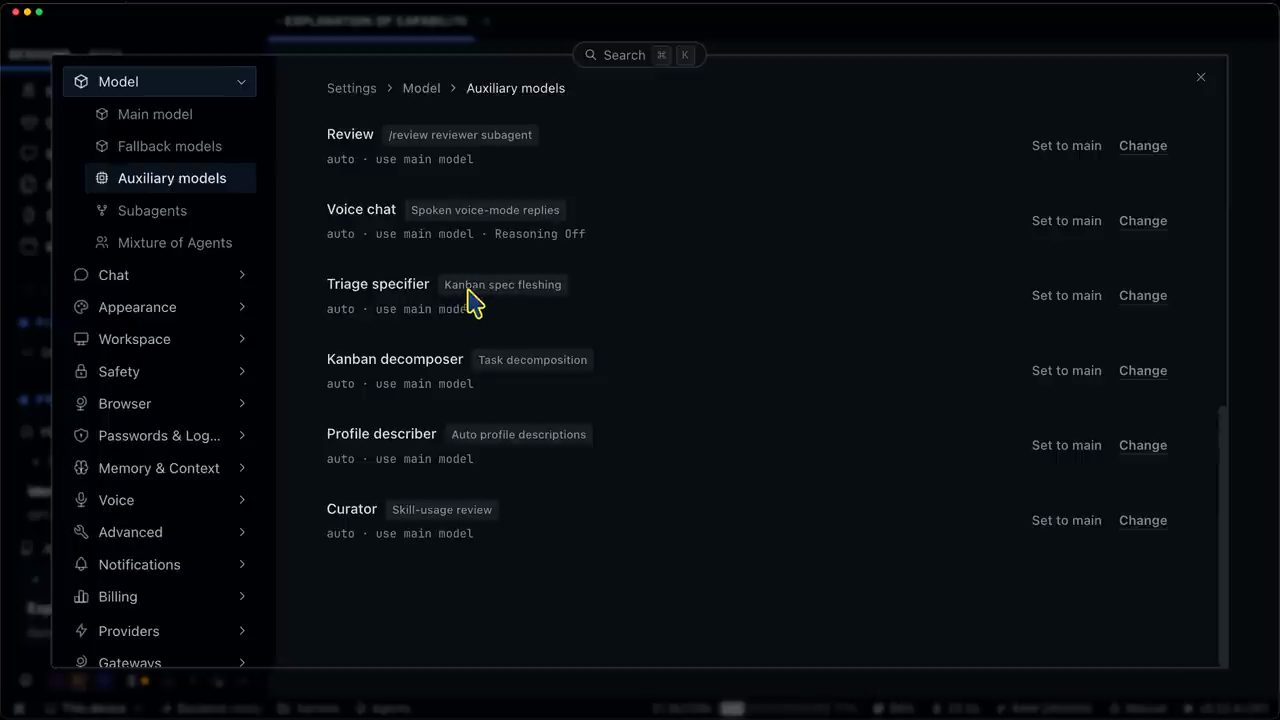
Trong bảng Kanban, ví dụ, có lựa chọn "Auto-decompose triage tasks": anh thêm một card mới, và auto decomposer sẽ xác định ai chịu trách nhiệm xử lý mục đó (demo trong video đăng ngày 30/10/2026). Trang docs Kanban của Hermes (đọc ngày 01/11/2026) ghi rằng decomposer dựng sẵn dùng đường model auxiliary.kanban_decomposer, đọc danh sách profile kèm mô tả, và chia task thành một đồ thị nhỏ các task con; model của nó và của triage specifier cấu hình trong config.yaml dưới auxiliary.kanban_decomposer và auxiliary.triage_specifier.
Theo Callum (video đăng ngày 30/10/2026), anh từng chạy nhiều thử nghiệm với Kanban và thấy một trong những khoản tốn token lớn hoá ra là task này, auto decompose triage tasks. Vậy thay vì phí số token đó cho một frontier model, giờ anh có thể giao nó cho một model local đã kết nối ở đây.
Ví dụ, kể cả khi orchestrator agent của anh chạy ở, giả sử, Astra, anh vẫn có thể chọn ChatGPT và cho triage specification chạy Luna: một model rẻ và nhanh, ở mức reasoning tương đối thấp, và theo anh (video đăng ngày 30/10/2026) cách này sẽ tiết kiệm cho anh rất nhiều credit. Trong demo, ô Triage specifier hiện "ChatGPT or Codex Subscription", model gpt-6-luna, và ô Reasoning đang ở "Medium".
17. Mixture of Agents
Còn một tính năng nữa Callum muốn nhắc: lựa chọn Mixture of Agents. Theo anh (video đăng ngày 30/10/2026), về cơ bản thay vì chỉ có một model duy nhất, ta có thể cho nhiều model khác nhau chạy cùng lúc rồi chuyển thông tin về lại orchestrator. Thay vì kết nối tới một model, bạn kết nối tới một hội đồng model, hay một mixture of agents.
Với anh, đây sẽ là phần thú vị nhất khi ta bắt đầu chạy model local của riêng mình (theo Callum, video đăng ngày 30/10/2026). Ta có thể dùng hai model kém mạnh hơn thay vì một model như GPT 6.1 Sol, thứ có thể là một model tuyệt vời tự thân nó; hai model tầng thấp hơn đó làm việc độc lập, rồi đối chiếu kết quả của nhau, và tập thể đó có thể nâng chất lượng khi kết quả được chuyển tới aggregator.
Ví dụ của anh: một trong những lỗi chính của model fast là có một chỗ overclaim quan trọng, dùng một tham chiếu chưa được định nghĩa và nói quá một điều thật ra mang tính toán học hơn (demo trong video đăng ngày 30/10/2026). Gợi ý của anh để xử lý kiểu lỗi đó: thay vì route fast chỉ là Gemma 4 26B, ta dựng một model mixture of agents, trong đó reference một là Gemma, reference hai là một model kiểu Qwen, hoặc Bonsai. Như vậy thay vì model fast chỉ chạy một lần, ta cho nó chạy song song rồi so kết quả sau đó. Theo anh, đó là một cách nâng chất lượng output. Rồi ta đặt aggregator lại là Gemma 4 26B.
Anh nói mình cần thử nghiệm thêm với cách này; đây chỉ là ví dụ, và đáng để bạn tự thử. Nhưng theo Callum (video đăng ngày 30/10/2026), đó là một cách để cải thiện chất lượng của model local bằng việc đổi model route sang dùng một mixture of agents.
Trang docs Mixture of Agents của Hermes (đọc ngày 01/11/2026) mô tả MoA là một virtual model provider: aggregator là model hành động, viết câu trả lời và gọi tool, và bị tính tiền cho cả lượt chạy; các reference model chạy trước, theo mặc định chỉ góp ý một lần mỗi lượt của người dùng.
18. Khi nào dùng gì
Nói xong những điều trên, Callum đưa nhanh một cây quyết định để hiểu khi nào nên dùng gì (video đăng ngày 30/10/2026).
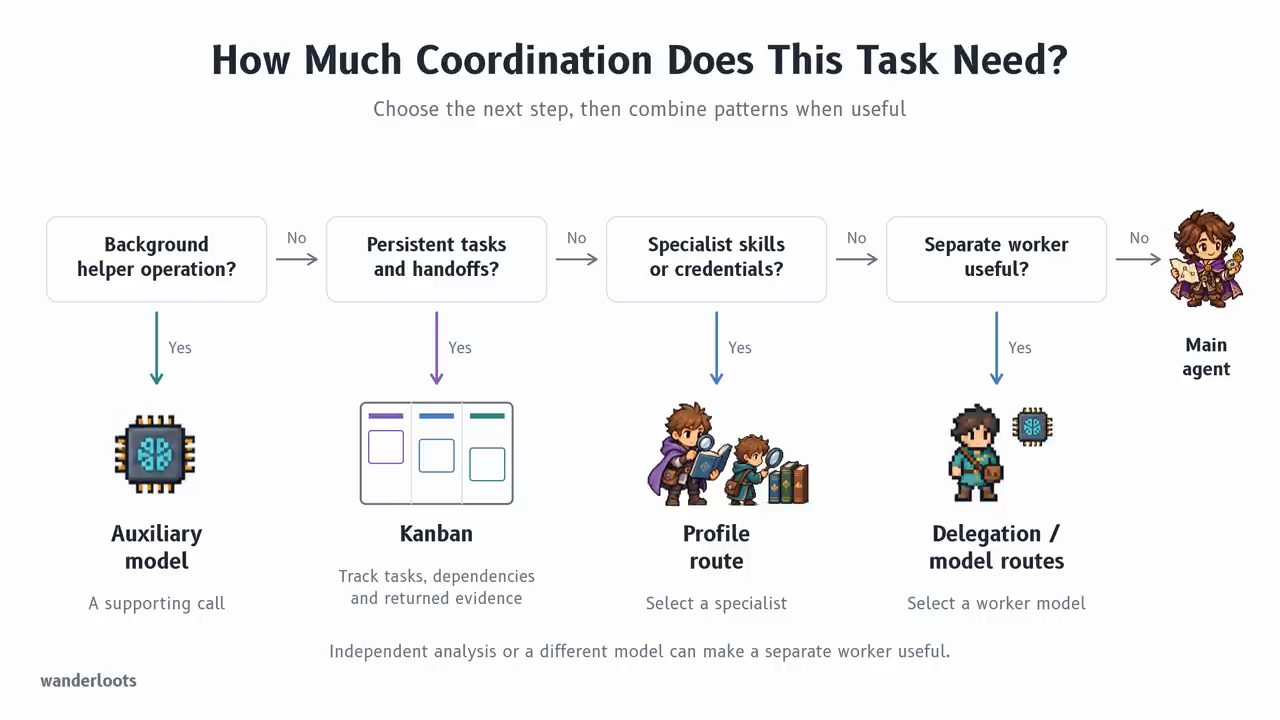
Câu hỏi đầu tiên: đây có phải việc nội bộ không? Nếu có, Callum khuyên xem auxiliary models (theo Callum, video đăng ngày 30/10/2026). Anh nghĩ đây là chỗ nên bắt đầu, với vài mục then chốt như compression, skills hub, và nếu dùng Kanban thì xem triage specifier và Kanban decomposer. Theo anh, nếu làm cho vài mục trong số này chạy ổn trên model local hoặc model rẻ, bạn sẽ thật sự tiết kiệm được rất nhiều chi phí, có khi cả thời gian.
Câu hỏi tiếp: việc này có cần một workflow nhiều bước, có persistence không? Theo Callum (video đăng ngày 30/10/2026), đó là chỗ dùng Kanban: có đủ các card, có nhiều profile khác nhau cùng làm việc, và persistence là then chốt, vì các card được lưu trong một database riêng. Bạn có thể quay lại xem mọi hành động đã làm, các báo cáo đã tạo; nó tồn tại lâu hơn bản thân lượt chạy.
Ngược lại, anh không bấm vào lại subagent vừa chạy được nữa. Vào mục agents, chúng không còn ở đó, chỉ ghi "list" (demo trong video đăng ngày 30/10/2026). Theo những gì anh biết, không thể quay lại xem chuyện gì đã thật sự diễn ra ở đó; anh nói có thể anh sai và ai đó có thể chỉnh anh. Còn trong Kanban thì xem được, từng hành động một. Theo anh (video đăng ngày 30/10/2026), đó là điều nên nhớ, nhất là khi bắt đầu đi vào các workflow phức tạp hơn.
Câu hỏi kế: việc này có cần skills, tools hay credentials riêng của một chuyên gia không? Nếu có, theo Callum (video đăng ngày 30/10/2026), có lẽ nên dùng profile routes thay vì model routes. Ví dụ, nếu đang chạy từ orchestrator, anh có thể chạy researcher, và researcher tự động cho anh quyền dùng thêm các plugin và connector, như MCP connector riêng của nó. Vậy bạn đưa được các tool research chuyên biệt vào thông qua profile researcher, dưới dạng một subagent bên trong orchestrator.
Tuy nhiên, theo anh (video đăng ngày 30/10/2026), nếu bạn cần memory của researcher, tức hệ thống memory bạn đã dùng theo thời gian, thì đó lại là trường hợp phải dùng Kanban, vì Kanban chạy trọn một profile với toàn bộ context của researcher đó, còn subagent thì không.
Câu hỏi cuối: phân tích độc lập có cải thiện kết quả không? Theo Callum (video đăng ngày 30/10/2026), đó là chỗ dùng delegation bình thường, hoặc model map của Advanced Delegation plugin. Vì như đã thấy, ta chạy được nhiều agent song song, rồi để aggregator agent hay parent agent phân tích output, đối chiếu chúng với nhau để hy vọng ra một kết quả tốt hơn.
Sau đó, theo Callum (video đăng ngày 30/10/2026), bạn có thể cân nhắc tới quyền riêng tư: bạn cần năng lực local, cloud hay hybrid? Nhờ vậy bạn giữ được quota và ưu tiên được thứ mình cần. Nếu việc không cần xảy ra quá nhanh, bạn có thể giao cho các agent local, chúng sẽ mất nhiều thời gian hơn nhưng giữ được quyền riêng tư và chi phí.
Theo anh (video đăng ngày 30/10/2026), chuyện này thật sự tuỳ bạn, và anh rất khuyên tự thử để xem cái gì hợp nhất. Mục tiêu không phải là dùng model mạnh nhất cho mọi việc, mà là tìm đúng trí tuệ cho đúng việc, và tổ hợp giúp giải quyết những vấn đề của riêng bạn.
Callum cảm ơn mọi người đã xem.
Nguồn và liên kết 11 nguồn
- Tên gốc: Don't Use 1 Model For Everything? 🧠 Hermes Agent Advanced Delegation
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=CtnwJp6MyUc youtube.com
- Kênh YouTube Wanderloots (Callum Lootsma): youtube.com/channel/UCFiU1vIpPD3lQltke_18m3A youtube.com
- Trang chủ Hermes Agent của Nous Research: hermes-agent.nousresearch.com hermes-agent.nousresearch.com
- Docs Hermes Agent, Subagent Delegation (chiến lược
model_mapvàprofile_routestừ advanced-delegation plugin; profile routes dùng chung credentials và SOUL.md, đọc ngày 01/11/2026): hermes-agent.nousresearch.com/docs/user-guide/features/delegation hermes-agent.nousresearch.com - Docs Hermes Agent, Kanban (decomposer dùng
auxiliary.kanban_decomposer, triage specifier dùngauxiliary.triage_specifier, đọc ngày 01/11/2026): hermes-agent.nousresearch.com/docs/user-guide/features/kanban hermes-agent.nousresearch.com - Docs Hermes Agent, Mixture of Agents (aggregator là model hành động và bị tính tiền cho cả lượt chạy, đọc ngày 01/11/2026): hermes-agent.nousresearch.com/docs/user-guide/features/mixture-of-agents hermes-agent.nousresearch.com
- Docs Hermes Agent, Configuration (auxiliary models như
auxiliary.compression, đọc ngày 01/11/2026): hermes-agent.nousresearch.com/docs/user-guide/configuration hermes-agent.nousresearch.com - Repo Hermes Agent: github.com/NousResearch/hermes-agent github.com
- llama.cpp, engine Hermes đóng gói sẵn để chạy model local (theo Callum, video đăng ngày 30/10/2026): github.com/ggml-org/llama.cpp github.com
Related talks
Hướng dẫn Claude Cowork: skill, plugin, project và automation
Nguyễn Trung Hiếu · Maz The Analyst · 17 min
Setup Claude Cowork, dọn folder và làm carousel, tạo skill có memory, dùng connector, plugin, project, scheduled task và Dispatch.
5 use case GrokBot với nhiều agent nhắn tin cho nhau
Brock Mesarich · Brock Mesarich | AI for Non Techies · 22 min
Năm use case GrokBot: inbox, video, Firecrawl, invoice và meeting agent phối hợp qua group chat, routine, trigger, plugin và Zapier MCP.
8 use case Grok Bot thay đổi cách làm việc
Alex Finn · Alex Finn · 27 min
Alex Finn đi qua tám agent Grok Bot anh đang chạy: chief of staff, email, coding, content, community, research, last30days và Hermes local.