Năm agent Qwen vượt Claude trên một bài test code khó
Workflow Memdoor chia một bài code khó cho năm vai cùng dùng Qwen3.8-27B, giao tiếp qua file, chấm bằng test, và giới hạn của kết quả này.
✓ Đã duyệt độc lập · cập nhật 02/11/2026 · 11 min
1. Năm bản Qwen3.8-27B vượt Claude Fable 5
Video (đăng ngày 01/11/2026) mở đầu bằng kết quả: năm bản sao của model mở Qwen3.8-27B đã vượt Claude Fable 5 trên một benchmark lập trình khó. Người điều phối năm bản sao này là Memdoor: nó giao cho mỗi bản một việc khác nhau, và giữ lại phần việc mà mỗi bản làm ra giữa các bước.
Theo kết quả trong video đăng ngày 01/11/2026, qua 50 lần thử, team Memdoor viết ra 49 chương trình đúng. Model nền không được train thêm và cũng không lớn hơn. Theo video, phần tăng đến từ việc tổ chức lại cách model tiếp cận từng bài. Benchmark này tên là LiveCodeBench Hard.
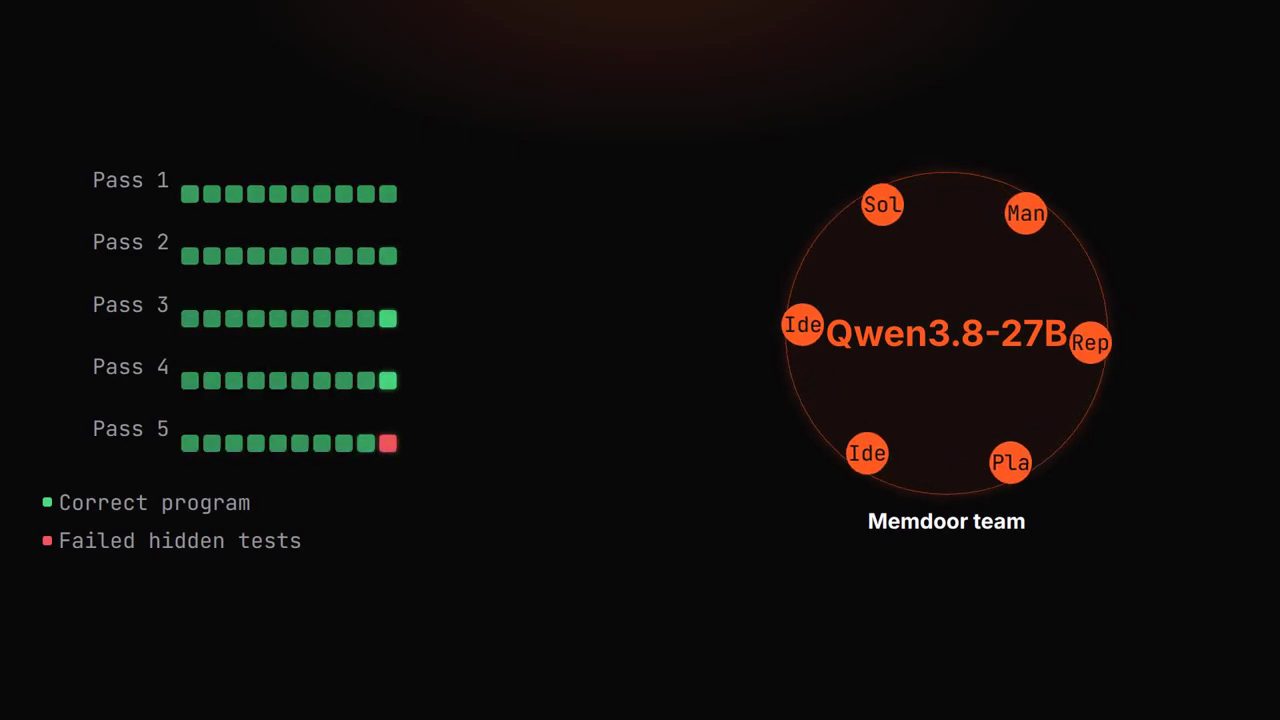
2. LiveCodeBench Hard chấm bài như thế nào
Theo video (đăng ngày 01/11/2026), mỗi thử thách trong LiveCodeBench Hard mô tả một bài toán lập trình và đưa kèm vài input mẫu cùng output mong đợi. Hệ thống viết code phải viết ra một chương trình chạy đúng cả ngoài những ví dụ đó. Sau đó một grader chạy chương trình trên các hidden test mà hệ thống chưa từng thấy.
Vì vậy, theo video (đăng ngày 01/11/2026), qua được các mẫu nhìn thấy (visible samples) chỉ là một bước kiểm tra sơ bộ. Điểm cuối cùng phụ thuộc vào mọi hidden test.
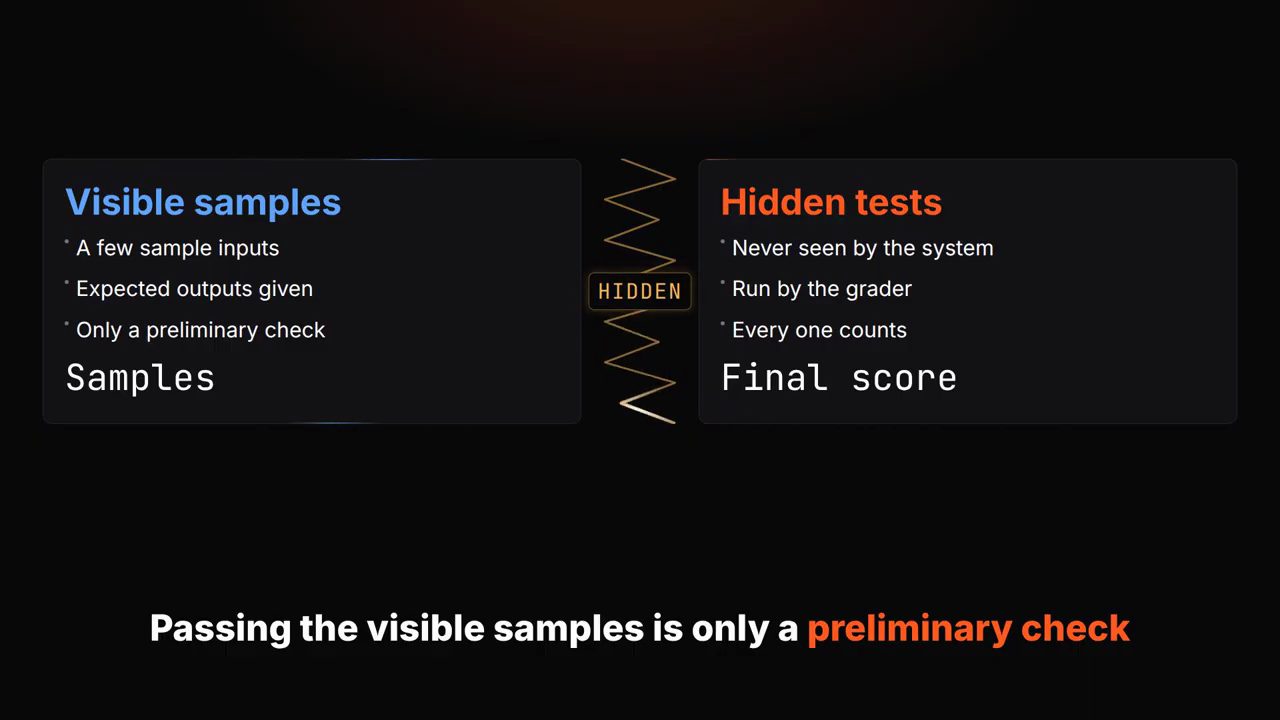
Memdoor được thử trên mười bài hard đầu tiên của một dự án nghiên cứu tên là Gorilla vs. 5 Humans (theo video đăng ngày 01/11/2026). Code của dự án này nằm trong repo GVS5H, và paper đi kèm có tên "GVS5H: Zero-Shot Self-Orchestration with Ledger-Based Control for Improved LLM Coding Performance" (arXiv, 2026; đọc ngày 02/11/2026).
3. Mười bài, năm lượt: một phép so sánh hẹp
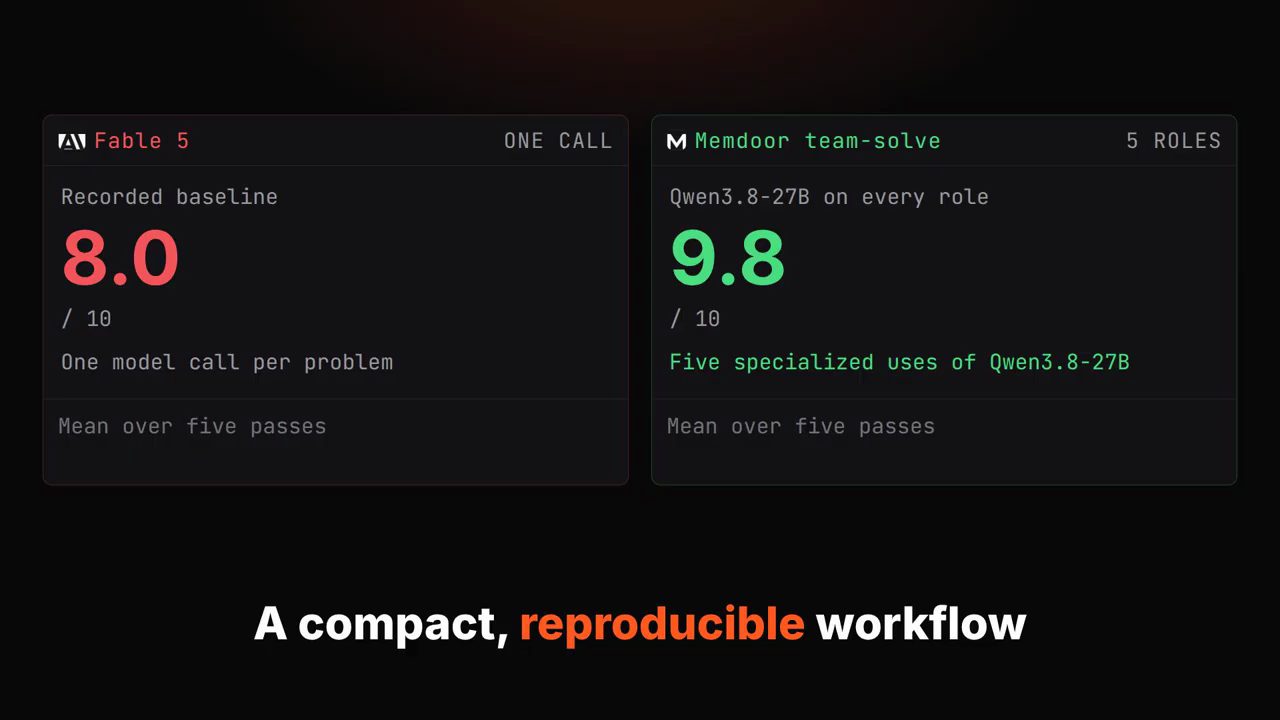
Thí nghiệm lặp lại mười bài đó năm lần. Theo kết quả trong video đăng ngày 01/11/2026, workflow Memdoor đạt trung bình 9,8 câu đúng trên 10. Claude Fable 5, trả lời mỗi bài bằng một lần gọi model, đạt trung bình 8 trên 10 theo các file kết quả của nhóm nghiên cứu gốc.
Video (đăng ngày 01/11/2026) nói rõ phép so sánh này hẹp, vì thí nghiệm Memdoor chỉ phủ 10 bài chứ không phải cả bộ 100 bài. Chênh lệch giữa 9,8 của Memdoor và 9,6 của nhóm nghiên cứu gốc quá nhỏ để khẳng định rằng Memdoor đã cải tiến phương pháp của họ. Dù vậy, theo video, điều có cơ sở để nói vẫn đáng kể: Memdoor tái hiện được hiệu năng team của nhóm nghiên cứu, và vượt baseline Fable 5 đã được ghi lại.
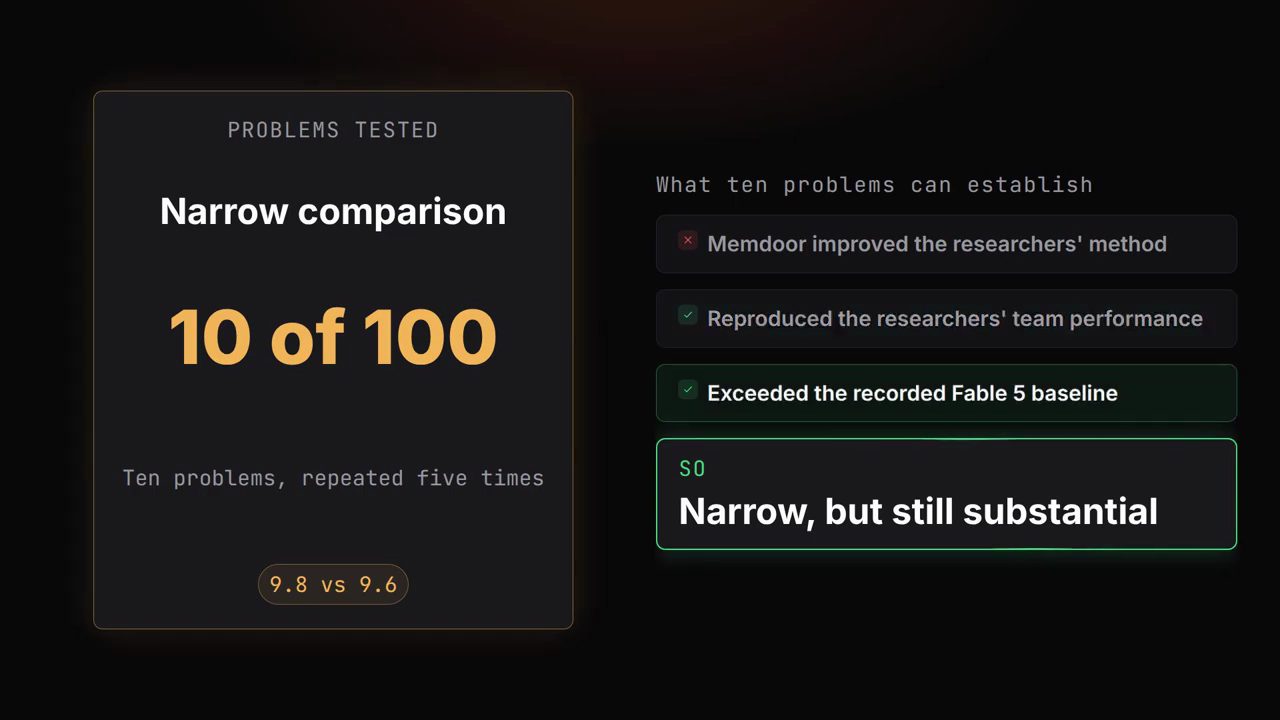
4. Vì sao một lần gọi model phải gánh mọi kiểu suy luận
Theo video (đăng ngày 01/11/2026), một lần gọi model phải làm nhiều kiểu suy luận trong cùng một cuộc hội thoại. Model phải hiểu đề, chọn thuật toán, kiểm tra thuật toán có đúng không, viết chương trình, và tự nhận ra lỗi của chính mình.
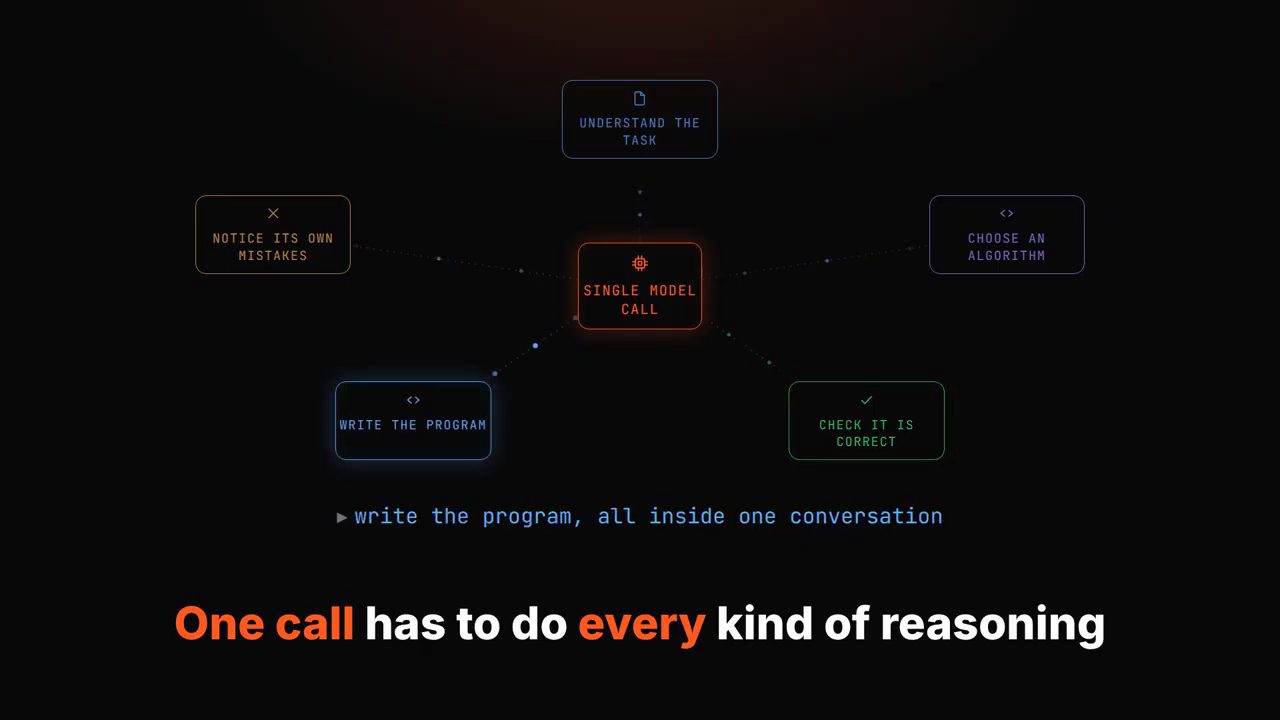
Theo video (đăng ngày 01/11/2026), một quyết định sớm có thể định hình mọi thứ phía sau. Nếu model chọn sai hướng, phần suy luận sau đó có thể dồn sức vào việc sửa một cái nền vốn đã sai. Workflow Memdoor tách các trách nhiệm đó ra.
5. Các vai trong workflow Memdoor
Theo video (đăng ngày 01/11/2026), một planning agent đọc đề bài và viết ra một plan. Sau đó hai idea agent làm việc song song. Một agent tìm một thuật toán trực tiếp, có thể lập luận rõ ràng là đúng. Agent kia cố ý tìm một họ kỹ thuật khác.
Theo video (đăng ngày 01/11/2026), một solver đọc cả hai đề xuất rồi chọn một hướng. Solver viết chương trình và ghi lại lý do chọn hướng đó. Một lệnh sau đó chạy các public sample test. Một manager xem xét chương trình cùng kết quả test, rồi viết hướng dẫn sửa (repair instructions).
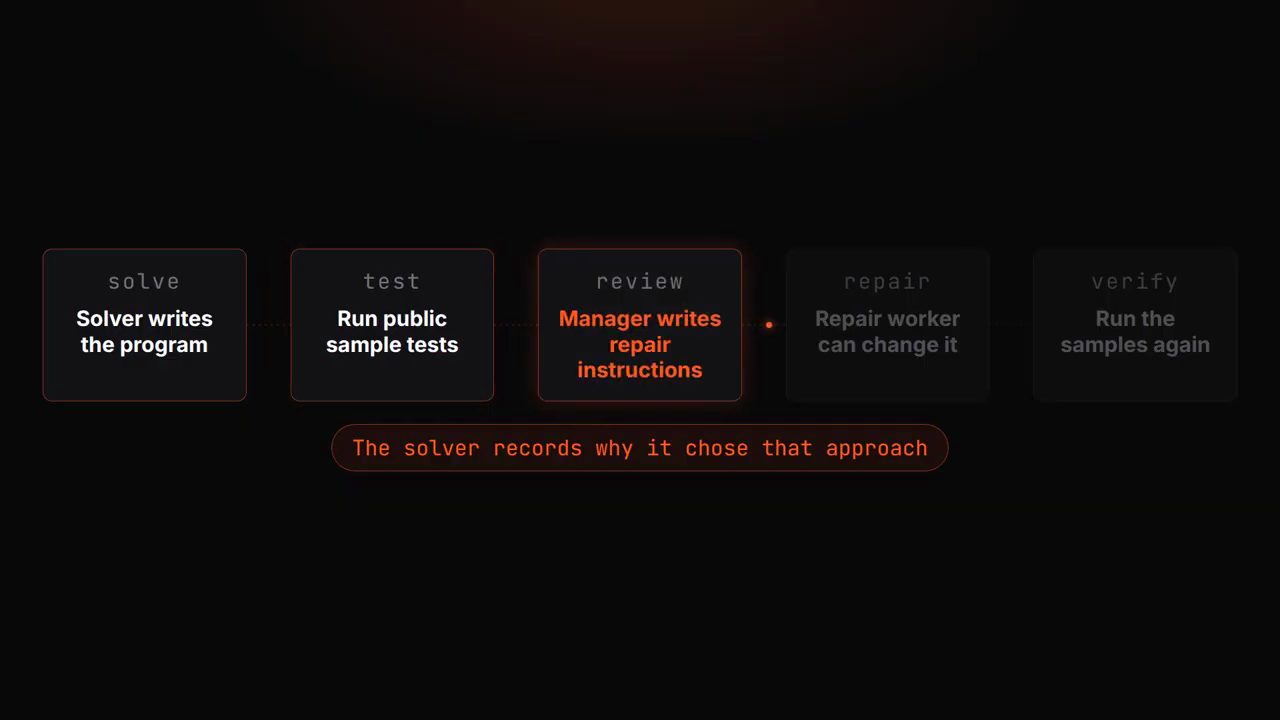
Một repair worker có thể sửa chương trình, và một lệnh cuối chạy lại các mẫu. Theo video (đăng ngày 01/11/2026), năm vai suy luận chính lái quá trình này, cộng thêm một bước sửa được gọi khi manager yêu cầu thay đổi.
6. Cùng một model, khác trách nhiệm: hai idea agent
Theo video (đăng ngày 01/11/2026), mọi vai đều dùng Qwen3.8-27B. Vì vậy lợi thế không đến từ việc đặt một model mạnh hơn vào vị trí chỉ huy. Nó đến từ việc giao cho những lần gọi lặp lại của cùng một model các trách nhiệm khác nhau.
Video (đăng ngày 01/11/2026) nói hai idea agent đặc biệt quan trọng. Giả sử một bài trông như mời gọi một luật greedy nhanh, kiểu chương trình cứ lặp lại việc chọn cái trông tốt nhất ở thời điểm đó. Một agent có thể thử chứng minh luật đó. Agent kia có thể khảo sát một hướng khác, chẳng hạn theo dõi nhiều trạng thái có thể xảy ra.
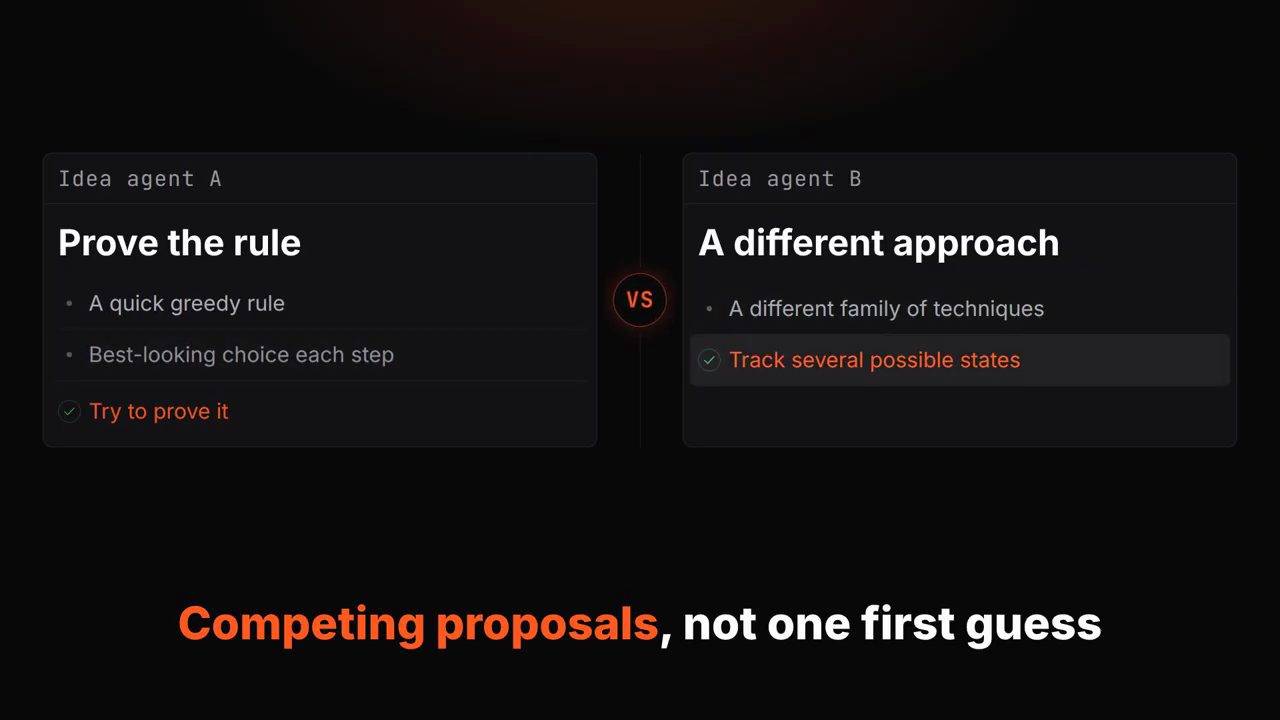
Theo video (đăng ngày 01/11/2026), nhờ vậy solver nhận được các đề xuất cạnh tranh nhau trước khi viết code, thay vì nhận một phỏng đoán đầu tiên không ai phản biện.
7. Không chung đoạn chat: file là bộ nhớ làm việc
Theo video (đăng ngày 01/11/2026), các agent không dùng chung một đoạn chat cứ dài ra mãi. Mỗi agent bắt đầu với một context mới, và đọc phần việc các agent trước để lại trong file. Các file đó chứa plan, các đề xuất cạnh tranh, chương trình hiện tại, output của test và hướng dẫn sửa.
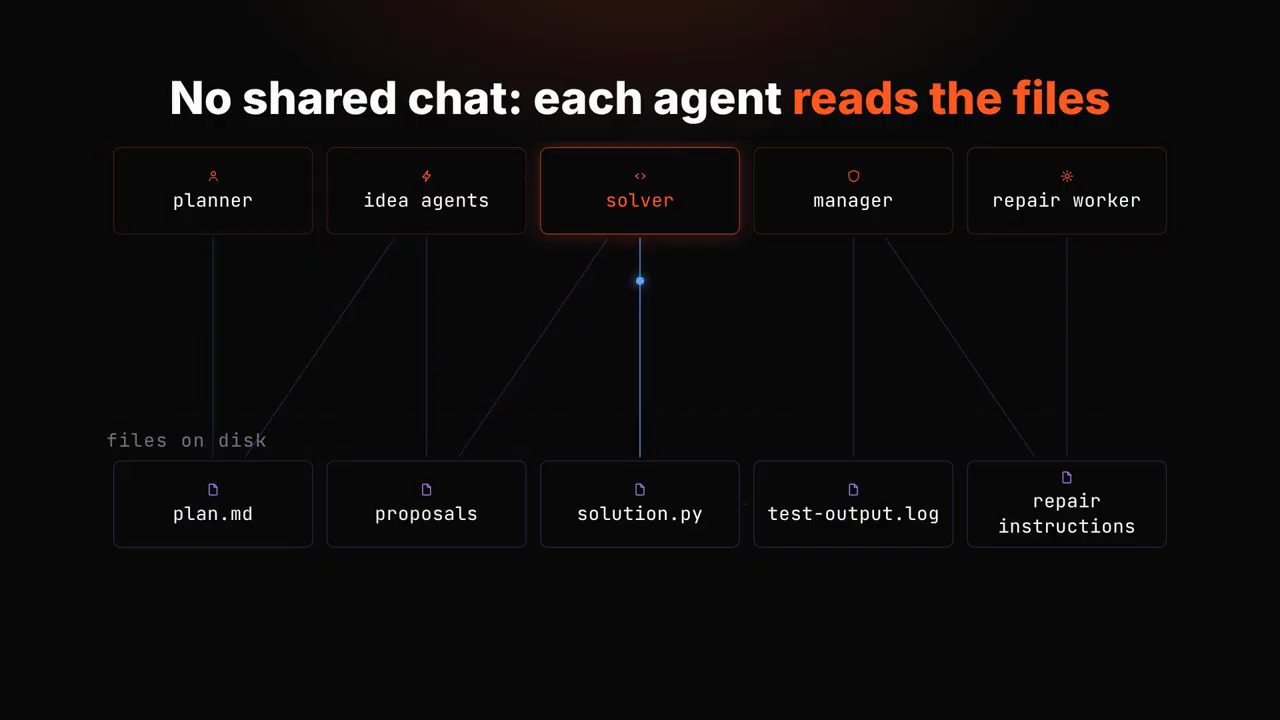
Theo video (đăng ngày 01/11/2026), nghiên cứu gốc gọi cách này là ledger-based zero-shot self-orchestration. Video nói cái tên không quan trọng bằng tác dụng thực tế: các file đóng vai bộ nhớ làm việc lâu dài (persistent working memory). Một agent mới thấy được những quyết định quan trọng mà không phải thừa hưởng mọi ý nghĩ đã bỏ dở và mọi đoạn rẽ ngang trong hội thoại của các lần gọi trước. Team giữ lại trạng thái hữu ích của bài toán, đồng thời cho mỗi vai một chỗ sạch để suy luận.
8. Handoff kiểm tra được, và model không tự chấm điểm
Theo video (đăng ngày 01/11/2026), cấu trúc này còn làm cho mỗi lần bàn giao (handoff) kiểm tra được. Solver không thể lặng lẽ tuyên bố rằng đã cân nhắc cả hai đề xuất, vì các đề xuất tồn tại thành những file riêng. Manager nhận một chương trình thật và output test thật. Repair worker nhận hướng dẫn bằng văn bản. Nếu một lượt chạy hỏng, dấu vết cho thấy quyết định đã đổi ở đâu.
Điều quan trọng nhất, theo video (đăng ngày 01/11/2026), là không có model nào trao kết quả cuối cùng. Một script chạy chương trình và so output với output mong đợi. Sau đó grader ẩn của benchmark quyết định chương trình nộp lên có thật sự đúng hay không. Các agent có thể tranh luận về một lời giải, nhưng sự tự tin của chúng không được tính là bằng chứng.
9. Tám file YAML, không có code
Theo video (đăng ngày 01/11/2026), toàn bộ quá trình được mô tả bằng 8 file cấu hình viết bằng YAML. Các file này quy định bước nào đọc tài liệu nào, mỗi agent phải tạo ra gì, và những bước nào phía trước phải xong trước. Bản thân workflow không chứa code chương trình tự viết nào. Nó cũng không nêu tên một model cụ thể, nên cùng cấu trúc đó có thể trỏ sang một kết nối model khác được hỗ trợ.
Nội dung file trên màn hình (file 1 trên 8, thư mục team-solve/steps/):
# steps/solve.yaml
# reads: both proposals
# writes: solution.py, its decision in notes.md
requires: [ideate-a, ideate-b]
# no custom code
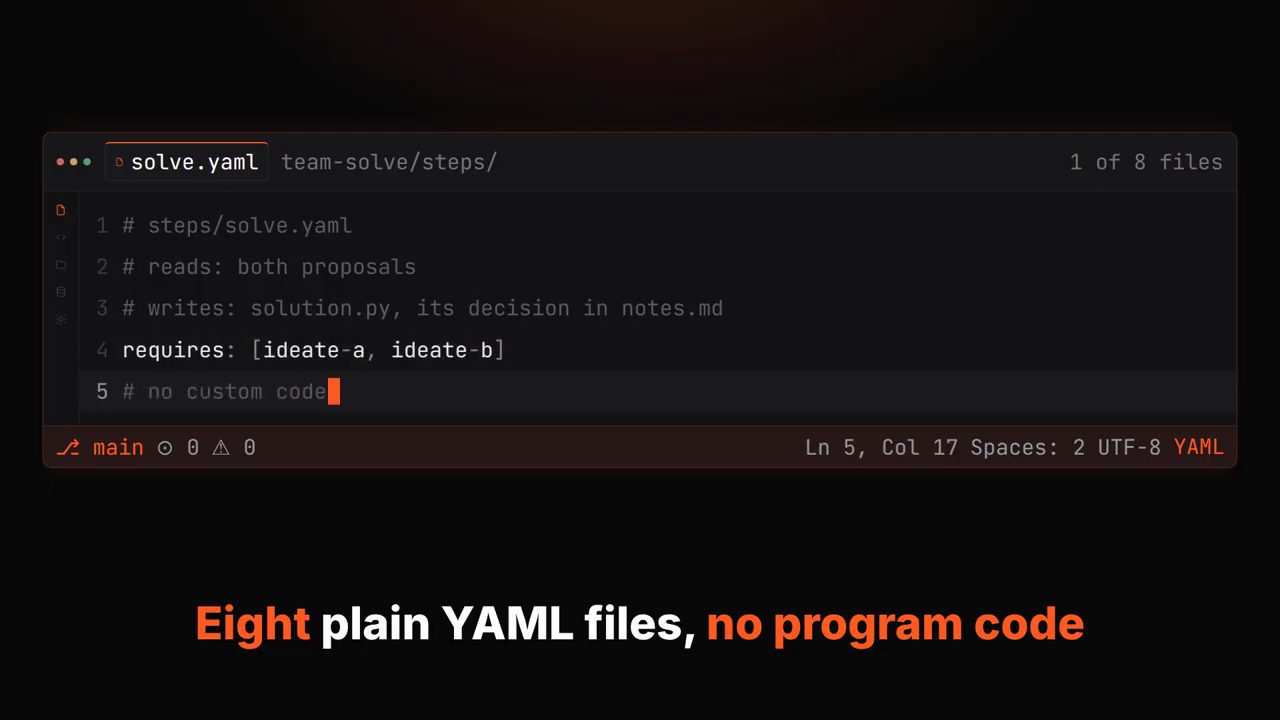
Trong repo Memdoor, thư mục examples/workflows/team-solve/steps/ có tám file: plan, ideate-a, ideate-b, solve, test, review, repair và verify (đọc ngày 02/11/2026).
10. Tái hiện đúng phương pháp gốc: parity test
Theo video (đăng ngày 01/11/2026), phiên bản của Memdoor được thiết kế để tái hiện phương pháp Gorilla vs. 5 Humans gốc. Một parity test đưa một model chạy theo kịch bản (scripted model) qua cả hai hệ thống rồi so các request sinh ra. Cả bốn test case khớp nhau từng byte. Một thay đổi chỉ một ký tự làm test phát hiện ra khác biệt.
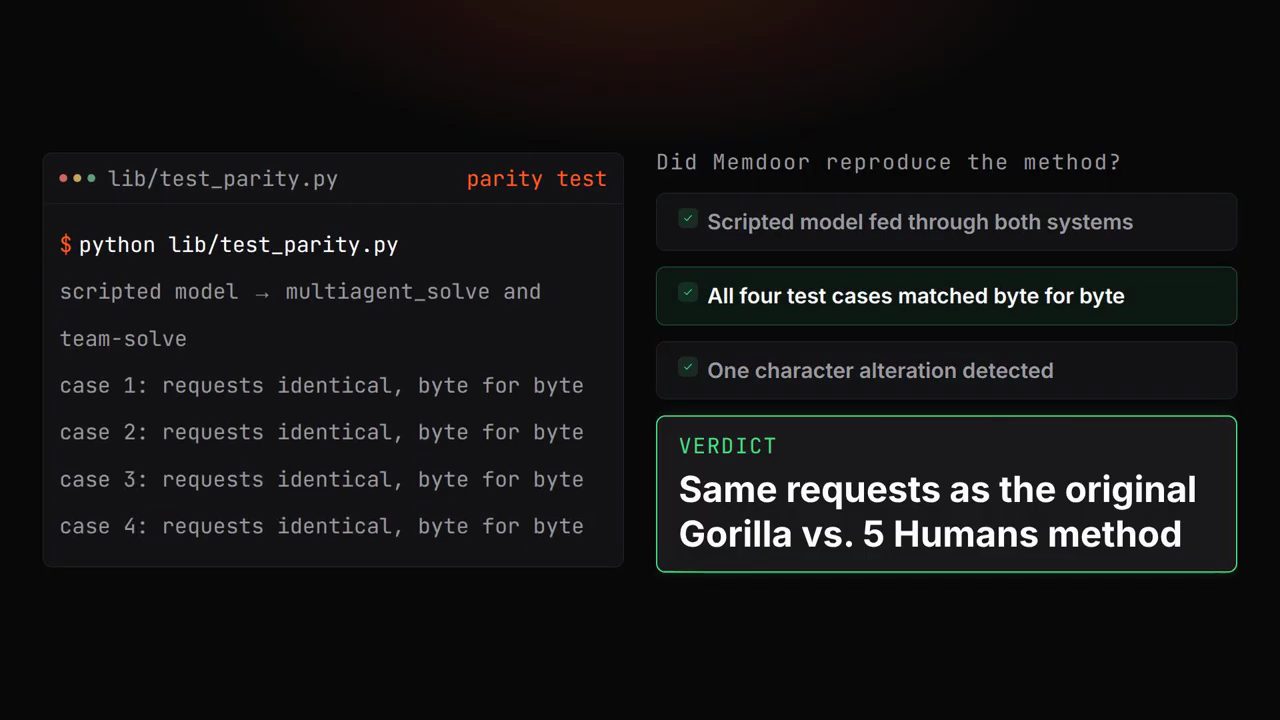
python lib/test_parity.py đưa scripted model qua multiagent_solve và team-solve, cả bốn case cho request giống hệt nhau từng byte. Verdict: "Same requests as the original Gorilla vs. 5 Humans method".Theo video (đăng ngày 01/11/2026), điều này quan trọng vì một bản bắt chước lỏng lẻo có thể cho điểm tương tự vì những lý do không liên quan. Request khớp nhau cho thấy Memdoor giữ nguyên prompt và vòng điều khiển (control loop) trong các trường hợp đã test.
Môi trường chạy chính thì vẫn khác. Theo video (đăng ngày 01/11/2026), nhóm nghiên cứu gốc tự phục vụ model, còn các lượt chạy Memdoor gọi Qwen qua một dịch vụ API trung gian cho model.
11. Kết quả đầy đủ trong paper: 100 bài, 11 model
Theo video (đăng ngày 01/11/2026), paper rộng hơn cho thấy vì sao kết quả mười bài của Memdoor đáng chú ý. Trên 100 bài LiveCodeBench hard, Qwen3.8-27B dùng một mình giải được 66,8%. Bản có điều phối (orchestrated) đạt 92,4%. Claude Fable 5 đạt 90,4% trên cùng bộ bài. Vậy trong thí nghiệm đầy đủ của paper, cấu trúc team đã nâng Qwen thêm hơn 25 điểm phần trăm. Phần tóm tắt của paper (arXiv, 2026; đọc ngày 02/11/2026) cũng ghi Qwen3.8-27B đạt 92,4% và Fable 5 đạt 90,4%.
Theo video (đăng ngày 01/11/2026), nhóm nghiên cứu đã thử 11 model, và lợi ích không tự động đến với mọi model. Có model giữ nguyên, có model còn tệ đi. Video nói điều phối (orchestration) là một phương pháp có thể khuếch đại phần suy luận hữu ích, chứ không phải lời bảo đảm rằng thêm lời gọi thì lúc nào cũng có ích. Phần tóm tắt của paper (arXiv, 2026; đọc ngày 02/11/2026) cũng ghi rằng lợi ích không phổ quát: một số model không đổi hoặc tệ hơn.
12. Khi reviewer phá hỏng code đúng
Theo video (đăng ngày 01/11/2026), chính lượt chạy thất bại của Memdoor cho thấy vì sao. Ở một bài, manager bịa ra một counterexample và gán cho nó một đáp án mong đợi sai. Team phản ứng bằng cách thay một chương trình vốn đúng.
Chương trình thay thế qua được 32 trên 44 hidden test, nên workflow đánh mất một bài mà một chương trình đúng đã giải xong (kết quả trong video đăng ngày 01/11/2026).
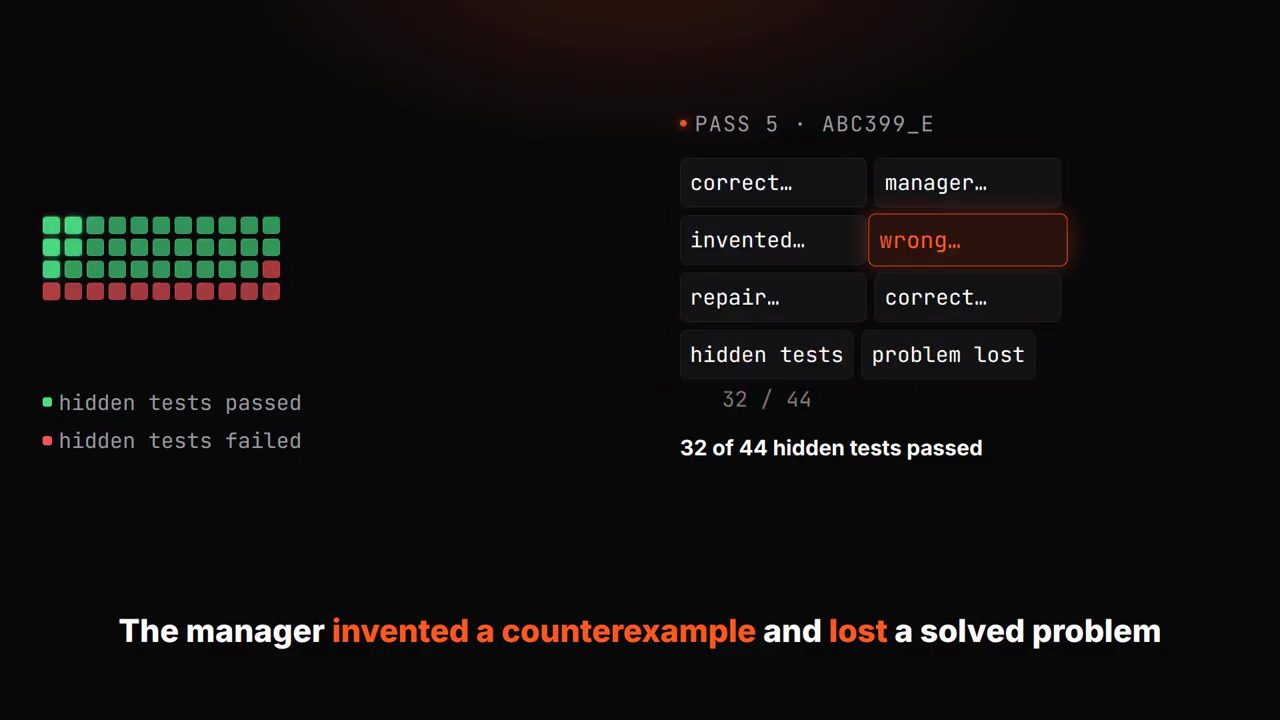
Theo video (đăng ngày 01/11/2026), một mối nguy tương tự xuất hiện ở một lượt khác, khi chương trình đúng bị ghi đè ở hai bài. Các lượt đó cuối cùng hồi phục lại, nhưng trở thành những lần thử tốn kém nhất.
Video (đăng ngày 01/11/2026) kết luận: một reviewer model có thể bắt lỗi, và một reviewer model cũng có thể tạo ra lỗi. Các test bên ngoài là điều kiện dừng đáng tin cậy duy nhất mà workflow có. Và ngay cả điều kiện dừng đó cũng có ranh giới.
13. Ranh giới của điểm dừng, và chi phí mỗi lượt
Theo video (đăng ngày 01/11/2026), trong lúc workflow chạy, các agent chỉ chạy được các public sample test. Hidden test vẫn bị giấu cho tới lúc chấm. Một chương trình có thể thỏa mọi ví dụ nhìn thấy mà vẫn trượt những trường hợp team không lường trước. Vì thế, theo video, 49 kết quả hidden test thành công có trọng lượng hơn những lần review của chính các agent.
Theo số đo trong video đăng ngày 01/11/2026, chi phí cho từng lượt chạy riêng lẻ ở mức vừa phải. Lần thử ở mức median tốn 39 cent tiền API và dùng 40 phút thời gian model. Theo video, phần mềm Memdoor miễn phí theo giấy phép Apache 2.0.
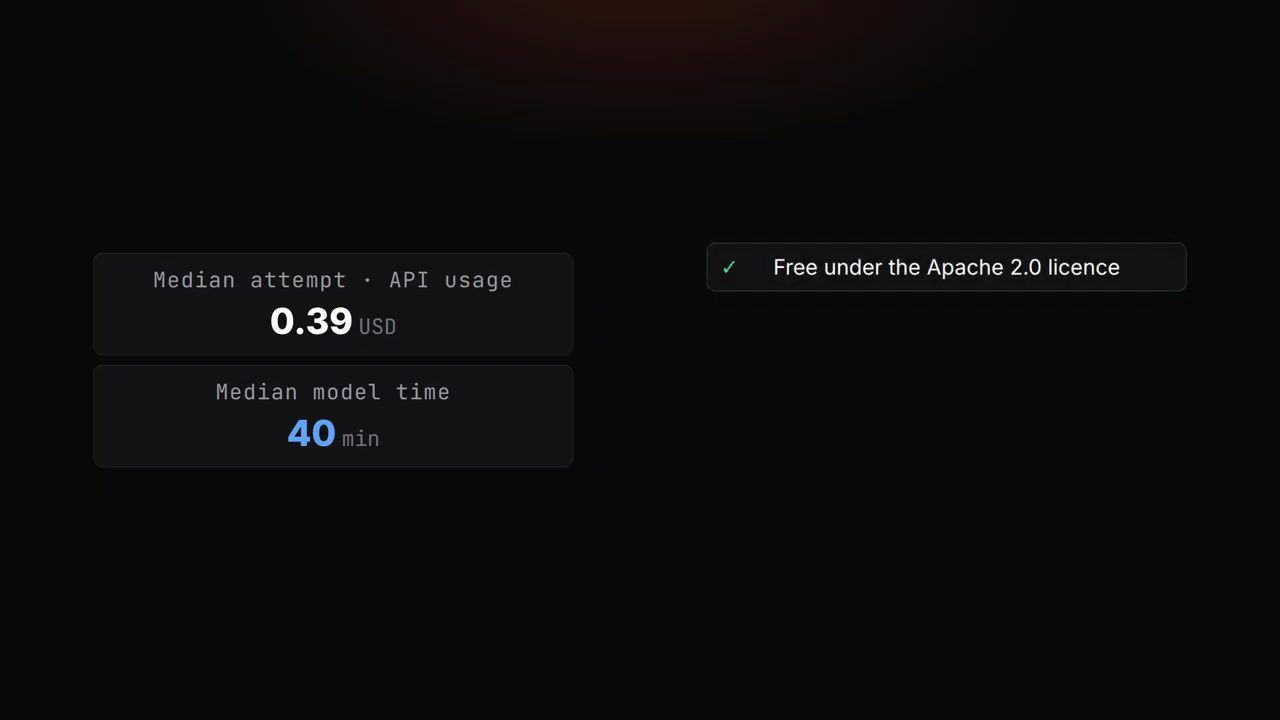
Theo video (đăng ngày 01/11/2026), Memdoor dùng API key của chính bạn, không cần tài khoản Memdoor, và để telemetry ở trạng thái tắt trừ khi bạn bật lên. Các con số trên không gồm phần cứng local, và kết quả benchmark được tạo qua một dịch vụ API trung gian cho model chứ không chạy trên máy local.
Memdoor có thể nối cùng workflow đó vào các runtime local (theo video đăng ngày 01/11/2026); màn hình lúc đó hiện lệnh memdoor connect local kèm nhãn "not benchmarked…". Nhưng theo video, thí nghiệm này không xác lập được yêu cầu phần cứng hay hiệu năng của một bản triển khai local. Nó cũng không xác lập được một mức chi phí tương đương bằng đô la cho Fable 5.
14. Đánh đổi: thêm lời gọi để mua thêm cơ hội đúng
Theo video (đăng ngày 01/11/2026), cơ cấu chi phí cho thấy sự đánh đổi. Memdoor tiêu nhiều lời gọi model hơn và nhiều thời gian thực hơn để tăng xác suất ra một chương trình đúng. Phần lớn các lần thử rẻ, còn những lần thử khó hoặc bị điều phối sai có thể kéo dài hàng giờ và tốn vài đô la.
Theo video (đăng ngày 01/11/2026), workflow đang mua thêm các hướng suy luận, review độc lập và cơ hội sửa. Sự đánh đổi đó có thể hợp lý với các bài lập trình, vì một đáp án sai có thể lãng phí nhiều thời gian hơn hẳn so với thêm một lời gọi model.
Theo video (đăng ngày 01/11/2026), bạn còn có thể xem các file trung gian, chạy lại một bước bị hỏng, và đổi model mà không phải dựng lại workflow. Phần điều phối trở thành một mảnh tái sử dụng được của quy trình kỹ thuật, thay vì một cuộc hội thoại ẩn bên trong một câu trả lời.
15. Kết quả này thay đổi điều gì
Theo video (đăng ngày 01/11/2026), kết quả này ủng hộ một bước chuyển lớn hơn trong cách các model viết code có thể tiến bộ. Chất lượng model không còn chỉ được quyết định bởi năng lực của một lần gọi. Quá trình bao quanh có thể quyết định model có khám phá các phương án khác, có giữ lại context hữu ích, có kiểm tra bằng chứng chạy được, và có sửa lỗi trước khi nộp hay không.
Theo video (đăng ngày 01/11/2026), Memdoor minh họa bước chuyển đó bằng một workflow gọn và tái hiện được. Năm cách dùng chuyên biệt của Qwen3.8-27B đạt trung bình 9,8 trên 10, trong khi baseline Fable 5 đã ghi lại đạt trung bình 8. Kết quả nghiên cứu đầy đủ trên 100 bài cũng chỉ về cùng một hướng. Video kết luận: một team được tổ chức tốt gồm một model mở giá phải chăng có thể vượt một model mạnh hơn làm việc một mình.
Nguồn và liên kết 9 nguồn
- Tên gốc: Five Qwen Agents Beat Claude on a Hard Coding Test
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=4Jj2c9S7p5M youtube.com
- Kênh YouTube CloudAICode (CloudAICode): youtube.com/channel/UC0tflg9lQMIueEAm00CKoDg youtube.com
- Repo Memdoor, giấy phép Apache 2.0 (đọc ngày 02/11/2026): github.com/guregodevo/memdoor github.com
- Workflow team-solve trong repo Memdoor, gồm bảng kết quả năm lượt và thư mục tám file YAML (đọc ngày 02/11/2026): github.com/guregodevo/memdoor/tree/main/examples/workflows/team-solve github.com
- Repo GVS5H (Gorilla vs. 5 Humans) của nhóm nghiên cứu gốc (đọc ngày 02/11/2026): github.com/slee-persis/GVS5H github.com
- Paper "GVS5H: Zero-Shot Self-Orchestration with Ledger-Based Control for Improved LLM Coding Performance", arXiv 2608.26480, 2026 (đọc ngày 02/11/2026): arxiv.org/abs/2608.26480 arxiv.org
- LiveCodeBench (đọc ngày 02/11/2026): livecodebench.github.io livecodebench.github.io
Related talks
Playbook AI-native SDLC của Anthropic với Claude Code
Eric Tech · Eric Tech · 21 min
Đi qua playbook AI-native SDLC của Anthropic: intent.md, spec.md, plan.md, TDD và feedback loop, eval trong CI, review PR, hook, deploy và metrics.
Cho Opus 5.5 build cùng một app ở mọi mức effort
Nate Herk · Nate Herk | AI Automation · 27 min
Cùng một prompt dựng hội nghị 3D, chạy Opus 5.5 ở sáu mức effort rồi so chất lượng, thời gian, chi phí API, token và số check (video 24/09/2026).
15 bài học sau hơn 1.000 giờ dùng Claude Code
Nick Saraev · Nick Saraev · 26 min
Mười lăm mẹo dùng Claude Code của Nick Saraev: eval, tự kiểm tra, quản lý context window, MCP sang skill, task song song, handoff note, /btw, fan out và CLAUDE.md.