Frontier results, on device
AI Engineer World's Fair 2026: Online Track · Video gốc
Thay lời gọi frontier model bằng SLM chạy local: golden dataset, capability eval với Phoenix, chọn SAGE model, prompt few-shot và post-processing.
1. Thôi trả tiền cho frontier model
RL Nabors (tên đầy đủ Rachel-Lee Nabors) mở đầu bằng lời hứa của cả buổi: dùng local model để thôi phải trả tiền cho frontier model. Slide tiêu đề nói gọn hơn nữa: muốn ngừng trả tiền cho frontier model thì hãy dùng eval và local model. Hai thứ đó đi cùng nhau, và phần lớn talk là chuyện eval, chứ không chỉ chuyện chọn model.
Trước khi vào việc, RL kể lý lịch của mình. RL từng làm việc trên những chuẩn đang vận hành web ngày nay: cùng Mozilla trên Firefox DevTools, cùng W3C trên web standards, và dĩ nhiên trên trình duyệt Edge của Microsoft. RL thậm chí từng ở trong React team. Ba năm gần đây, RL làm tư vấn cho các startup AI và cho một số công ty LLM và công ty trình duyệt "mà chúng ta đều thích", về mọi thứ liên quan tới web, AI và UI. Và gần đây, RL gia nhập Arize.
Rồi một câu hỏi nửa đùa nửa thật: bạn đã bao giờ bị CTO làm hỏng agentic workflow của mình chỉ bằng một thay đổi nhỏ trong prompt, hoặc một lần chuyển sang LLM khác chưa? Hay chính bạn đã từng là ông CTO đó? Nếu vậy thì có lẽ bạn cần observability platform của Arize, nền tảng quan sát "dành cho các model và những agent yêu quý chúng". RL nói hôm nay sẽ dùng thật một project open source của Arize là Phoenix, và sẽ quay lại nó ở phần sau.
2. Cái giá của inference một cỡ cho tất cả
Chủ đề thật của talk là AI đang làm bạn tốn kém thế nào. Mỗi lần bạn với tay lấy một foundation model như GPT-5 hay Claude, nó đang tốn của bạn, tốn của người dùng của bạn, và tốn của môi trường. RL đề nghị nhìn lần lượt từng loại chi phí của kiểu inference "một cỡ vừa cho tất cả".
Security: cái giá là niềm tin
Khi dùng một LLM lớn trên cloud, bạn đang gửi dữ liệu tới server ở xa. Việc đó luôn kèm rủi ro bị lộ, bị chặn giữa đường, hoặc bị bên thứ ba lưu giữ. Đã có những vụ việc dùng chatbot AI từ xa khiến dữ liệu kinh doanh nhạy cảm bị lưu lại, bị xâm nhập, hoặc bị rò ra công chúng.
Latency: cái giá là trải nghiệm người dùng
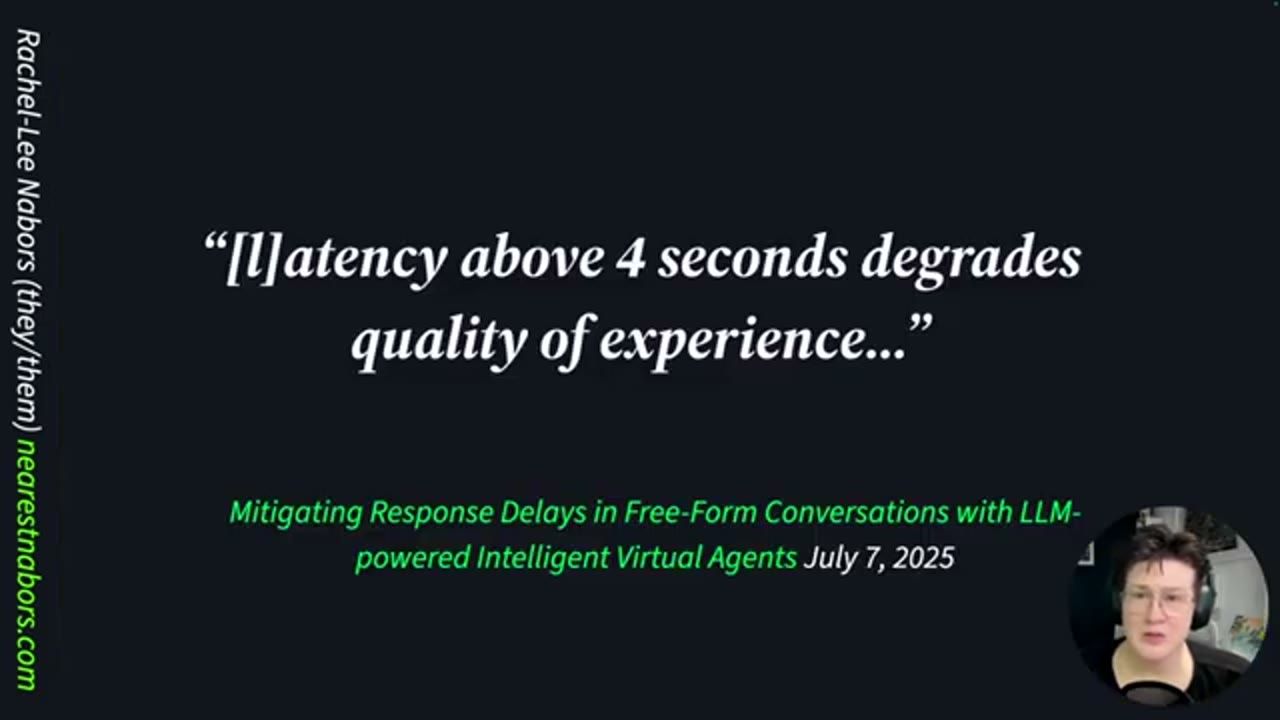
Có nghiên cứu về việc giảm độ trễ phản hồi của LLM trong các cuộc trò chuyện trong VR, và nó cho thấy bốn giây là giới hạn để người dùng còn tin vào cuộc hội thoại. Trong khi đó, nhiều lời gọi tới model lớn sẽ mất hơn bốn giây, như mọi người sẽ thấy khi xem số liệu trong Phoenix.
Chi phí cho doanh nghiệp
Chi phí inference của bên thứ ba là thứ bạn không kiểm soát được, khác với chi phí API thông thường. Agent tạo ra những tầng inference chồng lên nhau, và điều đó có nghĩa là kể cả khi token rẻ đi thì bạn có thể đang dùng nhiều token hơn; còn nếu bạn dùng ít token hơn thì có khi mỗi token lại đắt hơn.
Không có mạng thì không chạy
Và tất nhiên, nếu không có kết nối thì model từ xa đơn giản là không hoạt động. Nghĩa là trừ khi phần mềm của bạn được nối với web, không ai dùng được nó. Inference lớn mà mất kết nối sẽ làm mất năng suất: khi có sự cố outage, khi bạn ở chỗ không bắt được Wi-Fi, hoặc khi bạn làm việc trong một môi trường bảo mật rất cao.
3. Token rẻ đi, tổng chi lại tăng: có thật cần LLM không?
Giá token gần đây đang giảm, nhưng tổng chi cho inference lại đang tăng, vì các workload agentic và reasoning tiêu token nhanh hơn rất nhiều so với tốc độ giá giảm. RL cho rằng chúng ta có thể loại bỏ hoàn toàn phần lớn các chi phí kể trên, và điểm bắt đầu là tự hỏi: chính xác thì việc này đang tốn bao nhiêu? Và chúng ta có thật sự cần một LLM để làm việc này không?
4. Task-specific model và SLM
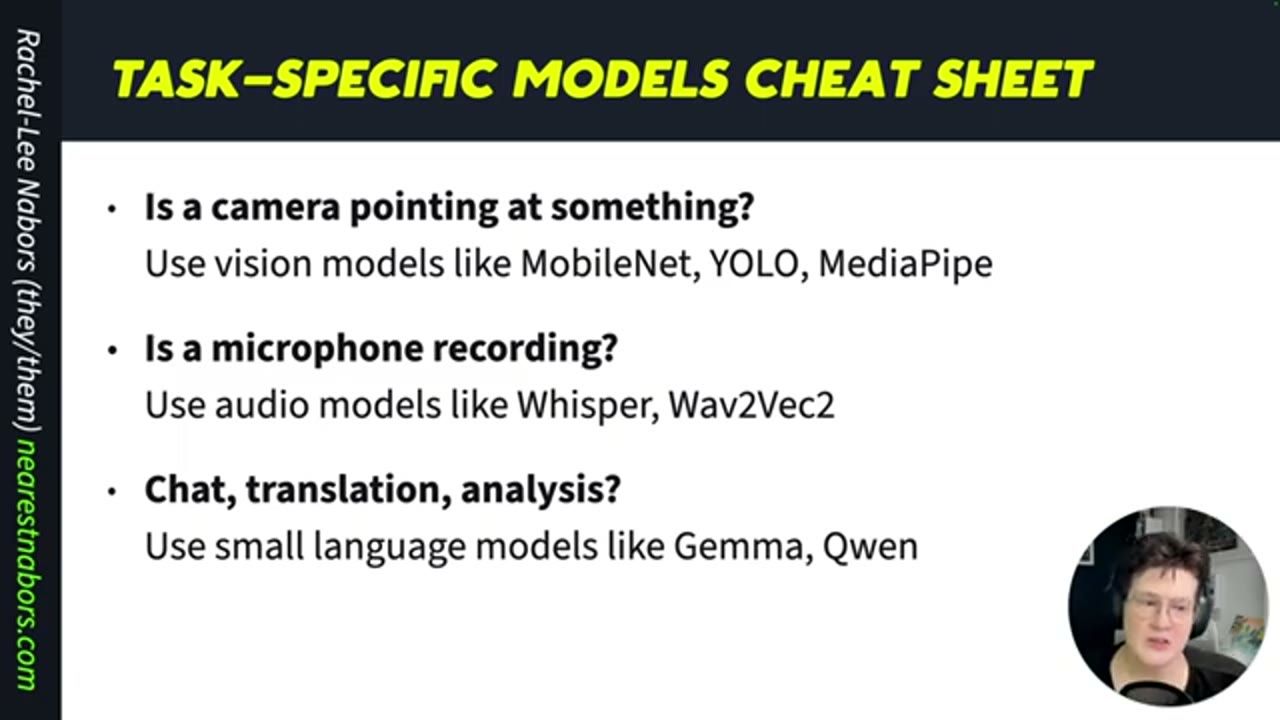
Lựa chọn đầu tiên là task-specific model: những model chuyên cho một việc, nhỏ hơn rất nhiều cả về kích thước lẫn mức tiêu thụ điện so với một AI foundation model. RL chia sẻ "cheat sheet" của mình khi đi tìm một expert model:
- Có camera đang hướng vào thứ gì đó không? Tức là có thành phần vision không. Khi đó dùng các model như MobileNet, YOLO, MediaPipe.
- Có microphone đang ghi âm không? Có các audio model như Whisper và wav2vec2.
- Chat, dịch hay phân tích? Đây là chỗ bạn có thể dùng một small language model như Gemma hay Qwen.
Những model nhỏ này được gọi là SLM, viết tắt của small language model, hay như RL cười và nói, "smaller language model", vì định nghĩa thế nào là "nhỏ" vẫn còn đang được tranh cãi. SLM rất hợp cho những lúc ta vẫn cần sức mạnh ngôn ngữ của một generative pre-trained transformer, tức một GPT, nhưng có lẽ không cần cả kho tri thức nhân loại nhốt trong một hộp đen để sai bảo, hoặc không cần khả năng multimodal. Ta sẽ không phân tích ảnh và âm thanh cùng lúc.
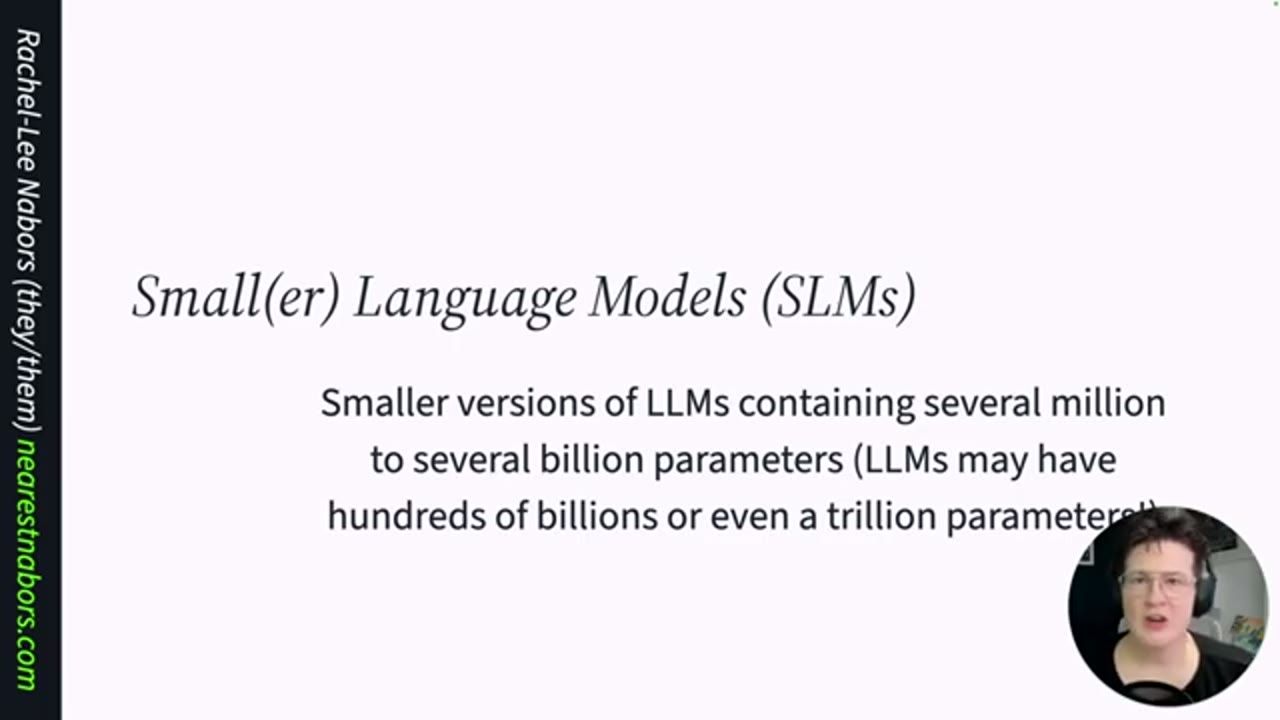
Nói cụ thể, SLM chứa từ hàng triệu tới hàng tỷ parameter, còn LLM chứa từ hàng tỷ tới, ừ thì, hàng nghìn tỷ. RL cho xem một hình so sánh: chấm to là một trong những LLM nhỏ hơn hiện có, còn chấm bé tí lại đại diện cho một trong những SLM lớn hơn. Chênh lệch về số parameter là khổng lồ, và điều đó có nghĩa là cỗ máy bạn cần để chạy mỗi loại cũng chênh lệch khổng lồ.
Tin tốt là bạn không cần phần lớn những gì nằm trong chấm to kia. Bạn không cần lịch sử. Bạn không cần triết học. Bạn không cần tất cả những đoạn chat trên Reddit. Bạn không cần phần lớn những gì model đã học và được train. Đa số chúng ta dùng model cho những việc như tóm tắt một thread chat, hay phát hiện xem người này có đang cư xử khó chịu không, và để quyết định những việc như vậy thì cần ít parameter hơn một cách đáng ngạc nhiên.
5. SLM nhỏ cỡ nào, và vì sao chạy được trên thiết bị
Điểm hay của SLM là chúng tiêu thụ năng lượng bằng hoặc ít hơn LLM để cho ra câu trả lời đúng, và RL nói đã có nghiên cứu tốt cho thấy điều này. SLM có đủ mọi kích cỡ và hình dạng. Phần lớn SLM dành cho mobile và web được deploy kèm quantization, tức là 8 bit hoặc 4 bit, và việc đó có thể giảm một nửa hoặc còn một phần tư yêu cầu về ổ đĩa và bộ nhớ. Một tỷ parameter vừa khoảng 2 GB ở FP16.
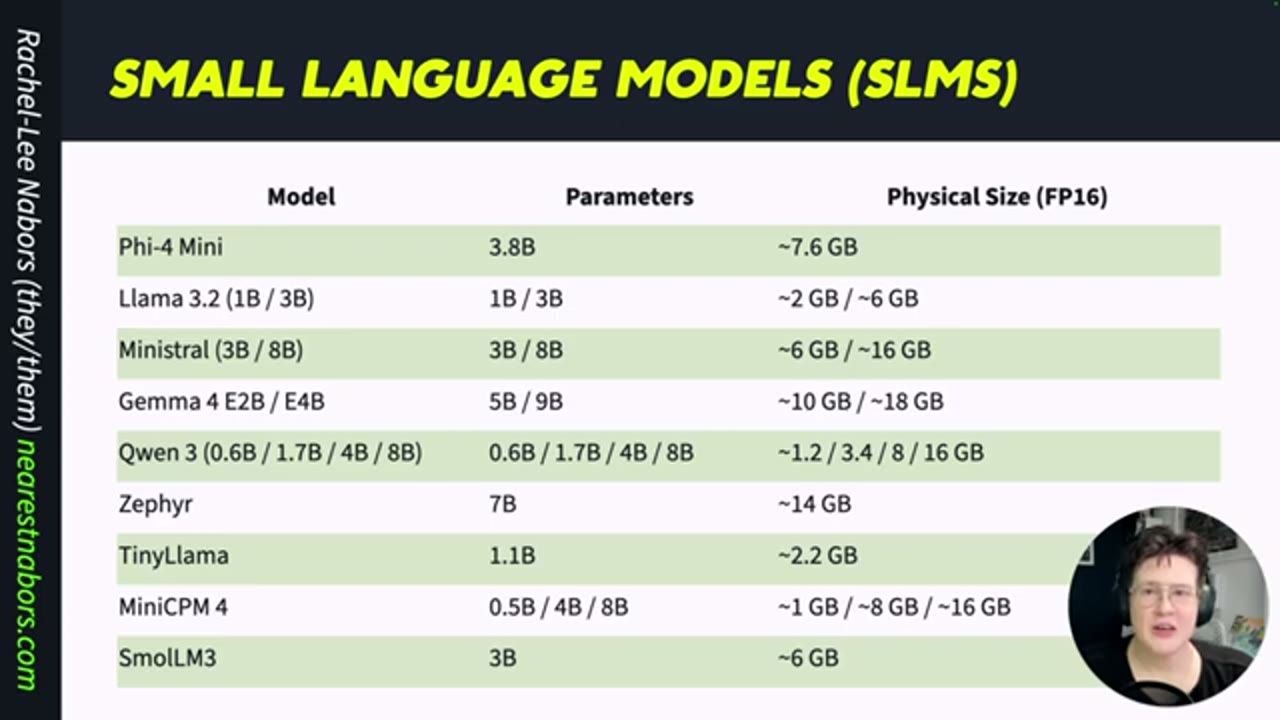
RL lưu ý bảng này đưa ra ước lượng cận trên, chỉ để bạn hình dung model nào vừa và không vừa với từng loại thiết bị. Sau quantization, những con số này còn nhỏ hơn nhiều. Các SLM nhẹ đến mức có thể đặt ngay trên thiết bị. Nhân tiện, chiếc Pixel Pro của RL có sẵn một model như vậy: RL mua ngay Pixel 10 Pro khi có thể, vì muốn biết làm việc với một on-device model, một SLM "của riêng mình", thì sẽ thế nào.
6. SLM đã sẵn sàng cho production
Tin tốt là SLM đã production-ready. NVIDIA gọi SLM là tương lai của agentic AI: một bài nghiên cứu hay từ 2025, "Small Language Models are the Future of Agentic AI", kết luận rằng SLM đủ mạnh để chạy các tác vụ agentic, và tiêu thụ ít năng lượng hơn các language model lớn.
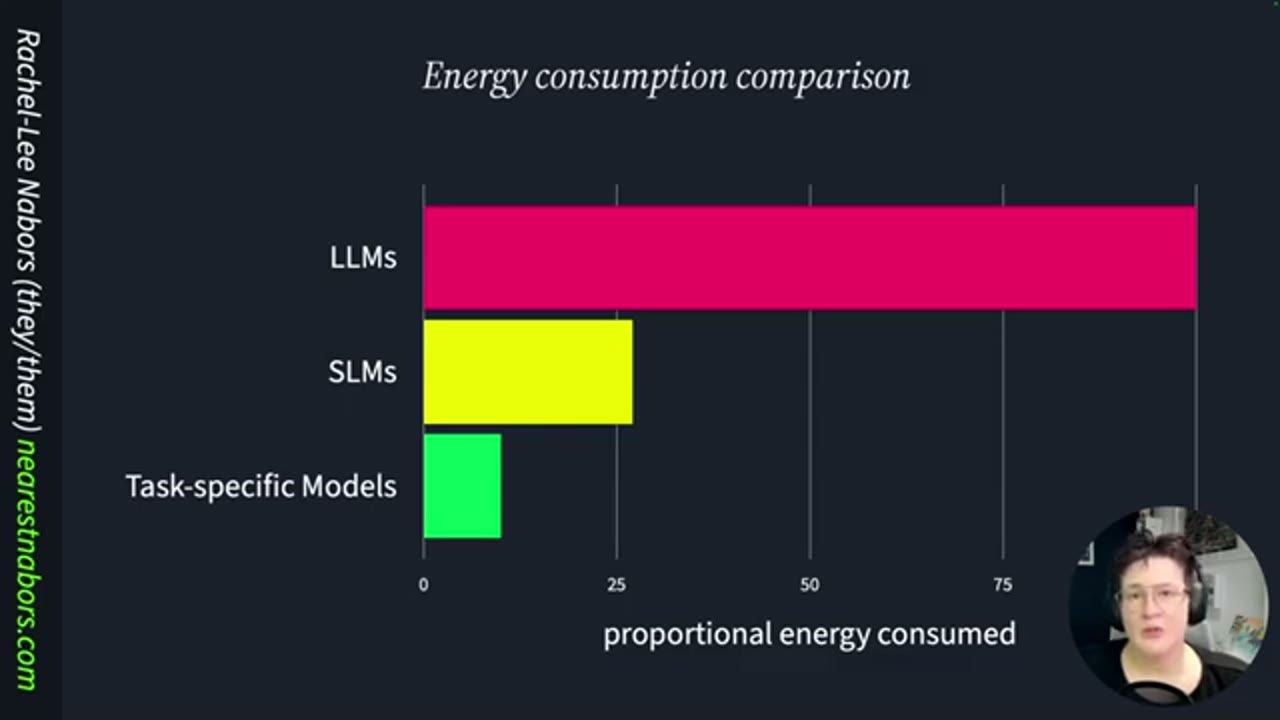
Để dễ hình dung, RL đưa ra một biểu đồ cột. Giả sử cột đầu là tổng năng lượng một LLM cần để làm một tác vụ. Một SLM mất khoảng 25% mức đó, và một task-specific model, theo lời RL, chỉ mất khoảng một nửa của mức SLM. Nhìn từ góc độ năng lượng, chạy SLM và task-specific model rẻ hơn nhiều.
Vậy lợi ích là gì? Nhắc lại một lần nữa: an toàn hơn, chạy được offline, không có phí, hiệu quả hơn, và latency thấp hơn vì chạy ngay trên thiết bị, không có round trip nào.
7. Goose, Gemma và câu hỏi về ichthyosaur
RL đã dùng local AI được một thời gian. Trên màn hình là hai cửa sổ: bên trái là Claude, bên phải là Goose, một agent harness open source có giao diện rất dễ chịu để chat với model. Cửa sổ Goose này đang chạy Gemma, và nó trả lời được. Nó mất lâu hơn một chút: model nhỏ có thể chậm hơn tuỳ bạn chạy trên thiết bị nào và model to cỡ nào.
Một trong những câu hỏi RL thích hỏi model nhất là: khả năng ichthyosaur, loài bò sát biển thời khủng long, có echolocation là bao nhiêu? Lý do là nếu nhìn bộ xương của chúng thì trông rất giống cá heo, và để trả lời được có thể hay không thì cần phải reasoning về sinh học.
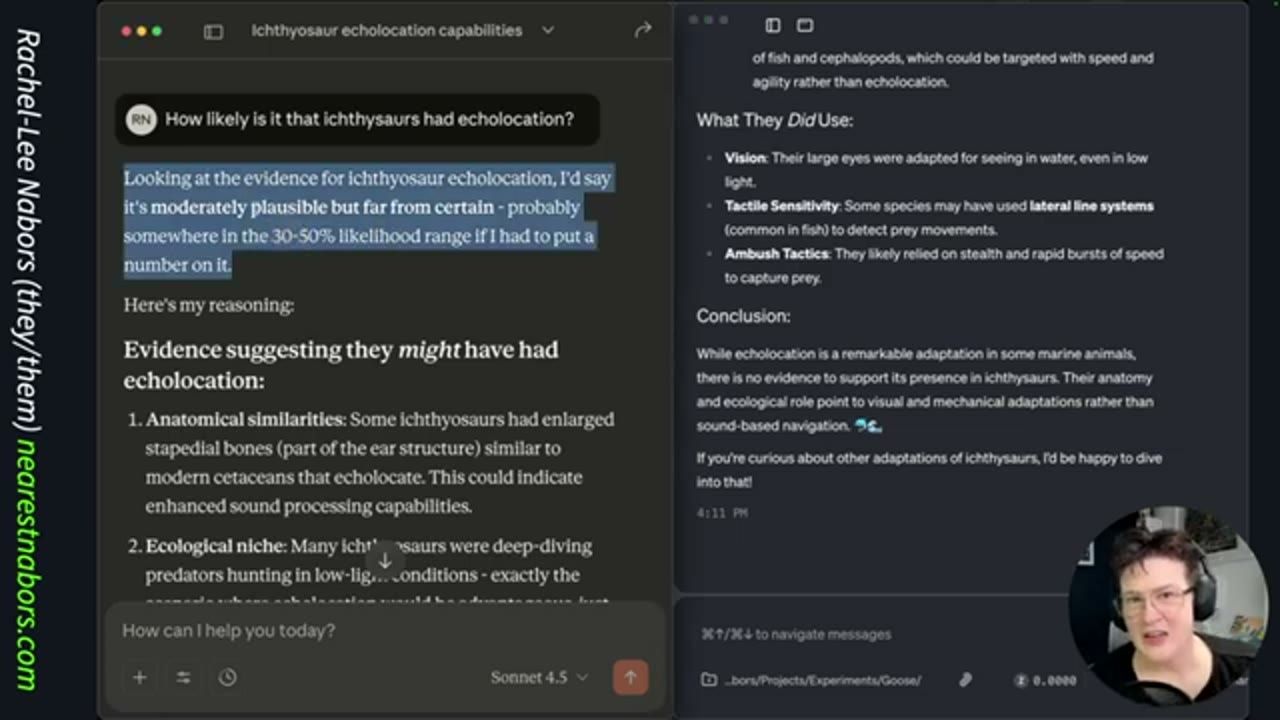
RL thấy thật buồn cười là ngay cả Gemma 3 (RL nghĩ đó là Gemma 3) cũng đưa ra được một câu trả lời tốt: trong hoá thạch không có bằng chứng nào cho thấy chúng đã phát triển "melon", hay những xương chuyên biệt cần cho việc dẫn truyền âm mà cá heo có. Còn Claude thì đánh trống lảng, nói kiểu "chúng ta không thể biết được", khoảng một trên ba lần hỏi, điều mà RL thấy thú vị. Claude vốn luôn hơi ngại đưa ra quan điểm của mình.
8. Prototype big, deploy small
Vậy chọn model tốt nhất cho một việc thế nào? Đây là phần khó. RL bật cười, vấp một nhịp rồi hỏi lại: làm sao chọn được model tốt nhất cho việc? RL đã xây một framework cùng Google và dùng nó cho chính các project của mình. Có thể đọc chi tiết trên web.dev, nhưng RL sẽ đi qua nó ngay tại đây.
Trước hết, RL thích nghĩ về nó như câu thần chú: prototype big, deploy small. Cứ lặp lại câu này với bản thân. Prototype big. Nghĩ lớn. Chơi lớn. Deploy small. Bạn muốn chuyển các phần trong hệ thống của mình sang SLM và specialized model khi lên production, nhưng hoàn toàn có thể prototype trên một foundation model, không vấn đề gì.
Bước đầu tiên của quy trình là xác định xem việc bạn muốn làm có khả thi hay không. Dùng model lớn nhất, giỏi nhất, và xem có bắt được nó làm việc đó không. Ví dụ, xem model có nhận ra được người nào đó qua chữ viết tay hay qua cách họ viết không. Nếu làm được, thì bạn biết một model khác có lẽ cũng xử lý được. Bạn có thể dùng một foundation model như Gemini, hoặc một task-specific model thật mạnh, chẳng hạn một model nhận dạng chữ viết tay.
9. Mima và tính năng tóm tắt thread
Ví dụ xuyên suốt phần còn lại là một tính năng trong sản phẩm RL thích build ngoài giờ: Mima, một client gom tất cả các mạng xã hội của bạn vào một chỗ. RL đã build cho nó một tính năng tóm tắt những thread hội thoại dài. Vì RL không biết bạn thế nào, nhưng có những hôm RL đi ngủ, thức dậy thì thấy 50 comment dưới một bài mình đăng, và chỉ muốn biết một điều: mọi người có đang giận mình không? Tính năng này cứu RL khỏi không ít cơn đau tim buổi sáng.
RL prototype tính năng này trước với Claude, để chứng minh nó đủ tốt. Trong giao diện có thể thấy những dòng summary nhỏ dưới mỗi thread, và nó làm khá tốt việc nói ra ai đang bàn chuyện gì.
10. Golden dataset và tiêu chí thành công
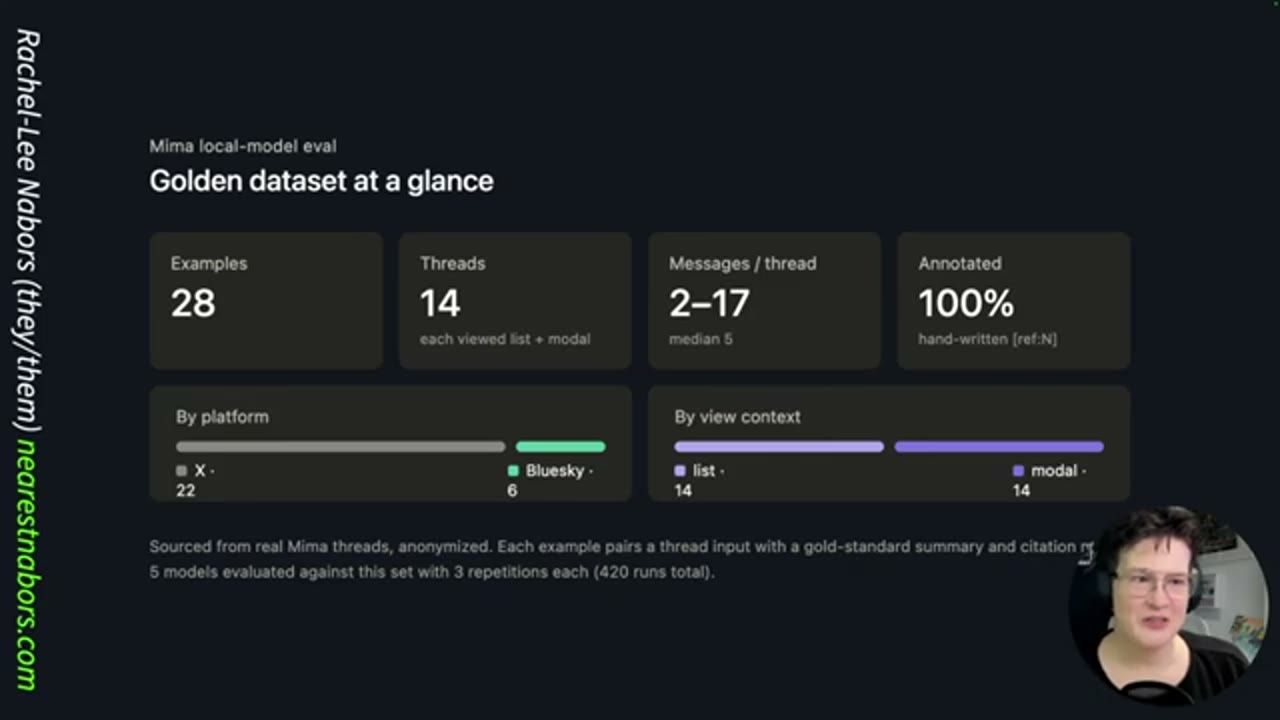
Bước tiếp theo là thu thập một tập input và output. Trong trường hợp của RL, đó là một tập thread, kèm cách RL sẽ tóm tắt chúng, hay cụ thể ở đây là cách Claude tóm tắt mà RL thấy đã ổn. RL export ra một golden dataset.
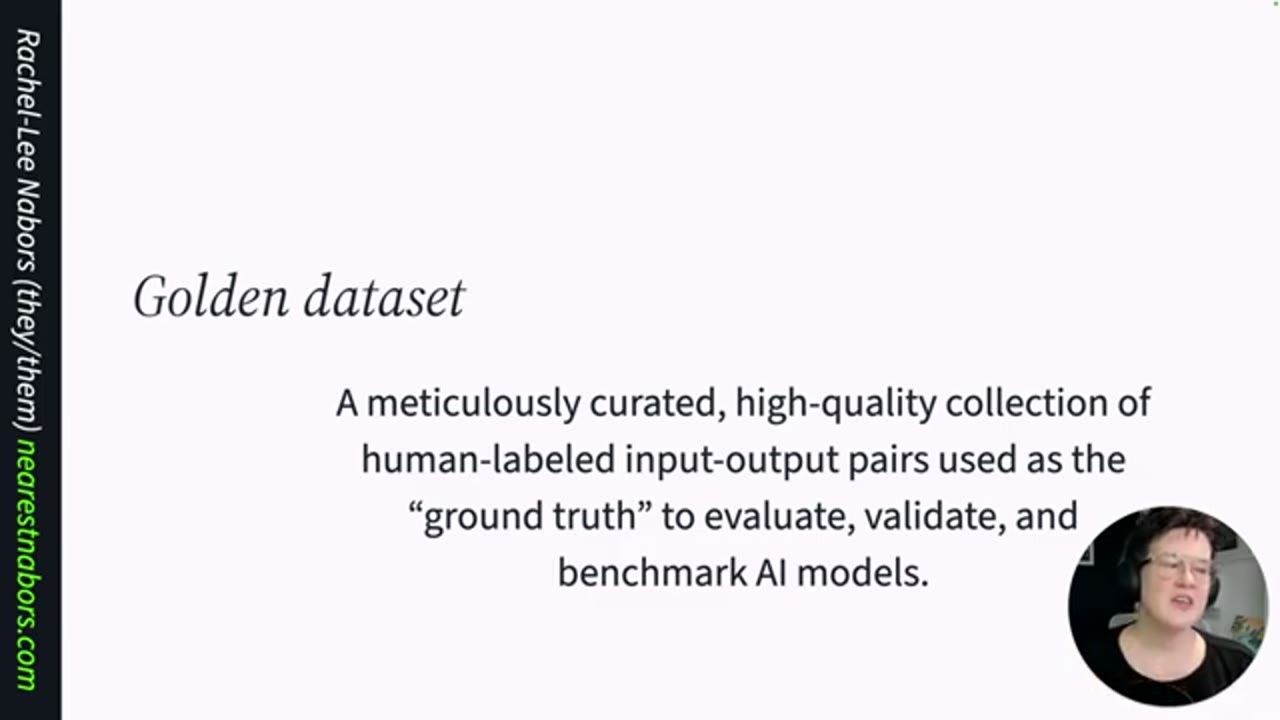
Golden dataset là một tập được tuyển chọn, chất lượng cao, tốt nhất là gồm các cặp input và output do người gán nhãn, mà bạn dùng làm ground truth để evaluate, validate và benchmark model của mình. Dữ liệu trông như sau: tất cả đều là thông tin công khai, mỗi bản ghi có author handle, nội dung, thời điểm tạo, và cờ cho biết tin đó có phải của chính RL không. RL gom tất cả thành một file JSONL lớn.
Có 14 thread, và RL đánh giá mỗi thread hai lần, một cho summary và một cho annotation, vì một số summary có link trỏ sâu vào bên trong cuộc hội thoại. Cùng một thread nhưng có hai output khác nhau: một là summary ngắn, một là summary có reference. Tổng cộng là 28 example.
Tiếp theo là những thứ RL sẽ đo. Trước khi làm bất cứ điều gì, bạn cần biết mình đang đo cái gì. Thế nào là thành công?
- JSON validity. JSON mà quá trình tóm tắt xuất ra có đúng không? Cách test dễ là thử
JSON.parse: chạy được thì "yay", không chạy được thì "boo". - Reference structural validity. Nếu summary trỏ tới các phần khác nhau trong cuộc hội thoại, thì những phần đó có thật sự tồn tại không?
- Factual consistency. Summary có tóm tắt đúng nội dung thread trong giới hạn hợp lý không. Nếu thread đang nói về mèo thì summary không được nói là đang bàn về cún. Chỗ này cần một LLM làm judge, hoặc con người, nhưng RL cam đoan là LLM sẽ rẻ hơn.
- Length compliance. Đảm bảo output nằm trong một giới hạn số từ nhất định.
- Latency. P50 là trung vị trên toàn bộ eval set, còn P95 là kịch bản tệ nhất.
Thu thập xong những thứ này, bạn sẽ test các model khác nhau và so xem chúng xếp hạng thế nào so với model lớn.
11. Phoenix, capability eval và baseline Claude Sonnet
Nguyên tắc là test từ nhỏ lên lớn. RL phải chọn ra một nhóm model, nhưng trước đó cần một framework, một công cụ để đo. RL chọn Phoenix, công cụ do Arize tạo ra. Nó open source, miễn phí, và theo RL thì các kỹ sư làm ra nó "khá là tuyệt vời, nếu tôi được phép tự khen".
Đầu tiên là một thứ gọi là capability eval. Capability eval hỏi: agent này làm tốt được những gì? Ta so hiệu năng của model lớn với hiệu năng của một nhóm model nhỏ hơn. Ta nói: "Đây là thứ Claude Opus tạo ra, còn đây là thứ Gemma 4 tạo ra. Hai cái này so với nhau thế nào?"
RL dùng Claude Sonnet làm baseline. Ở dòng dưới cùng, đánh số một, là baseline đó, và trông khá ổn: latency trung bình 2.9 giây, chi phí khoảng 22 cent để chạy 14 tác vụ này. RL làm một phép tính và thấy mình đang dùng khoảng một đô la inference mỗi ngày chỉ để dùng Mima. RL không có tiền để trả cho chừng ấy người dùng tuổi teen dùng Mima mỗi ngày. Nên sẽ phải chạy nó on-device.
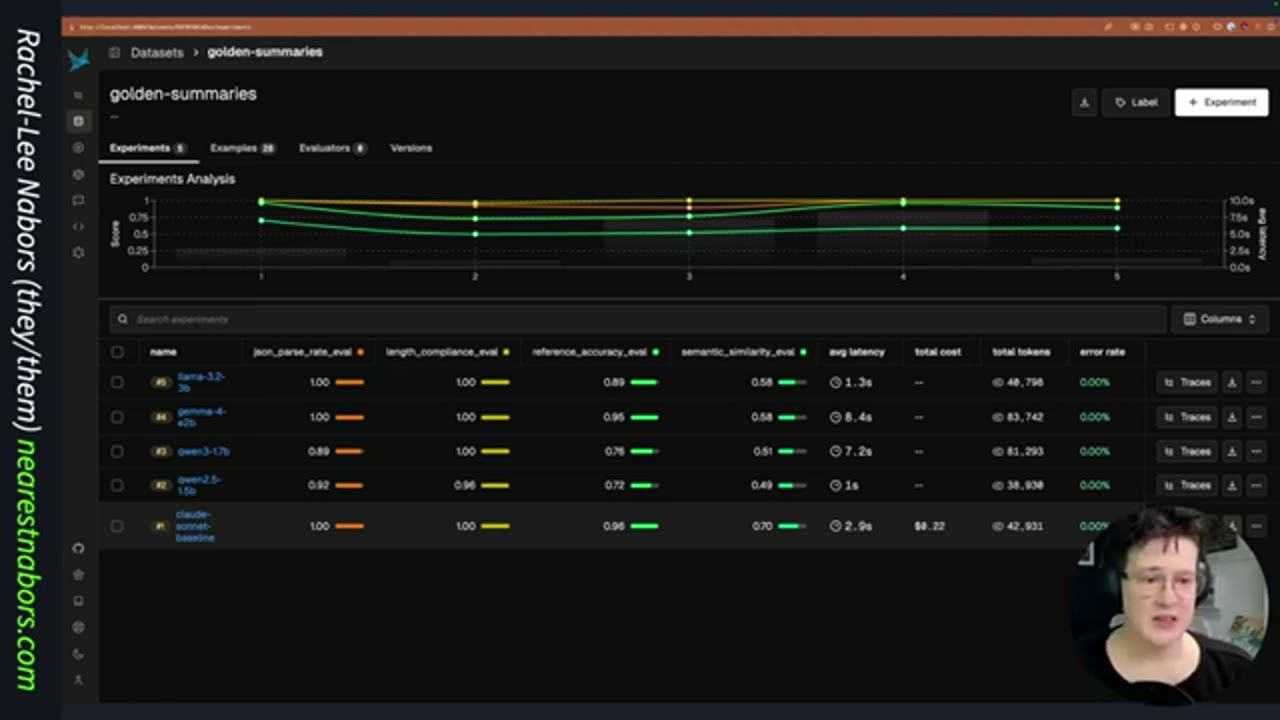
Tin tốt là cột total cost của tất cả các model local nhỏ đều bằng không, vì inference đã được đẩy sang phía người dùng. Nó chạy trên thiết bị của họ. Họ là người phải sạc điện thoại để model lấy năng lượng từ pin mà chạy. Tất nhiên bạn không muốn nó hút cạn pin, nhưng đó là một câu chuyện khác, thứ có thể test và evaluate trong tương lai.
12. Các thí sinh và SAGE model
Giờ đến lượt các "thí sinh", RL giới thiệu như bình luận viên võ đài:
- Qwen 2.5 Instruct, nặng 1.5 tỷ parameter, chỉ vỏn vẹn 1 GB trên ổ đĩa.
- Cô em Qwen 3, 1.7 tỷ parameter, to hơn một chút.
- Llama 3.2, nặng 3 tỷ parameter, gọn gàng 2 GB trên ổ đĩa.
- Và Gemma 4 E2B, 5 tỷ parameter, nặng ký với 3.1 GB. Đây là model mà rất nhiều kỹ sư RL hỏi ý kiến khi chọn model đều nói: "Gemma 4 là nhất. Phải dùng Gemma 4."
RL nghĩ điểm này quan trọng: nếu chỉ nghe theo bạn bè, RL có thể đã mang lại cho người dùng... không, xin sửa lại, không phải "có thể", mà chắc chắn đã mang lại cho người dùng một trải nghiệm rất khác, và không phải trải nghiệm tốt.
Bạn nên chọn model nhỏ nhất mà vẫn cho câu trả lời chấp nhận được cho use case của mình. RL gọi nó là SAGE model: small and good enough model, model nhỏ và đủ tốt. "Tôi đang cố biến nó thành một trend. Thông cảm cho tôi nhé. Hy vọng chúng ta làm SAGE thành một thứ phổ biến."
Lúc đầu RL tưởng mình muốn Qwen 2.5 vì nó nhanh nhất. Trên biểu đồ, Qwen 2.5 là vòng tròn xám ở góc dưới bên trái, với latency P50 tổng cộng khoảng một giây. Như vậy là tuyệt vời, rất nhanh cho một bản tóm tắt AI. Vấn đề là độ chính xác của nó khá thấp so với tất cả những model còn lại.
Hình vuông màu cam là Gemma 4 E2B, còn hình thoi màu xanh dương là Claude Sonnet, cái trần của chúng ta. Nó chính xác nhất, nhưng cũng hơi "mũm mĩm", hơi chậm, latency khoảng ba giây. Khi tính cả độ chính xác vào, người thắng hoá ra là Llama 3.2, vòng tròn xanh lá to nằm quanh mức 90% độ chính xác. Cả Claude lẫn Llama 3.2 đều nhanh hơn Gemma 4 rất nhiều: Gemma 4 vào khoảng tám giây. Có thể là vì Gemma 4 cần một kiểu prompt khác, nhưng kết quả này khá nhất quán: RL chạy mỗi model ba lần rồi lấy trung bình.
13. Mở experiment ra xem, và tóm tắt bốn bước
RL khuyên: khi chạy eval với một công cụ như Phoenix, hãy mở experiment ra và thật sự nhìn vào nó. Bạn sẽ thấy raw response là gì, expected response là gì, và có thể so chúng cạnh nhau. RL thấy trong nhiều trường hợp, câu trả lời của Llama gần với câu trả lời của Claude tới mức gần như không phân biệt được.
Vậy Llama 3.2 là người thắng cuối cùng, và RL quyết định đi tiếp với nó. Điều này cũng hợp lý: Llama 3.2 do Meta tạo ra, và Meta có lợi ích lớn trong việc làm ra những model xử lý tốt input của con người và tóm tắt những chuyện của con người trên mạng xã hội. Nghe hợp lý, đúng không? Mima là một thứ mang tính xã hội, nên được lợi từ một model "xã hội".
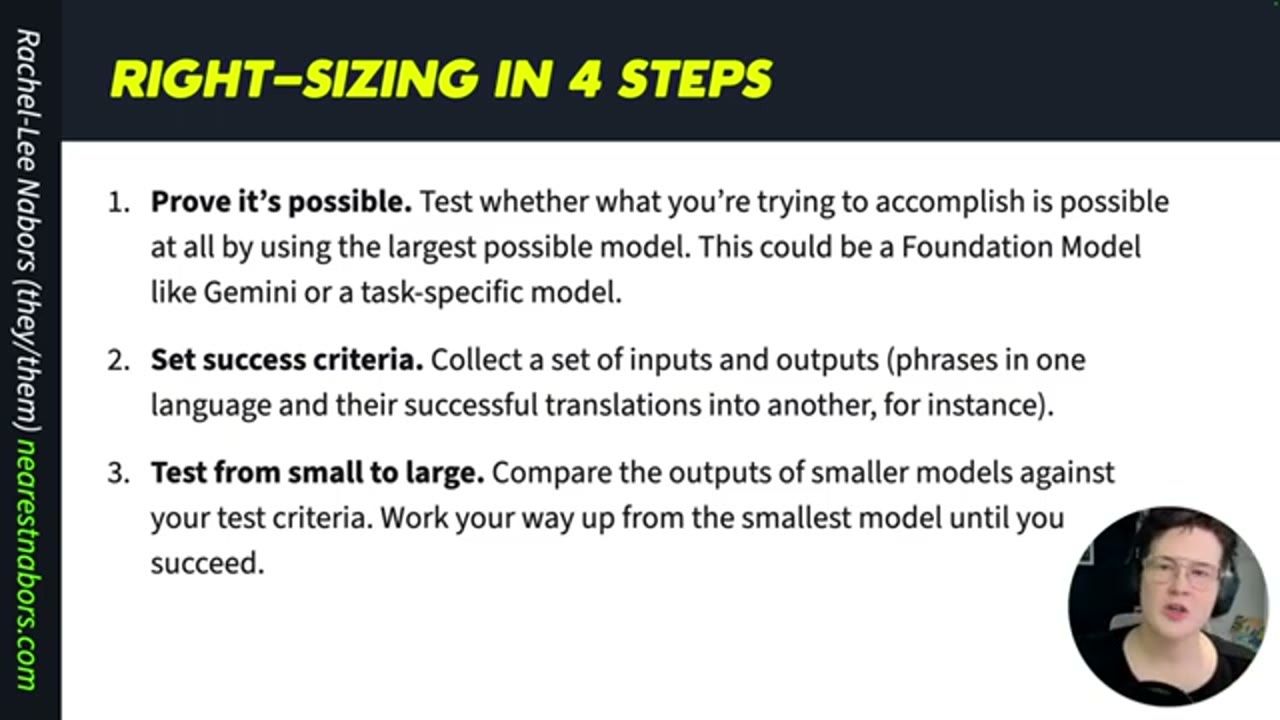
Tóm tắt lại, đây là cách chọn đúng cỡ model trong bốn bước:
- Prove it's possible. Test xem điều bạn muốn làm có khả thi hay không bằng model lớn nhất có thể. Đó có thể là một foundation model như Gemini, hoặc một task-specific model.
- Set success criteria. Thu thập một tập input và output mà bạn muốn thấy khớp với nhau. Đây sẽ là cái ngưỡng.
- Test from small to large. So output của các model nhỏ với tiêu chí test, và đi dần lên từ model nhỏ nhất cho tới khi vào được vùng chấp nhận được của model nhỏ và đủ tốt, SAGE model.
- Select your SAGE model. Chọn model nhỏ nhất cho câu trả lời chấp nhận được với input của bạn.
14. Thu hẹp khoảng cách bằng prompt engineering
Nhưng chắc bạn đang thắc mắc: còn khoảng cách kia thì sao? 90% độ chính xác nghe có vẻ có thể là lý do để từ chối luôn. Câu trả lời là ta có thể vắt thêm hiệu năng từ model nhỏ bằng prompt engineering.
Điều này quan trọng trong những trường hợp bạn không kiểm soát được mình đang dùng model nào. Có người sẽ, chẳng hạn, tạo một distilled model được train để làm thật tốt đúng một việc này. Nhưng nếu bạn làm một mobile app, có thể bạn không muốn dùng distilled model, vì mỗi lần thêm khả năng mới bạn có lẽ sẽ phải train lại model một chút, rồi lại ship một model một hay hai gigabyte mới tới người dùng mỗi lần như vậy. Đây đúng là kiểu tình huống "Ồ, mình không nghĩ là sẽ kiểm soát được model đó. Một khi nó đã nằm trên thiết bị người dùng, mình sẽ không bắt họ tải model mới về. Việc đó sẽ ngốn hết gói data của họ."
Hoặc bạn có thể vào một team đã cam kết dùng Gemma 3, và họ sẽ không áp dụng Gemma 4 cho tới khi đã tung ra một bản cập nhật xử lý xong toàn bộ các eval.
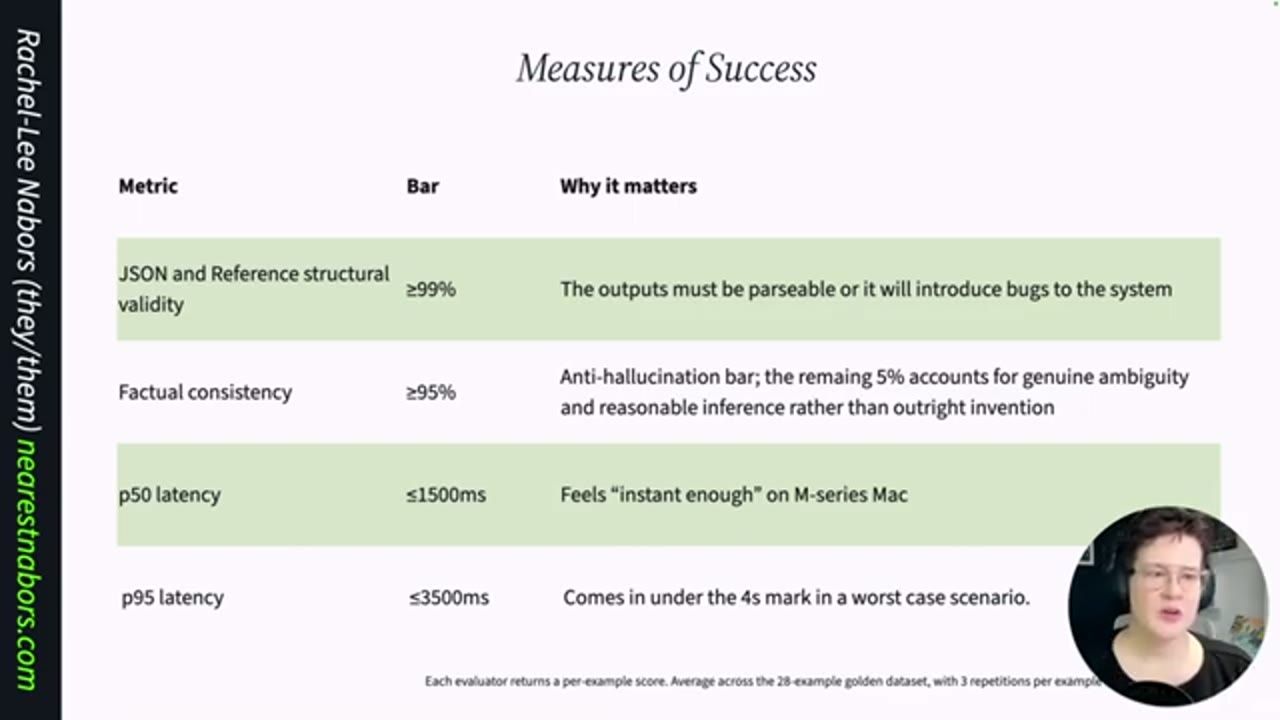
Vậy hãy xem cách thu hẹp khoảng cách giữa Sonnet và Llama, giờ là chấm xanh lá và chấm xanh dương ở góc phần tư trên bên trái. Những thước đo RL tập trung vào, chỗ hai model thật sự có kết quả khác nhau, là JSON và reference structural validity, factual consistency, latency P50 và latency P95.
RL quyết định ngưỡng cho latency P50 là một giây rưỡi. Với P95 là ba giây rưỡi, vì nhớ lại rằng theo nghiên cứu, bốn giây là kịch bản tệ nhất trước khi người dùng cảm thấy mất kết nối với một trải nghiệm có AI.
15. Năm prompt, mỗi lần một biến
Vậy bắt đầu từ đâu? RL khuyên tối ưu từng bước một. Bạn muốn cô lập một biến cho mỗi biến thể prompt, để test xem thứ bạn đang thử có thật sự làm kim chỉ số nhích lên khi dùng các prompt khác nhau hay không.
RL tạo năm prompt. Chính xác hơn là tạo bốn prompt mới, cộng prompt gốc làm baseline. Prompt gốc vốn đã khá tốt.
- V2, numbered input. Cùng prompt đó, nhưng định dạng lại thread thành các tin nhắn được đánh số thay vì dùng JSON. Giả thuyết: model nhỏ theo dõi cách đánh chỉ mục bằng ngôn ngữ tự nhiên tốt hơn là các offset của mảng trong một đống JSON.
- Few-shot. Thêm vài ví dụ kèm kết quả vào prompt. Giả thuyết: model nhỏ học format từ ví dụ nhanh hơn là từ luật.
- Strict rules. RL gọi đây là "ngôi nhà của chữ không": các ràng buộc phủ định rõ ràng. Không mở đầu dài dòng. Không đếm từ trước khi trả lời, à không, phải đếm từ trước khi trả lời. Giả thuyết: model nhỏ phản ứng với mệnh lệnh theo nghĩa đen, và chúng thích bị sai bảo một chút.
- Chain of thought. Buộc model xác định những khoảnh khắc quan trọng trước khi viết. Giả thuyết: nghĩ thành lời sẽ cải thiện grounding.
RL chạy lại các bài test với những prompt mới này, lần này chỉ với Llama 3.2, và "chúng ta" phát hiện ra vài điều. "Chúng ta" ở đây là chính RL: tất cả chỉ chạy local trên máy của RL và so kết quả. Bạn thậm chí có thể đưa kết quả vào một thứ như Claude rồi trò chuyện với nó về các đánh đổi nếu muốn. Đến đây RL bị gián đoạn một chút ("Thôi nào. Rồi, chúng ta quay lại.") rồi đi vào kết quả.
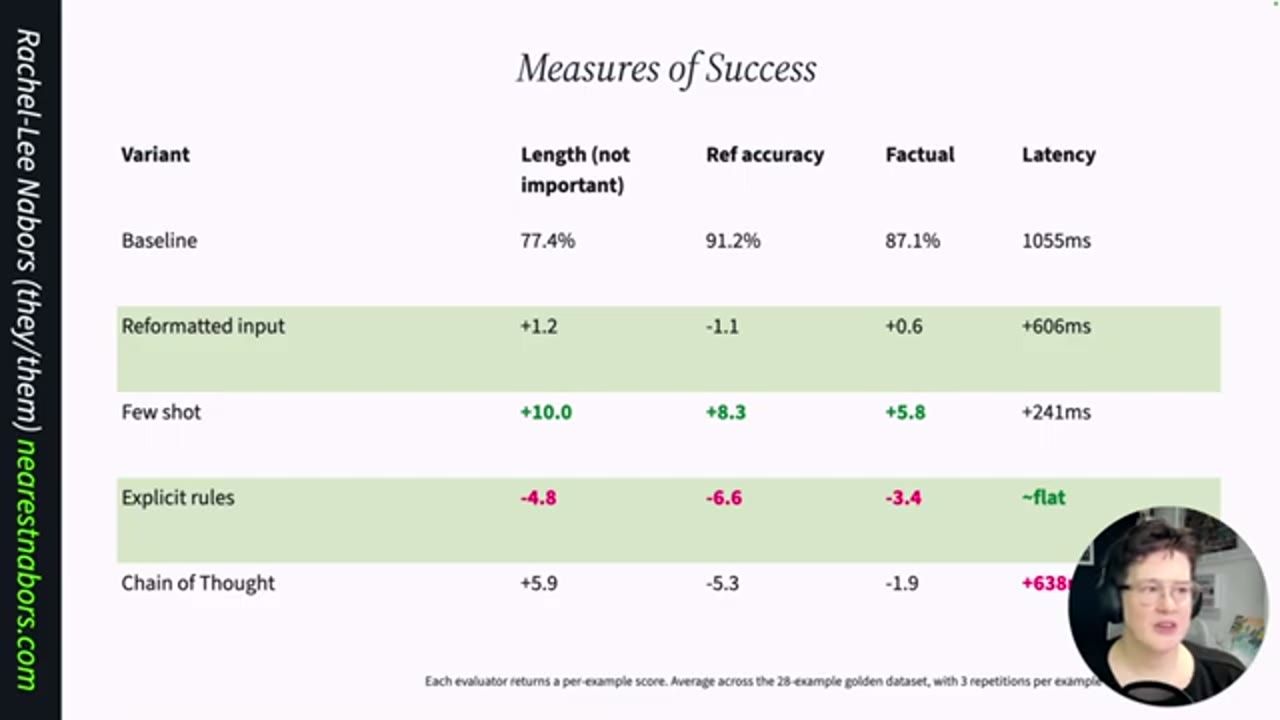
Với baseline, model không giỏi lắm trong việc xác định summary nên ngắn tới đâu để vừa với một khung nội dung nhất định. Ref accuracy là 91.2%, đúng về mặt dữ kiện 87.1% số lần, và latency khoảng một giây.
- Reformatted input không tạo ra khác biệt đáng kể.
- Explicit rules thực ra còn làm mọi thứ tệ hơn. Model phản ứng rất tiêu cực khi bị bảo nó không được làm gì, được và không được làm gì. Nó như một đứa trẻ bướng, không thích nghe lời.
- Chain of thought không tạo khác biệt lớn. Nó làm tốt hơn một chút ở phần độ dài, nhưng tiếc là phải trả bằng việc tăng latency thêm khoảng 600 ms.
- Few-shot, bản có thêm vài thread và vài ví dụ, là bản tốt nhất. Nó làm đúng độ dài tốt hơn nhiều, chính xác hơn, và trong các reference thì nó đồng thuận với model Claude nhiều hơn về việc ai đã nói gì. Và nó chỉ tăng latency khoảng 200 ms.
Nghe như một món hời, đúng không? Vậy prompt few-shot thắng. Nó tạo ra cải thiện lớn nhất.
16. Judge quá khắt khe, và post-processing trong harness
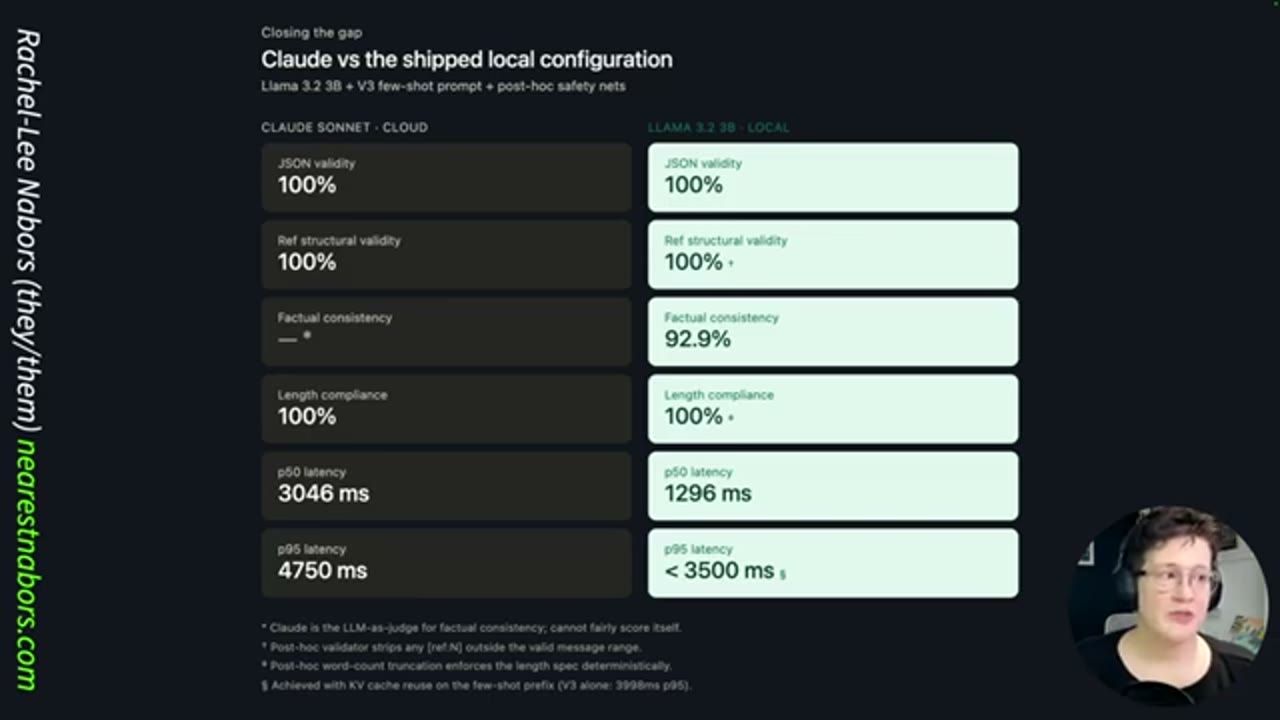
Giờ xem nó so với bản gốc thế nào ("bum, bum, bum"). Trên màn hình là cột so sánh Claude Sonnet với Llama 3.2 3B. Đến đây RL làm thêm vài việc vì muốn đóng hẳn khoảng cách.
Llama 3.2 3B với prompt few-shot thực ra đã vào được một biên sai số hợp lý. Latency P50 xuống dưới một giây rưỡi, nên hoàn toàn xanh. Structural validity 91.7%. Factual consistency 92.9%. Latency P95, theo lời RL, nằm dưới hẳn mốc 750 ms, thấp hơn Claude (slide "Closing the gap" bên dưới ghi P95 của Llama dưới 3500 ms, so với 4750 ms của Claude). Nhìn chung latency của nó rất tốt.
Nhưng còn hai khoảng mười phần trăm ở structural validity và factual consistency thì sao? Đây chính là lý do phải thật sự mở eval ra và nhìn vào bên trong.
Về factual consistency, hoá ra Claude chỉ đang là một giám khảo rất khắt khe. RL dùng Claude để chấm các câu trả lời: Claude Opus so câu trả lời của Claude Sonnet với câu trả lời của Llama 3.2. Và đương nhiên Claude thiên vị "cô em gái" của mình, kiểu: "Ừm, tôi nghĩ là, tôi không nghĩ cách bạn diễn giải điều Jenna nói là chính xác, vì bạn bảo cô ấy đang bực bội lo âu, trong khi thật ra cô ấy đang cáu." Toàn những chuyện như vậy, và đó là lý do phải mở chúng ra xem.
Còn ref consistency và độ dài thì thực ra có thể xử lý ngay trong harness bằng post-processing. Đảm bảo summary có đúng số reference trong thread là việc rất đơn giản để kiểm: chỉ cần xem thread dài bao nhiêu, nếu số ref nhiều hơn số thành viên của thread thì sai. Còn về độ dài thực của summary, nếu dài quá thì cứ cắt bớt.
Khi thêm post-processing, khoảng cách được đóng lại khá chắc chắn. Giờ JSON validity là 100%. Structural validity 100%. Factual consistency chỉ còn chút bất đồng, và hoá ra là do judge quá khắt khe. Latency P50 xuống khoảng một giây, còn P95 dưới ba giây rưỡi. Khá tốt. Cuối cùng nó đạt và vượt Claude Sonnet sau chút công sức thêm này, và RL đang tiết kiệm khoảng một đô la mỗi ngày tiền inference.
17. Regression eval, và bắt đầu từ đâu
Điều quan trọng là sau khi đã làm xong một việc như thế này, bạn không muốn đánh mất thành quả đã giành được. Bạn muốn đảm bảo mình có thể nâng cấp model hoặc đổi prompt trong tương lai mà không làm summary phình ra thành một đoạn văn dài, hay bắt đầu hallucinate ra những điều không đúng. Bạn sẽ phải giữ các eval chạy liên tục cho việc đó, và đó gọi là regression eval.
Bạn chạy chúng giống như chạy test CI/CD. Đó là cách bạn ngăn CTO vô tình thổi bay trải nghiệm agentic của bạn vào một buổi sáng nào đó. Chuyện có thật: nó đã xảy ra với một founder là bạn của RL.
Vậy bắt đầu từ đâu? Có bao nhiêu lời gọi Claude có thể là lời gọi Llama? RL thách mọi người về nhà hôm nay và nhìn lại những gì mình đang gửi tới LLM, rồi tự hỏi: "Đây có phải việc một model nhỏ hơn xử lý được không, và mình sẽ tiết kiệm được bao nhiêu nếu làm vậy?"
Khi làm các project AI, hãy để ý những SLM và specialized model có thể đã nằm sẵn trên thiết bị. Ví dụ, Chrome có Prompt API, truy cập Gemini Nano, model được ship sẵn trong Chrome. Điều đó có thể rất hữu ích, vì nghĩa là bạn không cần ship model cho bất kỳ ai dùng trình duyệt. Cứ tận dụng thứ đã có sẵn ở đó.
18. Prove it, define it, test it
Hãy nhớ rằng các model này hiệu quả hơn, và chúng gặp người dùng đúng ở nơi người dùng đang ở. Thông tin của họ ở lại trên thiết bị, bạn không phải lo về PII, và mức tiêu thụ năng lượng thấp thì, có thể nói, là một món quà cho môi trường.
Hãy nhớ: prototype big, deploy small. Bạn có thể prototype hệ thống với một foundation model, rồi chuyển nó, hay các phần của nó, sang small language model và specialized model khi lên production. Ghi nhớ trình tự: prove it, define it, test it, rồi chọn SAGE model vượt qua được các bài test. Bạn có thể dùng prompt engineering để có kết quả tốt hơn từ SLM và thu hẹp khoảng cách với model từ xa.
Lời thách cuối cùng: hãy coi implementation hiện tại của bạn là một prototype, và chuyển một tính năng sang dùng một local model nhỏ hơn. Về nhà, tự thử, và có thể bạn sẽ ngạc nhiên.
RL nói mong được gặp mọi người "ngoài kia trên web". Nếu bạn thích nói chuyện về local model nhỏ hay agentic web, có thể theo dõi RL tại nearestnabors.com. Nếu muốn thử chạy eval với setup hiện tại của mình, bắt đầu test với Phoenix tại phoenix.arize.com. Và cuối cùng, có thể đăng ký beta của Mima tại mima.social. Lời chào cuối: "Tôi là Rachel Nabors, và thật tuyệt khi được trò chuyện với các bạn hôm nay. Hãy đi và tự build inference stack của riêng mình."
Nguồn và liên kết
- Trang talk trên ai.engineer · Video gốc
- web.dev: bài viết về cách chọn model, framework "prototype big, deploy small" RL làm cùng Google
- Arize Phoenix (mã nguồn: Arize-ai/phoenix): công cụ open source dùng để chạy capability eval trong talk
- Arize: observability platform cho model và agent
- Small Language Models are the Future of Agentic AI (NVIDIA, 2025)
- Goose: agent harness open source RL dùng để chat với Gemma chạy local
- Chrome Prompt API: truy cập Gemini Nano có sẵn trong Chrome
- Mima: client mạng xã hội của RL, nơi có tính năng tóm tắt thread
- nearestnabors.com · RL Nabors trên X
Related talks
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
Your Agents Need a Save Button
Hamza Tahir · ZenML · 17 min
Checkpoint state của agent trong một durable runtime để replay run production với model hay tool khác, diff kết quả và quyết định trên cả cohort.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.