AI model chạy vượt khỏi một GPU như thế nào
Distributed inference: data, pipeline, tensor, expert parallelism, tách prefill/decode và cách ghép chúng để phục vụ LLM quá lớn cho một GPU.
✓ Đã duyệt độc lập · cập nhật 24/10/2026 · 9 min
1. Một nghìn tỷ parameter không vừa một GPU
Grace Ableidinger, Developer Advocate tại Red Hat (theo dòng tên hiện trên màn hình), mở đầu bằng một phép so sánh về kích thước. Theo chị, những AI model lớn nhất tính đến lúc video đăng (06/10/2026) có thể có hơn một nghìn tỷ parameter, và lưu chừng ấy cần cỡ 2 terabyte bộ nhớ. Trong khi đó, GPU lớn nhất trên thị trường, cũng theo chị ở cùng thời điểm, chứa được khoảng 288 gigabyte. Con số đó còn rất xa mới đủ để chứa những frontier model khổng lồ này.
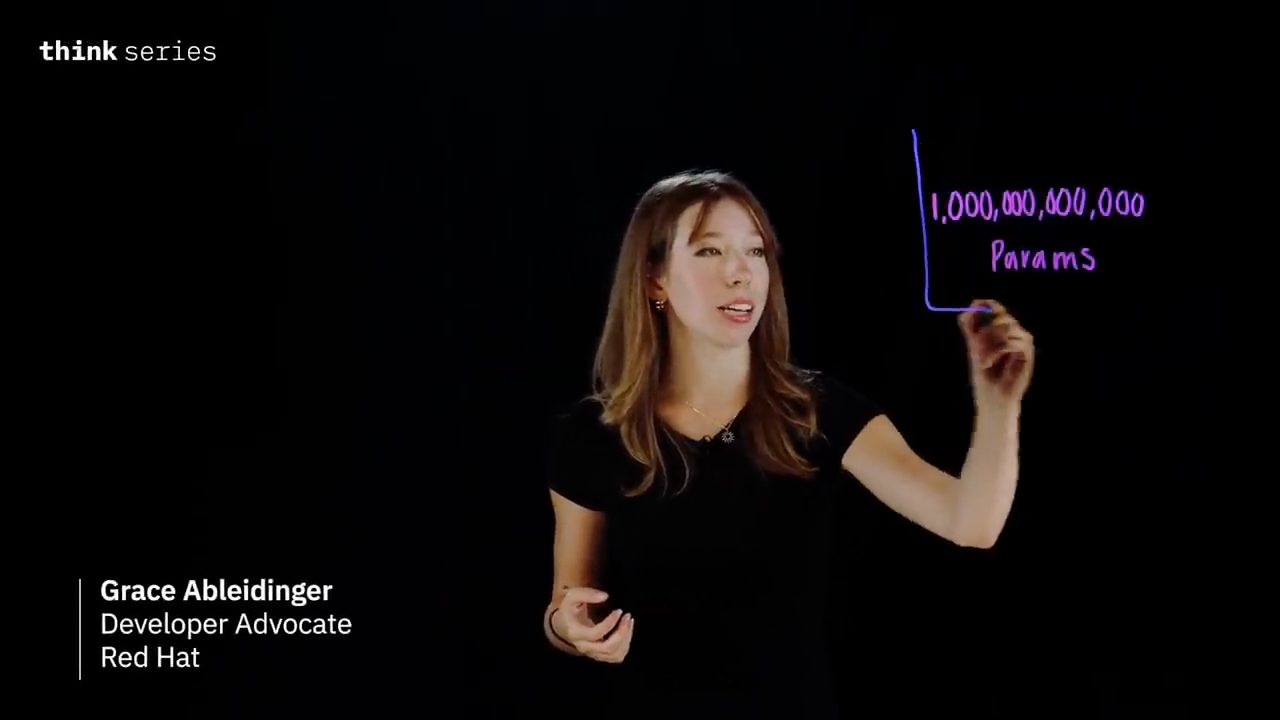
Vậy làm sao các model đứng sau những chatbot mà ai cũng dùng lại chạy ổn định cho hàng triệu người? Câu trả lời của Grace (video đăng ngày 06/10/2026): sự thật là không có một "siêu máy tính" (megacomputer) duy nhất nào đang host các AI model mà bạn trò chuyện mỗi ngày. Chúng chạy trên một hệ thống phối hợp gồm hàng chục, đôi khi hàng trăm GPU.
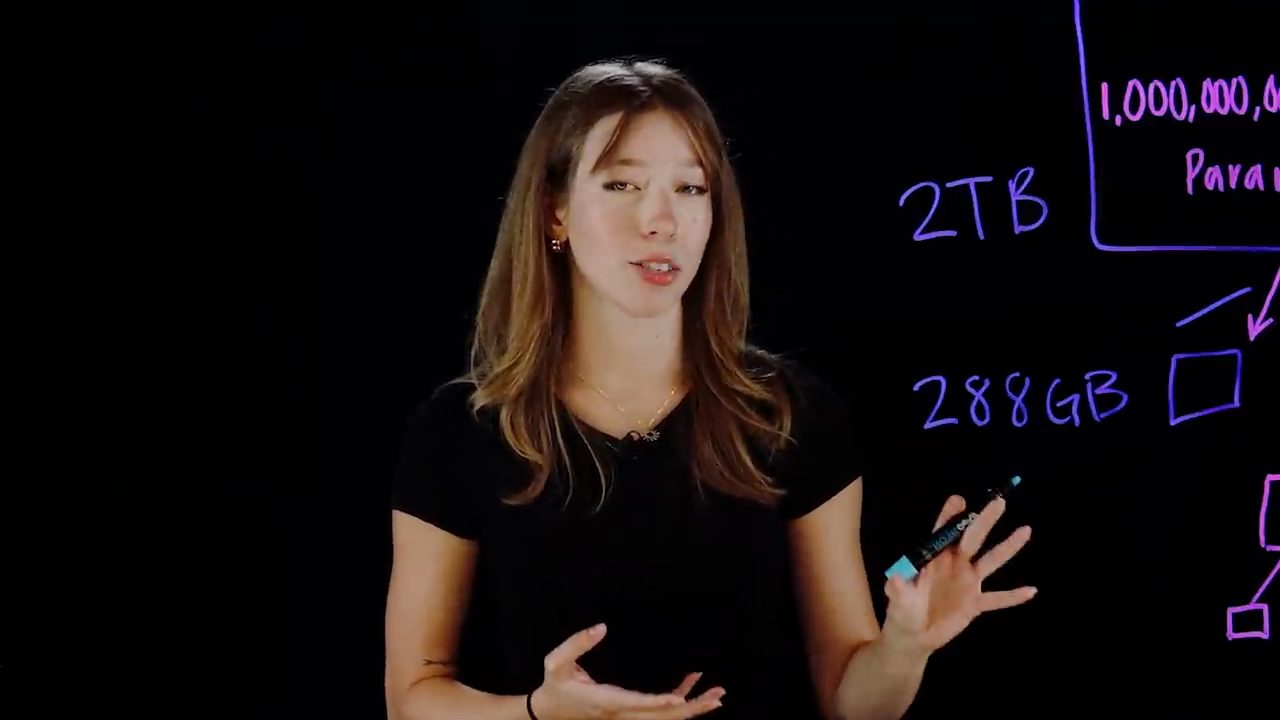
Grace nói thêm rằng model không chỉ cần được lưu trữ. Nó còn phải chạy, và phải chịu được traffic thật của người dùng trong production. Nếu gói gọn toàn bộ quá trình này vào một GPU, bạn sẽ nhanh chóng gặp những ràng buộc thật, những nút thắt (bottleneck) và latency cho cả hệ thống. Lời giải chị đưa ra là distributed inference: quá trình chạy một AI model bằng cách chia khối lượng tính toán ra nhiều thiết bị hoặc server được nối với nhau.
2. Ba ràng buộc khi phục vụ model trong production
Grace quay lại cấu tạo của một model. Một model gồm nhiều layer, và tất cả các layer đều chứa weight, tức là phần kiến thức (knowledge) của model. Muốn chạy model, toàn bộ weight phải được nạp vào bộ nhớ ngay từ đầu. Đó là thứ nhất: model weights.
Thứ hai, trong lúc chạy, model tích luỹ thêm cái chị gọi là working memory: thông tin bổ sung về cuộc hội thoại giúp nó nhớ những gì đã được nói trước đó. Phần context này được gọi là KV cache, và nó cũng nằm trong bộ nhớ, chồng lên trên chính model.
Thứ ba, mỗi request cần một khoảng thời gian nhất định để đi qua một GPU. Nếu có quá nhiều request đến cùng lúc, chúng bị dồn lại trong hàng đợi (queue), và mọi người dùng đều phải chờ lâu hơn mới có câu trả lời. Khi host cho người dùng thật, có thể có hàng trăm hay hàng nghìn người cùng gọi tới model một lúc, nên hệ thống phải phục vụ được nhiều người dùng đồng thời (concurrently).
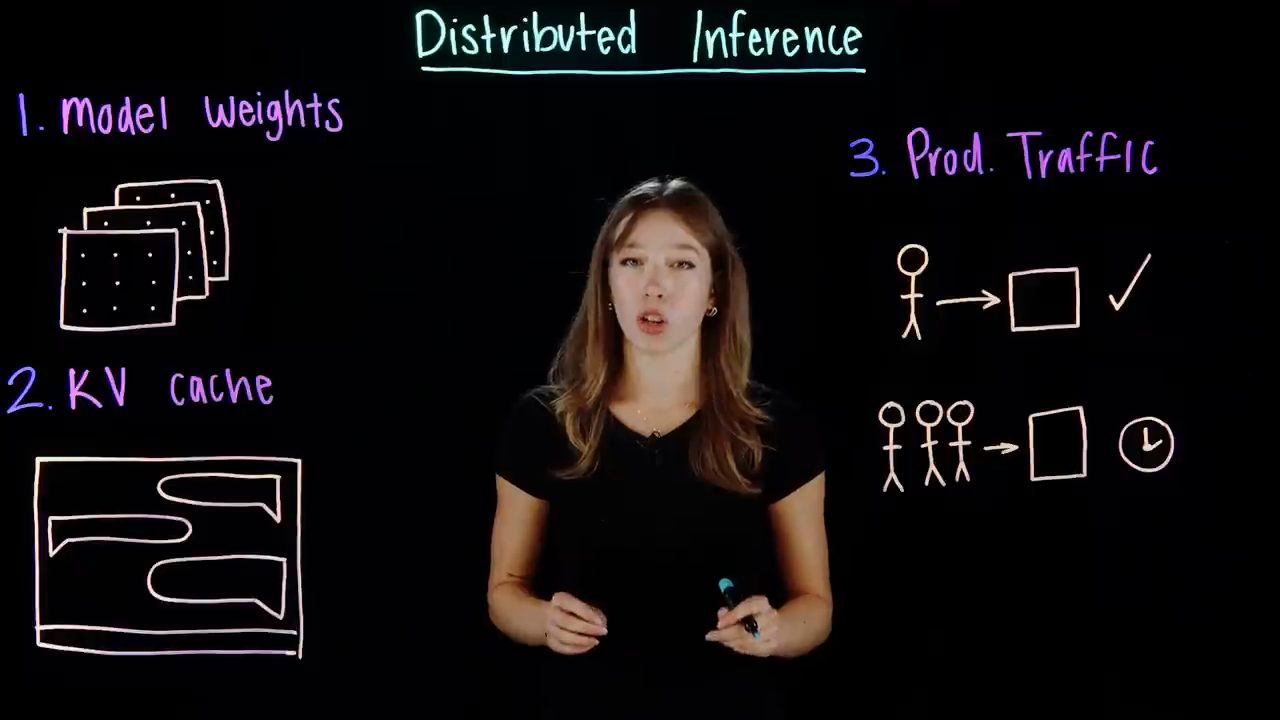
Phục vụ một model trong production, theo Grace, nghĩa là phải giải cùng lúc ba ràng buộc này:
- Model memory footprint: weight có vừa về mặt vật lý trên phần cứng bạn đang có hay không.
- KV cache growth: phần nội dung cứ lớn dần lên trong lúc bạn đang phục vụ.
- Request throughput: bạn phục vụ được bao nhiêu người dùng đồng thời.
3. Data parallelism: nhân bản model, chia request
"Hãy bắt đầu từ nhỏ", Grace nói. Giả sử model và KV cache của nó vừa vặn trên một GPU, nhưng số người dùng quá đông để phục vụ tất cả cùng lúc. Việc có thể làm là chép toàn bộ model sang nhiều GPU, rồi route request tới các bản sao đó một cách thông minh, dựa trên những yếu tố như mỗi GPU đang tải nặng tới đâu, hoặc bản sao (replica) nào đã có sẵn context liên quan trong cache.
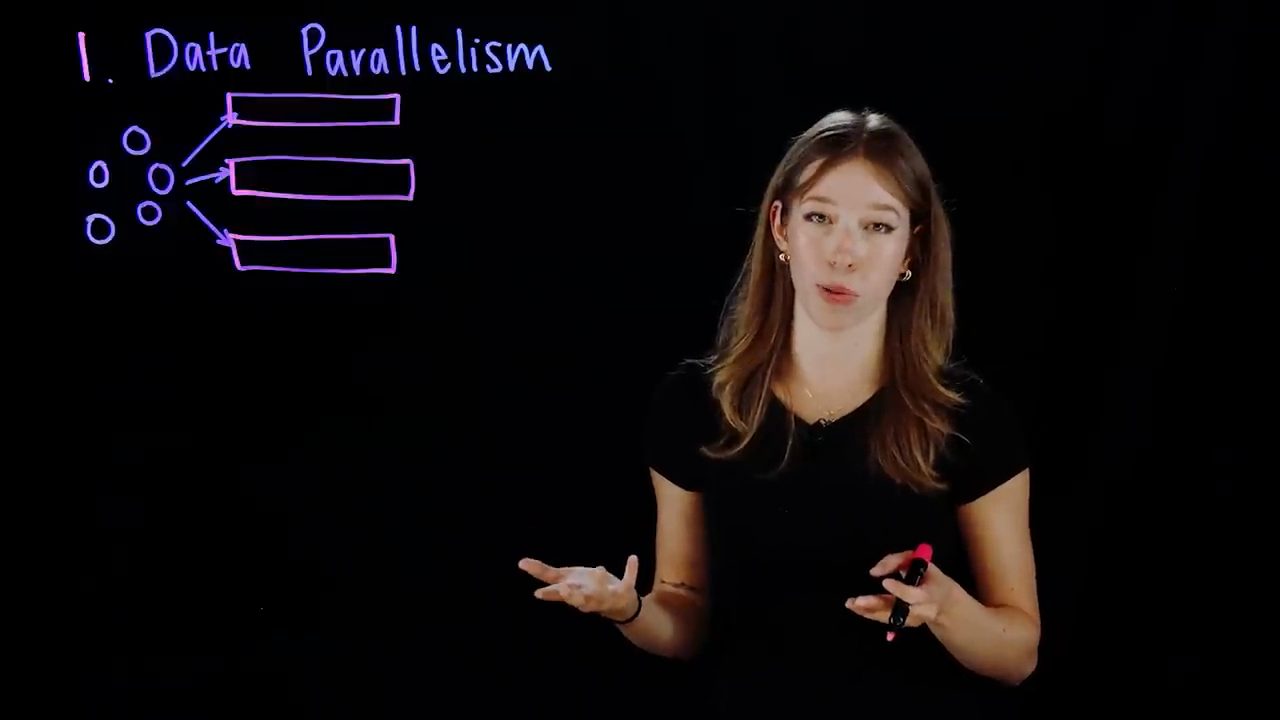
Đó là data parallelism. Mỗi replica là một bản sao đầy đủ, giống hệt nhau, của model. Giữa các replica không cần phối hợp gì cả; theo cách Grace ví von, bạn chỉ đang quyết định mỗi request sẽ bước qua cánh cửa nào.
4. Pipeline parallelism: cắt model theo layer
Nhưng thực tế, theo Grace (video đăng ngày 06/10/2026), nhiều model thông minh nhất không vừa trên một GPU. Chị nhắc lại: model thực chất chỉ là một chuỗi layer, mỗi layer giữ một phần kiến thức riêng. Chạy inference nghĩa là đưa input lần lượt đi qua từng layer, giống như một dây chuyền lắp ráp (assembly line). Vậy nếu cả model quá lớn, ta có thể chia, hay shard, model theo layer.
Chẳng hạn, layer 1 và 2 nằm trên GPU thứ nhất, layer 3 và 4 nằm trên GPU thứ hai, và cứ thế tiếp tục. Model thật sẽ có nhiều layer hơn nhiều, "nhưng các bạn hiểu ý rồi đấy", chị nói. Đó là pipeline parallelism: mỗi GPU chỉ giữ một số layer của model, vừa đủ để nằm thoải mái trong bộ nhớ của nó.
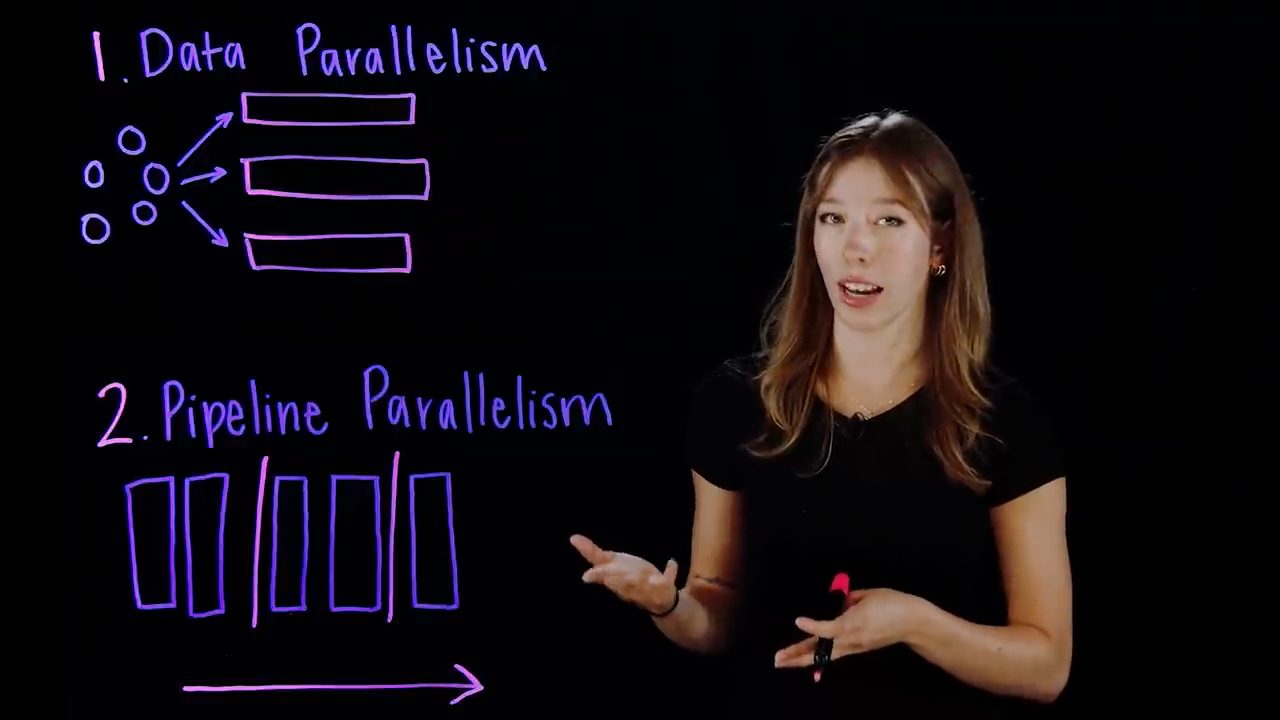
Vấn đề là nếu mỗi lần chỉ gửi một request đi qua, phần lớn GPU sẽ ngồi không, chờ tới lượt mình. Muốn tận dụng hết pipeline parallelism, hãy nghĩ tới dây chuyền lắp ráp: giữ cho request chảy liên tục, để trạm nào cũng bận việc thay vì đứng chờ trạm phía trước.
5. Tensor parallelism: cắt ngang từng layer
"Ta đã chia model theo chiều dọc, giờ hãy xem cách chia theo chiều ngang", Grace nói. Tensor parallelism chia chính từng layer, thay vì chia model theo layer. Mỗi GPU nhận một lát (slice) của cùng một layer, tính phần toán của mình trong layer đó, rồi trao đổi với các GPU khác để ghép các kết quả từng phần lại với nhau. Sau đó chúng lặp lại đúng quy trình ấy cho từng layer một.
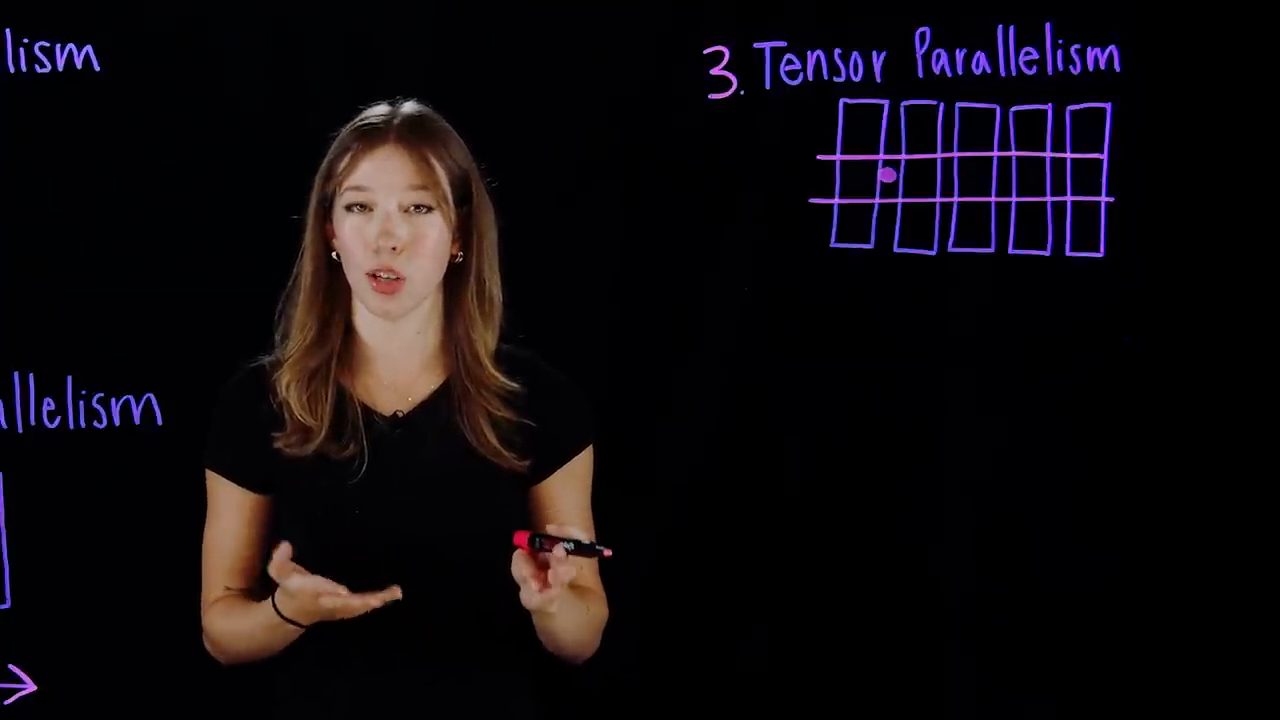
Bước ghép đó được gọi là một collective operation, và nó mang tính chặn (blocking) ở mỗi layer. Vì các GPU phải liên tục nói chuyện với nhau ngay giữa lúc tính toán, theo Grace (video đăng ngày 06/10/2026), cách này chỉ chạy tốt khi chúng được nối bằng một GPU interconnect có bandwidth cao và latency thấp, thường là nằm trong cùng một server. Nếu gửi chừng ấy trao đổi qua một mạng chậm hơn, chính phần giao tiếp này có thể trở thành nút thắt, thay vì là một cách tối ưu.
6. Expert parallelism cho model mixture of experts
Còn một trường hợp chuyên biệt hơn: một loại model gọi là mixture of experts, hay MoE. Thay vì giữ một khối weight duy nhất chạy cho mọi input, model này giữ nhiều mạng con (subnetwork) nhỏ hơn, gọi là expert, mỗi expert được thiết kế để chuyên về một phần khác nhau của việc sinh câu trả lời. Grace lấy ví dụ: một expert có thể thiên về code sample, một expert lo dấu câu (punctuation), có khi một expert khác lo về số.
Vì gom rất nhiều mạng con lại với nhau như vậy, theo Grace (video đăng ngày 06/10/2026), model MoE nhìn chung thường rất đồ sộ.
Expert parallelism rải các expert ra nhiều GPU, để mỗi GPU giữ một phần các expert thay vì một bản sao của cả model. Ở mỗi layer MoE, từng token được gửi (dispatch) tới một nhóm nhỏ expert mà router của nó đã chọn. Grace nói các model hiện đại sẽ chọn khoảng 8 expert trên tổng số 256 (con số chị nêu trong video đăng ngày 06/10/2026), rồi mọi thứ được ghép lại.
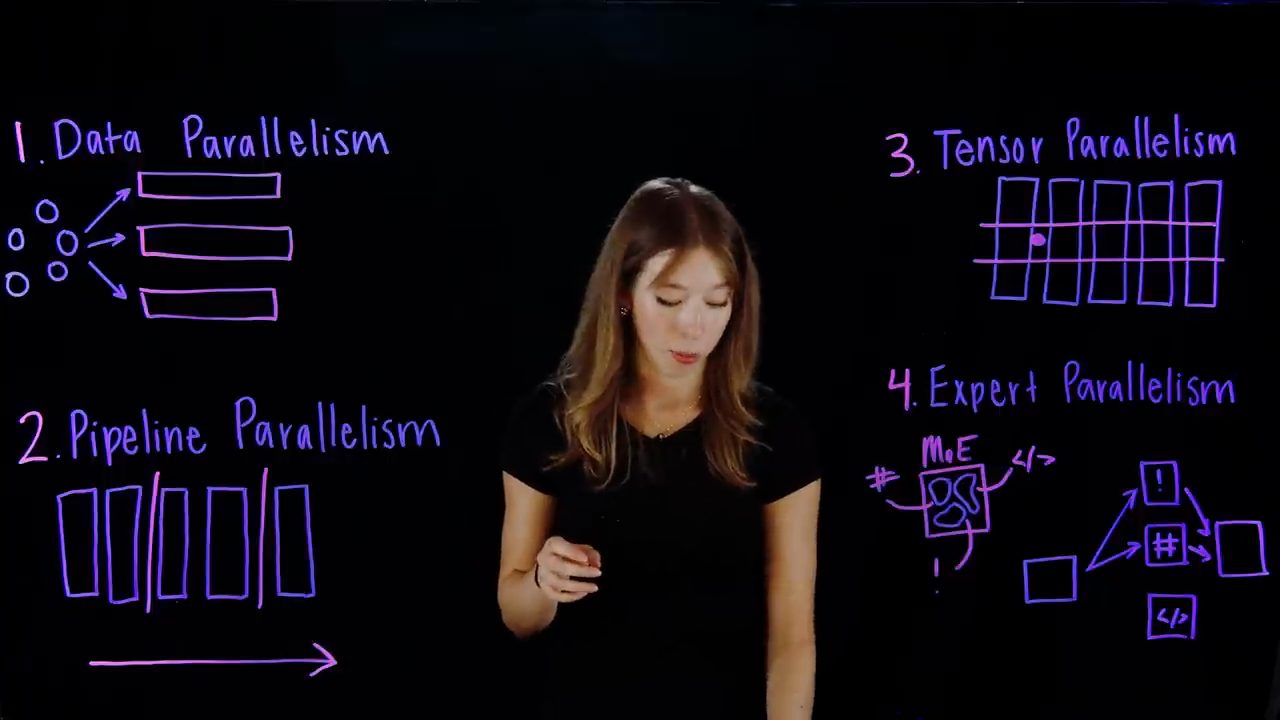
Theo Grace (video đăng ngày 06/10/2026), điều này có nghĩa là lượng tính toán cho mỗi token ít hơn nhiều, nhưng cái giá phải trả là toàn bộ traffic mạng từ GPU sang GPU: gửi từng token đi tới expert, rồi ghép thông tin lại sau đó.
7. Prefill và decode: hai giai đoạn, hai kiểu nút thắt
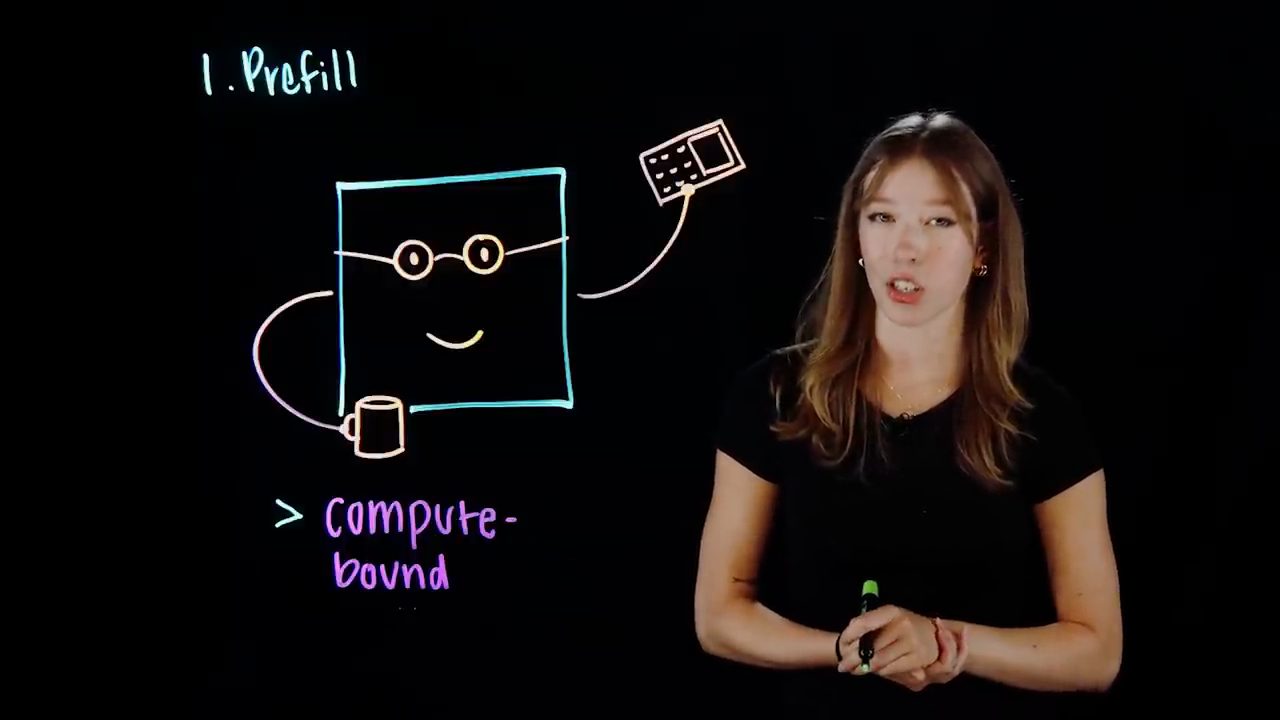
Tối ưu cuối cùng Grace giới thiệu là prefill/decode disaggregation. Trong lúc inference, model đi qua hai giai đoạn chính: prefill và decode.
Prefill là lúc model đọc và hiểu input của bạn. Nó làm việc trên một bộ model weight cố định và cần rất nhiều phép tính song song cùng lúc. Giai đoạn này là compute-bound, nghĩa là tốc độ của nó do việc tính toán nhanh tới đâu quyết định. Prefill cũng là bước xây nên KV cache, "ngân hàng" working memory của model, với mỗi token nó xử lý.
Decode là lúc model dựng câu trả lời cho người dùng. Nó sinh ra câu trả lời từng token một, và ở mỗi bước phải kéo toàn bộ KV cache ra. Khác với model weight, KV cache không cố định, nên nhu cầu bộ nhớ tăng lên theo từng bước decode. Decode là memory-bandwidth-bound: tốc độ của nó do dữ liệu được chuyển ra từ bộ nhớ nhanh tới đâu quyết định.
8. Prefill/decode disaggregation và cái giá của việc chuyển KV cache
Nếu hai giai đoạn nằm chung một chỗ (co-located), khi KV cache lớn dần, nhu cầu bộ nhớ ngày càng tăng của decode có thể bắt đầu lấn sang phần "lãnh thổ" của prefill. Vì hai giai đoạn này đè lên những phần hoàn toàn khác nhau của phần cứng, theo Grace (video đăng ngày 06/10/2026), tách chúng ra thành hai pool GPU riêng thực ra hiệu quả hơn, mỗi pool được tối ưu riêng cho nút thắt của chính nó.
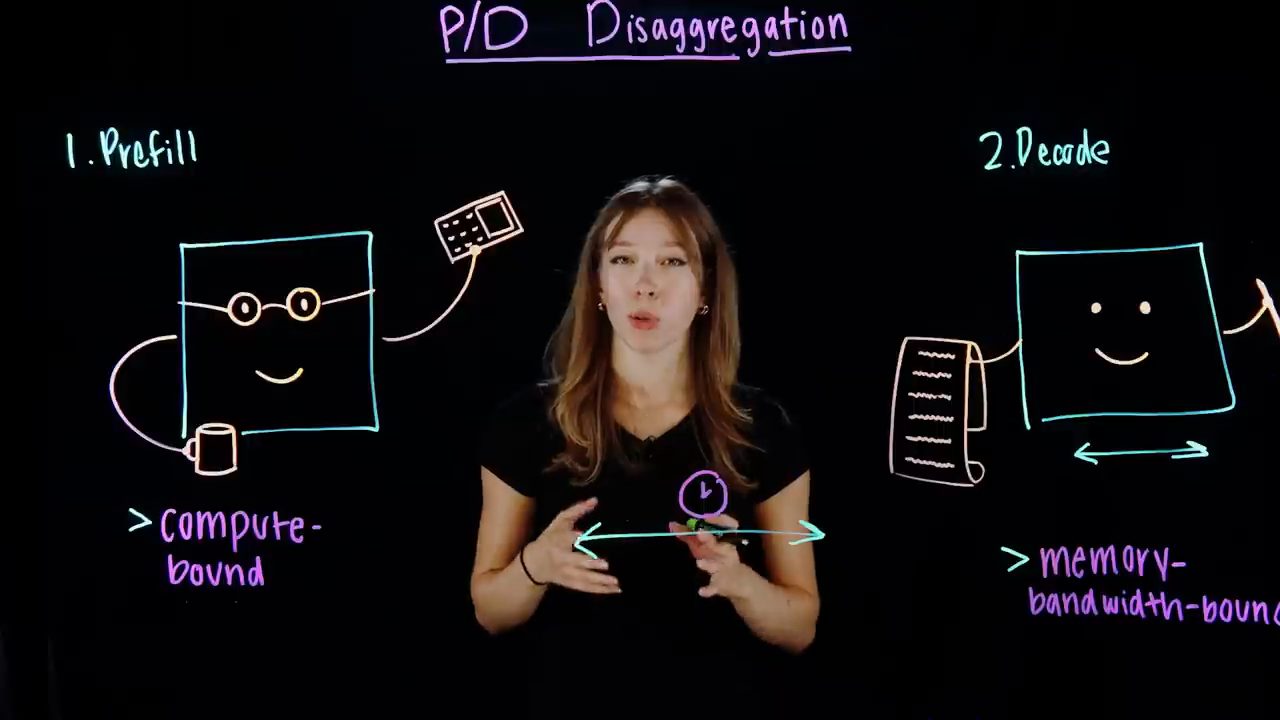
Tuy vậy, Grace nói (video đăng ngày 06/10/2026), việc tách này chỉ đáng khi chính bước bàn giao (handoff) cực kỳ nhanh. Toàn bộ KV cache phải di chuyển từ pool prefill sang pool decode, nên nếu đường nối giữa hai pool quá chậm, bạn sẽ đốt sạch phần thời gian vừa tiết kiệm được.
Trên thực tế, theo chị (video đăng ngày 06/10/2026), điều đó nghĩa là hai pool cần nằm trên hạ tầng mạng riêng, latency thấp, được thiết kế cho việc chuyển dữ liệu throughput cao giữa các compute node, chứ không chỉ là một đường mạng thông thường. TCP thuần trên Ethernet tiêu chuẩn thường không đủ nhanh để việc tách này đáng làm.
Grace tóm lại ba bài toán và lời giải tương ứng:
- Traffic quá đông: giải bằng thêm replica.
- Model quá lớn: giải bằng cách chia weight, theo layer, theo tensor, hoặc theo expert.
- Bộ nhớ cứ lớn dần trong khi phải làm hai kiểu việc khác nhau: giải bằng cách cho mỗi giai đoạn một pool phần cứng riêng.
9. Multidimensional parallelism và lớp orchestration
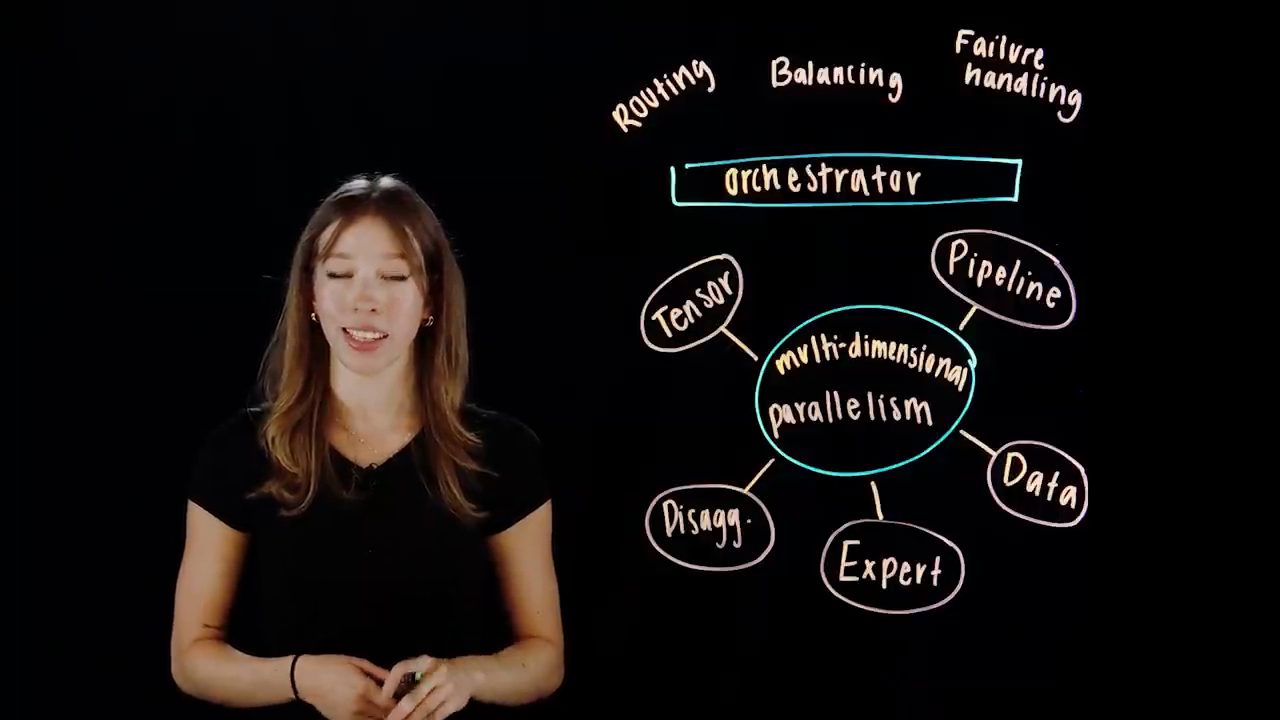
Trong production, theo Grace (video đăng ngày 06/10/2026), các deployment thật xếp chồng nhiều kỹ thuật cùng lúc: tensor parallelism trong một server, pipeline parallelism giữa các server, data parallelism giữa các replica, expert parallelism cho model mixture of experts, và disaggregation để tách serving pipeline theo giai đoạn. Cách kết hợp này được gọi là multidimensional parallelism.
Và theo Grace (video đăng ngày 06/10/2026), nằm trên tất cả là một lớp orchestration: route mỗi request tới đúng pool GPU, cân bằng tải (load balancing), và xử lý lỗi phần cứng mà không làm rơi request nào.
Grace nói đây là một chủ đề cực kỳ phức tạp. Chị mời người xem để lại câu hỏi ở phần bình luận, hoặc kể chị nghe họ đang tối ưu các deployment model của mình bằng distributed inference như thế nào, rồi cảm ơn mọi người đã xem.
Nguồn và liên kết 4 nguồn
- Tên gốc: How AI Models Scale Beyond a Single GPU Across LLM Workloads
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=qZBibWYcKH4 youtube.com
- Kênh YouTube IBM Technology (Grace Ableidinger): youtube.com/channel/UCKWaEZ-_VweaEx1j62do_vQ youtube.com
Related talks
Đọc hiểu tên model AI: số B, đuôi A, chữ Q
Thanh Trần · Thanh Trần - 5 Phút AI · 22 min
Bóc tên model AI ra ba phần (số B, đuôi A, chữ Q) để biết máy có chạy nổi không, kèm số đo thật ba hạng model trong LM Studio.
Tự dựng agentic harness bằng Python thuần, từ chat completion tới harness đầy đủ
Tim Ruscica · Tech With Tim · 38 min
Dựng agentic harness bằng Python không framework: gọi LLM, tool calling, agentic loop, MCP server, memory bằng file markdown và chuyển giữa các model.
Pi 1.0: Codemode, virtual model routing và Pi Durable
AICodeKing · AICodeKing · 17 min
Đi qua bản Pi 1.0: MCP native qua Codemode, Jev, virtual model routing, deferred tool, cache warming, theme mới, và Pi Durable cho agent chạy lâu.