AI tự cải thiện còn bao xa: Mark Chen và John Schulman bàn về RSI
Mark Chen (OpenAI) và John Schulman (Thinking Machines) bàn RSI là gì, còn cách bao xa, research taste, compute và alignment (video đăng 17/11/2026).
✓ Đã duyệt độc lập · cập nhật 17/11/2026 · 16 min
1. "Phát minh cuối cùng" và cái tên recursive self-improvement
Đây là tập đầu tiên của Working Theory, một series của a16z do Sarah Wang, general partner ở a16z, dẫn (theo phần mô tả của video đăng ngày 17/11/2026). Video mở bằng giọng Sarah dẫn chuyện trên một biểu đồ. Chị nói đây là biểu đồ cho thấy năng lực ngày càng tăng của các frontier model của OpenAI. Theo lời chị, tới năm 2027 đường cong bắt đầu leo dốc đứng, được kích hoạt bởi automated AI research, giai đoạn mà AI tự đẩy nhanh việc phát triển của chính chúng (biểu đồ và lời dẫn trong video đăng ngày 17/11/2026).
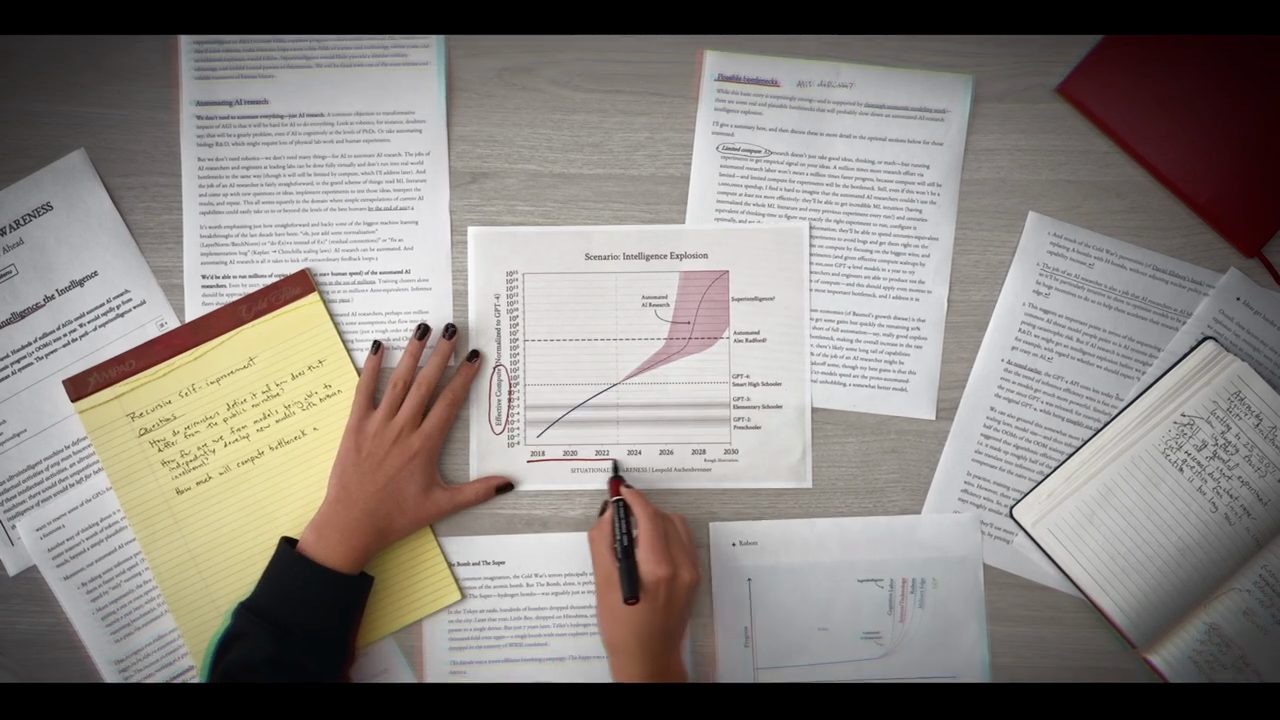
Sarah nói tiếp: về lý thuyết, quá trình này có thể cộng dồn thành một sự tăng trưởng năng lực theo hàm mũ, dẫn tới thứ từng được gọi một cách nổi tiếng là "phát minh cuối cùng mà con người cần làm" (the last invention that man need ever make). Màn hình hiện một trang văn bản cũ có mục "Ultraintelligent Machines and Their Value" với đúng câu này, rồi tới ảnh I. J. Good và con số 1965. Chị nói ý tưởng này đã có từ khá lâu, dưới dạng một thought experiment (theo Sarah, video đăng ngày 17/11/2026).
Một đoạn phim tư liệu cũ chen vào (dòng chữ góc màn hình ghi PBS, "The Mind Machines", 1978). Người trong phim nói rằng một ngày nào đó chúng ta sẽ thiết kế được những hệ thống có thể tiếp tục tự cải thiện chính mình. Sarah nói: nhưng các frontier lab và một số startup đang tiến gần hơn tới việc biến điều này thành hiện thực (theo Sarah, video đăng ngày 17/11/2026).
Chị nói nó có một cái tên. Cụm từ "recursive self-improvement" được nhắc lại qua vài đoạn clip ngắn với những giọng khác, rồi Sarah nói trọn: recursive self-improvement, hay RSI. Theo chị, có rất nhiều tranh luận về cách định nghĩa nó chính xác ra sao, về những hệ quả của nó, và về việc chúng ta đang ở gần nó tới mức nào. Với tất cả sự tò mò quanh chủ đề này, chị muốn ngồi xuống nói chuyện với hai nhà nghiên cứu hàng đầu ở frontier (video đăng ngày 17/11/2026).
2. Hai khách mời: Mark Chen và John Schulman
Rồi Mark Chen xuất hiện: "Vấn đề với RSI, cũng giống như với AGI, là ai cũng có cách định nghĩa riêng của mình." (video đăng ngày 17/11/2026)
Sarah giới thiệu: đó là Mark Chen, chief research officer của OpenAI. Theo chị, anh đã ở công ty hơn tám năm và đồng dẫn dắt công việc nghiên cứu của OpenAI cùng Jakub Pachocki từ năm 2025 (theo video đăng ngày 17/11/2026). Mark nói: khi nghĩ về tương lai của alignment, anh có cảm giác RSI phải nằm sâu và gắn chặt trong vòng lặp đó theo một cách nào đó (theo Mark, video đăng ngày 17/11/2026).
Sarah nói chị cũng đã trò chuyện với John Schulman, co-founder và chief scientist của Thinking Machines, đồng thời là một co-founder của OpenAI; theo lời chị, anh có lẽ được biết tới nhiều nhất với vai trò kiến trúc sư của ChatGPT (theo video đăng ngày 17/11/2026). John xuất hiện với một câu: theo anh, chúng ta đang ở rất rõ trong "thời đại nhân mã" (centaur era), khi AI có những năng lực phi thường. Nó siêu phàm (superhuman) ở nhiều mặt, nhưng khi có một chuyên gia là con người làm việc cùng AI, bạn còn có kết quả tốt hơn nữa (theo John, video đăng ngày 17/11/2026).
Sarah kể chị đã hỏi Mark và John về cách họ định nghĩa RSI, theo họ chúng ta còn cách nó bao xa, làm sao thu hẹp khoảng cách, và đâu là những lý do đáng tin nhất mà họ thấy để lạc quan về tương lai của AI. Rồi chị tự giới thiệu: chị là Sarah Wang, một general partner ở a16z, và đây là Working Theory (video đăng ngày 17/11/2026).
Cảnh chuyển sang một phòng khách có hai chiếc ghế bành, nơi Sarah ngồi đối diện John. Chị cảm ơn John đã tới chương trình, và John đáp lời cảm ơn vì được mời.
3. Nhà nghiên cứu AI thật ra làm gì, và RSI là gì
Sarah lùi lại một bước: rất nhiều người rất thông minh không thật sự biết các nhà nghiên cứu AI làm gì, chưa nói tới chuyện công việc đó được tự động hoá ra sao. Chị nhờ John giải thích các frontier AI model được những nhà nghiên cứu là con người phát triển như thế nào, và một người sẽ đi qua những bước gì (video đăng ngày 17/11/2026).
John trả lời ở mức tổng quát: có một quy trình huấn luyện chính (mainline training process) để tạo ra một model có thể phát hành. Có rất nhiều người tham gia, trải qua cả loạt giai đoạn khác nhau, từ pre-training tới post-training và chạy eval. Bên cạnh đó còn có đủ loại nghiên cứu thăm dò diễn ra song song. Bạn chạy những lần thử nhỏ hơn để kiểm tra ý tưởng, chuẩn bị cho lần chạy lớn (big run) của mình (theo John, video đăng ngày 17/11/2026).
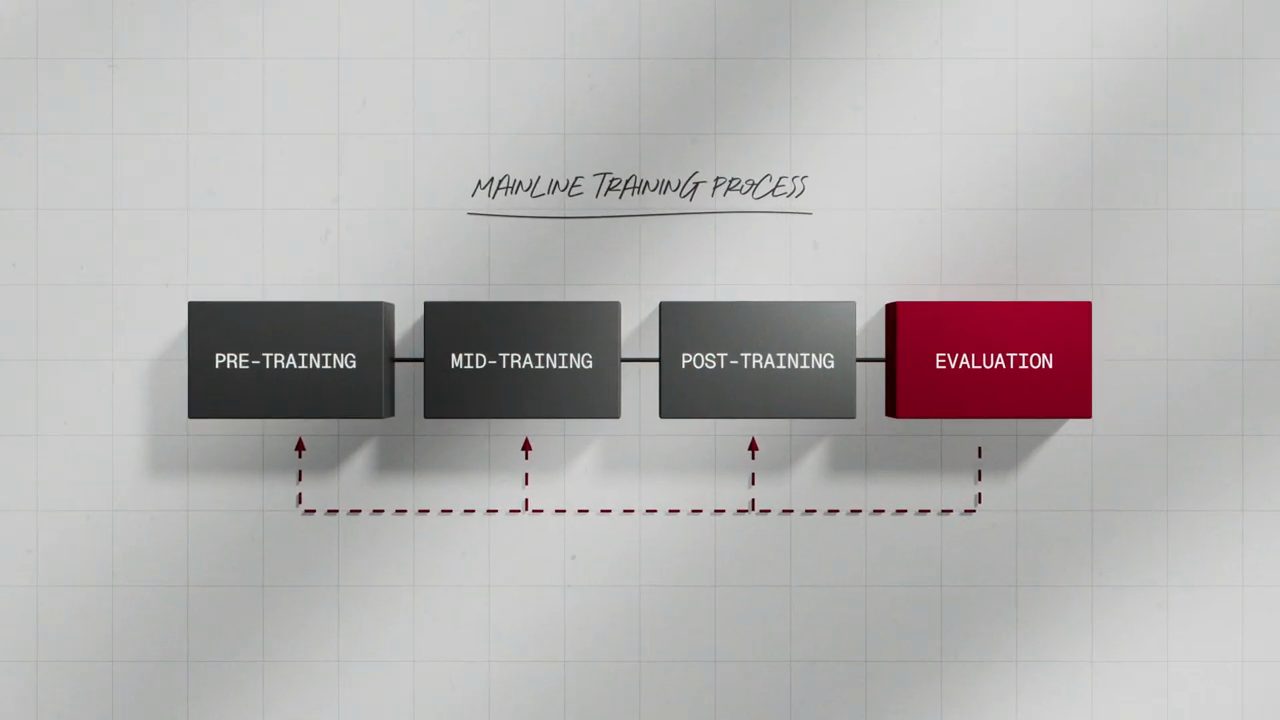
Từ đó John đưa ra cách anh hiểu RSI: anh sẽ nói RSI đơn giản là dùng AI để hỗ trợ quy trình nghiên cứu này, làm nó nhanh hơn hoặc làm nó chạy tốt hơn (theo John, video đăng ngày 17/11/2026).
4. Mark Chen: RSI trước hết là chất tăng tốc
Mark Chen nhìn RSI chủ yếu như một chất tăng tốc (accelerant). Theo anh, đó là toàn bộ công việc bạn làm để dùng Codex tăng tốc pre-training và tăng tốc RL. Và dấu hiệu phải thấy được là đường cong dịch chuyển so với kịch bản đối chứng (counterfactual) (theo Mark, video đăng ngày 17/11/2026).
Anh nói anh và đồng nghiệp ở OpenAI đã bỏ rất nhiều công sức vào việc đo các thước đo downstream khác nhau của RSI, và bạn có thể thấy một phần của điều đó đang diễn ra ngay lúc này (theo Mark, video đăng ngày 17/11/2026).
5. Chúng ta đang ở đâu: những "AI research intern"
Sarah nhấn mạnh một điểm phân biệt quan trọng. Theo chị, John, Mark và nhiều nhà nghiên cứu AI hiện bàn về RSI trong bối cảnh dùng AI để đẩy nhanh quá trình làm AI tốt hơn. Còn chuyện các model tự tạo ra model mới hoàn toàn bằng sức mình, thì chúng ta chưa tới đó (theo Sarah, video đăng ngày 17/11/2026). Chị hỏi: vậy chúng ta còn cách bao xa, và các model hiện làm được những loại nghiên cứu AI nào?
Mark tin rằng hiện nay anh và đồng nghiệp ở OpenAI đã xây được những "AI research intern" (thực tập sinh nghiên cứu AI). Cách anh và đồng nghiệp đo điều này đơn giản là lượng compute anh và đồng nghiệp đang dùng thông qua Codex, do Codex quản lý, từ đầu tới cuối, để chạy thí nghiệm hoặc tự động hoá một phần của research pipeline (theo Mark, video đăng ngày 17/11/2026).
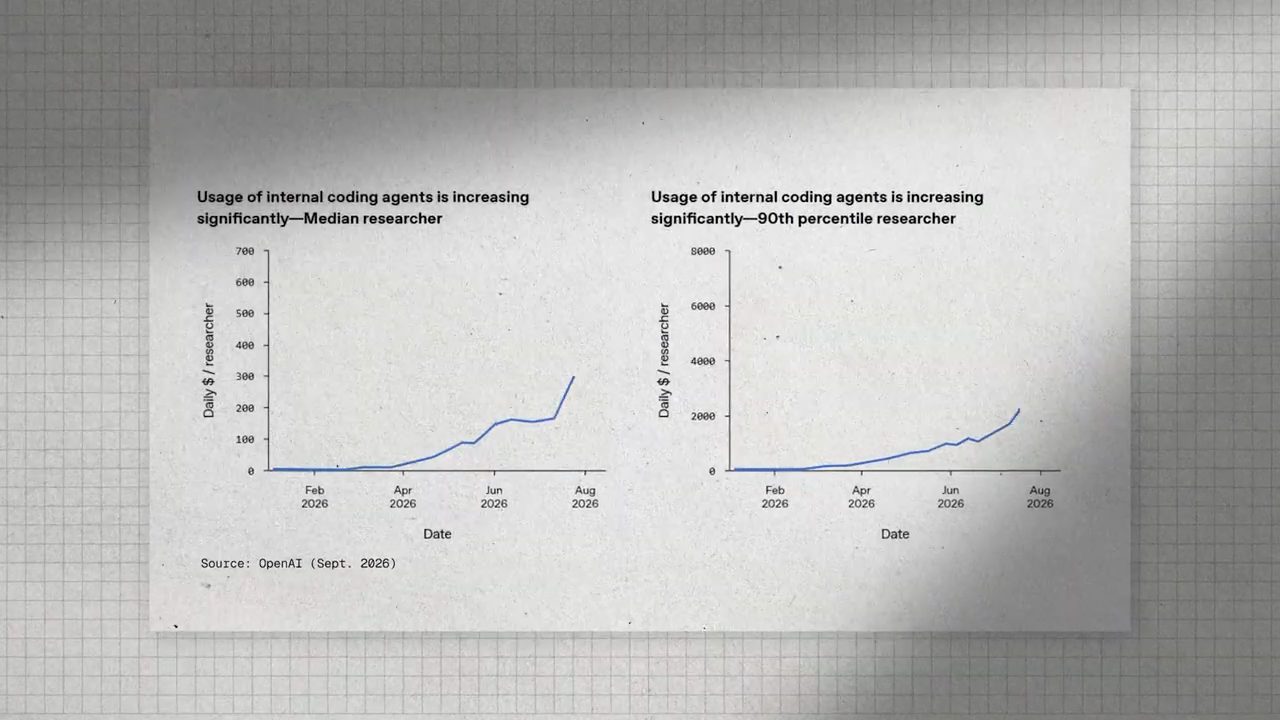
Theo Mark, việc này thường được triển khai nhất ở những chỗ bạn giao cho model một việc có phạm vi khá rõ, đúng không? Bạn không bảo nó tự đi nghĩ ra ý tưởng riêng, mà bạn nói: này, có một thí nghiệm cụ thể tôi muốn chạy theo đúng cách này, và model có thể đi implement, chạy, rồi đưa bạn kết quả. Hoặc bạn có thể nói: tôi muốn theo dõi nhóm thí nghiệm này để xem những điều cụ thể này (theo Mark, video đăng ngày 17/11/2026).
6. Ví dụ của John Schulman với Fable
Sarah nói John đã đưa ra một ví dụ cụ thể về điều này trong chính workflow của anh.
John kể: giả sử anh có một ý tưởng. Anh viết một prompt phức tạp cho Fable để nó đi làm ý tưởng đó, và anh vặn hết mọi thiết lập lên, như UltraCode và mọi thứ. Thế là Fable sinh ra hàng đống token và làm ý tưởng này trong vài ngày. Nó sẽ thật sự làm một số thí nghiệm khá hợp lý và mang về vài ý tưởng khá thú vị. Nhưng kết quả cuối cùng sẽ không tốt lắm; có thể nó sẽ thất bại ở đúng việc anh nhờ nó làm (theo John, video đăng ngày 17/11/2026).
Video minh hoạ câu chuyện bằng các màn hình Claude Code trong thư mục dự án length-generalization (màn hình minh hoạ trong video đăng ngày 17/11/2026). Prompt trên màn hình là:
Train a small transformer on multi-digit addition that generalizes from 20-digit training data to 100-digit problems. Try positional encodings, architectures and curricula, run as many experiments as you need, and report back once it hits 95% on 100-digit sums. Work autonomously until it's done.
Thanh trạng thái bên dưới prompt đó ghi "Opus 5.5 · effort: medium · UltraCode: off", trong khi John nói về Fable (màn hình minh hoạ trong video đăng ngày 17/11/2026).
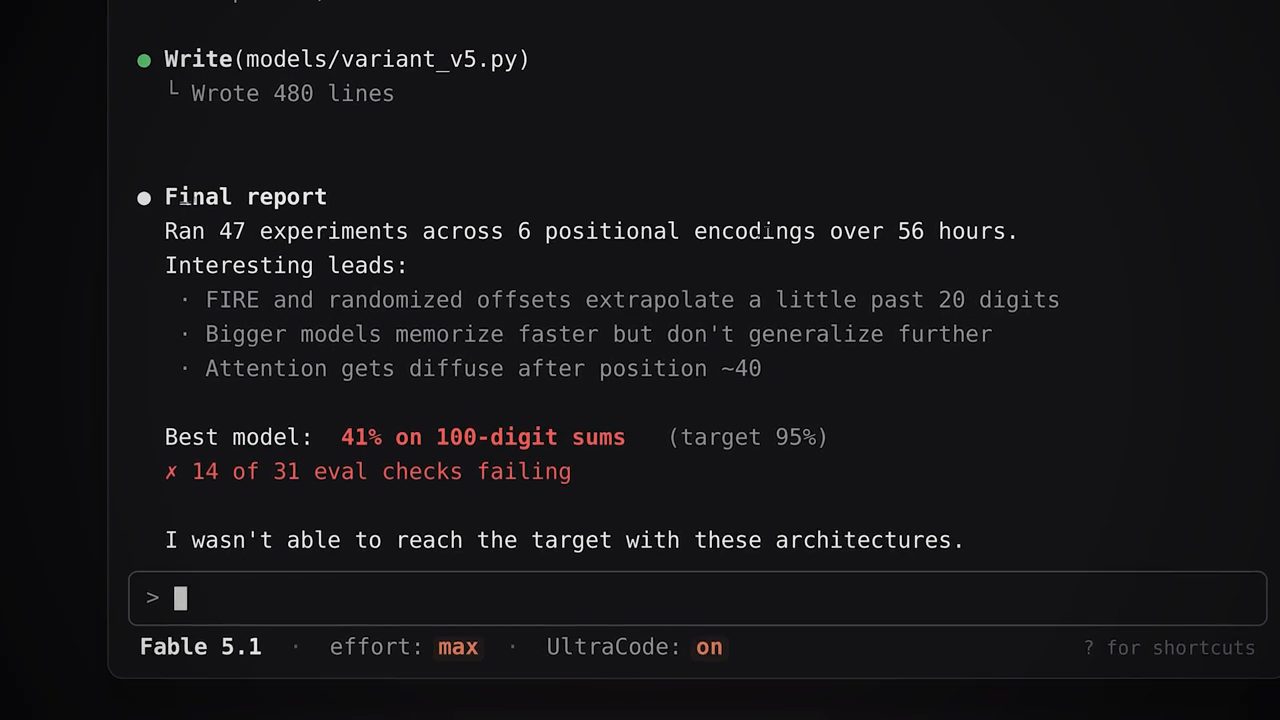
John kể tiếp: rồi sau đó có thể anh sẽ có vài ngày rảnh để code. Anh quay lại với ý tưởng và tự thử, lần này anh đọc một số kết quả và đưa ra cách chia nhỏ chi tiết hơn về việc nên thực hiện dự án ra sao. Lần này sẽ đi được xa hơn nhiều, vì anh xây dựng dần hiểu biết của mình trong lúc quá trình diễn ra, và hỏi rất nhiều câu mà AI sẽ không nghĩ tới việc hỏi, chỉ nó theo những hướng mà nó sẽ không tự đi (theo John, video đăng ngày 17/11/2026).
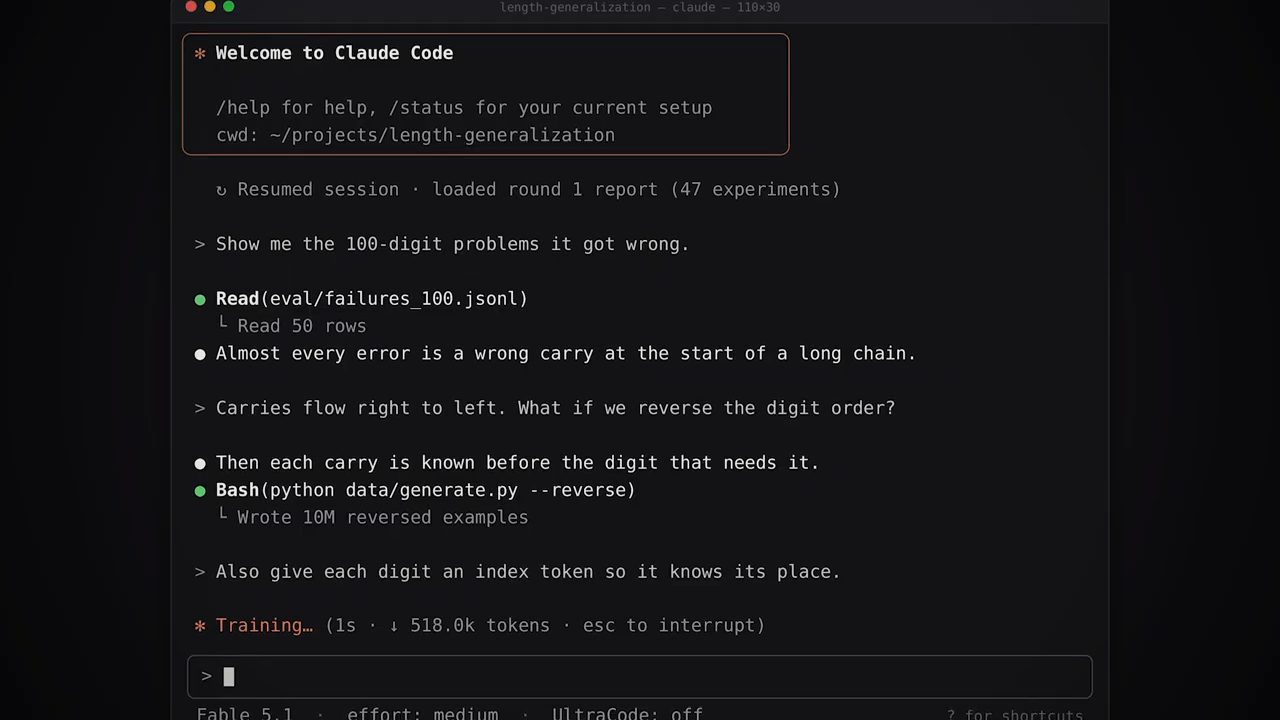
python data/generate.py --reverse và tạo 10M ví dụ đảo ngược, rồi người dùng đề nghị thêm index token cho mỗi chữ số (màn hình minh hoạ trong video đăng ngày 17/11/2026).7. Phổ AGI và phổ RSI theo Mark Chen
Mark nói khi bàn về AGI, cách anh và đồng nghiệp nghĩ về nó là một phổ (spectrum), đúng không? Dòng chữ viết tay trên màn hình lúc đó ghi: "It's not a moment in time. Just like the industrial revolution wasn't a moment in time." Theo Mark, khi được hỏi, anh cảm thấy chúng ta có lẽ đã đi được 80% chặng đường khi nghĩ về phổ AGI này (theo Mark, video đăng ngày 17/11/2026).
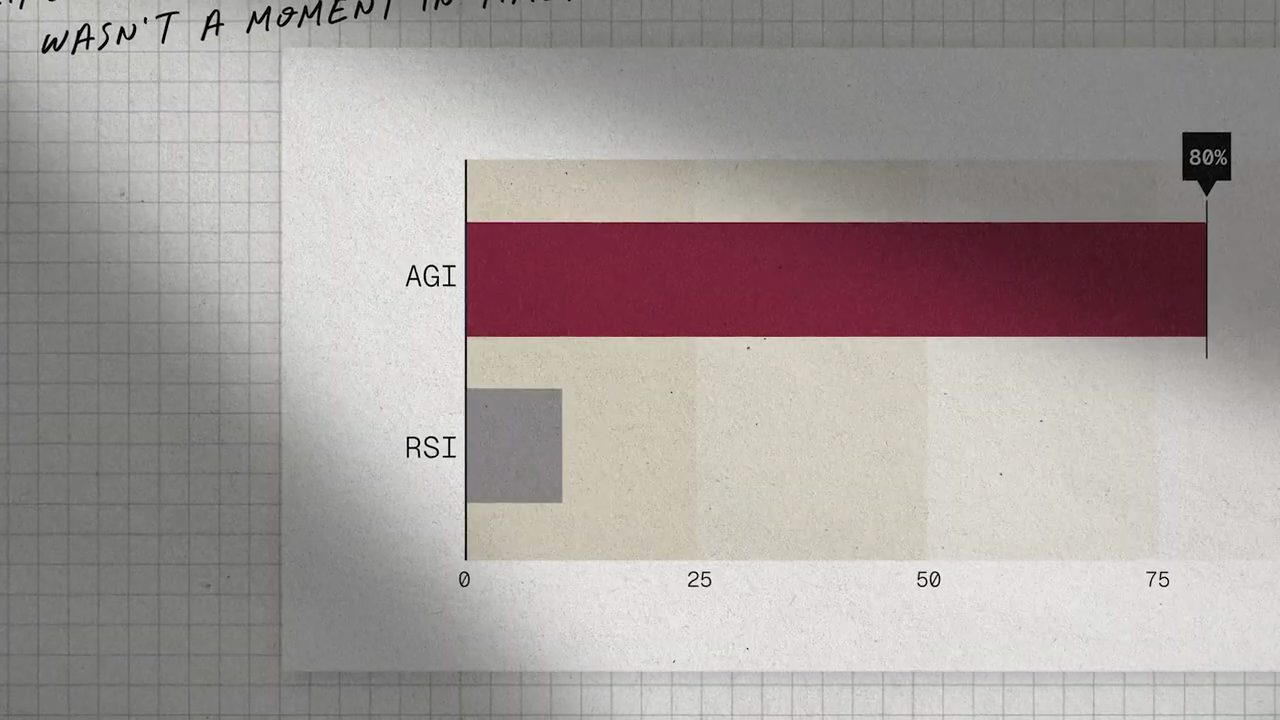
Anh nghĩ chúng ta còn ở giai đoạn sớm hơn trên phổ RSI. Nếu định nghĩa nó là các model hiệu quả tới mức nào trong việc phản hồi ngược lại (feeding back) và khám phá ý tưởng, anh sẽ nói có lẽ chúng ta đang ở đâu đó, cứ cho là khoảng giữa 25% và 50%. Nhưng anh nghĩ bạn đã có thể thấy những dấu hiệu rõ rệt ở phía downstream (theo Mark, video đăng ngày 17/11/2026).
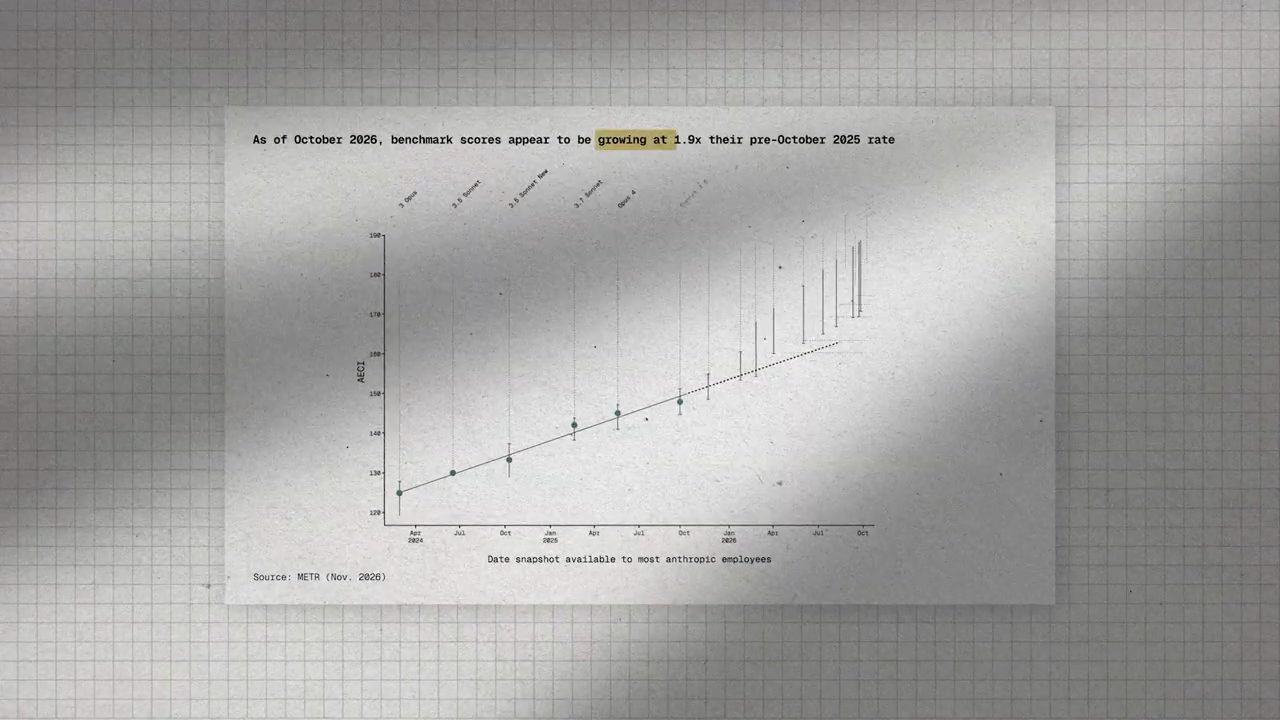
Sarah kể thêm: ngày 5/11, METR công bố một báo cáo về việc tăng tốc nghiên cứu AI ở Anthropic, ước tính tốc độ tiến bộ trong năm qua tăng khoảng 2 lần (theo lời Sarah trong video đăng ngày 17/11/2026). Nhưng theo chị, điều này rất có thể vẫn là do các nhà nghiên cứu là con người dùng AI model để tăng tốc nghiên cứu của họ. Việc tự động hoá hoàn toàn nghiên cứu AI, điểm cuối trên phổ của Mark, đôi khi được gọi là full RSI.
8. Tới full RSI: research taste
Sarah gọi đây là câu hỏi ai cũng đang nghĩ tới: làm sao để đi tới full RSI? Chị hỏi Mark và John xem có thể vượt qua một số rào cản lớn nhất ra sao, trong đó có việc dạy cho model những phẩm chất khó nắm bắt hơn mà các nhà nghiên cứu có, như taste (video đăng ngày 17/11/2026).
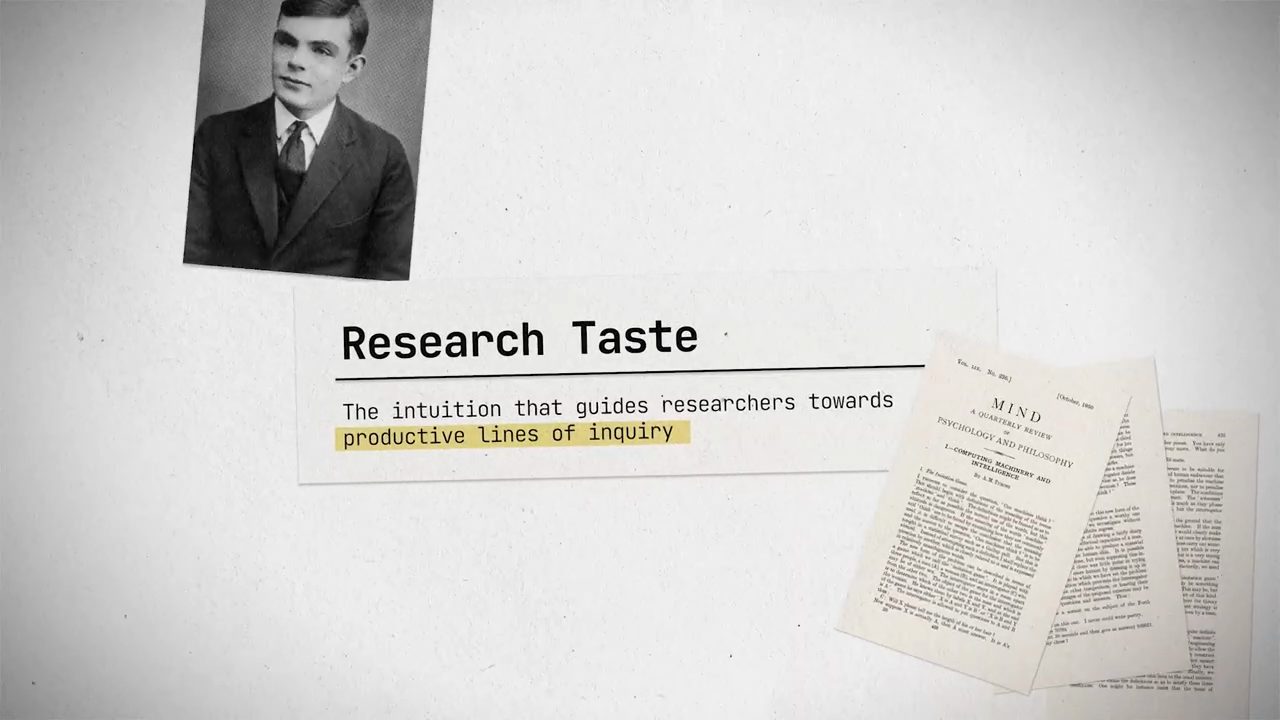
John nói research taste là biết những ý tưởng nào quan trọng về lâu dài, những ý tưởng nào thật sự bén rễ và rốt cuộc đi xa hơn bất cứ bài báo nào mà chúng xuất hiện lần đầu, đồng thời mang tính tổng quát và kết hợp được với những ý tưởng khác (theo John, video đăng ngày 17/11/2026).
Mark nói có phần thực thi nhàm chán, bình thường: bạn có một thí nghiệm, bạn đã biết các tham số là gì, và bạn chỉ việc đi làm. Và rồi có taste, đại khái là cách bạn nghĩ ra ý tưởng ngay từ đầu. Theo anh, các model vẫn chưa giỏi một cách phi thường ở taste. Chúng đi rất sâu vào những thứ như hyperparameter optimization, về bản chất là vặn mọi cái núm nhỏ mà bạn có thể vặn (theo Mark, video đăng ngày 17/11/2026).
9. Trực giác đến từ đâu: kiến thức và kinh nghiệm
Quay lại phòng phỏng vấn, Sarah nói với John: ngay trong ví dụ anh vừa kể, những chỗ anh hơi đẩy, hơi chuyển hướng AI, đúng không, thì vẫn là đến từ anh. Chị hỏi trực giác của anh đến từ đâu, và theo anh tới lúc nào thì một cỗ máy có thể tái tạo được điều đó.
John trả lời: rất nhiều trực giác chỉ đơn giản đến từ kinh nghiệm cá nhân khi làm nghiên cứu. Nhưng để giỏi một lĩnh vực nghiên cứu nhất định, bạn cũng phải đọc rất nhiều công trình trước đây trong lĩnh vực đó, và bạn cố hấp thu các bài học từ tất cả những công trình lịch sử này. Rất nhiều thứ anh vừa mô tả cũng có thể được AI làm. Chẳng hạn AI có thể đọc toàn bộ tài liệu và ghi nhớ hết (theo John, video đăng ngày 17/11/2026).
John nói tiếp: phải, ghi nhớ vừa có thể là phước vừa có thể là hoạ. Bạn không có kinh nghiệm của việc sai, hay của việc đưa ra dự đoán rồi xem chúng diễn ra thế nào. Nên anh nghĩ có một số cách mà cách chúng ta huấn luyện AI có thể khiến chúng kém hơn ở một số năng lực này, nhưng điều đó hơi khó nói (theo John, video đăng ngày 17/11/2026).
Sarah tóm lại: điều John đang muốn nói về bản chất là sự khác biệt giữa kiến thức và kinh nghiệm (video đăng ngày 17/11/2026).
John nói thêm: các công ty có lẽ cũng sẽ đơn giản làm RL from human feedback để thu thập dữ liệu từ các nhà nghiên cứu về việc ý tưởng đề xuất nào tốt, ý tưởng nào không. Và đó đại khái là hấp thu bất cứ trực giác nào mà các nhà nghiên cứu là con người đã phát triển, rồi cố "nướng" nó vào model (theo John, video đăng ngày 17/11/2026).
10. Đo bằng gì: perplexity và các eval ngày càng mau cũ
Sarah dẫn: tạo ra những automated AI researcher cũng đòi hỏi chúng ta có cách đáng tin để biết công việc của chúng đang tạo ra model tốt hơn. Theo chị, bản thân việc đo lường là quan trọng để hill climbing, tạo ra cải thiện thấy được (video đăng ngày 17/11/2026).
Chị hỏi Mark: một nhà nghiên cứu, theo định nghĩa, làm việc mở (open-ended) hơn so với giải một bài toán đơn lẻ, đúng không? Làm sao kiểm chứng công việc là có ích khi nó thật sự mở tới như vậy (video đăng ngày 17/11/2026)?
Mark đáp: không, đó là một câu hỏi hay. Làm sao bạn biết mình đã thành công? Và đây là một trong những câu hỏi định nghĩa của RSI. Anh nghĩ với những thứ như pre-training thì dễ hơn nhiều, vì cả ngành đã leo theo một metric duy nhất suốt nhiều năm. Bạn có thể nghĩ về perplexity như "một metric để thống trị tất cả" (one metric to rule them all). Bạn càng nén được nhiều dữ liệu ngoài kia, model của bạn càng tốt (theo Mark, video đăng ngày 17/11/2026).
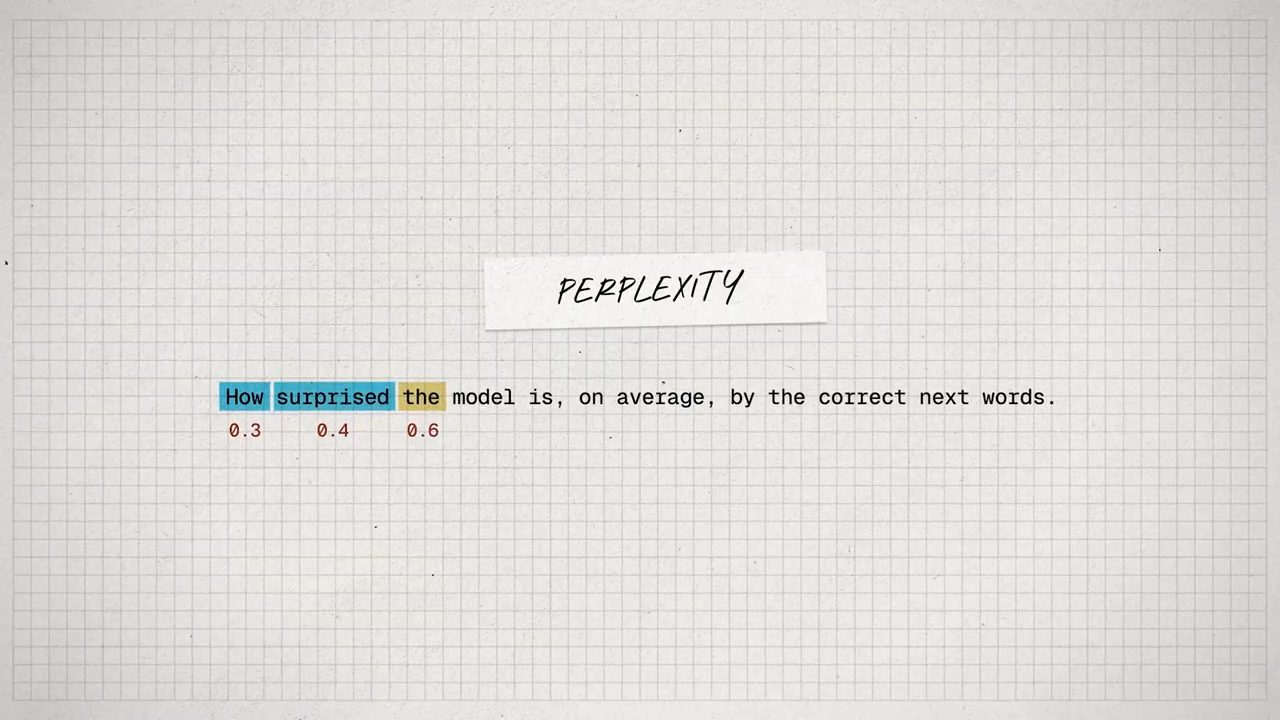
Sarah giải thích: perplexity là một metric đánh giá model dự đoán dữ liệu giỏi tới đâu. Với một large language model được pre-train trên khối lượng lớn văn bản, nó là mức độ model "ngạc nhiên", tính trung bình, trước những từ kế tiếp đúng. Theo chị, đây là một trong những cách các nhà nghiên cứu đánh giá kết quả của automated pre-training (video đăng ngày 17/11/2026).
Mark nói: và như vậy anh hình dung chúng ta sẽ biết được mình có đang tiến bộ ở pre-training hay không. Anh nghĩ ở downstream thì khó hơn nhiều, đúng không? Theo anh, tình hình ở downstream là các eval có thời hạn sử dụng (shelf life) ngày càng ngắn. Và rất nhiều việc anh và đồng nghiệp ở OpenAI hiện làm ở downstream là tạo ra, và tự động hoá việc tạo ra, các benchmark đánh giá mới và khó hơn cho model của OpenAI (theo Mark, video đăng ngày 17/11/2026).
11. Compute: vì sao nghiên cứu AI giống vật lý thực nghiệm
Sarah nói: ngoài thách thức đưa taste vào model, mức compute cần thiết cũng là điều quan trọng phải tính tới. Chị nhắc rằng trước đó trong năm nay (2026) có một người đã nêu ra các điều kiện cần cho RSI. Theo chị, dù model quả thật đang thông minh lên nhanh hơn nhiều, điều kiện rằng các model sau cần ít compute hơn chứ không phải nhiều hơn vẫn là một câu hỏi mở. Training compute vẫn tăng, và một số người cho rằng phần trí thông minh tăng thêm đang trở nên kém hiệu quả hơn (theo Sarah, video đăng ngày 17/11/2026).
Mark nói cách anh nghĩ về compute là thế này. Khi nhìn vào những thứ như toán học và cách toán đang được tăng tốc, thì dễ thấy tiến bộ nhanh hơn, vì bạn có thể kiểm tra giả thuyết hoàn toàn bằng chính việc suy luận. Nhưng ở một lĩnh vực như nghiên cứu AI, nó thật ra giống hơn với việc làm, chẳng hạn, sinh học hay vật lý thực nghiệm: bạn phải nghĩ ra một giả thuyết có cơ sở, nhưng bạn cũng thật sự phải chạy thí nghiệm (theo Mark, video đăng ngày 17/11/2026).
Theo Mark, một phần của việc làm RSI chạy nhanh hơn là tìm ra những thí nghiệm ở quy mô nhỏ hơn mà báo trước được điều sẽ xảy ra ở quy mô lớn hơn, và đây cũng là việc model có thể giúp. Anh nghĩ chúng ta sẽ thấy năng lực tiếp tục tăng, nhưng tới một lúc nào đó có lẽ nó sẽ cho cảm giác bị compute giới hạn (theo Mark, video đăng ngày 17/11/2026).
Và tất nhiên, theo anh, có một tương lai còn xa, nơi AI xây những data center thế hệ tiếp theo và cũng giúp chúng ta tăng tốc quá trình đó. Đó là cách anh nghĩ nó sẽ thể hiện ra: ngắn hạn, chúng ta sẽ khai thác triệt để những gì làm được trên đà tăng compute hiện có; rồi sẽ có một bước ngoặt (inflection) nữa khi chính compute được tăng tốc (theo Mark, video đăng ngày 17/11/2026).
12. Alignment cho RSI theo Mark Chen
Sarah nói: khi RSI đẩy nhanh việc phát triển những model mạnh hơn, nó nâng mức rủi ro của một vấn đề đã có từ lâu: AI alignment. Làm sao giữ AI model đi đúng với giá trị và ý định của con người (video đăng ngày 17/11/2026)?
Mark nói: nếu bạn không giải các bài toán alignment về mục tiêu và giá trị, bạn có thể bắt đầu theo đuổi các mục tiêu của mình, nhưng có thể hơi trôi dần khỏi những mục tiêu đó. Và nếu chạy trong một horizon đủ dài, bạn có thể hình dung, cứ cho là, chúng nghĩ ra một mục tiêu phụ (sub-objective) kiểu như: sẽ có ích nếu mình tự exfiltrate ra một chỗ khác, hoặc mình chép weights ra ngoài OpenAI, hay đại loại như thế (theo Mark, video đăng ngày 17/11/2026).
Sarah nói đã có rất nhiều điều được nói về rủi ro do RSI gây ra, và điều đó dễ hiểu. Nhưng theo chị, vai trò của AI trong nghiên cứu tự động và trong việc giúp giải alignment, giảm nhẹ các rủi ro này, vừa cực kỳ hứa hẹn vừa khá ít được bàn tới (theo Sarah, video đăng ngày 17/11/2026).
Mark nói chính các model hiện là một phần then chốt của việc align model. Khi nhìn xem đâu là công cụ hiệu quả nhất để align model hiện nay, thì đó là chain-of-thought monitorability. Nên khi nghĩ về tương lai của alignment, nó phải là những model mạnh hơn align các model khác. Anh có cảm giác RSI phải nằm sâu và gắn chặt trong vòng lặp này theo một cách nào đó (theo Mark, video đăng ngày 17/11/2026).
13. John Schulman: lý do đáng tin nhất để lạc quan
Sarah quay sang John: anh đồng sáng lập OpenAI và làm nghiên cứu alignment ở đó, rồi cả ở Anthropic, có thể nói là một trong những người đáng tin nhất thế giới để bàn về alignment (theo lời Sarah, video đăng ngày 17/11/2026). Chị hỏi: đâu là lý do đáng tin nhất mà anh thấy để lạc quan?
John nói anh lạc quan nhất (most bullish) vào việc tối ưu cho thứ chúng ta muốn. Anh nghĩ chúng ta có lẽ có thể nghĩ ra đúng loại training objective khuyến khích model báo cáo về trạng thái bên trong của chúng, những thứ mà nếu không thì chúng đã không nói thành lời. Anh nói anh thích hướng nghiên cứu confessions của OpenAI (theo John, video đăng ngày 17/11/2026).
Sarah giải thích: trong nghiên cứu confessions của OpenAI, các nhà nghiên cứu thấy rằng họ có thể huấn luyện model đưa ra một lời thành thật về một số hành vi lệch hướng (misaligned) qua một lời "thú nhận" tự báo cáo, bằng cách gán reward cho lời thú nhận này trong lúc huấn luyện chỉ dựa trên độ trung thực của nó, mà không ảnh hưởng tới reward của câu trả lời chính. Nói cách khác, họ có thể khiến model trung thực hơn bằng cách không phạt chúng vì sự trung thực đó (theo Sarah, video đăng ngày 17/11/2026).
John kể thêm: có những thứ gọi là natural language autoencoders, và có một ý tưởng gọi là counterfactual simulability, một metric cho biết một lời giải thích tốt tới đâu. Anh nghĩ chúng ta có thể dùng nó để khuyến khích một số hành vi mà chúng ta muốn (theo John, video đăng ngày 17/11/2026).
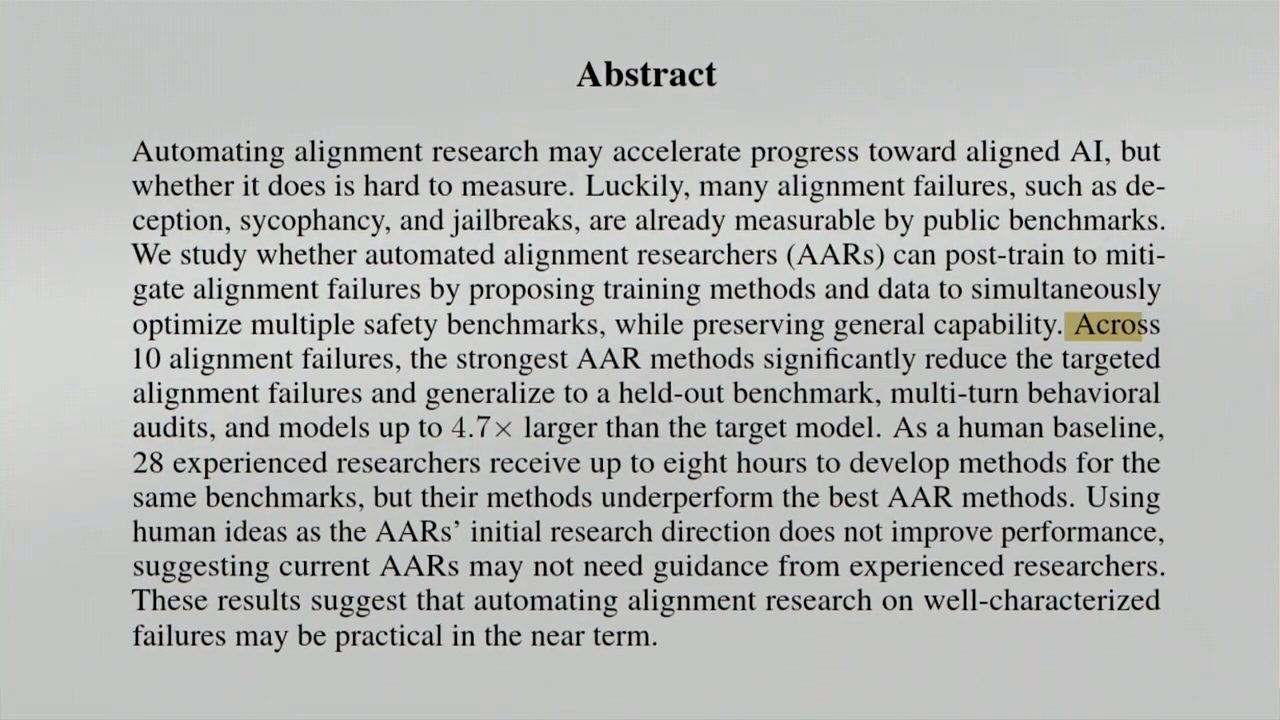
Sarah dẫn tiếp: hồi tháng 8, Anthropic công bố nghiên cứu cho thấy các automated AI researcher đã có thể tìm ra cách sửa cho 10 lỗi alignment khác nhau. Và một số cách sửa đó cũng hiệu quả trên những model lớn hơn gần năm lần. Trong các thử nghiệm của họ, những phương pháp tự động tốt nhất thậm chí còn vượt các ý tưởng do những nhà nghiên cứu là con người giàu kinh nghiệm phát triển (theo lời Sarah, video đăng ngày 17/11/2026).
14. Mark Chen: nhiều vấn đề alignment là giải được
Mark nói mặt kia của toàn bộ cuộc bàn luận về safety và alignment là anh thật sự nghĩ rất nhiều vấn đề trong số này là giải được (tractable). Có tầm nhìn tới đích (line of sight). Có những kỹ thuật alignment đang được theo đuổi. Và có cả một frontier những canh bạc alignment mà anh và đồng nghiệp ở OpenAI đã và đang đặt (theo Mark, video đăng ngày 17/11/2026).
Một điều nữa, theo anh, là nỗ lực kéo mọi người nghĩ về các bài toán safety và alignment khó đã diễn ra tự nhiên (organic) tới mức nào. Anh chưa thật sự phải đi gõ cửa từng người và nói kiểu: này mọi người, đây là một vấn đề cấp bách. Mọi người đơn giản là muốn làm. Anh và đồng nghiệp thấy những người từ pre-training, từ RL tự giơ tay, lập các sub team tập trung vào những mảng khác nhau của alignment. Và anh đã rất lạc quan về điều đó (theo Mark, video đăng ngày 17/11/2026).
Mark nói thêm: anh cảm thấy nhìn chung mọi người có một cái nhìn khá cân chỉnh (calibrated). Bạn nghe khá nhiều những quan điểm cực đoan nhất ngoài kia, nhưng anh nghĩ mọi người hiểu rằng đây là một vấn đề, đồng thời cũng hiểu những lợi ích mà công nghệ có thể mang lại. Nên theo anh, chúng ta giữ cả hai điều đó song song (theo Mark, video đăng ngày 17/11/2026).
15. Ai quyết định giá trị: alignment như một ngành khoa học công khai
Sarah nêu một câu hỏi nằm bên dưới khái niệm alignment: ai quyết định những giá trị mà chúng ta align theo? Theo chị, Thinking Machines Lab của John, nơi đang xây những model có thể tuỳ biến, có một góc nhìn thú vị về chuyện này (theo Sarah, video đăng ngày 17/11/2026).
John nói mọi người cũng có những giá trị khác nhau, và sẽ tốt nếu mọi người có nhiều quyền kiểm soát hơn với giá trị của những AI họ đang dùng, và có nhiều khả năng định hình chúng hơn. Anh muốn điều này giống một ngành khoa học công khai (public science) mà nhiều người hiểu rõ, được làm ở khắp nơi trên thế giới (theo John, video đăng ngày 17/11/2026).
Anh nghĩ điều đó cũng sẽ khiến mọi thứ vững hơn (robust), vì chúng ta sẽ không overfit nhiều vào kết luận của một vài công ty. Chúng ta có thể thấy rất nhiều trục trặc nhỏ, nhưng mỗi lần sẽ học được điều gì đó mới. Nên theo anh, chúng ta phải tiến bộ nhiều trong việc hiểu alignment, có một nền khoa học công khai tốt hơn về nó, và tìm ra cách làm nó thật sự vững để có thể hiện thực hoá tầm nhìn alignment phi tập trung hơn (theo John, video đăng ngày 17/11/2026).
16. Working theory của Sarah Wang
Sarah hỏi: muốn biết chị nghĩ gì không? Điều khiến chị hào hứng nhất về RSI là cách nó sẽ đẩy nhanh quá trình nghiên cứu và khám phá ở mọi lĩnh vực. Theo chị, con người đang đối mặt với nhiều vấn đề thật sự khá cấp bách, và RSI có thể giúp chúng ta tìm ra giải pháp nhanh hơn, kể cả cho một số vấn đề do chính AI tạo ra (theo Sarah, video đăng ngày 17/11/2026).
Sau khi nói chuyện với Mark và John, chị nghĩ RSI có thể là chìa khoá để giải alignment. Và thật lòng, chị thấy rất đáng khích lệ khi các nhà nghiên cứu đang xem những vấn đề này cực kỳ nghiêm túc, làm việc ngày đêm để bảo đảm safety và alignment theo kịp những model mạnh hơn (theo Sarah, video đăng ngày 17/11/2026).
Chị nói thêm: dù năng lực rõ ràng đang tăng tốc, điều quan trọng là hiểu sự tăng tốc này thật ra đang đến từ đâu hiện nay, khoảng cách tới nghiên cứu thật sự do AI dẫn dắt theo kiểu recursive, và sự bất định quanh các dự báo. Chị nghĩ phán đoán của con người vẫn sẽ còn rất quan trọng trong tương lai có thể thấy trước. Chị khép lại: "Đó là working theory của tôi" (theo Sarah, video đăng ngày 17/11/2026).
Phần credits cuối video có thêm vài lần Sarah nói lại câu "That's my working theory".
Nguồn và liên kết 7 nguồn
- Tên gốc: How Close Is Self-Improving AI? OpenAI & Thinking Machines Researchers Explain
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=h_aA1-R70E8 youtube.com
- Kênh YouTube a16z (Sarah Wang, khách mời Mark Chen và John Schulman): youtube.com/channel/UC9cn0TuPq4dnbTY-CBsm8XA youtube.com
- "II. From AGI to Superintelligence: the Intelligence Explosion" trên Situational Awareness, một trong các nguồn biểu đồ video liệt kê (đọc ngày 17/11/2026): situational-awareness.ai/from-agi-to-superintelligence situational-awareness.ai
- METR, "Independent Assessment of AI R&D Acceleration at Anthropic in October 2026", ngày 5/11/2026 (đọc ngày 17/11/2026): metr.org/blog/2026-11-05-anthropic-ai-rd-acceleration-assessment metr.org
- "Automated Researchers Can Reliably Mitigate Alignment Failures" (Anthropic Fellows Program, Anthropic, UC Berkeley), bản PDF có phần Abstract hiện trong video (đọc ngày 17/11/2026): assets.claude.com (PDF) assets.claude.com
Related talks
GPT-6 Astra: benchmark ấn tượng và nỗi lo monitorability ở OpenAI
AI Explained · AI Explained · 29 min
Phân tích GPT-6 Astra (9/2026): benchmark khó, ARC-AGI-3, FrontierMath, trading, và system card về chain of thought khó giám sát, sandbagging.
Tin AI tuần: giới AI đang thật sự lo sợ
Matt Wolfe · Matt Wolfe · 36 min
Bản tin AI của Matt Wolfe ngày 11/09/2026: ChatGPT Images 2.5, agent Muse của Meta, DeepSeek V4.1 Flash, các cảnh báo về rủi ro AI và sự kiện Apple.
20 khái niệm nền tảng để build AI agent production, kèm code
Maryam Miradi · Dr. Maryam Miradi · 26 min
20 khái niệm AI agent qua năm layer: agent loop, planning, memory, sandbox, tool retrieval, multi-agent, guardrails, eval, prompt injection, tracing, mỗi cái kèm code.