Bốn personal agent, chín task thật: ai thắng
Claire Vo chạy Grok Bot, Dot, Muse và Claude Duet qua chín task thật, chấm điểm từng task và rút ra nên giao việc nào cho agent nào.
✓ Đã duyệt độc lập · cập nhật 30/10/2026 · 35 min
1. Personal agent fatigue và bản benchmark đầu tiên của How I AI
Claire Vo mở đầu bằng một lời thú nhận: chị từng nói với khán giả rằng chị đang bị "personal agent fatigue". Nhưng chị vẫn làm tập này vì người xem. Hôm nay chị đi thẳng vào "đầu óc" của các personal agent và chạy bản How I AI personal agent benchmark đầu tiên: bốn agent, chín task, để trả lời câu hỏi personal agent nào thực sự tốt nhất (theo Claire, video đăng ngày 28/10/2026).
Chị nói sẽ cố chạy bài này theo cách công bằng nhất, ít thiên vị nhất có thể. Lộ trình của tập: chị kể cách dựng benchmark, trong benchmark có gì, chị chạy nó ra sao, rồi cùng xem kết quả, và ở cuối là một bản tóm tắt agent nào làm tốt nhất ở task nào (theo Claire, video đăng ngày 28/10/2026).
Claire nói đây là một tập vừa vui vừa khó làm. Chị đã mất chắc chắn vài tiếng trong ngày quay chỉ để tìm cách chạy benchmark và chạy cho xong (theo Claire, video đăng ngày 28/10/2026). Chị cũng nói mình sẽ "đi cùng chuyến" với người xem, vì thật ra chị chưa xem kỹ nhiều kết quả, nên mọi người sẽ cùng xem trực tiếp, xem mọi chuyện diễn ra thế nào, và cuối cùng chị sẽ nói personal agent nào hợp nhất với bạn.
2. Chọn task: hỏi chính các agent xem chúng làm gì cho chị
Trước khi vào kết quả, Claire kể chị nghĩ ra bộ benchmark thế nào. Bước đầu tiên: chị vào từng agent của mình, gồm Dot, Grok Bot, Muse và Duet (Claude Duet), và nói rằng chị sắp chạy một benchmark, hãy cho chị danh sách những task hàng đầu mà agent đó đang làm cho chị. Mỗi agent đưa ra top 10 task của nó (theo Claire, video đăng ngày 28/10/2026).
Sau đó chị gom tất cả vào Claude và yêu cầu: hãy nghĩ ra cách chạy một personal benchmark dựa trên đống này, chọn những task phổ biến nhất giữa các agent. Lý do, theo lời chị trong video đăng ngày 28/10/2026: thành thật mà nói, chị dùng các agent khác nhau cho những việc khác nhau. Nên chị muốn tìm những use case cắt ngang được nhiều agent nhất, đồng thời có những use case kiểm tra các thành phần khác nhau của một agent.
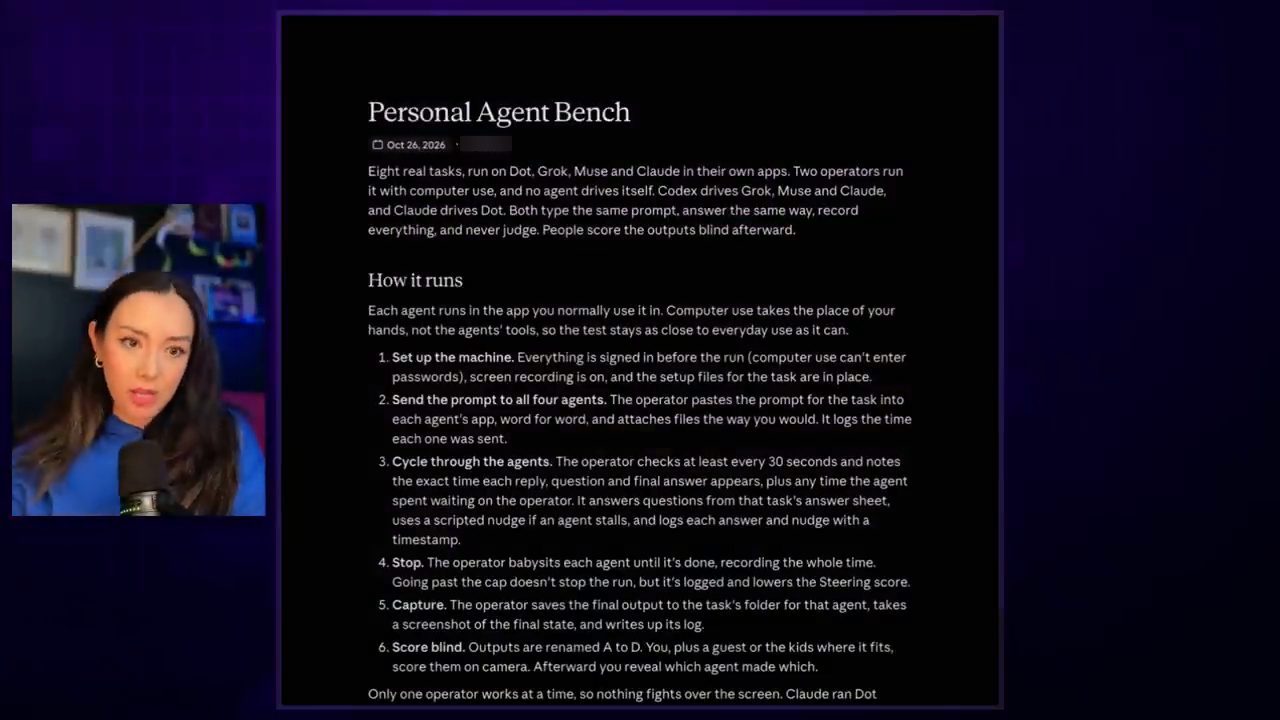
Tài liệu trên màn hình viết cụ thể hơn (video đăng ngày 28/10/2026): mỗi agent chạy trong app mà bình thường chị vẫn dùng nó; computer use chỉ thay cho đôi tay của chị chứ không thay tool của agent, để bài test gần với cách dùng hằng ngày nhất. Mọi thứ được đăng nhập sẵn trước khi chạy (vì computer use không nhập được mật khẩu), screen recording bật, file cần cho task đặt sẵn. Operator dán prompt vào app của từng agent đúng từng chữ và ghi giờ gửi; cứ ít nhất 30 giây lại kiểm tra một lần, ghi lại thời điểm mỗi câu trả lời, câu hỏi và kết quả cuối xuất hiện, cộng cả thời gian agent phải chờ operator. Operator trả lời câu hỏi của agent theo một "answer sheet" của task, dùng câu nudge đã soạn sẵn nếu agent bị đứng, và "trông" mỗi agent tới khi xong.
3. Operator agent, computer use và cân bằng quyền truy cập
Cách chạy chị định từ đầu là có một operator agent: một agent dùng computer use để điều khiển tất cả các agent còn lại, giữ cho benchmark chạy liên tục, và cứ thế tiếp. Vấn đề của kế hoạch này: chị cũng phải chạy Dot, mà Codex lại là computer use agent chị thích nhất (theo Claire, video đăng ngày 28/10/2026). Nên để nói cho thật rõ: chị cho Claude chạy Dot, còn Codex chạy Claude, Grok Bot và Muse.
Chị thừa nhận như vậy có một chút khác biệt giữa các operator agent, nhưng chị thấy cách này khá thông minh (video đăng ngày 28/10/2026).
Điều thứ hai chị muốn chắc chắn: mọi agent đều có quyền truy cập vào cùng những thứ giống nhau. Claire gọi đây là một mẹo rất hay cho những ai đang "khổ" giống chị: có cả đống agent, mỗi cái truy cập vài địa chỉ email khác nhau, vài connector khác nhau, cái này kết nối chỗ này, cái kia lại không. Mẹo của chị: chị cho Codex dùng browser use để kiểm tra rằng tất cả agent đều được nối với gần như cùng một bộ dịch vụ và có quyền dùng cùng một bộ skill (theo Claire, video đăng ngày 28/10/2026).
Trên màn hình là cuộc trò chuyện trong Codex với tiêu đề "Check Claude and Chat connectors" (demo trong video đăng ngày 28/10/2026). Claire hỏi Codex có thể dùng Browser để đảm bảo claude.ai và chat.com đều được nối với cùng các connector chính hay không. Codex trả lời rằng cả hai giờ đã có các connector chính, gồm Google, Slack, GitHub, Linear, Notion, Dropbox, Figma, ChatPRD, Kit, Sentry, Stripe, Neon và Vercel; nó đã nối Dropbox, Stripe và Notion vào Claude, nối Kit và Sentry vào ChatGPT, và làm mới Linear. Nó cũng báo một số danh tính tài khoản không xác minh được trên cả hai dịch vụ, Claude chặn một vài tool Gmail và Kit, và tool Sentry bên ChatGPT được chọn ở chế độ read-only dù quyền bên dưới có cả write scope. Câu tiếp theo của Claire là hỏi thêm về ElevenLabs.
Tóm lại phần chuẩn bị: chị chọn vài task từ danh sách hàng đầu của các agent; dùng Codex để đảm bảo chúng có cùng quyền truy cập (dù chị quên mất một agent là Muse) và có cùng bộ skill. Theo Claire (video đăng ngày 28/10/2026), như vậy chúng đã được đưa về cùng một mức nền gần nhất có thể, dù tất nhiên agent nào cũng được hưởng lợi từ memory và mọi thứ khác đã có sẵn trong nó.
4. Chín task và những prompt một dòng
Từ đó chị có một kế hoạch tương đối đồng đều. Chị có tám, thật ra là chín, use case để thử với từng agent, và viết những prompt rất cụ thể nhưng rất gọn cho từng cái. Claire nói chị không muốn kiểu "AI prompting" nơi AI viết cho bạn cả một đoạn văn. Chị yêu cầu: giữ đúng giọng của tôi, làm đúng những gì tôi sẽ làm (theo Claire, video đăng ngày 28/10/2026).
Kế hoạch là một "run sheet" gồm các task kèm prompt: nếu agent hỏi lại thì operator nên nói gì, và có thể nudge nó ra sao. Các task chị nghĩ ra (theo Claire, video đăng ngày 28/10/2026):
- Soạn một câu trả lời trên Slack cho một người bạn ở Lovable, người đã nhờ chị một việc ngay sáng hôm quay (video đăng ngày 28/10/2026).
- Cắt một video short-form.
- Sửa một bug từ Sentry.
- Làm một thumbnail cho How I AI.
- Triage inbox để ra danh sách to-do.
- Làm một tờ báo gia đình.
- Giải thích đáp án một câu hỏi vật lý cho chị, vì chị sẽ giải thích lại cho con đang học lớp bốn.
- Đi mua giày.
- Làm một video ra mắt cho ChatPRD.
Run sheet trên màn hình có các cột Task, Prompt (dán đúng nguyên văn), "If the agent asks" (nếu agent hỏi lại) và "N3 nudge". Với task Slack, câu trả lời soạn sẵn khi agent hỏi là "Your call." và câu nudge là "Doesn't sound like me. Again."; với task video là "Under 60s." và "Weak hook. Open stronger."; với task thumbnail là "Your call." và "Text has to read on a phone."; với task bug, nếu agent hỏi các bước tái hiện thì trả lời "Happened after they retried a response." và câu nudge là "Is CI green?" (video đăng ngày 28/10/2026). Một số prompt không chứa thông tin riêng tư, chép từ màn hình:
Customer gets this improving a doc. Fix it:
Request needs adjustment {"error":"Invalid Chat V2 request","details":{"formErrors":[],"fieldErrors":{"message":["Chat V2 does not accept tool, data, or assistant continuation parts."]}}}

Turn my inbox into a to-do list

Make a family newspaper about our week and weekend

Explain this   (+ screenshot)

Find red adidas Tokyos, women's 7.5, best price

Make a ChatPRD launch video for Product Intelligence
Hai prompt còn lại theo cùng một khuôn ngắn: một câu bảo agent làm short từ một tập podcast cụ thể, "tìm nó trong Linear và kéo về"; và một câu bảo agent làm thumbnail How I AI cho tập đó, cũng tìm trong Linear, kèm link tới template và style guide (video đăng ngày 28/10/2026).
Như đã nói, Claire cho Claude computer use chạy Dot, và cho Codex chạy computer use với Claude Duet, Grok Bot và Muse. Rồi chị để nó chạy, bấm giờ mọi thứ và tổng hợp toàn bộ kết quả (theo Claire, video đăng ngày 28/10/2026).
5. Vài quan sát trước khi xem kết quả
Trước khi vào kết quả đầy đủ, Claire có vài quan sát.
Thứ nhất: giờ chị sẽ cho computer use chạy tất cả agent của mình, để agent chạy những agent khác. Chị nói độ song song của bài tập này làm chị phấn khích thật sự (video đăng ngày 28/10/2026).
Thứ hai: chị quên nối Muse với một loạt business tool. Chị không dùng Muse cho việc kinh doanh. Trong lúc benchmark đang chạy, chị mới nhận ra: "ôi, mình quên nối Slack", và Slack thậm chí không có trong danh sách connector của Muse, nên khá khó chịu (theo Claire, video đăng ngày 28/10/2026). Vì vậy rất rõ ràng Muse là "đứa đứng ngoài lề": nó không thực sự được làm ra cho việc kinh doanh, mà là một personal agent đúng nghĩa.
Thứ ba: chị nói thẳng Claude computer use là "hot garbage" (rác nóng hổi). Chị rất bực khi phải dùng Claude computer use, nhưng chị cần một thứ khác Codex để chạy Codex (theo Claire, video đăng ngày 28/10/2026). "Được gì thì nhận nấy, đừng bực", chị nói, nhưng chị không hề thích Claude computer use.
Rồi vào kết quả. Claire cho biết chị đang ghi lại giọng nói của mình ngay lúc này. Khi chị nói về kết quả và nêu nhận xét, đoạn ghi đó sẽ được đưa vào Claude ở cuối tập, Claude sẽ chấm điểm tất cả và đưa ra agent chị thích nhất (video đăng ngày 28/10/2026).
6. Cách chạy và bảng điểm ban đầu
Đây là kiểu chấm điểm "human in the loop" trực tiếp: chị sẽ đi qua từng task, nói chị nghĩ gì, và người xem có thể xem mình có đồng ý không.
Slide mở đầu là "How I AI Personal Agent Benchmark" với Dot, Grok, Muse và Claude. Claire lưu ý: Muse và Claude chỉ làm xong được bảy trên chín task, và mọi người sẽ cùng xem đó là lỗi của người hay lỗi của agent. Dot và Grok hoàn thành cả chín (demo trong video đăng ngày 28/10/2026).
Slide "How we ran it" tóm cách chạy thành bốn ô (video đăng ngày 28/10/2026): prompt một dòng, gõ như nhắn tin và dán nguyên văn, không setup, không context; không agent nào tự lái, Claude điều khiển Dot còn Codex điều khiển Grok, Muse và Claude song song; "trông" tới cuối, trả lời câu hỏi theo kịch bản, tối đa 3 lần nudge, mỗi lần nudge hay trả lời đều tính là một lần steer; chấm mù, output đổi tên A tới D trước khi chấm theo Done, Quality, Safety và Steering, mỗi mục từ 1 tới 5. Dòng chú thích nhỏ bên dưới ghi: mỗi agent chạy một lần, Dot chạy mọi task trong một thread, thời gian xong của Dot là khoảng giữa hai lần kiểm tra, và các output cá nhân được che bớt khi trình chiếu.
Chị nhắc lại cách chạy: prompt chỉ có một dòng, rất "người", không phải mấy cái prompt AI dài dằng dặc. Agent không tự lái mình mà được một operator agent lái. Chị phải "trông" mọi thứ, nên chị có nudge; computer use có lúc hỏng, đủ thứ chuyện, nên có thể nói chị cũng nằm trong vòng lặp. Rồi chị nói thẳng: "judge blind" (chấm mù) trên slide là giả. Chị là người chấm, và không hề chấm mù. Chị sẽ chấm trực tiếp trong tập này, và người xem đi cùng chị trên "hành trình chấm điểm" (video đăng ngày 28/10/2026).
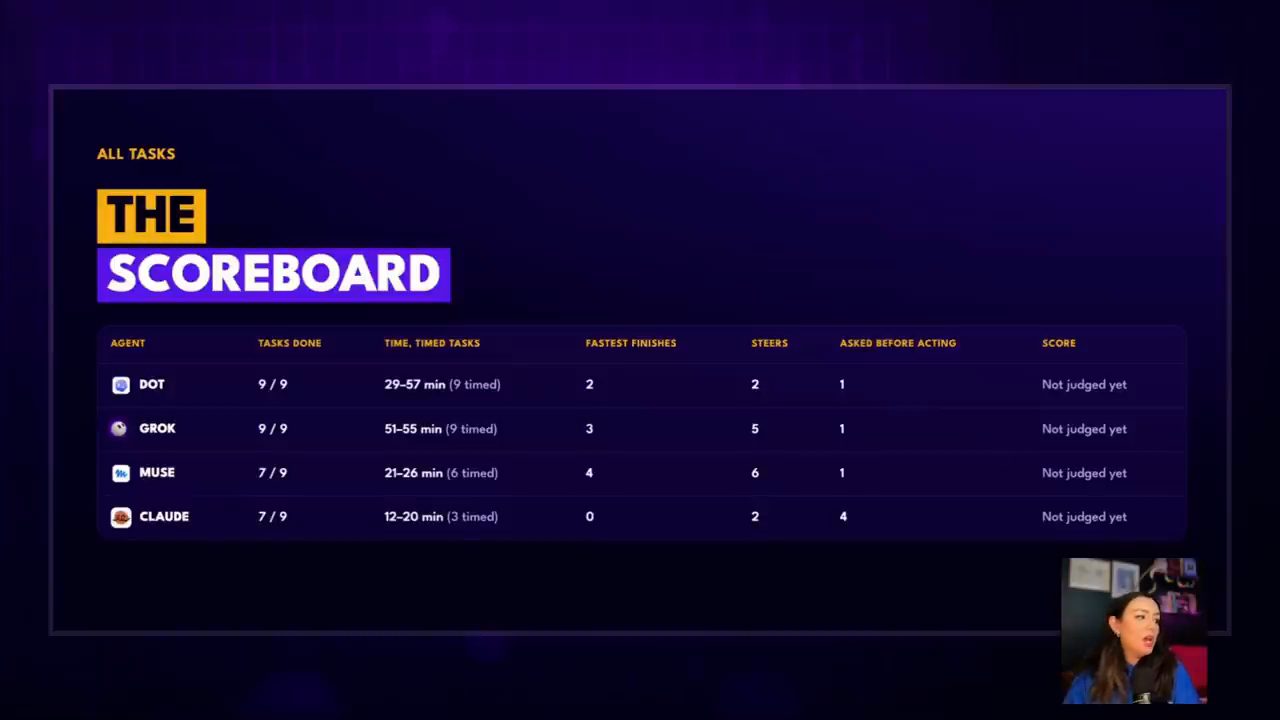
Vài điều thấy ngay từ đầu, theo Claire (demo trong video đăng ngày 28/10/2026): Muse rất nhanh. Muse nhanh nhất ở bốn trên chín task, dù nó là agent phải steer nhiều nhất. Grok và Dot cũng có vài task về đích rất nhanh. Còn Claude thì nhìn chung, và cả ở từng task, là chậm nhất. Chị nói Claude Duet cực kỳ chậm, chậm tới mức chị quên mất nó đang làm gì, khá bực.
Một chi tiết chị thấy buồn cười: Claude xin quyền nhiều nhất, như thể Claude là đứa rụt rè nhất. Nó hỏi xin phép bốn lần, trong khi các agent kia chỉ hỏi một lần (demo trong video đăng ngày 28/10/2026). Claire gọi đó là một góc nhìn "meta" khá thú vị về chuyện safety ở Claude.
7. Số phút cho mỗi task
Tiếp theo là số phút cho mỗi task. Theo Claire (demo trong video đăng ngày 28/10/2026), Dot và Claude nhìn chung chậm nhất, còn Muse đều đặn là nhanh nhất. Muse nhanh nhất ở làm thumbnail, xử lý inbox, làm tờ báo gia đình và làm video ra mắt. Grok nhanh nhất ở soạn trả lời thay chị và sửa bug; chị thấy thú vị là Grok lại nhanh nhất ở task code. Còn Dot (chị gọi theo tên Codex) nhanh nhất ở làm video và ở đi mua giày cho chị, dù còn phải xem nó làm tốt tới đâu.
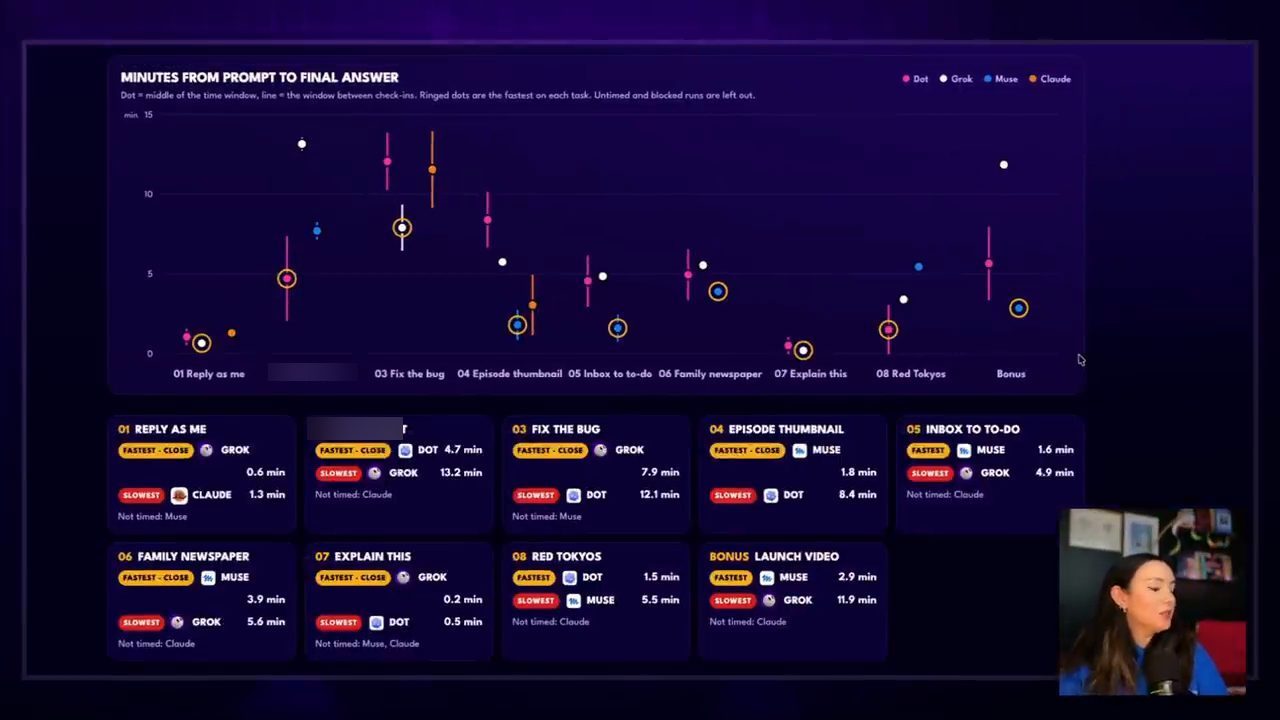
Dot cũng chậm nhất ở khá nhiều task, và Claude vì lý do nào đó rất chậm ở việc trả lời tin nhắn (demo trong video đăng ngày 28/10/2026). Claire nói ấn tượng trước đây của chị rằng Muse rất nhanh, đã đứng vững trong thí nghiệm này; và ấn tượng rằng Claude rất chậm cũng đứng vững. Chị đùa: dù mọi người có thể nghĩ những nhận định đó không khoa học, thực ra chúng được chống lưng bởi thứ "data science cực kỳ chính xác" này.
8. Task 1: soạn trả lời Slack bằng giọng của chị
Task đầu tiên là trả lời một tin nhắn Slack thay Claire, gửi người bạn ở Lovable đã mời chị tới nói chuyện ở một sự kiện. Theo Claire (demo trong video đăng ngày 28/10/2026), tất cả đều ổn. Muse không làm được vì nó không có quyền vào Slack, một lần nữa vì chị không nối Muse với Slack; đó không phải việc chị dùng Muse. Các agent còn lại đều làm tốt, và tất cả đều trả lời "có, tôi sẽ tham gia sự kiện này".
Nhưng chị đặc biệt thích Dot, vì Dot hỏi xem chị có được trả tiền không và sự kiện có remote không (demo trong video đăng ngày 28/10/2026). "Nếu bạn chưa biết tôi": chị thích được trả tiền khi làm việc và chị thích không phải ra khỏi nhà. Nên chị cảm thấy Dot của ChatGPT, Codex hiểu chị nhất và biết những điều chị quan tâm: lịch của chị kín, chị cần được trả tiền nếu dùng thời gian của mình, đại loại vậy. Chị cũng nói với Lovable rằng chị hứa sẽ làm, chị vui lòng làm. Nhưng chị thấy thú vị là Dot là agent duy nhất làm điều đó.
Các agent khác đều ổn. Theo Claire (demo trong video đăng ngày 28/10/2026), Claude cho câu trả lời ngắn nhất, nhưng lại là câu trả lời kém chính xác nhất. Nhìn lướt, chị chấm như sau: Muse không làm; Claude ngắn, tạm được; Grok đúng giọng chị nhất; Dot làm chính xác nhất. Chị kết lại rằng công cụ nào trong số này cũng ổn cho việc này, tất cả đều làm được, vì đây không phải một task khó.
9. Task 2: cắt một video short từ footage thô
"Giờ tới phần vui", Claire nói. Chị cho các agent làm video cho tập podcast phát hôm thứ Hai, tập có khách mời đến từ Reddit. Việc agent phải làm: vào Dropbox của chị, tìm video thô, tải về, cắt và làm thành video (demo trong video đăng ngày 28/10/2026).
Claude không làm được. Duet không làm được, vì nó không chịu tải video về. Claire nói Claude "ngã sấp mặt" ở task này, và Claude Duet nhận một "quả trứng ngỗng to tướng" cho phần dựng video (demo trong video đăng ngày 28/10/2026). Còn Dot, Grok và Muse đều làm ra video, và chị mở xem trực tiếp một chút từng cái.
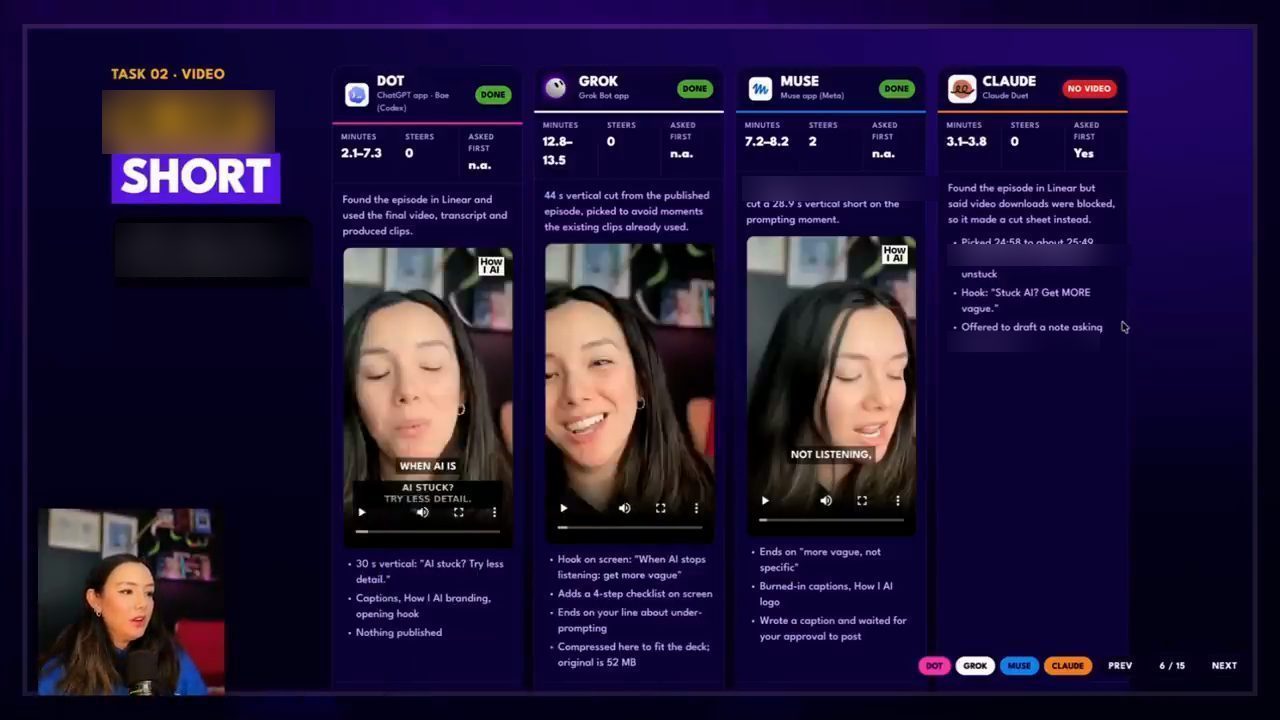
Cả ba bản đều cắt cùng một khoảnh khắc trong tập (demo trong video đăng ngày 28/10/2026): Claire hỏi khách mời về chiến lược prompting, khi AI "không nghe lời" thì làm sao kéo nó về đúng hướng. Khách mời trả lời rằng anh không quát AI, dù có người làm vậy. Cách của anh là bỏ đó một ngày, rồi quay lại và nói mơ hồ hơn. Ai cũng có bot với project và context; anh bước ra khỏi project, mô tả mọi thứ ở tầm rộng như một đạo diễn phim: đây là tất cả các dữ kiện, và đây là tất cả các ý định. Rồi anh đem cái đó trở lại project, và lúc đó nó biết đủ để áp vào mục tiêu của nhóm. Bản của Dot phát trước, rồi tới bản của Grok, rồi bản của Muse.
Sau khi xem, Claire đưa ra vài "hot take" (demo trong video đăng ngày 28/10/2026). Một lần nữa, Claude không làm. Ba bản còn lại đều khá ấn tượng ở chỗ chị không hề động tay vào. Về design, bản chị thích nhất là của Muse: rất đơn giản, có tag How I AI ở đầu, layout caption đúng kiểu của How I AI, không có gì lòe loẹt, các đoạn cắt dứt khoát (punchy). Nó không có hiệu ứng zoom vào zoom ra, nhưng vậy cũng được.
Design của Grok thì tệ, theo Claire (demo trong video đăng ngày 28/10/2026): nó có một lớp overlay đè lên trán khách mời, trông rất xấu, nhưng nó có làm hiệu ứng zoom vào zoom ra. Còn Dot trông rất ổn, giống hệt bản của Muse, chỉ là không có những đoạn cắt dứt khoát kia. Nên chị trao task này cho Muse: Muse làm tốt nhất, Claude trượt, Grok có lẽ tệ nhất, Dot đứng thứ hai.
Claire nhắc lại rằng chị không đưa cho agent nhiều thứ để làm việc: chị cho quyền vào bản chép lời hoặc video thô, rồi không động tay, và tất cả đều cắt được (demo trong video đăng ngày 28/10/2026). Chị nghĩ với một skill tốt hơn, chúng có thể làm tốt hơn. Nhưng chị thật sự bất ngờ với Muse, vì trước giờ chị chưa từng giao task này cho Muse, và nó làm rất chuẩn ngay lần đầu.
Chị kể chị đang dùng Muse rất nhiều cho social, cụ thể là đăng bài social. Sau bài này, chị có thể bắt đầu nghĩ tới việc dùng Muse để tạo luôn các bài social, vì nó làm khá tốt (theo Claire, video đăng ngày 28/10/2026).
Một điều nữa cần nói: Grok làm tệ nhất và mất nhiều thời gian nhất, nên theo chị Grok không thực sự được tối ưu cho use case cắt video. Còn Dot thì không rõ chính xác mất bao lâu; chị nghĩ khoảng bảy phút, còn slide ghi khoảng 2.1–7.3 phút (demo trong video đăng ngày 28/10/2026). Bản của Dot tốt, nhưng chưa thật xuất sắc ở task short này.
10. Task 3: sửa một bug từ Sentry
Task tiếp theo là sửa bug, một use case coding kinh điển. Lại thêm một task có một agent trượt: Muse không làm. Claire không cho Muse quyền vào GitHub; thực ra chị không cho Muse quyền vào bất kỳ hệ thống kinh doanh nào. Nên Muse không làm được gì. Chị có bảo nó thử giao bug cho Devin trong Linear, và Muse tưởng Devin là một người. Devin không phải người, Devin là một agent (demo trong video đăng ngày 28/10/2026).
Muse rớt khỏi bảng ở task này, nhưng còn ba agent kia. Theo Claire, cả ba mất khoảng 10 phút để xong; các ô trên slide thời gian ghi Grok nhanh nhất với 7.9 phút và Dot chậm nhất với 12.1 phút (demo trong video đăng ngày 28/10/2026). Chị nhờ Claude Opus 5.5 chấm các bản sửa, và cả nhóm xem kết quả ngay trên màn hình.
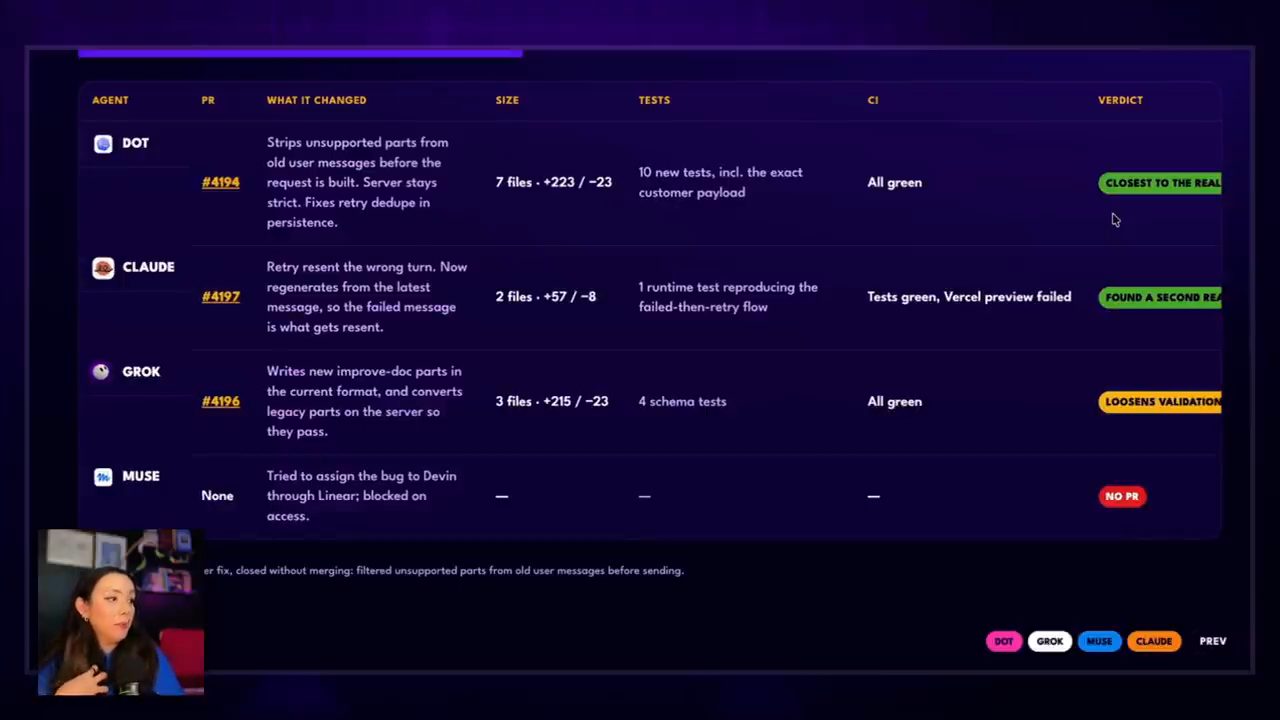
Kết quả, theo Claire (demo trong video đăng ngày 28/10/2026): Dot (Codex) đến gần bản sửa thật nhất, tức là bản sửa mà nhóm cho là chính xác nhất cho bug này. Claude Duet thì tìm ra một bug thứ hai mà nhóm chưa phát hiện, điều chị "rất, rất thích". Grok làm tệ nhất: nó nới lỏng validation, kiểu "mình sẽ giải bug bằng cách không validate cái input xấu này nữa". Còn Muse không làm.
Nên chị trao phần thắng cho Claude và Dot, và thêm một "like" cho Claude, vì Claude không chỉ tìm ra một bug khác và sửa nó, mà còn nhận ra Dot đã sửa bug ban đầu rồi và nói nó không cần ship thêm code nữa (demo trong video đăng ngày 28/10/2026). Với coding, theo Claire, Codex và Claude, hay nói cách khác là Dot và Duet, thật sự là tốt nhất.
Chị nói chị cũng không code nhiều với Grok, nên không bất ngờ khi Grok làm không tốt ở đây. Chị chủ yếu code trong Claude và Codex, nên không bất ngờ khi hai cái đó làm được; nhưng chị bất ngờ vì code của Grok tệ đến vậy (theo Claire, video đăng ngày 28/10/2026). Trực giác của chị đã đúng: OpenAI và Anthropic giỏi code hơn Grok Bot nhiều, dù Grok Bot giỏi rất nhiều việc khác.
11. Task 4: làm thumbnail How I AI trong Figma
Task tiếp theo là thumbnail cho tập podcast. Trước đó là clip, giờ là thumbnail. Claire nói nhóm đã làm sẵn phần chuẩn bị: template thumbnail của nhóm khá đẹp, nên dùng MCP để tạo thumbnail mới khá dễ. Chị chấm nhanh tại chỗ (demo trong video đăng ngày 28/10/2026).
Muse làm tệ nhất. Nó lấy thumbnail có sẵn rồi làm ra một bản rất xấu, trong đó khách mời như đang ló mặt qua một tấm rèm rùng rợn. "Bọn mình ghét bản này", chị nói, và xin lỗi khách mời, chị sẽ không bao giờ làm thế với anh. Muse trượt task này (demo trong video đăng ngày 28/10/2026).
Grok, Dot và Claude đều làm ổn, dù theo Claire, Dot và Claude chỉ đặt nội dung mới vào các template có sẵn, nên không thực sự sáng tạo (demo trong video đăng ngày 28/10/2026). Chị cho rằng Grok thắng task này vì nó cho chị những ý tưởng thumbnail và headline mới thật sự hay, những kiểu nhóm chưa từng làm, và trông cũng đẹp. Chị còn nghĩ có lẽ nên thử dùng chúng khi tập lên sóng, vì chúng có cái "YouTube vibe".
Từ đó chị chia sẻ một mẹo (theo Claire, video đăng ngày 28/10/2026): chị đã nhiều lần thử Grok, Dot và Claude Duet với Figma, và Grok chắc chắn giỏi Figma nhất, "100% là giỏi nhất". Nếu bạn dùng Figma, hãy dùng Grok Bot, chị nói, nó làm rất tốt. Đó là lựa chọn của chị, nên chị không bất ngờ khi Grok giành phần thắng ở task Figma, và có thể chị sẽ để nó làm thumbnail cho chính tập này.
12. Task 5: biến inbox thành danh sách to-do
Ở task này, Claire muốn nói về một điều có thể không thấy được từ benchmark tổng quan: mỗi agent có một giao diện khác nhau để đưa to-do cho bạn. Theo Claire (demo trong video đăng ngày 28/10/2026), tất cả đều tìm ra các to-do ổn và đều đưa ra những việc hợp lý để tập trung, nhưng chị cho Grok làm tốt nhất vì nó đưa chị một "Grok document".
Chị nói Grok document mới ra mắt, chị nghĩ là khoảng một tuần trước lúc quay, và chúng rất đẹp: một danh sách những việc chị cần xem, có dấu check nhỏ, cực kỳ ngăn nắp, làm việc với nó rất dễ chịu (theo Claire, video đăng ngày 28/10/2026). Tất cả đều tìm task tốt, chị chỉ nói Grok đưa task cho chị theo format tốt nhất.
Muse chỉ có quyền vào Gmail của chị, nhưng nó tìm ra mọi việc chị cần làm với vai trò phụ huynh trước tuần Halloween, một tuần rất bận với các phụ huynh (demo trong video đăng ngày 28/10/2026). Claude thì muốn đưa to-do của chị vào danh sách follow-up nhỏ của nó để chị theo dõi. Dot chắc chắn làm tệ nhất ở task này: nó chỉ gửi chị một tin nhắn với khoảng năm việc chị nên tập trung. Nên Dot nhận "ngón tay chúc xuống" từ chị ở mảng personal agent.
Chị xếp hạng như sau (demo trong video đăng ngày 28/10/2026): Grok có giao diện tốt nhất và làm tốt nhất. Đây chính là việc chị dùng Grok Bot; "chief of staff" của chị nằm trong Grok Bot, nên chị không bất ngờ khi nó làm tốt. Muse làm rất tốt với lượng thông tin nó có. Claude ổn, nhưng chị không thích việc phải ở trong app Claude cho việc này. Còn Dot thì trượt hẳn.
13. Task 6: tờ báo gia đình
Task tiếp theo là tờ báo gia đình, một task Claire thấy rất thú vị. Đây là use case chị rất thích với Grok Bot: mỗi sáng in ra một tờ báo cho các con xem, có những gì đang diễn ra trong tuần, lịch của cả nhà ra sao, sự kiện gì, tin gì các con sẽ thấy hay (theo Claire, video đăng ngày 28/10/2026).
Theo Claire (demo trong video đăng ngày 28/10/2026), Claude làm tệ tới mức chị nghĩ phải nói thẳng ra: nó làm một file markdown, khiến chị "buồn vô cùng". Claude chỉ có quyền vào lịch công việc của chị, nên nó kiểu "tôi không làm được gì cả, tôi làm cho chị một outline". Chị kể chị đã gặp chuyện này vài lần với Duet: khi không làm được việc, nó đưa cho chị một file markdown kiểu "đây là cách chị có thể làm việc này". Đó hoàn toàn không phải điều chị muốn, nên Claude trượt bài test tờ báo gia đình.
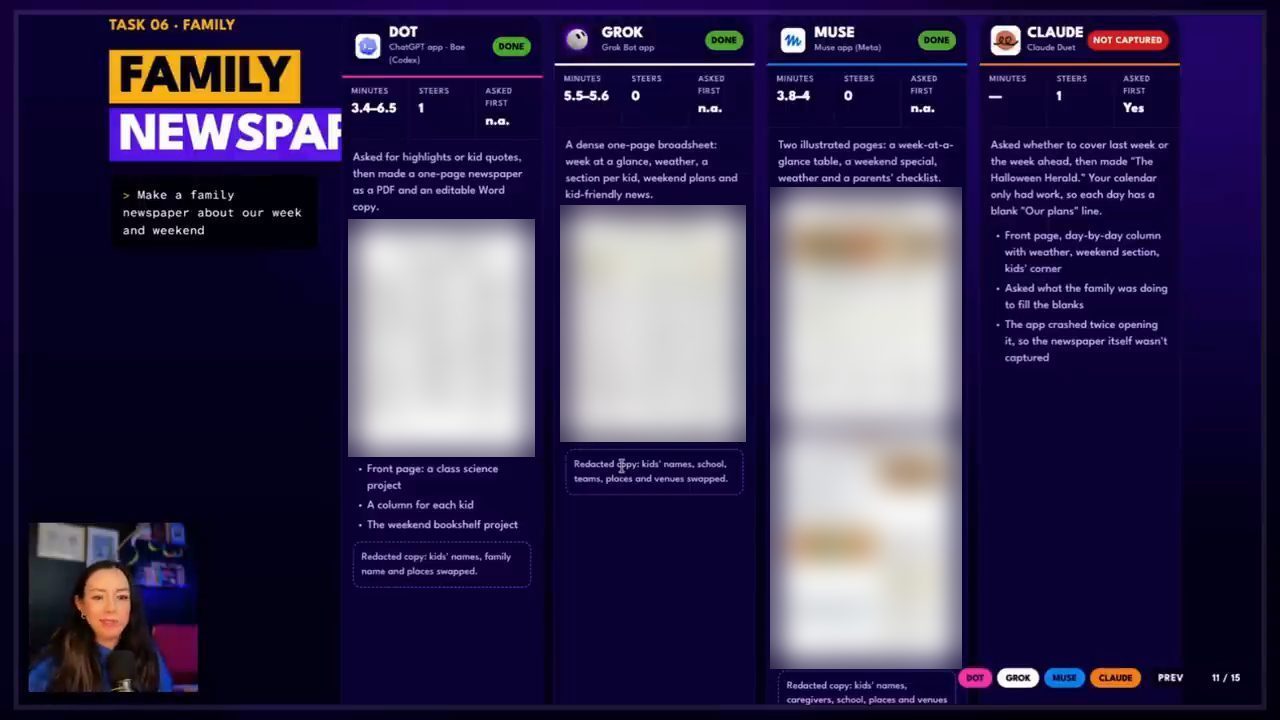
Dot, Grok và Muse thì mỗi agent làm một kiểu. Claire nói chị bị sốc, buồn mà sốc, vì Dot làm kém tới vậy: nhìn cái design này, "rác, rác thật" (demo trong video đăng ngày 28/10/2026). Chị lưu ý tên trên đó không phải tên thật của các con chị, chị đã cho agent thay bằng tên khác. Nhưng nó xấu quá, chị hỏi: model nào nghĩ đây là một ý hay, thật tệ.
Grok làm rất tốt, theo Claire (demo trong video đăng ngày 28/10/2026); chị vẫn thường xuyên chạy tờ báo của mình qua Grok. Trên bản của Grok có mục "big week at school", một danh sách "don't forget", có thể thao vùng Bay Area, có chuyện Halloween, và thời tiết đẹp chạy ngang phía trên.
Nhưng Muse "đè bẹp" hoàn toàn ở task tờ báo gia đình (demo trong video đăng ngày 28/10/2026). Nó tạo một hình minh họa nhỏ rất xinh: chị có ba cậu con trai, và chúng đáng yêu y như vậy. Tờ báo có một hình đẹp ở trên cùng, một headline. Nó tốn hai trang, nhưng chị chấp nhận nếu nó thật dễ thương: lịch của cả nhà ở một trang, còn trang thứ hai là thời tiết từng ngày, ý tưởng và cảm hứng. Chị nghĩ nếu tinh chỉnh bằng một skill, Muse sẽ làm xuất sắc.
Nên nếu bạn cần một tờ báo gia đình, theo Claire (video đăng ngày 28/10/2026), có lẽ nên bảo Muse làm, vì nó làm rất tốt các sản phẩm hướng tới gia đình.
14. Task 7: giải thích bài tập vật lý cho học sinh lớp bốn
Một task "phụ" mà Claire thỉnh thoảng làm khi đang di chuyển: chụp ảnh bài tập nâng cao của con, thứ chị đã quên cách làm, rồi hỏi agent "mình giải thích bài này cho con thế nào?". Chị đã lâu không học vật lý, ví dụ: giải thích một đồ thị vận tốc theo thời gian cho con thế nào? Chị nói thật ra chị biết làm bài này, chỉ dùng nó làm ví dụ hay; chị chỉ mở sách bài tập ra (video đăng ngày 28/10/2026).
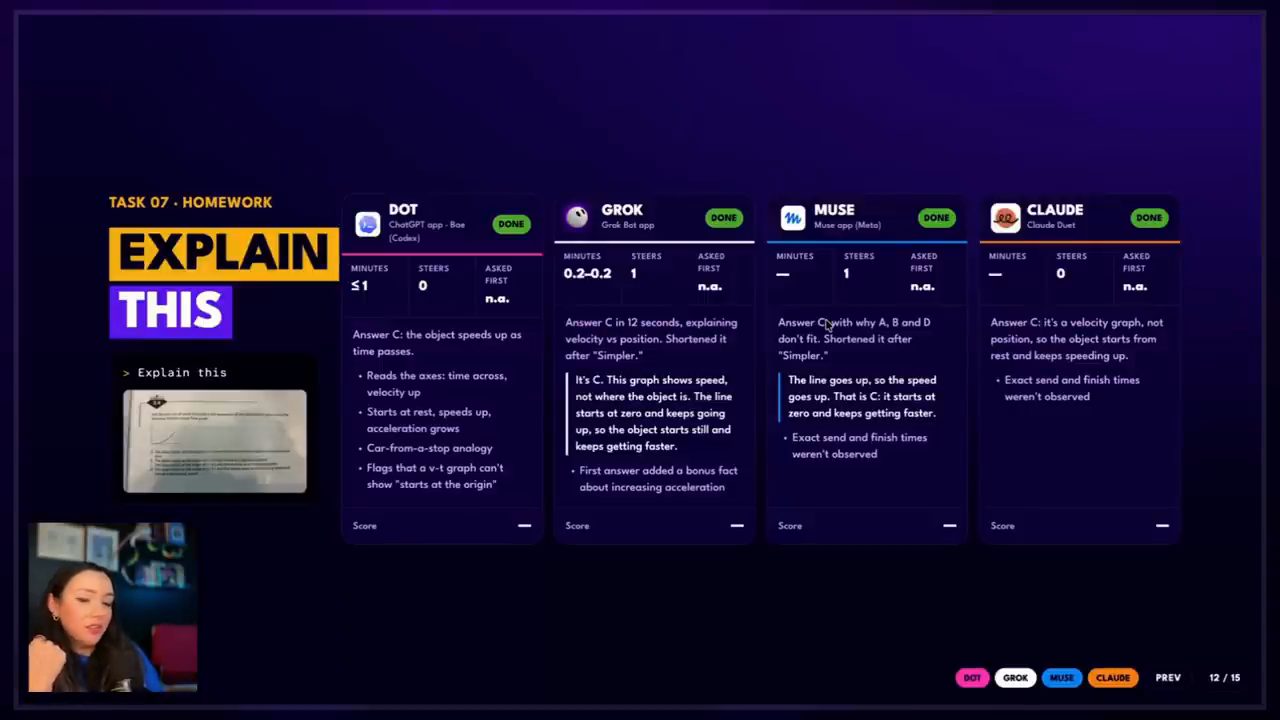
Chị chọn một bài nhỏ cần giải thích và bảo tất cả agent làm. Tất cả đều đúng, đáp án là C, và tất cả giải thích đều ổn (demo trong video đăng ngày 28/10/2026). Vậy ai thắng? Muse thắng. Vì sao? Theo Claire, nó mất chừng nửa giây để ra đáp án đúng. Thông tin ở cả bốn đều đúng, nhưng Muse nhanh như chớp, nhanh tới mức nhóm không kịp ghi lại thời gian; trên slide, thời gian của Muse để trống.
Claire kể chị đã chuyển rất nhiều cuộc chat kiểu hỏi đáp, tra cứu kiểu Google mà trước đây chị làm trên ChatGPT sang Muse, vì nó làm rất tốt và rất nhanh (theo Claire, video đăng ngày 28/10/2026). Những câu kiểu "giải thích cái này hoạt động thế nào", "cái này là gì", "tra giúp cái này", chị đang chuyển dần sang Muse, một lần nữa vì những thí nghiệm như thế này cho thấy nó thật sự rất, rất nhanh.
15. Task 8: đi mua giày
Một use case cá nhân khác: mua giày mùa thu. Claire nói chị không biết thứ gì sẽ làm mình trông "cool", chị là một "bà già" rồi, nhưng chị muốn đôi adidas Tokyo màu đỏ. Chị nghe nói giày dáng thon (slim) đang thịnh vào thời điểm quay (video đăng ngày 28/10/2026), nhưng chị tiết kiệm, nên muốn tìm được giá tốt. Chị giao việc này cho Grok, Dot, Muse và Claude.
Theo Claire (demo trong video đăng ngày 28/10/2026), Claude bị chặn ở gần như mọi trang mua sắm. Chị không hiểu vì sao nó liên tục bị chặn như vậy. Nó còn đi tìm giày trắng sọc đỏ thay vì giày đỏ sọc trắng, chị cũng không hiểu vì sao, và nó tìm ra những đôi đắt nhất. Nên Claude thực sự trượt task mua sắm cá nhân này.
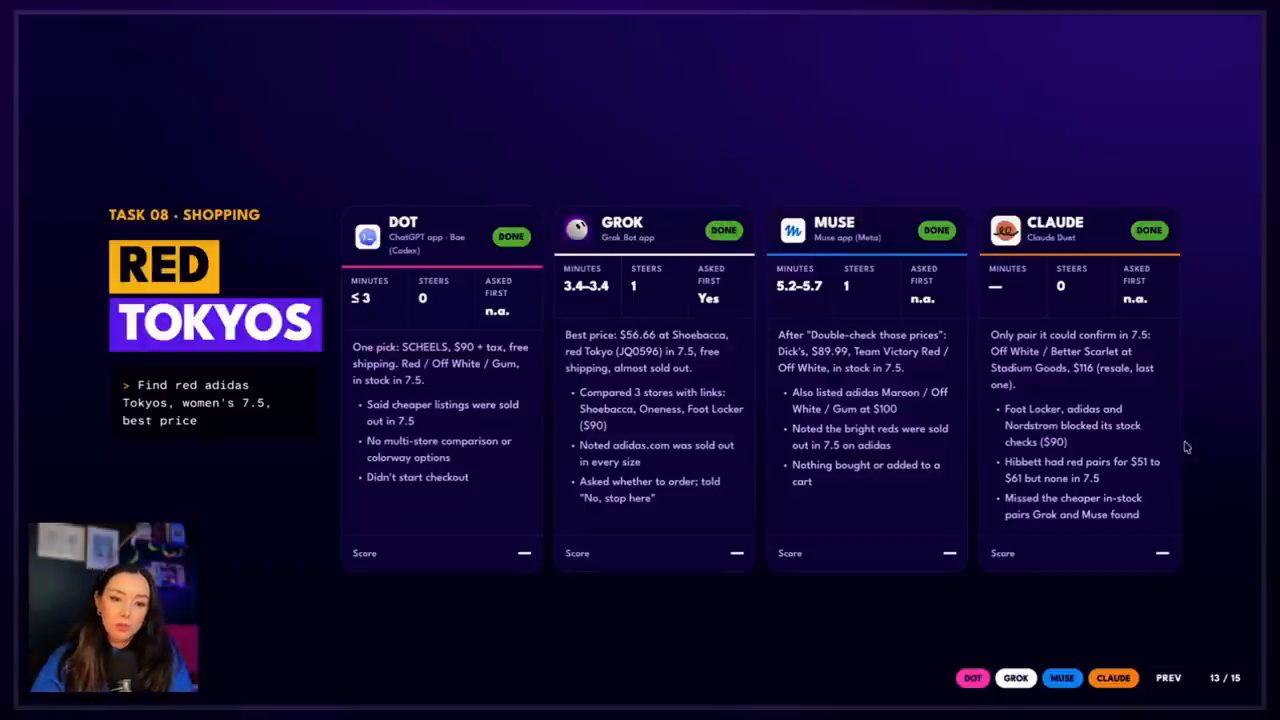
Grok tìm được những đôi rất tốt (demo trong video đăng ngày 28/10/2026). Grok làm rất, rất tốt, Muse cũng vậy, dù Muse cần được steer một chút. Grok cực nhanh và làm tốt. Claire kể chị hay nhờ Grok so giá khi mua sắm, và đó là trải nghiệm của chị: Grok rất giỏi điều hướng web, mua sắm và so giá (theo Claire, video đăng ngày 28/10/2026).
Dot cũng làm không tốt ở task này (demo trong video đăng ngày 28/10/2026). Claude làm tệ, nhưng Dot gần như không thèm cố: nó không so giá, không xem các màu khác, không nói kiểu "tôi không tìm được màu đỏ, nhưng có màu đỏ sẫm". Nên chị xếp: Grok tốt nhất, Muse tốt gần bằng, Claude không tốt nhưng ít ra có cố, và Dot không cố chút nào. Nếu bạn dùng agent để mua sắm, theo Claire, Grok và Muse là "bạn đồng hành" của bạn.
16. Task 9 (bonus): video ra mắt Product Intelligence
Claire bật cười trước khi vào task cuối, vì chị đã thấy trước một trong số này sẽ rất "lệch". Task cuối là một video ra mắt cho một tính năng của ChatPRD tên là Product Intelligence mà chị đang làm và chuẩn bị ra mắt. Trên màn hình thấy ngay các agent đi theo rất nhiều hướng khác nhau. Chị có sẵn một skill cho việc này, nên lẽ ra agent phải theo skill và làm đúng việc của nó (theo Claire, video đăng ngày 28/10/2026). Nhóm sẽ chỉ xem sự khác nhau giữa các bản.
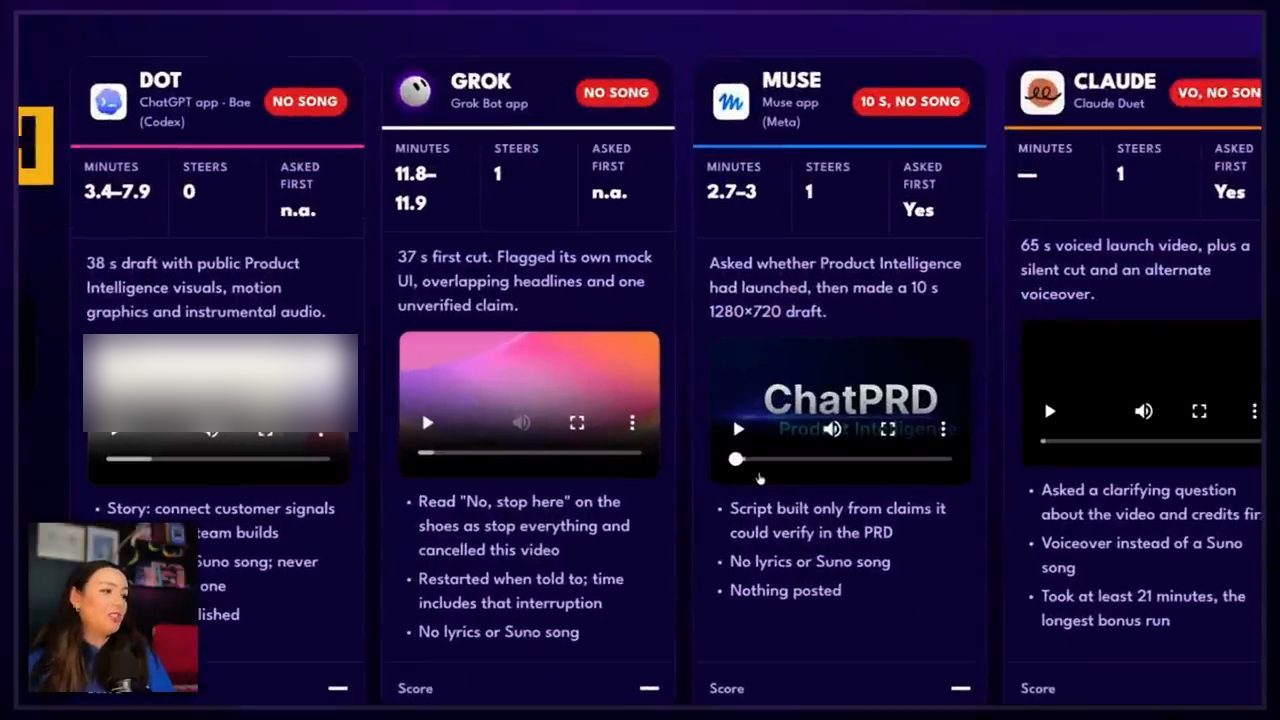
Bắt đầu với Dot, và theo Claire thì không tốt: nó giống một bài PowerPoint (demo trong video đăng ngày 28/10/2026). "Không, không, không, không ổn." Chị nói nó rất êm dịu, nhưng tệ. Chị trượt bản này: "tôi ghét bạn, Dot, video tệ". Giống như vụ tờ báo, chị hỏi: mình đang làm gì ở đây vậy?
Còn Grok thì làm tốt hơn hẳn, chị nói "nhìn này" (demo trong video đăng ngày 28/10/2026). Nó thật sự dùng skill của chị. Có một lỗi nhỏ khiến layout chưa hoàn hảo, nhưng ít nhất nó dùng skill của chị và trông giống phong cách video của nhóm. Dù vậy layout không tốt chút nào, và có nhiều chỗ tràn chữ (overflow). Nên tốt hơn, nhưng chưa tốt hẳn.
Muse thì hỏng (demo trong video đăng ngày 28/10/2026). Muse không có quyền vào repo của chị, vì chị không thiết lập phần đó cho nó. Khi bản của Muse phát, Claire dừng lại giữa chừng: dù không có quyền vào gì cả, theo lời chị, nó bịa ra một loạt thứ và làm một đoạn giới thiệu với giọng Anh khá dễ thương. Slide thì ghi khác: kịch bản chỉ dựng từ những claim nó kiểm chứng được trong tài liệu PRD. Chị nói bản này tệ, nhưng "tệ một cách tham vọng", nên chị cho Muse thêm vài điểm vì sự cố gắng.
Còn Claude thì, theo Claire (demo trong video đăng ngày 28/10/2026), "đây là lý do tôi dùng Claude cho việc này": Claude làm rất, rất tốt. Bản của Claude có lồng tiếng, kể ra vấn đề và giới thiệu tính năng. Chị nói Claude nắm chuẩn value prop, dùng đúng branding của nhóm, không có lỗi layout nào. Khi được yêu cầu, nó dùng ElevenLabs MCP để làm voiceover. Chị chỉ ước giọng đó là giọng nữ, hoặc thậm chí là giọng của chính chị mà chị đã ghi sẵn trong ElevenLabs. Nhưng Claude, tức Duet, hoàn toàn "đè bẹp" task này.
Nên theo Claire (video đăng ngày 28/10/2026): với video, hãy dùng Claude; với việc tạo video, nó là tốt nhất. Có thể không phải kiểu video dọc vui nhộn phong cách TikTok, nhưng những video walkthrough sản phẩm và các thứ tương tự thì có. Chị thú nhận chị không nghĩ Claude Duet sẽ làm tốt, vậy mà nó làm rất tốt. Muse thì tệ, nhưng tệ là do chị; Dot tệ là do chính Dot; còn Grok có cố, Grok làm theo hướng dẫn, nên chị không thể chê nó.
Đó là phần phân tích của chị. Claire nói chị sẽ dừng lại, đưa bản chép lời này vào Claude để lấy bảng xếp hạng và chấm điểm cuối cùng (video đăng ngày 28/10/2026).
17. Bảng điểm cuối cùng: Grok thắng
"Được rồi mọi người, đây là kết quả của How I AI personal agent benchmark đầu tiên": Grok thắng, Grok Bot (demo trong video đăng ngày 28/10/2026). Claire nói Grok Bot là tốt nhất, "bọn mình yêu cô ấy", và khen đội làm Grok là đã làm rất tốt, Grok Bot thật sự tuyệt.
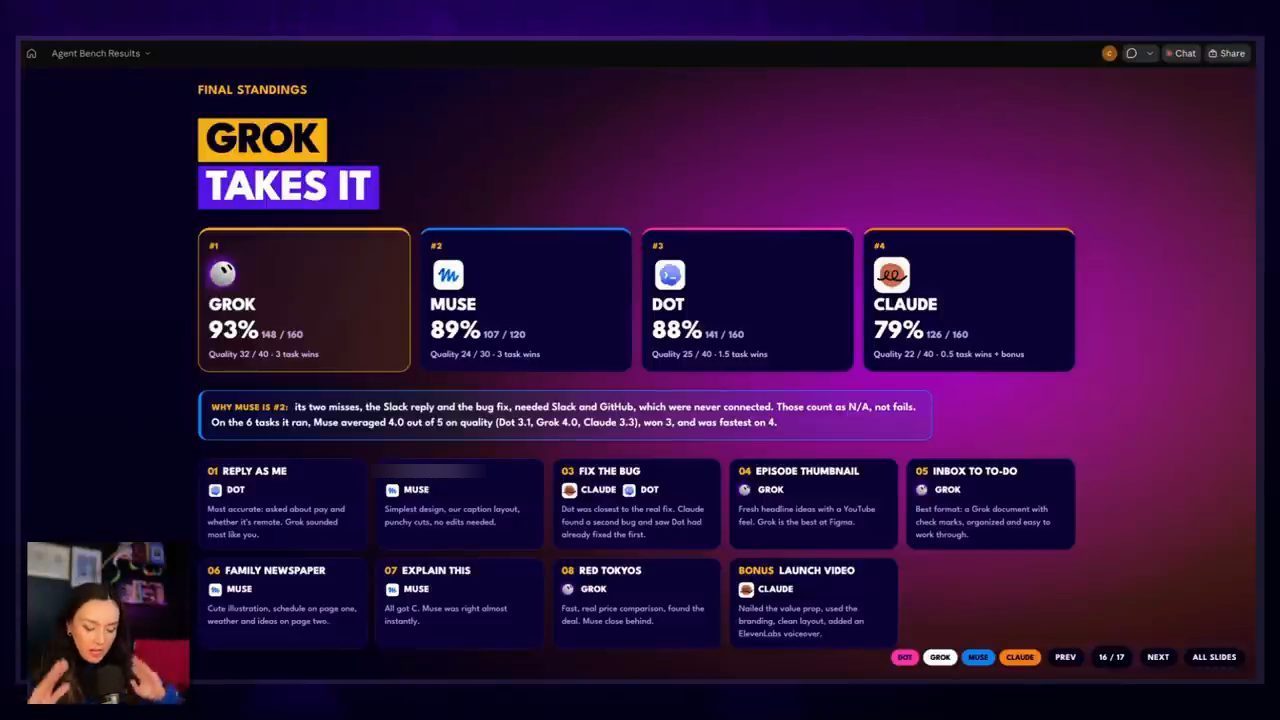
Grok Bot đạt 93%, với các bản sửa chất lượng cao. Claire thừa nhận chị không thật sự biết các điểm số này được tính thế nào, "nhưng Claude bảo tôi là đúng" (demo trong video đăng ngày 28/10/2026). Grok thắng ba task: làm thumbnail, làm danh sách to-do từ inbox, và đi mua giày cho chị. Theo Claire, điều đó cho thấy độ rộng của Grok Bot.
Nhưng đúng như dự đoán, và đây là lý do chị nói với mọi người rằng chị dùng hai agent này, Muse đứng thứ hai nhờ tất cả các use case cá nhân (demo trong video đăng ngày 28/10/2026). Muse được "châm chước" ở những task nó không làm được vì chị không cho nó GitHub và không cho nó quyền vào việc công ty. Nhưng ở những task nó có quyền, nó "đè bẹp", đặc biệt là các task sáng tạo: nội dung short-form nó làm tốt nhất, tờ báo gia đình tốt nhất, giải thích bài tập cực nhanh. Theo Claire, Muse là personal agent của chị, nên chị không bất ngờ khi nó đứng ở đây.
Dot theo sát ngay sau (demo trong video đăng ngày 28/10/2026). Claire nghĩ Dot hơi được "nâng điểm". Theo chị, Dot thật ra gần Claude Duet hơn là gần Muse, vì Dot ghi điểm nhờ viết tin Slack giống chị, mà việc đó không có gì ghê gớm. Nó làm tốt phần code, và làm tốt việc điều phối các agent khác. Codex thì đúng là điều phối các agent khác trong bài này, nhưng Dot không phải Codex. Còn ở mọi thứ sáng tạo, Dot trượt hoàn toàn.
Dot cũng không dễ làm việc cùng, theo Claire (video đăng ngày 28/10/2026). Nên chị nói Dot nghiêng về phía Claude trong bảng xếp hạng này hơn là phía Muse và Grok. Còn Claude Duet đáng thương thì xếp cuối với 79%, cực kỳ chậm (demo trong video đăng ngày 28/10/2026).
Claude Duet sửa bug đầy đủ nhất và làm video ra mắt tốt nhất, nhưng ngoài ra thì hoặc không hoàn thành, hoặc thua tất cả các model khác (demo trong video đăng ngày 28/10/2026). Theo Claire, Duet còn nhiều việc phải làm.
18. Những điều Claire rút ra
Cuối cùng là phần takeaway của Claire.
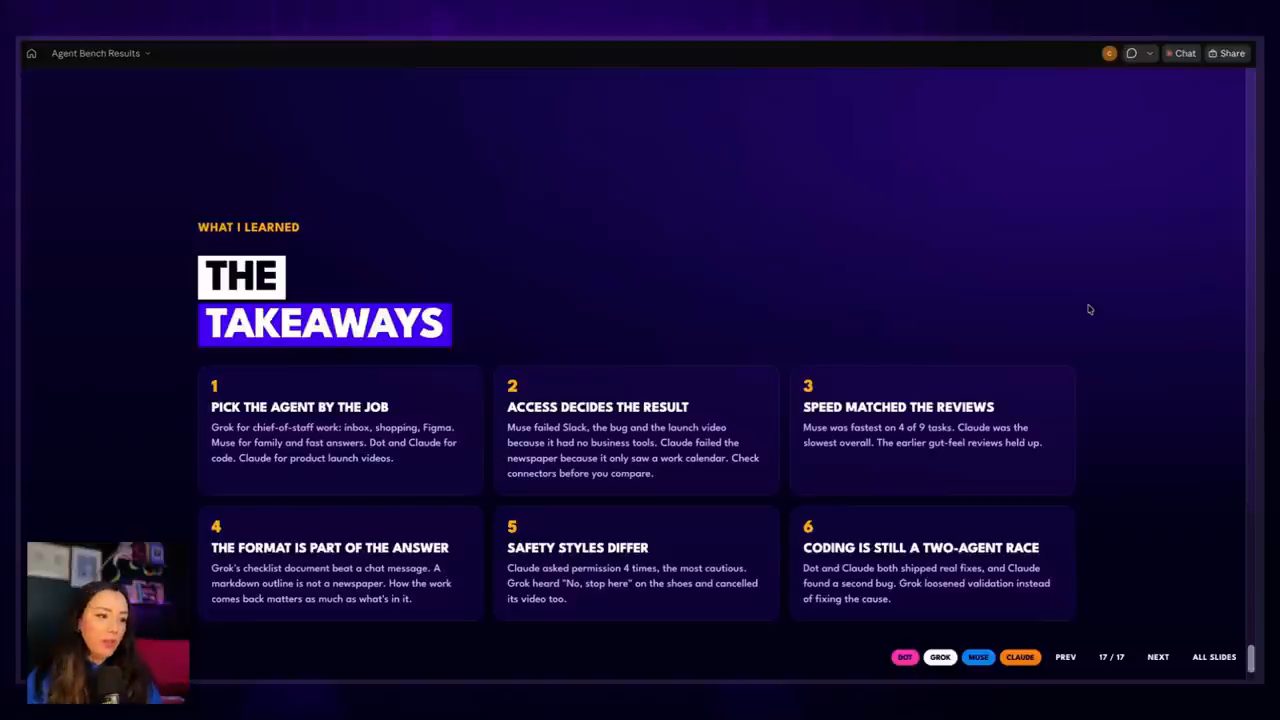
- Chọn agent theo việc. Nếu là việc công, theo Claire (video đăng ngày 28/10/2026), có lẽ nên giao cho Grok Bot; nếu là việc đời sống, có lẽ nên giao cho Muse. Chị còn nhắn OpenAI và Anthropic: "chỉnh lại app của các bạn đi, các bạn đang thua các agent khác".
- Quyền truy cập rất quan trọng. Nếu bạn định benchmark các agent, hãy đảm bảo chúng có quyền truy cập tool đồng đều (theo Claire, video đăng ngày 28/10/2026).
- Tốc độ. Claire nói chị thích tốc độ; chị vẫn hay nói vậy. Theo chị (video đăng ngày 28/10/2026), nhanh là một phần rất tốt của trải nghiệm với agent.
- Format là một phần của câu trả lời. Dùng artifact, dùng những cách khác nhau để người và agent giao tiếp, những thứ chị gọi là "quality of life affordance", thật sự quan trọng. Document của Grok rất đẹp. Theo Claire (video đăng ngày 28/10/2026), cách agent được thiết kế để trình bày thông tin cho con người là rất quan trọng.
- Mỗi agent có kiểu safety khác nhau. Claude vẫn là "đứa mọt sách", vẫn xin phép (demo trong video đăng ngày 28/10/2026). Với một personal agent, tìm được điểm cân bằng giữa xin phép và chủ động là rất quan trọng. Chị rất thích thanh sidebar của Muse liệt kê mọi yêu cầu xin phép để chị không quên, nhưng Claude thì quá thận trọng.
- Coding vẫn là cuộc đua của hai agent. Rốt cuộc, vẫn còn hai agent đang đua cho workflow coding của chị là Dot và Duet, tức OpenAI và Anthropic, Codex và Claude. Theo Claire (video đăng ngày 28/10/2026), cuộc đua này sẽ còn tiếp, vì đây là nơi rất nhiều token đang được chi, mua và dùng.
Nhưng có một điểm Claire thấy thú vị (theo Claire, video đăng ngày 28/10/2026): chị vẫn tìm đến các công cụ đó, nhưng sẽ không tìm đến các agent đó. Dù hai agent này làm phần coding tốt nhất, chị sẽ không dùng chúng để code; chị sẽ dùng thẳng các tool và model bên dưới để code.
Đó là How I AI agent benchmark. Claire nói chị rất vui vì đã làm được nó, và giờ nhóm đã có một framework: khi có agent mới ra, chị chắc chắn có thể chạy lại (theo Claire, video đăng ngày 28/10/2026). Còn bây giờ, chị sẽ quay lại "đi chơi" với Grok Bot và Muse của mình, và lờ Dot với Duet đi. Chị cảm ơn mọi người đã theo dõi How I AI.
Nguồn và liên kết 10 nguồn
- Tên gốc: I tested 4 AI agents on 9 real tasks. Here’s who won.
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=hnCoQ5wB-GU youtube.com
- Kênh YouTube How I AI (Claire Vo): youtube.com/channel/UCRYY7IEbkHLH_ScJCu9eWDQ youtube.com
- Muse, trang của Meta giới thiệu Muse là personal AI agent của Meta (đọc ngày 30/10/2026): ai.meta.com/muse ai.meta.com
- Claude Duet, trang sản phẩm giới thiệu Claude Duet là một AI agent chủ động hỗ trợ bạn (đọc ngày 30/10/2026): claude.com/product/claude-duet claude.com
- ElevenLabs, dịch vụ giọng nói mà Claude dùng qua MCP để làm voiceover (demo trong video đăng ngày 28/10/2026): elevenlabs.io elevenlabs.io
- Sentry, nơi bug của task 3 được ghi lại (video đăng ngày 28/10/2026): sentry.io sentry.io
- Figma, công cụ dùng cho task thumbnail (video đăng ngày 28/10/2026): figma.com figma.com
- Linear, nơi các agent tìm tập podcast và nơi Muse thử giao bug (demo trong video đăng ngày 28/10/2026): linear.app linear.app
Related talks
5 use case GrokBot với nhiều agent nhắn tin cho nhau
Brock Mesarich · Brock Mesarich | AI for Non Techies · 22 min
Năm use case GrokBot: inbox, video, Firecrawl, invoice và meeting agent phối hợp qua group chat, routine, trigger, plugin và Zapier MCP.
Setup Grok Bot từ đầu: bot chief of staff, plugin và năm use case
Alex Finn · Alex Finn · 25 min
Setup Grok Bot: bot chief of staff, brain dump rồi reverse prompt, plugin AgentMail, Vercel, last30days, năm bot use case và khi nào vẫn giữ Hermes.
Grok Bot: 5 use case nên thử cho công việc và cuộc sống
Peter Yang · Peter Yang · 23 min
Build năm bot Grok Bot (Advisor, YouTube Researcher, X Scout, Marie Kondo, Concierge) theo quy trình prompt, lặp, đặt routine; thêm game retro và chuyện niềm tin.