Chọn model AI local theo VRAM: context mới là đồng tiền thật
Vì sao từ card 12 GB tới 48 GB vẫn là cùng một model, KV cache ăn VRAM ra sao, hai cài đặt miễn phí tăng tốc, và khi nào nên thuê thay vì mua.
✓ Đã duyệt độc lập · cập nhật 21/10/2026 · 14 min
1. Những video tier list và một lần thử thất bại
Kai mở đầu bằng một câu hỏi: bạn đã đốt bao nhiêu giờ để xem các video kiểu "model AI local tốt nhất cho GPU của bạn", rồi cài thử một thứ, nhìn nó nghẹn ngay trên codebase của mình, và lặng lẽ đóng terminal lại như chưa có chuyện gì xảy ra? Nếu câu trả lời là "rất nhiều", thì chào mừng bạn vào câu lạc bộ, vì anh cũng đã làm y hệt như vậy.
Anh kể đã xem bốn video tier list khác nhau, từ bốn kênh khác nhau, và cả bốn đều nói với anh đúng một điều: ai có card 8 GB thì nên chạy một model ra đời từ năm 2024. Thế là anh chạy thử. Với autocomplete thì nó ổn. Nhưng ngay khi anh yêu cầu nó thật sự làm việc như một agent, tức là đọc các file của anh, hiểu một lỗi, rồi sửa lỗi đó, thì nó sụp đổ như một miếng bìa các-tông bị ướt.
Từ đó anh lao vào một "hang thỏ" gồm các thread trên Reddit, các log benchmark, và những bài đăng trên X của những người thật sự chạy các model này trên phần cứng thật, thay vì chỉ trích dẫn bảng thông số kỹ thuật (spec sheet).
2. Từ 12 GB tới 48 GB vẫn là cùng một model
Điều anh tìm ra là thứ mà không tier list nào nói với bạn: từ một card 12 GB cho tới một card 48 GB, đó vẫn là cùng một model trong suốt cả dải. Thứ thay đổi không phải là bạn chạy AI nào, mà là model đó giữ được bao nhiêu code của bạn "trong đầu", và nó đọc code đó nhanh tới đâu.
Theo Kai, chỉ một ý đó thôi đã nối dây lại toàn bộ chủ đề này. Vì vậy anh sẽ đi qua từng mức GPU, từng đồng tiền và từng sai lầm, bởi chính anh đã mắc một số sai lầm trong đó, và anh muốn giúp bạn tiết kiệm hoá đơn tiền điện.
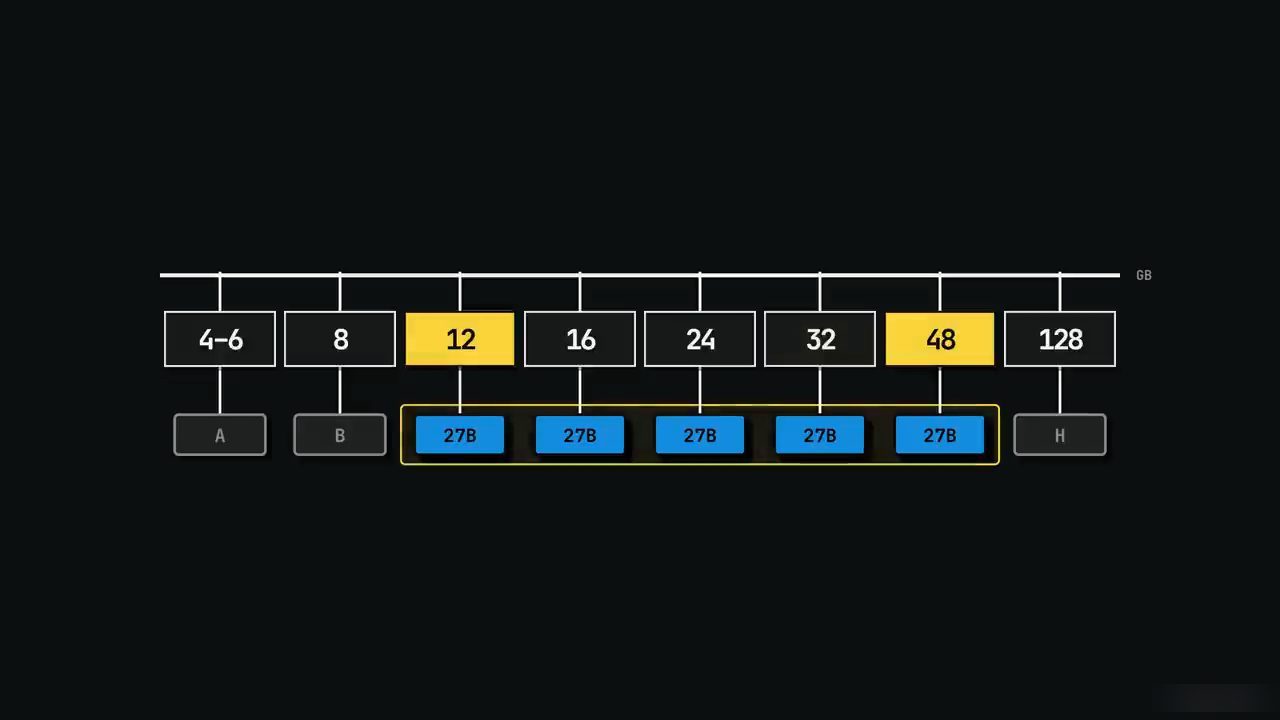
Theo Kai (video đăng ngày 26/09/2026), model 27B mà cộng đồng hội tụ về ở toàn dải này là Qwen 3.8 27B (tên ghi trên màn hình ở phần sau của video). Trên card lớn hơn, nó không thông minh hơn; bạn chỉ được dùng bản nhiều bit hơn và một context dài hơn.
3. Quy tắc nửa GB cho mỗi tỷ tham số, và mảnh còn thiếu
Trước hết, Kai muốn ghi nhận công của những người làm tier list, vì họ không sai, họ chỉ chưa đủ. Quy tắc họ dùng là có thật: một model đã nén (compressed) tốn khoảng nửa GB bộ nhớ cho mỗi tỷ tham số. Anh nói, như vậy một model 27 tỷ tham số cần khoảng 24 GB, xê xích một chút.
Từ đó, họ ghép kích thước model với kích thước card, đưa vào một video, và thế là xong. Đó là lý do chúng ta thấy cùng một biểu đồ được đăng lại vài tuần một lần, chỉ khoác thêm một lớp sơn mới.
Thứ làm anh chú ý là bình luận đứng đầu dưới một trong những video đó, video có 50.000 lượt xem. Bình luận chỉ ra rằng không biểu đồ kích thước nào trong số này tính tới một thứ gọi là KV cache. Theo Kai, một câu đó về cơ bản chính là toàn bộ video này.
4. KV cache: tiền thuê nhà chứ không phải tiền đặt cọc
Để hình dung cache này đang làm gì với VRAM của bạn, Kai đề nghị coi việc nạp model lên card giống như dọn vào một căn hộ: đó là một khoản chi phí một lần. Nhưng mọi thứ mà coding agent của bạn đọc, dù là các file, log lỗi hay output của test, model đều phải ghi lại những mẩu ghi chú nhỏ để không quên mình đang làm gì giữa chừng một câu. Những ghi chú đó sống trong cùng bộ nhớ với chính model, và chúng cứ lớn dần lên. Đó là KV cache, và nó là tiền thuê nhà hằng tháng, không phải tiền đặt cọc.
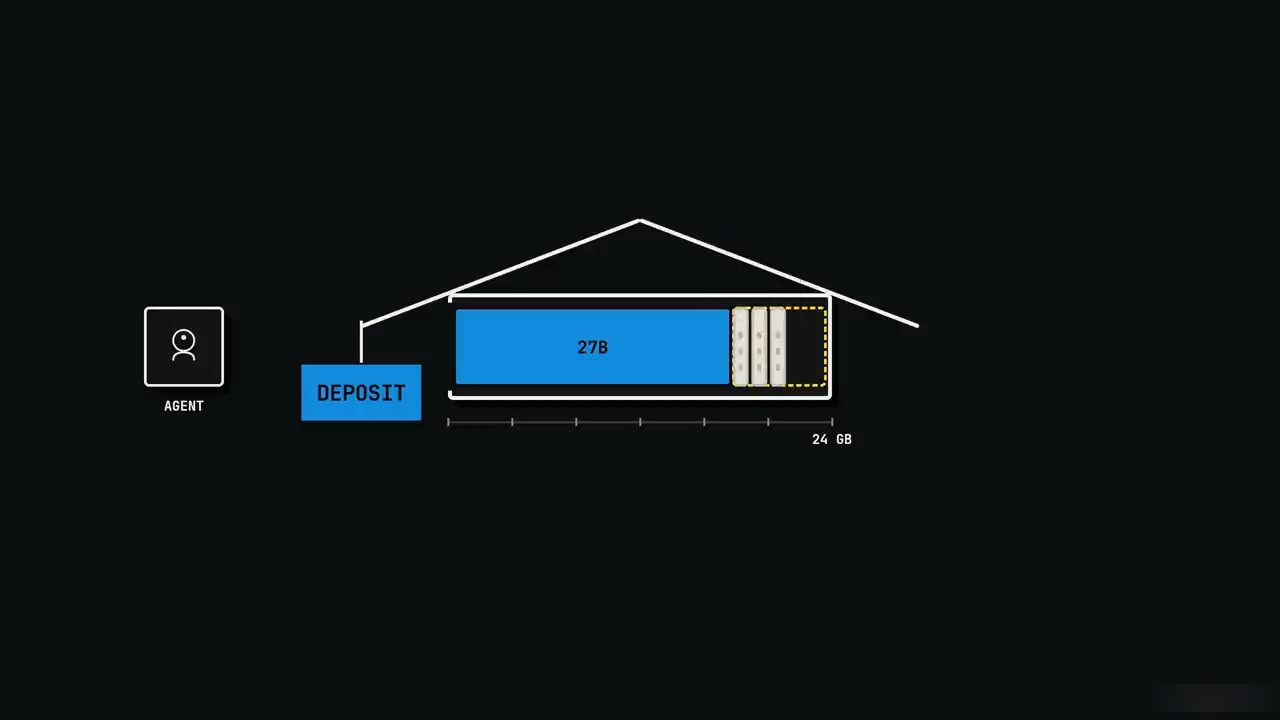
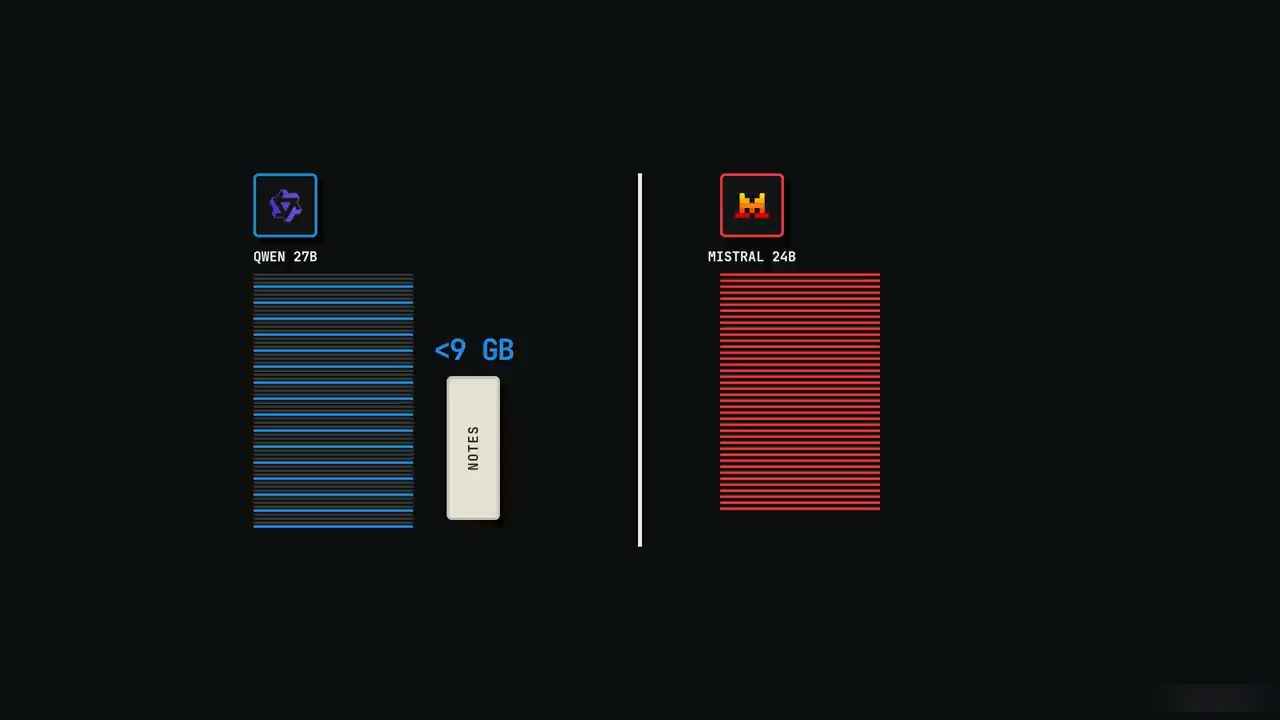
Phần tinh tế, theo anh, là không phải model nào cũng xử lý khoản tiền thuê này giống nhau. Model 27 tỷ tham số mà mọi người đã hội tụ về chỉ có 16 trong số 64 layer tích luỹ những ghi chú lớn dần này, các layer còn lại dùng một bản tóm tắt có kích thước cố định. Kết quả là một context đầy đủ 128.000 token chỉ tốn chưa tới 9 GB.
So với một model 24B có kích thước tương tự của Mistral (Devstral Small 2), nơi mọi layer đều giữ những ghi chú lớn dần, thì cùng độ dài context đó tốn hơn 21 GB. Con số đó lớn hơn cả chính file model. Vậy là cùng một hạng cân, nhưng tiền thuê nhà cao gấp hơn hai lần. Kai thú nhận anh thật sự không tin điều này cho tới khi đặt hai bộ số cạnh nhau.
5. Harness ăn context trước khi bạn gõ chữ nào
Tiền thuê bắt đầu tính trước cả khi một chữ nào được gõ, vì coding harness của bạn nạp các chỉ dẫn (instructions) và định nghĩa tool của chính nó trước tiên. Một người trên Reddit kể rằng chỉ ba kết nối tool MCP thôi đã ăn mất từ 3.000 tới 5.000 token, trước khi bất kỳ việc thật nào bắt đầu.
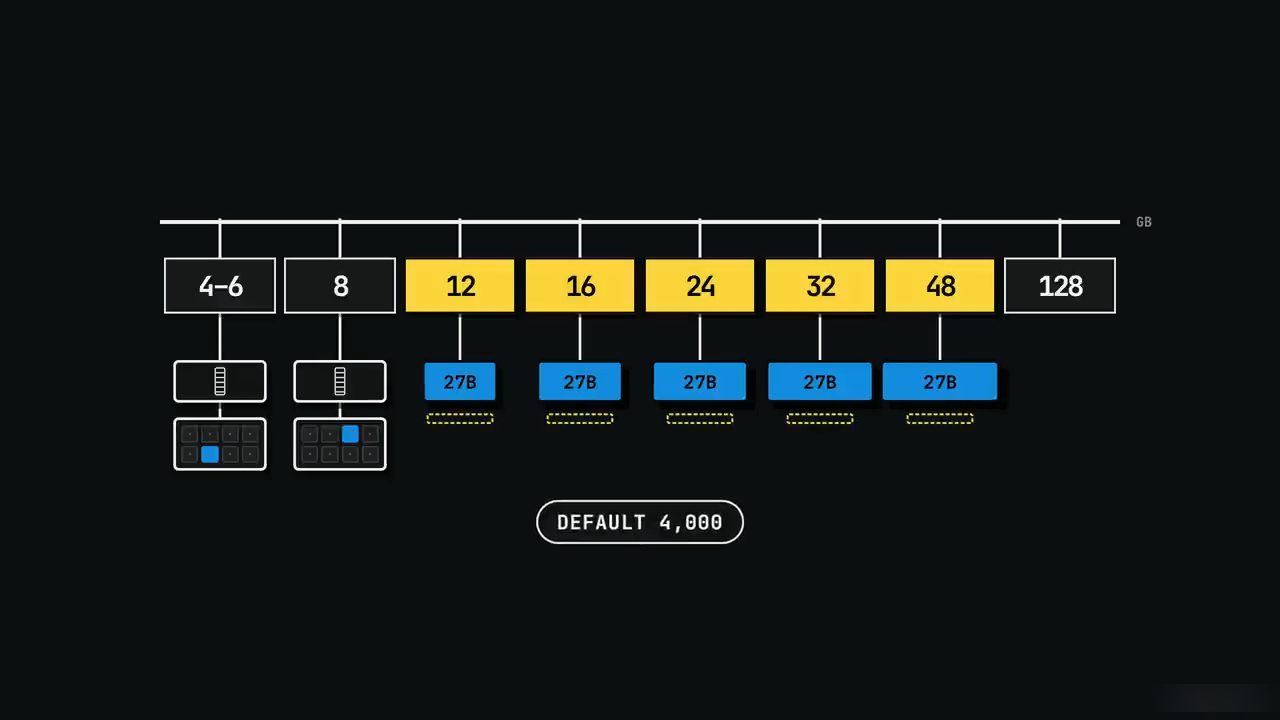
Trong khi đó, nhiều cấu hình mặc định chỉ đưa cho bạn 4.000 token context trên các card nhỏ. Tài liệu của Ollama, tính tới 10/2026, ghi mức mặc định 4k context cho máy dưới 24 GiB VRAM. Tới mức đó, theo lời Kai, nó không còn thật sự là một agent nữa, mà giống một chiếc bánh quy may mắn (fortune cookie) với vài bước thêm vào.
6. 4 đến 6 GB: một cỗ máy autocomplete rất nhanh
Với lăng kính đó trong tay, Kai đi qua từng mức. Ở 4 đến 6 GB VRAM, anh nói sẽ không tô hồng gì cả: thứ card này chạy được không phải là một agent, mà là một bộ autocomplete rất nhanh.
Các model nhỏ thật sự vừa vặn ở đây. Có một lựa chọn chắc chắn khoảng 3 GB và một lựa chọn khoảng 5 GB, cả hai đều cho kết quả đáng nể so với kích thước của chúng trên các benchmark công khai. Điều đó là thật, và hữu ích cho những câu hỏi nhanh trong một file.
Nhưng khi một người trên một diễn đàn có card 4 GB hỏi nên chạy gì, câu trả lời trung thực nhất về cơ bản là "không cái nào cả, cứ mua một gói cloud đi". Câu đó thẳng thừng, nhưng cũng đúng.
Kai thêm rằng, theo video đăng ngày 26/09/2026, thậm chí còn có một phiên bản hosted miễn phí của model 27B lớn hơn đang được chia sẻ trên mạng. Chỉ là đừng gửi bất kỳ thứ gì nằm dưới một thoả thuận bảo mật (NDA) tới một endpoint miễn phí, vì miễn phí hiếm khi đồng nghĩa với riêng tư.
Ở mức này còn một kẽ hở, và nó dẫn thẳng sang mức tiếp theo.
7. 8 GB: đừng nhồi model 27B, hãy dùng mixture of experts
Ở 8 GB, bản năng đầu tiên của mọi người, kể cả Kai, là cứ nhồi model 27B tốt kia vào và để nó tràn sang RAM hệ thống. Về kỹ thuật thì cách đó chạy được. Một creator đã làm đúng như vậy trên một card 8 GB (một chiếc RTX 4060) và, theo số liệu Kai dẫn trong video đăng ngày 26/09/2026, đạt khoảng 4 đến 5 token mỗi giây, nghĩa là viết một trang web duy nhất mất hơn một tiếng.
Theo Kai, video đó có nửa triệu lượt xem vì cho thấy nó chạy được. Điều đó đúng, nếu định nghĩa "chạy được" của bạn bao gồm cả việc ngồi xem sơn khô.
Nước đi thông minh hơn ở mức này là một loại model hoàn toàn khác: một thiết kế mixture of experts, nơi chỉ một phần nhỏ trong tổng số tham số thật sự được kích hoạt cho mỗi từ. Nhờ vậy phần lớn model có thể nằm thoải mái trong RAM hệ thống chậm, còn chỉ những phần thiết yếu nằm trên card. Model được nhắc tới ở mức này là Qwen 3.6 35B A3B.
Một người đã chạy cấu hình này trên một card 8 GB đời 2016 (GTX 1070) cùng 32 GB RAM hệ thống và đạt gần 26 token mỗi giây. Theo số liệu Kai dẫn trong video đăng ngày 26/09/2026, đó là nhanh gấp năm lần, trên một phần cứng mà tính theo năm công nghệ thì gần như là đồ cổ.
Đánh đổi thì có thật. Model gọn hơn này kém rõ rệt ở việc gọi tool trong các phiên agent dài, với tỉ lệ thất bại dao động rất mạnh trong các lần thử. Vậy nó không phải công cụ sắc nhất trong hộp, nhưng ở 8 GB, nó là công cụ thật sự vừa với cái hộp.
8. 12 đến 16 GB: cái bẫy của bản 4-bit và chuyện ai là người nén
Ở 12 đến 16 GB, model 27B lớn cuối cùng cũng nằm được trên chính GPU của bạn, và đây cũng chính là chỗ lời khuyên tiêu chuẩn sẽ làm bạn bỏng tay. Mọi hướng dẫn chung chung đều bảo bạn chạy bản nén 4-bit tiêu chuẩn, nhưng riêng bản build đó đã khoảng 17,4 GB. Vậy trên một card 16 GB, nó còn không vừa, trước khi một dòng code nào của bạn được nạp.
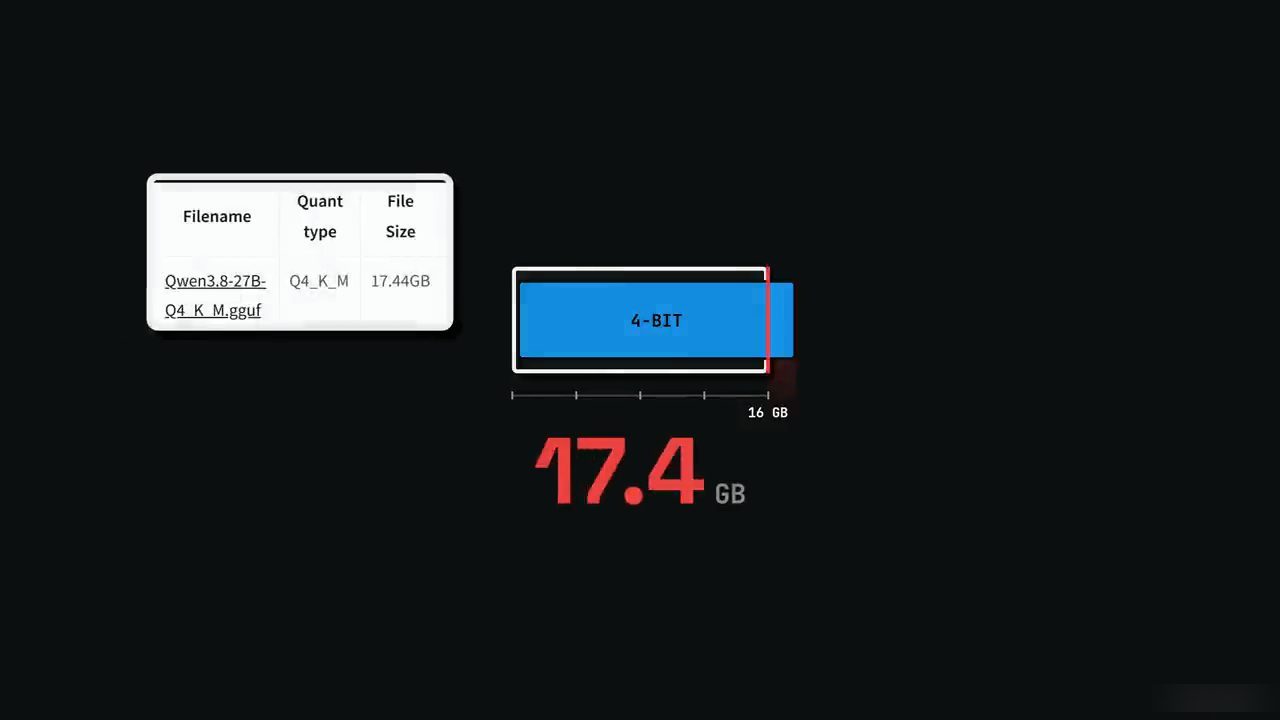
Qwen3.8-27B-Q4_K_M.gguf, loại quant Q4_K_M, dung lượng 17,44 GB. Thanh "4-BIT" vượt quá vạch 16 GB, tức bản 4-bit tiêu chuẩn không vừa card 16 GB.Thứ thật sự vừa là một bản 3-bit nén mạnh tay hơn, khoảng 13 GB. Và hoá ra nó không phải thảm hoạ "bị làm ngu đi" như hầu hết mọi người nghĩ. Theo video đăng ngày 26/09/2026, đó là một trong những cấu hình local được upvote nhiều nhất kể từ khi model này ra mắt, chạy trên một card 16 GB, với một người dựng được cả một REST API chạy hoàn chỉnh trên nó. Một đợt benchmark độc lập cho thấy bản build đã nén cho điểm gần như giống hệt model đầy đủ kích thước trên các tác vụ code thực tế.
Riêng ở 12 GB, mức nén còn giảm sâu hơn, xuống 2-bit. Và cú ngoặt khiến Kai thật sự bực mình khi phát hiện ra là: không phải bản build 2-bit nào cũng như nhau. Một developer đã thử hai bản upload 2-bit khác nhau của cùng một model, trên cùng các bài sửa bug. Một bản khớp với điểm của API hosted chính thức, còn bản kia giải được chưa tới một nửa số bug.
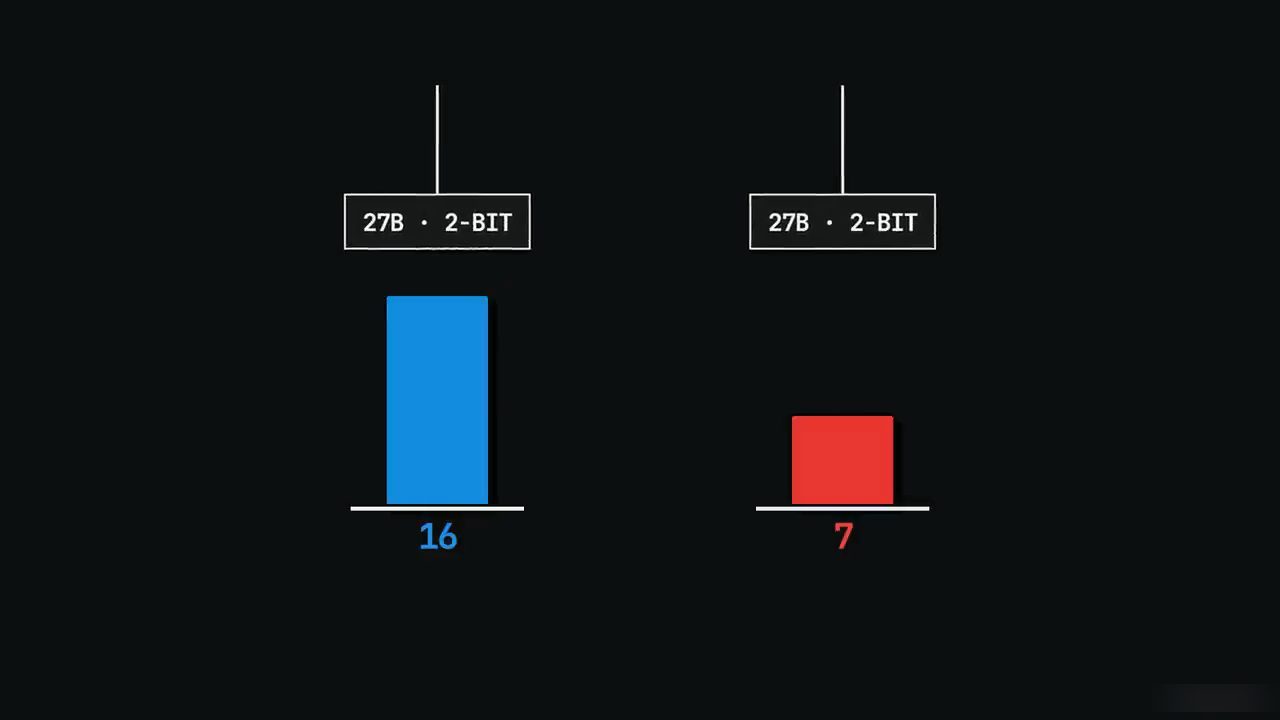
Vậy là cùng mức nén, cùng tên model, nhưng kết quả khác nhau một trời một vực, chỉ vì ai là người làm việc nén. Đó là lý do bài học ở mức này không chỉ là "nén mạnh hơn", mà là phải kiểm tra xem ai đã nén nó.
9. 24, 32 và 48 GB: con đường nâng cấp nhàm chán
Khi lên tới 24 GB, con đường nâng cấp trở nên nhàm chán một cách dễ chịu, vì cuối cùng chúng ta có được bản 4-bit tiêu chuẩn mà ai cũng khuyên dùng hồi ở mức 16 GB, và giờ nó vừa khít.
Dù vậy, các lần thử trên một card 24 GB cho thấy nó cần khoảng 22 GB ở một context 64.000 token khá ổn, còn context đầy đủ thì đẩy nhẹ quá sức chứa của card. Vì vậy ở 32 GB, ta có cùng bản build đó với context đầy đủ, không phải thoả hiệp gì.
Ở 48 GB, ta bước lên một bản 8-bit, với các ghi chú (KV cache) hoàn toàn không nén. Nhưng không ai gọi tên một model mới ở 48 GB, vì không có model mới nào cả. Đó vẫn là model từ mức 12 GB, chỉ là giờ nó được thở thoải mái.
10. Đọc kỹ tên trên hộp trước khi mua card
Một cái bẫy nhỏ trước khi bạn đi mua sắm: hãy kiểm tên thật trên hộp. Có một phiên bản laptop của một GPU cao cấp phổ biến chỉ mang 24 GB, chứ không phải 32 GB như bản desktop. Và trên các benchmark được chia sẻ, chip laptop chạy chỉ bằng khoảng một nửa tốc độ của "người anh em" desktop cùng tên. Cùng thương hiệu, nhưng là một card rất khác.
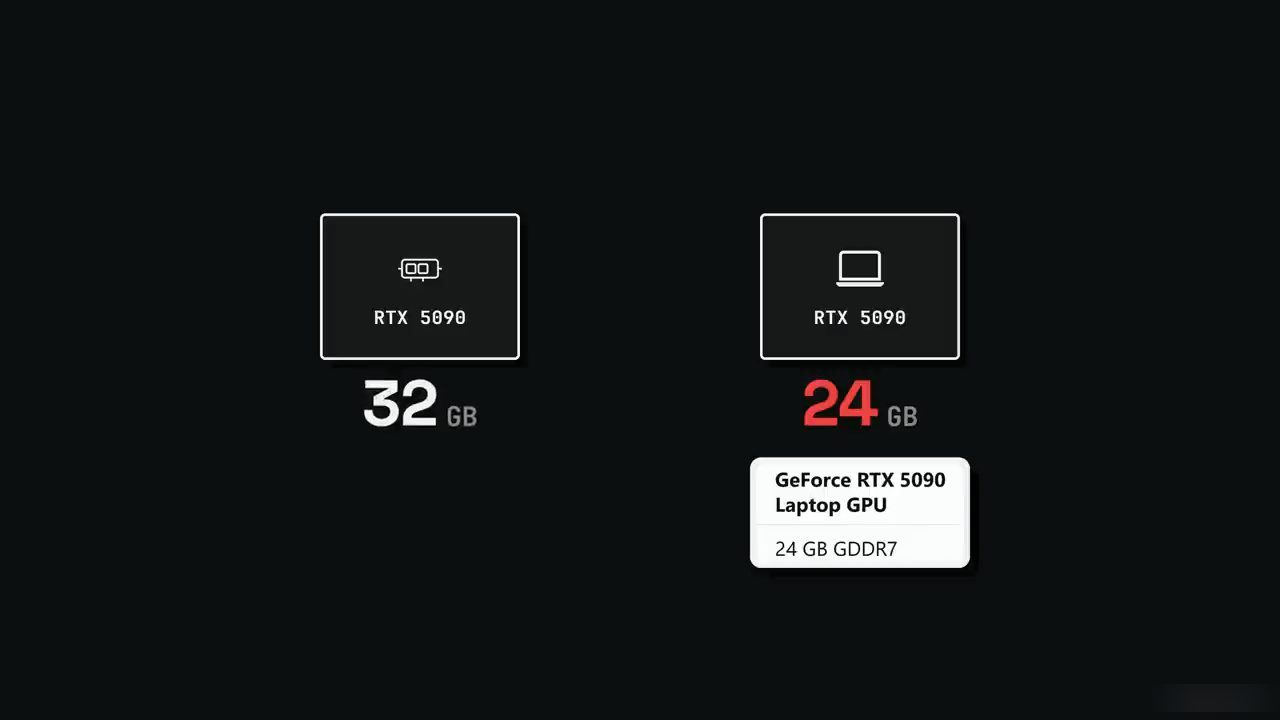
Thêm nữa, theo video đăng ngày 26/09/2026, card desktop đó ra mắt với giá dưới 2.000 đô và lúc quay video đang được bán với giá hơn 6.000 đô. Vì thế Kai khuyên hít một hơi thật sâu, và có lẽ đừng mua nó chỉ vì tức.
11. Hai cài đặt miễn phí đáng giá hơn nâng cấp phần cứng
Trước khi bạn kịp nghĩ tới một card mới, theo Kai trong video đăng ngày 26/09/2026, có hai cài đặt miễn phí tạo khác biệt lớn hơn hầu hết các lần nâng cấp phần cứng. Kai nói anh ước có ai đó nói cho anh điều này trước khi anh suýt mua một GPU mình không cần.
Multi-token prediction
Thứ nhất, model này có thể dự đoán trước vài từ rồi kiểm chứng chúng trong một lượt (multi-token prediction), và đó là tính năng bật được chỉ bằng một flag. Trên một bảng benchmark được chia sẻ, bật nó lên đưa một card cao cấp từ 48 token mỗi giây lên 76, và trên card desktop mới nhất (RTX 5090, tính đến lúc video đăng ngày 26/09/2026) thì nhảy từ 74 lên tận 180. Gần như là tốc độ miễn phí từ một flag.
Lạ là Apple Silicon không được lợi gì (trên một máy M4 Mac thì không đổi), vì có vẻ một số công cụ chuyển đổi bỏ hẳn tính năng này đi.
Mức reasoning
Cài đặt thứ hai là model suy nghĩ "chăm" tới đâu theo mặc định, vì model này xuất xưởng ở mức reasoning tối đa. Một developer có tiếng đã đưa nó một prompt vẽ hình duy nhất, và nó suy nghĩ 21 phút ở mức reasoning tối đa, so với khoảng hai phút khi tắt reasoning. Nhanh hơn chín lần chỉ nhờ một cài đặt.
Một tuần thử nghiệm của cộng đồng còn cho thấy mức reasoning trung bình (medium) cho điểm gần như giống hệt mức tối đa, trong khi chỉ suy nghĩ một phần nhỏ thời gian.
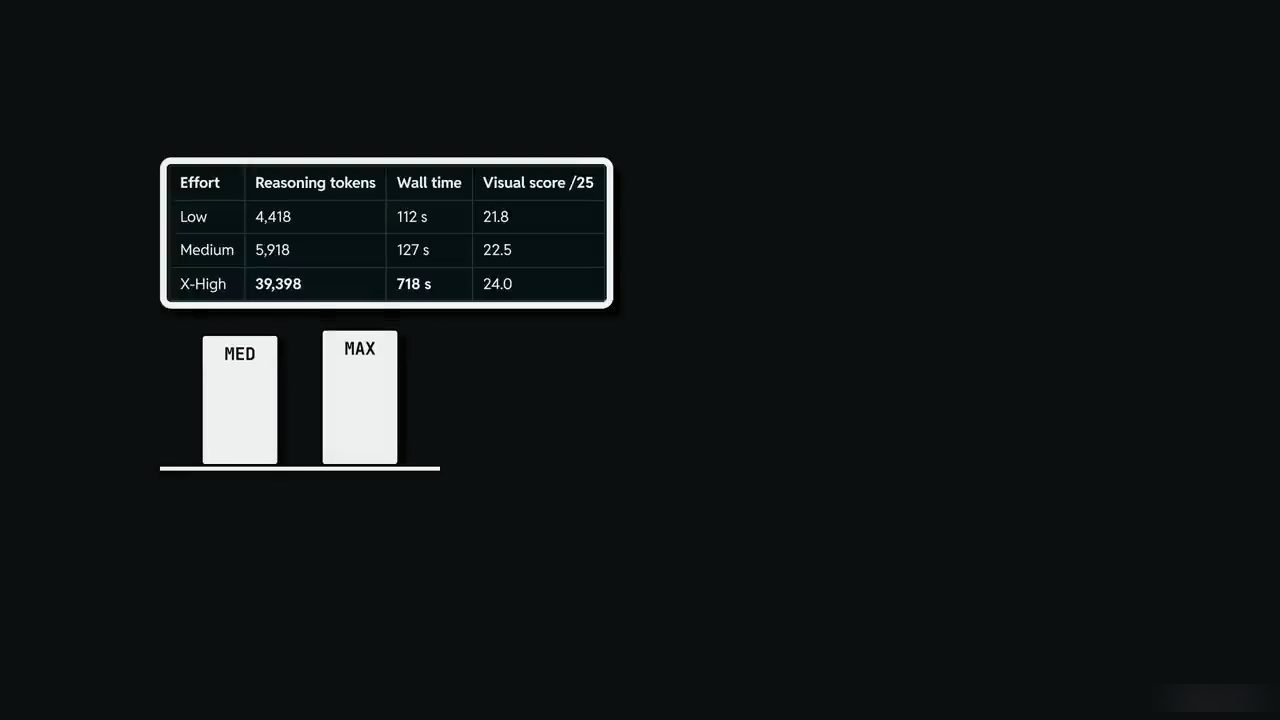
Vậy thứ chúng ta muốn là reasoning ở mức medium cùng multi-token prediction được bật. Theo Kai, đó là hiệu năng miễn phí, không cần mua card nào (với model và các công cụ tính đến 26/09/2026).
12. 128 GB: model đổi lần đầu, tốc độ đọc lên ngôi
Ở 128 GB bộ nhớ, mọi điều vừa nói bị gạt sang một bên, vì theo bản đồ của Kai (video đăng ngày 26/09/2026), lần đầu tiên chính model thay đổi. Giờ ta nói về một model mixture of experts mới hơn, lớn hơn nhiều (Qwen 3.8 Flash-Next), với tổng cộng hơn 100 tỷ tham số, nhưng chỉ một phần nhỏ được kích hoạt cho mỗi từ. Vẫn là mẹo giống trước, chỉ ở quy mô lớn hơn.
Ở 4-bit, nó cần khoảng 111 GB, nên chỉ hợp lý trên phần cứng nghiêm túc như một mini PC mạnh, một hộp AI workstation chuyên dụng, hoặc một Mac Studio cao cấp.
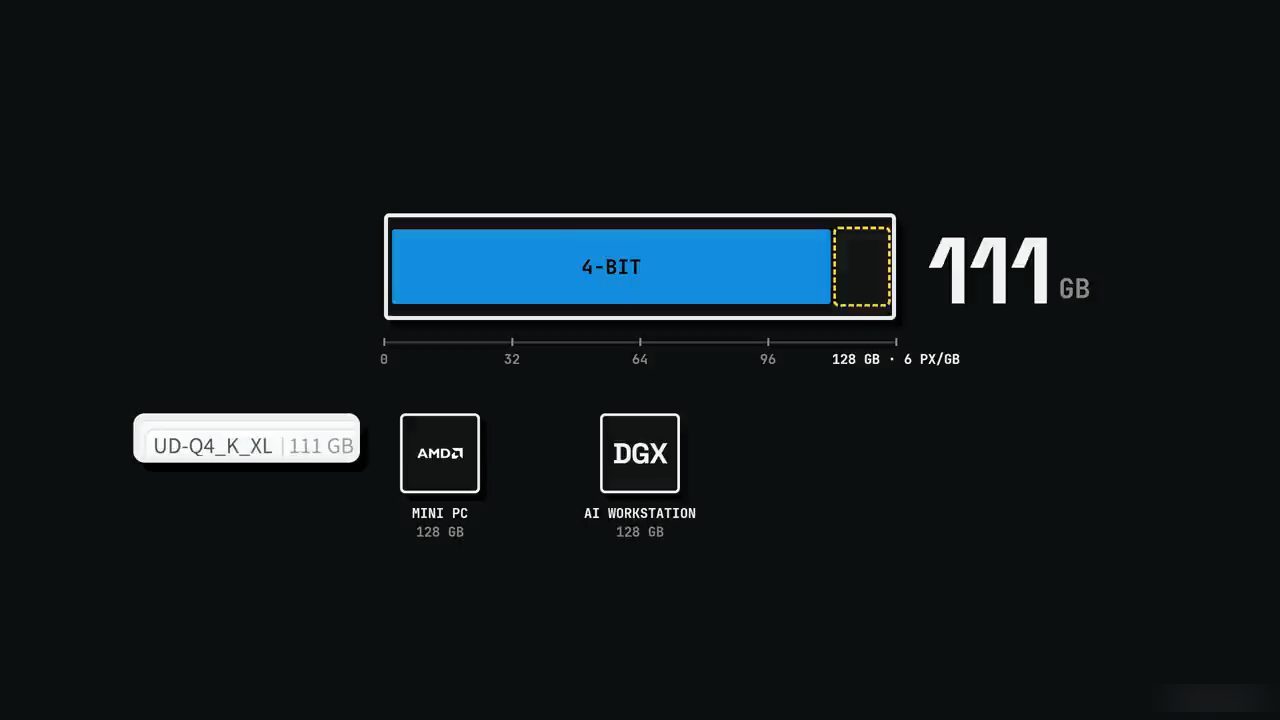
Theo số liệu Kai dẫn trong video đăng ngày 26/09/2026, một người chạy model này trên cấu hình mini PC đạt khoảng 50 token mỗi giây khi sinh code, một con số khá tốt. Nhưng con số quan trọng hơn là nó đọc nhanh tới đâu, vì agent của bạn liên tục đọc lại các file và output lỗi. Trên cùng cấu hình đó, tốc độ đọc thấp hơn nhiều so với tốc độ viết, nghĩa là một lần nạp lại toàn bộ prompt có thể mất hơn một phút trước khi model viết ra một từ mới nào.
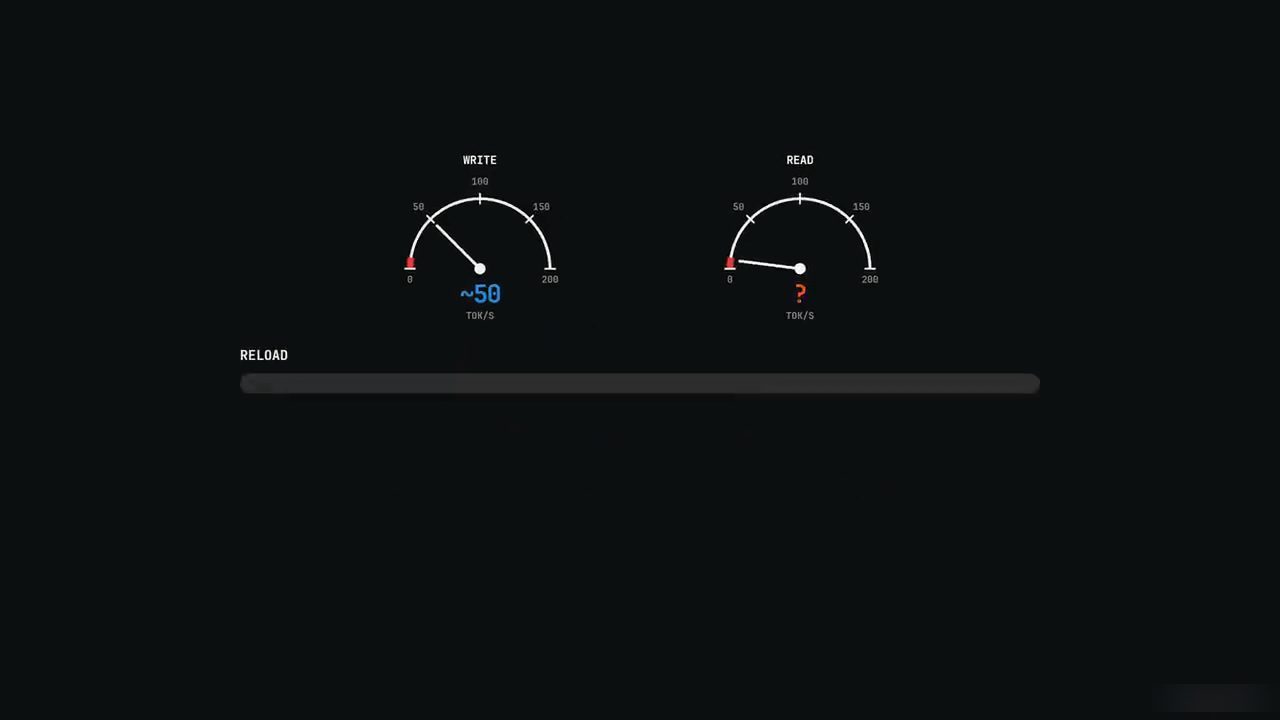
Một người chạy một dàn máy với bốn GPU cao cấp đã được mod thì kéo thời gian nạp lại đó xuống chỉ còn vài giây. Đó là lý do mức này không còn là chuyện dung lượng bộ nhớ nữa, mà là chuyện tốc độ đọc.
13. Trên 128 GB: thôi mua, chuyển sang thuê
Vượt quá 128 GB, còn một model lớn hơn nữa đáng nhắc tới (DeepSeek V4 Flash), với hàng trăm tỷ tham số và một phần trong đó kích hoạt cho mỗi từ, vừa với những chiếc Mac Studio bộ nhớ cực lớn mới nhất (tính đến lúc video đăng ngày 26/09/2026). Nhưng đây cũng chính là chỗ Kai bảo bạn dừng mua phần cứng và bắt đầu đi thuê.
Phép tính thật sự thuyết phục anh: theo video đăng ngày 26/09/2026, thuê model khổng lồ đó chỉ tốn vài xu cho mỗi triệu token output qua một dịch vụ API trung gian cho model, rẻ hơn gần 10 lần so với thuê model 27B nhỏ hơn đã nói ở trên.
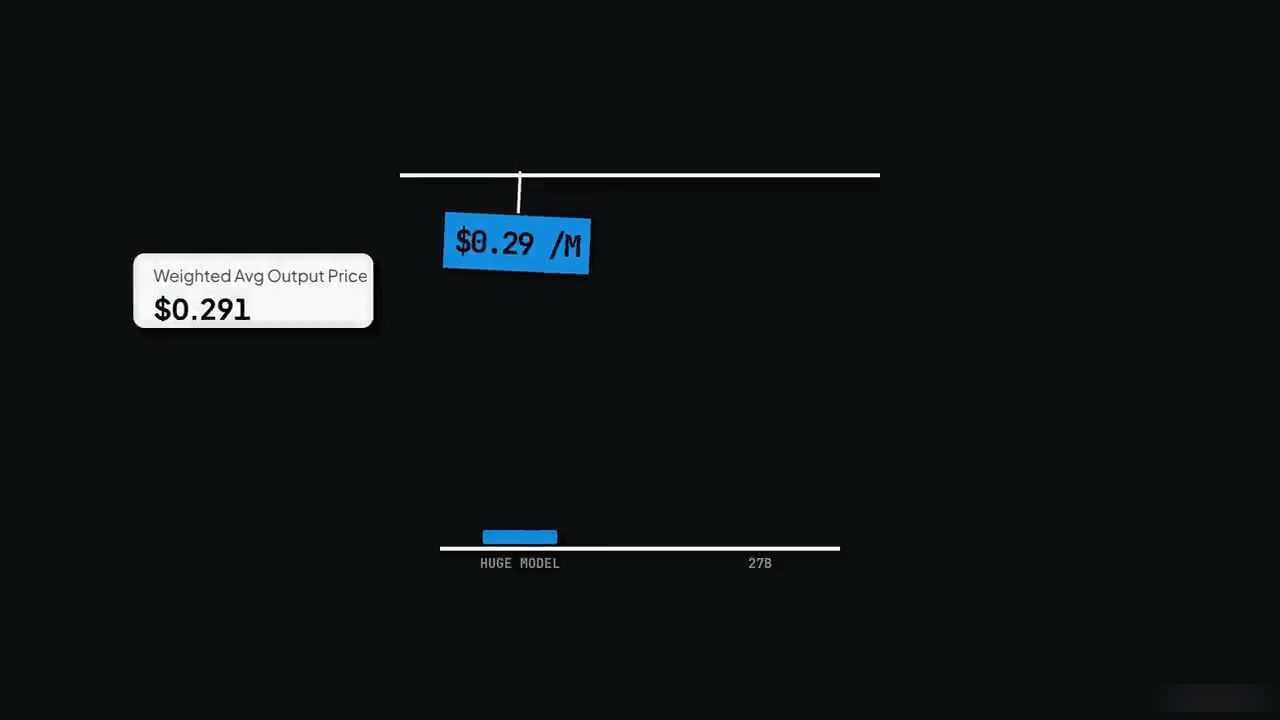
Vậy nếu lấy giá của một GPU desktop cao cấp và dùng số tiền đó để thuê quyền truy cập model lớn hơn, ta sẽ mua được hàng tỷ token, nhiều hơn cả số mà chính GPU đó có thể sinh ra về mặt vật lý nếu chạy liên tục nhiều năm. Và khi có người làm cùng phép tính (theo video đăng ngày 26/09/2026) cho một cặp hộp AI workstation cao cấp, họ ra kết quả khoảng sáu năm mới hoà vốn so với việc chỉ đi thuê. Sở hữu phần cứng ở quy mô này về cơ bản là mua sắm theo sở thích, không phải một quyết định tài chính.
14. Người mua duy nhất có lợi, và người không được gửi code ra ngoài
Phép tính đó lật ngược hoàn toàn cho đúng một kiểu người mua: người mà nếu không mua thì sẽ phải trả tiền thuê model 27B nhỏ hơn liên tục. Với người đó, theo phép tính trong video đăng ngày 26/09/2026, bài toán kinh tế đảo chiều, và mua GPU tự hoàn vốn trong khoảng một năm dùng đều đặn hằng ngày, chưa tính tiền điện.
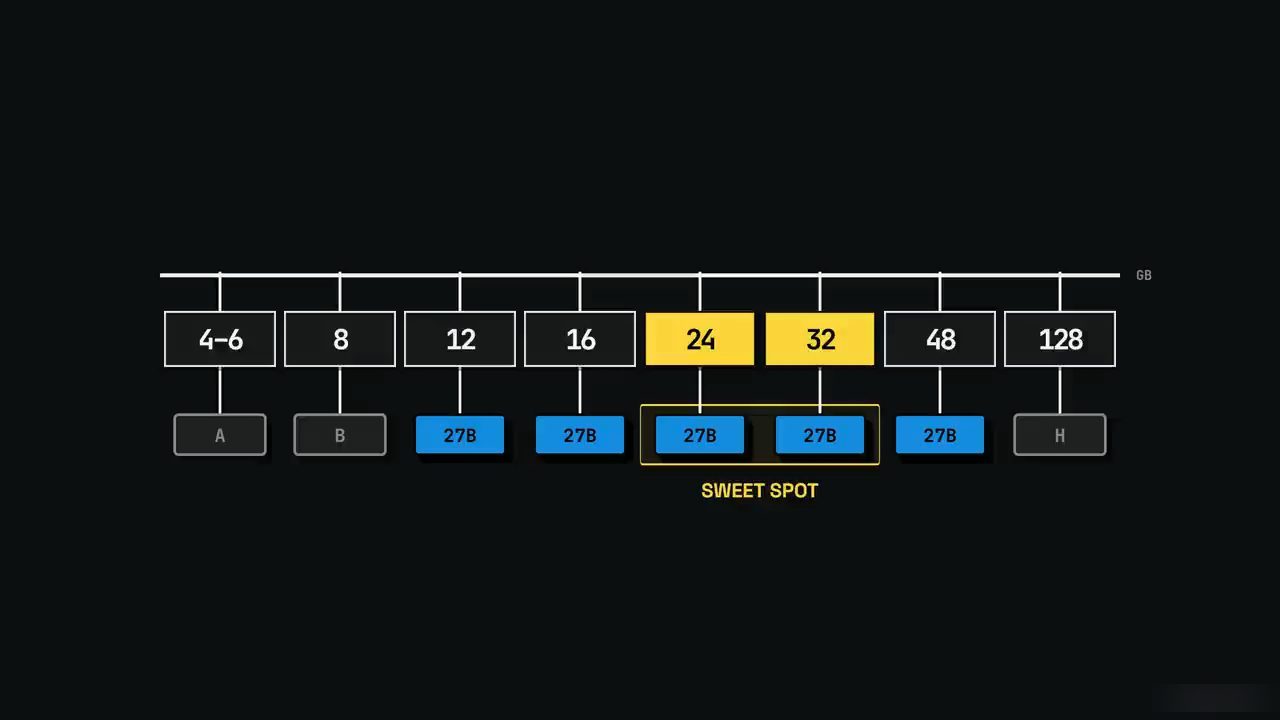
Đó là điểm ngọt, nằm ở 24 đến 32 GB, và về cơ bản không ở đâu khác trên cả danh sách này.
Rồi còn kiểu người mua mà giá chưa bao giờ là yếu tố quyết định: bất kỳ ai làm trong tài chính, y tế, hay đang chịu một NDA, nơi code về mặt pháp lý không được rời khỏi toà nhà. Với họ, mức giá hosted rẻ không phải là giảm giá gì cả, mà là thứ không thể cân nhắc.
Phần lớn các cấu hình nghiêm túc mà Kai từng thấy rơi vào khoảng giữa: một model frontier lớn lo phần lập kế hoạch và kiến trúc, còn một model local lặng lẽ xử lý những phần việc nhàm chán, đã được định nghĩa rõ bên dưới, như một người cộng sự chứ không phải một thứ thay thế.
15. Cả video trong một hơi
Kai gói cả video lại trong một hơi: đừng hỏi "model nào vừa card của tôi" nữa, vì với hầu hết mọi người, câu hỏi đó đã có một đáp án duy nhất. Thay vào đó hãy hỏi bạn thật sự đủ sức "chi" cho bao nhiêu context, vì đó mới là đồng tiền thật ở đây.
- Dưới 12 GB: mua RAM thay vì mua GPU, và lấy model mixture of experts.
- Từ 12 tới 48 GB: vẫn là cùng một model suốt dải, nên cứ chọn bản build lớn nhất mà vẫn để lại chỗ cho việc thật trong context, và tự đặt context đó thay vì tin vào mặc định.
- Bật multi-token prediction, hạ reasoning xuống medium, và dùng một harness gọn nhẹ để các chỉ dẫn không ăn hết cửa sổ context trước khi code của bạn kịp xuất hiện.
- Ở 128 GB: tốc độ đọc mới là thứ quan trọng, không phải dung lượng.
- Vượt quá mức đó: đã tới lúc cứ đi thuê.
Nếu video giúp bạn tránh mua nhầm card, hoặc tránh lặp lại sai lầm của anh là chạy một model 27B trên 8 GB chỉ bằng niềm hy vọng, Kai mời bạn subscribe. Anh hẹn tuần sau sẽ benchmark trực tiếp ba trong số các bản build này, đặt cạnh nhau, trên chính máy của anh.
Nguồn và liên kết 5 nguồn
- Tên gốc: I Tested Every Local AI Model So You Don't Have To
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=C9M6iUFtVB4 youtube.com
- Kênh YouTube Kai (Kai): youtube.com/channel/UCgUfJoPtkt7-RiiuYh4vmGA youtube.com
- Tài liệu Ollama về context length (mức mặc định theo VRAM: dưới 24 GiB là 4k context, 24 đến 48 GiB là 32k, từ 48 GiB là 256k; tính đến 10/2026): docs.ollama.com/context-length docs.ollama.com
Related talks
10 level dùng Jev cho agentic engineer
IndyDevDan · IndyDevDan · 35 min
10 level dùng Jev của TypeSafe, từ câu lệnh if thông minh tới guardrail hook, compact và agent tự hỏi Jev về file mà không đọc chúng.
Pi 1.0: Codemode, virtual model routing và Pi Durable
AICodeKing · AICodeKing · 17 min
Đi qua bản Pi 1.0: MCP native qua Codemode, Jev, virtual model routing, deferred tool, cache warming, theme mới, và Pi Durable cho agent chạy lâu.
Toàn bộ hướng dẫn Skills của Anthropic trong 22 phút
Mark Kashef · Mark Kashef · 22 min
Đi qua bản hướng dẫn 33 trang của Anthropic về skill: anatomy, ba tầng progressive disclosure, viết description, năm design pattern, test và phân phối.