Dùng RL để Qwen 4B đuổi theo Qwen 27B
Train Qwen 3.5 4B bằng GRPO trên RL environments mở: checker chặt, chọn task ở mép năng lực, vì sao điểm chững lại, rồi distillation từ 27B.
✓ Đã duyệt độc lập · cập nhật 22/10/2026 · 16 min
1. Câu hỏi: RL có kéo một model 4B lên ngang model 27B không?
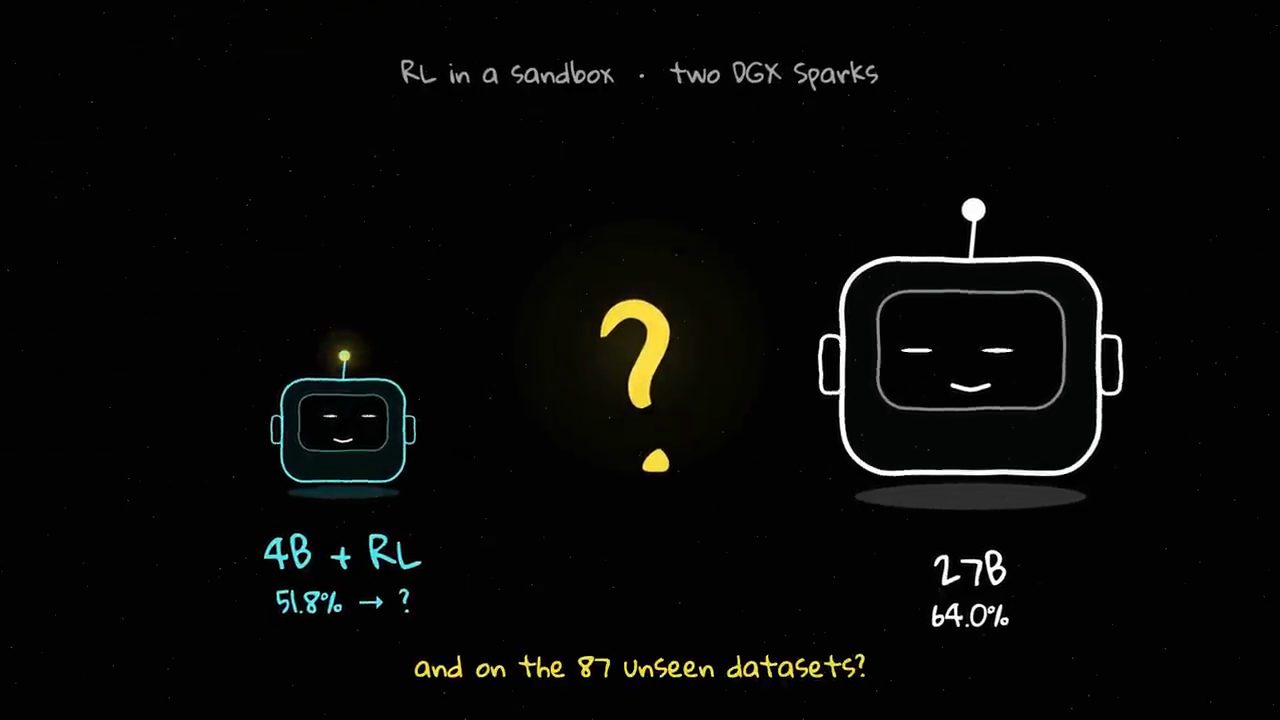
Muhammad Farooq mở video bằng một câu hỏi: liệu có thể làm cho một model 4 tỷ tham số (4 billion) đạt mức tương đương một model 27 tỷ tham số bằng RL (reinforcement learning) không? Đó chính là thứ anh sẽ cho xem trong video này.
Theo Muhammad, nếu nhìn vào các đợt ra mắt model gần đây (tính đến video đăng ngày 17/10/2026), có một thứ cứ lặp đi lặp lại, đó là RL environments. Anh lấy ví dụ Anthropic: theo tin được đưa ra, công ty này đã bàn tới chuyện chi hơn một tỷ đô la cho RL environments chỉ trong một năm. Và có vẻ như có được những RL environment tốt có thể đẩy giới hạn hiệu năng của model đi xa hơn.
Trên màn hình lúc đó là đoạn trích bài TechCrunch "Silicon Valley bets big on 'environments' to train AI agents" (đăng ngày 21/09/2025, dẫn lại The Information), với dòng tô sáng "$1 billion on RL environments" và con số "$1B+ per year" viết tay bên cạnh (theo video đăng ngày 17/10/2026).
2. RL environments đã có trong open source
Tin tốt, theo Muhammad (video đăng ngày 17/10/2026), là đã bắt đầu xuất hiện những RL environment thực sự ấn tượng trong open source. Xiaomi đã open source hàng nghìn environment cùng với MiMo V2.6; trên màn hình, bài viết của Xiaomi ghi "7k+ high-quality RL task environments", phủ bốn loại task cho agent, trong đó có software engineering, tái hiện lỗ hổng bảo mật, công việc nặng về kiến thức và web design. Và team Hugging Face cũng đã ra mắt các RL environment được build riêng cho model nhỏ (theo video đăng ngày 17/10/2026).
Vì vậy, trong video này anh muốn tìm hiểu một câu hỏi đơn giản: có thể dùng những environment mở này trên phần cứng của chính mình để làm cho một model nhỏ tốt hơn không? Để tìm câu trả lời, anh chạy một loạt thí nghiệm trên hai máy DGX Spark mà anh có, và sẽ đi qua tất cả những thí nghiệm đó. Trên màn hình, năm thí nghiệm được đánh số: random tasks, edge tasks, more RL, distillation và distill + RL.
Câu trả lời ngắn gọn: có, nó hoạt động. Theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), một model 4 tỷ tham số đã tốt lên rõ ràng và thu hẹp hơn một nửa khoảng cách tới một model lớn gấp khoảng sáu lần. Nhưng điều anh để ý là tới một lúc nào đó, nó ngừng tiến bộ. Và lý do vì sao, theo anh, có lẽ là phần hữu ích nhất của video này.
Trên màn hình lúc này là một đường cong điểm số đi lên rồi đi ngang, với dòng chữ "four routes ≈ 58%" (theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026), nằm dưới vạch của model 27B, cạnh một chữ "why?" to màu đỏ.
3. RL environment là gì: một bài thi có sẵn đáp án
Trước khi cho xem setup và các thí nghiệm, Muhammad giải thích chính xác RL environment là gì. Một mental model tốt là một bài thi thử (practice exam) kèm đáp án (answer key). Model nhận một task, cố giải nó, và có một thứ gì đó kiểm tra câu trả lời.
Để cụ thể hơn, anh lấy một environment mà anh đã dùng, tên là Small Data Environments (SmolDataEnvs). Mỗi task là một dataset thật lấy từ Kaggle, đi kèm một câu hỏi về dữ liệu đó, và một đáp án mà một chương trình có thể kiểm tra được. Ví dụ, đây là một bảng tính doanh số video game, và câu hỏi là publisher nào có tổng doanh số cao nhất. Với task cụ thể này, đáp án là Nintendo.
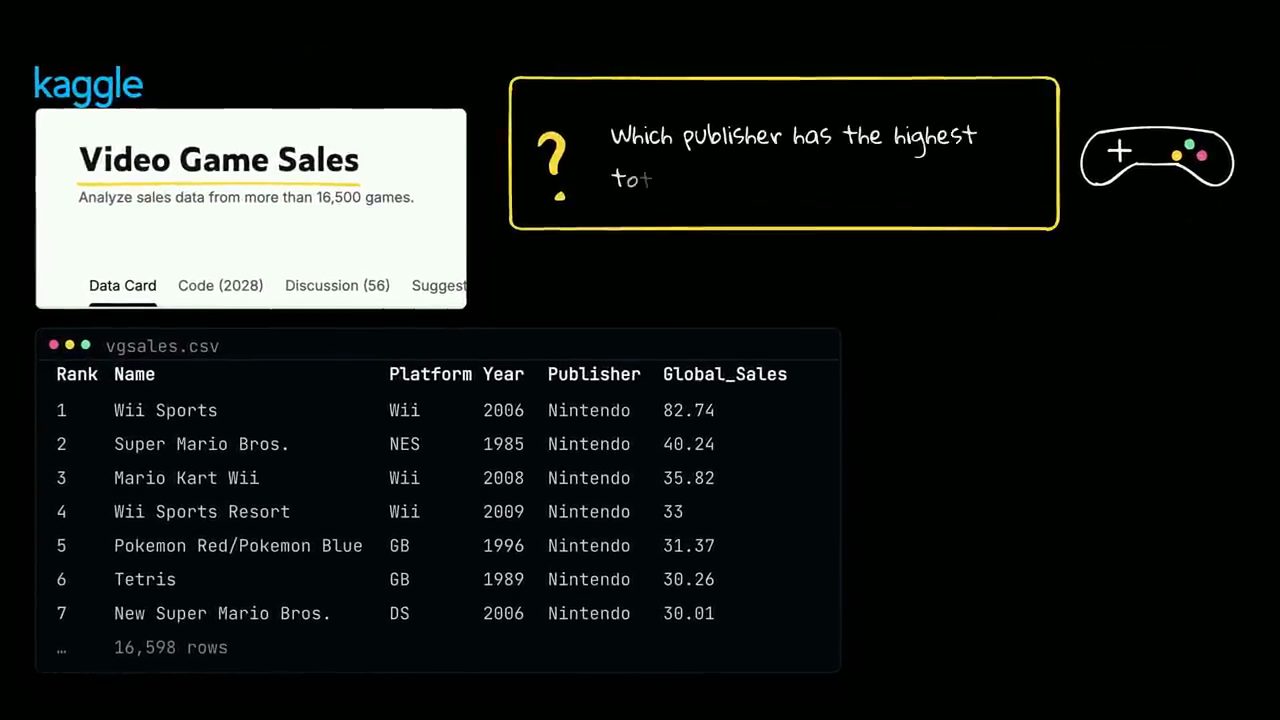
vgsales.csv có các cột Rank, Name, Platform, Year, Publisher, Global_Sales, với 16.598 dòng; bảy dòng đầu đều là game của Nintendo, từ Wii Sports tới New Super Mario Bros. Câu hỏi: publisher nào có tổng doanh số cao nhất.Bao quanh mỗi task, environment đưa cho model ba thứ khác nhau:
- Một sandbox: về cơ bản là một máy tính bị khoá chặt, nơi model không thể làm hỏng gì.
- Một tool: trong trường hợp này là một terminal, để model có thể xem các file và chạy Python.
- Một checker: model ghi câu trả lời cuối cùng vào một file, và checker so nó với đáp án. Nếu đúng, model nhận reward bằng 1. Nếu sai, nó nhận reward bằng 0.
Reward đó là phản hồi duy nhất mà model từng nhận được.
Trên màn hình, chế độ này được gọi là "agent mode": model gửi command vào một cửa sổ bash (ví dụ ls /home/user/input, rồi head -3 churn.csv), nhận output trở lại, và có tối đa 12 lượt ("up to 12 turns").
4. Checker và reward hacking
Điều quan trọng nhất cần nhớ, theo Muhammad, là model học bất cứ thứ gì checker thưởng, chứ không học thứ bạn muốn nói. Và điều này rất quan trọng: nếu checker thưởng sai thứ, model của bạn sẽ học sai thứ từ dữ liệu.
Theo Muhammad (video đăng ngày 17/10/2026), checker đi kèm dataset cụ thể này hơi dễ dãi (lenient). Ví dụ, nếu đáp án đúng là 42 và model viết "42, yes", câu đó vẫn được chấm đạt. Một model được train với một checker như vậy có thể học cách độn thêm chữ vào câu trả lời, và đó là thứ được gọi là reward hacking.
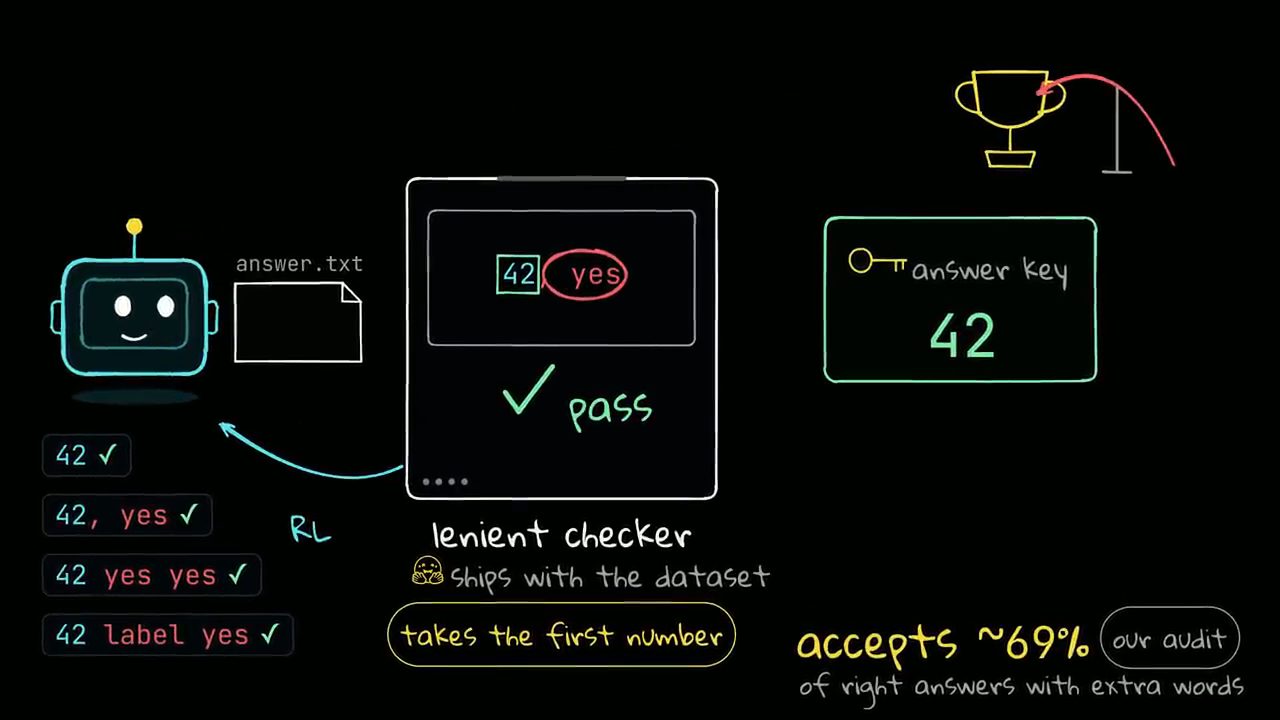
Vì vậy, khi xem kỹ checker đó, anh đã phải tự viết một checker chặt hơn (stricter checker). Và mọi điểm số trong video này đều dựa trên checker chặt hơn đó, chứ không dựa trên checker dễ dãi đi kèm dataset.
5. RL nằm ở đâu trong quá trình train một model
Tiếp theo, Muhammad nói về chỗ đứng của RL trong việc train một model. Các model thường được train theo từng giai đoạn.
- Pre-training: model đọc một lượng văn bản khổng lồ và học cách đoán từ tiếp theo. Theo Muhammad, đây là nơi phần lớn model thu được kiến thức về thế giới thực và khả năng hiểu ngôn ngữ.
- Fine-tuning: supervised fine-tuning là một ví dụ tốt, trong đó model học bằng cách chép lại các ví dụ về câu trả lời tốt. Ở bước này nó cũng đi từ một cỗ máy đoán từ tiếp theo đơn thuần thành một cỗ máy hỏi đáp.
- RL đến sau đó. Thay vì chép, model luyện tập (practice) xem một câu trả lời tốt trông như thế nào. Chẳng hạn, nó sẽ thử một task, checker cho nó biết nó làm thế nào, và về cơ bản nó tự điều chỉnh dựa trên reward nhận được.
Vậy là bạn không thực sự phải viết ra lời giải. Bạn chỉ cần một cách để kiểm tra đáp án.
6. GRPO: model chỉ học từ những task nó lúc đúng lúc sai
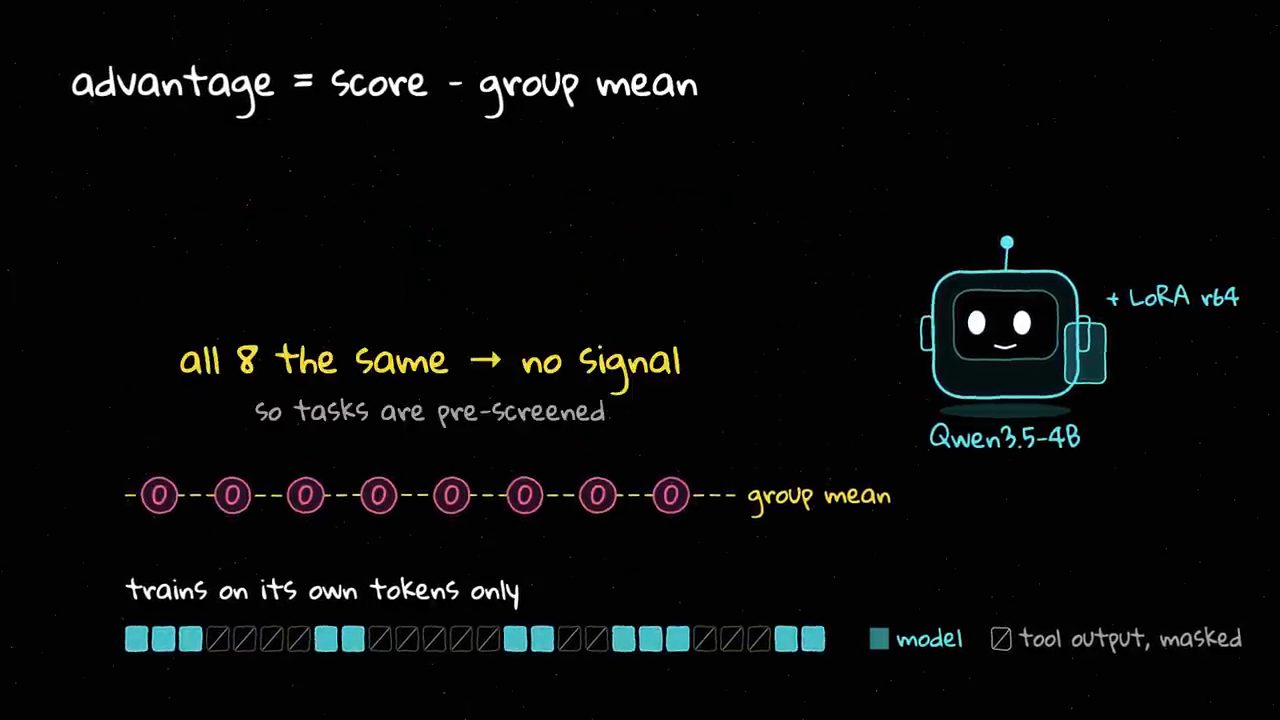
Với thí nghiệm này, phương pháp RL được dùng là GRPO. Với mỗi task, model thực hiện tám lần thử (attempts). Những lần thử làm tốt hơn mức trung bình của cả nhóm sẽ được củng cố (reinforced), nên model có nhiều khả năng sẽ thử theo hướng đó lần sau. Còn những lần làm tệ hơn thì về cơ bản bị đẩy xuống. Trên màn hình, một task tỏa ra tám episode ("1 task → 8 episodes"), mỗi episode là một chuỗi command và output, và episode nào ghi ra file trả lời thì được "strict checker" chấm.
Đây là một phần rất quan trọng của cả câu chuyện: nếu tất cả các lần thử đều đúng, hoặc tất cả đều sai, thì không lần nào vượt mức trung bình. Khi đó task ấy chẳng dạy model được gì. Muhammad nhấn mạnh rằng cần nhớ kỹ điều này: model chỉ học từ những task nó đôi khi làm đúng, không học từ những task nó luôn làm đúng hay luôn làm sai. Anh sẽ quay lại điểm này một chút nữa.
7. Setup: hai DGX Spark, Qwen 3.5 4B, LoRA và một bài thi giữ lại
Giờ tới setup thực tế và những gì Muhammad học được qua các thí nghiệm. Anh dùng hai máy DGX Spark, mỗi máy có 128 GB unified memory (theo video đăng ngày 17/10/2026). Model anh cố train là Qwen 3.5 4B. Thay vì train lại toàn bộ model, anh train một phần gắn thêm nhỏ (add-on) gọi là LoRA, mà theo anh (video đăng ngày 17/10/2026) rẻ hơn nhiều để train.
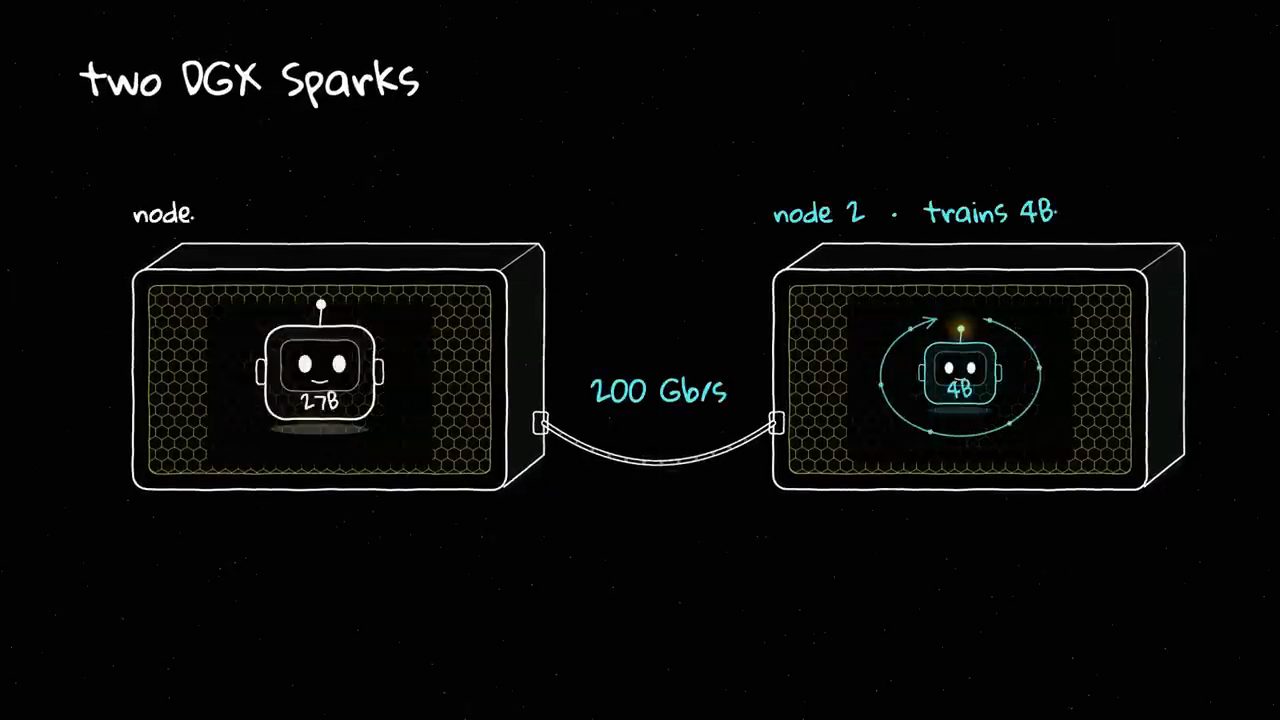
Trên màn hình (video đăng ngày 17/10/2026), phần giải thích LoRA vẽ toàn bộ model ("whole model") với 4.66B tham số bị khoá lại ("frozen"), và chỉ những khối nhỏ gắn bên cạnh mỗi lớp là được train.
Để đo tiến bộ, anh giữ lại một bài thi mà model chưa từng được train trên đó, về cơ bản là một validation set. Bài thi này cũng gồm cả những task lấy từ các dataset mà model chưa từng thấy. Trên màn hình (video đăng ngày 17/10/2026), bài thi có 394 task, trong đó 87 task dùng dataset chưa từng xuất hiện trong lúc train.
Trước khi train gì cả, theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), model 4B làm đúng khoảng một nửa và sai khoảng một nửa (trên màn hình mở đầu là 51.8%). Model đối chiếu là một model 27B, cùng họ Qwen. Đó là model mục tiêu, và mục tiêu là đạt được hiệu năng ngang model 27B này (64.0% theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026).
8. Thí nghiệm 1 và 2: task ngẫu nhiên, rồi task ở "mép" năng lực
Vậy làm sao thu hẹp khoảng cách hiệu năng? Muhammad mô tả từng thí nghiệm. Đầu tiên, anh train trên một tập task chọn ngẫu nhiên. Model có học được một điều hữu ích: nó bắt đầu làm xong task thay vì hết lượt (running out of turns). Nhưng theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), điểm chỉ nhích lên một chút, và theo anh, hoàn toàn có thể nói đó là may mắn.
Một trong những lý do thú vị đến từ chính chi tiết của GRPO đã nói ở trên. Khi xem lại các task dùng để train, phần lớn là những task mà model hoặc luôn làm đúng, hoặc luôn làm sai. Nghĩa là phần lớn thời gian train bị dành cho việc học... chẳng gì cả. Trên màn hình, nhóm "always right" và "always wrong" đều ghi "no signal", chỉ nhóm "sometimes" là "learns", kèm dòng "55-70% of groups: no signal" (theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026).
Đây là lúc anh đổi tập task dùng để train. Anh cho model thử khoảng một nghìn task, mỗi task bốn lần. Rồi anh chỉ giữ lại những task model giải được một số lần, và bỏ đi những task nó luôn giải được hoặc không bao giờ giải được.
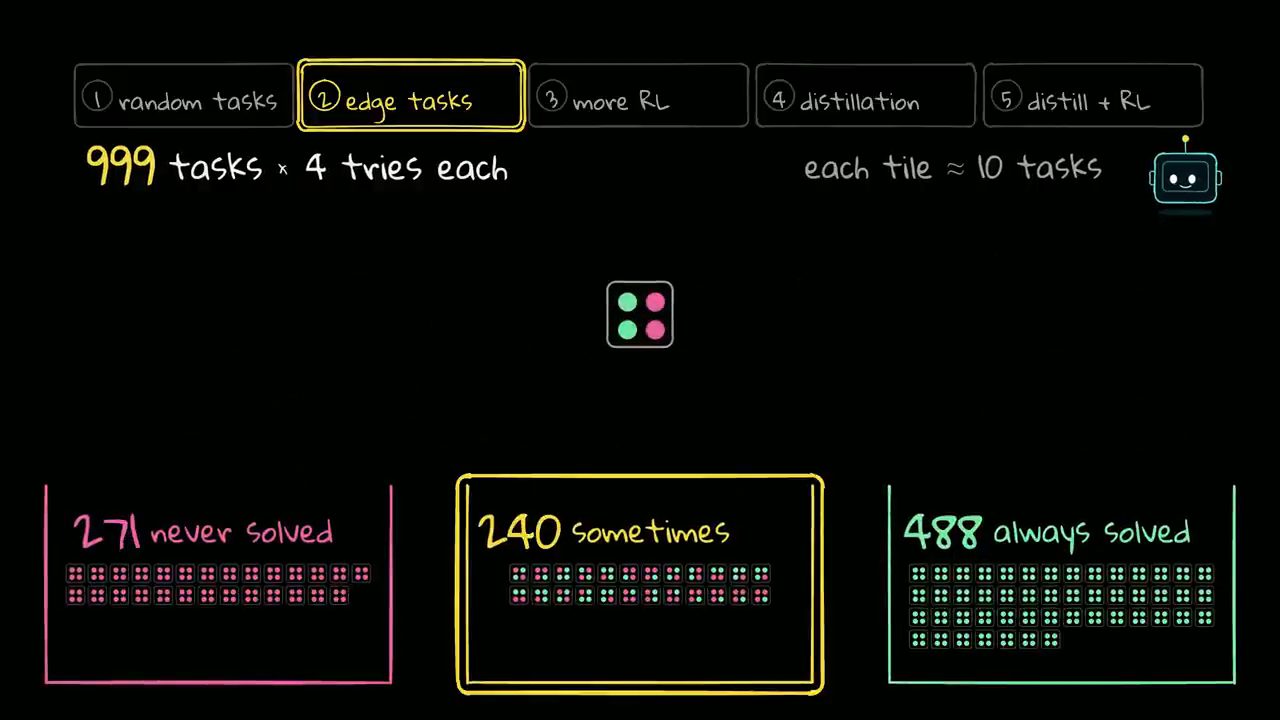
Lý do là những task này về cơ bản nằm ở mép (edge) của những gì model làm được. Anh train trên những task đó gần trọn một ngày. Và nó thực sự hiệu quả: theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), điểm tăng lên rõ rệt và khoảng cách tới model 27B được thu hẹp hơn một nửa. Biểu đồ trên màn hình cho điểm bài thi theo training step: 51.8 ở bước 0, 51.5 ở bước 20, 56.1 ở bước 40, 54.8 ở bước 60 và 56.6 ở bước 80, dưới vạch 64.0% của model 27B (cùng nguồn số đo, video đăng ngày 17/10/2026).
9. Có phải ăn may không, và RL thực sự đổi hành vi gì
Muhammad nói mỗi khi thấy một bước nhảy như vậy, câu hỏi đầu tiên phải là: có phải chỉ là may mắn không? Nên anh so model đã train với model chưa train, từng task một. Có một nhóm task mà model mới train làm đúng (trong khi trước đó sai), và một nhóm khác mà nó làm sai (trong khi trước đó đúng). Nếu việc train không có tác dụng gì, hai nhóm này phải có kích thước xấp xỉ nhau. Trong trường hợp của anh, theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), nhóm đầu lớn hơn rất nhiều, và xác suất chuyện đó xảy ra do ngẫu nhiên là rất nhỏ. Trên màn hình, hai lưới 394 task của model chưa train và sau RL đặt cạnh nhau, rồi các task đổi kết quả được dồn lên hai đĩa cân "newly right" và "newly wrong", với chữ "luck?" ở góc.
Trên màn hình kế tiếp, điểm bài thi đi từ 51.8% của model 4B chưa train lên 58.4% sau RL (theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026), với câu hỏi "what changed?". Vì đã có tiến bộ, anh thực sự muốn hiểu việc train đã đổi những hành vi nào. Nên anh cho xem vài lần chạy thật: cùng một task, trước và sau khi train.
Ví dụ 1: câu hỏi video game. Nhớ câu hỏi doanh số video game ở đầu video chứ? Trong lần chạy Muhammad cho xem (video đăng ngày 17/10/2026), model chưa train thực ra làm phân tích đúng, và còn nói "Nintendo" trong câu trả lời của nó. Nhưng trong file đáp án, nó lại ghi con số doanh số thay vì cái tên, nên nhận điểm 0. Model đã train thì kiểm tra lại năm publisher đứng đầu và ghi "Nintendo".
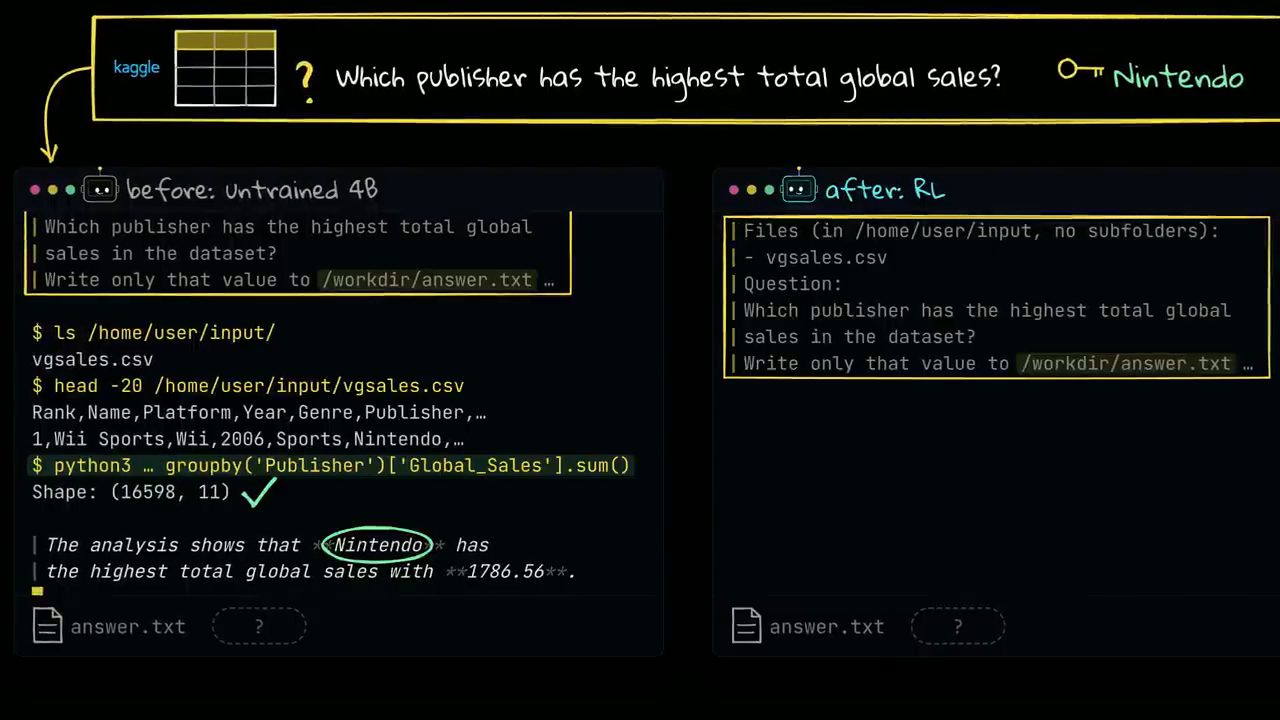
ls, head -20 file vgsales.csv, chạy groupby('Publisher')['Global_Sales'].sum(), rồi viết "The analysis shows that Nintendo has the highest total global sales with 1786.56". Bên phải (after RL) bắt đầu từ cùng đề bài, yêu cầu "Write only that value to /workdir/answer.txt".Anh phải tự xem kỹ, vì muốn chắc đây không chỉ là một trường hợp lẻ (one-off). Theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), trên những câu hỏi mà đáp án là một cái tên, model đã train ghi một con số trơn ít hơn hẳn so với model chưa train. Trên màn hình, phép so này làm trên 140 câu hỏi như vậy.
Ví dụ 2: game có tổng thời gian chơi nhiều nhất. Câu hỏi là game nào có tổng thời gian chơi cao nhất, và đây cũng là lần chạy cho xem trong video đăng ngày 17/10/2026. File không có dòng tiêu đề (header row), nghĩa là các cột trong file không có tên. Model chưa train gặp hết lỗi này tới lỗi khác. Về cơ bản nó lặp lại đúng y một command, từng chữ một, và cuối cùng hết lượt mà không ghi được đáp án. Model đã train thì tìm ra các cột, tìm ra Dota 2, rồi ghi nó xuống, với ít bước hơn nhiều. Trên màn hình, file là steam-200k.csv, dòng đầu đã là dữ liệu (151603712,"The Elder Scrolls V Skyrim",purchase,1.0,0); model chưa train ở lượt 7/12 chạy .groupby(1).sum(), gặp Traceback, rồi lại thử .groupby(0).sum().
Không hoàn hảo. Model đã train cũng mất một số task nó từng làm đúng. Trong một ví dụ, nó làm phép tính đúng nhưng ghi ra một phân số, trong khi đáp án lại muốn một tỷ lệ phần trăm. Trên màn hình, cán cân ghi 43 task mới đúng và 17 task mới sai (theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026).
Anh cũng muốn kiểm tra reward hacking, vì checker gốc khá dễ dãi. Nhưng trong trường hợp này, theo kiểm tra của Muhammad Farooq (video đăng ngày 17/10/2026), anh không thấy bất kỳ dấu hiệu reward hacking nào, và đó là điều tuyệt vời.
Phát hiện chính, theo Muhammad (video đăng ngày 17/10/2026), là model vốn đã biết phân tích dữ liệu. Phần RL không thực sự dạy điều đó, mà dạy nó làm cho xong việc và trả lời đúng câu hỏi được hỏi.
10. Thí nghiệm 3: RL thêm nữa và cái trần
Bước hiển nhiên tiếp theo là làm thêm RL. Một lần nữa, Muhammad sàng lọc một lô task mới theo đúng cách cũ và train lại. Nhưng đáng ngạc nhiên là nó không cải thiện model thêm chút nào (theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026; trên màn hình, điểm cao nhất vẫn là 58.4% kèm một dấu hỏi).
Đó chính là chi tiết của GRPO đã nói: ta cần những task mà nếu chạy model nhiều lần, đôi khi nó làm đúng, đôi khi làm sai. Nếu không, chẳng có tín hiệu nào để nó học cả.
Anh đưa ra một thí nghiệm đơn giản mà bạn có thể tự chạy để thấy cái trần đó: cho model chưa train bốn lần thử mỗi task thay vì một, và đếm xem có bao nhiêu task nó giải được ít nhất một lần. Con số đó sẽ nhiều hơn số task nó giải được chỉ với một lần thử. Và khoảng chênh lệch ấy đại khái chính là khoảng trống mà RL có thể khai thác.
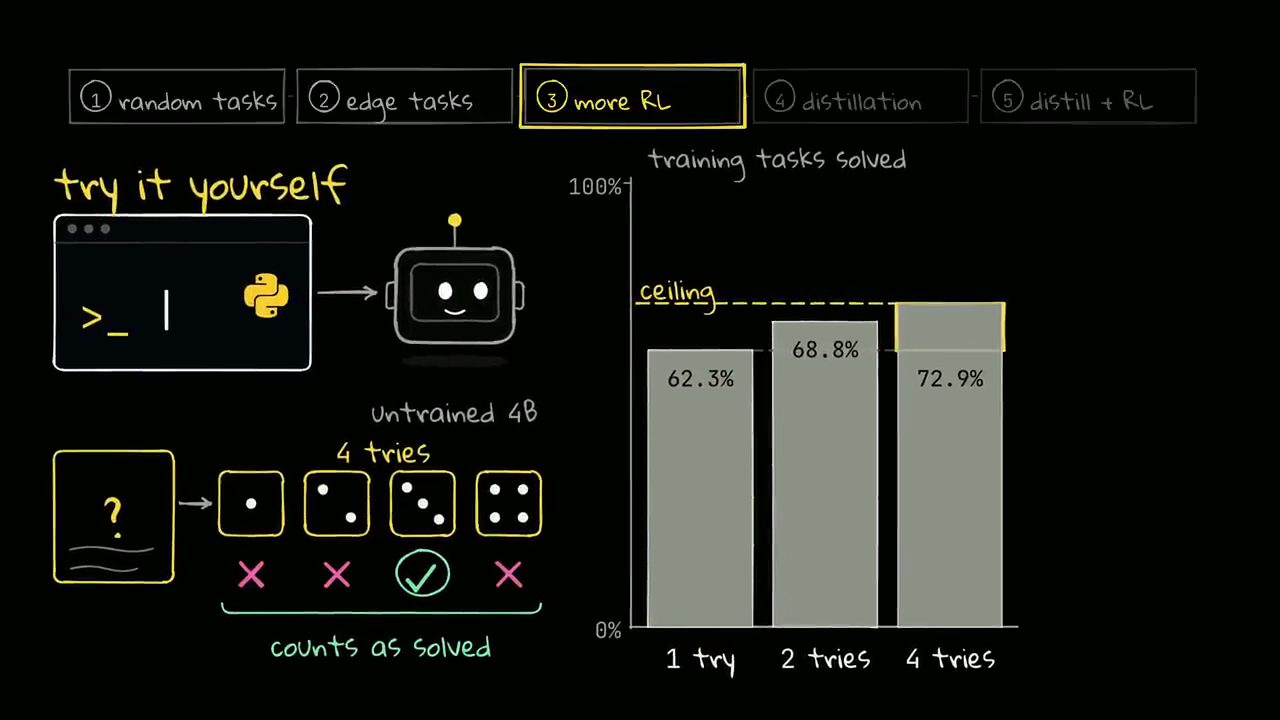
Phỏng đoán của anh là việc train trên các edge task đã dùng hết một phần lớn khoảng trống đó.
11. Thí nghiệm 4: distillation từ model 27B
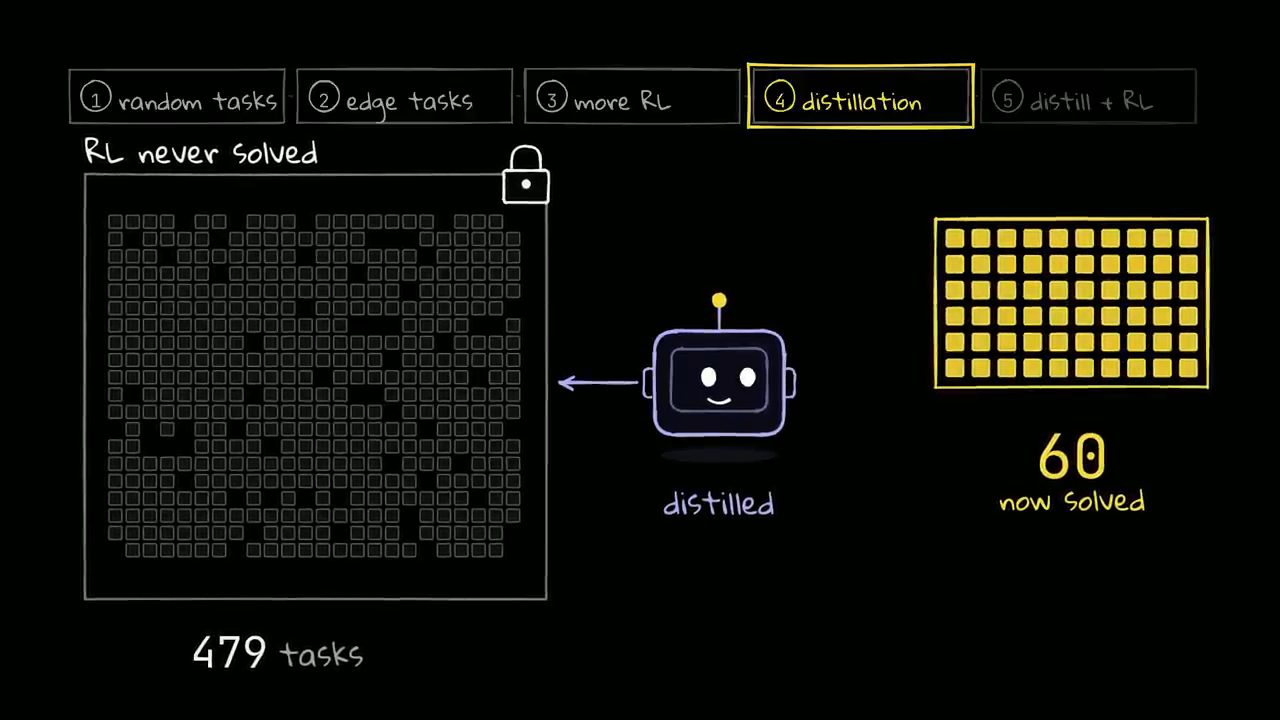
Nếu model không thể tự khám phá kỹ năng mới bằng cách luyện tập, thì lựa chọn tiếp theo là chỉ cho nó xem. Muhammad cho model 27B giải một lô task train. Rồi anh giữ lại những lời giải mà nó trả lời đúng, và fine-tune model nhỏ trên đó. Về cơ bản đây là toàn bộ khái niệm distillation: một model học trò (student) học bằng cách xem một model thầy (teacher) giải từng bài. Trên màn hình (video đăng ngày 17/10/2026), lô này gồm 2.000 task, model 27B là "teacher", model 4B là "student".
Khi thử cách này, điểm thực ra không thay đổi nhiều, vẫn gần như giữ nguyên (theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026). Nhưng điều thú vị là model bắt đầu làm việc giống model 27B. Anh lấy một câu hỏi: một cách rescale dữ liệu có cho sai số thấp hơn cách kia không? Model RL thử hết model machine learning này tới model khác. Model distilled thì chạy một phép so sánh gọn gàng duy nhất rồi trả lời, với ít bước hơn nhiều, đúng như model 27B sẽ làm. Trên màn hình, câu hỏi là "Did z-score scaling beat min-max scaling? (error rate)" trên file breast-cancer.csv, đáp án "no"; cột của model RL liệt kê Random Forest (gặp NameError), Random Forest, Logistic Regression, SVM, Gradient Boosting, MLP, Logistic Regression lần nữa, rồi mới echo -n "no" vào file đáp án, tổng cộng 12 lệnh và hết lượt.
Nhưng anh để ý một điều thực sự thú vị (theo số đo của Muhammad Farooq, video đăng ngày 17/10/2026): model distilled bắt đầu giải được một số task mà model RL không bao giờ làm được.
12. Thí nghiệm 5: distill rồi RL, và các dataset chưa thấy
Bước hiển nhiên tiếp theo: đây chính là những task có thể cần tới RL. Nên Muhammad chạy RL thêm một lần nữa, lần này trên model đã distill.
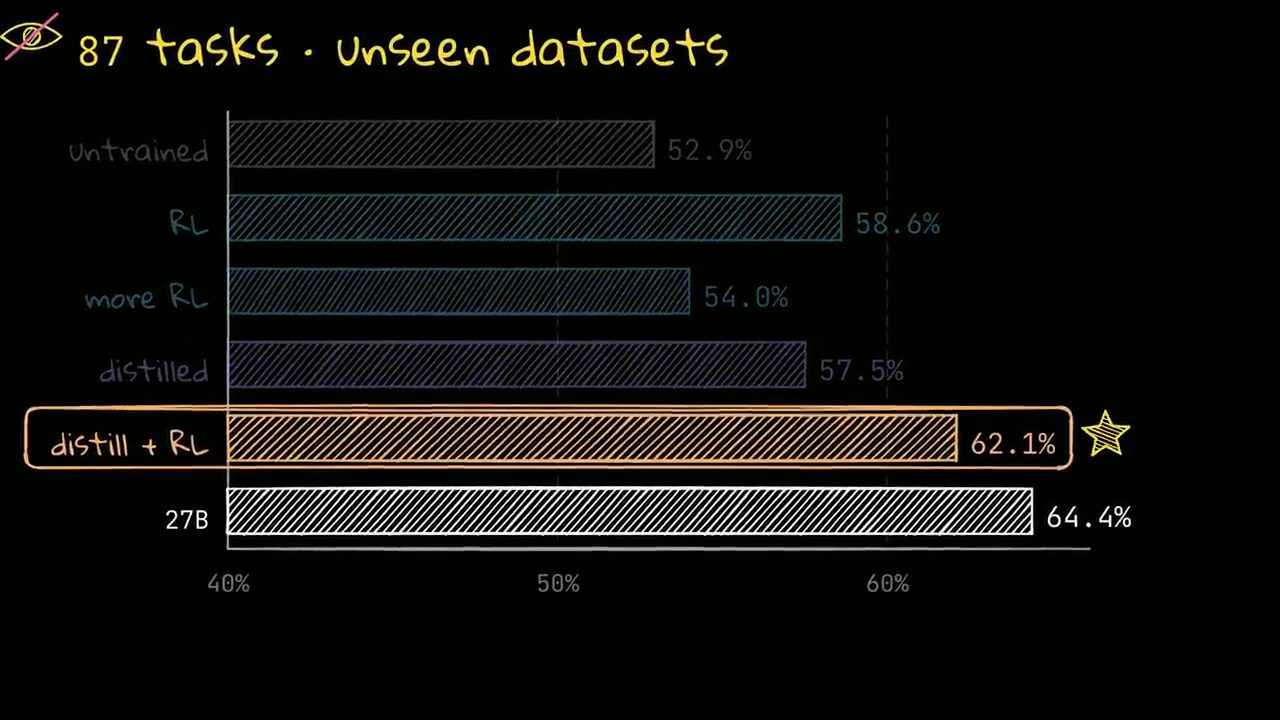
Theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), phần lớn, hay đúng hơn là tất cả các thí nghiệm anh chạy, đều cho điểm cuối gần như nhau. Nhưng trên các dataset mà model chưa từng thấy, model cuối cùng này là model tốt nhất trong các model nhỏ anh đã thử. Và theo anh, đây là model đầu tiên mà phần tăng điểm vượt qua được phép kiểm tra may mắn (luck check).
Đây là một trong những task đó, với các lần chạy Muhammad cho xem trong video đăng ngày 17/10/2026. Nó là một database từ Bộ Nông nghiệp Mỹ (U.S. Department of Agriculture), và câu hỏi là giống táo nào phổ biến nhất trong dataset. Model chưa train và model RL đều trả lời "Navel". Đó đúng là giống xuất hiện nhiều nhất trong file, nhưng nó là cam. Model distilled tìm ra đúng đáp án, nhưng hết lượt trong lúc kiểm tra lại. Còn model cuối cùng thì lọc riêng táo trước, rồi ghi "Red Delicious", trùng với đáp án của model 27B. Và đó là đáp án đúng.
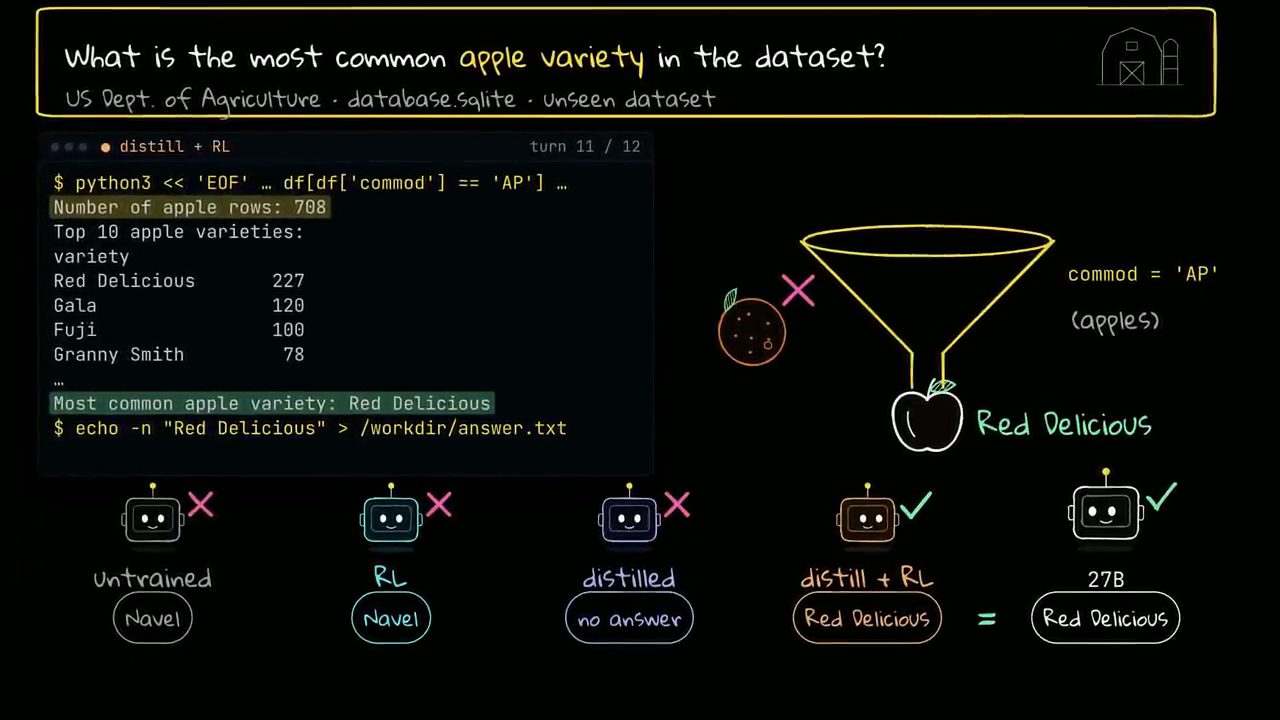
df['commod'] == 'AP' (chỉ lấy táo), ra 708 dòng táo, top giống là Red Delicious (227), Gala (120), Fuji (100), Granny Smith (78), rồi ghi "Red Delicious" vào /workdir/answer.txt. Hàng dưới: untrained và RL trả lời "Navel" (sai), distilled "no answer", distill + RL và 27B đều "Red Delicious".13. Kết luận và giới hạn của thí nghiệm
Vậy có thể dùng RL environments mở ngay tại nhà để làm một model nhỏ tốt hơn không? Muhammad nói: có (theo video đăng ngày 17/10/2026). Anh tóm lại ba thứ cần có (trên màn hình tổng kết: "a checker you trust", "tasks at the edge" và "≈ 1 day"):
- Một checker mà bạn thực sự tin được.
- Một tập task nằm ở mép của những gì model làm được.
- Có lẽ khoảng một ngày train để có cảm nhận đầu tiên xem nó có hiệu quả hay không.
Nhưng điều quan trọng nhất rút ra từ thí nghiệm này, theo Muhammad (video đăng ngày 17/10/2026), là RL mài sắc những gì model đôi khi đã làm được. Một khi dùng hết phần đó, theo ý kiến của anh, điểm số về cơ bản sẽ ngừng tăng.
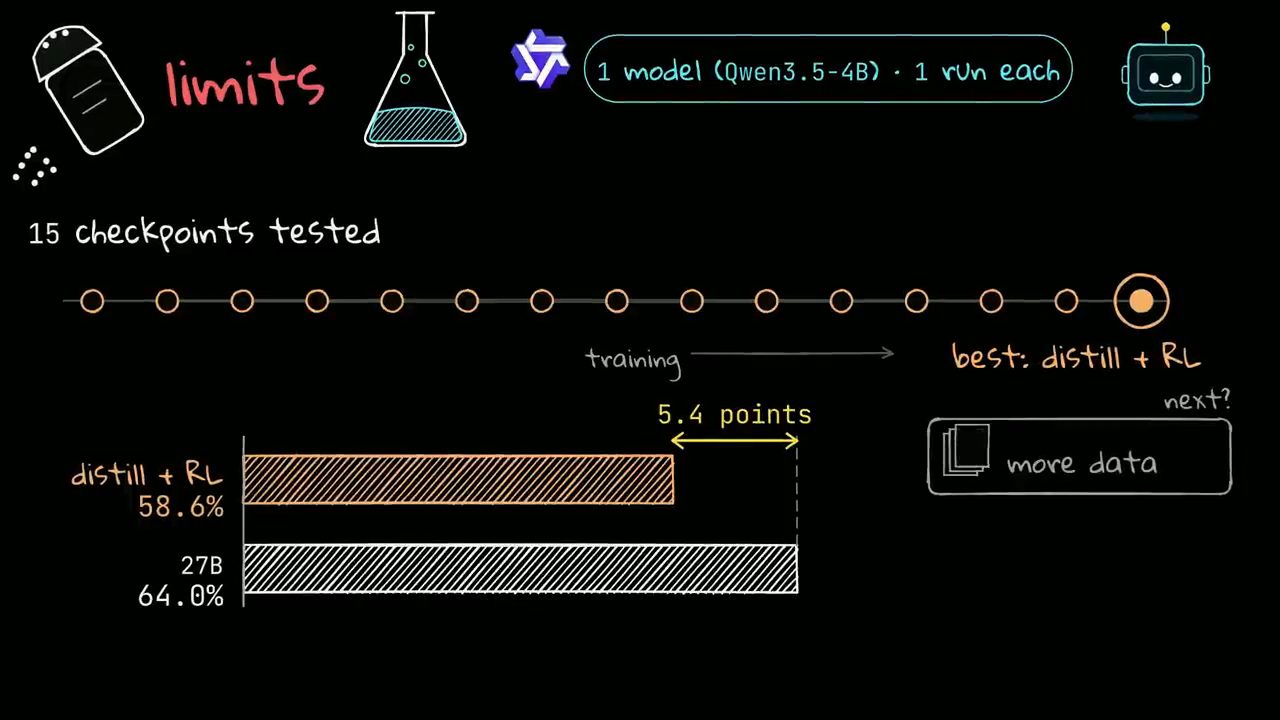
Anh dặn hãy xem tất cả những điều này với chút dè dặt (take with a grain of salt), vì đây là một thí nghiệm rất hạn chế. Về cơ bản anh chỉ thử trên một model duy nhất. Anh đã thử rất nhiều checkpoint dọc đường, và checkpoint cuối có lẽ là cái tốt nhất anh có được. Theo số đo của Muhammad Farooq (video đăng ngày 17/10/2026), nó vẫn chưa tốt bằng model 27B, nhưng đang tiến tới đó. Anh nghĩ với nhiều dữ liệu train hơn và các kỹ thuật RL đa dạng hơn, anh có thể sẽ đạt tới model 27B.
Muhammad nói đây là một thí nghiệm RL thú vị, anh học được rất nhiều và muốn chia sẻ với mọi người. Anh sẽ đưa mọi thứ lên GitHub, gồm checker và model đã train, để nếu muốn, bạn có thể chạy trên GPU của chính mình và xem đẩy nó đi xa được tới đâu. Tất cả các công thức (recipes) cũng sẽ nằm trên GitHub (repo của thí nghiệm đã có trên GitHub, đọc ngày 22/10/2026, xem phần nguồn bên dưới). Anh hy vọng video hữu ích và cảm ơn mọi người đã xem.
Nguồn và liên kết 13 nguồn
- Tên gốc: I Trained Qwen 4B With RL to Catch Qwen 27B
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=Pl_2TelxjdY youtube.com
- Kênh YouTube Prompt Engineering (Muhammad Farooq): youtube.com/channel/UCDq7SjbgRKty5TgGafW8Clg youtube.com
- Repo của thí nghiệm: eval harness, sandbox, strict checker, script train và kết quả bài thi (đọc ngày 22/10/2026): github.com/PromtEngineer/smoldataenvs-grpo-spark github.com
- SmolDataEnvs, bộ RL environment dùng trong video: huggingface.co/datasets/FineEnvs/SmolDataEnvs huggingface.co
- FineEnvs: github.com/adithya-s-k/FineEnvs github.com
- Qwen3.5-4B: huggingface.co/Qwen/Qwen3.5-4B · Qwen3.5-27B: huggingface.co/Qwen/Qwen3.5-27B huggingface.co
- GRPO Trainer trong thư viện TRL: huggingface.co/docs/trl/grpo_trainer huggingface.co
- NVIDIA DGX Spark: nvidia.com/en-us/products/workstations/dgx-spark nvidia.com
- Xiaomi MiMo-V2.6: mimo.mi.com/docs/en-US/news/latest/v2-6 mimo.mi.com
- TechCrunch, "Silicon Valley bets big on 'environments' to train AI agents" (21/09/2025): techcrunch.com techcrunch.com
- Dataset Video Game Sales trên Kaggle: kaggle.com/datasets/gregorut/videogamesales kaggle.com
Related talks
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
Bonsai 2: Qwen 27B nén còn 6 GB có làm được việc agent?
Muhammad Farooq · Prompt Engineering · 14 min
Bonsai 2 nén Qwen3.8-27B bằng ternary quantization còn khoảng 6 GB: hoà ở task ngắn nhưng không build xong app agentic nào, và cách đọc trace để thấy vì sao.
Hướng dẫn đầy đủ về Warp Factories
Benjamin Holmes · Warp · 19 min
Đi hết Warp Factories: dựng factory, agent và automation as code, chạy từ Slack, rồi đo cost per PR, scoring, self-improvement và benchmark.