Chọn model bằng chính các PR đã merge: OMP và council of reviewers
Vì sao chọn model quan trọng trên codebase lớn: benchmark bằng PR đã merge, council of reviewers từ ba lab, và khi nào Claude Code là đủ.
✓ Đã duyệt độc lập · cập nhật 30/10/2026 · 16 min
1. Chọn model quan trọng hơn bạn nghĩ
Video mở đầu bằng hai nhận định mạnh của người nói trên kênh exit node (video đăng ngày 30/10/2026): chọn model quan trọng hơn bạn nghĩ, và việc dùng những harness như Claude Code là lý do chính khiến bạn không tiến bộ trên hành trình phát triển phần mềm với AI.
Anh tự giới thiệu (video đăng ngày 30/10/2026) là một software engineer với 15 năm kinh nghiệm, trước đây từng làm director of AI. Anh tự nhận mình là một người lạc quan về AI (AI optimist) và tập trung vào giáo dục software engineering, nhất là trong thế giới AI. Trong video này, anh muốn đào sâu vào lý do vì sao chọn model lại quan trọng, tuỳ theo loại task bạn làm và môi trường công việc bạn đang ở.
Đúng lúc đó, bên ngoài có một tia chớp. Anh nói luôn: chuyện này thật sự quan trọng, đến cả bầu trời cũng đồng ý với anh. Rồi anh bắt đầu vào nội dung.
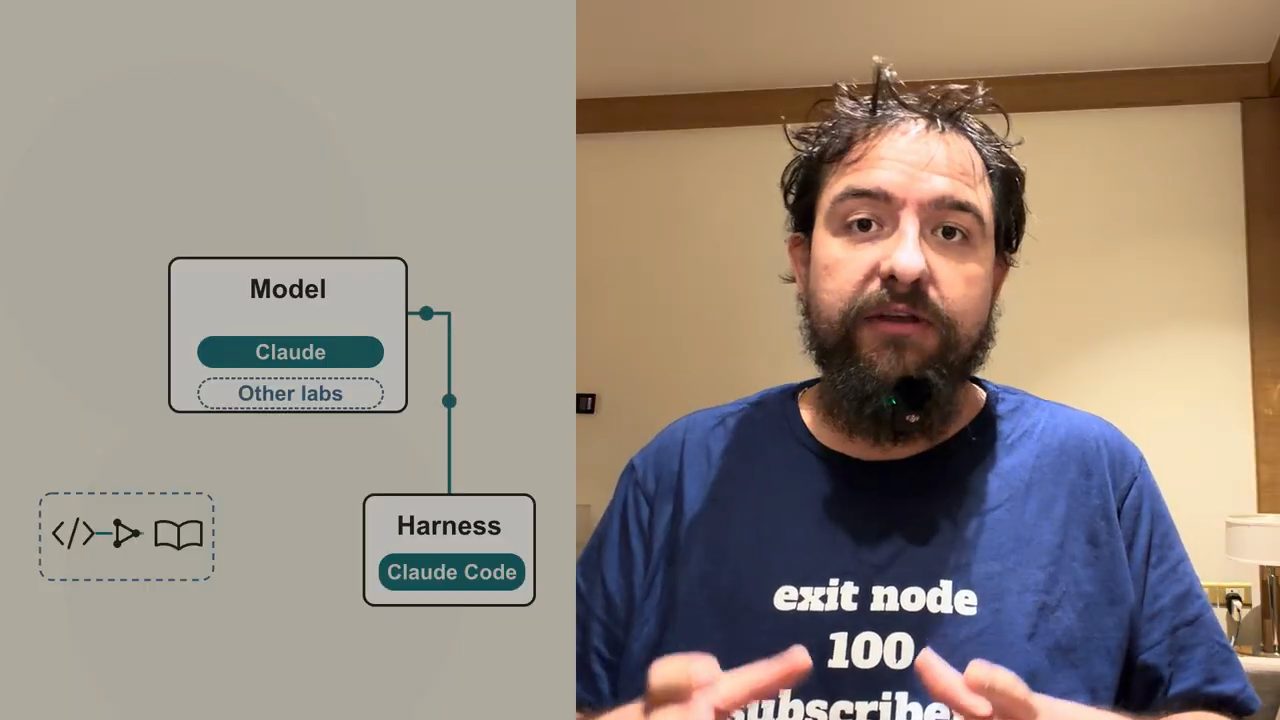
2. Chọn model trong Claude Code, và vì sao anh dùng OMP
Điểm đầu tiên anh nêu: nhiều người không biết rằng bạn có thể chọn model trong Claude Code. Rồi anh nói tiếp ngay: đó là vì bạn không thể, thật đáng tiếc. Theo anh (video đăng ngày 30/10/2026), đây cũng chính là lý do chính khiến Claude Code tệ hại; anh nói mình đã nói điều này từ trước và sẽ giữ quan điểm này đến cùng ("I'm going to die on this hill").
Màn hình lúc này (video đăng ngày 30/10/2026) ghi rõ hơn: trong Claude Code, lệnh /model chỉ cho chọn các model Claude dựng sẵn (Opus, Sonnet, Haiku). Trang tài liệu Model configuration của Claude Code (đọc ngày 30/10/2026) cũng mô tả /model và cờ --model chọn theo alias hoặc tên model Claude.
Thay vào đó, anh mời người xem cân nhắc một harness như OMP (Oh-My-Pi), harness anh ưa dùng. Theo anh (video đăng ngày 30/10/2026), OMP là mã nguồn mở, hoàn toàn mở để bạn sửa theo ý mình. Lợi ích chính của nó so với gần như mọi lựa chọn khác, theo lời anh, là nó "batteries included", đủ đồ dùng ngay như Claude Code, nhưng được xây trên Pi và là mã nguồn mở. README của repo OMP (đọc ngày 30/10/2026) ghi OMP là một fork của Pi.
Nếu cần thêm lý do, anh kể (video đăng ngày 30/10/2026): đội phát triển còn làm một terminal tích hợp đồ hoạ tên là Tern, lúc đó đang ở dạng closed beta hay alpha, gọi sao cũng được; muốn dùng thì phải đăng ký trên website của họ để được mời. Anh gọi nó là tuyệt vời, và nói từ khi có combo OMP với Tern, cuộc sống của anh đã thay đổi hẳn theo hướng tốt hơn.
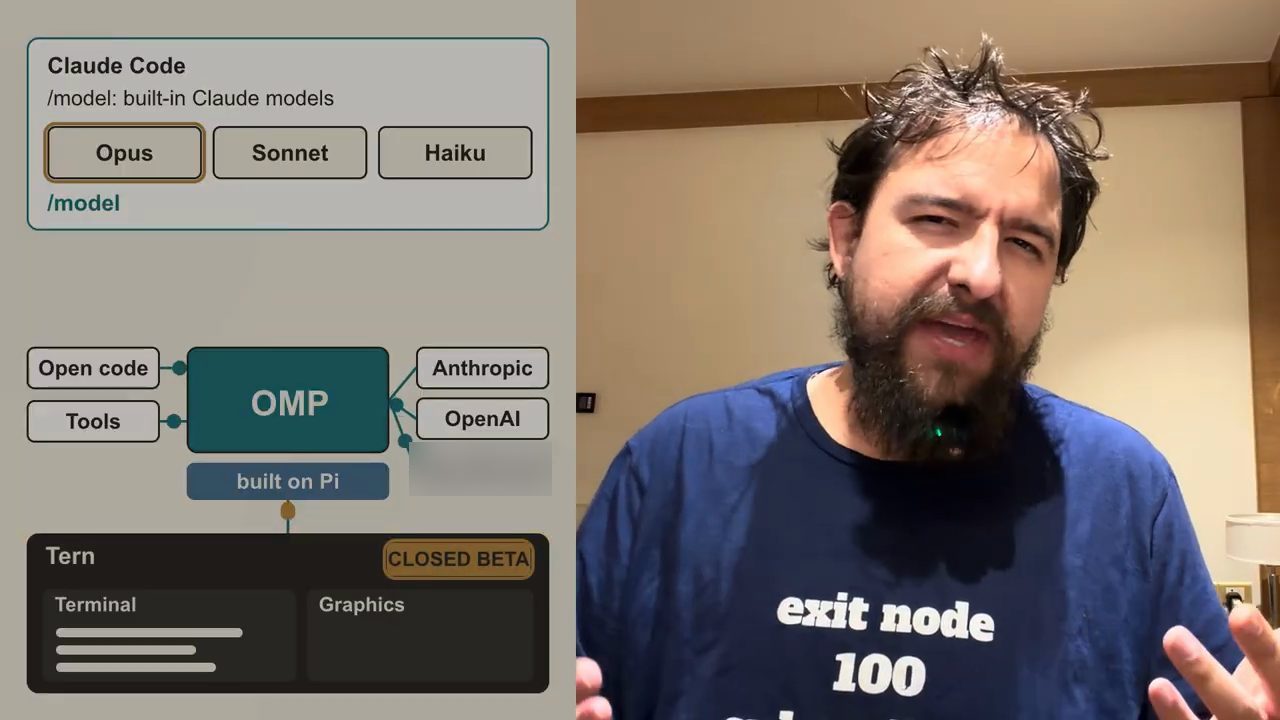
/model chỉ gồm các model Claude dựng sẵn. Phía dưới, OMP nối với "Open code", "Tools" và nhiều nguồn model (Anthropic, OpenAI và một dịch vụ API trung gian cho model), có nhãn "built on Pi"; dưới cùng là Tern với hai phần Terminal và Graphics, gắn nhãn CLOSED BETA.3. Từ thời prompt engineering tới chuyện chọn model
Anh kể (video đăng ngày 30/10/2026) mình đã dùng Claude Code một cách chuyên nghiệp kể từ khi nó ra đời. Trước đó nữa, anh và nhóm đã có những công cụ tương tự chạy local, thời còn làm context engineering, prompt engineering và những thứ kiểu vậy, trong "thời kỳ tăm tối" mà anh nói là, nếu anh nhớ không nhầm, mới năm ngoái thôi.
Nhưng nhìn vào vị trí hiện tại (video đăng ngày 30/10/2026), theo anh công nghệ đã tiến bộ và đi xa đến mức thứ thật sự quan trọng nhất ngày nay, theo ý kiến của anh, là chọn model.
Anh nói Anthropic đã nhiều lần khẳng định rằng các model của Anthropic đủ tốt để nhận một prompt duy nhất rồi tự mình xử lý trọn một task lớn. Anh hứa với người xem rằng điều đó không hoàn toàn đúng (theo anh, video đăng ngày 30/10/2026).
4. Greenfield và codebase lớn, rối
Với dự án greenfield, anh nói (video đăng ngày 30/10/2026): đúng, hoàn toàn được. Bạn có thể làm những thứ đáng kinh ngạc với Opus 5.5 ở mức X High hay đại loại thế, những thứ thật sự choáng ngợp.
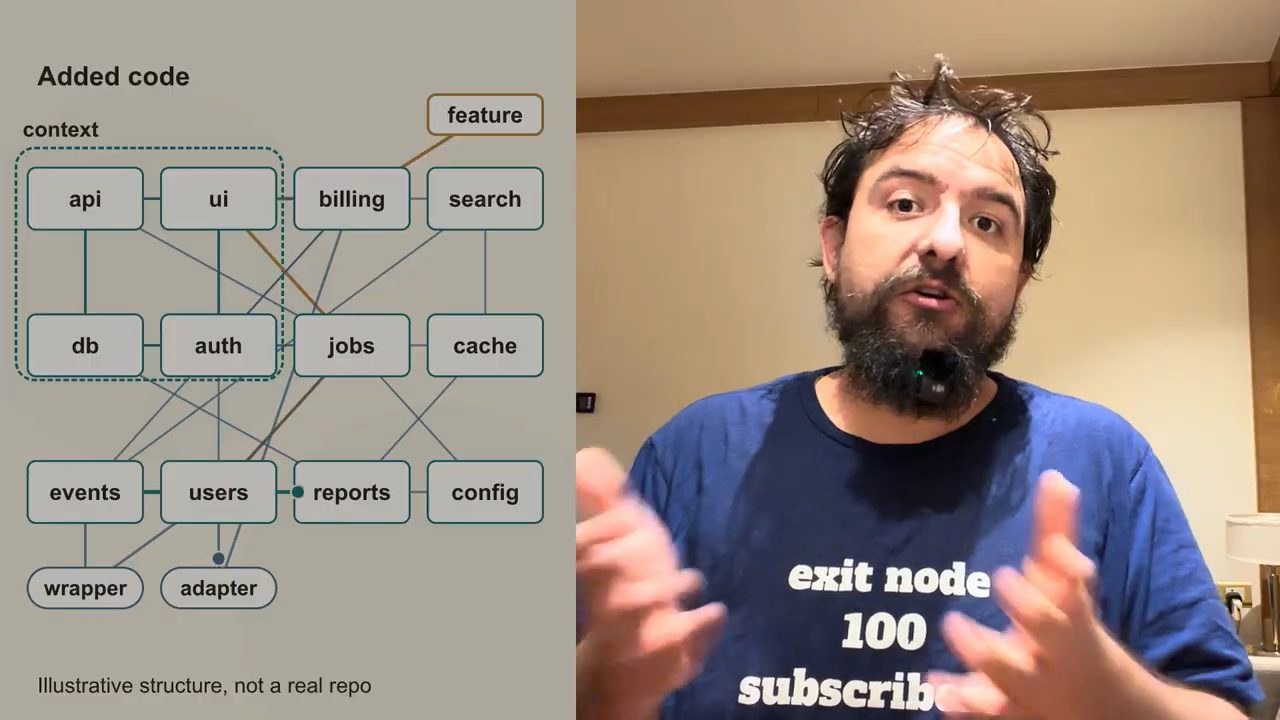
Rồi bạn nạp model đó vào một repository có sẵn, bên trong vượt quá một triệu context token; lý tưởng nhất, anh nói, là thử thách nó thêm chút nữa, vài triệu context token. Sau đó bạn phải làm một feature chạm vào nhiều phần của code, nhất là khi đó là một monorepo có phần tích hợp lỏng lẻo, kiểu code spaghetti. Theo anh (video đăng ngày 30/10/2026), lúc đó model sẽ "vỡ trận" hoàn toàn.
Không chỉ vậy, theo anh, nó còn có khả năng thêm rất nhiều phần phình to (bloat) vào repository để xử lý chỗ bloat có sẵn, vì LLM không giỏi xử lý những mớ hỗn độn lớn hay tự gỡ mình ra khỏi một mớ hỗn độn. Anh nói đó là do cách công nghệ này vận hành bên dưới, và có nhiều nghiên cứu viết về chuyện này. Anh không nắm chi tiết cụ thể, nhưng từ kinh nghiệm, anh biết chắc model muốn sinh thêm code hơn là xoá code (theo anh, video đăng ngày 30/10/2026).
Và theo anh (video đăng ngày 30/10/2026), không skill nào, cũng không cách làm tương tự nào, về cơ bản là prompt engineering hay context engineering, cứu được chuyện này. Anh có vài cách tiếp cận riêng dùng trong công việc của mình và hứa sẽ nói sau.
Quay lại ý chính: chuyện này liên quan gì tới việc chọn model? Theo anh (video đăng ngày 30/10/2026), nó liên quan vì mỗi model xoay xở tốt hơn trong những môi trường khác nhau.
5. Monorepo của anh và benchmark dựng từ những PR khó đã merge
Anh đưa ví dụ từ codebase của mình: một monorepo khổng lồ. Anh nói codebase đang tiến gần mốc khoảng 100.000 dòng code; trên màn hình lúc đó lại ghi "≈700k lines (narrated)". Bạn có thể đoán đó là bao nhiêu token, anh nói: về cơ bản là nhiều triệu token. Monorepo được chia thành microservice. Dù vậy, anh và nhóm vẫn chật vật để thêm feature mới một cách gọn gàng mỗi lần. Phần lớn thời gian thì làm được, nhưng theo anh (video đăng ngày 30/10/2026), điều đó phụ thuộc vào model mà anh và nhóm chọn.
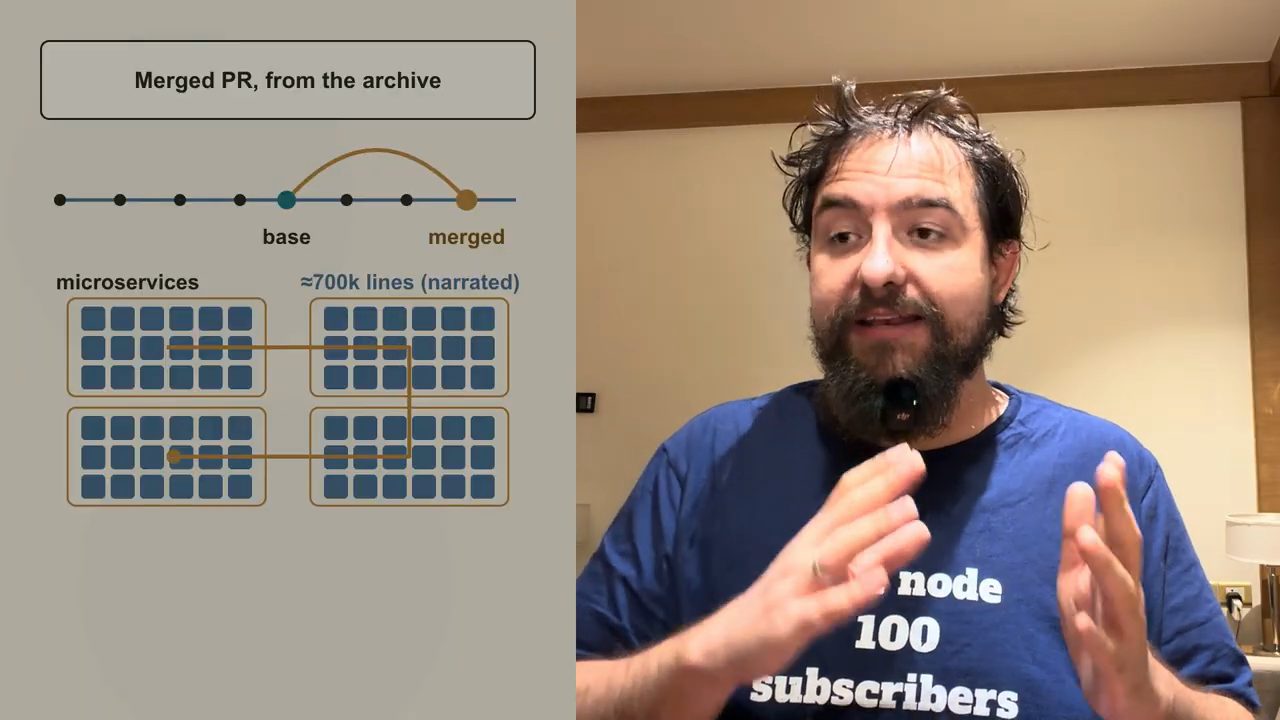
Làm sao anh biết? Vì anh đã tạo một benchmark cho công việc của chính mình và cho công việc của công ty. Cách làm (video đăng ngày 30/10/2026): anh chọn ra một loạt PR đã được chứng minh là cực khó và đã được implement trọn vẹn trong quá khứ. Có PR rất phức tạp về mặt code. Có PR lại phức tạp ở vòng feedback mà nó phải đi qua: từ lúc ticket được viết, PR được tạo, rồi những thay đổi sau review, rồi phải mời những "bộ óc lớn" trong công ty, những người hiểu codebase từ trong ra ngoài.
Phần lớn đó là các product owner chuyên trách từng service. Vậy nên ai cũng phải nhảy vào những PR này. Về cơ bản, đó là loại PR khó nhất: cần rất nhiều chất xám, LLM không đủ, và theo anh (video đăng ngày 30/10/2026) không LLM nào thật sự giải được giùm bạn. Rồi anh dừng lại: "Khoan đã."
6. Một prompt, một ticket: kết quả benchmark của anh
Anh kể về GPT-6.1 Sol (anh gọi tắt là Sol 6.1), model mà theo anh (video đăng ngày 30/10/2026) chắc chắn không còn nằm trong top ba nữa. Anh nói có thể anh sai, nhưng về cơ bản nó không phải số một, và đó mới là điều quan trọng nhất ở đây.
Anh nói khi vào Artificial Analysis, bạn sẽ thấy Opus rồi vài model khác của Anthropic; rồi Kimi giờ đứng thứ hai về intelligence, theo anh nghĩ; còn Sol nằm thấp hơn một chút, anh nghĩ là top bốn, có thể top ba. Anh nói điều đó không quan trọng. Màn hình lúc đó cho thấy một bảng khác với lời anh: "General leaderboard" theo AA Intelligence Index ngày 29/10/2026, lấy setting tốt nhất của mỗi họ model, xếp Gemini 4 Carbon 59, Opus 5.5 58, GPT-6 Astra 57 và GPT-6.1 Sol 55, kèm dòng "Top family leads Sol by 4 points" (video đăng ngày 30/10/2026).
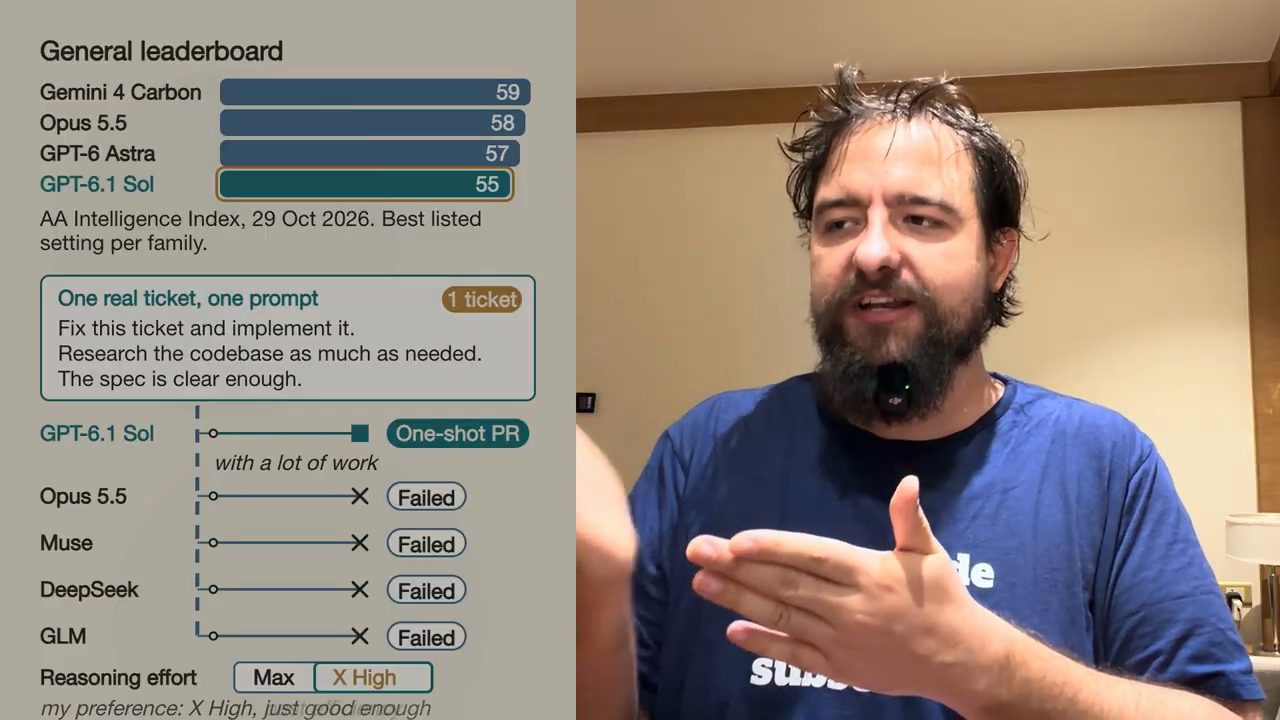
Ý của anh (video đăng ngày 30/10/2026): Sol 6.1, model không đứng số một, lại one-shot được một PR, dù phải làm rất nhiều việc. "One-shot" ở đây nghĩa là anh tạo một prompt cho nó, và đó chính là benchmark: một prompt duy nhất bảo nó đi sửa ticket này, làm phần implementation, nghiên cứu codebase nhiều bao nhiêu tuỳ cần. Spec đã được đưa đủ rõ, và nó đi implement thật. Nội dung prompt trên màn hình:
Fix this ticket and implement it.
Research the codebase as much as needed.
The spec is clear enough.
Trong khi đó, theo kết quả anh kể (video đăng ngày 30/10/2026), Opus đã fail; anh cũng thử với Muse, với DeepSeek, với GLM, và tất cả đều fail. Anh chạy ở mức Max và cả mức X High, vì anh biết có nhiều tranh cãi về việc mức nào tốt hơn. Anh thấy X High nhìn chung là mức effort hiệu quả nhất, vì nói thật là nó làm tốt nhất, và là một mức "vừa đủ tốt" rất dễ chịu.
7. Bảng xếp hạng và phép đo trên code của bạn
Anh nhắc lại: kết quả phụ thuộc vào model bạn chọn, và đây là thứ bạn không thể đánh giá bằng các benchmark mới nhất (video đăng ngày 30/10/2026). Lý tưởng nhất, theo anh, đây là điều bạn muốn tự tìm ra cho loại công việc của mình, codebase của mình, và những loại vấn đề bạn vật lộn nhiều nhất.
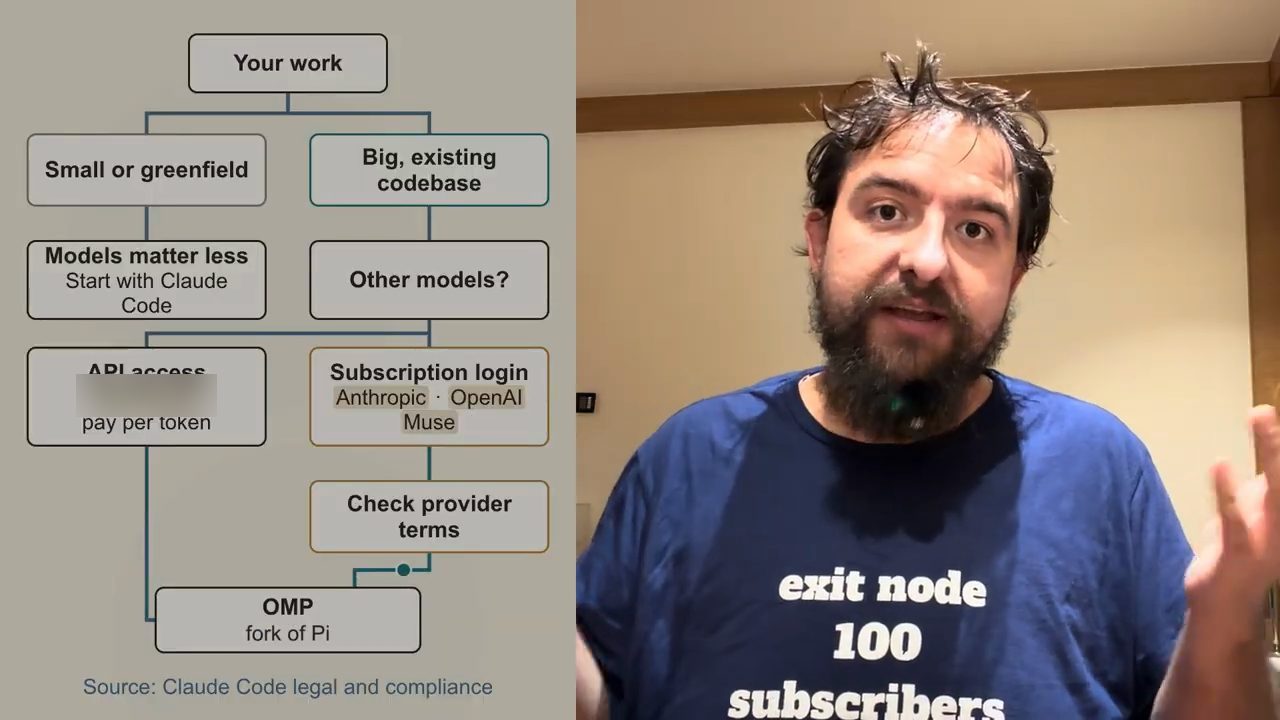
Theo anh (video đăng ngày 30/10/2026), chọn model không thật sự dành cho dự án greenfield. Nếu bạn là hacker, hoặc không làm code chuyên nghiệp, hoặc không phải xử lý những codebase sản phẩm lớn, kể cả codebase lớn do chính bạn tạo ra; có thể bạn là một entrepreneur hay một solo developer. Trong trường hợp đó, nếu bạn làm dự án nhỏ hoặc greenfield, model không thật sự quan trọng. Anh "spoil" luôn: lấy một gói subscription của Anthropic, dùng Claude Code, có lẽ bạn sẽ hài lòng hơn cả mong đợi.
Còn nếu bạn làm trên một codebase lớn, hoặc muốn bắt đầu tìm hiểu các model khác và xem mỗi model mang lại gì, anh nói (video đăng ngày 30/10/2026) bạn sẽ cần đi xem các lựa chọn thay thế.
8. Model của Anthropic ngoài Claude Code
Anh nói Claude Code không cho phép model của mình được dùng trong harness khác, và anh biết điều đó. Theo anh (video đăng ngày 30/10/2026), phía Anthropic dường như cũng biết, nhưng không thật sự thống nhất được giải pháp: anh nghĩ trang support của Anthropic trả lời câu hỏi "có dùng được model của họ trong harness khác không" đã qua hơn bảy hay tám lần sửa, và định nghĩa chính xác cứ thay đổi qua lại.
Trang Legal and compliance của Claude Code (đọc ngày 30/10/2026) ghi rằng đăng nhập OAuth bằng gói subscription dành cho việc dùng thông thường Claude Code và các ứng dụng gốc của Anthropic, còn nhà phát triển làm sản phẩm thì nên dùng API key. Màn hình của anh cũng đặt ô "Check provider terms" ngay dưới nhánh đăng nhập bằng subscription.
Điều anh biết, anh kể (video đăng ngày 30/10/2026), là anh dùng OMP từ khoảng tháng Tám, và đã dùng nó với Anthropic, OpenAI, một dịch vụ API trung gian cho model, và gần đây nhất là Muse. Ba cái (Anthropic, OpenAI, Muse) là subscription, còn dịch vụ trung gian thì trả theo từng token. Anh nói nó tuyệt vời, chạy cực kỳ tốt và anh chưa bao giờ gặp vấn đề gì.
Khi anh còn dùng Pi, Anthropic không phải một lựa chọn, theo anh (video đăng ngày 30/10/2026): Pi không có "phép màu" gì đó mà OMP có, nhưng chuyện là vậy ("that's how the cookie crumbles"). Và nói thật, đó là lý do chính anh thích dùng OMP.
9. Model Trung Quốc và Kimi K3.1
OMP cho anh khả năng trải nghiệm các model Trung Quốc, những model mà theo anh (video đăng ngày 30/10/2026) liên tục "huỷ diệt" các model frontier của Mỹ. Anh tả lại không khí mỗi khi Kimi ra bản mới: "Ôi trời, đây là thứ tốt nhất từng có, Trung Quốc lại làm được rồi", và anh nói đúng là họ làm được thật.
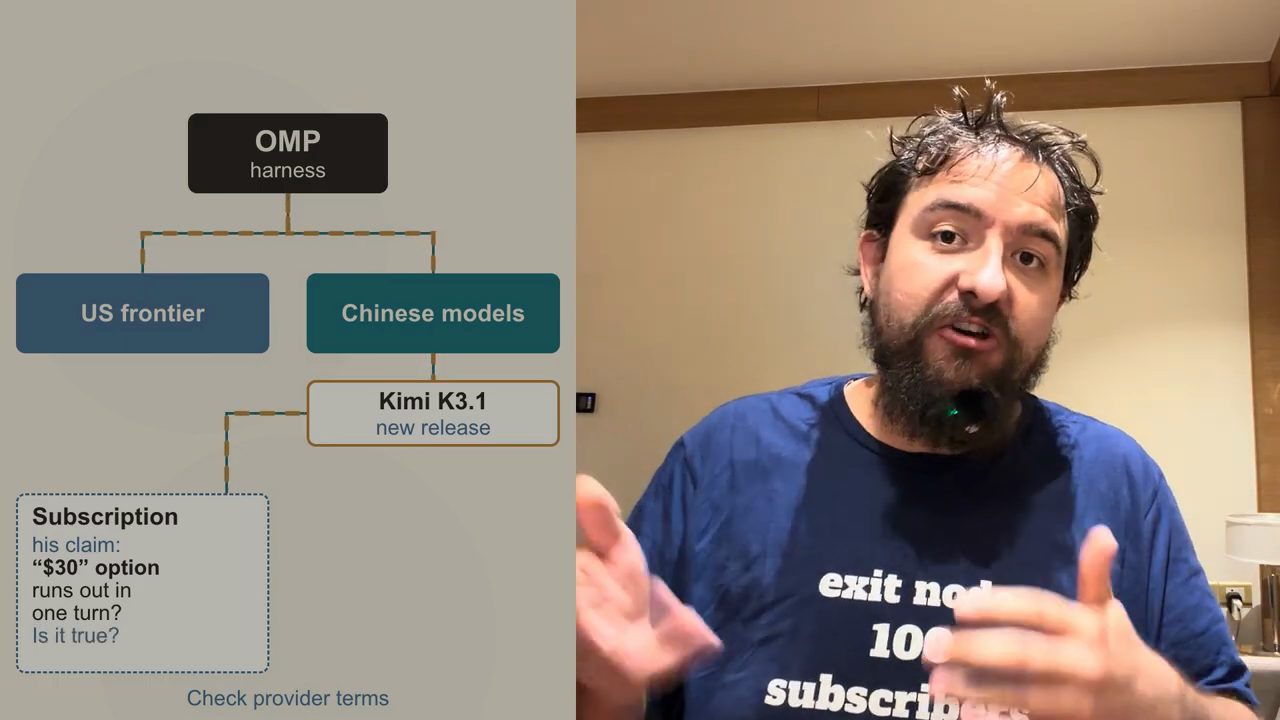
Nhưng theo anh, bạn sẽ không thật sự trải nghiệm được Kimi K3.1, hay họ gọi bản mới nhất là gì cũng được, chỉ bằng cách mua subscription của họ, vì theo anh subscription đó thật lòng là rất tệ: anh nói gói 30 đô hết hạn mức ngay trong một lượt (lời anh kể trong video đăng ngày 30/10/2026). Anh nói đã thấy các bài đăng trên Twitter về chuyện này. Đúng hay không, anh không biết; anh sẽ không đưa tiền cho họ nếu ấn tượng đầu tiên là như vậy, vì có rất nhiều người xác nhận ý kiến đó.
Còn khi thử Kimi K3.1 qua một dịch vụ API trung gian cho model, anh thấy nó tuyệt vời (video đăng ngày 30/10/2026). Nhưng nó đắt khủng khiếp, nên anh sẽ không dùng lại. Dù vậy, anh có quyền lựa chọn, và theo anh đó là điều tuyệt vời ở đây.
10. Council of reviewers: ba model từ ba lab chấm một PR
Một ví dụ khác: gần đây anh hay dựa vào một hội đồng reviewer (council of reviewers), một phần vì nó cho anh lựa chọn dùng các model frontier, và đó là lý do anh dùng model frontier từ nhiều lab khác nhau. Hội đồng ba thành viên của anh lúc này gồm OpenAI, Anthropic và Muse (video đăng ngày 30/10/2026).
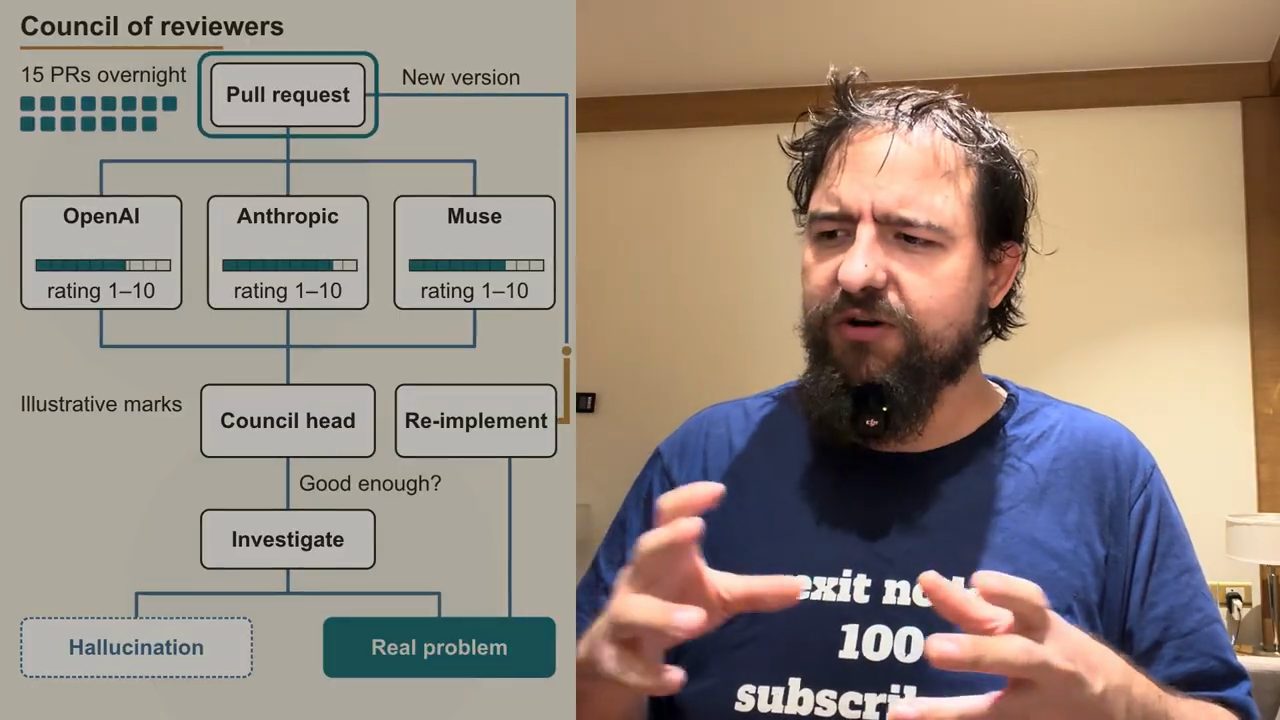
Cách chạy, theo anh (video đăng ngày 30/10/2026): mỗi thành viên đi đánh giá code; anh dùng nó cho code review. Mỗi thành viên chấm PR một điểm từ 1 đến 10, rồi gửi lại cho "council head", gọi sao cũng được: một model điều phối ba model kia. Khi model đó nhận đủ điểm, nó ra quyết định: thế này đã đủ tốt để cho qua chưa, hay cần đi tìm hiểu chuyện gì đã xảy ra?
Ví dụ, tuỳ model nào, nó có thể đã trừ điểm vì một chuyện khá "corner case". Khi đó, theo cách anh mô tả (video đăng ngày 30/10/2026), council head sẽ đi điều tra thêm. Nếu nó thấy đây là vấn đề thật chứ không phải hallucination, theo anh đó là chỗ bạn hưởng lợi từ việc nhiều thành viên hội đồng cùng xác nhận một điều. Và nó cho bạn lựa chọn gửi PR về để implement lại, rồi quay lại hội đồng.
Anh kể (video đăng ngày 30/10/2026) vừa xong một đợt 15 PR cho chạy qua đêm, vì anh có một epic lớn gồm các PR khá "greenfield", tách biệt. Nên anh quyết định thử phiên bản mới toanh của pipeline này; đây không phải phiên bản đầu tiên, mà là phiên bản mới nhất lúc đó. Ý chính, theo anh, là anh liên tục cải tiến, và anh liên tục cải tiến được vì có quyền truy cập các model mới để thử.
11. Harness đóng và model của một lab
Khi công cụ của bạn liên tục bị thay đổi bên dưới, từ phía hậu trường, hay bạn chẳng thật sự biết chuyện gì đang xảy ra, theo anh (video đăng ngày 30/10/2026) bạn mất đi rất nhiều sự tinh tế, mất kết nối với thực tế. Và bạn chỉ còn cách tự đánh giá các model, mà trong trường hợp này, bạn sẽ chỉ đánh giá model của Anthropic.
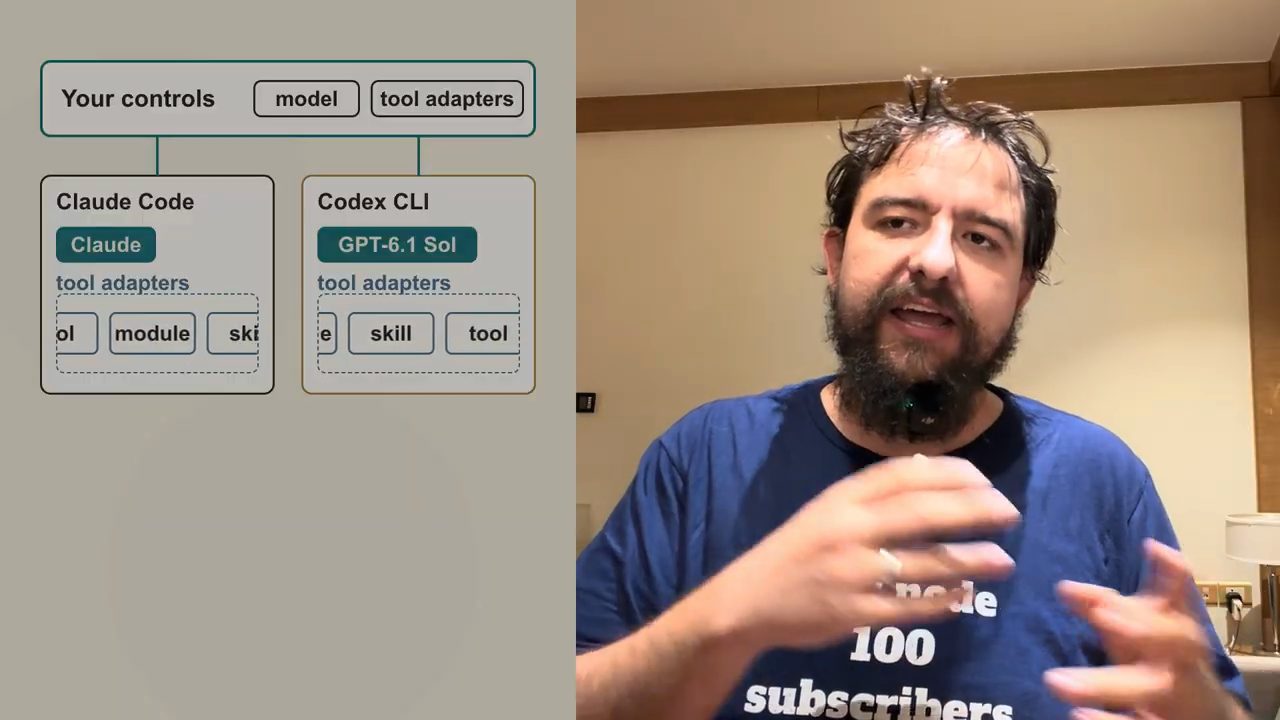
Còn nếu muốn dùng một model của OpenAI, ví dụ Sol 6.1 mà anh gọi lại là tuyệt vời, bạn sẽ phải sang Codex CLI. Ở đó bạn có thể ghép các skill và tool của Claude Code sang, nhưng theo anh (video đăng ngày 30/10/2026) khi chạy trên một harness khác thì chúng không còn tốt hay đáng tin cậy như vậy. Kết quả, theo lời anh, là một mớ hỗn độn.
12. Những benchmark harness anh từng thấy
Anh biết nhiều người nói bạn nên chọn model dựa trên harness đang dùng. Nhưng theo anh (video đăng ngày 30/10/2026), trong tất cả các benchmark anh từng thấy, không cái nào nhắc tới OMP. Lúc nào cũng là Claude Code, Codex và Pi. Pi thì lúc nào cũng thất bại thảm hại, và người ta kết luận: "Đấy, harness mã nguồn mở. Toàn đồ bỏ."
Hoặc một thứ như Hermes, anh nói, "lạy trời": theo anh đó còn không phải một coding harness, đừng chọn nó (video đăng ngày 30/10/2026). Nhưng điều anh muốn nói là thế giới có quá nhiều "hương vị", vậy tại sao bạn lại tự giới hạn mình vào chỉ một hương vị?
13. Vì sao anh không chọn Pi
Nếu anh đã thuyết phục được bạn dùng OMP hay một harness khác cho bạn quyền chọn, anh nói mình không biết nên giới thiệu cái nào, vì anh chỉ dùng OMP. Pi có lẽ là một lựa chọn, nhưng theo anh (video đăng ngày 30/10/2026) nó đòi quá nhiều công sức cho từng module riêng mà bạn quyết định tự build và gắn vào.
Anh biết có vài người hâm mộ Pi trong số người xem: anh nói yêu quý họ, cứ tiếp tục theo cách của mình. Còn anh thì thật lòng không theo nổi. Theo anh (video đăng ngày 30/10/2026), quá nhiều thời gian của anh sẽ phải dành cho việc chỉnh Pi, và anh không làm được.
Anh (video đăng ngày 30/10/2026) muốn bớt việc để nhận được nhiều việc hơn, nếu điều đó nghe có lý. Anh không muốn quay lại chỉnh sửa, trong tất cả mọi thứ, chính harness của mình. Đó là vấn đề mà anh rất sẵn lòng giao cho cộng đồng, và khi gặp lỗi thì đóng góp thay đổi cho cộng đồng.
14. Chọn model thế nào: bảng công khai và benchmark tự dựng
Vậy nếu bạn đã chuyển sang rồi, làm sao chọn model? Anh nói (video đăng ngày 30/10/2026) đây là câu hỏi một người xem đã hỏi anh ít nhất 15 lần, và anh nói đã trả lời cả triệu lần, nhưng lần này người đó sẽ được nghe bằng âm thanh, "full HD".
Cách anh chọn model, theo anh (video đăng ngày 30/10/2026): thứ chính là benchmark, cực kỳ quan trọng. Artificial Analysis thì tuyệt. Anh cũng thích một bảng của Theo (T3 Chat), mà anh gọi là một bản tô màu lại rất đẹp của Artificial Analysis. Nhưng như anh đã nói, Artificial Analysis không cho bạn bức tranh đầy đủ.
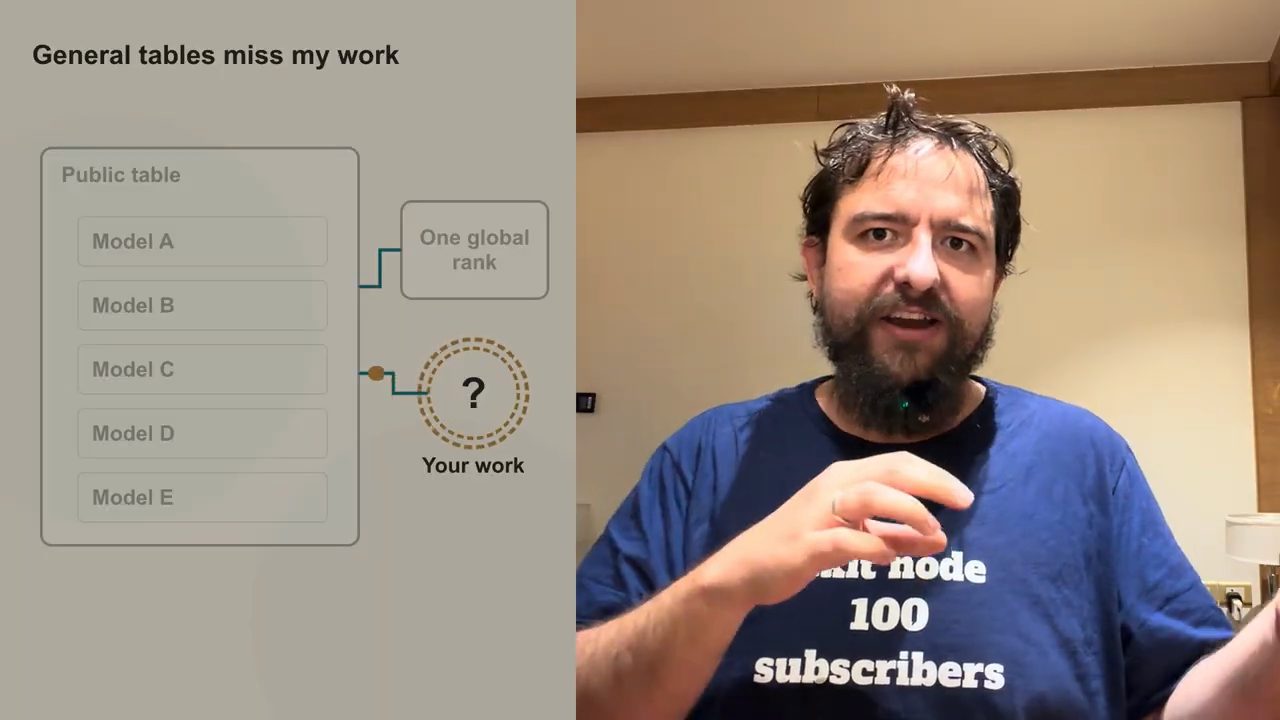
Thứ cho bạn bức tranh đầy đủ hơn cho công việc bạn đang làm, theo anh (video đăng ngày 30/10/2026), là tự tạo benchmark của mình ở local, lý tưởng nhất là trên những việc bạn đã merge trước đây: tức là công việc đã được review thành công và merge vào production. Đó sẽ là một benchmark rất tốt, một kết quả kiểu ground truth, khách quan, để bạn săn tìm trong các model mới liên tục ra mắt.
Anh biết nhiều người khác thích tự làm benchmark theo kiểu mô phỏng các nghiên cứu học thuật. Anh nói mình không đủ thông minh cho việc đó, cũng không hề giả vờ là gần đủ thông minh. Nhưng theo anh (video đăng ngày 30/10/2026), một thứ đơn giản như thế này đã giúp anh rất nhiều.
Anh kể (video đăng ngày 30/10/2026) đã rất vui khi dùng Sol 6.1 làm reviewer kể từ khi nó ra. Anh chạy benchmark này ngay tuần đầu tiên model ra mắt và từ đó chưa bỏ model này. Trước đó, anh đã suýt huỷ subscription OpenAI của mình.
15. Mở rộng benchmark sang side project và sở thích
Anh gọi loại benchmark này là thứ "nuôi dưỡng tâm hồn" (soul-feeding). Bạn còn được lợi là có thể thêm vào nó về sau. Và theo anh (video đăng ngày 30/10/2026), đây là một trải nghiệm tuyệt để thật sự suy nghĩ: được rồi, đây là một loại công việc bạn làm; còn side project thì sao? Còn những sở thích mà bạn có thể dùng AI hỗ trợ thì sao?
Anh lấy ví dụ (video đăng ngày 30/10/2026): anh biết nhiều người chơi D&D đang dùng AI trong các chiến dịch của họ, nhất là các dungeon master dùng AI để tạo chiến dịch. Có người dùng AI làm đồ hoạ hay animation cho các trận chạm trán (encounter). Anh thấy điều đó cực kỳ thú vị.
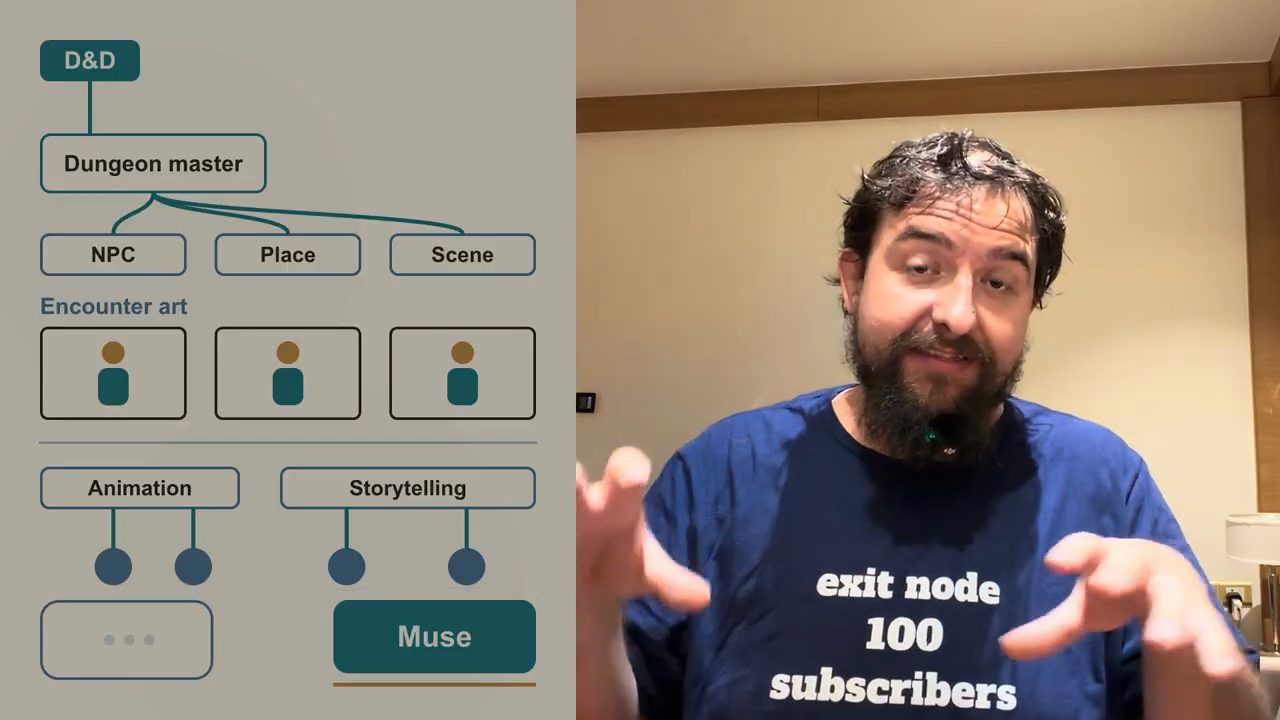
Vấn đề là không phải model nào cũng giỏi animation hay kể chuyện, anh nói (video đăng ngày 30/10/2026). Ví dụ, theo anh, không gì thật sự vượt được cách nói của Muse. Đó là lý do chính anh trả khoảng 50 đô mỗi tháng. Anh yêu Muse như một model để trò chuyện, như model viết lách giùm anh.
Anh nói các video của mình chưa bao giờ có kịch bản, và anh không nghĩ sẽ bao giờ có. Nhưng nếu có, anh sẽ dùng Muse để viết, vì theo anh (video đăng ngày 30/10/2026) nó nghe như một thứ rất riêng, rất độc đáo, một trải nghiệm đẹp. Anh khuyên ai chưa thử thì nên thử, vì theo anh nó thật sự tuyệt vời.
16. So sánh song song cùng một prompt, và clip 15 giây
Một cách nữa để chọn model, theo anh (video đăng ngày 30/10/2026), hiển nhiên là viết prompt rồi so sánh song song: một prompt chạy với model này, rồi ở một session khác bạn chạy cùng prompt đó với model khác, rồi so sánh kết quả. Bạn hoàn toàn làm được việc này.
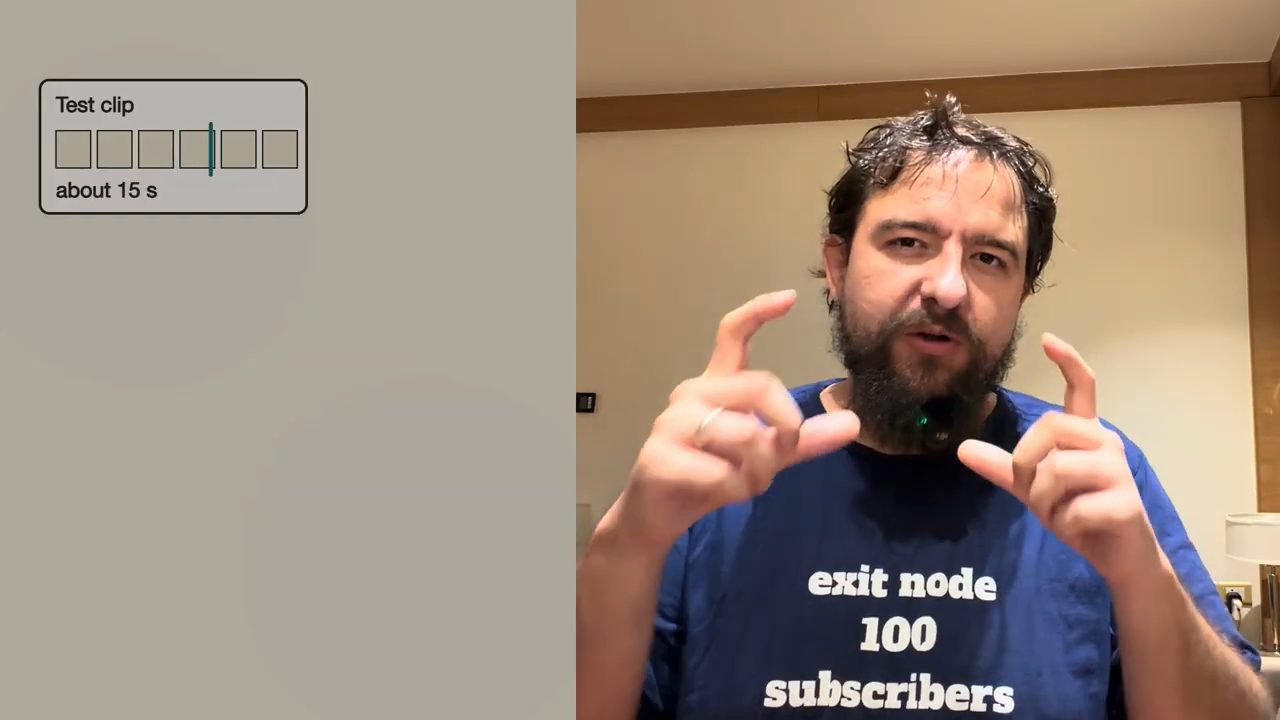
Với anh, đây là cách benchmark anh dùng cho công cụ dựng video của mình (video đăng ngày 30/10/2026): anh có một clip ngắn chứa nhiều lỗi, cho nó chạy qua pipeline với các model khác nhau gắn vào, rồi xem model nào cho kết quả tốt nhất. Theo anh, cách này rất nhanh: clip chỉ khoảng 15 giây, và anh vào xem lại bằng tay.
Như vậy có cách tự động và có cách làm bằng tay, tuỳ bạn muốn gì. Nếu muốn chắc chắn tuyệt đối và an toàn, theo anh (video đăng ngày 30/10/2026), bạn sẽ dùng kết hợp cả hai.
17. Với code: chấm bằng việc PR được nhận nhanh hay không
Với code, anh nói (video đăng ngày 30/10/2026) mình gần như đã thôi đọc code. Anh chưa thoát được hẳn, thật đáng tiếc, nhưng anh cố hết sức. Nên anh không thật sự áp cách so sánh bằng tay này cho các thay đổi liên quan tới code. Thay vào đó, anh đánh giá theo việc PR của anh có được chấp nhận dễ dàng, nhanh chóng, không nhiều phiền phức hay không. Theo anh, điều đó thường có nghĩa là anh đang đi đúng hướng; về cơ bản, đó là chấm theo cảm giác (vibes-based).
Đó là tất cả những gì anh có cho video này. Anh cảm ơn mọi người đã xem và chúc mọi người một ngày tốt lành.
Nguồn và liên kết 8 nguồn
- Tên gốc: I'm Sorry Claude Code, but OMP just works.
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=mVbnPsUORDE youtube.com
- Kênh YouTube exit node (exit node): youtube.com/channel/UCASjrPJfHsvX-0AVz9eSfAQ youtube.com
- OMP (Oh-My-Pi), repo mã nguồn mở; README ghi đây là một fork của Pi (đọc ngày 30/10/2026): github.com/can1357/oh-my-pi github.com
- Pi, harness mà OMP được fork từ đó (đọc ngày 30/10/2026): github.com/earendil-works/pi github.com
- Claude Code, Model configuration: cách chọn model bằng
/modelvà--model(đọc ngày 30/10/2026): code.claude.com/docs/en/model-config code.claude.com - Claude Code, Legal and compliance: mục Authentication and credential use (đọc ngày 30/10/2026): code.claude.com/docs/en/legal-and-compliance code.claude.com
Related talks
Kimi K3.1 Pro trên KingBench 4: gần bằng Opus hay không
AICodeKing · AICodeKing · 14 min
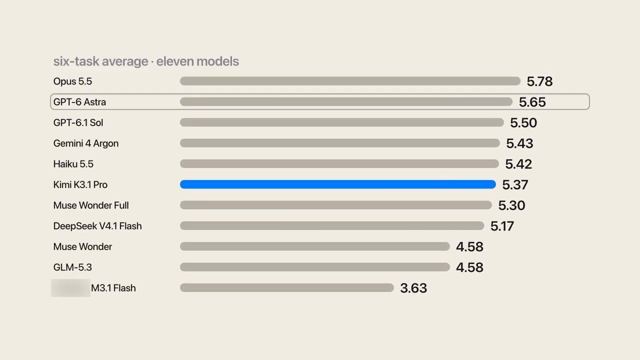
Chạy Kimi K3.1 Pro qua sáu task KingBench 4 bằng PandaCode: điểm từng project, bảng mười một model, chi phí $31.88 và open weights.
Claude Code và Codex: đo thật chi phí và hiệu năng
Nathan Sebhastian · Nathan Sebhastian · 23 min
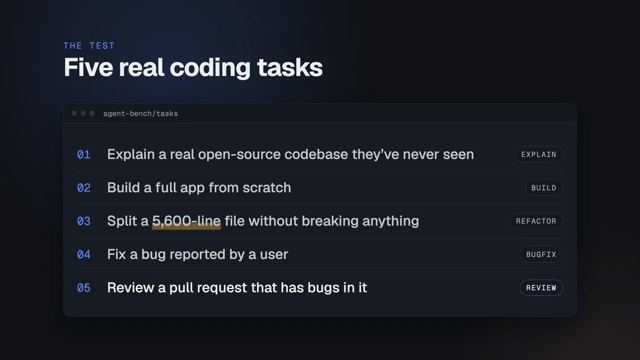
Năm bài test code thật, ba tầng model mỗi bên, 30 lượt chạy: so thời gian, token, chi phí và cách Claude Code với Codex làm việc.
Không cần để laptop mở nữa: Codex giờ chạy trên cloud, trong Slack và cả trên điện thoại
Dominik Kundel · OpenAI · 22 min
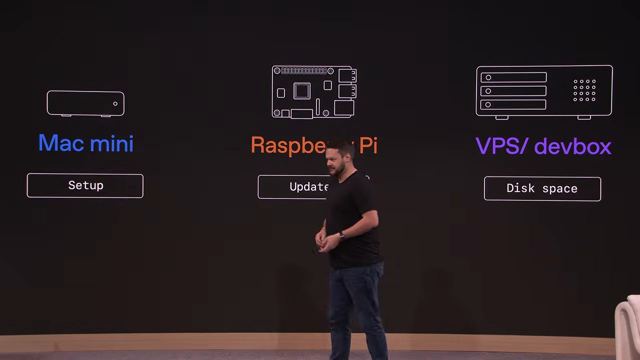
OpenAI đưa Codex lên cloud, vào Slack, Teams, trình duyệt và terminal, để giao việc cho agent ở đâu cũng được mà không phải tự lo máy móc.