12 công cụ, nghiên cứu và demo AI lướt qua khá lặng lẽ
Matt Wolfe xem và thử Simulon, Hy-Nomas, Reshoot 4D, giọng AI Dessa, Haru 4B, Live 3, kính Subvocal, Budget3D, MotionBricks và robot (video 18/11/2026).
✓ Đã duyệt độc lập · cập nhật 18/11/2026 · 29 min
1. Những thứ hay ho lướt qua khá lặng lẽ
Matt Wolfe mở đầu bằng lời hứa sẽ cho mọi người xem một số thứ về AI và công nghệ thú vị nhất mà anh bắt gặp thời gian gần đây (video đăng ngày 18/11/2026). Hôm nay anh không nói về những tin AI lớn nhất, mà về "tất cả những thứ còn lại": những gì anh tìm được trong khoảng một tháng qua, những thứ thật sự hay mà theo lời anh đã kiểu như lướt qua khá lặng lẽ ("kind of flew under the radar").
Anh điểm trước những gì sắp có (theo video đăng ngày 18/11/2026): những world model mới mà theo anh tốt hơn của Google; công nghệ giọng nói AI "điên rồ" mà bạn sẽ thề là giọng người thật, kèm một đoạn chào hỏi ngắn trích từ một demo giọng nói; một cặp kính được cho là đọc được những từ bạn không hề nói ra thành tiếng; một robot có thể bắt quả bóng đang bay trong không trung; một robot biết đi dùng một chiếc điện thoại Android cũ làm bộ não; và, theo lời anh, cả một loạt công nghệ điên rồ khác cho thấy chúng ta thật ra đang sống trong tương lai.
Rồi anh nói hãy bắt đầu với một công nghệ augmented reality mà anh thấy rất hay.
2. Simulon: nhân vật 3D phản ứng với cảnh quay thật
Đoạn clip Dracula mà Matt vừa cho xem đến từ một app điện thoại tên là Simulon (video đăng ngày 18/11/2026). Theo Matt, app này đặt các nhân vật 3D vào căn phòng thật của bạn thông qua camera. Và họ vừa thêm một tính năng: bạn đặt một nhân vật vào cảnh, bấm quay, tự diễn một cảnh, rồi nhân vật thật sự phản ứng với những gì bạn làm và những gì bạn nói.
Matt cho xem một phim ngắn mà Simulon làm ra để kiểu như "show off" những gì app làm được (video đăng ngày 18/11/2026). Trong phim, một người tiền sử đi lại, và ông ta đi qua một khung cảnh thật. Theo lời Matt, những người trong phim là người thật, video là video thật, còn người tiền sử thì được thêm vào sau. Ví dụ, có cảnh người tiền sử nhảy vào một chiếc Uber, tương tác với một chiếc xe thật, đang thật sự đậu ở đó, trong một video thật. Tua tới cuối phim, có thể thấy đây là một clip quay cảnh thật, và chưa từng có gì thật sự ở đó cả.
Tiếp theo là toàn bộ clip Dracula từ nhà sáng lập của Simulon, và theo Matt, clip này bắt đầu chỉ từ một tấm ảnh duy nhất (video đăng ngày 18/11/2026). Chiếc xe điều khiển từ xa là thật, và Dracula cưỡi chiếc xe thật đó chạy ngang mặt bàn. Có thể thấy cả chiếc áo choàng của nhân vật như đang chuyển động, bay phía sau chiếc xe. Rồi khi chiếc xe lao qua mép bàn, nhân vật hoạt hình biết kiểu như nhảy ra chứ không rơi theo xe.
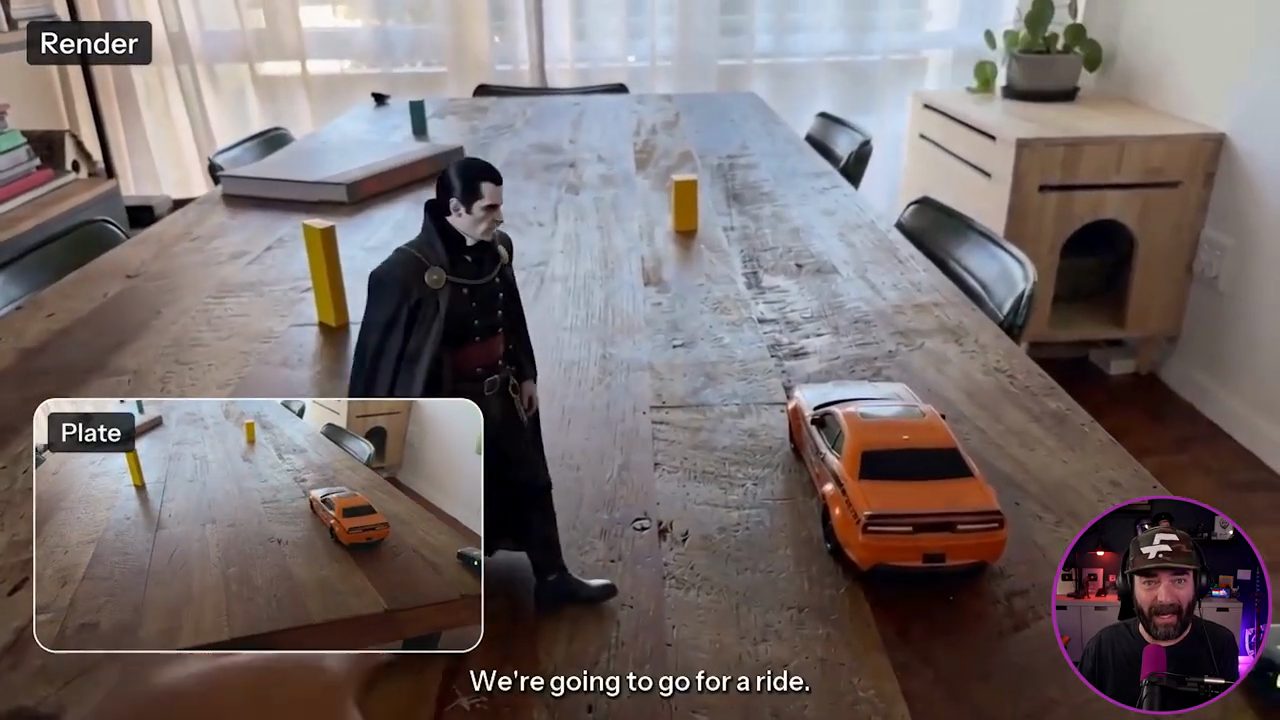
Theo lời Matt, nhà sáng lập nói không có chi tiết nào trong đó được prompt cả (video đăng ngày 18/11/2026). Anh ấy chỉ đặt nhân vật vào thế giới đó rồi lái chiếc xe chạy vòng quanh.
Matt lưu ý rằng không có gì trong số này diễn ra trực tiếp (theo video đăng ngày 18/11/2026). Bạn quay cảnh của mình, và khi bạn dừng, app gửi đoạn quay lên cloud rồi vẽ lại toàn bộ video với nhân vật ở trong đó. Theo anh, app thật sự nhìn vào những gì có trong cảnh, như cái bàn, chiếc xe, bàn tay bạn, những gì bạn nói, rồi dựng một phiên bản mới của cảnh quay từ tất cả thông tin đó.
3. Matt thử Simulon với một con gorilla trên bàn
Matt mở app Simulon trên điện thoại của anh (demo trong video đăng ngày 18/11/2026). Trong app có cả loạt nhân vật để chọn. Bạn cũng có thể thêm nhân vật của riêng mình vào thư viện, nhưng theo lời anh, cái đó đòi bạn nâng cấp gói, còn anh lúc này chỉ đang dùng gói miễn phí.
Anh chọn một con gorilla trắng (demo trong video đăng ngày 18/11/2026). App chuyển sang camera điện thoại của anh, và con gorilla hiện ra kiểu như đang lơ lửng giữa không trung trong văn phòng anh. Anh cần thu nhỏ nó lại, nên anh nắm lấy nó và kéo nhỏ. Thu nhỏ xong, anh đặt nó lên bàn làm việc, thử xoay nó lại ("Come on. There we go."), cho tới khi nó kiểu như quay mặt về phía anh. Nó nằm trên bàn, anh đặt nó cố định ở chỗ đó, và có thể thấy nó cứ như đang sống ở đúng vị trí đó trong augmented reality.
Theo lời Matt, nếu anh quay một video thì về lý thuyết anh có thể tương tác với con gorilla (demo trong video đăng ngày 18/11/2026). Anh có thể kiểu như vuốt ve nó, hoặc cầm cây bút ở bên cạnh lên và chọc nó. Về lý thuyết, trong video của anh, nó sẽ tương tác với bất cứ việc gì anh đang làm. Anh bấm tạo video, và theo lời anh, app báo bản render đang được xử lý, sẽ mất vài phút.
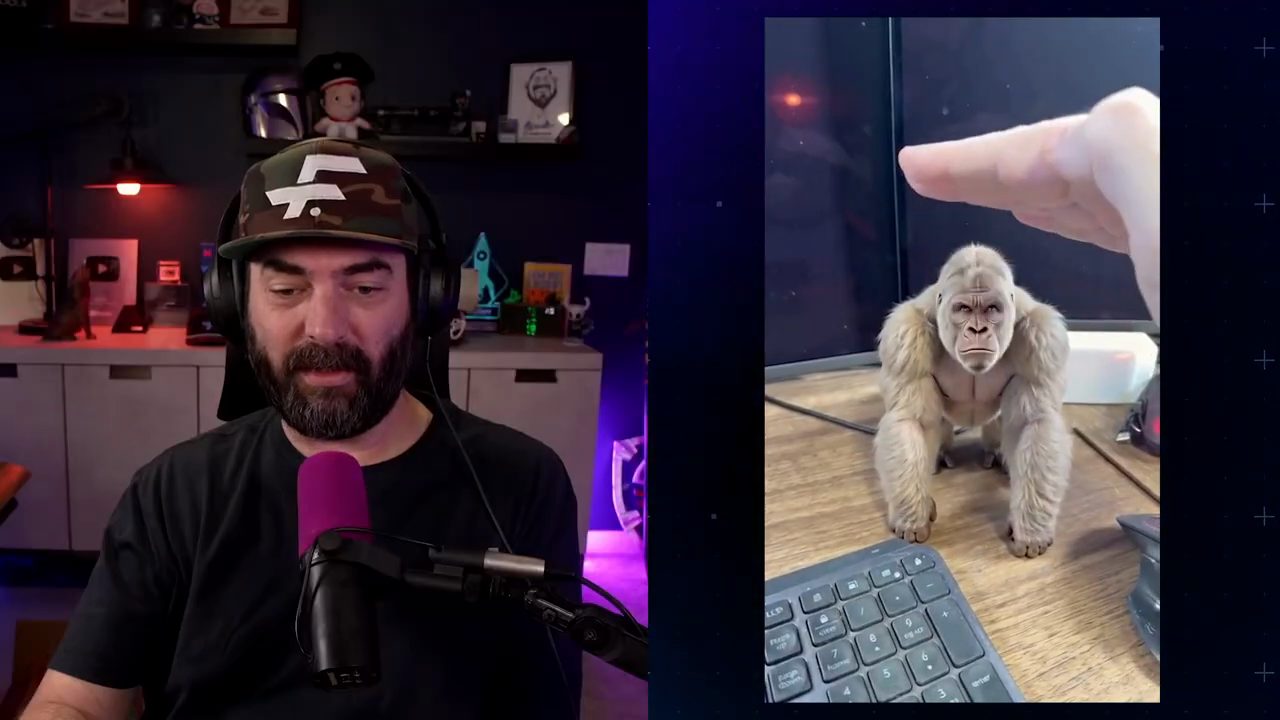
Video trả về có con gorilla trên bàn của anh (demo trong video đăng ngày 18/11/2026). Anh đặt tay xuống, và khi anh đưa tay vuốt nó, có thể thấy nó tương tác với bàn tay anh vừa đặt lên phía trên. Khi anh chọc nó bằng bút, có thể thấy nó tương tác với việc bị chọc, kiểu như gạt cây bút ra. Theo Matt, trông khá hay.
Theo Matt (video đăng ngày 18/11/2026), tính năng phản ứng này, như lúc anh chọc bằng bút và vuốt ve con gorilla, hiện tại chỉ có trên iPhone, và sẽ sớm có trên Android. Bạn có thể dùng thử miễn phí: app cho 100 starter credit, sau đó tốn 15 đô một tháng, và theo lời anh, số starter credit đó hết rất nhanh. Trên trang giá mà Matt mở có gói Simulon Plus 14,99 đô một tháng và Simulon Pro 39,99 đô một tháng, cùng dòng "Try Simulon free" với 100 starter credit dùng một lần (trang hiển thị trong video đăng ngày 18/11/2026).
Theo Matt (video đăng ngày 18/11/2026), nếu bạn có một workflow video mà bạn đang cố đặt thứ gì đó vào môi trường thật của mình, app này có thể khá hay. Anh còn bảo hãy hình dung cảnh này chạy trực tiếp trên một cặp kính AR, vì theo lời anh, nhà sáng lập nói đó là đích mà họ đang hướng tới: họ muốn bạn đeo kính, nhìn thấy những thứ này và tương tác với chúng qua kính. Theo anh, như vậy sẽ khá hay.
4. Hy-Nomas: world model của Tencent mà bạn điều khiển bằng lời
Vừa xem nhân vật được thả vào thế giới thật, Matt chuyển sang một model mà theo anh, Tencent vừa phát hành: model này tạo ra cả một thế giới, và bạn đạo diễn nó bằng cách nói chuyện với nó (video đăng ngày 18/11/2026). Model tên là Hy-Nomas.
Theo Matt (video đăng ngày 18/11/2026), phần lớn AI video hoạt động thế này: bạn viết một prompt, bạn nhận một clip, và nếu muốn khác đi thì bạn làm lại từ đầu. Với Hy-Nomas, video cứ chạy tiếp, và bạn cứ tiếp tục đưa chỉ dẫn. Bạn có thể nói những câu như thêm một con chó, rồi cho tuyết rơi, rồi lia camera sang trái, và theo lời anh, nó vẫn giữ nguyên một thế giới suốt từ đầu đến cuối.
Trong clip Matt cho xem, một phi hành gia nhìn quanh, và khi quay lại, có thể thấy đó vẫn đúng là thế giới mà anh ta thấy lúc ban đầu nhìn về hướng đó (clip trong video đăng ngày 18/11/2026). Theo Matt, một số world model khác đánh mất sự nhất quán đó: nhìn về một hướng, nhìn đi chỗ khác, và khi nhìn lại thì cảnh đã khác. Model này giữ được sự nhất quán đó.
Theo phần Matt giải thích (video đăng ngày 18/11/2026), Hy-Nomas dựng video thành từng mảnh năm giây. Mỗi mảnh mới nhận chỉ dẫn mới nhất của bạn, có thể là text, một chuyển động camera, hoặc cả hai. Và trước khi vẽ bất cứ thứ gì, nó nhìn lại mọi thứ nó đã tạo. Theo anh, chính bộ nhớ đó giữ cho thế giới không thay đổi trước mắt bạn. Và nó có thể chạy tiếp khoảng một phút.
Matt nói có những world model giữ được nhất quán bằng cách để một game engine theo dõi mọi thứ (video đăng ngày 18/11/2026). Model này không có game engine: theo lời anh, chính video model tự nhớ mọi thứ.
5. Matt thử Hy-Nomas: một con kiến trong khu rừng tương lai
Matt vào trang dùng thử Hy-Nomas (demo trong video đăng ngày 18/11/2026). Bạn có thể bắt đầu với một ảnh tham chiếu hoặc không cần ảnh tham chiếu. Bạn chọn được góc nhìn thứ nhất, thứ ba, thứ hai, hay "third person observer". Anh chọn góc nhìn thứ ba. Phần môi trường anh gõ A lush green forest in the future, một khu rừng xanh tươi trong tương lai; phần đối tượng anh chọn a tiny ant, một con kiến nhỏ xíu.
Khi anh vào màn hình mô phỏng, theo lời Matt, có thể thấy nó đã cải thiện đối tượng và khung cảnh anh nhập, thêm rất nhiều chi tiết (demo trong video đăng ngày 18/11/2026). Rồi con kiến nhỏ của anh đi lại trong khu rừng xanh tươi.
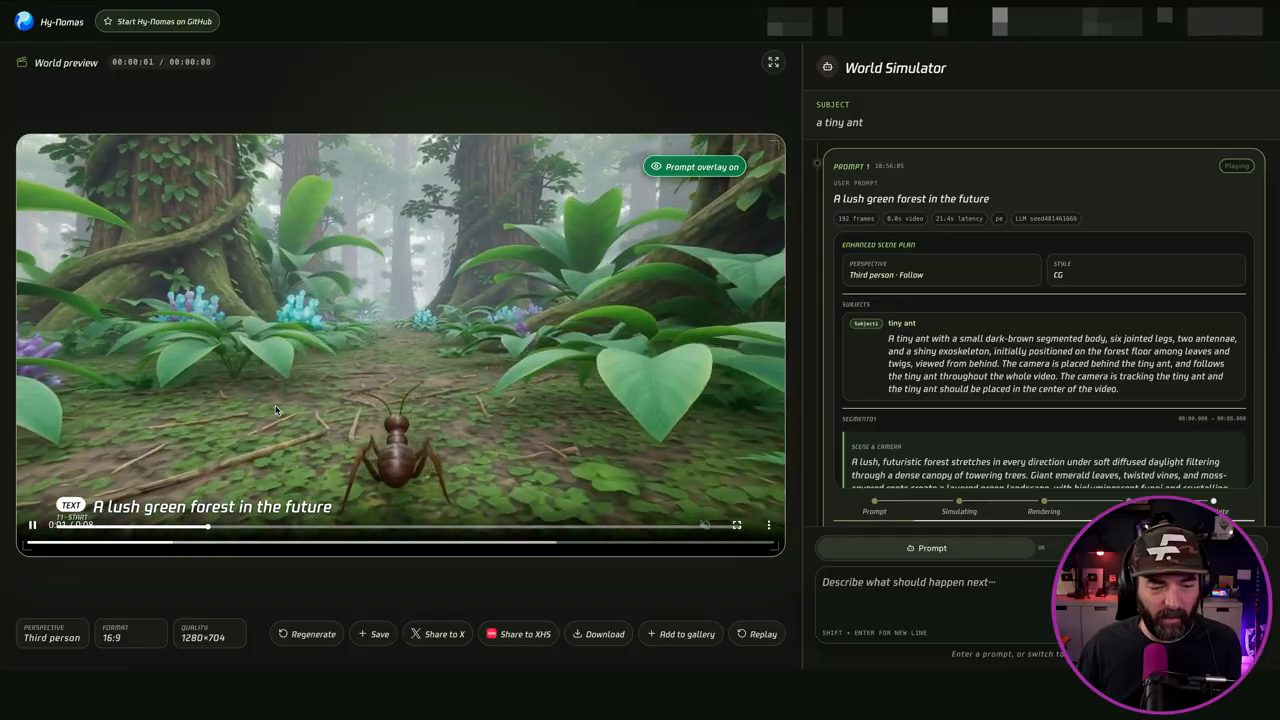
Anh nhập thêm "a deer runs by", một con nai chạy ngang qua (demo trong video đăng ngày 18/11/2026). Theo Matt, mỗi lần làm vậy, nó kiểu như chạy bước mô phỏng xem chuyện gì xảy ra tiếp theo, nên nó kiểu như dựng dần từng lượt, nhưng không diễn ra theo thời gian thực nhiều như một thứ kiểu Genie. Video nối tiếp đúng chỗ nó dừng, và theo lời anh, con nai trông hơi kỳ quặc.
Anh đổi sang điều khiển camera, chỉnh góc nhìn bằng các phím mũi tên và các phím WASD, xoay quanh để thử nhìn kiểu như phía trước của con kiến (demo trong video đăng ngày 18/11/2026). Theo lời anh, hơi khó điều khiển, vì nếu bấm W thì nó đi sang phải, còn bấm A thì lại có cảm giác như đang tiến lên. Anh vẫn cho tạo video từ vị trí camera đó, và kết quả trông hơi kỳ quặc, anh nói thẳng là không nói dối chuyện đó. Nhưng có thể thấy các góc camera thay đổi khá nhiều theo những chuyển động anh đã bấm bằng phím mũi tên lúc trước. Matt tóm lại: không phải kết quả ấn tượng nhất, nhưng rất thú vị.
Vài lưu ý nhanh của Matt về Hy-Nomas (video đăng ngày 18/11/2026): model mở hoàn toàn, code và model đều dùng miễn phí, và bạn còn có thể dùng cho mục đích thương mại nếu muốn. Tencent nói nó chạy được trên một card RTX 4090, nhưng theo Matt, đó là kiểu một phiên bản đã nén, chậm hơn. Cấu hình thời gian thực mà họ thử nghiệm thực ra dùng tám GPU data center. Và Tencent chưa công bố số liệu so sánh nó với các world model khác, nên theo Matt, những tuyên bố về độ nhất quán đến từ kiểu như các demo của chính họ.
Theo Matt (video đăng ngày 18/11/2026), anh hình dung thứ này được dùng khi bạn đang lên kế hoạch cho một cảnh quay: bạn có thể nói chuyện để đi qua một cảnh, prompt những thứ khác nhau bạn muốn thấy trong cảnh, rồi kiểu như phác ra trước khi thật sự đi quay. Theo anh, rõ ràng chất lượng chưa đủ tốt để dùng cho bất kỳ sản phẩm cuối nào. Nhưng thấy các world model mới ra đời vẫn rất hay, nhất là những model đang trở thành open weight và ai cũng dùng được.
6. Reshoot 4D: quay lại video của bạn từ một góc máy mới
Matt nối tiếp (video đăng ngày 18/11/2026): mục vừa rồi di chuyển camera quanh một thế giới do AI bịa ra, còn mục tiếp theo di chuyển camera quanh một video bạn đã quay sẵn. Theo lời anh, ByteDance từng làm việc này với một cảnh phim cũ, nhưng điểm vướng là chưa ai dùng được. Còn thứ này thì theo Matt, bạn tải về được ngay hôm nay. Nó tên là Reshoot 4D: bạn đưa vào một video và quay lại nó từ một góc mới. Bạn có thể bay vòng quanh người trong cảnh, đẩy máy vào gần, cẩu máy lên cao, thậm chí làm kiểu cú "bullet time".
Theo phần Matt giải thích (video đăng ngày 18/11/2026), Reshoot 4D có bốn bước. Thứ nhất, nó dựng một bản capture 3D của cảnh khi cảnh chuyển động theo thời gian, tính ra camera gốc của bạn đặt ở đâu và đối tượng của bạn di chuyển thế nào. Thứ hai, bạn có một camera ảo: bạn đặt nó đi đâu, chọn ống kính, chọn lấy nét, hoặc chọn một preset như orbit hay crane. Thứ ba, nó quay lại cảnh đó từ góc camera mới, và theo lời anh, bước này có tạo ra kiểu những vùng mờ nhòe và artifact kỳ lạ ở hậu cảnh. Nên ở bước bốn, nó dùng một model mở tên là LTX để chạy một lượt hoàn thiện, cho ra trông giống cảnh quay thật và gỡ bớt những chỗ kỳ lạ ở các mép. Trên trang How it works mà Matt mở, bước bốn ghi "Photoreal Pass · LTX 2.3" (trang hiển thị trong video đăng ngày 18/11/2026).
Theo Matt, họ cho bạn dùng thử bản demo của trình chỉnh sửa (demo trong video đăng ngày 18/11/2026). Bạn chưa tải được cảnh quay của riêng mình lên, nhưng có thể xem cách nó hoạt động. Anh mở video có sẵn để chỉnh, chuyển sang chế độ editor view, nơi có thể thấy các đường bay vòng và những thứ khác làm được với nó. Anh nắm camera kéo sang bên này, dời sang chỗ kia, và nói thẳng là anh không thật sự biết mình đang làm gì, cứ thử xem chuyện gì xảy ra. Ở góc dưới bên phải hiện cảnh quay đi qua các vị trí camera đã đặt keyframe. Rồi theo Matt, nó chưa hoàn toàn sẵn sàng.
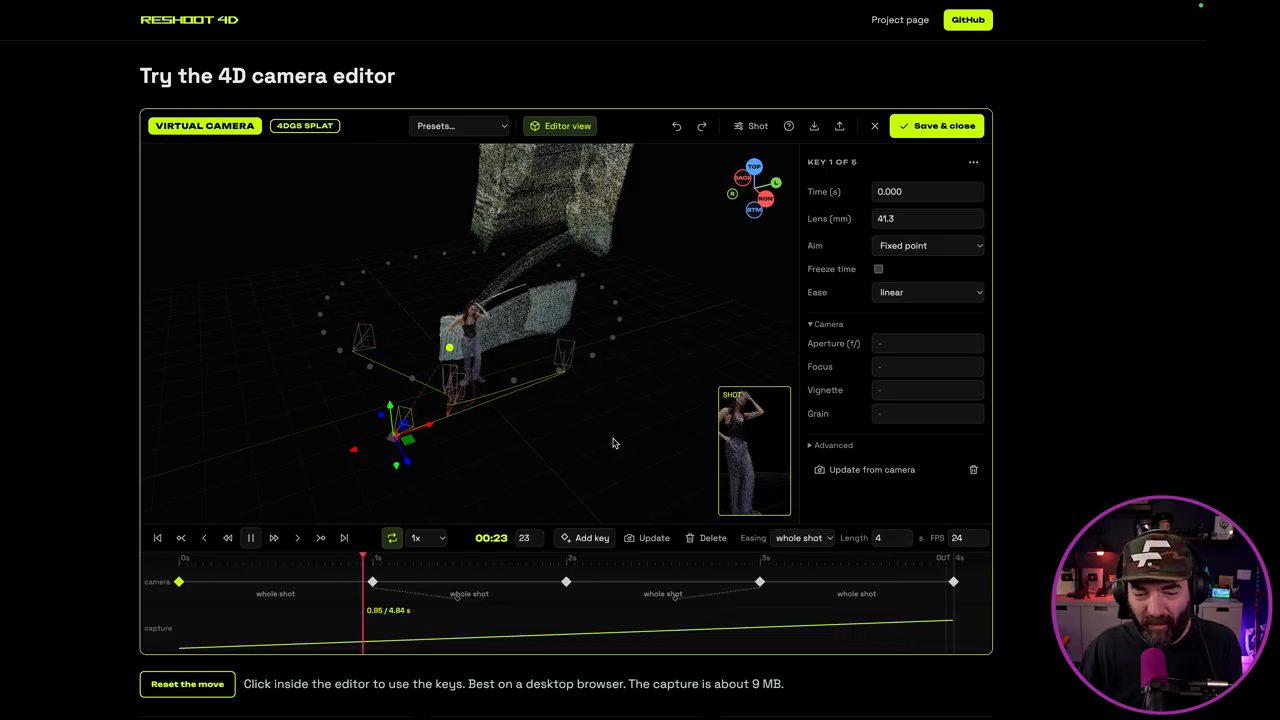
Vài lưu ý khác của Matt (video đăng ngày 18/11/2026): Reshoot 4D không dựng thêm gì mới ở phía sau đối tượng, nên những thứ nằm ngoài khung hình có thể thay đổi từ góc này sang góc khác. Trong một ví dụ, cảnh bên ngoài cửa sổ thay đổi chút ít qua mỗi cảnh quay mới. Họ cũng nói chuyển động nhanh có thể làm nhòe một khuôn mặt trong kiểu vài khung hình, nên theo Matt, hiện tại nếu có nhiều chuyển động nhanh thì kết quả sẽ không đẹp.
Theo Matt (video đăng ngày 18/11/2026), bạn cần cụ thể là một card đồ hoạ NVIDIA, cùng với một chút hiểu biết về cách dùng ComfyUI, mà theo anh, đường học không phải êm nhất. Nhưng nó miễn phí và mã nguồn mở, và được làm bởi một developer, người nói anh ấy đã làm toàn bộ bằng Claude Code và Codex.
7. MoviEdit: sửa một lần, áp lên mọi cảnh quay
Nếu đổi camera vẫn chưa đủ, Matt giới thiệu tiếp một thứ thay đổi chính những gì có trong cảnh quay (video đăng ngày 18/11/2026). Đó là MoviEdit, theo lời anh là một research model của Adobe và một trường đại học ở Hàn Quốc. Bạn gõ một chỉ dẫn, ví dụ xoá người đàn ông mặc bộ đồ chiến thuật màu đen, và nó xoá người đó khỏi mọi cảnh quay trong phân cảnh.
Theo Matt (video đăng ngày 18/11/2026), vấn đề cũ là AI chỉnh sửa video chỉ làm việc với từng cảnh quay một. Bạn đổi áo khoác của một nhân vật, video cắt sang cảnh tiếp theo, và chiếc áo khoác cũ có thể đã quay lại. Với MoviEdit, bạn cũng có thể cho nó thấy bạn muốn gì: sửa một khung hình duy nhất trong Photoshop hay ở bất cứ đâu, và nó mang thay đổi đó đi suốt cả clip, qua mọi đoạn cắt.
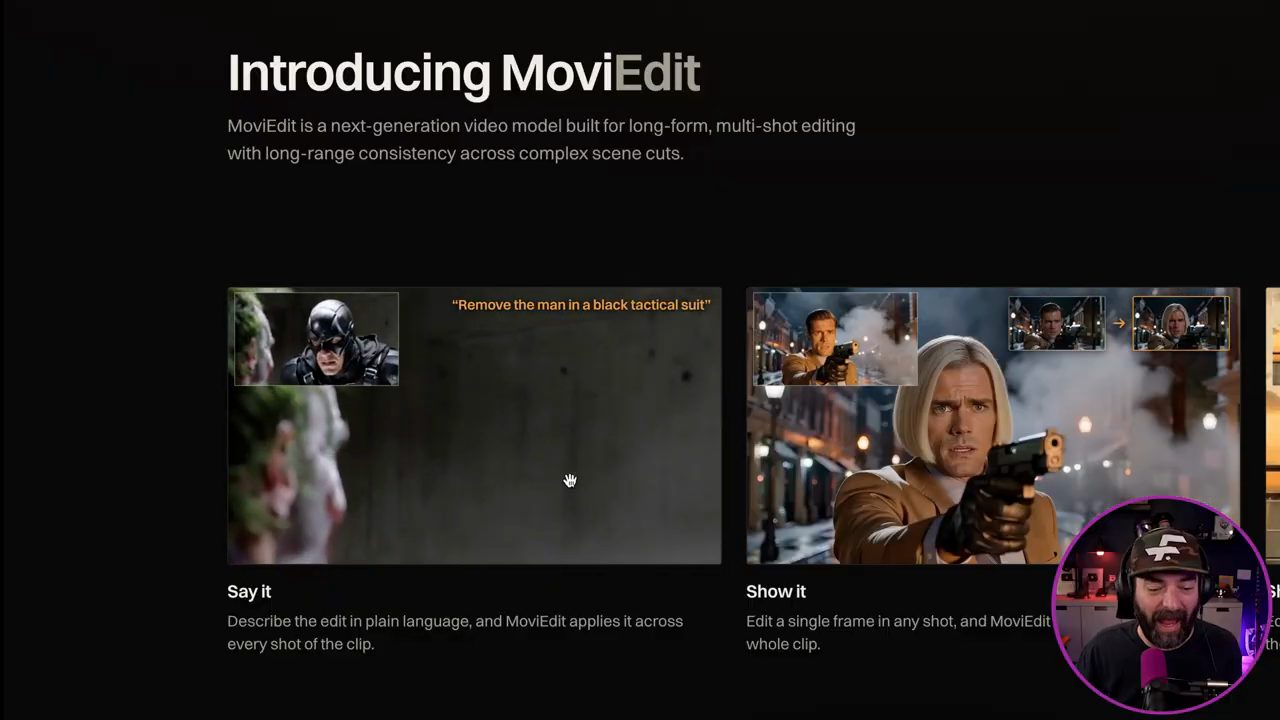
Theo Matt (video đăng ngày 18/11/2026), MoviEdit xử lý được clip dài tới 25 giây, và nó làm bản nháp thô nhanh trước để bạn kiểm tra bản sửa trước khi render đầy đủ.
Điểm vướng, theo Matt (video đăng ngày 18/11/2026): lúc này nó chỉ là một bài nghiên cứu cùng kiểu một bộ video ví dụ. Không có model để tải về, và chưa có tin gì về việc nó có được đưa vào Premiere hay không. Nên theo anh, đây là thứ mọi người sẽ phải để mắt theo dõi, vì mọi người chưa tự chơi thử được.
8. Dessa: cuộc trò chuyện AI nghe giống người nhất mà Matt từng nghe
Matt nói sẽ cho mắt mọi người nghỉ một chút, vì mục tiếp theo chỉ cần nghe (video đăng ngày 18/11/2026). Mục này tên là Dessa, theo lời anh là một voice model từ một lab nghiên cứu nhỏ nằm trong Block, công ty của Jack Dorsey, một trong những người sáng lập ban đầu của Twitter. Với Dessa, bạn có thể trò chuyện qua lại thật sự với nó.
Theo Matt (video đăng ngày 18/11/2026), đây là một trong những clip anh thích thời gian gần đây: một người trong team đăng nó lên, và nó khá buồn cười. Anh cho nghe một đoạn ngắn. Trên màn hình là hai ô "HUMAN" và "DESSA" kèm phụ đề: người gọi mở lời "Hey, how you doing?", rồi ô DESSA hiện câu hỏi lại "How you doing," kèm một cái tên không phải tên người gọi. Đoạn hội thoại sau đó xoay quanh chuyện nhầm tên này.
Matt kể tiếp (video đăng ngày 18/11/2026): nếu nghe hết cả cuộc trò chuyện, người kia hỏi thăm gia đình, và Dessa đáp rằng con mình vẫn ổn, mình vừa có một bé trai mới sinh, từ ngày 20 tháng 10, đã đặt tên cho bé, và kể có một cô con gái thích cái tên đó. Theo lời Matt, nhân vật từ Dessa cứ thế bịa ra đủ loại chuyện về cuộc đời mình. Rồi cuộc gọi kết thúc: người kia nói kiểu "tuyệt đấy, nói chuyện vui lắm", Dessa đáp "yeah, you too", chào tạm biệt, và tới cuối vẫn lại gọi người kia bằng cái tên nhầm đó. Matt nói anh không biết vì sao chuyện đó buồn cười với anh đến vậy.
Theo Matt (video đăng ngày 18/11/2026), ngoài chuyện nghe chân thật đến mức nào, một trong những điều thú vị hơn cả là AI nói nó có một cậu con trai mới sinh. Trước đó trong cuộc gọi, nó than mệt vì công việc hái nông sản. Sau đó nó kể một câu chuyện dài về vợ nó và đứa bé khóc. Nhưng không có gì trong số đó thật sự tồn tại: theo lời anh, nó đã bịa ra cả một cuộc đời.
Matt giải thích lý do nó hành xử như vậy (video đăng ngày 18/11/2026): rất nhiều voice AI biến giọng nói của bạn thành text, đưa text đó qua một language model như GPT hay Claude, rồi biến câu trả lời ngược lại thành giọng nói. Dessa không làm vậy. Theo lời anh, Block nói họ train nó từ đầu trên các bản ghi người nói chuyện với nhau, không có text và không có language model nào sẵn có bên dưới. Mọi thứ nó biết, nó học được hoàn toàn bằng cách nghe âm thanh.
Theo Matt (video đăng ngày 18/11/2026), điều đó cũng có nghĩa là nó chưa bao giờ có được tính cách trợ lý giống ChatGPT hay Claude. Nó học xem một cuộc gọi điện thoại giữa hai người nghe ra sao, nên nó cứ thế cư xử như một anh chàng đang gọi điện, có công việc, có gia đình và có chuyện để kể về con cái. Nó cũng có thể vừa nghe vừa nói cùng lúc, đúng như cách con người vẫn làm. Trong clip, mà theo Matt là thứ nên nghe nếu bạn chưa nghe hết, bạn có thể nghe người kia nói "yeah" và "uh-huh" chen bên dưới trong khi model Dessa vẫn tiếp tục nói. Matt cho nghe thêm một đoạn trích ngắn của cuộc gọi.
Rồi Matt nêu vài lưu ý (video đăng ngày 18/11/2026). Bạn chưa dùng được Dessa. Đây là bản research preview, và hiện tại Block chỉ cấp quyền truy cập cho một nhóm nhỏ các nhà nghiên cứu AI safety. Họ có nói nó chạy được trên một chiếc MacBook Pro dùng chip M4 Max, nhưng chưa ai bên ngoài Block thật sự được thử nó.
Matt nói lại rằng anh thấy các clip này buồn cười và nghe rất hay (video đăng ngày 18/11/2026). Theo anh, đây là cuộc trò chuyện AI nghe giống người nhất mà anh từng nghe cho tới giờ, chấm hết. Và anh nghĩ đó là vì nó không cố giúp bạn việc gì như một trợ lý vẫn làm.
Nhưng theo Matt (video đăng ngày 18/11/2026), mặt trái hiển nhiên của thứ này là khả năng bị dùng để lừa đảo: nó có thể bị dùng rất dễ dàng cho các cuộc gọi lừa đảo, và anh nghĩ đó là lý do họ rất thận trọng khi phát hành nó cho mọi người. Anh cho nghe thêm một đoạn trích ngắn nữa của cuộc gọi trước khi chuyển mục.
9. Haru 4B: một model cùng ý tưởng, tải về được
Bạn chưa dùng được Dessa, nhưng theo Matt, có một model hoạt động theo cùng cách và bạn tải về được ngay hôm nay (video đăng ngày 18/11/2026). Nó tên là Haru 4B, của một startup Nhật Bản tên Higurashi. Cùng một ý tưởng: nó vừa nghe vừa nói cùng lúc, không có bước text ở giữa.
Matt cho nghe một đoạn demo (clip trong video đăng ngày 18/11/2026). Hai giọng chào nhau, hỏi thăm nhau, rồi một giọng hỏi bộ phim hài lãng mạn yêu thích nhất mọi thời đại là phim nào. Câu trả lời bắt đầu bằng "Well, I think I am very familiar with American pop culture", rồi chọn "How to Lose a Guy in 10 Days".
Matt bảo hãy để ý (video đăng ngày 18/11/2026): có kiểu những tiếng "okay", "yes" và "mm-hmm" nho nhỏ chen vào trong lúc AI đang nói, và chúng không làm AI ngắt lời hay dừng nói.
Theo phần Matt giải thích (video đăng ngày 18/11/2026), ở mỗi bước, Haru 4B xếp thẳng hàng ba thứ: âm thanh của bạn, âm thanh của chính nó, và những từ nó đang nói. Nó làm việc đó khoảng bảy lần mỗi giây, và đó là cách nó biết lúc nào nên chen vào và lúc nào chỉ cần nói "mm-hmm". Trên sơ đồ kiến trúc mà Matt mở, góc trên ghi "7.5 Hz · 133 ms per frame", kèm dòng mô tả rằng một language model vừa nghe vừa nói cùng lúc, dự đoán text và speech trong mỗi frame (trang hiển thị trong video đăng ngày 18/11/2026). Theo lời anh, họ nói trên một chiếc MacBook, cả vòng lặp này mất khoảng một phần năm giây; hình minh hoạ đi kèm ghi "200ms".
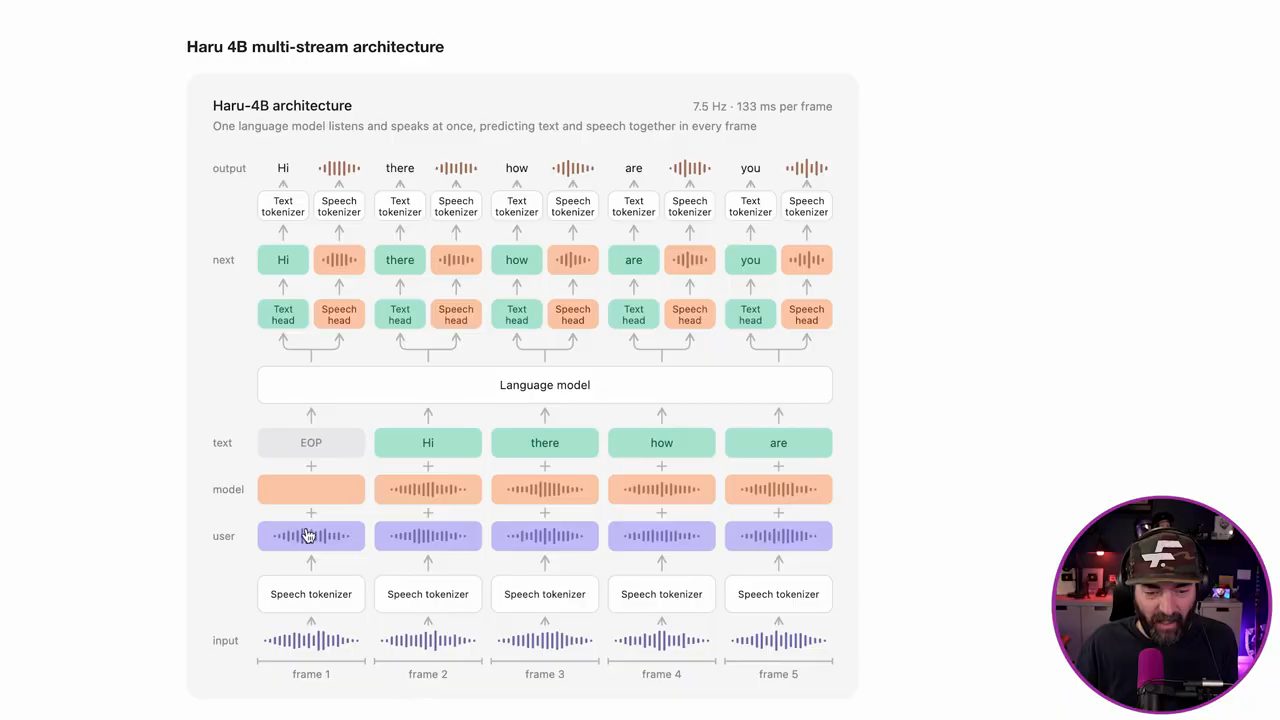
Theo Matt (video đăng ngày 18/11/2026), có một điểm vướng nhỏ: đây là base model, nghĩa là một điểm khởi đầu để developer build tiếp lên. Nó sẽ trò chuyện với bạn, nhưng đừng mong những câu trả lời thông minh ở cấp ChatGPT hay Claude. Dù vậy, model đang có trên Hugging Face, và họ đưa code lên GitHub, nên theo lời anh, bạn dùng và tải về được ngay.
Theo Matt (video đăng ngày 18/11/2026), họ có một Hugging Face Space để bạn tự thử, nhưng anh không hiểu lắm cách dùng Space này để có một cuộc đối thoại thật sự. Có vẻ như bạn hoặc ghi âm hoặc tải âm thanh lên, rồi nó chèn âm thanh của chính nó vào sau. Nên theo anh, cảm giác không giống một bài thử thật sự cho khả năng của nó.
Theo Matt (video đăng ngày 18/11/2026), anh nghĩ điều thú vị nhất ở model này là thời điểm: bản mở này xuất hiện chỉ ba tuần sau bản đóng Dessa, thứ mà lúc này chưa ai dùng được.
10. Fish Audio Live 3: voice agent cho doanh nghiệp
Model âm thanh thứ ba mà Matt muốn nói tới đến từ Fish Audio, công ty đứng sau voice model Drama 3 (video đăng ngày 18/11/2026). Model mới tên là Live 3. Theo Matt, Live 3 được làm cho doanh nghiệp, cho những việc kiểu như cuộc gọi hỗ trợ khách hàng, đặt lịch và những thứ tương tự. Trên trang có một ví dụ nhà hàng drive-thru, và theo lời anh, bạn có thể tự chạy demo này.
Matt bắt đầu một cuộc gọi và tự đóng vai khách (demo trong video đăng ngày 18/11/2026). Giọng AI chào: "Welcome to Harper Burger. What can I get for you today?". Matt gọi một phần khoai tây chiên lớn, một triple cheeseburger và một ly milkshake sô-cô-la. AI đáp quán không có triple cheeseburger, xin lỗi, loại lớn nhất là double cheeseburger, giá 4,99 đô. Matt hỏi có thể thêm một miếng thịt nữa vào đó cho anh không. AI xin lỗi, không thể thêm miếng thịt, phần double giữ nguyên như vậy.
Matt đổi: vậy cho anh một double cheeseburger và một cheeseburger thường, anh sẽ tự ghép lại (demo trong video đăng ngày 18/11/2026). AI nhắc lại đơn: một double cheeseburger, một cheeseburger, một khoai tây chiên lớn và một milkshake sô-cô-la. Matt đổi sang Oreo shake. AI đáp quán không có Oreo shake, xin lỗi, chỉ có vani, sô-cô-la hoặc dâu, bạn muốn loại nào. Matt nói thôi giữ sô-cô-la.
Theo Matt (demo trong video đăng ngày 18/11/2026), nghe khá ổn: bạn ngắt lời nó được, nói đè lên nó được, và họ có vài demo ấn tượng. Theo lời anh, nó chạy được bằng hơn 30 ngôn ngữ, và lúc này giá khoảng ba xu rưỡi mỗi phút. Nhưng đó là một ưu đãi có thời hạn: mức giá đó sẽ tăng gấp đôi vào cuối năm. Nếu muốn thử, bạn được 5 đô credit miễn phí để chạy thử.
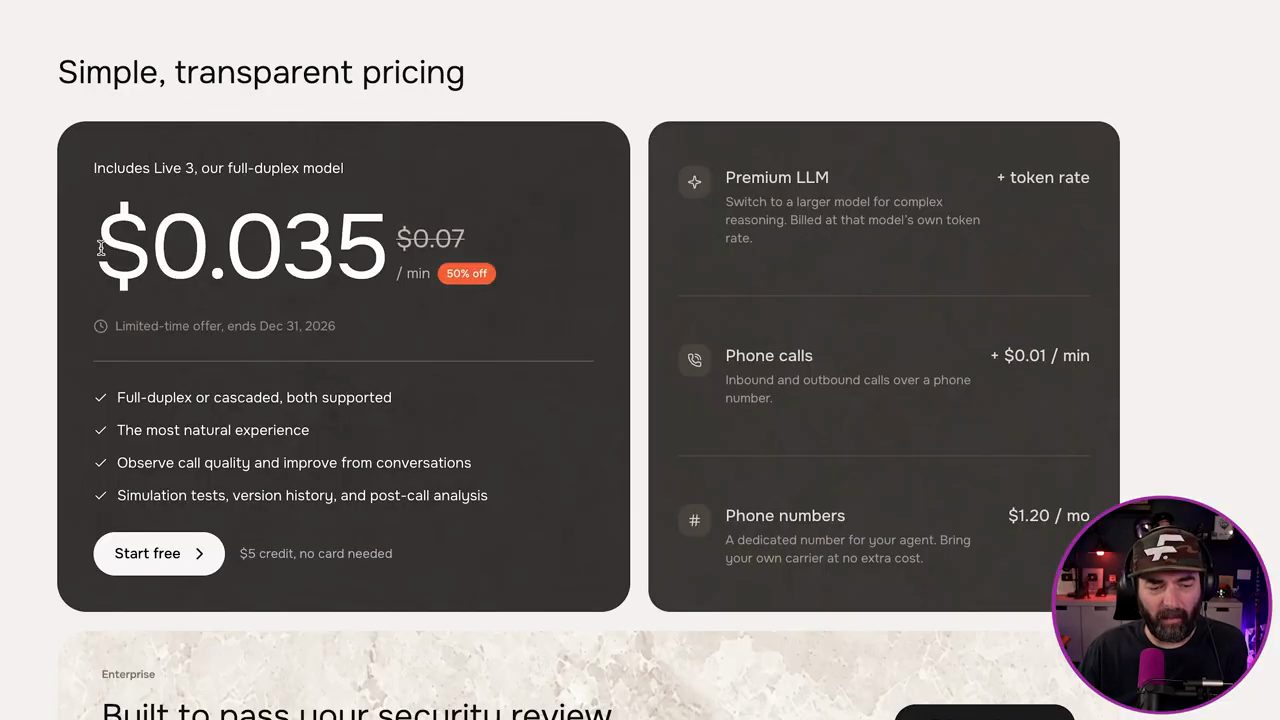
Theo Matt (video đăng ngày 18/11/2026), không có model hay thứ gì tương tự để tải về. Live 3 chạy qua trang của họ và API của họ. Nó không mở. Đây là mô hình trả tiền theo subscription.
Matt tóm lại (video đăng ngày 18/11/2026): chỉ trong khoảng ba tuần, mọi người đã đi từ một bản demo nghiên cứu rất ấn tượng, tới một model mở chạy gần như tốt bằng, và giờ là một sản phẩm trả tiền. Theo anh, cả ba kiểu như làm cùng một việc, và tốt ngang ngửa nhau.
11. Subvocal: kính được cho là đọc được lời nói không thành tiếng
Mục tiếp theo, theo Matt, hơi lạ và hơi khác một chút (video đăng ngày 18/11/2026). Mọi thứ vừa nghe đều cần bạn nói thành tiếng với nó. Còn đây là một cặp kính được cho là giúp bạn nói chuyện với AI mà không thật sự phát ra âm thanh. Kính đến từ một công ty tên Subvocal, theo lời Matt là của hai sinh viên Georgia Tech trong batch Y Combinator hiện tại, và họ bắt đầu dự án này ở một hackathon hồi tháng Hai.
Matt cho xem video của họ (clip trong video đăng ngày 18/11/2026). Theo lời anh, người trong video đang nói nhưng không có âm thanh nào phát ra, và trong lúc anh ấy nói, những gì anh ấy nói hiện lên màn hình. Matt nói anh đã tắt tiếng đoạn này, nhưng có thể thấy môi họ chuyển động mà không có tiếng nào phát ra từ miệng trong lúc họ đeo cặp kính này và nói.
Theo Matt (video đăng ngày 18/11/2026), không có camera và không có microphone nào làm việc này. Anh đọc đoạn "How it works" trên trang của Subvocal: Subvocal dùng RF sensing từ một cặp kính để bắt những chuyển động rất nhỏ trên khuôn mặt khi bạn nhẩm từ ngữ không thành tiếng; họ gửi sóng radio công suất thấp xuyên qua khuôn mặt và đo xem sóng thay đổi thế nào khi cơ của bạn chuyển động; rồi các model của họ giải mã thẳng những tín hiệu đó thành text. Theo lời Matt, video ra mắt của họ đạt hơn 12 triệu lượt xem trên X.
Vài lưu ý nhanh của Matt (video đăng ngày 18/11/2026): công ty tuyên bố đạt hơn 200 từ mỗi phút với bất kỳ vốn từ nào. Tuy nhiên, theo anh, các nghiên cứu đã công bố về kiểu cảm biến radio này mới chỉ đạt tối đa một vốn từ 50 từ. Theo lời anh, đó là một khoảng cách khá lớn, và chưa ai bên ngoài công ty thật sự thử cặp kính này.
Theo Matt (video đăng ngày 18/11/2026), các nhà sáng lập cũng nói bản prototype hiện tại trông tệ hơn nhiều so với cặp kính thật trên website mà bạn sẽ nhận được. Theo anh, nhìn bản prototype thì trông chúng chỉ như được in 3D.
Theo Matt (video đăng ngày 18/11/2026), đặt trước cặp kính tốn 199 đô, và đó là khoản đặt cọc hoàn lại được, trừ vào mức giá 499 đô. Họ ước tính giao hàng trong quý 1 năm 2027, nên theo lời anh là chỉ trong vài tháng tới. Trên trang sản phẩm mà Matt mở có dòng "$199 Due today, Fully refundable", "Total Early Bird price" 499 đô (giá gạch ngang 699 đô), nút "Sold out" kèm "Join waitlist", dòng "Early Bird preorders are closed" và "Estimated shipping Q1 2027" (trang hiển thị trong video đăng ngày 18/11/2026).
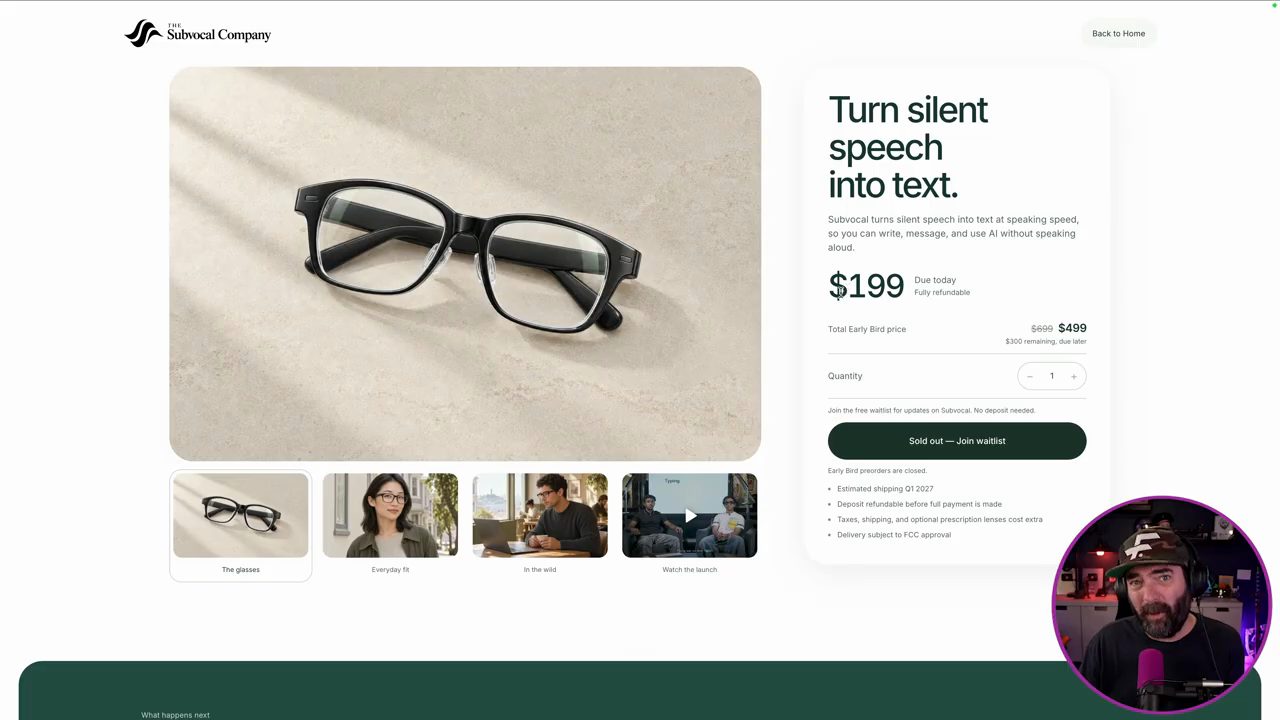
Cá nhân Matt nói anh thật sự muốn thứ này là thật (video đăng ngày 18/11/2026). Anh nghĩ đọc chính tả cho máy tính, như ở quán cà phê hay trên máy bay, mà không ai nghe thấy anh, thì sẽ khá tuyệt. Nhưng anh vẫn kiểu như đang chờ một bài thử độc lập trước khi thật sự bỏ tiền ra. Anh chưa hoàn toàn biết nên nghĩ gì, nhưng anh thật sự muốn chúng là thật và hoạt động đúng như họ tuyên bố.
12. Budget3D: từ một ảnh ra vật thể 3D, tự chọn ngân sách token
Matt quay lại với những thứ bạn thật sự tự chạy được (video đăng ngày 18/11/2026). Ở đầu video, Simulon biến một tấm ảnh thành một nhân vật 3D, và đây là một công cụ cho đúng bước đó, tên là Budget3D. Bạn đưa vào một ảnh, và nó có thể trả lại một vật thể 3D.
Theo Matt (video đăng ngày 18/11/2026), điểm khác biệt của Budget3D là thanh trượt: bạn chọn nó tiêu bao nhiêu sức tính toán. Bạn có thể hạ xuống và nó chạy nhanh khoảng gấp đôi, dùng ít bộ nhớ hơn, nhưng bạn cũng sẽ bị giảm chất lượng một chút.
Trong ví dụ Matt cho xem, ảnh đầu vào là một món đồ chơi cao bồi nhỏ (trang hiển thị trong video đăng ngày 18/11/2026). Khi dùng toàn bộ ngân sách token, theo lời anh, kết quả ra chất lượng khá tốt. Khi đổi thanh trượt, có thể thấy chất lượng giảm nhưng tốc độ tăng. Kéo thanh tới mức 40%, nó dùng ít token hơn nhiều, tốc độ nhanh hơn nhiều, nhưng theo Matt, có thể thấy chất lượng bản 3D tạo ra giảm khá rõ.
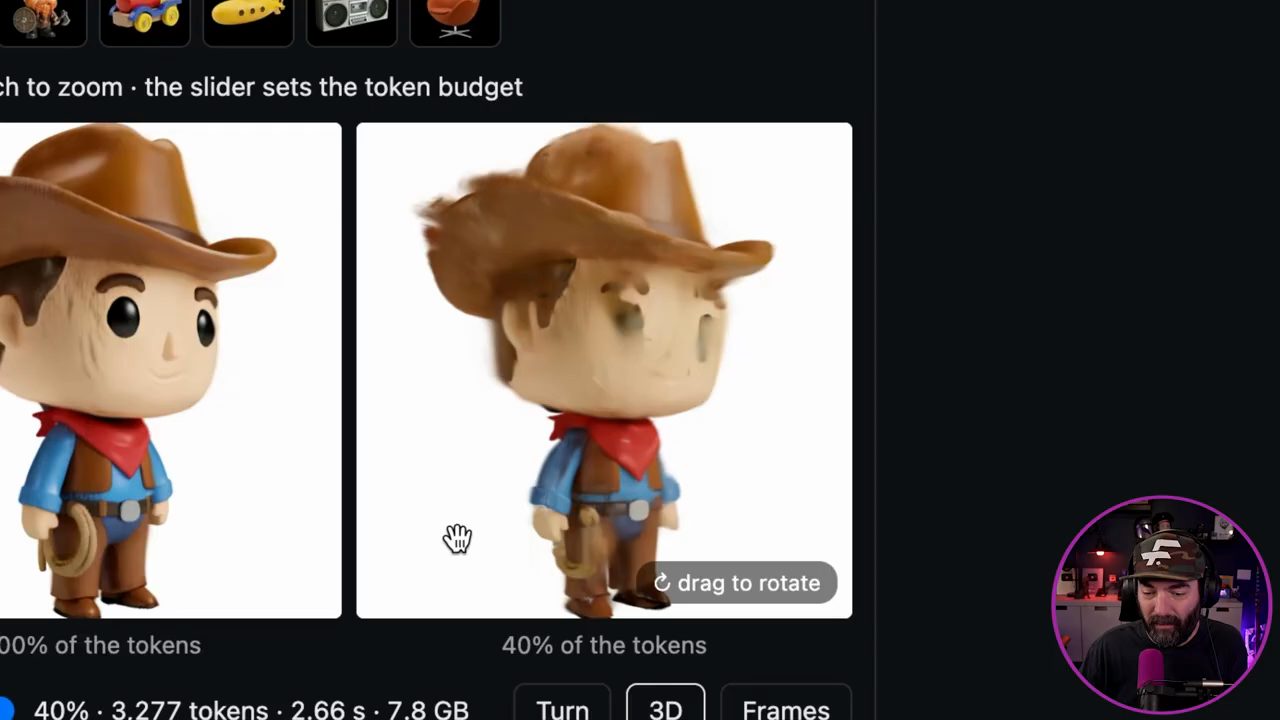
Ví dụ khác là một đoàn tàu đồ chơi ở tốc độ tối đa và ngân sách thấp nhất, theo Matt là không đẹp (trang hiển thị trong video đăng ngày 18/11/2026). Kéo hết cỡ lên thì nó chạy chậm hơn nhiều, dùng nhiều token hơn nhiều, nhưng ra kết quả chất lượng khá tốt.
Theo phần Matt giải thích (video đăng ngày 18/11/2026), thông thường các model này bỏ cùng một lượng công sức cho mọi phần của vật thể, kể cả khoảng trống xung quanh vật thể. Budget3D thì tìm ra những phần nhàm chán, bắt đầu từ khoảng trống đó, gộp chúng lại với nhau, rồi dồn toàn bộ công sức vào chỗ có chi tiết.
Theo Matt (video đăng ngày 18/11/2026), họ có bản demo trên Hugging Face dưới dạng một Hugging Face Space, nơi bạn tải ảnh của mình lên và đặt ngân sách token. Anh tải lên một ảnh chân dung khuôn mặt, chọn ngân sách token tối đa trước. Kết quả, theo lời anh, rõ ràng là nó không biết phía sau trông thế nào nên ra một cái đầu phẳng, nhưng nhìn từ phía trước thì không tệ lắm. Anh hạ ngân sách token xuống hết mức rồi tạo lại: nó tạo nhanh hơn nhiều, và anh nói "yeah, đó là thứ mình nhận được" (demo trong video đăng ngày 18/11/2026).
Theo Matt (video đăng ngày 18/11/2026), trang này có cho thấy nó nhanh hơn bao nhiêu khi đổi ngân sách token, nhưng không có kiểu con số hay chỉ số nào về chênh lệch chất lượng. Nên theo anh, bạn kiểu như phải tự nhìn bằng mắt xem mức nào hợp với nhu cầu của mình.
Theo Matt (video đăng ngày 18/11/2026), để chạy model này trên máy, nó chỉ cần dưới 8 GB VRAM, nên theo anh, gần như mọi card gaming đời gần đây chắc đều chạy được. Code có trên GitHub, model weights có trên Hugging Face, và bạn có thể chạy demo miễn phí trong Hugging Face Space ngay trên trình duyệt.
13. MotionBricks của NVIDIA: hoạt hình nhân vật theo thời gian thực
Khi đã có một nhân vật 3D, có thể bạn sẽ muốn nhân vật đó thật sự chuyển động, và theo Matt, đội nghiên cứu của NVIDIA có một lời giải mới cho việc đó (video đăng ngày 18/11/2026). Nó tên là MotionBricks, và nó tạo chuyển động cho nhân vật theo thời gian thực. Bạn điều khiển nhân vật như trong một game, và mọi chuyển động được tạo ra ngay tại chỗ. Theo lời Matt, mọi thứ trong clip đều do model tạo ra, và NVIDIA nói không hề có đoạn chuyển tiếp nào làm thủ công.
Theo Matt (video đăng ngày 18/11/2026), trong một game bình thường, animator dựng hàng trăm clip riêng lẻ như đi, chạy, nhảy, ngồi. Rồi phải có người nối chúng lại với nhau bằng tay để nhân vật chuyển mượt từ động tác này sang động tác khác. Theo anh, việc nối đó là rất nhiều công sức của chuyên gia. Ở đây, một model học từ khoảng 350.000 clip chuyển động, và nó tự xử lý toàn bộ phần chuyển tiếp ở giữa.
Theo phần Matt giải thích (video đăng ngày 18/11/2026), có hai phần. Phần thứ nhất là chuyển động: bạn cho nó một tốc độ, một hướng và một phong cách, và bạn đổi phong cách được ngay khi đang chạy. Có kiểu dáng đi zombie, kiểu chân bị thương, kiểu nhảy chân sáo.
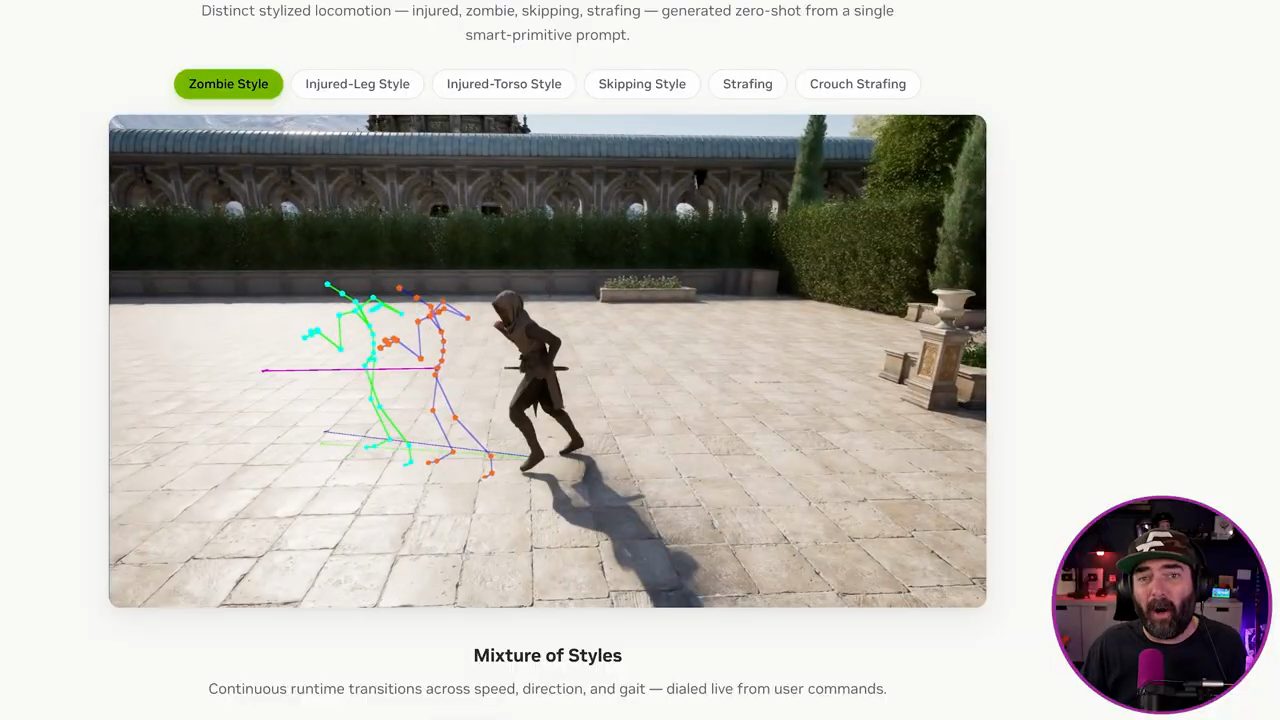
Phần thứ hai, theo Matt, là vật thể (video đăng ngày 18/11/2026). Bạn đánh dấu vài tư thế then chốt như tay đặt lên thanh kiếm hay ngồi trên ghế băng, và model tự điền phần tiến lại gần, phần chạm vào và phần động tác tiếp theo sau đó. Trong clip, nhân vật đi tới nhặt vật thể lên, và ở clip khác thì đi tới ngồi xuống ghế băng.
Theo Matt (video đăng ngày 18/11/2026), cùng model đó cũng đang điều khiển robot: nó là lớp chuyển động bên trong GR00T, hệ thống của NVIDIA dành cho robot hình người.
Theo Matt (video đăng ngày 18/11/2026), các demo này trông thật sự rất đẹp, nhưng nó chưa dùng được bên trong Unreal Engine, nên game developer chưa thể cứ thế thả nó vào bất kỳ project nào. Nhưng code và các model đã train đang có trên GitHub. Theo anh, nếu bạn là một game developer làm một mình, đây là hoạt hình nhân vật mà không cần ngân sách thuê animator.
14. Flash ALOHA: robot hai tay bắt bóng và dọn bàn
Nói tới robot, theo Matt, mục tiếp theo là về tốc độ (video đăng ngày 18/11/2026). Đây là Flash ALOHA, theo lời anh đến từ Stanford. Trong clip là một robot hai tay tung một quả bóng rồi tự bắt lại, không có ai điều khiển.
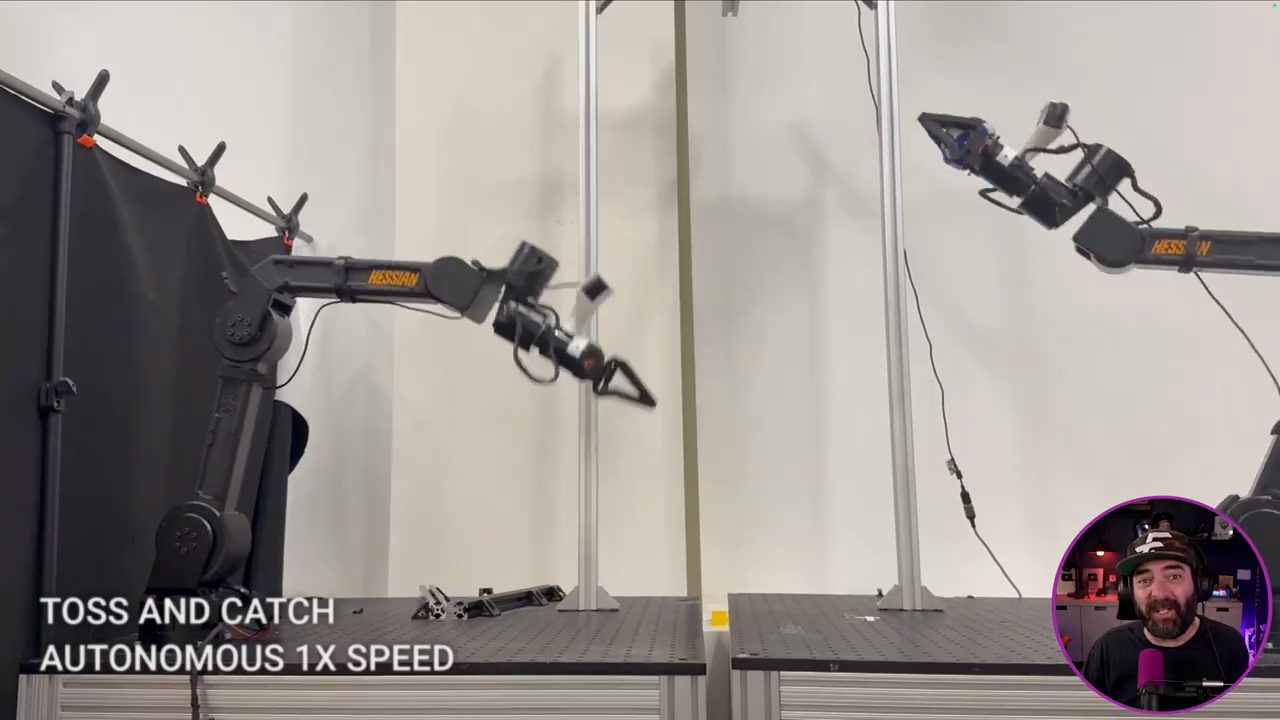
Theo Matt (video đăng ngày 18/11/2026), bắt đồ thật ra khá khó với robot, vì thật sự không có thời gian để suy nghĩ. Phần lớn robot học những việc như thế này bằng cách xem một người làm, rồi cuối cùng chậm hơn người đó rất nhiều, vì theo lời anh, cách mọi người thường dạy chúng thì chậm: có người lái robot qua một bộ điều khiển từ xa, và cách đó trở nên vụng về ở tốc độ cao.
Theo phần Matt giải thích (video đăng ngày 18/11/2026), cách khắc phục mà nhóm tìm ra là làm những cánh tay mà bạn nắm lấy và di chuyển được bằng tay. Một người cầm lấy hai cánh tay của robot và làm việc đó ở tốc độ đầy đủ, rồi robot ghi lại. Sau đó một phần mềm nhỏ làm mượt những chỗ giật cục khi robot phát lại.
Theo Matt (video đăng ngày 18/11/2026), robot còn làm được những việc như gấp quần short, lắp pin vào một thiết bị giúp bạn, và lau dọn bàn cho bạn sau khi ăn. Mỗi việc như vậy chỉ cần 50 lần làm mẫu để học, và nó chỉ dùng camera thông thường.
Theo Matt (video đăng ngày 18/11/2026), họ có báo cáo tỉ lệ thành công trên 80%, và theo anh, như vậy vẫn có nghĩa là nó có thể trượt một trong năm lần bắt. Họ cũng nói trong phần mô tả rằng nó gần với tốc độ của con người, nhưng theo Matt, trang không thật sự nói rõ điều đó nghĩa là gì. Dòng tóm tắt trên trang mà Matt mở có cụm "over 80% success rates while close to human speed" (trang hiển thị trong video đăng ngày 18/11/2026).
Theo Matt (video đăng ngày 18/11/2026), code của dự án có trên GitHub, và tài liệu của họ liệt kê toàn bộ phần cứng bạn cần mua nếu muốn tự build một bộ. Với anh, phần bắt đồ là ấn tượng nhất: anh chưa thấy robot nào học từ làm mẫu mà phản ứng nhanh như những gì đang thấy ở đây. Theo anh, phần đó thật sự rất hay.
15. PhoneBot: robot biết đi dùng điện thoại Android làm bộ não
Mục cuối cùng: nếu những robot kia có vẻ ngoài tầm với, theo Matt, đây là một robot bạn có thể tự build với một chiếc điện thoại cũ đang nằm trong ngăn kéo (video đăng ngày 18/11/2026). Đó là PhoneBot, theo lời anh đến từ một lab robotics ở UCLA. Đây là một robot biết đi, cao khoảng một foot rưỡi, và bộ não của nó là một chiếc điện thoại Android.
Theo Matt (video đăng ngày 18/11/2026), chiếc điện thoại đảm nhận mọi phần khó để robot này chạy được. Camera của điện thoại là mắt của robot. Chính cảm biến dùng để xoay màn hình điện thoại là cảm biến mà họ dùng để giữ thăng bằng cho robot. Và nó có kết nối internet để dùng dịch vụ GPT cho phần AI thật sự điều khiển bộ não và cách nó di chuyển. Mọi thứ còn lại là khoảng 400 đô tiền linh kiện.
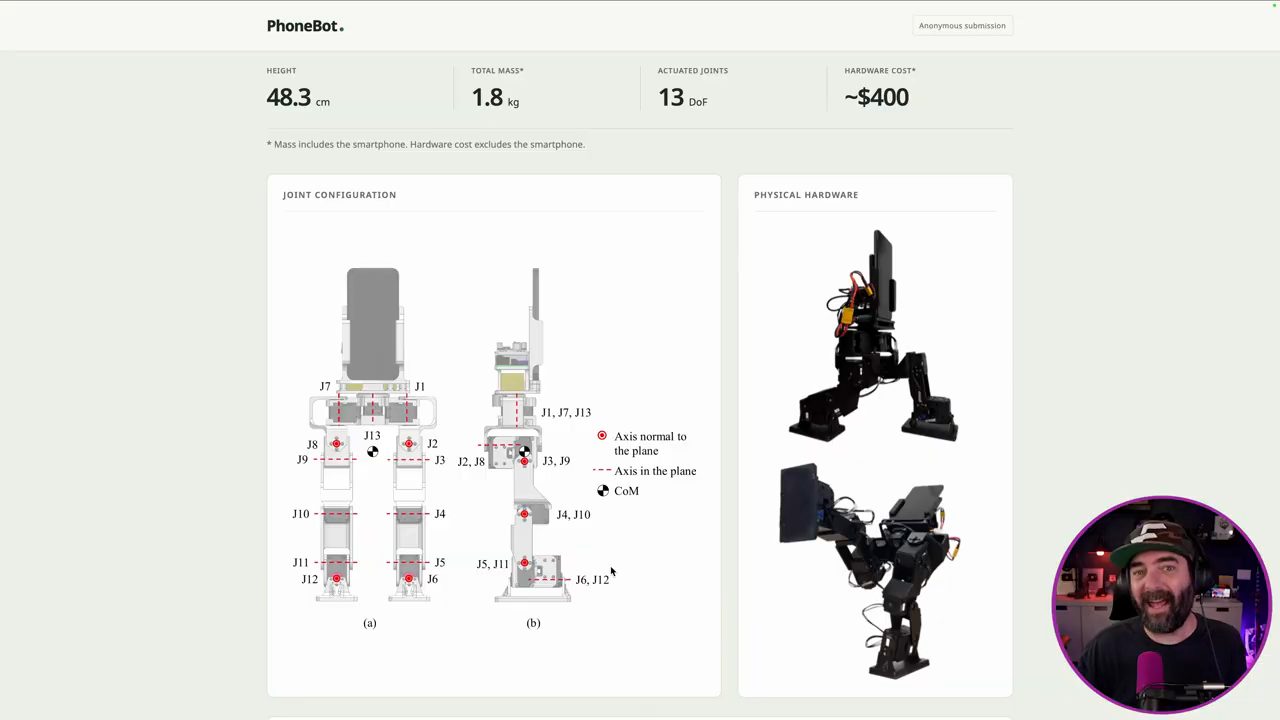
Theo Matt (video đăng ngày 18/11/2026), họ còn đưa cho bạn danh sách linh kiện cần mua, các file in 3D và một hướng dẫn lắp ráp để build robot. Theo lời anh, nó thật ra chỉ là 13 động cơ nhỏ, một cục pin và một thân in 3D. Họ thử nó với vài chiếc điện thoại Android trả trước cũ có giá từ 50 tới 80 đô.
Theo Matt (video đăng ngày 18/11/2026), robot đi tới và đi lùi được, xoay người được, và có thể đi theo một người bằng camera. Khi ngã sấp mặt, nó tự đứng dậy được mà không cần ai giúp, mà theo anh là xem khá "wild". Nó học đi trong một môi trường mô phỏng bằng cách thử và sai: được cộng điểm khi giữ được tư thế đứng thẳng và theo kịp nhịp, bị trừ điểm khi lê chân.
Matt có để ý thấy một điểm mà theo anh là hơi có vấn đề (video đăng ngày 18/11/2026). Họ có cho biết bạn cần mua những gì, và họ có kiểu các file CAD. Nhưng anh vừa phát hiện các nút Printable Parts và tutorial thực tế không bấm được, nên chúng chưa thật sự sẵn sàng để bạn lấy về. Tính tới lúc quay video, bạn chưa lấy được các file in 3D hay hướng dẫn lắp ráp. Robot cũng chỉ đi được trên mặt phẳng và không có tay. Nên theo lời anh, nó sẽ không rửa bát hay gấp quần áo cho bạn trong thời gian tới.
16. Ghép các mảnh lại và lời chào
Matt bảo hãy nghĩ về mọi thứ đã xem trong video (video đăng ngày 18/11/2026): một model chuyển động của NVIDIA vốn đã điều khiển robot hình người, một voice model tải về được và nói chuyện như người. Ghép những thứ đó vào một robot 400 đô với điện thoại làm bộ não, và theo anh, đó là thứ khá vui để build. Thật ra, anh nói anh có thể sẽ thử làm.
Rồi Matt nói đó là tất cả những gì anh có hôm nay, cảm ơn mọi người rất nhiều vì đã cùng "nerd out" với anh, và chào tạm biệt.
Nguồn và liên kết 14 nguồn
- Tên gốc: Insane AI Breakthroughs Nobody Is Talking About
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=-oA6oLxWpJg youtube.com
- Kênh YouTube Matt Wolfe (Matt Wolfe): youtube.com/channel/UChpleBmo18P08aKCIgti38g youtube.com
- Simulon, trang chủ "Simulon 2.0 | The camera for your imagination" (đọc ngày 18/11/2026): simulon.com simulon.com
- Tencent, "Hy-Nomas: Interactive World Modeling" (đọc ngày 18/11/2026): hy-nomas.hy.tencent.com hy-nomas.hy.tencent.com
- Trang dự án MoviEdit (đọc ngày 18/11/2026): multi-shot-edit.github.io multi-shot-edit.github.io
- Block, "Dessa: the Conversation Model trained only on speech" (đọc ngày 18/11/2026): block.xyz/dessa block.xyz
- Higurashi, "Haru 4B: Full-duplex speech AI" (đọc ngày 18/11/2026): higurashi.ai/haru4b higurashi.ai
- Fish Audio, "Live 3: Full-Duplex Real-Time Voice Model for Voice Agents" (đọc ngày 18/11/2026): fish.audio/live3 fish.audio
- Subvocal, "Silent Speech Glasses" (đọc ngày 18/11/2026): subvocal.company subvocal.company
- Trang dự án Budget3D (đọc ngày 18/11/2026): budgetany.github.io/budget3d budgetany.github.io
- NVIDIA Research, "MotionBricks: Scalable Real-Time Motions with Modular Latent Generative Model and Smart Primitives" (đọc ngày 18/11/2026): nvlabs.github.io/motionbricks nvlabs.github.io
- "PhoneBot: A Low-Cost Open Humanoid Robot Platform Reusing Smartphones" (đọc ngày 18/11/2026): phonebot.dev phonebot.dev
Related talks
Agent-Native + Claude Code: app mà người và AI agent cùng làm việc
AICodeKing · AICodeKing · 14 min
Đi qua app Slides của Agent-Native: sửa tay rồi để agent làm tiếp, Revise with AI, defineAction, context awareness, và dùng Claude Code thêm review checklist.
MCP Apps là gì? Build app chạy ngay trong Claude và ChatGPT
Ashita Prasad · AWS Developers · 14 min
Build ba MCP app (form, dashboard Chart.js, PDF) chạy trong Claude Desktop bằng MCP Apps SDK, rồi deploy MCP server lên Amazon Bedrock AgentCore.
Hỏi đáp về GPT-Live: full duplex, delegation và custom voice
Aarti · OpenAI · 9 min
Aarti của OpenAI trả lời câu hỏi về GPT-Live: khác GPT Realtime ra sao, môi trường ồn, giọng tiếng Pháp, custom voice, delegation và context backend.