Jev: AI không viết chữ, chỉ ra quyết định
Chạy thật Jev, model chỉ ra quyết định, phân loại 51 bình luận khách hàng, dùng độ chắc chắn để đặt ngưỡng và tránh ba lỗi người mới hay vấp.
✓ Đã duyệt độc lập · cập nhật 17/10/2026 · 14 min
1. Con AI không viết nổi một chữ
Thanh mở đầu bằng một việc rất cụ thể: anh sắp giao cả một đống bình luận khách hàng, 51 bình luận thật, cho một con AI vừa ra mắt đúng 10 ngày. Con AI này có một đặc điểm rất kỳ lạ: nó không viết được một chữ nào. Hỏi nó "hôm nay thế nào" thì nó không trả lời được. Bảo nó viết email, nó không viết. Bảo nó tóm tắt một tài liệu, nó cũng không làm. Nghe như hàng lỗi.
Vậy mà trong 24 giờ đầu tiên, nó trở thành model được dùng nhiều nhất trong lịch sử của Vercel, một trong những nền tảng lớn nhất của giới lập trình, với lượng dùng gấp đôi kỷ lục cũ. Chỉ vài ngày sau, nó vượt mốc 1.000 tỷ token mỗi ngày.
Vì vậy video này không nói nhiều lý thuyết. Thanh mở máy ra chạy thật, quay nguyên màn hình từ đầu đến cuối, và chỉ cho người xem những chỗ dễ sai mà ít người nhắc tới.
2. Jev là gì và ai làm ra nó
Luật chơi như sau. Model này tên là Jev. Công ty làm ra nó là TypeSafe AI, đặt ở San Francisco. Người sáng lập từng làm 4 năm ở OpenAI và là đồng tác giả của nghiên cứu dẫn đến ChatGPT, tức là không phải người ngoài ngành.
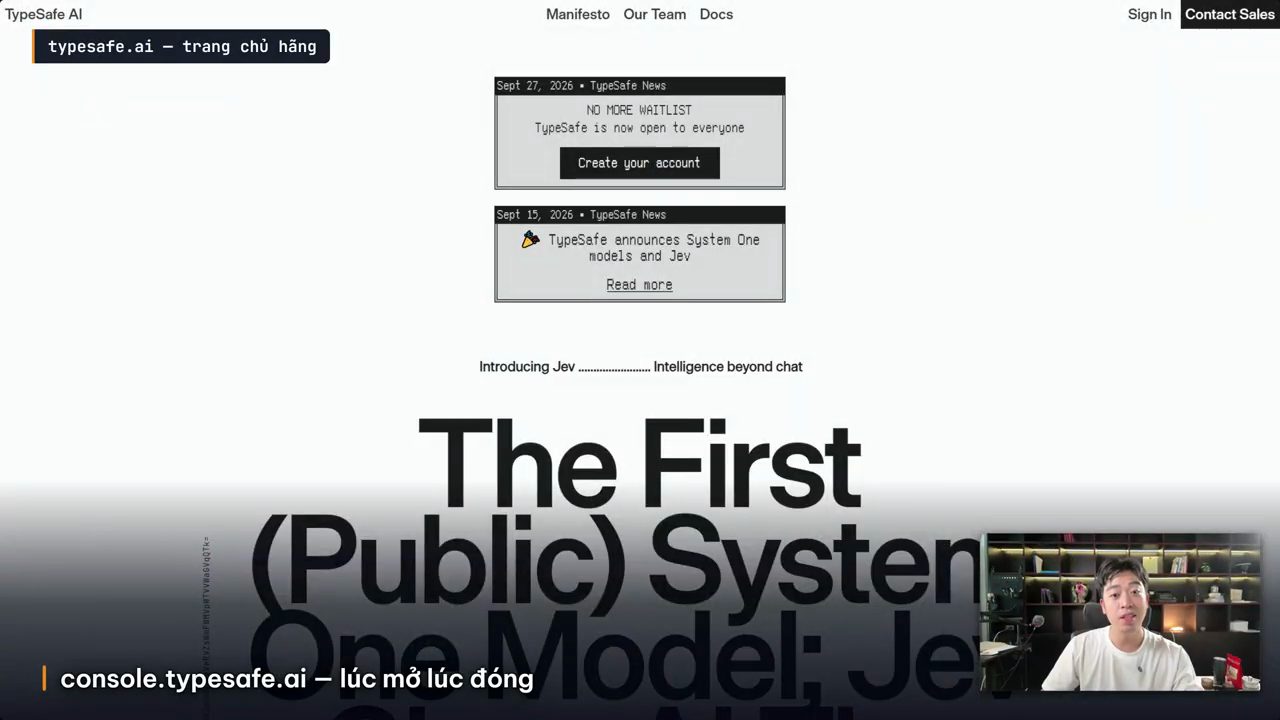
Trên trang chủ, Jev được giới thiệu với khẩu hiệu "Intelligence beyond chat", tức là trí tuệ vượt ra ngoài chuyện chat. Đây là manh mối đầu tiên cho thấy nó không được làm ra để trò chuyện.
3. AI viết chữ và AI ra quyết định
Toàn bộ những AI mọi người đang dùng bây giờ, ChatGPT, Claude, Gemini, đều là AI viết chữ. Bạn hỏi, nó nghĩ, rồi nó gõ lại từng chữ cho bạn đọc. Nó được tạo ra để phục vụ mắt người.
Jev thì ngược hẳn. Nó không viết cho bạn đọc, nó trả kết quả cho phần mềm đọc. Bạn đưa cho nó một đoạn dữ liệu (một bình luận, một tin nhắn, một đơn hàng) kèm theo một bộ câu hỏi đã có sẵn đáp án để chọn, và nó trả về đáp án đã chọn kèm phần trăm chắc chắn. Chỉ thế thôi: không giải thích, không lý lẽ, không một chữ văn xuôi nào.
Thanh đưa một hình dung. Giả sử bạn thuê hai người đọc bình luận của khách hàng. Người thứ nhất đọc xong thì viết cho bạn một bài phân tích 300 chữ: đó là ChatGPT. Người thứ hai đọc xong chỉ gạch một dấu tích vào ô "khách hỏi giá", kèm một dòng "tôi chắc 87%": đó là Jev. Người thứ nhất thông minh hơn, nhưng nếu bạn có 10.000 bình luận cần phân loại thì lúc đó bạn cần người thứ hai.
Trước khi làm thử, có hai thứ cần chuẩn bị. Thanh làm nhanh, và theo anh, ai cũng có thể làm theo ngay cả khi chưa từng viết một dòng code nào.
4. Chuẩn bị thứ nhất: khoá API
Thứ nhất là cần một cái chìa khoá, tức là API key. Thanh nói trước một chuyện để người xem đỡ mất công: trang của công ty này lúc mở lúc đóng. Tuần trước nó mở cho tất cả mọi người, rồi bị quá tải nên siết chặt lại. Cứ vào thử trang console.typesafe.ai; nếu vào được thì càng tốt, tài khoản mới được tặng 5 đô để trải nghiệm.
Nếu bị chặn thì đừng mất công đứng đó. Có một đường vào lúc nào cũng chạy, lúc nào cũng thông: một dịch vụ API trung gian cho model, nơi Jev cũng được bán. Đó là đường Thanh chọn dùng trong video vì nó ổn định. Các bước anh làm:
- Mở trang dịch vụ đó và đăng nhập bằng Google.
- Vào mục Keys, bấm Create Key. Trang hiện ra một chuỗi khoá. Copy ngay chuỗi này, vì nếu đóng hộp thoại lại thì bạn không xem lại được nữa.
- Nạp một chút credit. Thanh nạp tạm 5 đô. Với mức giá của model này, theo anh, 5 đô thì xài vài tháng cũng chưa hết.
5. Chuẩn bị thứ hai: dữ liệu của chính bạn
Thứ hai là dữ liệu của chính bạn. Thanh dặn đừng lấy dữ liệu mẫu, vì cái hay của việc này nằm ở chỗ bạn nhìn thấy nó phân loại đúng khách hàng thật của mình.
Cách làm: mở một file Excel mới, đặt tên cột A là nội dung, rồi dán vào đó 50 đến 100 bình luận hoặc tin nhắn gần nhất. Chịu khó làm, vì kể cả copy tay cũng chỉ mất khoảng 10 phút. Sau đó lưu lại dưới định dạng CSV, đặt tên file là binh-luan.csv, và để vào một thư mục trống. Thanh đặt tên thư mục là thu-jev.
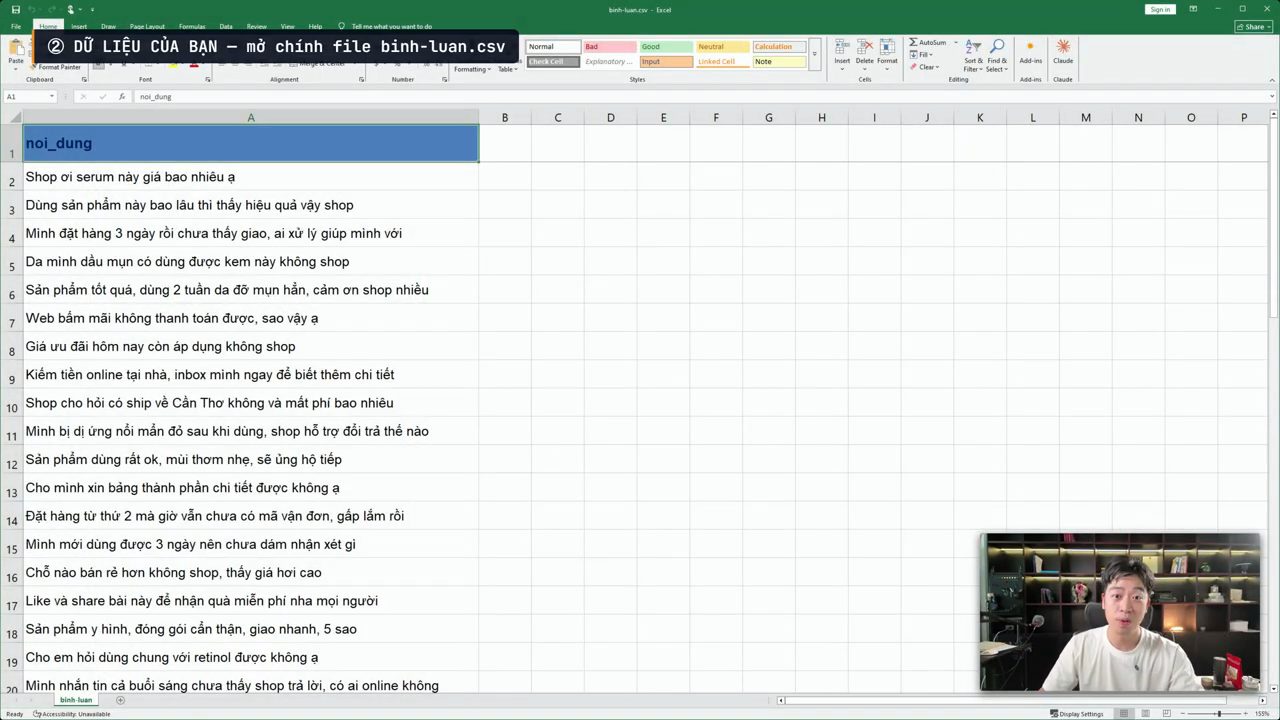
Trong file có đủ loại bình luận của một shop mỹ phẩm: hỏi giá, hỏi phí ship về Cần Thơ, hỏi da dầu mụn có dùng được không, khen sản phẩm đỡ mụn sau 2 tuần, phàn nàn web bấm mãi không thanh toán được, bị dị ứng nổi mẩn đỏ, và cả những dòng spam rủ like, share để nhận quà.
6. Giao đề bài cho máy
Xong phần chuẩn bị thì bắt đầu thử. Thanh chạy Claude Code trên terminal: anh mở terminal ngay trong thư mục thu-jev, gõ claude, rồi dán vào đúng một đoạn yêu cầu. Anh dặn cứ chép nguyên, chỉ cần đổi phần nhãn cho hợp với ngành của mình.
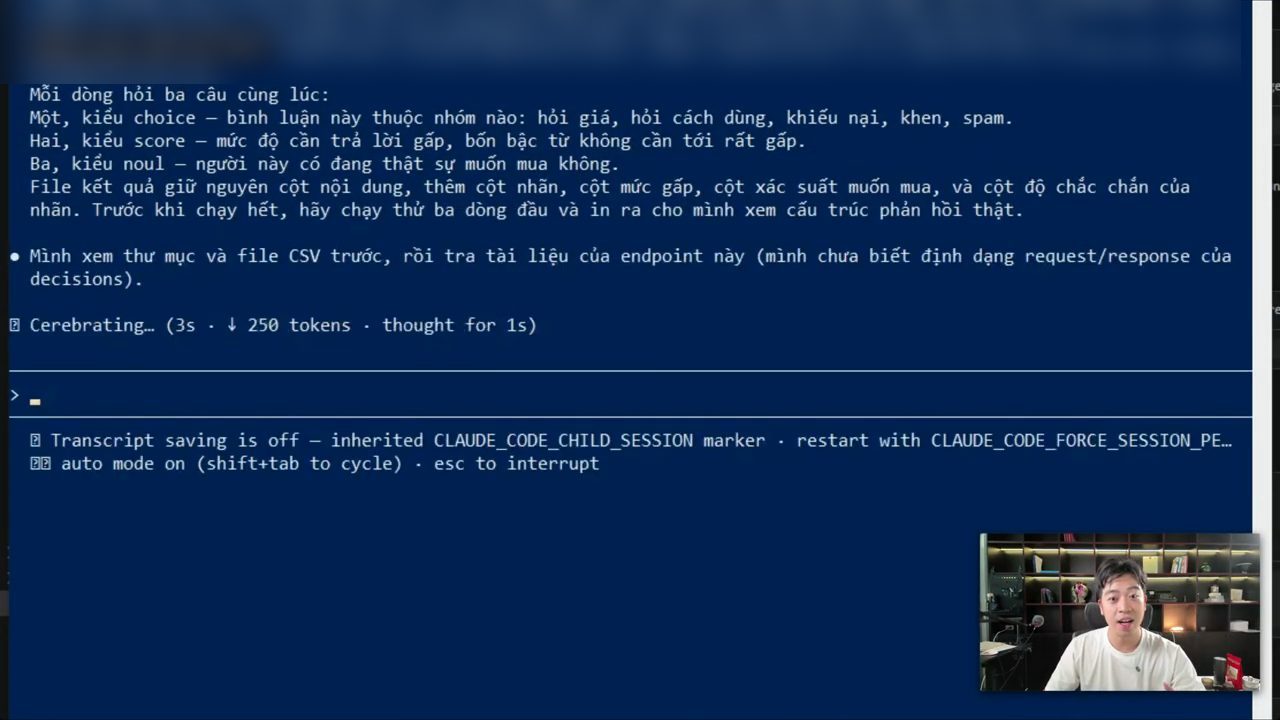
Tóm lại, anh bảo máy rằng trong thư mục này có file binh-luan.csv, hãy viết một script Python đọc từng dòng, gọi model Jev để phân loại, rồi ghi kết quả ra file ket-qua.csv. Mỗi dòng thì hỏi ba câu cùng lúc: bình luận này thuộc nhóm nào, mức độ cần trả lời gấp tới đâu, và người này có đang thực sự muốn mua không. Câu cuối của đoạn yêu cầu là câu quan trọng nhất: trước khi chạy hết, hãy chạy thử ba dòng đầu và in ra cho mình xem cấu trúc phản hồi thật.
Đây là đoạn prompt trên màn hình. Phần tên dịch vụ, địa chỉ endpoint và tên biến môi trường chứa khoá được để trong ngoặc vuông để bạn điền theo đường vào mình dùng:
Trong thư mục này có file binh-luan.csv, cột noi_dung là nội dung bình luận khách hàng. Hãy viết cho mình một script Python đọc từng dòng, gọi model Jev qua [dịch vụ API bạn dùng] để phân loại, rồi ghi kết quả ra file ket-qua.csv.
Gọi vào endpoint [endpoint decisions của dịch vụ đó], model typesafe/jev-1.13, khoá API đọc từ biến môi trường [TÊN_BIẾN_KHOÁ_API].
Mỗi dòng hỏi ba câu cùng lúc:
Một, kiểu choice - bình luận này thuộc nhóm nào: hỏi giá, hỏi cách dùng, khiếu nại, khen, spam.
Hai, kiểu score - mức độ cần trả lời gấp, bốn bậc từ không cần tới rất gấp.
Ba, kiểu noul - người này có đang thật sự muốn mua không.
File kết quả giữ nguyên cột nội dung, thêm cột nhãn, cột mức gấp, cột xác suất muốn mua, và cột độ chắc chắn của nhãn. Trước khi chạy hết, hãy chạy thử ba dòng đầu và in ra cho mình xem cấu trúc phản hồi thật.
7. Máy tự đi tra tài liệu trước khi viết code
Thanh bảo người xem chú ý màn hình, vì đây là chỗ anh thích nhất. Máy không lao vào viết code. Nó dừng lại và nói thẳng: mình chưa biết định dạng của endpoint này. Rồi nó đi tra cứu.
Nó tìm kiếm. Nó mở trang tài liệu đầu tiên: lỗi 404, trang không tồn tại. Nó mở tiếp trang thứ hai, rồi trang thứ ba, và lấy được định dạng thật từ tài liệu chính thức. Xong việc đó nó mới bắt đầu viết.
Theo Thanh, đó mới là lý do bây giờ người ta không cần tự viết code. Không phải vì code dễ đi, mà vì cái đứng giữa bạn và code đã tự đi tra tài liệu được rồi.
8. Ba kiểu câu hỏi: chọn một, chấm mức, đúng hay sai
Script viết xong, máy chạy thử ba dòng đầu như Thanh yêu cầu. Và đúng ba dòng này lộ ra toàn bộ bộ xương của Jev: nó chỉ trả lời đúng ba kiểu câu hỏi, không hơn.
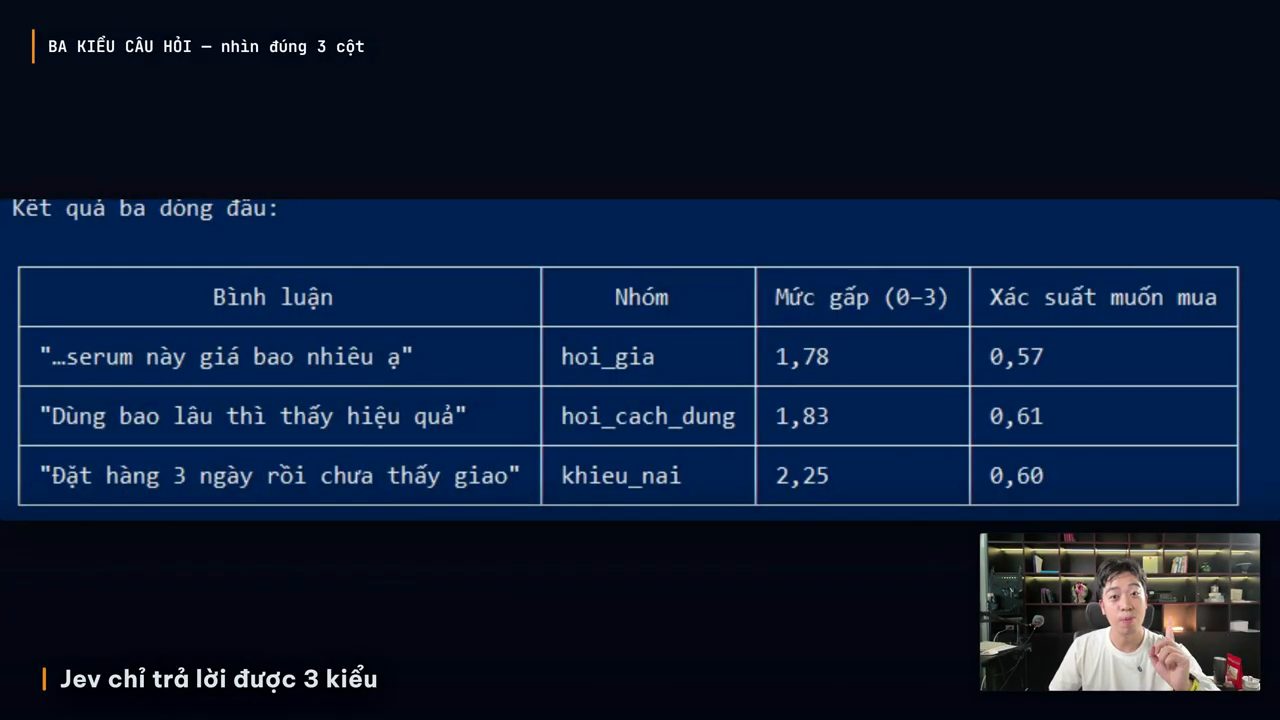
Kiểu một là chọn một trong nhiều. Bạn đưa một danh sách nhãn, nó chọn đúng một. Ở đây là hỏi giá, hỏi cách dùng, khiếu nại, khen và spam. Một danh sách được tối đa 250 nhãn. Dòng đầu tiên là "serum này giá bao nhiêu ạ", nó chọn hỏi giá với mức chắc chắn 100%.
Kiểu hai là chấm mức. Bạn đưa cho nó một thang có thứ tự, nó chỉ vào một bậc. Ở đây là mức độ gấp, có 4 bậc. Thanh bảo chú ý chỗ này: nó không trả về một bậc chẵn, nó trả về 1,78, tức là đứng giữa bậc 1 và bậc 2 nhưng hơi nghiêng về 2.
Kiểu ba là đúng hay sai. Bạn đưa cho nó một mệnh đề, nó trả về xác suất mệnh đề đó đúng. Ví dụ "người này có đang thực sự muốn mua không" thì nó trả về 0,57.
Chỉ có ba "viên gạch" như vậy. Nhưng theo Thanh, mọi quyết định lặp đi lặp lại trong công việc đều được xếp từ ba viên gạch này.
9. Chỗ đáng ngờ đầu tiên trong kết quả
Ngay tại đây, trên đúng ba dòng thử, có một chuyện Thanh phải dừng lại để nói. Nhìn cột cuối, cột muốn mua: dòng 1 là 0,57, dòng 2 là 0,61, dòng 3 là 0,60. Mà dòng 3 là dòng khiếu nại, "đặt hàng 3 ngày rồi chưa thấy giao". Tức là một người đang bực vì chưa được giao hàng và một người đang hỏi giá ra gần như cùng một điểm muốn mua.
Cái đó là sai. Và chính model viết script đã tự nói ra chuyện đó, không phải Thanh.
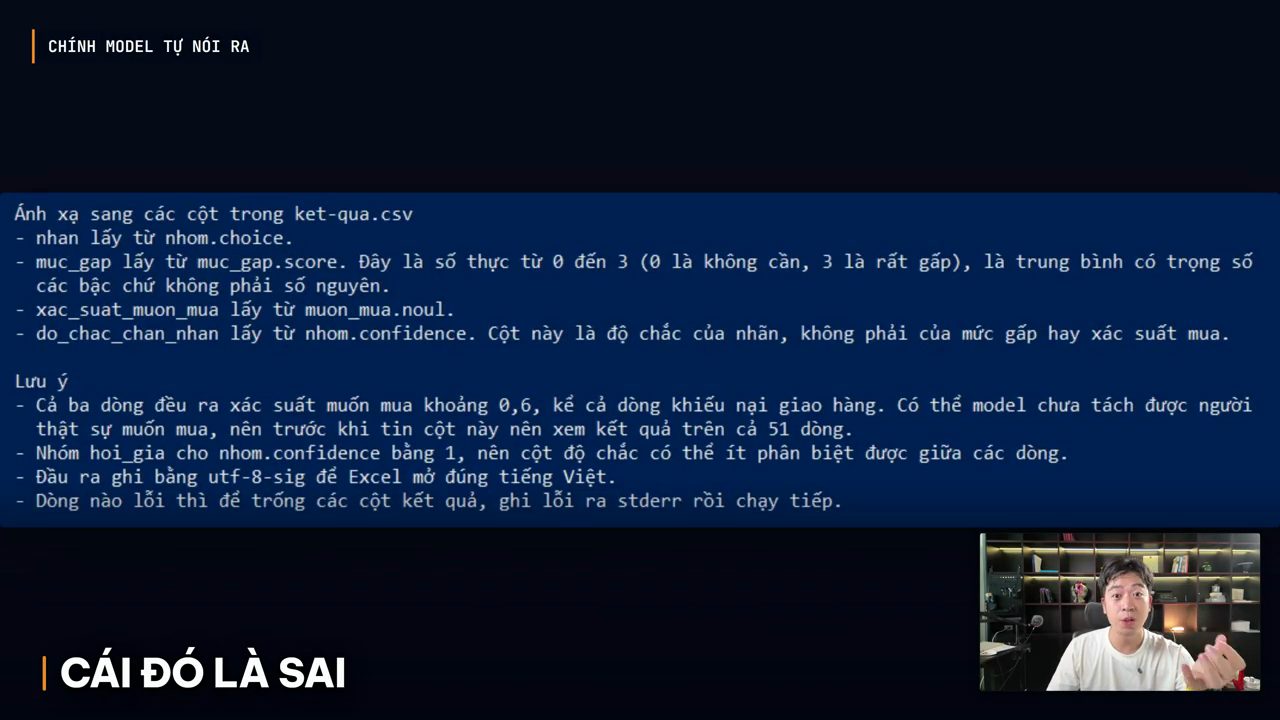
Phần lưu ý trên màn hình ghi rõ: cả ba dòng đều ra xác suất muốn mua khoảng 0,6, kể cả dòng khiếu nại giao hàng; có thể model chưa tách được người thật sự muốn mua, nên trước khi tin cột này nên xem kết quả trên cả 51 dòng. Máy cũng ghi chú thêm rằng mức gấp là trung bình có trọng số các bậc nên là số thực chứ không phải số nguyên, cột độ chắc chắn là độ chắc của nhãn chứ không phải của mức gấp hay xác suất mua, nhóm hỏi giá cho độ chắc bằng 1 nên cột này có thể ít phân biệt được giữa các dòng, file được ghi bằng utf-8-sig để Excel mở đúng tiếng Việt, và dòng nào lỗi thì để trống các cột kết quả, ghi lỗi ra stderr rồi chạy tiếp.
Thanh đánh dấu chỗ này lại để lát nữa quay lại kiểm tra. Với ví dụ của anh, máy hỏi có chạy hết 51 dòng không. Anh cho nó chạy.
10. Vì sao Jev nhanh: tư duy nhanh và tư duy chậm
Trong lúc chờ máy chạy, Thanh giải thích chỗ hay nhất về mặt kỹ thuật, cũng là chỗ rất ít người nói đúng. Công ty làm ra Jev đặt tên cho sự khác biệt này bằng một khái niệm có thể bạn đã nghe: tư duy nhanh và tư duy chậm.
Tư duy chậm là khi bạn ngồi xuống cân nhắc một quyết định lớn: có nên đổi việc hay không, có nên vay tiền mua nhà hay không. Khi đó bạn phân tích, viết ra giấy, và mất thời gian. Tư duy nhanh là khi bạn nhìn mặt một người và biết ngay họ đang khó chịu. Bạn không cần phân tích gì cả, và chỉ cần khoảng một phần mười giây để biết.
Tất cả các model AI hiện nay đều là tư duy chậm. Chúng suy luận thành lời, và càng ngày càng suy luận nhiều hơn. Jev là model đầu tiên được làm ra chỉ để tư duy nhanh: nó không suy luận, nó phản xạ.
Và đây mới là điểm kỹ thuật thực sự. Lúc nãy Thanh hỏi ba câu cùng một lúc. Ba câu đó không chạy nối đuôi nhau mà chạy song song: nó trả lời cả ba trong cùng một lượt. Cho nên hỏi một câu hay tám câu thì về mặt thời gian kết quả gần như ngang nhau. Đó mới là lý do gốc của tốc độ, chứ không phải vì nó chạy trên máy chủ khoẻ hơn.
Toàn bộ vòng phản hồi của nó, từ lúc tiếp nhận thông tin tới lúc trả lời, mất từ 70 đến 500 phần nghìn giây, nhanh hơn một cái chớp mắt. Người sáng lập nói thẳng: suốt 4 năm nay các model chỉ được tối ưu để làm hài lòng người đọc, nhưng phần lớn công việc thật trong doanh nghiệp không cần một câu trả lời hay. Nó cần một quyết định đúng, nhanh, và lặp lại được 10.000 lần. Khẩu hiệu của họ là làm một model để chạy trong hệ thống thật, chứ không phải để thi thố sự thông minh.
11. Chạy hết 51 dòng với giá khoảng 25 đồng
Quay lại màn hình, Thanh cho xem quá trình chạy: 10 trên 51, rồi 20, 30, 40, 50, và xong 51 trên 51, không dòng nào lỗi.
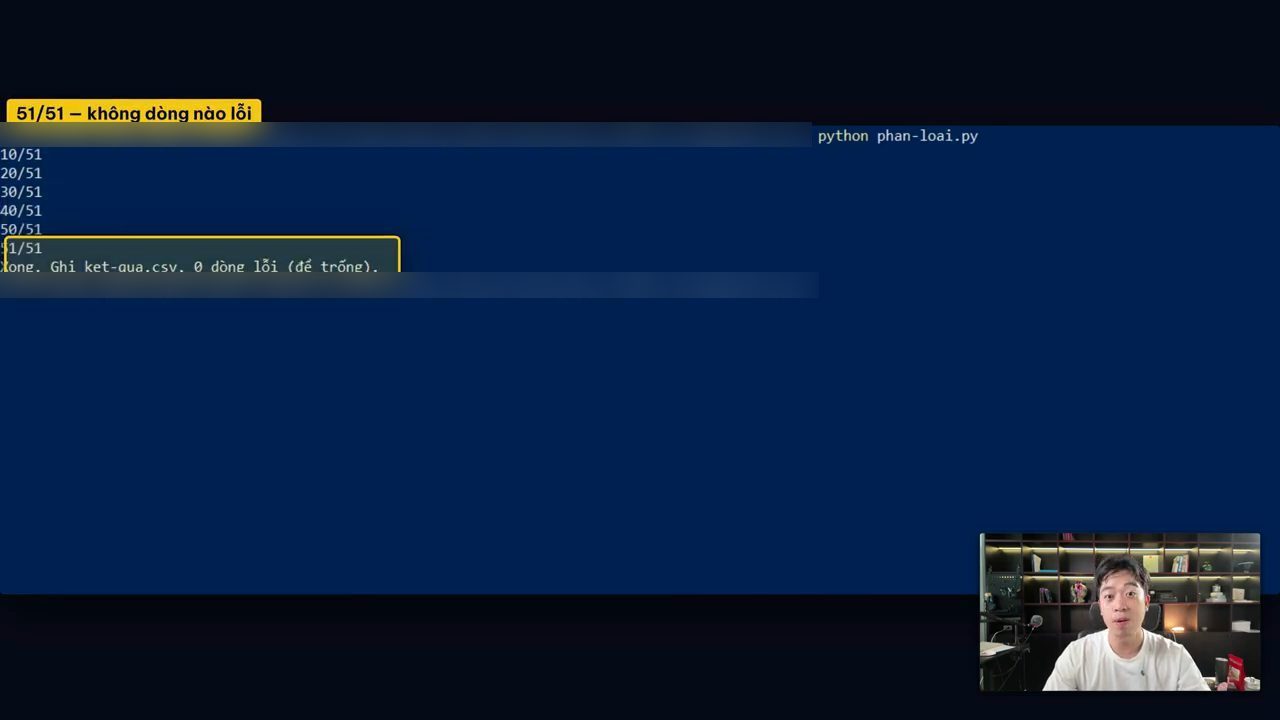
python phan-loai.py chạy qua 51 dòng theo từng nấc 10, 20, 30, 40, 50 rồi 51/51, và in "Xong. Ghi ket-qua.csv, 0 dòng lỗi (để trống)."Lúc nãy máy ước tính chi phí khoảng 0,001 đô, tức là cỡ 25,5 đồng, cho cả 51 bình luận, mỗi bình luận ba câu hỏi.
12. Cột độ chắc chắn, phần hầu như không ai chỉ bạn
Bây giờ tới phần mà theo Thanh hầu như không ai chỉ cho bạn. Anh mở file kết quả và nhìn cột độ chắc chắn. Điều làm model này khác mọi cách phân loại cũ không phải là nó phân loại đúng hơn, mà là nó nói cho bạn biết nó chắc chắn bao nhiêu, và con số đó được hiệu chỉnh để đúng theo nghĩa đen. Khi nó nói chắc 70%, tức là trong 100 lần như vậy nó sẽ đúng khoảng 70 lần. Nghe là những con số khô khan, nhưng nó đổi hoàn toàn cách bạn làm việc.
Thanh lọc ra 6 dòng mà chính model tự chấm là thiếu chắc chắn nhất trong cả file, rồi đọc thử xem nó "dốt" ở chỗ nào.
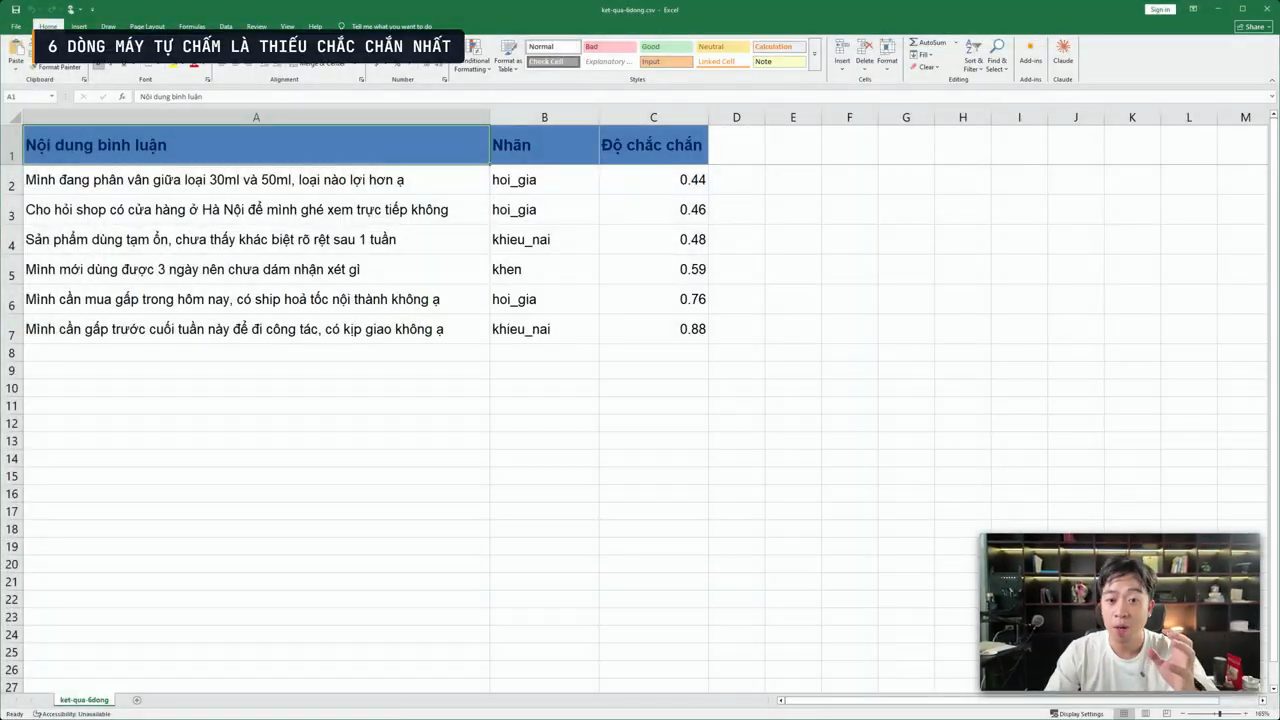
- "Mình đang phân vân giữa loại 30ml và 50ml, loại nào lợi hơn ạ?": 0,44.
- "Cho hỏi shop có cửa hàng ở Hà Nội để mình ghé xem trực tiếp không?": 0,46.
- "Sản phẩm dùng tạm ổn, chưa thấy khác biệt rõ rệt sau 1 tuần": 0,48.
- "Mình mới dùng được 3 ngày nên chưa dám nhận xét gì": 0,59.
Đọc lại bốn câu đó thì câu nào cũng lửng lơ thật. Phân vân giữa hai loại thì là hỏi giá hay hỏi cách dùng? Dùng tạm ổn nhưng chưa thấy khác biệt thì là khen hay chê? Theo Thanh, nó không dốt ở mấy dòng đó; nó đang nói đúng rằng mấy dòng đó mơ hồ thật. Còn lại 45 trên 51 dòng, anh thấy nó chắc từ 80% trở lên.
13. Đặt ngưỡng: khi nào để máy tự xử lý
Cách dùng con số này như sau:
- Trên 90%: để hệ thống tự xử lý, tự gắn nhãn, tự chuyển cho đúng người.
- Dưới 60%: tự đọc bằng mắt.
- Ở giữa, từ 60 đến 90%: tuỳ việc đó quan trọng tới đâu mà bạn quyết định.
So với ChatGPT hay Claude thì khác đúng ở chỗ này. ChatGPT cũng phân loại được, thậm chí khéo hơn, nhưng nó luôn trả lời với giọng chắc nịch như nhau, kể cả khi nó đang đoán, và bạn không có cách nào biết khi nào nên tin. Ở đây bạn có một con số để đặt ngưỡng, và chỉ khi có ngưỡng bạn mới dám để máy tự chạy mà không cần ngồi canh.
14. Nghi ngờ đúng một nửa, và đó là lỗi của người ra đề
Giờ Thanh quay lại chỗ đã đánh dấu: cột muốn mua. Anh soi cả 51 dòng, và kết quả là nghi ngờ lúc nãy chỉ đúng một nửa.
Một nửa là chỗ model có lý, khi nhìn theo nhóm: các dòng spam trung bình chỉ khoảng 30% muốn mua, các dòng hỏi giá trung bình 64%. Nghĩa là nó đã đẩy đi đúng hướng.
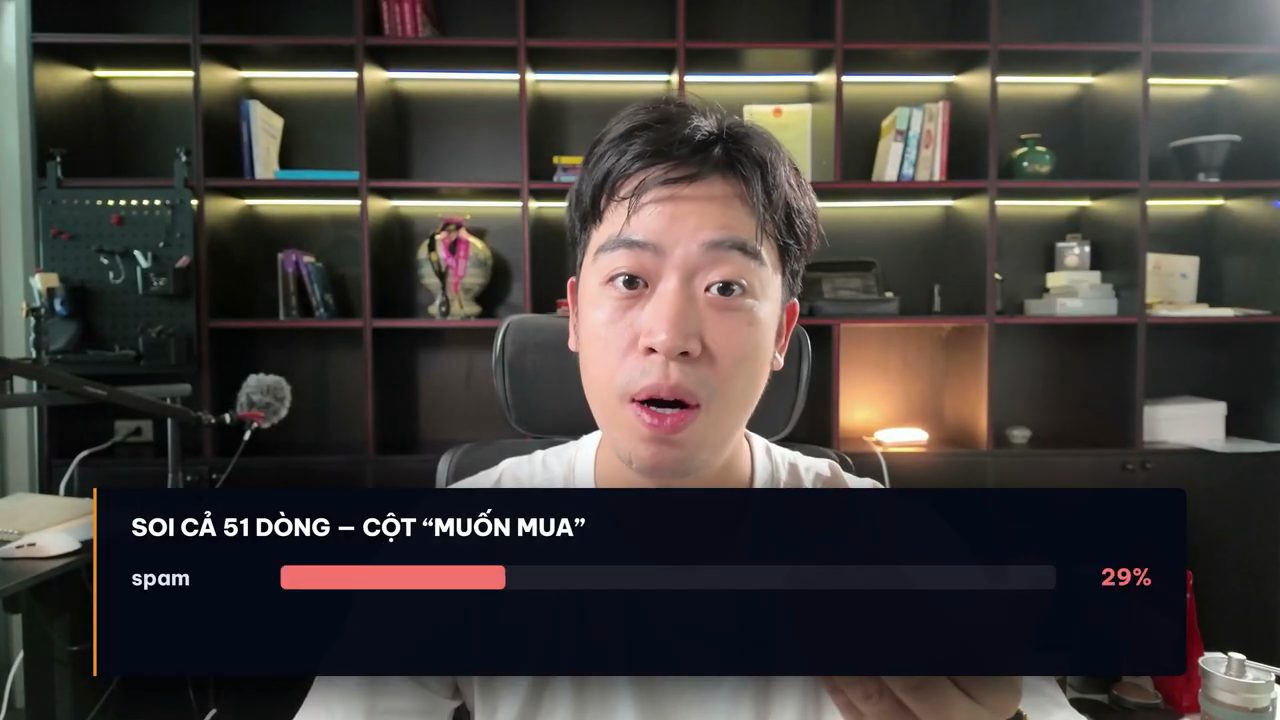
Nửa còn lại mới là chỗ cần chú ý: gần một nửa số dòng nằm dồn trong khoảng 50 đến 70%, và trung bình cả file là 53%. Mà 53% thì có nghĩa gì với bạn? Thực ra chẳng có nghĩa gì cả. Bạn không thể đặt một cái ngưỡng trên một cột như thế.
Và theo Thanh, lỗi này không phải lỗi của model mà là lỗi của anh, người ra đề. Anh đã hỏi một câu quá mơ hồ: "người này có thực sự muốn mua không?". Câu đó kéo theo rất nhiều câu hỏi xung quanh: muốn mua là muốn mua hôm nay, muốn mua trong tháng này, hay chỉ đang ngắm? Câu hỏi mơ hồ thì câu trả lời cũng mơ hồ. Chỉ cần sửa câu hỏi thành "người này có đang hỏi để chốt đơn trong hôm nay không", tức là cụ thể, có mốc thời gian, có hành động, thì con số sẽ tách ra về hai phía ngay.
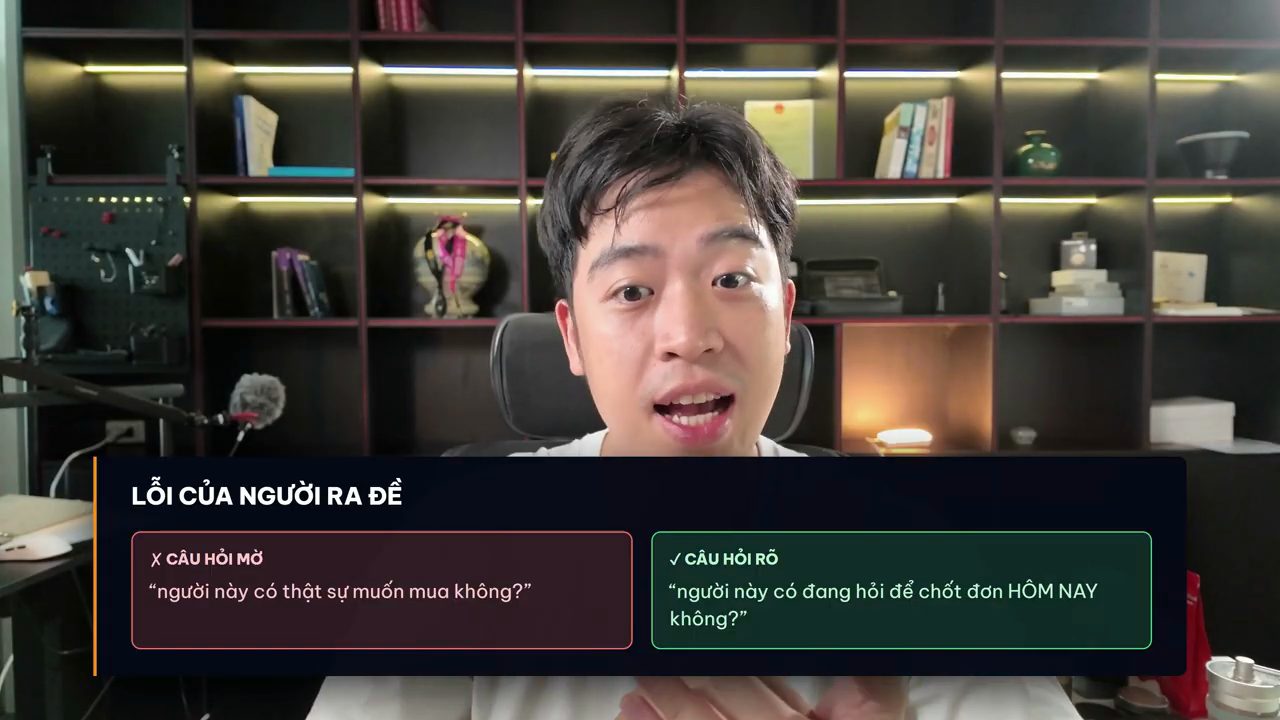
Đây là bài học giá trị nhất Thanh muốn nói trong video: model không đọc được ý của bạn, nó chỉ trả lời đúng cái bạn hỏi.
15. Ba lỗi người mới dùng hay vấp
Tiếp theo là ba lỗi mà gần như ai mới dùng cũng vấp phải.
Lỗi thứ nhất: bắt nó làm việc nó không làm được. Tài liệu chính thức ghi rõ nó không biết tính toán, không biết đếm, không so sánh được ngày tháng và không suy luận nhiều tầng. Thanh kể đã thấy trong một video nước ngoài có người nối nó vào tín hiệu mua bán Bitcoin và thua đều. Cũng đúng thôi, vì đó là việc cần suy luận và cần tin tức bên ngoài, không phải việc phản xạ. Nếu câu hỏi của bạn cần chữ "vì sao" thì đừng dùng model này; nó chỉ trả lời được "cái nào" và "bao nhiêu".
Lỗi thứ hai: đặt nhãn chồng lấn lên nhau. Nếu bạn để hai nhãn "khiếu nại" và "phản hồi tiêu cực" cạnh nhau, nó sẽ chia đôi xác suất, và độ chắc chắn sẽ tụt xuống thấp ở mọi dòng. Không phải nó ngu, mà vì bạn hỏi không rõ. Các nhãn phải tách bạch, và mỗi nhãn nên kèm một câu mô tả.
Lỗi thứ ba: tin con số quảng cáo là thật. Thanh nói công ty tự công bố Jev nhanh hơn 20 đến 200 lần, nhưng đó là họ tự đo bằng quy trình nội bộ; TechCrunch đo độc lập thì chỉ ra nhanh hơn 5 đến 18 lần. Nó vẫn rất nhanh, nhưng không phải con số 200.
Trong phần mô tả video, chính Thanh đính chính hai chỗ này. Con số hãng công bố thực ra là nhanh hơn 40 đến 200 lần và rẻ hơn 40 đến 400 lần, đỉnh là 193,6 lần. Người đo ra 5 đến 18 lần là Vercel (đo p95 trên công cụ nội bộ của họ), TechCrunch chỉ đưa tin lại; mà Vercel là đối tác bán Jev nên chưa phải bên trung lập. Các bên thứ ba trung lập đo lại chỉ còn 2 đến 5 lần. Luận điểm của anh vẫn nguyên: càng bên trung lập đo thì con số càng tụt, từ 193,6 lần (hãng tự đo) xuống 5 đến 18 lần (đối tác) rồi 2 đến 5 lần (bên thứ ba).
Nhân chuyện hoài nghi, Thanh kể chưa đầy một tuần sau khi Jev ra mắt đã có một model mã nguồn mở tên là Laya làm đúng việc tương tự: 421 triệu tham số, chạy với dưới 1GB bộ nhớ, tải về tự do và chạy được ngay trên laptop hoặc điện thoại của bạn.
Bảng điểm của Laya nói nó nhanh hơn Jev tới 8 lần. Nhưng công bằng mà nói, bảng điểm đó cũng do chính những người làm Laya công bố, và bản gốc của Laya khi chưa tinh chỉnh thì gần như chỉ đoán bừa; toàn bộ thành tích đến từ việc huấn luyện thêm. (Phần mô tả video ghi chính xác hơn: Laya nhanh hơn Jev 7,8 lần, chỉ đúng sau khi tinh chỉnh trên đúng bộ dữ liệu đó, còn bản gốc chạy chay chỉ đạt 0,362.) Về phía Jev, tới giờ hãng vẫn chưa công bố kiến trúc, số tham số hay cách huấn luyện. Cả hai bên đều đang tự chấm điểm cho chính mình, và Thanh nói góc nhìn của cả hai phía để người xem tự đánh giá.
16. Nghịch lý Jevons: rẻ đi 100 lần thì dùng nhiều hơn
Còn một chuyện quan trọng mà ít người nhắc tới, và nó nằm ngay trong cái tên. Jev lấy từ Jevons, William Stanley Jevons, một nhà kinh tế người Anh ở thế kỷ 19.
Ông phát hiện ra một chuyện ngược đời. Hồi đó nước Anh vận hành bằng than đá. Khi người ta cải tiến máy hơi nước để đốt ít than hơn cho cùng một công việc, ai cũng nghĩ nước Anh sẽ tiêu ít than hơn. Sự thật diễn ra ngược lại hoàn toàn: nước Anh tiêu thụ than nhiều hơn hẳn. Vì khi than trở nên rẻ, người ta bắt đầu dùng than cho những việc trước đây chẳng ai nghĩ tới. Máy hơi nước từ đó chui vào nhà máy dệt, vào tàu hoả, tàu thuỷ, vào mọi thứ.
Công ty này đặt tên model theo đúng nghịch lý đó. Họ nói thẳng ngay từ đầu: rẻ hơn 100 lần sẽ không làm bạn tiết kiệm được đồng nào, mà nó khiến bạn dùng AI ở những chỗ trước đây bạn không dám nghĩ tới.
Thanh lấy ví dụ cụ thể với công việc của người xem. Hôm nay bạn có cho AI đọc từng bình luận trên mọi bài đăng của mình không? Chắc chắn là không, vì quá tốn; thường chúng ta chỉ đọc vài bình luận nổi lên trên đầu. Bạn có chấm điểm từng tin nhắn inbox theo thời gian thực để biết ai đang thực sự muốn mua không? Cũng không, ai mà làm nổi. Bạn có bắt AI đọc lại toàn bộ 2 năm tin nhắn cũ để tìm những khách hàng đã bỏ lỡ không? Chắc chắn là không luôn.
Thanh vừa cho xem cái giá của việc thứ nhất: khoảng 25 đồng. Cả ba việc kia cũng chỉ là cái giá đó nhân lên. Theo anh, đó mới là chuyện đang xảy ra: không phải AI thông minh hơn, mà là cái sàn giá đang sụp xuống. Những việc trước đây vô lý về mặt kinh tế thì bây giờ đã thành hiển nhiên.
17. Tóm lại ba câu và việc cho bạn làm trong 20 phút
Thanh tóm lại ngắn gọn bằng ba câu.
- Đây không phải là AI thông minh hơn, mà là một loại AI khác hẳn: chỉ ra quyết định chứ không viết chữ, trả kết quả cho phần mềm chứ không cho người đọc.
- Giá trị thật không nằm ở chỗ nó nhanh, mà ở chỗ nó kèm theo một con số chắc chắn để bạn đặt ngưỡng. Có ngưỡng thì bạn mới dám để máy tự chạy. Và nếu những con số đó mơ hồ thì hãy tự soi lại câu hỏi của mình trước khi đổ lỗi cho máy.
- Khi một thứ rẻ đi 100 lần, bạn sẽ không tiêu ít tiền hơn, mà sẽ bắt đầu dùng nó ở những chỗ trước đây không dám nghĩ tới.
Rồi tới lượt người xem, chỉ khoảng 20 phút: lấy khoảng 50 bình luận hoặc tin nhắn gần nhất của mình, cho chạy qua đúng ba câu hỏi trong video, rồi trả lời một câu duy nhất: trong 50 dòng đó, bao nhiêu dòng máy đã tự xử lý được mà bạn không cần đụng tới? Theo Thanh, đó chính là số giờ mỗi tuần bạn đang đốt vào những việc không cần làm nữa.
Anh mời người xem để lại con số của mình trong phần bình luận, vì anh muốn xem các ngành khác nhau (bán hàng, dịch vụ, đào tạo) ra những con số khác nhau thế nào; chắc chắn chúng sẽ không giống nhau. Ai bị kẹt ở bước nào thì cứ mô tả cụ thể, anh sẽ trả lời từng người. Cuối video, anh mời theo dõi kênh và hẹn gặp lại ở video sau.
Nguồn và liên kết 6 nguồn
- Tên gốc: JEV - Con AI không viết nổi một chữ - và nó phá kỷ lục của Vercel trong 24 giờ
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=P8C3Lukop3E youtube.com
- Kênh YouTube Thanh Trần - 5 Phút AI (Thanh Trần): youtube.com/channel/UCTumIe5W_2OoKUEDAq3xsKQ youtube.com
- Trang chủ TypeSafe AI, hãng làm ra Jev và các model System One: typesafe.ai typesafe.ai
- Laya, model mã nguồn mở làm việc tương tự Jev (421 triệu tham số, giấy phép Apache 2.0): huggingface.co/convaiinnovations/laya huggingface.co
Related talks
Làm chủ Grok Bot qua bốn cấp độ
Matt Palmer & Alex Lieberman · Tenex · 16 min
Bốn cấp độ dùng Grok Bot: gom thông tin nhiều tool, bot gọi bot và channel, CRM từ mạng lưới X, rồi Grok Bot làm outer loop cho Cursor.
5 cấp độ dùng AI: từ copy paste tới hơn 1.000 agent
Thanh Trần · Thanh Trần - 5 Phút AI · 11 min
Thang 5 cấp dùng AI đo bằng số agent, demo 6 agent tự soát lỗi nhau, vì sao nên dùng Auto Mode thay cờ bỏ qua quyền, và việc cần làm tuần này.
Build AI agent bằng Claude Code và UiPath skills
Garrick Chow · Kevin Stratvert · 18 min
Cài UiPath CLI để nạp skill vào Claude Code, build một agent phân loại support ticket từ một prompt, test ở local rồi push lên UiPath.