Tăng tốc coding agent với Jev và Google Antigravity
Jev trả quyết định có kiểu (Choice, Score, Noul) trong khoảng 50 ms cho agent loop; cài TypeSafe skill vào Antigravity và dựng model router Gemini.
✓ Đã duyệt độc lập · cập nhật 15/10/2026 · 8 min
1. Agent loop chậm vì LLM phải viết chữ
Smitha Kolan mở đầu bằng mục tiêu của video: chỉ cho người xem cách dùng Jev cùng các coding agent như Google Antigravity, Claude Code hay Codex. Chị giải thích vấn đề trước. Các LLM tiêu chuẩn được xây ra để viết text. Điều đó khiến chúng rất giỏi ở nhiều việc, nhưng khi bạn chạy agent loop với tần suất thật cao, bạn sẽ bắt đầu thấy latency ở đó: mỗi vòng lặp phải chờ model sinh ra chữ.
Jev thì khác. Theo Smitha, đây là một model chuyên biệt, được xây để đưa ra các quyết định không phải dạng text (non-text decisions) trong chưa tới 50 mili giây. Trong video, chị hứa sẽ đi qua ba phần: Jev hoạt động chính xác ra sao, người ta đang build những gì với nó, và cách nối nó vào Google Antigravity từng bước một.
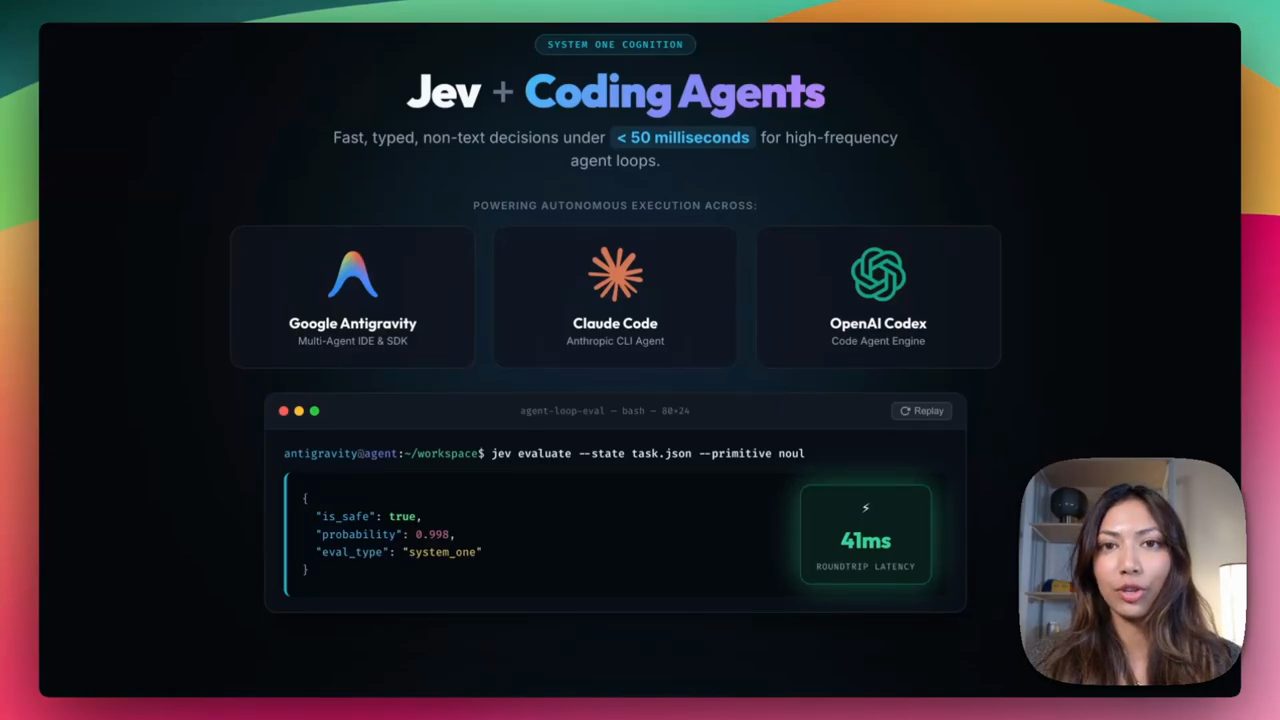
jev evaluate --state task.json --primitive noul trả về is_safe: true, probability 0.998, roundtrip latency 41 ms.2. Token generation và classification: 1 giây so với 50 mili giây
Vậy Jev chạy thế nào? Smitha đưa một ví dụ rất đơn giản. Một agent loop cần biết một lệnh shell có an toàn để chạy hay không. Thông thường, nó sẽ hỏi một LLM đa dụng (general-purpose) như Gemini, Claude, v.v. Và kể cả khi đã bật JSON mode hay structured outputs, model vẫn sinh text từng token một: nghĩa là từng dấu ngoặc, từng dấu nháy, từng tên field, từng giá trị. Chính việc sinh chữ đó tạo ra latency, thường mất một giây hoặc hơn chỉ để trả về một kết quả Boolean rất đơn giản.
Jev được xây theo cách hoàn toàn khác vì nó không sinh text tổng quát. Nó hoạt động như một classification model. Bạn đưa dữ liệu vào, nó đánh giá các câu hỏi của bạn về dữ liệu đó trong một lượt duy nhất (single pass), rồi trả về các giá trị có kiểu (typed values): Boolean hoặc điểm số dạng số. Nó làm việc này trong khoảng 50 mili giây, và bạn không cần parse text gì cả.
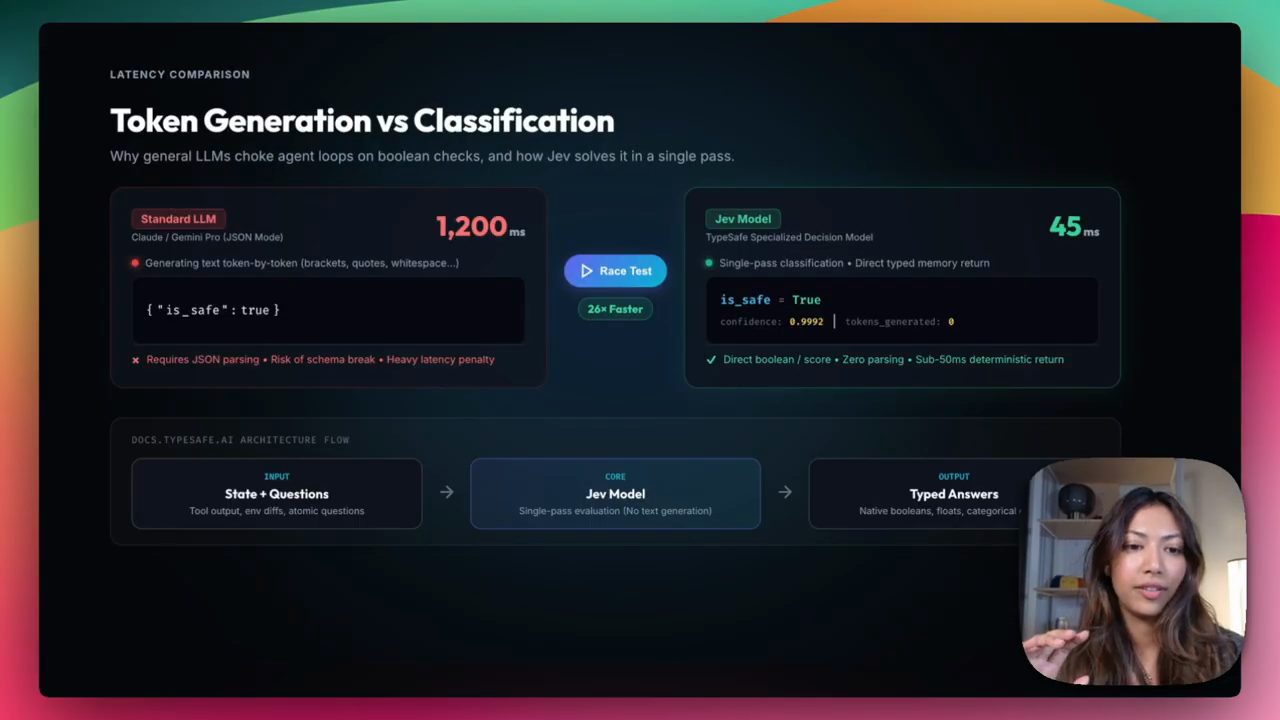
{"is_safe": true} từng token, mất 1.200 ms, cần parse JSON và có rủi ro vỡ schema. Bên phải, Jev Model của TypeSafe trả is_safe = True với confidence 0.9992 và 0 token sinh ra, mất 45 ms, nhanh hơn khoảng 26 lần. Dòng dưới cùng là luồng kiến trúc: State + Questions, qua Jev Model, ra Typed Answers.Nói gọn lại, thay một lần gọi LLM mất cỡ hai giây bằng một lần đánh giá chừng 50 mili giây của Jev sẽ giúp cải thiện latency của cả vòng lặp. Tuy vậy, Smitha nhấn mạnh rằng Jev không được thiết kế để thay các large language model truyền thống trong việc reasoning. Nó chỉ đóng vai một lớp đánh giá (evaluation layer) đứng song song bên cạnh chúng. Chị coi đây là điều thật sự quan trọng cần mang về từ video.
3. State, questions và ba primitive: Choice, Score, Noul
Tiếp theo, Smitha đi sâu hơn vào cách Jev hoạt động. Bạn đưa cho Jev hai thứ: state (trạng thái, dữ liệu ngữ cảnh) và questions (các câu hỏi). Jev trả lại cho bạn ba kiểu dữ liệu nguyên thuỷ (primitive types) khác nhau:
- Choice: chọn một phương án từ một danh sách định nghĩa sẵn.
- Score: dựa trên câu hỏi bạn đặt ra, Jev chấm task theo một thang số.
- Noul: về cơ bản là một xác suất từ 0 tới 1 cho các mệnh đề đúng hoặc sai.
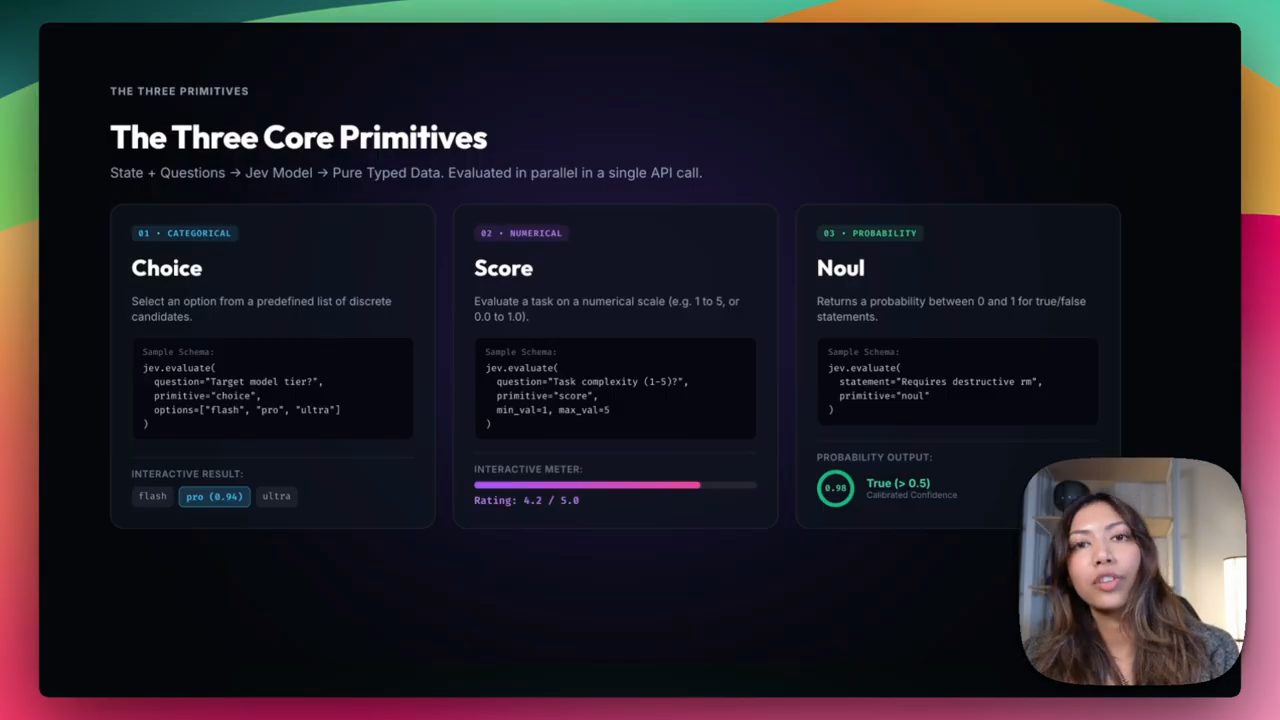
Các schema mẫu trên slide cho thấy cách gọi trông ra sao. Với Choice, bạn truyền câu hỏi, tên primitive và danh sách lựa chọn:
jev.evaluate(
  question="Target model tier?",
  primitive="choice",
  options=["flash", "pro", "ultra"]
)
Với Score, bạn truyền câu hỏi và khoảng giá trị:
jev.evaluate(
  question="Task complexity (1-5)?",
  primitive="score",
  min_val=1, max_val=5
)
Với Noul, bạn truyền một mệnh đề (statement) để Jev trả về xác suất nó đúng:
jev.evaluate(
  statement="Requires destructive rm",
  primitive="noul"
)
4. Nhiều câu hỏi trong một lần gọi, và chuyến bay Zürich tới London trong 7,1 giây
Mỗi lần đưa một state cho Jev, bạn cũng có thể hỏi nhiều câu cùng lúc trong một API call duy nhất. Jev đánh giá các câu hỏi đó song song trên cùng ngữ cảnh của bạn, rồi trả về tất cả các giá trị có kiểu kèm confidence score và các thông tin khác.
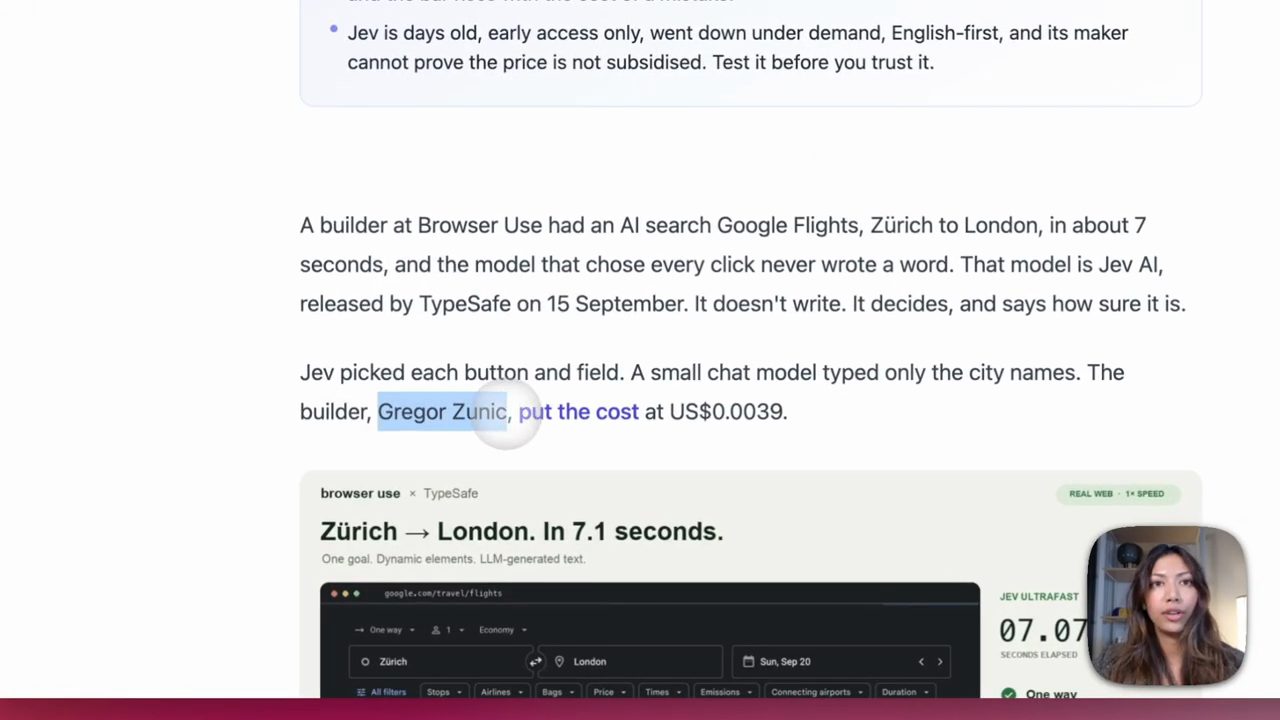
Vì Jev bỏ qua được latency của việc sinh token, theo Smitha, nhiều developer đang dùng các primitive này cho các vòng quyết định nhanh, tần suất cao. Chị kể một ví dụ được chia sẻ gần đây: Gregor Zunic làm một project open source dùng Jev để điều hướng Google Flights, và tìm được vé từ Zürich tới London trong chưa tới 7,1 giây. Anh làm được như vậy bằng cách đánh giá mọi hành động click và nhập liệu có thể có cùng một lúc, trong một lượt khoảng 50 mili giây. Smitha nhận xét đó là một ví dụ khá hay.
5. Cài TypeSafe skill vào Google Antigravity
Giờ tới phần dùng Jev với Google Antigravity. Smitha nói có nhiều cách để bắt đầu, nhưng một trong những cách dễ nhất là dùng TypeSafe skill chính thức (TypeSafe là công ty làm ra Jev). Bạn chỉ việc cài skill này vào Google Antigravity, Codex hay thậm chí Claude Code. Slide hướng dẫn cài đặt ghi hai lệnh, tuỳ môi trường:
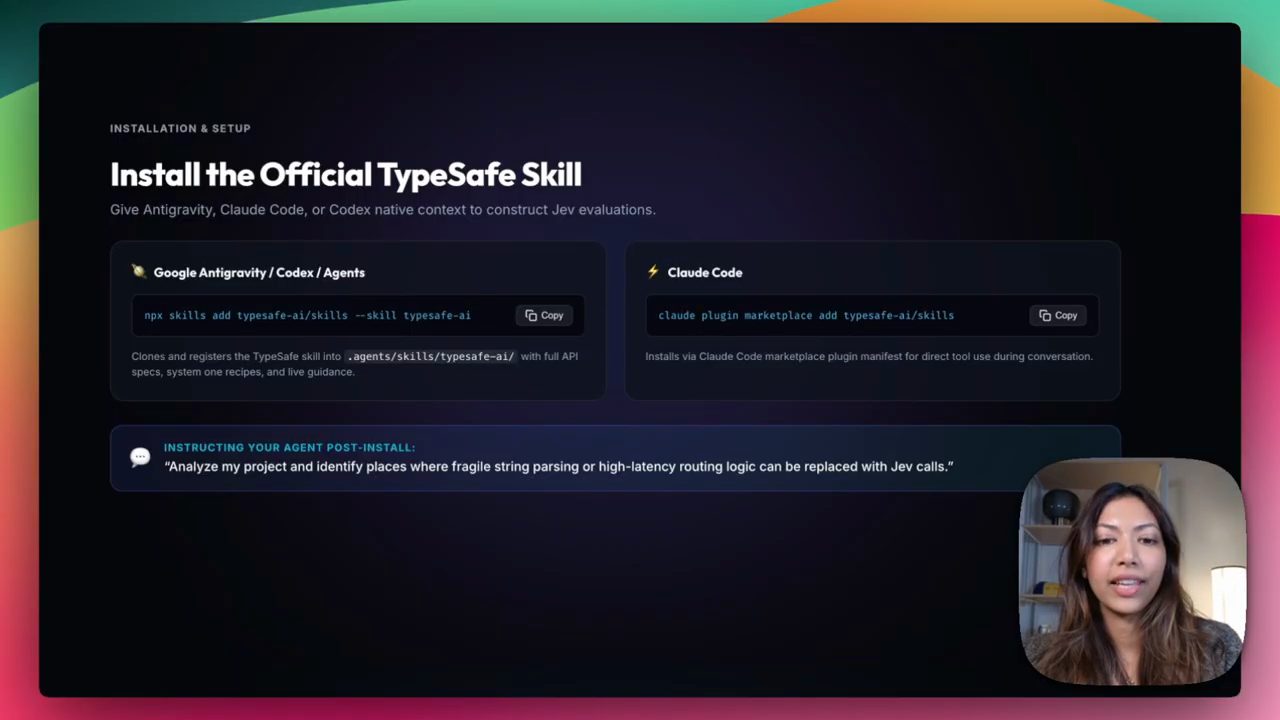
.agents/skills/typesafe-ai/ cùng API spec và các công thức System One). Ô bên phải cho Claude Code, cài qua plugin marketplace. Dòng dưới là câu lệnh mẫu để dặn agent sau khi cài.npx skills add typesafe-ai/skills --skill typesafe-ai
claude plugin marketplace add typesafe-ai/skills
Slide cũng gợi ý một câu để dặn agent ngay sau khi cài:
Analyze my project and identify places where fragile string parsing or high-latency routing logic can be replaced with Jev calls.
Hướng dẫn chi tiết nằm trong trang Agent skill của tài liệu TypeSafe. Nếu không muốn tự cài bằng tay trong terminal, bạn có thể copy rồi dán một prompt có sẵn trên trang đó vào một agent như Google Antigravity, và agent sẽ tự lo phần tải về. Smitha gọi đó là một cách tuyệt vời để bắt đầu, và đó chính là cách chị làm trong video.
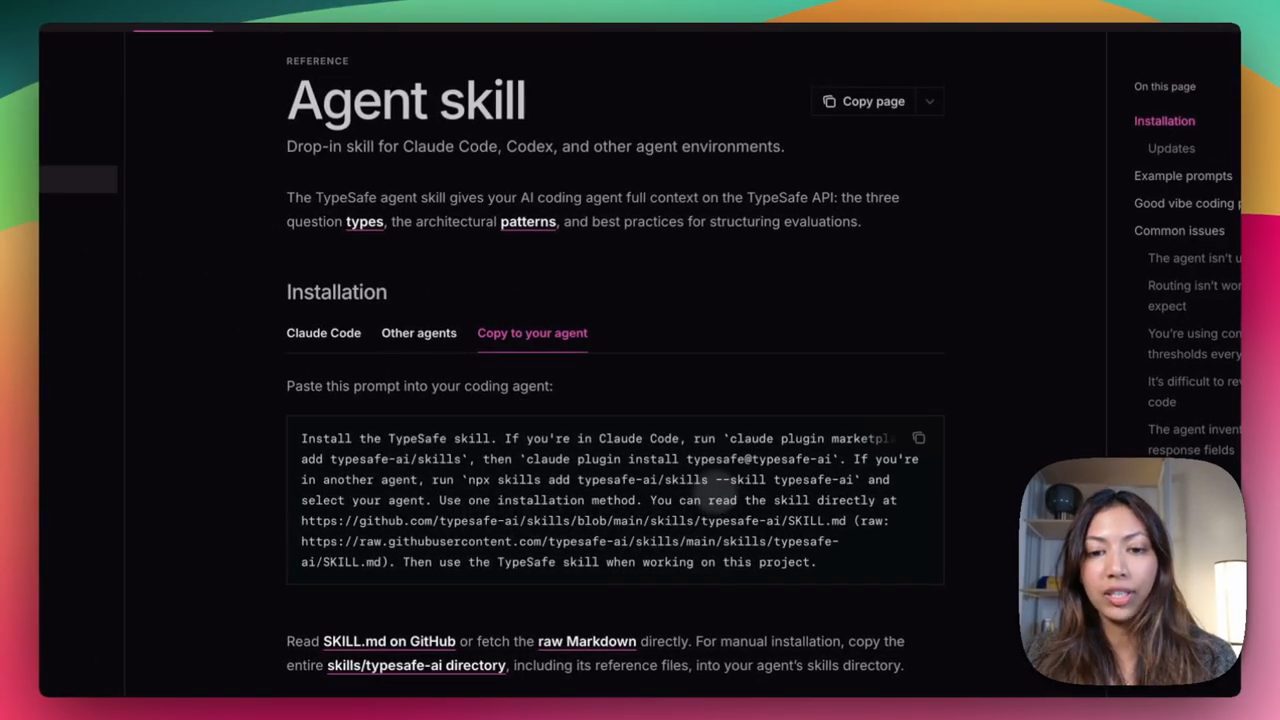
Install the TypeSafe skill. If you're in Claude Code, run `claude plugin marketplace add typesafe-ai/skills`, then `claude plugin install typesafe@typesafe-ai`. If you're in another agent, run `npx skills add typesafe-ai/skills --skill typesafe-ai` and select your agent. Use one installation method. You can read the skill directly at https://github.com/typesafe-ai/skills/blob/main/skills/typesafe-ai/SKILL.md (raw: https://raw.githubusercontent.com/typesafe-ai/skills/main/skills/typesafe-ai/SKILL.md). Then use the TypeSafe skill when working on this project.
Smitha copy prompt này rồi mở Antigravity IDE với một project trống tên antigravity-jev-demo, model đang chọn trong khung Agent là Gemini 3.8 Flash Medium. Chị dán prompt lấy từ tài liệu của TypeSafe AI vào khung chat. Về cơ bản prompt bảo Antigravity tải TypeSafe AI skill về. Chị cho chạy.
Khi chạy xong, bạn sẽ thấy file SKILL.md của TypeSafe AI trong thư mục project, và từ đó có thể bắt đầu prompt với nó.
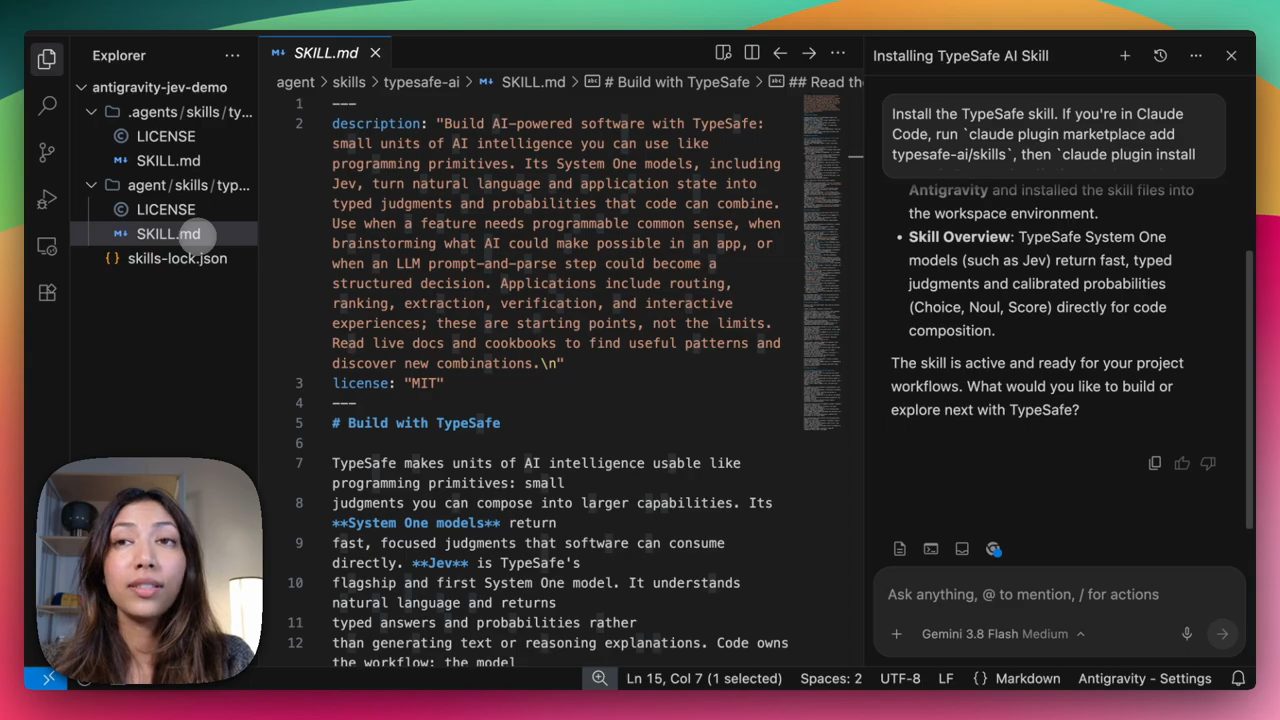
.agents/skills/typesafe-ai và agent/skills/typesafe-ai, mỗi chỗ một LICENSE và SKILL.md, cùng skills-lock.json. File SKILL.md mở ở giữa, phần mô tả nói TypeSafe biến các đơn vị trí tuệ AI nhỏ thành thứ dùng được như primitive lập trình và Jev là System One model chủ lực. Khung Agent bên phải báo skill đã hoạt động, tóm tắt rằng các System One model như Jev trả về judgment có kiểu và xác suất đã hiệu chỉnh (Choice, Noul, Score), rồi hỏi bạn muốn build gì tiếp.6. Prompt mẫu đầu tiên và API key trong TypeSafe console
Trang tài liệu có một vài prompt mẫu để thử Jev ngay trong Google Antigravity. Prompt đầu tiên, theo Smitha, rất hợp để mở một phiên brainstorming giúp bạn tìm ra chỗ nào trong project dùng TypeSafe là đáng nhất:
Using the TypeSafe skill, explore the project and find opportunities for using
intelligent judgement to stand in for complex parsing or other fragile code.
Bạn cũng có thể tạo một API key và cấp quyền cho agent tự tìm cách dùng TypeSafe tốt nhất bằng cách chạy các truy vấn thử rẻ tiền:
Using the TypeSafe skill, run some experiments using the TypeSafe API key that I've
exported to `TYPESAFE_API_KEY`. Propose changes based on the most promising results.
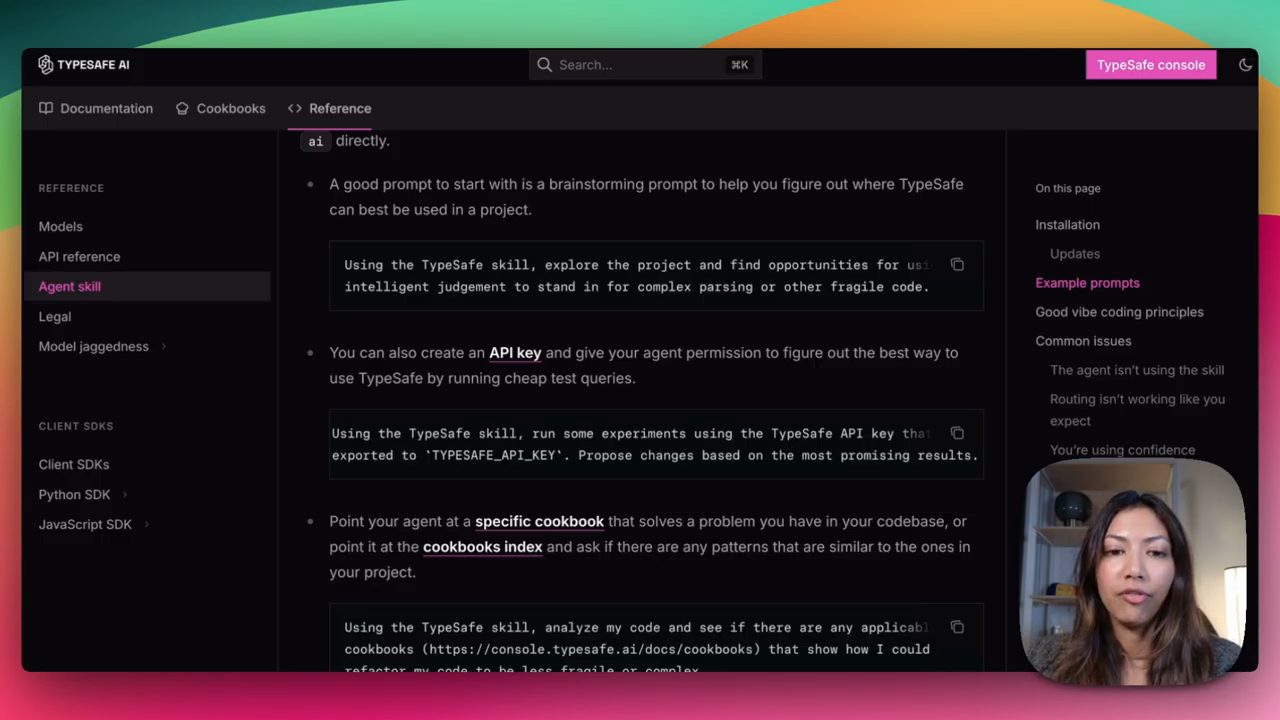
TYPESAFE_API_KEY, và gợi ý thứ ba là trỏ agent vào một cookbook cụ thể hoặc vào danh mục cookbooks để tìm pattern giống với project của bạn.API key nằm trong TypeSafe console; tài liệu có link dẫn tới đó. Smitha mở console cho người xem thấy nó trông thế nào: một trang API keys đơn giản, nơi bạn tạo key rất dễ. Chị đã tạo một key như vậy, rồi dán nó vào file .env trong project trên Google Antigravity.
7. Demo: model router chọn Gemini Flash hay Gemini Pro
Khi đã cài skill và lưu API key TypeSafe trong file .env, Smitha dùng Jev như một kiểu model router bên trong Antigravity. Chị viết một prompt bảo Antigravity tạo một Python script tên router, dùng TypeSafe skill để viết nó. Ý tưởng: mỗi khi chị bảo Antigravity làm hay thực thi một việc, tuỳ độ phức tạp của việc đó, router sẽ chọn Gemini Flash hoặc Gemini Pro.
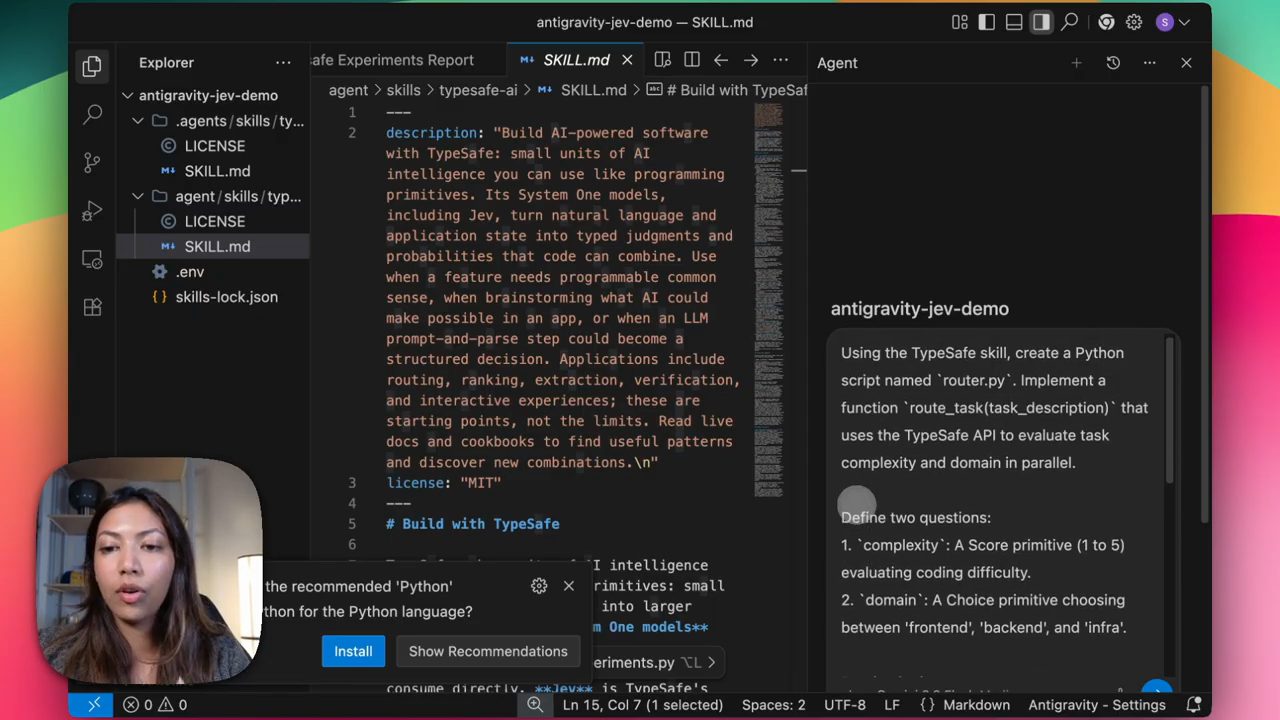
router.py, với hàm route_task(task_description) gọi TypeSafe API để đánh giá song song độ phức tạp và domain của task.Phần prompt nhìn thấy được trên màn hình gồm định nghĩa hàm, hai câu hỏi cho Jev và logic định tuyến:
Using the TypeSafe skill, create a Python script named `router.py`. Implement a function `route_task(task_description)` that uses the TypeSafe API to evaluate task complexity and domain in parallel.

Define two questions:
1. `complexity`: A Score primitive (1 to 5) evaluating coding difficulty.
2. `domain`: A Choice primitive choosing between 'frontend', 'backend', and 'infra'.

Routing logic:
- If complexity <= 2, set selected_model to "gemini-flash".
- If complexity > 2, set selected_model to "gemini-pro".

Return selected_model, domain, and
Câu cuối của prompt bị khung chat che mất một phần trên màn hình. Thiết kế ở đây khớp với hai primitive đã giới thiệu: Score để chấm độ khó từ 1 tới 5, Choice để xếp task vào frontend, backend hay infra, và cả hai câu hỏi được hỏi trong cùng một lần gọi.
Antigravity viết xong router.py và chạy thử với một loạt task mẫu. Trong kết quả của model router chạy bằng Jev bên trong Antigravity, có thể thấy một số task được chuyển cho Gemini Flash, còn các task khó hơn được chuyển cho Gemini Pro. Kết quả cũng ghi latency của từng lần định tuyến tính bằng mili giây, và Smitha chỉ ra mọi thứ chạy nhanh tới mức nào.
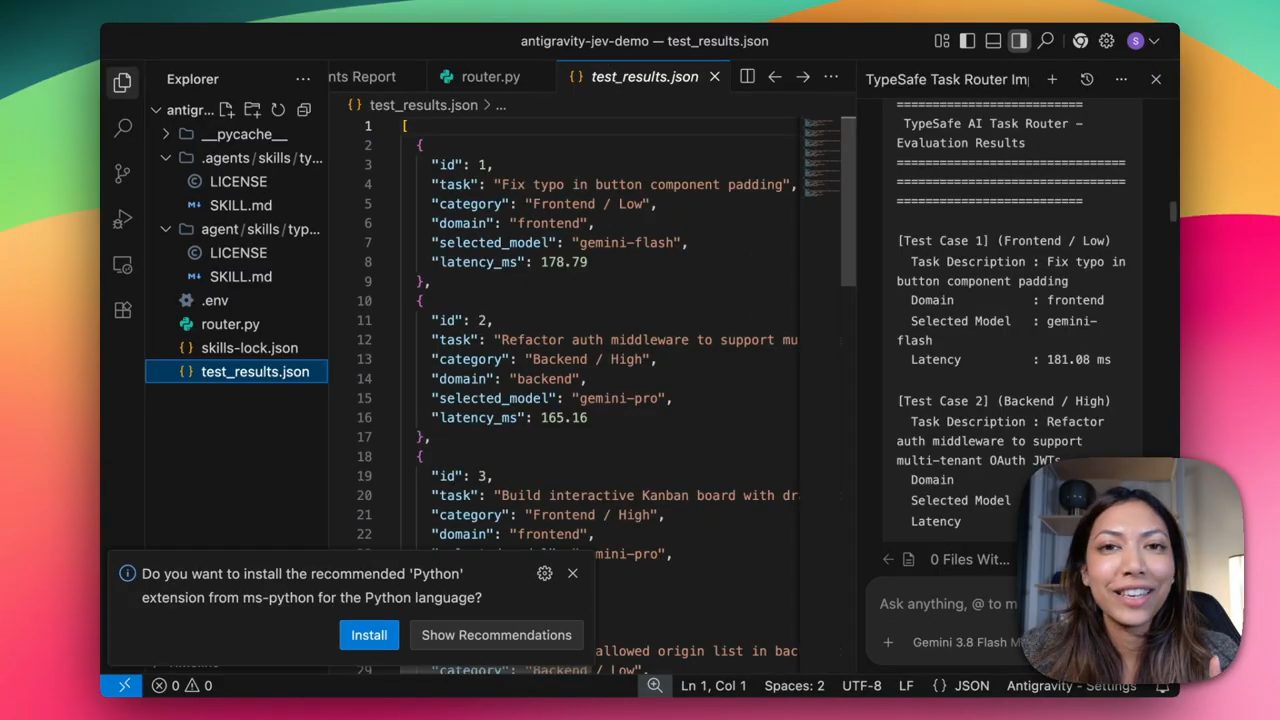
test_results.json và báo cáo "TypeSafe AI Task Router - Evaluation Results". Task 1 "Fix typo in button component padding" (Frontend / Low) đi tới gemini-flash, latency 178.79 ms; task 2 "Refactor auth middleware to support multi-tenant OAuth JWTs" (Backend / High) đi tới gemini-pro, 165.16 ms; task 3 "Build interactive Kanban board..." (Frontend / High) đi tới gemini-pro.Với Smitha, đây là một ví dụ rất hay về thứ bạn có thể build với Jev.
8. Giới hạn của Jev và những gì không nên giao cho nó
Phần cuối nói về các ràng buộc và giới hạn của Jev. Slide "Constraints & Limitations" mở bằng một câu: Jev là classification model chuyên biệt, hãy tuân theo các nguyên tắc sau để có độ chính xác cao nhất. Smitha đi qua bốn thẻ.
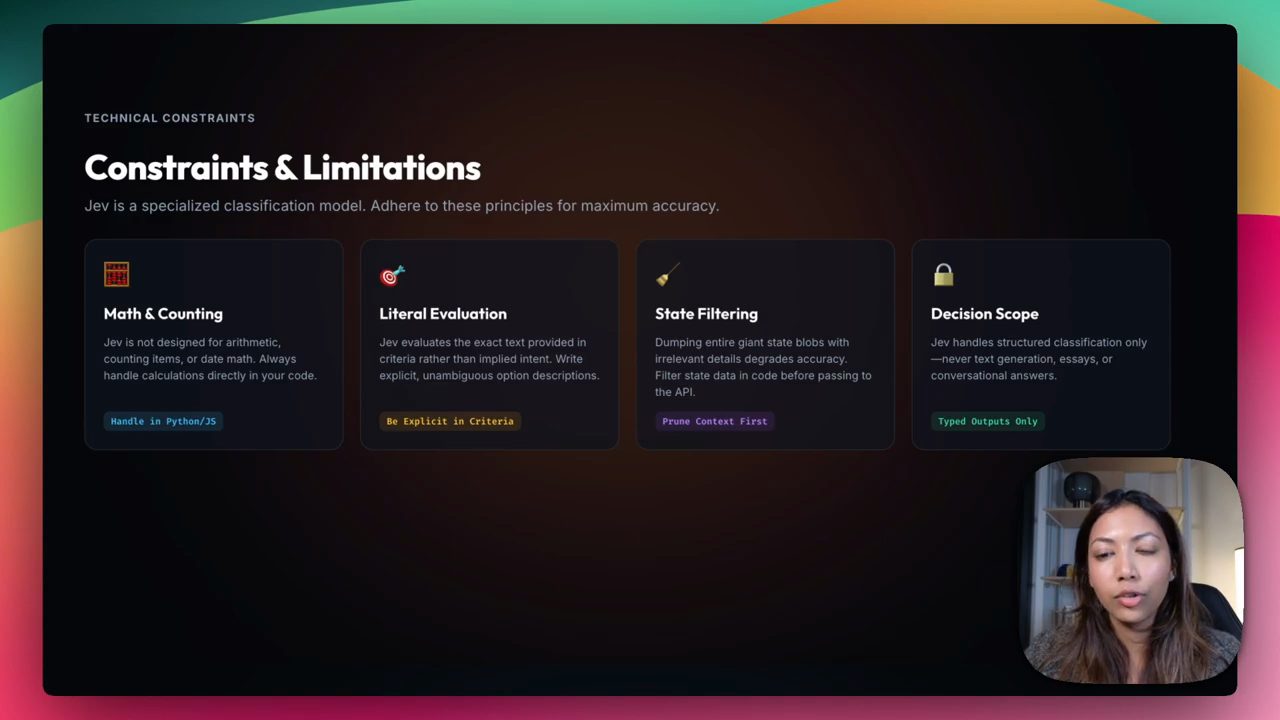
Thứ nhất, Math & Counting. Smitha mở đầu ý này bằng việc Jev không giỏi ở một mảng, rồi chuyển luôn sang ý kế tiếp; trên slide, thẻ đầu tiên ghi rằng Jev không được thiết kế cho số học, đếm phần tử hay tính toán ngày tháng, và các phép tính đó luôn nên làm trực tiếp trong code của bạn (Python hoặc JS).
Thứ hai, Literal Evaluation. Jev cũng không giỏi suy ra ý ngầm. Nó đánh giá đúng nguyên văn text bạn đưa trong tiêu chí (criteria), chứ không đánh giá điều bạn có thể đang ngụ ý. Vì vậy, theo Smitha, điều rất quan trọng là viết mô tả thật tường minh, không mơ hồ. Thẻ trên slide ghi: hãy viết mô tả các option rõ ràng, không nước đôi.
Thứ ba, State Filtering. Jev cũng không hợp với việc tự lọc state: đổ nguyên một state hay một context khổng lồ vào không phải cách hay. Slide nói rõ hơn: đổ cả khối state lớn chứa chi tiết không liên quan sẽ làm giảm độ chính xác, nên hãy lọc state trong code trước khi gửi lên API.
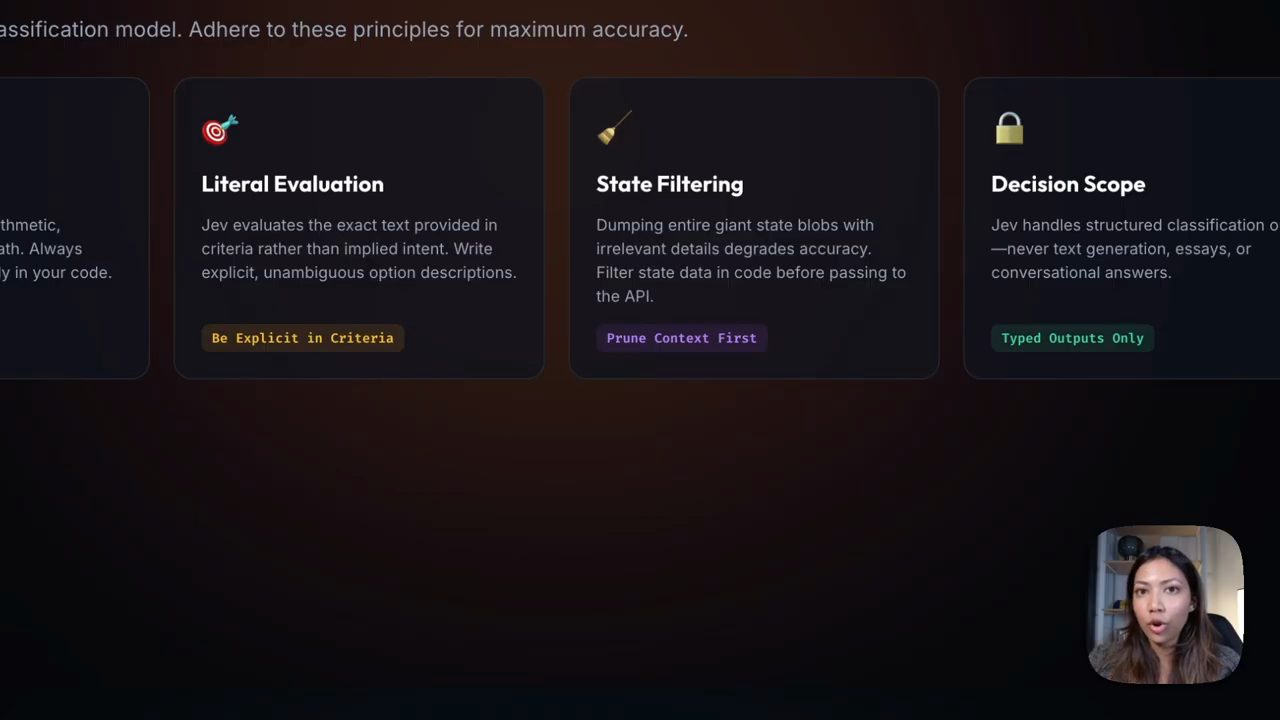
Thứ tư, Decision Scope. Jev xử lý classification có cấu trúc rất tốt, và các quyết định nên nằm ở đó. Smitha nói điều quan trọng là khoanh phạm vi cho chuẩn, đừng trôi sang sinh text, viết bài luận hay trả lời kiểu hội thoại, vì rõ ràng như thế sẽ thất bại.
Dù vậy, chị nói có rất nhiều use case cho Jev ngoài kia; nếu vào X hay Reddit, bạn sẽ thấy vô số thứ người ta đã build với nó. Smitha để mọi thứ đã nhắc tới trong video ở phần mô tả, mời người xem cho chị biết họ nghĩ gì, và cảm ơn mọi người đã xem.
Nguồn và liên kết 9 nguồn
- Tên gốc: Make Your Coding Agents Way Faster (Jev + Google Antigravity)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=fsEssFc-WhU youtube.com
- Kênh YouTube Smitha Kolan - Machine Learning Engineer (Smitha Kolan): youtube.com/channel/UCsh8qhZ4Wm2IJDRsNr_5Z0A youtube.com
- Tài liệu TypeSafe (Jev, API reference, cookbooks, SDK): docs.typesafe.ai docs.typesafe.ai
- Trang Agent skill của TypeSafe (cách cài cho Claude Code và các agent khác, prompt mẫu): docs.typesafe.ai/agent-skill docs.typesafe.ai
- Repo skill của TypeSafe: github.com/typesafe-ai/skills github.com
- Google Antigravity: antigravity.google antigravity.google
- Codelab Getting Started with Google Antigravity: codelabs.developers.google.com/getting-started-google-antigravity codelabs.developers.google.com
Related talks
Hai update lớn của Grok Bot và việc nên làm ngay
Nate Herk · Nate Herk | AI Automation · 9 min
Model routing tự động và X search miễn phí trong Grok Bot, vì sao nên tách skill, và cách chạy Claude Code, Codex bằng subscription riêng trong Grok Bot.
Toàn bộ hướng dẫn Skills của Anthropic trong 22 phút
Mark Kashef · Mark Kashef · 22 min
Đi qua bản hướng dẫn 33 trang của Anthropic về skill: anatomy, ba tầng progressive disclosure, viết description, năm design pattern, test và phân phối.
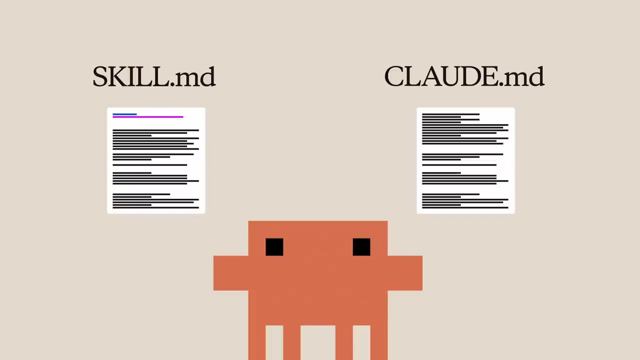
Skill là gì?
Claude · Claude · 3 min
Skill là file SKILL.md dạy Claude một việc một lần: Claude chọn skill qua description, đặt ở đâu, khác CLAUDE.md và slash command ra sao.