Context engineering cho trợ lý mua sắm: retrieval, hard filter và memory nhiều lượt
Context engineering qua một trợ lý mua sắm: token budget, keyword, semantic và hybrid search, hard filter, memory nhiều lượt và cách đánh giá retrieval.
✓ Đã duyệt độc lập · cập nhật 18/11/2026 · 20 min
1. Từ prompt engineering tới context, loop và harness engineering
Video được Elastic tài trợ.
Aishwarya Srinivasan mở đầu (video đăng ngày 18/11/2026): context engineering đã trở thành một từ khoá lớn của AI trong năm 2025. Ban đầu, rất nhiều sự chú ý dồn vào prompt engineering, tức là cách viết chỉ dẫn tốt hơn. Rồi cuộc thảo luận mở rộng ra context engineering. Và ở thời điểm quay video, bạn cũng sẽ nghe nhiều hơn về loop engineering và harness engineering. Chị đề nghị hãy xem chúng như những trách nhiệm nối liền với nhau.
Theo chị (video đăng ngày 18/11/2026), chúng ta viết chỉ dẫn; chúng ta quyết định model nhận được thông tin gì; chúng ta thiết kế cách một agent lặp lại và tự kiểm tra công việc của nó; và chúng ta xây môi trường xung quanh nó, gồm tool, quyền (permissions) và các lớp bảo vệ (safeguards).
Mỗi lần model chọn một hành động hay sinh ra một câu trả lời, theo Aishwarya (video đăng ngày 18/11/2026), nó phụ thuộc vào thông tin có sẵn cho model đúng vào lúc đó. Đó là ý chị muốn nói khi bảo context làm giàu cho việc ra quyết định của model: context cung cấp cho model các sự thật (facts), các ràng buộc (constraints) và lịch sử, những thứ làm cho một câu trả lời phù hợp với đúng nhiệm vụ đó.
Chị nói rõ (video đăng ngày 18/11/2026): context không đảm bảo câu trả lời đúng, nhưng nó cho model một thứ gì đó liên quan để làm việc. Chị hứa đến cuối video, bạn sẽ biết cách chọn thông tin đó, cách retrieve nó, cách mang nó xuyên suốt một cuộc hội thoại, và cách kiểm tra xem model có dùng nó đúng không.
2. Vòng ngoài cùng là context
Aishwarya chỉ vào một sơ đồ (video đăng ngày 18/11/2026). Đường biên lớn bao bên ngoài đại diện cho context. Bên trong nó, prompt của người dùng chỉ là một mảnh. Phần chỉ dẫn (instructions) mô tả assistant nên cư xử thế nào. Lịch sử hội thoại cho nó biết chuyện gì đã xảy ra tới giờ. Memory dài hạn có thể cung cấp một preference đã được lưu từ một phiên trước.
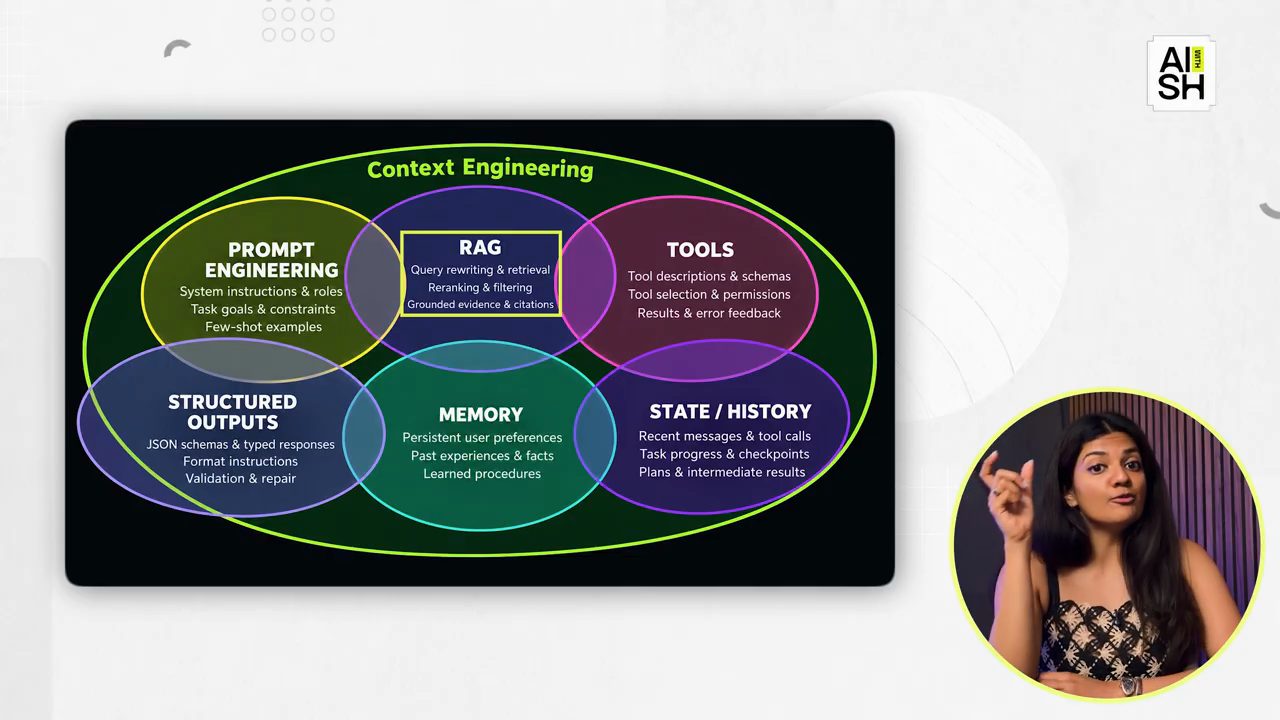
Rồi tới phần thông tin được retrieve cho riêng nhiệm vụ này, và phần mô tả các tool để model dùng. Vùng nhỏ output format đại diện cho cấu trúc mà ta muốn câu trả lời tuân theo, ví dụ các field như tên sản phẩm và giá mà bạn muốn model xuất ra. Theo chị (video đăng ngày 18/11/2026), những phần chồng lên nhau trong hình là một cách để cho thấy các mảnh này tương tác với nhau.
Chị lưu ý (video đăng ngày 18/11/2026): bạn không cần mọi mảnh trong mọi request, và sơ đồ này không có nghĩa là ta nên nạp nguyên một kho memory vào model. Chị mong phần này tạo đủ hứng thú để bạn đi sâu hơn vào context engineering.
Chị tự giới thiệu (video đăng ngày 18/11/2026): chị là Aishwarya Srinivasan, còn được gọi là Ash. Chị đã làm trong ngành machine learning và AI hơn mười năm, từng làm ở Google và Microsoft để xây những hệ thống AI như thế này. Trước đó chị dẫn dắt mảng developer relations ở một công ty cung cấp dịch vụ API cho model, và ở thời điểm quay video chị đang xây công ty AI của riêng mình. Chị nói chị rất thích dạy học, và đó là lý do chị ở đây.
3. Trợ lý mua sắm và bài thi mở sách
Để học kỹ hơn về context engineering, Aishwarya đưa nó về thực tế với một use case trợ lý mua sắm (shopping assistant) (video đăng ngày 18/11/2026). Hãy tưởng tượng bạn hỏi: bạn gợi ý tai nghe cho tôi dùng trên đường đi làm (commute) được không? Assistant trả lời: hãy tìm loại có chất lượng âm thanh tốt và đeo vừa vặn thoải mái. Đó là một lời khuyên hợp lý, nhưng bạn vẫn đang phải tự đi mua sắm.
Giờ hãy đưa cho nó các yêu cầu của bạn: bạn muốn tai nghe over-ear (trùm tai), có noise cancellation, và budget 150 đô. Theo chị (video đăng ngày 18/11/2026), để gợi ý được một thứ bạn có thể mua, nó còn cần thông tin sản phẩm hiện hành.
Để hiểu rõ hơn, chị đưa ra hình ảnh một bài thi mở sách (open book exam) (video đăng ngày 18/11/2026). Hiểu môn học thì có ích, nhưng nếu câu hỏi phụ thuộc vào một case study cụ thể, bạn vẫn cần bằng chứng đó ở ngay trước mặt. Bạn vẫn cần những trang tài liệu đang mở.
Trong ứng dụng của ta, theo Aishwarya (video đăng ngày 18/11/2026), chúng ta lắp ráp lại các phần: chỉ dẫn, request hiện tại, phần lịch sử liên quan, kiến thức được retrieve và kết quả của tool. Chỉ dẫn nói phải tôn trọng budget. Lịch sử có thể cho biết earbuds làm bạn đau tai. Các bản ghi được retrieve cung cấp thông số, và một lần gọi tool kiểm tra kho (inventory) xác nhận một sản phẩm cụ thể còn hàng.
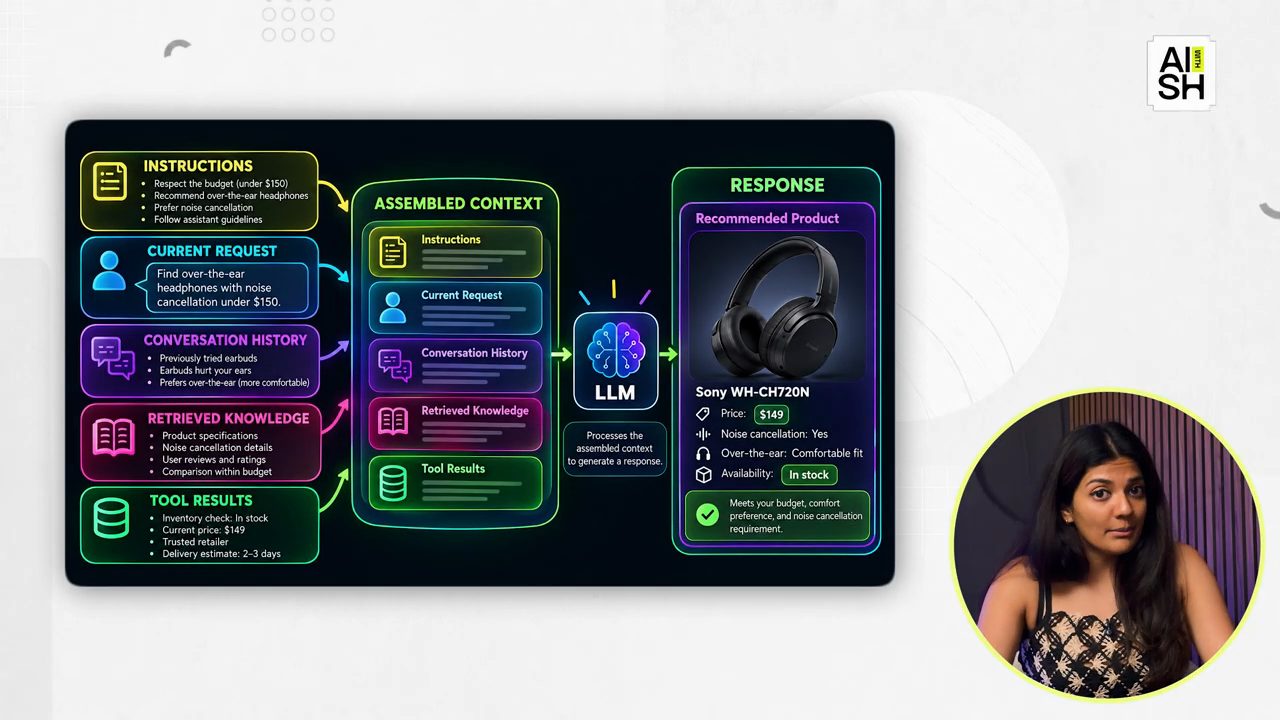
Chị bảo hãy để ý sự khác nhau giữa mô tả của một tool và kết quả của nó (video đăng ngày 18/11/2026). Mô tả cho model biết cách kiểm tra hàng tồn. Kết quả cho model biết sản phẩm đó có sẵn hay không.
4. Bản ghi sản phẩm và token budget
Với mỗi sản phẩm, Aishwarya nói chị sẽ giữ chung một chỗ (video đăng ngày 18/11/2026): mã định danh, giá, đơn vị tiền tệ, thông số, cùng nguồn và độ mới (freshness) của các sự thật hay thay đổi. Nếu không, một mức giá có thể bị tách khỏi đúng sản phẩm mà nó thuộc về.
Chúng ta cũng cần một token budget, theo chị (video đăng ngày 18/11/2026). Token về cơ bản là các đơn vị văn bản, thường là từ hoặc một phần của từ. Context window của model có giới hạn, nên bạn không thể đưa cho nó nhiều token hơn mức nó tiếp nhận được. Chỉ dẫn, lịch sử, bằng chứng và chỗ trống cho câu trả lời đều phải vừa trong context window của model đó.
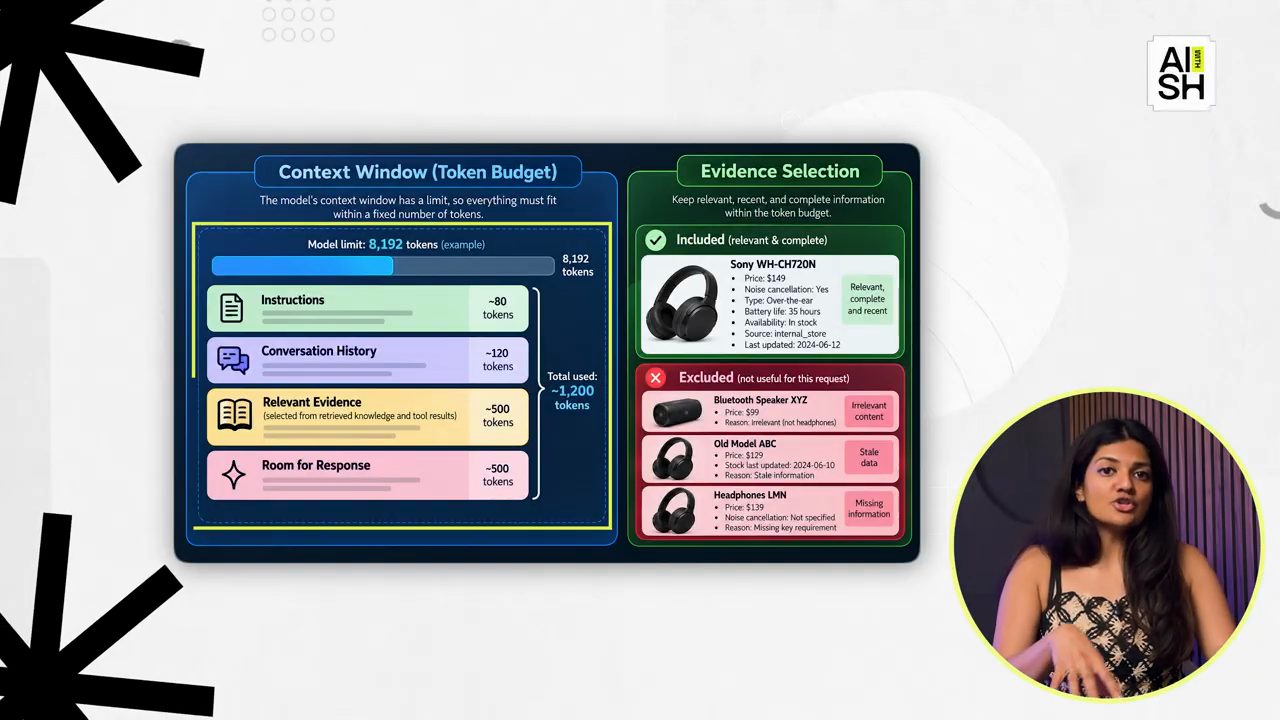
Nhưng vừa thôi thì chưa đủ (video đăng ngày 18/11/2026). Chị lấy ví dụ: một listing loa gần như không liên quan gì tới câu hỏi này. Hoặc số lượng tồn kho của hôm qua có thể đã cũ. Còn bất cứ thứ gì thiếu thông tin noise cancellation thì khiến ta không thể xác nhận một yêu cầu.
5. Chỉ dẫn ngắn trỏ tới chi tiết, và text sản phẩm không phải chỉ dẫn
Aishwarya trích một ví dụ hữu ích từ bài viết về Harness Engineering năm 2026 của OpenAI (video đăng ngày 18/11/2026): giữ phần hướng dẫn ngắn gọn, trỏ tới tài liệu chi tiết, rồi chỉ truy cập phần chi tiết đó khi cần. Chị so sánh với cách cấu trúc file hoạt động: bạn có metadata trỏ tới dữ liệu chính.
Ở đây, chị nói chị sẽ áp dụng ý đó bằng cách chỉ lấy chính sách đổi trả (return policy) khi khách hỏi về đổi trả (video đăng ngày 18/11/2026). Không cần mọi chính sách trong mọi lần gợi ý sản phẩm.
Nhưng, theo chị (video đăng ngày 18/11/2026), ta cần giữ text sản phẩm tách riêng khỏi các chỉ dẫn đáng tin cậy. Một listing là bằng chứng để xem xét, không phải một sự cho phép để thay đổi quy tắc của assistant.
6. Keyword search, semantic search và hybrid retrieval
Giờ tới chuyện chọn thứ gì để retrieve (video đăng ngày 18/11/2026). Giả sử cửa hàng có hàng nghìn sản phẩm. Ta cần một cách tìm ra những sản phẩm đáng xem xét cho đúng request này.
Với keyword search, theo Aishwarya (video đăng ngày 18/11/2026), ta tìm các từ khớp nhau. Nếu bạn gõ tên một model cụ thể, cách diễn đạt đó là một tín hiệu giá trị: ta muốn tìm đúng model đó. Nhưng bạn cũng có thể nói: tôi cần thứ gì chặn được tiếng ồn trên tàu. Mô tả sản phẩm có thể dùng cụm "active noise cancellation". Cách diễn đạt khác nhau, dù ý tưởng liên quan với nhau. Đây là chỗ semantic search giúp được.
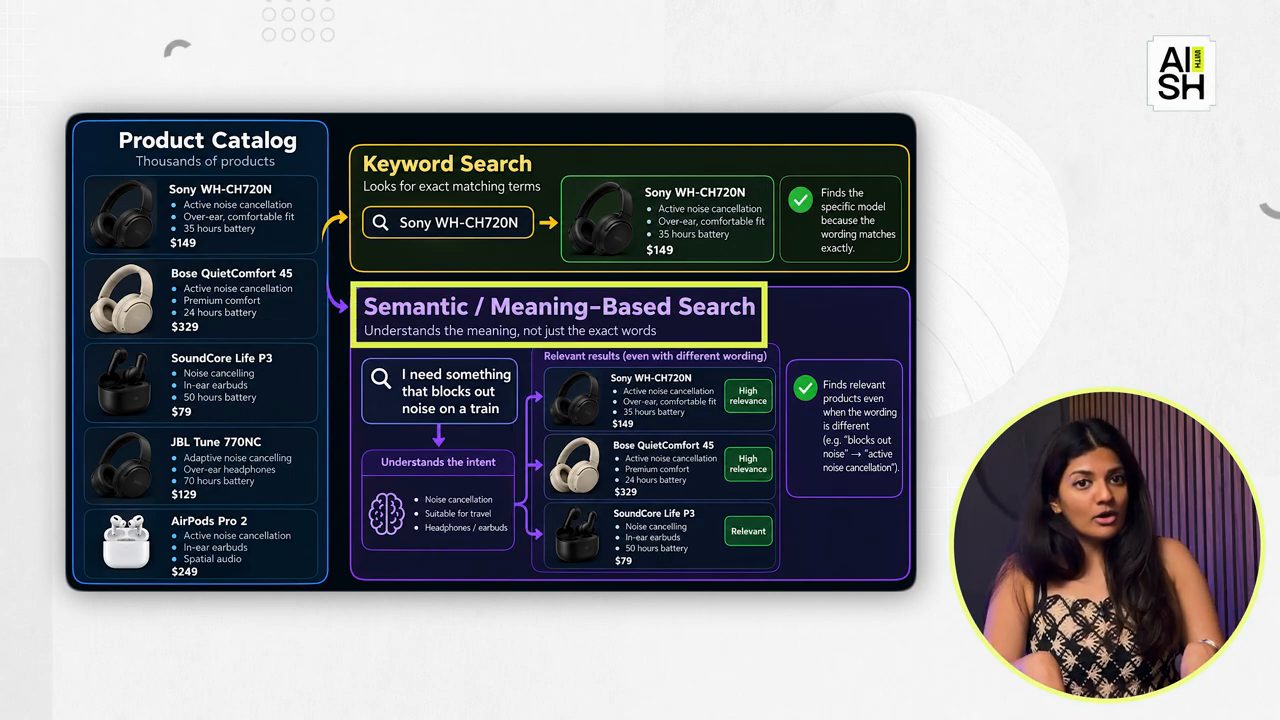
Trong cách làm dựa trên vector, chị giải thích (video đăng ngày 18/11/2026), ta dùng một embedding model để biểu diễn câu truy vấn và text sản phẩm thành danh sách các con số. Hệ thống search so sánh các biểu diễn đó để tìm những sản phẩm có thể liên quan. Độ tương đồng về số giúp ta tìm ra ứng viên phù hợp, nhưng nó không xác minh giá, hàng tồn hay thông số của chúng.
Hybrid retrieval, theo chị (video đăng ngày 18/11/2026), kết hợp các tín hiệu đó thành một danh sách kết quả đã xếp hạng.
7. Hard filter: liên quan chưa chắc đã phù hợp
Aishwarya muốn người xem để ý một chi tiết (video đăng ngày 18/11/2026): một sản phẩm có thể rất liên quan mà vẫn hoàn toàn không phù hợp. Một chiếc tai nghe 300 đô có thể khớp mô tả của bạn một cách tuyệt đẹp, nhưng budget của ta là 150 đô.
Budget đó cũng cần trở thành một hard filter, tức là, theo lời chị, một điều kiện tường minh được kiểm tra với field giá (video đăng ngày 18/11/2026). Ta cũng yêu cầu kiểu over-ear, có noise cancellation và còn hàng, dựa trên các field đáng tin cậy của catalog.
Để thử nhanh, chị đề nghị tưởng tượng ba sản phẩm (video đăng ngày 18/11/2026): một cái đáp ứng mọi yêu cầu, một cái quá đắt, và một cái là in-ear earbud. Chỉ cái đầu tiên được đi tới bước gợi ý, dù hai cái kia nghe có giống tới đâu.
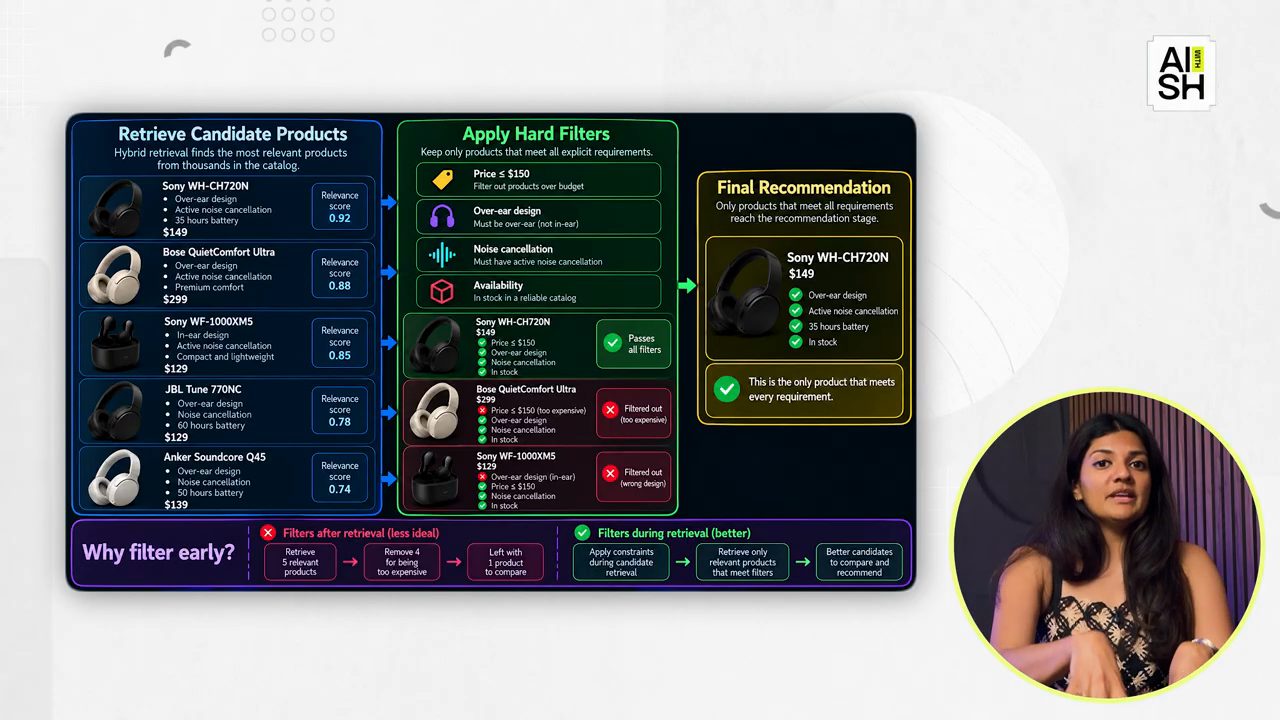
Vị trí đặt các filter có ý nghĩa (video đăng ngày 18/11/2026). Nếu ta retrieve năm sản phẩm trước rồi bỏ bốn cái vì quá đắt, ta chỉ còn đúng một cái để so sánh. Áp các ràng buộc ngay trong lúc retrieve ứng viên có thể giúp tránh chuyện đó, tuỳ vào hệ thống ta đang dùng.
Ta có thể đưa nguyên catalog cho model, theo Aishwarya (video đăng ngày 18/11/2026), nhưng khi đó ta sẽ tốn token để xử lý những sản phẩm thậm chí không thuộc về câu trả lời.
8. Hạ tầng khi hệ thống lớn lên, và một vector database project
Khi hệ thống lớn lên, theo Aishwarya (video đăng ngày 18/11/2026), còn có phần việc hạ tầng phải tính. Một database truyền thống có thể hỗ trợ một phần những gì ta cần. Thêm vector retrieval có thể kéo theo việc tinh chỉnh index và các embedding pipeline. Các service tách rời có thể đồng nghĩa với việc giữ các bản sao đồng bộ và lên kế hoạch capacity cho tất cả chúng. Storage, memory, indexing và lưu lượng truy vấn đều ảnh hưởng tới kế hoạch đó.
Theo lời chị (video đăng ngày 18/11/2026), có thể bạn biết Elasticsearch qua search, và nó cũng có khả năng vector database cho semantic search, RAG và các ứng dụng AI; Elasticsearch Vector Database là một serverless project trên Elastic Cloud, được xây riêng cho các workload vector và AI retrieval, kết hợp vector search với hạ tầng được quản lý và một hardware profile tối ưu cho các workload đó.
Chị dùng nó để xem một ứng dụng tìm thông tin mà AI của nó cần như thế nào (demo trong video đăng ngày 18/11/2026). Trong vector database project, bạn mang dữ liệu và câu hỏi của mình tới; các thiết lập mặc định tối ưu cho vector đảm nhận nhiều hơn phần cài đặt storage và indexing, còn semantic_text lo phần chunking và embedding.
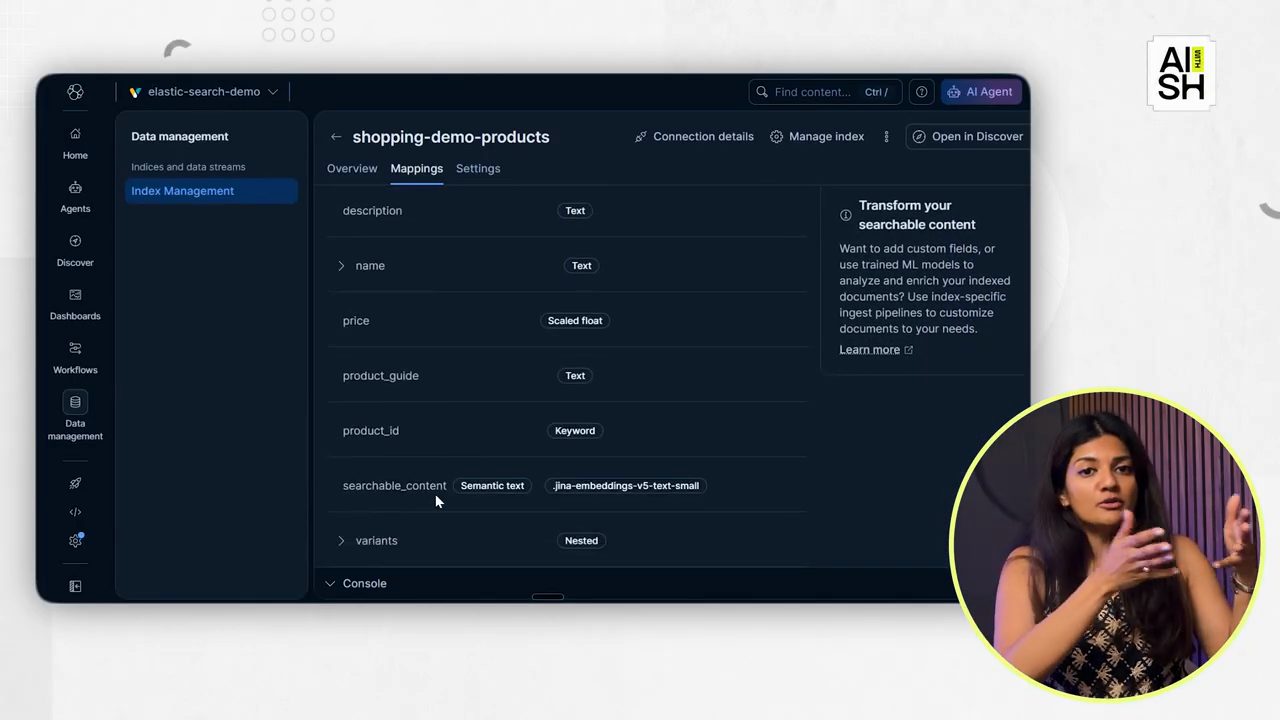
shopping-demo-products có các field description, name (Text), price (Scaled float), product_guide (Text), product_id (Keyword), variants (Nested) và searchable_content kiểu Semantic text gắn với .jina-embeddings-v5-text-small.9. Embedding, vector và field semantic_text
Aishwarya giải thích kỹ hơn bằng một ví dụ mới (video đăng ngày 18/11/2026). Khách hỏi giày thoải mái để đi bộ cả ngày. Một mô tả sản phẩm có thể ghi "lightweight sneakers with cushioned soles for everyday comfort" (giày sneaker nhẹ, đế có đệm, thoải mái hằng ngày). Từ ngữ khác nhau, nhưng ý nghĩa liên quan.
Embedding model mà chị nhắc tới ở trên là thứ chuyển đoạn text này thành một danh sách số gọi là vector (video đăng ngày 18/11/2026). Những con số đó giúp ta so sánh ý nghĩa của câu hỏi với mô tả của sản phẩm. Chị đề nghị hình dung nó như một tấm bản đồ, nơi những thứ có ý nghĩa giống nhau nằm gần nhau. Câu hỏi và mô tả sản phẩm rơi vào cùng một khu, dù chúng dùng chữ khác nhau. Vector search dùng phép so sánh đó để tìm ra các ứng viên liên quan.
Trong demo (video đăng ngày 18/11/2026), chị dùng một catalog nhỏ, mỗi sản phẩm có một đoạn mô tả và các thông tin có cấu trúc như giá và tình trạng còn hàng. Theo chị, Elasticsearch có thể lưu các thông tin đó cạnh các vector. Để mô tả có thể search được, chị dùng một kiểu field tên là semantic_text: bạn đưa text vào, và Elasticsearch lo chunking và embedding thông qua inference endpoint đã cấu hình.
Chunking, chị giải thích (video đăng ngày 18/11/2026), về cơ bản là chia nội dung dài thành những phần nhỏ hơn. Ví dụ với một bản hướng dẫn sản phẩm dài, ứng dụng có thể retrieve các phần liên quan thay vì cả tài liệu.
Với demo này, theo Aishwarya (video đăng ngày 18/11/2026), inference endpoint được cấp sẵn dùng một embedding model gốc của Jina AI thông qua Elastic Inference Service (EIS), chạy trên GPU được quản lý. Ta không phải tự vận hành một server embedding model. Chị nói như vậy bạn có ít thứ phải cài đặt hơn trước khi bắt đầu kiểm tra kết quả search của mình có hữu ích hay không.
Lệnh chị chạy trong Dev Tools và phần đầu kết quả, như trên màn hình (demo trong video đăng ngày 18/11/2026):
GET _inference/.jina-embeddings-v5-text-small

{
  "endpoints": [
    {
      "inference_id": ".jina-embeddings-v5-text-small",
      "task_type": "text_embedding",
      "service": "elastic",
      "service_settings": {
        "model_id": "jina-embeddings-v5-text-small",
        "similarity": "cosine",
        "dimensions": 1024
      },
      "chunking_settings": {
        "strategy": "sentence",
        "max_chunk_size": 250,
        "sentence_overlap": 1
      },
      "metadata": {
        "heuristics": {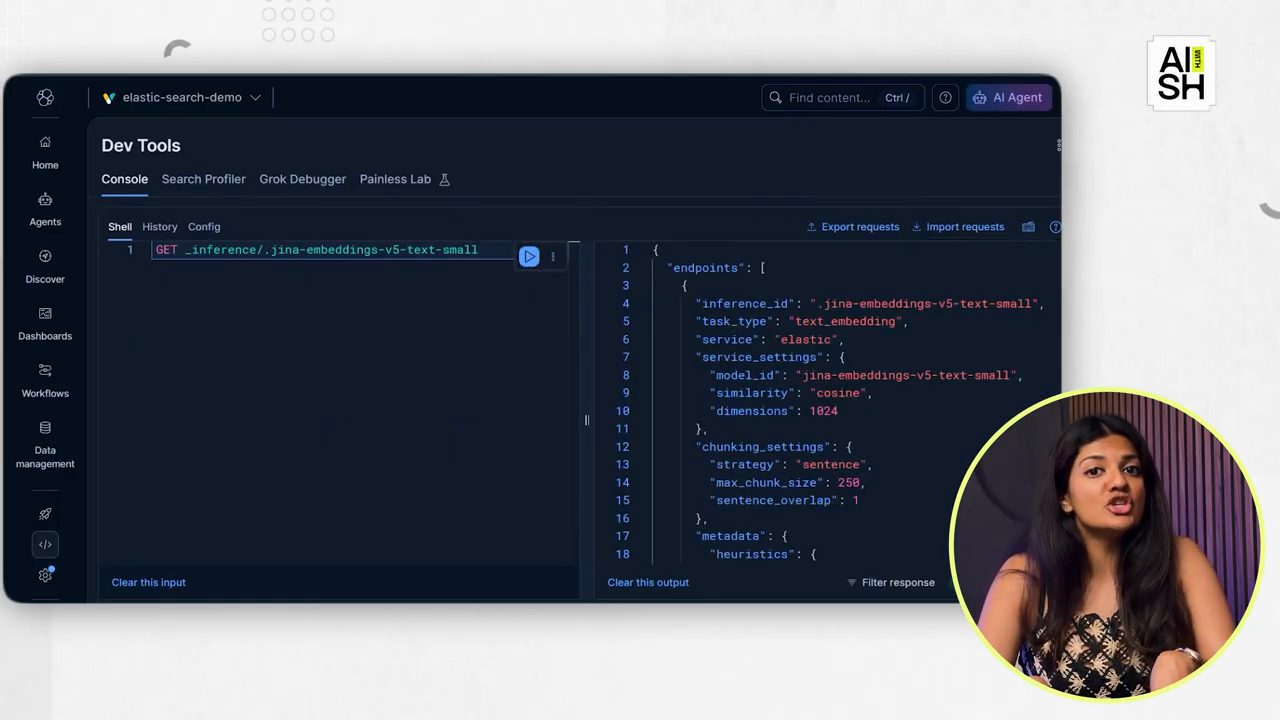
jina-embeddings-v5-text-small, similarity cosine, 1024 chiều, và chunking theo câu với max_chunk_size 250, sentence_overlap 1.10. Đọc kết quả, lọc theo giá, rồi hybrid search
Giờ chị search catalog đã index với câu "giày thoải mái để đi bộ quanh thành phố cả ngày" (demo trong video đăng ngày 18/11/2026). Theo chị, Elasticsearch gửi câu truy vấn qua EIS tới model Jina AI đã cấu hình để biến nó thành embedding, rồi dùng embedding đó để search index; semantic_text lo luồng semantic query này cho ta.
Chị bảo hãy nhìn các mô tả được trả về (video đăng ngày 18/11/2026): chúng có đáp ứng nhu cầu đó không, ngay cả khi cách diễn đạt khác? Một mô tả nhắc tới đệm (cushioning) và việc đi bộ hằng ngày có thể là liên quan mà không cần lặp lại câu của khách.
Lời khuyên của chị (video đăng ngày 18/11/2026): trước khi nối với một language model, hãy tự đọc vài kết quả đầu. Chúng có trả lời được câu hỏi không? Đó là một bước đánh giá đầu tiên hữu ích, và ta tiếp tục test với thêm nhiều câu hỏi trong lúc build.
Nhưng ta còn có budget 100 đô (video đăng ngày 18/11/2026). Một đôi giày 180 đô có thể là một kết quả semantic rất khớp, nhưng nó vẫn không đáp ứng điều kiện đó. Nên ta lọc theo giá, và thu hẹp kết quả về các sản phẩm còn hàng đúng size khách đã chọn.
Giờ tưởng tượng khách hỏi một model cụ thể như Walk Light 200 (video đăng ngày 18/11/2026). Những chữ chính xác đó cũng quan trọng. Đây là chỗ hybrid search giúp được. Theo Aishwarya, Elasticsearch có thể kết hợp keyword search và semantic search trong cùng một request, cùng với các filter bạn có.
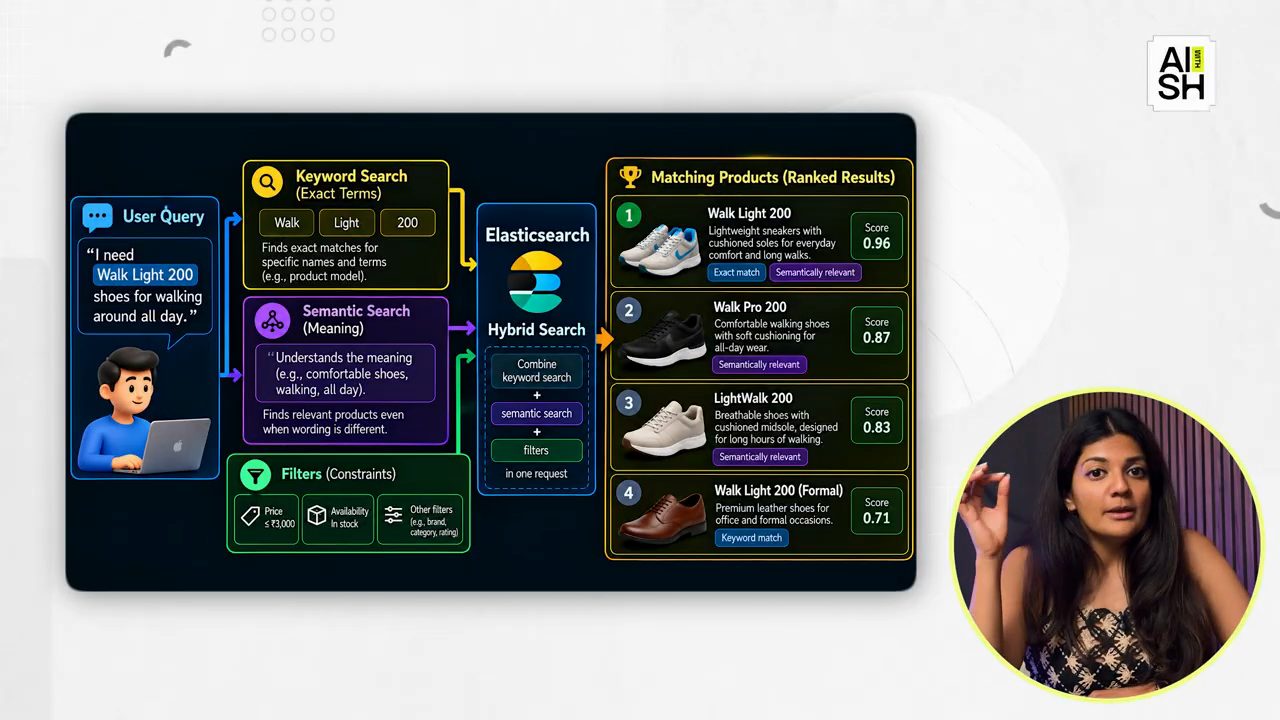
Keyword search lo các tên và thuật ngữ cụ thể; semantic search lo ý nghĩa; còn filter áp các điều kiện như giá và tình trạng còn hàng (video đăng ngày 18/11/2026). Theo chị, kết hợp lại chúng giúp ta tìm ra thông tin phù hợp với request.
Những chi tiết sản phẩm này là thứ ứng dụng sẽ đưa cho language model, theo Aishwarya (video đăng ngày 18/11/2026). Model khi đó có thể so sánh các lựa chọn dựa trên những sự thật đó, có lẽ giải thích phần đệm được mô tả ở hai listing, hoặc sản phẩm nào rẻ hơn. Nếu thiếu một thứ quan trọng, như đôi giày có chống nước hay không, ứng dụng nên xử lý chuyện đó thay vì trông chờ model tự lấp chỗ trống.
Chị nói đó chính là mối nối với context engineering (video đăng ngày 18/11/2026): chọn thông tin hữu ích trước khi model sinh câu trả lời.
11. Chunking, và khi nào retrieval trở nên hữu ích
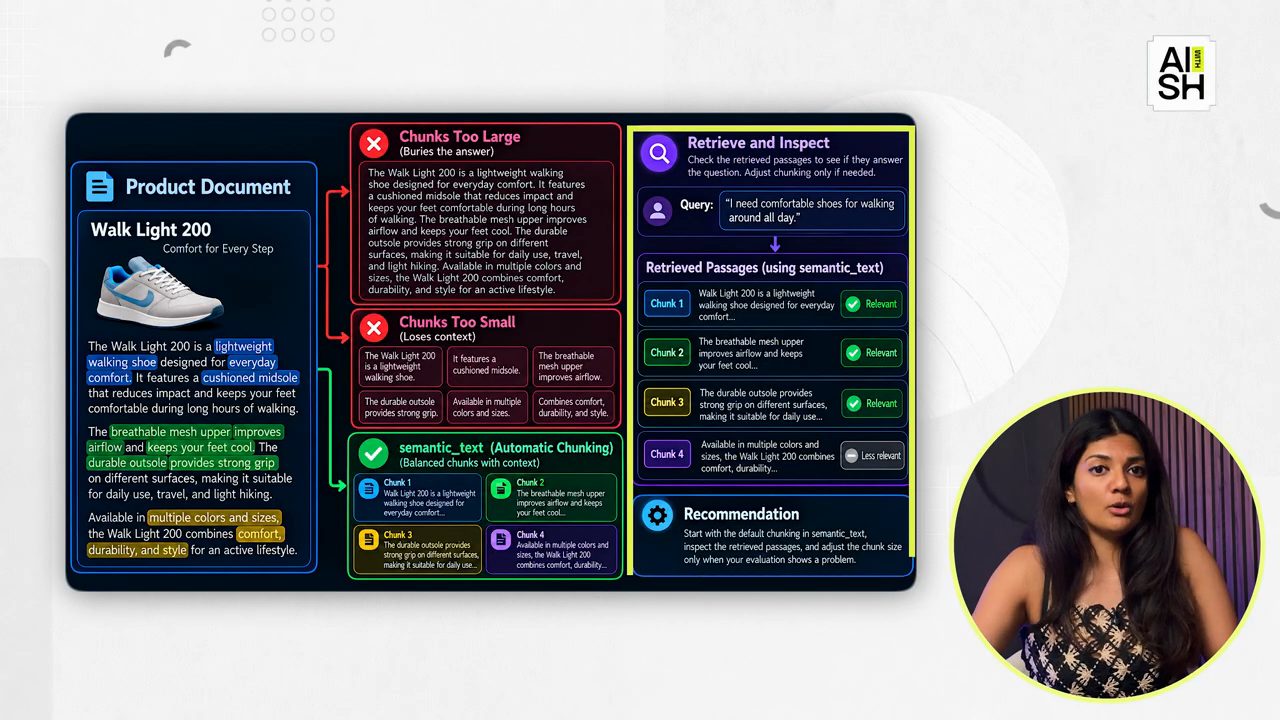
Với một retrieval stack tự lắp bằng tay, theo Aishwarya (video đăng ngày 18/11/2026), chunking có thể tốn công. Phần quá lớn thì chôn mất câu trả lời, còn phần quá nhỏ thì mất context. Ở đây, semantic_text lo chunking cho ta.
Lời khuyên của chị (video đăng ngày 18/11/2026): bắt đầu với mặc định của nó, xem xét các đoạn được retrieve, rồi chỉ điều chỉnh khi các bài đánh giá của bạn cho thấy có vấn đề.
Cùng một khuôn mẫu áp dụng cho các ứng dụng khác, theo chị (video đăng ngày 18/11/2026). Một trợ lý cho nhân viên có thể retrieve chính sách công ty, lọc theo địa điểm. Một trợ lý học tập có thể retrieve tài liệu từ bài học liên quan. Còn một AI agent có thể gọi search này như một tool khi nó cần thông tin để hoàn thành nhiệm vụ.
Với một tập thông tin nhỏ và ổn định, theo Aishwarya (video đăng ngày 18/11/2026), đặt thẳng nó vào context window có thể là đủ. Retrieval trở nên hữu ích khi khối tài liệu đó lớn lên, thay đổi, hoặc cần được chọn lọc cho một người dùng hay một câu hỏi cụ thể.
12. Từ prototype lên production: vectordb_document, BBQ và auto-calibration
Theo lời Aishwarya (video đăng ngày 18/11/2026), Elastic Vector Database cho bạn một điểm khởi đầu được quản lý cho lớp retrieval, có chỗ để lớn lên. Serverless project quản lý phần hạ tầng bên dưới. Chế độ index vectordb_document của nó bật sẵn theo mặc định và áp các thiết lập storage và indexing mà nếu không thì một chuyên gia phải tự chọn. Trong đó có lưu trữ bfloat16 cho các raw vector nhỏ hơn, nạp trước đúng các file search vào cache, và merge các index segment song song. Bạn cấu hình ít hơn trong khi index được tổ chức cho vector search hiệu quả.
Một điểm khác, theo chị (video đăng ngày 18/11/2026): better binary quantization, hay BBQ, cũng bật sẵn theo mặc định. Nó nén vector để giảm yêu cầu về memory. DiskBBQ còn giảm thêm memory cần cho các workload lớn, theo chị là giúp việc mở rộng vừa túi tiền hơn.
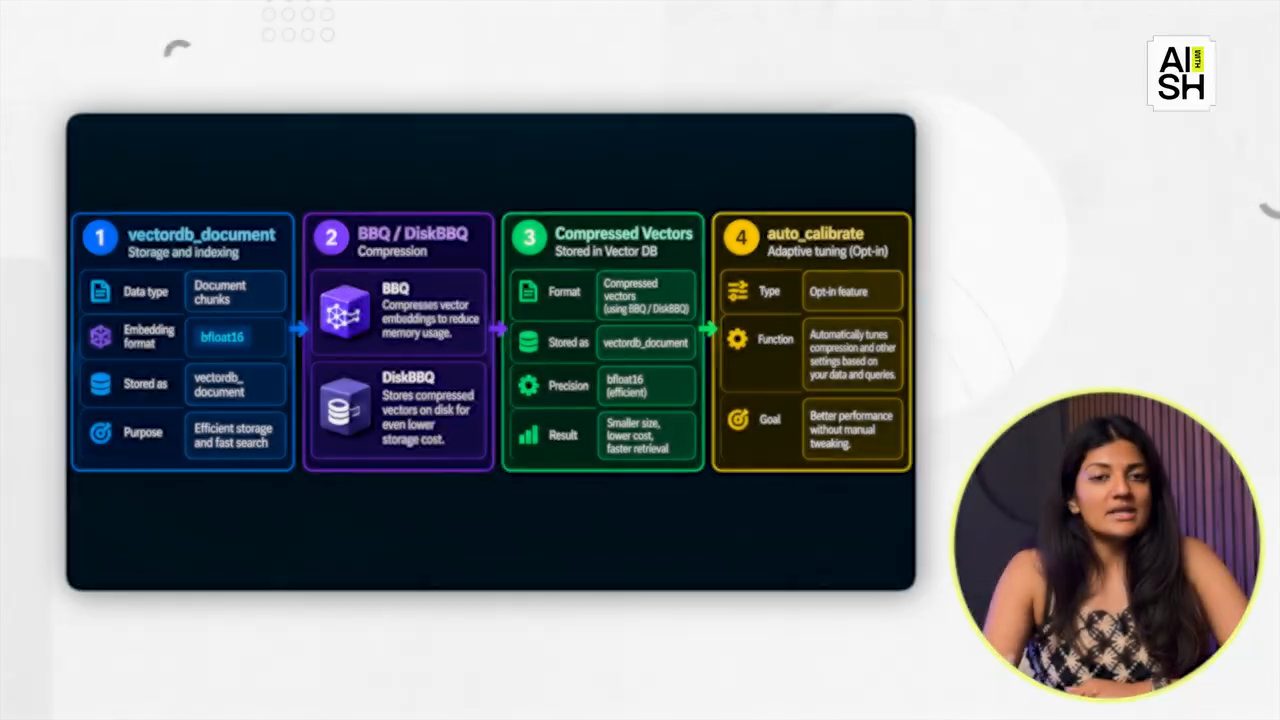
vectordb_document cho storage và indexing, embedding format bfloat16; (2) BBQ nén vector embedding để giảm memory, DiskBBQ lưu vector đã nén trên disk; (3) Compressed Vectors lưu trong vector DB; (4) auto_calibrate, một tính năng opt-in tự chỉnh nén và các thiết lập khác theo dữ liệu và truy vấn.Với DiskBBQ, theo Aishwarya (video đăng ngày 18/11/2026), bạn có thể chọn bật auto-calibration. Nó tự điều chỉnh quantization, pre-conditioning và oversampling theo dữ liệu được index, và nó cũng xem xét lại các lựa chọn khi các segment được merge. Nói đơn giản theo lời chị, nó chỉnh cách vector được nén và số ứng viên được kiểm tra, nhắm tới giữ recall trong khi cải thiện throughput và hiệu quả chi phí khi dữ liệu thay đổi.
Gộp lại, theo chị (video đăng ngày 18/11/2026), các khả năng đó hỗ trợ việc đi từ một prototype nhỏ lên production mà không phải thiết kế lại lớp retrieval chỉ vì bộ dữ liệu lớn lên. Nó cũng có security, access control và observability mà bạn có thể cấu hình cho một ứng dụng thật.
Mô hình giá, theo lời chị (video đăng ngày 18/11/2026), dựa trên storage, indexing và search capacity, nên bạn có thể ước tính chi phí theo lượng dữ liệu và tải truy vấn dự kiến, và chị nói điều đó giúp việc lập ngân sách dễ đoán hơn. Chị cũng nói điều đó không có nghĩa là mọi workload đều tốn như nhau: bạn vẫn cần đánh giá chất lượng retrieval và theo dõi mức sử dụng, nhất là khi agent search lặp đi lặp lại.
Chị tóm lại phần demo (video đăng ngày 18/11/2026): ta bắt đầu với một câu hỏi về giày thoải mái và một budget; ta search catalog bằng ý nghĩa, bằng thuật ngữ cụ thể và bằng ràng buộc; và kết quả là một tập thông tin liên quan nhỏ hơn để đưa cho model.
Lời khuyên của chị (video đăng ngày 18/11/2026): hãy bắt đầu với một bộ sưu tập nhỏ gồm dữ liệu và câu hỏi của chính bạn, nơi bạn biết một kết quả hữu ích trông như thế nào. Rồi chị chuyển sang chuyện gì xảy ra khi cuộc hội thoại dài ra, và cách quyết định thứ gì ở lại trong context window.
13. Khi khách hàng đổi ý: budget mới đi kèm một điều kiện
Phần này, Aishwarya nói về context xuyên suốt một cuộc hội thoại (video đăng ngày 18/11/2026). Quay lại vị khách: giờ ta tìm được sản phẩm liên quan, nhưng mới chỉ xử lý request đầu tiên.
Giả sử khách quay lại và nói (ví dụ trong video đăng ngày 18/11/2026): "Thật ra tôi có thể chi tới 200 đô nếu micro tốt hơn. Tôi nghe điện thoại công việc trên tàu." Trước khi search lại, theo chị, ta cần diễn giải xem điều gì đã thay đổi.
Khách chưa hề nói "quên budget cũ của tôi đi" (video đăng ngày 18/11/2026). Họ nói rằng họ sẵn sàng chi nhiều hơn cho một lợi ích cụ thể. Nếu ta chỉ lưu "budget = 200 đô", ta mất điều kiện đó. Nên Aishwarya nói chị sẽ giữ budget ban đầu như một preference, và ghi lại mức trần cao hơn cùng lý do của nó. Bằng cách đó, ta có thể xem xét các lựa chọn đắt hơn mà không giả định rằng khách muốn chi hết số tiền. Ta cũng cần bằng chứng rằng micro thực sự tốt hơn.
Giờ giả sử khách thêm (ví dụ trong video đăng ngày 18/11/2026): "và tôi thích loại nhẹ". Yêu cầu over-ear và noise cancellation vẫn còn áp dụng. Theo chị, chúng không biến mất chỉ vì không được nhắc trong tin nhắn cuối cùng.
14. Conversational memory: history, summary và bản ghi requirement
Đây là lý do ta cần conversational memory, theo Aishwarya (video đăng ngày 18/11/2026). Ứng dụng phải lưu và cung cấp thông tin liên quan. Ta không nên giả định model tự động nhớ các lần gọi trước.
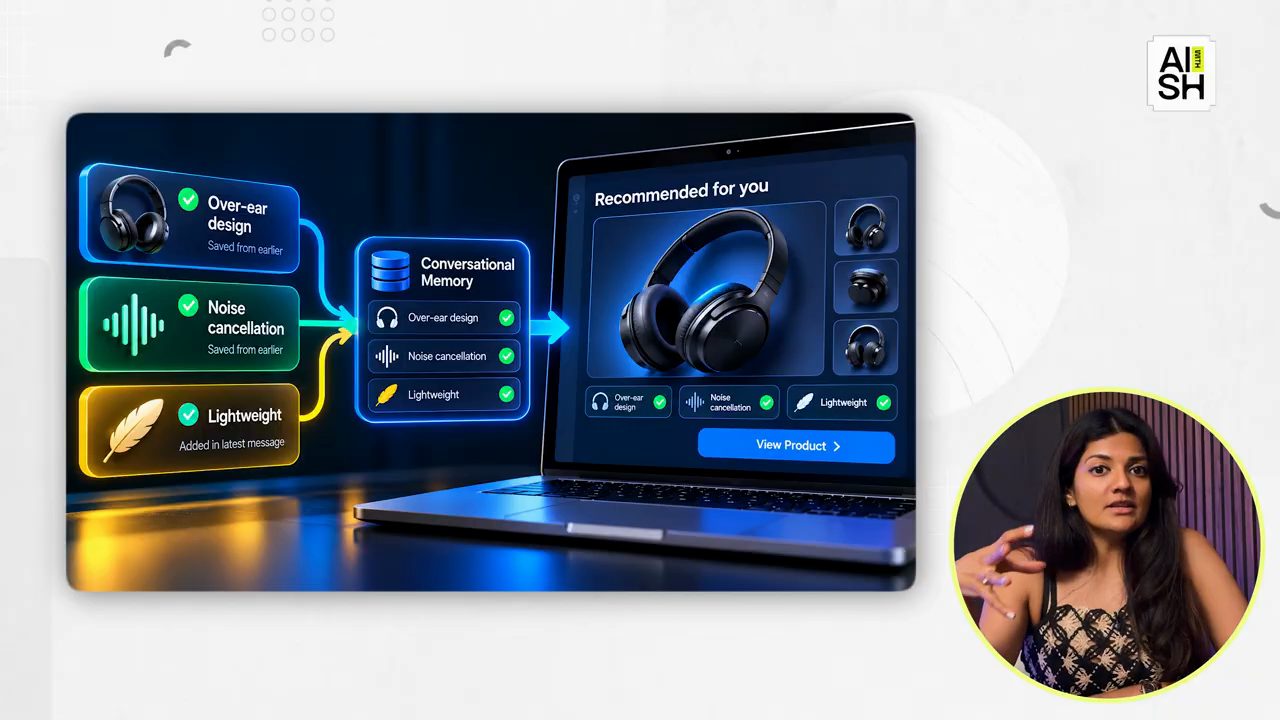
Một cách làm đơn giản, trực tiếp là gửi toàn bộ lịch sử kèm mỗi request (video đăng ngày 18/11/2026). Với một cuộc hội thoại ngắn, chị nói điều đó có thể hoàn toàn hợp lý. Nhưng theo thời gian, ta tích luỹ các sản phẩm đã bị từ chối, các mức giá cũ và những preference mà khách đã đổi. Thay vào đó, ta có thể giữ đoạn trao đổi gần nhất và một bản tóm tắt những gì còn quan trọng.
Với assistant này, Aishwarya nói chị cũng sẽ giữ một bản ghi nhỏ có cấu trúc về các yêu cầu hiện tại của khách (video đăng ngày 18/11/2026). Theo lời chị, bản ghi đó có thể ghi:
over ear, noise cancellation required, preferably under $150, with permission to go up to $200 for supported microphone improvements
Phần điều kiện kèm theo phải sống sót qua bản tóm tắt, theo chị (video đăng ngày 18/11/2026). Với một điều kiện như vậy, giữ nguyên câu gốc có thể hữu ích.
Còn một chi tiết khác (video đăng ngày 18/11/2026). Nếu khách hỏi "cái thứ hai có nhẹ hơn không?", ta cần nhớ mình đã cho xem những sản phẩm nào và theo thứ tự nào. Một bản tóm tắt chung chung kiểu "chúng ta đã bàn về tai nghe" không giúp ta giải được tham chiếu đó. Khi đã xác định được sản phẩm, ta có thể tra trọng lượng của nó.
15. Memory và retrieval là hai việc khác nhau
Aishwarya bảo hãy để ý rằng có hai việc đang diễn ra ở đây (video đăng ngày 18/11/2026). Memory giúp ta hiểu khách muốn nói gì. Retrieval cho ta bằng chứng về sản phẩm cụ thể đó.
Nhớ được mức giá mình đã báo trước đó không xác nhận rằng giá đó vẫn còn hiện hành (video đăng ngày 18/11/2026). Theo chị, ta cần một freshness policy cho các sự thật hay thay đổi, và ta nên xác nhận giá và tình trạng còn hàng trước khi mua, hoặc thậm chí trước khi gợi ý sản phẩm đó cho khách.
Chị đưa ra một hình ảnh (video đăng ngày 18/11/2026): hãy xem các preference đã lưu như danh sách đi chợ của bạn, còn catalog là kệ hàng trong cửa hàng. Danh sách có thể giữ nguyên trong khi kệ hàng thay đổi. Theo chị, đó là lý do nhớ thứ bạn muốn và kiểm tra thứ đang có là hai việc tách rời.
16. Đánh giá cả câu trả lời: tìm đúng chỗ hỏng
Tiếp theo, Aishwarya đi vào một phần chị gọi là rất quan trọng: đánh giá toàn bộ câu trả lời (video đăng ngày 18/11/2026). Ta cần kiểm tra xem các mảnh này có làm việc cùng nhau không.
Giả sử nó gợi ý một chiếc tai nghe đắt hơn mức khách cho phép (video đăng ngày 18/11/2026). Theo chị, rất dễ bị cám dỗ sửa prompt ngay lập tức. Nhưng trước hết, ta cần xem xét điều gì đã xảy ra. Có thể ta đã trích sai budget từ cuộc hội thoại. Có thể filter đã không được áp. Hoặc có thể mức giá đúng đã tới được model và nó chỉ đơn giản là phớt lờ ràng buộc đó. Khách thấy cùng một gợi ý tồi, nhưng mỗi nguyên nhân cần một cách sửa khác nhau.
Nên việc cần làm, theo chị (video đăng ngày 18/11/2026), là bắt đầu từ retrieval. Kiểm tra xem nó có tìm ra các sản phẩm và sự thật cần cho câu hỏi không. Sau đó kiểm tra kết quả có thực sự thoả các filter không. Tiếp theo, xem xét context đã tới được model. Thông tin có thể được retrieve đúng mà vẫn bị rơi mất trong lúc ta chọn lọc hoặc tóm tắt nó. Cuối cùng, so câu trả lời với bằng chứng đó.
Chị lấy ví dụ (video đăng ngày 18/11/2026): nếu context ghi 180 đô mà câu trả lời ghi 140 đô, model đã trình bày sai sự thật được cung cấp. Nhưng nếu chính context chứa một mức giá đã lỗi thời, ta cần điều tra dữ liệu và làm mới quy trình.
17. Eval case, access control, loop engineering và trace
Aishwarya nói chị sẽ xây các eval case quanh những khác biệt này (video đăng ngày 18/11/2026): đưa vào một thông số bị thiếu, một budget đã đổi, một sản phẩm hết hàng, và một request mà không sản phẩm nào đạt. Trong ca cuối, theo chị, assistant nên giải thích tình huống thay vì lặng lẽ đổi các yêu cầu.
Chị cũng khuyên test cả access control (video đăng ngày 18/11/2026). Thông tin mà một người dùng không được phép xem phải bị loại ra trước khi tới model, thông qua permissions được ứng dụng và các hệ thống dữ liệu thực thi.
Theo Aishwarya (video đăng ngày 18/11/2026), các bài viết gần đây về loop engineering, trong đó có hướng dẫn thực hành của Addy Osmani, nhấn mạnh các bước kiểm tra rõ ràng và điều kiện dừng. Với assistant của ta, chị nói chị sẽ giới hạn số lần thử lại và dừng khi một sự thật bắt buộc không xác minh được. Lặp lại một lần search không làm cho bằng chứng còn thiếu trở thành đúng.
Việc bạn cần làm, theo chị (video đăng ngày 18/11/2026), là đo latency và chi phí trên cả retrieval, các lần thử lại và bước sinh câu trả lời. Hãy giữ đủ trace, với các kiểm soát privacy phù hợp, để so được người dùng đã hỏi gì, hệ thống đã retrieve gì, và model thực sự nhận được gì. Theo chị, đó là thứ cho phép bạn chọn cách sửa dựa trên bằng chứng.
18. Tự làm: theo một request từ đầu tới cuối
Nếu bạn tự xây hệ thống này, Aishwarya khuyên (video đăng ngày 18/11/2026) hãy bắt đầu với một tập nhỏ các cuộc hội thoại mà bạn có thể xem xét kỹ. Lấy ví dụ tai nghe và đi theo một request từ đầu tới cuối. Nhìn vào budget ta đã trích ra, sản phẩm ta đã retrieve, context ta đã lắp ráp và gợi ý ta đã tạo ra.
Rồi thay đổi một thứ, theo chị (video đăng ngày 18/11/2026): hạ budget, xoá một bản ghi tồn kho, nhắc tới một sản phẩm từ một lượt trước, và xem assistant có còn cư xử hợp lý không.
Khi cải thiện hệ thống, chị khuyên (video đăng ngày 18/11/2026) mỗi lần chỉ đổi một phần và chạy lại toàn bộ các cuộc hội thoại đó. Theo chị, điều đó giúp bạn thấy mình đã cải thiện retrieval, giữ được ý định của khách, hay giúp model dùng bằng chứng của nó trung thực hơn.
Nguồn và liên kết 6 nguồn
- Tên gốc: Mastering Context Engineering: Retrieval, Hard Filters, and Multi-Turn Memory
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=r7ZnrKCjVj4 youtube.com
- Kênh YouTube Aishwarya Srinivasan (Aishwarya Srinivasan): youtube.com/channel/UCzd4ZN716evEjtbJERBMTfg youtube.com
- Addy Osmani, "Practical Loop Engineering", bài viết ghi ngày 14/08/2026, được trích trong video (đọc ngày 18/11/2026): addyosmani.com/blog/practical-loop-engineering addyosmani.com
- Philipp Schmid, "The New Skill in AI is Not Prompting, It's Context Engineering", bài viết mà phần mô tả video ghi là nguồn của sơ đồ context (đọc ngày 18/11/2026): philschmid.de/context-engineering philschmid.de
Related talks
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
10 skill để trở thành AI engineer
Dhaval Patel · codebasics · 32 min
Mười skill AI engineer cần theo Dhaval Patel: từ Python, LLM fundamentals, context engineering, RAG, agents, evals tới deploy, guardrails, fine-tuning và system design.
Khoá Generative AI trọn gói: từ token tới agent, eval và sự nghiệp
Tejas AI · Tejas AI · 36 min
Một lượt đi qua Gen AI: token, embedding, attention, training, sampling, RAG, agent, MCP, fine-tuning, eval, security và lộ trình chín project.