AI Lab tự host: workstation RTX Pro, hai Mac Studio và một router
Workstation RTX Pro và hai Mac Studio tự host Qwen, Gemma, Whisper qua một router; agent cho data, CRM, tìm và ghép B-roll; Nvidia so với Mac.
✓ Đã duyệt độc lập · cập nhật 15/11/2026 · 29 min
1. AI Lab: phục vụ cả R&D lẫn production
Duy Luân mở đầu bằng lời chào và nói đây là một video rất đặc biệt: anh rủ người xem đi xem thử những món mà anh gọi là "AI Lab" của mình, xem trong đó đang có những gì (video đăng ngày 13/11/2026).
Theo lời anh, một số thứ trong AI Lab đang nằm trong nhà anh, nhưng sắp tới chúng sẽ được đặt ở data center. Lý do anh đưa ra: những thiết bị này không chỉ phục vụ mục đích nghiên cứu, cái anh gọi là R&D, mà còn phục vụ cả một số việc liên quan tới production, tức là anh đang chạy thực tế cho một số công cụ, một số thứ anh dùng ở công ty (theo Duy Luân, video đăng ngày 13/11/2026). Rồi anh vào phần chính của video.
2. Workstation với hai card RTX Pro, và vì sao lại là hai card
Món đầu tiên anh giới thiệu là một trong những thứ quan trọng nhất, và cũng là một trong những món đồ công nghệ đắt nhất anh từng mua trong năm nay: một case máy tính. Anh tạm gọi nó là workstation, dù nói rõ là anh sẽ không xếp nó vào loại workstation thật sự, chỉ tạm gọi như vậy thôi (video đăng ngày 13/11/2026).
Bên trong máy có hai card đồ họa: một card NVIDIA RTX Pro 5000 Blackwell và một card cũng là RTX Pro nhưng là bản 4500 Blackwell (video đăng ngày 13/11/2026).
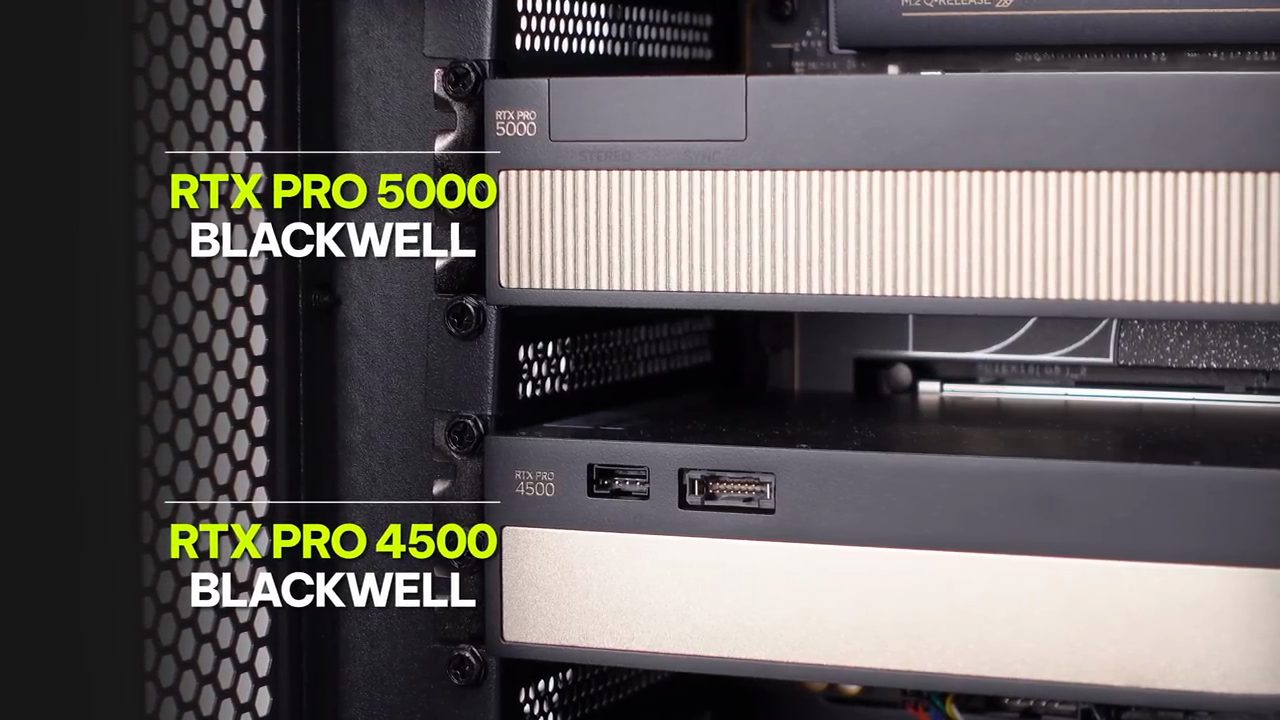
Anh kể thật ra lúc mới mua máy này, anh chỉ mua hai card RTX Pro 4500. Bây giờ thì đang dư ra một card, nên anh để card đó trong một hộp eGPU và kết nối vào máy qua Thunderbolt (video đăng ngày 13/11/2026).
Ý định ban đầu của anh là host một số model, mà nếu chỉ có một card 4500 thì không đủ. Model anh đang chạy là Qwen 3.8, 27 tỷ tham số. Anh thấy bản 8 bit tốt hơn khá nhiều so với bản 4 bit cho những mục đích sử dụng bình thường của anh: cho các công cụ data, cho việc media, cho các bạn editor khi dùng agent để ghép B-roll. Với những việc đó, theo anh, Qwen 3.8 bản 8 bit tốt hơn nhiều. Mà nếu host bản 8 bit thì chỉ một card 4500 là không đủ, nên ngay từ đầu khi build máy anh đã chọn dùng hai card (theo Duy Luân, video đăng ngày 13/11/2026).
Sau đó anh lại muốn nâng thêm, vì thấy VRAM vẫn còn hơi thấp, nên mua thêm một card nữa là RTX Pro 5000. Đây là phiên bản 72GB VRAM. Theo anh, với lượng VRAM Nvidia đang có lúc quay video, máy khá dư dả cho mục đích sử dụng của anh (video đăng ngày 13/11/2026).
Anh nói phần đầu video sẽ giới thiệu phần cứng trước, sau đó mới nói tới phần mềm.
3. CPU Intel, mainboard, RAM 128GB, SSD và nguồn 1600W
Ngoài các card đồ họa, phần mà anh gọi là quan trọng nhất, cấu hình máy còn một số thứ khác. Đầu tiên là CPU: máy chạy Intel Core Ultra 7 270K Plus (video đăng ngày 13/11/2026).
Một điều quan trọng khi anh chọn máy chạy chip Intel là mainboard của nó hỗ trợ Thunderbolt 4. Anh biết là nếu có Thunderbolt 4 thì anh dùng được với hộp eGPU của mình. Thật ra ban đầu máy chỉ có hai card gắn trực tiếp bên trong, không có card rời bên ngoài, và anh dự tính sẽ gắn chiếc RTX 2060 cũ của mình vào hộp eGPU, vì anh biết nếu nối qua eGPU thì nó chạy được bằng Thunderbolt; anh đã test và đã chạy rồi (video đăng ngày 13/11/2026).
Vì vậy khi chọn cấu hình, anh đứng giữa hai lựa chọn, một là Intel, hai là AMD, và anh ưu tiên Intel vì lý do trên. Chưa kể, lúc anh build, bản Intel còn rẻ hơn được vài triệu đồng gì đó so với cấu hình AMD (theo Duy Luân, video đăng ngày 13/11/2026).
Mainboard là ASUS ProArt Z890-Creator WiFi. Bình thường anh cắm dây mạng; phần WiFi không quan trọng lắm. Tản nhiệt các thứ thì anh bỏ qua (video đăng ngày 13/11/2026).
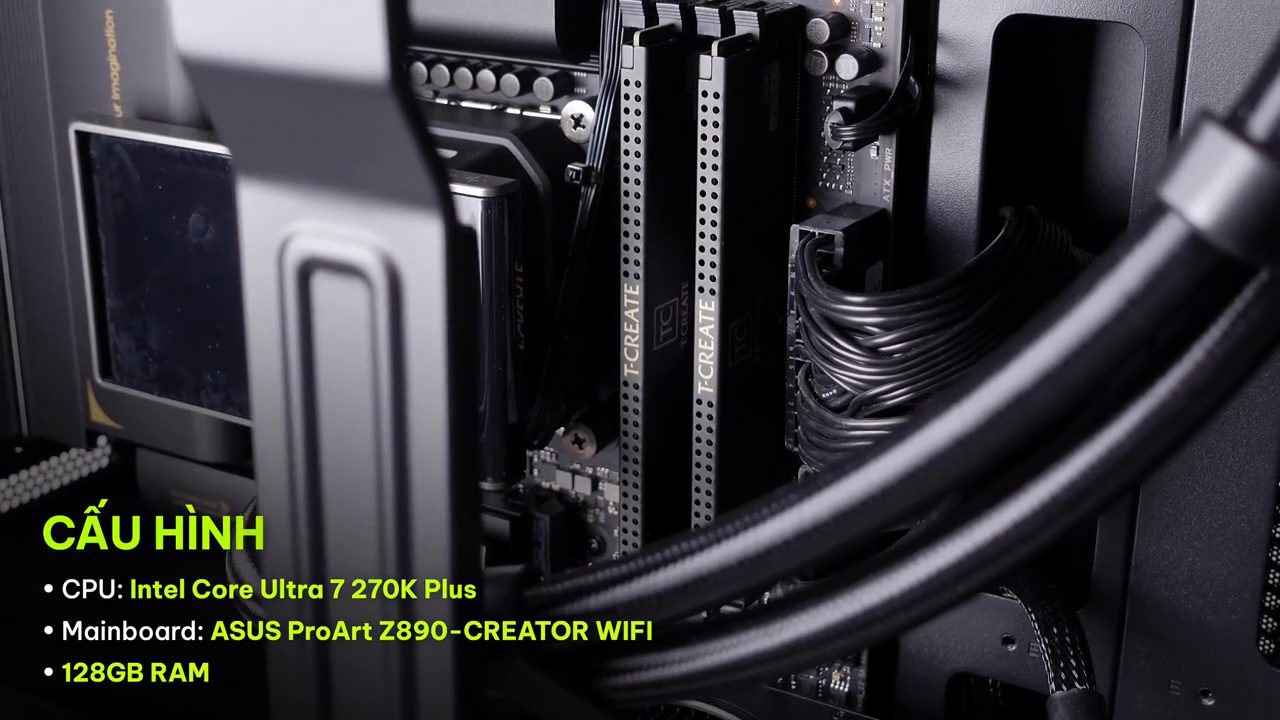
RAM là RAM T-Create của Team Group, tổng cộng 128GB. Anh nói năm nay giá RAM "điên khùng": riêng 128GB RAM này đã 70 triệu đồng. Và đây mới chỉ là RAM bình thường, chưa phải loại RAM chuyên dùng cho máy trạm workstation hay RAM server; những loại đó giá còn cao hơn nữa (theo Duy Luân, video đăng ngày 13/11/2026).
Với một máy R&D, phục vụ nhu cầu không quá cao, anh thấy spec như thế này là đủ. SSD thì chỉ 1TB, anh gắn thêm một ổ 1TB cũ của mình vào nữa (theo Duy Luân, video đăng ngày 13/11/2026).
Nguồn anh đang dùng là 1600W, và theo anh với toàn bộ cấu hình này thì dư sức. Kể cả sắp tới: anh đang mua một adapter chuyển từ M.2 sang PCIe để gắn luôn card đang nằm ở hộp eGPU vào bên trong máy. Máy còn một khe bên dưới, anh chưa biết có vừa không và đang chờ đặt cái dây về để thử. Nếu vừa, anh sẽ đưa card vào bên trong luôn, đỡ tốn một hộp eGPU bên ngoài. Khi đó nguồn 1600W vẫn đủ để ba card chạy được. Lúc mua nguồn, anh cố ý mua dư một chút để sau này mở rộng được (theo Duy Luân, video đăng ngày 13/11/2026).
Đó là chiếc máy chạy các card Nvidia của anh. Anh nói tí nữa người xem sẽ thấy performance của mấy card này "rất là đã": với những mục đích thông thường của anh, máy hoàn toàn đáp ứng được, thậm chí còn dư (theo Duy Luân, video đăng ngày 13/11/2026).
Hôm trước anh tính mua thêm một card RTX Pro 5000 nữa, nhưng sau khi nghiên cứu, anh thấy không cần, vì lúc quay video máy đã đủ khả năng phục vụ anh và các project của anh rồi (theo Duy Luân, video đăng ngày 13/11/2026). Trong lúc anh nói về phần cứng, một thẻ chú thích hiện trên màn hình ghi: "Ở thời điểm bạn coi video này thì mình đang nâng main, CPU và RAM để hỗ trợ 4 GPU PCIe rồi :))" (thẻ chú thích trong video đăng ngày 13/11/2026).
4. Nvidia và Mac Studio: tốc độ prefill và giá tiền
Nói về mặt chi phí, theo anh đây là một trong những nhược điểm lớn nhất của Nvidia ở thời điểm quay video. Các card Nvidia chạy rất tốt cho các LLM. Anh không làm về AI tạo video hay tạo hình ảnh nên không rành mảng đó, nhưng với các LLM thì tốc độ prefill của các card Nvidia này cực kỳ xuất sắc, tốt hơn nhiều so với các máy Mac. Đổi lại, giá của nó cao hơn (theo Duy Luân, video đăng ngày 13/11/2026).
Anh lấy ví dụ một chiếc Mac Studio M5 Ultra: theo anh, lúc quay video mua cấu hình cơ bản là khoảng 150 mấy triệu đồng. Trong khi đó, một card RTX Pro 4500 này hôm trước anh mua đã là 145 hay 142 triệu gì đó rồi, và tới hôm quay video hình như nó còn tăng giá nữa. Riêng card RTX Pro 5000 thì hôm anh mua đã là 315 triệu đồng (theo Duy Luân, video đăng ngày 13/11/2026).
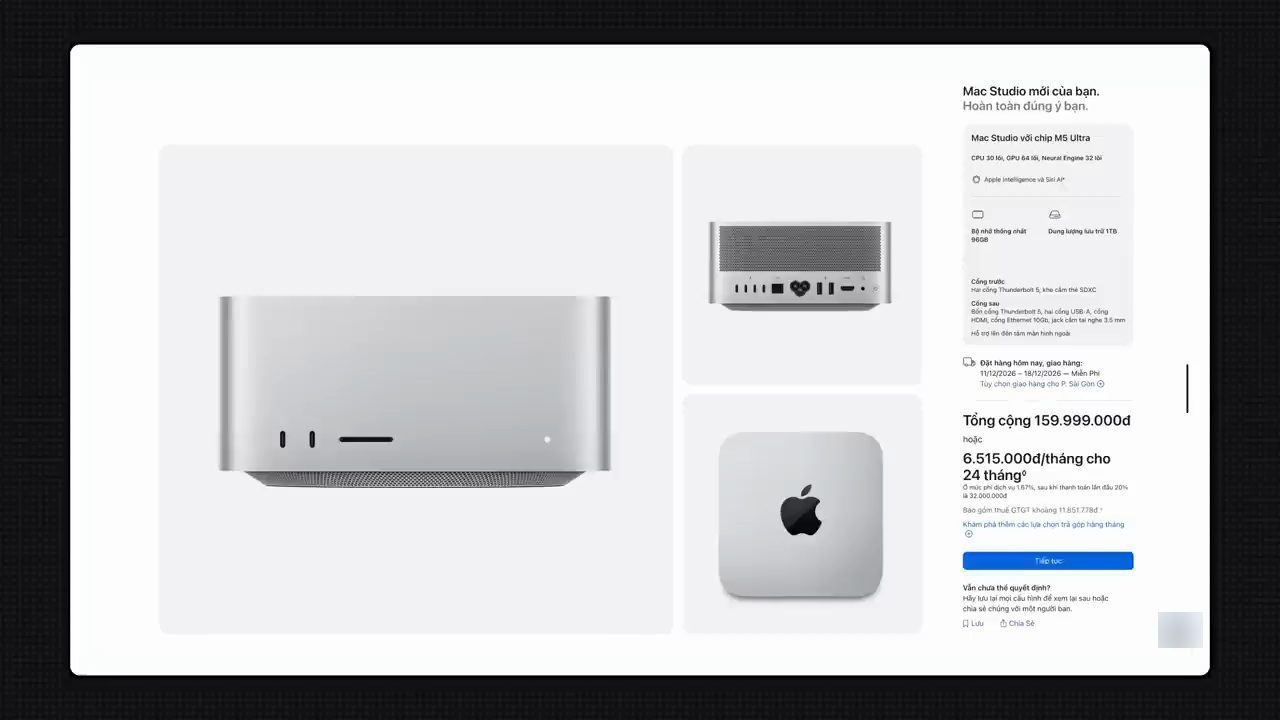
Tính riêng chiếc máy này đã vào khoảng 500 mấy, 600 mấy chục triệu đồng gì đó; anh nói anh chưa ngồi tính chi tiết, nhưng tầm tầm khoảng đó. Vậy mà mức VRAM của nó đâu có phải là 256GB (theo Duy Luân, video đăng ngày 13/11/2026).
Đây là một trong những điểm anh hứa sẽ nói tiếp trong video: sự đánh đổi giữa Nvidia và Mac là gì. Theo anh, mỗi bên có thế mạnh riêng, và tùy vào nhu cầu, mục đích và ngân sách mà mỗi người chọn máy nào (theo Duy Luân, video đăng ngày 13/11/2026).
5. Rack 3U cho hai chiếc Mac Studio
Món phần cứng tiếp theo là một cái khung: một rack 3U, tức chiều cao là 3U. Anh giải thích cho người chưa biết: rack này sẽ được gắn vào trong một cái tủ, và cái tủ đó nằm trong một data center, tạm gọi là trung tâm dữ liệu, vì những máy này anh sẽ không để ở nhà (video đăng ngày 13/11/2026).
Anh cần rack này vì nó gắn được hai chiếc Mac Studio của anh. Anh đang có hai chiếc Mac Studio 256GB RAM: một chiếc chạy chip M3 Ultra, là máy anh dùng từ trước tới giờ, và một chiếc chạy chip M5 Ultra, là máy mới. Anh gắn cả hai máy vào rack, sau đó đem lên tủ rack ở data center để gắn luôn; như vậy anh phục vụ được nhiều mục đích sử dụng khác nhau. Ở data center, theo lời anh, bên vận hành yêu cầu phải có một cái rack như thế này thì mới gắn được hai máy vào (theo Duy Luân, video đăng ngày 13/11/2026).
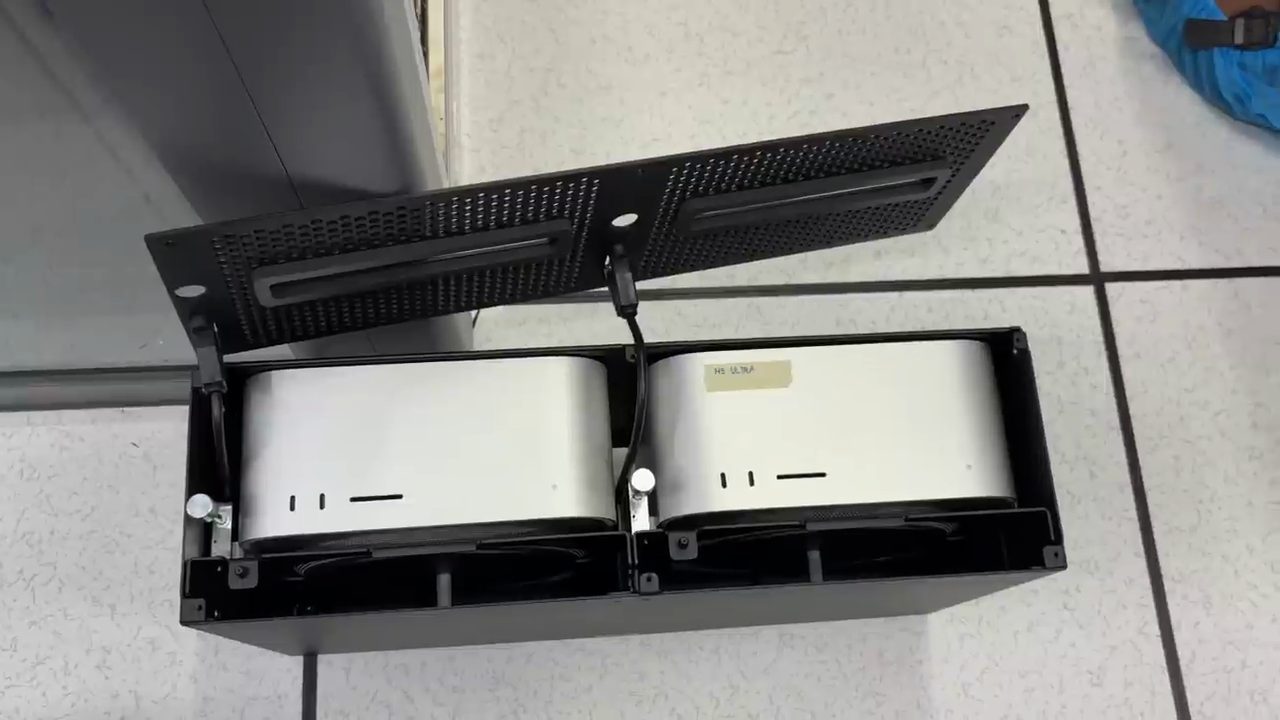
Anh mua rack này của một hãng tên là Sonnet. Ở Việt Nam không có bán, anh phải ship từ nước ngoài về, giá khoảng mười mấy triệu đồng (theo Duy Luân, video đăng ngày 13/11/2026). Trên mặt rack có chữ "RackMac Studio".
Anh nói cái rack này "vui lắm". Ngoài cổng USB các thứ, nó còn có một nút nguồn. Nút này có cơ chế là một cái lẫy tay ở phía sau: khi nhấn nút ở mặt trước, lẫy sẽ nhấn thay vào nút nguồn của chiếc Mac Studio. Như vậy anh không phải vòng ra phía sau tủ rack để nhấn nút, cũng không cần kéo máy ra, chỉ cần nhấn ở bên ngoài. Về cơ bản, theo anh, đây chỉ là một cục sắt, không có linh kiện điện tử gì bên trong hết (theo Duy Luân, video đăng ngày 13/11/2026).
6. eGPU hay PCIe Gen 5, chuyện lên data center và chi phí so với API
Anh nhắc lại: ban đầu anh mua hai card gắn vào trong máy thôi, nhưng rồi lại dư ra một card, nên bây giờ card đó nằm trong hộp eGPU. Và anh nói có một điểm rất thú vị: anh đã benchmark cho những việc thông thường anh làm, và performance khi chạy qua eGPU so với khi cắm thẳng vào một khe PCIe Gen 5 như trong máy là gần như không khác biệt (theo số đo của Duy Luân, video đăng ngày 13/11/2026). Thẻ chú thích trên màn hình lúc đó ghi: "Tốc độ khi sử dụng eGPU và PCIe Gen 5 gần như không khác biệt".
Chỗ khác biệt nằm ở thời gian ban đầu, khi load model vào VRAM của card: qua eGPU thì tốn thời gian hơn. Còn một khi đã load xong, model chạy và bắt đầu serving rồi, thì sự khác biệt không còn đáng kể. Vì vậy lúc quay video anh vẫn để card rời như thế (theo Duy Luân, video đăng ngày 13/11/2026).
Trong thời gian tới, anh dự kiến đổi chiếc máy này sang một case dạng rack 4U, và đang tham khảo xem nếu được thì cũng đem lên data center luôn. Để ở nhà thì, theo anh, điện và mạng lúc quay video vẫn đáp ứng được, nhưng lỡ một hôm cúp điện hay mạng có vấn đề thì các service của anh bị gián đoạn, như vậy không hay lắm, mặc dù chuyện đó hiếm xảy ra. Đó cũng là một lựa chọn anh đang cân nhắc (theo Duy Luân, video đăng ngày 13/11/2026).
Anh nói thật với người xem: với tất cả chi phí anh đang bỏ ra cho project này, con số sẽ gấp rất nhiều lần so với việc dùng các API, ví dụ từ Gemini hay thậm chí từ Claude ở thời điểm quay video. Nhưng được một điều là một số project của anh, những thứ liên quan tới data, không được phép submit lên các API public, và lúc đó anh đã có project này. Anh kể nhờ chiếc máy này mà vừa rồi anh đã win thêm được một project với một khách hàng. Theo anh, nó không chỉ phục vụ mục đích R&D mà còn phục vụ được cho các project của anh (theo Duy Luân, video đăng ngày 13/11/2026).
Đến đây anh nói phần cứng đã giới thiệu xong; anh sẽ nối hết mọi thứ lại và cho người xem thấy anh đang dùng những thứ này để làm gì, vì nếu chỉ có phần cứng không thì chẳng có tác dụng gì, quan trọng là thực tế anh đang dùng ra sao.
7. Agent khai thác dữ liệu trong Data Warehouse
Sang phần mềm. Ngoài việc nghiên cứu R&D, những thứ anh gọi là "vọc", có một thứ theo anh khá quan trọng: trước mắt, hệ thống phục vụ được những việc liên quan tới data của anh (theo Duy Luân, video đăng ngày 13/11/2026).
Anh mở hệ thống có tên Elton DataUtils (tên hiện trên màn hình). Về cơ bản, data đã nằm trong Data Warehouse; câu hỏi tiếp theo là làm sao để khách hàng của anh khai thác nó một cách hiệu quả. Câu trả lời của anh là gắn một agent platform vào, và anh dựng nên một công cụ như vậy. Theo anh, công cụ này cũng đang được cung cấp cho khách hàng của anh (theo Duy Luân, video đăng ngày 13/11/2026).
Anh kể rất nhiều khách chỉ dùng Gemini, vì API key thì họ muốn nhập gì thì nhập, muốn dùng thứ gì thì dùng. Nhưng có một số khách có requirement đặc biệt: những thứ liên quan tới thông tin cá nhân không được submit lên các hệ thống ở nước ngoài. Khi đó anh sẽ config để hệ thống chạy trên phần cứng của anh (theo Duy Luân, video đăng ngày 13/11/2026).
Anh mở phần cấu hình cho người xem. Trang System Configuration, mục AI & Models, có danh sách Provider API Keys: Gemini đang ở trạng thái "Configured (encrypted)", các mục Claude (Anthropic), ChatGPT (OpenAI), DeepSeek và Qwen (Alibaba Cloud) ở trạng thái "Not configured", còn mục "Generic OpenAI Compatible" thì đã cấu hình. Bên dưới là phần "More self-hosted servers" với ba máy: Mac Studio M5 Ultra, Duyluan AI và Octopus AI (trên màn hình trong video đăng ngày 13/11/2026). Anh nói anh có config Gemini nhưng không dùng; anh config cho nó chạy vào hệ thống của các card Nvidia. Lúc quay video, dù máy đang nằm ở nhà anh, mạng các thứ vẫn ổn nên nó chạy ok; sau này khi lên data center thì còn tốt hơn nữa (theo Duy Luân, video đăng ngày 13/11/2026).
"Octopus AI" là cái tên anh tự đặt thôi, không có ý nghĩa gì hết. Còn model thì, theo anh, cho tất cả các tính năng liên quan tới agent, hệ thống đều đang chạy Qwen 3.8 (video đăng ngày 13/11/2026).
Rồi anh cho xem hệ thống được dùng thế nào. Một trong những thứ anh khá thích là có thể hỏi thông tin một cách đơn giản. Anh nói trước rằng đây là data dummy nên người xem không có gì phải lo. Anh hỏi tình hình CRM và hệ thống e-commerce trong 7 ngày, rồi đổi lại thành trong 6 tháng qua. Câu hỏi hiện trong khung chat là: "Tình hình của CRM và hệ thống ecommerce trong 6 tháng qua như thế nào" (demo trong video đăng ngày 13/11/2026).
Anh nói cũng có thể nhập bằng voice input: trong ô nhập có biểu tượng micro, và tính năng voice này cũng là thứ anh đang serve trên chiếc Mac Studio của mình. Anh cho phép dùng micro rồi nói thêm yêu cầu: trình bày dưới dạng bảng và tạo thành một dashboard (demo trong video đăng ngày 13/11/2026).
Model này nằm ở đâu? Theo anh, nó đang được serve từ chiếc Mac Studio M5 Ultra của anh (video đăng ngày 13/11/2026).
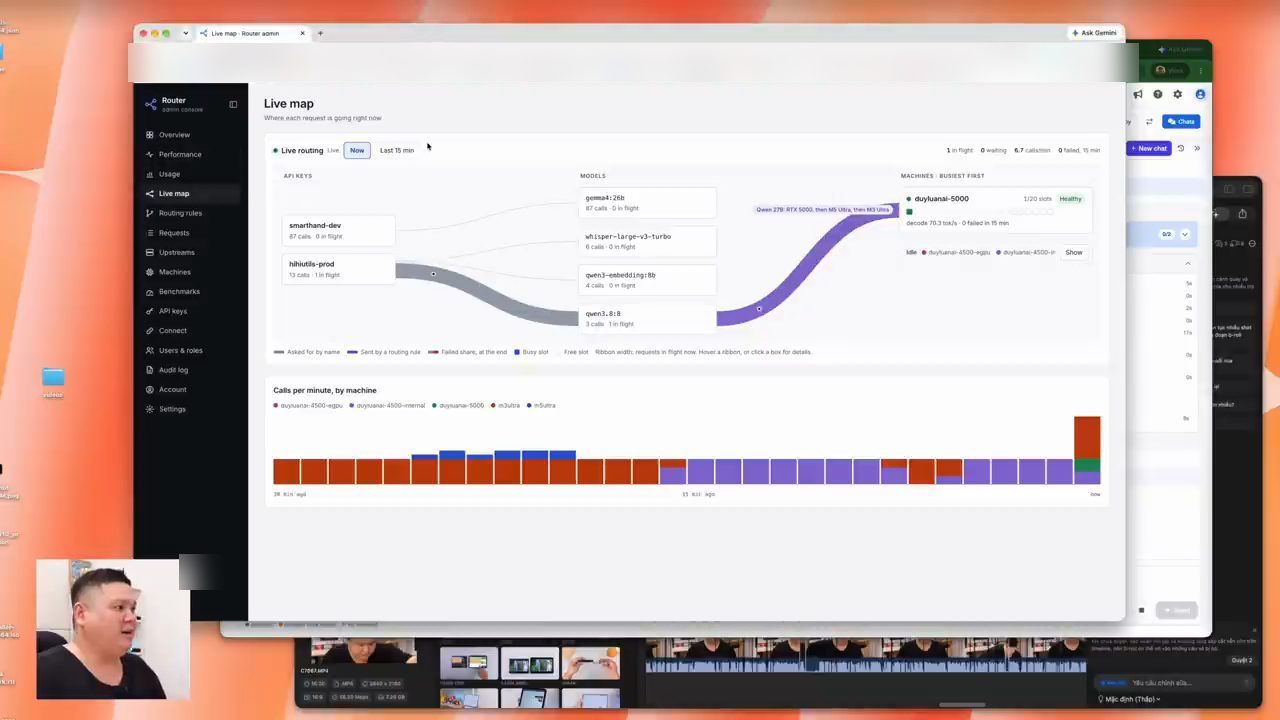
Để cho người xem thấy, anh mở một hệ thống khác: một router dùng để điều hướng các request tới model chạy ở những máy khác nhau. Trên router, "hihiutils" là hệ thống vừa rồi; nó gọi model Qwen 3.8, và model Qwen 3.8 này đang được serve từ card RTX Pro 5000, chạy bằng vLLM (theo Duy Luân, video đăng ngày 13/11/2026). Anh cho thấy có nhiều hệ thống đang chạy như thế.
8. Agent trong CRM của công ty
Anh còn có một hệ thống CRM nữa và mở luôn cho người xem. CRM này đang phục vụ các công ty của anh (video đăng ngày 13/11/2026).
Anh gõ thử một yêu cầu hiển thị các hợp đồng mới trong 3 tháng, rồi dừng lại và tự hỏi sao mình phải nhập tay, vì quên mất là hôm trước vừa làm tính năng voice. Anh đổi sang yêu cầu lấy tất cả hợp đồng xuất hiện trong một tuần qua, và nói là có thể nhập bằng voice input luôn. Trên màn hình, câu hỏi trong khung chat CRM AI Agent là "Lấy tất cả hợp đồng xuất hiện ở trong một tuần qua", và ô chọn model bên dưới ghi "qwen3.8:8" (demo trong video đăng ngày 13/11/2026).
Anh chỉ cho người xem: request vừa rồi đã gọi vào model Whisper Large V3 Turbo. Model này chạy trên chiếc M3 Ultra của anh, chiếc M3 Ultra đang nằm trên data center. Tức là anh có rất nhiều model ở những máy khác nhau, và nhờ có một hệ thống router như thế này, nó biết với những request nào thì nên đi tới chỗ nào (theo Duy Luân, video đăng ngày 13/11/2026).
Theo anh, khi một hệ thống chạy như thế này, các bạn trong team admin của anh, trước đây phải thao tác với một giao diện CRM truyền thống có form, có bảng biểu này kia, mất thời gian hơn; bây giờ họ chỉ cần hỏi đáp với agent. Ở đây anh chỉ đang truy vấn thông tin, một tác vụ rất đơn giản, nhưng các bạn trong team còn làm nhiều thứ phức tạp hơn: tạo báo cáo, tạo slide phục vụ việc nghiệm thu, hay có hóa đơn thì đính kèm hóa đơn, invoice vào một hợp đồng nào đó, rồi tạo hợp đồng mới. Tất cả đều được thao tác qua các agent này (theo Duy Luân, video đăng ngày 13/11/2026).
Những thông tin này anh không muốn đưa lên hệ thống Cloud API, và có một số thông tin không được phép đưa lên luôn. Vì vậy, theo anh, chạy model trực tiếp là quá hợp lý (theo Duy Luân, video đăng ngày 13/11/2026).
Anh quay lại hệ thống data lúc nãy. Lệnh của anh được nhận bởi agent chính, agent này gọi qua hai agent phụ, mỗi agent phụ được access vào một vùng khác nhau trên Data Warehouse, rồi trả về cho anh một kết quả. Anh nói các con số này người xem cứ nhìn thoải mái, vì đó là dummy data anh generate để những lúc cần thuyết trình với khách thì có data để nói (demo trong video đăng ngày 13/11/2026).
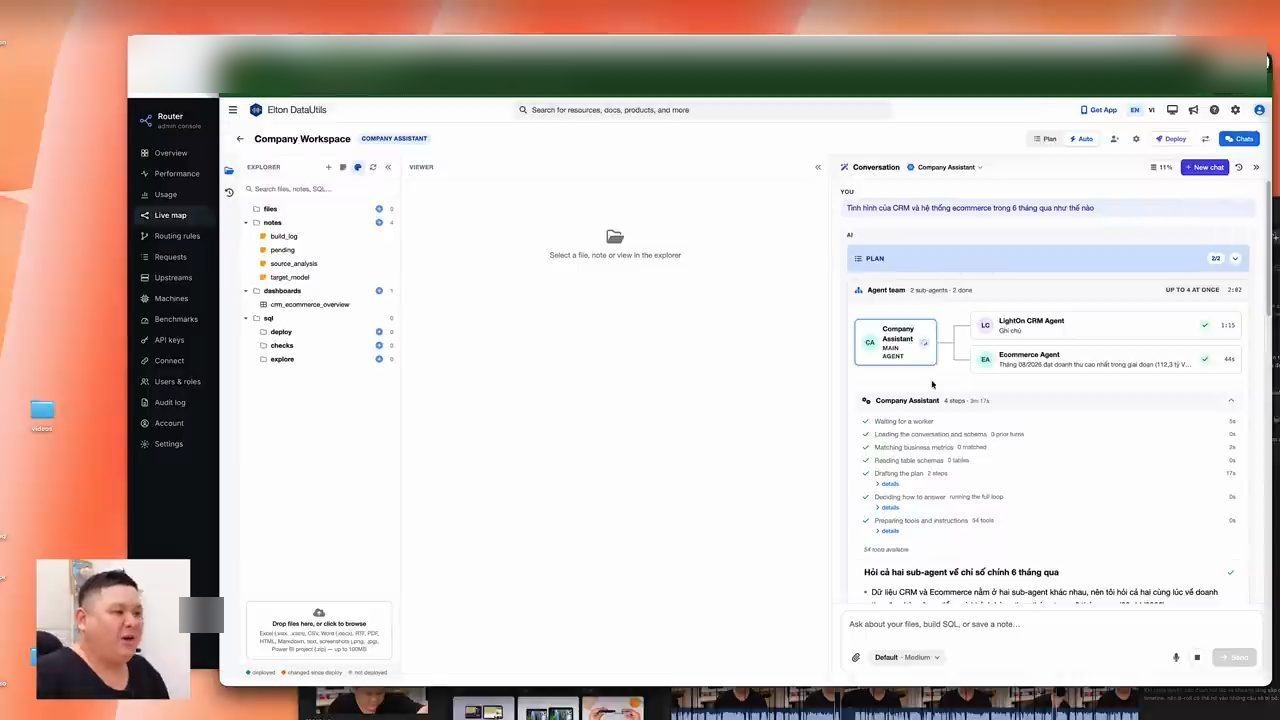
Theo anh, tất cả những thứ này đang chạy cực kỳ tốt với các model anh self-host. Anh nói thật anh cũng bất ngờ: khoảng một năm trước, anh không nghĩ model self-host sẽ làm được như thế này. Nhưng những model như Qwen 3.8, 27 tỷ tham số, là model anh rất thích vì nó càng lúc càng thông minh hơn; những model DeepSeek lúc quay video cũng tốt; hay thậm chí Gemma của Google, Gemma 4, cũng cực kỳ tốt (theo Duy Luân, video đăng ngày 13/11/2026).
Khi model chạy được những việc như thế này, điều quan trọng, theo anh, là các việc đó khá đơn giản, đâu cần một model quá lớn, model vẫn có thể hoàn thành tốt. Nó giải quyết được một điểm nghẽn trước đây: khách có data nhưng phải thuê BA để làm. Bây giờ thì nhiều khi team business của khách tự vào dùng công cụ này luôn, tự vọc trực tiếp (theo Duy Luân, video đăng ngày 13/11/2026).
9. Remote Library: index từng đoạn B-roll
Thứ nhất là data, thứ hai là CRM. Còn một việc nữa anh đang dùng các model self-host, đó là việc media (video đăng ngày 13/11/2026).
Anh mở một app dựng video. Theo anh, bình thường mọi người dùng app này thì nó có một số tính năng, nhưng khi anh dùng nó gắn vào một hệ thống backend riêng của mình thì có thêm một số tính năng nữa. Một trong những tính năng anh dùng nhiều nhất tên là Remote Library: tất cả video anh từng quay đều nằm trên đây (theo Duy Luân, video đăng ngày 13/11/2026).
Anh lấy một project gần đây làm ví dụ, project về iPad mini, quay trong chuyến công tác hôm trước. Với từng đoạn B-roll, hệ thống cho anh biết clip đó nói về cái gì, và trong clip có những thông tin cụ thể ra sao ở từng mốc thời gian khác nhau. Như vậy anh tìm rất dễ; và thứ hai, khi anh chạy tính năng Smart Edit để ghép B-roll thông minh, nó cũng có thể hoàn thành rất tốt (theo Duy Luân, video đăng ngày 13/11/2026).
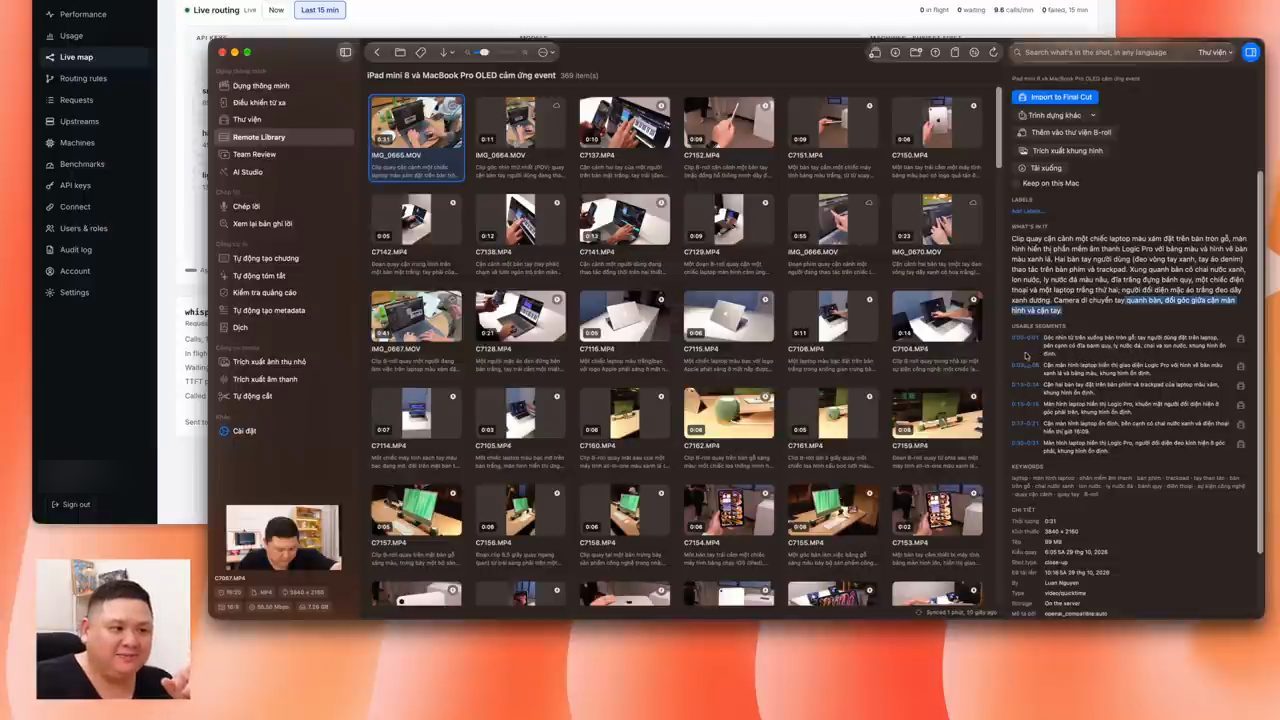
Để có được những thông tin như vậy, với mỗi video anh có một thuật toán đơn giản, phần này thì không cần AI: nó tách ra những khúc có thay đổi lớn trong video. Với mỗi khúc, hệ thống submit lên để index xem đoạn đó nói về nội dung gì (theo Duy Luân, video đăng ngày 13/11/2026).
Anh cho xem một clip đã index, quay chiếc MacBook Pro có màn hình cảm ứng. Clip có 3 mốc timestamp khác nhau, và 3 mốc này được AI sử dụng trong việc tìm kiếm và Smart Edit (demo trong video đăng ngày 13/11/2026).
10. Tìm B-roll bằng chữ và bằng ngữ nghĩa
Việc tìm kiếm này khác bình thường thế nào? Anh kể trong công việc, anh hay các bạn editor thường phải đi tìm một cảnh quay cũ nào đó. Chẳng hạn bây giờ anh muốn tìm MacBook Air, MacBook Air M4. Anh gõ tìm như vậy, và hệ thống trả về những cảnh quay MacBook Air M4 mà anh đã quay cách đây khoảng một năm mấy, tức là của năm 2025 (demo trong video đăng ngày 13/11/2026).
Lý do anh đưa ra là mọi thứ đã được index, và anh kết hợp cả search thông thường lẫn semantic search, nên hệ thống ra được thông tin anh muốn (theo Duy Luân, video đăng ngày 13/11/2026).
Tìm theo dạng chữ như thế là đơn giản. Còn tìm theo những thứ xuất hiện trong video thì sao? Anh thử gõ: "Người đàn ông ngồi trên bàn trước một cái laptop". Anh giải thích có thể là anh đang có một nhu cầu nào đó, cần một video minh họa cho đoạn này. Hệ thống vẫn tìm ra được tất cả các video có một người đàn ông ngồi trước một cái laptop (demo trong video đăng ngày 13/11/2026).
Rồi anh muốn cụ thể hơn, không phải laptop chung chung, và đổi truy vấn thành: "Người đàn ông cầm tai nghe". Theo anh, vì khi lưu thông tin này anh không chỉ lưu dạng text mà còn dùng embedding, nên khi search theo embedding, tức là theo dạng vector, anh cũng tìm được theo ngữ nghĩa. Kết quả ra những video có người đàn ông cầm tai nghe (demo trong video đăng ngày 13/11/2026).
Anh chỉ vào một video trong kết quả: nó có nhiều khúc, và anh có thể tìm được nhiều khúc khác nhau trong cùng video đó. Theo anh, đây là một trong những thứ giúp tiết kiệm rất nhiều thời gian cho anh và các bạn editor (theo Duy Luân, video đăng ngày 13/11/2026).
Anh cũng cho biết các folder này có thể sync trực tiếp vào máy, để lúc edit thì không phải lôi từ cloud về mà lấy B-roll trực tiếp từ trong máy ra. Anh nói mấy tính năng lặt vặt đó thì không liên quan tới AI (theo Duy Luân, video đăng ngày 13/11/2026).
Người đàn ông ngồi trên bàn trước một cái laptop
Người đàn ông cầm tai nghe
11. Smart Edit: nhờ agent chèn B-roll, và hóa đơn Gemini trước đó
Ngoài ra anh còn có tính năng Smart Edit. Anh mở một project về video so sánh iPhone Duo với Galaxy Z Fold 8. Bình thường, theo anh, anh phải ghép B-roll thủ công vào: khi nói về một vấn đề gì đó, ví dụ nói về màn hình của một chiếc laptop, anh phải ghép những hình ảnh màn hình vào để người xem nhìn, hay nói về thiết kế, hay về đa nhiệm chạy thế nào. Trước đây, theo cách truyền thống, anh phải làm việc đó thủ công (theo Duy Luân, video đăng ngày 13/11/2026).
Bây giờ anh cho nó chạy: anh bảo nó chèn B-roll cho toàn bộ video. Anh nói đây là một project thô; quy trình bình thường của anh là cắt voice xong rồi mới ghép, nhưng ở đây anh cho xem trước cách nó hoạt động để người xem hình dung (demo trong video đăng ngày 13/11/2026).
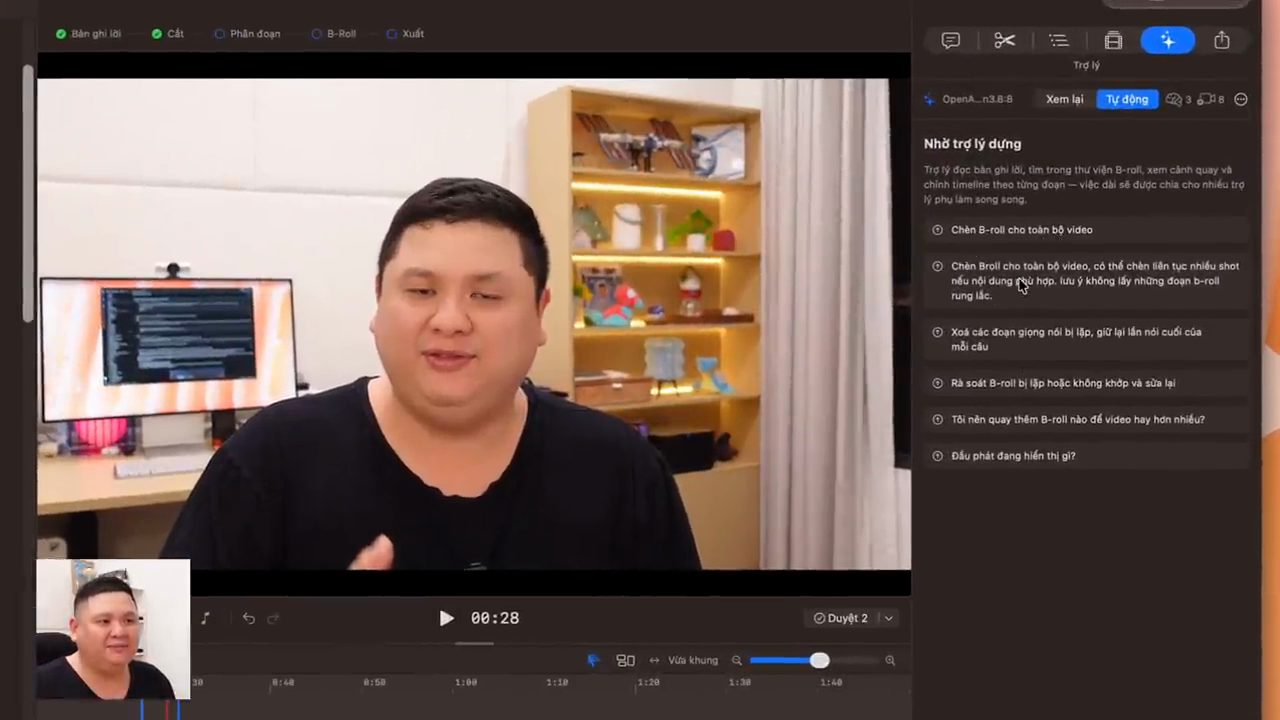
Các gợi ý trong khung trợ lý, chép từ màn hình:
Chèn B-roll cho toàn bộ video
Chèn Broll cho toàn bộ video, có thể chèn liên tục nhiều shot nếu nội dung phù hợp. lưu ý không lấy những đoạn b-roll rung lắc.
Xoá các đoạn giọng nói bị lặp, giữ lại lần nói cuối của mỗi câu
Rà soát B-roll bị lặp hoặc không khớp và sửa lại
Tôi nên quay thêm B-roll nào để video hay hơn nhiều?
Đầu phát đang hiển thị gì?
Lúc này, theo anh, nó đang bắt đầu gọi lên, và chạy trực tiếp trên Qwen 3.8 đang host trong hệ thống Nvidia của anh (demo trong video đăng ngày 13/11/2026).
Anh kể khoảng một tháng trước, khi anh chưa mua mấy card Nvidia này, toàn bộ những việc này anh đang dùng qua API của Gemini. Để đạt được kết quả như ý, anh nhớ tháng trước anh trả khoảng 500, 600 đô gì đó cho tất cả tiền API Gemini của mình. Về API, lúc quay video anh chỉ dùng Gemini. Vì tất cả chạy qua Gemini nên coi như là 600 đô một tháng, mà đó là khi tần suất sử dụng còn ít, anh còn không chạy đủ cả tháng (theo Duy Luân, video đăng ngày 13/11/2026).
Khi chuyển qua phần cứng của mình, nó tiết kiệm được một phần chi phí cho anh. Tất nhiên, anh nói, không thể nào break even được 100%, vì chiếc máy này anh mua hơi lố so với nhu cầu của anh. Nhưng anh vẫn muốn người xem hình dung được là nó bù đắp được một phần trong chi phí đó (theo Duy Luân, video đăng ngày 13/11/2026).
12. Lead agent, sub-agent và Nvidia so với Mac Studio khi nhiều người dùng
Bên trong chính app này có một cơ chế: một agent gọi là lead agent. Agent này điều phối cho nhiều sub-agent khác, để các sub-agent bắt đầu đi tìm những B-roll tương ứng với từng đoạn video và ghép vào (theo Duy Luân, video đăng ngày 13/11/2026).
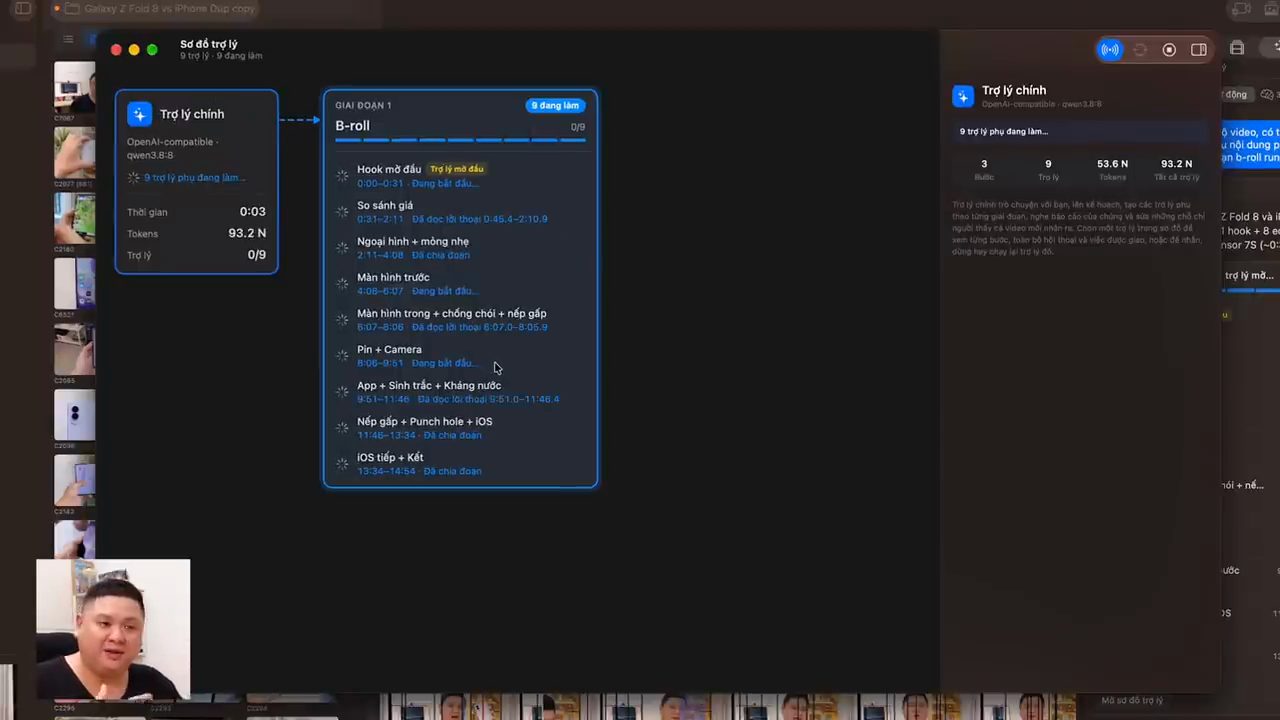
Anh mở thử sub-agent phụ trách phần ngoại hình xem nó đang làm gì: nó cũng đang đi search, đi tìm kiếm. Anh chỉ ra rằng nhờ anh đã index các video và biết được nội dung video, agent mới tìm kiếm được; nếu không có phần index ở đoạn đầu thì agent lấy gì mà ghép vào (demo trong video đăng ngày 13/11/2026).
Tính năng này cũng có một bạn editor trong team đang dùng chung với anh và đang test thời gian gần đây. Theo anh, nó tiết kiệm được thời gian cho anh và team, và khi đó thời gian dành cho những việc quan trọng hơn, tạo ra nhiều ý nghĩa hơn. Đi tìm B-roll thì có gì đâu, ai làm chẳng được; các bạn editor có thể dành thời gian để tạo những minh họa cho đẹp hơn, những hiệu ứng, hoặc chăm chút cho những thứ khác. Nói chung, theo anh, mấy việc thủ công này để agent thay thế là rất hợp lý (theo Duy Luân, video đăng ngày 13/11/2026).
Agent chia từng đoạn trong video ra, rồi bắt đầu edit, edit, edit. Tất cả các request, như người xem thấy trên router, đang được điều phối về Qwen trên card RTX Pro 5000. Với model Qwen này, anh đang chừa 20 slot; nếu 20 slot đầy, router bắt đầu fallback, gửi tiếp những request đó qua chiếc M5 Ultra của anh (theo Duy Luân, video đăng ngày 13/11/2026).
Khi anh đo thử tất cả những thứ như thế này, card Nvidia chạy nhanh hơn Mac Studio rất nhiều, đặc biệt là về concurrency, tức là phục vụ cho nhiều người sử dụng cùng lúc: ở khoản này, theo anh, Mac Studio không thể nào so được với các card Nvidia (theo số đo của Duy Luân, video đăng ngày 13/11/2026).
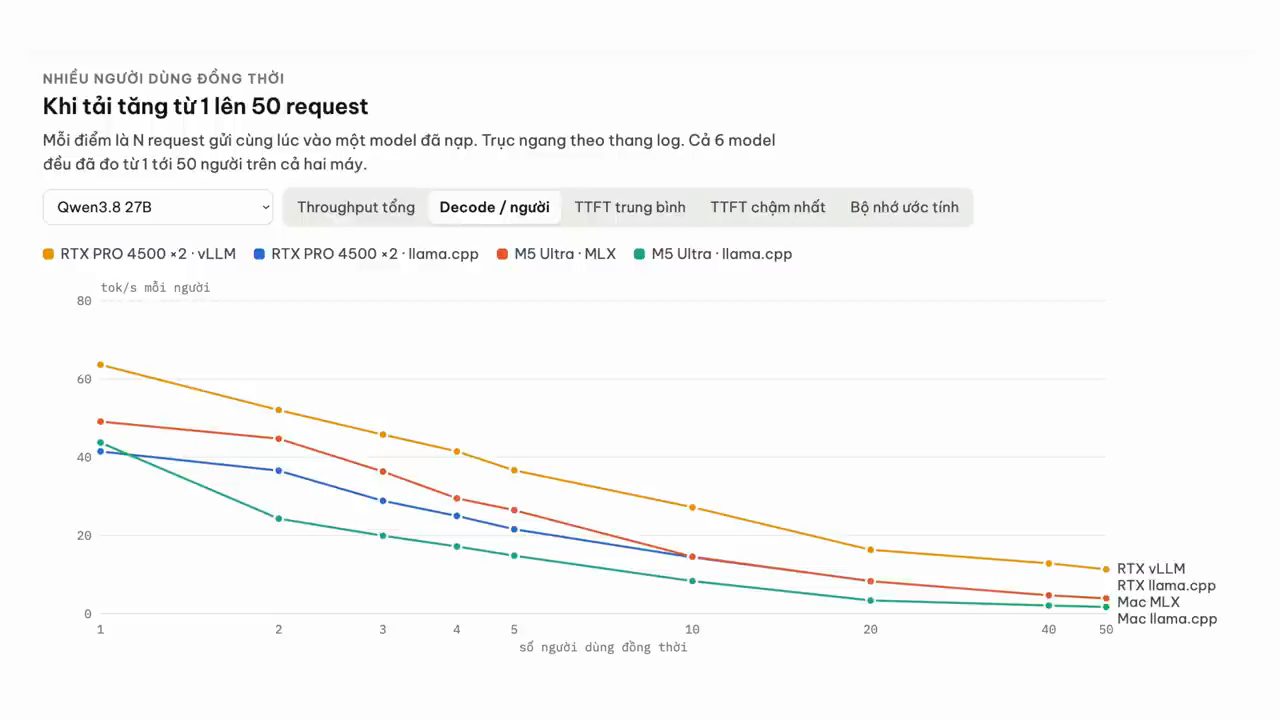
Dòng mô tả của biểu đồ ghi: "Mỗi điểm là N request gửi cùng lúc vào một model đã nạp. Trục ngang theo thang log. Cả 6 model đều đã đo từ 1 tới 50 người trên cả hai máy." (trên màn hình trong video đăng ngày 13/11/2026).
Điểm trừ của các card Nvidia, theo anh, là quá đắt. Nếu không đủ kinh phí, Mac Studio là một lựa chọn tiết kiệm hơn. Nếu serve cho khoảng 4 hoặc 6 người cùng lúc thì Mac Studio vẫn được, nhưng serve cho nhiều người thì không được, phải là các card Nvidia. Còn dùng cho quy mô nhỏ hơn, anh thấy Mac Studio tiết kiệm hơn (theo Duy Luân, video đăng ngày 13/11/2026).
Anh nói anh có đủ hết rồi, thậm chí có luôn cả tính năng benchmark; nhưng trong video này anh chỉ nói về các ứng dụng, vì benchmark cho từng máy thì nhiều lắm (video đăng ngày 13/11/2026).
13. Chạy song song, xuất sang Final Cut Pro, và những việc lặp đi lặp lại
Quay lại việc media: anh nói nhờ chạy sub-agent song song như thế này, đúng nghĩa là concurrency, hệ thống đang gửi rất nhiều request lên card Nvidia của anh. Và nhờ nhiều sub-agent chạy song song, anh tiết kiệm được thời gian (theo Duy Luân, video đăng ngày 13/11/2026).
Nếu không, cứ chạy lần lượt, thì rất lâu. Anh kể ban đầu anh làm cho nó chạy lần lượt, trước khi đổi qua sub-agent, và "trời ơi" nó rất lâu, tốn thời gian nhiều lắm. Còn ở đây nó chạy đâu đó khoảng 5 đến 7 phút gì đó là xong (theo số đo của Duy Luân, video đăng ngày 13/11/2026).
Khi đó việc của anh là xuất kết quả vào Final Cut Pro rồi edit tiếp: anh có thể cắt, gọt, chỉnh sửa thêm những thứ khác trong Final Cut Pro (theo Duy Luân, video đăng ngày 13/11/2026).
Qua đây anh muốn chia sẻ: những việc mang tính lặp đi lặp lại, những việc nghe khá chán, là những thứ anh thấy AI có thể thay thế rất tốt. Anh khuyên người xem nhìn thử xung quanh mình: việc nào thay thế được bằng AI thì thường sẽ là những việc mang tính lặp lại như thế, rồi nghiên cứu xem có thể áp dụng bằng cách nào (lời khuyên của Duy Luân, video đăng ngày 13/11/2026).
Anh nói ở đây anh đang làm cho workflow bình thường của mình và cho khoản ngân sách anh đang có. Còn với đa số mọi người, có thể sẽ không cần phức tạp như vậy, hoặc không cần nhiều như vậy; khi đó họ sẽ dùng cho những nhu cầu ít hơn (theo Duy Luân, video đăng ngày 13/11/2026).
Anh nhắc lại: những thứ này lúc quay video anh đang serve từ nhà mình thôi. Khi lên data center, mạng ngon hơn, điện ổn định hơn, có cả hệ thống cấp điện các thứ, thì chạy production còn ok hơn nữa. Lúc quay video anh đang hỏi giá các bên co-location để chọn, nên chưa đem máy lên data center (theo Duy Luân, video đăng ngày 13/11/2026).
14. Router: số token, ngày bắt đầu và cơ chế chuyển máy
Anh xem lại số liệu của router. Từ lúc anh build router này tới khi quay video là khoảng một tuần rưỡi, và anh đã dùng 142 triệu token in, 18 triệu token out (theo số liệu của Duy Luân, video đăng ngày 13/11/2026).
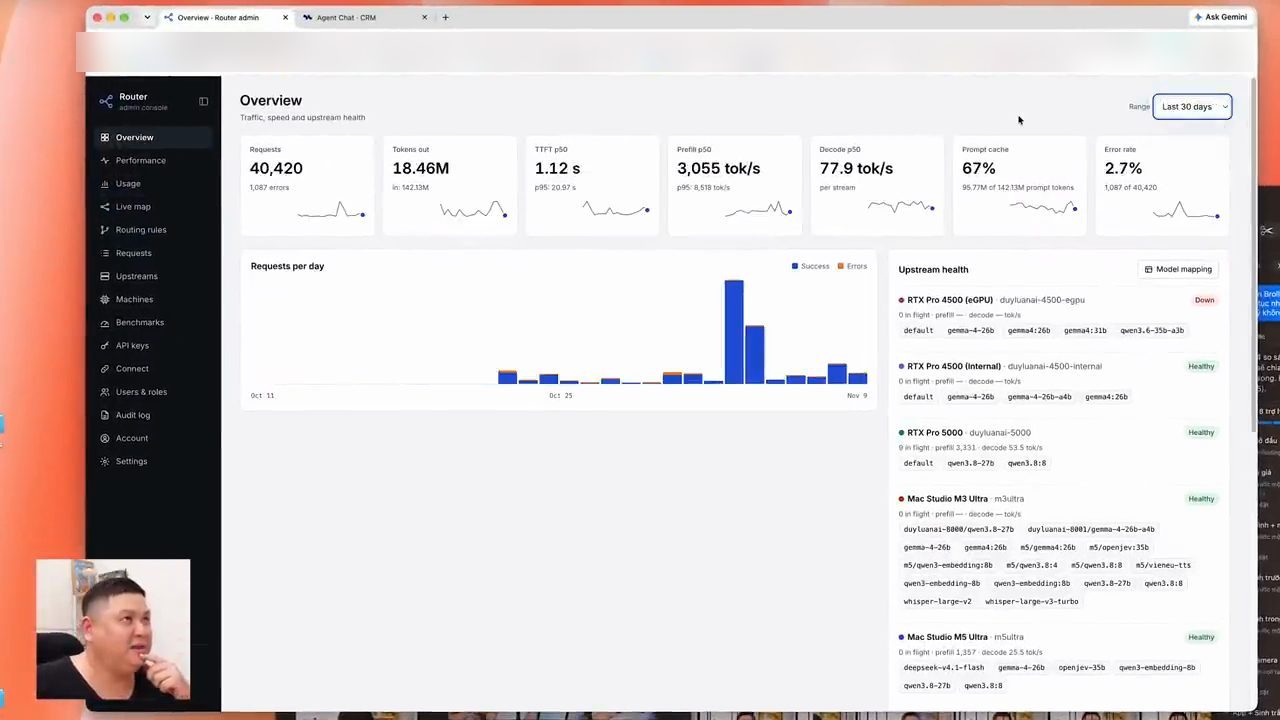
Anh bắt đầu chuyện này khoảng ngày 23 tháng 10: ngày 23/10/2026 là ngày anh build router. Trước đó, các hệ thống gọi trực tiếp vào từng máy, và anh thấy như vậy phức tạp quá, setup này kia không ngon, nên anh nối hết vào router (theo Duy Luân, video đăng ngày 13/11/2026).
Router còn một tác dụng nữa: ví dụ một máy nào đó bị "đau", bị sập, bị mất điện hay bị lỗi gì đó, router sẽ tự động chuyển request đó tới những máy khác. Theo anh, đó cũng là một chức năng nữa của router anh đang build (theo Duy Luân, video đăng ngày 13/11/2026).
15. Những gì anh học được, hai card 4500 còn dư và con robot
Đương nhiên, qua tất cả những việc này anh học được rất nhiều thứ về self-host, về local AI: làm sao để optimize KV cache, làm sao host được nhiều thứ song song. Trên Linux anh chạy vLLM, còn trên Mac anh chạy MLX server để có performance tốt hơn (theo Duy Luân, video đăng ngày 13/11/2026).
Theo anh, nếu không có chiếc máy này thì anh vẫn học được những thứ đó bằng cách này hay cách khác, nhưng có thể sẽ mất thời gian hơn. Chưa kể máy là đồ của mình thì dùng thoải mái hơn, đỡ phải suy nghĩ. Chưa kể chuyện data submit ra bên ngoài thì rủi ro lắm. Nên anh thấy cũng chấp nhận được (theo Duy Luân, video đăng ngày 13/11/2026).
Như anh nói từ đầu, thật ra với những nhu cầu bình thường này, mua một card RTX Pro 5000 72GB là đủ đáp ứng: anh host được một model Qwen và một model Gemma, về cơ bản là ok hết rồi. Coi như hai card 4500 của anh đang bị dư ra. Nhưng giờ bán thì mất công quá, nên anh để đó làm R&D cho những thứ khác (theo Duy Luân, video đăng ngày 13/11/2026).
Anh sẽ có một con robot nho nhỏ, và anh sẽ chạy NVIDIA Isaac để chạy robot simulation và reinforcement learning. Con robot thì anh có rồi, nhưng hôm trước anh làm hư nên đang đem đi sửa (theo Duy Luân, video đăng ngày 13/11/2026).
Lúc đó trên màn hình, một agent trong project ghép B-roll đã xong. Anh nhận xét: nói chung nó cũng nhanh. Trong thời gian nó ghép B-roll, anh có thể làm việc khác, khi nào nó xong thì quay lại. Đó là cách anh chờ khi dùng AI: tận dụng thời gian đó cho những việc khác (demo trong video đăng ngày 13/11/2026).
16. Robot test pin: Gemma 4 nhận diện màn hình điện thoại
Anh nhớ ra còn một việc nữa, đơn giản thôi, nho nhỏ thôi, nhưng sẵn có cluster này thì anh dùng: con robot test pin của anh (video đăng ngày 13/11/2026).
Lúc trước anh có một model AI nho nhỏ để nhận diện xem màn hình điện thoại có đang bật hay không, và lúc trước model đó chạy trực tiếp trên chiếc MacBook Pro của anh. Nhiều khi anh đang cần test pin mà vẫn phải đem máy đi ra ngoài các thứ. Sau này anh có thể chuyển qua một chiếc Mac Studio hay một chiếc Mac mini cố định cũng được, vì phần model bây giờ anh đã host trên card Nvidia rồi (theo Duy Luân, video đăng ngày 13/11/2026).
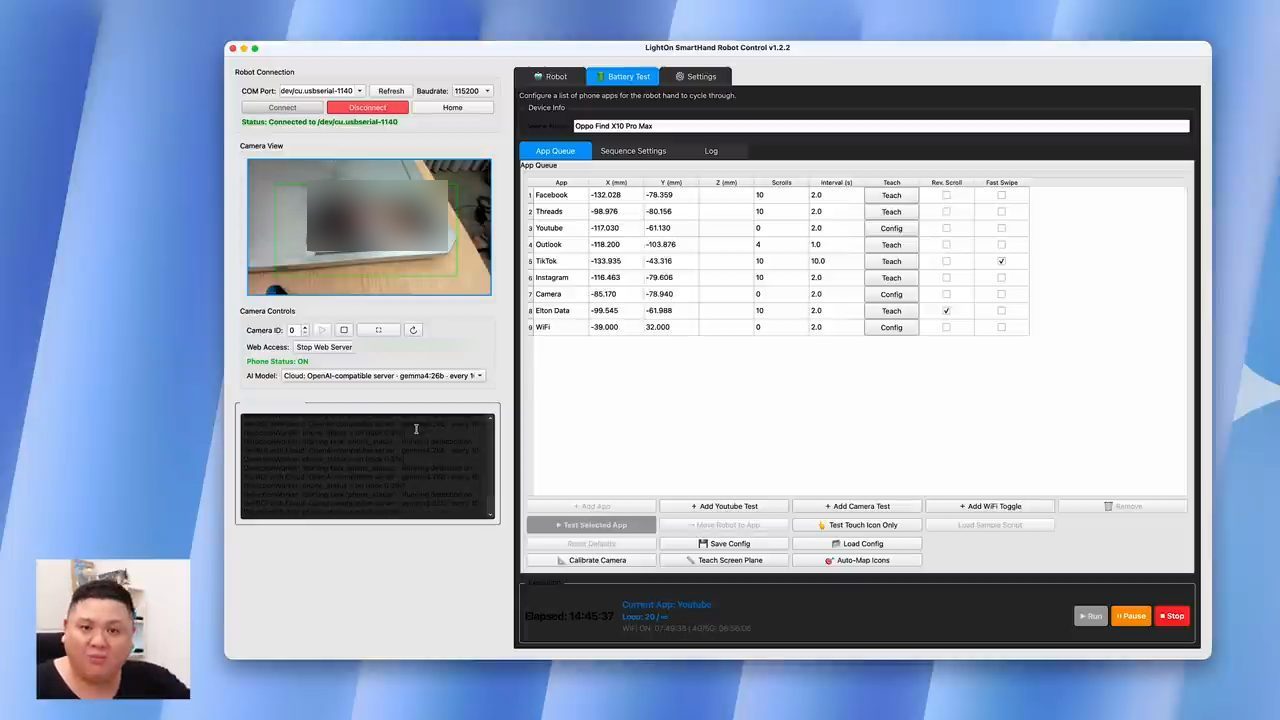
Anh cho xem log đang chạy, và nhờ người xem chịu khó nhìn vì app này có lỗi màu ở Dark Mode. Cứ mỗi 10 giây, app gửi một khung hình lên model Gemma 4 26 tỷ tham số, cụ thể là Gemma 4 26B A4B, để nhận diện xem điện thoại còn bật hay không. Và nó chỉ tốn 0,2 mấy giây để xử lý, theo anh là rất nhanh (theo số đo của Duy Luân, video đăng ngày 13/11/2026).
Hồi trước, lúc anh host model cũ là Gemma 3 chạy trực tiếp trên MacBook của mình, nó cần khoảng 2 đến 3 giây mới xong. Bây giờ, theo anh, nhanh hơn rất nhiều (theo số đo của Duy Luân, video đăng ngày 13/11/2026).
Quay lại router, anh chỉ cho người xem request từ SmartHand đang đi đâu: nó đang trỏ vào card 4500 gắn bên trong máy. Nhưng lúc nãy, khi anh gỡ máy ra để quay cho người xem, request sẽ lại chạy xuống chiếc M3 Ultra. Theo anh, tác dụng của router là như vậy (demo trong video đăng ngày 13/11/2026).
Những thứ này, lúc quay video, anh dùng cho công ty, không public ra ngoài (theo Duy Luân, video đăng ngày 13/11/2026).
17. AI cho business, và khi nào không cần self-host
Anh tổng kết: đó là một vài thứ anh đang dùng, cái anh gọi là AI cho business. Không phải những nhu cầu giải trí cá nhân hay sắp xếp việc cá nhân gì hết, mà là những thứ rất business: nó sinh ra tiền, nó tiết kiệm được thời gian, nó ảnh hưởng tới productivity của công ty (theo Duy Luân, video đăng ngày 13/11/2026).
Anh làm video này để người xem tham khảo: đây là những ứng dụng có thể dùng được, và không nhất thiết phải self-host. Phần self-host này, phần lớn với anh là R&D, và anh làm cho biết. Còn không thì có thể dùng API Gemini này kia, chi phí sẽ rẻ hơn rất nhiều (theo Duy Luân, video đăng ngày 13/11/2026).
Ngoại trừ những thứ không được submit lên cloud: khi đó, theo anh, phải nhớ kiểm tra kỹ phần này. Anh cho rằng đây sẽ là một trong những vấn đề quan trọng nhất khi sử dụng những hệ thống này, cái anh gọi là AI in business (lời khuyên của Duy Luân, video đăng ngày 13/11/2026).
Duy Luân cảm ơn người xem rất nhiều, chào và hẹn gặp lại.
Nguồn và liên kết 10 nguồn
- Tên gốc: Mời xem "AI Lab" của mình: 1x NVIDIA RTX Pro 5000 72GB, 2x Pro 4500, 2x Mac Studio
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=hcdEbk4461M youtube.com
- Kênh YouTube Duy Luân Dễ Thương (Duy Luân): youtube.com/channel/UCQ0jSGgYMLmRMeTE6UaPPXg youtube.com
- NVIDIA RTX PRO 5000 Blackwell, trang sản phẩm ghi bản 72 GB GDDR7 with ECC (đọc ngày 15/11/2026): nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-5000 nvidia.com
- Sonnet RackMac Studio, trang sản phẩm mô tả một rack 3U chứa một hoặc hai Mac Studio, có nút nguồn riêng ở mặt trước (đọc ngày 15/11/2026): sonnettech.com/product/rackmac-studio sonnettech.com
- vLLM, thư viện cho LLM inference và serving (theo tài liệu, đọc ngày 15/11/2026): docs.vllm.ai docs.vllm.ai
- MLX, array framework cho machine learning trên Apple silicon (theo mô tả repo, đọc ngày 15/11/2026): github.com/ml-explore/mlx github.com
- Whisper Large V3 Turbo, trang model trên Hugging Face (đọc ngày 15/11/2026): huggingface.co/openai/whisper-large-v3-turbo huggingface.co
- NVIDIA Isaac Sim, robotics simulation (đọc ngày 15/11/2026): developer.nvidia.com/isaac/sim developer.nvidia.com
Related talks
Jev giúp Claude Code nhanh và rẻ hơn thế nào
Jay Enriquez · Jay E | RoboNuggets · 12 min
Jev, System 1 model chỉ trả lời đúng/sai, chọn mục hoặc chấm điểm, ghép với Claude để chọn model, chọn skill, phân loại hàng loạt và tìm ảnh theo nghĩa.
Microsoft đưa agent OpenClaw vào công ty bạn: năm thói quen để dùng tốt
Nate B Jones · AI News & Strategy Daily | Nate B Jones · 26 min
Theo video đăng ngày 02/10/2026, Copilot Autopilot đưa agent nền OpenClaw vào Outlook, Teams, Excel; Nate nêu năm thói quen để lấy việc thật từ AI công ty cho phép.
Jev từ A đến Z: mô hình AI không sinh text
Việt Nguyễn · Việt Nguyễn AI · 47 min
Jev của TypeSafe AI là gì, ba kiểu câu hỏi Noul, Choice, Score, vì sao nhanh và rẻ, con số calibrate, điểm yếu, và demo Python phân loại tin nhắn lừa đảo.