Chạy LLM local và agent trên AI workstation riêng
Krish Naik chạy LLM local bằng Ollama trên GPU 16 GB, so một research agent local với GPT-5 về thời gian, tool call, chi phí, và demo Zenni Claw.
✓ Đã duyệt độc lập · cập nhật 16/11/2026 · 22 min
1. Vì sao dựng một AI workstation riêng
Krish Naik chào mọi người và nói hôm nay anh có một thứ rất thú vị muốn cho xem: anh đã tự build một AI workstation cho mình. Anh nói rõ đây không phải thêm một chiếc PC chơi game mạnh nữa. Anh muốn có một cái máy mà trên đó anh có thể chạy large language model (LLM), build AI agent và thử nghiệm AI inference ngay trên phần cứng của chính mình (video đăng ngày 13/11/2026).
Anh đoán người xem sẽ hỏi: tại sao phải tự build workstation khi mình đã có API key của OpenAI, Claude hay Gemini? Theo anh, ngày nay ta đã có chatbot, ứng dụng RAG, coding assistant và hệ thống multi-agent. Nhưng càng build nhiều AI agent, hạ tầng inference lại càng trở nên quan trọng (theo Krish Naik, video đăng ngày 13/11/2026).
Anh nhờ người xem hình dung một agent chạy suốt cả ngày: đọc tài liệu, dùng tool, tạo báo cáo và trao đổi với các agent khác. Mỗi request tới một cloud API trả phí đều có thể tiêu tốn token, và khi có rất, rất nhiều agent thì chi phí này cứ thế cộng dồn lên (theo Krish Naik, video đăng ngày 13/11/2026).
Từ đó anh đặt hai câu hỏi. Sẽ thế nào nếu anh chạy được một số workload này ngay trên máy, không phải trả phí inference theo từng token trên cloud? Và sẽ thế nào nếu anh kết hợp được AI chạy local với AI trên cloud bất cứ khi nào cần (video đăng ngày 13/11/2026)?
Anh nói hôm nay anh sẽ cho xem chiếc workstation ASUS, mà anh và nhóm cũng gọi là ASUS agent computer: giải thích các linh kiện, chạy một LLM ngay trên máy bằng Ollama, và build một ứng dụng multi-AI agent end-to-end. Anh sẽ cho xem hiệu năng khi dùng LLM local, rồi cho xem nếu dùng một dịch vụ cloud thì chi phí token phát sinh là bao nhiêu, và so sánh hai bên. Cuối cùng anh sẽ demo ASUS Zenni Claw, một sản phẩm mà theo anh sẽ giúp build một số agentic workflow và cũng rất dễ dùng (theo Krish Naik, video đăng ngày 13/11/2026).
2. Phần cứng của bản build
Sang phần cứng, anh nói bản build này dùng card đồ họa GeForce RTX 5070 Ti dòng ROG Strix của ASUS, với 16 GB bộ nhớ GDDR7. Anh và nhóm sẽ dùng khả năng tăng tốc bằng GPU của card này cho những workload inference chạy local tương thích (video đăng ngày 13/11/2026).
Anh kể thêm các linh kiện còn lại của bản build: mainboard ROG Maximus Z890 Hero, bộ nguồn ASUS TUF Gaming 1000P và bộ tản nhiệt nước ROG Strix LC III 360 ARGB cho CPU (video đăng ngày 13/11/2026). Rồi anh chuyển sang xem chiếc máy thật sự làm được gì.
Anh nói phần tiếp theo sẽ cho thấy cách "chơi" với các LLM local, build một số project multi-AI agent, và so sánh ngay trên chiếc AI workstation mới này (video đăng ngày 13/11/2026).
3. Cài Ollama và menu lệnh ollama
Đầu tiên anh mở Chrome. Anh nói sẽ dùng Ollama để cài các LLM local, và sẽ chọn nhiều model khác nhau như Llama 3.2 hay các model Qwen 3.5. Anh đã cài sẵn rồi, nhưng nếu ai quan tâm thì việc đầu tiên là bấm Get started trên trang Ollama. Có thể tạo tài khoản nếu muốn, hoặc vào thẳng phần tài liệu để làm theo hướng dẫn cài đặt (demo trong video đăng ngày 13/11/2026).
Trong trang Quickstart, anh chỉ ra là có thể tải Ollama về, hoặc kết nối với ứng dụng desktop. Trang tài liệu anh mở ghi hai lựa chọn Claude Desktop và ChatGPT Desktop (demo trong video đăng ngày 13/11/2026; trang Quickstart của Ollama, đọc ngày 16/11/2026).
Anh đã cài xong rồi. Anh mở command prompt và gõ lệnh ollama. Theo anh, sau khi cài xong và gõ lệnh này, bạn sẽ thấy một menu có mục "Chat with a model". Model mặc định anh đặt là Qwen 3.5 bản 4 tỷ tham số, và anh sẽ chat thử với model này (demo trong video đăng ngày 13/11/2026).
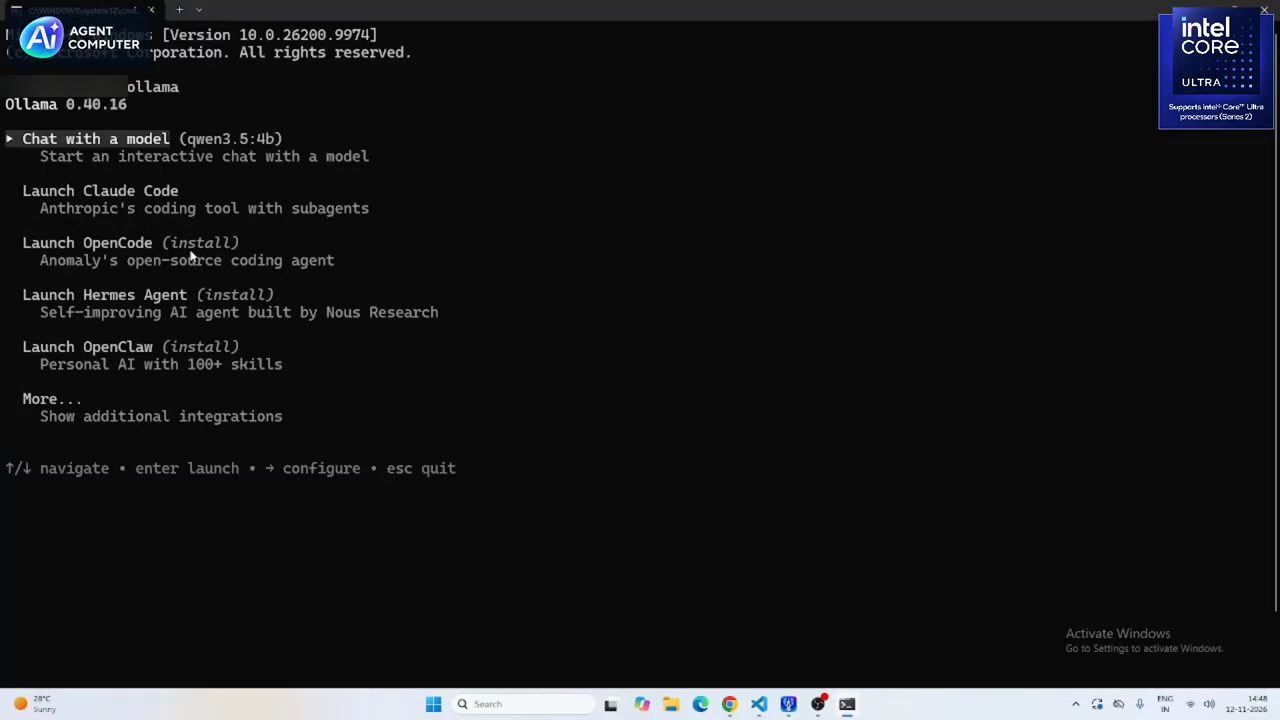
ollama (phiên bản 0.40.16 trên màn hình): mục Chat with a model đang trỏ tới qwen3.5:4b, bên dưới là các mục Launch Claude Code, Launch OpenCode, Launch Hermes Agent và Launch OpenClaw (demo trong video đăng ngày 13/11/2026).Anh nói thêm: project mà anh và nhóm đã tạo sẵn cũng dùng Claude Code cùng với Qwen 3.5 bản 4 tỷ tham số. Phần so sánh với project đó sẽ làm ở giai đoạn sau (video đăng ngày 13/11/2026).
4. Chat với Qwen 3.5 bản 4B, một reasoning model
Để cho thấy hiệu năng trước, anh chat với LLM local là Qwen 3.5 bản 4 tỷ tham số. Anh nói đây là một reasoning model. Anh gõ "hi" và bảo người xem để ý câu trả lời ra nhanh thế nào (demo trong video đăng ngày 13/11/2026).
Anh định hỏi tiếp "tell me what all things you can do" thì nói "oops", xin một giây, rồi mở lại command prompt, gõ lại lệnh ollama, vào lại mục chat với model, và nói có thể gõ clear (demo trong video đăng ngày 13/11/2026).
Làm lại từ đầu, anh giải thích: gõ ollama thì bạn sẽ được đưa ra nhiều lựa chọn, như chat với một model. Anh đã cài nhiều model local: Qwen 3.5 bản 4B, Llama 3.2, và cả các model Gemma 4. Project anh và nhóm build thì dùng Claude Code với một model local là Qwen 3.5 (video đăng ngày 13/11/2026).
Anh gõ "hi" lần nữa. Model hiện quá trình reasoning rồi trả lời, và anh lại nhấn mạnh tốc độ. Sau đó anh hỏi model nó làm được những gì. Câu anh gõ trên màn hình là "tellme what all things u cvan actually do". Model bắt đầu phần "Thinking..." bằng những dòng như "the user is asking what I can actually do. Let me start by recalling my capabilities as Qwen3.5", rồi đưa ra danh sách khả năng (demo trong video đăng ngày 13/11/2026).
Anh bảo người xem nhìn xem phần reasoning được làm xong nhanh thế nào và câu trả lời nhận được ra sao, rồi kết luận: "This is good enough" (demo trong video đăng ngày 13/11/2026).
5. Llama 3.2 viết code game Tetris
Nếu muốn dùng thêm model khác, theo anh, chỉ cần quay lại trang Ollama, bấm vào Models và chọn model bạn muốn. Anh chọn Llama 3.2, và trên trang model có sẵn lệnh để chạy (demo trong video đăng ngày 13/11/2026):
ollama run llama3.2
Anh mở thêm một command prompt nữa và dán lệnh này vào. Anh nói anh đã cài model này sẵn, vì việc tải về sẽ mất một khoảng thời gian tùy vào tốc độ mạng, nên để mọi thứ nhanh hơn anh đã làm trước (video đăng ngày 13/11/2026).
Anh gõ "hi", model hỏi lại có thể giúp gì. Rồi anh gõ: "Write me Python code to play Tetris game". Model bắt đầu viết code Python dùng pygame: định nghĩa màu, kích thước ô, lề, lưới, cửa sổ, font cho điểm số và class Shape. Anh bảo người xem nhìn tốc độ, và nhấn mạnh mọi thứ đều đang chạy local: LLM này chạy ngay trên máy (demo trong video đăng ngày 13/11/2026).
6. GPU, VRAM và nvidia-smi
Anh mở Task Manager, sang tab Performance, để người xem thấy GPU đang được dùng bao nhiêu và bộ nhớ đang được dùng bao nhiêu (demo trong video đăng ngày 13/11/2026).
Rồi anh quay lại command prompt và gõ nvidia-smi để xem máy đang dùng GPU nào. Anh chỉ ra card NVIDIA GeForce RTX 5070 Ti và nói card này có 16 GB VRAM (video đăng ngày 13/11/2026).
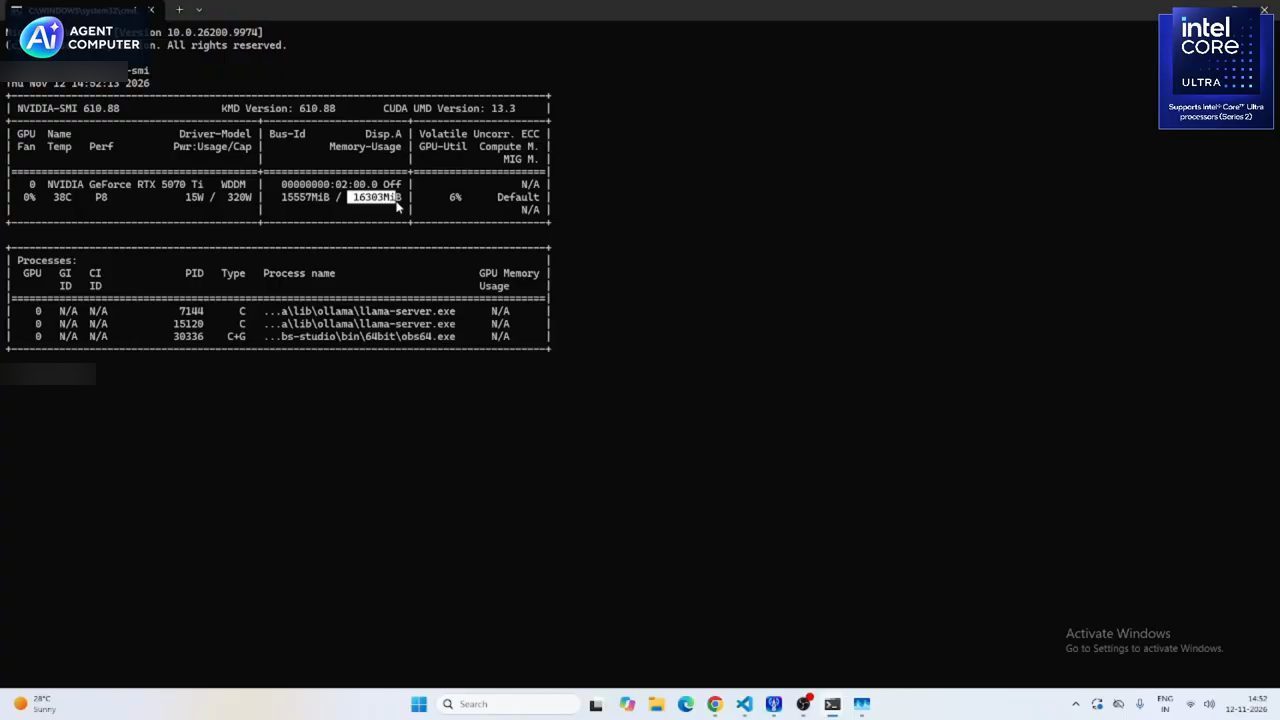
nvidia-smi lúc demo: card NVIDIA GeForce RTX 5070 Ti, cột Memory-Usage ghi 15557MiB / 16303MiB (anh bôi đậm con số tổng 16303MiB), GPU-Util 6%, và danh sách tiến trình có hai tiến trình llama-server.exe của Ollama (demo trong video đăng ngày 13/11/2026).Tiếp theo, anh nói sẽ chạy một ứng dụng agentic AI và so sánh giữa một LLM local với các model LLM của OpenAI (video đăng ngày 13/11/2026).
7. Project research agent dựng bằng Claude Code
Anh đã tạo sẵn project cho việc này, và nói anh dùng Claude Code với LLM local để làm. Trong project có một file research agent (trên màn hình là researchagent.py): đây là research agent của anh, có thể làm nhiều tác vụ khác nhau. Trong file có viết sẵn một số chỉ dẫn ở phần system prompt (video đăng ngày 13/11/2026).
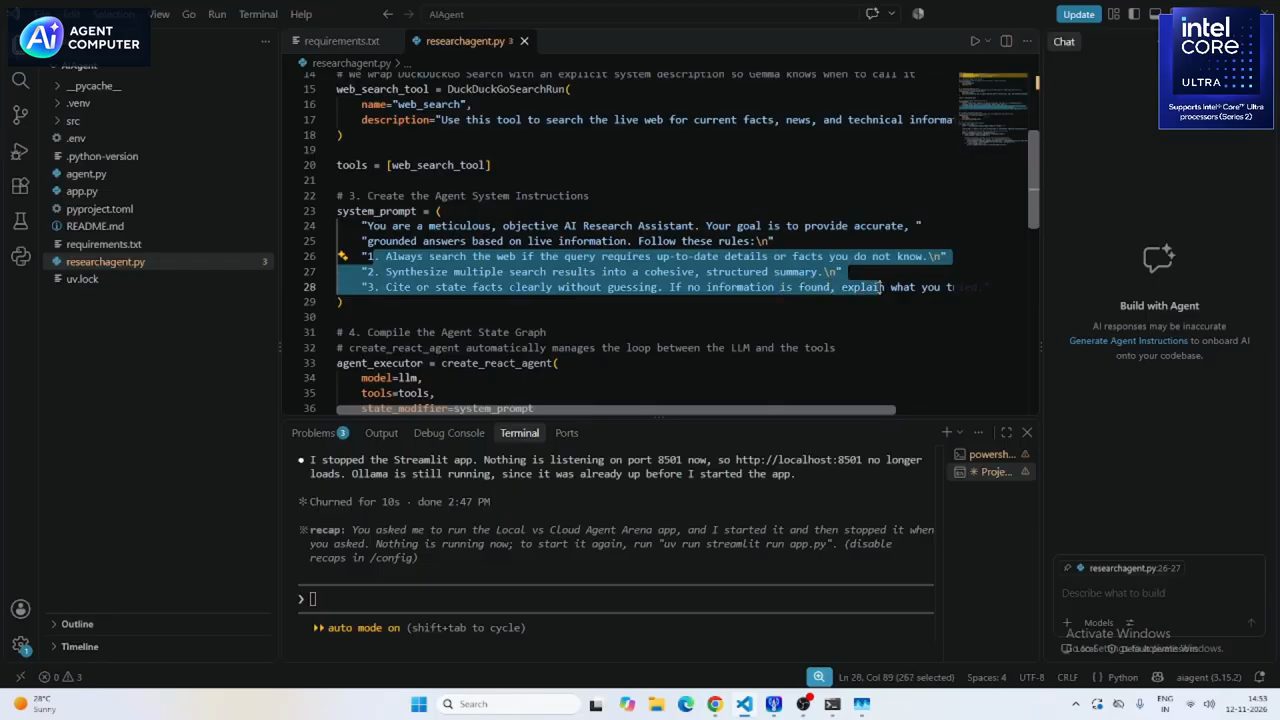
researchagent.py trong VS Code: một web_search tool dựa trên DuckDuckGoSearchRun, phần system prompt được bôi chọn, và create_react_agent lo vòng lặp giữa LLM và tool. Panel terminal bên dưới là phiên Claude Code của anh (demo trong video đăng ngày 13/11/2026).Một đoạn của system prompt trên màn hình, dòng cuối còn chạy tiếp ra ngoài khung hình (demo trong video đăng ngày 13/11/2026):
"You are a meticulous, objective AI Research Assistant. Your goal is to provide accurate, "
"grounded answers based on live information. Follow these rules:\n"
"1. Always search the web if the query requires up-to-date details or facts you do not know.\n"
"2. Synthesize multiple search results into a cohesive, structured summary.\n"
"3. Cite or state facts clearly without guessing. If no information is found, explain what you
Project này cũng có một Streamlit app, với code trong app.py và agent.py để làm các tác vụ khác nhau. Anh nhắc lại mục tiêu chính: so sánh LLM local với OpenAI (video đăng ngày 13/11/2026).
Anh bảo Claude Code chạy Streamlit app. Claude Code chạy nhanh lệnh dưới đây, trả về một URL, và anh mở URL đó trong trình duyệt (demo trong video đăng ngày 13/11/2026):
uv run streamlit run app.py
8. Local vs Cloud Agent Arena: chọn model
Ứng dụng hiện ra với tiêu đề "Local vs Cloud Agent Arena". Anh chỉ vào ô Ollama URL và nói ô này cho biết Ollama đang chạy. Anh đã cài nhiều model local như Llama 3.2 và Gemma 4 (demo trong video đăng ngày 13/11/2026).
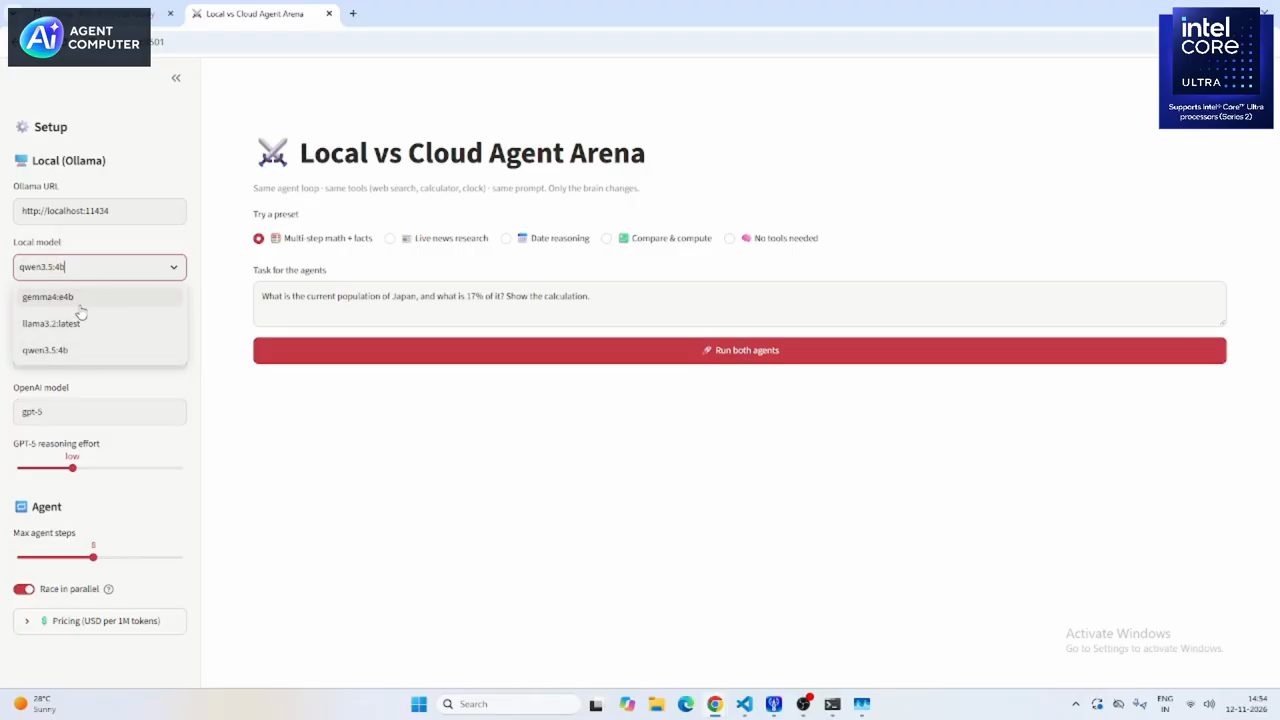
Anh nói anh chọn các model nhỏ: model này là 4 tỷ tham số; Llama 3.2 latest, theo lời anh, là 2 tỷ tham số; còn Qwen 3.5 là 4 tỷ tham số. Bạn có thể cân nhắc lấy các model rất lớn, nhưng model cỡ 60 GB, 70 GB sẽ không vừa, vì GPU của bạn chỉ có 16 GB (theo Krish Naik, video đăng ngày 13/11/2026).
Phía bên kia, anh so sánh với GPT-5 trong các model của OpenAI (trên màn hình, ô OpenAI model ghi gpt-5; demo trong video đăng ngày 13/11/2026).
9. Bài toán dân số Nhật Bản: thời gian, tool call và chi phí
Anh đã viết sẵn một số tác vụ, trong đó có preset Multi-step math + facts, tức một tác vụ gồm cả toán nhiều bước lẫn tra cứu sự kiện cho agent. Câu hỏi trên màn hình là (demo trong video đăng ngày 13/11/2026):
What is the current population of Japan, and what is 17% of it? Show the calculation.
Anh chạy cả hai agent: một agent dùng Qwen 3.5, agent kia dùng GPT-5 của OpenAI. Mục tiêu chính của anh là xem output và số token mỗi bên tạo ra, để từ đó quyết định chi phí. Toàn bộ báo cáo sẽ hiện ở cuối trang sau khi chạy xong (demo trong video đăng ngày 13/11/2026).
Anh chỉ vào step one, step two. Theo anh, vì cả hai đều là reasoning model nên cách tính toán và cách chúng đi tìm kiếm gần như giống nhau. Hai bên đều ra final answer về dân số hiện tại của Nhật Bản, và anh nhận xét output của hai bên xấp xỉ nhau (demo trong video đăng ngày 13/11/2026).
Anh nói "obviously" GPT-5 "far, far, far" tốt hơn Qwen 3.5 bản 4 tỷ tham số. Nhưng ở đây, bên local xong trong 17 giây với hai tool call, còn bên kia dùng bốn tool call, và câu trả lời hai bên nhận được gần như bằng nhau (theo số đo của Krish Naik, video đăng ngày 13/11/2026).
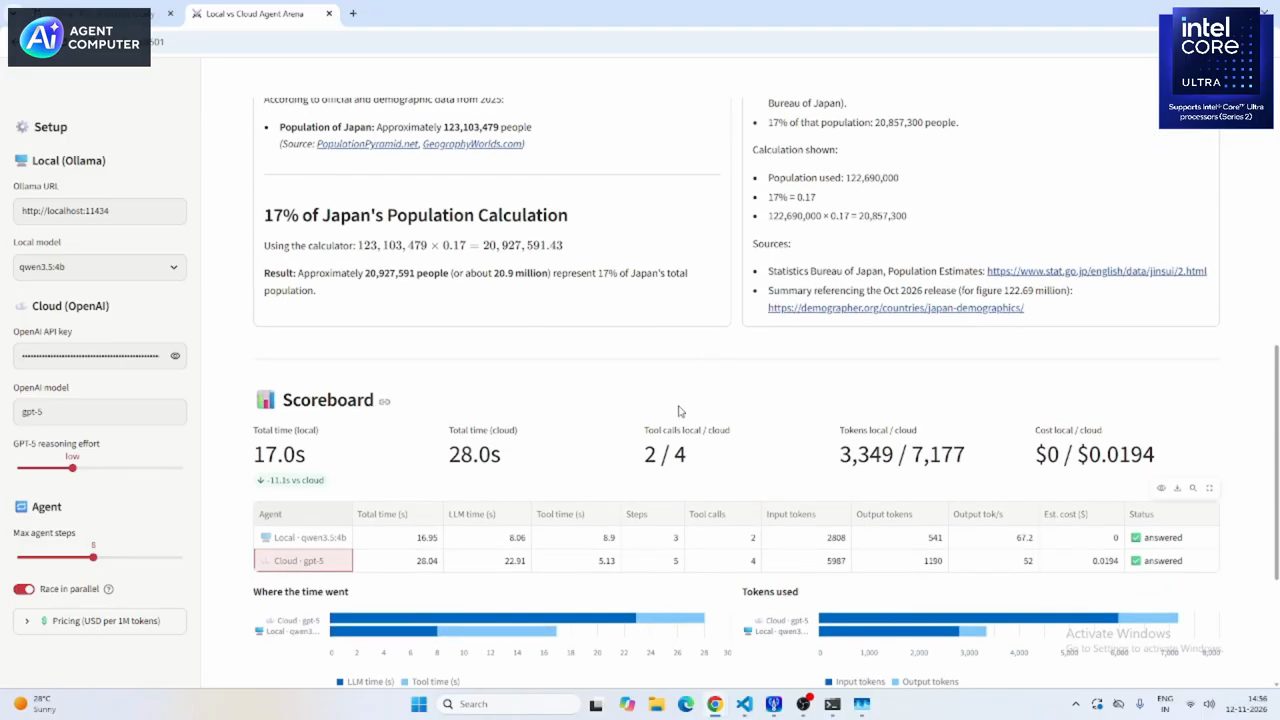
Scoreboard là phần anh thật sự tập trung vào. Cả Qwen 3.5 local lẫn bên cloud đều trả lời được, nhưng chi phí ước tính cho GPT-5 là 0.0194, còn bên local gần như bằng không. Tóm lại, bên này mất khoảng 17 giây, bên kia mất khoảng 28 giây (theo số đo của Krish Naik, video đăng ngày 13/11/2026).
Anh nói anh không bảo rằng GPT-5 rất, rất tốt khi so với Qwen 3.5, cũng không bảo Qwen 3.5 rất, rất tốt khi so với GPT-5. Anh nói tiếp: nếu bạn làm những tác vụ hằng ngày, chẳng hạn phân tích báo cáo, hay muốn một AI assistant chạy ngay trên phần cứng của mình, trên compute của mình, thì lúc đó bạn có thể dùng kiểu AI workstation này, chiếc ASUS agent computer này, cho những việc như vậy (theo Krish Naik, video đăng ngày 13/11/2026).
10. Live news research và giới hạn số bước
Anh thử thêm một loại tác vụ nữa mà anh đã tạo, gọi là live news research. Lúc đọc câu hỏi, anh lỡ nói "with line of code" rồi sửa lại ngay: "one line with a source". Câu hỏi trên màn hình là (demo trong video đăng ngày 13/11/2026):
What are the 3 most important AI announcements from the past week? Summarise each in one line with a source.
Anh nói bên này cũng chạy rất nhanh: trong vòng 11,5 giây đã tới step four. Anh chỉ tiếp sang "step three", và nói cả hai đều là reasoning model (theo số đo của Krish Naik, video đăng ngày 13/11/2026).
Anh giải thích anh và nhóm có đặt một bộ hẹn giờ, nên đôi khi tác vụ có thể fail nếu trong khoảng thời gian đó mọi thứ chưa chạy xong. Nhưng lần này bên local chạy xong: anh đọc "28, 9, 29.8 seconds", năm tool call đã được thực thi, và kết quả đã hiện ra (demo trong video đăng ngày 13/11/2026).
Bên kia vẫn đang chạy. Theo anh, điều đó có nghĩa là nó vẫn đang reasoning, vì đó là một model cao cấp, cho tới khi nó có được câu trả lời hoàn hảo. Anh chỉ vào step seven với kết quả web search về tuần vừa qua, rồi step eight, và nói: nhiều reasoning quá, có thể là reasoning tốt hơn, nhưng với kiểu tác vụ này thì... (demo trong video đăng ngày 13/11/2026).
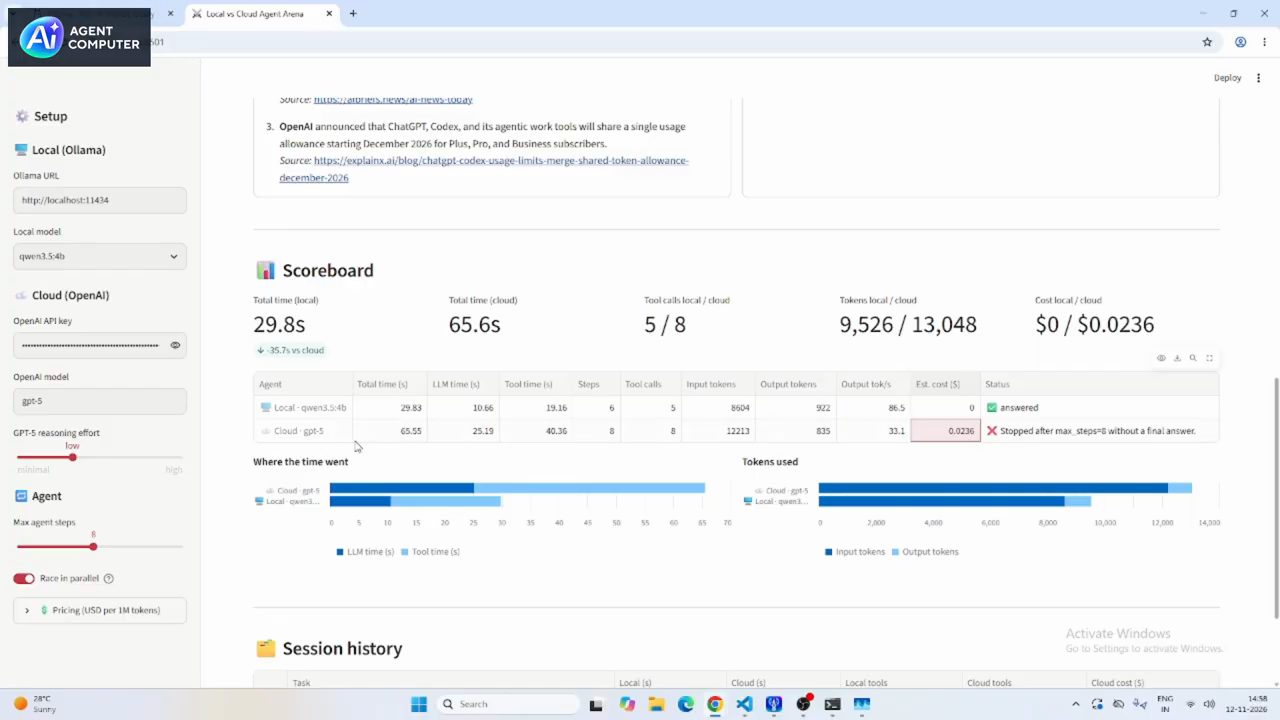
Rồi bên cloud fail. Anh nói nó fail vì anh đã đặt giới hạn thời gian; trạng thái trên màn hình thì ghi bên cloud dừng lại sau max_steps=8 mà chưa có câu trả lời cuối. Với bên local, anh đọc thời gian là 29,83 giây cho tác vụ này (demo trong video đăng ngày 13/11/2026).
Chi phí ước tính, theo anh, vào khoảng 0.023 với GPT-5 của OpenAI chạy trên cloud (Scoreboard ghi $0.0236), còn với Qwen 3.5 local thì chi phí bằng không. Anh nói rõ tất nhiên vẫn cần điện để chạy AI workstation. Nhưng anh cảm thấy với phần lớn những tác vụ tương tự, bạn có thể làm theo cách dễ hơn nhiều (theo Krish Naik, video đăng ngày 13/11/2026).
11. Compare & compute, và giới hạn của 16 GB VRAM
Anh mời người xem tự thử, chẳng hạn với date reasoning. Rồi anh chọn preset Compare & compute, đọc câu hỏi về vốn hóa thị trường của Nvidia, cái nào lớn hơn và lớn hơn bao nhiêu phần trăm, và cho chạy tác vụ này để xem output ra sao. Câu hỏi trên màn hình là (demo trong video đăng ngày 13/11/2026):
Find the current market cap of Nvidia and Microsoft. Which is larger and by what percentage?
Trong lúc chờ, anh tóm lại hai điều quan trọng đã bàn. Thứ nhất, anh và nhóm đã test các LLM local, tải về vài model tốt cỡ 4 tỷ tới 2 tỷ tham số. Anh cũng đã thử thêm một model 12 tỷ tham số, và model đó chạy "seamlessly well" (theo Krish Naik, video đăng ngày 13/11/2026).
Nhưng máy chỉ có 16 GB VRAM, nên anh nói phải giới hạn ở một mức số tỷ tham số nhất định, và không nên vượt quá mức đó. Dù vậy, với phần lớn những tác vụ anh và nhóm thực sự muốn làm, việc này là khả thi (theo Krish Naik, video đăng ngày 13/11/2026).
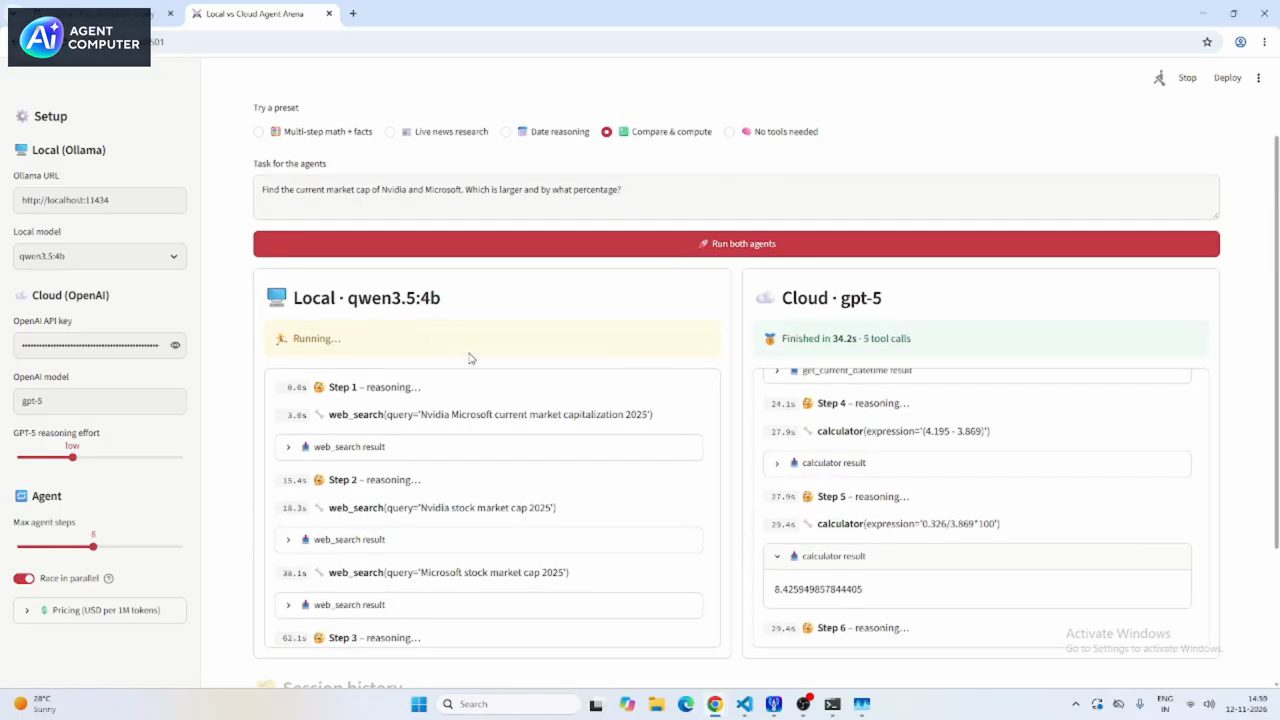
Anh chỉ vào màn hình và nói mọi thứ agent đang làm đều hiện ra, phần này cũng đang chạy, "absolutely fine". Theo anh, điều này cho bạn một ý niệm rõ ràng về cách chiếc AI workstation này đang hoạt động, với những model ít tỷ tham số mà bạn có thể chạy dễ dàng trên máy của mình (theo Krish Naik, video đăng ngày 13/11/2026).
Anh hy vọng người xem đã hiểu cách chạy LLM local, và anh đã cho một so sánh nhanh để thấy mọi thứ diễn ra thế nào khi chạy bằng LLM local và khi chạy trên cloud. Anh nói trong trường hợp này GPT-5 mất khoảng 34,2 giây, rồi nói "nó" vẫn đang chạy và anh nghĩ có lẽ sẽ fail vì anh đã đặt giới hạn. Trên màn hình lúc đó, bên local qwen3.5:4b vẫn ghi "Running..." (demo trong video đăng ngày 13/11/2026). Anh chuyển sang phần tiếp theo.
12. ASUS Zenni Claw: model local và thêm provider
Phần cuối là ASUS Zenni Claw. Anh nói mỗi ngày bạn đều làm một số việc nhất định, và có thể biến những việc hằng ngày đó thành các AI workflow có hướng dẫn. Theo lời anh, Zenni Claw là một cách đơn giản hơn để khám phá agentic AI, với các skill thiết yếu cho công việc, du lịch và lên kế hoạch hằng ngày, trong khi người dùng vẫn kiểm soát từng bước (theo Krish Naik, video đăng ngày 13/11/2026).
Anh đã tải ứng dụng về; khi mở, ứng dụng sẽ hướng dẫn cài đặt. Trong ứng dụng, bạn thấy được những LLM model nào đã cài trên máy, như Gemma 4 và các model khác (demo trong video đăng ngày 13/11/2026).
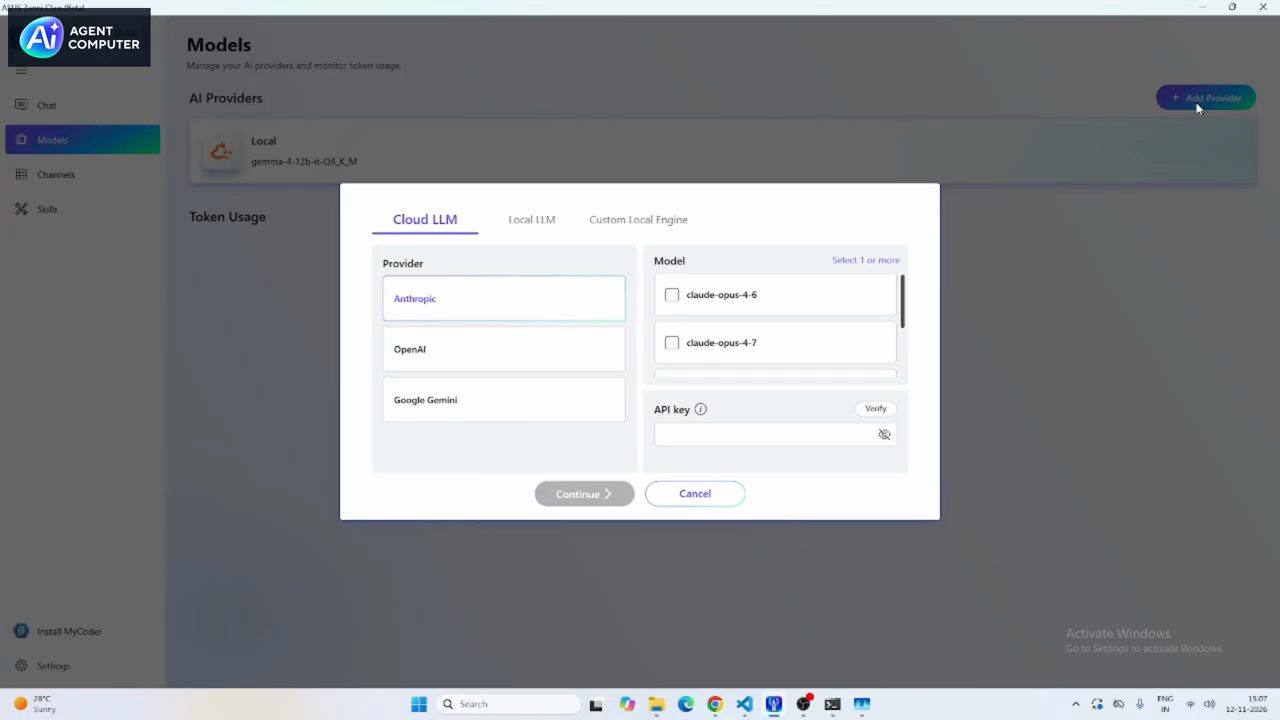
Nếu muốn thêm provider khác, như các model Claude của Anthropic, theo anh bạn có thể làm, chỉ cần cung cấp API key, giống cách mọi người dùng OpenClaw. Anh nói công cụ này làm rất tốt vai trò của nó trong nhiều tác vụ mà ta làm hằng ngày (theo Krish Naik, video đăng ngày 13/11/2026).
13. Work assistant: một bản tin tổng hợp về AI
Anh muốn tạo một kiểu work assistant. Lúc đầu anh đưa một câu kiểu tổng hợp một bản tin ngành về AI và phát triển media cùng các tin khác; rồi anh sửa lại cho gọn, và bấm generate. Câu trên màn hình là (demo trong video đăng ngày 13/11/2026):
Compile an industry news digest about AI
Assistant bắt đầu làm việc. Model anh dùng ở đây là Gemma 4. Theo anh, dựa trên đó nó tự tạo một agentic workflow bên trong, rồi thực thi theo workflow đó để làm ra cả bản tin tổng hợp (theo Krish Naik, demo trong video đăng ngày 13/11/2026).
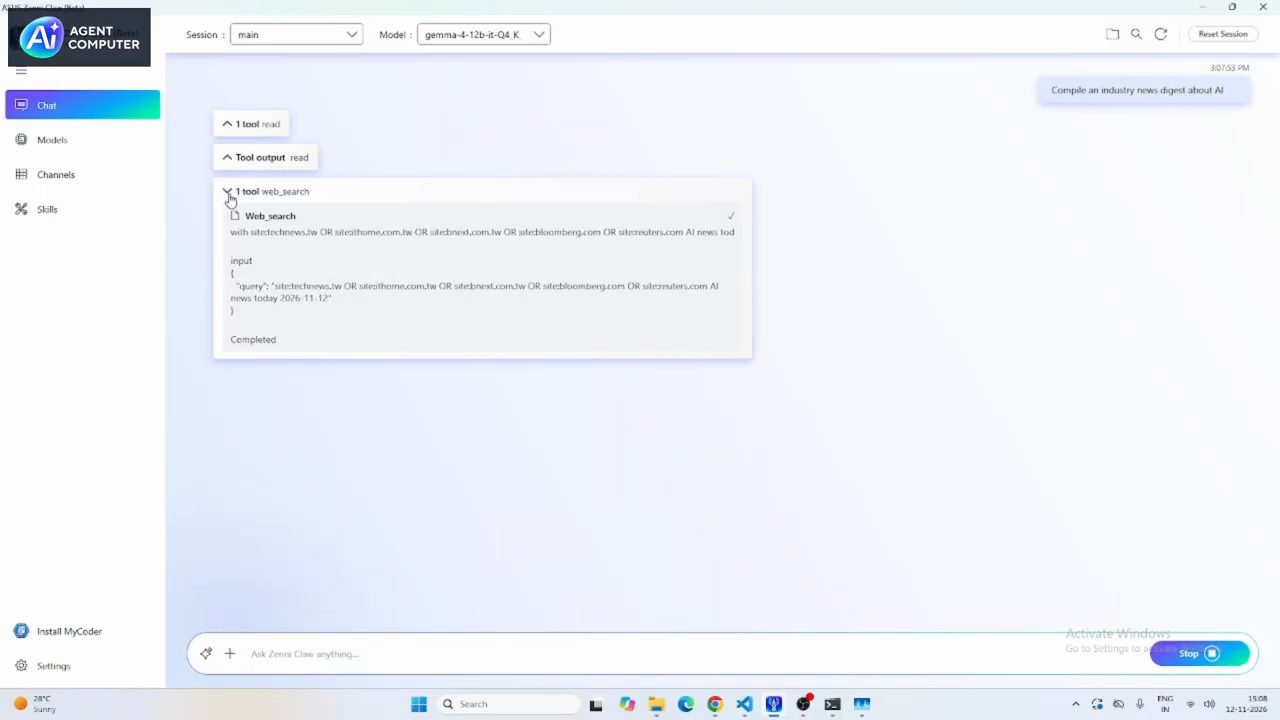
Anh chỉ vào từng bước: một tool read, một tool output, một tool web search, và phần tool output hiện rõ ràng. Anh nói ở bên trong nó đang dùng một dạng OpenClaw. Bước tiếp theo sau web search thì gặp một tool error. Anh nói không sao, nó sẽ thử lại (demo trong video đăng ngày 13/11/2026).
Và assistant đưa ra output: các tin nổi bật trong ngày cùng toàn bộ thông tin, hiện hết ra cho người dùng xem. Theo anh, bất kỳ tác vụ nào bạn muốn làm, bạn đều có thể làm ở đây (theo Krish Naik, demo trong video đăng ngày 13/11/2026).
14. Prompt library và một slide deck về agentic AI
Để làm thêm việc, anh bấm dấu cộng. Theo anh, ở đó bạn cũng có thể đưa file vào, và có một loạt mẫu để dùng: slide generator, work assistant, industry news digest, meeting actions, flight monitor, trip itinerary planner, local deep experiences, auto subtitle generator, bất cứ thứ gì bạn muốn (demo trong video đăng ngày 13/11/2026).
Anh chọn slide generator để làm một deck về agentic AI systems. Anh nói đây là một trong những việc nhiều người làm ở văn phòng, và công cụ này có sẵn cùng với chiếc workstation ASUS (theo Krish Naik, video đăng ngày 13/11/2026).
Sau khi anh đưa chỉ dẫn, assistant chạy tool read, nhận tool output, và gọi skill tạo file PowerPoint. Trên màn hình, đó là "PPTX Generation Skill", đọc từ một file SKILL.md trong thư mục skill của OpenClaw (demo trong video đăng ngày 13/11/2026).
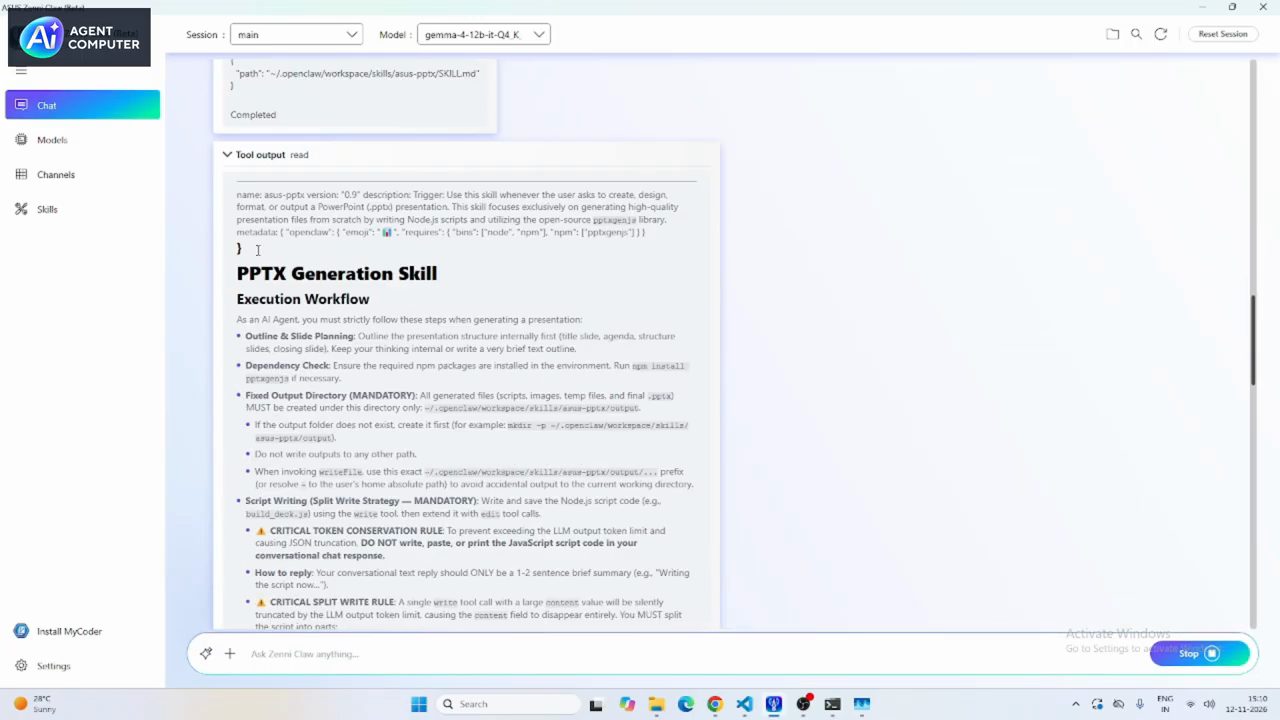
Tool output tiếp theo là bước cài package. Anh đọc là "adding all the nine packages", còn trên màn hình ghi "added 19 packages in 1s". Anh nói tất cả những việc này đều đang chạy với LLM local. Nếu muốn dùng LLM bên ngoài, anh nhắc lại là bạn chỉ cần thêm model cần dùng như anh đã chỉ ở trên (demo trong video đăng ngày 13/11/2026).
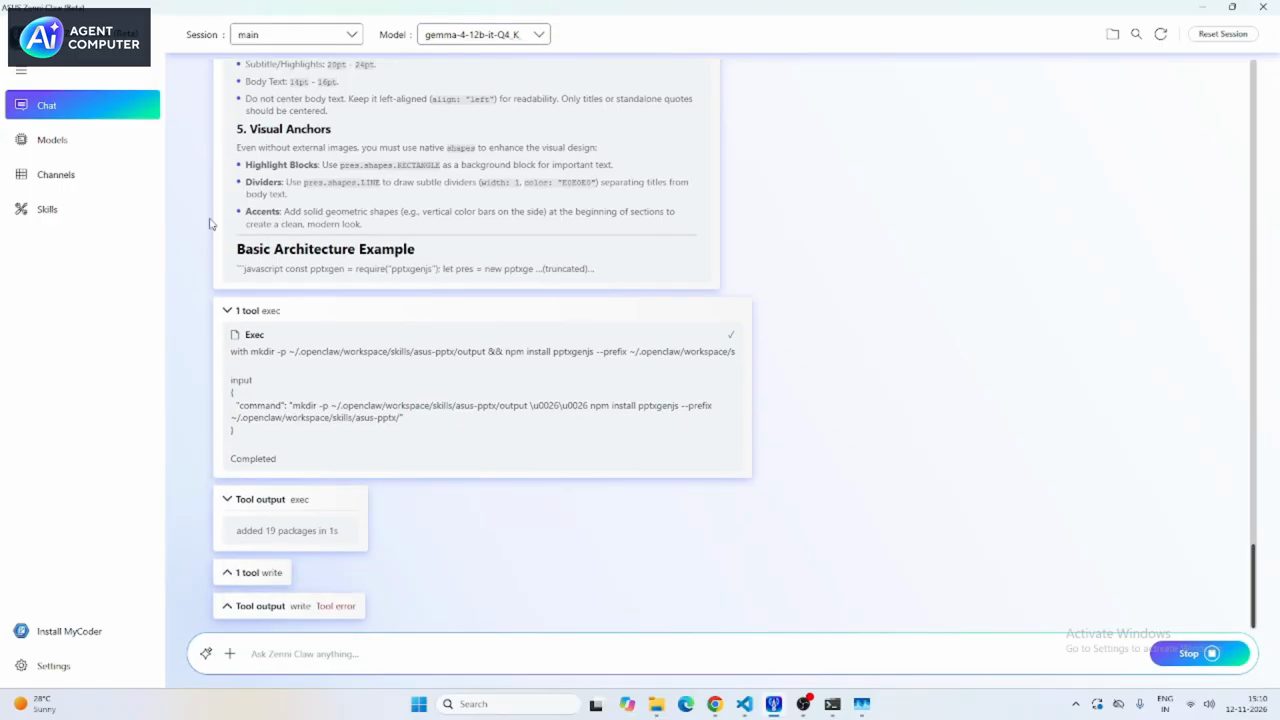
mkdir -p thư mục output rồi npm install pptxgenjs, tool output ghi "added 19 packages in 1s"; ngay sau đó bước write báo "Tool error" (demo trong video đăng ngày 13/11/2026).Anh gặp một lỗi, nhưng nói không sao, vì nó sẽ tự sửa cả những lỗi đó, liên quan tới các package đã cài, và sẽ ra được output (theo Krish Naik, demo trong video đăng ngày 13/11/2026).
Tóm lại, theo anh, bạn làm được nhiều tác vụ khác nhau, giống như những agentic workflow hằng ngày bạn vẫn dùng, nhưng chạy cùng LLM local, và điều đó mang lại nhiều lợi thế (theo Krish Naik, video đăng ngày 13/11/2026).
15. Bài học chính: local, cloud hay hybrid
Bài học lớn nhất mà anh rút ra: AI đang tiến hóa từ machine learning và các ứng dụng LLM sang những hệ thống có thể lên kế hoạch, dùng tool và thực thi workflow. Khi các hệ thống này ngày càng tinh vi, hạ tầng phía sau chúng càng quan trọng hơn (theo Krish Naik, video đăng ngày 13/11/2026).
Với chiếc ASUS agent computer này, anh và nhóm đã thử chạy một LLM local được hỗ trợ, và thấy vì sao bộ nhớ GPU, các thông số inference và hiệu năng lại quan trọng. Với Zenni Claw, anh và nhóm cũng đã thấy agentic workflow có thể trở nên dễ tiếp cận hơn cho các tác vụ năng suất hằng ngày (theo Krish Naik, video đăng ngày 13/11/2026).
Theo anh, tương lai không đơn giản là cloud đối đầu local. Có lúc cloud là lựa chọn đúng, có lúc local cũng đúng, và có lúc hybrid cho bạn sự cân bằng tốt nhất (theo Krish Naik, video đăng ngày 13/11/2026).
Anh cảm ơn mọi người đã xem và chúc "Happy learning".
Nguồn và liên kết 8 nguồn
- Tên gốc: My ASUS AI Agent Computer: Local LLMs, Coding & Agent Demos
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=HCJvnek8zZM youtube.com
- Kênh YouTube Krish Naik (Krish Naik): youtube.com/channel/UCNU_lfiiWBdtULKOw6X0Dig youtube.com
- Ollama, công cụ anh dùng để chạy LLM local: ollama.com ollama.com
- Trang Quickstart trong tài liệu Ollama (đọc ngày 16/11/2026): docs.ollama.com/quickstart docs.ollama.com
- Trang model Llama 3.2 trên Ollama: ollama.com/library/llama3.2 ollama.com
- Trang model Qwen 3.5 trên Ollama: ollama.com/library/qwen3.5 ollama.com
Related talks
Model Hardware Standard: AI giúp chạy thí nghiệm khoa học vật lý
Alek Kemeny, Arco Bast, Gagan Bhat, Margaret Porter Scott & Anupriya Tripathi · Anthropic · 11 min
Câu chuyện Model Hardware Standard: Claude điều khiển kính hiển vi, cánh tay robot và thí nghiệm ở Janelia, Danaher, Genentech (video 27/08/2026).
Nối ChatGPT Codex với Power BI qua MCP server
Pankaj Namekar · Data With Pankaj · 26 min
Cài Power BI Modeling MCP Server, nối Codex với Power BI Desktop, rồi tạo bảng ngày, relationship, DAX KPI, insight và bố cục report bằng prompt.
Claude Code Projects mới: một agent điều phối, nhiều thread
Riley Brown · Riley Brown · 24 min
Riley Brown demo Claude Code Projects: agent chính giao việc cho các thread, theo dõi token, design mode, artifact, dùng trên iPhone và bảy điều cần biết.