Theo về Fable 5.2: vì sao không ai cạnh tranh nổi với Anthropic
Theo Browne đánh giá Fable 5.2 ngày đầu: benchmark, chi phí theo effort, hạn mức gói $200, các eval trên code base thật và vì sao Opus 5.5 vẫn là daily driver (11/2026).
✓ Đã duyệt độc lập · cập nhật 15/11/2026 · 48 min
1. Fable 5.2 chứ không phải 5.5
Theo mở đầu bằng câu anh đã chờ bản phát hành này quá lâu và không thể hào hứng hơn. Sau Opus 5.5, Sonnet 5.5 và Haiku 5.5, anh nói có vẻ dòng 5.5 không gì cản nổi, nên ai cũng hào hứng với bản phát hành hôm nay. Rồi anh đọc tên: Fable và Mythos 5.2. Anh ngạc nhiên: tưởng mọi người đang chờ 5.5, sao lại đi lùi. Anh nói đây sẽ là một video phức tạp hơn anh mong (video đăng ngày 10/11/2026).
Anh nhắc rằng anh là fan lớn của Fable 5, và còn hơn thế với Fable 5.1. Theo anh, có lúc tưởng như chỉ mình anh nhận ra Fable 5.1 là một model rất tốt. Rồi Opus 5.5 ra mắt và cho mọi người thấy vì sao Fable 5.1 tốt, bằng cách làm nó nhanh hơn, rẻ hơn và bớt khó chịu một chút khi nói chuyện với bạn. Anh đã rất mong thấy những cái lợi đó ở Fable 5.2, và theo anh, thực tế là mọi người đang thấy rất nhiều trong số đó (video đăng ngày 10/11/2026).
Anh kể ra: điểm state-of-the-art trên Artificial Analysis, đặt Fable 5.2 trên Gemini 4 Carbon, model cao nhất trước đó, trọn bốn rưỡi đến năm điểm; các mức high và x-high cũng ghi điểm cao hơn nhiều. Model làm CAD ở mức mà mọi người không nghĩ agent làm được. Và "bench" yêu thích mới của anh, MDash Bench, đếm số dấu gạch ngang dài (em dash) trong bài công bố: anh nói bài này đạt state-of-the-art với 29 em dash (theo video đăng ngày 10/11/2026).
Nói đùa thế thôi, anh bảo còn quá nhiều điều để nói. Anh đã cố trả lời mọi thứ mọi người hay hỏi, tới mức lúc quay đã là 1 giờ 15 sáng, vì anh muốn ra video với càng nhiều chi tiết càng tốt. Anh hứa sẽ cho xem model này giỏi nhất ở đâu, những chỗ nó làm anh bực, nó thực sự tốn bao nhiêu tiền, nó thực sự ngốn bao nhiêu hạn mức subscription (phần anh phân tích rất nhiều), và hơn thế nữa. Theo anh (video đăng ngày 10/11/2026), đây là một model đáng kinh ngạc, nhưng nên được dùng một cách có chủ đích và cẩn thận, và anh sẽ cố giải thích vì sao.
2. Bài công bố: hai cửa của một nhà hàng, giá và fast mode
Theo bắt đầu đọc bài công bố, và báo trước là trang khá sáng. Câu mở đầu nói Anthropic đã nâng cấp Fable và Mythos thành các model được thiết kế để giải quyết những thử thách kỹ thuật khó nhất. Anh lưu ý cụm "technical challenges" là một cách đóng khung rất cụ thể mà anh sẽ "đọc quá ý", giống như anh sẽ đọc quá ý chuyện số 5.2 thay vì 5.5. Bài viết nói Fable và Mythos 5.2 cải thiện ở coding, reasoning và vision (bài công bố mà anh đọc trong video đăng ngày 10/11/2026).
Theo bài công bố anh đọc (video đăng ngày 10/11/2026), trong giai đoạn thử nghiệm trước khi phát hành, các model này đã giúp kỹ sư của Anthropic hoàn thành những cuộc migration phần mềm mà nếu không có chúng thì không khả thi, thiết kế từ đầu ba thiết bị điện tử chạy được, giải hai bài toán mở trong vật lý lỗ đen, tiến bộ đáng kể trên các eval robotics, và hình thức hoá chứng minh Định lý cuối cùng của Fermat chỉ trong 30 giờ. Theo nhận xét rằng trong danh sách này chỉ có một thứ về phần mềm, là các migration "không khả thi". Anh nói anh đã làm những migration rất "không khả thi" với Opus rồi, như viết lại TypeScript bằng Rust, nên đây có thể là, mà cũng có thể không phải, một bước mở khoá mới.
Bài viết nêu một điều anh nói cần nhắc lại: Fable và Mythos là cùng một model nền. Cách anh hình dung: một nhà hàng có hai lối vào. Một lối có nhiều bảo vệ, kiểm tra bạn đúng là người được phép vào. Lối kia được canh gác nhẹ hơn nhiều, nhưng phải có quyền truy cập đặc biệt mới tới được đó. Nhà hàng bên trong như nhau, đồ ăn như nhau; chỉ khác ai được ra vào và thứ gì được mang ra vào. Có thể đi lối này thì bạn không được mang đồ ăn ra ngoài, hoặc chỉ được gọi một số món trong thực đơn. Vẫn là một nhà hàng, một toà nhà; có vài thứ bên này lấy được còn bên kia không. Theo lời anh (video đăng ngày 10/11/2026), Mythos chỉ là ít có khả năng bị một lớp bên thứ ba bao quanh chặn request hoặc response hơn.
Bài công bố viết rằng Fable có các safeguard mạnh về cybersecurity và sinh học để chống lạm dụng, nhờ đó có thể mở cho mọi người dùng. Các tổ chức theo đuổi ứng dụng có lợi trong cybersecurity hay nghiên cứu y sinh có thể xin quyền dùng Mythos qua các chương trình xác minh mở rộng cho life sciences và cyber. Theo đáp gọn: hay đấy, anh còn chẳng thuộc mấy chương trình đó (video đăng ngày 10/11/2026).
Theo bài công bố anh đọc (video đăng ngày 10/11/2026), người thử nghiệm thấy Fable 5.2 và Mythos 5.2 giao tiếp rõ ràng hơn các bản Fable và Mythos trước, và sinh output nhanh hơn tới 30% so với Claude Fable 5.1 và Mythos 5.1. Anh nói đây là một chi tiết rất thú vị mà lát nữa anh sẽ "đọc quá ý" rất nhiều. Chúng cũng rẻ hơn: $8 cho mỗi triệu token input và $40 cho mỗi triệu token output.
Fable và Mythos 5.2 có thêm một fast mode tuỳ chọn, mà Theo gọi là một thay đổi lớn: trước đây Fable và Mythos phải chạy ở tốc độ gốc, không có cách nào chạy nhanh hơn. Giờ có thể trả gấp đôi tiền để nhanh hơn 2,5 lần (theo video đăng ngày 10/11/2026; trang công bố, đọc ngày 15/11/2026, ghi fast mode giá $16 cho mỗi triệu token input và $80 cho mỗi triệu token output). Theo anh, mức này thật ra không tệ, nhất là khi fast mode thường của OpenAI tăng tốc ít hơn nhiều: phải dùng ultra fast mới có một cú tăng thật, và khi đó giá tăng điên rồ tới mức không đáng.
Bài viết có một phần về safety và alignment, và Theo nói không có gì ngạc nhiên: Anthropic rất quan tâm chuyện người khác không distill model của họ rồi dùng chúng làm việc xấu. Có một system card rất dài và chi tiết như mọi lần. Anh nói anh đã audit nhanh, thừa nhận là không sâu như thường lệ vì bản này dài 264 trang; anh sẽ tiếp tục audit sau để xem có gì lớn bị bỏ sót, còn trong video này anh muốn tổng quan chung hơn (video đăng ngày 10/11/2026).
3. Lời khuyên của Anthropic và bảng benchmark
Bài công bố có một đoạn ngắn về khi nào dùng Fable và Mythos, và anh đọc nó. Theo đoạn đó (bài công bố mà anh đọc trong video đăng ngày 10/11/2026), Fable và Mythos tốt nhất cho những việc kỹ thuật tham vọng và mở nhất. Với đa số việc coding và việc tri thức, Anthropic khuyên bắt đầu với Opus 5.5, "daily driver mạnh nhất" của họ, rồi đổi model khi cần tuỳ phạm vi và độ phức tạp: lên Fable hoặc Mythos, hay xuống Sonnet hoặc Haiku. Fable 5.2 cũng có thể đóng vai Advisor, nơi các model khác hỏi nó khi gặp bài khó, hoặc Orchestrator, nơi nó giao các việc đơn giản hơn cho model nhỏ hơn.
Theo nói anh không hoàn toàn đồng ý với lời khuyên này sau khi dùng model cả ngày, và sẽ đi sâu hơn nhiều vào chỗ nên và không nên dùng. Điều anh tuyệt đối đồng ý là ý Opus 5.5 là daily driver mạnh nhất; anh nói anh đồng ý "cực kỳ" (video đăng ngày 10/11/2026). Một điều anh rút ra từ bản phát hành này là anh trân trọng Opus 5.5 hơn, không phải vì nó thông minh hơn, mà vì mối quan hệ giữa các model này và việc nó có năng lực tới mức khó tin.
Rồi tới benchmark. Anh nói mặt anh trong khung hình sẽ che chữ Gemini 4 Carbon ở góc, mà cũng không có nhiều lý do để nhìn vào đó. Theo bảng anh đọc (bài công bố, video đăng ngày 10/11/2026), Fable đạt điểm cao nhất ở agentic coding với FrontierCode 2 và FrontierSWE v2, vượt đa số model khác. Anh nói GPT-6 Astra được 65 và Fable được 70, rồi Astra được 42.8 và Fable được 49.1; bảng ghi FrontierSWE v2 là 65.5% và 69.9%, FrontierCode 2.0 là 42.8% và 49.1%. Ở Business workflows, Fable đứng thứ hai sau Gemini 4 Carbon, điều anh thấy thú vị.
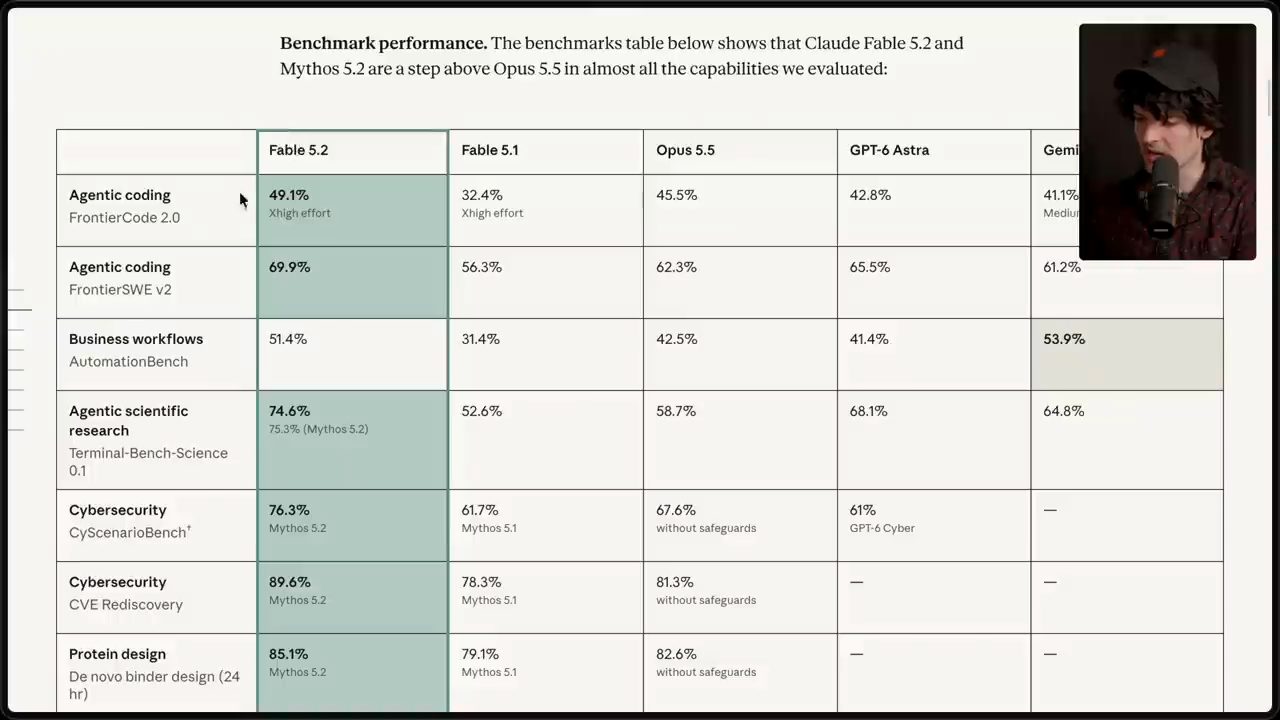
Fable thắng ở agentic science research, mà Theo gọi là một chiến thắng lớn: nhảy vọt từ 52.6 của Fable 5.1 lên 74.6, và cũng vượt xa Opus. Theo anh, đáng chú ý nhất là khoảng cách giữa Opus 5.5 và Astra ở đây rất lớn, anh nói 10 điểm (bảng ghi 58.7% và 68.1%); giờ Fable 5.2 đã vượt cả Astra, từ 68.1 lên 74.6. Anh cho rằng (video đăng ngày 10/11/2026) có vẻ nhiều giá trị của model này nằm ở các ngành khoa học ngoài khoa học máy tính: Anthropic đã đầu tư rất mạnh vào sinh học, các dạng hoá học trong Terminal-Bench Science, và điều đó thể hiện trong các con số.
Ở CyScenarioBench (mục Cybersecurity), Fable cũng vượt trội; Anthropic dùng Mythos cho phần đó vì, như mọi người có thể đoán, bản Fable thông thường sẽ không cho làm những việc ấy. Ở CVE rediscovery, anh nói nó được khoảng 90% (bảng ghi 89.6%); thiết kế protein 85.1, cũng với Mythos vì Fable sẽ không làm những việc này. Thắng, thắng, thắng. Ở Elo trên AA-Briefcase, nó kém Opus 5.5 một chút (bảng ghi 1785 và 1800), vẫn là một chiến thắng trọn vẹn cho Anthropic; rồi lại thắng, thắng và thắng. Theo gọi đây là một trong những lần "thống trị hoàn toàn" một bộ benchmark mà anh thấy trong một thời gian (video đăng ngày 10/11/2026). Nhưng anh nói còn những benchmark khác, nhiều cái do anh làm, và nó không làm tốt bằng trên các bench của anh.
4. Trên các bench của Theo: "cú vọ thông thái"
Theo có một số bench mà anh cho model phân tích một code base phức tạp: ở đây là TS Rust, T3 Code, Lakebed, review một loạt PR và những thứ tương tự. Anh nói (video đăng ngày 10/11/2026) anh thấy Fable 5.2 thật ra kém Opus và Sonnet, và vượt xa các model OpenAI, trên bộ eval cụ thể này. Và không chỉ ở một bench, mà ở gần như tất cả: nó xuống thấp hơn những model khác khá nhiều.
Điều gì khiến điểm của nó thấp hơn nhiều như vậy? Anh nói anh có vài giả thuyết. Cách đơn giản nhất anh diễn đạt được là Fable có "vấn đề cú vọ thông thái": nó cố tỏ ra khéo léo rất nhiều. Điều đó có điểm mạnh: nó làm những thứ các model khác không làm, và có vẻ vì thế nó đạt điểm rất cao ở những bench truyền thống hơn (nhận định của Theo, video đăng ngày 10/11/2026). Anh nói khó mô tả, nhưng chữ hiện ra trong đầu là "spiky", chữ anh ghét vì thường để dành cho các model OpenAI, những model "vọt" lên những mức ngu ngốc không tin nổi.
Theo anh, Fable giống người thông minh trong team, thỉnh thoảng không hiểu hết tình huống. Người đó ngồi suốt cuộc họp nhưng chỉ nghe được nửa số chữ, rồi nói một câu khá lạ, từ đâu không biết. Phần lớn thời gian câu đó có lý ở mức nào đó; đôi khi chẳng có lý chút nào, khiến bạn tự hỏi họ có nghe không; và trong một phần nhỏ còn lại, bạn chợt nhận ra: "ồ, đây là thiên tài, hay hơn nhiều so với những gì mọi người đã nghĩ". Anh nói model này trải trọn cả dải đó, "tin tôi đi" (video đăng ngày 10/11/2026).
5. Chi phí theo effort, và vì sao đừng dùng Max
Bài công bố có các biểu đồ cho từng benchmark. Ở FrontierCode, Theo chỉ ra vài thay đổi thú vị: mức x-high của Opus và mức high của Fable 5.2 có chi phí không chênh nhiều. Theo lời anh (video đăng ngày 10/11/2026), x-high là điểm cao nhất, vượt Opus 5.5 ở mức max với khoảng cách giá không lớn. Tuy nhiên, max lại tệ hơn.
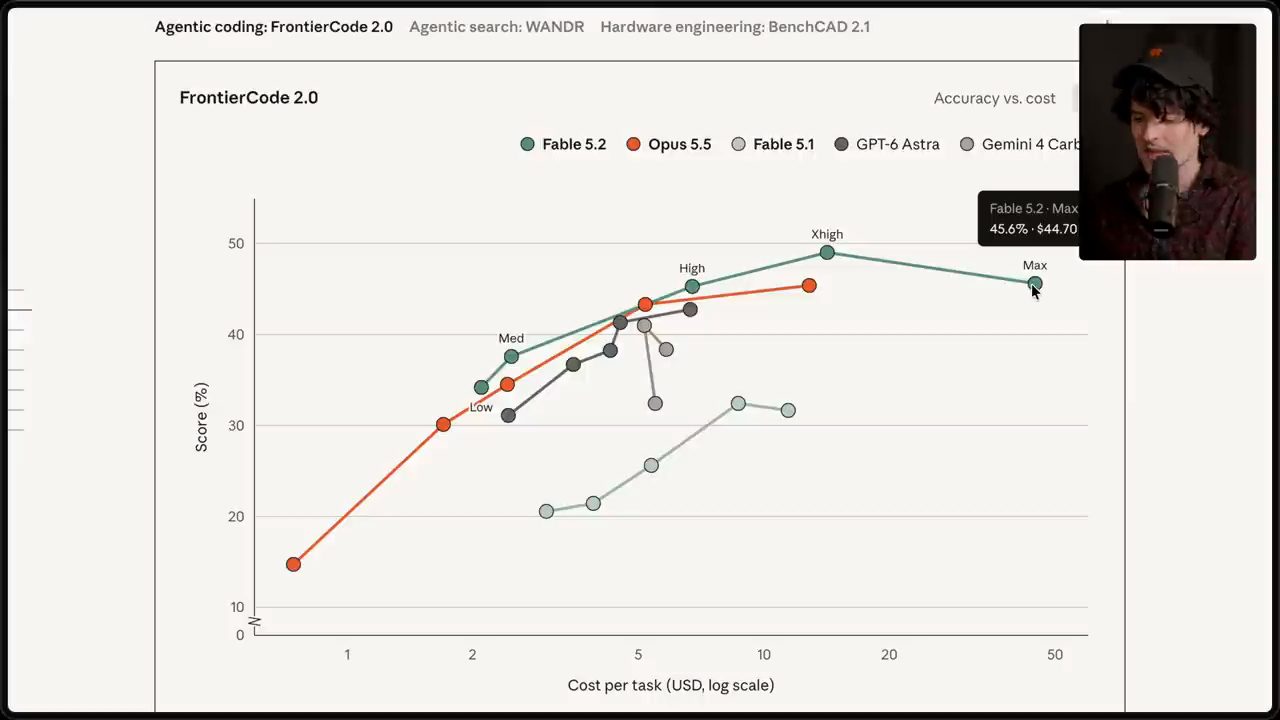
Theo gọi đây là bài học đầu tiên trong nhiều bài học về Fable hôm nay. Nếu bạn là kiểu người xem một video thế này, về cách tận dụng tối đa model khi làm developer, từ một người vốn làm video về web dev, thì bạn là người dùng các model này cho code. Theo anh, reasoning effort ở mức max xưa nay luôn là một sự cân bằng chông chênh với code: không chỉ đắt hơn nhiều, nó thường đi quá xa và mắc lỗi vì thế. Giờ điều đó đã nằm trong benchmark: anh nói Fable 5.2 Max sẽ ghi điểm tệ hơn trên đa số task coding một cách nhất quán, và developer không nên dùng nó (lời khuyên của Theo, video đăng ngày 10/11/2026).
Anh nói nếu bạn nghĩ mình biết rõ hơn anh, thì nhiều khả năng bạn chính là kiểu người không nên dùng Max. Nếu bạn dùng nó một cách miễn cưỡng vì có những việc rất cụ thể mà model dừng quá sớm, các cố gắng prompt để thoát khỏi chuyện đó không thành công, và bạn đang chủ động eval so với các mức reasoning effort thấp hơn, thì có thể bạn dùng được. Nhưng theo anh (video đăng ngày 10/11/2026), nếu Anthropic đã bắt người dùng bấm một nút trong settings để bật chế độ full access, thì họ cũng nên làm vậy với max mode, vì nó nguy hiểm ngang hoặc hơn, và đắt hơn đáng kể. Bài viết có hai biểu đồ khác mà max làm tốt hơn một chút.
Điều anh thấy rất thú vị là giá của Fable 5.2 ở một mức effort gần khớp với giá của Opus ở mức cao hơn một bậc: Fable 5.2 high gần như ngang giá Opus 5.5 x-high, và Fable 5.2 x-high ngang Opus 5.5 max (theo biểu đồ anh xem trong video đăng ngày 10/11/2026). Nhưng anh nhắc lại: max mode không có lợi nhiều, tốt hơn là đừng dùng.
Anthropic cũng cài vào BenchCAD, bench cho kỹ thuật phần cứng, nơi model tăng điểm khá mạnh. Theo nói anh đã nói chuyện với nhiều người bạn kỹ sư điện; có vẻ mọi người đang ở thời điểm mà những lợi ích đã thấy với code và phần mềm bắt đầu xuất hiện nhiều hơn trong phần cứng và kỹ thuật điện. Anh tin (video đăng ngày 10/11/2026) đây sẽ là một trong những thứ tăng tốc rất nhanh trong tương lai rất gần.
6. Phần coding: 90% code, Python sang Rust, một hệ điều hành
Theo nói tới đây mọi thứ bắt đầu lạ. Phần coding của bài công bố nói code của Anthropic do Claude viết, và anh nói ở chỗ anh cũng vậy: theo anh (video đăng ngày 10/11/2026), tuyệt đại đa số code trong T3 Code, khoảng 95% trở lên, giờ là Claude viết. Vì thế anh thấy buồn cười khi Anthropic hào hứng nói rằng hơn 90% thay đổi được merge vào code base của họ là Claude viết. 90%. Anh nói nhiều người đang xem video này đang land nhiều PR bằng Claude hơn cả Anthropic, "theo lời họ".
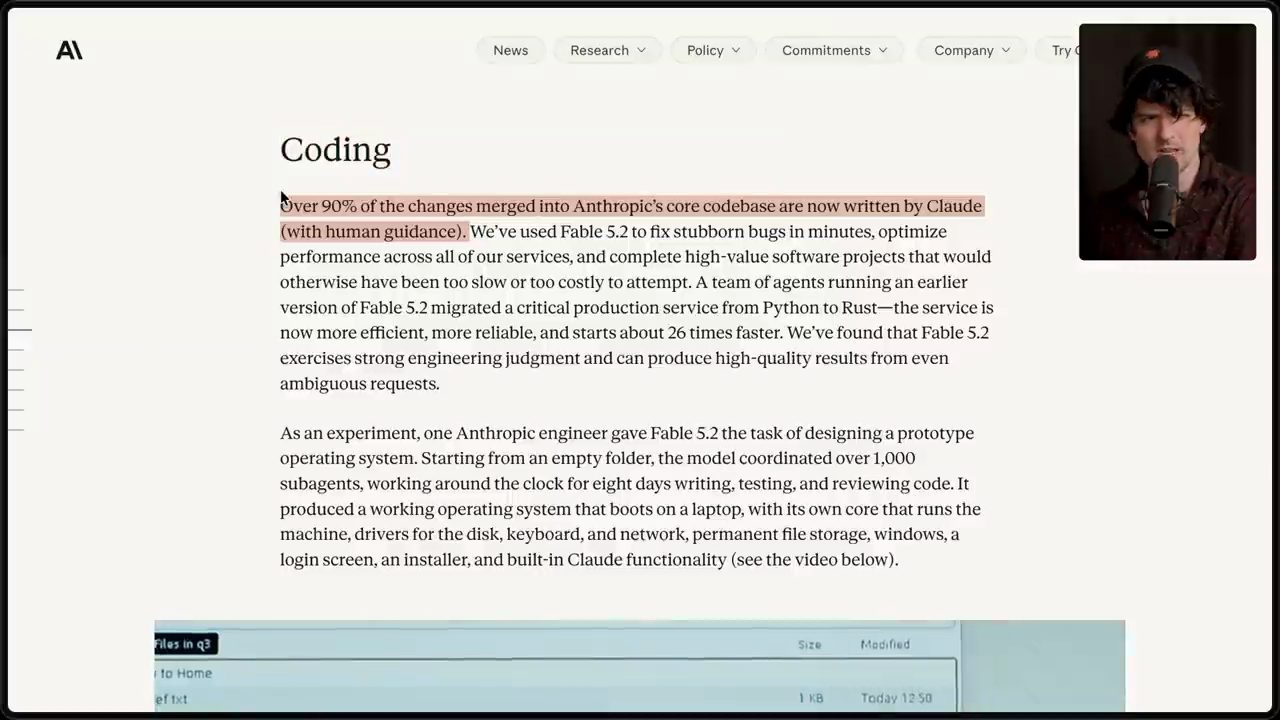
Anh nói, cho có thêm thông tin, anh đã nghe Boris nói trong vài cuộc phỏng vấn và ở những nơi khác rằng 10% còn lại không phải là không do Claude viết, mà là chưa được ghi nhận đúng; và Anthropic thà đưa con số thấp còn hơn đưa ra tuyên bố táo bạo, sau bao nhiêu lần bị chê khi nói "bọn tôi viết mọi thứ bằng Claude" (theo lời Theo, video đăng ngày 10/11/2026). Anh nói những điều Anthropic nói sáu tháng trước, khi mọi người chế giễu họ, giờ đã đúng với nhiều doanh nghiệp ngoài Anthropic, còn tuyên bố của họ bây giờ nghe dè dặt, điều anh thấy rất buồn cười.
Bài viết kể một team agent chạy một phiên bản sớm của 5.2 đã migrate một service production quan trọng từ Python sang Rust, giờ hiệu quả hơn, tin cậy hơn và khởi động nhanh hơn 26 lần (bài công bố mà anh đọc trong video đăng ngày 10/11/2026). Theo đáp: anh đã viết lại một ngôn ngữ bằng Rust với Opus và nó nhanh hơn 20 đến 100 lần. Anh nói thật điên rồ khi những thứ mới gần đây còn táo bạo giờ không làm anh động lòng nữa.
Ví dụ tiếp theo anh gọi là buồn cười: trong một thí nghiệm, một kỹ sư Anthropic giao cho Fable 5.2 thiết kế một hệ điều hành mẫu. Anh mỉa: "Ôi, hệ điều hành, thứ cơ bản là không ai đụng tới được, thật điên khi nghĩ một AI làm được thứ bất khả như một OS". Anh nhắc T3 OS của anh, và nói cho công bằng thì nó dựa trên Ubuntu, không phải một OS mới (video đăng ngày 10/11/2026).
Điều anh muốn nói là anh đã mặc định Opus làm được việc này; thậm chí anh nghĩ Astra hay Sol cũng làm được. Theo anh (video đăng ngày 10/11/2026), driver là một bài toán tương đối đã được giải, và mọi phần khác đều có đủ tài liệu tham khảo. Anh không quá ngạc nhiên khi trong tám ngày nó làm được một OS có driver, có hiển thị chạy được và đủ network để có một widget cloud nhỏ bên trong. Hay đấy, làm tốt lắm, nhưng với anh không còn ấn tượng điên rồ nữa. Anh nói thật điên khi mọi người quen với chuyện này nhanh như vậy, "con ếch này bị luộc nhanh".
7. Khoa học, robotics, phân tích dữ liệu và ZDR
Trước khi vào phần science and engineering, Theo nhắc rằng phần cuối là thứ nhiều người tới xem: các demo code vui, lần chạy Fish Slop (vì tất nhiên anh phải chạy nó), và nhận xét thật lòng của anh sau khi code với model này cả ngày và land khoảng 20 PR với nó. Anh nói nhận xét có thể thay đổi theo thời gian, nhưng anh đã thử nó điên cuồng từ 11 giờ sáng khi model ra cho tới 1 giờ sáng lúc quay; anh nghĩ anh đã có vài quan điểm, dĩ nhiên chưa sâu bằng vài ngày nữa, nhưng đó là một model tốt (video đăng ngày 10/11/2026).
Về vật lý, theo bài công bố anh đọc (video đăng ngày 10/11/2026), model đã giải hai bài toán mở trong vật lý lý thuyết, đều về lỗ đen, trong nỗ lực thống nhất hai lý thuyết trụ cột của vật lý hiện đại là thuyết tương đối và cơ học lượng tử. Cả hai dựa nhiều vào đối ngẫu holographic, ý tưởng rằng một số vũ trụ chứa hấp dẫn có thể được mô tả chính xác bằng một lý thuyết lượng tử hoàn toàn không có hấp dẫn. Trong bài toán thứ nhất, năm 1983 các nhà vật lý đã chỉ ra rằng khi các vũ trụ này nóng lên, lỗ đen hình thành đột ngột. Tới đây Theo xin lỗi vì anh không thức nổi trong giờ vật lý: đó không phải sở trường của anh, anh thích phần mềm hơn.
Model cũng làm protein folding. Theo nói đã có nhiều tiến bộ về protein folding và thật hay khi thấy thêm; càng gấp được nhiều protein, càng có nhiều cách chữa cho nhiều bệnh. Anh nói (video đăng ngày 10/11/2026) rất có thể mọi người đang gần một phương pháp chữa ung thư nhờ AI, và anh tò mò điều đó sẽ làm gì với thế giới. Model cũng hình thức hoá Định lý cuối cùng của Fermat, chuyện đã gây khá nhiều drama trên internet; anh nói "hay, nó giỏi toán", và thật điên khi chuyện này còn chẳng làm mọi người động lòng nữa.
Model giỏi hơn nhiều ở robotics, cả tự chế robot lẫn điều khiển robot đó; Theo gọi là đáng sợ nhưng khá thú vị. Theo lời anh (video đăng ngày 10/11/2026), nó "đè bẹp" RoboDojo, một benchmark đo model làm các task robot tốt tới đâu; biểu đồ trong bài công bố ghi Fable 5.2 đạt 64.9, so với 39.4 của Opus 5.5.
Ở mục research and analysis, nhiều người được trích nói nó rất, rất giỏi phân tích mọi kiểu task mơ hồ, nặng dữ liệu. Theo nói anh có kết quả lẫn lộn, cả khi tự dùng Fable 5.2 hôm nay lẫn với các model Fable nói chung (video đăng ngày 10/11/2026). Anh thấy chúng có nhiều ý tưởng mới hơn về việc làm gì với dữ liệu, nhưng đôi khi cũng nhảy cóc theo cách không hợp lý, và quên kiểm tra các mốc thời gian bên ngoài bộ dữ liệu để hiểu rõ hơn các sự kiện gây nhiễu. Anh đã phải nhắc model này đi tra ngày ra mắt các model khác, để dùng nó đánh dấu các thay đổi trong dữ liệu khi anh phân tích dữ liệu T3 Code.
Theo anh (video đăng ngày 10/11/2026), model vẫn không có ZDR (zero data retention) khi dùng cho doanh nghiệp, nên không dùng được nó mà không để Anthropic giữ dữ liệu. Nhưng có beta Enterprise Frontier Safeguards mới, cho phép chạy phần kiểm tra trong hạ tầng của chính bạn thay vì của Anthropic, để an toàn hơn một chút; anh nói nó đã ở private beta với Bridgewater, Salesforce và Stripe. Trang công bố (đọc ngày 15/11/2026) viết rằng với Enterprise Frontier Safeguards, việc giám sát an toàn tự động chạy trên prompt và response lưu trong hạ tầng của khách hàng, tương thích với ZDR, và đang ở private beta với Bridgewater, Salesforce và Stripe.
8. ZDR và cú chiếm lĩnh của Opus 5.5
Một điều rất thú vị Theo học được, và thấy rõ tác động với Opus 5.5: chính sách ZDR có tác động cực lớn tới việc các công ty áp dụng model. Theo anh (video đăng ngày 10/11/2026), Opus là model "đẳng cấp thần thánh" đầu tiên cư xử tốt mà nhiều doanh nghiệp dùng được với chính sách hiện có mà không mất ZDR, và kết quả là Opus 5.5 được áp dụng ở mức "phá vỡ thế giới" tại rất nhiều doanh nghiệp.
Anh nói khó diễn tả cú Claude Opus chiếm lĩnh mọi thứ điên rồ tới mức nào. Theo số liệu T3 Code anh nêu (video đăng ngày 10/11/2026), tuyệt đại đa số turn trong T3 Code, lên tới khoảng 63% hoặc hơn, đã dùng Opus 5.5. Trước đây chưa từng có model nào vượt 50%, còn Opus chạm 60% chỉ vài ngày sau khi ra mắt. Gộp mọi model Codex trước đó cũng chỉ vừa nhỉnh hơn 50%, rồi rất nhanh Opus lấy tuyệt đại đa số lưu lượng.
Anh đưa dữ liệu lên Slopalytics, trang anh gom mọi con số từ Artificial Analysis cùng mọi con số của T3 Code về một chỗ, để thấy các model thực sự được dùng thế nào ngoài đời thật. Theo lời anh (video đăng ngày 10/11/2026), Codex dẫn nhẹ trong khá lâu, lúc đỉnh lên tới 70%, thường ở khoảng 60%, với lên xuống chỗ này chỗ kia. Rồi Opus 5.5 ra và lập tức lật sang Claude: anh nói giờ ở khoảng 78% và vẫn đang tăng. Anh gọi sự thống trị hoàn toàn, không dứt này của Claude là hơi siêu thực, vì nó diễn ra quá nhanh.
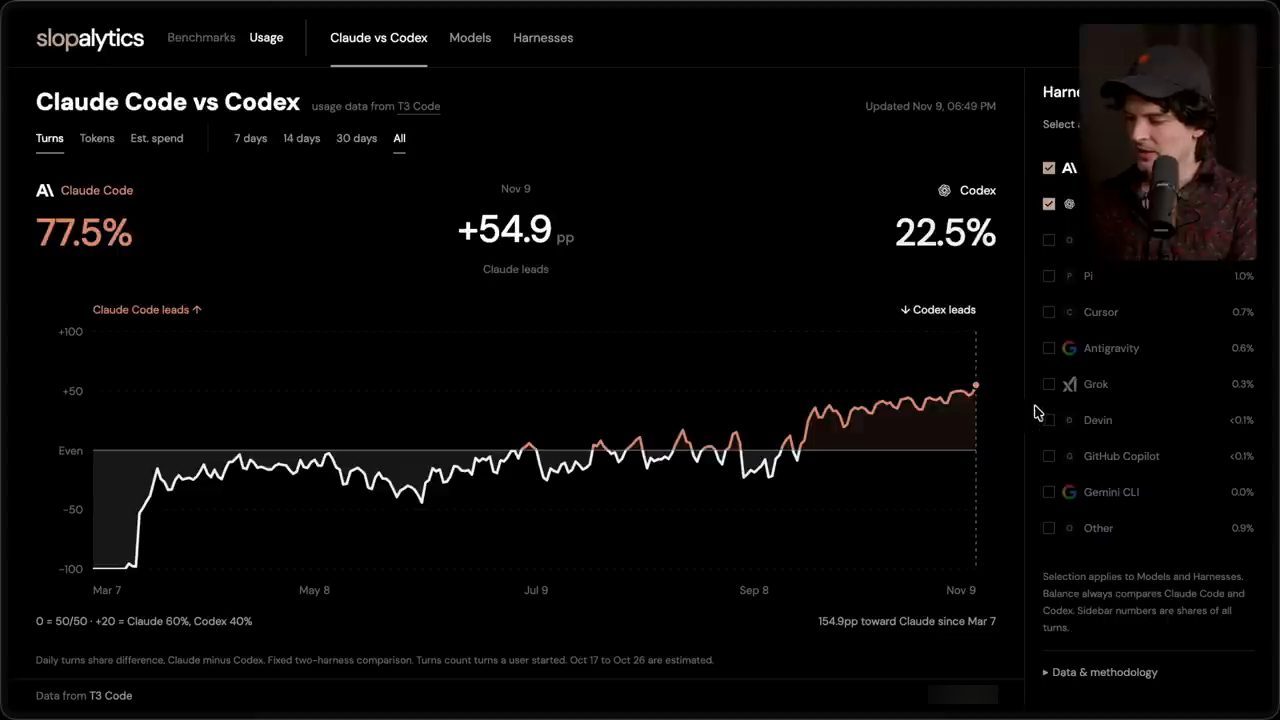
Theo nói giờ anh phải bắt đầu nói về việc dùng thật: nó chạy thế nào trong các code base của anh, và tất nhiên, Fish Slop.
9. Các eval của Theo trên code base thật
Vì anh có nhiều code base khổng lồ do agent viết, Theo nói anh thấy việc dùng agent phân tích chúng là một bench hữu ích đến bất ngờ, nhất là review bench, nơi anh cho model review code thật trong repo thật của anh và cho anh biết bộ PR có những thiếu sót gì. Ở các lần phân tích code base tổng quát hơn, anh thấy (video đăng ngày 10/11/2026) Sol và Astra xây được hiểu biết mạch lạc hơn về code base, và nói thẳng ra là nói ít điều ngớ ngẩn hơn một chút.
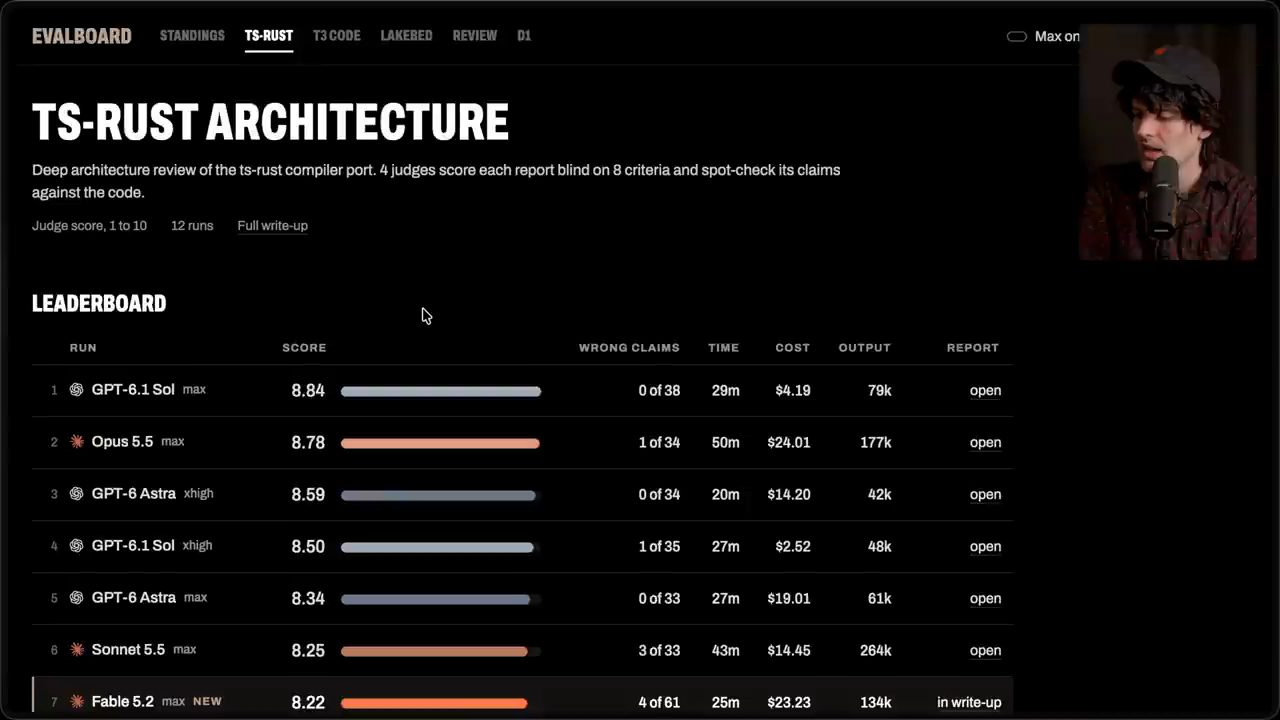
Theo lời anh (video đăng ngày 10/11/2026), Fable 5.2 vẫn thỉnh thoảng đưa ra claim sai: trong 61 claim về code base, bốn claim sai, nhưng chỉ tốn khoảng $23 cho lần phân tích kỹ TS Rust này. Anh nhắc TS Rust là bản viết lại hoàn toàn TypeScript bằng Rust, và Opus viết code base đó; Opus vẫn đứng thứ hai sau GPT-6.1 Sol. Sol đưa 38 claim, không cái nào sai, làm trong 29 phút với $4.19. Theo anh, GPT-6.1 Sol là một "ngựa thồ" cho các việc kiểu phân tích, đáng đồng tiền.
Với T3 Code, ở phần phân tích T3 Code, Opus đứng đầu; Terra, không hiểu sao, đứng thứ hai, làm tốt đến bất ngờ và rẻ khủng khiếp; Fable 5.2 đứng thứ ba khá ổn, dù đưa sáu claim sai trên 83 claim (theo số đo của Theo, video đăng ngày 10/11/2026).
Ở phần code review, anh thấy nó nhìn chung khá tốt, nhưng mất quá lâu để review, điều mà theo anh thật lòng làm mất nhiều giá trị: khoảng 120 phút runtime để review 8 PR là khó chấp nhận, quá nhiều thời gian cho một lợi thế không đủ lớn. Anh không có số liệu ghi lại cho các model GPT ở đây, nhưng chúng mất gần với 20 đến 30 phút cho cùng loạt này (theo số đo của Theo, video đăng ngày 10/11/2026). Có lên có xuống; nhìn chung chậm, nhưng ít nhất nó là chiếc lược răng dày đi qua các PR.
Nói chung, anh khá may mắn với chuyện: nếu Fable nghĩ một PR đã ổn để merge, thì sẽ bất ngờ nếu nó không ổn. Theo anh (video đăng ngày 10/11/2026), có một lợi ích anh chưa thấy nhiều ở model khác: các model khác hơi quá dễ sa vào nitpick và chỉ ra những thứ không quan trọng lắm, còn Fable 5.2 sẵn sàng bỏ qua những thứ đó hơn nhiều. Điều này có cả mặt lợi lẫn mặt hại: nó bỏ sót vài thứ, nhưng không bị kẹt nặng như các model khác. Anh nói vì những lý do anh chưa thể nói, chuyện model bị kẹt sẽ là chủ đề rất quan trọng trong vài tuần tới.
10. Hạn mức gói $200 và thử nghiệm reset
Việc đầu tiên anh làm với model hôm nay là đi qua một loạt phép tính về mức dùng Claude Code trong công việc hằng ngày của anh, để xem model này ngốn hạn mức thế nào. Trước đó anh muốn phàn nàn về điều Fable làm: anh cho nó kiểm lại các con số mà Opus đã chạy, rồi bảo nó làm trang Opus tạo ra bớt xấu đi, và nó làm. Nó còn thay ảnh chụp màn hình, nên anh mở bản gốc của Opus, mà anh gọi là "xấu tội lỗi". Rồi anh cho xem bản redesign và nói bản này không trực quan hoá rõ khoảng chênh giữa các con số chút nào, nhất là khi điều anh yêu cầu là thấy được bạn tiêu được bao nhiêu trên các model khác nhau trong gói $200 (demo trong video đăng ngày 10/11/2026).
Vậy là nói luôn về gói đó. Anh cho xem các con số anh có khi dùng cạn vài account và kiểm tra lượng dùng nhận được. Điều đầu tiên anh thấy rất quan trọng phải nói là, theo anh (video đăng ngày 10/11/2026), Anthropic vẫn cho bạn một nửa hạn mức tuần cho Fable. Họ thể hiện điều này theo một cách lạ, khiến nhiều người nhầm. Gói $200 giờ có hai hạn mức; gói $100 và gói rẻ hơn có ba, vì còn hạn mức năm giờ. Gói $200 không có hạn mức năm giờ, nhưng có một hạn mức cho cả tuần, và riêng một hạn mức Fable bảy ngày.
Điều mọi người có vẻ không hiểu, theo anh: họ nghĩ nếu hạn mức thường còn 0 mà Fable còn 100 thì vẫn dùng được Fable. Không. Theo lời anh (video đăng ngày 10/11/2026), hạn mức Fable là một hạn mức cộng thêm ở trên: cứ hai điểm bạn tiêu ở hạn mức Fable thì tính là một điểm ở hạn mức thường. Nên bạn có thể đưa hạn mức Fable về 0 mà tuần vẫn còn 50%.
Anh nói đó là trạng thái anh từng để mọi account của mình, vì Opus 5 tệ còn Fable 5 và 5.1 thì tuyệt: cả sáu account của anh đều tới mức hết hạn mức Fable nhưng tuần còn một nửa. Giờ không còn như vậy, nên anh làm lại toàn bộ phép tính. Thêm nữa, model này rẻ hơn một chút, điều mà theo anh (video đăng ngày 10/11/2026) dĩ nhiên phản ánh phần nào vào mức dùng hằng ngày.
Có một điều thú vị khác Anthropic làm, và anh nói mọi người sẽ cùng tìm hiểu; anh "đốt" một thứ rất quý với anh để thử. Theo lời anh (video đăng ngày 10/11/2026), Anthropic tặng một lần reset cùng bản phát hành này: account dưới sáu tháng tuổi được một lần, từ sáu đến 12 tháng được hai, trên 12 tháng được ba. Một account của anh được ba, các account còn lại được một hoặc hai.
Có một vấn đề: đây là reset theo model. Theo anh, nghĩa là nó reset hạn mức Fable, không phải hạn mức tổng. Anh cho thấy account đang còn 22% Fable và 11% tổng; lần reset cũng hết hạn sau bảy giờ, nên anh có thể để nó tự reset. Nhưng chưa ai trả lời anh câu hỏi này, nên anh thử: nó có trả lại 50% của tuần không, vì theo anh đó là điều nó nên làm. Sau khi dùng reset, anh đọc: tuần đã dùng 51%, còn Fable 0%: vậy nó thật sự trả lại nửa hạn mức tuần (demo trong video đăng ngày 10/11/2026).
Anthropic vẫn giữ một điều anh rất thích: khi bạn dùng một lần reset, nó không reset luôn bộ đếm thời gian. Theo lời anh (video đăng ngày 10/11/2026), mỗi lần Tibo reset Codex, bộ đếm thời gian của bạn cũng reset theo: nếu bạn còn ba ngày nữa tới kỳ reset mà Tibo reset, bộ đếm quay về bảy ngày. Nếu bạn làm việc theo một nhịp cố định, điều đó có thể phá hỏng nhịp của bạn. Với reset của Claude, bộ đếm giữ nguyên; bạn chỉ có thêm lượng dùng sớm hơn.
Anh thấy cách này dễ làm việc và lên kế hoạch hơn nhiều, và ít làm rối lịch của anh hơn. Với Codex, anh gặp vấn đề lạ là mọi account reset cùng lúc và anh cứ đốt vào một con số lớn hơn. Anh thừa nhận chuyện này lạ với anh vì anh có nhiều account, nhưng anh đoán bây giờ cũng có kha khá người như vậy; có một lịch riêng nhất quán để lên kế hoạch thật ra dễ chịu nếu bạn cố tận dụng tối đa các account. Công bằng mà nói, theo anh (video đăng ngày 10/11/2026), Claude không reset nhiều bằng; anh sẵn sàng lấy số lần reset mà Tibo cho bất cứ lúc nào, nhưng ít nhất reset của Claude dễ lên kế hoạch hơn.
11. Gói $200 đáng bao nhiêu, và giả thuyết model nhỏ hơn
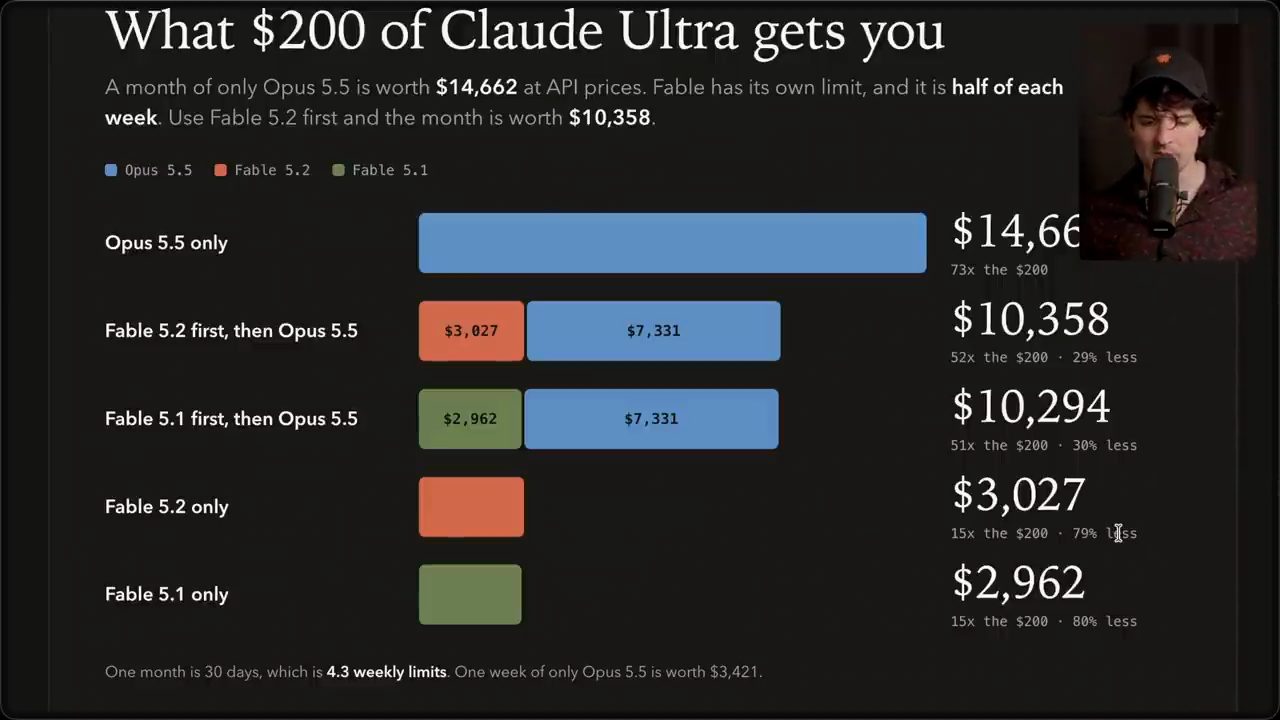
Vậy gói $200 cho bạn bao nhiêu? Theo phép tính của Theo (video đăng ngày 10/11/2026), nếu chỉ dùng Opus 5.5, nghĩa là dùng được 100% tuần cho Opus, một tháng đáng $14,662 theo giá API, gấp 73 lần số tiền bỏ ra cho gói $200 nếu dùng cạn. Anh nói con số này cho cả tháng, khoảng $14,500 đến $15,000 theo giá API.
Và anh bảo mọi người nhắc lại cùng anh: giá API bị thổi phồng. Theo anh (video đăng ngày 10/11/2026), ai cũng nhìn đây là trợ giá điên rồ cho subscription, và đúng là vậy, nhưng mặt khác biên lợi nhuận trên giá API cao điên rồ tới mức họ làm được thế. Anh bảo hãy nghĩ một phần là mọi người trả ít hơn trên subscription, một phần là doanh nghiệp trả một khoản "thuế" lớn trên giá API để trợ giá cho mọi người. Đó là một sự cân bằng, và theo anh ai cũng bị thiệt một chút, trừ Claude.
Opus cho bạn khoảng 14.5 đến 15 nghìn đô. Nhưng anh nhắc về giá model: Anthropic nói model này $40 cho mỗi triệu token output thay vì $50 như trước, và còn nhanh hơn. Theo lời anh (video đăng ngày 10/11/2026), điều đầu tiên cần biết là Fable 5 lẽ ra được định giá khác: khi Anthropic công bố Mythos lúc đầu, giá là $25 cho mỗi triệu token input và $125 cho mỗi triệu token output. Rồi họ có thoả thuận compute với SpaceX và bất ngờ công bố giá chỉ $10 input và $50 output, vì có đủ compute.
Theo anh (video đăng ngày 10/11/2026), đó là Anthropic "nổ súng" vào OpenAI, đồng thời đối phó với chuyện ZDR không phải tuỳ chọn cho model này, nghĩa là nhiều công ty không dùng được vì cần zero data retention. Nên họ đưa model ra rẻ hơn và chịu mất một phần lớn biên lợi nhuận thường lệ, tới một nửa biên lợi nhuận bị cắt chỉ bằng một hành động đó. Họ có thể giữ giá ấy và, giả định là, làm gì đó như làm model nhỏ hơn hay rẻ hơn để chạy, để bù chênh lệch chi phí và tăng biên lợi nhuận, rồi họ lại quyết định làm nó rẻ hơn nữa.
Chuyện model này nhanh hơn 30%: anh nói anh đã chạy số, và nó thật ra nằm trong khoảng 5% tốc độ của Opus. Theo anh (video đăng ngày 10/11/2026), đó có lẽ là điều bất ngờ nhất với anh, vì Fable xưa nay chậm hơn khá nhiều: Fable 5.1 là 81 đến 84 TPS, còn bản này 106 TPS so với Opus 112. Anh nói hai model giờ sát nút nhau; model này không chậm.
Và anh nói đến đây là "vùng thuyết âm mưu": theo anh (video đăng ngày 10/11/2026), đây là một model nhỏ hơn. Anh nói model này không còn nghi ngờ gì là nhỏ hơn Fable 5.1, gần như chắc chắn, hoặc họ có vài mẹo lạ, hoặc làm các expert nhỏ hơn, hoặc gì đó. Rõ ràng nó rẻ hơn để Anthropic chạy, và theo anh đó là lý do họ làm những gì họ đang làm: lý do họ có fast mode bây giờ, lý do họ làm nó rẻ hơn, lý do nó nhanh hơn một cách khách quan. Model này hoặc nhỏ hơn, hoặc vì lý do khác mà dễ host và chạy hơn. Tuyệt, mọi người được lợi từ đó.
Theo anh (video đăng ngày 10/11/2026), điều đó cũng có nghĩa là model Fable khổng lồ bí mật mà Anthropic có nội bộ, có lẽ còn không phải Fable, họ gọi là Model 4 và tất cả họ đều dùng, khác xa thứ mọi người nhận được hôm nay. Đó là thứ "huyền thoại điên rồ" họ giấu nội bộ, và họ dùng nó để làm ra Fable 5.2 cũng như dòng 5.5. Anh hẹn sẽ nói tới các thuyết âm mưu vì sao 5.2 không phải 5.5 sau.
Anh nói anh chỉ muốn chỉ ra model này chắc chắn nhỏ hơn trong khi nói về chuyện trợ giá, vì nó giải thích mức cắt 50%: theo anh (video đăng ngày 10/11/2026), Anthropic đã tự ăn 50% biên lợi nhuận khi đưa giá từ 125 xuống 50, cắt biên lợi nhuận đi một nửa, nên họ cắt lượng bạn dùng được trong subscription đi một nửa. Anh nói nếu nghĩ về nó thì nó khớp kiểu vậy, nhưng đừng nghĩ quá kỹ, kẻo não rơi ra ngoài, vì mấy thứ này đều được quyết định ngẫu nhiên trong nội bộ.
12. Fable trước, Opus sau: tiền, token, turn và thread
Nhìn rộng ra: bạn bắt đầu với Fable 5.2 cho tới khi hết, rồi dùng Opus cho nửa còn lại. Theo phép tính của Theo (video đăng ngày 10/11/2026), trong một tháng bạn có khoảng $3,000 giá trị Fable 5.2 cho phần đầu mỗi tuần, rồi với 50% còn lại mỗi tuần bạn làm được khoảng bảy nghìn đô Opus 5.5. Vậy bạn chịu hụt khoảng bốn nghìn đô trên tổng số tiêu được trong tháng nếu dùng cạn Fable. Anh nói có thể tệ hơn, dù dĩ nhiên vẫn dở; và nếu chỉ dùng Fable, hệ số của bạn đi từ 73x xuống 15x, giảm 80%, không hay.
May là Opus 5.5 là một model tuyệt, theo anh (video đăng ngày 10/11/2026); trước đây Opus 5 thì không, nên nửa còn lại cứ thế bỏ phí. Anh nói có lẽ anh đã mất hơn 100 lần phần 50% ấy của các tuần trên tất cả account, vì không dùng được các model kia. Giờ anh đốt sạch mọi account khá thường xuyên, nhờ Opus.
Bạn nhận được nhiều token hơn đáng kể cho số tiền đó, vì Fable 5.2 rẻ hơn và hiệu quả hơn, nên bạn có nhiều output token hơn hẳn, là giá trị mọi người nhận từ model, dù số tiền gần như ngang Fable 5.1 cho phần bạn nhận (theo phép tính của Theo, video đăng ngày 10/11/2026; trang của anh ghi cùng một hạn mức Fable chứa được 4.7M output token Fable 5.2 so với 2.8M của Fable 5.1, tức +68%).
Số turn và thread là lúc mọi thứ bắt đầu vui. Theo anh (video đăng ngày 10/11/2026), bạn mất một ít turn với Fable so với dồn hết vào Opus, nhưng chỉ khoảng 20% ít hơn, thay vì cú hụt lớn hơn rất nhiều nếu khác đi. Trong bài test của anh, mà anh thừa nhận hôm nay anh benchmark model rất nhiều, có vẻ Fable cộng Opus cho bạn nhiều thread hơn tổng thể, vì Fable dễ hoàn thành một thread trong một turn hơn Opus, nhưng cũng vì nhiều việc anh chạy hôm nay là one-shot.
Trang "Turns and threads in one month" anh cho xem (video đăng ngày 10/11/2026) ghi: chỉ Opus là 5,220 turn và 986 thread mỗi tháng; Fable 5.2 cộng Opus là 4,080 turn (22% ít hơn) và 1,054 thread (7% nhiều hơn); Fable 5.1 cộng Opus là 2,998 turn và 769 thread; chỉ Fable 5.2 là 1,470 turn và 561 thread; chỉ Fable 5.1 là 388 turn và 276 thread.
Model này cũng viết nhanh hơn nhiều; như anh nói, TPS tốt hơn hẳn, và anh ấn tượng. Anh cho biết toàn bộ giao diện trông "rất Anthropic" này do model mới làm (demo trong video đăng ngày 10/11/2026).
13. Front-end: design skill bật và tắt
Tiếp theo, Theo mở trang Which AI Made This? để xem model làm front-end thế nào. Theo những gì trang hiện trong video đăng ngày 10/11/2026, nó so sánh cách các model khác nhau thiết kế UI, có và không có frontend design skill của Anthropic, với cùng một prompt ghi trên trang:
I want you to design the landing page for a note-taking application as essentially a second brain. You should design five iterations and each of them should be accessible within the slash one, slash two, slash three like pages directory. And then you should add a little button that lets me switch between them easily.
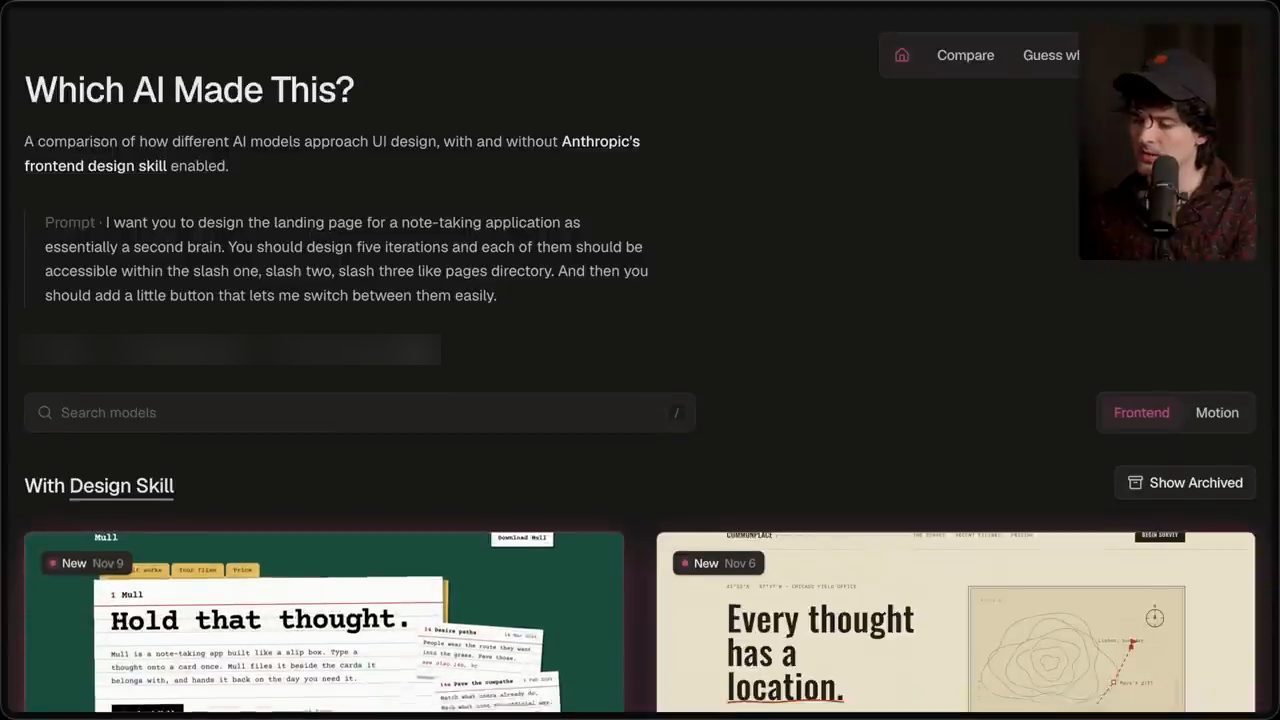
Bản đầu tiên, theo nhận xét của Theo (demo trong video đăng ngày 10/11/2026): anh ghét font, nhưng animation nhỏ cho các thẻ "không phải tệ nhất". Bản tiếp theo anh thấy dễ thương, thích màu và animation, và dặn nhớ màu này vì lát nữa sẽ quay lại. Rồi tới bản kiểu sơ đồ tàu điện ngầm, trông không ngầu bằng khi không thu nhỏ đủ để thấy toàn bộ; anh thích animation, và cách nó chạy ra khỏi màn hình khá hay. Theo anh, nó sẽ dễ chịu hơn nếu trang căn chỉnh tốt hơn một chút, điều nó gặp khó vì màn hình nhỏ hơn của anh; trên màn hình thường của anh lúc trước thì tốt hơn nhiều. Hơi thô, nhưng nhìn chung vẫn hay.
Bản tiếp theo anh không thích lắm và không biết nó muốn anh đi đâu hay làm gì. Bản thứ năm có ý tưởng hay; anh thích màu hồng, nhưng hiệu ứng mờ dần vào ra không ngầu như anh mong (nhận xét của Theo, demo trong video đăng ngày 10/11/2026). Tất cả những bản này là với design skill bật.
Rồi anh xem khi tắt skill: theo nhận xét của anh (demo trong video đăng ngày 10/11/2026), lại ra "template slop". Có vài animation hay chỗ này chỗ kia, nhưng một nửa trong số này tệ. Anh nói anh ghét những bản kiểu ngôi sao, và bản nào cũng lén nhét vào một bản kiểu brutalist mà anh đã quá mệt; các thẻ ở đây thì "cringe". Nó có những khoảnh khắc hay, nhưng theo anh model này thật sự cần design skill, không thì bạn sẽ có "Fable slop".
Theo anh (video đăng ngày 10/11/2026), "Claude slop" trong UI nói chung là thứ bạn phải "đánh" cho nó bỏ đi, và may là Anthropic cung cấp skill đó. Anh nói thật điên khi một chút markdown giúp được, nhưng nó giúp rất nhiều.
Anh nói cái đoạn rẽ ngang này bắt đầu vì anh đang trút giận về những thay đổi Fable làm. Bức ảnh ở đây sai; bản trước là bản dọc mà anh đã cho xem, nơi không thấy khác biệt giữa các model, và anh đã nổi nóng với nó. Anh viết rằng ảnh chụp ở trên cùng quá tệ, thậm chí không trực quan hoá được khác biệt. Anh đưa nó một ảnh chụp mà nó đã xê dịch UI rất nhiều theo cách rất "cringe"; rồi nó sửa và làm bớt tệ đáng kể (demo trong video đăng ngày 10/11/2026).
Nhưng anh thấy (video đăng ngày 10/11/2026) với model này anh phải ở trong vòng lặp nhiều hơn. Một phần là vì anh không đưa nó cả bộ thứ kiểu console mà anh làm với các model khác, nơi anh cho chúng được review một cách ám ảnh bằng những thứ khác; nhưng anh cũng mong không cần phải làm vậy. Có vẻ model này cần điều đó hơn Opus một chút: cần bạn dắt tay một chút, không thì nó có thể tự kẹt khá nhanh. Không phải kẹt kiểu không giải được bài toán; nó thật ra tự gỡ khá tốt. Mà kẹt kiểu nó đưa ra một quyết định không quan trọng lắm rồi lao dần theo hướng đó theo những cách mà con người nhìn là thấy sai.
14. Chữ eyebrow, và câu hỏi về cup2
Anh thêm một ví dụ thấy trên Twitter, nơi có người chỉ ra rằng model này vẫn làm đủ thứ chữ eyebrow và tiêu đề phụ không cần thiết, và anh cũng thấy điều đó trong nhiều thứ của mình. Nên anh hỏi model nó gọi chúng là gì và vì sao làm vậy; nó bảo anh nên làm gì. Anh sửa file AGENTS.md của mình để nó đừng làm vậy, và từ đó nó làm ít hơn, điều anh thấy dễ chịu (theo lời Theo, video đăng ngày 10/11/2026).
Theo anh (video đăng ngày 10/11/2026), model có vẻ viết văn xuôi tốt hơn nói chung và giỏi hơn khi viết cho các model khác. Nên làm việc với nó để đại tu nhiều phần copy và nhiều thứ anh đang làm, gồm cả một loạt skill, khá dễ chịu.
Vài ngày trước anh dùng Terra (GPT-6.1 Terra) cho vài việc, chỉ để thử khả năng quản lý hệ thống Linux, vì anh thấy computer use của Terra khá tốt. Nhưng mỗi lần anh hỏi vì sao ổ lưu trữ trên một máy cụ thể chậm hơn mức đáng có, dù anh vừa đại tu cả file system, nó không hiểu ra, và lần nào cũng nhả ra "slop": cứ đưa lại cùng những biểu đồ và nói một loạt chi tiết vô nghĩa (theo lời Theo, video đăng ngày 10/11/2026). Một câu trả lời anh đọc: cup2, máy mới, mất 3.2 đến 3.3 lần thời gian để dựng một worktree T3 Code "ấm" so với ba máy T3 OS vật lý, phần lớn nằm ở pnpm, vân vân. Anh gọi là khó đọc, khó chịu. Anh đã hỏi chừng sáu lần riêng rẽ trong thread đó.
Nên anh hỏi tiếp bằng cách chuyển sang Fable, và viết: "I feel like I'm going insane. Can you just tell me WHY is it slower?". Theo lời anh (demo trong video đăng ngày 10/11/2026), Fable trả lời: cup2 là một VPS, ba máy kia là máy vật lý có ổ NVMe local; đó là toàn bộ lý do, và nó gây ra hai vấn đề. Anh nói câu trả lời này nghe có vẻ rất đơn giản, nhưng tin xấu là không phải vậy, vì anh đã hỏi đúng câu đó trong thread Terra và nó đáp bằng thêm điều vô nghĩa.
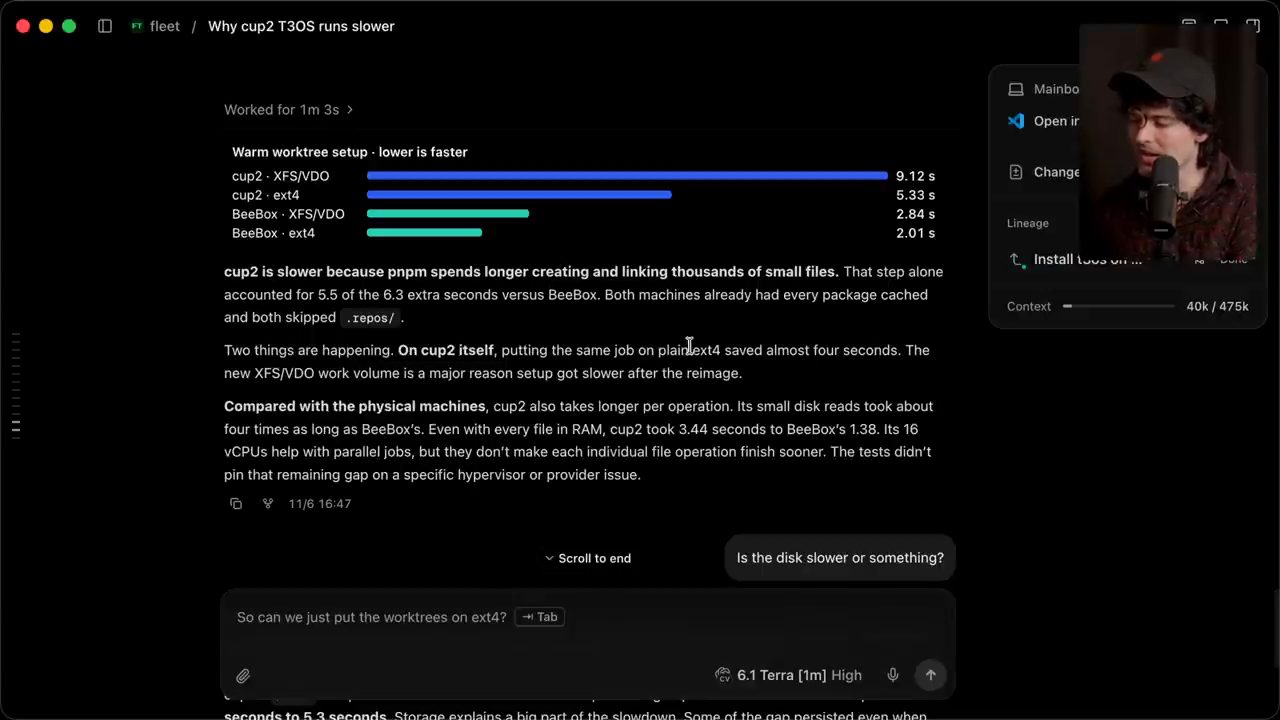
Anh đọc câu trả lời của Terra: cup2 chậm hơn vì pnpm mất lâu hơn để tạo và link hàng nghìn file nhỏ; riêng bước đó chiếm 5.5 trong 6.3 giây chênh lệch. Có hai chuyện đang xảy ra: trên chính máy này, chạy cùng job trên ext4 thường tiết kiệm gần bốn giây; volume làm việc XFS/VDO mới là một lý do lớn khiến setup chậm đi sau khi reimage. Nó cũng mất lâu hơn cho mỗi thao tác: các lần đọc đĩa nhỏ lâu gấp khoảng bốn lần; kể cả khi mọi file ở trong RAM, nó vẫn lâu hơn. Theo nói chi tiết nằm giấu trong câu nhỏ này, và đó là toàn bộ vấn đề (demo trong video đăng ngày 10/11/2026).
Anh nói anh hiểu, Terra là một model nhỏ, "dở". Anh chỉ mong nó tốt hơn, vì anh đã có trải nghiệm tốt với nó nói chung. Theo anh (video đăng ngày 10/11/2026), đây là một ví dụ đơn giản, tốt về một model lớn làm đúng việc; Opus cũng có câu trả lời tốt ở đây. Còn với OpenAI, anh chửi thề: anh biết Terra nhỏ, nhưng thế này thì thảm hại.
15. MCP, dám phản biện, nhưng vẫn sai ngớ ngẩn
Điều anh muốn nói, theo anh (video đăng ngày 10/11/2026), là model này dễ chịu khi làm cùng: nó làm điều bạn bảo và làm tương đối tốt. Anh đang làm vài thứ về MCP với tổ hợp Muse Wonder Full và Opus 5.5, cố đơn giản hoá hướng dẫn MCP nói chung, vì anh nhận thấy các model rất dở trong việc cấu hình nó.
Hướng dẫn chúng viết ra yêu cầu đặt một link trên trang mà người thấy được, nhưng khi bấm vào thì không làm gì cả ngoài đưa bạn tới một endpoint báo lỗi. Theo lời anh (demo trong video đăng ngày 10/11/2026), nó thật sự được khuyến nghị ngay ở đầu: bước một, tìm MCP endpoint bằng cách đặt trên trang một URL tới MCP endpoint mà con người không thấy. Bạn thấy được link, bấm được link, nhưng endpoint đó sẽ không làm gì. Anh nói đây thật sự là điều Opus và Muse khuyến nghị sau hàng giờ qua lại.
Anh nhờ Fable xem, và nó lập tức kiểu: không hiểu các agent kia khuyến nghị gì; giải pháp của bạn rõ ràng tuyệt, vấn đề duy nhất là nếu người dùng ở trên một trình duyệt bình thường thì sao. Anh bảo nó đi xem lịch sử của anh, và nó tự chứng minh được là điều đó hoàn toàn vô lý. Theo anh (demo trong video đăng ngày 10/11/2026), điều đó thật ra khá hay: cảm giác như đang nói chuyện với một đồng nghiệp. Và đây là chỗ anh đổi model.
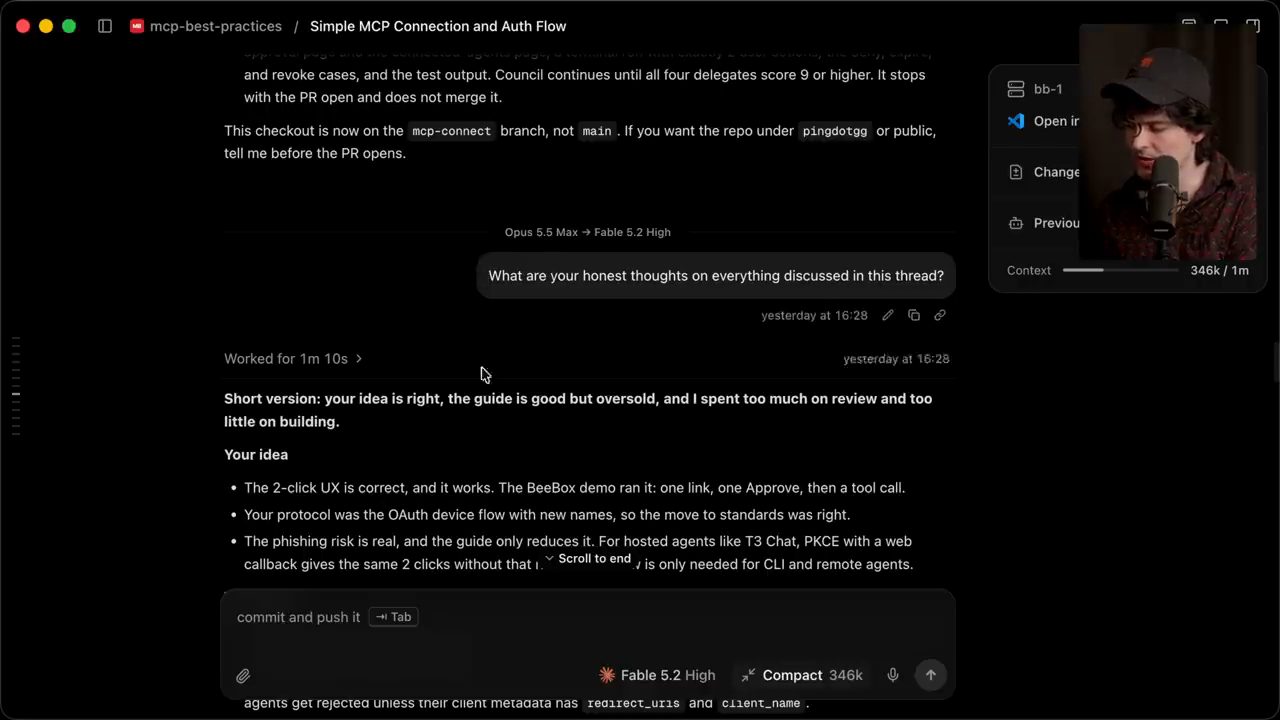
Anh bảo nó cho ý kiến thật lòng, và nó nói ý tưởng của anh đúng; hướng dẫn tốt nhưng bị thổi phồng; nó đã dành quá nhiều thời gian cho review và quá ít cho việc thật sự build. Anh nói rằng device flow chỉ cần cho CLI và agent chạy từ xa, rồi bảo nó đi qua lịch sử của anh để xem có đúng vậy không. Nó làm, và xác nhận anh đúng (demo trong video đăng ngày 10/11/2026). Theo anh, bạn đưa nó nguồn dữ liệu thì nó thường tự bác bỏ được mình, nhưng nó không ngại phản biện; đó là những điều anh rất thích ở nó.
Nhưng nó cũng bỏ sót, và đôi khi dẫn tới hành vi rất ngớ ngẩn. Một ví dụ: anh làm một dashboard muốn ẩn email và thông tin khác khi anh quay video. Theo lời anh (video đăng ngày 10/11/2026), nó làm hỏng tệ tới mức anh sợ mở nó trong buổi quay: trong chế độ đó có một banner đỏ lớn ở trên cùng báo bạn đang ở safe mode, kèm địa chỉ email. Nó đặt luôn địa chỉ email vào thanh báo bạn đang ở safe mode để không có gì lộ, rồi làm lộ một loạt thứ ngay trong thanh đó. Anh gọi đó là cực kỳ ngớ ngẩn: kiểu lỗi mà anh không ngờ ngay cả Opus mắc, model này thỉnh thoảng lại mắc. Anh nói bạn vẫn phải audit output.
Anh thích cách một người bạn có early access đóng khung chuyện này (anh nói thêm, như mọi người có thể đoán, anh thì không có early access). Theo cách người bạn đó nói mà anh thuật lại (video đăng ngày 10/11/2026): model này có năng lực hơn nhiều, nhưng không tự chủ hơn nhiều. Nó không giỏi hơn trong việc tự ra quyết định trong các lần chạy dài; nó giỏi hơn ở chỗ không bị chặn trong các lần chạy dài và giải các bài khó trong các lần chạy dài. Còn những thứ cần bàn tay, suy nghĩ hay quyết định của con người, nó sẽ không làm tốt hơn bao nhiêu, trừ khi bạn là chuyên gia siêu cấp trong lĩnh vực và nó đang làm những phần triển khai kỹ thuật rất cụ thể. Theo anh, ừ thì nó sẽ làm tốt hơn một chút, nhưng sẽ không tự dưng ra những quyết định có gu ở chỗ model khác không ra. Ít nhất các model OpenAI khác chắc chắn sẽ không, nhưng các model Claude khác sẽ làm tốt ở rất nhiều thứ giống vậy.
16. Audit Lakebed và sơ đồ cho Slophouse
Một trong những ví dụ ngớ ngẩn nhất anh đưa ra: anh nhờ model mới audit dự án Lakebed của anh, mà anh gọi là "cloud của tôi", thứ lẽ ra đã phải ra mắt rồi; anh nói anh khá bận. Anh bảo nó audit dự án, cho biết những lỗ hổng nó nhận ra và những gì anh nên ưu tiên. Theo lời anh (demo trong video đăng ngày 10/11/2026), nó cho phản hồi rất tốt: anh chưa bảo đảm backup đúng cách, chưa đặt hạn mức cho account miễn phí đúng cách, chưa xác nhận email báo lạm dụng đi về đâu, còn những bản sửa code phải land, vân vân.
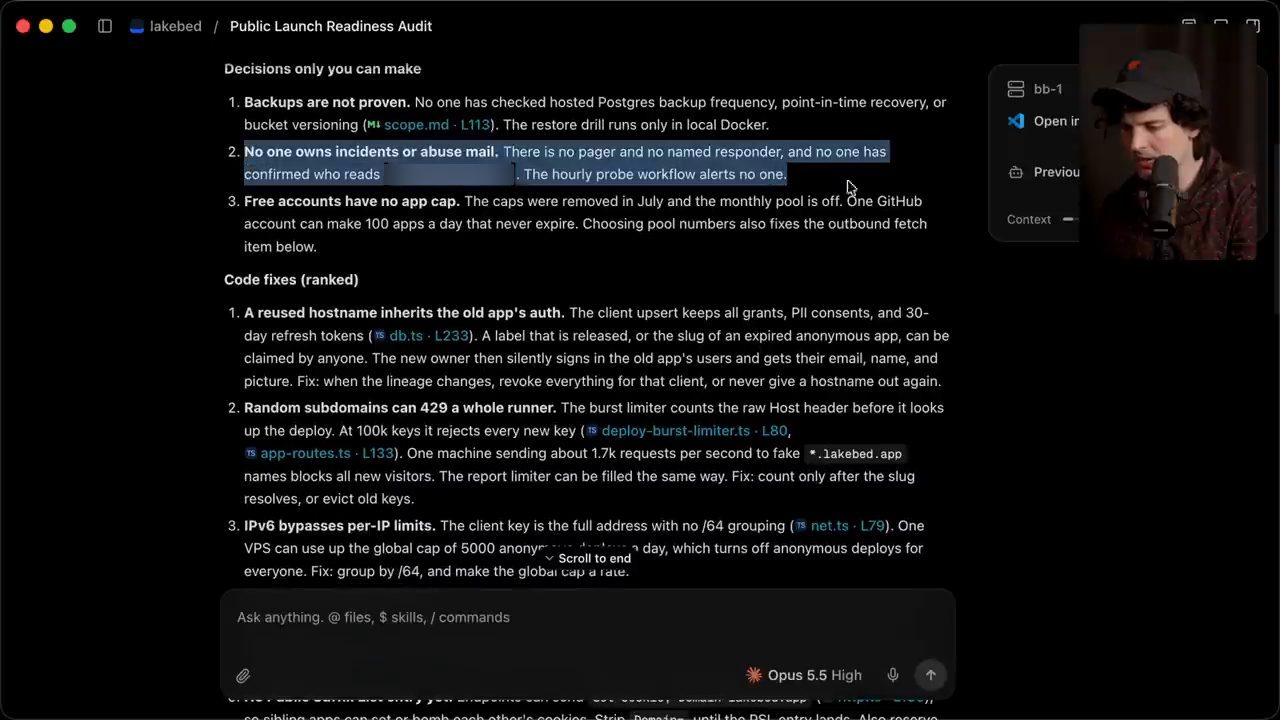
Và nếu nhìn kỹ màn hình, anh nói mọi người có thể đã thấy góc dưới bên phải: Opus 5.5 High. Anh quên chuyển sang Fable, vì Opus là mặc định của anh; ban đầu anh chạy nhầm máy, rồi đổi máy mà không đổi model, và không nhận ra cho tới khi đã đọc xong và thấy ấn tượng. Theo anh (video đăng ngày 10/11/2026), đây sẽ là một chủ đề lặp lại: Opus 5.5 vẫn tốt khủng khiếp, và bạn làm được nhiều hơn hẳn với hạn mức bạn có; nếu bạn thật sự trả theo giá API thì còn hơn thế. Anh gọi Opus 5.5 là "món quà từ trời", không thể tin nổi nó có năng lực tới đâu, nhất là so với giá. Không có gì thay đổi ở điểm đó.
Anh có thêm một ví dụ "ngớ ngẩn". Anh định bàn giao công cụ analytics nội bộ Slophouse cho một thành viên trong team và muốn người đó hiểu nó tốt hơn; anh cũng muốn thử khả năng thiết kế của model. Nên anh cho nó đi qua lịch sử của anh, tìm một sơ đồ và bản giải thích trước đây về cách mọi thứ hoạt động, để nó dọn lại, làm đẹp hơn, cập nhật thông tin mới, rồi gửi cho đồng nghiệp. Theo lời anh (demo trong video đăng ngày 10/11/2026), nó làm được, và làm ra một thứ thật sự rất đẹp, anh gọi là "ngầu kinh khủng". Tuy nhiên, không có sơ đồ nào, trong khi toàn bộ mục đích là giải thích kiến trúc và làm nó dễ hiểu.
Anh thừa nhận anh không nói rõ phải dùng sơ đồ, nhưng anh đã bảo nó tìm cái gần nhất mọi người làm, cập nhật kiến trúc hiện tại và dùng code làm nguồn sự thật. Anh phàn nàn rằng nó rất ngầu nhưng không có sơ đồ kiến trúc anh cần, và lần này nó vẽ một sơ đồ. Theo nhận xét của anh (demo trong video đăng ngày 10/11/2026), sơ đồ không vừa khít màn hình và không phải sơ đồ anh thích nhất, nhưng nó đã thêm khi anh nói anh cần, vì anh cần dữ liệu về những gì đi vào và đi ra khỏi mọi server trong kiến trúc. Anh nói hoá ra analytics không hề đơn giản, và gần đây anh đã chạm nhiều giới hạn của pipelines; anh chỉ nói tới đó.
17. Fish Slop: bản Fable và bản Opus
Còn một thứ mọi người đang chờ. Ngay lúc đó, Theo bật cười: theo lời anh (demo trong video đăng ngày 10/11/2026), anh đã chọn Claude Code làm công cụ để dựng Fish Slop, vì lúc đó anh đang dọn lại setup T3 Code để dùng model cho đúng. Anh bấm phím T đúng một lần, và app đang nhân đôi mọi phím bấm; anh nói họ đã làm một mẹo hack ngớ ngẩn để cải thiện hiệu năng, và trong quá trình đó làm nó nhân đôi chính xác mọi phím. Trong ô nhập lúc đó, chữ hiện ra là "RRuunn. ii". Anh gọi app này là thứ "vibe code rác rưởi".
Anh nói anh biết nhiều thứ thế này trông như sắp đặt, như anh chỉ cố chê OpenAI và Anthropic khi cho xem, và anh không thích vậy. Gần đây anh cố không nói T3 Code là công cụ duy nhất dùng được, và anh đã dùng mọi công cụ khác để tìm tính năng tốt, để T3 Code không cạn ý tưởng hay. Rồi anh chửi thề: không có gì khác chạy cả. Anh nói T3 Code còn lâu mới hết bug, còn lâu mới hoàn hảo, theo anh còn lâu mới tuyệt; mỗi lần mở nó anh thấy rất nhiều thứ anh chỉ muốn sửa liên tục. Nhưng nó không nhân đôi phím khi bạn gõ; anh nói anh thật không thể hình dung được loại bug đó (theo lời Theo, video đăng ngày 10/11/2026).
Ít nhất model đủ năng lực xử lý được, và cuối cùng anh mở được Fish Slop. Anh nói cá chưa bao giờ "slop" hơn thế, nửa đùa: cá thật ra khá đẹp. Theo nhận xét của anh (demo trong video đăng ngày 10/11/2026), có nhiều chi tiết nhỏ nó làm chưa đúng; anh cũng phải bảo nó làm lượt thứ hai vì bản đầu đồ hoạ và điều khiển chưa tốt nhất. Vòng lặp gameplay cũng chưa ổn: anh không thích chơi bản này bằng bản Opus, dù nó trông đẹp hơn khá nhiều và các model 3D đẹp hơn đáng kể.
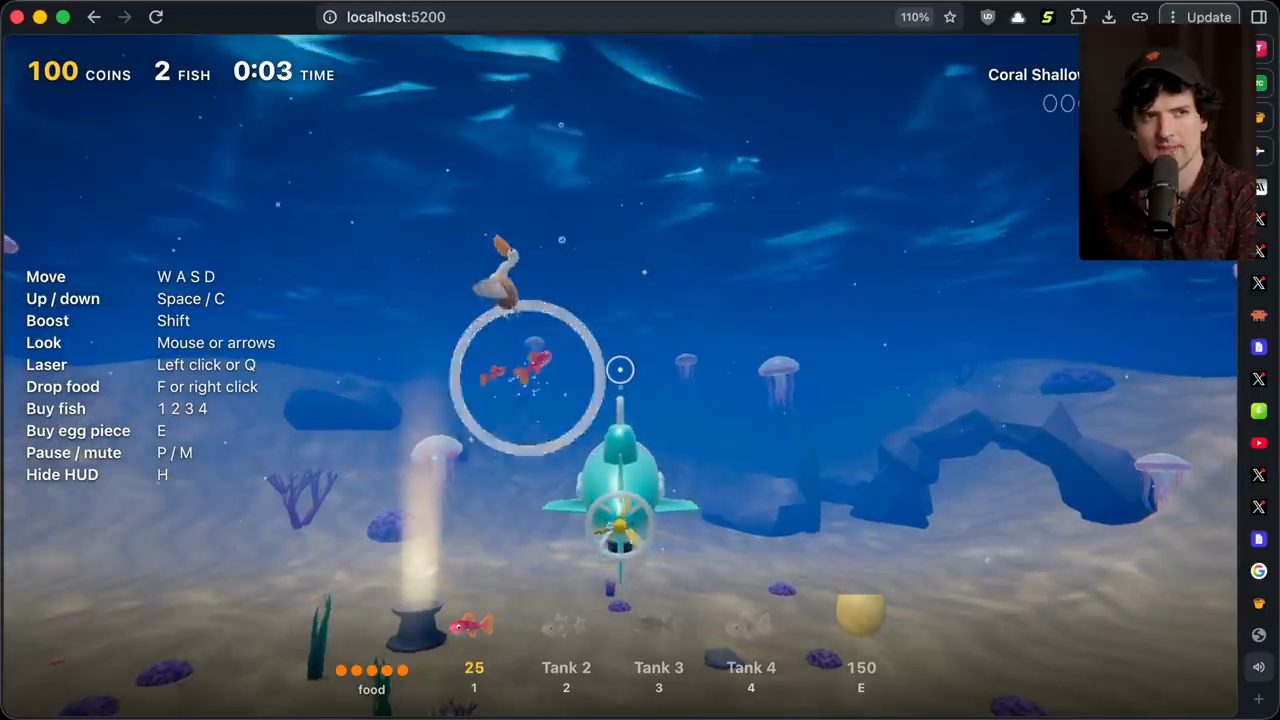
Theo anh (video đăng ngày 10/11/2026), đó là thứ duy nhất mà Astra và OpenAI vẫn còn hơn: làm model trong Blender đẹp hơn, nhưng đổi lại game là một mớ giật lag, FPS thấp, trông đẹp trong ảnh chụp nhưng chạy thì tệ. Bản này chạy tốt hơn nhiều so với bất cứ thứ gì anh từng có từ một model OpenAI, và nhìn chung cũng đẹp hơn. Gameplay vẫn không cuốn bằng bản Opus, và một lần nữa anh cảm thấy kết hợp Opus và Fable là hướng đi.
Anh than build này làm hỏng chuột phải để bắn trên trackpad, nên anh không bắn được; rồi anh nhận ra là chuột trái, anh quên rằng nó đã đổi trong build thứ hai, vì điều khiển lần đầu giật cục nên anh phải đổi hết. Anh cũng thích kiểu bể hở mà nó làm ở đây (demo trong video đăng ngày 10/11/2026).
Rồi tới Fish Slop bản Opus. Theo nhận xét của anh (demo trong video đăng ngày 10/11/2026), đồ hoạ có nhiều thứ tệ hơn, nhưng cũng có nhiều quyết định nghệ thuật anh thích hơn: anh rất thích con cá đuối manta và ước có thêm những thứ như vậy thay vì toàn sứa như bản kia; anh thích animation ở bản này hơn nhiều, và các vật thể ngẫu nhiên cũng hay. Nhưng nhìn chung nó xấu hơn hẳn: có bug vật thể bị trần cắt mất, và tường là tường cứng thật thay vì là một ô nhìn ra một vùng lớn hơn nhiều. Dù vậy anh thấy gameplay ở bản này hay hơn nhìn chung, và anh đã chơi nó tới hết vì thấy vòng lặp gameplay thật sự khá vui.
Kết luận của anh ở phần này (video đăng ngày 10/11/2026): anh thấy Opus thật ra làm game vui hơn; Fable làm chúng đẹp hơn nhiều, và quan trọng hơn, giữ mạch lạc tốt hơn một chút qua các lần chạy dài.
18. Vì sao là 5.2, và kết luận
Vậy rốt cuộc thế nào? Fable 5.2 có phải model vĩ đại nhất mọi thời đại không? Theo đáp có. Nhưng anh lập luận rằng Opus 5.5 cũng vậy. Theo anh (video đăng ngày 10/11/2026), mức độ thống trị của Anthropic lúc này điên rồ: họ có model lớn tốt nhất và model, anh không biết gọi thế nào, "thực dụng" tốt nhất, vì Opus không nhỏ, cũng không ngu. Opus 5.5 chỉ là một con ngựa thồ: làm đúng những gì được bảo. Còn Fable cố tỏ ra khéo léo hơi quá.
Anh ví Fable như người bạn rất thông minh nhưng làm cùng hơi khổ, dù thật sự biết mình đang làm gì; đưa đúng bài toán thú vị, họ sẽ vào và xử lý gọn. Opus thì là gã tập thể hình vạm vỡ vào đó để khuân đồ, và nó sẽ khuân sạch mọi thứ, kể cả những thứ anh còn không nghĩ là khuân được (phép so sánh của Theo, video đăng ngày 10/11/2026).
Vậy vì sao là 5.2 mà không phải 5.5? Anh nói có nhiều cách đọc: vai trò của Model 4, model nào được train khi nào, Anthropic đang nghĩ thế nào về pre-training so với post-training, ".5" nghĩa là gì. Nhưng anh nói thật đơn giản: khi Anthropic ra Opus 4.5, nó thành model anh dùng cho mọi thứ; khi Anthropic ra Opus 5.5, nó thành model anh dùng cho mọi thứ; Fable 5.2 vừa ra, và nó không phải model anh sẽ dùng cho mọi thứ. Anh hy vọng đây là tín hiệu cho thấy Fable 5.5 vẫn chưa tới, và trong tương lai một bản .5 hay .6 có thể là model anh dùng cho mọi thứ (nhận định của Theo, video đăng ngày 10/11/2026).
Theo anh (video đăng ngày 10/11/2026), 5.2 lẽ ra đã là 5.5 nếu khoảng cách giữa Opus và Fable lớn hơn; nhưng khoảng cách giữa Sonnet 5.5 và Opus 5.5 lớn hơn đáng kể so với từ Opus 5.5 lên Fable 5.2. Nếu khoảng cách bằng nhau, họ đã giữ số; không bằng, nên họ không giữ. Anh nói có rất nhiều cách đọc quá ý chuyện này, và anh rất muốn, nhưng anh chọn không làm, vì đã gần 2 giờ 30 sáng, và sự thật là các tên gọi đều do người ta đặt ra; nếu model đủ tốt để là Fable 5.5 thì nó đã là Fable 5.5. Đáng tiếc là chưa có Fable 5.5.
May là, theo anh, đã có một model Fable mới làm được những việc anh chưa bao giờ nghĩ sẽ thấy máy tính làm, huống chi một AI tự chạy. Anh nói tương lai thật điên rồ, và đây là lúc nó tệ nhất từ nay về sau. Anh rất háo hức cho một hai tháng nữa, khi nó rẻ hơn bốn lần, vì theo anh (video đăng ngày 10/11/2026) đó là khuôn mẫu mọi người vẫn thấy một cách nhất quán. Anh khen Anthropic đã "nấu" ra món ngon và xứng đáng với những chiến thắng họ có.
Anh nói anh kiệt sức, sẽ bỏ mũ ra và đi ngủ, và chỉ mong tuần này không có model mới nào ra nữa, vì chẳng ai lại tung thêm gì sau vụ này, đúng không? Nhất là khi GTA 6 sắp ra (theo lời anh, video đăng ngày 10/11/2026). Anh tự đáp: không, chắc chắn không. Anh đi ngủ, và chào "Peace, nerds."
Nguồn và liên kết 8 nguồn
- Tên gốc: Nobody Is Competing With Anthropic
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=yh5IAUow4Hc youtube.com
- Kênh YouTube Theo - t3․gg (Theo Browne): youtube.com/channel/UCbRP3c757lWg9M-U7TyEkXA youtube.com
- Bài công bố của Anthropic, "Introducing Claude Fable 5.2 and Claude Mythos 5.2" (đọc ngày 15/11/2026): anthropic.com/news/claude-fable-and-mythos-5-2 anthropic.com
- Cyber Verification Program của Anthropic (đọc ngày 15/11/2026): anthropic.com/news/cyber-verification-program anthropic.com
- Slopalytics, trang tự mô tả là so sánh các model theo intelligence, cost, speed và mức "thinking" (đọc ngày 15/11/2026): slopalytics.com slopalytics.com
- Which AI Made This?, trang tự mô tả là so sánh UI do AI tạo từ cùng một prompt, có và không có frontend design skill (đọc ngày 15/11/2026): whichai.dev whichai.dev
Related talks
Pi 1.0: Codemode, virtual model routing và Pi Durable
AICodeKing · AICodeKing · 17 min
Đi qua bản Pi 1.0: MCP native qua Codemode, Jev, virtual model routing, deferred tool, cache warming, theme mới, và Pi Durable cho agent chạy lâu.
DeepSeek Harness hay Pi: coding agent miễn phí nào thắng
Devsplainers · Devsplainers · 9 min
So Pi 1.0 và DeepSeek Harness qua sáu round: cài đặt, benchmark cùng model, chi phí, model local, tính năng sẵn có, MCP codemode và quyền riêng tư.
Local AI năm 2026: chạy model trên máy của bạn
Madeline Zhang · Maddy Zhang · 9 min
Vì sao local AI đáng học năm 2026, quantization và bộ nhớ, chạy model với LM Studio hay Ollama, coding agent, fine-tune LoRA, khi nào dùng cloud.