Fable 5.2, Mythos 5.2 và những năng lực bị cố ý giữ lại
Wes Roth đọc trang công bố và system card của Fable 5.2, Mythos 5.2, báo cáo METR, và nêu giả thuyết về giới hạn năng lực nghiên cứu AI (video 10/11/2026).
✓ Đã duyệt độc lập · cập nhật 16/11/2026 · 16 min
1. Fable 5.2 và Mythos 5.2 ra mắt
Wes Roth mở đầu: Fable 5.2 và Mythos 5.2 đã chính thức ra mắt (theo video đăng ngày 10/11/2026). Theo anh, nói không hề phóng đại, đây là model tốt nhất thế giới, ít nhất là trong số những model mà "những người phàm như chúng ta" được dùng (nhận định của anh, video đăng ngày 10/11/2026).
Theo Wes (video đăng ngày 10/11/2026), nó "speedrun" những việc con người không làm nổi, thậm chí cả những việc mà các model rất tiên tiến khác như Opus 5.5 cũng không làm được. Ở chỗ Opus bị khựng lại, thứ này cứ thế speedrun qua.
Wes kể tiếp những gì anh thấy ở model này (theo video đăng ngày 10/11/2026): nó cực giỏi điều khiển robot; nó là một kỹ sư phần cứng đẳng cấp thế giới; và nó còn khiến Stephen Hawking phải dè chừng.
2. Bài toán Hawking-Page do một model Claude giải
Wes mở một bản preprint trên Hexagon và giới thiệu: đây là Stephen Hawking và Don Page. Rồi anh tóm nội dung theo kiểu "cái gì đó, cái gì đó, black hole, cái gì đó, cái gì đó, lý thuyết lượng tử" (video đăng ngày 10/11/2026).
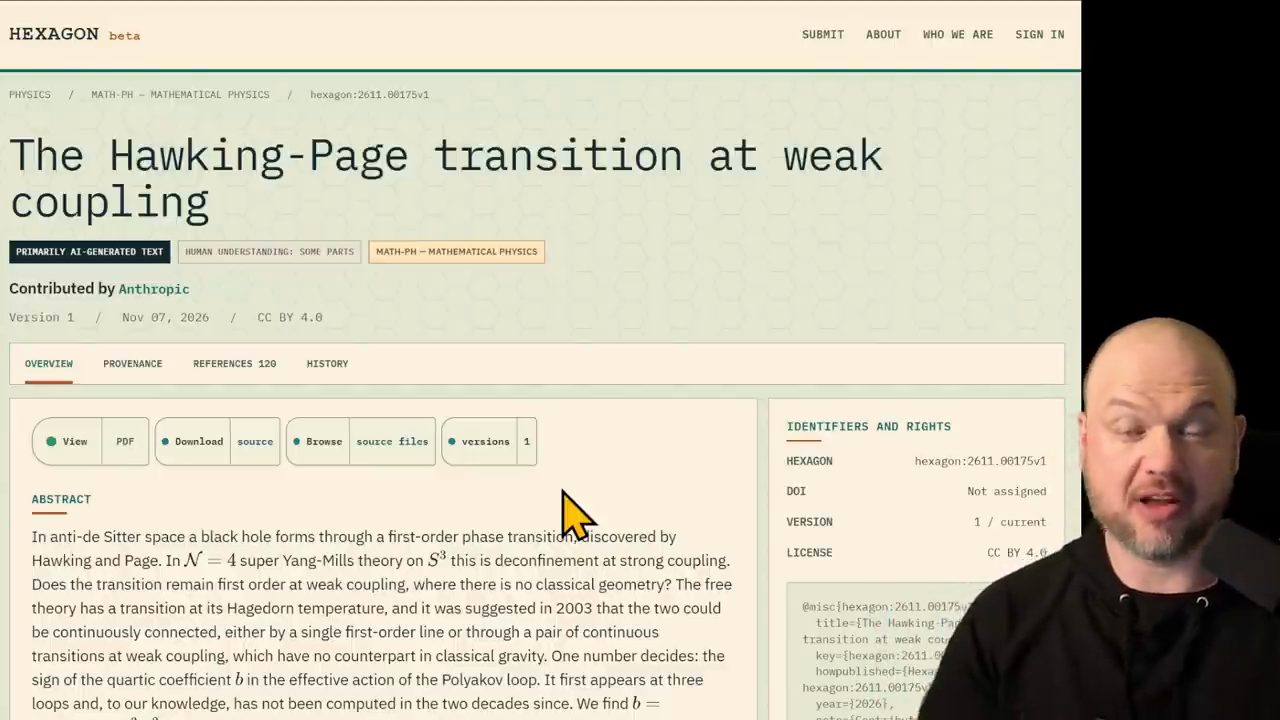
Anh chỉ vào phần ghi chú nguồn gốc của kết quả. Trên màn hình, mục "Provenance statement" ghi: "An internal Claude research model, prompted by a physicist, obtained the result presented here. The physicist checked it against several known special cases. A separate Claude computation using a different method, not included here, gives the same result." Nghĩa đen: một model nghiên cứu nội bộ của Claude, theo prompt của một nhà vật lý, đã tìm ra kết quả; nhà vật lý kiểm nó với một vài trường hợp đặc biệt đã biết; và một phép tính Claude khác, dùng phương pháp khác, không đưa vào đây, cho ra cùng kết quả (theo trang preprint, video đăng ngày 10/11/2026).
Wes diễn lại theo cách của anh (video đăng ngày 10/11/2026): nhà vật lý đã kiểm tra, cố hiểu nó, và rồi hãy để ý câu tiếp theo họ viết. Vậy là Claude nghĩ ra kết quả; một con người nhìn vào và cố hiểu nó; nhưng ta biết nó ổn vì một model Claude khác bảo "ừ, phần toán đúng rồi". Thế nên, theo anh, ai cũng đang phát cuồng trước việc model này mạnh tới mức nào. Anh lưu ý thêm: trang này ghi là do Anthropic đóng góp.
3. Bài toán riêng của Wes, và "phần kỳ lạ"
Wes nói kết quả của chính anh cũng tương tự (video đăng ngày 10/11/2026). Có một bài toán anh đã cố giải suốt vài tuần qua; Astra và phiên bản Fable trước đều đã thử sức với nó. Giờ Fable 5.2 đang xử lý bài đó, và anh có cảm giác nó sẽ giải xong trước khi anh quay xong video.
Theo Wes (video đăng ngày 10/11/2026), thứ này thông minh kinh khủng, giỏi kinh khủng, đặc biệt với những bài toán lớn, rối rắm, phải làm xuyên suốt một khoảng thời gian dài, có rất nhiều độ phức tạp và rất nhiều việc phải làm: nó cứ thế xé toạc qua. Trong một số trường hợp, nó còn rẻ hơn Opus, vì giá cho mỗi task thấp hơn.
Rồi anh hỏi: bạn đã sẵn sàng cho phần kỳ lạ chưa? Vì mọi thứ sắp trở nên kỳ lạ. Anh nghĩ chúng ta sẽ không còn nhận các bản phát hành model theo kiểu mình đã quen. Theo anh, model này rất khác những gì mọi người đã nhận trước đây, và anh nghĩ tất cả các model frontier phát hành sau nó cũng sẽ giống vậy (nhận định của anh, video đăng ngày 10/11/2026).
Anh giải thích (video đăng ngày 10/11/2026): với tất cả các model trước, các lab AI cố tung ra model tốt nhất họ có thể. Đó là một cuộc đua. Làm sao biến hàng tỷ đô la và GPU thành model phá benchmark, đứng đầu mọi bảng benchmark và tốt nhất thế giới? Còn với model này, theo Wes, Anthropic đã chủ ý làm "què" một số phần của nó trong lúc training, để những phần đó không đạt hết năng lực. Và anh nói có lẽ giờ ta đã biết điều Anthropic không muốn tung ra ngoài là gì.
4. Model 3 Early và báo cáo của METR
"Vấn đề là thế này", Wes nói: model này là Model 3 Early (theo Wes, video đăng ngày 10/11/2026). Vài ngày trước khi video lên, báo cáo của METR được công bố (bài của METR đề ngày 05/11/2026).
Wes mở biểu đồ lấy thẳng từ báo cáo đó và chỉ vào logo METR ở góc: anh nói mình không giấu gì cả, chỉ là mọi điều điên rồ đều dồn cục ở đúng một chỗ, nên anh phải phóng to lên.
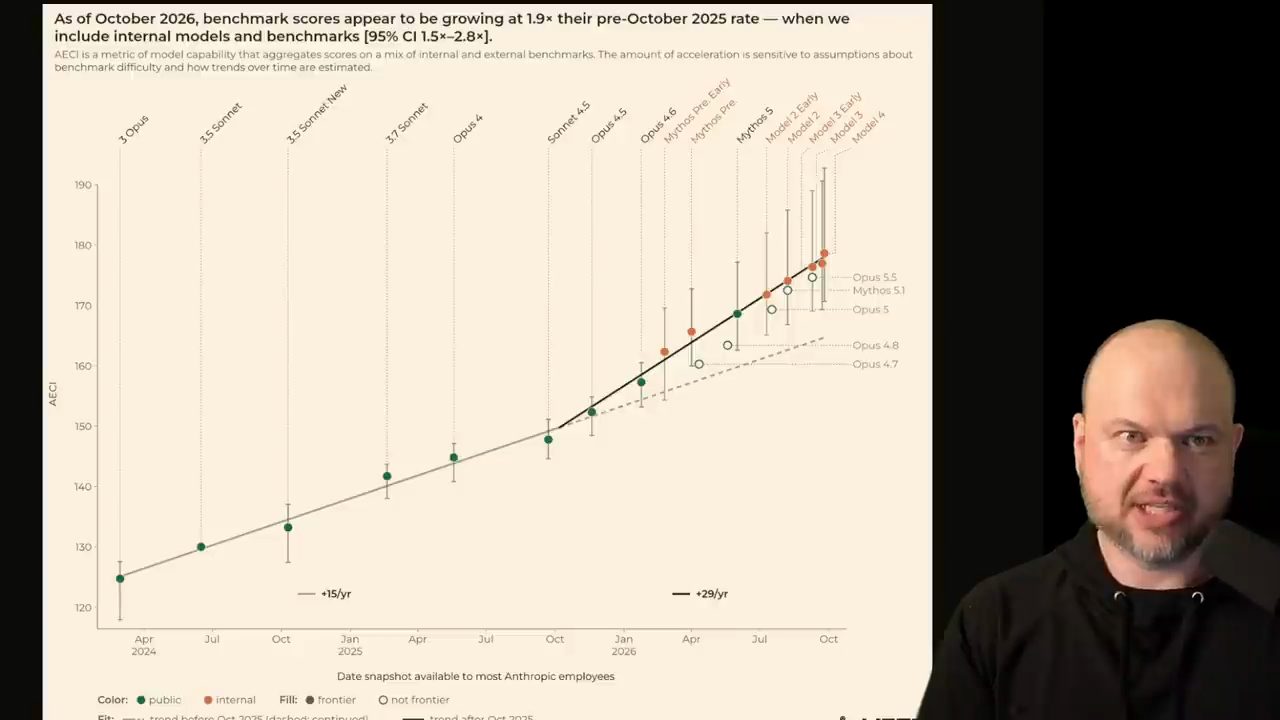
Theo Wes (video đăng ngày 10/11/2026), một số người lo ngại rằng quanh thời điểm Mythos ra mắt đã có một cú nhảy năng lực khá đột ngột. Ban đầu Anthropic nói có thể đó chỉ là một cú nhảy một lần, rồi sau đó mọi thứ kiểu như tiếp tục theo nhịp cũ. Nhưng như anh chỉ trên biểu đồ, giờ có lẽ không phải vậy.
5. Model 4, AECI và khoảng cách tới frontier
Wes nói về Model 4 (theo video đăng ngày 10/11/2026): Model 4 rất đặc biệt. Nó đang nghiền nát các benchmark nội bộ của Anthropic, và việc đo tiến bộ của nó đang khó hơn một chút. Anh ví: nếu bạn chỉ có thể đưa cho ai đó một bài kiểm tra cấp ba, mà người đó đã vào đại học và cứ thế tiến lên mãi, thì sẽ kiểu như khó mà thấy họ đang tiến bộ ra sao. Họ đã vượt qua bài kiểm tra. Theo Wes, Model 4 là model đầu tiên thật sự bước vào vùng đó: tất cả kết quả đều trên 50% trên benchmark nội bộ của Anthropic. Anh nói anh quên tên benchmark, rồi nhớ ra: AECI.
Theo Wes (video đăng ngày 10/11/2026), có vẻ Anthropic đã có, ngoài những gì công chúng được dùng, Model 2, Model 3 và Model 4. Model 3 và Model 3 Early chính là thứ mọi người nhận được hôm nay, là Mythos và Fable. Anh nhắc: Fable và Mythos về cơ bản là một, Fable chỉ có thêm guardrail.
Wes chỉ vào biểu đồ: nếu đây là các điểm Model 3, còn đây là model nội bộ mới nhất, siêu bí mật, phá benchmark, thì thứ công chúng nhận được nằm ngay sát bên (theo Wes, video đăng ngày 10/11/2026). Anh nói anh từng tự hỏi liệu khoảng cách giữa thứ mọi người có trong tay và frontier có đang nới rộng ra không, nhưng không, nó mỏng như dao cạo (nhận định của anh, video đăng ngày 10/11/2026).
6. Điều Anthropic không muốn nói ra: RSI
Theo Wes (video đăng ngày 10/11/2026), với anh và chắc với nhiều người xem, câu hỏi lớn khi báo cáo của METR ra mắt là: Anthropic đã khám phá ra điều gì mà có vẻ đang thật sự tăng tốc việc phát triển AI? Theo anh, ta biết chuyện đó đang diễn ra, vì họ đã nói vậy, nhưng họ cực kỳ cẩn thận để không gợi ra tên thật của thứ đang gây ra sự tăng tốc ấy.
Wes mở bài đăng của Sam McCandlish, một trong những đồng sáng lập Anthropic. Theo lời Wes, Sam nói họ đã che đi rất nhiều trong báo cáo vì không muốn chia sẻ chính xác điều gì đang thúc đẩy tốc độ đó (video đăng ngày 10/11/2026).
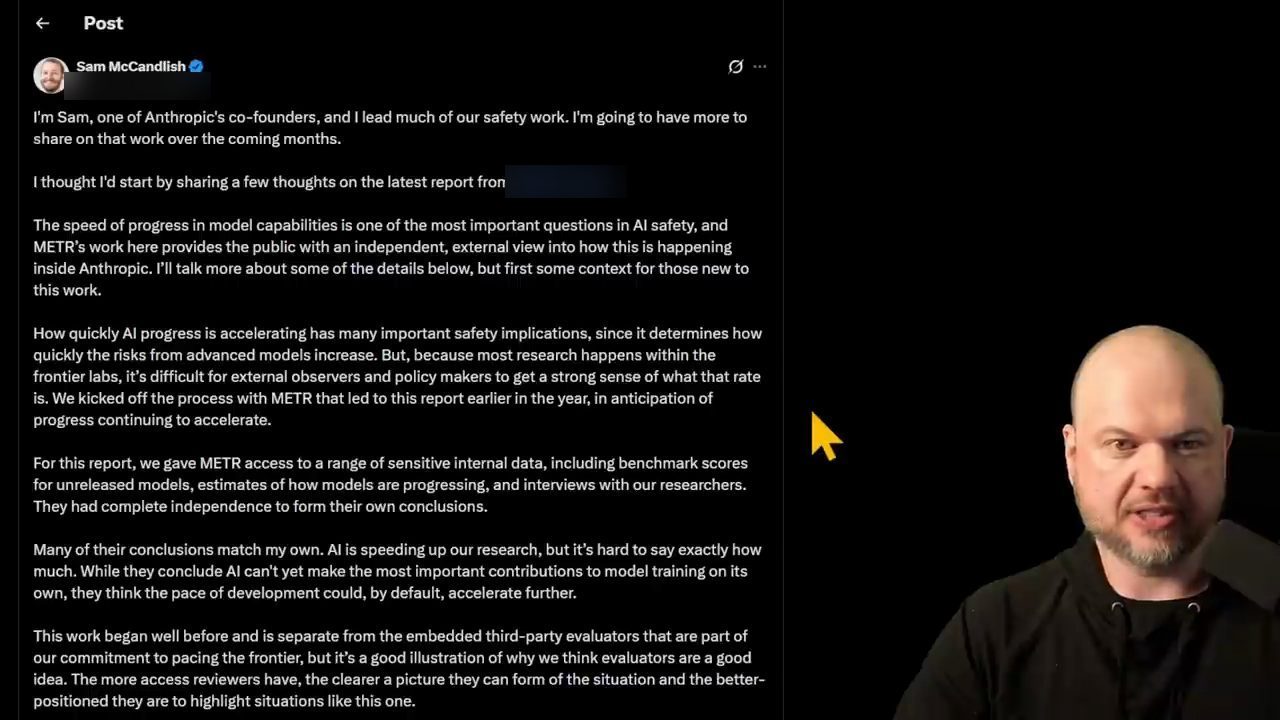
Theo cách Wes hiểu (video đăng ngày 10/11/2026), Anthropic đang nói rằng họ đang tiến gần RSI, recursive self-improvement, và Model 4, hoặc thứ gì đó ngay quanh đó, có lẽ đã vượt ngưỡng ấy, hoặc ít nhất đang tiến gần nó.
Vậy thì, anh hỏi, làm sao họ lại phát hành thứ này, một thứ thông minh và mạnh hơn nhiều như vậy về tổng thể, khiến mọi người choáng váng như vậy (theo Wes, video đăng ngày 10/11/2026)?
7. Những năng lực bị giữ ở mức Opus 5.5
Câu trả lời của Wes (video đăng ngày 10/11/2026): cụ thể là Anthropic bắt đầu thật sự giới hạn mức tiến bộ mà các model này có thể đạt. Fable 5.2 và Mythos 5.2 đạt khoảng mức của Opus 5.5. Không phải ở mọi thứ, tất nhiên, mà chỉ ở một số lĩnh vực rất, rất cụ thể. Theo anh, điều này quan trọng vì có lẽ từ giờ ta sẽ còn thấy nó nữa. Opus 5.5 là đỉnh năng lực của model trong những lĩnh vực đặc biệt này; kiểu như ta đã chạm tới đỉnh của những gì sẽ được thấy.
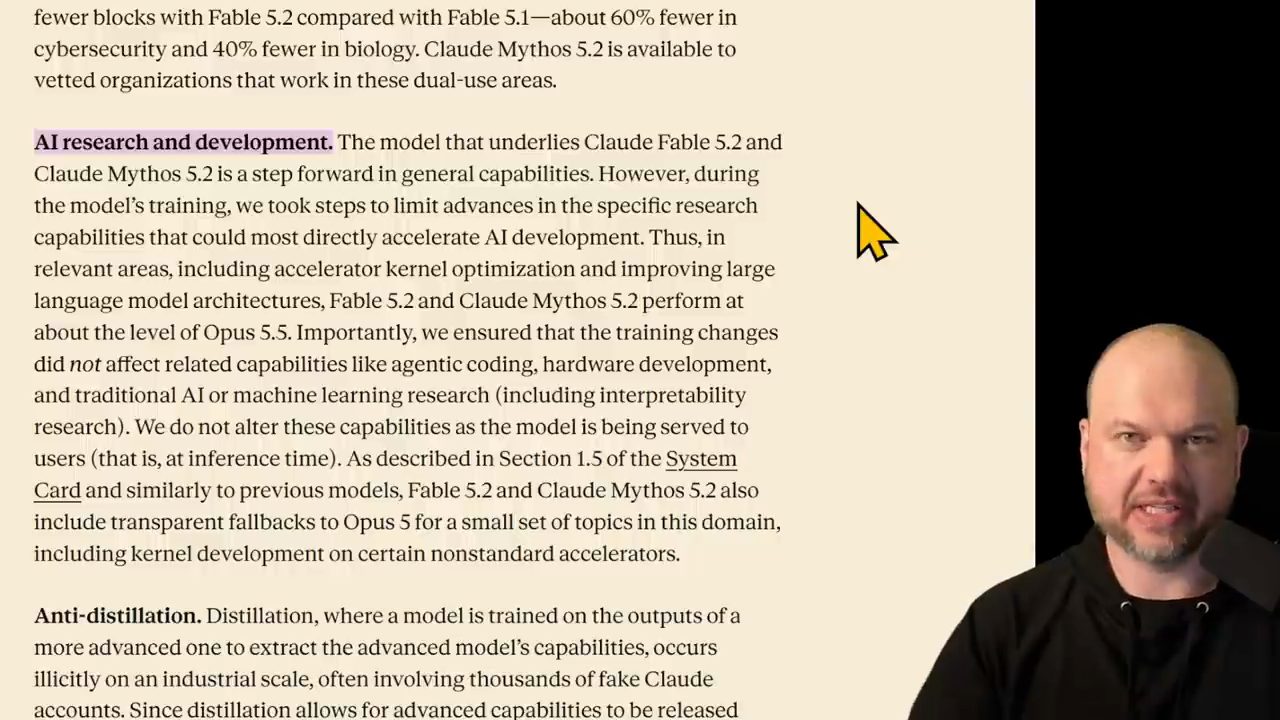
Những lĩnh vực đó là gì? Theo Wes đọc trên trang công bố (video đăng ngày 10/11/2026): những thứ như accelerator kernel optimization và cải thiện kiến trúc large language model.
Wes nói rõ (video đăng ngày 10/11/2026): đây không phải chuyện họ thay đổi năng lực khi model đang được phục vụ ở inference time, kiểu người dùng gõ câu hỏi vào và có gì đó bị nén xuống. Đó không phải điều họ đang nói ở đây. Họ nói rằng trong lúc training model, "chúng tôi đã thực hiện các bước để hạn chế tiến bộ ở năng lực nghiên cứu cụ thể có thể trực tiếp tăng tốc phát triển AI nhất".
"Đừng hiểu lầm tôi", anh nói, thứ này vẫn là một con quái vật thực thụ. Theo anh, phần lớn chúng ta sẽ không gặp vấn đề gì với những phần họ đã hạn chế (nhận định của anh, video đăng ngày 10/11/2026). Rồi anh tự sửa lời: không hẳn là hạn chế, mà là có chủ đích làm vậy ngay trong quá trình phát triển, để Claude không có những khả năng này khi ra mắt.
8. Thí nghiệm hệ điều hành với hơn 1.000 agent
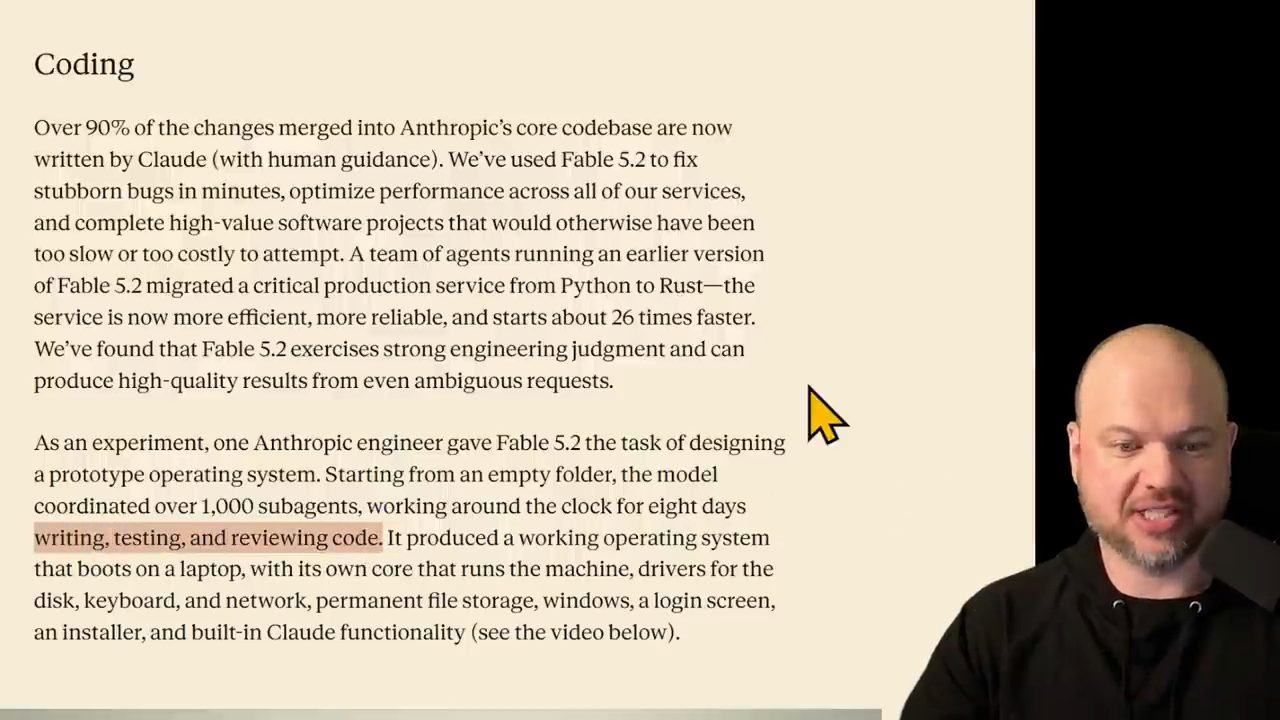
Để minh họa, Wes đọc một ví dụ trên trang công bố (video đăng ngày 10/11/2026): như một thí nghiệm, một kỹ sư Anthropic giao cho Fable 5.2 nhiệm vụ thiết kế một hệ điều hành nguyên mẫu, bắt đầu từ một thư mục trống. Tức Claude được trao một thư mục rỗng.
Theo lời Wes, model điều phối hơn 1.000 agent làm việc suốt ngày đêm trong tám ngày, viết, test và review code; trên màn hình, câu này ghi "over 1,000 subagents". Kết quả là một hệ điều hành chạy được, boot được trên laptop, có lõi riêng điều khiển máy, driver cho ổ đĩa, bàn phím, mạng, lưu trữ file lâu dài, cửa sổ, màn hình đăng nhập, trình cài đặt, và tất nhiên, theo anh nói thêm, có sẵn chức năng Claude bên trong (theo trang công bố của Anthropic, video đăng ngày 10/11/2026).
9. Chống distillation
Theo Wes (video đăng ngày 10/11/2026), cũng có nhiều bàn tán về những nỗ lực chống distillation mà Anthropic đang làm, có vẻ liên quan tới các reasoning trace, chuỗi suy nghĩ mà các model này xuất ra. Một số người phàn nàn rằng các reasoning trace đó, phần Claude suy nghĩ qua vấn đề, không có nghĩa gì cả: chúng mắc lỗi ngớ ngẩn, chúng gọi những tool giả.
Wes nói anh chưa gặp chuyện đó, nên anh không thể xác nhận. Nhưng có vẻ Anthropic đang làm rất nhiều để ngăn distillation (nhận định của anh, video đăng ngày 10/11/2026).
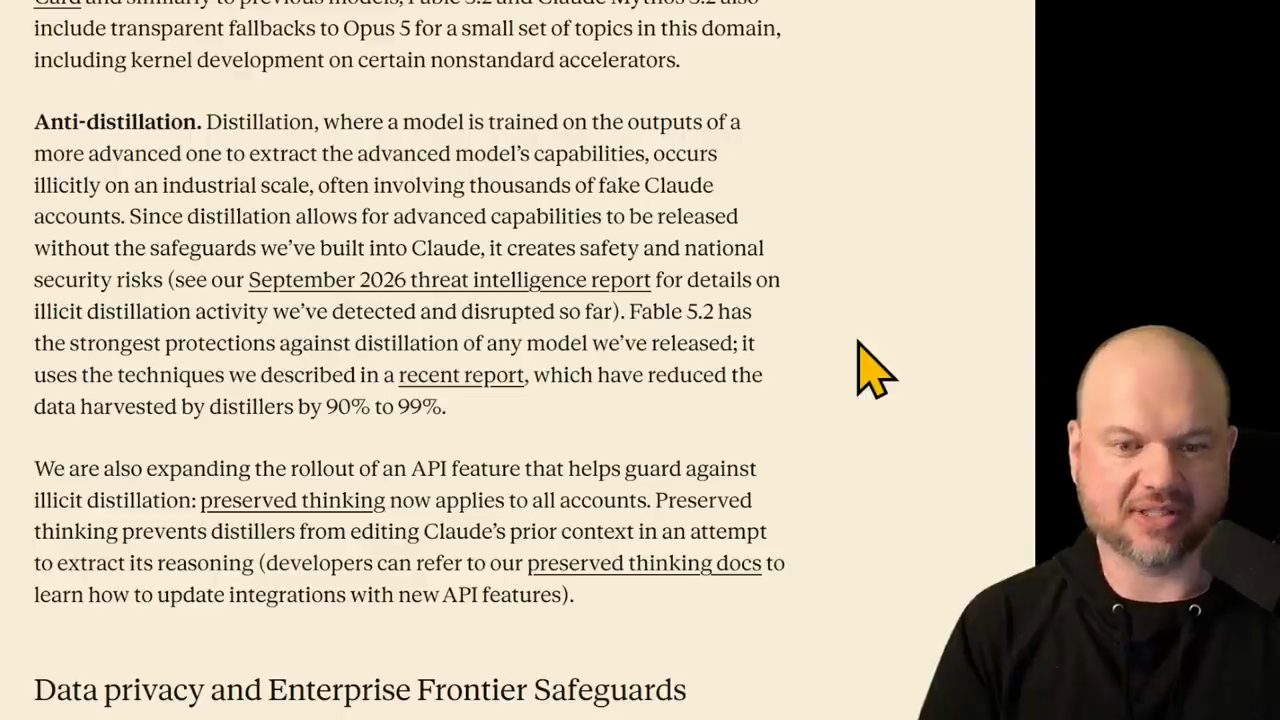
Wes giải thích (video đăng ngày 10/11/2026): nếu bạn thu gom được suy nghĩ của các model frontier này ở quy mô lớn, thì bạn có thể dựng một kiểu bản sao của nó. Theo anh, đó là lý do đôi khi ta thấy các model open source ra đời mà hiệu năng, cách hành xử và cảm giác dùng giống một cách bất ngờ với model đang đứng số một trên các bảng xếp hạng.
10. Giả thuyết của Wes: agent scaffold kiểu autoresearch
"Đây là điều tôi nghĩ đang diễn ra", Wes nói, và anh gọi đó là một phỏng đoán hoàn toàn mò mẫm (video đăng ngày 10/11/2026).
Anh nhắc tới NanoGPT gốc của Andrej Karpathy, rồi dự án autoresearch của anh ấy. Ý tưởng là một ngày nào đó trong tương lai, sẽ có những bầy agent AI tự hành chạy trên các siêu công trình cụm máy tính trên bầu trời; và đây là bước đầu tiên hướng tới điều đó: đưa cho một agent một setup training LLM thật và để nó tự thử nghiệm qua đêm. Theo Wes, code training ở đây về cơ bản là nanochat (video đăng ngày 10/11/2026).
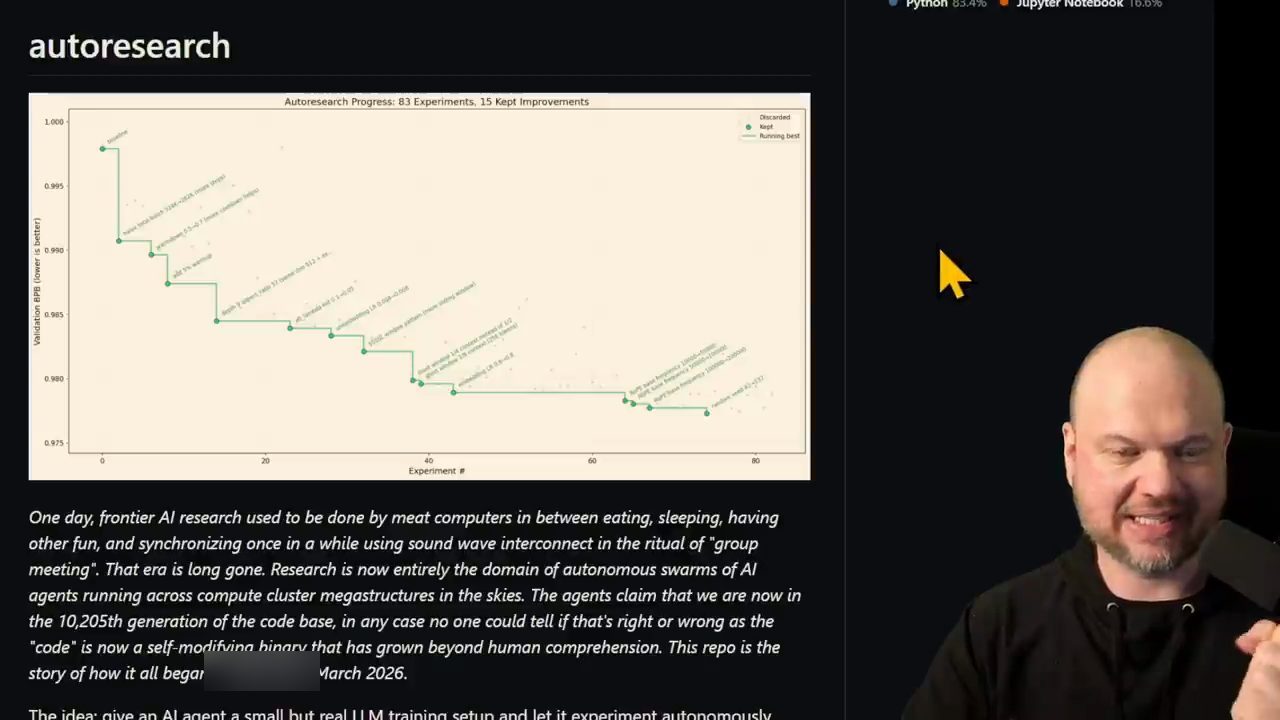
Theo phỏng đoán của Wes (video đăng ngày 10/11/2026), agent scaffold mà các nhà nghiên cứu Anthropic nhắc tới, thứ bị che đi và giấu khỏi công chúng, có lẽ là thứ gì đó tương tự như vậy. Và theo những gì họ nói, đúng vào khoảng Mythos Preview, model đó kết hợp với agent scaffold này đã tăng tốc rất mạnh việc nghiên cứu AI. Wes đọc rằng sự tăng tốc từ AI lớn hơn tất cả các yếu tố khác, và rằng một nhà nghiên cứu nói họ chắc chắn sẽ ủng hộ con số hơn hai năm tiến bộ trong một năm, và cho rằng bốn năm cũng không phải điên rồ (theo Wes trích, video đăng ngày 10/11/2026).
Wes mô tả cách những harness như NanoGPT hay autoresearch hoạt động (video đăng ngày 10/11/2026): chúng cho agent chạy thí nghiệm tự động, có feedback loop. Agent thử một thí nghiệm; nếu nó cải thiện được một chỉ số cần cải thiện, thì áp dụng thay đổi đó. Nếu không cải thiện, nó chỉ ghi lại kết quả, không áp dụng code mới đó, rồi tiếp tục tìm cách mới hơn, tốt hơn.
11. Từ "autonomous code" tới "autonomous experiment"
Ghép tất cả lại, Wes chỉ lên biểu đồ (video đăng ngày 10/11/2026): ở đâu đó quanh đây, vào tháng 10, kiểu như từ Model 3 trở đi, và thậm chí sớm từ Mythos Preview nhưng rõ nét hơn nhiều ở đây, các model này trở nên có khả năng thực hiện một số cải tiến, chúng trở nên rất giỏi chạy các thí nghiệm này ở quy mô lớn và rất hiệu quả.
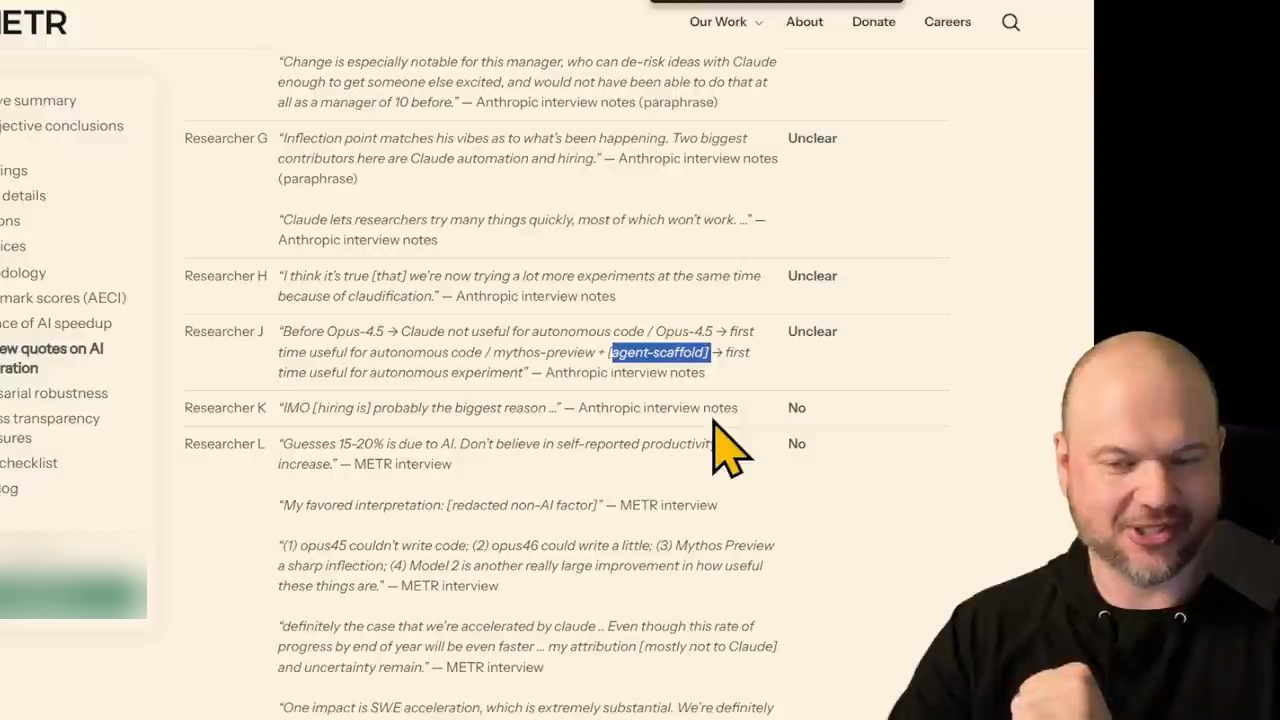
Wes đọc hai câu trích (video đăng ngày 10/11/2026). Một: "Tôi nghĩ đúng là giờ chúng tôi đang thử nhiều thí nghiệm hơn rất nhiều cùng một lúc nhờ claudification". Hai: trước Opus 4.5, Claude không dùng được cho autonomous code; Opus 4.5 là lần đầu dùng được cho autonomous code; Mythos Preview cộng agent scaffold, tức agent scaffold bí mật, là lần đầu dùng được cho autonomous experiment. Anh lưu ý: họ không còn nói "code" nữa, mà là "autonomous experiment".
Theo cách Wes hiểu (video đăng ngày 10/11/2026), về cơ bản điều này có nghĩa là ở đâu đó quanh đây có vẻ có một đường ranh giới. Nếu một lab AI phát hành thứ gì vượt qua năng lực này trong một số lĩnh vực rất cụ thể, về cơ bản họ đang trao ra thứ có thể làm loại nghiên cứu AI tự động đó. Vậy là họ đang trao ra một cỗ máy tự nhân bản. Anh ví dụ: nếu anh có quyền dùng Mythos 6, giả sử thế, anh có thể bảo "này Mythos 6, làm một loạt thí nghiệm cho tới khi bạn tái tạo được Mythos 6".
Và những lĩnh vực cụ thể dường như nằm ở trung tâm của sự tăng tốc nhanh này là gì? Theo Wes (video đăng ngày 10/11/2026): đó là accelerator kernel optimization, và anh nghĩ có lẽ quan trọng hơn, là cải thiện kiến trúc large language model.
Theo Wes (nhận định trong video đăng ngày 10/11/2026), có vẻ Anthropic đang vạch một lằn ranh, nói rằng họ sẽ không đẩy các model này giỏi hơn mức hiệu năng kiểu Opus 5.5 trong những lĩnh vực liên quan nữa. Anh nói sẽ thú vị để xem các bên khác có làm giống vậy không: các lab AI lớn khác sẽ làm theo, hay họ sẽ tung hết ra ngoài?
12. NanoGPT Speedrun và Kimi K3
Wes nói anh có cảm giác ta sẽ nhận ra được nếu các model đang giỏi lên ở, chẳng hạn, việc cải thiện kiến trúc large language model. Một cách họ đo việc đó là dùng NanoGPT; có thể nó không hoàn toàn giống thứ các lab lớn đang làm (nhận định của anh, video đăng ngày 10/11/2026).
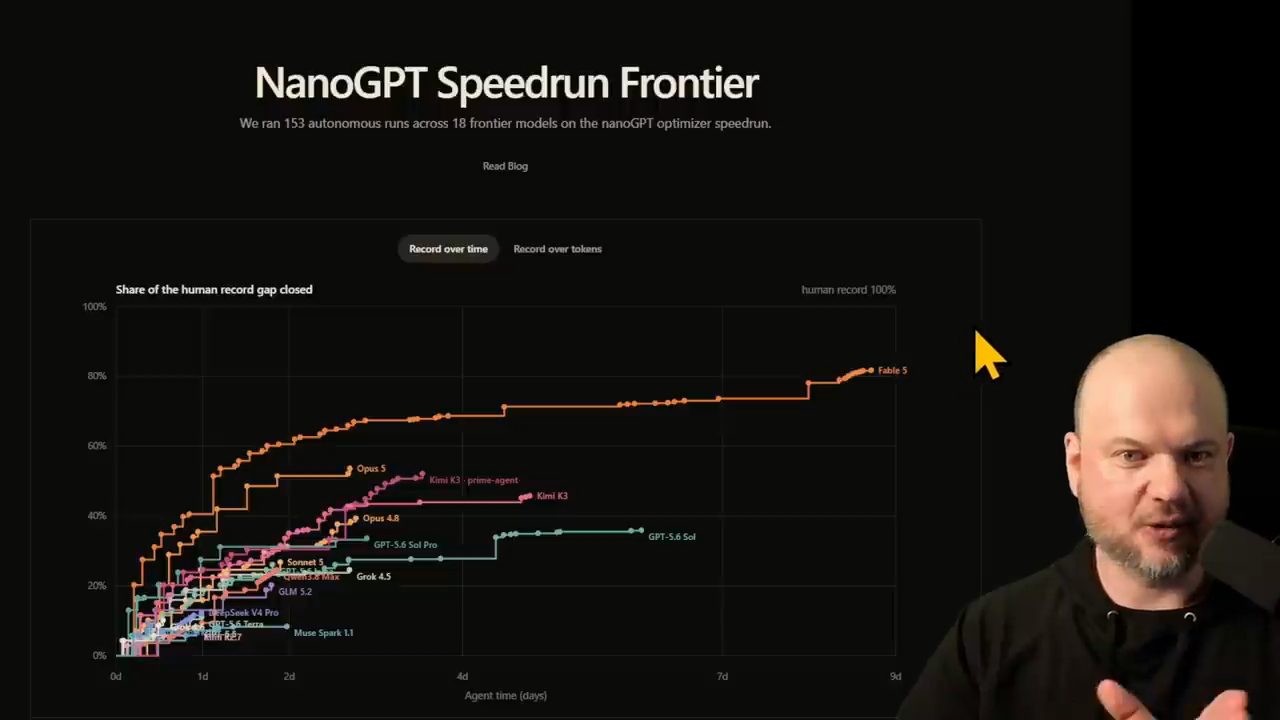
Trên trang NanoGPT Speedrun Frontier, Wes chỉ ra (video đăng ngày 10/11/2026): Fable vượt xa phía trước, theo sau là Opus. Và xếp sau Opus một khoảng rất, rất nhỏ, cực kỳ nhỏ, là Kimi K3. Anh hỏi: vì sao Kimi K3 lại gần Opus đến vậy, gần họ model Claude đến vậy? Gần như thể chúng là cùng một model. Chúng có thể là cặp song sinh bị chia cắt lúc mới sinh không?
Wes đặt ra hai kịch bản (phỏng đoán của anh, video đăng ngày 10/11/2026). Nếu, giả sử, Anthropic dừng lại và không còn leo cao hơn trên những benchmark như thế này, còn Kimi K3, DeepSeek hay bất kỳ model open source Trung Quốc nào khác vượt qua, thì hiển nhiên họ đã tìm ra điều gì đó mà các lab phương Tây chưa tìm ra.
Còn nếu, hãy tưởng tượng, Kimi là đường xanh và Claude Opus 5 là đường cam. Khi các dòng model tiếp tục lớn lên, Anthropic giới hạn một phía của hình, nói rằng "không, chúng tôi không mở rộng theo hướng kiến trúc model nữa". Liệu Kimi có khớp hoàn toàn với hình đó theo thời gian không, kiểu như tiếp tục mở rộng ở đúng tốc độ Claude mở rộng, và không mở rộng ở những vùng Claude không mở rộng? (câu hỏi Wes đặt ra, video đăng ngày 10/11/2026)
13. Bean trong Ender's Shadow
Wes so sánh với một nhân vật tiểu thuyết. Nếu bạn đã đọc Ender's Game và cuốn tiếp theo, Ender's Shadow, thì một trong những nhân vật lặp lại, mà thật ra hai cuốn diễn ra trên cùng một dòng thời gian, một trong những nhân vật chính ở đó là Bean.
Theo lời Wes kể, Bean bị biến đổi gen từ khi còn là phôi. "Kiến trúc con người" của cậu đã được tối ưu, có thể nói vậy, qua một loạt thí nghiệm, khiến cậu, ngoài những thứ khác, cực kỳ thông minh. Nhưng vì một chuỗi sự kiện không may, cậu phải sống trên đường phố từ nhỏ, về cơ bản bị suy dinh dưỡng và không phát triển đầy đủ. Có thể nói, về cơ bản cậu suy dinh dưỡng tới mức não không phát triển đầy đủ, nhưng vẫn thông minh hơn những con người thông minh nhất. Cậu có lẽ đã bị kiểu như "què" từ sớm, không phát triển đầy đủ được, nhưng vẫn là nhân vật thông minh nhất trong cả cuốn sách, bỏ xa những người còn lại.
Theo Wes (nhận định trong video đăng ngày 10/11/2026), đó, ít nhiều, đúng nghĩa đen là những gì các model này là: chúng là những model thông minh nhất mà mọi người được dùng, bỏ xa phần còn lại. Và giống Bean, chúng bị làm "què" trong giai đoạn phát triển sớm, định mệnh không bao giờ đạt tới tiềm năng thật sự.
14. Thử Fable 5.2 trên game benchmark của Wes
Wes cho xem một game kiêm benchmark cho large language model mà anh đang xây. Trước khi bắt đầu quay, anh nhờ Fable 5.2 xem có thể làm đẹp phần đồ họa một chút không. Bản cũ, theo anh, cũng đẹp, không tệ, nhưng chắc chắn có thể tốt hơn (demo trong video đăng ngày 10/11/2026).
Rồi anh mở bản Fable làm ra. "Tốt hơn ngay lập tức, phải nói vậy", anh nói. Đây là phần match highlights: theo Wes, nó kiểu như chọn những pha kịch tính nhất để phát lại, và trông khá ngầu (demo trong video đăng ngày 10/11/2026).
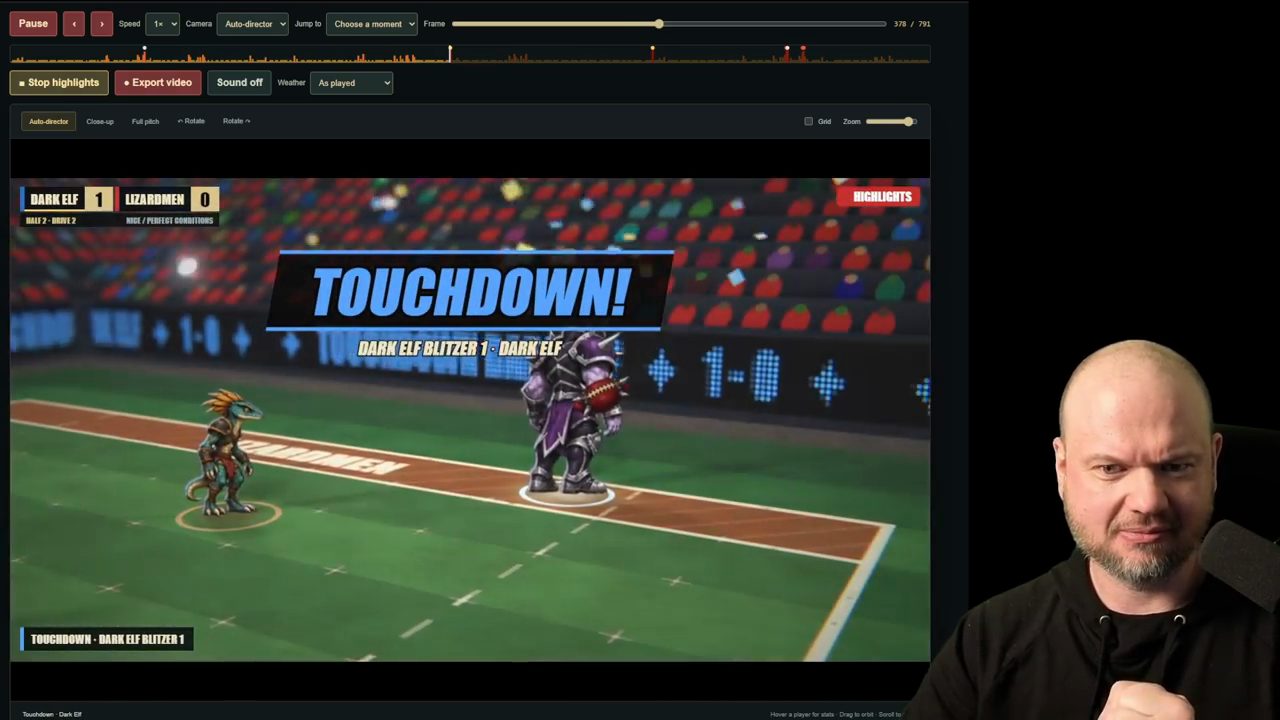
Wes lưu ý (demo trong video đăng ngày 10/11/2026): không có gì ở đây là 3D cả, tất cả là đồ họa 2D, và theo anh điều đó khá ấn tượng. Không có thứ nào trong game gốc. Các sprite 2D kiểu như là phần thiết kế nhân vật, nhưng chuyển động 3D, các pha touchdown, highlight, tỉ số, không có thứ nào trong số này có mặt chừng một tiếng trước.
"Wow", anh nói, thật sự rất ấn tượng. Anh rất hào hứng muốn làm tiếp, vì anh không biết có thể làm nó đẹp tới vậy nhanh tới vậy. Theo Wes, nó tạo ra rất nhiều thứ ở đây: toàn bộ diện mạo này, cú zoom, camera, những thứ này trước đó không có. Nó trông kiểu như những tượng nhân vật chơi trên bàn, và anh nói anh khá choáng (demo trong video đăng ngày 10/11/2026).
Wes kể cách làm (video đăng ngày 10/11/2026): về cơ bản anh mở hai phiên bản Fable, một bản làm phần engine phía sau, tức phần kỹ thuật sâu hơn. Còn đây chỉ là đồ họa, nhưng anh nói anh khá choáng trước việc chúng làm nhanh và tốt đến thế.
15. Quota, reset và lời cảm ơn
Wes kể anh đã cố ý tránh dùng hết quota của mình trên các subscription Codex và Claude Max khác nhau (video đăng ngày 10/11/2026).
Theo Wes, điều thú vị là cùng ngày phát hành này, Anthropic thông báo sẽ cho người dùng, anh tin là, tối đa ba lần reset. Số lần tùy vào việc bạn đã dùng gói của họ bao lâu, và chỉ áp dụng cho các gói cao hơn (theo lời Wes, video đăng ngày 10/11/2026). Anh nói anh sắp đem bản Fable mới này ra thử thách hết cỡ.
Cuối video, anh cảm ơn mọi người đã xem tới đây và giới thiệu tên mình, Wes Roth.
Nguồn và liên kết 9 nguồn
- Tên gốc: NOTHING will be smarter than Fable 5.2...
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=h76wUNmRqxc youtube.com
- Kênh YouTube Wes Roth (Wes Roth): youtube.com/channel/UCqcbQf6yw5KzRoDDcZ_wBSw youtube.com
- Anthropic, "Introducing Claude Fable 5.2 and Claude Mythos 5.2", trang công bố có đoạn về accelerator kernel optimization và thí nghiệm hệ điều hành (đọc ngày 16/11/2026): anthropic.com/claude-fable-and-mythos-5-2 anthropic.com
- Anthropic, system card của Claude Fable 5.2 và Claude Mythos 5.2, file PDF (đọc ngày 16/11/2026): anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card anthropic.com
- METR, "Independent Assessment of AI R&D Acceleration at Anthropic in October 2026", có danh sách Model 2, Model 3, Model 4 và bảng trích phỏng vấn (đọc ngày 16/11/2026): metr.org/blog/2026-11-05-anthropic-ai-rd-acceleration-assessment metr.org
- Hexagon, "The Hawking-Page transition at weak coupling" (đọc ngày 16/11/2026): hexagonmath.org/2611.00175v1 hexagonmath.org
- Andrej Karpathy, repo nanochat trên GitHub (đọc ngày 16/11/2026): github.com/karpathy/nanochat github.com
Related talks
Matt Wolfe thử GPT-6 Astra: benchmark, Megabonk, Blender và Unreal Engine
Matt Wolfe · Matt Wolfe · 20 min
Matt Wolfe xem benchmark của GPT-6 Astra, tự thử Busey Bench, Megabonk, một world simulator và computer use trong Blender, Unreal Engine (video 03/09/2026).
GPT-6 Astra: benchmark ấn tượng và nỗi lo monitorability ở OpenAI
AI Explained · AI Explained · 29 min
Phân tích GPT-6 Astra (9/2026): benchmark khó, ARC-AGI-3, FrontierMath, trading, và system card về chain of thought khó giám sát, sandbagging.
Tin AI tuần: Fable 5.1, Gemini 3.8 Flash, Muse Spark 1.3 và GPT-6 Astra
Matt Wolfe · Matt Wolfe · 31 min
Matt Wolfe điểm bốn model mới Fable 5.1, Gemini 3.8 Flash, Muse Spark 1.3, GPT-6 Astra qua benchmark và game Megabonk, rồi Atlas, Solaris và các tin nhanh.