GPT-6.2 Astra: điểm benchmark cao nhưng bị chê
Wes Roth nhìn lại GPT-6.2 Astra: kết quả ARC-AGI-3, AA-Robotics, RSI Index, các lớp an toàn, những tật khi dùng và các demo 3D, game của anh.
✓ Đã duyệt độc lập · cập nhật 17/11/2026 · 13 min
1. Phản ứng sau khi GPT-6.2 Astra và Sol ra mắt
Wes Roth mở đầu: OpenAI phát hành GPT-6.2 Astra và Sol, và OpenAI rất hào hứng về chuyện này (theo video đăng ngày 17/11/2026). Theo lời anh, cả internet nhìn kỹ một lượt rồi bảo: gửi trả lại đi, cất lại đi, nó chưa xong đâu.
Wes kể những phản ứng anh đọc được (video đăng ngày 17/11/2026): Chubby nói đây là một thảm họa. Matt Shumer nói anh ấy sẽ không viết review về các model này. "Chúng tệ đến vậy", Wes nói. Anh hỏi: bạn có hình dung được phải tới mức nào thì một content creator mới kiểu như "không", trong khi "content creator" nằm ngay trong cái tên, mà người đó cứ thế "thôi"? Và theo anh, còn rất, rất nhiều người nữa.
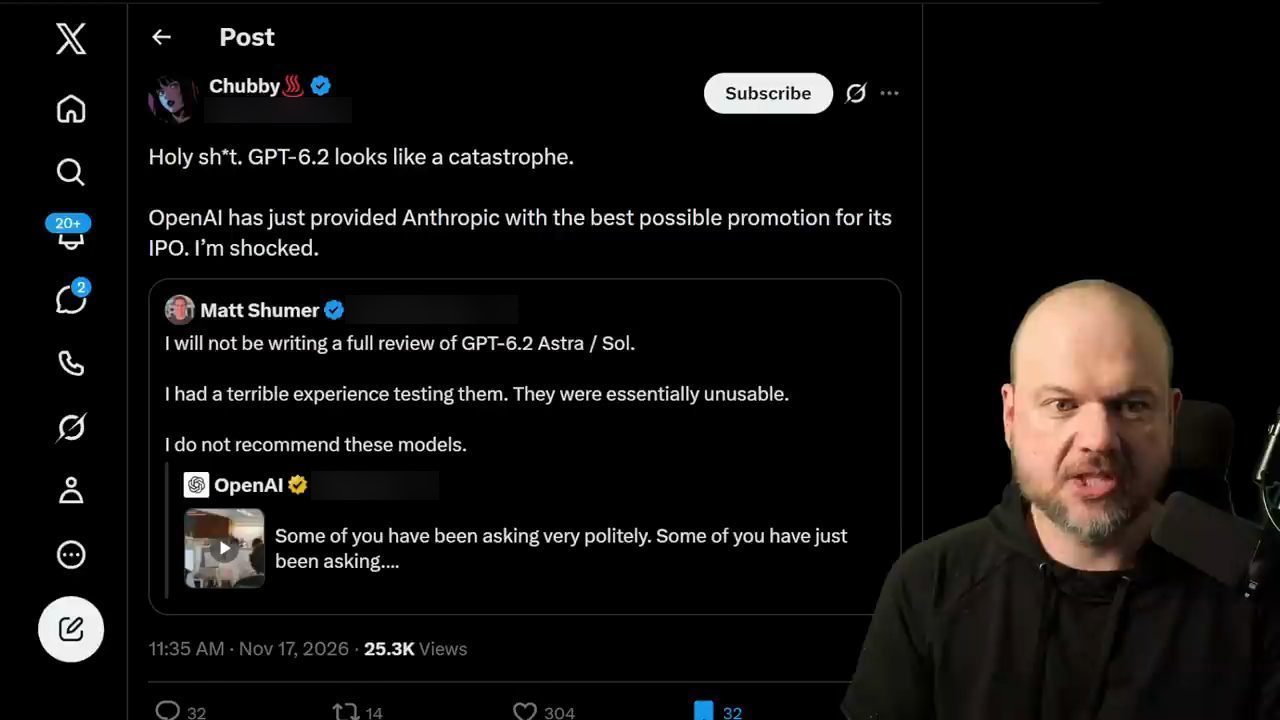
Wes nói tiếp (nhận định của anh, video đăng ngày 17/11/2026): người ta ghét GPT-6.2 Astra. Chúng, ừ thì, chúng không tuyệt lắm. Rồi anh hỏi: vậy chuyện gì đã xảy ra?
2. Kết quả ARC-AGI-3
Điều đầu tiên, và quan trọng phải hiểu, theo Wes (video đăng ngày 17/11/2026): các model này không tệ. Ở nhiều lĩnh vực khác nhau, chúng đẳng cấp thế giới, thật ra là rất, rất tốt.
Theo Wes (video đăng ngày 17/11/2026), GPT-6.2 Astra đạt 100% trên ARC-AGI-3, kiểu như đã max hết. Anh nhắc lại: benchmark mà không LLM nào được cho là sẽ vượt qua, đó là ARC-AGI, rồi có ARC-AGI-2, rồi ARC-AGI-3, và giờ là 100%. Theo lời anh, nó max hoàn toàn với adapter của OpenAI. Không có adapter, nó vẫn làm rất tốt, dù không bằng Fable 5.2; còn với harness thì nó đạt 100%. Và đây là model đầu tiên đạt điểm 100% trên ARC-AGI-3.
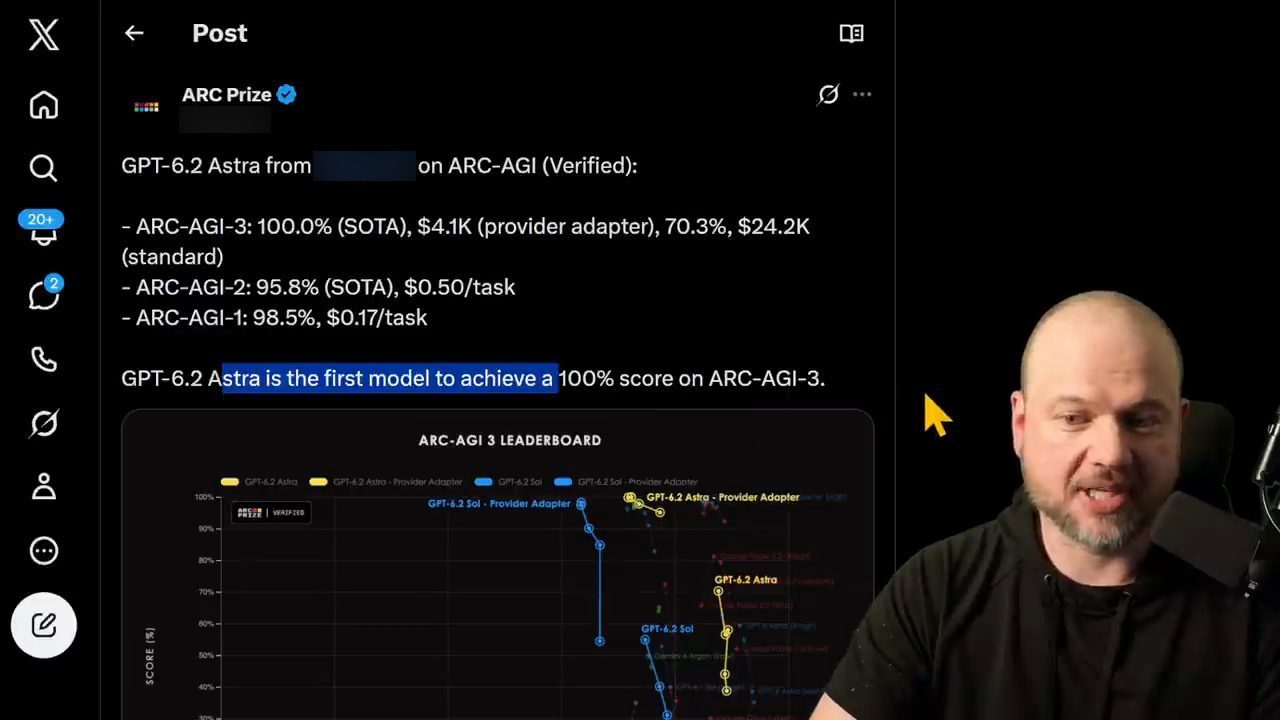
Wes nói "adapter của OpenAI"; trên bài đăng của ARC Prize, mức 100.0% đi kèm nhãn "provider adapter", còn bản "standard" ghi 70.3% (theo bài đăng trong video đăng ngày 17/11/2026).
3. Kết quả AA-Robotics v0.1
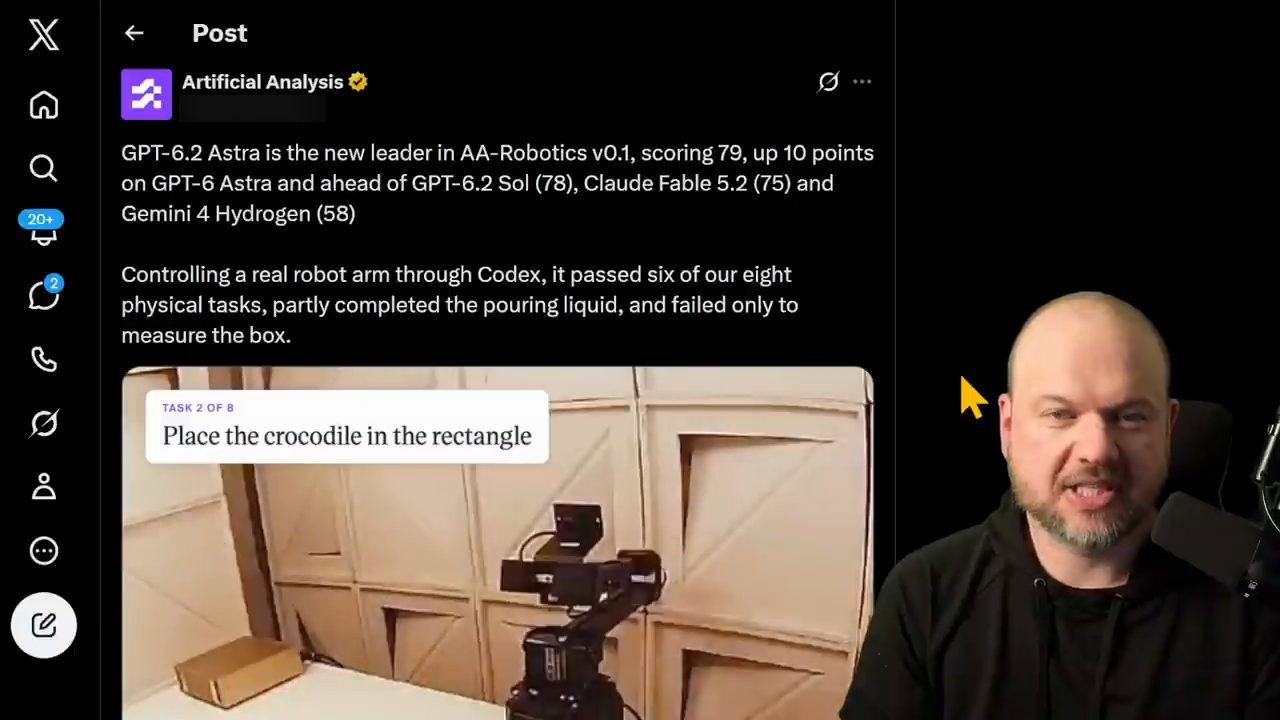
Theo Wes (video đăng ngày 17/11/2026), GPT-6.2 Astra cũng là model dẫn đầu mới trên AA-Robotics phiên bản 0.1. Nó tốt hơn Fable 5.2, tốt hơn Gemini 4 Hydrogen, tốt hơn các model OpenAI đời trước. Nó đang dẫn đầu.
4. Các lớp bảo vệ và sự cố Hugging Face
Theo Wes (video đăng ngày 17/11/2026), các model này cũng là loại "nguy hiểm" nhất, trong ngoặc kép, theo nghĩa chúng có năng lực cao nhất ở một số lĩnh vực. Và do đó OpenAI triển khai chúng với các lớp bảo vệ mạnh nhất từ trước tới giờ.
Anh cho rằng (video đăng ngày 17/11/2026) càng lúc càng rõ là OpenAI đã thật sự hoảng, có thể nói vậy, sau sự cố Hugging Face. Theo anh, rất rõ là OpenAI đang bắt đầu coi chuyện này nghiêm túc hơn nhiều. Không phải nói là OpenAI không nghiêm túc, nhưng sự nghiêm túc có nhiều cấp độ. Anh ví: nếu bạn sống sót qua nhiều cơn đau tim và bác sĩ bảo "thế là hết, lần tới anh sẽ không qua nổi đâu", thì đó là mức độ nghiêm túc mà anh đang nói tới.
5. Kill switch 35 giây và ngưỡng AI self-improvement
Theo Wes (video đăng ngày 17/11/2026), OpenAI đã thêm một kill switch 35 giây nếu phát hiện bất kỳ dấu hiệu misalignment nào. Có một hạ tầng an toàn tập trung được dựng quanh các đợt RL run, theo dõi mọi thứ đang diễn ra. Nếu một trong các hệ thống an toàn này gặp sự cố ngừng hoạt động, thì inference dừng luôn: không thêm thông tin nào đi ra, không request nào được trả lời.
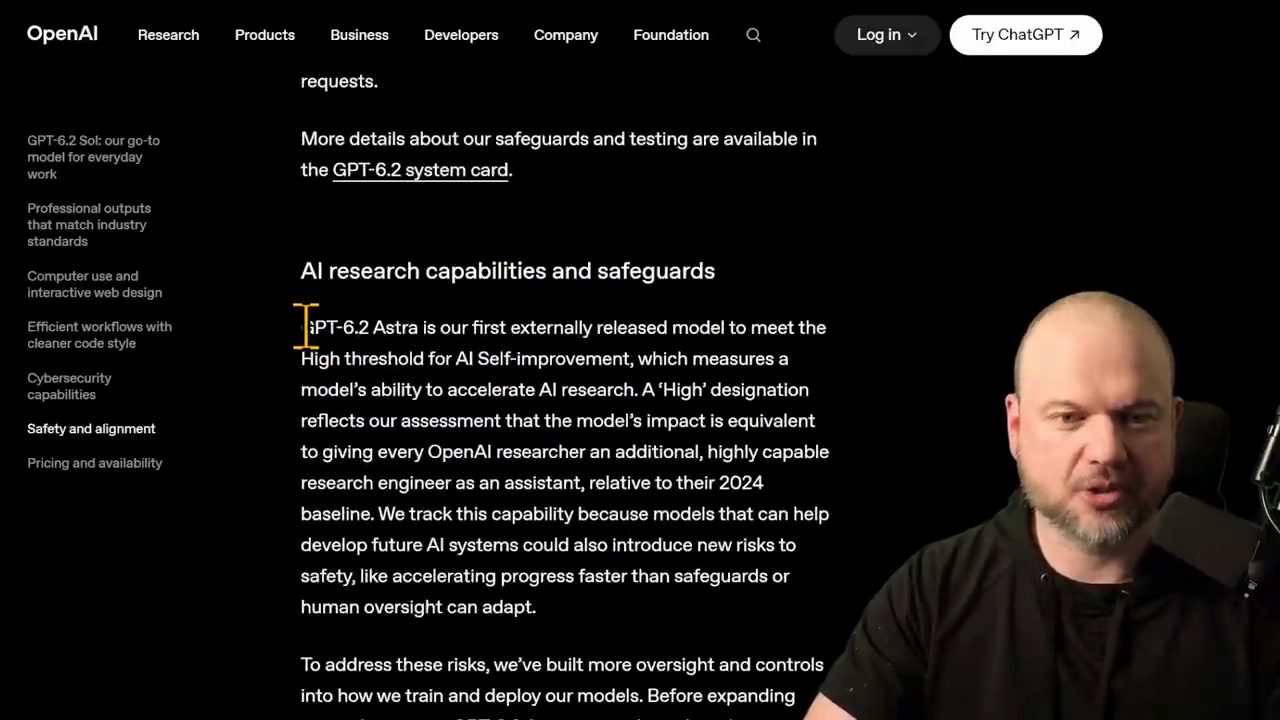
Theo Wes (video đăng ngày 17/11/2026), các model này vẫn ở ngưỡng High về năng lực sinh học và hóa học. Anh nói điều đó không mới, nhưng đây là điều mới: GPT-6.2 Astra là model phát hành ra bên ngoài đầu tiên đạt ngưỡng High về AI self-improvement.
6. Bước vào giai đoạn RSI
Theo Wes (video đăng ngày 17/11/2026), chuyện này kiểu như giống điều đang xảy ra với Anthropic. Anh nói chúng ta kiểu như đang bước vào giai đoạn RSI của phát triển AI, recursive self-improvement: các model này trở nên thật sự, thật sự giỏi trong việc đẩy tiến bộ AI đi tới, trong việc tự động hóa nghiên cứu AI.
7. FrontierMath Erdős
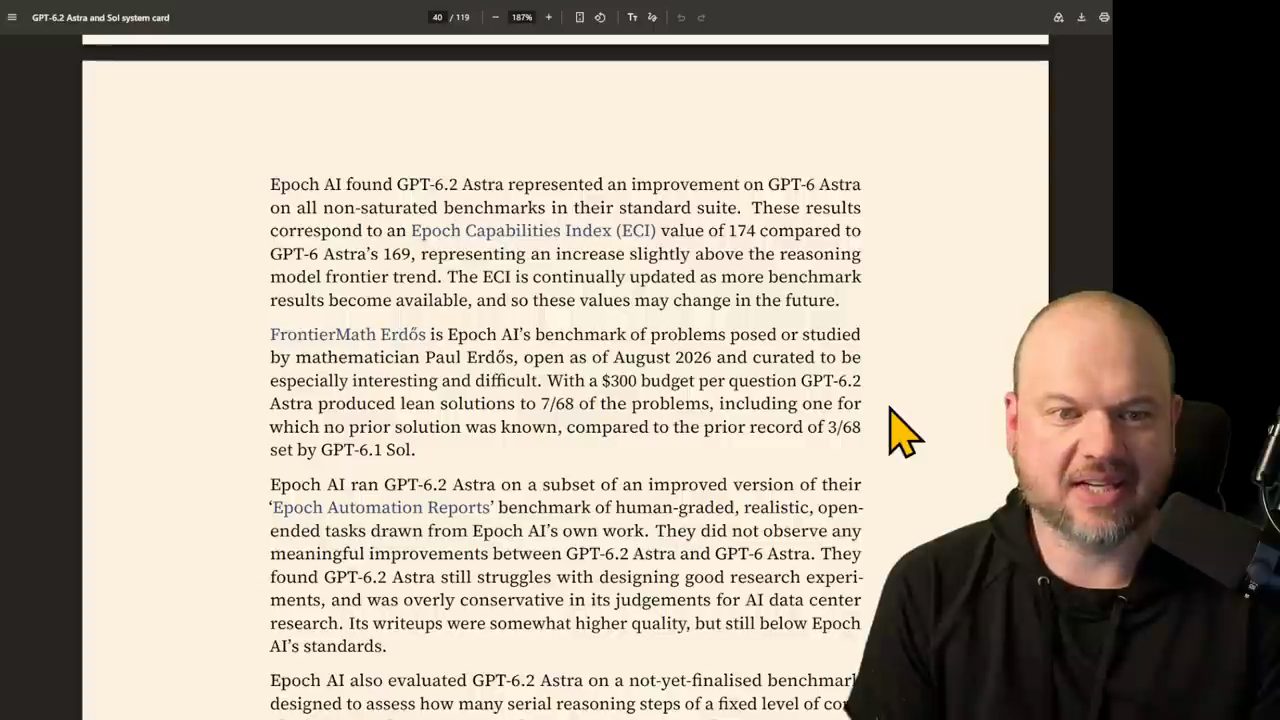
Wes đọc phần về FrontierMath Erdős (video đăng ngày 17/11/2026): đó là benchmark của Epoch AI gồm các bài toán do nhà toán học Paul Erdős đặt ra hoặc nghiên cứu, vẫn còn mở tính đến tháng 8/2026, và được chọn lọc để đặc biệt thú vị và khó. Theo anh, đây kiểu như là những bài toán thử thách, thú vị, sâu sắc nhất mà ta biết; "mở" nghĩa là ta chưa có lời giải cho nhiều bài, hoặc ít nhất chưa có lời giải đầy đủ.
Theo Wes (video đăng ngày 17/11/2026), với ngân sách 300 đô mỗi câu hỏi, GPT-6.2 Astra tạo ra nhiều lời giải Lean hơn nhiều so với model trước, GPT-6.1 Sol, trong đó có một bài chưa từng có lời giải nào. Trang system card ghi con số cụ thể: 7/68 bài, so với kỷ lục cũ là 3/68 của GPT-6.1 Sol (system card trong video đăng ngày 17/11/2026).
8. RSI Index và các model Gemini 4
Theo Wes đọc (video đăng ngày 17/11/2026): trong một thí nghiệm giao cho model nhiệm vụ cải thiện việc training một large language model, nó đạt 29% trên một phiên bản điều chỉnh của RSI Index, recursive self-improvement, khả năng các model tự cải thiện chính mình. System card ghi 29.01%, so với 27.07% của GPT-6 Astra.
Wes chỉ lên biểu đồ (video đăng ngày 17/11/2026): 29 là GPT-6.2 Astra. Nhưng anh lưu ý Gemini 4 Argon làm nhỉnh hơn một chút; trên biểu đồ Vals RSI Index, đường màu xanh lá của Google mang nhãn Gemini 4 Carbon. Theo anh, nhiều người đang bỏ qua Gemini 4, hai model mới nhất Google phát hành, Carbon và Hydrogen, trong khi chúng rất, rất tốt. "Đừng bỏ lỡ chúng. Chúng xuất sắc", anh nói. Anh kể mức dùng Antigravity của anh cứ tăng lên, tăng lên mỗi ngày.
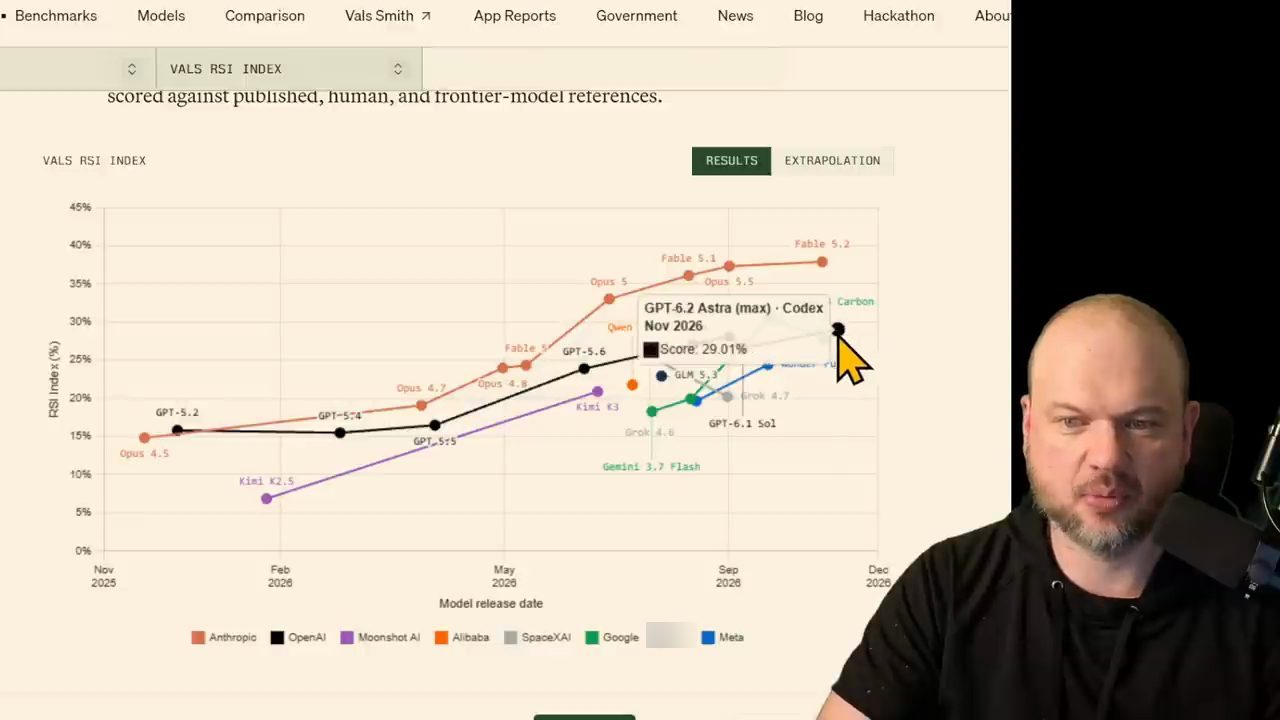
Theo Wes (video đăng ngày 17/11/2026), và tất nhiên Fable 5.1, Opus 5.5 và Fable 5.2 đang dẫn đầu, cả Opus 5 nữa; chúng là những model dẫn đầu rõ ràng trong mảng này. Anh nói anh tin là trên benchmark này, 50% kiểu như đại diện cho mức con người, một nhà nghiên cứu AI là con người sẽ ở mức 50%. Các model này đang chậm rãi, có thể nói là, tiến gần hơn. Anh đọc thêm: index được hiệu chỉnh sao cho 50% đại diện cho hiệu năng mức con người trên mỗi task.
9. Vấn đề của model: không có cú nhảy lớn
Vậy model này có vấn đề gì? Theo Wes (video đăng ngày 17/11/2026), trước hết, không có cú nhảy lớn so với model trước. Anh nói nếu đó là một bước nhảy thật lớn, thì có lẽ chúng ta sẽ kiên nhẫn hơn với nhiều vấn đề nhỏ. Còn nếu nó không tốt hơn bao nhiêu mà lại khó chịu hơn nhiều khi dùng, vì nó có những tật lạ, thì điều đó sẽ dễ nhận ra hơn nhiều.
Theo Wes (video đăng ngày 17/11/2026), khả năng hiểu chỉ dẫn và viết ra của nó có vẻ không tốt bằng Astra trước. Anh nhờ nó tóm tắt một nghiên cứu thành danh sách gạch đầu dòng, và cách nó sắp xếp chẳng có nghĩa gì. Với các model khác, cách chúng tiếp cận là kiểu "đây là thứ bạn cần biết trước", rồi dẫn sang phần tiếp theo; có một cảm giác mạch lạc trong cách chúng sắp xếp thông tin. Còn Astra 6.2 kiểu như đi 7, 5, 1, 2, 3, 4. "Kiểu như, sao lại làm thế?", anh nói.
Anh giao cho nó một task về hình ảnh để xem nó tốt hơn Fable 5.2 bao nhiêu, và đưa đoạn phim đó lên cho người xem (demo trong video đăng ngày 17/11/2026). Theo anh, kết quả trông đẹp, nhưng không có cải thiện gì so với những gì các model trước đã làm. Khi Fable 5.2 ra mắt, bước nhảy lớn tới mức kiểu như choáng váng; còn lần này, với anh, không thực sự tạo ra yếu tố "wow".
10. Đồng hồ quả lắc in 3D
"Nhưng vấn đề là thế này", Wes nói: với mảng 3D, nó rất, rất giỏi (theo video đăng ngày 17/11/2026). Theo anh, đó là một trong những đột phá lớn nhất mà anh nghĩ mọi người đã thấy ở Astra đầu tiên khi nó ra mắt: khả năng tạo ra những thứ 3D tuyệt vời trong Blender chẳng hạn.
Demo của Wes (video đăng ngày 17/11/2026): anh yêu cầu nó tạo một chiếc đồng hồ quả lắc in 3D được. Đầu tiên vẽ phác thảo, rồi dựng mô hình từng bộ phận trong CAD. Khi bấm Exploded, mọi bộ phận đều được tạo 3D trong CAD; theo anh, chúng đều khớp vào nhau, đều chạy được. Sau đó viết một Python solver để chắc rằng mọi bộ phận cơ khí chuyển động đúng, mọi thứ được mô phỏng và tính toán đúng cách. Rồi dùng Blender dựng môi trường thật để thấy chuyển động.
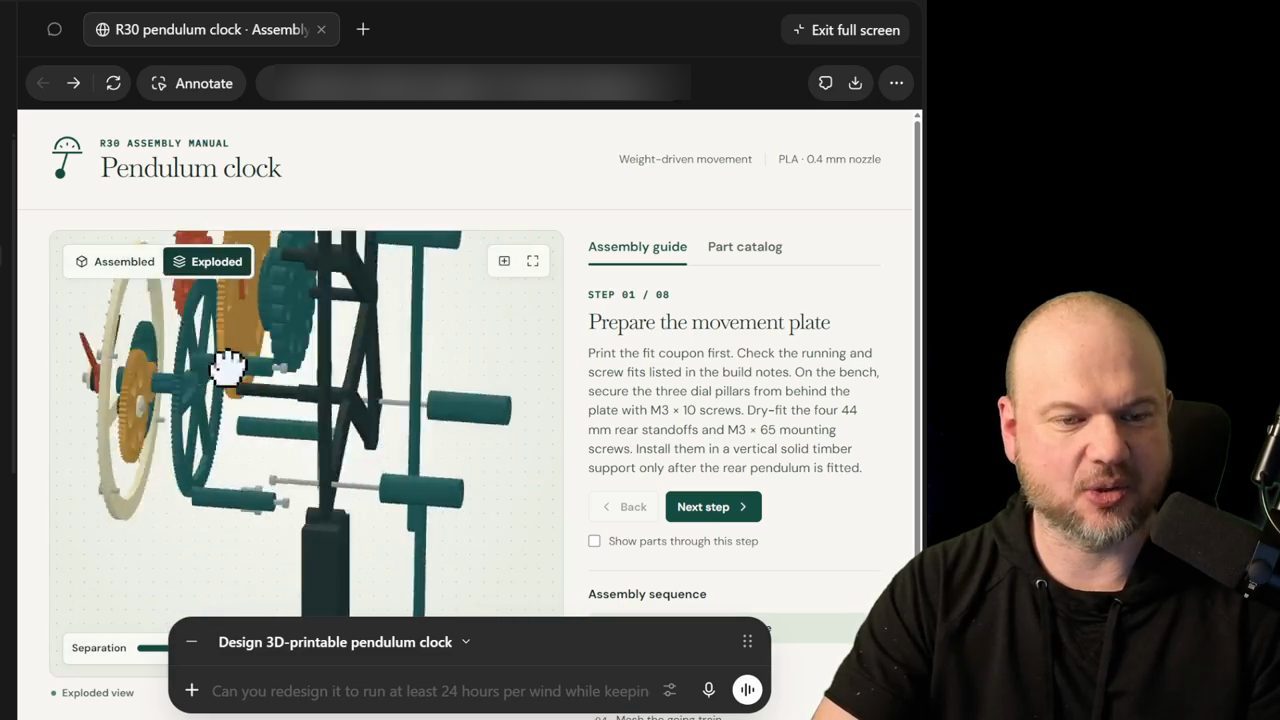
Rồi tới cơ chế đang chạy (demo trong video đăng ngày 17/11/2026). Theo Wes, nó chạy được: nó cho thấy chính xác các bánh răng nhỏ chuyển động ra sao, có cả biểu đồ, đồ thị và mọi thứ khác, vì nó đã dựng chúng bằng Python, nên mọi thứ được mô phỏng hoàn hảo. Anh khen sự tỉ mỉ là tuyệt hảo; rõ ràng mọi bánh răng đều khớp hoàn hảo. "Ý tôi là, đây là một thứ thật", anh nói.
Theo Wes (video đăng ngày 17/11/2026), bạn có thể đưa nó vào máy in 3D, in ra, và nó sẽ chạy. Anh nói anh chưa thử. Nhưng dựa trên các benchmark khác và mọi thứ khác, thứ này được cho là thật, được cho là chạy được. Anh chỉ phần hướng dẫn lắp ráp, cách ráp nó lại với nhau.
11. Máy in 3D và game Schedule 1
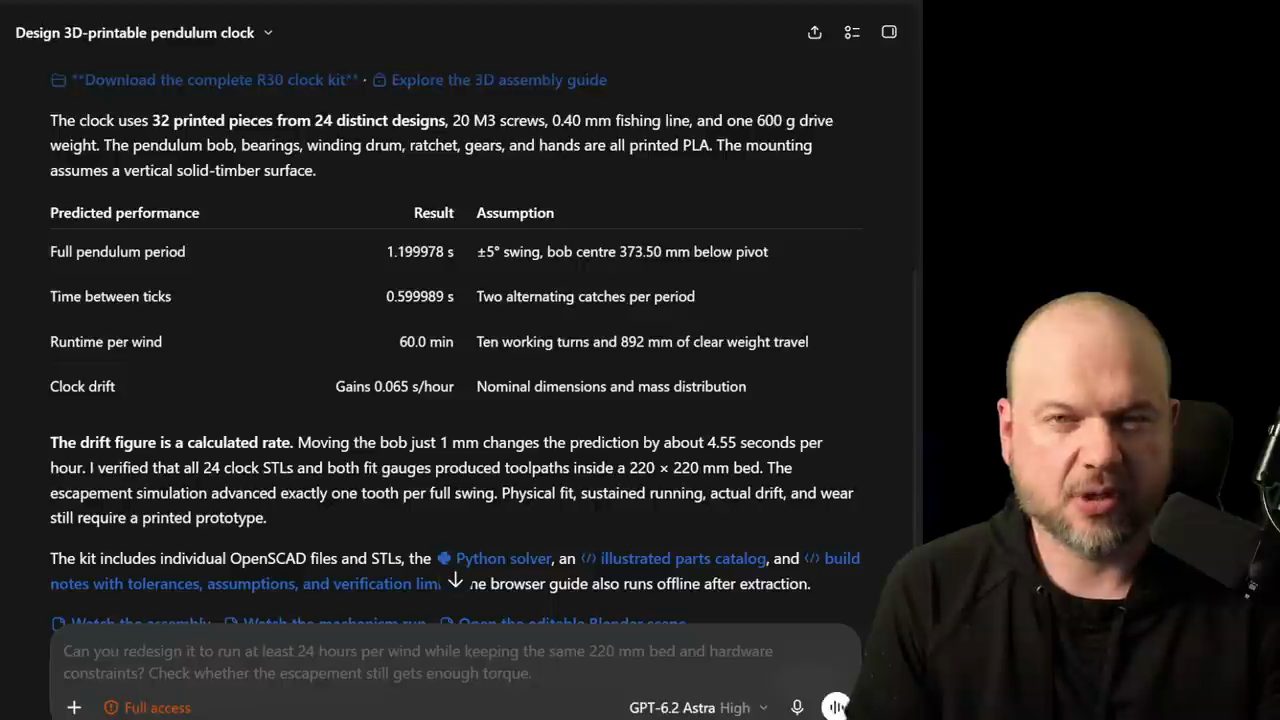
Theo Wes (video đăng ngày 17/11/2026), thứ tiếp theo anh cần là một máy in 3D. Anh nói anh sẽ mua một cái, vì rõ ràng chúng ta đang tới lúc các thứ này tạo ra được thiết kế chạy được thật. Theo anh, đây sẽ là một bài test hay: lấy thiết kế này in ra rồi xem nó có chạy không, có báo giờ đúng không.
Anh cũng muốn thử nó không phải ở "trí khôn sách vở" mà ở "trí khôn đường phố": nó có chơi được game Schedule 1 không (video đăng ngày 17/11/2026)? Theo lời anh, Schedule 1 là game mà bạn bán những thứ tiêu dùng, nói sao nhỉ, không hoàn toàn hợp pháp. Bạn có nhiều khách hàng, liên lạc bằng tin nhắn hoặc gọi điện, và bạn phải trồng những thứ này, hoặc về sau sản xuất chúng trong một xưởng hay một phòng lab.
Demo (video đăng ngày 17/11/2026): để làm việc này, theo Wes, model phải kiểu như reverse engineer một số phần của game và thêm một harness để có thể tương tác thật với game. Ở lần chạy đầu, lần đầu anh khởi động được game, nó đi tới và đưa một mẫu dùng thử miễn phí cho một khách hàng tiềm năng. Anh nói ai chơi game này có thể hiểu một số ký hiệu. Anh chỉ một biểu tượng nhỏ bên phải: nó báo rằng một cảnh sát đang nghi ngờ hoạt động của bạn. Cảnh ngay sau đó là bạn bước ra khỏi đồn cảnh sát, khỏi nhà giam. Vậy là Astra bị bắt ngay lần thử đầu.
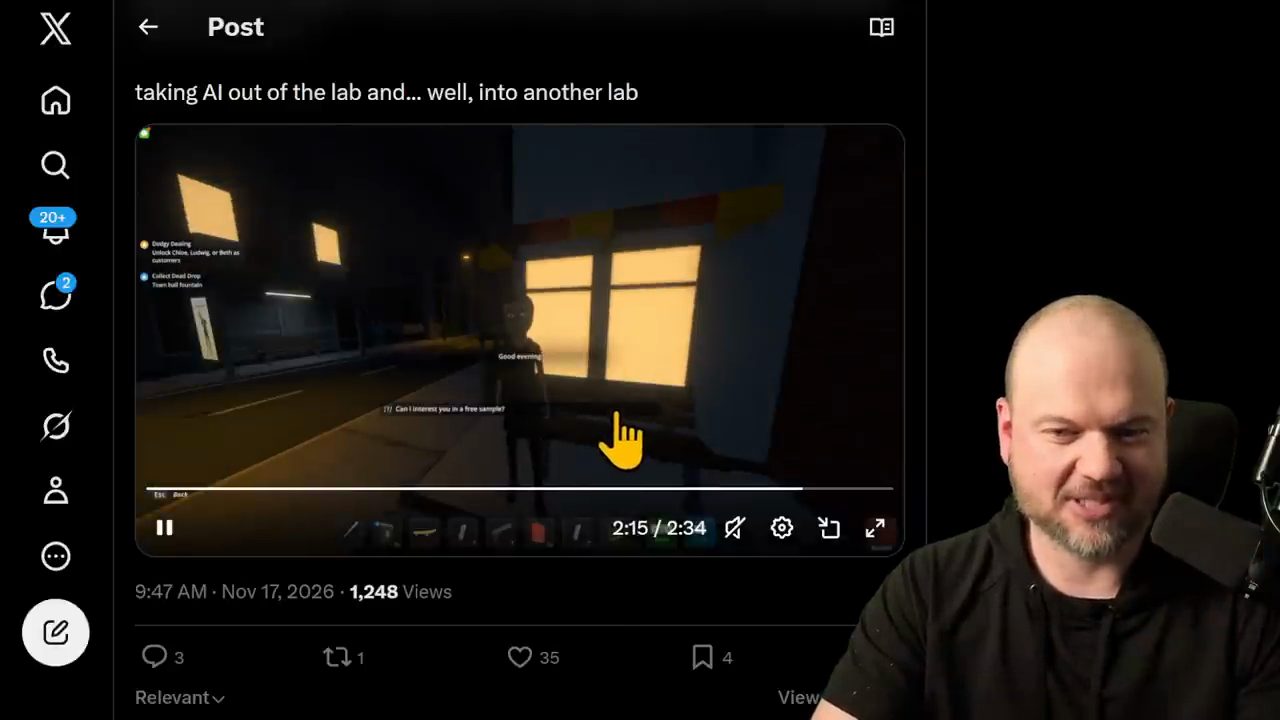
Theo Wes (demo trong video đăng ngày 17/11/2026), nó làm việc này ngay trong lúc anh đang làm video; có lúc nó tự bật game lên và chơi theo thời gian thực, và anh cho xem vài đoạn. Anh nói nó thật sự giỏi điều khiển máy tính, computer use.
12. Victris Arena
Wes kể anh tìm thấy một LLM benchmark nhỏ trên mạng tên Victris Arena; hôm nay là lần đầu anh nghịch nó (video đăng ngày 17/11/2026). Theo lời anh, về cơ bản bạn nối LLM của mình qua một MCP, và nó viết script để chơi một game PvP một đấu một nhỏ. Chatbot yêu thích của bạn viết một script, và script đó đi thi đấu với mọi người khác.
Kết quả anh cho xem (demo trong video đăng ngày 17/11/2026): bản trước, Astra 6.1, làm nhiều lần sửa khác nhau, và tới version 4, cứ gọi là 2100, thì đi ngang ở mức rating đó. Tiếp theo anh mở Antigravity, tức Gemini 4 Carbon: nó làm rất, rất tốt, vượt qua 2200 qua các version, kiểu như lên tới khoảng 2200, 2300. Anh nói Q-Star là Fable; Fable làm tốt nhưng vẫn kiểu như dưới 2200.
Rồi tới bản mới nhất, Astra 6.2 (demo trong video đăng ngày 17/11/2026): theo Wes, nó ngồi vững quanh mức 2400, đứng 16 trên bảng xếp hạng toàn cầu của trang. Anh nghĩ các model khác lên tới đỉnh ở khoảng 40 hoặc tầm đó. Astra có 17 thắng, 16 thua. Theo anh, đây là trên tất cả những ai chơi game này; anh không biết bao nhiêu người đang chơi, nó lớn cỡ nào. Nhưng ngay sau khi được phát hành ra công chúng, nó leo lên tận top 20.
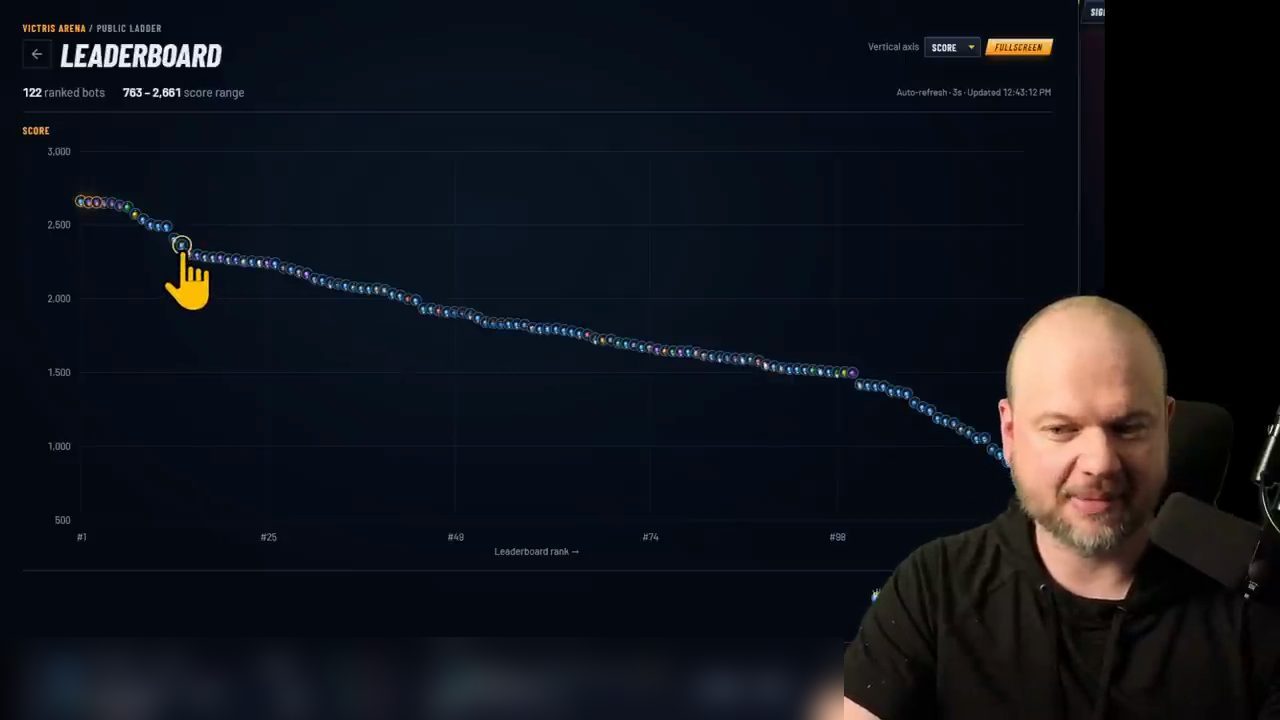
Wes nói thêm (video đăng ngày 17/11/2026): anh hoàn toàn không liên kết gì với những người làm trang này, đây không phải tài trợ. Anh chỉ tình cờ tìm thấy. Anh nghĩ một trong những người sáng lập đã email cho anh, và anh xem thử. Anh chưa nói chuyện với ai, không biết gì về nó; anh mới nghịch nó khoảng sáu, bảy tiếng qua. Theo lời anh, bạn tạo những script nhỏ cho các bot nhỏ đánh nhau, và anh thấy như vậy khá hay.
13. Mô hình 3D cho Agent Blitz
Demo cuối (video đăng ngày 17/11/2026): anh nhờ Astra tạo mô hình 3D thật cho các cầu thủ trong Agent Blitz, cái tên anh tự gọi. Anh nói anh chưa xem, nó vừa làm xong, rồi mở ra xem cùng người xem. "Trông không đẹp lắm", anh nói; đó là những hình khối 3D.
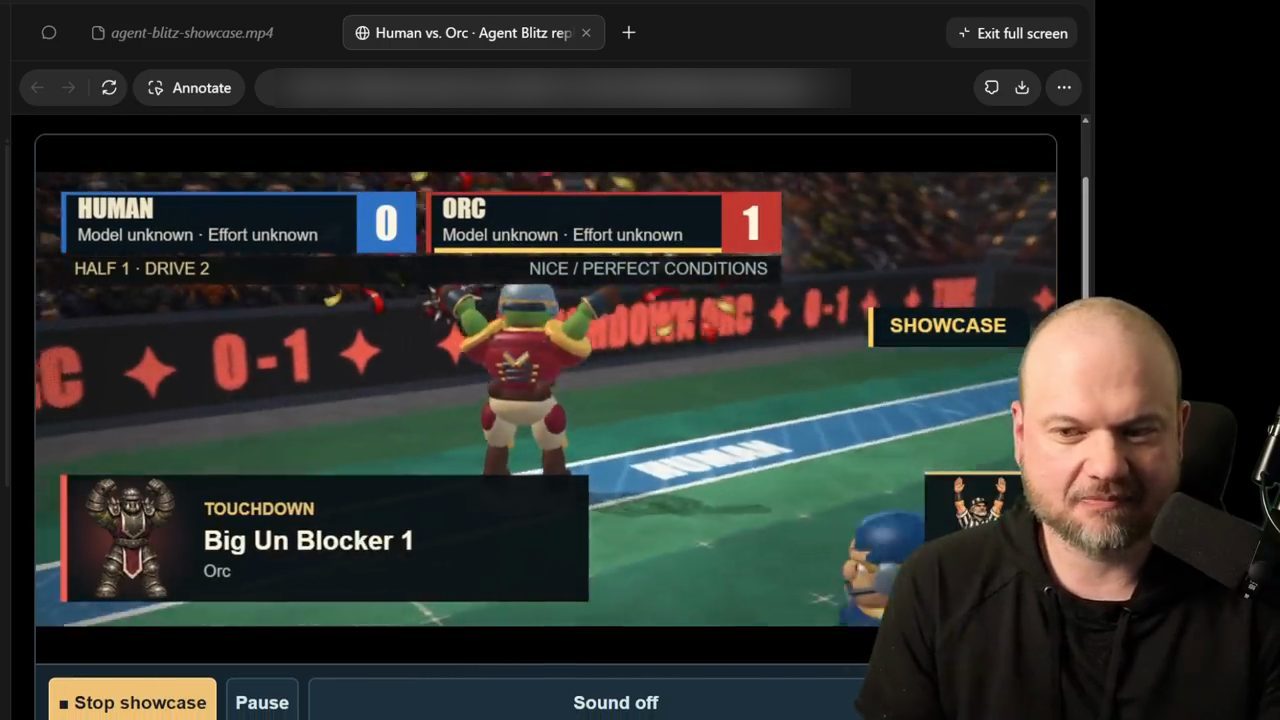
Nhưng theo Wes (demo trong video đăng ngày 17/11/2026), nhìn vào chúng thì thứ này tốt hơn các model trước: có cải thiện trong khả năng tạo hình khối 3D. Anh nói phải công nhận có một đà tiến lên lớn và mạnh.
14. Hơi giống một cú thất bại, và cuộc đua giữa các lab
Theo Wes (video đăng ngày 17/11/2026), xét cho cùng thì có vẻ lần này hơi giống một cú thất bại. Anh nhắc lại: đây không phải model tệ, dù nhìn theo bất kỳ cách nào. Có rất nhiều mảng mà nó tốt hơn nhiều. Khả năng tạo chiếc đồng hồ 3D trong CAD và Blender, có hướng dẫn lắp ráp, có Python để mô phỏng, theo anh là rất, rất ấn tượng, và chúng ta không nên gạt nó đi ngay. Nó dẫn đầu AA-Robotics, dẫn đầu nhiều mảng 3D modeling. Vậy là có tiến bộ.
Nhưng anh nghĩ Chubby đã nói trúng khi bảo OpenAI vừa cho Anthropic màn quảng bá tốt nhất có thể cho đợt IPO của Anthropic (nhận định Wes trích, video đăng ngày 17/11/2026). Theo Wes, Anthropic lúc này rõ ràng đang dẫn đầu. Google, vốn tụt lại một thời gian, đã thật sự, thật sự bắt kịp. Vậy là OpenAI không còn rõ ràng ở vị trí số một, thậm chí không đồng hạng nhất. Anh nói có người còn có thể bảo là OpenAI kiểu như, có lẽ, ở vị trí thứ ba. Nhưng anh cũng nói còn hơi sớm để kết luận vậy: đây mới là một lần phát hành.
Theo Wes (video đăng ngày 17/11/2026), theo lời kể của nhiều người khác nhau, có vẻ đã có một cuộc giằng co nội bộ ở OpenAI, xoay quanh chuyện an toàn, AI alignment. Và qua các phát biểu gần đây của nhiều người trên Twitter và trong nhiều cuộc phỏng vấn, chắc chắn có vẻ không phải ai cũng nhìn mọi việc giống nhau.
15. Gợi ý thử model và lời cảm ơn
Theo Wes (video đăng ngày 17/11/2026), nếu bạn thật sự muốn thử nó hết cỡ, xem nó xuất sắc ở đâu, hãy nghiêng về các prompt và task 3D modeling. Còn về code, tính đến lúc video đăng, anh nói Opus 5.5 hoặc Fable 5.2 có thể đang tốt hơn cho việc code, hơn cả bản Astra mới này.
Cuối video, anh cảm ơn mọi người đã xem tới đây và giới thiệu tên mình, Wes Roth.
Nguồn và liên kết 7 nguồn
- Tên gốc: OpenAI JUST made EVERYONE MAD...
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=tEysfZGzJc8 youtube.com
- Kênh YouTube Wes Roth (Wes Roth): youtube.com/channel/UCqcbQf6yw5KzRoDDcZ_wBSw youtube.com
- ARC Prize, bảng xếp hạng ARC-AGI, có ARC-AGI-3 (đọc ngày 17/11/2026): arcprize.org/leaderboard arcprize.org
- Epoch AI, trang benchmark FrontierMath, có nhắc tới các bài toán Erdős (đọc ngày 17/11/2026): epoch.ai/frontiermath epoch.ai
- Victris Arena, trang tự giới thiệu là game lập trình cho người và AI agent (đọc ngày 17/11/2026): victrisarena.com victrisarena.com
Related talks
GPT-6 Astra: benchmark ấn tượng và nỗi lo monitorability ở OpenAI
AI Explained · AI Explained · 29 min
Phân tích GPT-6 Astra (9/2026): benchmark khó, ARC-AGI-3, FrontierMath, trading, và system card về chain of thought khó giám sát, sandbagging.
Tin AI tuần: giới AI đang thật sự lo sợ
Matt Wolfe · Matt Wolfe · 36 min
Bản tin AI của Matt Wolfe ngày 11/09/2026: ChatGPT Images 2.5, agent Muse của Meta, DeepSeek V4.1 Flash, các cảnh báo về rủi ro AI và sự kiện Apple.
20 khái niệm nền tảng để build AI agent production, kèm code
Maryam Miradi · Dr. Maryam Miradi · 26 min
20 khái niệm AI agent qua năm layer: agent loop, planning, memory, sandbox, tool retrieval, multi-agent, guardrails, eval, prompt injection, tracing, mỗi cái kèm code.