Bỏ tokenmaxxing: 4 kỹ thuật context engineering cho AI agent
Bốn nhóm kỹ thuật context engineering (compress, externalize, select, isolate) cho AI agent, kèm demo code Strands và dòng context_manager="auto".
✓ Đã duyệt độc lập · cập nhật 16/10/2026 · 22 min
1. Hết thời tokenmaxxing: context engineering và agent harness
Morgan Willis mở đầu bằng một tuyên bố: thời kỳ "token maxxing", tức cứ đốt thật nhiều token cho AI agent, đã qua. Một trong những cách chính để kiểm soát chi phí cho agent là context engineering.
Cô định nghĩa context engineering là việc chủ động, có chủ đích về những dữ liệu nào được đưa vào context window của agent, kiểm soát chúng ở lại đó bao lâu, và quản lý thông tin đó sao cho agent luôn tập trung và hiệu quả.
Cách làm điều này, theo Morgan, là thông qua thiết kế agent harness. Một bên là model, thứ đưa ra quyết định, là "bộ não" chạy agent. Bên kia là agent harness: hệ thống bao quanh model, quyết định agent được tiếp cận những context, tool, memory và instruction nào trong lúc làm việc. Model cộng harness mới tạo thành một agent.
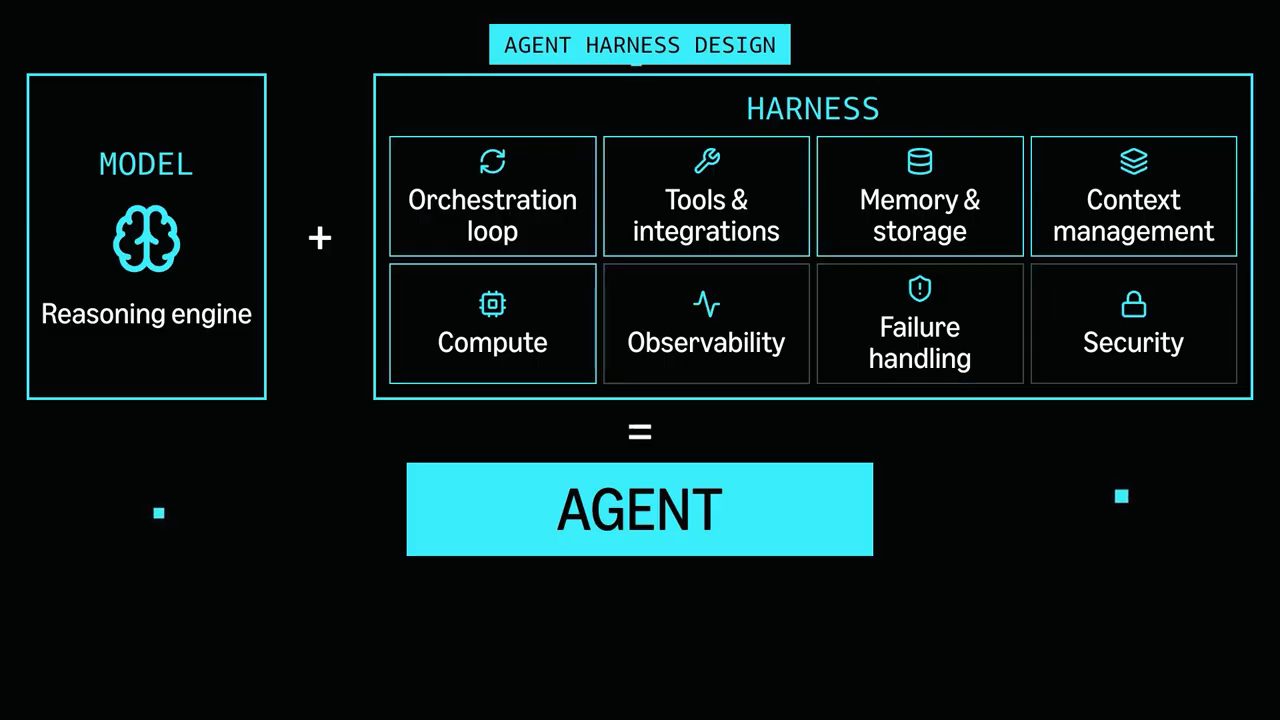
Vì vậy, mỗi khi bạn tạo một agent harness tuỳ chỉnh cho bất kỳ use case nào, bạn cần cân nhắc các best practice về context engineering. Trong video này Morgan dùng Strands, một SDK open-source để build AI agent. Strands có sẵn một harness framework, cho cô một cách đơn giản để định nghĩa agent và kiểm soát cách context được quản lý.
2. Một dòng code: giảm 55% chi phí, accuracy từ 68% lên 98%
Morgan đưa ra ngay "món chính": chỉ một dòng code thả vào một agent Strands có thể giảm chi phí 55% và đưa accuracy của agent từ 68% lên 98%. Đó là kết quả mà một benchmark do Strands công bố cho thấy, khi dùng đúng cấu hình context engineering này trên các tác vụ điều tra code thật (real code investigation tasks).
agent = Agent(context_manager="auto")
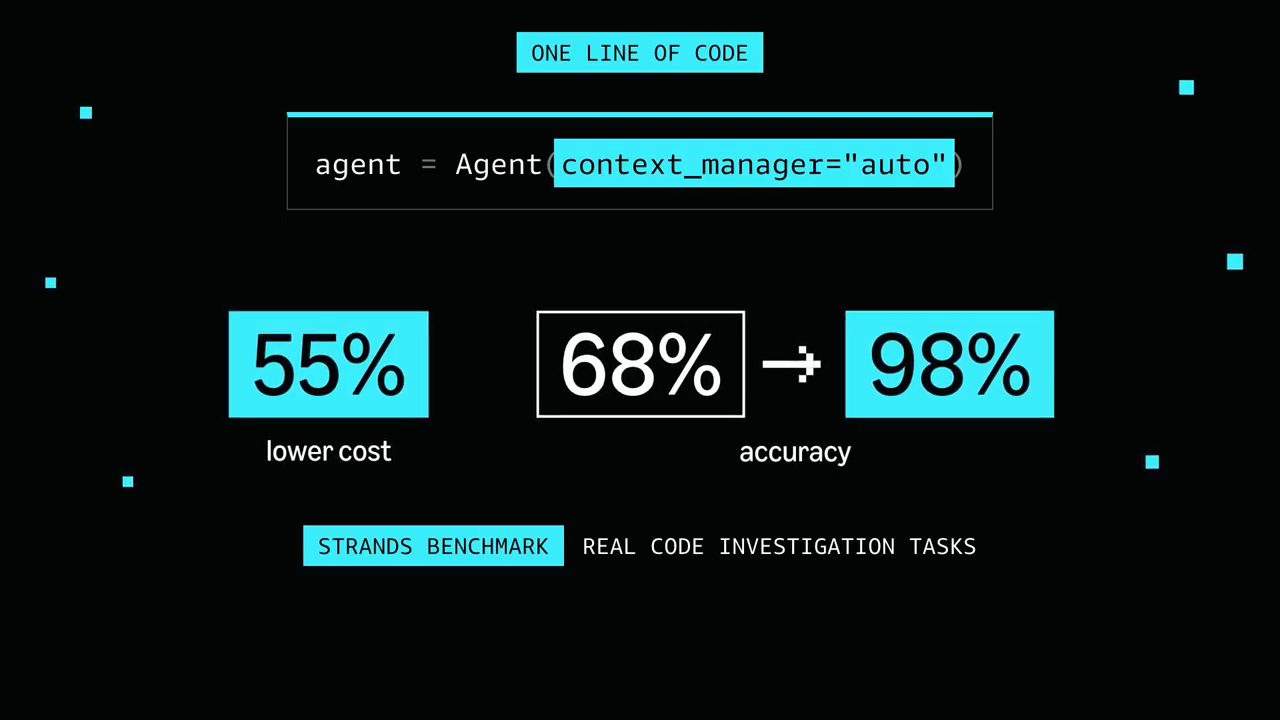
agent = Agent(context_manager="auto"), bên dưới là 55% lower cost và accuracy từ 68% lên 98%, ghi chú "Strands benchmark, real code investigation tasks".Dòng đó cho bạn một loạt best practice về context engineering ngay khi cài vào, gồm các kỹ thuật như giá trị mặc định đã tối ưu cho context compaction (nén context) và context offloading (đẩy context ra ngoài). Bạn có thể thả dòng đó vào bất kỳ agent Strands nào ngay lập tức, rất tiện.
Nhưng Morgan nói bạn cũng nên hiểu nền tảng của context engineering, để có thể chọn đúng cho agent cụ thể của mình. Nên thay vì chỉ đưa lối tắt rồi coi như xong, cô sẽ chỉ ra các pattern nằm phía sau. Cô sẽ phân tích các pattern context engineering và đi qua một vài kỹ thuật khác nhau để build agent hiệu quả hơn và chính xác hơn. Những pattern này áp dụng bất kể bạn build bằng framework nào.
Toàn bộ code trong video nằm trong repo GitHub được link ở phần mô tả (xem mục nguồn bên dưới).
3. Bốn nhóm kỹ thuật: compress, externalize, select, isolate
Morgan chia các kỹ thuật context engineering thành bốn nhóm lớn mà cô hay dùng khi suy nghĩ về chủ đề này.
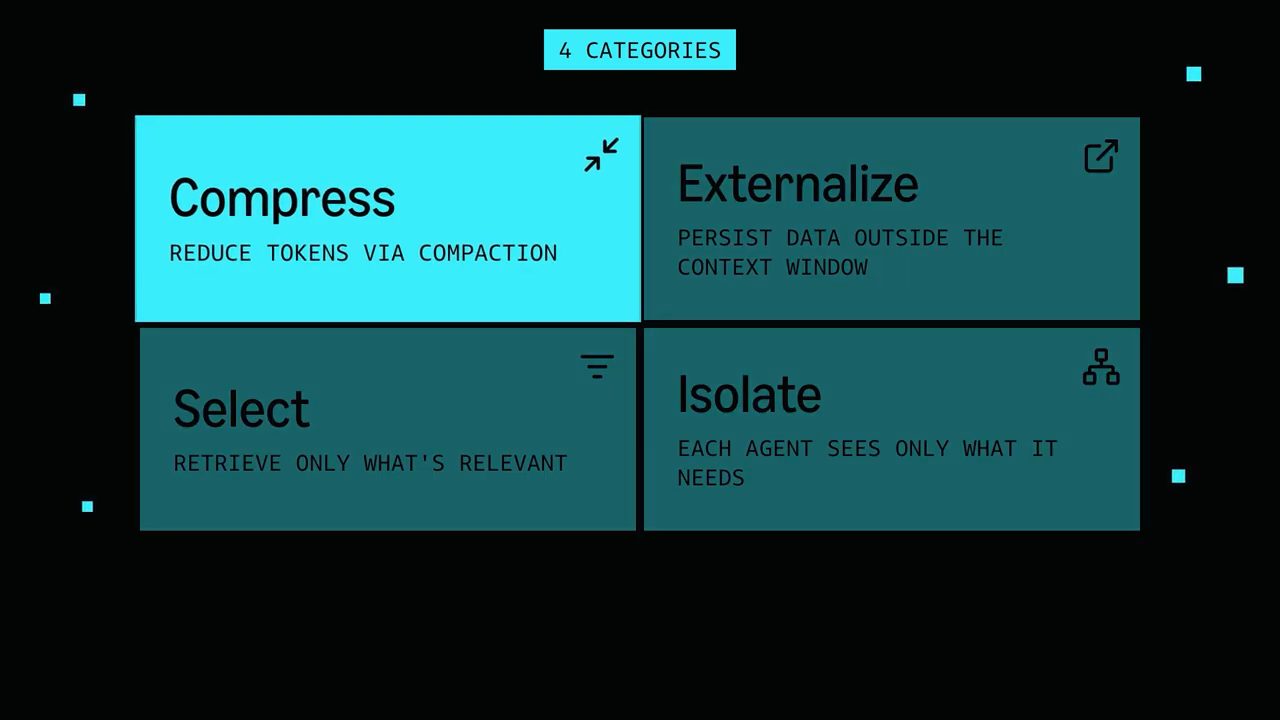
- Compress: giảm số token trong context window thông qua compaction, bằng các kỹ thuật như summarization (tóm tắt).
- Externalize: thay vì giữ mọi thứ trong context window, bạn lưu bền thông tin ở đâu đó bên ngoài, như file hay database, để không phải giữ tất cả trong "bộ nhớ làm việc" của agent mọi lúc.
- Select: khi thông tin đã nằm ngoài context window, bạn cần cho agent cách để lấy về đúng phần liên quan tới tác vụ đang làm.
- Isolate: chạy tác vụ trên nhiều agent để mỗi agent chỉ thấy thứ nó cần, giữ cho từng context window tập trung và ít nhiễu.
Các nhóm này không loại trừ nhau. Một số kỹ thuật cô sắp trình bày trải trên nhiều nhóm, và trong thực tế, agent production thường kết hợp vài kỹ thuật với nhau. Cô bắt đầu với compression vì đó là nhóm đơn giản nhất.
4. Compress: summarization và hai vùng lịch sử
Kỹ thuật compression phổ biến nhất là summarization. Khi cuộc hội thoại của agent dài ra và tiến gần giới hạn context window, bạn lấy phần lịch sử cũ hơn và dùng một model khác chạy nền để nén nó thành một bản tóm tắt ngắn hơn. Context của agent khi đó được thay bằng bản tóm tắt, và agent tiếp tục làm việc với bản tóm tắt thay vì toàn bộ nội dung thô của cuộc hội thoại.
Nhưng thật ra bạn không muốn tóm tắt mọi thứ. Những message gần nhất thường liên quan nhất tới việc agent đang làm ngay lúc này: chúng có chi tiết mới nhất và phần context nhiều khả năng quan trọng nhất cho tác vụ trước mắt.
Vì vậy, trong thực tế bạn chia cuộc hội thoại thành hai vùng khác nhau: lịch sử gần đây giữ nguyên vẹn, còn lịch sử cũ thì được tóm tắt. Bạn có thể chỉnh tỉ lệ giữa hai vùng theo use case của mình. Trên slide "Summarization", một khối SUMMARY đứng đầu, theo sau là các message 8 tới 12 được đánh dấu "freshest details", một khối "summarizer, background model" nằm bên dưới, và mép phải là vạch "context limit".
5. Demo summarization với ContextManager của Strands
Morgan chuyển sang code để xem cách làm điều này với một agent Strands. Để tạo agent trong Strands, bạn viết agent = Agent(...) rồi truyền vào các thành phần và cấu hình bạn muốn agent có. Với chuyện quản lý context, bạn truyền vào một context manager, nơi cho phép bạn cung cấp các strategy và cấu hình khác nhau cho cách context được quản lý.
Đây là file 01_summarization/main.py cô mở trên màn hình:
# Tip: context_manager="auto" gives you opinionated defaults with zero config.
# Here we configure it explicitly so you can see what each knob does.
agent = Agent(
    context_manager=ContextManager(
        strategies=[
            # When the context window hits 85% utilization, summarize the
            # oldest messages into a single summary message.
            # The 2 most recent matching messages are never touched.
            Offload.summarize("*").when(utilization=0.85, preserve_recent=2),
        ],
        stash=False,
    ),
    system_prompt="You are a research assistant.",
)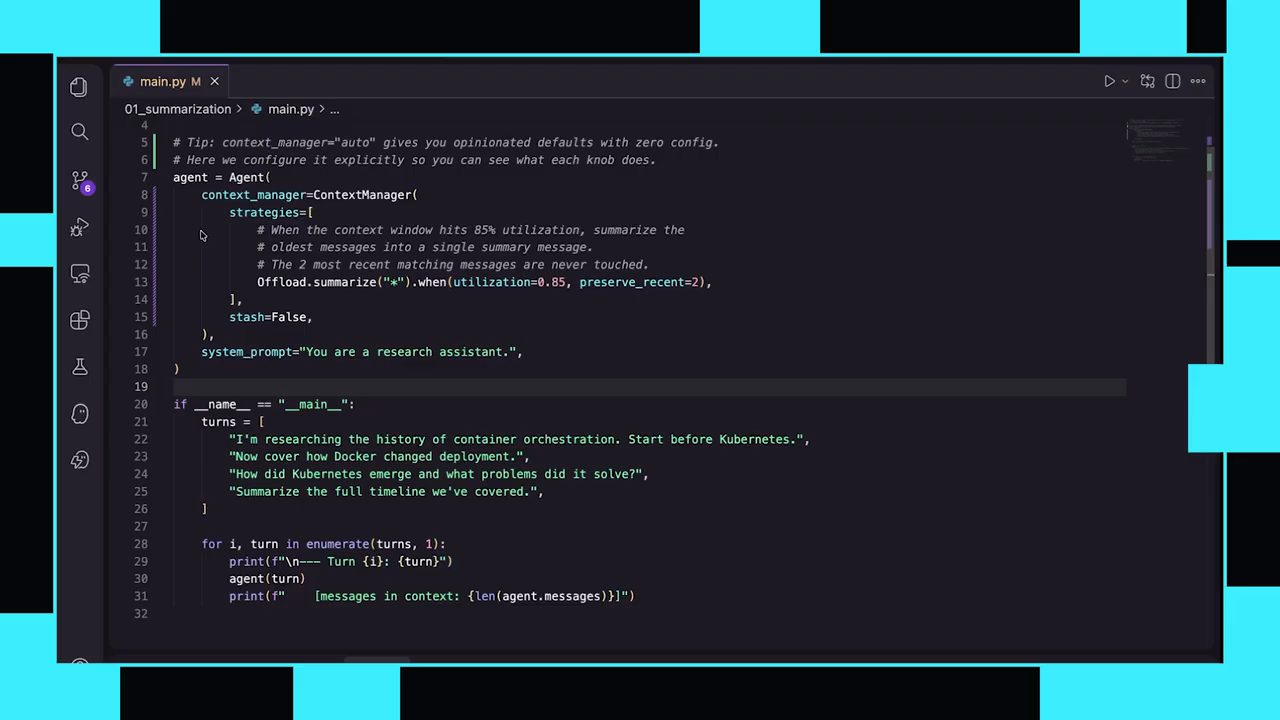
01_summarization/main.py: agent "research assistant" với một strategy Offload.summarize("*"), và bốn lượt hỏi về lịch sử container orchestration (trước Kubernetes, Docker thay đổi deployment ra sao, Kubernetes ra đời thế nào, tóm tắt cả timeline).Để làm summarization hay compression, bạn cung cấp cấu hình Offload.summarize. Morgan lưu ý: đây là một kỹ thuật tóm tắt, nhưng về mặt kỹ thuật nó cũng là offloading, vì nó lấy nội dung ra khỏi context window và thay bằng một lượng dữ liệu nhỏ hơn.
Dấu sao "*" đại diện cho các loại nội dung bạn muốn tóm tắt. Bạn có thể giới hạn nó vào tool result cụ thể, vào phần text của assistant (thứ model trả về), hay chỉ phần text của user, và có quyền kiểm soát rất chi tiết xem chính xác cái gì được tóm tắt. Ở đây dùng dấu sao, nghĩa là tóm tắt chung những gì đang có trong context window.
Tiếp theo là when(utilization=0.85): khi context window đạt 85% mức sử dụng, nó sẽ chủ động khởi động quá trình tóm tắt. Quá trình này tóm tắt các message cũ nhất trong context window, còn các message mới thì để yên. Bạn kiểm soát số message gần nhất được để nguyên bằng giá trị preserve_recent. Tóm lại cấu hình này nghĩa là: tóm tắt mọi thứ khi mức sử dụng chạm 85%, và giữ hai message gần nhất không bị tóm tắt, tức giữ nguyên như cũ.
6. Model rẻ hơn, prompt tuỳ chỉnh và cái giá của nén lossy
Bạn cũng có thể dùng một model riêng, rẻ hơn cho bước tóm tắt, và tuỳ chỉnh prompt tóm tắt để giữ lại những chi tiết quan trọng nhất với workload cụ thể của mình. Theo Morgan, tóm tắt lịch sử thường không cần tới model reasoning đắt nhất của bạn, và đó là một quyết định ở tầng agent harness có thể giảm chi phí.
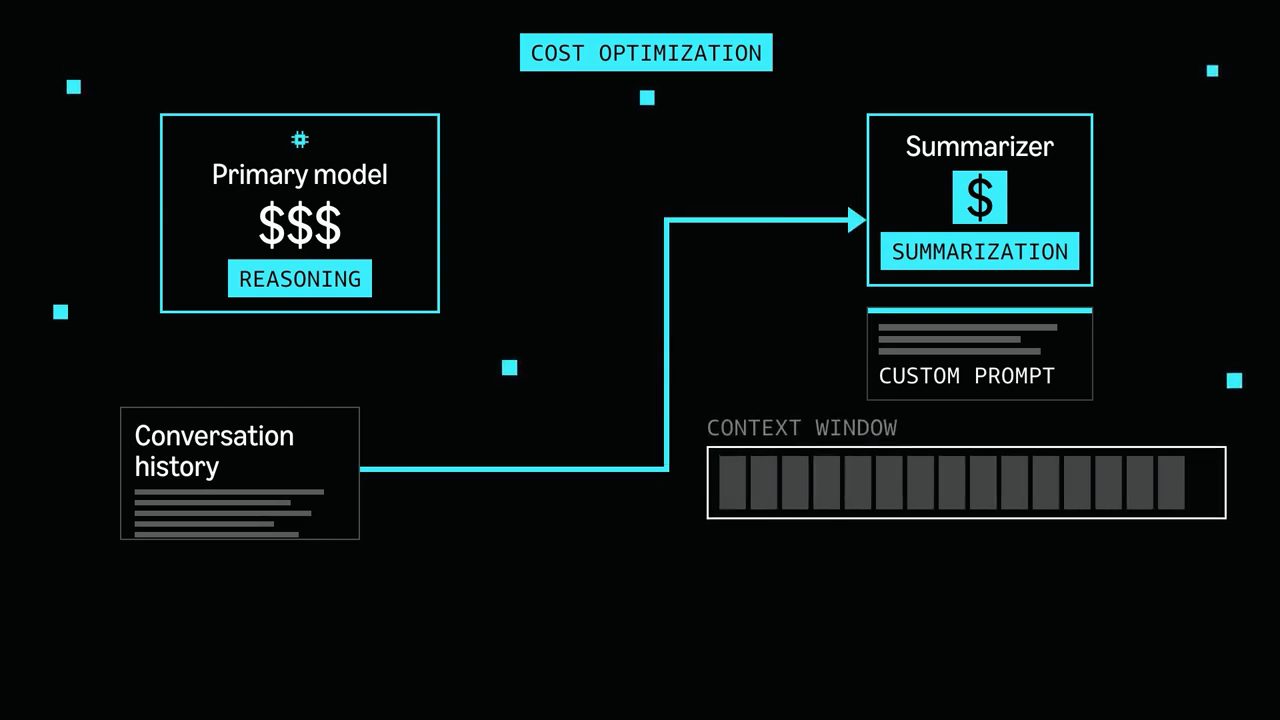
Đánh đổi ở đây là summarization là kiểu nén lossy (có mất mát). Mỗi lần tóm tắt là một lần có khả năng chi tiết bị rơi mất, và qua một workflow chạy dài, những mất mát đó có thể cộng dồn và làm agent kém hiệu quả đi. Đó là lý do bạn phải chỉnh xem cái gì được tóm tắt và cái gì giữ nguyên.
Lời khuyên của cô: giữ lịch sử gần đây đầy đủ, tóm tắt phần cũ, và tuỳ chỉnh prompt tóm tắt để trích ra những chi tiết thật sự quan trọng với use case của bạn. Nếu agent đang theo dõi một danh sách requirement xuyên suốt một cuộc hội thoại dài, hãy bảo summarizer giữ lại những chi tiết đó. Summarizer nên được thiết kế để biết những thứ bạn quan tâm.
Còn nếu có thứ gì tuyệt đối không được phép mất, thì đó là lúc externalization vào cuộc: bạn có thể đưa thông tin đó ra khỏi cuộc hội thoại hoàn toàn và lưu ở nơi agent có thể lấy lại khi cần, đúng là chủ đề tiếp theo.
7. Externalize: agent triage sự cố và những tool result khổng lồ
Morgan đưa ra một ví dụ thực tế: một agent triage sự cố production (production incident triage agent), giúp điều tra các sự cố đang diễn ra bằng cách kéo log, gọi API và thu thập metrics cùng dữ liệu về một hệ thống đang chạy. Agent có thể có một tool để lấy file log, và mỗi kết quả từ tool đó có thể là hàng chục nghìn token được thêm vào context window. Về lâu dài, việc đó rất tốn kém, và context window sẽ đầy rất nhanh.
Thêm nữa, nếu bạn tự động tóm tắt dữ liệu log đó, nó sẽ đánh rơi đúng những chi tiết bạn thật sự cần. Bạn cần một cách cho agent tiếp cận log thô để làm tốt việc của nó, mà không phải trả tiền cho hàng đống token mỗi khi agent lặp lại, dùng thêm tool và thu thập thêm dữ liệu trong lúc cố giải quyết vấn đề.
Để làm việc này hiệu quả, bạn lưu toàn bộ kết quả ra bên ngoài, ví dụ vào một file ở đâu đó, rồi đưa cho model một bản preview nhỏ cộng với một tham chiếu (reference) chỉ chỗ nó có thể tìm phần còn lại. Nếu sau đó agent quyết định cần thứ gì từ kết quả đó, nó có thể kéo thông tin về bằng tool.
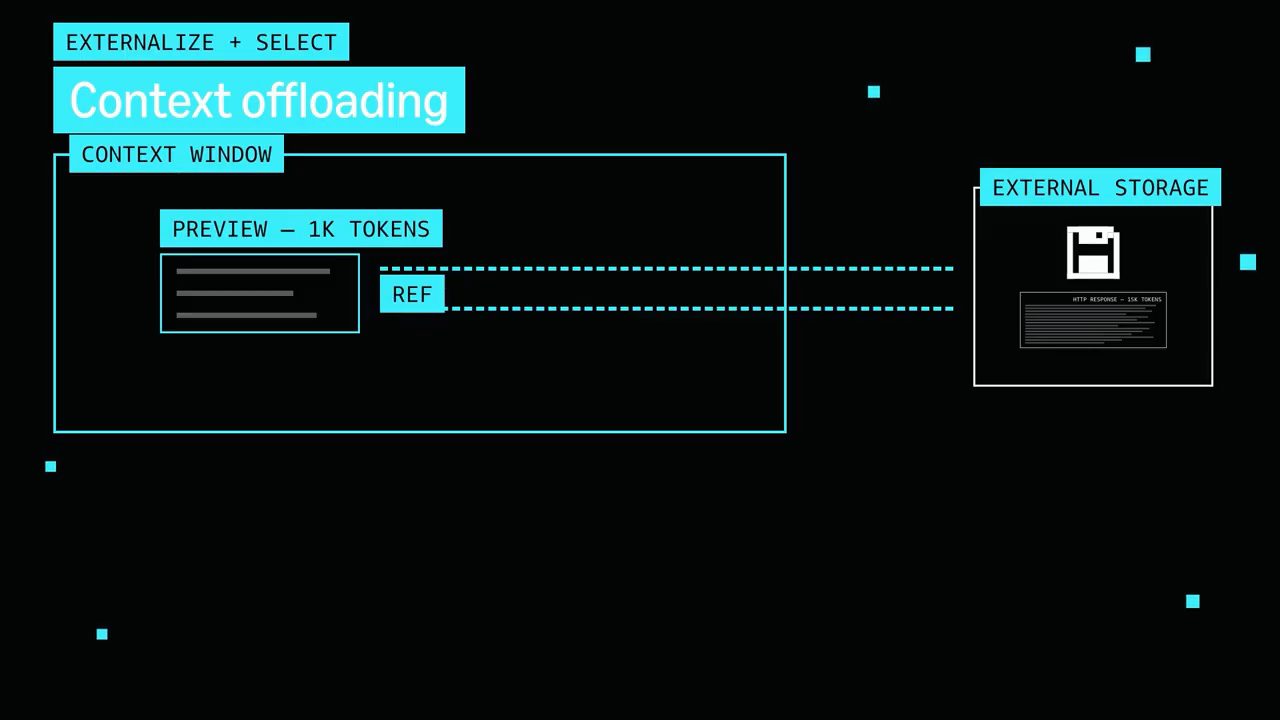
Theo cách đó, khác với summarization, không chi tiết nào bị mất. Chưa có gì bị vứt đi cả: kết quả đầy đủ vẫn còn đó, nó chỉ không còn chiếm chỗ trong context window ở mọi lượt của cuộc hội thoại nữa.
8. Demo context offloading: truncate, stash và retrieval tool
Morgan cho xem cách làm context offloading bằng chính context manager đã thấy ở demo đầu, trong một agent triage sự cố production. Đầu tiên, cô định nghĩa một tool cho agent tra log của service (get_service_logs). Trong một ứng dụng agent thật, tool này sẽ gọi tới một API hay service nào đó; ở đây nó được mock để trả về một tool result rất dài dòng.
Rồi tới phần cấu hình agent, file 02_context_offloading/main.py:
agent = Agent(
    context_manager=ContextManager(
        strategies=[
            # Tool results over ~2,500 tokens get offloaded; a 500-token
            # head/tail preview stays in the context window.
            Offload.truncate(
                "tool_results",
                {"preview_tokens": 500},
            ).when(threshold=2500),
            # Same summarization policy as Demo 1.
            Offload.summarize("*").when(utilization=0.85, preserve_recent=2),
        ],
        # Storage backend for offloaded content. The retrieval tool (get_context)
        # is automatically added to the agent so it can fetch originals on demand.
        # Omit `stash` entirely to use in-memory storage instead.
        stash={
            "storage": LocalFileStorage("./artifacts/"),  # or S3Storage for production
            "retrieval_tool": True,
        },
    ),
    tools=[get_service_logs],
    system_prompt=(
        "You are an incident triage agent. Investigate issues by pulling logs "
        "and retrieving offloaded details when you need them."
    ),
)
Vẫn là context manager như demo trước, vẫn có dòng summarization quen thuộc. Thứ được thêm vào là strategy offloading thứ hai tên là truncate: Offload.truncate, áp cho "tool_results", tức các tool result trả về khi agent gọi tool.
Tiếp theo là ngưỡng: bao nhiêu token thì kích hoạt việc truncate. Ở đây là 2.500: nếu một tool result vượt 2.500 token, cơ chế này sẽ chạy. Thứ được chèn vào context window cho agent xem là một bản preview của tool result đó, và preview này dài 500 token.
Hai strategy này xếp chồng lên nhau trong context manager. Sau đó bạn còn phải cấu hình chỗ cất thông tin, vì nó phải được lưu ở đâu đó. Ở đây cô dùng local file storage trong thư mục artifacts, dù trong production bạn có thể đổi sang thứ như S3. Cô cũng cho agent một retrieval tool, để agent có thể nói kiểu: "tôi thấy mấy token preview kia, và tôi muốn lấy thêm thông tin từ file local đó".
Sau đó agent được giao tool get_service_logs, một system prompt cho nó biết nó là một incident triage agent, và hàm main mô phỏng hai lượt: lượt đầu hỏi về chuyện payment service bị timeout, lượt thứ hai là một câu hỏi tiếp theo (trong code: "What were the exact timestamps of the database connection errors?").
Cô chạy chương trình. Khi agent chạy xong, có thể thấy lượt một bắt đầu và agent gọi tool get_service_logs. Ngay sau đó agent nói rằng log đã bị truncate, để nó kéo phần ở giữa về cho có bức tranh đầy đủ. Rồi nó dùng tool đã được cấp, retrieve_context, kéo thêm thông tin về, và có thể làm tiếp.
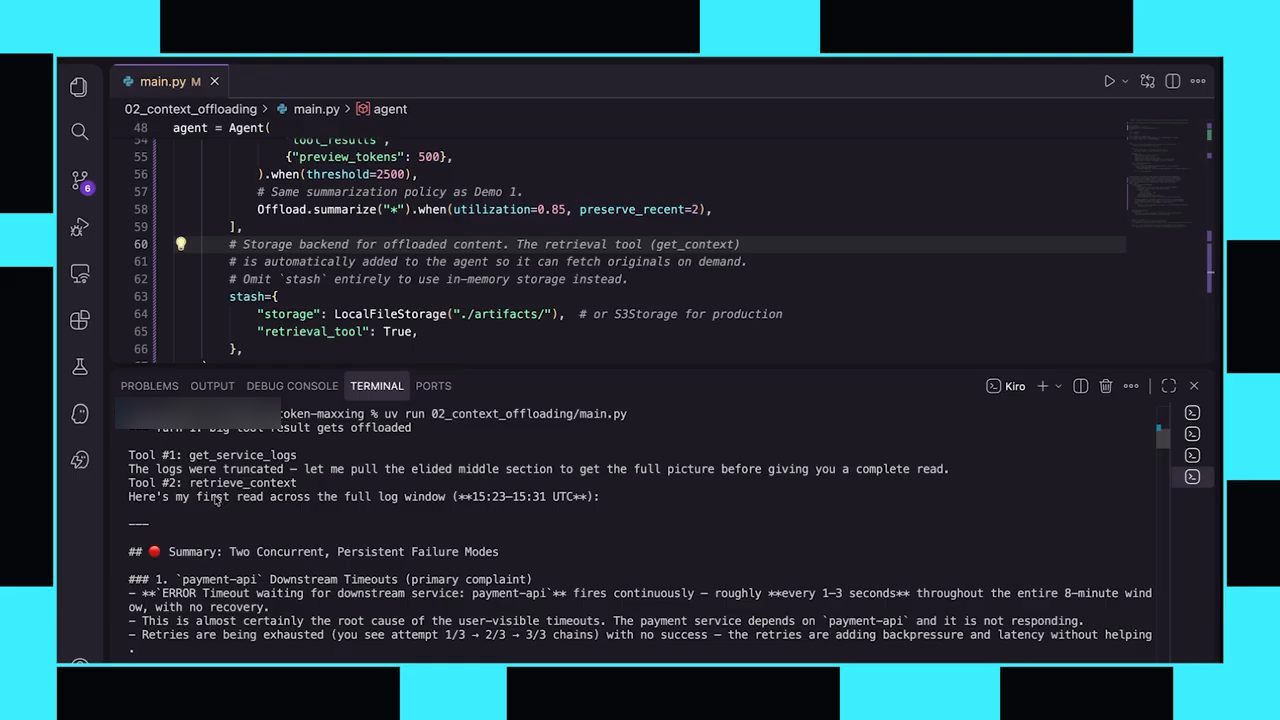
get_service_logs, báo log đã bị truncate và sẽ kéo phần giữa bị lược, gọi Tool #2 retrieve_context, rồi đưa ra bản tóm tắt hai kiểu lỗi kéo dài (timeout ở payment-api và lỗi kết nối database).Cách này giúp bạn giữ những tool result lớn ra khỏi context window, nhưng vẫn cho agent quyền kéo thông tin đó vào khi cần.
9. Select: progressive disclosure với skill
Một vấn đề context phổ biến khác, theo Morgan, là system prompt cố nhồi mọi thứ agent có thể cần. Nếu agent hỗ trợ 20 workflow khác nhau, bạn không muốn instruction cho cả 20 workflow ngốn token trong mọi request.
Thay vào đó, bạn có thể externalize các instruction đó thành skill và chỉ nạp chúng khi chúng liên quan. Pattern này gọi là progressive disclosure: khởi đầu agent với một lượng context nhỏ, rồi cho nó tool để dần dần kéo vào các instruction chi tiết hơn khi cần. Cô chỉ ra đây chính là pattern vừa nói ở context offloading, chỉ khác use case một chút.
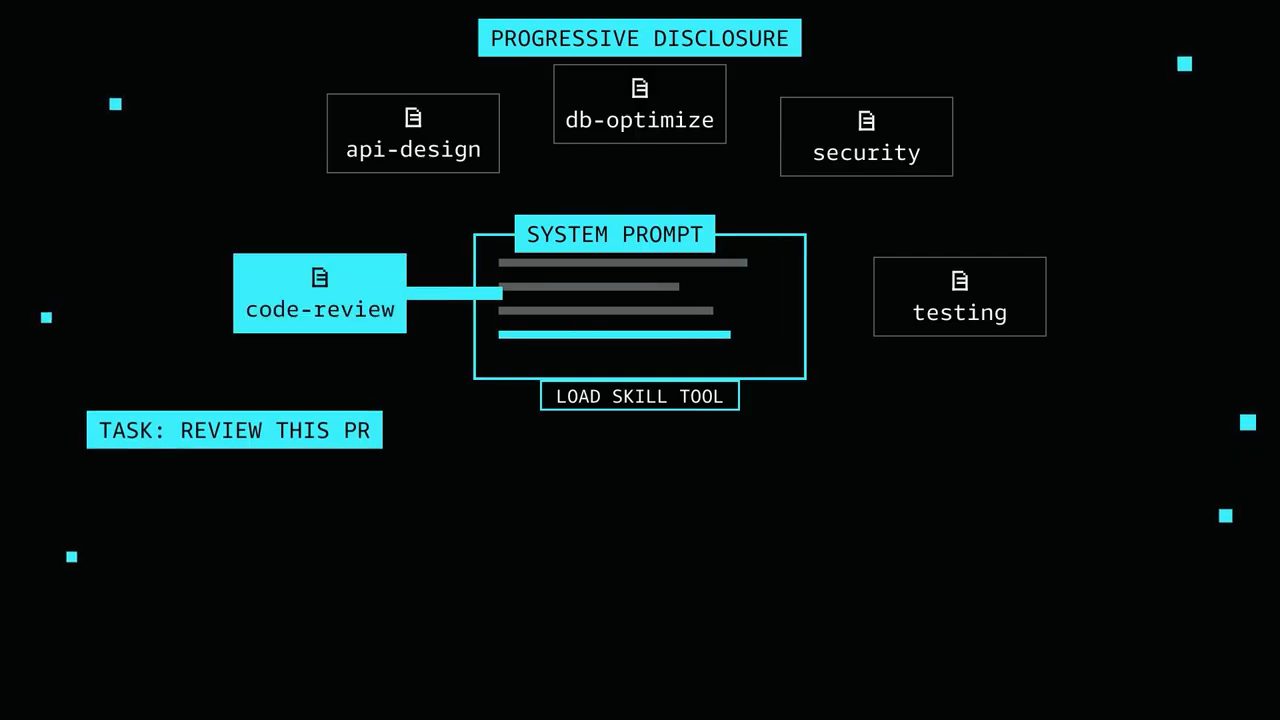
Chẳng hạn agent gặp một tác vụ cần một workflow cụ thể: nó nạp skill đó, lấy instruction cần thiết rồi tiếp tục. Nếu skill không liên quan, các instruction đó không bao giờ đi vào context window. Trong Strands, bạn hiện thực điều này bằng skills plugin.
10. Demo plugin AgentSkills cho một engineering assistant
Morgan tạo một agent "engineering assistant" để giúp các kỹ sư làm nhiều tác vụ chuyên biệt khác nhau. Thay vì nhét instruction cho tất cả các tác vụ đó vào system prompt, cô tách chúng ra nhiều file markdown, đóng gói thành skill. Trên thanh tab của editor có thể thấy các file SKILL.md của api-design, code-review và database-optimization.
Trong phần cấu hình agent vẫn là context manager như hai ví dụ trước, với context offloading và summarization, và giờ thêm plugin agent skills:
    plugins=[
        AgentSkills(skills=str(SKILLS_DIR)),
    ],
    tools=[file_editor, shell],
    system_prompt=(
        "You are an engineering assistant. Activate the relevant skill "
        "before starting a specialized task."
    ),
Với plugin agent skills, bạn chỉ cần truyền vào một thư mục skills chứa toàn bộ skill của mình. Plugin cũng cấp cho agent một tool để đọc các skill này. Sau đó cô đưa tool cho agent: ở đây là các vended tool (tool có sẵn của Strands) file_editor và shell. Có system prompt, rồi cô truyền vào prompt yêu cầu làm vài tác vụ khác nhau, mỗi tác vụ lẽ ra sẽ kéo một skill khác.
Trong code, task 1 là "Review this function" với một hàm get_user ghép thẳng user_id vào câu SQL (dòng in ra ghi nó kích hoạt skill code-review), và task 2 là "Design an API endpoint for managing user notifications." (dòng in ra ghi nó kích hoạt skill api-design, và instruction của code-review không bao giờ được nạp ở đây).
Cô chạy chương trình. Ở lượt đầu, tác vụ lẽ ra kích hoạt skill code review, và có thể thấy agent gọi skills tool, kéo đúng phần context liên quan để có instruction cần thiết, rồi hoàn thành tác vụ. Xuống dưới trong output là tác vụ thứ hai, tác vụ lẽ ra kích hoạt một skill khác. Morgan nói agent nhận prompt rồi dùng skills tool để kéo thông tin từ skill code review vào.
Cô nhấn mạnh: skill là chuyện nạp động instruction và hướng dẫn, nhưng pattern này mở rộng ra gần như mọi loại dữ liệu. Bạn có thể cho agent tool để lấy thông tin từ API, hệ thống memory, file system, MCP server, database hay các nguồn bên ngoài khác theo nhu cầu. Thay vì nạp trước vào prompt mọi thông tin có thể sẽ cần, agent tự chọn thứ nó cần, đúng lúc nó cần, dựa trên tác vụ đang làm. Đó là lý do các kỹ thuật này nằm ở hai nhóm cùng lúc: externalize và select.
11. Isolate: sub-agent như một context window dùng xong bỏ
Tiếp theo là isolation. Khi bạn có một tác vụ sinh ra rất nhiều context nhiễu, như parse một file log khổng lồ, query một API cực kỳ dài dòng, scrape web hay làm research, bạn có thể giao việc đó cho một sub-agent có context window riêng, tách biệt.
Morgan bảo hãy nghĩ về sub-agent gần như một context window dùng xong bỏ (disposable context window). Nó tự làm phần việc bừa bộn, xử lý toàn bộ dữ liệu thô, rồi chỉ chuyển kết luận hữu ích về cho parent agent. Parent agent không bao giờ thấy 10.000 token log hay những API response dài lê thê; nó chỉ nhận đúng kết quả nó cần.
Đúng là bạn vẫn tốn token cho lượt gọi sub-agent, vì công việc đó vẫn phải được làm ở đâu đó. Nhưng bạn tiết kiệm token ở mọi lượt gọi model sau đó của parent agent, đồng thời giữ cho context của parent sạch và tập trung hơn.
12. Pattern agent as a tool
Trong Strands có vài cách làm việc này, và một trong số đó là tạo một agent riêng rồi phơi nó ra cho parent agent như một tool. Cách này gọi là pattern agent as a tool. Sub-agent có system prompt riêng và context window riêng.
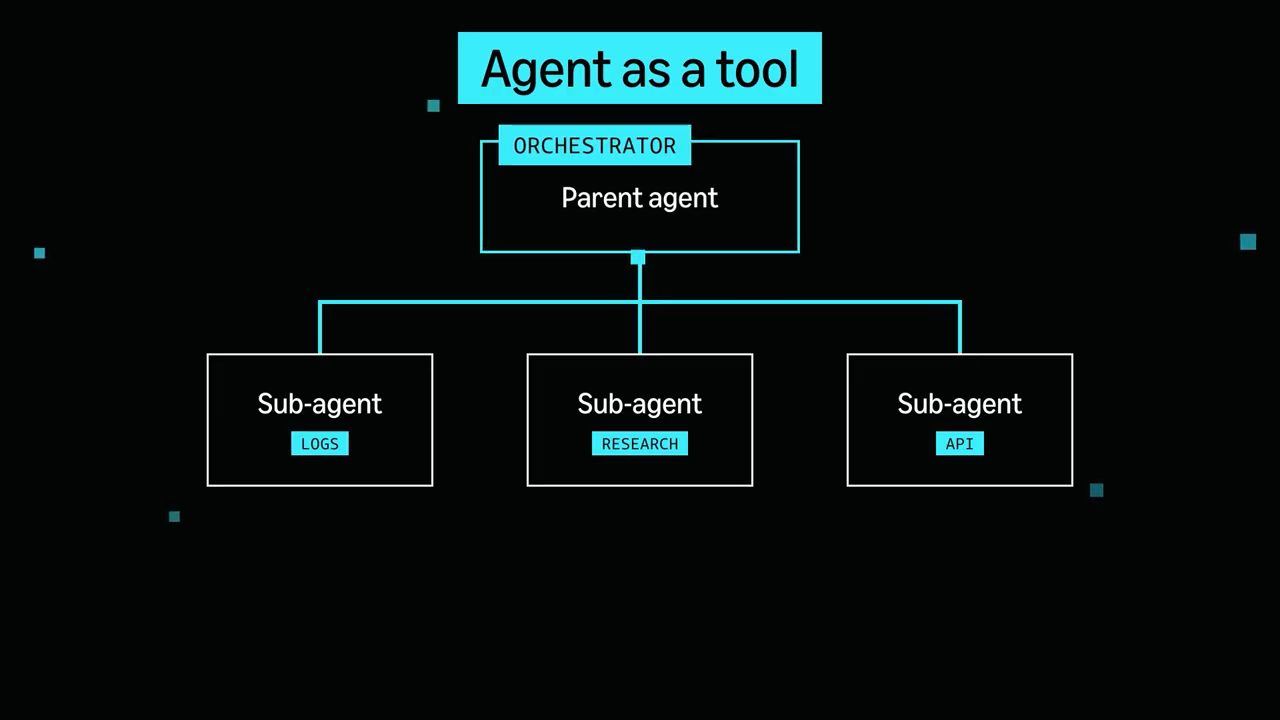
Theo Morgan, cái hay của việc sub-agent có context window riêng là mọi kỹ thuật đã nói trước đó đều áp dụng được bên trong context tách biệt ấy, vì đó là một agent hoàn toàn riêng. Bạn có thể compress, externalize và select bên trong một sub-agent, thậm chí cho nó có các sub-agent khác, rồi chỉ trả kết quả cuối về cho parent. Có rất nhiều chỗ để tối ưu ở đây.
13. Demo orchestrator với hai sub-agent phân tích log và metrics
Ví dụ này lại là một agent triage sự cố production, nhưng thay vì cho mọi thứ đi qua một agent, Morgan dùng nhiều sub-agent để lo các phần research nhiễu của tác vụ.
Đầu tiên cô viết stub cho vài tool mô phỏng dữ liệu hạ tầng nhiễu. Tool đầu tiên là read_logs, được biến thành tool cho agent Strands bằng decorator @tool; nó tạo ra một đống thông tin dài trông giống log để agent dùng cho việc research. Tool thứ hai là get_metrics, tương tự, nhưng trả về kiểu dữ liệu khác để mô phỏng metrics đến từ một service hạ tầng.
Rồi cô tạo hai sub-agent, mỗi cái là một agent đầy đủ. Đầu tiên là log analyzer agent: bạn đặt cho nó tên, mô tả, tool; agent này có danh sách tool riêng, system prompt riêng và context window tách biệt riêng. Bất cứ thứ gì dùng được với một agent đều dùng được với một sub-agent. Sub-agent thứ hai là metrics analyzer, được truyền tool get_metrics và một system prompt khác. Hai agent này có vòng đời và context window hoàn toàn tách biệt nhau, và cũng không nói chuyện được với nhau.
Cuối cùng là parent agent, hay orchestrator, nơi cô truyền thẳng log analyzer agent và metrics analyzer agent vào như tool:
orchestrator = Agent(
    tools=[log_analyzer, metrics_analyzer],
    system_prompt=(
        "You are a senior SRE. Use your specialized agents to investigate "
        "services, then synthesize findings into concise, actionable recommendations."
    ),
)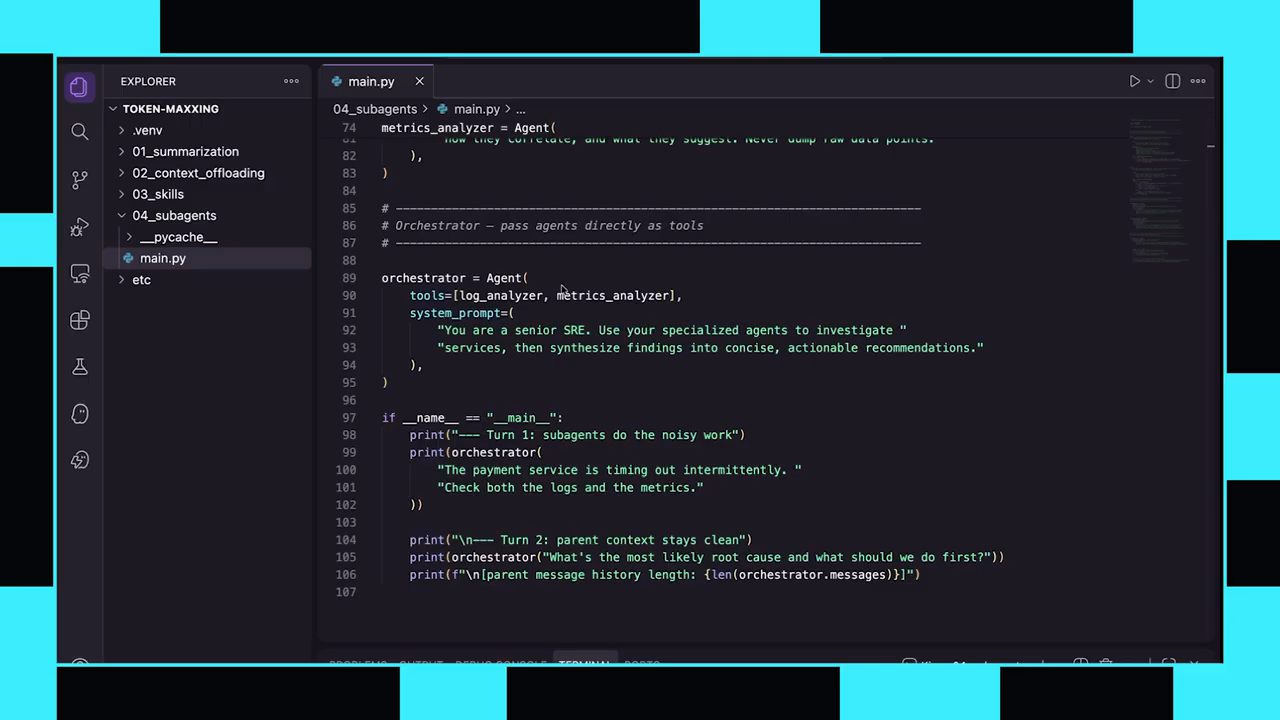
04_subagents/main.py: orchestrator nhận log_analyzer và metrics_analyzer làm tool, kèm hai lượt hỏi về payment service bị timeout và nguyên nhân gốc.Cách này cho orchestrator khả năng gọi các agent kia để phân tích log hay phân tích metrics, mà context window của orchestrator vẫn sạch. System prompt của nó nói nó là một senior SRE, dùng các agent chuyên biệt để điều tra service và tổng hợp phát hiện thành khuyến nghị ngắn gọn, làm được ngay.
Khi gọi agent, cô truyền vào prompt: payment service đang bị timeout lúc có lúc không, hãy kiểm tra cả log lẫn metrics. Còn một lượt thứ hai hỏi: nguyên nhân gốc khả dĩ nhất là gì và nên làm gì trước tiên? Việc này mô phỏng một cuộc hội thoại bạn có với một agent xử lý sự cố production.
Cô chạy chương trình. Khi agent chạy xong, có thể thấy ở lượt đầu nó quyết định khởi động cả phân tích log lẫn phân tích metrics: gọi tool một là analyze logs, tool hai là analyze metrics. Nó thật ra khởi động hai việc này song song, nên hai agent được sinh ra và chạy song song. Các agent đó lại gọi tool riêng của mình: agent analyze metrics gọi get_metrics, agent analyze logs gọi read_logs. Agent analyze metrics còn gọi get_metrics thêm vài lần nữa, rồi cả hai trả kết quả về orchestrator, nơi nó tổng hợp toàn bộ thông tin thành một bản tóm tắt và một khuyến nghị.
14. Bonus: prompt caching
Morgan thêm một kỹ thuật bonus bổ trợ cho tất cả những điều trên: prompt caching. Nếu agent có một system prompt lớn hay phần context tĩnh lặp lại qua các request, bạn không nhất thiết muốn xử lý lại toàn bộ số token đó từ đầu mỗi lần.
Nhiều model provider hỗ trợ prompt caching, và Amazon Bedrock là một trong số đó. Dù bản thân Strands không phụ thuộc model provider nào, nó dùng Amazon Bedrock làm model provider mặc định, và bạn có thể cấu hình prompt caching khá dễ.
model = BedrockModel(
    model_id="global.anthropic.claude-sonnet-5",
    cache_config=CacheConfig(strategy="auto"),
)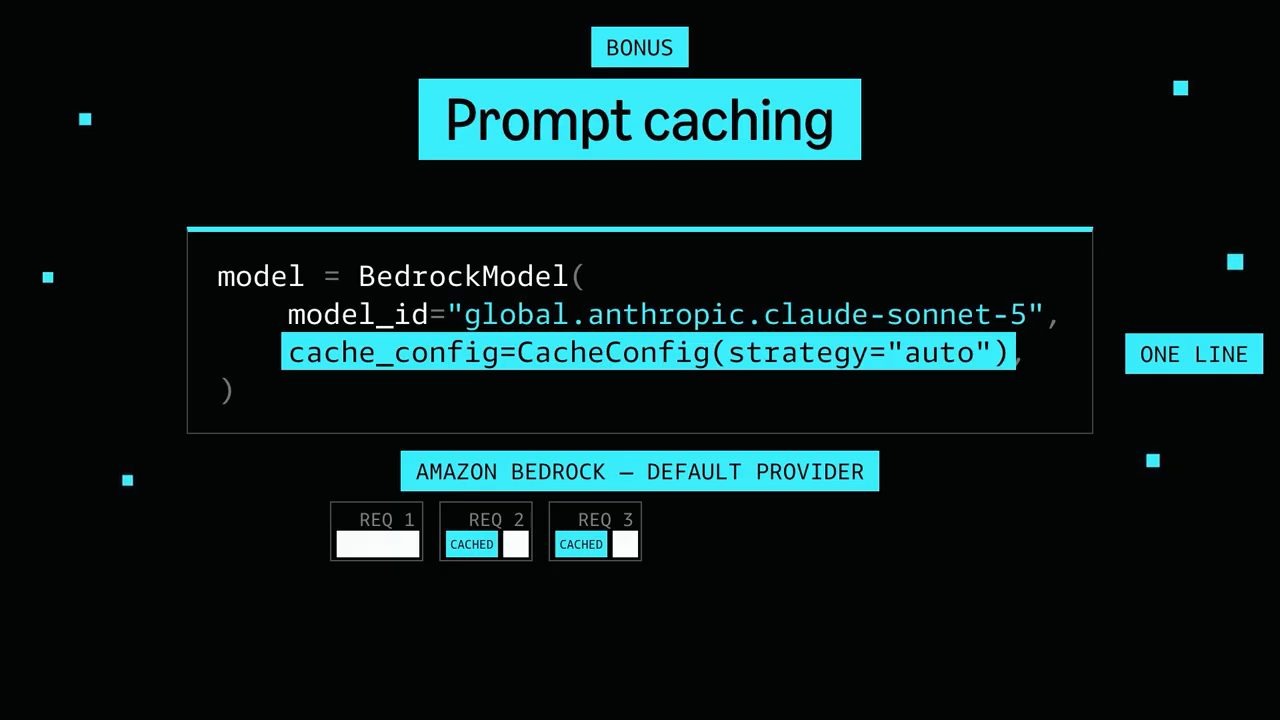
BedrockModel với dòng cache_config được đánh dấu "one line", nhãn "Amazon Bedrock, default provider", và ba request trong đó request 2 và 3 dùng lại phần đã cache.Với prompt caching, các phần lặp lại trong context có thể được cache và dùng lại qua các request, giảm chi phí và độ trễ của việc xử lý chúng lần nữa.
Morgan nói rõ prompt caching thật ra không hẳn là một kỹ thuật context engineering, vì nó không thay đổi thứ gì đi vào context window, mà thay đổi mức hiệu quả khi xử lý phần context lặp lại. Hãy coi nó là thứ bổ trợ: bạn cần engineer context để giữ nó tập trung, rồi cache thêm những phần giữ nguyên từ request này sang request khác.
15. Quay lại dòng context_manager="auto"
Cuối cùng Morgan quay lại dòng code đã cho xem lúc đầu. Khi bạn đặt context_manager="auto" trong Strands, nó kết hợp nhiều pattern vừa nói với các giá trị mặc định đã được benchmark kiểm chứng.
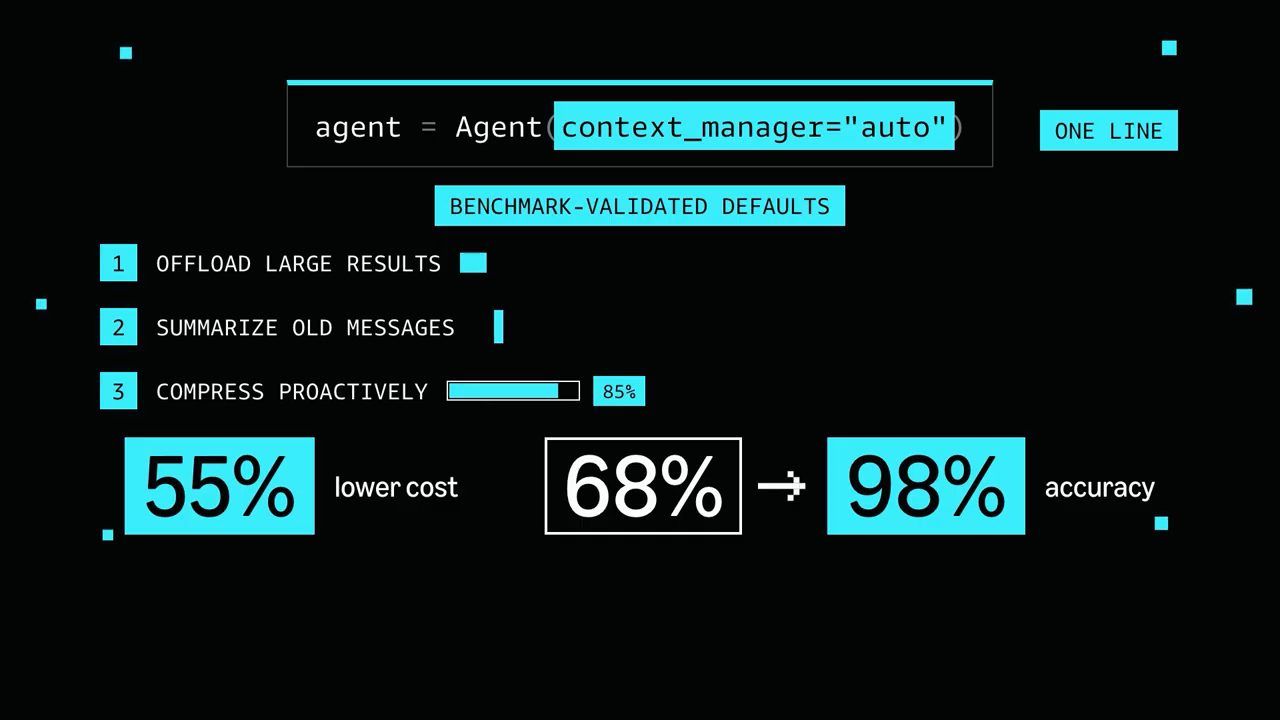
context_manager="auto" với "benchmark-validated defaults" gồm ba việc (offload large results, summarize old messages, compress proactively ở mốc 85%), kèm 55% lower cost và accuracy từ 68% lên 98%.- Tool result lớn vượt một ngưỡng được offload khỏi context window và thay bằng một bản preview nhỏ hơn, dùng context offloading.
- Phần hội thoại cũ được nén bằng summarization thông qua conversation manager.
- Việc nén đó diễn ra chủ động khi context window bắt đầu đầy, thay vì đợi tới lúc chạm giới hạn.
Nhờ vậy, thay vì tự tay cấu hình ngưỡng offloading, kích thước preview, tỉ lệ tóm tắt và thời điểm nén, bạn có một cấu hình hợp lý chỉ trong một dòng. Đó chính là cấu hình đứng sau những con số cô nói ở đầu video: chi phí giảm 55% và accuracy tăng từ 68% lên 98%. Cô để link tới bản benchmark đầy đủ bên dưới để mọi người tự xem.
Morgan kết lại: đó là vài mẹo context engineering với Strands để bạn có thể bỏ kiểu token maxxing và bắt đầu build những agent hiệu quả. Cô nhắc xem link trong phần mô tả để có toàn bộ code của video, và cài Agent Toolkit for AWS vào coding assistant của bạn để nhận hướng dẫn mới nhất về Strands trong lúc build. Cô cảm ơn mọi người đã xem và hẹn gặp lại.
Nguồn và liên kết 9 nguồn
- Tên gốc: Quit Tokenmaxxing: 4 Context Engineering Techniques for AI Agents
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=-q_u6nrVdgo youtube.com
- Kênh YouTube AWS Developers (Morgan Willis): youtube.com/channel/UCT-nPlVzJI-ccQXlxjSvJmw youtube.com
- Repo code của video, bốn demo summarization, context offloading, skills, subagents và phần prompt caching: github.com/morganwilliscloud/quit-token-maxxing github.com
- Bài viết đi kèm trên AWS Builder Center, "Quit Tokenmaxxing: 4 Tips For Context Engineering (With Code Samples)": builder.aws.com builder.aws.com
- Bài benchmark của Strands (chi phí giảm 55%, accuracy 68% lên 98%): strandsagents.com/blog/reduced-cost-better-isolation-more-resilience strandsagents.com
- Strands Agents, SDK open-source để build AI agent: strandsagents.com · repo github.com/strands-agents/harness-sdk strandsagents.com
- Agent Toolkit for AWS: aws.amazon.com/products/developer-tools/agent-toolkit-for-aws aws.amazon.com
Related talks
Context engineering cho AI agent: giữ record, gửi focused view
Rod Rivera · Rasa · 15 min
Vì sao agent nên giữ record ngoài prompt và mỗi lượt chỉ gửi model một view do live state chọn, minh hoạ bằng skill.md và template của Rasa Mantle.
Thôi viết prompt cho Claude, hãy làm harness engineering
Austin Marchese · Austin Marchese · 16 min
Bốn layer của harness engineering, tám thành phần của một harness, và cách dựng internal knowledge harness đầu tiên trên Claude Code với giao diện web local.
Khi nào dùng Skills, khi nào dùng Tools trong Agent Framework
Rasmus Wulff Jensen · AI in C# (Rasmus Wulff Jensen) · 23 min
Đo input token của cùng ba capability dưới dạng skills và tools trong Microsoft Agent Framework (C#), từ 3 tới 300 capability, để biết khi nào chọn bên nào.