Bonsai 2: Qwen 27B nén còn 6 GB có làm được việc agent?
Bonsai 2 nén Qwen3.8-27B bằng ternary quantization còn khoảng 6 GB: hoà ở task ngắn nhưng không build xong app agentic nào, và cách đọc trace để thấy vì sao.
✓ Đã duyệt độc lập · cập nhật 24/10/2026 · 14 min
1. Lời hứa của Bonsai 2
Muhammad mở đầu bằng một câu hỏi: liệu có thể giữ được 98% performance của một model 27 tỷ tham số trong chưa tới 8 gigabyte không? Đó chính xác là điều PrismML tuyên bố với model mới Bonsai 2 của họ (theo video đăng ngày 28/09/2026). Câu hỏi đặt ra là con số ấy có đứng vững khi thử ngoài đời thật hay không.
Để trả lời, anh đưa Bonsai 2 vào benchmark riêng của mình và so trực tiếp với Qwen3.8-27B. Theo số đo của Muhammad (video đăng ngày 28/09/2026), trên các task đơn giản hai model rất sát nhau, về cơ bản là hoà. Nhưng với các task agentic dài hơn, nơi model phải lập kế hoạch, viết code, tự kiểm tra việc của mình rồi tiếp tục từ đó, thì câu chuyện khác hẳn.
Vì vậy trong video này, anh muốn cho thấy compression có thể ảnh hưởng thế nào tới một model, ảnh hưởng ấy lộ ra ở đâu, và làm sao bạn tự nhận ra nó, vì theo anh ta học được rất nhiều từ chuyện này (video đăng ngày 28/09/2026). Nhưng trước đó, cần nói rõ Bonsai 2 là gì, vì cách nó được làm ra rất thú vị và là một phần của toàn bộ câu chuyện anh muốn kể.
2. Từ 54 GB xuống khoảng 6 GB
Qwen3.8-27B ở full precision lưu mỗi weight dưới dạng một số 16-bit. Với floating point 16-bit, cả model nặng khoảng 54 gigabyte, theo Muhammad (video đăng ngày 28/09/2026) là nhiều hơn bộ nhớ mà phần lớn laptop hay GPU dân dụng có. Bonsai 2 cắt con số đó xuống còn khoảng 6 gigabyte, tức nhỏ hơn chừng 9 lần.
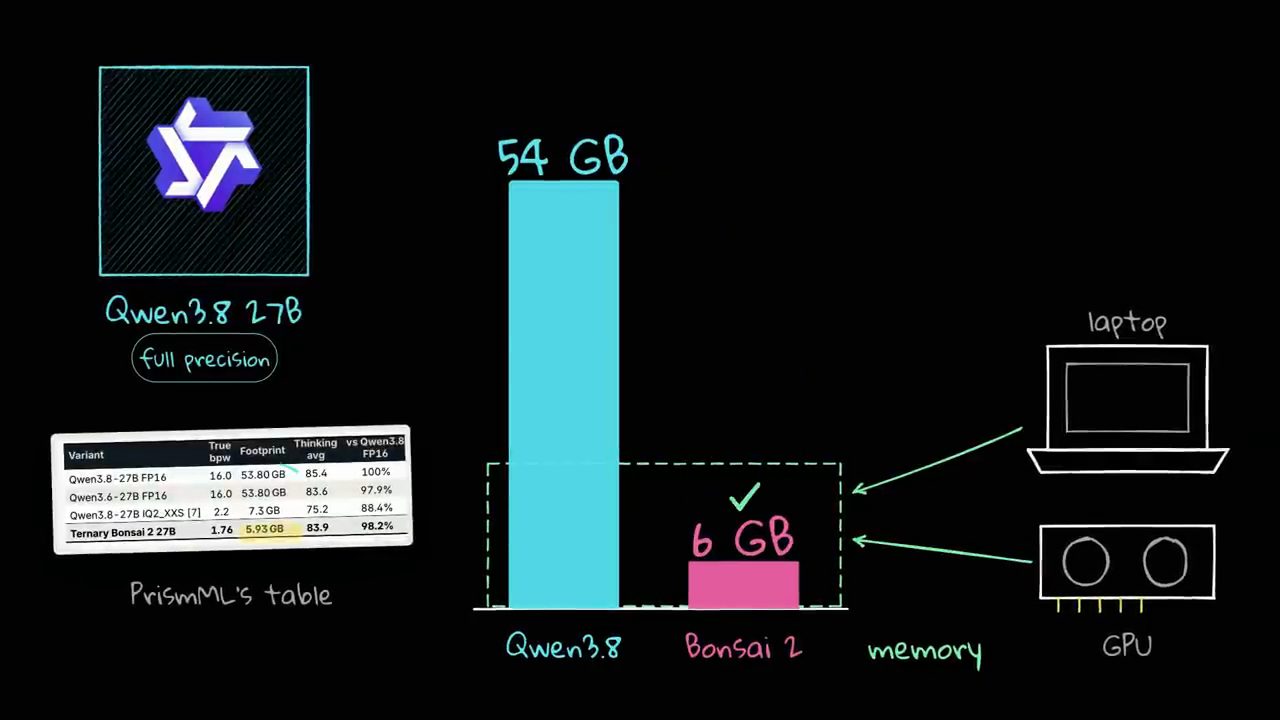
3. Quantization là làm tròn, và cái giá của bản 2-bit
Thông thường, khi muốn làm một model nhỏ lại, người ta quantize nó. Theo Muhammad, một mental model tốt cho quantization là làm tròn (rounding): bạn lấy một model đã được train xong, rồi làm tròn từng weight về một con số cần ít bit hơn. Cách này rẻ và nhanh, và theo anh (video đăng ngày 28/09/2026) bạn thấy nó ở hầu hết các model ngoài kia.
Vấn đề là nếu làm tròn quá mạnh, model bắt đầu mất trí thông minh, vì trí thông minh nằm trong chính các weight. Một bản 2-bit bình thường của cùng model Qwen đó nặng khoảng 7,3 gigabyte, và theo chính bảng của PrismML (trên màn hình, video đăng ngày 28/09/2026), nó giữ được khoảng 88% điểm benchmark.
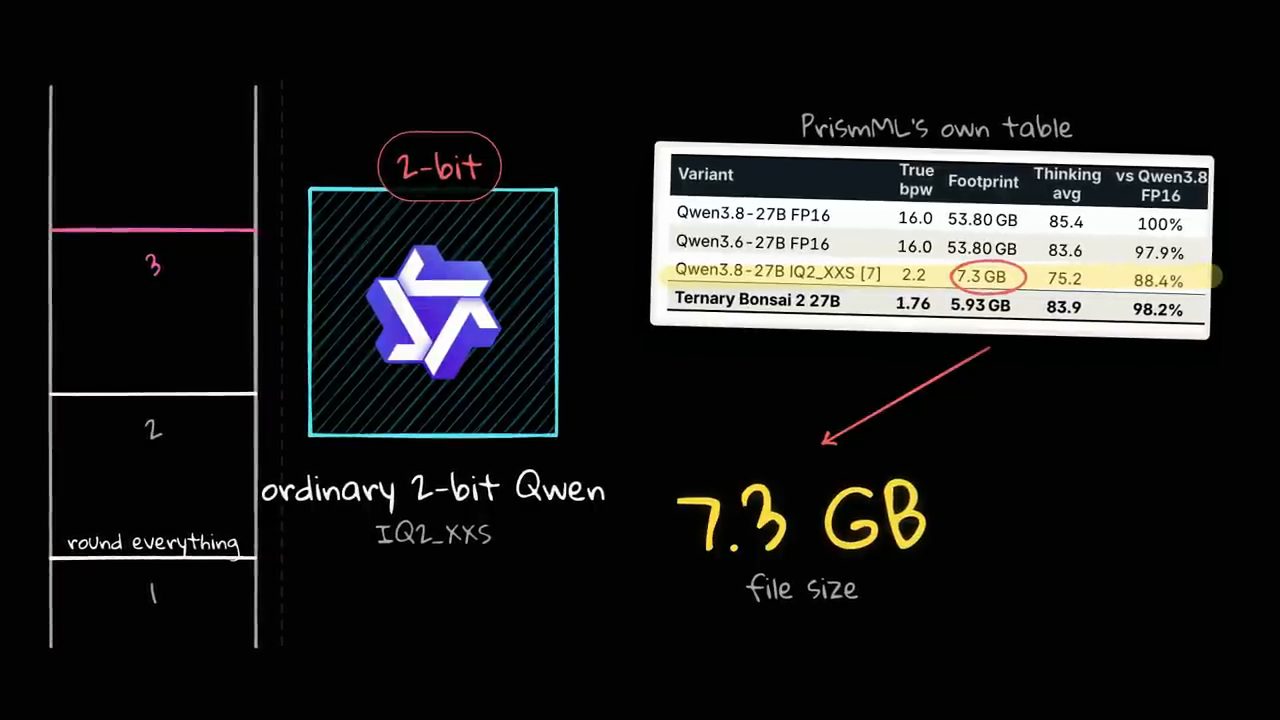
Rồi có một phiên bản khôn hơn của ý tưởng ấy, mà Muhammad đã nói trong video DwarfStar trước đây của anh (nhắc lại trong video đăng ngày 28/09/2026). Insight ở đó là bạn không quantize mọi thứ: bạn giữ phần quan trọng nhất của model ở precision cao hơn (trên màn hình: 16-bit cho phần "matters most"), và quantize mạnh tay phần còn lại (2-bit cho "the rest"). Nên đó thực chất là selective quantization, nhưng vẫn là làm tròn một model đã được train xong.
4. Bonsai 2 đi một đường khác: train lại vào định dạng mới
Bonsai 2 đi một con đường rất khác. Theo PrismML (như Muhammad kể trong video đăng ngày 28/09/2026), nó bắt đầu từ bản pre-trained Qwen3.8-27B, rồi được train vào một định dạng mới, thay vì chỉ bị làm tròn vào đó. PrismML nói việc train được làm trên TPU của Google, nhưng theo Muhammad họ chưa công bố phương pháp, dữ liệu, hay lượng compute đã dùng. Nên một phần của nó đơn giản là black box.
Dù vậy, theo Muhammad (video đăng ngày 28/09/2026), ta vẫn có bộ weight cuối cùng và định dạng mà nó được quantize vào.
5. Ternary quantization và scale factor
Theo Muhammad (video đăng ngày 28/09/2026), Bonsai dùng một kỹ thuật gọi là ternary quantization: mỗi weight được chuyển thành một trong ba giá trị có thể, là âm một, không, hoặc cộng một. Trong trường hợp này, các weight dương lớn thành cộng một, các weight âm lớn thành âm một, còn các weight nhỏ bị làm tròn về không.
Họ còn dùng thêm một scale factor để giữ lại độ lớn của weight. Mỗi nhóm 128 weight dùng chung một scale, và weight thật về cơ bản là scale đó nhân với giá trị ternary. Muhammad nói bạn cần khoảng 1,7 bit cho mỗi weight để lưu các giá trị ternary cùng scale factor, nhỏ hơn khoảng chín lần so với 16 bit của bản full precision Qwen3.8-27B. Trên màn hình là 1.7 so với 16 bit, "≈ 9x smaller"; bảng của PrismML ghi 1.76 bit mỗi weight. Whitepaper của PrismML (đọc ngày 24/10/2026) mô tả định dạng này là "Ternary g128 (FP16 group-wise scaling)".
6. Rotation để làm phẳng outlier, và chú thích nhỏ về con số trung bình
Họ dùng thêm một mẹo nữa. Trong bất kỳ neural network tiêu chuẩn nào, sẽ có một số ít weight cực lớn làm hỏng hoàn toàn cái scale dùng chung cho cả nhóm 128 weight. Để sửa, trước khi biến mọi thứ thành ternary, họ áp một rotation matrix để làm phẳng những đỉnh nhọn khổng lồ đó, trải chúng ra trên toàn bộ các giá trị. Khi các outlier đã được trải ra, việc nhét chúng vào ba giá trị riêng biệt trở nên gọn gàng hơn nhiều. Whitepaper của PrismML (đọc ngày 24/10/2026) gọi phần này là "Blockwise Hadamard rotation".
PrismML tuyên bố cách này giúp giữ được trí thông minh của model. Một bản 2-bit ngây thơ giữ khoảng 88%, còn Bonsai thu nhỏ footprint hơn nữa mà vẫn đạt mức 98% trên các benchmark chính (theo bảng của PrismML trong video đăng ngày 28/09/2026). Ý tưởng là bạn có một file nhỏ hơn đi kèm performance tốt hơn, điều mà Muhammad nhận xét là hơi ngược với những gì thường xảy ra.
Một chi tiết quan trọng anh muốn nhấn mạnh: con số 98% đó là trung bình trên 20 benchmark, và được đo khi thinking của model bật ở mức effort tối đa (theo Muhammad, video đăng ngày 28/09/2026; whitepaper của PrismML, đọc ngày 24/10/2026, ghi bộ đánh giá gồm 20 benchmark, mọi model chạy ở thinking mode). Anh dặn người xem nhớ điều này, vì nó sẽ quay lại trong các thử nghiệm của anh.
7. Single shot khác agentic loop
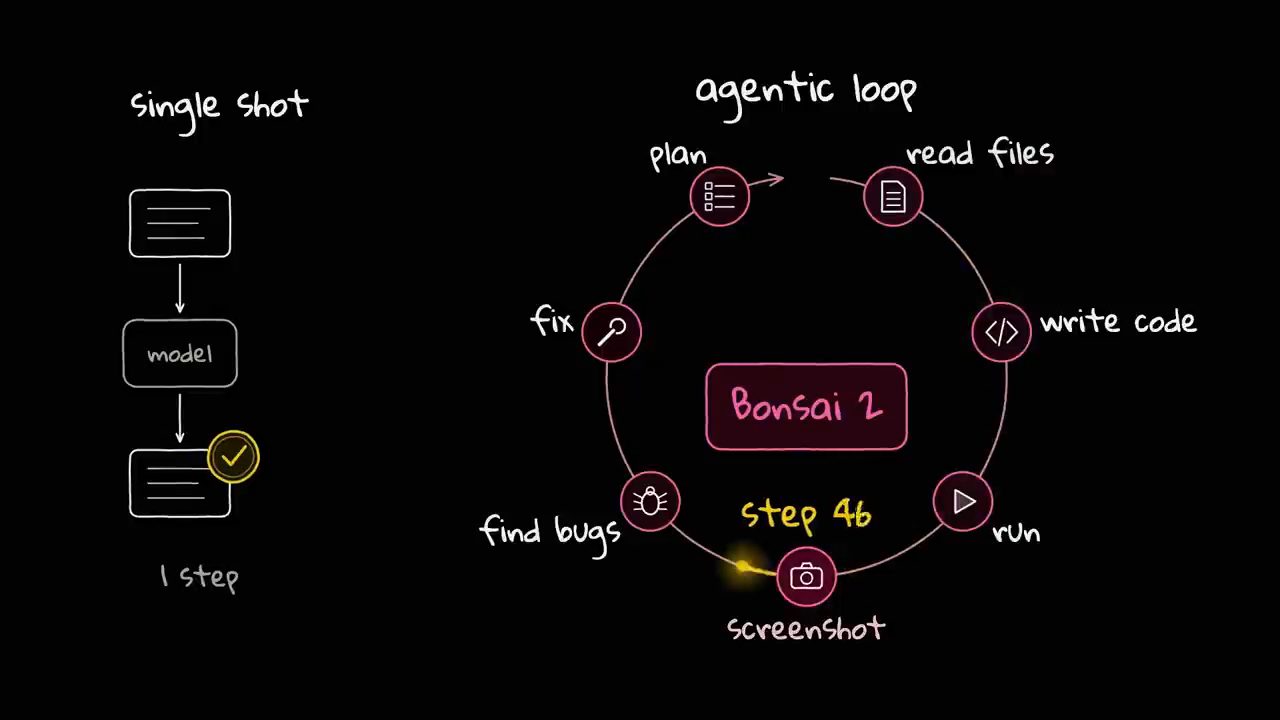
Theo Muhammad (video đăng ngày 28/09/2026), phần lớn các benchmark này và phần lớn các so sánh bạn sẽ thấy là single shot: bạn đưa prompt cho model, nó trả lời, và bạn chấm câu trả lời. Nhưng đó không phải cách chúng ta dùng các model này trong một agentic setup.
Trong một agentic loop, model sẽ đọc file, viết code, chạy nó, chụp screenshot, tìm bug, sửa bug, và lập kế hoạch quanh tất cả những việc đó. Để làm hết chừng ấy thứ, đôi khi nó phải đi qua hàng chục hoặc hàng trăm bước (theo Muhammad, video đăng ngày 28/09/2026). Vì vậy câu hỏi thật sự mà anh muốn kiểm là: con số 98% đó có còn đứng vững trong một agentic loop không?
8. Thiết lập thử nghiệm: cùng harness, tắt thinking
Đây là setup Muhammad đã thử (video đăng ngày 28/09/2026). Một bên là Bonsai 2 chạy local trên máy Mac của anh, qua bản fork llama.cpp của chính PrismML. Bên kia là bản gốc Qwen3.8-27B ở full precision, đúng là bản mà PrismML dùng để so sánh. Anh không chạy được model đó trên MacBook của mình, nên gọi nó qua API của một dịch vụ API trung gian cho model.
Cả hai model đều chạy bên trong Pi, agentic coding harness mà anh đang dùng (tính đến video đăng ngày 28/09/2026), với cùng tool, cùng prompt và cùng instruction. Với cả hai, anh tắt thinking, vì muốn có một baseline thật sạch cho chính bản thân model. Anh cũng nói trước rằng việc tắt thinking có lộ ra ở các task khó hơn, phần sẽ xem ngay sau đây.
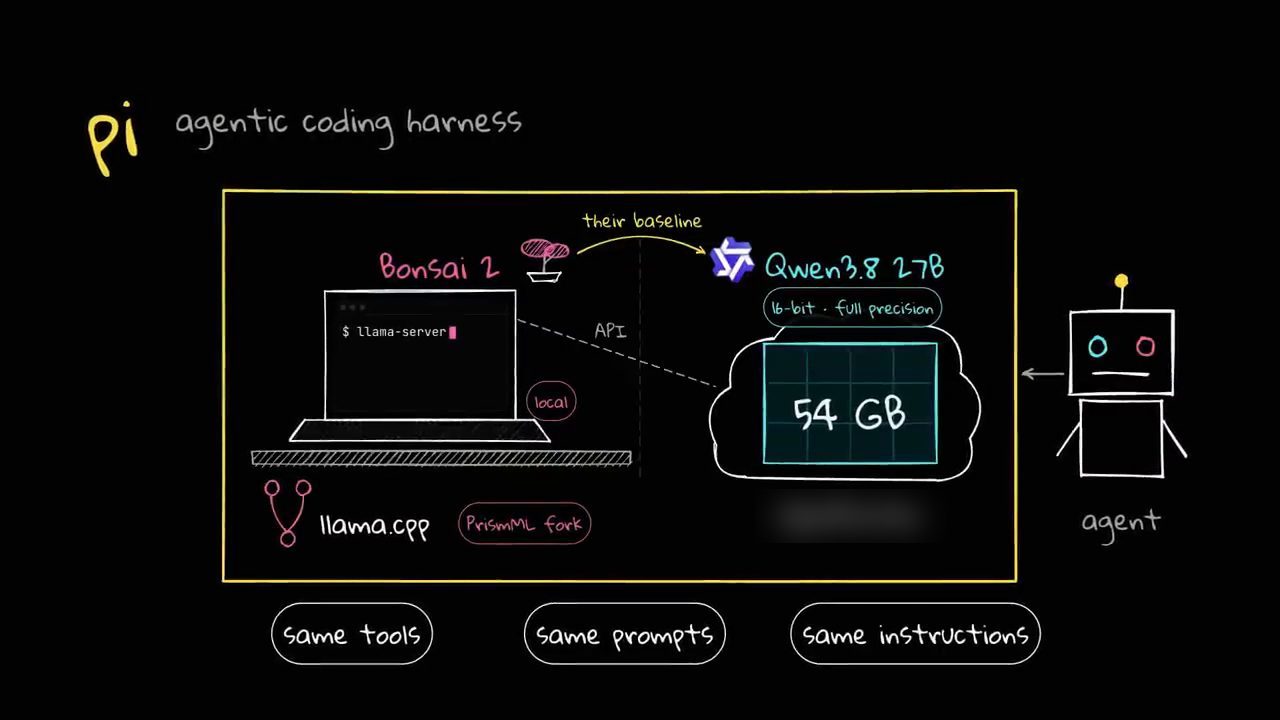
llama-server (llama.cpp, nhãn "PrismML fork"); Qwen3.8 27B bản 16-bit full precision, 54 GB, nằm trên cloud và được gọi qua API, mũi tên "their baseline" nối hai bên. Bên dưới: same tools, same prompts, same instructions.Thêm một ghi chú: PrismML cũng có hỗ trợ native cho MLX framework của Apple. Nhưng trong thử nghiệm của Muhammad (video đăng ngày 28/09/2026), bản MLX chậm hơn nhiều so với llama.cpp, nên anh chọn llama.cpp.
9. Hai loại test và một grader khách quan
Muhammad chạy hai kiểu test khác nhau (video đăng ngày 28/09/2026). Bộ thứ nhất là loại task ngắn mà người ta thường thử. Bộ thứ hai là các bản build agentic dài.
Với bộ thứ hai, anh không chỉ nhìn bằng mắt rồi đánh giá (video đăng ngày 28/09/2026). Mỗi bản build đi kèm một checklist các yêu cầu cụ thể, và một script tự động kiểm từng yêu cầu. Anh nhấn mạnh điều này quan trọng: anh không dựa vào kiểu "nhìn thấy ổn là được". Đây là một bài test khách quan: chẳng hạn ta có một số feature nhất định muốn agent build, rồi grader thật sự kiểm xem agent đã build những feature đó hay chưa.
10. Vòng 1: các task ngắn
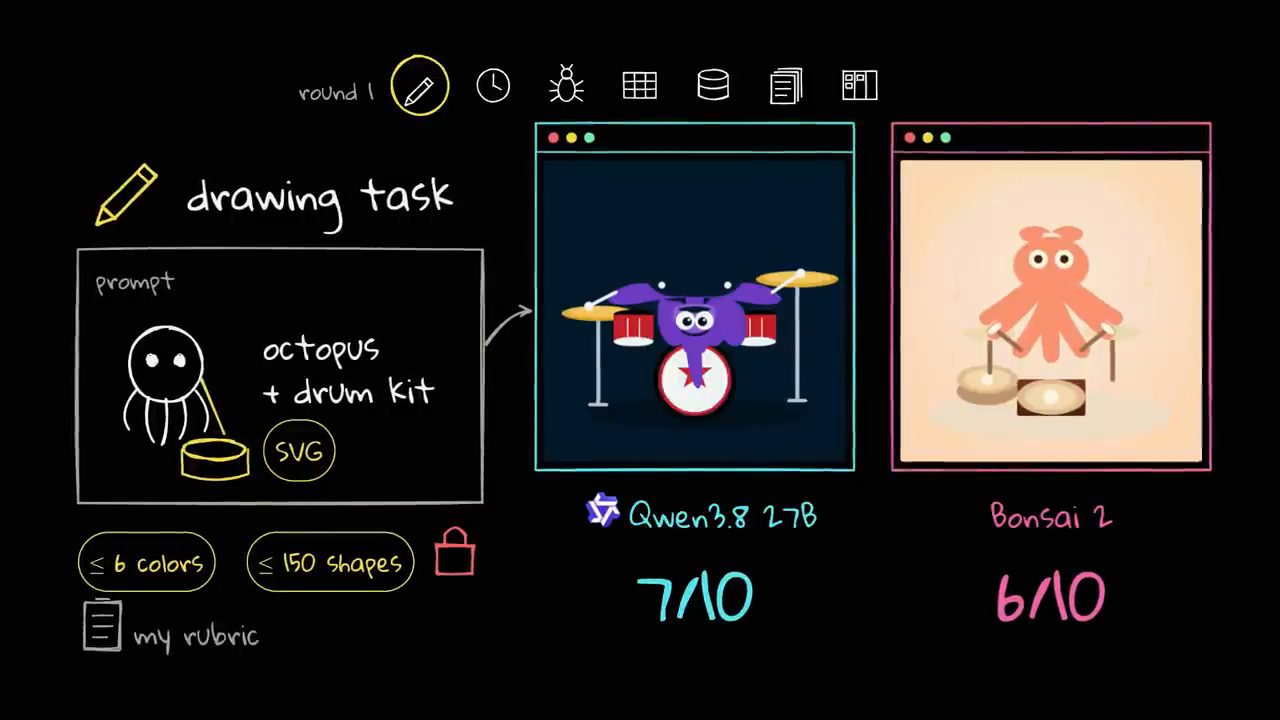
Bắt đầu với các task đơn giản hơn. Task thứ nhất là vẽ: prompt yêu cầu vẽ một con bạch tuộc đang chơi bộ trống dưới dạng SVG, với giới hạn chặt về số màu và số hình. Theo rubric của Muhammad (số đo trong video đăng ngày 28/09/2026), Qwen được 7 trên 10, Bonsai được 6. Hai bên khá sát nhau.
Tiếp theo là một chiếc đồng hồ kim phải hiển thị đúng giờ lấy từ URL anh đưa vào (trên màn hình là ?t=10:08:37). Task này khó hơn vẻ ngoài, vì checker đo vị trí của từng kim chính xác tới vài độ. Ở đây cả hai đều vật lộn: theo số đo của anh (video đăng ngày 28/09/2026), Qwen được 3, Bonsai được 4.
Rồi tới một task debugging. Anh đưa cho cả hai model một game Breakout có sáu bug được cài sẵn. Bốn bug do người chơi báo, hai bug chỉ tìm ra được khi đọc code. Thú vị là theo số đo của Muhammad (video đăng ngày 28/09/2026), Bonsai sửa được năm trên sáu bug và được 8,5 điểm, còn Qwen được 7.
Sau đó là hai task agentic ngắn. Một là một bảng tính doanh số lộn xộn có bốn cái bẫy ẩn, như các dòng trùng lặp và chuyện lẫn lộn đơn vị tiền tệ. Hai là một báo cáo hoàn tiền bị hỏng trong một database. Cả hai model đều bắt được mọi cái bẫy và sửa xong báo cáo (demo trong video đăng ngày 28/09/2026; trên màn hình mỗi bên 10/10 ở cả hai task). Anh thấy điều này khá đáng khích lệ: với các task đơn giản, có vẻ hai model ngang ngửa nhau.
Kế đến là một bài test long context. Anh đưa cho cả hai một codebase thật khoảng 100.000 token, có cài sẵn một số thông tin, rồi hỏi bảy câu. Cả hai đều trả lời đúng hết (demo trong video đăng ngày 28/09/2026, trên màn hình 7/7 cho mỗi bên).
Task cuối là một bản clone Linear ngắn trong một file duy nhất, và cả hai model đều làm ra một trang bị crash ngay khi tải (demo trong video đăng ngày 28/09/2026). Tức là cùng một kiểu thất bại ở cả hai bên.
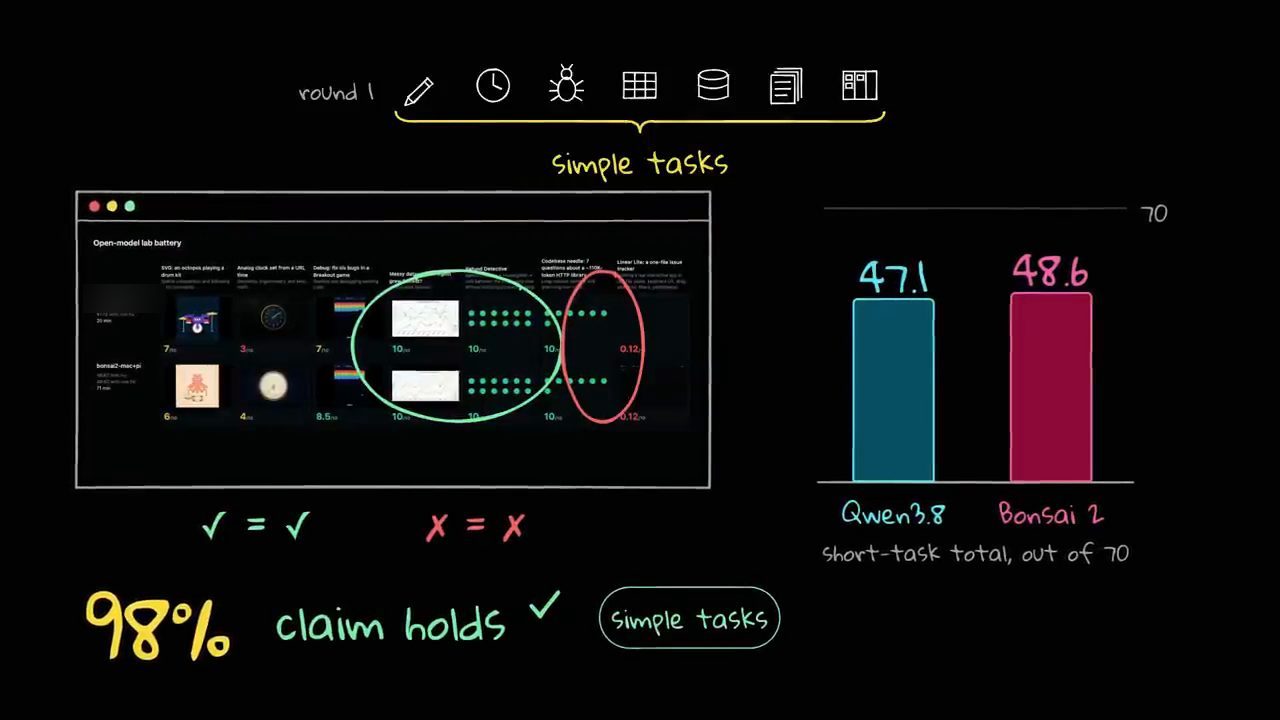
Vậy với các task đơn giản, cả thành công lẫn thất bại của hai model trông rất giống nhau. Muhammad nói rằng con số 98% thật sự đứng vững với các task đơn giản, ngay cả khi tắt thinking (theo số đo của anh, video đăng ngày 28/09/2026). Nhưng tất cả những task này đều là loại bạn có thể hoàn thành trong một câu trả lời, hoặc chỉ trong vài bước.
11. Vòng 2: sáu bản build agentic
Giờ tới vòng hai, các bản build agentic. Bộ thứ hai gồm sáu bản build thật (video đăng ngày 28/09/2026). Thứ nhất là mô phỏng một hố đen với hiệu ứng gravitational lensing. Thứ hai là một trận đánh tàu cướp biển theo phong cách 1-bit Mac. Thứ ba là một con rùa biển dạng voxel trên rạn san hô. Thứ tư là một ISS tracker đặt trạm vũ trụ lên một quả địa cầu 3D theo vị trí thật. Thứ năm là một launch page dựng từ một research brief. Và cuối cùng là một bản clone Linear đầy đủ với teams, cycles, phím tắt bàn phím và undo.
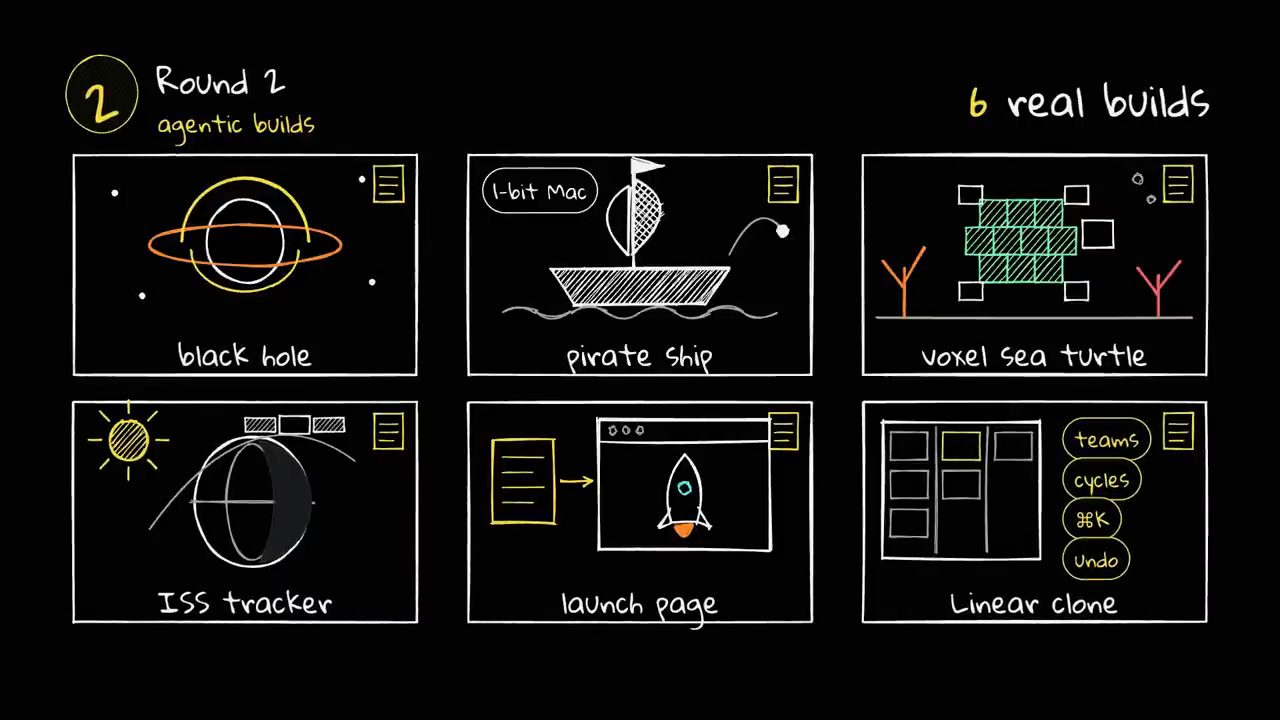
Ở vòng này, model phải thật sự lập kế hoạch, viết nhiều file, chạy chúng, xem screenshot và sửa những gì bị hỏng. Theo số đo của Muhammad (video đăng ngày 28/09/2026), Qwen được 35 trên 60. Nó build bản Linear qua được 19 trên 24 yêu cầu. Launch page qua 11 trên 13. ISS tracker được 9 trên 13. Cảnh rùa biển được 9 trên 15.
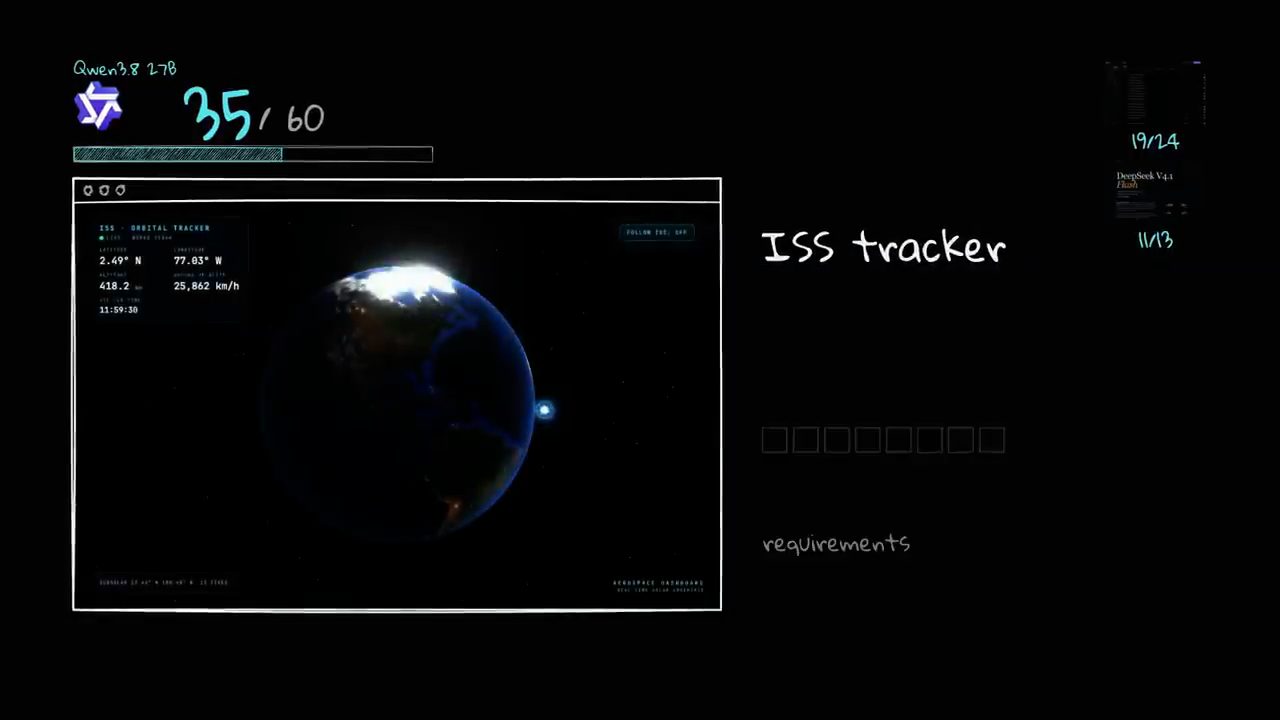
Qwen vật lộn với phần đồ hoạ khó nhất, như vật lý của hố đen và các quy tắc pixel chặt chẽ của cảnh cướp biển. Nhưng theo anh (demo trong video đăng ngày 28/09/2026), nó vẫn ship được một app thật sự chạy được.
12. Bonsai không ra được app nào chạy
Bonsai thì sụp hoàn toàn ở vòng này. Theo số đo của Muhammad (video đăng ngày 28/09/2026), nó không làm ra được một trang chạy được nào trên cả sáu task. Ở năm trong sáu task, nó thậm chí chưa bao giờ tạo được một trang nào trong thư mục project của mình.
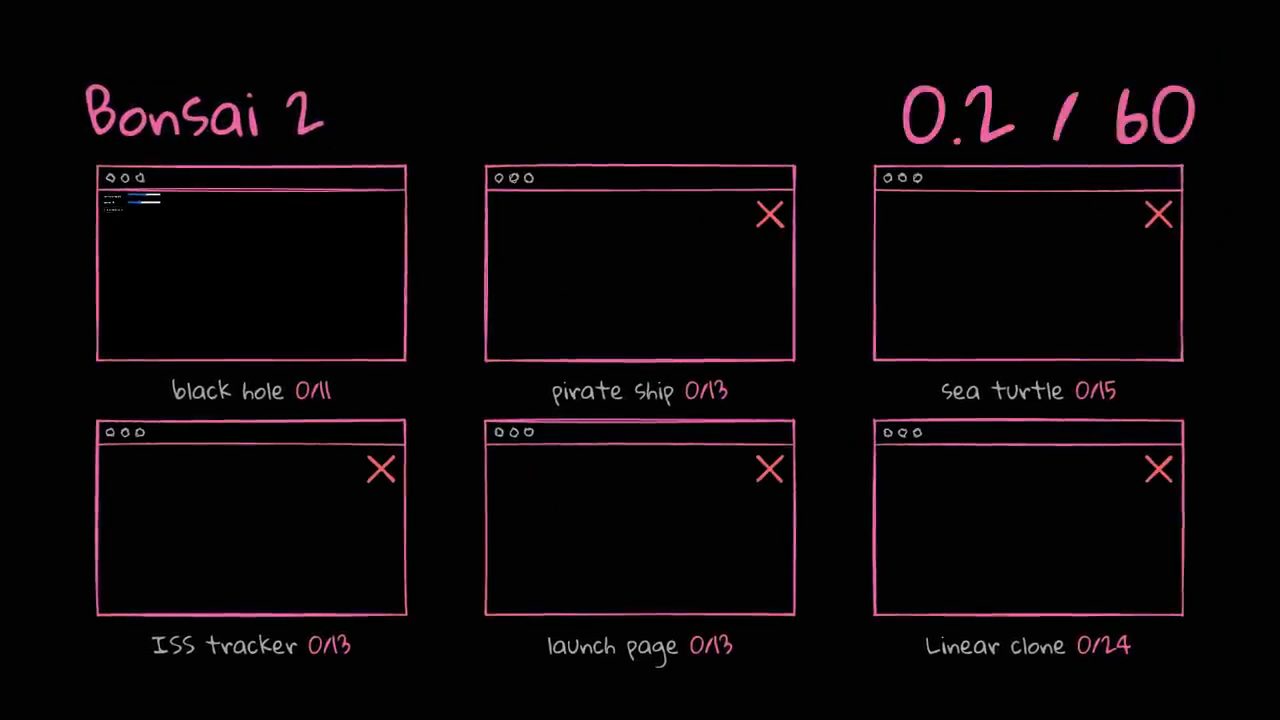
Có một điều anh muốn chỉ ra: Bonsai chạy trên máy Mac của anh, còn Qwen chạy qua API. Vì vậy anh quay lại một loạt lần chạy trước đó trên DGX Spark của mình, khoảng 10 ngày trước đó (theo anh kể trong video đăng ngày 28/09/2026). Ở loạt đó Bonsai được cho hàng giờ cho mỗi task, và nó vẫn thất bại theo đúng cùng một kiểu.
13. Đọc log: đi loanh quanh và lặp lại
Theo Muhammad, đây là chỗ rất quan trọng phải nhìn vào lý do vì sao những thất bại này xảy ra. Anh giữ lại toàn bộ log và tìm thấy vài điều rất thú vị (video đăng ngày 28/09/2026).
Thứ nhất, trên các task khó, Bonsai thường kẹt ở việc chỉ đi loanh quanh xem xét. Có lần nó thực hiện 153 tool call trên task ISS tracker, và 150 trong số đó chỉ là nhìn quanh: đọc file, liệt kê file và tìm kiếm (theo log anh đọc, video đăng ngày 28/09/2026).
Thứ hai là lặp vòng (looping). Anh để ý rằng trên nhiều task khó, Bonsai sẽ chạy một tool, nhận kết quả, rồi lại chạy chính tool đó và nhận đúng kết quả ấy, lặp đi lặp lại. Ví dụ, trong một trường hợp nó chạy một tool 114 lần. Khi so trực tiếp với Qwen, lần lặp tệ nhất của Qwen trên cả sáu project chỉ là sáu (số đo của Muhammad, video đăng ngày 28/09/2026).
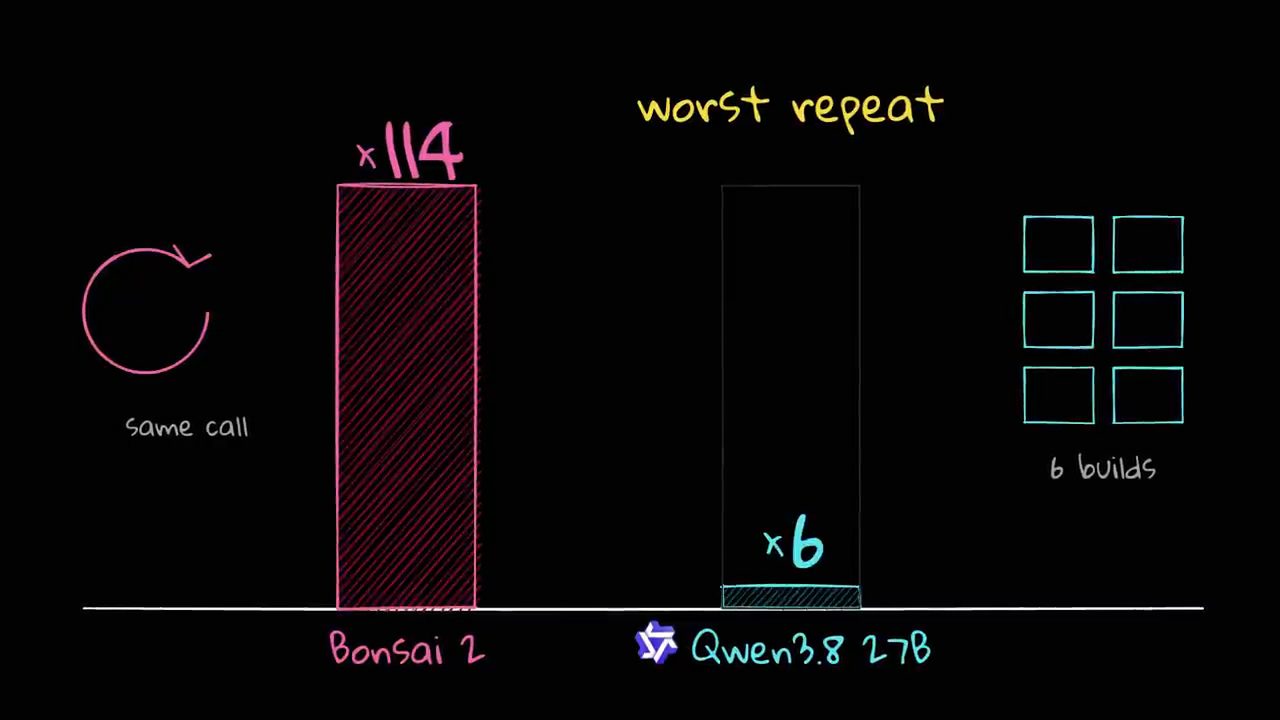
Qwen cũng có vấn đề riêng. Ở cảnh cướp biển, nó mất khoảng 40 phút để đuổi theo một lỗi cú pháp trong chính code của nó. Và nó có thói quen viết lại cả file thay vì sửa từng chỗ (theo log Muhammad đọc, video đăng ngày 28/09/2026). Nhưng theo anh, đó là lỗi của một model đang thật sự build một thứ gì đó.
Pattern của Bonsai thì rất khác. Theo Muhammad (video đăng ngày 28/09/2026), nó có thể viết code hoàn toàn trôi chảy, nhưng dường như không nhận ra là nó đã làm xong một việc nào đó rồi. Nên trên các task khó hơn, về cơ bản nó không bao giờ đi tiếp được.
14. Whitepaper của PrismML cũng chỉ ra điều đó
Sau khi chạy xong thử nghiệm, Muhammad cố tìm hiểu chính xác chuyện gì đang xảy ra, và anh nhận thấy whitepaper của chính PrismML cũng chỉ về cùng một hướng. Họ dẫn con số 98% trên 20 benchmark ngắn hơn, nhưng paper của họ cũng báo cáo hai benchmark agentic dài, và hai benchmark đó không nằm trong con số trung bình (theo Muhammad, video đăng ngày 28/09/2026).
Trên Terminal-Bench 2.1, Bonsai giữ được khoảng 76% điểm của model gốc. Trên SWE-bench Verified, benchmark được dựng từ các GitHub issue thật, con số là khoảng 75%. Whitepaper (đọc ngày 24/10/2026) ghi Ternary Bonsai 2 27B đạt 52.8 và 60.8, so với 69.7 và 80.6 của Qwen3.8-27B, "giữ lại khoảng ba phần tư" performance của bản full precision trên cả hai benchmark.
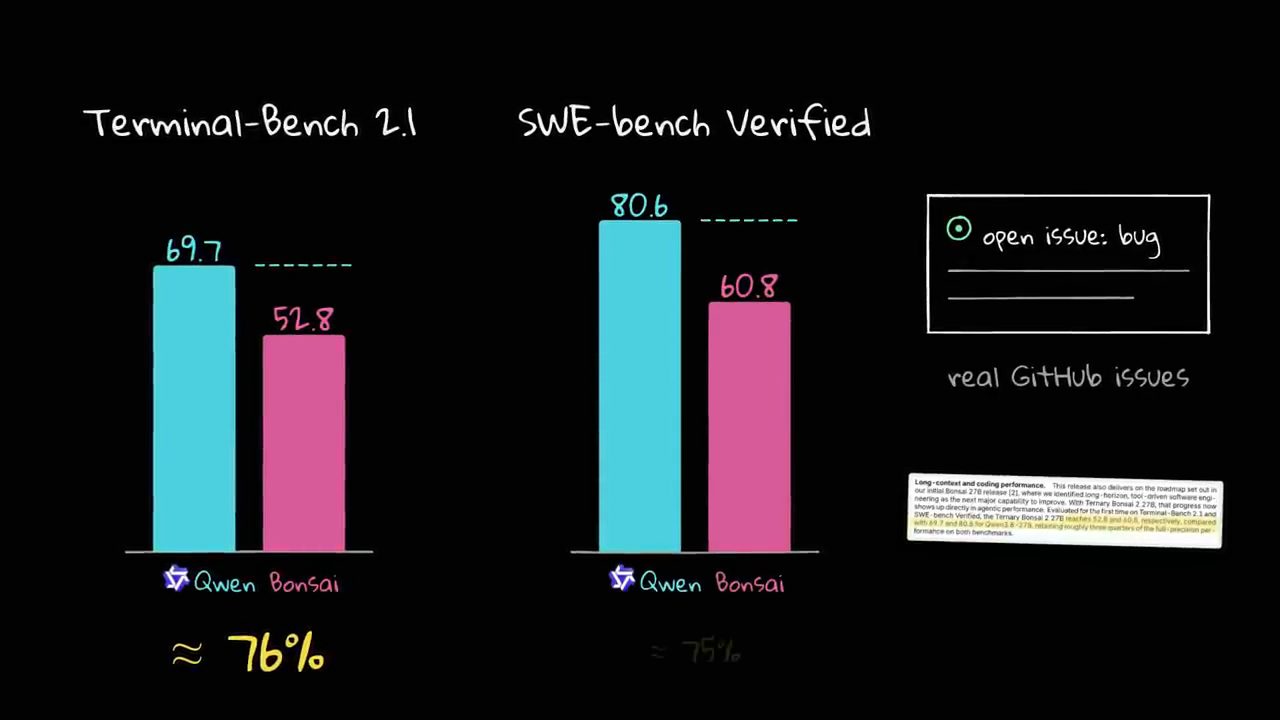
Để công bằng, Muhammad nói đó vẫn là một điểm số ấn tượng với một model cỡ này (nhận định trong video đăng ngày 28/09/2026). Nhưng nó cho thấy đây là một model tốt cho các task ngắn hơn.
15. Bài học và kết luận về Bonsai 2
Vậy rút ra được gì? Bài học thứ nhất: khớp nhau trên benchmark không có nghĩa là khớp nhau trong công việc agent thật. Theo số đo của Muhammad (video đăng ngày 28/09/2026), trên các task ngắn Bonsai về cơ bản hoà với model đầy đủ, nhưng trên các bản build dài thì nó không thể hoàn thành được việc gì, ít nhất là trong các thử nghiệm của anh.
Bài học thứ hai: nếu bạn chạy agent local, hãy đọc trace của chúng, vì trace sẽ cho bạn biết chính xác chuyện gì đang xảy ra với agent. Theo Muhammad (video đăng ngày 28/09/2026), việc này cũng giúp bạn cải thiện agent loop của mình.
Bài học thứ ba: nếu muốn chạy model này trên MacBook, anh khuyên thử bản llama.cpp của PrismML cho bất cứ việc gì agentic, vì nó cache cuộc hội thoại giữa các bước, còn bản MLX thì không, ít nhất là tính đến lúc quay video (video đăng ngày 28/09/2026).
Cuối cùng, Bonsai 2 đứng ở đâu? Muhammad nói với chat, coding help nhanh và các tool call ngắn trên laptop, nó thật sự là một model khá tuyệt, và compression thật sự hiệu quả ở đó. Còn với công việc agent dài, không có người giám sát, anh vẫn sẽ chọn một model đầy đủ (nhận định trong video đăng ngày 28/09/2026).
Theo anh, compression cho phép chúng ta chạy những model lớn này trên máy local, nhưng nhìn chung nó không thật sự giữ được trí thông minh thực sự của model (nhận định trong video đăng ngày 28/09/2026). Anh dặn người xem nhớ điều đó khi cân nhắc dùng một model local đã quantize thay vì một bản đầy đủ lớn hơn. Anh kết video bằng lời cảm ơn người xem và hẹn gặp ở video sau.
Nguồn và liên kết 8 nguồn
- Tên gốc: Qwen 27B on 6GB VRAM...
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=jxOOiNUB9DQ youtube.com
- Kênh YouTube Prompt Engineering (Muhammad Farooq): youtube.com/channel/UCDq7SjbgRKty5TgGafW8Clg youtube.com
- Bài blog của PrismML giới thiệu Ternary Bonsai 2 27B, đăng ngày 17/09/2026 (ternary weight với FP16 group-wise scaling, 1.76 bit mỗi weight, 5.9GB, 98.2% so với bản full precision; đọc ngày 24/10/2026): prismml.com/news/bonsai-2-27b prismml.com
- Whitepaper Bonsai 2 27B của PrismML (định dạng Ternary g128, Blockwise Hadamard rotation, 20 benchmark ở thinking mode, Terminal-Bench 2.1 và SWE-bench Verified; đọc ngày 24/10/2026): github.com/PrismML-Eng/Bonsai-demo/blob/main/bonsai-2-27b-whitepaper.pdf github.com
- Bản fork llama.cpp của PrismML (README của repo Bonsai-demo, đọc ngày 24/10/2026, ghi hai định dạng PQ2_0 và PTQ1_0 vẫn cần bản fork này): github.com/PrismML-Eng/llama.cpp github.com
- Bộ model Bonsai 2 trên Hugging Face (đọc ngày 24/10/2026): huggingface.co/collections/prism-ml/bonsai-2 huggingface.co
Related talks
Hướng dẫn đầy đủ về Warp Factories
Benjamin Holmes · Warp · 19 min
Đi hết Warp Factories: dựng factory, agent và automation as code, chạy từ Slack, rồi đo cost per PR, scoring, self-improvement và benchmark.
Muse Wonder Full qua sáu project KingBench 4: kiểm từng app, điểm, token và chi phí
AICodeKing · AICodeKing · 24 min
Muse Wonder Full của Meta làm sáu app KingBench 4: kiểm từng app chạy được gì, điểm so với Standard Wonder, Opus 5.5, GPT-6, token và chi phí ước tính.
Thử Gemini 4 Argon: 1 triệu output token và agent chạy hàng giờ
Muhammad Farooq · Prompt Engineering · 20 min
Thử Gemini 4 Argon: continuation token cho 1 triệu output token, cách prompt output dài, chọn reasoning effort, và vì sao grader phải nằm ngoài sandbox.