ReviewDebt: a practical framework for scoring every pull request
AI Engineer World's Fair 2026: Online Track · Video gốc
ReviewDebt chấm mỗi PR bằng năm tín hiệu deterministic để đo khoảng trống giữa code coding agent tạo ra và code con người thật sự review.
1. Khoảng trống không ai đo
Sachin Gupta mở đầu bằng lời chào và tự giới thiệu ngắn: anh là một software engineer. Tên talk nói đúng điều nó muốn nói: coding agent của bạn đang tạo ra review debt, một dạng nợ về review. Trước khi vào nội dung, anh đề nghị người nghe ngồi lại với cái tên đó một chút và để ý xem nó không nói gì. Anh không nói coding agent là thứ tệ. Anh cũng không nói chúng không làm chúng ta nhanh hơn. Điều anh nói là chúng đang tạo ra một loại nợ mà chưa ai đo, và món nợ đó rồi sẽ tới hạn phải trả.
Anh nêu lộ trình cho mấy phút tiếp theo. Đầu tiên anh định nghĩa review debt là gì. Sau đó anh đi qua năm nhóm tín hiệu (signal family) cùng nhau cấu thành nó. Tiếp theo anh chấm điểm ba pull request thật, đặt cạnh nhau. Cuối cùng anh cho xem một lần scan trên nhiều repo, hơn năm trăm PR, lấy từ ba codebase public. Rồi anh vào việc luôn.
Đầu tiên là khoảng trống mà không ai đang đo. Báo cáo Octoverse 2025 của GitHub, gần như bao trọn mọi pull request public trên hành tinh, cho thấy số commit tăng 25% so với năm trước. Nhưng cũng trong năm đó, số comment trên commit lại giảm 27%. Các comment này chính là proxy cho hoạt động review. Nghĩa là lượng code được sản xuất tăng lên, còn sự chú ý dành cho review thì giảm xuống. Hai đường đi ngược chiều nhau, và lại xảy ra ngay trong cùng một năm.
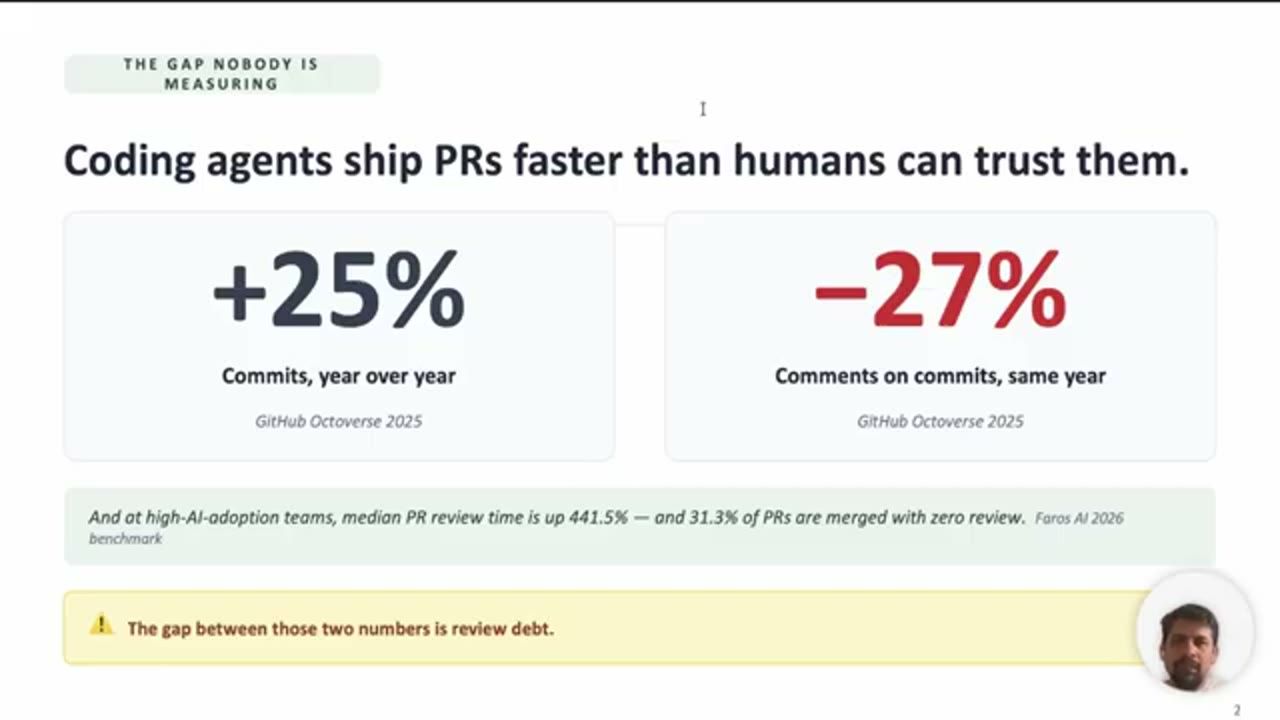
Giờ nhìn sang các team đã đi xa nhất trên đường cong áp dụng AI. Faros AI theo dõi nhóm này trong benchmark năm 2026 của họ. Thời gian review PR trung vị (median) tăng 441,5%. Nếu tính ra, anh nói, bạn sẽ thấy một PR giờ mất khoảng 5,4 lần thời gian review so với trước đây. Thêm nữa, số PR được merge mà không hề có review tăng thêm 31%.
Vậy là AI viết code rất nhanh, AI mở pull request rất nhanh, nhưng con người không thể review chúng một cách có trách nhiệm ở tốc độ đó. Khoảng trống này được gọi là ReviewDebt. Nó tích luỹ một cách lặng lẽ, nó cộng dồn lãi, và hiện giờ không ai có một con số cho nó. Sachin hứa rằng tới cuối talk, người nghe sẽ có được một con số cụ thể.
2. Câu chuyện mọi team đang kể: các vanity metric
Slide tiếp theo là câu chuyện mà team nào cũng đang kể lúc này. Số PR trên mỗi developer tăng 16%. Con số này lấy từ Faros AI Acceleration Whiplash Benchmark, công bố tháng 4 năm 2026, khảo sát khoảng 22.000 developer và 4.000 team. Kích thước PR trung vị tăng 63%, từ 44 dòng lên 72 dòng mỗi pull request. Đây là dữ liệu dài hạn mười sáu tháng từ nghiên cứu DX 2026, gồm bốn trăm tổ chức.
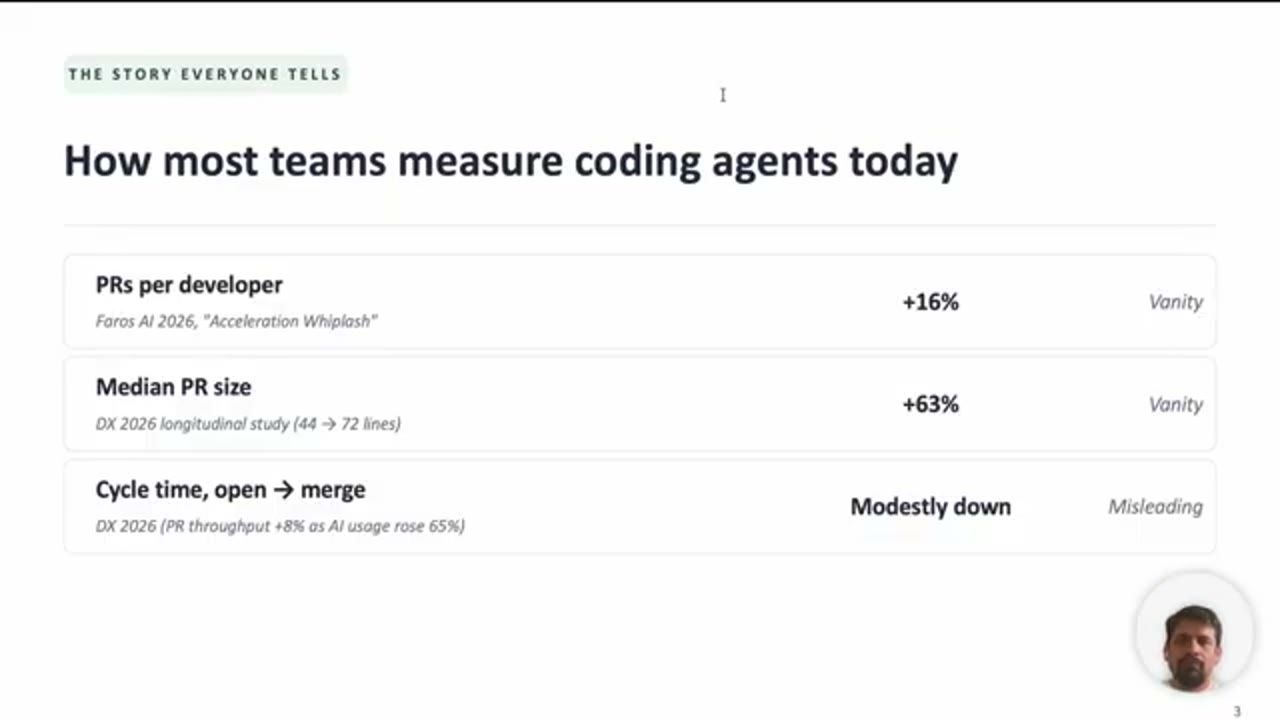
Cycle time, tính từ lúc mở PR tới lúc merge, có giảm nhưng chỉ ở mức khiêm tốn, cũng theo cùng nghiên cứu DX. Cách diễn giải thường rất hào phóng: throughput PR tăng khoảng 8%, trong khi mức sử dụng AI tăng khoảng 65%. Mức lợi mà chúng ta thấy hôm nay là có thật, nhưng nó nhỏ hơn nhiều so với lượng hype đang tồn tại.
Từng con số ở đây đều là thật. Không con số nào là nói dối. Nhưng mỗi con số đều là một vanity metric, chỉ số để khoe. Số PR tăng lên khi một PR bị chia thành bảy PR. Kích thước PR trung vị tăng lên không phải là lợi ích, đó thật ra là sự phình to (bloating). Cycle time giảm xuống khi reviewer thôi phản biện. Những chỉ số này cho bạn biết tốc độ sản xuất. Chúng không cho bạn biết tốc độ của niềm tin (the speed of trust).
3. Câu chuyện không ai kể: những chi phí ẩn
Nếu đi tìm câu chuyện thứ hai, câu chuyện không ai kể, bạn sẽ thấy những thứ sau.
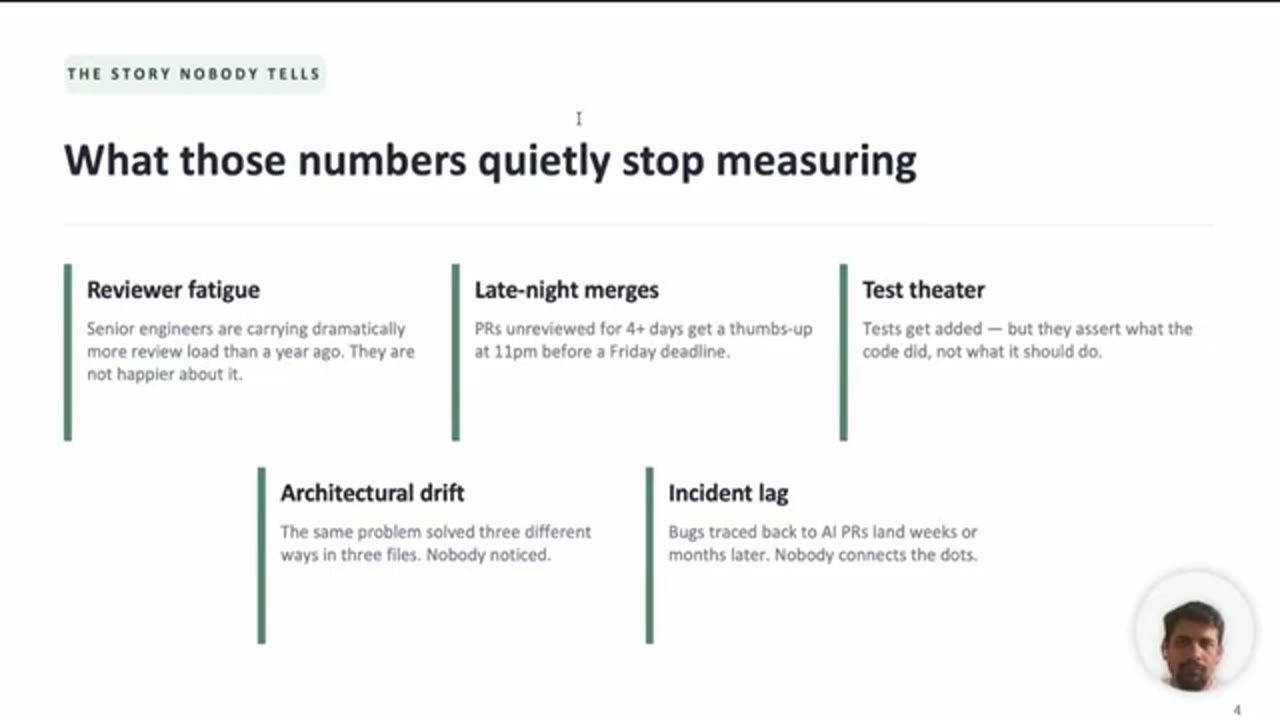
Reviewer fatigue (reviewer kiệt sức). Engineer đang gánh lượng review nhiều hơn hẳn so với một năm trước, và họ không vui hơn vì điều đó.
Late-night merges (merge lúc nửa đêm). PR nằm đó không ai review suốt ba, bốn ngày, rồi đột nhiên nhận một cái thumbs up lúc 11 giờ đêm, ngay trước deadline ngày thứ Sáu.
Test theater (test để diễn). Test có được thêm vào, nhưng chúng assert những gì code đã làm, không phải những gì code nên làm. Chúng khoá cứng hành vi hiện tại, kể cả bug.
Architectural drift (kiến trúc trôi dạt). Cùng một vấn đề được giải theo ba cách khác nhau trong ba file khác nhau. Không ai thật sự đang giữ sợi chỉ xuyên suốt của kiến trúc.
Incident lag (sự cố đến trễ). Khi có gì đó hỏng, bug xuất hiện sau khi merge hàng tuần hoặc hàng tháng. Không ai nối được các dấu chấm để lần ngược về thay đổi do AI viết.
Những chi phí này, theo Sachin, cho tới giờ chưa xuất hiện trên bất kỳ dashboard nào. Anh chuyển sang slide tiếp theo để đi sâu hơn.
4. Định nghĩa review debt và ba vòng feedback làm nó tích luỹ
Giờ là định nghĩa. ReviewDebt là khoảng cách đang tích luỹ giữa lượng code mà agent của bạn đã tạo ra và lượng code mà con người đã thật sự review, tin tưởng và hiểu. Nó nghe giống technical debt, nhưng bản chất gần với nợ tài chính hơn, vì nó tính lãi kép. Nó sinh lãi thật, chỉ có điều tiền lãi không trả bằng tiền mà trả bằng sự chú ý của con người.
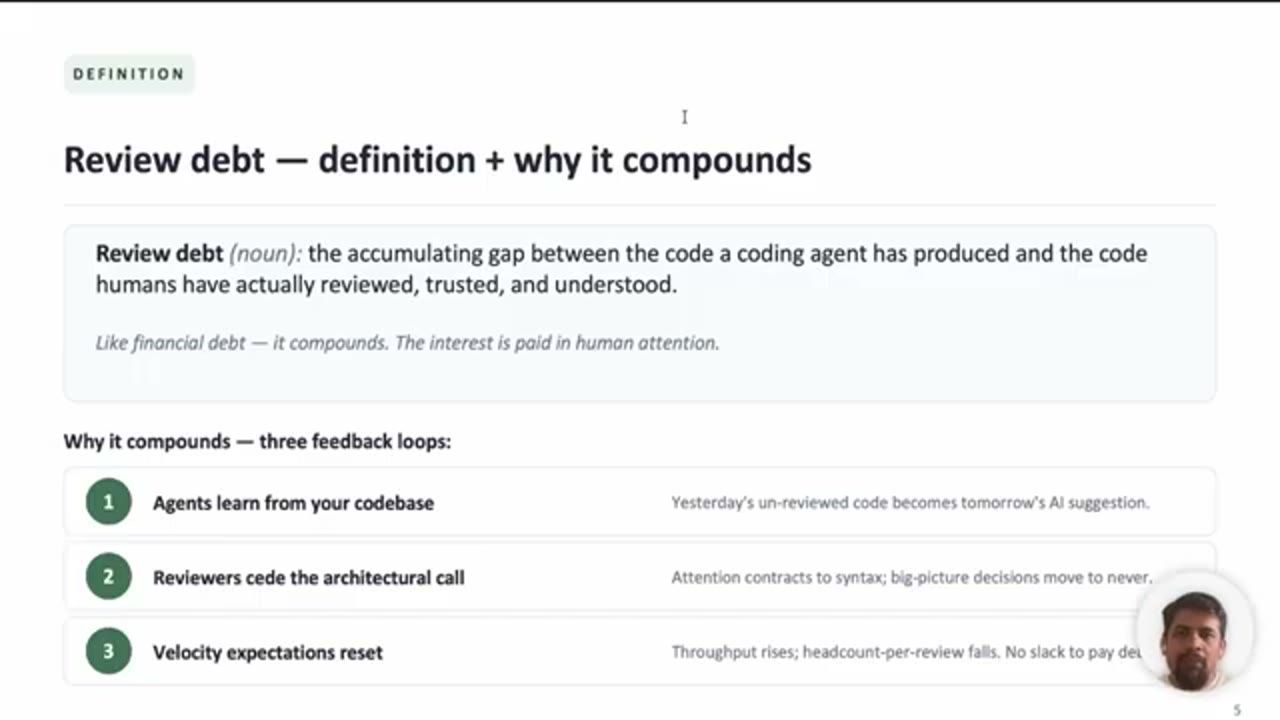
Nó compound vì ba vòng feedback.
Vòng thứ nhất: agent học từ codebase của bạn, qua fine-tuning, qua RAG grounding, qua các gợi ý trong context. Code hôm qua chưa được review kỹ sẽ trở thành nền (grounding) cho PR ngày mai. Món nợ này mang tính sinh sôi (generative): nợ cũ đẻ ra nợ mới.
Vòng thứ hai: reviewer nhường lại quyết định kiến trúc. Khi phần lớn một PR là code sinh ra, sự chú ý của reviewer co lại chỉ còn cú pháp và những bug hiển nhiên. Các quyết định bức tranh lớn bị dời từ lúc review sang... không bao giờ.
Vòng thứ ba: kỳ vọng về velocity bị đặt lại. Một khi leadership đã thấy throughput mới, bạn sẽ không được tuyển thêm reviewer theo đúng tỷ lệ. Không còn chút dư địa (slack) nào để trả món nợ đó.
Từng vòng riêng lẻ thì vẫn sống sót được. Gộp cả ba lại, bạn sẽ có một vòng xoáy mất kiểm soát (runaway). Câu hỏi tiếp theo là: bạn sẽ đo nó bằng cách nào?
5. Năm nhóm tín hiệu, mười check deterministic, không có LLM
Đo review debt bằng năm nhóm tín hiệu, tổng cộng khoảng mười check deterministic. Sachin nhấn mạnh từ khoá ở đây là deterministic. Mọi check đều tính được chỉ từ một pull request và repository của nó. Không cần đến language model nào cả.
Tại sao? Vì khi một LLM đóng vai trò giám khảo (LLM-as-a-judge), nó có thể làm hỏng hai thứ. Thứ nhất, điểm số trở thành một mục tiêu di động: cùng một PR, điểm bạn nhận được sẽ khác đi khi model của bạn thay đổi. Thứ hai, điểm số không còn bảo vệ được trong một buổi engineering review. Bạn không thể đưa nó lên slide, không thể đặt nó trước mặt leadership. Thứ bạn cần là một con số truy ngược được về một phép tính deterministic.
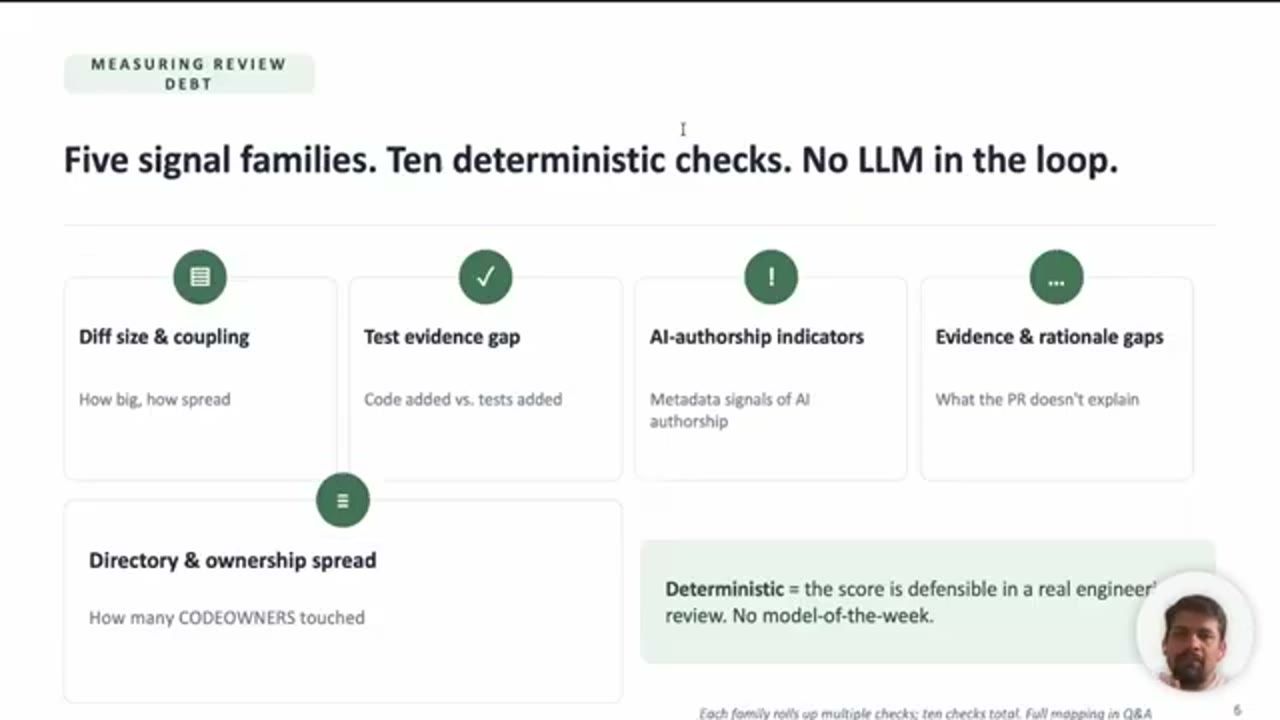
Năm nhóm đó là:
- Diff size và coupling.
- Test evidence gap.
- Directory và ownership spread.
- AI authorship indicators.
- Evidence và rationale gaps.
Năm nhóm này chứa mười check bên dưới. Sachin đi qua từng nhóm một.
6. Tín hiệu 1: diff size và coupling
Tín hiệu đầu tiên là diff size và coupling. Đây là tín hiệu đơn giản nhất để tính, nhưng cũng là tín hiệu hay bị đọc sai nhất. Nó đo số dòng thay đổi ròng (net lines changed), số file bị chạm vào, và việc các thay đổi tập trung trong một module hay trải rộng ra nhiều module.
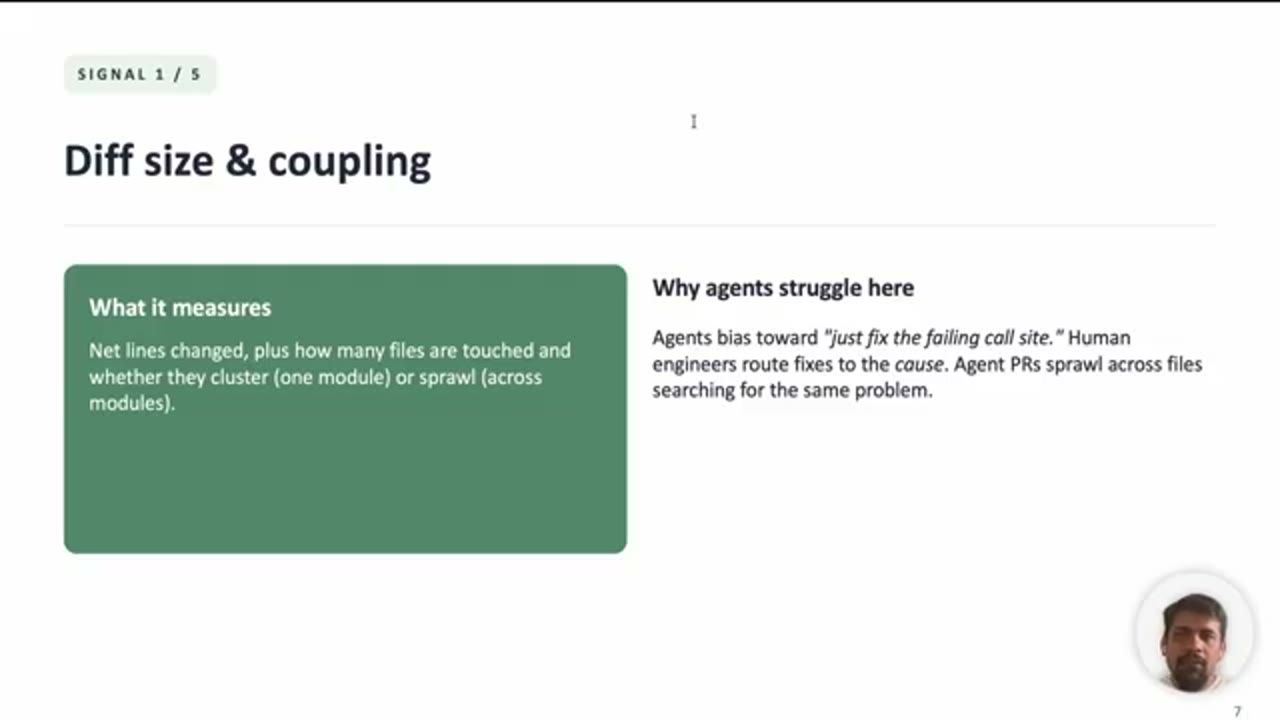
Tại sao agent gặp khó ở đây? Agent có thiên hướng sửa ngay tại call site, chỗ đang báo lỗi. Một engineer con người sẽ đưa bản fix về đúng gốc của vấn đề (root cause), và điều đó giữ cho diff rất nhỏ. Còn agent thì với tay vào nhiều file, đi tìm cùng một triệu chứng ở khắp nơi.
Chi phí review của một diff loang lổ không tỷ lệ thuận với kích thước của nó. Nó dốc hơn nhiều. Coupling giữa các file làm bùng nổ cái mental model mà reviewer phải giữ trong đầu cùng lúc.
7. Tín hiệu 2: test evidence gap
Tín hiệu thứ hai là test evidence gap. Nó đơn giản là số dòng test thêm vào chia cho số dòng production code thêm vào, tính trên từng pull request. PR do AI viết thường đi kèm tỷ lệ test trên code thấp hơn hẳn. Đôi khi không hề có file test nào, và nếu có thì cũng rất tối thiểu. Khoảng chênh này là một khoảng chênh nhất quán.
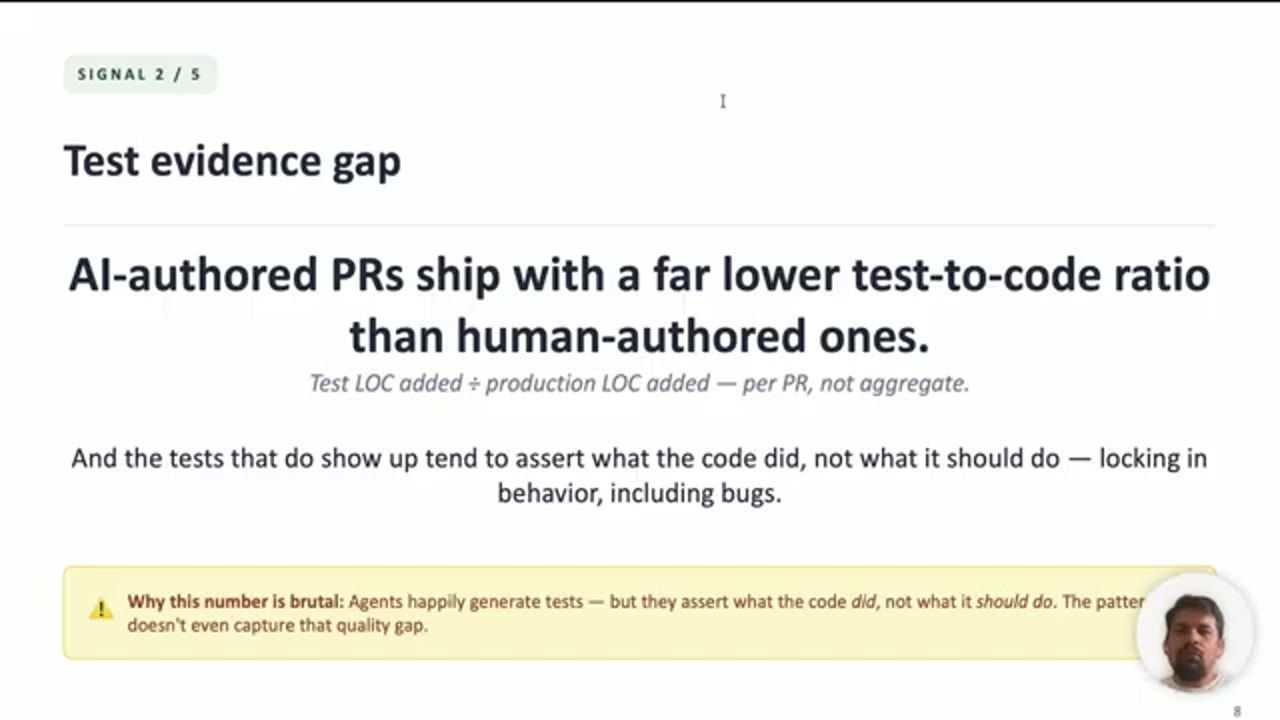
Vấn đề với tín hiệu này, lý do con số này tàn nhẫn (brutal), là agent có sinh test. Chúng sinh rất nhiều test. Nhưng các test đó assert điều code đang làm. Agent không sinh ra test case cho điều code thật sự nên làm. Những test này khoá cứng hành vi hiện tại, kể cả bug.
Tỷ lệ này không bắt được khoảng chênh về chất lượng. Nó chỉ đo xem test có xuất hiện hay không. Tín hiệu sâu hơn nằm ở một tầng bên dưới, và đó là bước tiếp theo.
8. Tín hiệu 3: directory và ownership spread
Tín hiệu thứ ba là directory và ownership spread. Cách tính: đếm số team code owner khác nhau có file xuất hiện trong diff.
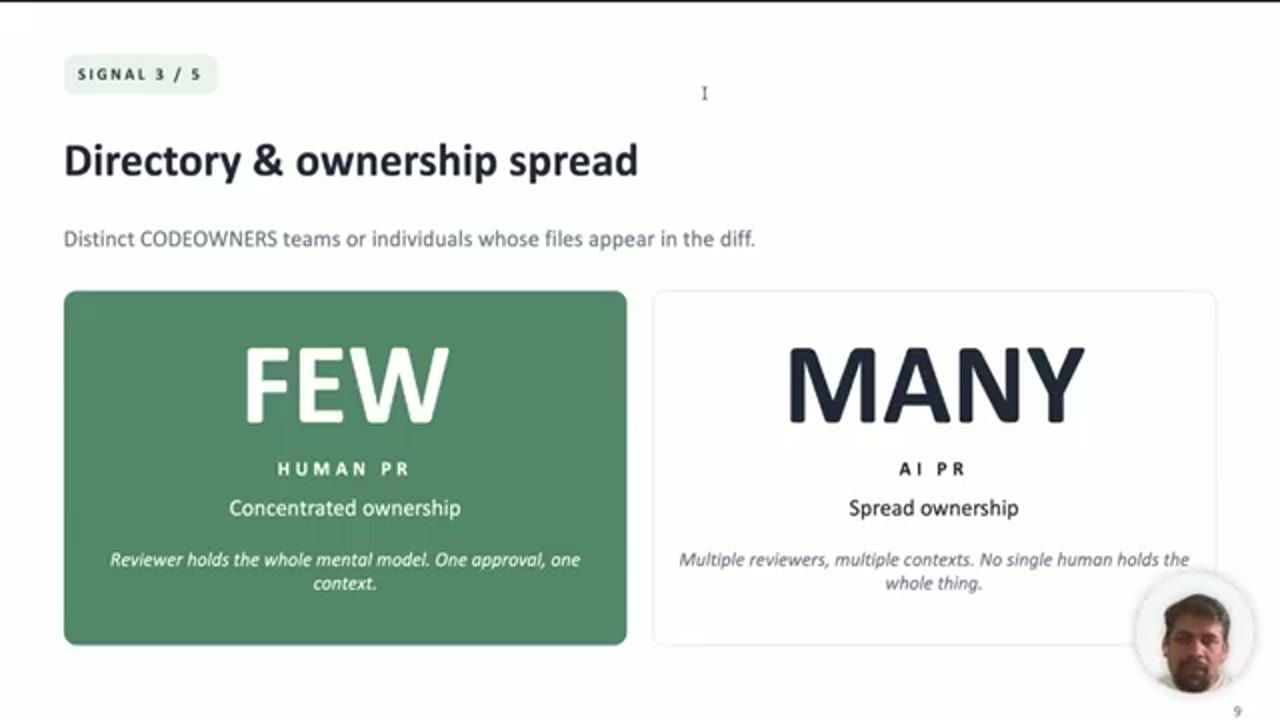
Nghĩa là gì? Một PR có hình dạng tốt sẽ tập trung trong lãnh thổ của một team. Một PR loang lổ sẽ với sang file của nhiều team, và chi phí review trong trường hợp này là khổng lồ. Không một người nào giữ được toàn bộ mental model. Bạn cần nhiều approval từ nhiều engineer, trong nhiều context khác nhau. Chi phí điều phối dễ dàng vượt quá lượng thời gian agent đã tiết kiệm khi viết code.
Đây là chỗ bạn bắt đầu cảm nhận được kinh tế học (economics) của review debt. Agent cho bạn những giờ gõ phím miễn phí. Rồi bạn tiêu chính những giờ đó để mua lại sự chú ý của nhiều reviewer từ nhiều phía.
9. Tín hiệu 4: AI-authorship indicators
Tín hiệu thứ tư là AI-authorship indicators. Trước khi mọi người bắt đầu phòng thủ, Sachin nói rõ: tín hiệu này không dùng để đổ lỗi. Họ không gắn cờ chuyện engineer dùng coding agent. Điểm số được thiết kế để một PR có hình dạng của việc viết với sự hỗ trợ của agent sẽ nhận thêm chút chú ý từ reviewer. Nhờ vậy bạn biết: à, đây là PR đến thẳng từ agent.
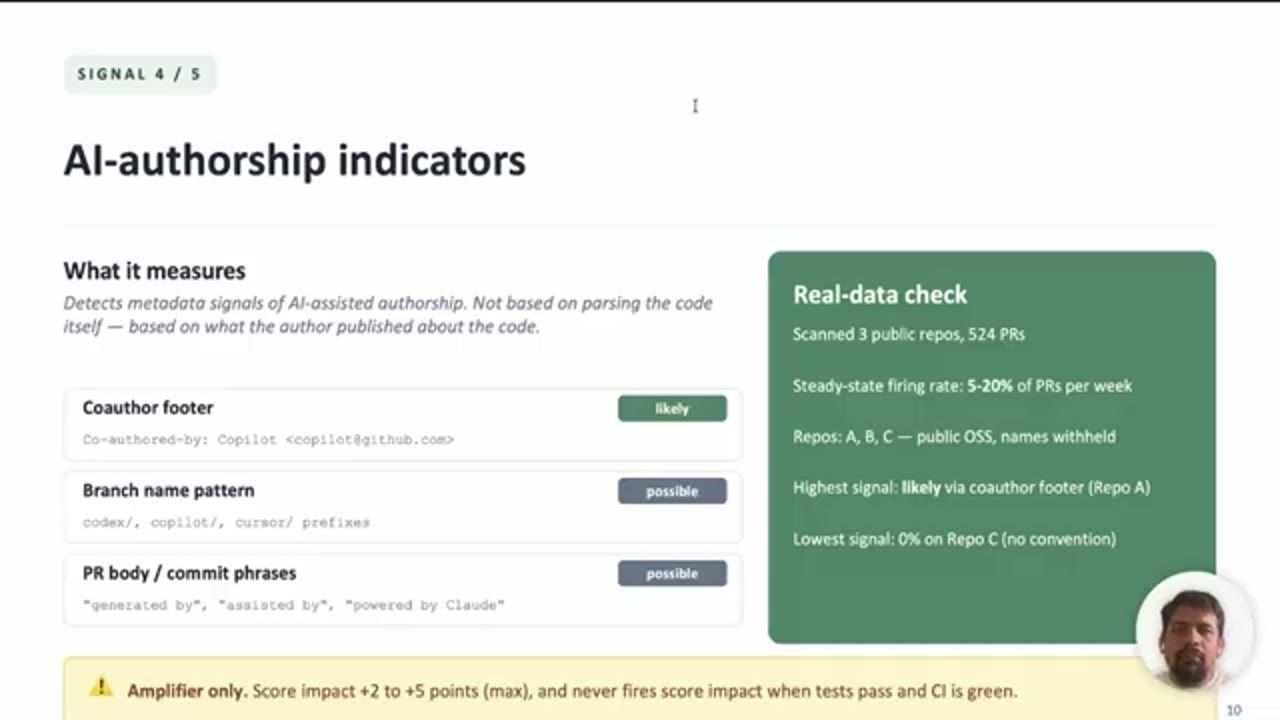
codex/, copilot/, cursor/ (gắn nhãn "possible"), và cụm từ trong PR body hoặc commit như "generated by", "assisted by", "powered by Claude" (gắn nhãn "possible"). Hộp "Real-data check" bên phải: scan 3 repo public, 524 PR; tỷ lệ kích hoạt ổn định 5 đến 20% số PR mỗi tuần; repo được gọi là A, B, C, đều là OSS public, giấu tên; tín hiệu cao nhất là "likely" qua co-author footer (repo A); thấp nhất là 0% ở repo C (không có quy ước). Dải vàng dưới cùng: "Amplifier only", tác động lên điểm từ +2 tới tối đa +5, và không bao giờ cộng điểm khi test pass và CI xanh.Có ba detection mode rất phổ biến, mà anh nghĩ ai cũng đã thấy rồi:
- Co-author footer, một trong những tín hiệu mạnh nhất. Bạn thấy dòng kiểu "Co-authored-by: Copilot" ở cuối commit.
- Branch name pattern: tên nhánh thường có tiền tố Codex, Copilot hay Cursor.
- Cụm "generated by", "assisted by" xuất hiện trong PR body hoặc commit message.
Họ đã làm một lần kiểm tra trên dữ liệu thật ở ba repo public, tổng cộng 524 PR. Sachin không nêu tên công ty, và chỉ gọi chúng là A, B và C. Tín hiệu cao nhất đến từ co-author footer. Tín hiệu thấp nhất là 0% ở repo C, dù code ở đó cũng được viết bằng coding agent; theo anh, có thể repo đó đã chặn mọi dòng kiểu "co-authored" hay "generated by" và những thứ tương tự.
10. Tín hiệu 5: evidence và rationale gaps
Tín hiệu cuối cùng là evidence và rationale gaps. Sachin nói cá nhân anh thấy đây là một trong những tín hiệu deterministic nhất, và cũng là tín hiệu phá hỏng khả năng review (reviewability) nhanh nhất. Nó đo một điều: PR có giải thích tại sao hay chỉ nói cái gì.
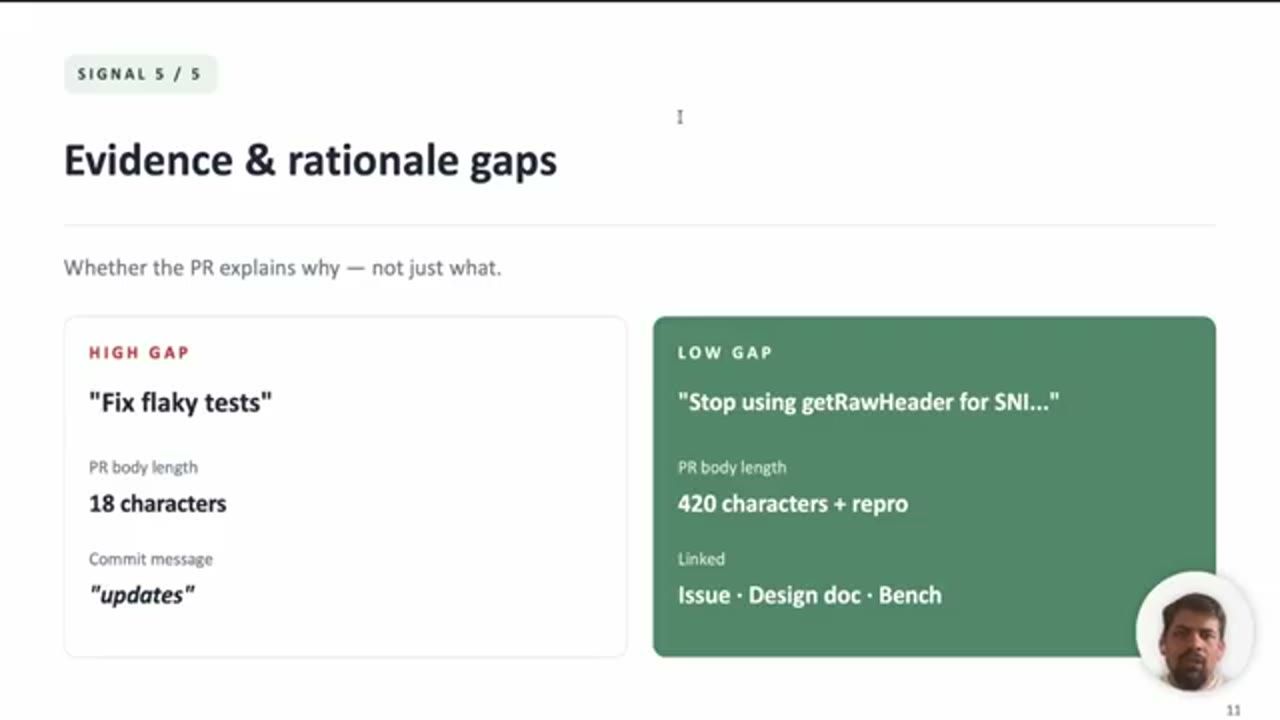
Bên trái là một PR có gap cao. Tiêu đề ghi "Fix flaky test". Toàn bộ dữ liệu trên slide lấy từ các repo public. PR body dài 18 ký tự. Commit message ghi "updates". Sachin nói thẳng: nếu bạn đưa PR này cho anh, anh không review được, và anh không thể chấp nhận nó.
Bên phải là một PR có gap thấp. Tiêu đề nói rõ thay đổi là về chuyện gì. Body có triệu chứng (symptom), chẩn đoán (diagnosis), thay đổi, và link tới benchmark. Lúc này reviewer mới làm được việc của mình.
Trong bộ regression fixture và các team được chấm điểm thủ công, tín hiệu này phá hỏng reviewability nhanh nhất. Còn trên dữ liệu open source thật, PR body thường theo định dạng conventional commit, nên ở đó tín hiệu này hiếm khi kích hoạt nhất. Anh cũng lưu ý rằng các regression fixture chỉ là bản demo.
11. Năm tín hiệu gộp thành một điểm số
Giờ xem năm tín hiệu kết hợp với nhau thế nào. Cuối cùng bạn chỉ có một con số, chạy từ 0 tới 100, và các trọng số cụ thể chỉ là giá trị mặc định.
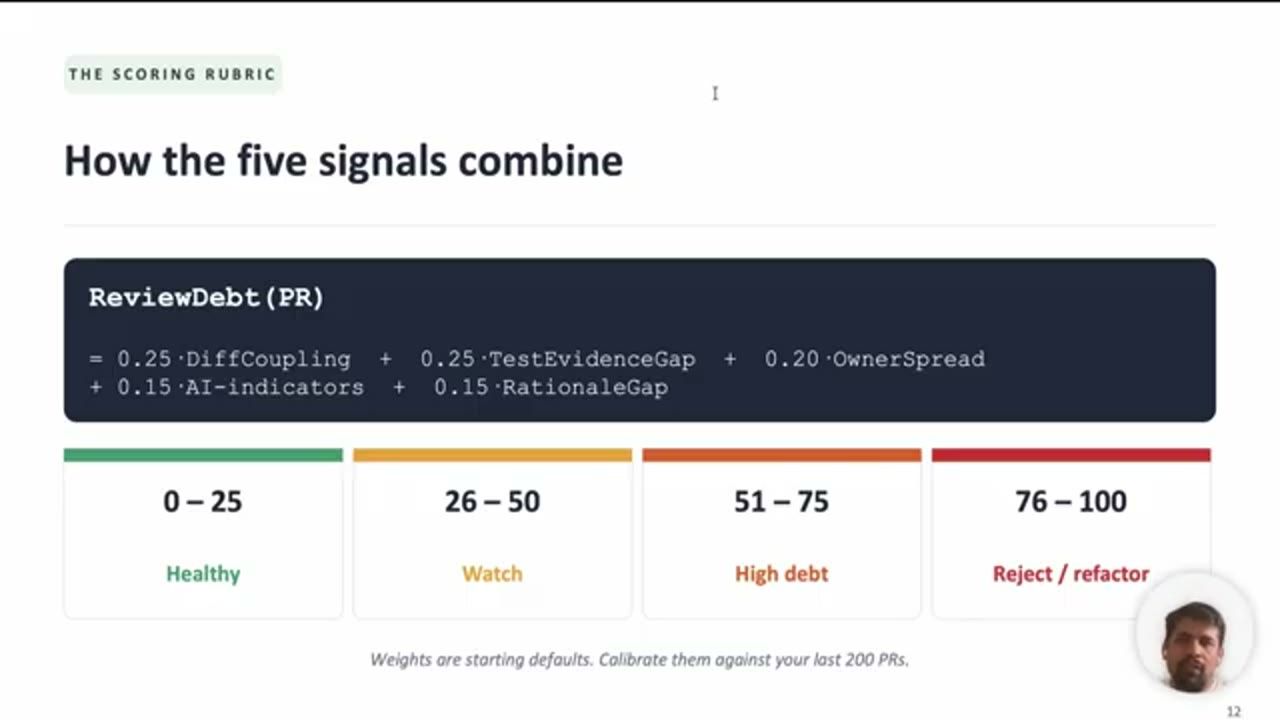
Công thức trên slide, để bạn mang về dùng:
ReviewDebt(PR) = 0.25·DiffCoupling + 0.25·TestEvidenceGap + 0.20·OwnerSpread
               + 0.15·AI-indicators + 0.15·RationaleGap
Nếu định áp dụng, Sachin muốn bạn làm việc này trước tiên: chạy ngược nó trên 200 PR đã merge gần nhất trong công ty bạn. Calibrate các trọng số dựa trên trải nghiệm thật của reviewer trong team. Điểm số phải khớp với cảm giác từ ruột (gut) của bạn.
Khi nói, anh chia điểm thành bốn dải:
- 0 tới 24: review burden rất thấp.
- 25 tới 49: bình thường, tiến hành với mức cẩn thận tiêu chuẩn.
- 50 tới 74: cần author bổ sung bằng chứng (evidence) trước khi tới lượt senior review.
- Từ 75 trở lên: chắc chắn là cao, nên tách PR hoặc yêu cầu thêm context.
Trên slide, bốn dải được ghi là 0 tới 25, 26 tới 50, 51 tới 75 và 76 tới 100, với các nhãn Healthy, Watch, High debt và Reject / refactor. Hình dạng giống các hạng mục của technical debt, chỉ có đơn vị là khác.
12. Walkthrough 1: một PR sạch
Tiếp theo là xem scanner thật sự làm gì. Sachin nói tiếc là hôm nay anh không demo trực tiếp được, nhưng anh sẽ dẫn người nghe đi qua output của CLI. Anh muốn cho xem ba pull request đã được chấm điểm, đặt cạnh nhau, ở mức mà framework trở nên hữu ích như một cuộc trao đổi review lặp lại được.
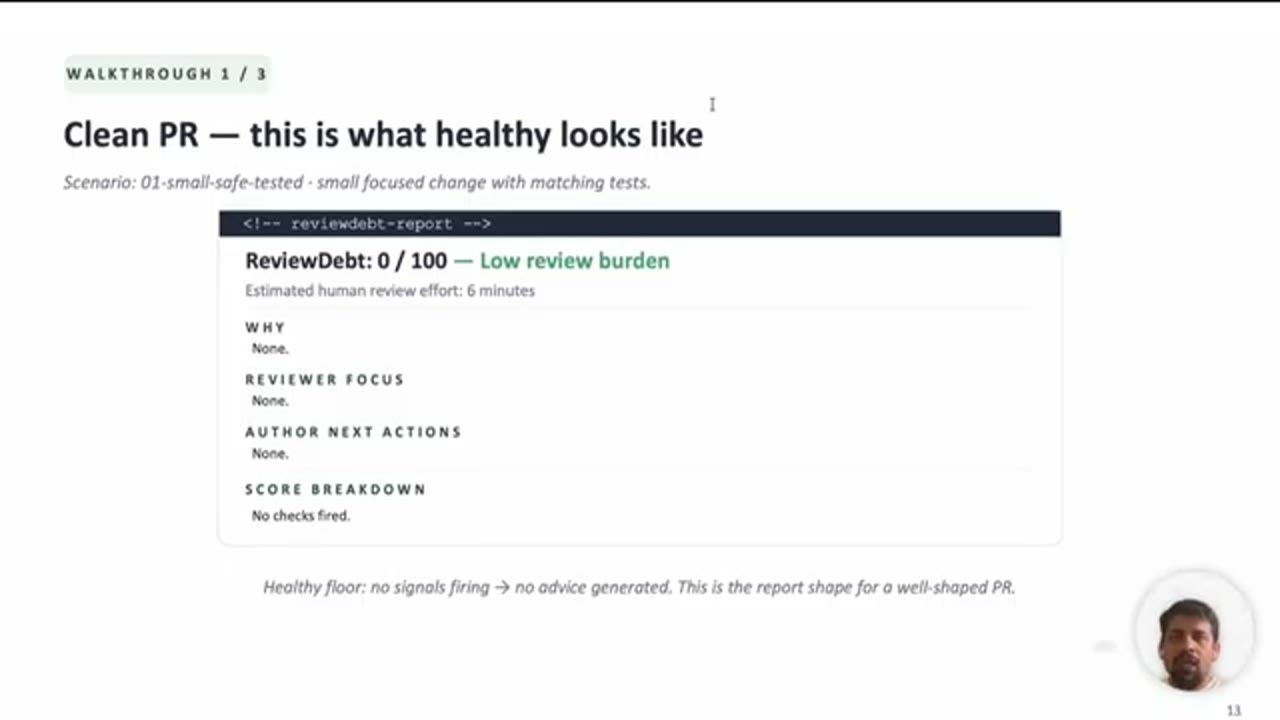
Đây là cái đầu tiên: scanner nói gì khi một PR có hình dạng tốt. Điểm 0 trên 100. Burden về cơ bản bằng không. Review burden thấp. Thời gian ước tính là sáu phút. Không check nào kích hoạt.
Nhìn vào cấu trúc report, bạn sẽ thấy vì sao danh sách trống, phần reviewer focus trống, phần author next action trống. Framework chỉ sinh lời khuyên khi nó có điều gì cụ thể để nói. Một PR khoẻ mạnh tạo ra một report bé xíu, gần như mang tính nghi thức. Đó đúng là thứ bạn muốn.
Bài học rút ra: phần lớn PR khoẻ mạnh tạo ra zero noise. Chúng hoàn thành việc mà không gây ồn. Đây không phải công cụ mặc định đi phàn nàn. Chạy nó trên mọi PR chỉ tốn của bạn một comment nói "Look good". Vậy thôi.
13. Walkthrough 2: PR do AI viết, review debt cao
Giờ tới PR có debt cao. Thứ đang hiện trên màn hình lấy từ một repo public, và là một kịch bản thật trong regression suite của scanner. Điểm ở đây là 60 trên 100, thuộc dải cần bằng chứng, hiển thị màu cam với nhãn "Needs evidence". Ước tính tám mươi sáu phút công sức review.
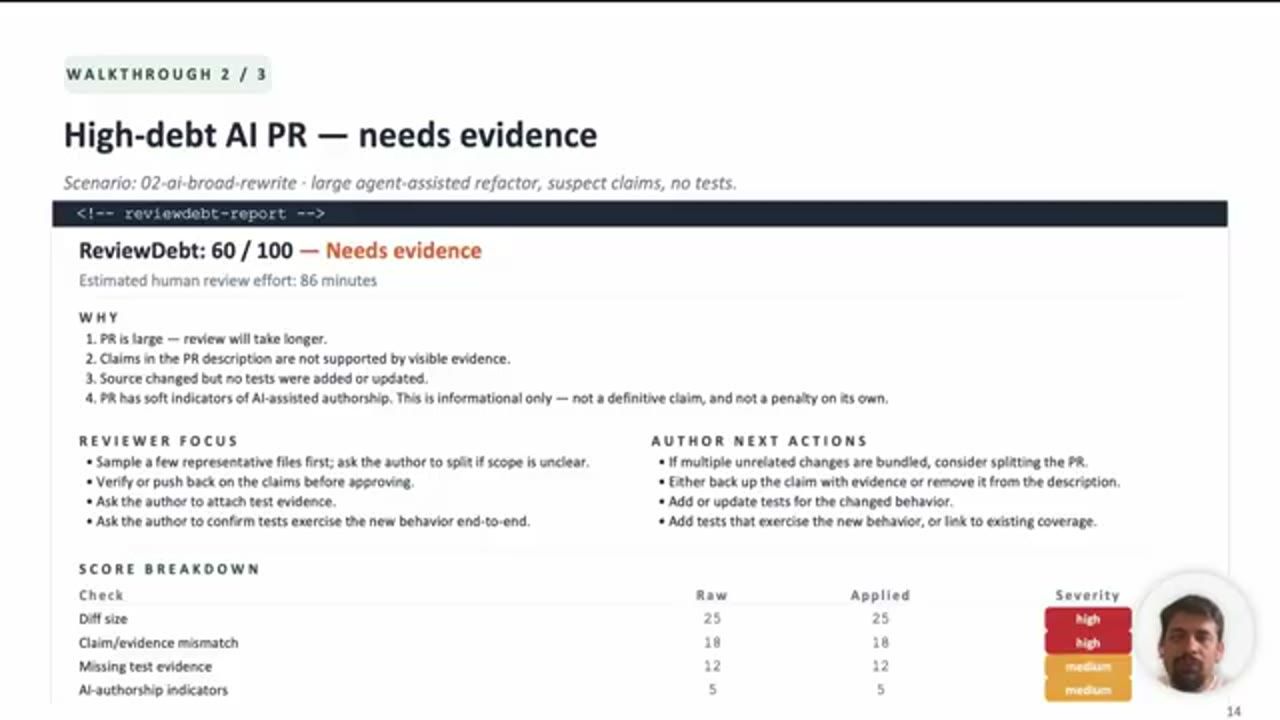
Hãy nhìn vào output có cấu trúc. Nó không chỉ là một con số. Có một danh sách why giải thích cái gì đã kích hoạt. Có một danh sách reviewer focus nói với reviewer nên làm gì tiếp. Có một danh sách author next action nói với author cách kéo điểm xuống. Theo Sachin, đây là phần mà hầu hết các công cụ chấm chất lượng PR bỏ sót. Riêng điểm số đã hữu ích. Nhưng chính lời khuyên có cấu trúc mới là thứ thật sự thay đổi hành vi của team.
Nếu đọc gạch đầu dòng thứ tư, nó ghi: "PR has soft indicators of AI-assisted authorship." Đây chỉ là thông tin, không phải một khẳng định chắc chắn, và tự nó không phải một hình phạt. Câu này nằm nguyên văn trong output của scanner.
Check AI indicator đóng góp 5 trong 60 điểm, tức khoảng 8%. 55 điểm còn lại đến từ diff size, claim mismatch (claim không khớp bằng chứng) và việc thiếu test. Đó là những tín hiệu burden cao với bất kỳ PR nào, dù agent viết hay không. Đây không phải một scorecard chống AI. Nó là một scorecard về review burden. Không phải agent gây ra điểm số này, mà là hình dạng của cái PR mà agent tạo ra.
14. Walkthrough 3: PR do AI viết nhưng gọn gàng, điểm 7
Cái tiếp theo là một PR do AI viết, có hình dạng rất tốt, và điểm là 7, review burden thấp. Cùng một agent, làm cùng loại việc, nhưng lần này test đã được thêm vào nên CI xanh. Đường đi rủi ro (risky path) được gọi tên rõ trong mô tả PR. Đó là lý do điểm chỉ là 7 trên 100. Burden rất thấp, chỉ mất 14 phút.
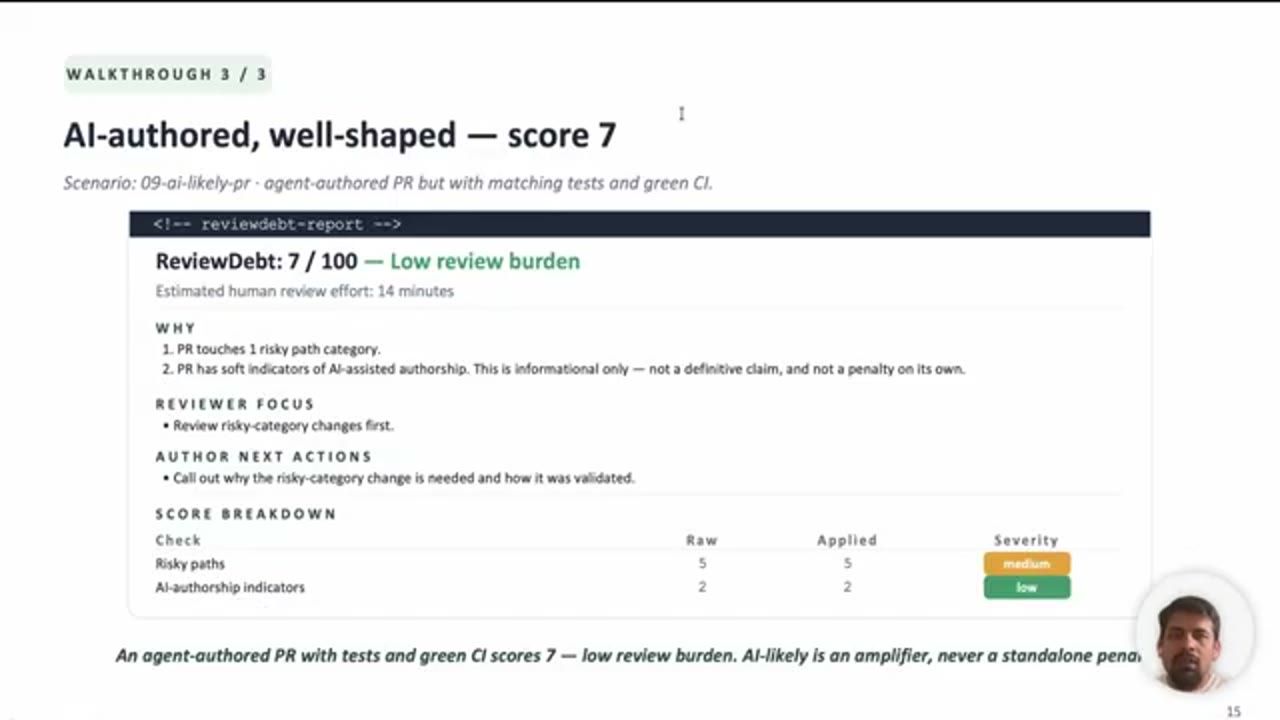
Check AI indicator vẫn kích hoạt, nhưng lần này nó chỉ đóng góp hai điểm. Thứ nhất, mức nghiêm trọng thấp. Thứ hai, framework nói rõ, và Sachin trích nguyên văn report: "Information only, not a definitive claim and not a penalty on its own."
Vậy khi team của bạn hỏi: "Công cụ này có phạt chúng ta vì dùng coding agent không?" Câu trả lời là không. Câu trả lời nằm ngay trên màn hình: review burden thấp. Đó là một PR do AI viết, có hình dạng rất tốt.
15. Mở rộng: ba repo public, 524 PR
Tiếp theo là ba repo public với tổng cộng 524 pull request. Sachin muốn cho xem diễn biến trong 90 ngày trên ba repo này. Điều nổi lên là review burden vẫn tăng ngay cả khi tỷ lệ code do AI viết không tăng.
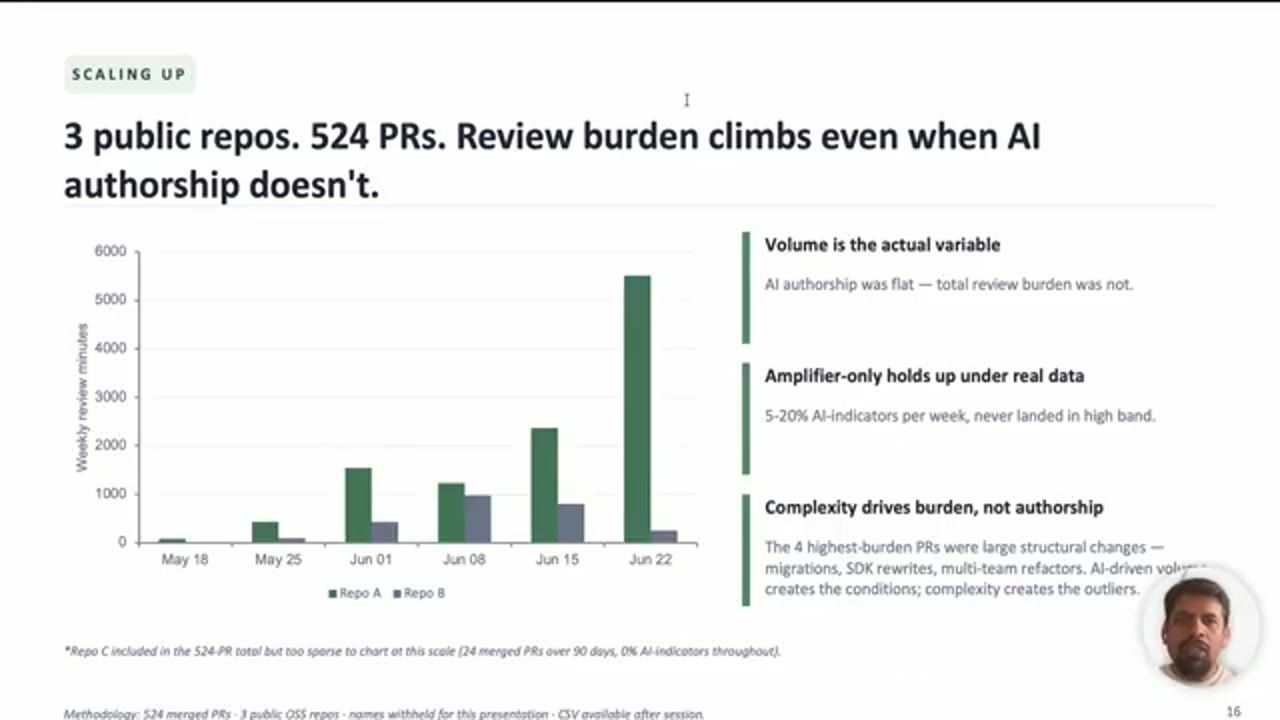
Từ lần scan này họ quan sát được ba điều.
Một: volume mới là biến số thật sự. Tỷ lệ AI viết thì phẳng, ở trạng thái ổn định 5 đến 20%, nhưng review burden thì không. Một repo tích luỹ 186 giờ senior reviewer trong 27 ngày, repo kia chỉ có 43. Độ dài cửa sổ là như nhau, nhưng volume không giống nhau, và burden cũng không giống nhau. Đó chính là sức nặng của volume PR.
Hai: vai trò "chỉ là amplifier" đứng vững trên dữ liệu thật. AI indicator kích hoạt trên 5 đến 20% số PR mỗi tuần, trên cả ba repo. Không có PR nào do AI viết rơi vào dải high burden một cách bất cân xứng. Cam kết về cách định vị (positioning contract) của framework vẫn đúng khi áp vào codebase thật.
Ba: độ phức tạp đẩy burden lên, không phải tác giả. Trong 524 PR, có bốn PR rơi vào dải needs evidence hoặc high. Cả bốn đều là thay đổi cấu trúc: migration lớn, viết lại SDK, refactor trên nhiều team. Framework chấm độ phức tạp một cách công bằng. Volume do AI đẩy lên tạo ra điều kiện để những PR như vậy tích tụ.
Vậy 524 PR trông như thế nào qua lăng kính này, và review debt thật sự lộ ra ở đâu?
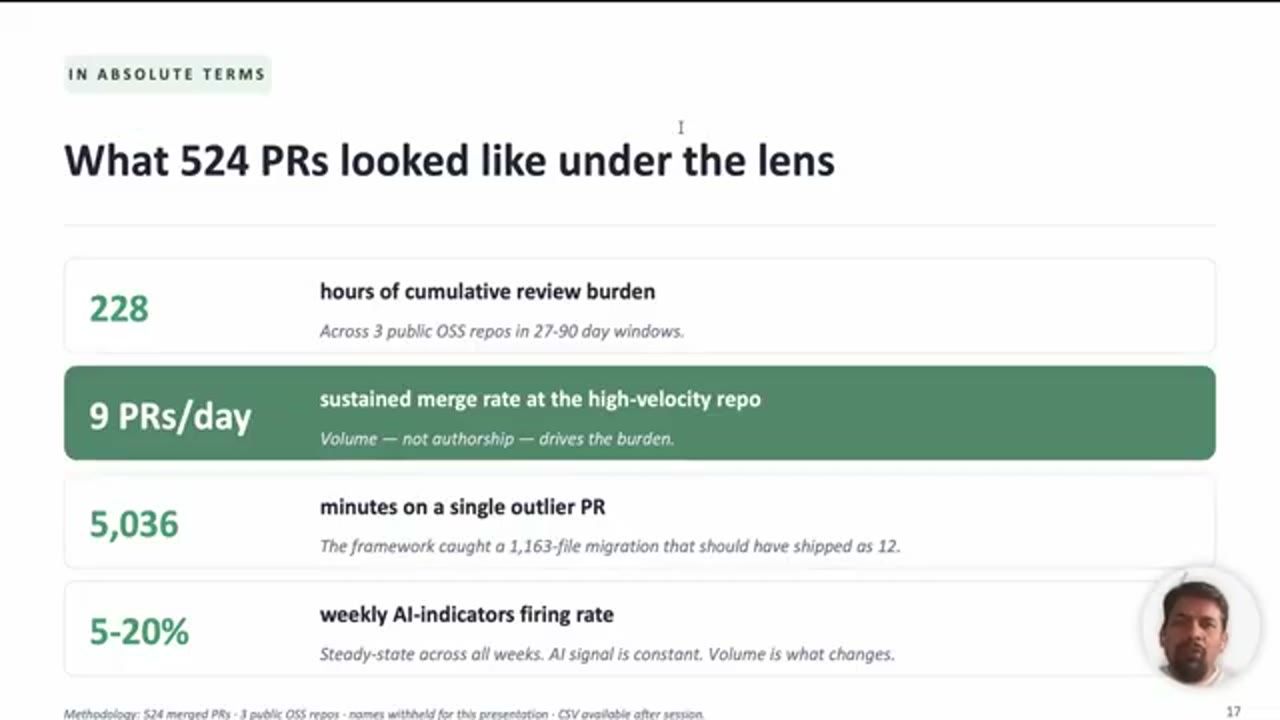
Xét theo con số tuyệt đối: scanner thấy 524 pull request thật trong ba repo public, cộng dồn 228 giờ của senior reviewer, trong các cửa sổ scan từ 27 tới 90 ngày.
Con số thứ hai là chín PR mỗi ngày, tốc độ merge duy trì của một repo có velocity cao. Một lần nữa, chính volume đang đẩy burden lên.
Con số thứ ba là 5.036. Đây là số phút dành cho một PR duy nhất, tức khoảng 84 giờ công review ước tính cho đúng một pull request. Điểm của PR đó là 73, thuộc dải cần bằng chứng.
Và mỗi tuần, 5% đến 20% số PR kích hoạt tín hiệu AI indicator. Sachin nhắc lại: chính volume đang gây ra review debt, và đó là thứ đang thay đổi cuộc chơi.
16. Làm gì để kéo con số xuống
Đã đo được vấn đề, đã thấy được chi phí. Giờ làm gì với nó?
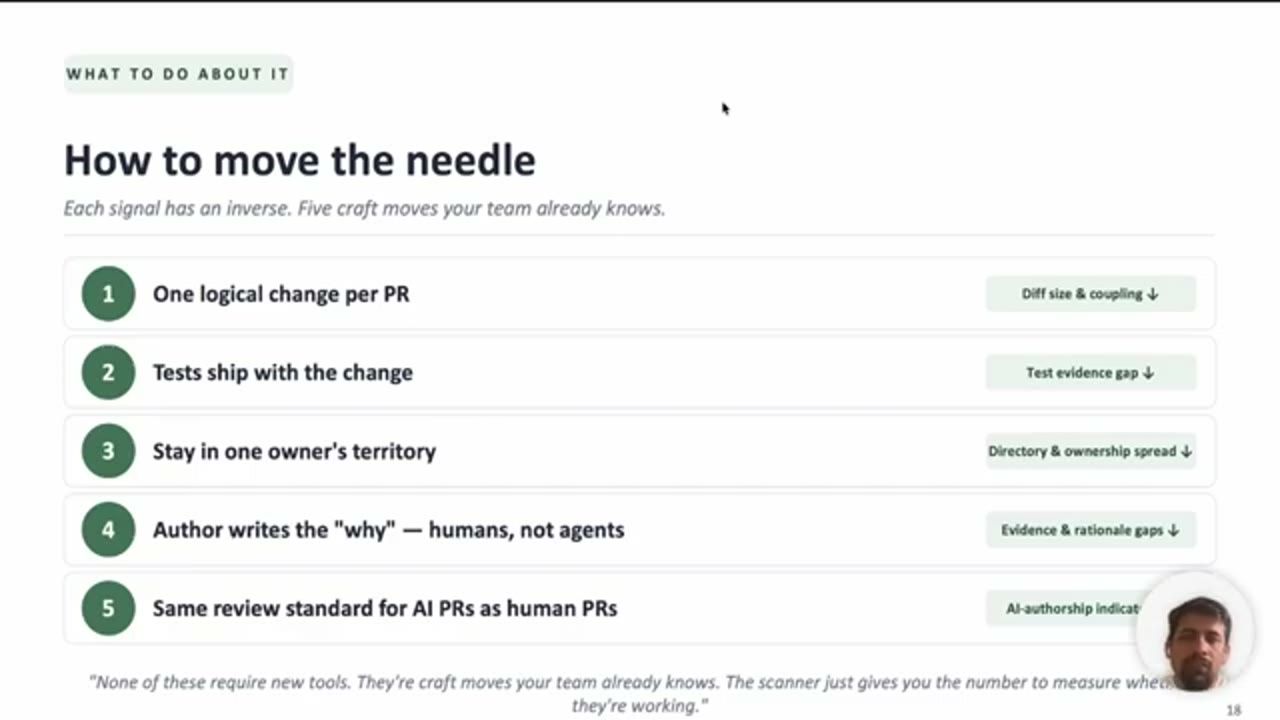
Một thay đổi logic cho mỗi PR. Sachin nói anh không bảo "PR nhỏ" một cách trừu tượng. Một thay đổi logic là đủ.
Test đi cùng thay đổi. Ngay cả khi agent viết code, ngay cả khi agent viết test, author con người vẫn phải xác nhận rằng test assert điều code nên làm, không phải điều code đang làm. Điều code được kỳ vọng phải làm.
Ở trong lãnh thổ của một owner. Việc cắt ngang nhiều phần thì tách ra thành từng PR theo team. Ở yên trong lãnh thổ của mình: một approval, một context, một mental model.
Author viết phần "why". Agent không nên viết PR body. Đó là khoảnh khắc author con người cam kết rằng mình hiểu thứ mình đang ship.
Cùng một chuẩn review cho PR của AI và PR của người. AI indicator chỉ là amplifier, nó chỉ có tác dụng khi các tín hiệu khác yếu. Hãy giữ bốn tín hiệu kia mạnh, khi đó amplifier gần như vô hình. Và đảm bảo không có ngoại lệ nào dành cho AI.
Không cái nào trong số này đòi bạn phải có một công cụ mới. Đây là những nước đi bạn vốn đã biết. Bạn chỉ cần thực hiện chúng.
17. Áp dụng trong năm bước, và từ đo lường sang governance
Vậy bạn định áp dụng thế nào? Một lần nữa có năm bước: backfill, threshold, surface, aggregate, và talk about it.
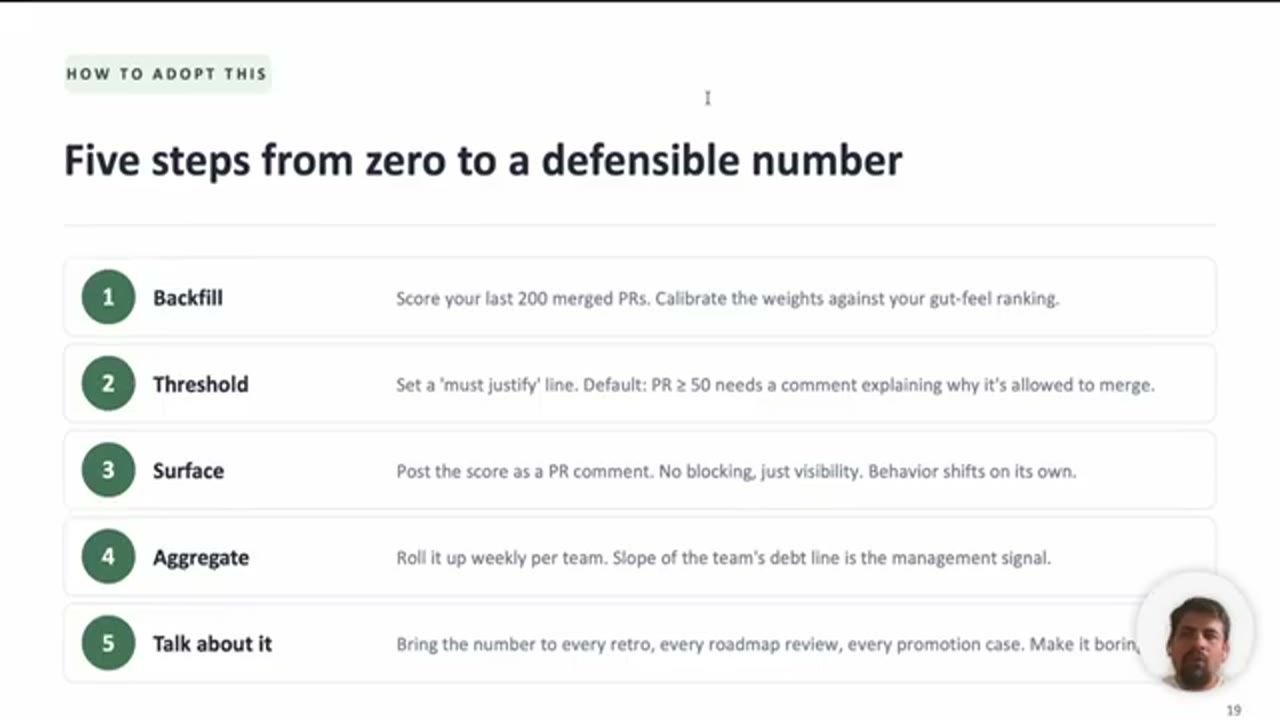
Backfill. Chạy bộ chấm điểm trên 200 PR đã merge gần nhất. Nhìn vào những PR có điểm cao nhất.
Threshold. Đặt một ngưỡng cần giải trình. Mặc định, giả sử bạn chọn 50: mọi PR có điểm từ 50 trở lên phải có một comment từ author. Đơn giản vậy thôi.
Surface. Đăng điểm thành một comment trên mọi PR. Đừng chặn merge. Chỉ để cho thấy, đưa nó lên bề mặt để mọi người biết chuyện gì đang diễn ra ở đó.
Aggregate. Gộp theo tuần cho từng team. Độ dốc của đường debt của mỗi team là chỉ báo sớm (leading indicator). Đó là thứ engineering manager của bạn nên theo dõi.
Talk about it. Mang con số đó vào mỗi buổi retrospective, mỗi buổi roadmap review. Trong mọi cuộc họp, bạn nên bàn về con số đó, kiểu như: điểm của bạn là bao nhiêu khi làm cái PR kia? Vậy thôi.
Tại sao con số này quan trọng? Có phải chỉ vì cuộc trò chuyện này? Hoàn toàn không. Không có con số, thứ bạn đang trao đổi chỉ là cảm giác (vibe). Có con số, cuộc trao đổi có cấu trúc. Bạn có thể nói: "Với coding agent, đợt rollout của chúng ta đã thêm X% throughput", nhưng bạn cũng phải nói thêm rằng nó đã cộng Y điểm review debt, tích luỹ trong Z tuần. Với độ dốc hiện tại, đó là khoảng N giờ senior engineer mà các bạn cần bàn tới. Điều đó chuyển cuộc thảo luận từ cảm giác sang đo lường, nên bạn luôn phải có một con số.
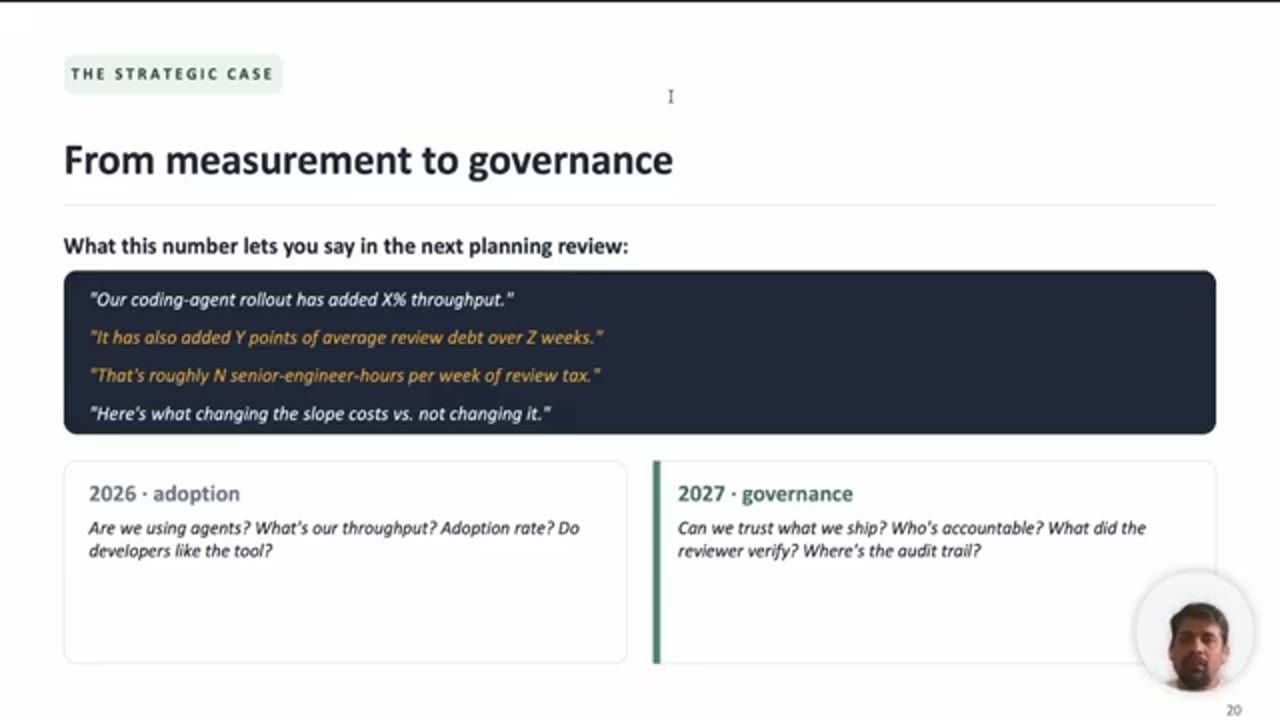
Năm 2026, chúng ta đang trong giai đoạn áp dụng. Nhưng 2027 sẽ là năm cuộc trò chuyện này chuyển sang mô hình governance, và nó thật ra đã bắt đầu ngay lúc này. Bạn có tin được code mình đang ship không? Nếu có, mọi thứ ổn. Nếu không, thì ai chịu trách nhiệm khi một thay đổi do AI viết gây ra sự cố? Audit trail nằm ở đâu?
ReviewDebt là cây cầu nối giữa hai cột này. Nó là con số đầu tiên cho phép bạn có cuộc trò chuyện ở cột bên phải mà không phải bỏ đi những thành quả ở cột bên trái.
18. Ba việc mang về sáng thứ Hai
Đến slide cuối, Sachin muốn người nghe mang về ba điều.
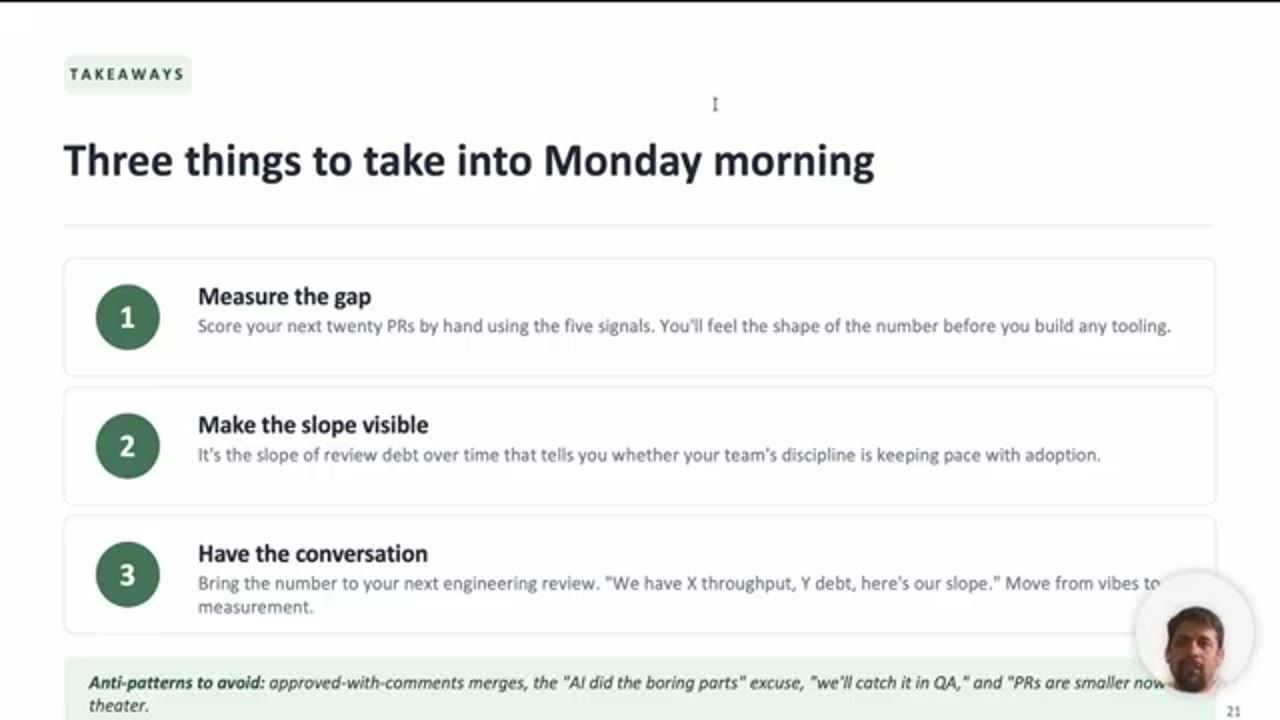
Thứ nhất: đo khoảng trống. Chưa cần build tooling vội. Lấy 20 PR từ tuần trước, chấm chúng bằng năm tín hiệu vừa bàn. Bạn sẽ có một con số, và nhờ đó hiểu được framework có đang hoạt động đúng hay không.
Thứ hai: làm cho độ dốc hiện ra. Độ dốc của review debt theo thời gian quan trọng hơn mức tuyệt đối. Vẽ nó theo tuần, rồi bàn với team, trong một cuộc họp hay buổi sprint planning, theo cách nào bạn thấy hợp.
Thứ ba: có cuộc trò chuyện đó. Mang con số vào buổi review tiếp theo. Nói kiểu: "Chúng ta có X throughput, Y debt, và đây là độ dốc." Lúc đó bạn đang rời văn hoá cảm tính (vibe culture) để chuyển sang văn hoá đo lường.
Một lưu ý nhanh về các anti-pattern cần tránh. Thứ nhất là kiểu merge "approve with comment". "AI đã làm phần nhàm chán rồi"? Không. "Ta sẽ bắt được nó ở khâu QA"? Không. "Giờ PR nhỏ hơn rồi"? Không. Hãy thôi viết LGTM lên PR. Hãy chắc rằng những thói quen đã bàn ở đây sẽ được làm theo. Đó là toàn bộ ý của talk.
Sachin cảm ơn mọi người đã lắng nghe.
Nguồn và link
- Trang diễn giả Sachin Gupta: ai.engineer/speakers/sachin-gupta · GitHub: github.com/sachinkg12
- GitHub Octoverse, nguồn số liệu commit và comment: octoverse.github.com
- Faros AI, nguồn benchmark về thời gian review và PR merge không review: faros.ai
- DX, nguồn nghiên cứu về kích thước PR và cycle time: getdx.com
- CODEOWNERS trên GitHub, nền cho tín hiệu ownership spread: tài liệu chính thức
- Co-author trailer trong commit, một detection mode của AI-authorship indicators: tài liệu GitHub
- Conventional Commits, định dạng PR body phổ biến ở repo open source: conventionalcommits.org
Related talks
Parallelize your development with GitHub Copilot
Pamela Fox · Microsoft · 32 min
Chạy nhiều coding agent song song theo ba chiều environment, timing, ownership: worktree, port, staging riêng từng branch, background agents và sub-agents.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
A Genius With Amnesia
Victor Savkin · Nx · 20 min
Agent bị giới hạn trong một repo và quên mọi session cũ; Polygraph gỡ cả hai bằng synthetic monorepo và trace dùng chung giữa các agent.