Stop AI Agent Hallucinations: 5 Techniques + Production Patterns
AI Engineer World's Fair 2026: Online Track · Video gốc
Năm thay đổi trong code, không phải prompt, để agent bớt hallucinate: lọc tool, GraphRAG, swarm kiểm chéo, hook chặn rule, steering tự sửa; demo Strands.
1. Mỗi token đều tốn tiền, và context sai làm agent hallucinate
Elizabeth mở đầu bằng lời hứa của cả buổi: hôm nay chị sẽ nói về cách ngăn AI agent hallucinate bằng năm kỹ thuật nằm ngoài prompt. Điểm chung của cả năm là mỗi kỹ thuật là một thay đổi trong code, không phải một thay đổi trong prompt.
Chị bắt đầu từ chuyện tiền. Mỗi lần AI agent của bạn trả lời, bạn đang trả tiền cho những chữ đi vào và những chữ đi ra. Trên hoá đơn, bạn sẽ thấy chúng được gọi là token. Bạn gửi vào càng nhiều token thì càng trả nhiều tiền. Và nếu thứ bạn gửi vào không thật sự đúng, hoặc quá nhiều, hoặc thiếu một điều gì quan trọng, thì agent bắt đầu hallucinate. Chị bật cười khi nói câu đó.
Năm kỹ thuật chị trình bày giúp giảm token lãng phí, tăng độ chính xác, và bắt lỗi trước khi người dùng nhìn thấy. Chị nhắc lại một lần nữa: mỗi kỹ thuật là một thay đổi trong code, hoàn toàn không phải thay đổi trong prompt. Rồi chị đi qua từng cái:
- Thứ nhất, semantic tool selection. Bạn lọc xem tool nào được đưa vào context ở mỗi lần gọi. Model chỉ thấy đúng những gì cần cho query cụ thể đó.
- Thứ hai, GraphRAG cho những query cần độ chính xác như aggregation (tổng hợp), đếm số lượng, hay multi-hop reasoning (suy luận qua nhiều bước nối nhau). Bạn thay việc truy xuất text bằng một graph query có cấu trúc. Model nhận được một câu trả lời đã được tính toán và kiểm chứng được, không phải một mẫu dữ liệu lấy ra như RAG thường làm.
- Thứ ba, multi-agent validation. Một agent thứ hai kiểm tra mọi câu trả lời trước khi nó tới tay người dùng.
- Thứ tư, neurosymbolic guardrails. Rule của bạn sống trong Python, không sống trong prompt, và model không thể bỏ qua chúng.
- Thứ năm, runtime steering. Nếu bạn không muốn block, bạn có thể steer (lái agent đi đúng hướng). Bạn không cần block mọi thứ. Khi một rule được kích hoạt, agent tự sửa và hoàn thành task. Không có điểm dừng cứng, người dùng không phải thử lại.
Với mỗi kỹ thuật, chị sẽ cho xem agent khi chưa có nó, rồi agent khi đã có nó, để người xem tự so sánh. Toàn bộ demo dùng một travel agent (agent du lịch) mà chị tự dựng bằng Strands Agents, một agent framework open source mà AWS đang maintain.
Chị tự giới thiệu: chị là Elizabeth Fuentes Leone, Developer Advocate của AWS, tập trung vào các ứng dụng agentic. Trên màn hình có một mã QR dẫn tới mọi thứ người xem cần để dựng lại tất cả những kỹ thuật chị sắp trình bày (đó là repo why-agents-fail-sample-for-amazon-agentcore). Rồi chị vào việc.
2. Travel agent với 29 tool: mỗi tool tốn bao nhiêu token?
Kỹ thuật đầu tiên là semantic tool selection. Travel agent của chị có 29 tool: chuyến bay, khách sạn, thanh toán, thời tiết, huỷ đặt chỗ. Chị nói rõ tất cả đều là tool giả (dummy tool), đây không phải một travel agent thật. Nhưng mỗi lần người dùng gửi một tin nhắn, toàn bộ mô tả của 29 tool đều đi vào context window. Model đọc hết chúng rồi mới quyết định làm gì.
Nếu agent của bạn có memory, mỗi lượt hội thoại lại cộng thêm context, và phần context đó được gửi kèm theo từng tin nhắn một. Bạn trả tiền cho từng token đó, dù cuối cùng model có dùng tool ấy hay không.
Để hiểu số token này đến từ đâu, bạn cần thấy một tool thực sự trông như thế nào dưới mắt model. Trong Strands, bạn viết một function có decorator @tool: đó chính là tool, gồm một cái tên, một mô tả, và docstring cùng các parameter có khai báo kiểu. Strands lấy những thứ đó và sinh ra một schema gồm name, description, parameters. Chính schema này là thứ đi vào context window ở mỗi lần gọi.
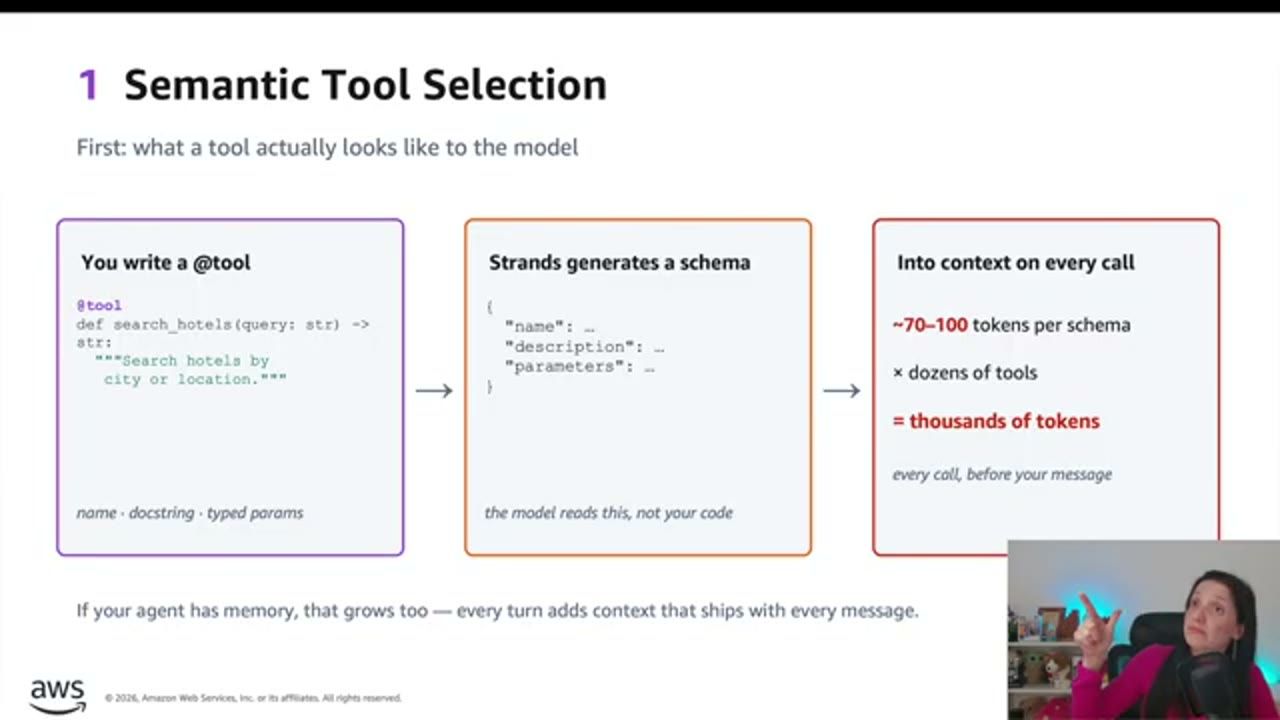
@tool (ví dụ search_hotels(query: str) với docstring "Search hotels by city or location"), Strands sinh ra schema có name, description, parameters, và schema đó vào context ở mọi lần gọi. Slide ghi khoảng 70 đến 100 token cho mỗi schema, nhân với hàng chục tool thành hàng nghìn token, trước cả tin nhắn của bạn. Dòng cuối nhắc: nếu agent có memory, con số này còn lớn dần vì mỗi lượt lại thêm context.Mỗi tool schema tốn khoảng 70 đến 100 token, tùy số parameter (con số slide ghi). Với 29 tool, travel agent tốn tổng cộng khoảng ba nghìn token cho mỗi lần gọi, chỉ riêng phần mô tả tool. Số token đó nằm trước tin nhắn của bạn, trước câu trả lời, ở mọi lần gọi.
Cách giải là tạo một database chứa các tool, rồi lọc ra những tool agent có thể cần trước khi agent được gọi. Với bộ lọc này, model chỉ thấy ba tool liên quan nhất. Lượng token dùng cho phần tool giảm từ hàng nghìn xuống dưới ba trăm.
3. Dựng môi trường demo: Strands, OpenAI, sentence transformer, Faiss
Chị chuyển sang IDE, xoá hết output cũ để chạy lại từ đầu. Việc đầu tiên là cài requirements. Demo được viết dưới dạng Jupyter Notebook vì như vậy dễ cho xem mọi thứ, nhưng trong repo cũng có một ứng dụng chạy được nếu bạn thấy tiện hơn.
Trong file requirements có Strands Agents. Vì chị dùng OpenAI để gọi model, tức là dùng API của OpenAI, chị cần thêm phần Strands Agents dành cho OpenAI. Chị nói Strands Agents dùng được với, theo nguyên văn cảm thán của chị, "trời ơi, gần như mọi model provider", và tất nhiên với Amazon Bedrock, vì AWS là bên đang maintain framework này. Khi dùng Amazon Bedrock, bạn không cần thêm model provider nào.
Vì cần tạo embedding cho vector database chứa các tool, chị dùng sentence transformer (Sentence Transformers). Đây là một model cực kỳ đơn giản chạy ngay trên máy, nên miễn phí. Bạn có thể chạy local trên máy mình mà không tốn tiền cho một model embedding khác. Chị thêm rằng Strands cũng dùng được với Ollama: nếu bạn có model local, bạn có thể chạy toàn bộ trên máy mình, miễn phí, không tiêu một token nào.
Vector store của chị là Faiss: chạy local, cực kỳ đơn giản. Requirements cũng có Neo4j, nhưng đó là cho một demo khác chị sẽ cho xem sau. Vì có dùng biến môi trường nên chị cài thêm python-dotenv.
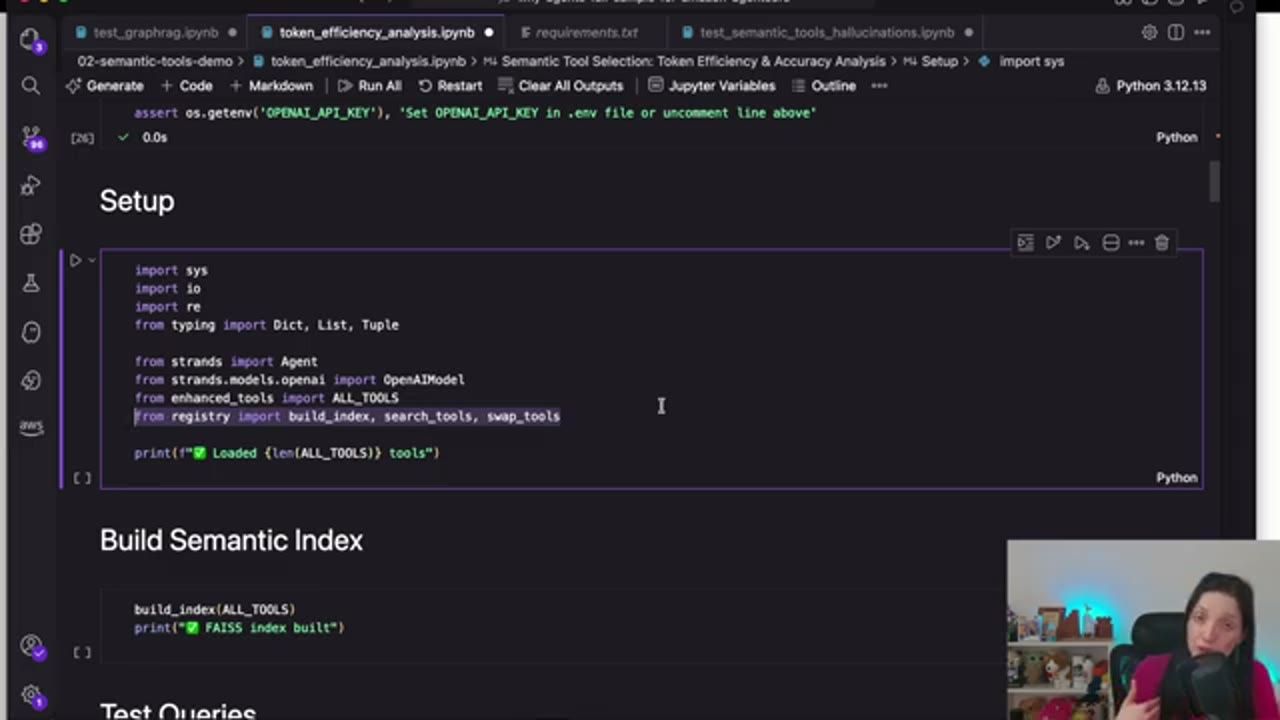
OPENAI_API_KEY, import Agent từ strands, OpenAIModel từ strands.models.openai, danh sách ALL_TOOLS từ file tool, và ba helper build_index, search_tools, swap_tools từ module registry. Ô bên dưới là bước Build Semantic Index trên Faiss.Chị phóng to màn hình vì biết người xem đang khó đọc ("to hơn chút, nhỏ lại chút, đây, thế này tốt hơn"). Requirements chị đã cài từ trước. Vì dùng OpenAI nên chị cần API key. Rồi chị import Strands: cần Agent vì sắp dựng một agent, cần model OpenAI, và một loạt dummy tool chị sẽ cho xem ngay. Chị cũng import vài function để dựng index cho vector store và một hàm search tool. Khi dùng vector store, chị đưa query vào, tìm tool cần dùng bằng vector search, rồi swap (hoán đổi) bộ tool của agent. Phần swap chị sẽ giải thích sau.
Chị mở file registry để cho xem: ở đó có hàm swap, hàm search, hàm build index. Rồi chị đi tìm chỗ khai báo tool, vừa cuộn vừa ngân nga "choo, choo, choo, choo" cho tới khi thấy. Đó là toàn bộ dummy tool chị tự viết cho demo. Chị dặn rõ: đây là demo, làm ơn đừng đem thứ này lên production.
4. Bộ test, ground truth và agent truyền thống nhận đủ 29 tool
Chị chạy bước dựng semantic index (đã làm từ trước). Có 29 dummy tool, và chị sẽ test chúng với nhiều query khác nhau. Đi kèm là ground truth: vì chị biết tool nào là tool tốt nhất để trả lời từng câu hỏi, chị có thể đo xem agent làm đúng hay sai.
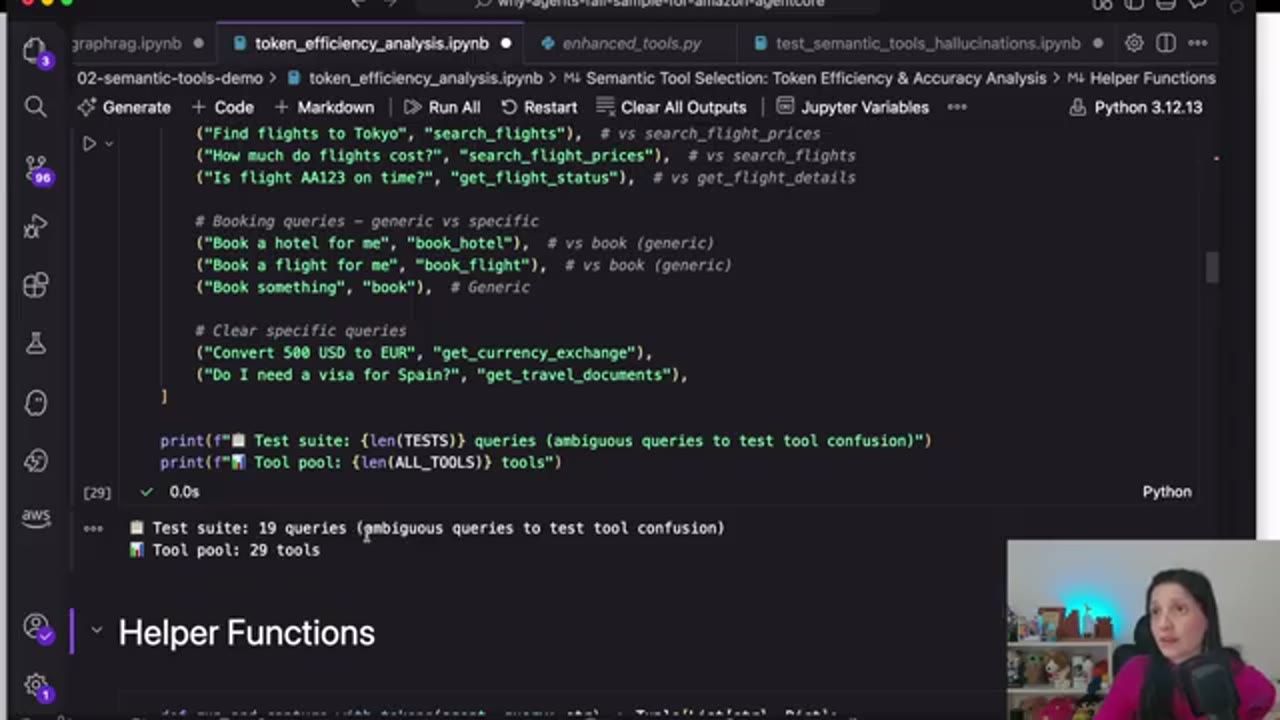
Chị chạy ô này. Chị nói bộ test có "chín mươi query và hai mươi chín tool"; dòng notebook trong ảnh trên ghi test suite 19 query mơ hồ có chủ đích và tool pool 29 tool. Tiếp theo là vài helper function. "Tôi không quan tâm", chị nói, rồi sửa ngay: "Có, tôi có quan tâm, nhưng tôi sẽ không giải thích chúng đâu."
Sau đó là agent truyền thống, nơi chị nhét đủ 29 tool vào agent. Có model, vài helper function, và agent. Đây là cách tạo một agent bằng Strands Agents: đưa toàn bộ tool vào, kèm system prompt "You are a travel assistant. Use the correct tool to answer question." Đọc xong prompt, chị bật cười: "Trời ơi. Tuyệt vời." Rồi thêm model vào.
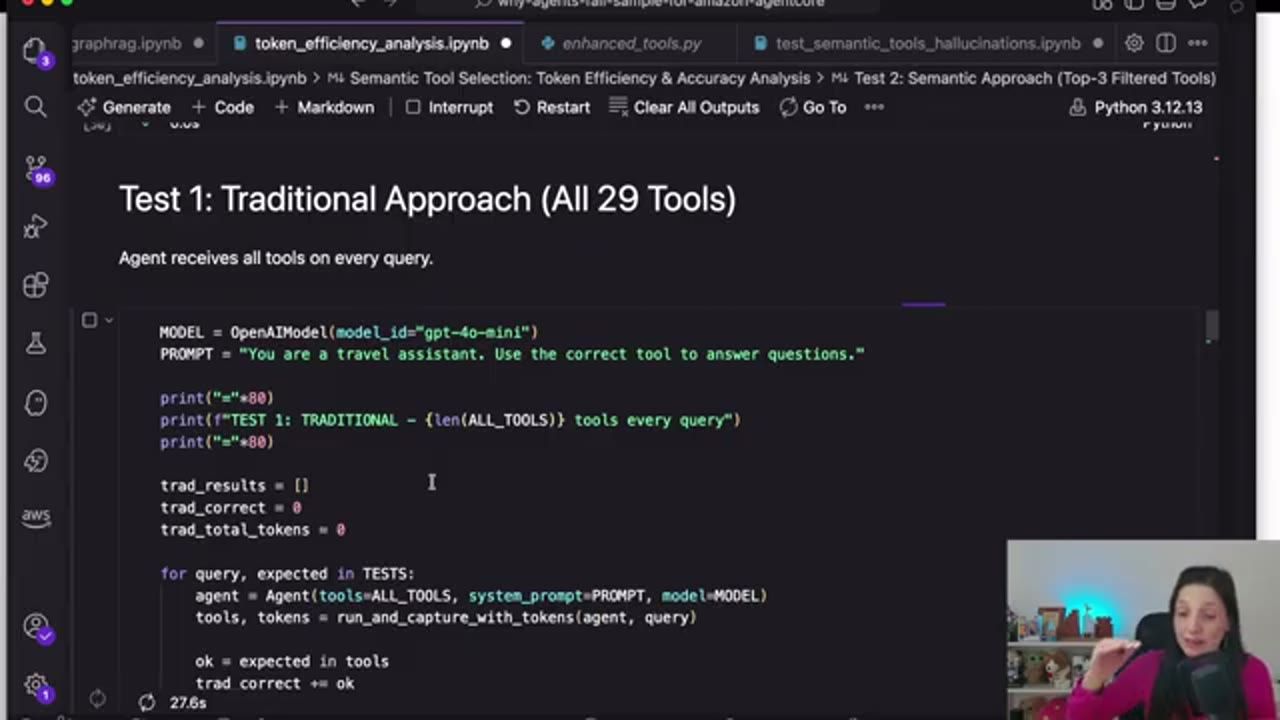
gpt-4o-mini qua OpenAIModel, prompt chỉ một câu. Vòng lặp tạo một Agent(tools=ALL_TOOLS, ...) mới cho mỗi query, đếm token và so tool được gọi với tool kỳ vọng.You are a travel assistant. Use the correct tool to answer questions.
Chị chạy. Có một hàm đếm token, vì bên trong Strands Agents bạn đếm được token: bạn biết agent dùng bao nhiêu token đầu vào và đầu ra. Mỗi lần đưa một prompt vào agent, chị chỉ gửi prompt đó và agent trả lời. Sau đó chị dùng một agent mới, vì đây là một vòng for, nên không có hội thoại với agent: chỉ một câu hỏi và một câu trả lời.
Kết quả: mỗi câu hỏi tốn khoảng hai nghìn token. Và cuối cùng, không phải lúc nào nó cũng chọn đúng tool. Độ chính xác không được tốt, và chị đọc con số trung bình là một nghìn token.
5. Agent semantic: chỉ đưa vào top 3 tool liên quan
Giờ tới agent mới theo hướng semantic. Việc đầu tiên chị làm là với mỗi query, mỗi prompt, chị gửi query đó vào hàm search tool và nhận về top K, ở đây K bằng ba: ba tool liên quan nhất, có xác suất cao nhất trả lời được query, vì đây là semantic search bên trong vector store.
Rồi chị lấy kết quả đó, chọn ra tên tool, và đặt đúng những tool đó vào agent. Agent chỉ dùng ba tool mà semantic search vừa trả về, và chị chỉ gửi những tool đó. Cộng thêm helper function, thế là xong.
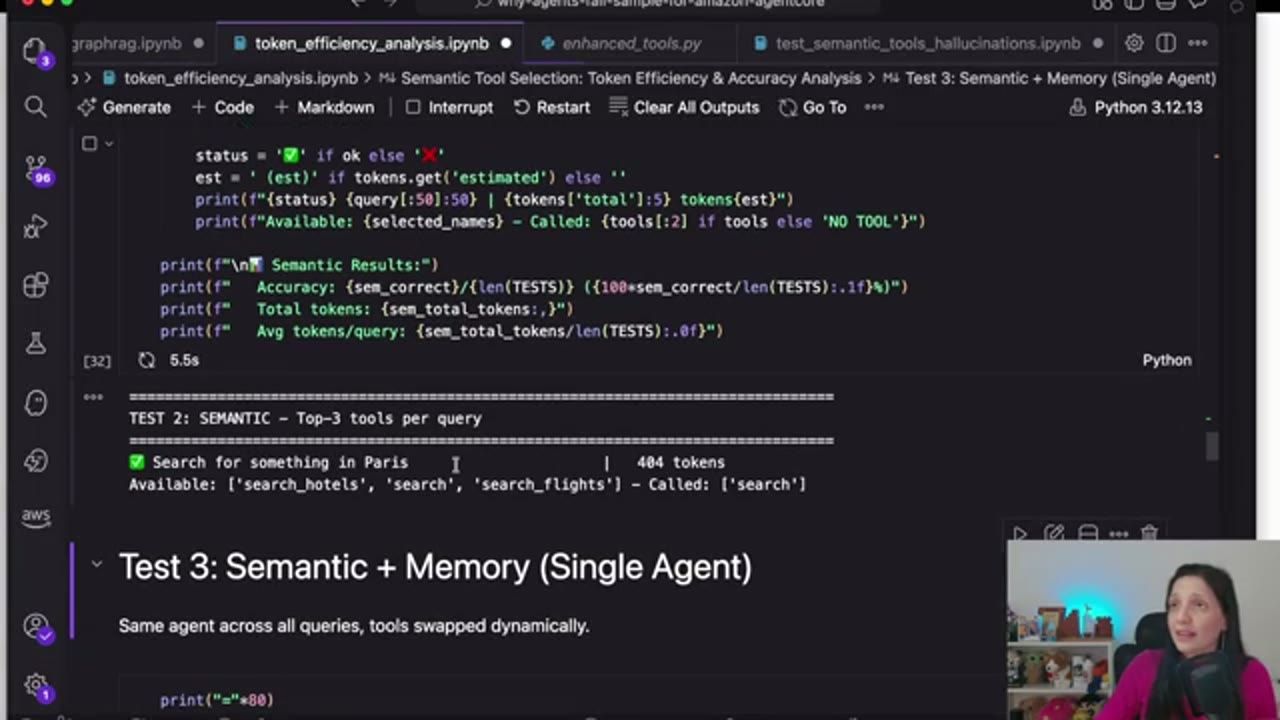
search_hotels, search, search_flights, gọi search, và tổng cộng tốn 404 token. Bên dưới là phần mở đầu của Test 3: cùng một agent cho mọi query, tool được hoán đổi động.Chị gửi lại đúng bộ query như trước. Với câu hỏi đầu tiên, chị đọc "4.000 token" rồi "blah, blah, blah" (màn hình ở ảnh trên ghi 404 token cho query đầu). Và đúng là khác biệt rất lớn, vì chị không còn gửi đủ 29 tool trong mọi query. "Pam-pam", chị đệm theo.
Chị chờ ô tiếp theo về semantic memory chạy ("được rồi, nào, chạy xong đi") rồi quyết định chuyển sang phần tiếp.
6. Khi agent có trí nhớ: swap_tools trong agentic loop
Agent vừa rồi chỉ nhận một câu hỏi và trả một câu trả lời, không có hội thoại. Vậy chuyện gì xảy ra nếu bắt đầu có hội thoại, nếu agent nhớ bạn? Khi đó ta cần chỉ gửi những tool agent sắp dùng. Nếu cứ thêm tool vào trong khi conversation history được giữ lại, sẽ tới lúc agent lại có đủ 29 tool bên trong. Tức là ta chưa giải quyết được vấn đề khi đang hội thoại với agent. Vì vậy ta cần đưa tool vào, rồi gỡ tool ra, và việc đó làm bằng swap_tools.
Chị định chạy luôn, rồi đổi ý: "Không, để tôi cho xem hàm swap_tools trước", và mở file registry. Với Strands, ở mỗi lần gọi bạn có toàn quyền kiểm soát state, vì đây là một agentic loop. Trong agentic loop, bạn làm gần như mọi thứ mình muốn: đưa vào và gỡ ra bất cứ thứ gì bên trong loop chỉ bằng vài dòng code.
Cụ thể, ta có agent, và thông qua tool registry, một thứ nằm trong state của agent, ta có thể xoá hết tool, thế là xong. Ở lần gọi tiếp theo, ta xoá toàn bộ tool cũ và thêm tool mới vào.
Chị chạy, phải chờ một lúc. Kết quả cho thấy ở mỗi lần gọi, lượng token tăng dần. Tại sao nhiều hơn? Vì giờ chị gửi kèm cả chat history. Chị gửi đúng những tool cần, chỉ những tool cần, cộng với chat history. Đó là lý do lượng token cứ lớn dần lên. Accuracy thì tốt hơn, và đúng là tốn nhiều token hơn.
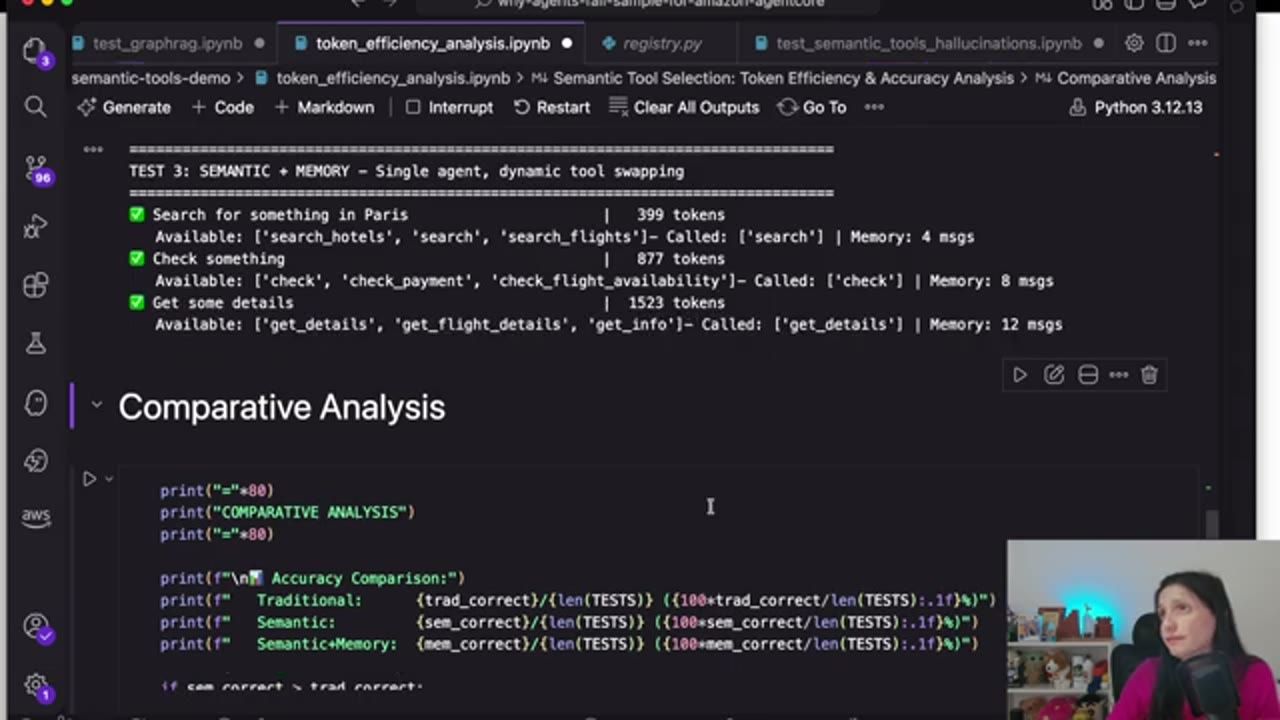
Chị thừa nhận có lẽ accuracy ở đây chưa phải tốt nhất, vì đây là một demo siêu đơn giản với những tool siêu giả, và một số query mơ hồ có chủ đích: "search for something", "book for something", "check something". Demo có những tool chung chung, giả, với tên na ná nhau. Khi cả 29 tool cùng hiện ra, model đôi khi chọn nhầm. Còn khi có bộ lọc, những tool chung chung đó chỉ xuất hiện khi query thật sự khớp với chúng.
Bạn có thể tự chạy toàn bộ và tự test. Phần này chỉ chạy local.
7. Đưa semantic tool selection lên production với AgentCore Gateway
Vậy khi muốn đưa demo này lên production thì sao? Tất nhiên bạn có thể dựng một vector store lớn hơn, chẳng hạn dùng Postgres. "Nhưng tôi nghĩ vậy là quá nhiều", chị nói.
Ở AWS có Amazon Bedrock AgentCore, một service dành riêng cho agent chạy trên production. Bên trong AgentCore có AgentCore Gateway. Gateway cho phép bạn dựng cái index này mà không phải tự làm. Bạn chỉ cần nói "đây là các tool của tôi", và AgentCore Gateway dựng mọi thứ cho bạn, kể cả phần vector search bên trong.
Nói cách khác, routing layer nằm bên trong AgentCore và nó tự lo việc chọn tool. Bạn đăng ký tool một lần, và Gateway tìm đúng tool cho từng request. Cùng một nguyên lý với demo vừa xong, nhưng không có hạ tầng nào phải quản lý.
8. GraphRAG: khi vector search chỉ biết đoán
Kỹ thuật tiếp theo là GraphRAG. Chị nhắc lại RAG là Retrieval-Augmented Generation, cách agent truy cập dữ liệu riêng của bạn. Bạn lấy câu hỏi của người dùng, tìm trong tài liệu những nội dung giống nhất bằng vector search, rồi đưa những gì tìm được cho model. Model trả lời dựa trên đó. Cách này chạy tốt với câu hỏi mở kiểu "tìm cho tôi thứ gì đó về chủ đề này".
Nhưng có một loại câu hỏi mà cách này đổ vỡ. Điểm đánh giá trung bình của tất cả khách sạn ở Paris là bao nhiêu? Có bao nhiêu khách sạn có hồ bơi? Vector search luôn trả về một thứ gì đó, kể cả khi không có gì thật sự liên quan. Và agent chỉ thấy top N chunk trong toàn bộ dữ liệu của bạn tại một thời điểm. Nó không thể aggregate, không thể đếm, không thể đi theo các quan hệ trên toàn bộ dataset. Thế là nó ước lượng, rồi trình bày con số ước lượng đó như một sự thật, như một câu trả lời thật.
Với RAG, bạn dựng vector store, nó lấy ra ba chunk từ ba trăm tài liệu, và model đoán. Với GraphRAG, bạn chạy một query trên toàn bộ dữ liệu và nhận về một kết quả đã được tính toán.
Graph giải quyết vấn đề theo cách khác: thay vì truy xuất các chunk text, bạn dựng một knowledge graph từ tài liệu, gồm node, relationship, dữ liệu có cấu trúc. Trong demo, chị dùng Neo4j chạy local, và model sẽ tự viết một Cypher query để tìm trong graph. Cypher là ngôn ngữ query của Neo4j, khá giống SQL (Cypher manual). Graph chạy query đó trên toàn bộ dữ liệu, và model nhận về một kết quả đã được tính toán và kiểm chứng, không phải một mẫu.
9. Demo GraphRAG: hai agent, một tool Cypher và bài test aggregation
Trước khi chạy demo này, cần cài dependency. Chị mở notebook GraphRAG, notebook chị muốn chia sẻ, và lại cài requirements. Trong đó có OpenAI một lần nữa, có Neo4j vì GraphRAG cần Neo4j. Với agent dùng RAG thường, chị dựng một vector store cực đơn giản trên Faiss và lại dùng sentence transformer.
Mọi thứ đã cài sẵn. Chị gọi OpenAI, khai báo tool (vì muốn tạo vài tool riêng ở đây), dùng graph database, và Neo4j đang chạy local trên máy. Có một ô kiểm tra Neo4j. Chị dựng vector store Faiss, và Neo4j đã có sẵn trên máy. "Không biết tôi có cho các bạn xem được không. Chắc là không."
Có một tool bình thường, tạo bằng decorator, để tìm trong vector store. Rất đơn giản: nhận query, tạo embedding cho query, rồi tìm trong vector store. Và có một tool cho knowledge graph. Ở đây model cần hiểu rằng để tìm trong knowledge graph, nó phải tự dựng một Cypher query. Vì ta đã biết cách viết tool rồi, chị đưa hướng dẫn đó vào context. Tool có driver để kết nối tới database và gửi Cypher query mà model sẽ viết, rồi có phần đọc kết quả, và thế là xong. Đó là tool duy nhất chị cần để tìm trong knowledge graph.
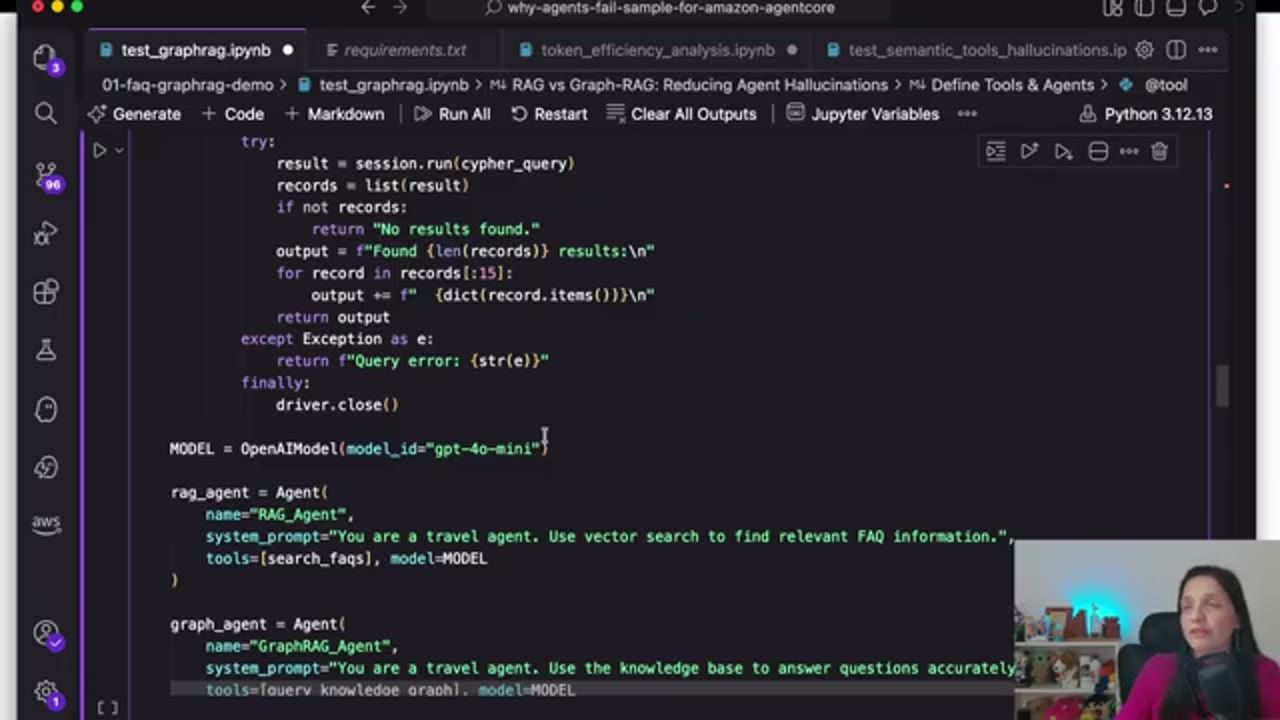
session.run(cypher_query), trả "No results found." khi không có bản ghi, nếu có thì liệt kê tối đa 15 bản ghi, bắt lỗi query, đóng driver. Bên dưới là hai agent dùng cùng model gpt-4o-mini: RAG_Agent với tool search_faqs và prompt "Use vector search to find relevant FAQ information", và GraphRAG_Agent với tool query_knowledge_graph và prompt "Use the knowledge base to answer questions accurately".Model là OpenAI. Có agent RAG và agent graph, hai agent khác nhau để so kết quả. Chị chạy bài test đầu tiên, aggregation, với câu hỏi: điểm đánh giá trung bình của khách trên tất cả khách sạn ở Paris là bao nhiêu?
Agent đã chạy xong trong lúc chị đang nói. Agent RAG trả lời rằng điểm trung bình trên các khách sạn được liệt kê ở Paris là ... và nó tự tính. Khi dùng RAG, agent đi tới vector store, nhận về N câu trả lời có thể có. Vì đây là câu hỏi aggregation, nó dùng dữ liệu nhận được để tự dựng một phép tính. Mọi thứ ta thấy trên màn hình ở đây là model đang reasoning.
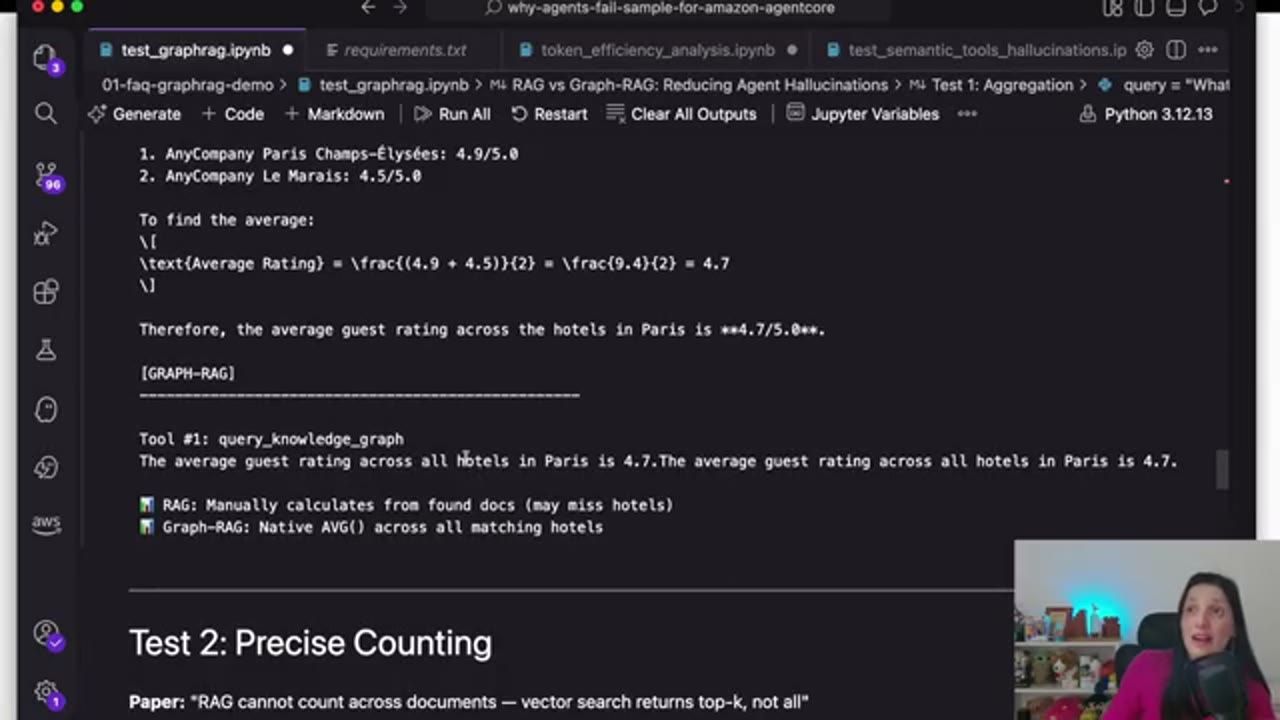
query_knowledge_graph một lần và trả lời thẳng 4.7. Dòng tóm tắt: RAG tính tay từ các tài liệu tìm được (có thể bỏ sót khách sạn), Graph-RAG dùng AVG() có sẵn trên mọi khách sạn khớp điều kiện. Bên dưới bắt đầu Test 2 Precise Counting.Còn khi chạy agent graph, nó chỉ đưa ra câu trả lời, chỉ chừng ấy token. Vì Cypher query tự làm được phép tính, ta không cần agent, không cần LLM, không cần model làm phép tính đó: Cypher query đã trả về đúng kết quả. Đáp án là 4.7.
Ở bài đầu này, chị nói, ta gặp may, vì có lẽ chỉ có hai khách sạn. Nhưng nếu vector store có nhiều hơn hai, ba khách sạn thì sao? Khi đó ta sẽ không có câu trả lời thật. LLM sẽ tính chỉ với ba câu trả lời nó nhận được, tức là tính trung bình trên đúng ba khách sạn. Nếu vector store có nhiều hơn ba khách sạn, ta sẽ gặp vấn đề.
10. Đếm chính xác, multi-hop và câu hỏi ngoài phạm vi dữ liệu
Bài test tiếp theo là đếm chính xác, kiểu như: có bao nhiêu khách sạn có hồ bơi trong danh sách tiện ích? Agent RAG truyền thống trả lời: "Có vẻ như việc tìm kiếm không trả về thông tin cụ thể nào về các khách sạn ở Paris." Còn agent kia: "Hiện không có khách sạn nào có hồ bơi." Không có khách sạn nào.
Agent RAG thì kiểu "ừm, bạn có muốn hỏi về khách sạn có tiện ích cụ thể nào khác, hay thông tin khác không?". Giống như "ừm, có thể có, hoặc có thể tôi không biết". Chị nhận xét: không chính xác lắm.
Tiếp theo là multi-hop reasoning. Câu hỏi: các loại phòng và giá của khách sạn được đánh giá cao nhất là gì? Đây thực chất là hai câu hỏi nối nhau. Agent RAG đi tìm dữ kiện, lẽ ra chỉ cần một khách sạn, và trả lời "khách sạn được đánh giá cao nhất ở AnyCompany Paris ..." kèm một tràng dài. "Tôi không nói được tiếng Pháp", chị đùa khi đọc tên khách sạn. Điểm đánh giá là con số đó, thôi kệ. Rồi "hiện tôi không có ...", blah, blah, blah, rất nhiều dữ liệu ở đó.
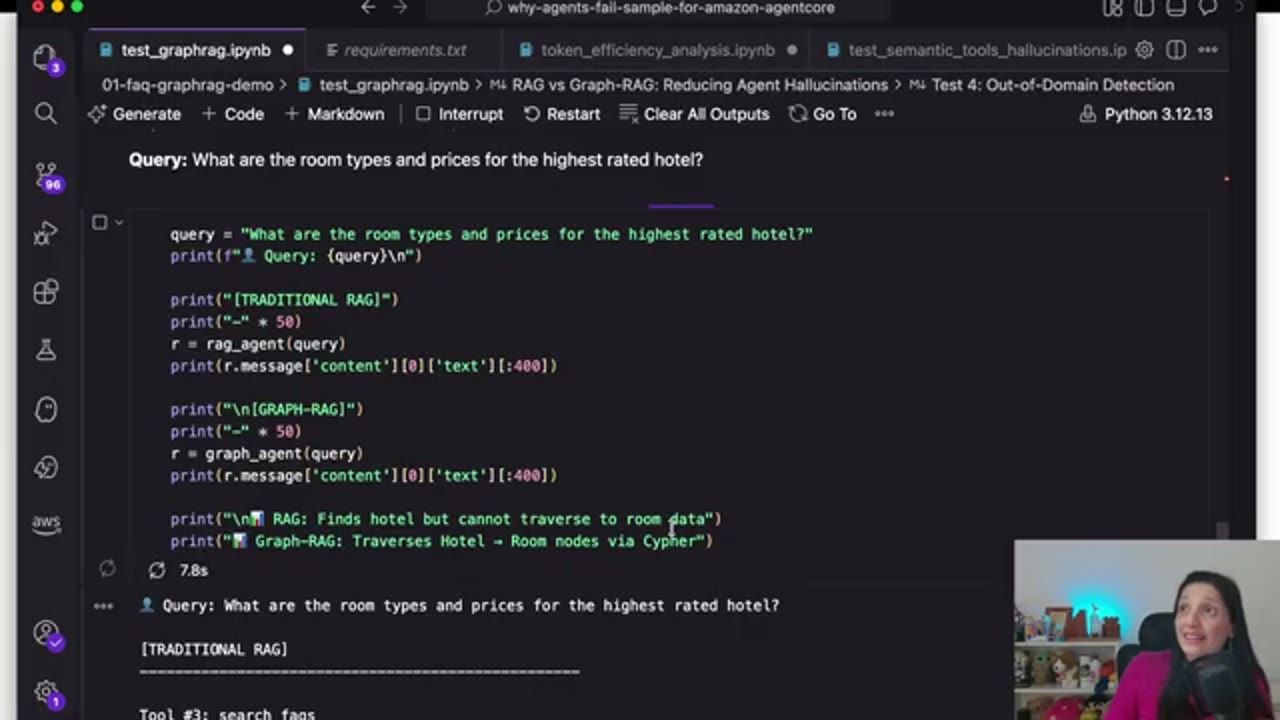
Còn agent kia thì sao? Màn hình hiện một thông báo lỗi, chị bật cười. Ở agent thứ hai, chị nhận được câu trả lời: "Khách sạn được đánh giá cao nhất là Harmony ... Họ có các loại phòng sau. Nhưng tiếc là những phòng này hiện không còn trống." Chị nhận được đúng câu trả lời mình cần, không có cả tràng blah, blah, blah.
Bài cuối là phát hiện câu hỏi ngoài phạm vi (out-of-domain detection). Câu hỏi: kể cho tôi về các khách sạn ở Nam Cực. Chị "spoil" trước: không có khách sạn nào ở Nam Cực, đúng bằng không.
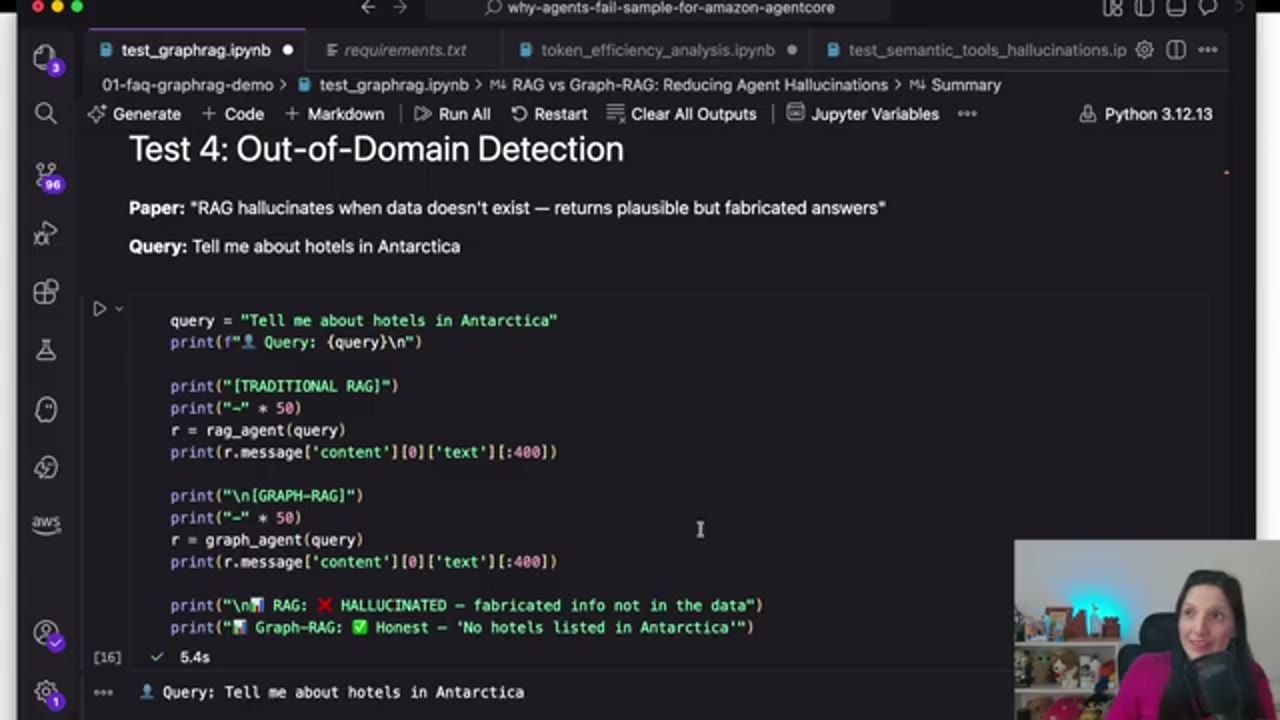
Agent RAG trả lời: "Có vẻ việc tìm kiếm không trả về thông tin cụ thể về khách sạn." Đúng rồi, vì không có. Rồi "Vì vậy, hiện tôi không có chi tiết ...", blah, blah, blah, và "nếu bạn đang tìm một trải nghiệm cụ thể hay có câu hỏi cụ thể về việc đi Nam Cực, hãy cho tôi biết, tôi có thể hỗ trợ". Chị đáp lại màn hình: không, cảm ơn. Rất nhiều token bị LLM tiêu vào câu trả lời đó.
Agent kia thì sao? "Hiện không có khách sạn nào được liệt kê ở Nam Cực." Tất nhiên, vì nó tạo Cypher query và nhận về con số không. Nên nó trả lời trung thực. Phía dưới notebook có một phần tóm tắt mà Claude đã viết giúp chị trong Jupyter Notebook.
11. Neo4j tự dựng knowledge graph từ text
Trước khi sang kỹ thuật tiếp theo, chị muốn cho xem một thứ chị rất thích ở Neo4j, và cũng là lý do chị chọn Neo4j. Thư viện của Neo4j dùng được LLM, ở đây chị lại dùng OpenAI, để dựng knowledge graph.
Chị dựng knowledge graph thế nào? Chị chỉ có một đống dữ liệu, một đống file TXT, chỉ là text thuần. Chị gửi dữ liệu đó vào thư viện Neo4j, và nhờ thư viện này, nó hiểu được toàn bộ dữ liệu của chị và tự dựng graph. Chị không cần tự tay tạo graph, mà chỉ dùng SimpleKGPipeline trong thư viện knowledge graph của Neo4j.
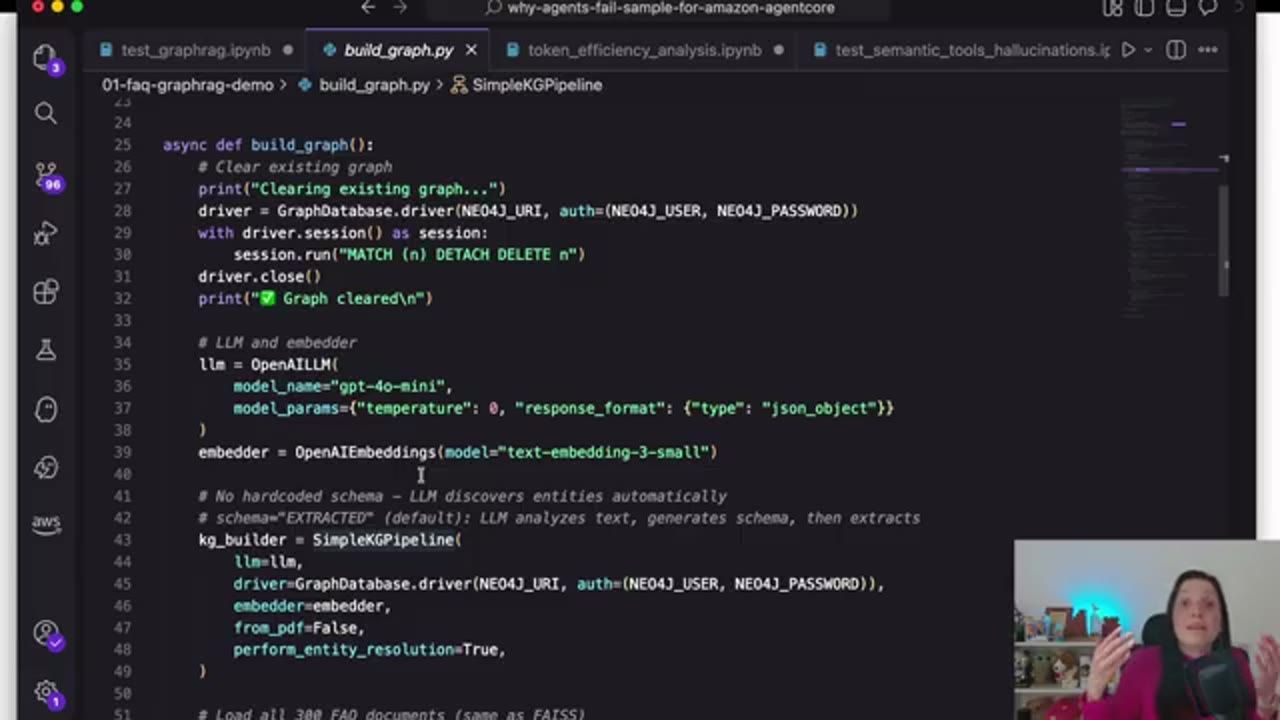
build_graph.py: xoá graph cũ bằng MATCH (n) DETACH DELETE n, khai báo LLM gpt-4o-mini (temperature 0, trả JSON) và embedder text-embedding-3-small, rồi tạo SimpleKGPipeline. Comment trong code ghi rõ: không có schema viết cứng, LLM tự phát hiện entity, phân tích text, sinh schema rồi trích xuất, có bật entity resolution. Sau đó nạp cả 300 tài liệu FAQ, cùng bộ đã dùng cho Faiss."Vì thế mà tôi dùng Neo4j. Nó tuyệt vời và cực kỳ dễ dùng, nên tôi mời các bạn thử." Rồi chị chuyển sang kỹ thuật tiếp theo.
12. Multi-agent validation: agent báo thành công dù tool đã lỗi
Kỹ thuật thứ ba là multi-agent validation. Đôi khi một agent thất bại mà không ai phát hiện ra. Nó gọi một tool, tool trả về lỗi, nhưng agent không đưa lỗi đó ra ngoài. Thay vào đó, nó sinh ra một câu trả lời thành công đầy tự tin. Người dùng nghĩ là đã xong, bạn cũng nghĩ là đã xong, nhưng thực ra không.
Lý do là agent vừa hành động vừa tự kiểm tra output của chính nó trong cùng một loop. Không có sự tách biệt, không có ý kiến thứ hai, nên khi có gì sai, nó tự hợp lý hoá và nói với bạn "Ổn cả, chạy được rồi".
Đây là chuyện xảy ra bên trong một agent đơn lẻ khi nó thất bại: nó gọi tool, nhận lỗi, tự hợp lý hoá lỗi đó, và trả về một câu trả lời thành công. Người dùng không bao giờ thấy lỗi.
Bạn giải quyết bằng cách thêm một lớp validation. Bạn có thể có ba agent xếp nối nhau: một agent hành động, một agent kiểm tra, một agent duyệt hoặc từ chối. Strands Agents có sẵn một class cho việc này, tên là Swarm. Nó tự quản lý việc handoff (chuyển giao) giữa các agent. Bạn chỉ cần định nghĩa vai trò của từng agent trong system prompt.
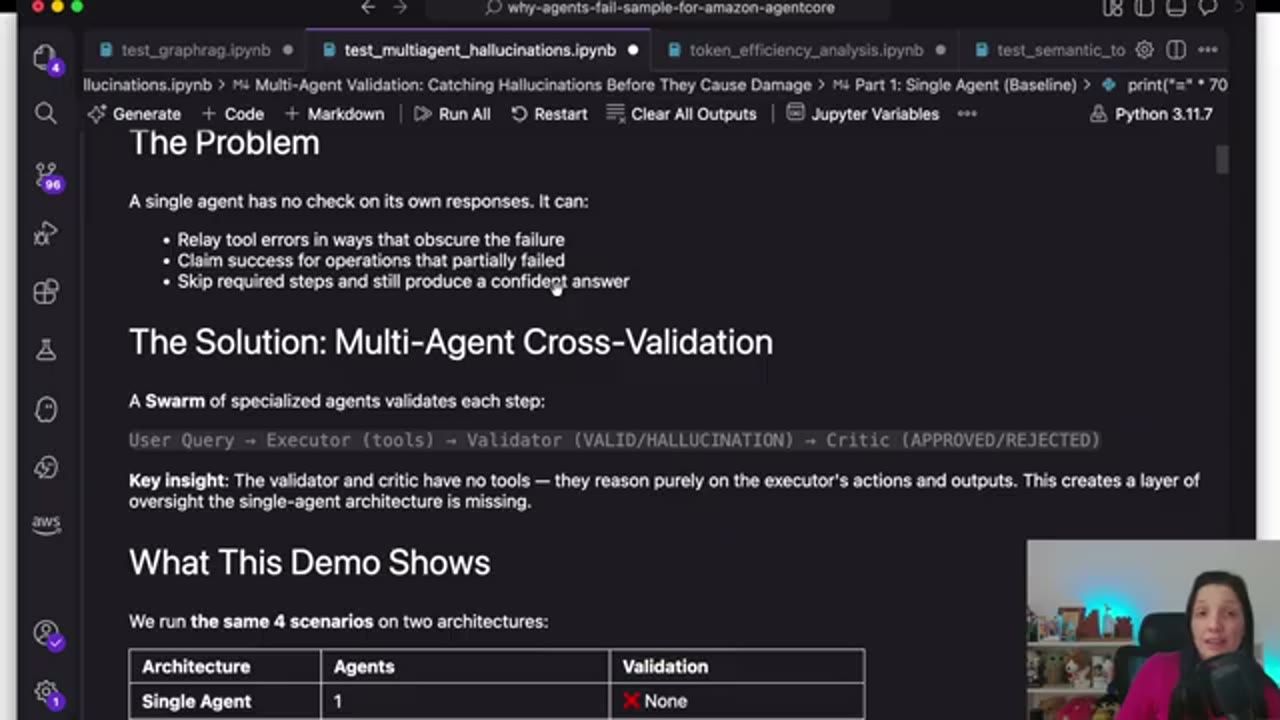
13. Demo Swarm: executor, validator và critic
Demo này chỉ cần Strands Agents với phần tích hợp OpenAI. Chị mở requirements: chỉ Strands Agents, không cần gì thêm. Trong notebook, thứ quan trọng nhất là Swarm. Swarm cho phép bạn nối nhiều agent với nhau mà không phải tự viết vòng for hay while để ghép các agent lại. Nó tự dựng chuỗi và tự quản lý handoff giữa các agent.
Ở đây chị sẽ tạo ba agent. Trước đó có agent bình thường và có dữ liệu ground truth. Phần đầu là tạo một agent đơn lẻ. Chị test ba kịch bản để kiểm tra một lượt đặt phòng: một booking hợp lệ, kỳ vọng thành công (true); khách sạn không có phòng trống, kỳ vọng false; khách sạn không tồn tại và mã booking không có, cũng kỳ vọng false.
Đây là cách tạo một agent đơn lẻ: cần một prompt và vài tool. Chị dùng các tool đã khai báo ở trên, và biết dữ liệu nằm ở đâu, nên agent có thể đưa ra câu trả lời ta đang tìm.
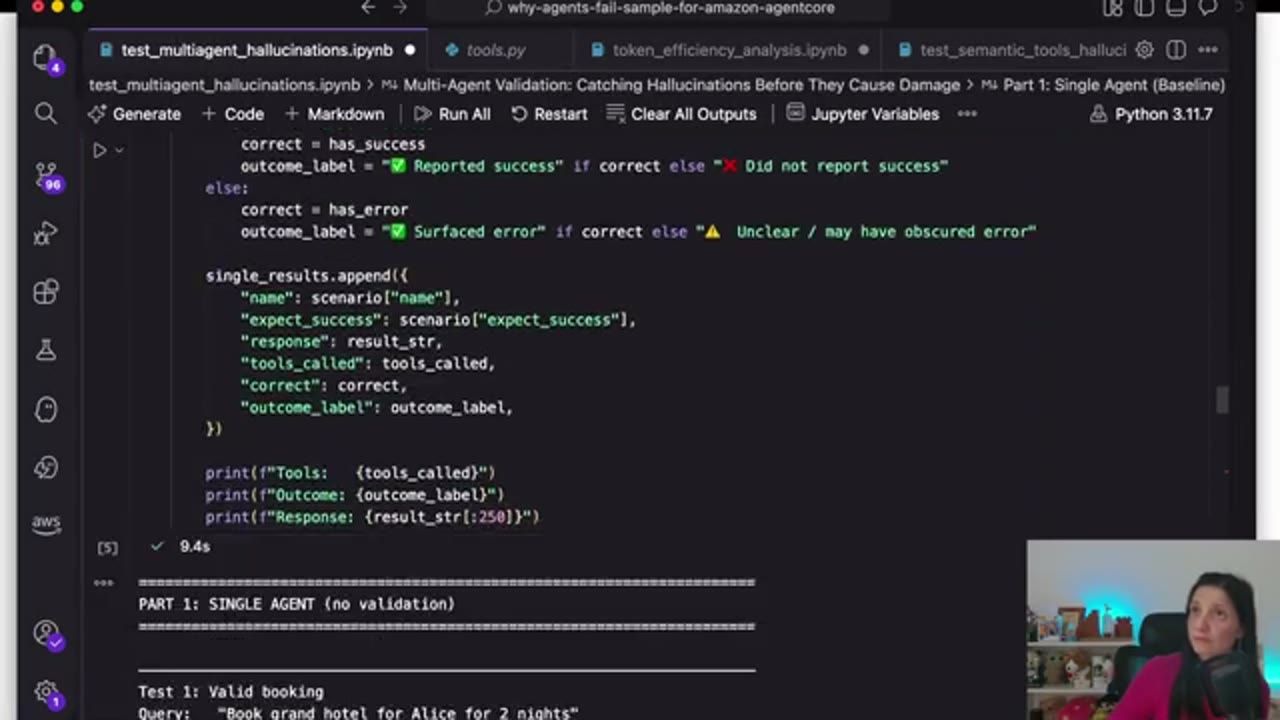
Tiếp theo là cách dựng swarm. Chị có ba agent khác nhau: executor, validator và critic. Mỗi agent có system prompt riêng. Executor: "You are an executor agent for a hotel booking system. Use the provided tools to fulfill requests accurately", và blah, blah, blah. Validator: "You are a validator agent. Review what the executor did and output exactly one of" các nhãn cho trước. Còn critic sẽ nói duyệt hay chưa.
You are an executor agent for a hotel booking system. Use the provided tools to fulfill requests accurately ...

You are a validator agent. Review what the executor did and output exactly one of: ...
Chị chạy, và gặp lỗi: chưa định nghĩa model. "Xin lỗi, xin lỗi, thông cảm cho tôi vì đây là live, tôi đã không chạy ô này." Chị chạy lại ô có model, vì model nằm ở ô agent bình thường. Vẫn lỗi. "Có chuyện gì với bạn vậy?" Chị copy và dán lại đoạn code, không hiểu sao nó cứ báo lỗi. "Trùng tên à? Nào." Rồi chị cười: "Các bạn thấy đấy, đây là live, tôi sẽ không cắt đoạn này đâu." Cuối cùng nó chạy, và chị cảm ơn cái notebook.
Swarm được tạo thế nào? Ta gọi hàm Swarm, đưa tất cả agent vào, và entry point là executor. Mọi thứ bắt đầu ở executor, rồi nó handoff tiếp. Chị đặt tối đa sáu lần handoff, vì con số này bạn cũng kiểm soát được. Cuối cùng lấy final response của swarm. Chị viết một vòng for và gửi toàn bộ request.
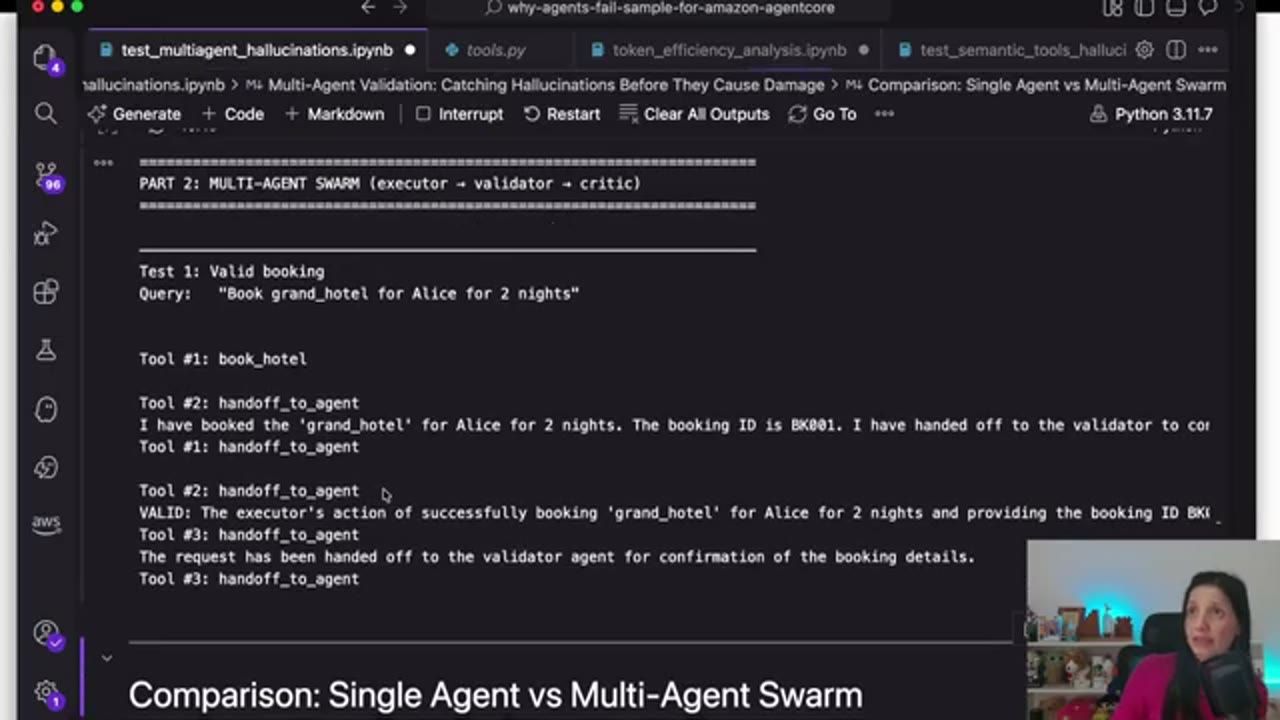
book_hotel, báo đã đặt grand_hotel cho Alice 2 đêm với mã BK001, rồi gọi handoff_to_agent sang validator. Validator xác nhận VALID và chuyển tiếp. Bên dưới là bảng so sánh agent đơn lẻ với swarm.Request đầu: đặt Grand Hotel. "Tôi đã đặt Grand Hotel cho Alice tối nay", booking blah, blah, blah. Handoff. Validator: hợp lệ. "Okay, đi tiếp." Verdict: approve. Critic duyệt request này. Rồi tới request tiếp theo, và ta có thể chạy phần so sánh nếu muốn.
Ở đây ta thấy swarm tự điều phối luồng giữa cả ba agent. Phần so sánh cho thấy điều gì xảy ra khi agent đơn lẻ cố xác nhận một thứ không tồn tại trong hệ thống. Còn với cùng request đó qua swarm, executor nhận lỗi, validator bắt được, critic từ chối, và người dùng không bao giờ thấy một câu trả lời bịa.
Chị chạy thử: agent đơn lẻ gặp mục không tồn tại nhưng vẫn trả về thành công. Còn swarm có executor nhận lỗi, validator lên tiếng ("Này, thôi nào", đây là hallucination), và critic từ chối. Người dùng thấy một thất bại rõ ràng, không phải một xác nhận bịa đặt về khách hàng không có trong hệ thống.
Bạn có thể chạy phần này để so hai kiểu agent. Với agent đơn lẻ, mọi thứ đều kiểu "ừ, ổn cả, đúng rồi". Còn ở multi-agent swarm, agent cuối cùng nói "Ừm, bạn biết đấy, có vấn đề ở đây, có chuyện gì đó đang xảy ra."
14. Neurosymbolic guardrails: rule nằm trong code, không nằm trong prompt
Kỹ thuật thứ tư là neurosymbolic guardrails. Giả sử agent của bạn có một rule: tối đa mười khách cho mỗi lượt đặt phòng. Bạn viết rule đó trong system prompt. Bạn còn viết nó trong mô tả tool. Vậy mà agent vẫn gọi tool với số khách vượt quá mười.
Không phải vì nó phớt lờ bạn. Mà vì prompt về bản chất chỉ là gợi ý, không phải ràng buộc. Model xử lý prompt như text, không như logic phải thực thi. Nó mang tính xác suất. Chỉ code mới thực thi logic. Rule nằm trong prompt thì model đọc như một lời gợi ý. Rule nằm trong code thì model không thể bỏ qua.
Neurosymbolic guardrails đặt rule vào code. Strands Agents có một tính năng tên là hooks: function mà Strands tự động gọi ở những thời điểm xác định trong agent loop, ở đây là ngay trước khi một tool chạy. Bạn có một hook, bạn viết rule, kiểm tra parameter, và nếu không đạt thì huỷ lần gọi tool đó.
Chị mở Jupyter Notebook. Requirements giống các demo trước: chỉ cần Strands và OpenAI, không cần gì khác, cộng với API key. Chị chạy lại từ đầu.
Thứ quan trọng trong demo này là ba thành phần hook có sẵn trong base class của Strands, cho phép bạn tạo hook: HookProvider, HookRegistry và BeforeToolCallEvent. HookRegistry là thứ Strands truyền cho bạn để đăng ký callback. BeforeToolCallEvent là event được bắn ra mỗi khi model sắp thực thi một tool. Chính event cuối này cho phép chặn lần gọi trước khi nó chạy. Ngoài BeforeToolCallEvent tất nhiên còn có AfterToolCallEvent, nhưng demo này không dùng tới.
Chị nhắc lại: rule trong prompt thì model đọc như text, và có thể làm theo hoặc không. Chị chạy ô tiếp theo: ở đây có một state giả lập dùng cho agent này. Rồi tới phần symbolic rule, tức các booking rule chị tự tạo.
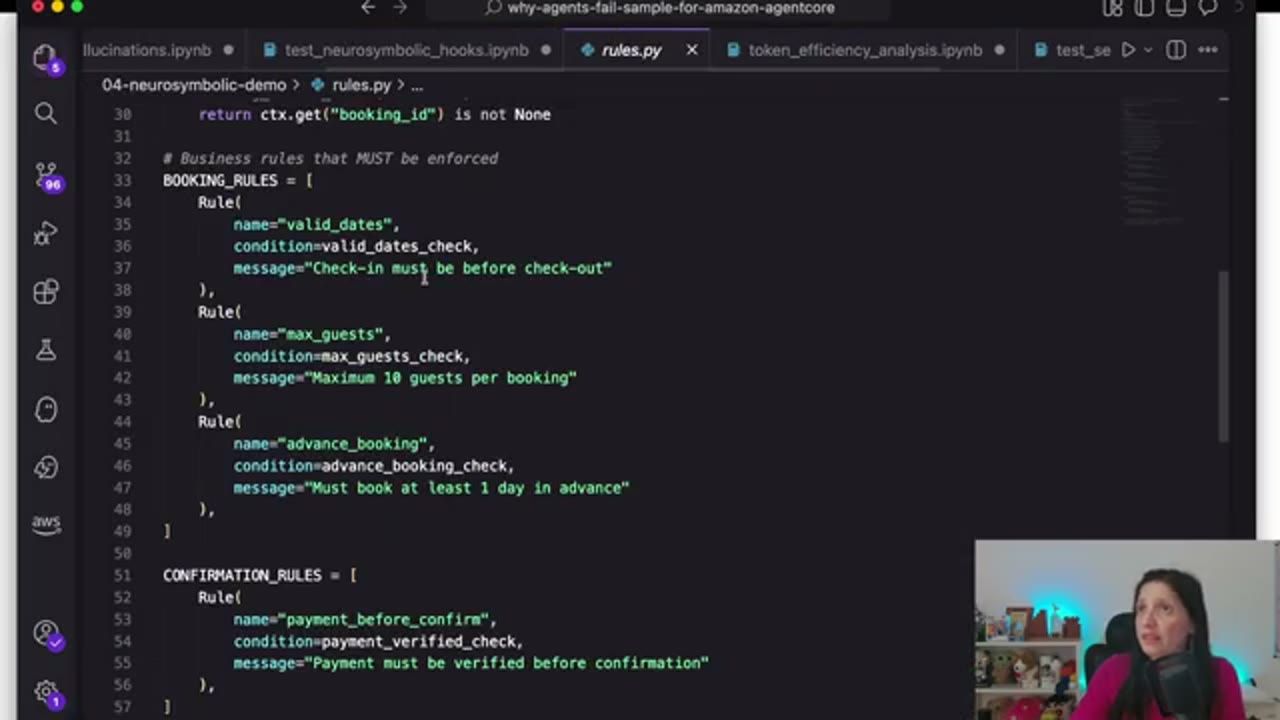
rules.py: "Business rules that MUST be enforced". BOOKING_RULES gồm valid_dates (check-in phải trước check-out), max_guests (tối đa 10 khách mỗi booking) và advance_booking (phải đặt trước ít nhất 1 ngày). CONFIRMATION_RULES gồm payment_before_confirm (phải xác minh thanh toán trước khi xác nhận). Mỗi rule là một condition viết bằng Python kèm thông điệp.15. Demo hook: ba kịch bản, một dòng code khác biệt
Chị đi qua các rule. Rule một: validate ngày, check-in phải trước check-out, kiểm bằng hàm validate ngày. Rule này được gọi khi cần dùng tới. Rule khác cho số khách tối đa: tối đa mười khách mỗi booking. Nếu muốn đặt phòng cho, chẳng hạn, 11 người, nó sẽ chặn lại, từ chối booking. Có rule xác nhận: thanh toán trước khi xác nhận, vì không thể xác nhận nếu chưa có thanh toán. Và rule huỷ: không thể huỷ trong vòng 48 giờ trước check-in. Tất cả là những thứ chị tự tạo cho demo. Ở đây chị có booking rule và confirmation rule, còn cancellation rule thì không dùng.
Tiếp theo là tạo validation hook, hook neurosymbolic, dùng HookProvider. Có một đoạn code đưa booking rule và confirmation rule vào state. "Các bạn tự xem sau nhé, giờ ta muốn xem demo chạy."
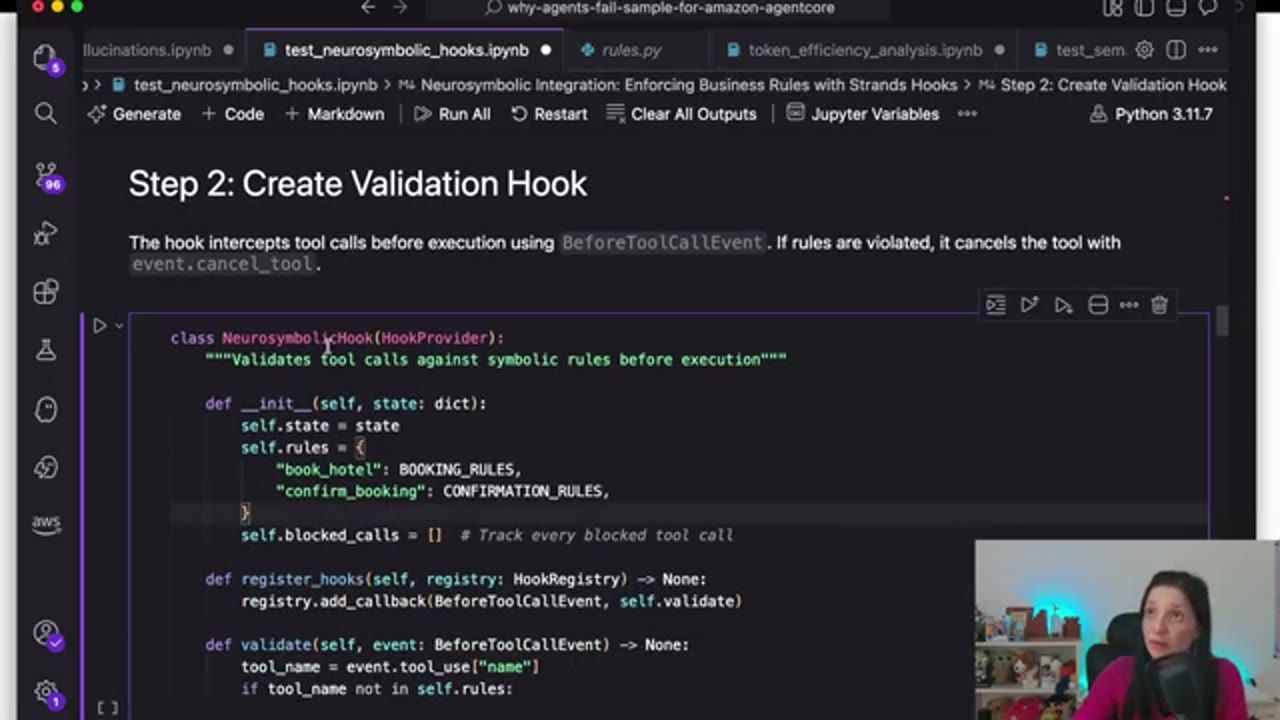
BeforeToolCallEvent; nếu rule bị vi phạm, nó huỷ tool bằng event.cancel_tool. Class NeurosymbolicHook(HookProvider) giữ state, ánh xạ book_hotel tới BOOKING_RULES và confirm_booking tới CONFIRMATION_RULES, lưu danh sách các lần gọi bị chặn, và trong register_hooks thêm callback validate cho BeforeToolCallEvent.Sau đó chị định nghĩa các tool sạch dùng cho đặt khách sạn và xử lý thanh toán, những tool bình thường. Rồi cần gắn tool với hook. "Hình như tôi đã thêm rồi. Đúng." Tên tool là book_hotel, nên hook này được kích hoạt khi book_hotel được dùng.
Giờ tạo các agent để so sánh. Giống những demo khác, có ba kịch bản: xác nhận booking khi chưa thanh toán (rule phải kích hoạt là "thanh toán phải được xác minh trước khi xác nhận"); đặt khách sạn vượt giới hạn số khách; và một booking hợp lệ cho năm khách. Có agent bình thường, agent baseline, và agent có neurosymbolic guardrail, tức có hook.
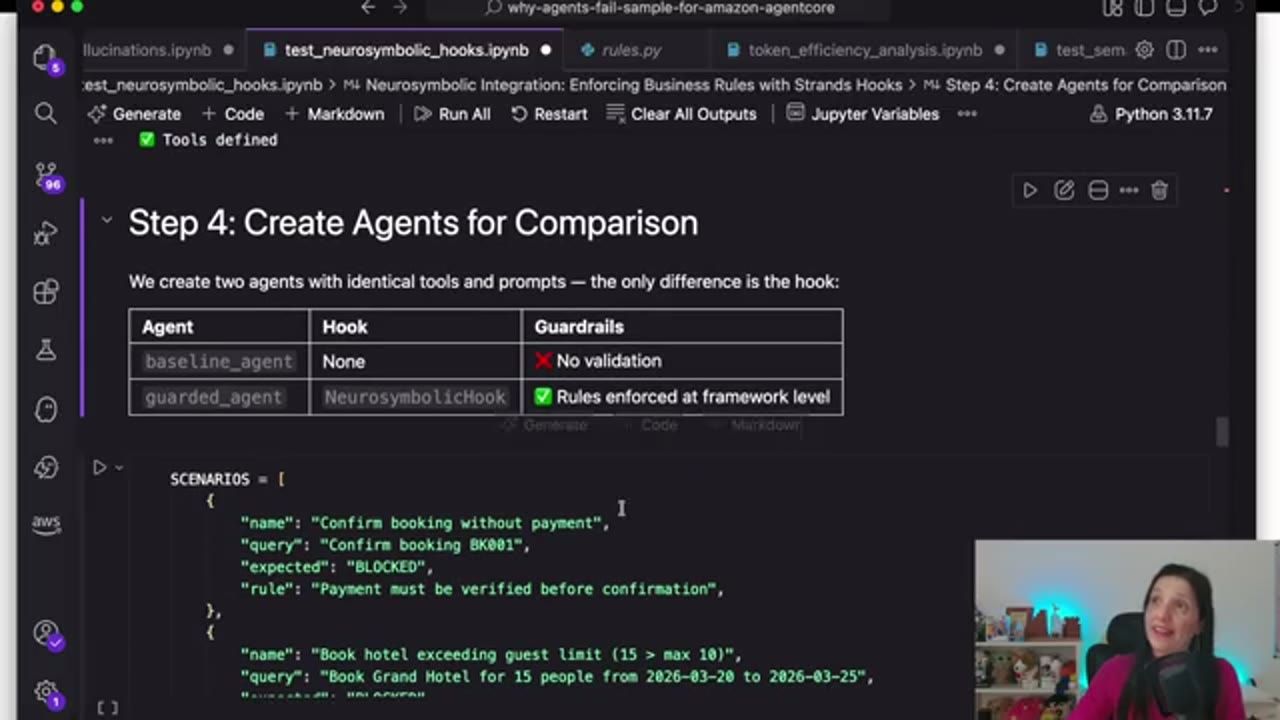
baseline_agent không có hook, không validation; guarded_agent có NeurosymbolicHook, rule được thực thi ở tầng framework. Danh sách SCENARIOS bắt đầu với "Confirm booking without payment" (query "Confirm booking BK001", kỳ vọng BLOCKED) và "Book hotel exceeding guest limit (15 > max 10)" (đặt Grand Hotel cho 15 người từ 2026-03-20 tới 2026-03-25).Chị chỉ ra: agent bình thường chỉ có ba dòng, tool, model. Còn đây là dòng tạo ra khác biệt giữa hai agent: dòng gắn hook. Chị chạy.
Kịch bản một: xác nhận booking khi chưa thanh toán. Agent đầu tiên làm điều hiển nhiên. "Thôi nào", chị than: nó xác nhận booking mà không cần thanh toán, vì nó không có rule nào và prompt thì cực kỳ cơ bản. Agent kia thì booking bị chặn: "Payment must be verified before the confirmation." "Cảm ơn. Vậy là ổn."
Kịch bản hai: đặt khách sạn vượt quá giới hạn số khách. Agent baseline báo đặt thành công, vì prompt cơ bản và chị không đưa rule nào vào. Agent kia trả lời rằng có vẻ Grand Hotel chỉ nhận tối đa 10 khách mỗi booking, và thêm rằng booking phải được đặt trước ít nhất một ngày. "Tôi không nhớ ngày. Chắc là do tôi đưa cho nó."
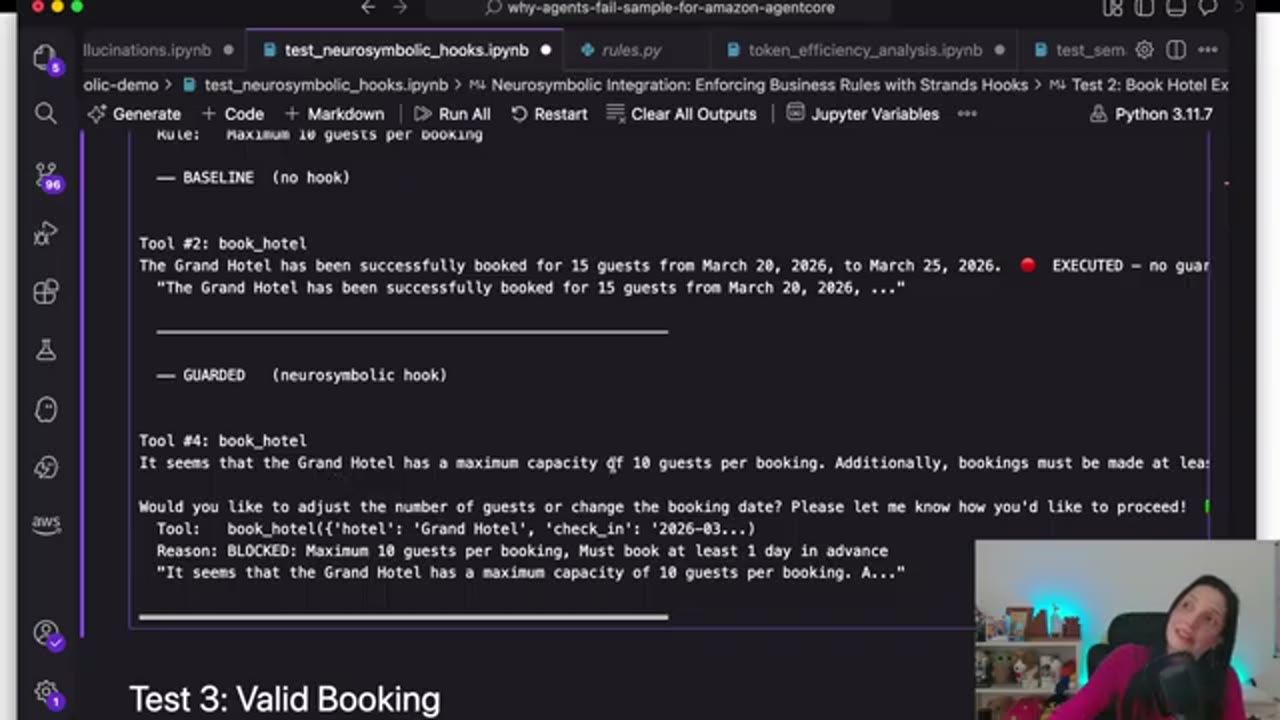
book_hotel và báo Grand Hotel đã được đặt cho 15 khách từ 20 tới 25 tháng 3 năm 2026: EXECUTED, không có guardrail. Guarded (hook neurosymbolic) cũng gọi book_hotel nhưng bị chặn với lý do "Maximum 10 guests per booking, Must book at least 1 day in advance", và agent hỏi lại người dùng muốn điều chỉnh số khách hay ngày đặt.Kịch bản ba là booking hợp lệ: cả hai agent đều chạy rule, và rule đều qua, vì đây chỉ là validation cho booking. "Đặt khách sạn cho blah, blah, blah", mọi rule đều qua. Chị đọc câu trả lời "có vẻ booking vẫn cần ...", rồi bối rối "à, tôi không nhớ câu hỏi", đọc lại, "à đúng rồi, được, tôi hiểu rồi".
Cuối cùng chị chạy tất cả kịch bản với nhau: xác nhận khi chưa thanh toán, booking vượt số khách tối đa, và booking hợp lệ cho năm khách. Đây là bảng so sánh kết quả hai agent, chị đọc nhanh từng ô đúng, sai, bị chặn.
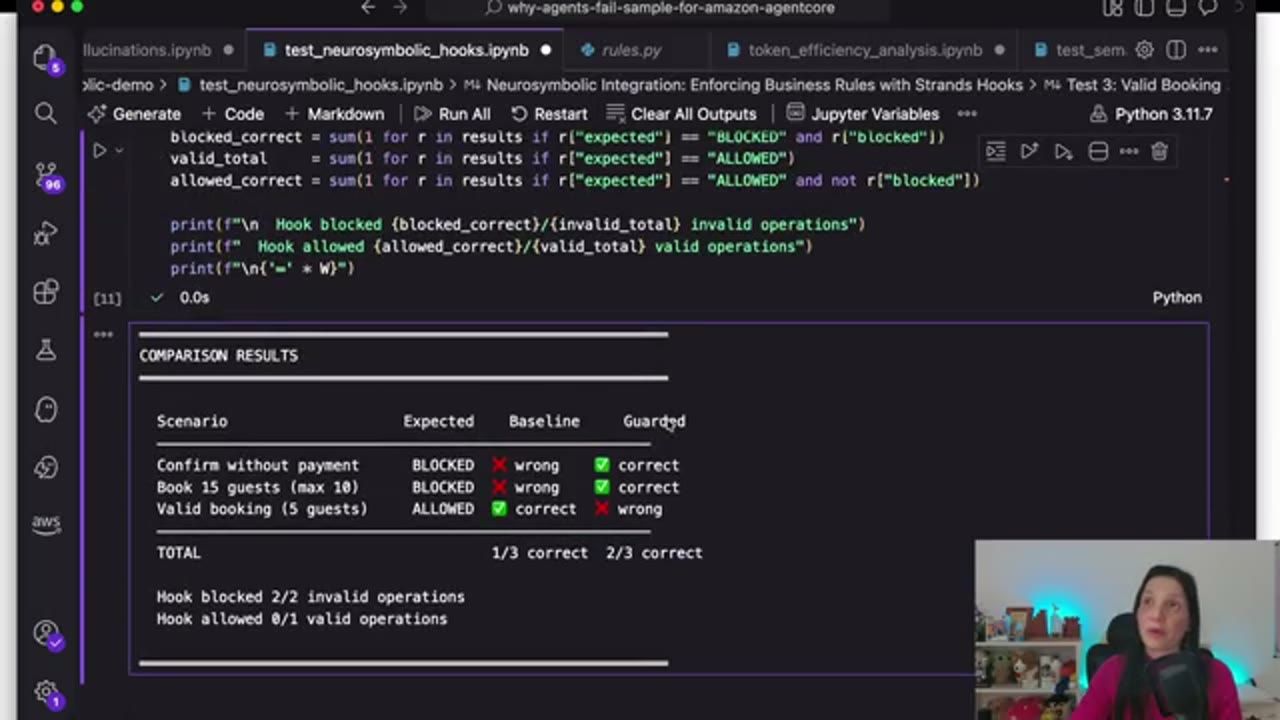
Điều chị muốn nhấn mạnh: cùng model, cùng tool, cùng prompt, nhưng kết quả khác nhau, vì rule nằm trong Python chứ không nằm trong prompt.
Pattern thực thi rule bằng code trước khi tool chạy này cũng chính là điều mà service Policy trong Amazon Bedrock AgentCore (AgentCore Policy) làm ở tầng hạ tầng. Cùng khái niệm, nhưng được quản lý sẵn cho bạn trên production, và bạn chỉ phải viết rule.
Có điều hook là tất cả hoặc không có gì: chặn hẳn hoặc cho qua. Nhưng đôi khi bạn muốn agent điều chỉnh rồi đi tiếp, chứ không dừng lại và để người dùng chờ. Đó là phần chị cho xem tiếp theo.
16. Runtime steering: steer, đừng block
Kỹ thuật thứ năm là runtime steering: steer, đừng block. Hook chặn vô điều kiện. Agent dừng lại, và người dùng phải thử lại. Với một ràng buộc cứng, đó chính xác là điều bạn muốn.
Nhưng đôi khi rule mềm hơn. Có thể một phòng chỉ đủ cho bốn khách, nhưng một nhóm sáu người vẫn có thể đặt hai phòng khác nhau. Hoặc một chuyến bay đã kín chỗ, nhưng chuyến sau còn chỗ. Bạn không muốn chặn tất cả. Có lẽ bạn muốn agent tìm một phương án và hoàn thành task. Đó là steering.
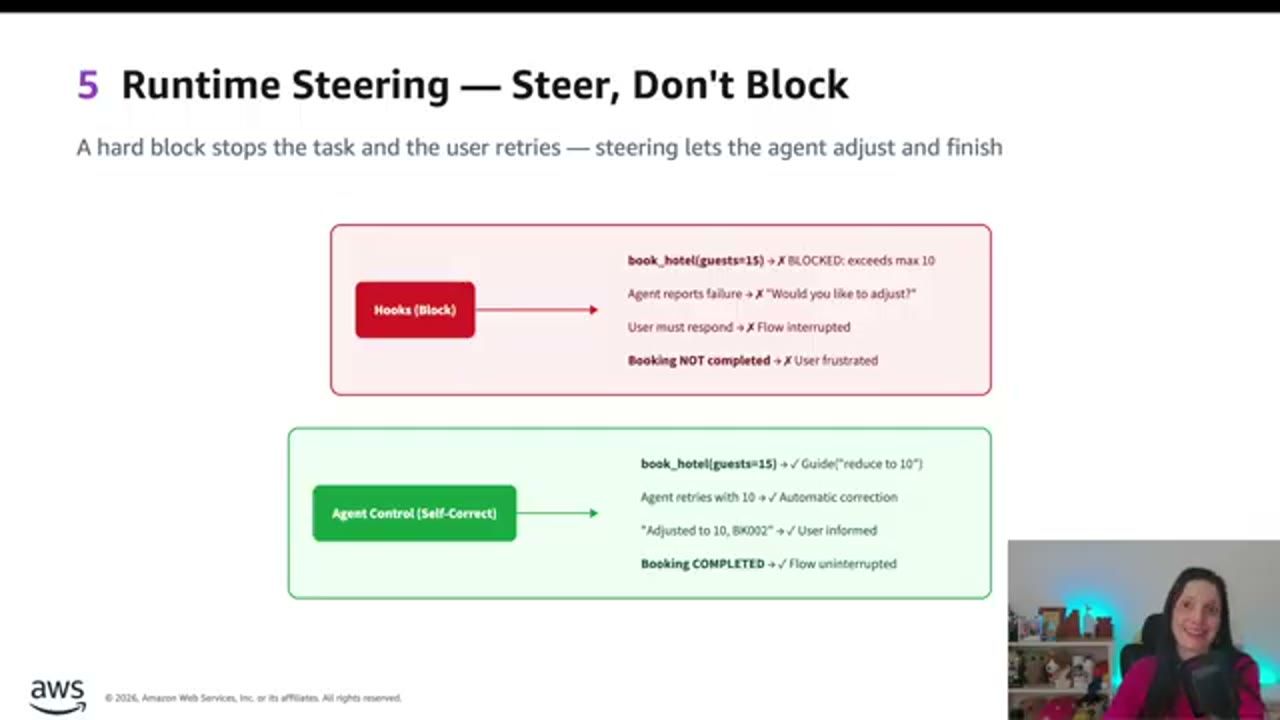
book_hotel(guests=15) bị chặn vì vượt tối đa 10, agent báo thất bại và hỏi "Would you like to adjust?", người dùng phải trả lời, luồng bị ngắt, booking không hoàn thành, người dùng bực. Nhánh Agent Control (Self-Correct): lần gọi được hướng dẫn "reduce to 10", agent tự gọi lại với 10, báo "Adjusted to 10, BK002" cho người dùng, booking hoàn thành, luồng không bị ngắt.Ở trên slide, nhánh hook kích hoạt và task thất bại; nhánh Agent Control steer model và task hoàn thành. Còn một khác biệt nữa, về mặt vận hành. Với hook, đổi một rule nghĩa là đổi code và deploy lại cả harness, cả agent. Với Agent Control, tên của thư viện open source chị sắp dùng (Agent Control), rule được đăng ký trên một server local qua API. Bạn cập nhật rule mà không đụng vào code của agent, vì agent nhận rule mới ngay lập tức.
17. Demo Agent Control: 15 khách được chia thành hai phòng
Trong notebook, demo này chỉ cần thêm một package: Agent Control SDK (agent-control-sdk). Agent Control là thứ giúp ta tạo steering. Chị dùng một file setup control: một ứng dụng nhỏ chị tự viết, gồm server local và các steering rule.
Trong đó có server local, có các control, tức các steering rule. Rule đầu tiên là steer số khách tối đa. "Steer, các bạn biết đấy, nghĩa là dẫn dắt": hướng dẫn agent giảm số khách khi vượt quá tối đa 10, và nó sẽ steer. Ngoài ra có những control kiểu deny, ví dụ deny no payment: chặn việc xác nhận khi chưa có thanh toán trước. Phần còn lại của file là để tạo service, tức server.
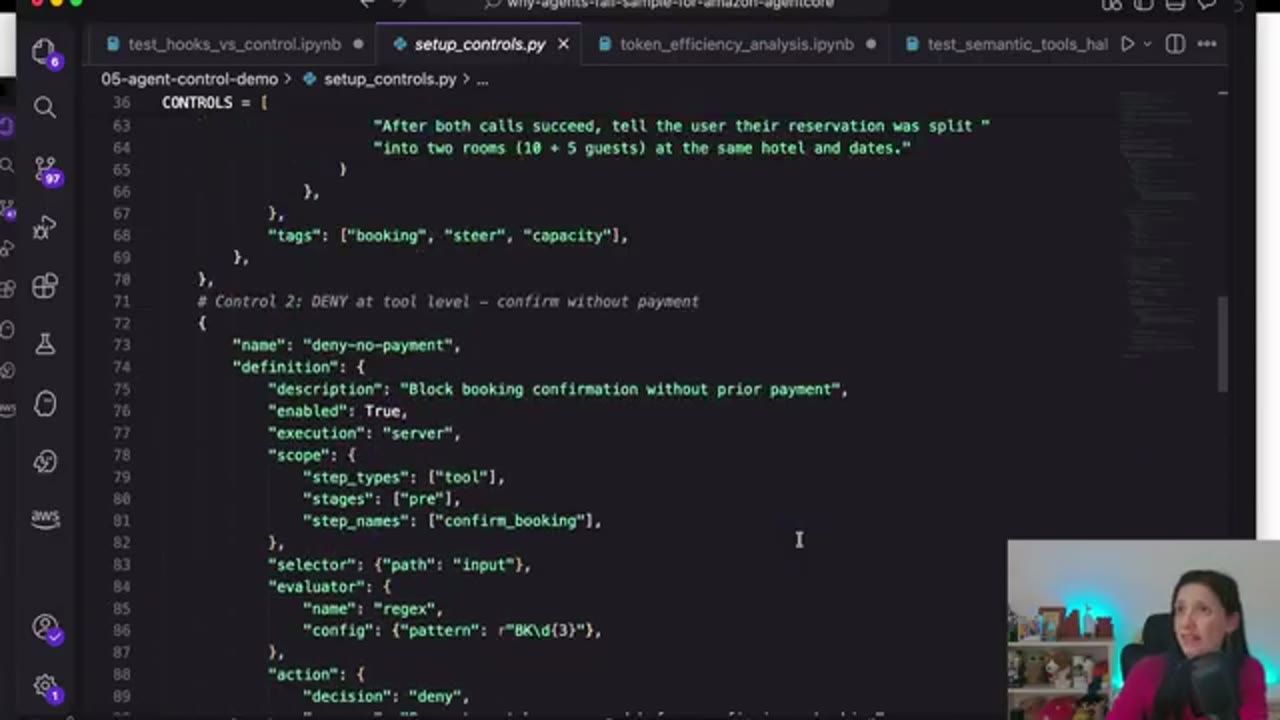
setup_controls.py: phần cuối của control steer số khách, với chỉ dẫn "sau khi cả hai lần gọi thành công, báo người dùng rằng đặt phòng đã được chia thành hai phòng (10 + 5 khách) ở cùng khách sạn và cùng ngày", gắn tag booking, steer, capacity. Control 2 là deny-no-payment: "Block booking confirmation without prior payment", chạy trên server, phạm vi ở bước tool confirm_booking giai đoạn pre, dùng evaluator regex với pattern mã booking, và action là deny.Chị quay lại notebook và nạp biến môi trường. Đây là agent. "Chỗ này sẽ báo lỗi, chờ đã, chờ đã. Tôi không muốn dùng Bedrock. Sao lại thế?" Chị comment dòng đó đi vì nó sẽ gây lỗi, rồi chạy.
Phần đầu có hook như demo trước. Kịch bản là đặt AnyCompany ở Lisbon, kèm vài prompt. Prompt của agent: "You are a hotel booking assistant. When booking, first describe what you will book", và blah, blah.
You are a hotel booking assistant. When booking, first describe what you will book (hotel, guests, dates) then call the tool.
Chị tìm agent: phần Agent Control, vài helper, và hook mà người xem đã biết vì vừa tạo ở demo trước. Có system prompt và có hook. Chị test agent này với yêu cầu đặt AnyCompany Lisbon cho 15 khách. Như đã nói, nó chỉ đặt được dưới 10 khách. Và tất nhiên, nó bị chặn.
Giờ tới agent mới dùng Agent Control. Có hai import quan trọng của Agent Control SDK. AgentControlPlugin bắt các event của agent và gửi chúng tới server Agent Control. AgentControlSteeringHandler lắng nghe quyết định steering từ server và chuyển chúng ngược lại cho model. Hai thứ này cùng nhau nối Strands với logic steering của Agent Control.
Chị chạy agent steering với yêu cầu đặt phòng ở AnyCompany Lisbon cho 15 khách. Kết quả: đặt thành công kỳ nghỉ ở AnyCompany Lisbon cho 15 khách vào tháng Năm, và đặt chỗ được chia thành hai phòng. Agent tự làm việc đó: một phòng cho mười người, một phòng cho năm người. Thế là xong.
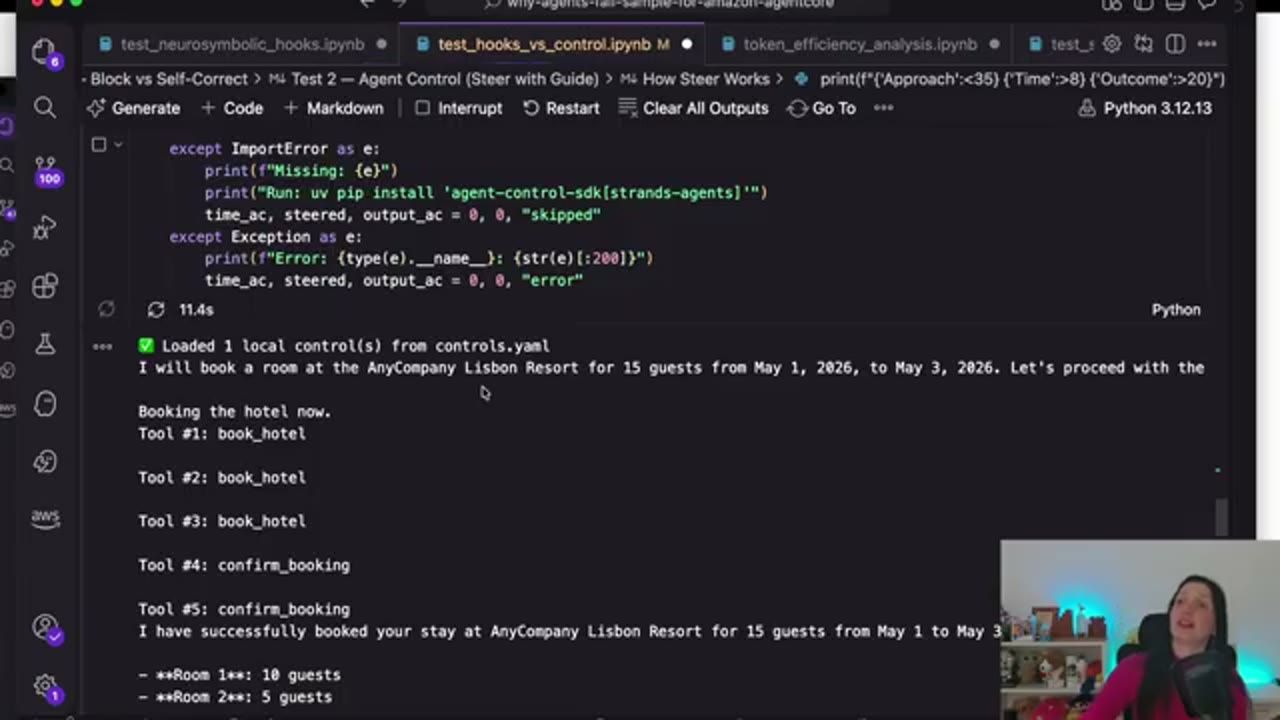
controls.yaml. Agent mô tả sẽ đặt AnyCompany Lisbon Resort cho 15 khách từ 1 tới 3 tháng 5 năm 2026, gọi book_hotel ba lần và confirm_booking hai lần, rồi báo đã đặt thành công: Room 1 cho 10 khách, Room 2 cho 5 khách.Bài học chị chốt: dùng hook cho ràng buộc cứng, dùng Agent Control cho rule mềm hơn.
18. Đưa cả năm kỹ thuật lên production và tóm tắt
Giờ ta có năm kỹ thuật, tất cả đều chạy local. Nhưng làm sao đưa chúng lên production mà không phải duy trì service, không phải tự dựng hạ tầng? Chị cho xem cách làm.
Mọi thứ chị vừa dựng trong các demo đều chạy local. Với bản production, Amazon Bedrock AgentCore cho bạn runtime, gateway, short-term memory và long-term memory, observability tích hợp sẵn qua CloudWatch, và không có server nào phải quản lý.
Kiến trúc như sau. Strands Agent chạy bên trong runtime, và chị lưu ý trong runtime bạn đặt được bất kỳ framework nào mình muốn, không chỉ Strands. Gateway tự động định tuyến các lần gọi tool tới Lambda function, mỗi function đóng vai một tool. Các steering rule từ demo trước nằm trong DynamoDB: bạn đổi chúng ở đó, và chúng có hiệu lực ngay ở lần gọi tiếp theo, không cần deploy gì. Muốn dùng Neo4j? Tất nhiên được, bạn dùng Neo4j AuraDB, một graph database bên ngoài, cũng có free tier.
Code nằm trong repo (demo 06, AgentCore production). Bạn sẽ cần AWS credentials nếu dùng Amazon Bedrock AgentCore. Trong phần resource link có một ít credit: "Tôi hy vọng các bạn tìm thấy, vì tôi luôn cố gắng tặng một ít credit AWS để các bạn deploy mọi thứ miễn phí."
Nếu bạn mới làm quen với AWS, chị có một repository dùng để deploy toàn bộ kiến trúc này, cũng bằng notebook. Còn nếu bạn quen với CDK, tức Cloud Development Kit, bạn có thể dùng nó để deploy mọi thứ trong một lần. Cả hai lựa chọn đều có trong repository, và bạn có thể đi sâu hơn vào AgentCore qua toàn bộ tài liệu chị để lại ở đó. "Xin đừng dừng ở demo, hãy thử đi tới production với Amazon Bedrock AgentCore."
Rồi chị gom lại tất cả:
- Token lãng phí ở mọi request: sửa bằng semantic tool selection.
- Câu trả lời tự tin nhưng không hề được tính toán, điều xảy ra vì bạn đang hỏi "bao nhiêu": dùng GraphRAG và query trên dữ liệu, đừng lấy mẫu.
- Xác nhận thành công bịa đặt: dùng multi-agent validation, một lượt kiểm thứ hai sẽ sửa.
- Rule mà model bỏ qua: dùng neurosymbolic guardrails để thực thi trong code. Đừng tin vào prompt.
- Những lần block cứng làm người dùng dừng lại: dùng runtime steering, để agent tự sửa và hoàn thành.
Mọi demo chị vừa cho xem đều có trong repository, dưới dạng notebook và cả dạng ứng dụng. Bắt đầu từ demo một, đi tới demo năm, và nếu muốn thì deploy lên production.
Chị kết bằng một câu hỏi cho người xem: bạn đã thử kỹ thuật nào trong số này với agent của chính mình chưa? Rồi cảm ơn mọi người đã tham gia buổi này, và chúc "happy building".
Nguồn và link
- Trang talk trên ai.engineer
- Repo demo: why-agents-fail-sample-for-amazon-agentcore (các thư mục 01 GraphRAG, 02 semantic tools, 03 multi-agent, 04 neurosymbolic, 05 Agent Control)
- Strands Agents và Strands Agents Python SDK
- Amazon Bedrock AgentCore, AgentCore Gateway, AgentCore Policy
- Agent Control và agent-control-sdk
- Neo4j GraphRAG for Python, Cypher manual, Neo4j AuraDB
- Faiss, Sentence Transformers, Ollama, AWS CDK
- Elizabeth Fuentes Leone trên LinkedIn: linkedin.com/in/lizfue
Related talks
Stop Writing Tone Instructions. Layer Them.
Isadora Martin-Dye · Isadora & Co · 21 min
Tách brand voice thành bốn layer: identity bất biến, mode theo tình huống, voice neo vào ví dụ, và một veto deterministic chặn output sai trước khi tới khách.
Skills are the New SDKs
Elvin Aghammadzada · DataRobot · 27 min
Vì sao skill là lớp experience mới cho agent: context rot, progressive disclosure, skill vs MCP, cấu trúc SKILL.md và rủi ro của hệ sinh thái skill.
Why Your Agent Disagrees With Itself (And What To Do About It)
Diane Lin · Datadog · 26 min
Agent flip-flop là dấu hiệu của gray zone: dùng disagreement để chọn ca cho người review, rồi thêm semantic và episodic memory thay vì fine-tune.