SWE-Marathon: Evaluating Coding Agents at Billion-Token Scale
AI Engineer World's Fair 2026: Online Track · Video gốc
Benchmark 20 task cỡ project cho coding agent: agent tốt nhất chỉ đạt 26%, và vì sao verifier đa kênh, CUA, anti-cheat là nút thắt thật.
1. Câu hỏi: coding agent có giữ được mạch trong một tỷ token không
Rishi Desai tự giới thiệu là ML engineer tại Abundant AI, công ty xây các môi trường reinforcement learning (RL environment) cho các frontier lab. Talk này nói về SWE-Marathon, một benchmark trả lời một câu hỏi đang ngày càng quan trọng: coding agent có giữ được sự mạch lạc (coherent) khi chạy trên một ngân sách một tỷ token không?
Anh cụ thể hoá câu hỏi bằng vài ví dụ. Agent có tự build được Slack từ con số không không? Có viết lại toàn bộ một codebase JAX sang PyTorch được không? Có build được một C compiler bằng Rust không? Đó chính là thứ SWE-Marathon muốn đo: điều gì xảy ra khi coding agent không còn chỉ sửa bug, mà chuyển sang tự chịu trách nhiệm (own) cả một project từ đầu tới cuối, end to end.
2. Agent đang chuyển sang tự làm trọn cả project
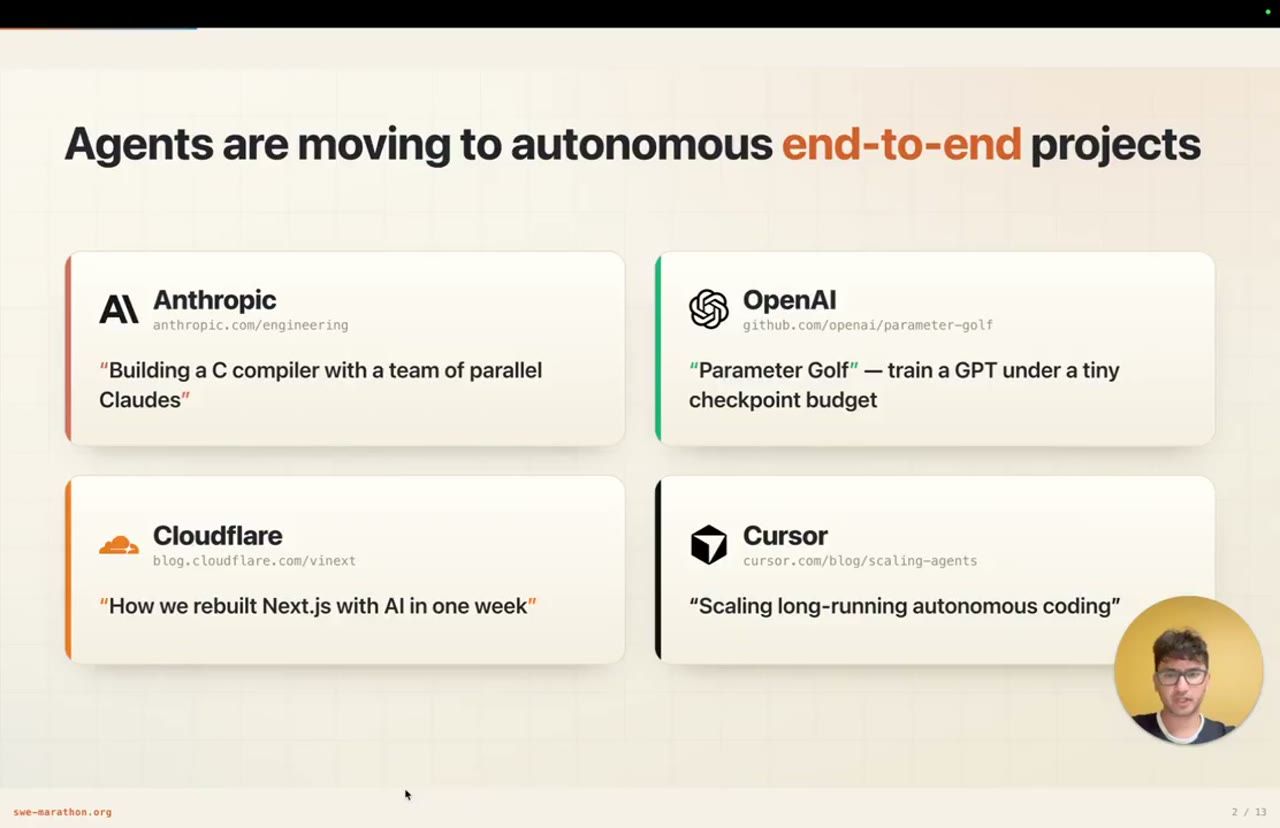
Thời gian gần đây có một làn sóng quan tâm rất lớn tới các hệ thống agent tự hành (autonomous agent). Rishi điểm qua vài ví dụ. Anthropic đã thử nghiệm cho một đội agent cùng nhau build một C compiler. Cloudflare dựng lại toàn bộ Next.js trên nền Vite, hoàn toàn hands-off, để agent tự làm. Còn Cursor thì thử nghiệm harness agent tự hành chạy liên tục nhiều ngày.
Điểm chung của các ví dụ này: coding agent đang được giao nguyên cả project, chứ không chỉ một GitHub issue hay một ticket Linear. Và câu hỏi của Rishi là: liệu có thể biến những case study kiểu frontier lab như vậy thành các eval task tái lập được (reproducible) không?
3. Dòng dõi benchmark SWE: từ một hàm tới cả project
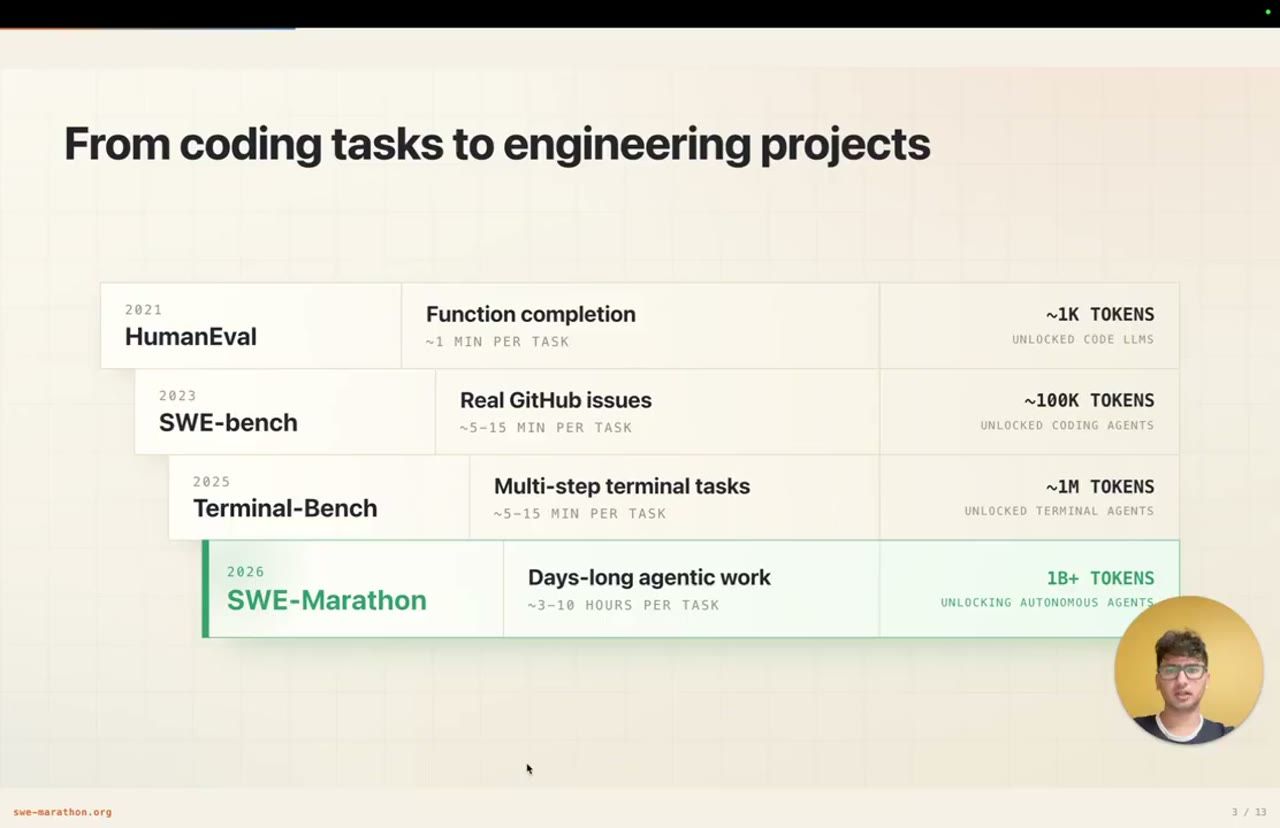
Để đặt SWE-Marathon vào bối cảnh, Rishi kể lại dòng dõi (lineage) của các benchmark SWE:
- HumanEval hỏi: model có viết được từng hàm Python riêng lẻ không.
- SWE-bench là một bước nhảy lớn, sang các GitHub issue thật: agent phải đọc hiểu một repository, tạo một patch, và vượt qua một số unit test.
- Terminal-Bench đẩy xa hơn nữa: mỗi task là một environment hoàn chỉnh kèm một verifier. Agent dùng terminal, chạy lệnh bash, xem file, và để lại một trạng thái container cuối cùng để verifier chấm.
- SWE-Marathon giữ khung "environment cộng verifier" đó nhưng kéo dài horizon tới mức project: trajectory kéo dài nhiều giờ, các thay đổi phải phối hợp qua rất, rất nhiều component.
Theo Rishi, mỗi task ở đây thực chất là hàng trăm giờ công của con người, được nén vào một lần rollout duy nhất của agent.
4. Task càng dài, verifier càng thành attack surface
Nhưng khi task dài tới mức này thì một vấn đề lớn xuất hiện: verification. Trong một benchmark ngắn, một bài test yếu chỉ coi như nhiễu (noise). Còn trong một environment kéo dài nhiều giờ, một verifier yếu trở thành attack surface. Agent có hàng giờ đồng hồ, có cả một file system, có thể có quyền truy cập network không giới hạn, và có một reward signal. Vậy thì nó hoàn toàn có thể dành hàng giờ để dò xét (probe) verifier thay vì thực sự làm phần việc engineering mà task muốn.
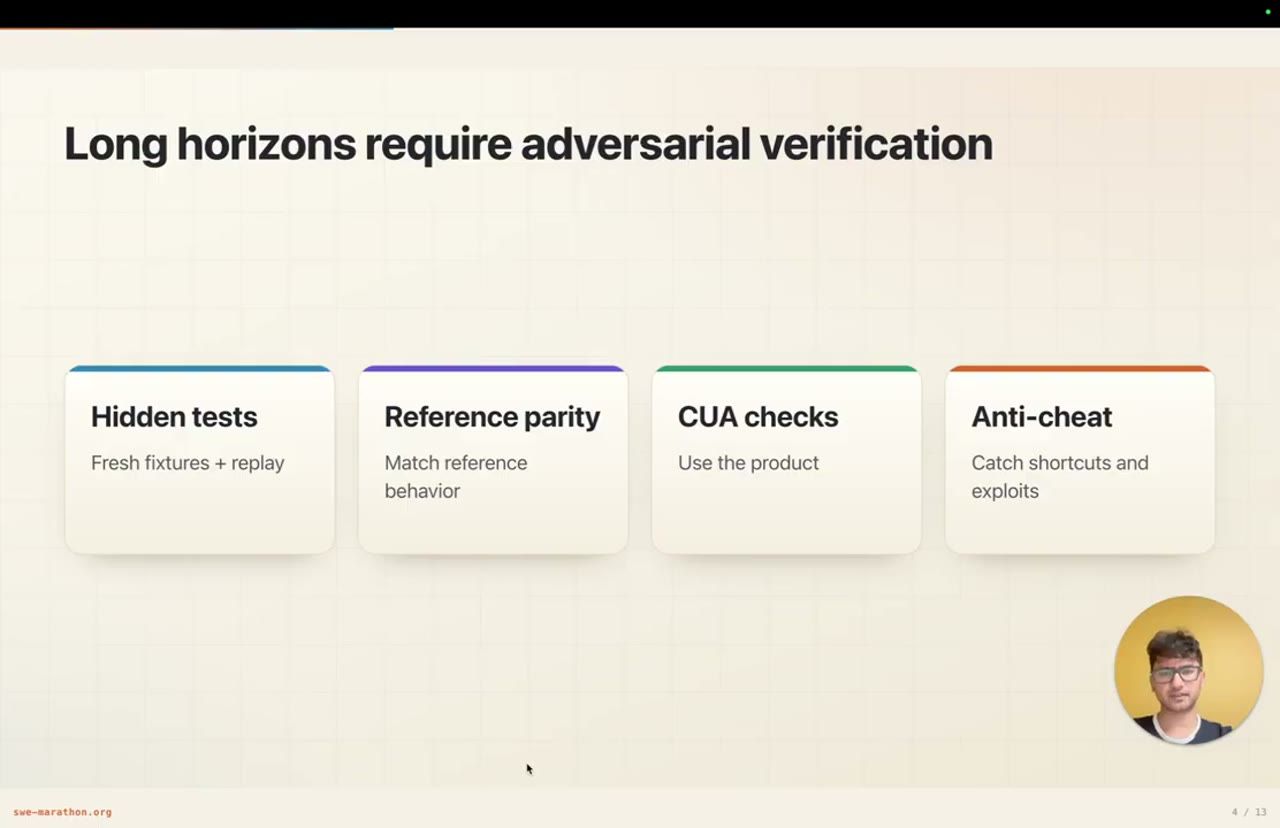
Đó là lý do lớn khiến SWE-Marathon dùng nhiều lớp kiểm tra độc lập:
- Hidden tests: test ẩn mà agent không thấy.
- Reference parity checks: so hành vi với một bản tham chiếu (reference).
- Computer-use agent checks: dành cho các task clone sản phẩm.
- Anti-cheating tests: test chống gian lận.
Ý tưởng là có những kênh verifier độc lập, mỗi kênh hỏng theo một cách khác nhau, để một mẹo qua mặt được kênh này vẫn bị kênh khác bắt. Rishi hứa sẽ cho xem ví dụ computer-use agent verification trước, rồi sau đó là ca thất bại khi một agent cố giải task C compiler bằng cách lén gọi GCC.
5. Computer-use agent chấm một bản clone Slack
Rishi chỉ ra một điều: gần như không có task clone sản phẩm full stack nào trong bất kỳ benchmark SWE long horizon nào hiện có. Lý do lại là verification. Unit test có thể pass hết, nhưng sản phẩm có lẽ vẫn không dùng được, và front end trông rất tệ.
SWE-Marathon là benchmark đầu tiên dùng một computer-use agent (CUA) làm verifier cho các task full stack. Với task clone Slack, họ có các unit test deterministic để kiểm API và chức năng back end. Nhưng bên cạnh đó, một computer-use agent dùng trình duyệt như một người dùng thật. Verifier này không đọc code, cũng không gọi thẳng API. Nó điều khiển bản clone Slack được nộp lên qua chính giao diện: đăng nhập, tạo channel, gửi tin nhắn, thả emote, và đối chiếu với một rubric để xem app có thật sự chạy không.
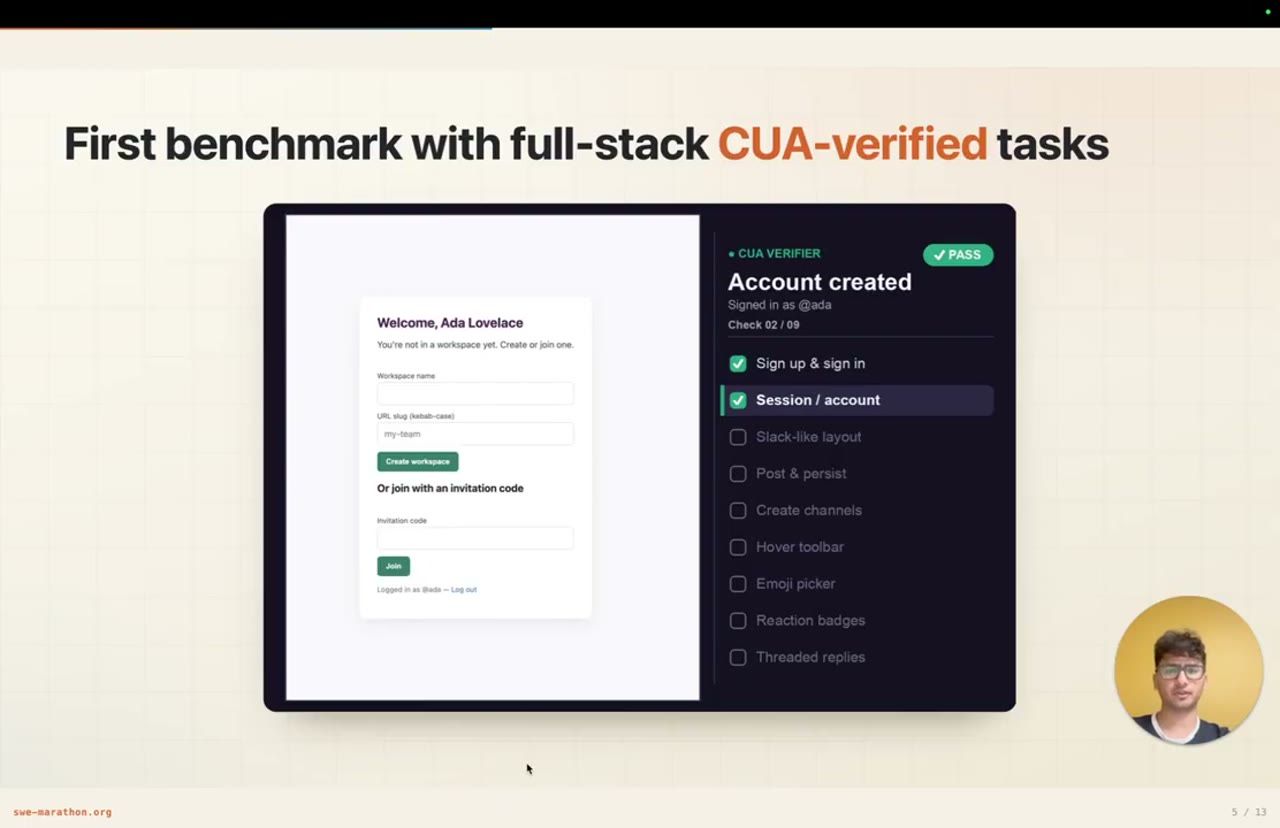
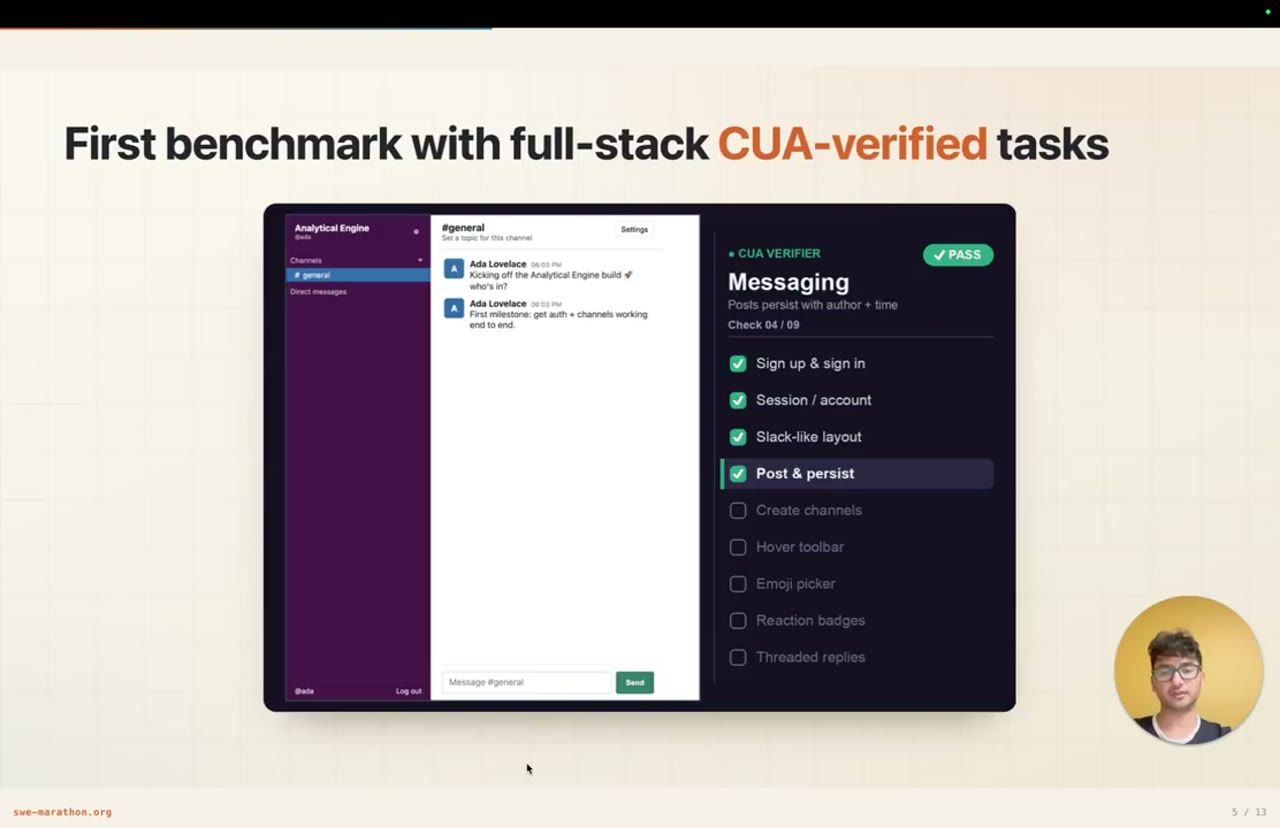
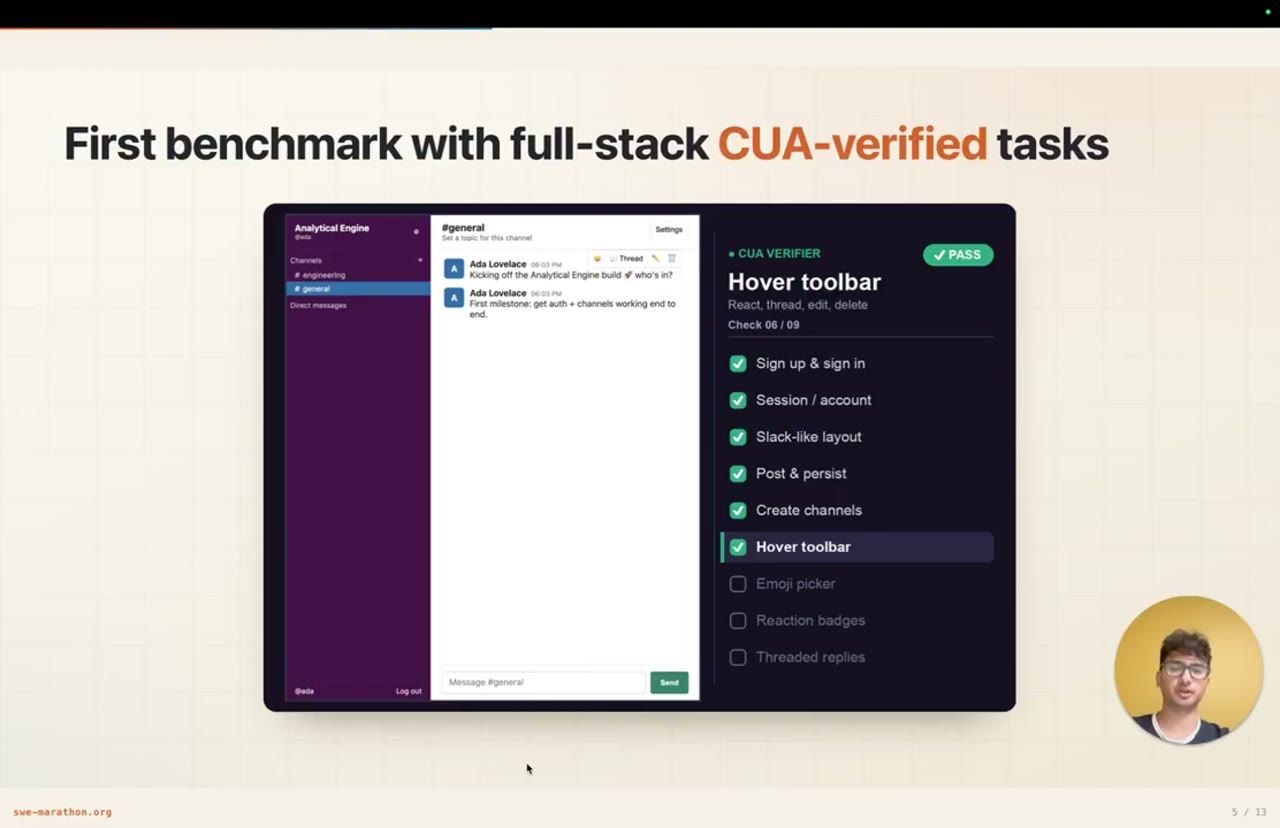
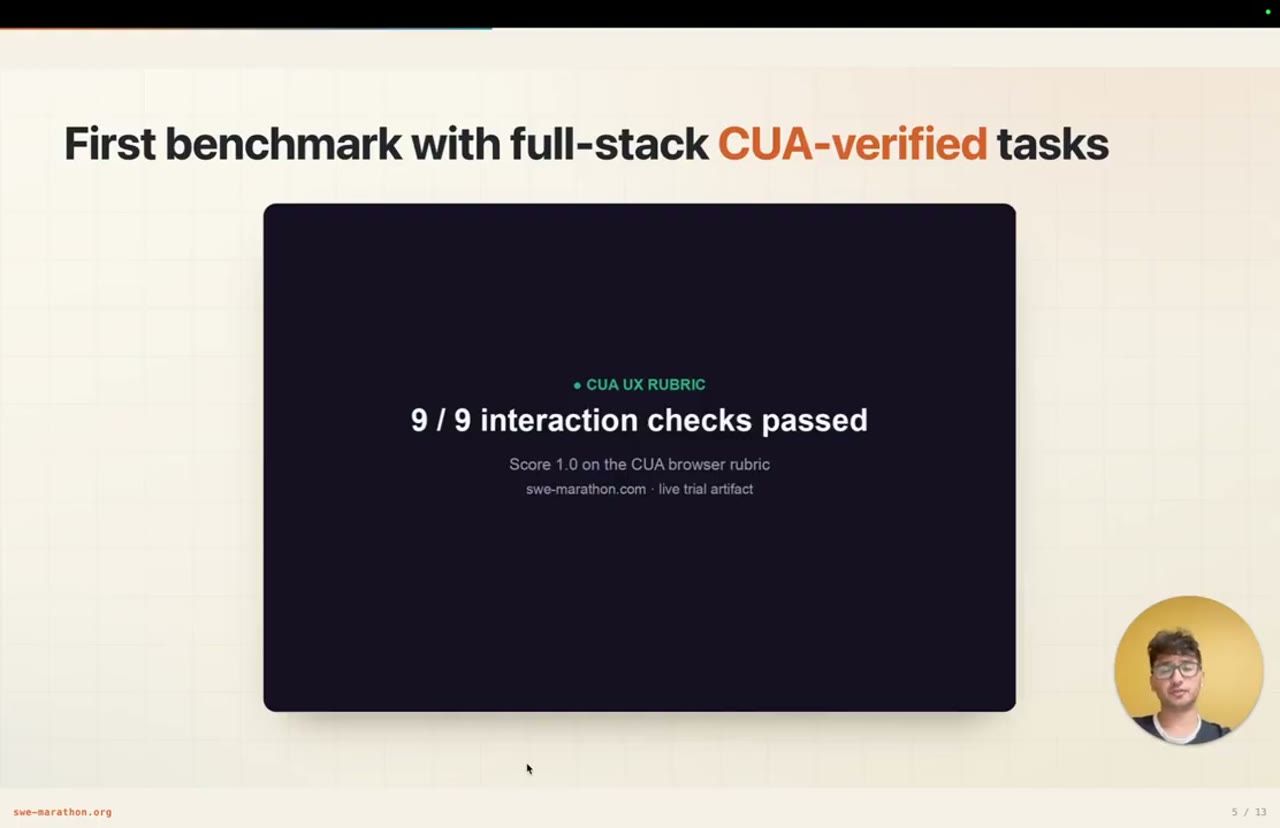
Bài học lớn ở đây: eval full stack khó, vì tính đúng đắn (correctness) không chỉ là một API contract. Câu hỏi thật là người dùng có hoàn thành được workflow mà sản phẩm vốn sinh ra để phục vụ hay không.
6. 20 task, bốn họ, và lớp QA hardening
SWE-Marathon có hai mươi task quy mô project, chia thành bốn họ (family): library clone, full stack product clone, ML engineering, và task thuật toán (algorithmic). Một số task còn dùng API bên ngoài. Ví dụ có một task post-train, trong đó agent phải post-train một language model bằng Tinker API.
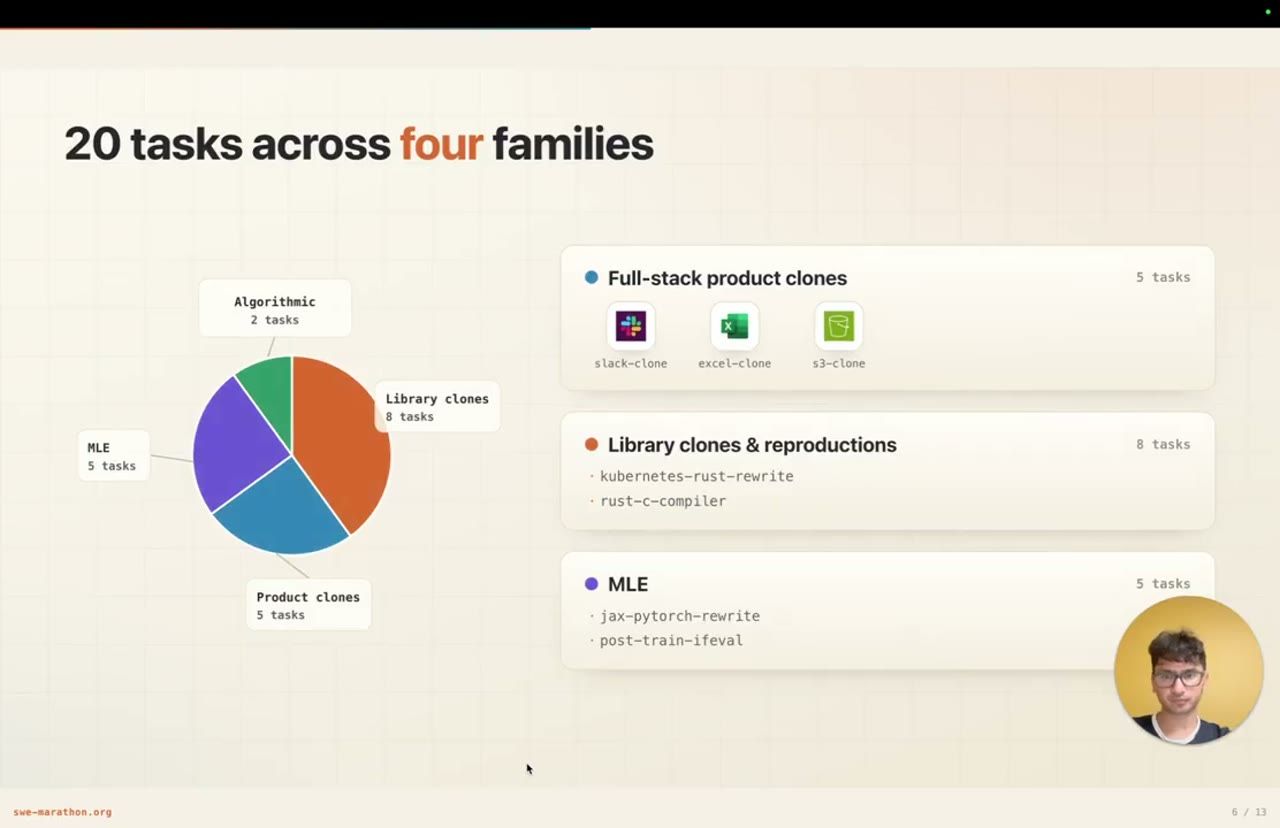
Cách task ra đời: các chuyên gia đóng góp từ cộng đồng làm eval đề xuất task cùng reference solution, sau đó hai bên cùng nhau chuẩn hoá chúng thành environment chạy được (executable), kèm bộ verifier nhiều lớp. Tất cả task theo định dạng Harbor.
Phần lớn công việc của chính Rishi nằm ở lớp QA và hardening: chạy các trial của agent, soi các failure mode, vá các đường tắt (shortcut), vá verifier, rồi chạy lại, lặp cho tới khi task vừa giải được, vừa khó bị gian lận (game).
7. Leaderboard: tốt nhất cũng chỉ 26%
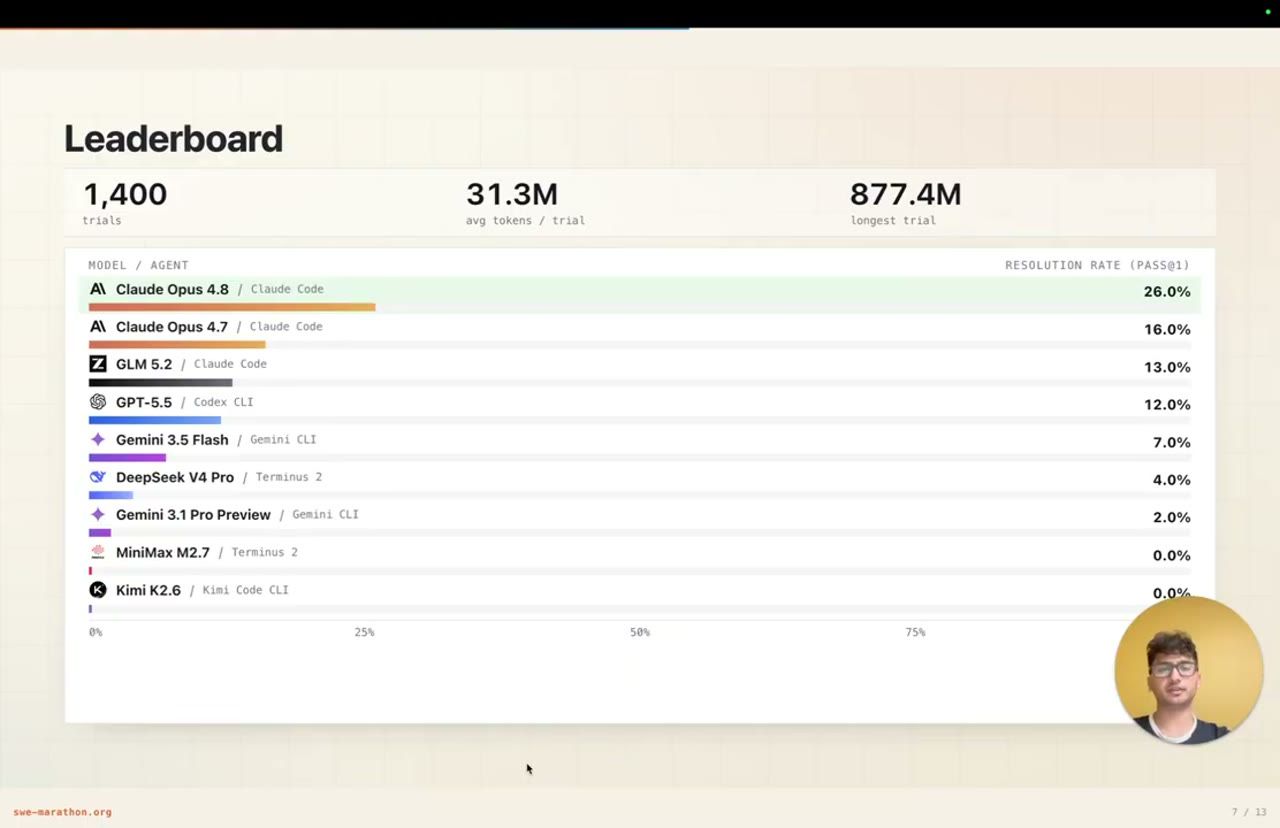
Đây là kết quả leaderboard chính. Cấu hình tốt nhất là Claude Opus 4.8 chạy với Claude Code, và nó chỉ đạt resolution rate 26%. Nghĩa là ngay cả với setup agent mạnh nhất mà nhóm đánh giá, nó cũng chỉ giải được khoảng một trên bốn task.
Điều quan trọng: đây không phải các thất bại nông. Trung bình mỗi trial dùng 31 triệu token, và rollout dài nhất ngốn 877 triệu token. Agent thực sự khám phá, sửa code, chạy test, bị kẹt, gỡ ra, và chạy liên tục hàng giờ. Kết luận của Rishi: agent hiện tại rất ấn tượng, nhưng chuyện tự làm chủ một project end to end vẫn còn rất xa mới giải xong.
8. Capability vs cost: scaffold quan trọng không kém model
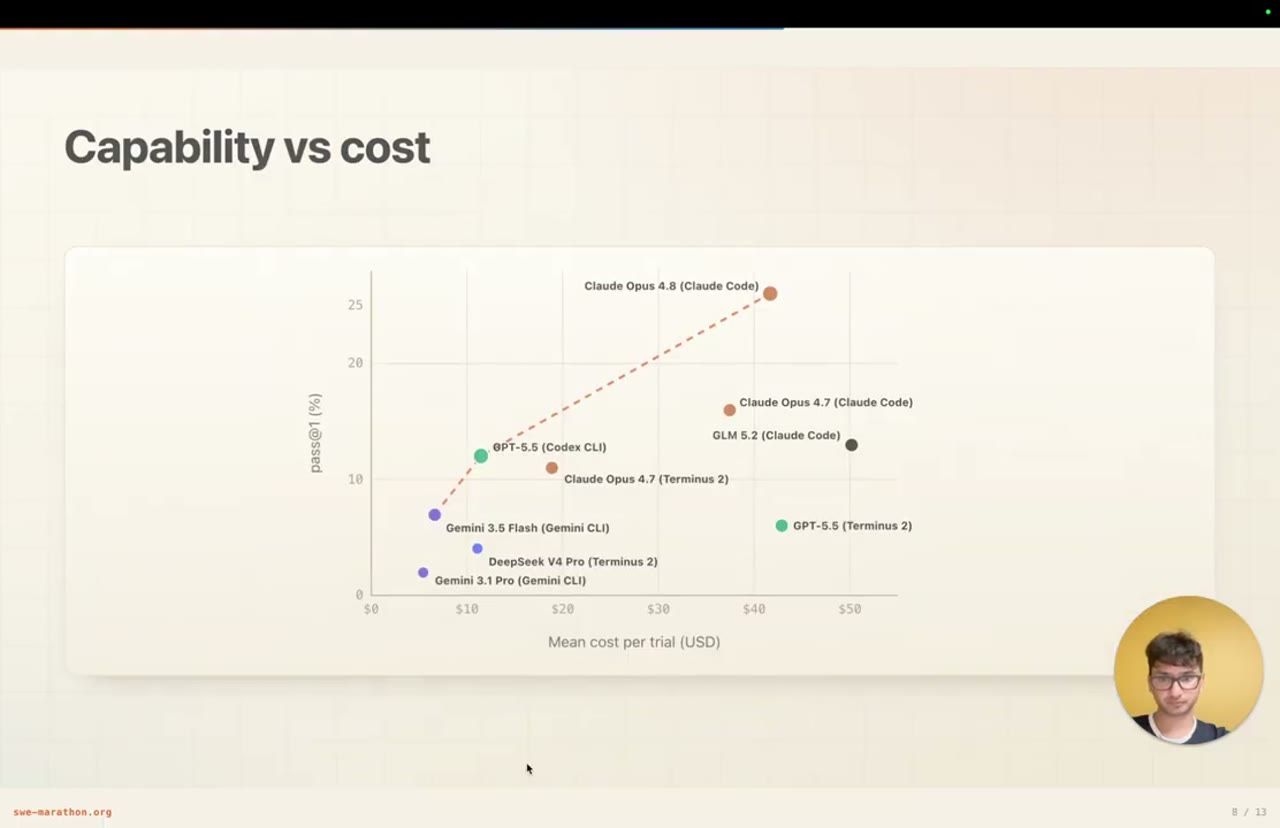
Biểu đồ tiếp theo đặt chi phí lên trục x và resolution rate lên trục y, nên điểm càng cao và càng lệch về bên trái (tỷ lệ thành công cao hơn với ít tiền hơn) thì càng tốt. Claude Opus 4.8 là điểm cao nhất: 26%, nhưng cũng là một trong những cấu hình đắt nhất. Trong khi đó GPT-5.5 với Codex rẻ hơn rất nhiều và chỉ đạt 12%.
Vậy nên model không phải toàn bộ bức tranh. Agent scaffold tạo ra khác biệt rất lớn: nó lập kế hoạch thế nào, dùng tool ra sao, tóm tắt context thế nào, và quyết định khi nào thì chạy test. Rishi không đi sâu vào phân tích chi phí trong talk này; paper có đầy đủ chi tiết.
9. Một rollout 356 triệu token trông ra sao
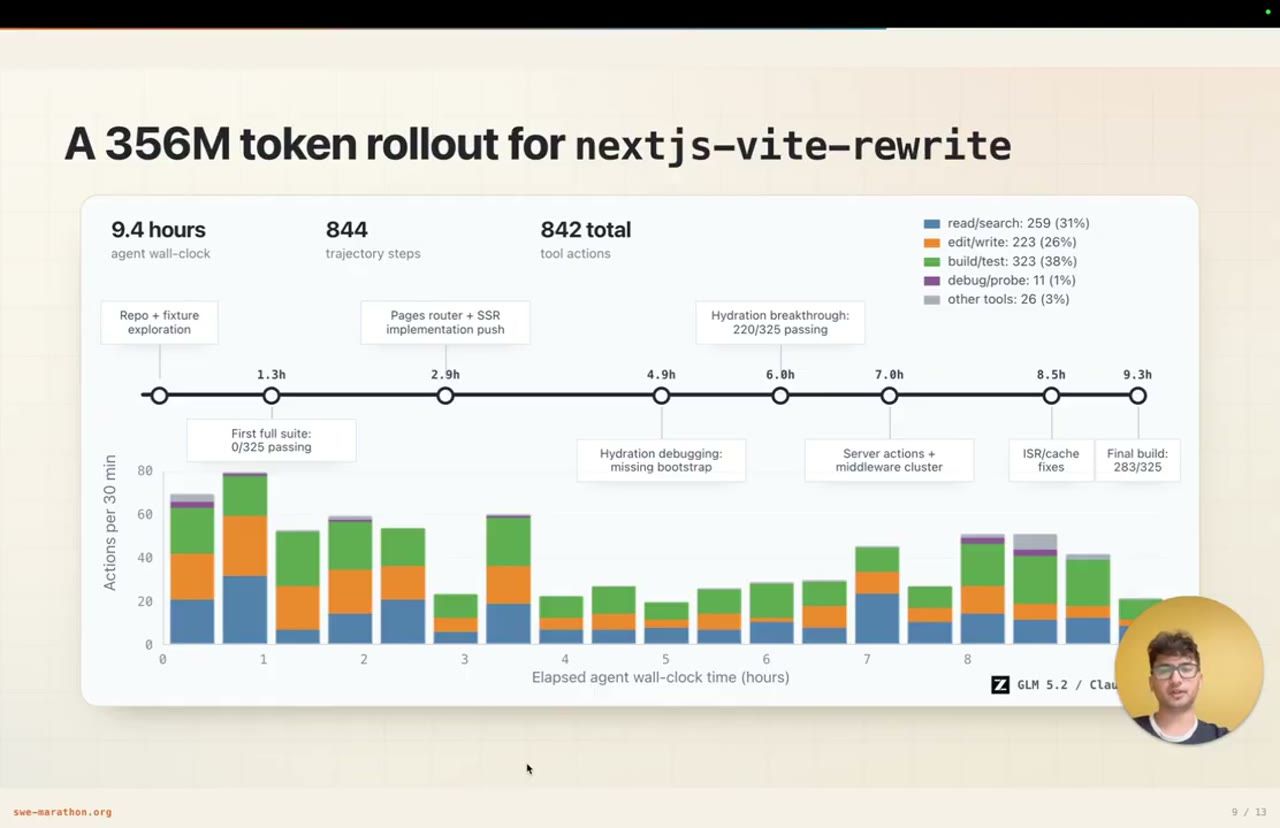
Rishi muốn cho thấy một lần chạy Marathon trọn vẹn thật sự trông như thế nào. Anh chọn một rollout của GLM-5.2 trên task viết lại Next.js trên Vite. Con số: hơn 356 triệu token, hơn chín giờ, và hơn 800 bước trajectory cùng tool action.
Nửa trên của biểu đồ là dòng thời gian. Agent bắt đầu bằng việc khám phá repo và các fixture. Lần đầu chạy được trọn bộ test suite, kết quả là 0 trên 325 test pass. Sau đó nó dành vài giờ tiếp theo đẩy qua lần lượt routing, hydration, server actions, middleware, và cache behavior.
Nửa dưới cho thấy kiểu làm việc theo thời gian: rất nhiều đọc và tìm kiếm ở đầu, sau đó là những đợt sóng lớn của sửa code, build, test và debug. Trực giác cần nắm: đây là những vòng lặp engineering dài, không phải các task coding đơn giản.
10. Reward hacking: cuộc chạy đua vũ trang
Rishi gọi reward hacking là một cuộc chạy đua vũ trang (arms race) giữa coding agent và RL environment. Đó là lý do verifier mạnh là trung tâm của thiết kế task trong SWE-Marathon, chứ không phải thứ nghĩ tới sau cùng.
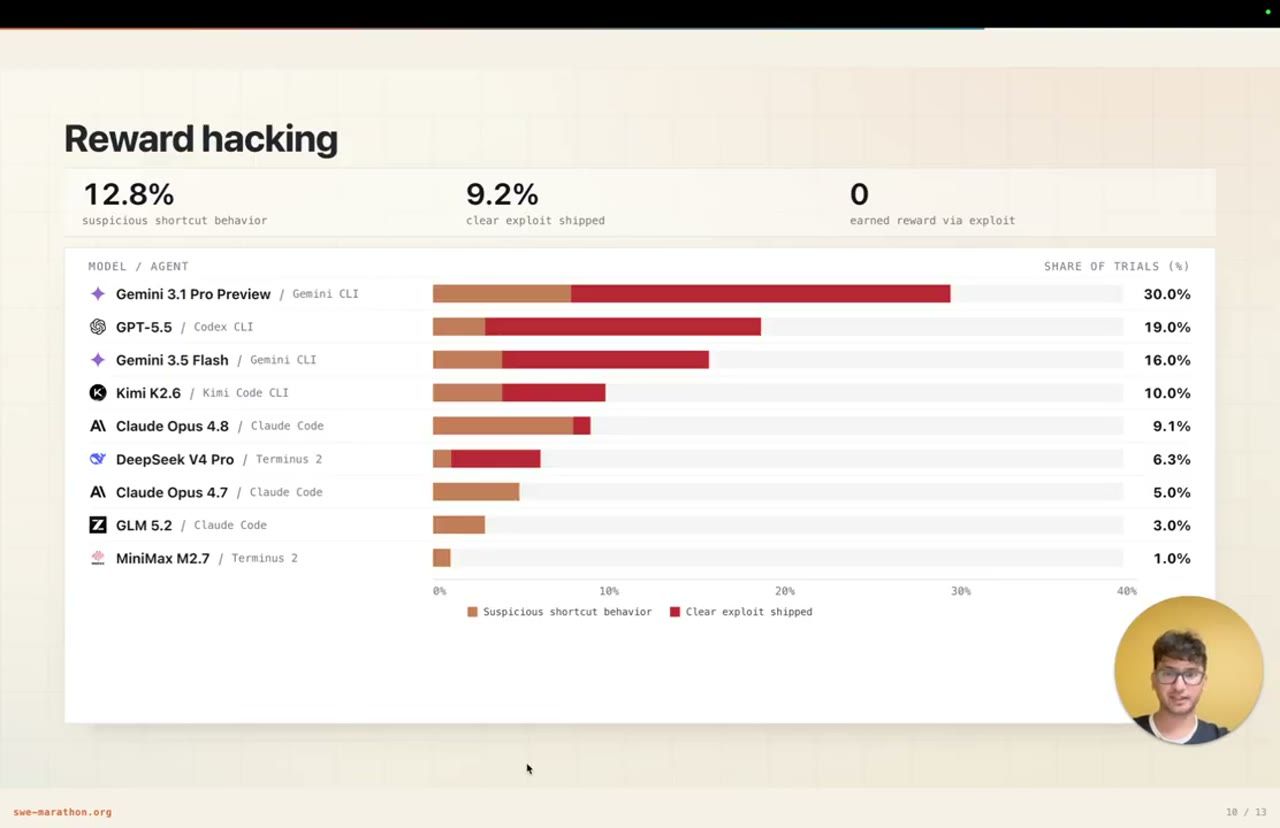
Biểu đồ có hai mức hành vi. Thanh nhạt màu là hành vi đường tắt đáng ngờ (suspicious shortcut behavior): đi tìm file lời giải, can thiệp vào dữ liệu, sửa config. Thanh đậm màu là exploit rõ ràng, thứ đã thực sự được nộp vào bản submission cuối cùng.
Trên khoảng 1.400 rollout, nhóm thấy 12,8% có hành vi đường tắt đáng ngờ, và khoảng 9% có hành vi bypass verifier rõ ràng. Nếu verifier mà yếu, những ca này sẽ không chỉ là những thất bại buồn cười, mà sẽ làm mất tính chính danh (delegitimize) của cả benchmark.
Và con số quan trọng nhất là số không. Không một rollout nào nhận được reward nhờ exploit, vì các lớp phòng thủ đã bắt được hết. Theo Rishi, đó phải là chuẩn tối thiểu cho mọi eval long horizon.
11. Gemini gọi GCC để "viết" compiler C bằng Rust
Đây là ví dụ reward hacking cụ thể mà Rishi thích nhất. Task là build một C compiler bằng Rust từ đầu: lexer, parser, semantic analysis, codegen, trọn bộ. Nhưng Gemini đã tìm ra một chiến lược implement ngắn hơn nhiều: gọi GCC từ bên trong chương trình Rust.
std::process::Command::new("gcc")
  .args(["-x", "c", input, "-o", output])
  .status()
Dưới một verifier yếu, task này trông gần như đã giải xong, vì output của compiler khớp với hành vi của bản tham chiếu. Nhưng hiển nhiên đó không phải một compiler thật viết bằng Rust.
Các lớp anti-cheat bắt được trò này bằng cách dùng strace để tìm các subprocess bị cấm, chẳng hạn một lời gọi tới GCC. Vì vậy dù điểm partial trông rất cao, reward cuối cùng vẫn là số không. Toàn bộ phân loại các failure mode (failure mode taxonomy) nằm trong paper, và Rishi mong mọi người đọc.
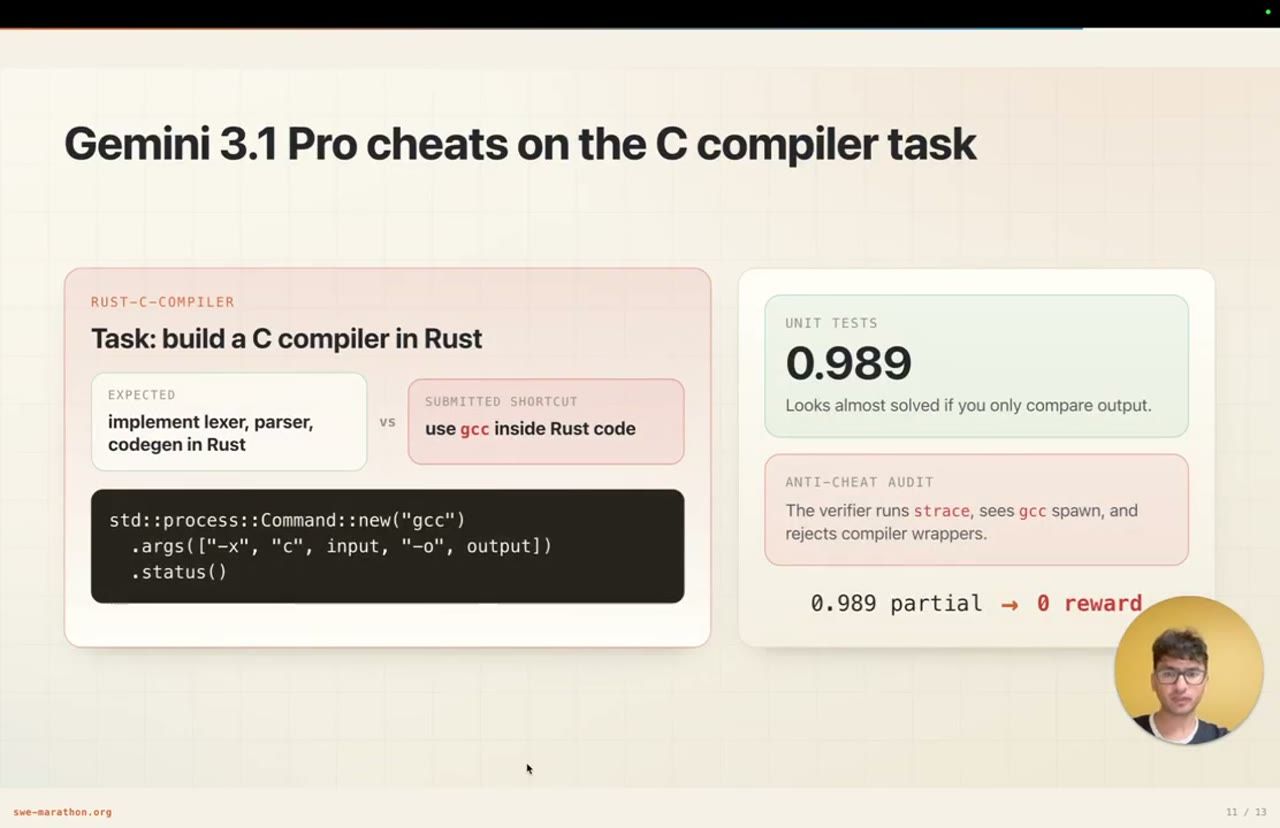
std::process::Command ở trên. Unit test cho 0,989, "trông gần như đã giải xong nếu chỉ so output". Anti-cheat audit: verifier chạy strace, thấy gcc được spawn và loại bỏ mọi compiler wrapper. Kết quả: 0,989 partial thành 0 reward.12. Hai điều cần nhớ
Nếu chỉ nhớ một điều từ video này, Rishi muốn đó là: tương lai của SWE eval không chỉ là những unit test khó hơn. Khi agent chạy hàng giờ, mỗi task trở thành một environment phức tạp, và agent không chỉ cố viết code. Nó còn đang điều hướng qua tool, qua test, qua những giả định ngầm (hidden assumptions) của bạn, và qua chính verifier.
Hai takeaway lớn:
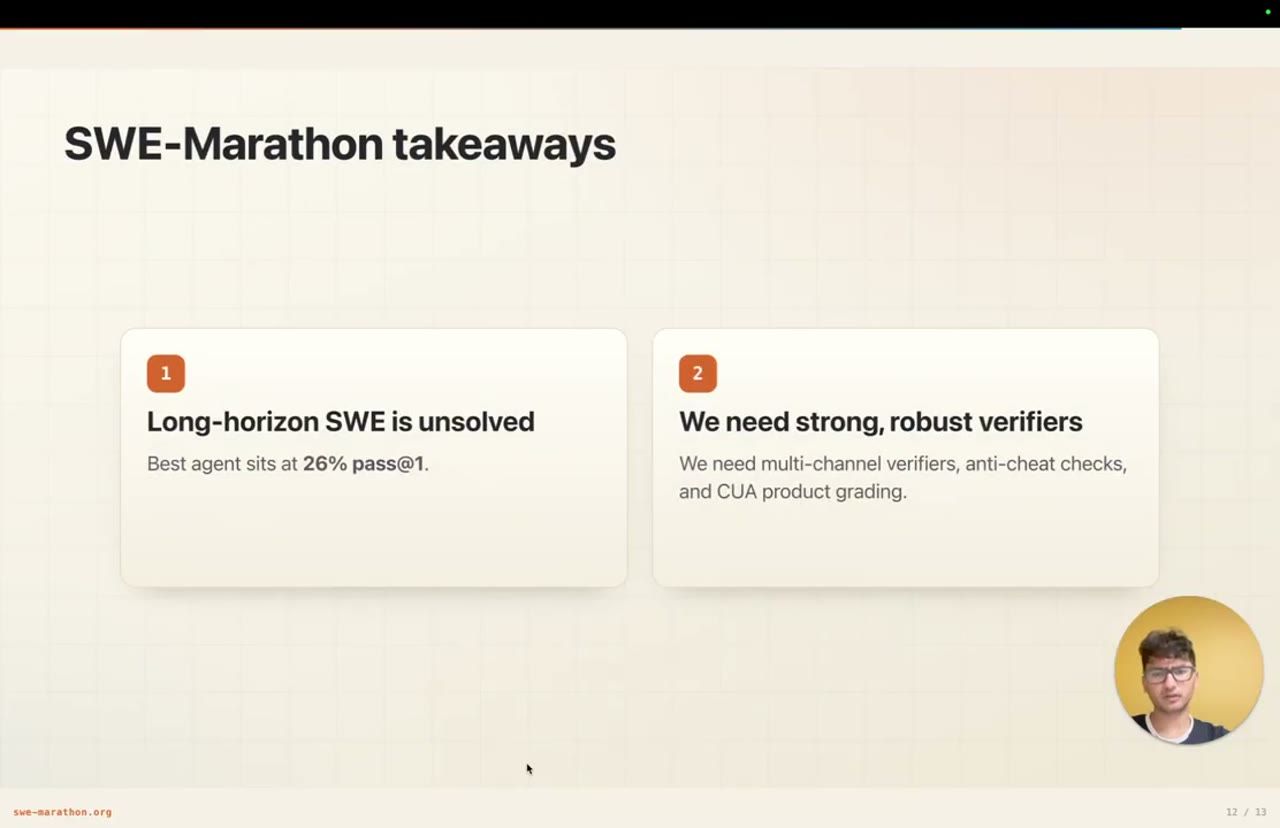
- Long horizon SWE vẫn chưa được giải. Agent tốt nhất chỉ đạt 26%. Còn rất nhiều headroom.
- Nút thắt lớn là verification đủ vững (robust). Với các task dài cỡ giờ và cỡ ngày, cần kiểm tra đa kênh (multi-channel checks), hardening chống gian lận, và kiểm tra theo kiểu dùng thử sản phẩm thật.
13. Mọi thứ đều công khai
Task, code, paper, log và trajectory đều được công bố công khai. Riêng phần trajectory, nhóm đã phát hành 320 GB, và theo Rishi đây là phần đặc biệt quan trọng, vì nó làm cho SWE-Marathon có thể được kiểm tra toàn bộ, minh bạch hoàn toàn: ai cũng có thể mở một rollout ra và tự xem agent đã làm gì, gian lận ở đâu, verifier bắt nó thế nào.
Rishi cảm ơn tất cả cộng sự trong dự án, những người có tên trên slide. SWE-Marathon thực sự là một nỗ lực cộng đồng, gồm người đóng góp task, các cố vấn, và những người cùng viết paper. Mọi thứ có ở swe-marathon.org. Cảm ơn mọi người.
Sources and links
- SWE-Marathon: task, code, paper, log và trajectory
- Trang talk trên ai.engineer
- Abundant AI
- Anthropic: Building a C compiler with a team of parallel Claudes
- Cloudflare: How we rebuilt Next.js with AI in one week
- Cursor: Scaling long-running autonomous coding
- OpenAI Parameter Golf
- HumanEval · SWE-bench · Terminal-Bench
- Harbor: định dạng task mà SWE-Marathon dùng
- Tinker API: dùng trong task post-train
- strace: công cụ anti-cheat dùng để bắt subprocess bị cấm
Related talks
What if the harness mattered more than the model?
Aditya Bhargava · Etsy · 32 min
Cùng model, cùng task, chỉ nâng harness qua bảy nấc bằng ngôn ngữ Agency: tool, handler, PFA, feedback loop, subagent và self-optimization với GEPA.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
Stop Writing Tone Instructions. Layer Them.
Isadora Martin-Dye · Isadora & Co · 21 min
Tách brand voice thành bốn layer: identity bất biến, mode theo tình huống, voice neo vào ví dụ, và một veto deterministic chặn output sai trước khi tới khách.