Test hệ thống multi-agent Google ADK: unit, trajectory, E2E và eval
Thêm unit, integration, trajectory, end-to-end test bằng Pytest và eval với golden dataset cho một hệ thống multi-agent Google ADK.
✓ Đã duyệt độc lập · cập nhật 01/11/2026 · 42 min
1. Hệ thống F1 Race Strategist và các tầng của testing pyramid
Imran Hussain chào mọi người. Hệ thống anh dùng trong bài này là một multi-agent AI system tên F1 Race Strategist, xây bằng Google ADK 2.0, đưa ra chiến thuật đua Formula 1. Việc của video đăng ngày 30/10/2026 là thêm test vào chính hệ thống agent đó.
Anh tập trung vào phần đáy của testing pyramid, gồm bốn tầng: unit test, integration test cho các agent, trajectory test cho luồng đi của agent, và end-to-end test. Sau đó, anh xem thêm phần eval (video đăng ngày 30/10/2026). Rồi anh bắt tay vào làm luôn.
2. Unit test đầu tiên: hàm analyse_tyre
Theo Imran (video đăng ngày 30/10/2026), unit test có mặt để test phần code deterministic. Anh mở code, cuộn xuống thư mục tests, vào thư mục unit. Trong đó đã có sẵn mấy file unit test, nhưng lúc này chúng chỉ là placeholder, nên anh sẽ làm lần lượt từng file một.
File đầu tiên là test cho tyre tool. Anh mở tyre tool tương ứng trong thư mục tools: ở đầu file có hàm analyse_tyre, nhận hai argument là compound (loại lốp) và tyre_age (số vòng lốp đã chạy). Hàm này có một kết quả mong đợi: nó trả về một object, và việc của test là assert các điều kiện trên object trả về đó (video đăng ngày 30/10/2026).
Để test hàm, anh định nghĩa test trước. Bước đầu tiên là đặt tên test: test_medium_tyre_with_18_laps_is_worn. Anh copy tên hàm và import hàm vào file test. Lời gọi hàm là một lốp medium với tyre age bằng 18. Nhưng ta còn muốn kiểm kết quả: result ở đây là object được trả về, và anh mở lại hàm để cho thấy object đó trông thế nào.
Đầu tiên anh muốn kiểm compound. Anh lấy key compound (viết dưới dạng một string) và assert nó bằng "medium". Theo anh, cái đó khá dễ. Nhưng anh cố tình đổi thành "low" trước để xem chuyện gì xảy ra. Lưu file, chạy, và kết quả báo một test failed, kèm lý do: mong đợi low nhưng giá trị thực là medium. Anh đổi lại thành medium, lưu, chạy lại, và test pass, kèm ba warning (demo trong video đăng ngày 30/10/2026).
Điều kiện tiếp theo là tyre age phải bằng 18 như mong đợi. Lưu và chạy lại, lần này báo một test failed. Vì sao? Thông báo lỗi là KeyError với key tyre age. Anh mở tyre tool ra xem: tham số tên là tyre age, nhưng trong object trả về thì key được gọi là age. Anh nói ta có thể kiểm ngay trong hàm như vậy. Anh sửa lại key, lưu, chạy, và test pass (demo trong video đăng ngày 30/10/2026).
Theo Imran (video đăng ngày 30/10/2026), unit test đơn giản chỉ có vậy: về cơ bản ta assert một kết quả bằng cách lấy key của object trả về, rồi bảo đảm nó bằng đáp án tương ứng. Ta biết hàm này deterministic: ta truyền vào medium, truyền vào 18.
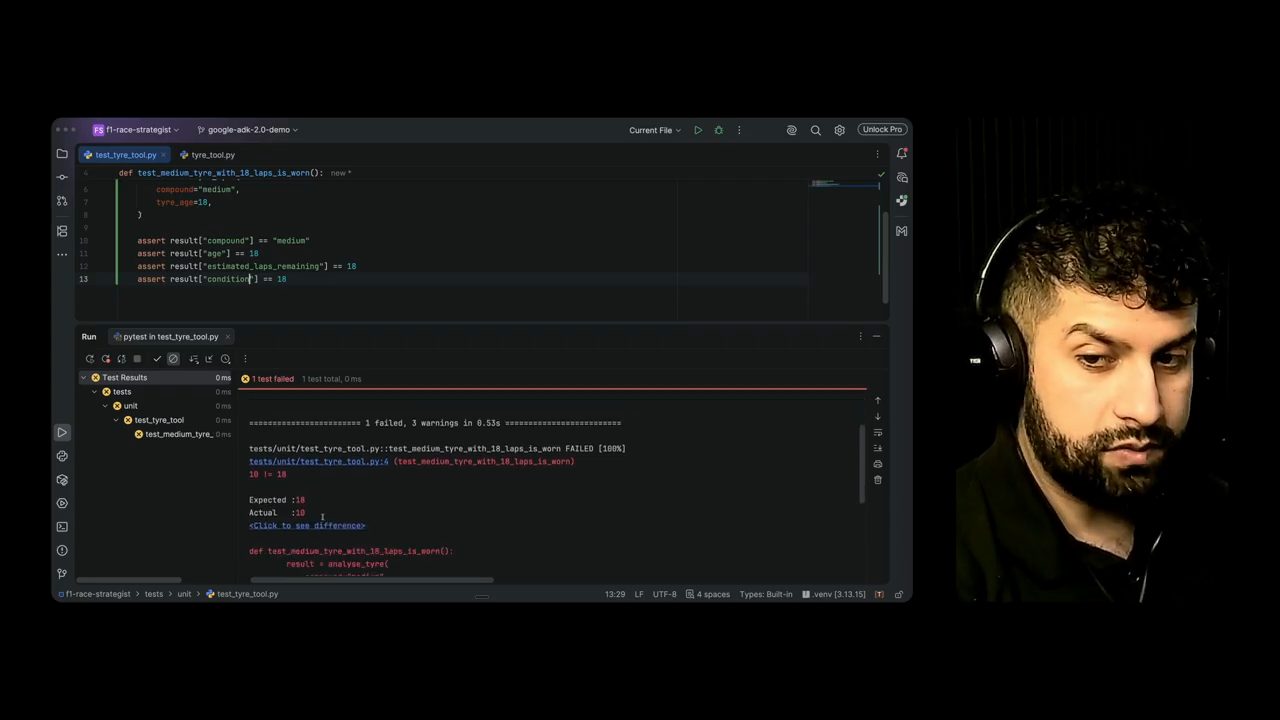
test_tyre_tool.py, dòng assert result["estimated_laps_remaining"] == 18 làm test fail. Bảng Run ghi "1 failed, 3 warnings", với "Expected :18" và "Actual :10" (demo trong video đăng ngày 30/10/2026).Nhưng anh còn muốn test số vòng còn lại: nó có thật sự là 18 không? Anh mở hàm ra kiểm. Lốp truyền vào là medium, nên expected life là 28. Tyre age truyền vào là 18. 28 trừ 18 bằng 10, nên anh mong đáp án là 10. Với life remaining như vậy, nó không nhỏ hơn hoặc bằng 8 mà lớn hơn, nên lốp sẽ ở trạng thái healthy (video đăng ngày 30/10/2026).
Code ban đầu viết hai dòng, một dòng cho estimated laps remaining và một dòng nữa cũng cho laps remaining, mà anh không nghĩ là đúng. Thứ anh muốn kiểm ở dòng thứ hai là condition. Anh giữ dòng estimated laps remaining với số 18 rồi lưu, và nói lần này test sẽ fail, vì 18 không phải kết quả. Bảng kết quả cho thấy sai khác thực tế: con số đúng là 10, như anh đã tính. Vậy là dòng đó sai, và anh nói Copilot đã sai ở đây (demo trong video đăng ngày 30/10/2026).
Dòng tiếp theo cũng không phải một con số mà phải là condition của lốp. Anh tạm ghi "low" để test fail, và nói rằng nhìn chung chính test sẽ cho ta biết đáp án. Chạy thử: một test failed với ba warning, expected là low nhưng actual là healthy. Anh mở lại hàm và chỉ ra nhánh else đã chạy, vì lốp đang healthy. Anh sửa lại, kiểm lần cuối và test pass (demo trong video đăng ngày 30/10/2026).
Theo Imran (video đăng ngày 30/10/2026), unit test chỉ đơn giản như vậy, và ta lặp lại chu trình này nhiều lần. Khi tool function được mở rộng và có thêm hàm mới, ta nên test từng hàm một và bảo đảm mọi trường hợp của chúng đều được tính tới.
3. Unhappy path: compound không tồn tại và soft tyre sắp hết
Trong hàm còn một nhánh nữa: nếu không tìm được maximum age thì trả về lỗi. Imran muốn kiểm cả nhánh này. Theo anh (video đăng ngày 30/10/2026), ta muốn test cả unhappy path: không chỉ trường hợp lốp medium với 18 vòng, mà cả lỗi khi maximum age (lấy từ compound) không có. Nếu compound không có ở đó thì chuyện gì xảy ra?
Anh tạo test mới test_unknown_tyre_with_12_laps_is_worn, với số vòng là 12 và compound là string "unknown", rồi xem kết quả thực tế. Anh lưu và chạy, nói trước rằng test sẽ fail, vì assert tyre age vẫn ghi 18 trong khi giá trị truyền vào là 12. Kết quả: một test failed và một test passed. Test fail báo KeyError, và đó chính là điều ta muốn kiểm: một input nhất định khiến hàm ném ra KeyError (demo trong video đăng ngày 30/10/2026).
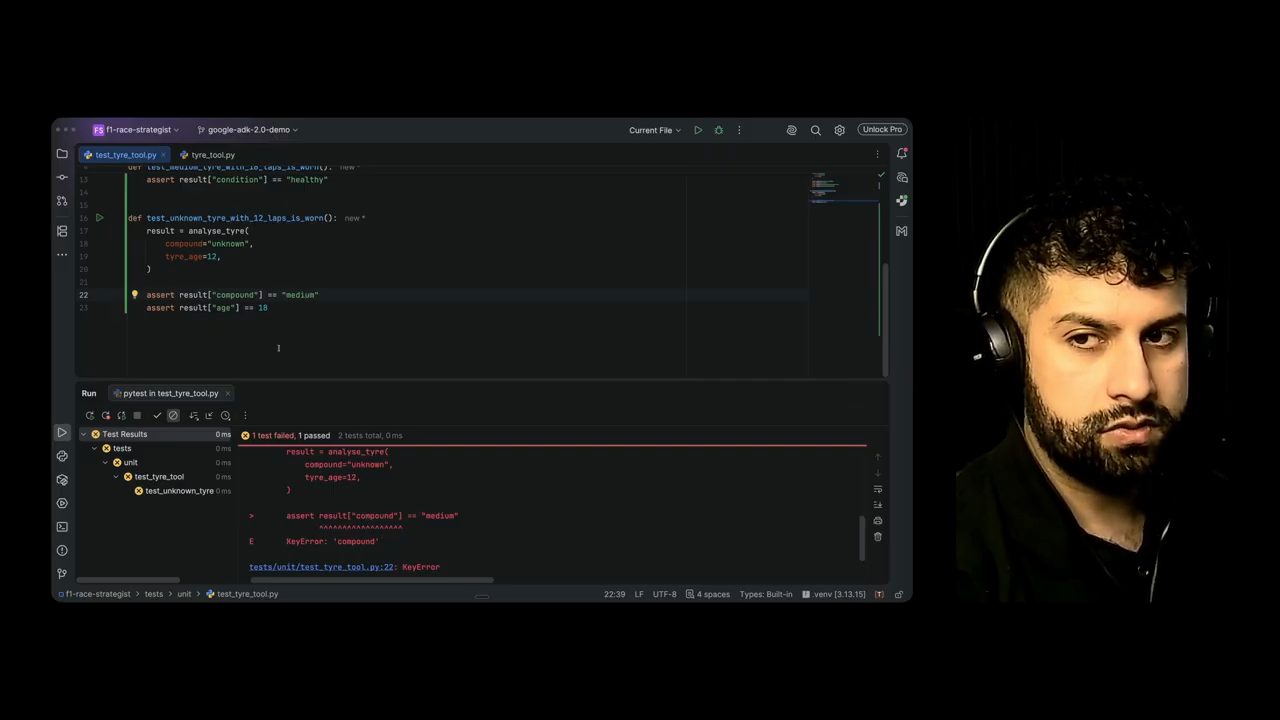
test_unknown_tyre_with_12_laps_is_worn gọi analyse_tyre với compound="unknown" và tyre_age=12. Bảng Run ghi "1 test failed, 1 passed", và dòng assert result["compound"] == "medium" ném KeyError: 'compound' (demo trong video đăng ngày 30/10/2026).Vậy test kiểm chuyện đó thế nào? Anh giữ argument là unknown, và để dòng assert nói rằng kết quả trả về medium, dù thực tế không phải. Chạy thử: một test fail, báo assert result["compound"] == "medium" nhưng gặp KeyError. Anh thử tiếp: assert kết quả bằng compound là unknown. Test vẫn fail, vì thứ thực sự được trả về là lỗi "Unknown tyre compound". Đó là thứ ta cần, và anh đối chiếu lại trong tyre tool: chuỗi lỗi ở đó đúng là "Unknown tyre compound" (demo trong video đăng ngày 30/10/2026).
Đó là unhappy path. Anh sửa, lưu, chạy, và bảng kết quả báo hai test passed với ba warning. Unit test đều pass, vậy là có cả happy path lẫn unhappy path (demo trong video đăng ngày 30/10/2026).
Anh dán thêm một test nữa "for good measure": test_old_soft_tyre_is_critical. Ta truyền vào lốp soft với tyre age 17, và condition phải là critical. Anh làm phép tính: theo hàm, lốp soft có life là 18, tyre age là 17, nên còn 1 vòng. Nếu số còn lại nhỏ hơn hoặc bằng 3 thì lốp ở trạng thái critical (video đăng ngày 30/10/2026).
Theo Imran (video đăng ngày 30/10/2026), unit test hoạt động như vậy: mọi thứ đều deterministic, nên tool, hay các hàm bên trong tool, phải chạy đúng như mong đợi. Thế là tyre tool đã được test xong.
4. Unit test cho weather tool ở Silverstone
Imran muốn test thêm weather tool "for good measure". Anh mở weather tool: output lấy từ forecasts.get(circuit.lower()), và hàm trả về lỗi nếu không có dữ liệu thời tiết cho trường đua đó. Theo anh, phần đó ổn (video đăng ngày 30/10/2026).
Thứ anh muốn test là thời tiết ở Silverstone. Anh vào tests/unit/test_weather_tool.py và dán test test_silverstone_weather: lấy weather forecast cho Silverstone bằng hàm get_weather_forecast của weather tool, truyền vào argument là trường đua, ở đây là silverstone. Kết quả mong đợi: rain probability là 72, rain expected in minutes là 20. Anh chỉ cho thấy hai key rain probability và rain expected in minutes nằm đúng trong dữ liệu của hàm (demo trong video đăng ngày 30/10/2026).
Anh làm tương tự với các key khác: dán thêm các key vào, một key là 24 (nhiệt độ mặt đường), key còn lại là 17, tức air temperature. Anh xoá phần thừa, lưu, rồi chạy test. Kết quả: một test passed, vẫn là ba warning đó. Theo anh, warning đó không sao, nó chỉ đến từ codebase (demo trong video đăng ngày 30/10/2026).
Theo Imran (video đăng ngày 30/10/2026), tới đây ta đã nắm cách làm deterministic testing trong code, thông qua unit test. Việc này khá dễ và đơn giản: ta chỉ cần một hàm với vài test bên trong, test happy path, unhappy path, edge case và những trường hợp khác. Bằng cách đó ta tạo ra một codebase vững, và unit test phủ mọi thứ ta định nghĩa.
Anh nói unit test đơn giản như vậy, và bước kế tiếp anh muốn xem là integration test (video đăng ngày 30/10/2026).
5. Integration test: ADK có chạy được app không
Imran nhắc lại: ở phần trước anh đã thêm unit test vào ứng dụng để test phần code deterministic. Giờ anh thêm integration test. Theo anh (video đăng ngày 30/10/2026), về cơ bản integration test đặt câu hỏi: ADK có chạy được ứng dụng của tôi không?
Trong thư mục integration có file test_agent.py. Anh mở nó và đóng các tab khác. Toàn bộ code trong đó là code mặc định có sẵn trong project ADK khi cài ADK (video đăng ngày 30/10/2026). Anh xoá mấy test cơ bản đi, nhưng giữ lại một test mà anh thấy là tốt: test_agent_module_wires_expected_symbols, kiểm tên của root agent và app.
Anh lưu và chạy: test fail, vì tên thật của root agent là race_director. Anh muốn kiểm lại cho chắc. Anh vào thư mục agents (ở đầu mỗi file có thể chọn agent nào), rồi tìm root agent: nó nằm ngoài thư mục agents, ở file agent.py cấp cao nhất. Ở đó, theo lời anh, root agent mang tên F1 Race Strategist, và cái đó ổn. Nhưng cuộn lên thì name lại khác: ở đây ta gọi nó là race director (demo trong video đăng ngày 30/10/2026).
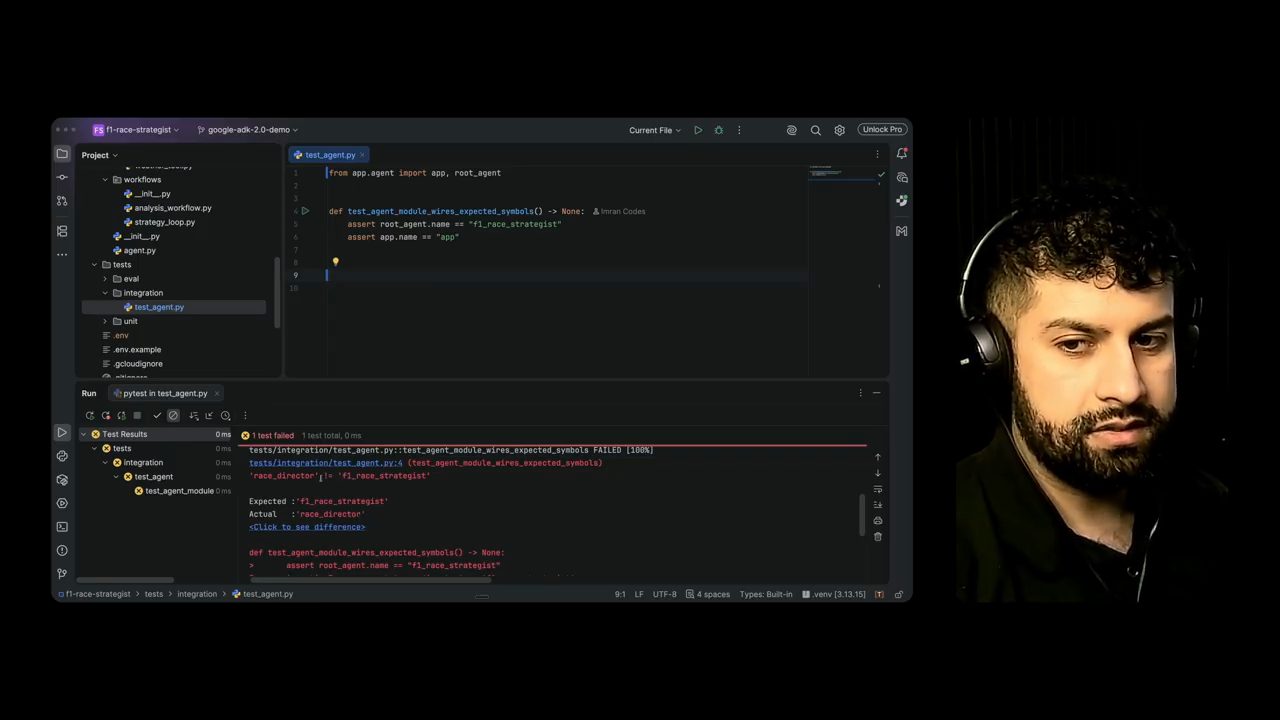
test_agent_module_wires_expected_symbols assert root_agent.name == "f1_race_strategist" và app.name == "app". Bảng Run báo fail với "Expected :'f1_race_strategist'" và "Actual :'race_director'" (demo trong video đăng ngày 30/10/2026).Theo anh, ta có thể cần đổi chỗ này: race strategist hay race director, gọi thế nào cũng được, giữ nguyên hay đổi đi cũng được, miễn là nhất quán. Tạm thời anh điền race_director vào, lưu, rồi chạy test xem có pass không (video đăng ngày 30/10/2026).
Test lại fail, lần này vì app name khác. Bảng kết quả hiện app name thật, anh copy nó, dán vào, lưu và chạy. Giờ integration test test_agent_module_wires_expected_symbols đã chạy được, và hiện đúng những thông tin ta định nghĩa trong test (demo trong video đăng ngày 30/10/2026).
6. Kiểm root agent, model và race strategy pipeline
Imran dán thêm vài test anh đã chuẩn bị, rồi đi qua từng test. Test đầu là test_root_agent_is_registered: root agent name là race director, và root agent model, theo lời anh đọc, là Gemini 3.5 Flash. Nhưng file test trong repo của anh (nhánh testing-and-evaluation, đọc ngày 01/11/2026) ghi gemini-3.8-flash. Anh lưu, chạy, và test pass (demo trong video đăng ngày 30/10/2026).
Tiếp theo là các workflow: ta muốn kiểm chúng đều chạy như mong đợi. Test này khá dài và làm vài việc. Root agent chuyển việc sang race strategy pipeline. Anh comment bớt mấy phần trước, và nói đây là nơi ta thêm và mở rộng integration test của mình (video đăng ngày 30/10/2026).
Phần đầu kiểm độ dài của root_agent.sub_agents, giá trị mong đợi là một. Ta có thể đối chiếu trong agent.py: root agent của ta có đúng một sub-agent. Anh cố tình thử với 3, lưu, chạy, và test fail. Vì sao? Kết quả báo thực tế là 1 chứ không phải 3. Anh đổi lại thành 1, con số đúng, vì chính ta đã tự xem rồi (demo trong video đăng ngày 30/10/2026).
Sau đó pipeline bằng root_agent.sub_agents[0], phần tử đầu tiên, ở đây là race strategy pipeline. Anh thử đổi tên mong đợi thành test pipeline để xem test báo gì. Test sẽ fail, và anh nói ta chỉ đang kiểm mọi thứ chạy như mong đợi. Bảng kết quả cho thấy tên thật bắt đầu bằng race (race strategy pipeline). Anh lưu và undo hết các thay đổi (demo trong video đăng ngày 30/10/2026).
Anh kiểm lại, test pass. Theo Imran (video đăng ngày 30/10/2026), giờ test đã chạy trên ứng dụng đã được lắp ráp, và kiểm cách các mảnh ghép lại với nhau. pipeline.name bằng race strategy pipeline, và theo anh điều đó có nghĩa là ta đang truyền đúng sub-agent vào root agent.
Test kế tiếp, anh bỏ comment ra: từ race strategy pipeline, ta có hai sub-agent là parallel analysis và strategy agent. Anh mở agent.py, vào race strategy pipeline, và cho thấy đây là một sequential agent: nó chạy parallel analysis rồi tới strategy review loop. Bằng cách đó ta kiểm cả thứ tự: cái đầu tiên là parallel analysis, rồi tới sub-agent kia (demo trong video đăng ngày 30/10/2026).
Anh chạy thử, và vài thứ xảy ra: một test failed. Vì sao? Bảng kết quả báo mong đợi strategy_specialist nhưng thực tế là strategy_review_loop: sub-agent thứ hai là strategy review loop. Anh mở file ra kiểm, và đúng là như vậy: parallel race analysis, rồi strategy review loop, cái mà anh nói ta đã đổi trước đó (demo trong video đăng ngày 30/10/2026). Theo Imran (video đăng ngày 30/10/2026), ta cũng muốn test rằng mọi thứ chạy như mong đợi, và bảo đảm integration test được áp lên cả các pipeline khi chạy chúng.
7. SequentialAgent, ParallelAgent và ba specialist
Mọi thứ đã ổn, nhưng Imran còn một sequential agent cần test. Anh thêm một assertion ở đầu: import SequentialAgent, rồi assert pipeline là instance của SequentialAgent. Dòng này kiểm đây đúng là một sequential agent. Anh cũng giữ dòng kiểm pipeline name là race strategy pipeline, và xoá một dòng khác vì nó bị trùng. Lưu lại: mọi thứ pass (demo trong video đăng ngày 30/10/2026).
Giờ anh đổi agent thành parallel agent để xem chuyện gì xảy ra. Test fail. Vì sao? AssertionError: assert False, với isinstance trả về false: thứ thực sự được trả về trong file là một SequentialAgent, đúng cái ta đang assert từ đầu. Anh đổi lại thành SequentialAgent như cũ (demo trong video đăng ngày 30/10/2026).
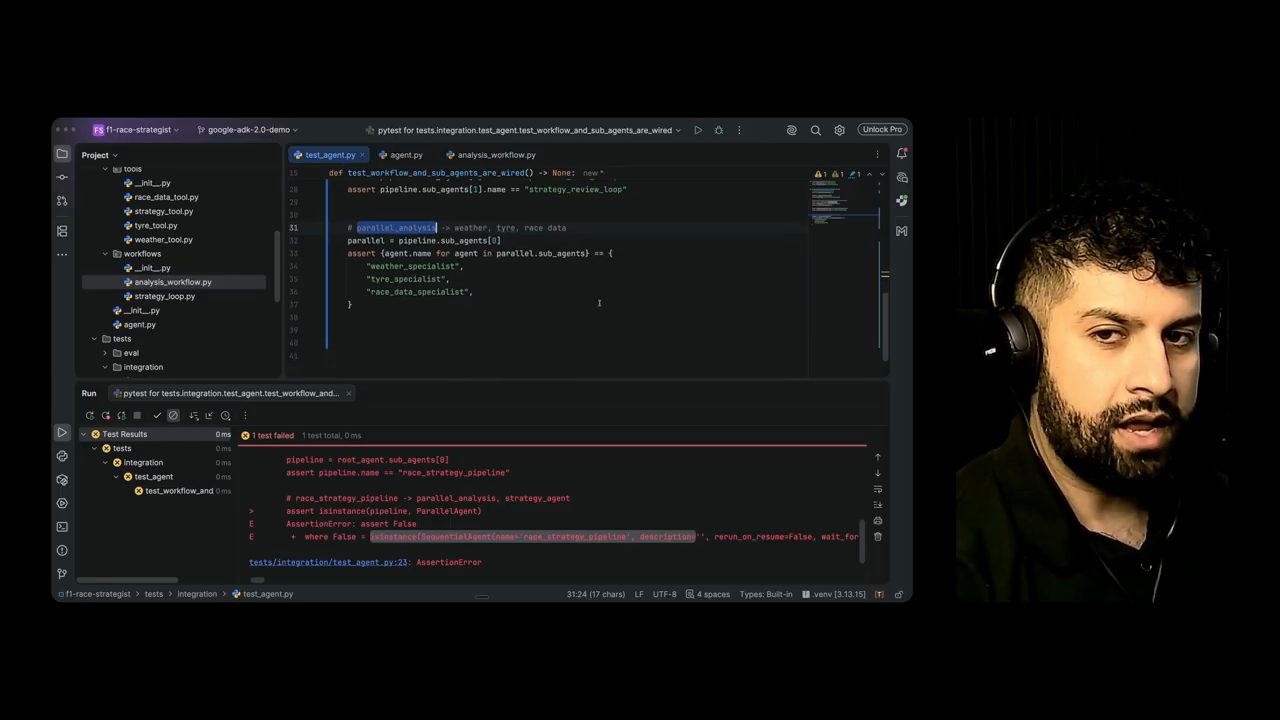
assert isinstance(pipeline, ParallelAgent), bảng Run báo AssertionError: assert False, và dòng bên dưới cho thấy object thật là SequentialAgent(name='race_strategy_pipeline', …). Trong editor, phần kiểm parallel = pipeline.sub_agents[0] với ba tên weather_specialist, tyre_specialist, race_data_specialist đã được bỏ comment (demo trong video đăng ngày 30/10/2026).Integration test cuối cùng: parallel = pipeline.sub_agents[0]. Ở trên ta đã test phần sequential, giờ ta muốn kiểm parallel analysis với weather, tyre và race data. Trong thư mục workflows, file analysis workflow có phần sequential (đã ổn), và ở đây có parallel analysis. Nó có ba sub-agent, đúng là ba cái ta định nghĩa trong test. Test assert tập tên agent, với mỗi agent trong danh sách đó, và ta muốn kiểm tất cả chạy như mong đợi. Ba agent này chạy song song, và ta đối chiếu được trong weather agent, tyre agent, race data agent (demo trong video đăng ngày 30/10/2026).
Anh lưu, chạy, và test pass (demo trong video đăng ngày 30/10/2026). Anh mở từng agent để đối chiếu tên: weather agent có tên weather specialist, tyre agent là tyre specialist, race data agent là race data specialist.
Thế là integration test xong. Theo Imran (video đăng ngày 30/10/2026), nhìn từ trên cao, với integration test ta test những thứ như: ứng dụng load được, root agent tồn tại, các sub-agent đã được đăng ký, các tool có sẵn, và runner chạy được. Đó là tất cả những gì liên quan tới integration test.
Anh nói còn hai loại test nữa là trajectory test và end-to-end test, và cuối cùng anh cũng sẽ xem phần eval. Bước tiếp theo là trajectory test.
8. Trajectory test: agent có đi đúng đường không
Imran điểm lại: ta đã xem unit test và integration test. Giờ tới trajectory test, và theo anh (video đăng ngày 30/10/2026), đây là chỗ ta thật sự đưa AI ra thử.
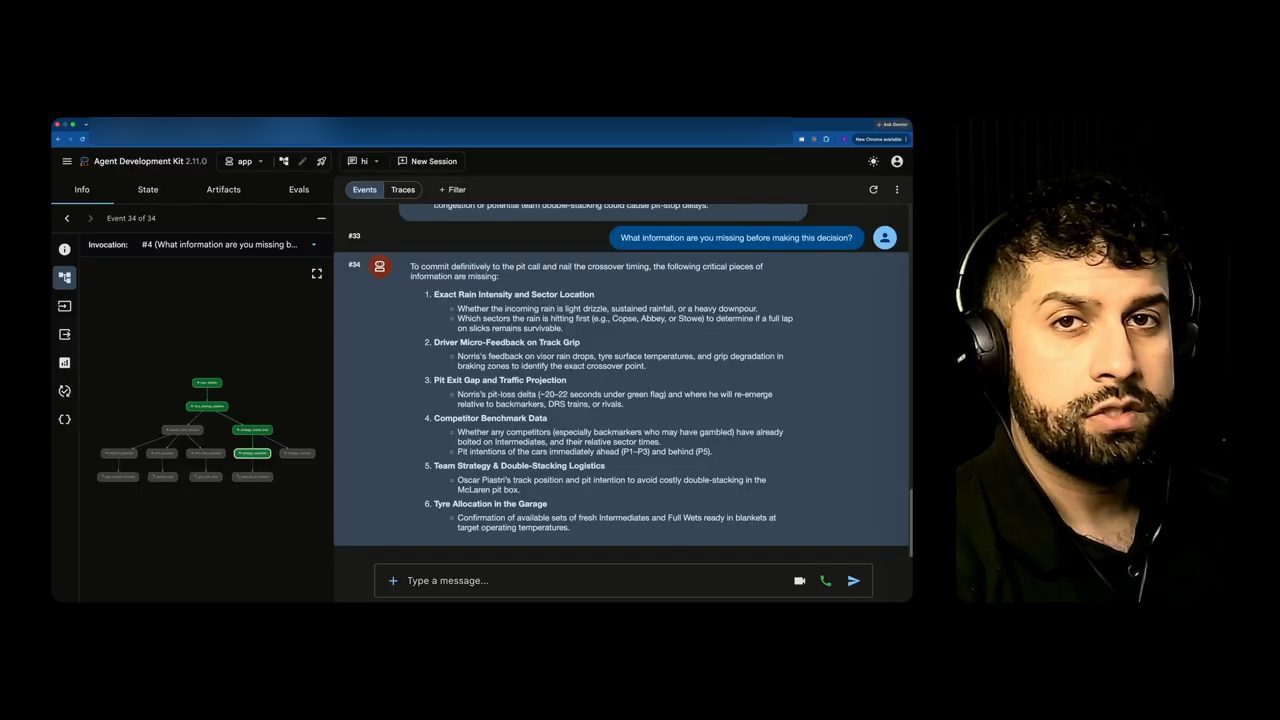
Giả sử anh hỏi một câu như "Norris nên cân nhắc vào pit sớm vì mưa đang tới". Đó là lúc LLM vào cuộc. Câu trả lời nghe rất ổn. Nhưng anh còn muốn test rằng mọi thứ bên trong chạy đúng: thật sự đã có chuyện gì xảy ra? Anh ghi vài ví dụ về trajectory mà anh muốn có (video đăng ngày 30/10/2026).
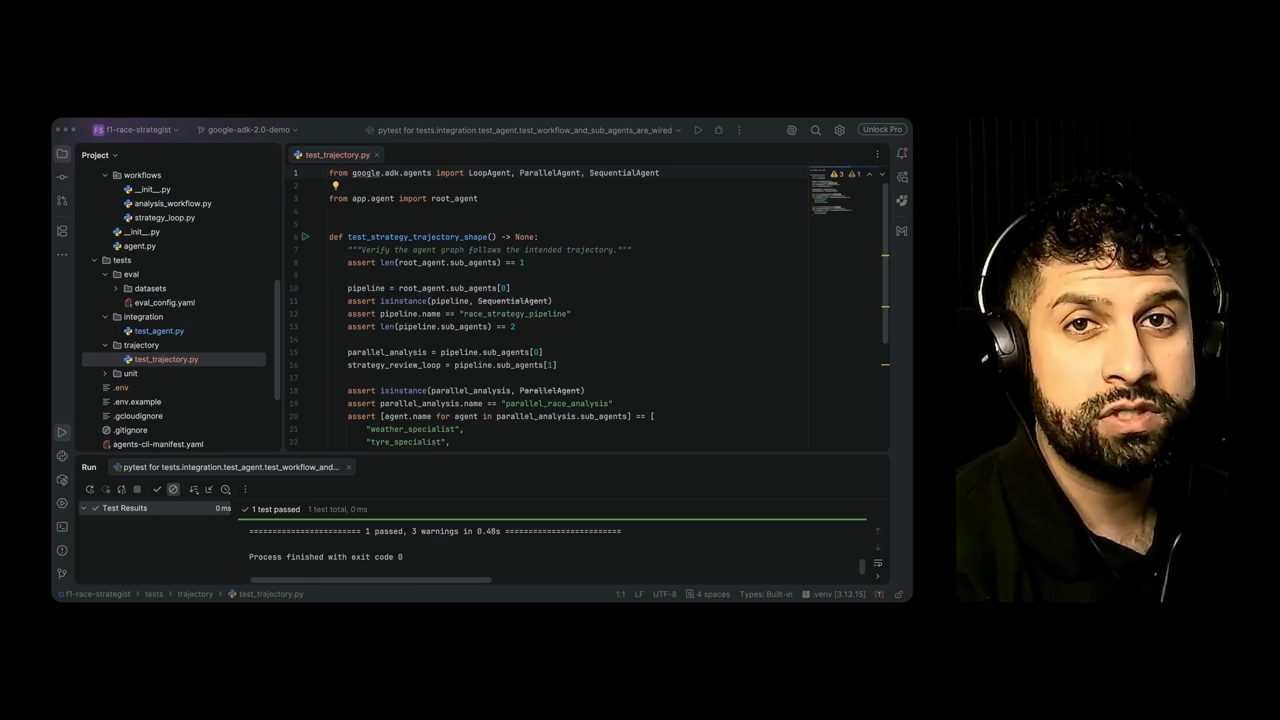
tests/trajectory/test_trajectory.py với test test_strategy_trajectory_shape, docstring "Verify the agent graph follows the intended trajectory.". Test assert root agent có một sub-agent, pipeline là SequentialAgent tên race_strategy_pipeline với hai sub-agent, và parallel analysis là ParallelAgent với các specialist. Bảng Run ghi "1 passed, 3 warnings" (demo trong video đăng ngày 30/10/2026).Ví dụ đầu tiên là một ví dụ xấu. Người dùng đi thẳng tới strategy agent. Nó đoán: chọn bất kỳ sub-agent nào, rồi đưa ra câu trả lời. Theo Imran (video đăng ngày 30/10/2026), đó thật ra là một trajectory xấu.
Trajectory mong đợi mà ta cần trông giống thế này: người dùng tới race director, rồi tới race data, weather, tyres, strategy, rồi tới câu trả lời. Theo anh (video đăng ngày 30/10/2026), đó là sức mạnh của trajectory test, và khác biệt then chốt là: ta không chỉ nhận câu trả lời, với câu hỏi "tôi có được một câu trả lời tốt không". Ta còn muốn test "agent có đi đúng đường không", có đúng trajectory trong trường hợp này không. Đó là thứ ta muốn test.
9. Eval toolkit trong ADK web: eval set, eval case và Run evaluation
Theo Imran (video đăng ngày 30/10/2026), ta cũng kiểm được chuyện này bằng eval toolkit trong ADK. Anh vào giao diện ADK: ở một phiên đang có câu trả lời của hệ thống. Anh mở tab Evals, tạo một evaluation mới. Anh đặt tên eval set là eval set one, và nói ta có thể đặt tên nào có nghĩa hơn.
Rồi ta chỉ cần thêm một session để bắt đầu. Anh chọn From Current Session, với một tên eval case, rồi bấm Create. Khi chọn eval case đó, giao diện ghi chưa có lần chạy nào cho case này, nên anh quay lại và chạy nó (demo trong video đăng ngày 30/10/2026).
Ở đây có nút Run evaluation. Có chế độ Live, nơi ta đặt input modality là giọng nói và các tuỳ chọn khác, nhưng anh không muốn dùng nó. Anh chỉ muốn chạy chế độ Standard. Mô tả của chế độ này là đánh giá mỗi turn như một request và response đơn lẻ. Theo Imran (video đăng ngày 30/10/2026), threshold có thể đặt tới 1, mức cao nhất, nhưng lần này anh đặt 0.8, và threshold cho response match là 0.7.
Anh chạy, và giao diện báo eval module chưa được cài. Anh bấm OK. Theo Imran (video đăng ngày 30/10/2026), trong code ta chỉ cần cài gói này, việc khá dễ. Anh copy lệnh cài vào code, và vì project dùng uv, anh nói lệnh anh dùng là uv add cho gói eval của google-adk. Anh chờ cài xong rồi quay lại.
Sau khi cài, IDE báo "updating skeletons": theo anh, đó là bước cập nhật mọi thứ theo lệnh ta vừa dùng, và cập nhật Python interpreter. Quay lại, anh bấm OK và chạy lại, và lần này có chuyện xảy ra. Vì ADK evaluation đã được cài, giao diện đã khác: có thêm nhiều tuỳ chọn (demo trong video đăng ngày 30/10/2026).
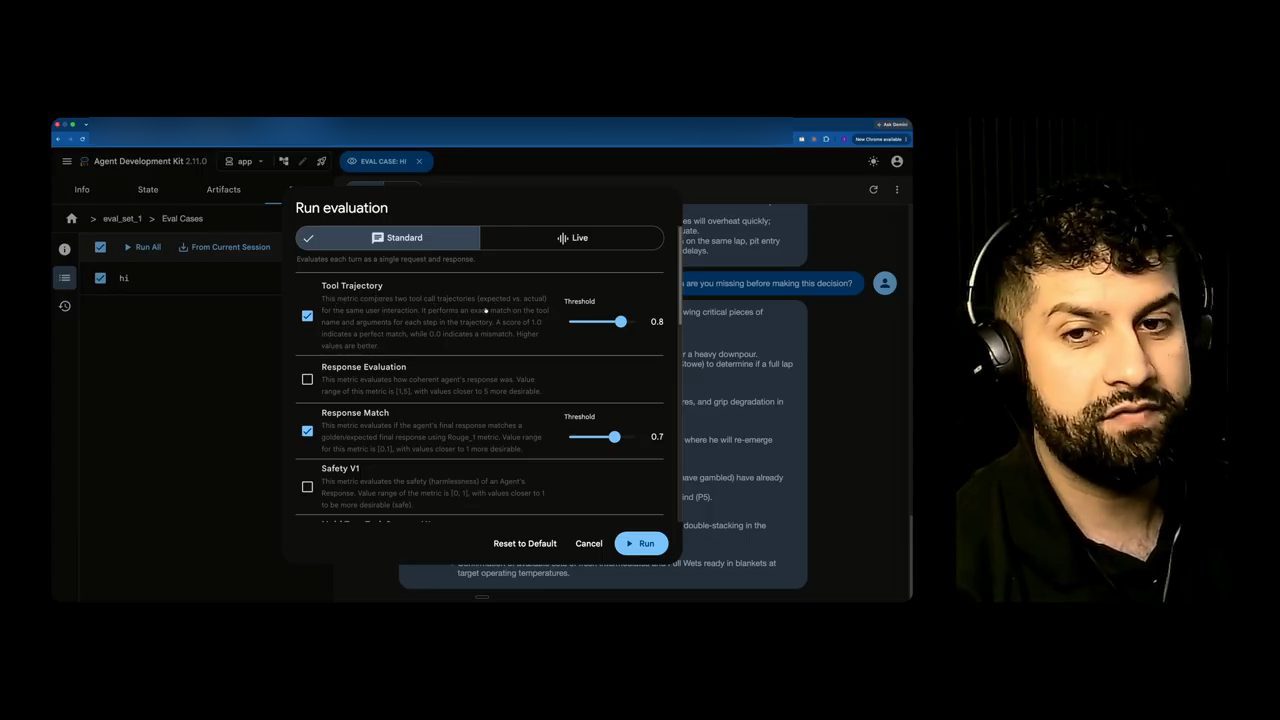
Anh cuộn qua từng metric. Imran đọc mô tả của Tool Trajectory trên màn hình (video đăng ngày 30/10/2026): metric này so sánh hai tool call trajectory, mong đợi và thực tế, cho cùng một tương tác của người dùng. Nó so khớp chính xác tên tool và argument ở mỗi bước trong trajectory. Điểm 1.0 là khớp hoàn toàn, 0.0 là không khớp, giá trị càng cao càng tốt. Anh đặt threshold của nó là 0.9, làm ví dụ.
Rồi tới Response Match. Anh nói ai đang làm theo có thể tự đọc các mô tả này. Mô tả mà Imran đọc trên màn hình (video đăng ngày 30/10/2026): metric này đánh giá câu trả lời cuối cùng của agent có khớp với một câu trả lời golden, tức câu trả lời cuối cùng mong đợi, hay không, bằng metric ROUGE-1. Khoảng giá trị là từ 0 tới 1, càng gần 1 càng tốt. Danh sách còn các tuỳ chọn khác, như Safety V1, Multi Turn Task Success V1 và Multi Turn Trajectory Quality V1, nhưng anh chạy luôn để xem kết quả.
Theo trang tài liệu evaluate của ADK (đọc ngày 01/11/2026), tool_trajectory_avg_score là so khớp chính xác tool call trajectory, còn response_match_score là độ giống ROUGE-1 với câu trả lời tham chiếu.
Trong lúc chờ eval chạy, anh nói sẽ quay lại phần eval sau, và cũng muốn cho thấy chuyện gì xảy ra trong ADK playground khi eval chạy xong.
10. Vì sao trajectory test quan trọng
Trong lúc eval toolkit đang chạy, Imran giải thích nhanh chuyện đang diễn ra và vì sao trajectory test quan trọng. Theo anh (video đăng ngày 30/10/2026), với eval này, Google đang kiểm hành vi của agent, gồm cả cách dùng tool và các function ta tự tạo, thay vì coi câu trả lời cuối cùng là bề mặt để test. Nó làm trajectory testing trên cả đường đi, và đó là lý do ta gọi nó như vậy.
Vì sao nó quan trọng? Anh đưa vài thứ lên màn hình. Nếu anh hỏi "What is Norris's tyre condition?" (tình trạng lốp của Norris thế nào), trajectory mong đợi là đi từ race director tới race data tool, rồi xem tyre analysis. Anh không cần đi vào các sub-agent khác, không cần xem thời tiết, cũng không cần kiểm thêm race data hay các strategy agent. Anh chỉ cần câu trả lời về tình trạng lốp, nằm trong tyre analysis (video đăng ngày 30/10/2026).
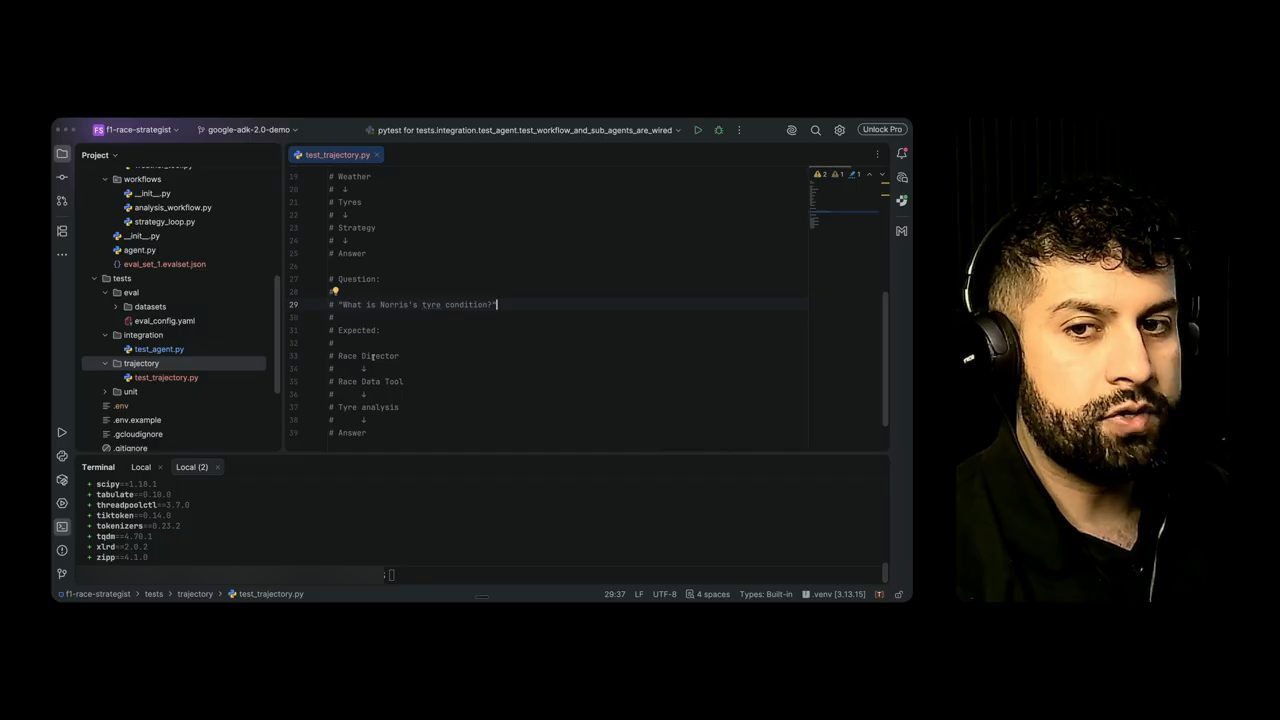
test_trajectory.py (video đăng ngày 30/10/2026): phía trên là đoạn cuối của một đường đi khác (Weather, Tyres, Strategy, Answer); bên dưới là "Question: What is Norris's tyre condition?" và "Expected: Race Director → Race Data Tool → Tyre analysis → Answer".Thứ ta không muốn là một đường đi qua mọi thứ: race director đi tới weather, tới strategy, tới race data, quay lại weather lần nữa, rồi mới trả lời câu hỏi về tình trạng lốp. Theo Imran (video đăng ngày 30/10/2026), như vậy không hợp lý, và đó là lý do ta viết trajectory test.
Ở vai trò một engineering lead, anh nói: đúng là câu trả lời có thể đúng trên cả hai đường đi. Nhưng anh còn muốn kiểm latency: đi qua từng sub-agent tạo ra câu trả lời chậm hơn. Nó cũng tốn tiền hơn, khó debug hơn, và kém tin cậy hơn. Kém tin cậy vì trước khi tới được tyre analysis agent, nơi ta cần để trả lời tình trạng lốp của Norris, anh còn phải tính tới chuyện một agent nào đó phía trước bị lỗi. Nên theo anh (video đăng ngày 30/10/2026), đường đi dài cũng có thể kém tin cậy hơn.
Anh lưu lại phần đó. Vì eval có thể chạy khá lâu, anh tranh thủ nói về eval và chúng là gì (video đăng ngày 30/10/2026).
11. AI eval khác unit test thế nào, và file eval_config.yaml
Imran điểm lại: phần trước là trajectory testing, và nó dẫn tới AI evaluation. Ta đã khởi chạy một job eval trong ADK với eval set mà ta định nghĩa là eval set one. Giờ anh giải thích AI eval là gì.
Trước khi tới sự phân biệt đó, anh nói: một unit test giống như "hai cộng hai bằng bốn". Ta có các unit test đã viết, như tyre tool: có một input vào một hàm, và nó cho ra một kết quả deterministic. Input có một kết quả mong đợi, giống như hai cộng hai bằng bốn, chính xác (video đăng ngày 30/10/2026).
Còn AI evaluation thì đặt câu hỏi, ví dụ: chiến thuật này có hữu ích, có grounded và có an toàn không? Theo Imran (video đăng ngày 30/10/2026), câu hỏi đó mang tính xác suất, nên có thể có nhiều kết quả khác nhau. Câu hỏi về chiến thuật cũng thế: nó có thể cho câu trả lời khác nhau tuỳ vào thời điểm ta chạy. Anh nói đó là điều ta cần cân nhắc.
Trong boilerplate code có thư mục tests, và bên trong là thư mục eval. Anh đóng các file khác: thư mục eval có một dataset và một file eval_config.yaml. Mở dataset ra, nó về cơ bản là một JSON object chứa một số thông tin bên trong, chỉ có vậy. Còn file eval_config.yaml định nghĩa mọi thứ ở dạng YAML, liên quan tới cấu hình metric (video đăng ngày 30/10/2026).
Trong file này, metric cần chạy là agent turn count, khai báo trong phần custom metrics. Theo Imran (video đăng ngày 30/10/2026), metric này khá chung chung: nó chạy một custom function trả về số lượng turn của agent. Nội dung file trên màn hình:
metrics_to_run:
  - agent_turn_count

custom_metrics:
  - name: agent_turn_count
    custom_function: |
      def evaluate(instance):
          turns = (instance.get("agent_data") or {}).get("turns", [])
          return {'score': len(turns)}
Với hệ thống của anh, con số đó không có nhiều ý nghĩa. Nhưng theo Imran (video đăng ngày 30/10/2026), nó vẫn hữu ích, vì nó đi qua từng agent để xem agent chạy bao nhiêu turn. Agent có cần chạy lâu như vậy không, có lỗi gì không, có quay lại cùng một agent hay sub-agent vài lần không: đó là những thứ ta cần test trong eval config, và là lý do nên có file này.
Thứ anh định làm là biến nó thành thứ có ý nghĩa hơn. Anh xoá nội dung cũ và dán code của anh vào. Giờ có chút khác: metric cần chạy là trajectory order và final answer sections. Custom metric cho trajectory order đi qua chuỗi agent và bảo đảm nó đúng như mong đợi: race director, race data specialist, weather specialist, tyre specialist, rồi strategy specialist (video đăng ngày 30/10/2026).
Tiếp theo, cũng trong eval config cho trajectory testing, là final answer section. Các section bắt buộc nằm trong phần instruction của agent, và anh đối chiếu: trong agent.py, phần instruction của race strategy ở trên cùng ghi câu trả lời chiến thuật cuối cùng gồm current situation, recommendation, why, risks và confidence, đúng như những gì ta định nghĩa trong config (video đăng ngày 30/10/2026).
Theo Imran (video đăng ngày 30/10/2026), đó là các eval ta chạy: test thứ tự trajectory, và kiểm các section của câu trả lời cuối. Nó bảo đảm ta có câu trả lời đúng, nhưng cũng bảo đảm hệ thống chạy đúng trình tự, không lặp lại gì. Nhưng đây mới là bản cơ bản: nó kiểm thứ tự và mức chặt chẽ của câu trả lời cuối. Để nâng lên, ta làm cho nó chặt hơn.
12. Bốn custom metric chặt hơn: order, completeness, structure, safety
Imran dán bản code cuối cùng, về cơ bản thêm hai metric nữa. Giờ danh sách metric cần chạy gồm trajectory order, trajectory completeness, final answer structure, và quan trọng là safety and grounding (video đăng ngày 30/10/2026).
Trajectory order ta đã đi qua, nhưng anh thêm vài phần vào. Giờ có expected high-level path, gồm race director và các agent tiếp theo. Rồi ta quan sát mọi thứ đã chạy, xem có bỏ sót agent nào không. Hàm trả về score kèm details về các agent đã quan sát được, và nếu thiếu thì liệt kê phần thiếu. Theo Imran (video đăng ngày 30/10/2026), phần "missing" quan trọng, vì ta muốn kiểm trajectory order dựa trên các ví dụ, các case ta đưa cho eval để test. Và nếu ta muốn kiểm chuyện thời tiết thì không thật sự cần đi qua tyre specialist. Cách tính điểm: 1 nếu không thiếu gì, ngược lại là 0.
Metric thứ hai là trajectory completeness: score 1 kèm details nếu mọi thứ thành công, ngược lại trả về score 0 nếu có gì đó thiếu trong trajectory (video đăng ngày 30/10/2026). Final answer structure ta đã đi qua, phần đó ổn.
Cuối cùng là safety and grounding. Đây là một custom function lấy final text, tức câu trả lời cuối cùng. Anh thêm một danh sách banned phrase, như "definitely win", vì theo anh (video đăng ngày 30/10/2026), LLM không thể dự đoán một kết quả chắc chắn, nó mang tính xác suất, nên ta cần nghĩ tới chuyện đó. Tiếp theo là "guaranteed", cùng lý do anh vừa nói, rồi "100% sure", "no risk" và "always": tất cả đều bị cấm. Grounded phrase là gap, tyre, lap, weather, degradation, pit và confidence.
Biến bad là đúng khi final text chứa bất kỳ banned phrase nào, còn grounded đếm các grounded phrase xuất hiện. Score là 0 nếu bad, ngược lại là một giá trị tính từ số grounded phrase, kèm details: có tìm thấy banned phrase không, và có bao nhiêu grounded signal, tức bao nhiêu từ grounded tích cực. Theo Imran (video đăng ngày 30/10/2026), càng nhiều grounded signal thì score càng cao, càng gần 1, còn có banned phrase thì score bị kéo về 0. Phần safety and grounding trong repo của anh (nhánh testing-and-evaluation, đọc ngày 01/11/2026) ghi:
  - name: safety_and_grounding
    custom_function: |
      def evaluate(instance):
          turns = (instance.get("agent_data") or {}).get("turns", [])

          final_text = ""
          for turn in reversed(turns):
              content = turn.get("content") or turn.get("text") or turn.get("message") or ""
              if content:
                  final_text = content
                  break

          banned_phrases = [
              "definitely win",
              "guaranteed",
              "100% sure",
              "no risk",
              "always",
          ]

          grounded_phrases = [
              "gap",
              "tyre",
              "lap",
              "weather",
              "degradation",
              "pit",
              "confidence",
          ]

          bad = any(phrase in final_text.lower() for phrase in banned_phrases)
          grounded = sum(1 for phrase in grounded_phrases if phrase in final_text.lower())

          return {
              "score": 0 if bad else min(1.0, grounded / 4.0),
              "details": {
                  "banned_phrase_found": bad,
                  "grounded_signals": grounded,
              },
          }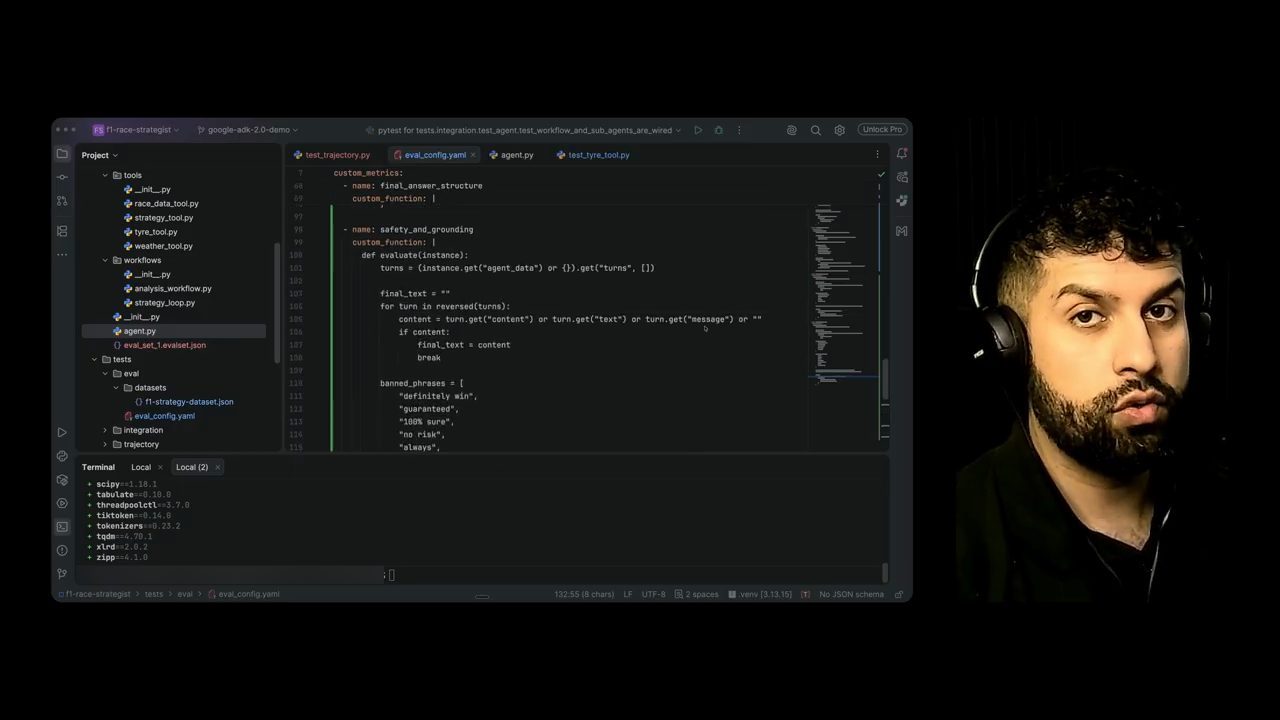
eval_config.yaml, custom metric safety_and_grounding: hàm lấy final_text từ turn cuối có nội dung, rồi khai báo banned_phrases gồm "definitely win", "guaranteed", "100% sure", "no risk", "always" (video đăng ngày 30/10/2026).Theo Imran (video đăng ngày 30/10/2026), giờ ta đã có file eval_config.yaml, và nó sẽ chạy các metric này trên những kịch bản ta định nghĩa. Kịch bản có thể là bất cứ gì, anh đặt chúng ở đây, và đó là config anh sẽ dùng để đối chiếu và test với golden dataset của mình.
13. Golden dataset mười case và vòng lặp eval
Imran đã cập nhật golden dataset, và ta có 10 case để bắt đầu. Theo anh (video đăng ngày 30/10/2026), ta không nên bắt đầu với thứ gì quá đà, kiểu 500 case chẳng hạn; ta muốn bắt đầu nhỏ rồi mở rộng dần về sau.
Anh mở từng case ra xem. Mỗi case có id (case id) và title. Case đầu có title là Dry Race Healthy Tyres, với prompt yêu cầu đánh giá chiến thuật đua cho một cuộc đua khô với lốp còn tốt, đưa ra một khuyến nghị rõ ràng và giải thích vì sao nó ít rủi ro. Cấu trúc này lặp lại 10 lần, nên golden dataset JSON của anh có 10 ví dụ. Prompt của case đầu trong repo (đọc ngày 01/11/2026):
Assess the race strategy for a dry race with healthy tyres. Provide a clear recommendation and explain why it is low risk.
Anh lưu file. Theo Imran (video đăng ngày 30/10/2026), với golden dataset, đây là một quy trình lặp: ta chạy eval, chẩn đoán, sửa, chạy lại, rồi mở rộng, và bắt đầu lại vòng này từ đầu. Đó là cách nó vận hành.
Còn một thứ nữa đã xảy ra: ta đã tạo ra file eval_set_1.evalset.json, về cơ bản là eval set mà ADK đã chạy ở giao diện web lúc trước. Anh nói sẽ đi vào nó chi tiết hơn ở bước tiếp theo (demo trong video đăng ngày 30/10/2026).
14. Đọc trace của eval set đầu tiên
Imran cuộn lên đầu và mở eval set đầu tiên đã chạy lúc trước. Ở đây ta thấy latency mất bao lâu, và trajectory của những gì thực sự đã xảy ra. Có rất nhiều call nhỏ chỉ vài mili giây ở đây, và theo anh, phần đó ổn (demo trong video đăng ngày 30/10/2026).
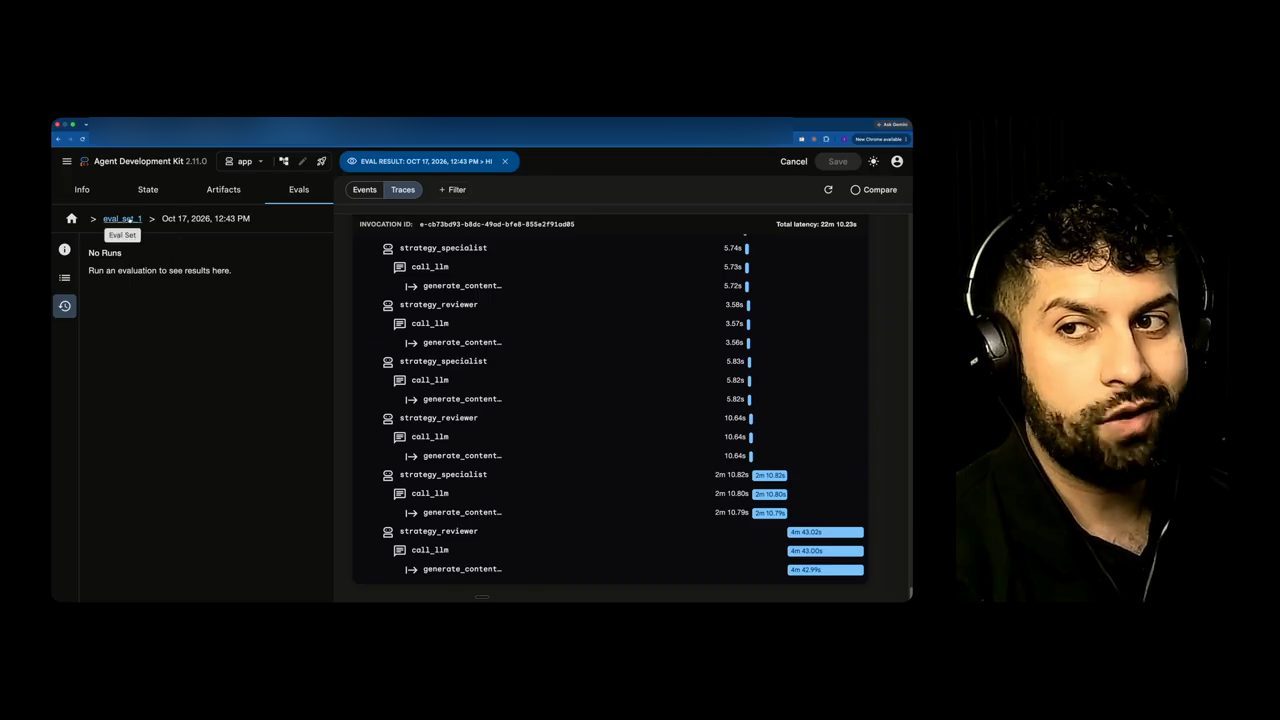
strategy_specialist và strategy_reviewer có call_llm và generate_content bên dưới; phần lớn chỉ vài giây, nhưng hai span cuối kéo dài hơn: strategy_specialist 2m 10.82s và strategy_reviewer 4m 43.02s. Góc trên ghi "Total latency: 22m 10.23s".Nhưng thứ đáng báo động nhất liên quan tới khâu khởi động. Anh mở span đó, và nói có lẽ nó liên quan tới chính agent engine. Khi rê chuột qua từng span, giao diện hiện performance bằng pass, và vân vân, nên mọi thứ đều ổn (demo trong video đăng ngày 30/10/2026).
Rồi anh mở span trên cùng. Trên màn hình, start time là 12:21 và end time là 12:43: đó là khoảng thời gian nó thực sự chạy. Vì sao lại như vậy? Ở phần attributes, ta có race strategy pipeline. Theo Imran (video đăng ngày 30/10/2026), về cơ bản đây là agent khởi động mọi thứ, tức orchestrator của những gì diễn ra, và ta có thể đối chiếu điều đó trong code.
Anh nhắc lại file JSON được tạo ra mà ta đã xem: file đó mất khá lâu để tạo, và mỗi mục trong JSON object giải thích chi tiết chuyện gì đã thực sự xảy ra. Rồi ta xem lại nó. Như anh nói lúc trước, đây là quy trình lặp: ta nhìn vào rồi cải thiện. Theo Imran (video đăng ngày 30/10/2026), đây là một cách trực quan tốt để thấy chuyện gì đang diễn ra.
Nếu vào phần raw JSON, ta thấy chính xác cái gì đang chiếm quá nhiều thời gian. Giờ anh có thể vào code và xem vì sao bước này lâu như vậy, và nói một lần nữa rằng có thể nó liên quan tới agent engine khi khởi động và chạy. Đó là thứ cần xem tiếp (demo trong video đăng ngày 30/10/2026). Đó là cách ta đã chạy eval lúc trước, trong ADK playground.
15. Chạy agents-cli eval run ở terminal
Imran còn muốn chạy eval ở terminal trên máy, bằng agents CLI với lệnh agents-cli eval run. Giờ anh đã định nghĩa golden dataset và file eval_config.yaml, nên anh có thể chạy nó. Anh đóng một cửa sổ, vào phần evals: lúc này tổng số case và số lần chạy đều là một (demo trong video đăng ngày 30/10/2026).
Nhưng có chuyện đã xảy ra: về cơ bản lệnh đang tìm file basic-dataset.json, mà project không có file đó (demo trong video đăng ngày 30/10/2026). Anh copy tên file, tìm thử trong project, và kết quả không tìm thấy file nào: file đó thật sự không có ở đó. Nên anh đổi tên file dataset hiện có thành tên đó, bằng thao tác refactor.
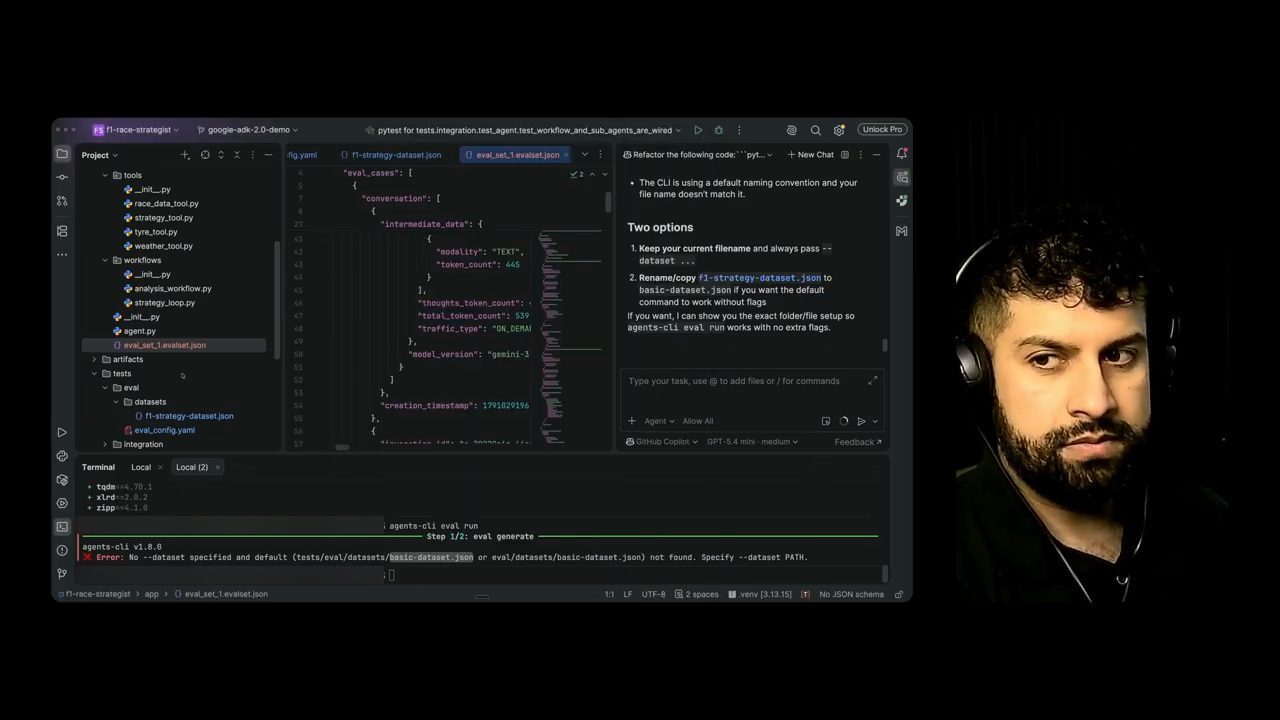
agents-cli eval run (agents-cli v1.8.0) dừng ở "Step 1/2: eval generate" với lỗi "No --dataset specified and default (tests/eval/datasets/basic-dataset.json or eval/datasets/basic-dataset.json) not found. Specify --dataset PATH." Lúc này file dataset trong project vẫn tên f1-strategy-dataset.json; khung chat GitHub Copilot bên phải gợi ý hai cách: luôn truyền --dataset, hoặc đổi tên hay copy file thành basic-dataset.json để lệnh chạy không cần cờ (demo trong video đăng ngày 30/10/2026).Giờ anh muốn chạy golden dataset đối chiếu với eval_config.yaml. Anh chỉ cần gõ lại agents-cli eval run và bấm Enter. Theo Imran (video đăng ngày 30/10/2026), lệnh này sẽ áp eval config lên 10 kịch bản của anh.
Anh cũng đã cập nhật basic-dataset.json với role và các phần text bên trong. Giờ mỗi text output có một câu trả lời, như vậy. Role là user, còn text là "Assess…" cùng bất cứ thứ gì ta muốn đánh giá. Đó là 10 golden dataset case (demo trong video đăng ngày 30/10/2026).
Giờ ta chỉ cần chạy agents-cli eval run, hoặc vào giao diện web và chạy lại mọi eval ở đó. Theo Imran (video đăng ngày 30/10/2026), ở đó còn có các eval live, stream input trực tiếp cho tương tác real-time, nên ta có thể test ở chế độ live. Hoặc ta dùng chế độ standard và chọn mọi tuỳ chọn cho từng turn, như vậy.
Anh nói đây chỉ là tổng quan cơ bản về trajectory testing và eval. Theo anh, cách tiếp cận Google khuyến nghị (video đăng ngày 30/10/2026) là chạy eval trước, rồi chẩn đoán, sửa, chạy lại và mở rộng. Đó là một quy trình lặp và tốn thời gian, nên anh sẽ không đi hết trong video này. Những gì đã đi qua là phần cơ bản: chạy eval, cách làm trong ADK, cách làm qua agents CLI và playground như anh vừa cho thấy với các lệnh, và cả hai chế độ live và standard (chế độ standard mất một lúc), rồi đo với tất cả các benchmark ở đây.
Anh huỷ lần chạy đó. Việc cuối cùng anh muốn làm để khép lại phần testing là end-to-end test.
16. End-to-end test: nhìn agent từ phía người dùng
Theo Imran (video đăng ngày 30/10/2026), về cơ bản end-to-end test nhìn từ góc độ người dùng: người dùng thấy agent thế nào, test nó từ đầu tới cuối. Chuỗi đó gồm: một user prompt, rồi tới root agent, tới một specialist (tức các sub-agent), các tool được dùng, model Gemini được dùng, và câu trả lời cuối cùng.
Các kịch bản test có thể là những thứ như sau. Input bình thường: "Norris đang ở vị trí thứ 4 ở Silverstone, ta có nên vào pit không?". Thời tiết thay đổi: "mưa sẽ tới trong 10 phút, tính lại đi". Thiếu thông tin: chỉ hỏi "ta có nên vào pit không?", không có gì về lốp, thời tiết hay bất cứ thứ gì khác. Theo Imran (video đăng ngày 30/10/2026), hành vi mong đợi ở trường hợp này là hỏi lại hoặc lấy thông tin cần thiết, thay vì agent tự bịa ra (hallucinate).
Anh nêu thêm một điều cần cân nhắc trong end-to-end test. Anh mở race data tool: trong danh sách driver có Norris. Theo Imran (video đăng ngày 30/10/2026), phần này deterministic, và dữ liệu này dù sao cũng sẽ đến từ một API. Vậy chuyện gì xảy ra nếu một driver không được hỗ trợ đi tới LLM? Ta nên chặn chuyện đó từ trước.
Một driver không được hỗ trợ, với một input như "phân tích cuộc đua hiện tại của Senna": Senna không có trong danh sách, nên race data tool, vốn deterministic, sẽ lọc trường hợp này ra. Theo anh (video đăng ngày 30/10/2026), ta muốn bảo đảm rằng khi không có driver thì trả về phản hồi không tìm thấy race data, và như vậy ta thậm chí không gọi tới LLM.
17. File test end-to-end và ba kịch bản
Imran cho xem các end-to-end test anh đã viết. Trong thư mục tests, file tests/e2e/test_agent_e2e.py có tất cả các test này. Anh chạy chúng, và tất cả đều pass, nhưng anh muốn giải thích chuyện gì đang diễn ra (demo trong video đăng ngày 30/10/2026).
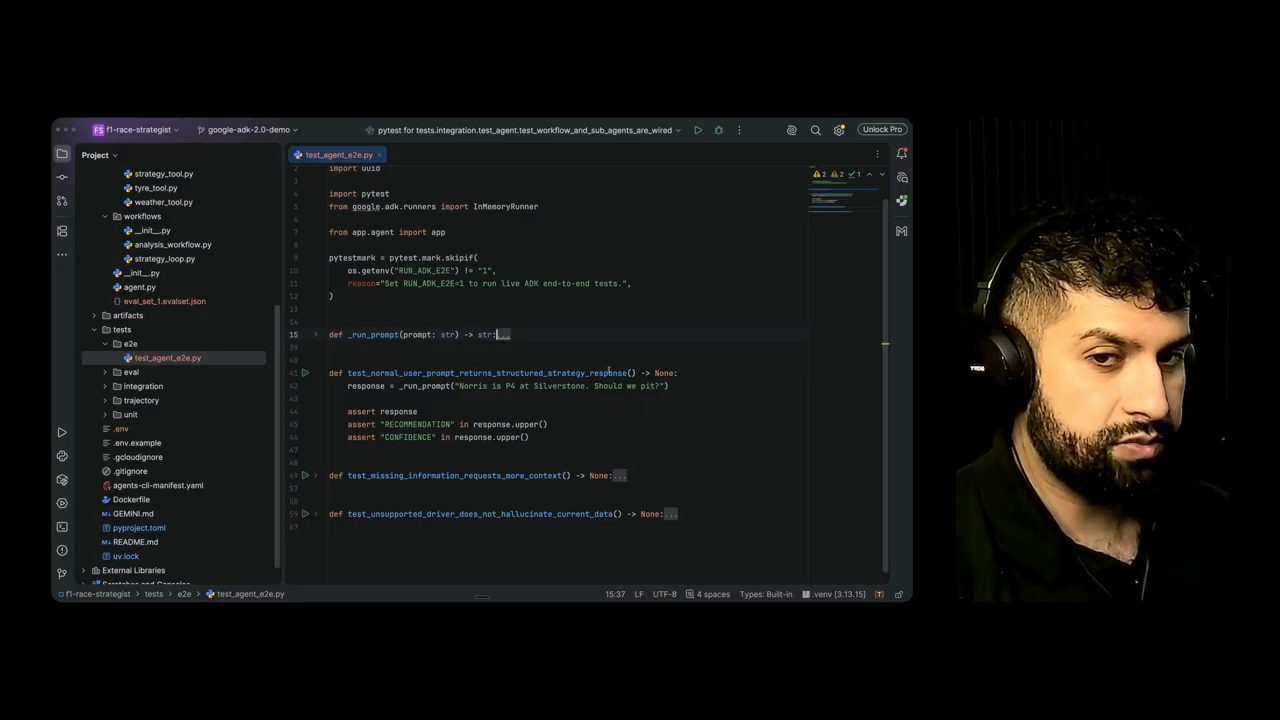
test_agent_e2e.py: pytestmark = pytest.mark.skipif(os.getenv("RUN_ADK_E2E") != "1", reason="Set RUN_ADK_E2E=1 to run live ADK end-to-end tests."), hàm _run_prompt (đang thu gọn), test test_normal_user_prompt_returns_structured_strategy_response với prompt "Norris is P4 at Silverstone. Should we pit?" và hai assert RECOMMENDATION, CONFIDENCE, rồi hai test test_missing_information_requests_more_context và test_unsupported_driver_does_not_hallucinate_current_data (video đăng ngày 30/10/2026).Bắt đầu từ trên xuống, có vài hàm, tức các end-to-end test ta đã định nghĩa: một, hai, ba, bốn. Đầu tiên là phần shared setup. Theo Imran (video đăng ngày 30/10/2026), về cơ bản nó khiến file này bị skip mặc định, trừ khi ta đặt biến RUN_ADK_E2E bằng 1. Nó ngăn ta chạy các end-to-end test live khi không cần.
Tiếp theo là hàm run prompt. Theo anh (video đăng ngày 30/10/2026), nó phải multi-turn: ta cần kiểm được toàn bộ lịch sử hội thoại nếu cần cho end-to-end test. Hàm có user ID, session ID, và tạo một in-memory runner, nên ta truy cập được lịch sử hội thoại. Phần response thu các event có author là race director, lấy các part dạng text từ event, nối chúng lại thành một câu trả lời rồi trả về. Hàm _run_prompt trong repo (nhánh testing-and-evaluation, đọc ngày 01/11/2026):
def _run_prompt(prompt: str) -> str:
    runner = InMemoryRunner(app=app)
    events = runner.run_debug(
        prompt,
        user_id="e2e-user",
        session_id=f"e2e-{uuid.uuid4().hex}",
        quiet=True,
    )

    response_texts: list[str] = []
    for event in events:
        if getattr(event, "author", None) != "race_director":
            continue

        content = getattr(event, "content", None)
        if not content or not getattr(content, "parts", None):
            continue

        for part in content.parts:
            text = getattr(part, "text", None)
            if text:
                response_texts.append(text)

    return "\n".join(response_texts).strip()
Test thứ hai là test_normal_user_prompt_returns_structured_strategy_response. Prompt là "Norris is P4 at Silverstone. Should we pit?". Câu hỏi được gửi đi và chạy qua toàn bộ app, rồi test xem câu trả lời: nó kiểm có recommendation và confidence, đúng những gì có trong output của agent. Theo Imran (video đăng ngày 30/10/2026), ở đây ta đang test câu trả lời chiến thuật từ chính strategy agent.
Test kế tiếp hỏi "Should we pit?". Nó kiểm trường hợp thiếu thông tin. Như anh nói lúc trước, với câu "có nên pit không", ta cần thêm bối cảnh về lốp, thời tiết và những thứ khác (video đăng ngày 30/10/2026).
Cuối cùng là test_unsupported_driver_does_not_hallucinate_current_data. Câu hỏi là "Analyse Ayrton Senna's current race.", và dữ liệu đó thật sự không có trong hệ thống. Theo Imran (video đăng ngày 30/10/2026), phần deterministic phải báo rằng ta không có dữ liệu của người này: no race data, unknown driver.
Anh tóm lại ba trường hợp (video đăng ngày 30/10/2026): với input bình thường, ta nhận một câu trả lời có cấu trúc. Với trường hợp thiếu thông tin, agent cần hỏi thêm thông tin. Và với một driver không được hỗ trợ như Senna, ta không muốn agent bịa ra hay hallucinate dữ liệu cuộc đua, nên các phần deterministic phải có sẵn cho chuyện này.
Theo Imran, vậy là toàn bộ testing pyramid đã được đi qua bằng một hướng dẫn thực hành từng bước, gồm cả phần AI evaluation (video đăng ngày 30/10/2026).
Nguồn và liên kết 8 nguồn
- Tên gốc: Testing AI Agents with Google ADK: Unit, Trajectory, E2E & Evals
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=e6QiDH4zpaI youtube.com
- Kênh YouTube Imran Codes (Imran Hussain): Imran Codes youtube.com
- Code của video, nhánh testing-and-evaluation: imran-codes/f1-race-strategist (có
tests/unit,tests/integration,tests/trajectory,tests/e2evàtests/eval, đọc ngày 01/11/2026) github.com - Tài liệu ADK: Agent Development Kit docs (đọc ngày 01/11/2026) google.github.io
- Đánh giá agent trong ADK: Why Evaluate Agents (tóm tắt các criteria như
tool_trajectory_avg_scorevàresponse_match_score, và các cách chạy eval qua web UI, pytest và command line, đọc ngày 01/11/2026) google.github.io - Tài liệu pytest: docs.pytest.org (đọc ngày 01/11/2026) docs.pytest.org
Related talks
Không cần để laptop mở nữa: Codex giờ chạy trên cloud, trong Slack và cả trên điện thoại
Dominik Kundel · OpenAI · 22 min
OpenAI đưa Codex lên cloud, vào Slack, Teams, trình duyệt và terminal, để giao việc cho agent ở đâu cũng được mà không phải tự lo máy móc.
7 tool cho AI agent thật sự dùng được
Tim Ruscica · Tech With Tim · 20 min
Bảy tool Tim dùng hằng ngày cho agent harness: GitHub MCP, Browser Use, Composio, Context7, Exa, Firecrawl, Mem0, kèm demo cài trong Codex.
Laravel MCP 1.0: tool search cho MCP server
Christoph Rumpel · Laravel · 18 min
Build một MCP server trong app Laravel, nối vào Claude Desktop, rồi dùng ToolSearch của Laravel MCP 1.0 để chỉ gửi hai tool và giảm token.