The 100-Tool Agent Is a Trap: Scaling with Semantic Routers and JIT Context
AI Engineer World's Fair 2026: Online Track · Video gốc
Nạp mọi tool vào prompt làm accuracy rơi từ 78% xuống 13% ở 741 tool; semantic routing (RAG cho tool) với JIT context giữ trên 83% và cắt 99% token.
1. Cái bẫy trông vô hại: đưa cho agent mọi tool cùng một lúc
Sohail mở đầu bằng cách chào mọi người, giới thiệu mình và người cùng trình bày là Ankush. Chủ đề của hai anh là một sai lầm lúc đầu trông hoàn toàn vô hại: cấp cho một AI agent quyền truy cập vào mọi tool mà nó có thể sẽ cần, tất cả cùng một lúc. Cách làm này chạy tốt trong demo. Nó thậm chí còn chạy ổn khi số tool còn nhỏ, chẳng hạn khoảng mười tool. Nhưng khi catalog tool lớn dần, agent bắt đầu chậm đi, có thể đắt hơn, và kém chính xác hơn. Đó là lý do hai anh gọi hiện tượng này là "the hundred tool agent trap", cái bẫy của agent một trăm tool.
Trong khoảng nửa tiếng, hai anh hứa sẽ cho thấy vì sao thiết kế đó vỡ, các con số trông như thế nào, và semantic routing kết hợp với just-in-time context giúp sửa vấn đề ra sao.
Sohail tự giới thiệu: anh là Sohail Shaikh, hiện làm data scientist ở Prosodica. Background của anh trải qua AI, NLP, marketing, analytics và cả engineering. Trọng tâm hiện tại của anh là applied AI, NLP, conversational intelligence, cùng với các hệ RAG. Anh đặc biệt quan tâm tới việc làm cho AI system đáng tin cậy hơn, đo lường được, và scale được vượt ra khỏi demo để chạy trong production.
Ankush tiếp lời: anh là Ankush Rastogi, senior data solutions engineer ở Prosodica, đã làm hơn mười năm trong AI, data engineering và các production system. Anh nói rõ góc nhìn của mình là phía engineering: câu hỏi không phải là thứ gì chạy được trong notebook, mà là nó có sống sót được với tải thật, user thật và lỗi thật hay không. Đó cũng là góc mà cả talk đi theo. Hai anh chia vai rõ ràng: Sohail tập trung vào hành vi của model và của routing, còn Ankush tập trung vào system design, cách implement và các trade-off khi lên production.
Prosodica là công ty làm conversation analytics: biến các cuộc hội thoại (chẳng hạn cuộc gọi ở contact center) thành insight vận hành, chấm điểm cuộc gọi tự động và đưa insight theo thời gian thực.
2. Fat agent: kiến trúc ngây thơ chạy đẹp trong demo
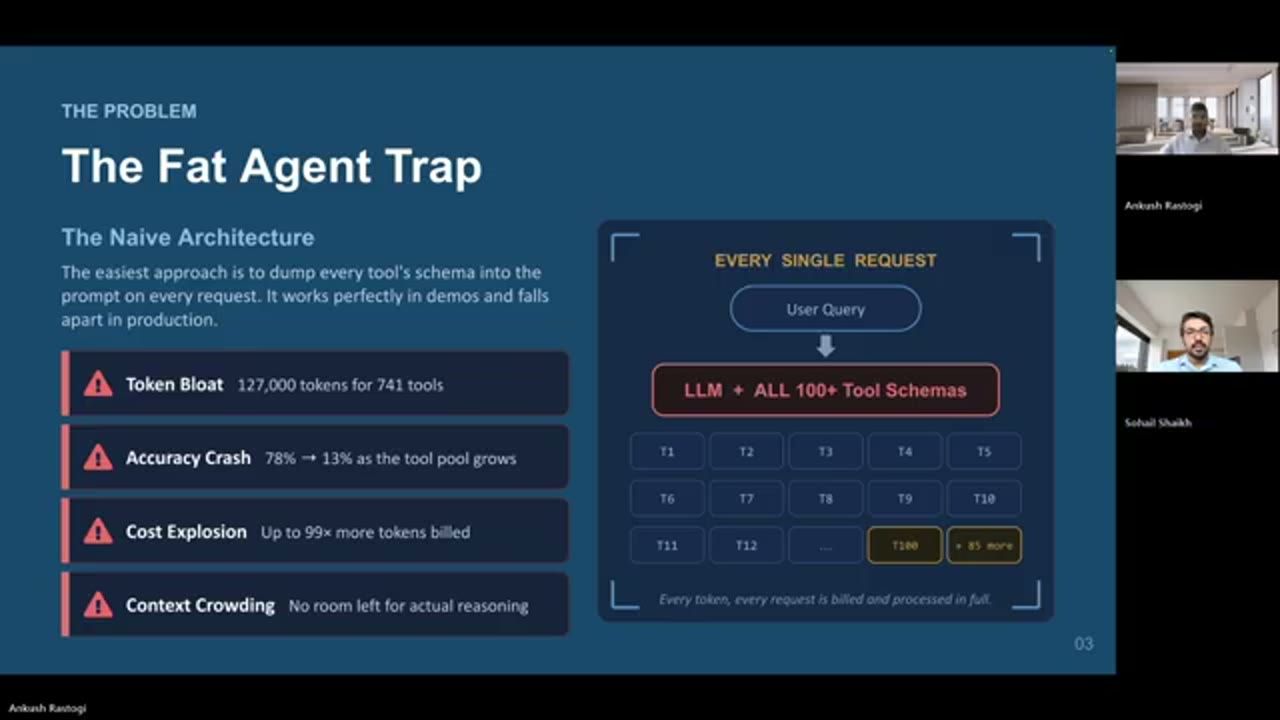
Sohail bắt đầu bằng một thiết kế rất phổ biến. Bạn build một hệ thống làm được nhiều việc: query database, gửi email, kiểm tra calendar, tra cứu một đơn hàng, gọi một API, và cứ thế tiếp tục. Cách đơn giản nhất ở đây là đưa cho model định nghĩa của mọi tool trong mọi request. Mọi function name, mọi description, và cả mọi JSON schema đều đi vào prompt, bất kể user có cần tới chúng hay không. Hai anh gọi thiết kế này là fat agent.
Ở quy mô nhỏ, cảm giác mọi thứ đều ổn. Với mười tool, model thường chọn đúng. Demo trông rất đẹp. Rồi sản phẩm lớn lên. Mười tool trở thành ba mươi, rồi tiếp tục tăng, và đến một lúc model bắt đầu gọi sai function, nhầm lẫn giữa các tool giống nhau, tự bịa ra tên tool không tồn tại, và mất nhiều thời gian hơn để trả lời.
Điểm quan trọng mà Sohail nhấn mạnh: thiết kế này không hỏng vì có một tool nào đó viết tệ. Nó hỏng vì mọi request đều bị bắt phải mang theo toàn bộ catalog.
3. 741 tool, 127.000 token, và accuracy sụp từ 78% xuống 13%
Sohail đưa ra con số cụ thể. Giả sử toàn bộ schema của bạn có 741 tool. Chỉ riêng phần description của tất cả các tool đó đã chiếm tới khoảng 127.000 token. Và đó là trước khi câu hỏi thật của user được tính tới. Kết quả là context overload, và cần quản lý nó cho đúng.
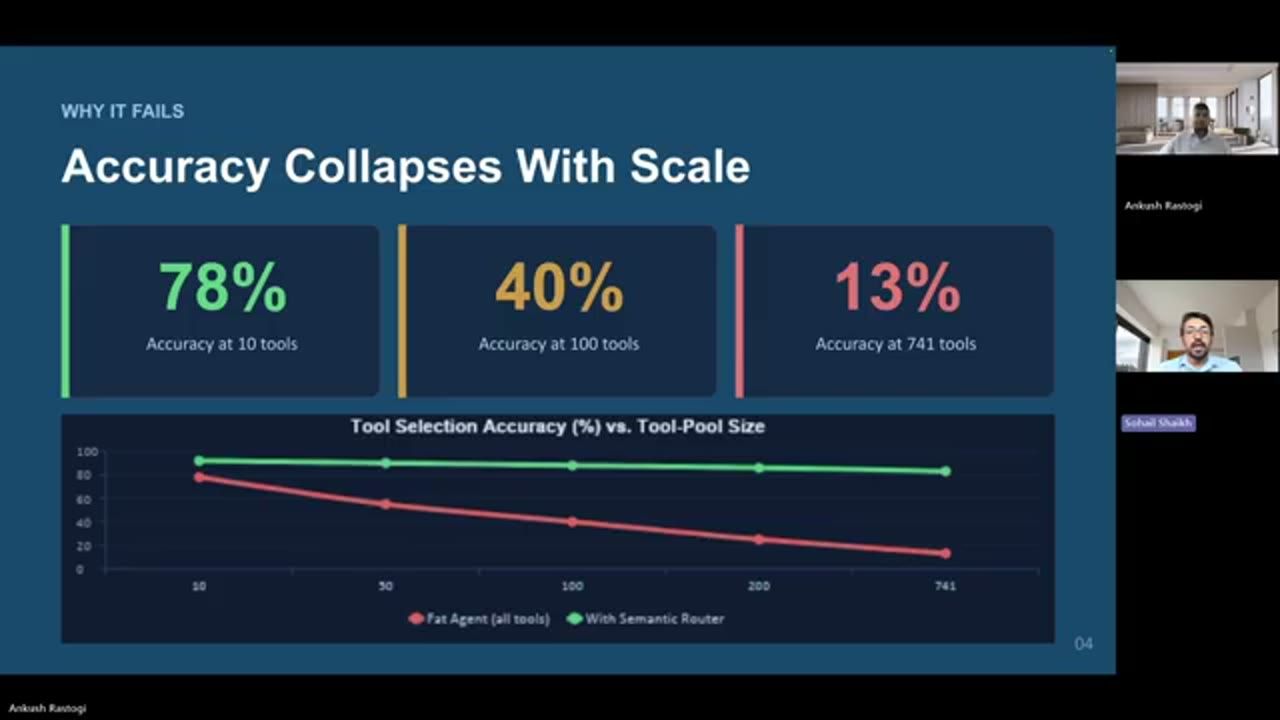
Slide tiếp theo cho thấy vì sao thiết kế thất bại và vì sao accuracy sụp đổ sau một ngưỡng. Nhìn vào đường accuracy: với mười tool, fat agent chọn đúng tool khoảng 78% số lần. Chưa hoàn hảo, nhưng dùng được. Tới khoảng một trăm tool, accuracy rơi xuống quanh 40%: chưa tới một nửa số tool được gọi là tool đúng. Và nếu catalog còn lớn hơn nữa, như ở mức 741 tool, accuracy chỉ còn vỏn vẹn 13%. Nói ngắn gọn, khoảng một tool đúng trên tám lần gọi.
Đặt cạnh đó là semantic router, và nó hành xử hoàn toàn khác: accuracy giữ trên 83% ở cùng các kích thước catalog đó. Lý do là model không còn phải chọn từ hàng trăm tool nữa. Nó chỉ chọn trong một tập nhỏ và liên quan.
4. Lost in the middle: vì sao prompt to làm quyết định khó hơn
Một lý do khiến fat agent thất bại là vấn đề lost in the middle. Model chú ý mạnh hơn vào phần đầu và phần cuối của một context dài. Khi hàng trăm tool schema bị nhồi vào giữa, model không dùng chúng một cách đáng tin cậy. Thế là ta trả tiền cho một prompt khổng lồ, và chính prompt đó lại làm cho quyết định càng khó hơn.
Hiện tượng này đã được đo trong nghiên cứu "Lost in the Middle: How Language Models Use Long Contexts" (Liu và cộng sự, 2023): khi thông tin cần dùng nằm ở giữa một context dài, độ chính xác của model giảm rõ so với khi nó nằm ở đầu hoặc cuối, tạo thành một đường cong hình chữ U. Với fat agent, tool đúng cho câu hỏi hiện tại rất dễ rơi đúng vào vùng giữa đó.
5. Cái thuế ẩn: cost và latency tăng theo số tool
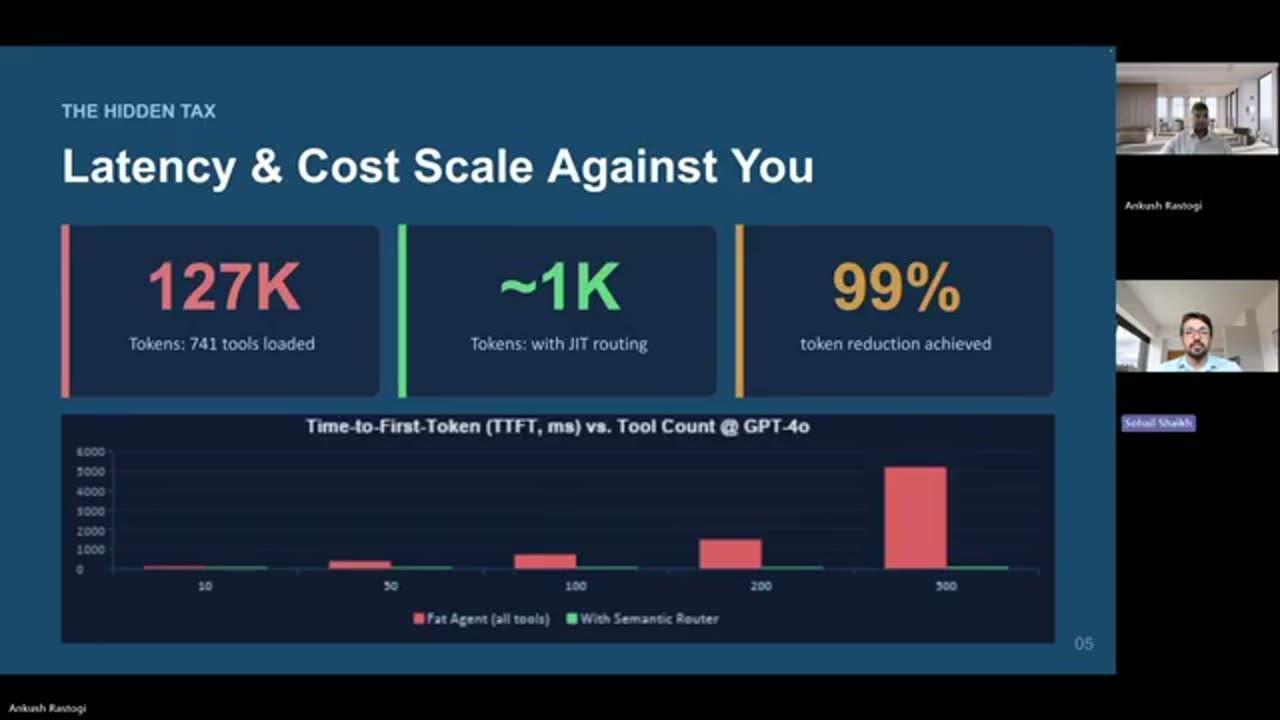
Ngoài accuracy, Sohail nêu thêm hai lý do nữa: latency và cost. Quay lại ví dụ 741 tool cần gần 127.000 token, bao gồm cả description lẫn phần text của schema. Chi phí đó bị trả ở mọi request. Nếu đẩy hệ thống lên production với 100.000 request mỗi ngày, bạn đang gửi đi hàng tỉ token chỉ để mô tả tool. Với just-in-time routing, prompt có thể chỉ chứa ba tới năm schema liên quan, khoảng 1.000 token. Tức là giảm khoảng 99% lượng token dành cho tool context.
Để thấy quy mô: 127.000 token nhân 100.000 request là khoảng 12,7 tỉ input token mỗi ngày chỉ cho phần mô tả tool, so với khoảng 100 triệu token nếu mỗi request chỉ mang khoảng 1.000 token.
Vấn đề tiếp theo là latency. Với fat agent, time to first token (TTFT) tăng theo kích thước catalog, vì model phải xử lý một prompt lớn hơn trước khi có thể trả lời câu hỏi của user. Ví dụ, nếu agent của bạn có 500 tool, đường đi của fat agent có thể đẩy latency của token đầu tiên vượt quá năm giây. Điều này đặc biệt quan trọng nếu sản phẩm của bạn là real-time: hệ thống sẽ trả lời lâu hơn, khiến thiết kế có cảm giác chậm và khó đoán. Với semantic routing, hệ thống phản hồi nhanh hơn và mang cảm giác real-time hơn.
6. So sánh trực diện: fat agent và semantic router
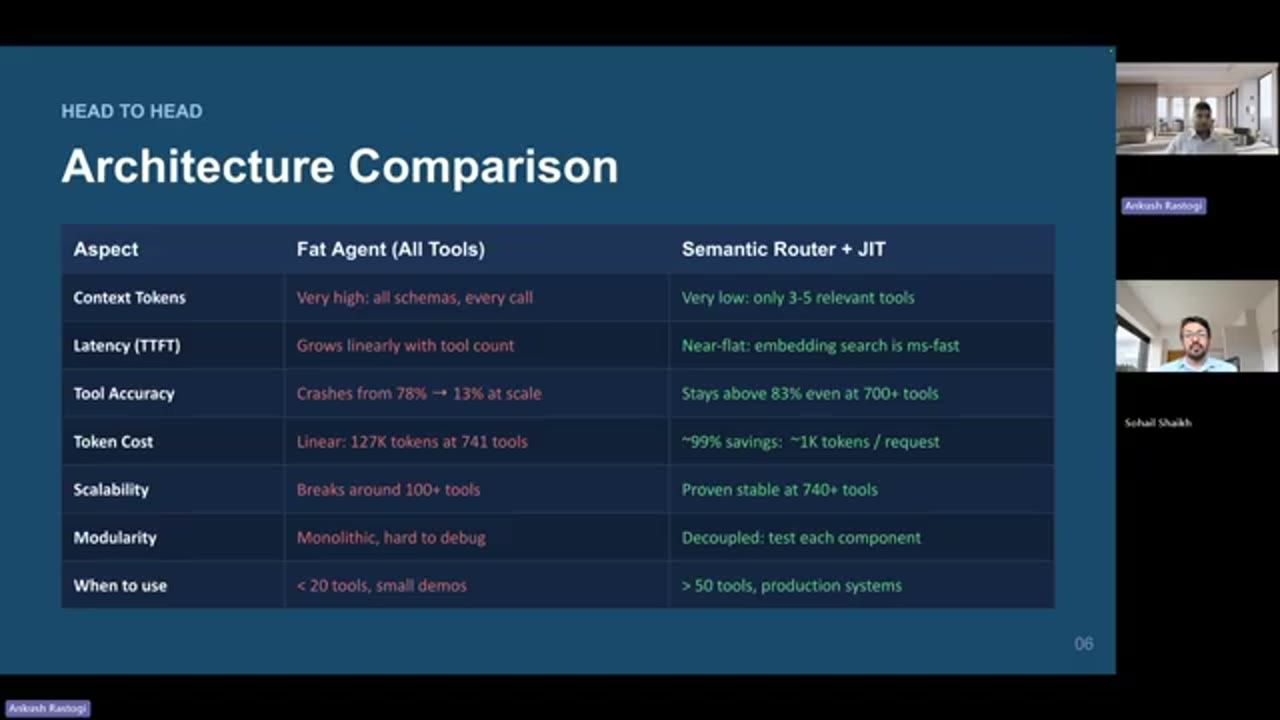
Tiếp theo là một bảng so sánh gọn: bên trái là fat agent, bên phải là semantic router. Với fat agent, mọi schema được nạp cho mọi request, bất kể user hỏi gì. Vì vậy catalog lớn lên thì prompt lớn lên, latency tăng và accuracy giảm. Agent cũng trở thành một khối monolithic lớn, khó test, rủi ro khi update và rất mệt khi debug.
Với thiết kế semantic routing, agent không khởi đầu với mọi tool. Router nhìn vào câu hỏi của user trước, lấy ra ba tới năm tool liên quan nhất, rồi chỉ inject những tool đó vào lời gọi model. Context vì thế giữ nhỏ, latency ổn định, và accuracy giữ được vì model chọn từ một danh sách tập trung thay vì một catalog khổng lồ.
Ankush thêm một lưu ý quan trọng: nếu bạn có ít hơn 20 tool, router có thể là không cần thiết, cứ nạp tool trực tiếp. Nhưng khi hệ thống production vượt quá 50 tool, thiết kế dựa trên router bắt đầu hợp lý hơn.
7. Semantic routing hoạt động ra sao: RAG cho tool
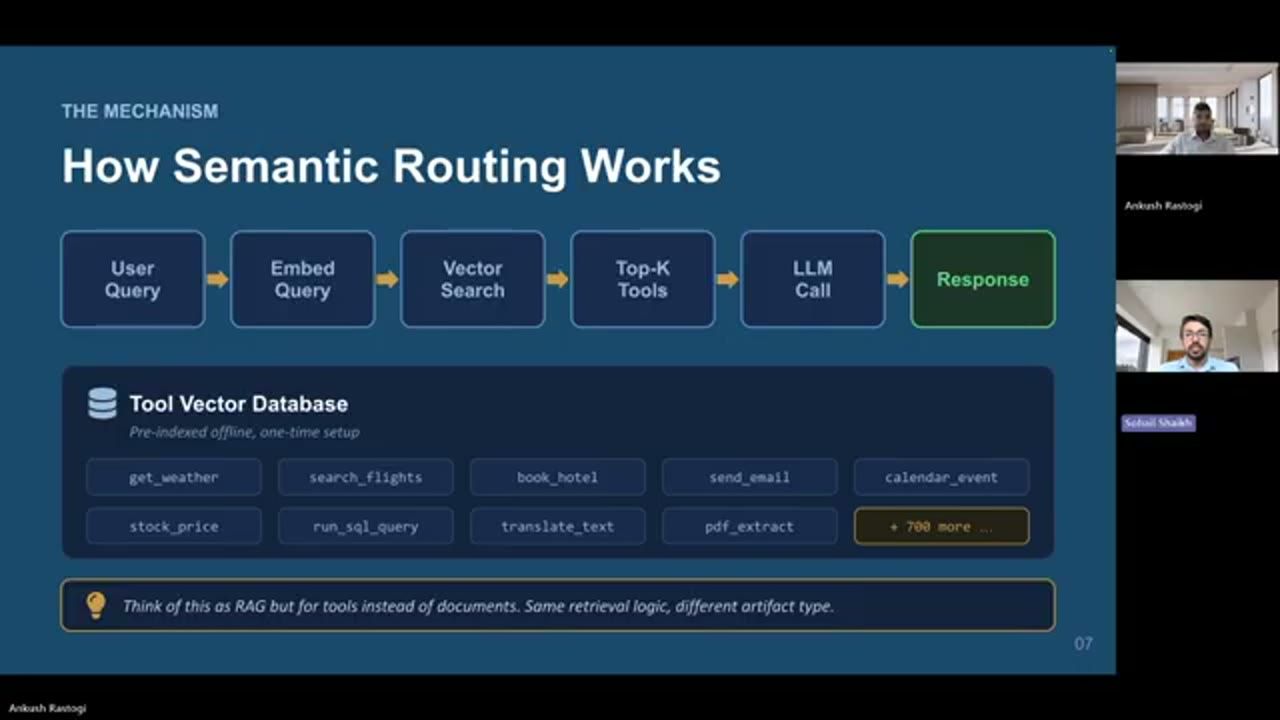
Sohail cảm ơn Ankush rồi đi vào cơ chế. Nếu bạn từng build một hệ RAG, phần này sẽ rất quen. Khác biệt duy nhất là ta retrieve tool thay vì document.
Ở bước đầu tiên, mỗi tool cần có một description rõ ràng. Ví dụ một tool search flights, một tool kiểm tra lịch trống trên calendar, hay một tool tra trạng thái đơn hàng của khách. Bước thứ hai: các description đó được embed và lưu vào một vector index. Việc này thường làm offline, khi catalog tool được tạo ra hoặc được cập nhật.
Lúc runtime, user đặt câu hỏi. Ta embed câu hỏi đó bằng đúng embedding model đã dùng cho description, rồi search trong vector index để tìm những tool có description gần với câu hỏi nhất. Router trả về top K tool, thường K là ba hoặc năm tool khớp với câu hỏi, và chỉ những schema được chọn đó mới được inject vào lời gọi model.
Toàn bộ pattern gói lại như sau: index tool description offline, retrieve tool liên quan lúc runtime, và giữ cho context của model tập trung. Nói ngắn gọn, ý tưởng rất đơn giản: semantic routing chính là RAG cho tool. Nếu stack của bạn đã có một embedding model và một vector database, phần lớn hạ tầng ở đây bạn đã quen thuộc rồi.
8. Just-in-time context injection: chỉ nạp thứ cần, đúng lúc cần
Ankush cảm ơn Sohail rồi đi sâu vào just-in-time context injection. Anh phân biệt hai lớp: semantic routing là retrieval layer, còn just-in-time context injection là chiến lược quản lý context.
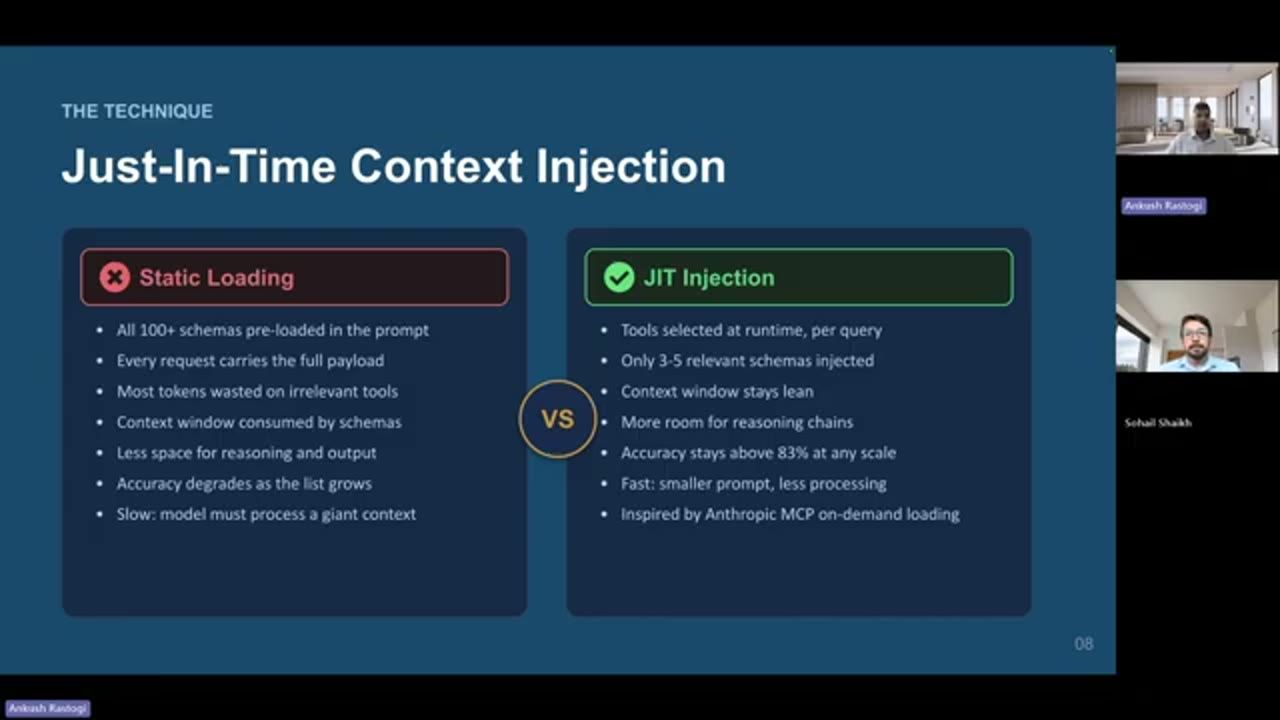
Với fat agent, mọi thứ được nạp trước khi câu hỏi được hiểu: model nhận một danh sách tool khổng lồ trước, rồi mới cố gắng reasoning xuyên qua nó. Just-in-time context làm ngược lại: nó chờ tới khi biết câu hỏi, rồi mới inject đúng phần context cần cho request đó.
Ankush nhắc rằng đây không phải ý tưởng mới trong software. Chúng ta đã dùng lazy loading, just-in-time compilation và on-demand resource loading từ nhiều năm nay. Ở đây ta chỉ áp dụng cùng nguyên lý đơn giản đó cho context của LLM.
Anthropic đã viết về pattern này với việc nạp tool theo nhu cầu qua MCP. Theo báo cáo của họ, lượng token dùng giảm từ khoảng 150.000 xuống còn 2.000, tức giảm 98,7%. Với Ankush, đó là tín hiệu rõ ràng: catalog tool lớn không nên bị đổ vào mọi prompt, mà nên được retrieve khi cần. Bài viết đó là "Code execution with MCP" trên Anthropic Engineering Blog, trong đó agent chỉ đọc định nghĩa của những tool mà task hiện tại cần thay vì nạp tất cả từ đầu.
9. Một benchmark plan có thể lặp lại
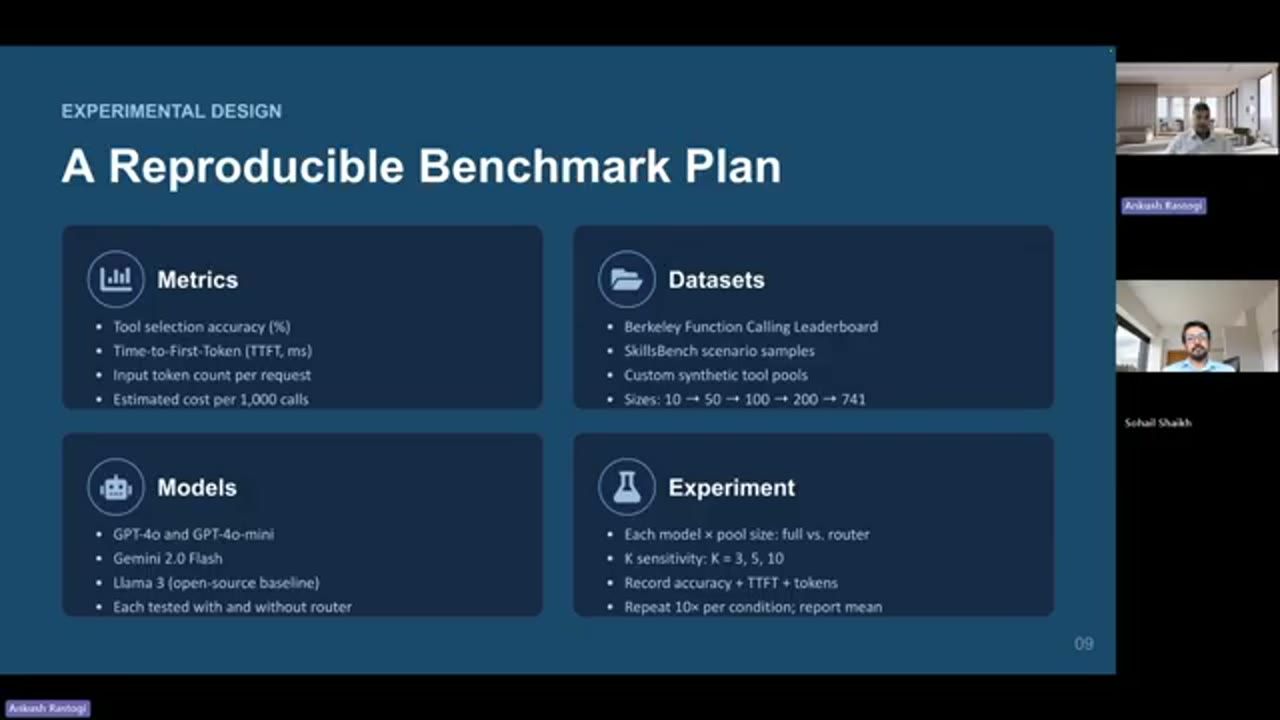
Chuyển sang slide tiếp theo, Ankush bàn về cách đánh giá cho công bằng. Hai anh đo bốn thứ: tool-selection accuracy, time to first token, số input token mỗi request, và chi phí ước tính cho mỗi một nghìn lần gọi.
Về dataset, họ dùng Berkeley Function Calling Leaderboard, các kịch bản theo kiểu SkillsBench, và các pool tool tổng hợp (synthetic) cho phép tăng số tool theo ý muốn, nhờ vậy test được ở mười, năm mươi, một trăm, hai trăm hay thậm chí 741 tool.
Họ chạy cùng một bộ câu hỏi ở hai chế độ, fat agent và semantic routing. Cùng model, cùng answer key, cùng catalog tool. Khác biệt duy nhất là model nhìn thấy mọi tool hay chỉ những tool đã được route.
Họ cũng quét K ở ba, năm và mười để hiểu trade-off. K nhỏ thì nhanh hơn và rẻ hơn. K lớn có thể cứu được thêm những edge case. Trong thực tế, K bằng năm là điểm khởi đầu mặc định tốt, nên nếu muốn thử, cứ đặt mặc định là năm. Ở đây K là số tool mà semantic router retrieve và đưa cho LLM cho mỗi câu hỏi của user.
10. Kết quả benchmark: catalog lớn dần, working set vẫn nhỏ
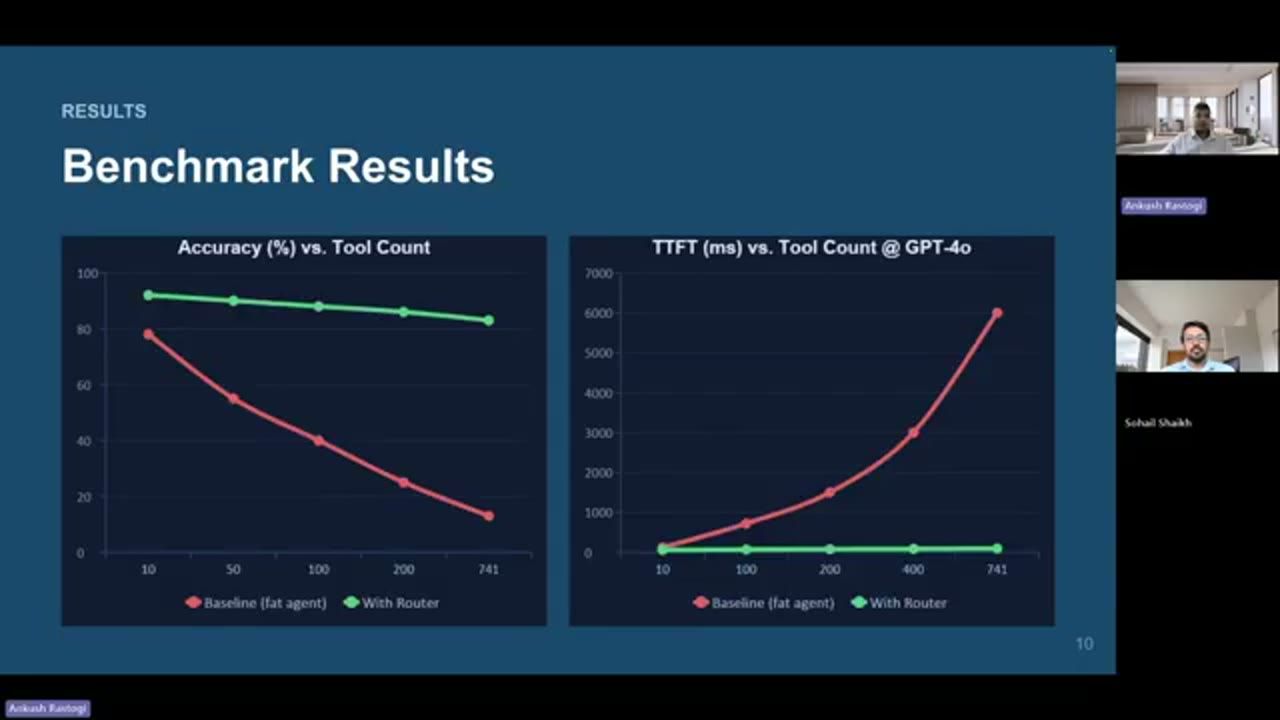
Ankush trình bày kết quả. Ở biểu đồ bên trái, đường accuracy của fat agent rơi mạnh khi số tool tăng: bắt đầu quanh 78% ở mười tool, rồi rơi xuống khoảng 13% ở 741 tool. Còn đường của router giữ trên 83%, vì từ góc nhìn của model mọi thứ ổn định: nó luôn chỉ chọn trong một nhúm tool, dù catalog thật có tới hàng trăm.
Biểu đồ bên phải, time to first token, kể cùng một câu chuyện. Đường fat agent chậm dần khi thêm tool schema. Ở các catalog lớn, model tốn một khoảng thời gian đáng kể chỉ để xử lý prompt. Còn với router, đường gần như phẳng, vì kích thước prompt được kiểm soát.
Ankush chốt bài học cốt lõi của benchmark: catalog có thể lớn lên, nhưng working set của model phải luôn nhỏ.
11. Pattern ba bước để implement
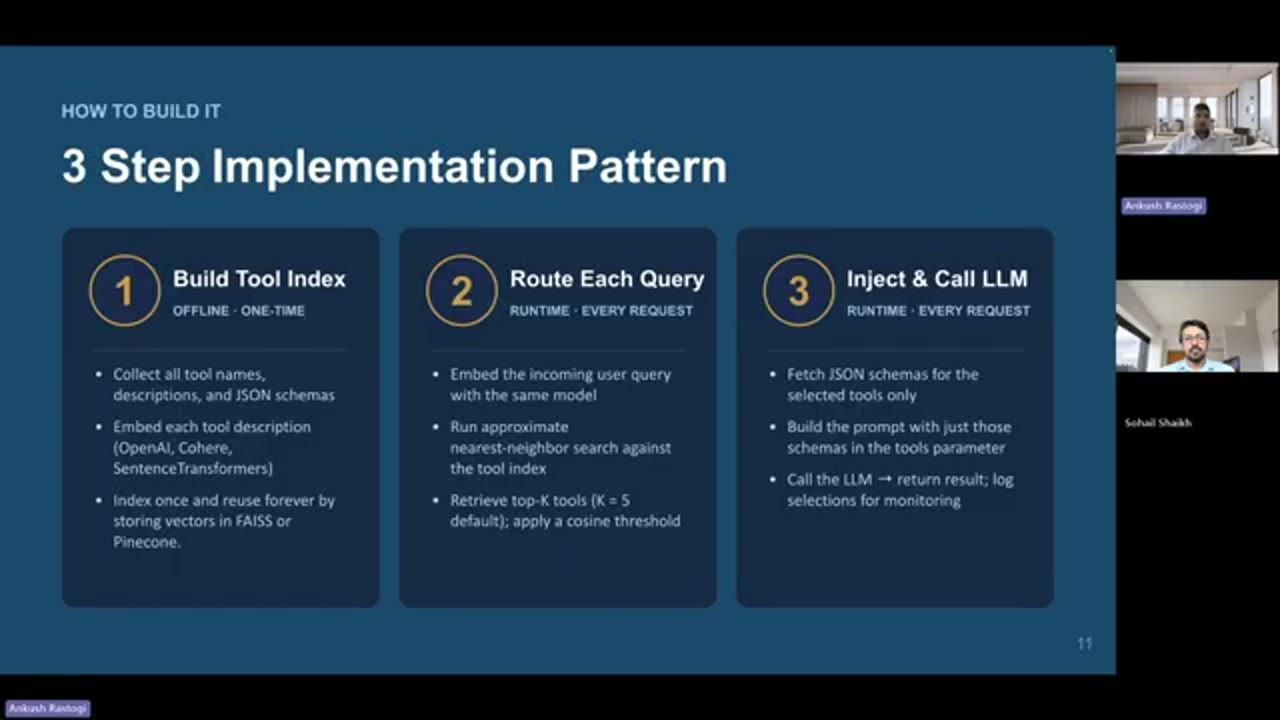
Ankush chuyển sang implementation pattern, gồm ba bước.
Bước một chạy offline. Build một catalog tool. Với mỗi tool, lưu name, description và schema, rồi embed description và lưu vào một vector database. Bạn có thể dùng ChromaDB, Pinecone hay Qdrant, vector database nào bạn đang dùng cũng được.
Bước hai xảy ra ở mọi request. Embed câu hỏi của user, chạy nearest neighbor search, và trả về top K tool.
Bước ba cũng xảy ra ở mọi request. Fetch schema của những tool được chọn, chỉ đưa những schema đó vào lời gọi model, và log lại tool nào đã được chọn.
Ankush nhấn mạnh rằng logging ở đây thực sự quan trọng. Giả sử router bỏ sót một tool, và bạn muốn sửa lại description hoặc chỉnh K: bạn cần một hệ thống logging tốt để dựa vào. Overhead lúc runtime rất nhỏ, chỉ một lần gọi embedding và một lần vector search. Đổi lại là prompt nhỏ hơn nhiều và việc chọn tool ổn định hơn.
12. Semantic router bằng Python trong vài dòng
Sohail tiếp lời: sau khi đã hiểu implementation pattern, anh đi qua phiên bản code, và nó khá thẳng thắn. Ban đầu, bạn loop qua catalog tool, và với mỗi tool, như Ankush đã nói, embed description rồi lưu vào vector database cùng tên tool và các chi tiết khác.
Lúc runtime, embed câu hỏi của user, so sánh vector của câu hỏi với các vector tool đã lưu bằng cosine similarity hoặc vector search, lấy ra những tool liên quan nhất, rồi gọi model chỉ với các schema đó trong tham số function hoặc tool. Dòng cuối cùng là phần quan trọng nhất, vì model không nhận tất cả tool, nó chỉ nhận những tool đã được route.
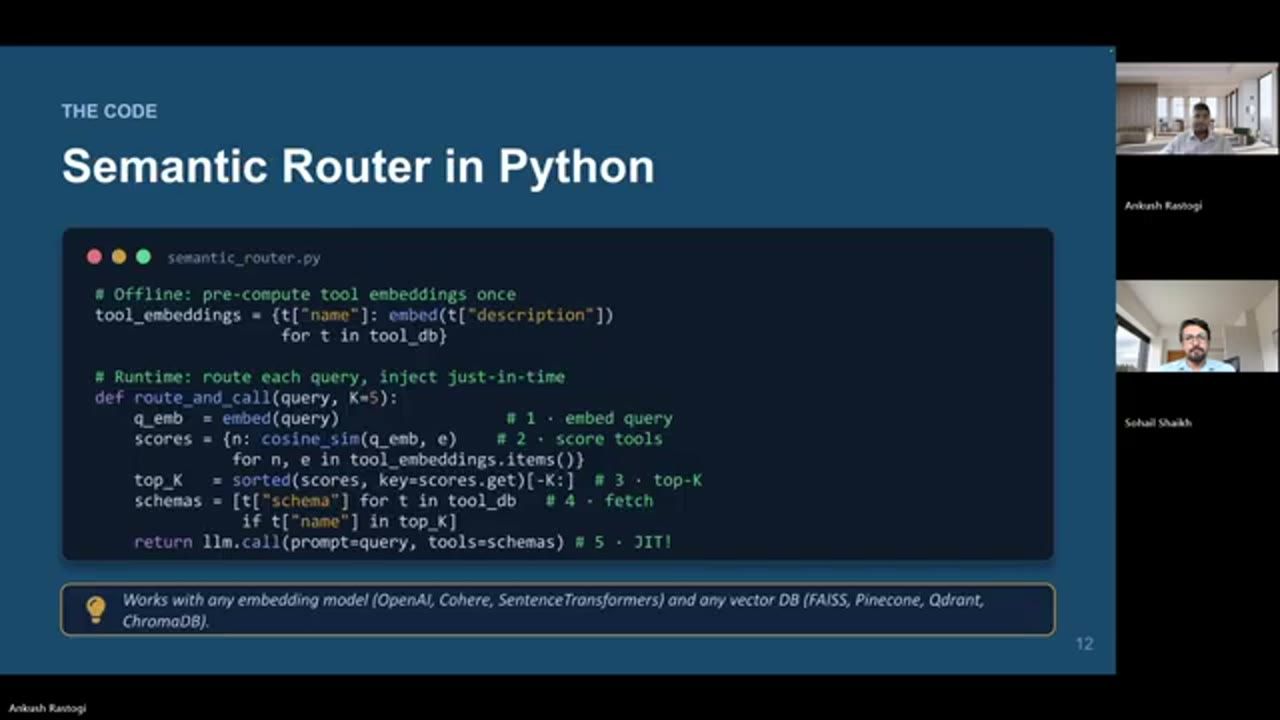
# Offline: pre-compute tool embeddings once
tool_embeddings = {t["name"]: embed(t["description"])
                   for t in tool_db}

# Runtime: route each query, inject just-in-time
def route_and_call(query, K=5):
    q_emb  = embed(query)                          # 1 · embed query
    scores = {n: cosine_sim(q_emb, e)              # 2 · score tools
              for n, e in tool_embeddings.items()}
    top_K  = sorted(scores, key=scores.get)[-K:]   # 3 · top-K
    schemas = [t["schema"] for t in tool_db        # 4 · fetch
               if t["name"] in top_K]
    return llm.call(prompt=query, tools=schemas)   # 5 · JIT!
Cách này chạy với bất kỳ embedding model nào và với bất kỳ vector database nào. Như Ankush đã nói, bạn có thể bắt đầu với Qdrant hoặc một vector database khác chạy local, rồi chuyển sang một vector store managed sau nếu cần. Và nếu bạn đã có hạ tầng RAG, như hai anh nói từ trước, đây không phải hạ tầng mới: nó chính là pattern retrieval cũ, áp vào việc chọn tool.
Đoạn code trên là pseudocode: embed, cosine_sim và llm.call là chỗ bạn gắn embedding model, hàm tính similarity và SDK của LLM mình đang dùng. Với catalog lớn, phần tính score cho mọi tool trong vòng lặp thường được thay bằng một truy vấn nearest neighbor vào vector database.
13. Agent 200 tool với hai câu hỏi
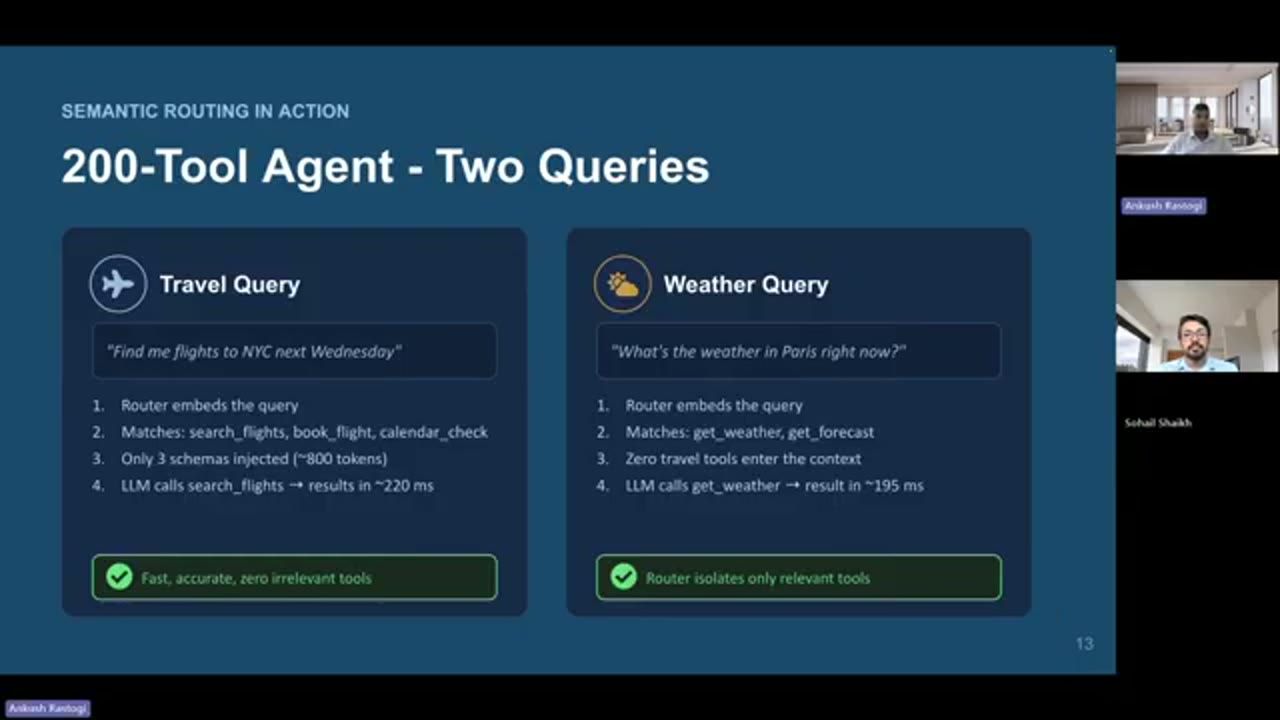
Ankush cảm ơn Sohail rồi cho xem semantic routing trong thực tế. Hình dung bạn có một agent 200 tool. User hỏi: "Find me a flight to New York next Wednesday" (tìm cho tôi một chuyến bay tới New York vào thứ Tư tuần sau). Router embed câu hỏi đó và trả về các tool như search flights, book flight, calendar check. Model chỉ nhìn thấy những schema liên quan đó, nên khả năng nó gọi đúng tool cao hơn nhiều.
Nhưng nếu ta nạp cả 200 tool, thì tool khách sạn, tool thời tiết, tool email, tool SQL hay bất kỳ tool workflow không liên quan nào cũng sẽ tranh giành sự chú ý của model. Đó chính là lúc model bắt đầu chọn sai function.
Câu hỏi thứ hai: "What is the weather in Paris right now?" (thời tiết ở Paris lúc này thế nào?). Router trả về get weather và get forecast. Tool chuyến bay không được inject. Tool khách sạn không được inject. Ở request này, chúng đơn giản là không tồn tại.
Ankush chỉ ra một lợi ích hay bị đánh giá thấp: router không chỉ thêm tool đúng vào, nó còn loại tool sai ra khỏi tập lựa chọn của model.
14. Checklist sáu bước để đưa vào production
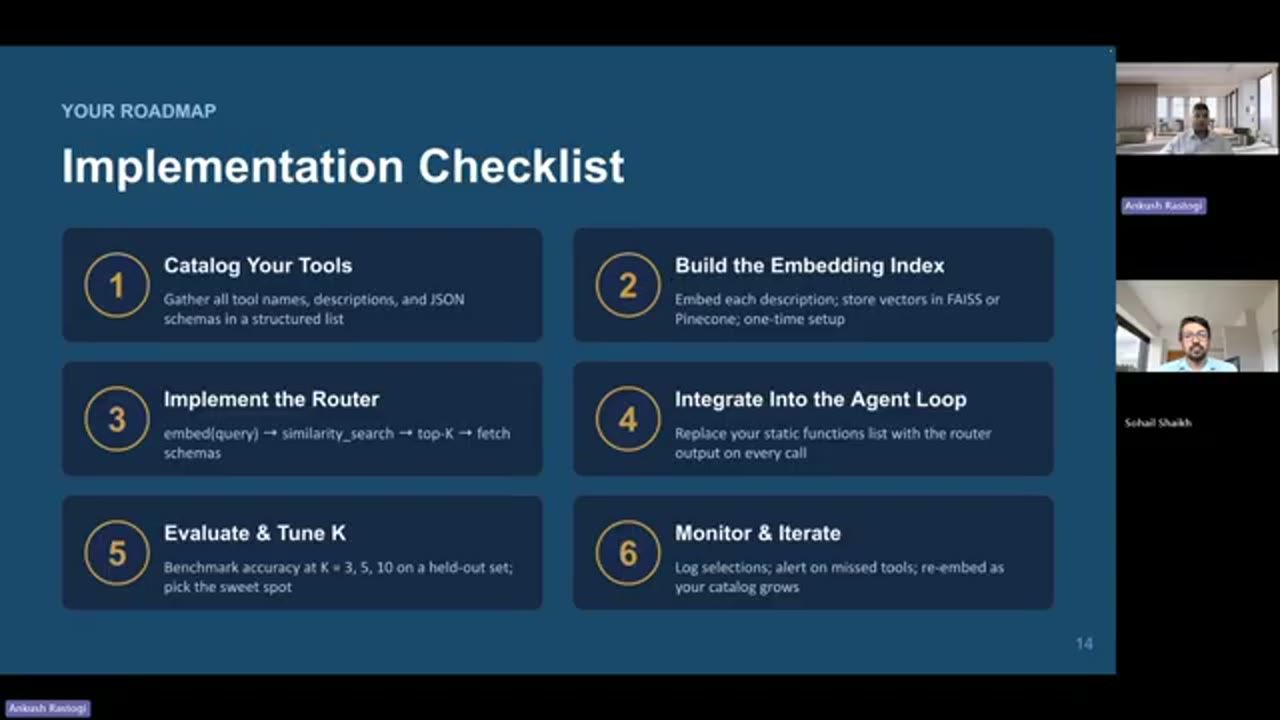
Slide tiếp theo là implementation checklist, một checklist production cho ai muốn làm theo.
- Catalog tool ở một chỗ. Với mỗi tool, ghi name, description, schema, owner và version.
- Build index. Embed từng description và lưu các vector.
- Viết router. Embed câu hỏi, search index, lấy top K và fetch schema.
- Nối vào agent loop. Danh sách tool của model phải đến từ router, không phải từ một catalog đầy đủ hard-code.
- Evaluate. Chạy test set ở K bằng ba, năm và mười, rồi chọn K nhỏ nhất đạt được accuracy target.
- Monitor production. Log tool được chọn, tool call cuối cùng, failure và việc dùng fallback. Re-embed tool khi description hoặc schema thay đổi.
Ankush kết luận: đây không phải một cuộc viết lại platform kéo dài sáu tháng. Với phần lớn team, đó chỉ là một sprint tập trung.
15. Cộng đồng đã đụng cùng một bức tường
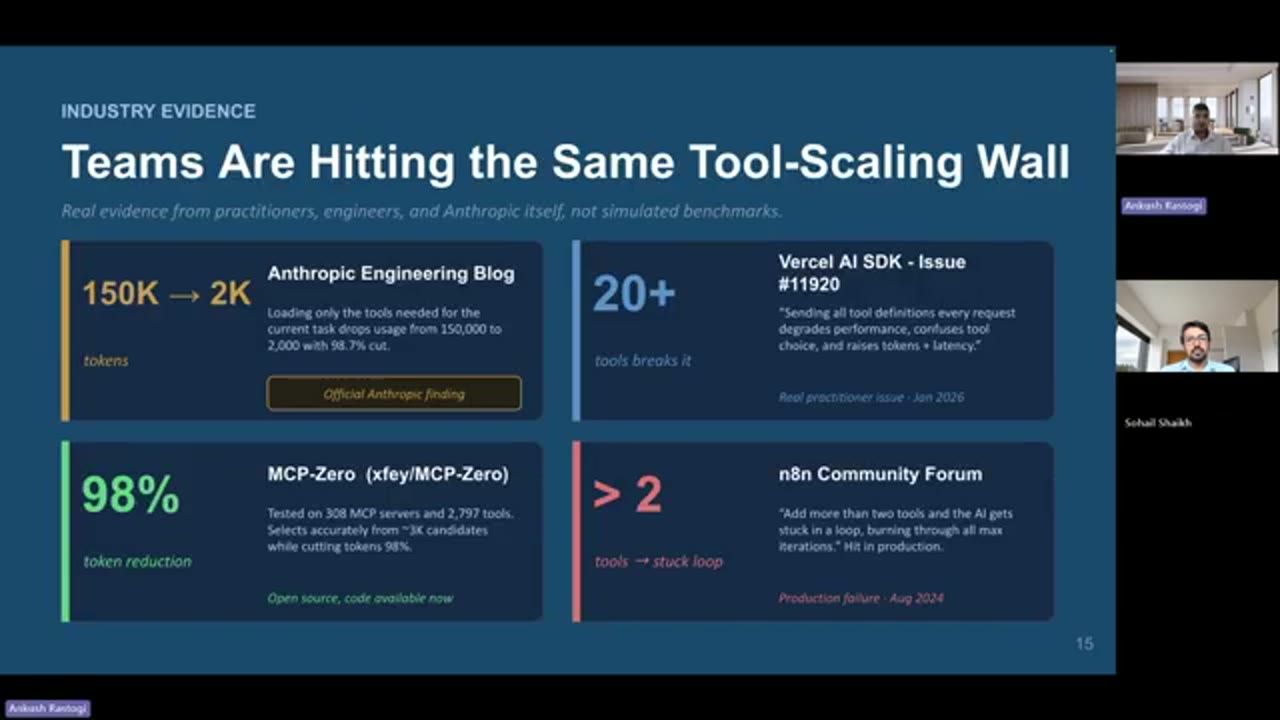
Slide tiếp theo nói về những gì cộng đồng đã xác nhận, để cho thấy đây không chỉ là quan sát của riêng hai anh. Anthropic đã công bố cơ chế nạp tool theo nhu cầu với MCP và báo cáo lượng token giảm từ 150K xuống 2K, một mức giảm rất lớn.
Developer cũng đã nêu những vấn đề tương tự trong các project agent và SDK phổ biến, chỉ ra rằng việc gửi toàn bộ định nghĩa tool ở mọi request có thể làm tăng latency, tăng token và khiến model nhầm tool. Các project open source như MCP-Zero cũng đã thử routing ở quy mô rất lớn, gồm hàng nghìn tool trải trên nhiều server. Và bạn có thể tìm thấy các bài trên forum của những người build đã gặp chuyện nhầm tool chỉ với vài tool, từ rất lâu trước khi chạm mốc một trăm.
Thông điệp ở đây: nếu agent của bạn bắt đầu hỏng khi thêm tool, điều đó không tự động có nghĩa là prompt của bạn tệ. Có thể là kiến trúc đang bắt model giải sai bài toán.
16. Bộ starter kit open source
Hai anh giới thiệu những project open source mình đã tìm thấy. Một trong số đó là project semantic router open source của Aurelio Labs, bạn có thể dùng để test local và benchmark. ToolBench và Berkeley Function Calling Leaderboard cũng là những điểm khởi đầu hữu ích. Còn để có hướng dẫn thực tế, hãy đọc bài viết về MCP của Anthropic: nó giải thích vì sao nạp tool theo nhu cầu lại quan trọng và là một tín hiệu thực tế mạnh cho kiến trúc này.
Ý chính là bạn không cần phát minh lại cả hệ sinh thái từ đầu, các mảnh ghép đã có sẵn. Slide chuyển hơi chậm ("next slide... sorry, here it is"), rồi phần trade-off bắt đầu.
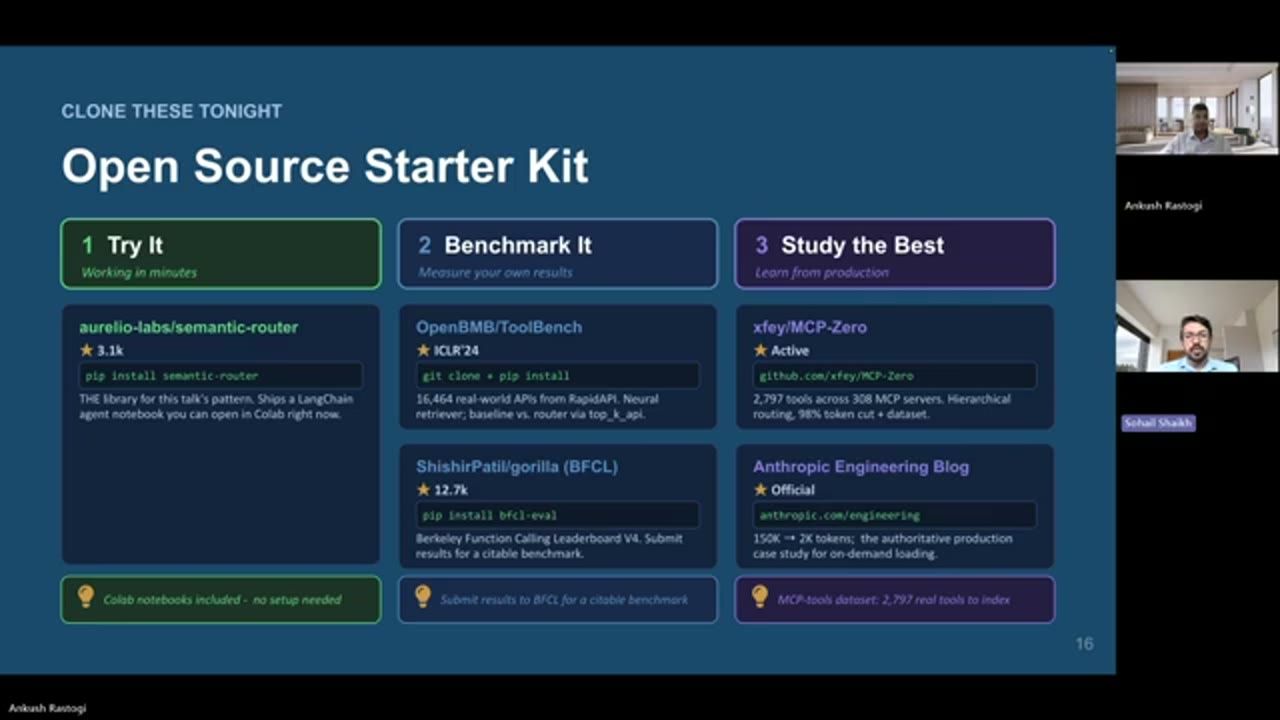
pip install semantic-router), thư viện đúng với pattern của talk, kèm notebook agent LangChain mở thẳng trên Colab. Benchmark It: OpenBMB/ToolBench (ICLR'24), 16.464 API thật từ RapidAPI, có neural retriever, so baseline với router qua top_k_api; ShishirPatil/gorilla (BFCL, khoảng 12,7k sao, pip install bfcl-eval), Berkeley Function Calling Leaderboard V4, nộp kết quả để có benchmark trích dẫn được. Study the Best: xfey/MCP-Zero, 2.797 tool trên 308 MCP server, routing phân cấp, giảm 98% token, kèm dataset; Anthropic Engineering Blog, 150K xuống 2K token, case study production về on-demand loading.17. Trade-off và best practice
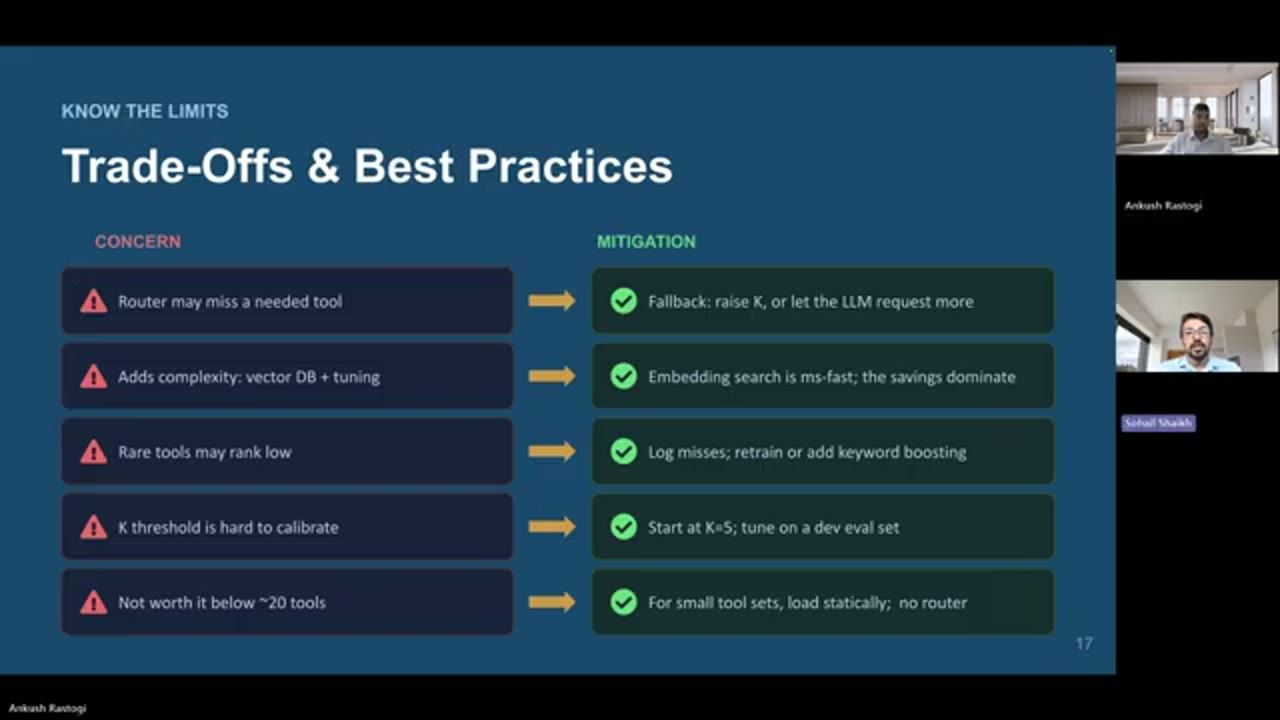
Cách làm này cũng có những trade-off riêng.
Rủi ro thứ nhất là router miss. Router có thể không retrieve được tool mà model cần. Cách xử lý là một fallback: nếu model không hoàn thành được task, bạn có thể nới rộng K, chạy một lượt retrieval thứ hai, hoặc route sang một nhóm tool rộng hơn.
Rủi ro thứ hai là tool description yếu. Nếu description mơ hồ, embedding cũng sẽ yếu. Hãy viết description bằng chính những từ user thật sự dùng, và đưa vào đó intent, action cùng các entity chính.
Rủi ro thứ ba là tool hiếm. Có những tool sẽ không bao giờ đạt score cao trừ khi description của chúng chứa đúng ngôn ngữ. Bạn cần monitor các lần trượt và viết lại description cho phù hợp.
Và cuối cùng, đừng over-engineer hệ thống nhỏ. Nếu bạn có mười hay mười lăm tool, nạp tĩnh vẫn có thể ổn. Routing thường chỉ đáng giá khi catalog đủ lớn để kích thước prompt, latency hay chuyện nhầm tool trở thành vấn đề production thật.
18. Năm takeaway, tài liệu tham khảo và lời chào
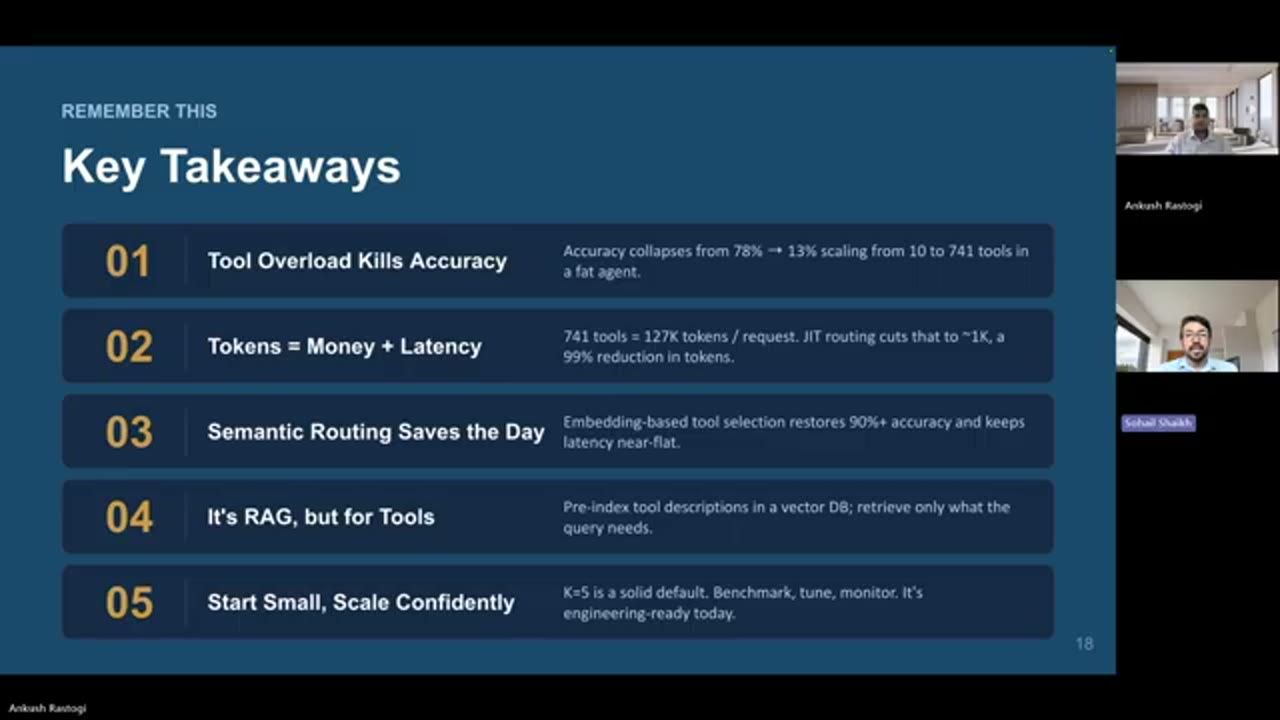
Phần tổng kết gồm vài takeaway. Thứ nhất, như đã bàn, tool overload làm hại accuracy: nạp mọi schema vào mọi prompt khiến quyết định của model khó hơn khi catalog lớn lên. Thứ hai là về token: token vừa là cost vừa là latency. Catalog tool lớn có thể thêm hàng chục nghìn token trước khi request thật của user được xử lý. Thứ ba, semantic routing giúp sửa vấn đề đó: khi catalog lớn, model chỉ nhìn thấy những tool liên quan tới câu hỏi hiện tại. Thứ tư, về bản chất đây là RAG cho tool: index description cho đúng, retrieve lúc runtime, và chỉ inject thứ cần thiết. Và cuối cùng, bắt đầu đơn giản: dùng K bằng năm làm điểm khởi đầu, log mọi quyết định, evaluate trên một test set thật, và cải thiện tool description dần dần khi thấy tool sai bị chọn.
Mục tiêu không phải là làm cho agent phức tạp hơn. Mục tiêu là ngừng bắt model phải reasoning qua những tool không liên quan.
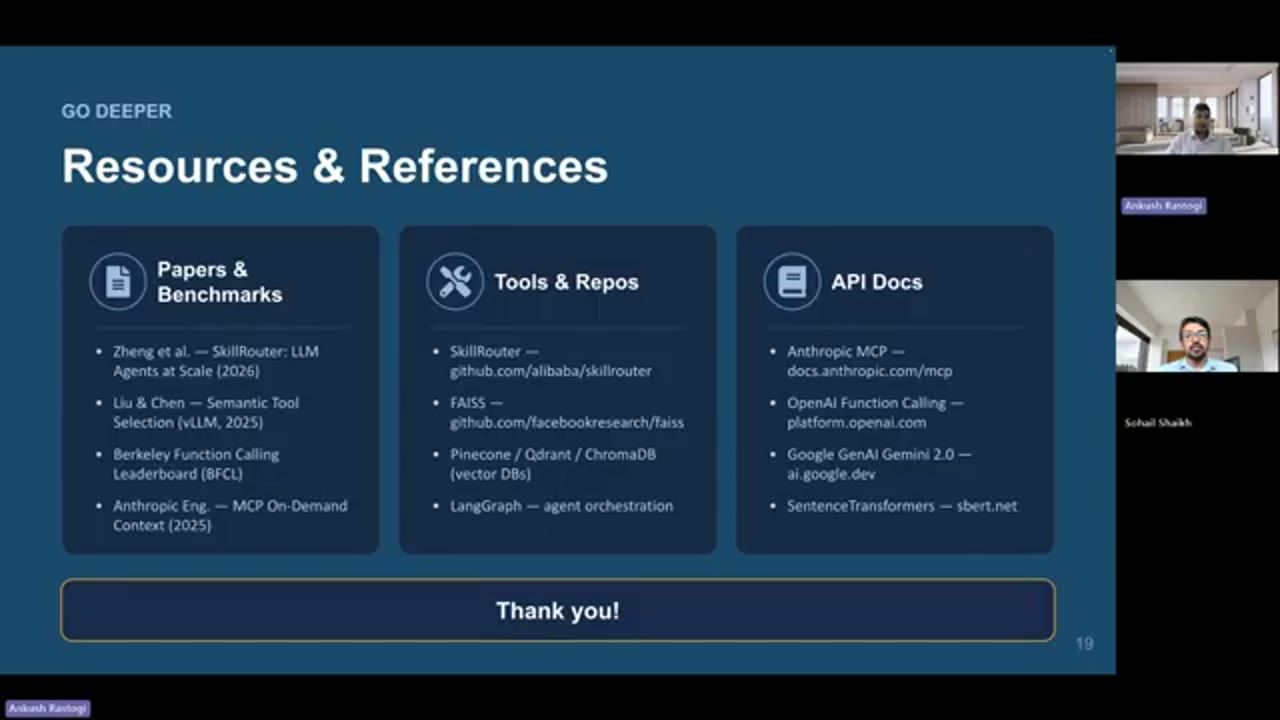
Hai anh để lại một slide tài liệu tham khảo cho ai đang build: các thư viện semantic routing, ToolBench, Berkeley Function Calling Leaderboard, bài viết về MCP của Anthropic, và các vector store như Pinecone, Qdrant.
Hai anh cảm ơn mọi người đã xem. Nếu talk này hữu ích, hãy chia sẻ nó cho ai đó đang build agent: họ hoặc đã đụng phải bức tường này, hoặc sắp đụng. Người xem có thể quét QR code LinkedIn trên slide cuối để kết nối; hai anh sẵn lòng tiếp tục trao đổi, chia sẻ tài liệu, hoặc nghe cách người khác đang giải bài toán này trong hệ thống của họ. "Tôi là Ankush, đây là Sohail. Cảm ơn mọi người rất nhiều."
Nguồn và link
- Trang talk chính thức trên ai.engineer · Video gốc
- Prosodica, nơi hai diễn giả làm việc: prosodica.com
- Anthropic Engineering, Code execution with MCP (150.000 xuống 2.000 token, giảm 98,7%): anthropic.com/engineering/code-execution-with-mcp · Model Context Protocol: modelcontextprotocol.io
- Semantic Router của Aurelio Labs: github.com/aurelio-labs/semantic-router
- ToolBench: github.com/OpenBMB/ToolBench
- Gorilla và Berkeley Function Calling Leaderboard: github.com/ShishirPatil/gorilla · gorilla.cs.berkeley.edu/leaderboard.html
- MCP-Zero: github.com/xfey/MCP-Zero
- Vercel AI SDK, issue #11920 "Dynamic Tool Selection to Reduce Context Pollution": github.com/vercel/ai/issues/11920
- Lost in the Middle: How Language Models Use Long Contexts (Liu và cộng sự, 2023): arxiv.org/abs/2307.03172
- Vector database và embedding: FAISS · Pinecone · Qdrant · Chroma · SentenceTransformers
- Sohail Shaikh trên GitHub: github.com/Sohail-Sh · Ankush Rastogi trên GitHub: github.com/ankushrastogi04 · LinkedIn: linkedin.com/in/sohail-shaikh, linkedin.com/in/ankushrastogi
Related talks
Voice In, Visuals Out: The Agony and the Ecstasy
Allen Pike · Forestwalk Labs · 13 min
Vì sao voice-in, visuals-out là UX tốt nhất cho AI, và ba trụ cột giữ phản hồi dưới một giây: model nhanh, inference chu kỳ ngắn, prefix caching ổn định.
The Future Is Domain-Specific Agents
Justin Schroeder · StandardAgents · 31 min
Composition over inheritance cho agent: thay vì nhồi MCP và skill vào một agent lớn, ghép nhiều agent nhỏ theo domain, tiết kiệm token, dùng được small model.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.