Memory wall: vì sao LLM và AI accelerator bị nghẽn ở bộ nhớ
Memory wall, arithmetic intensity và roofline model: tính ridge point của B200, vì sao decode bị memory bound còn prefill compute bound, và batching giúp ra sao.
✓ Đã duyệt độc lập · cập nhật 22/10/2026 · 12 min
1. Chip nhanh hơn hàng nghìn lần, workload không nhanh theo
Kaoutar El Maghraoui (trên màn hình ghi Principal Research Scientist, IBM) mở đầu bằng một con số: trong hai thập kỷ qua, khả năng tính toán (compute) của một con chip đơn lẻ đã tăng khoảng 6.000 lần (theo video đăng ngày 18/10/2026). Nghe vậy, bạn sẽ kỳ vọng các workload của mình cũng chạy nhanh hơn theo. Nhưng thực tế không phải vậy.
Chị kể: các kỹ sư, khi profile workload của mình, thường không thấy khác biệt hiệu năng bao nhiêu. Còn những con chip kia thì phần lớn thời gian ngồi không (idle), chờ dữ liệu được đưa lên từ bộ nhớ. Hiện tượng đó có tên: the memory wall, bức tường bộ nhớ.
2. Ba câu hỏi mà memory wall trả lời
Theo Kaoutar, nếu công việc của bạn là build, train hay serve model, thì ý tưởng này giải thích được ba điều:
- Vì sao workload hay AI model của bạn không chạy nhanh gấp đôi khi số FLOPs của chip tăng gấp đôi.
- Vì sao batching giúp ích ở một số workload, nhưng ở workload khác thì không.
- Vì sao các AI accelerator được thiết kế theo cách mà chúng đang được thiết kế.
3. Hai đường tăng trưởng: compute và memory bandwidth
Chị vẽ lên bảng một biểu đồ tăng trưởng theo thang log (growth, log scale), trục ngang từ 2006 tới 2026, đúng hai mươi năm chị quan tâm. Trong khoảng thời gian đó, có hai đại lượng tăng lên với hai tốc độ khác nhau.
Đại lượng thứ nhất là compute, đo bằng FLOPs per second. Kaoutar lấy ví dụ: GPU của NVIDIA vào khoảng đầu năm 2006 chạy ở mức chừng vài trăm tỷ phép tính mỗi giây. Còn khi nhìn tới B200 năm 2025, con chip này làm được khoảng 2.000 nghìn tỷ phép tính mỗi giây. Tính ra, mức tăng là vào khoảng 6.500 lần (các con số phần cứng này theo video đăng ngày 18/10/2026).
Cùng lúc đó, trong cùng khoảng thời gian, đại lượng thứ hai cũng tăng: memory bandwidth, đo bằng byte mỗi giây. Nhưng như trên bảng, đường này tăng chậm hơn nhiều so với compute. Và khoảng cách giữa hai đường cứ ngày càng rộng ra. Chị nói khoảng cách đó vào chừng "7x"; trên bảng, chữ viết ở giữa hai đường là "70x". Theo Kaoutar (video đăng ngày 18/10/2026), chính khoảng cách này là cái được gọi là memory wall.
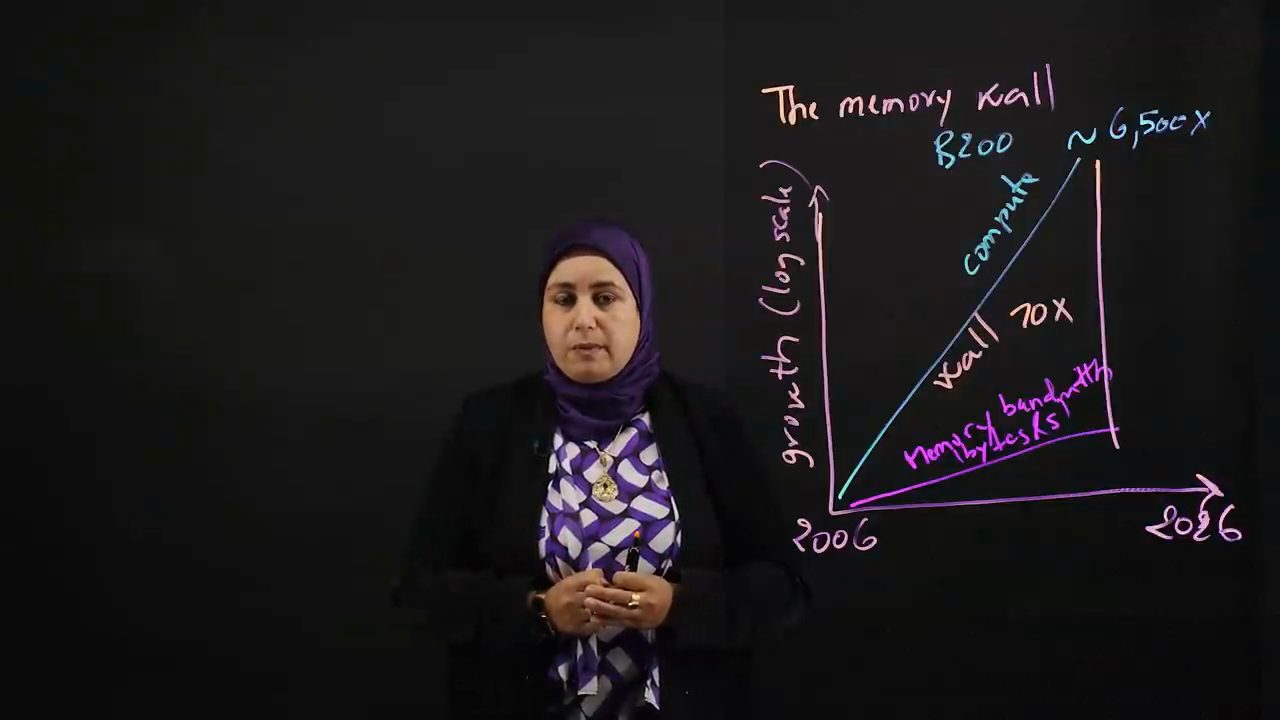
4. Arithmetic intensity: FLOPs trên mỗi byte
Từ đó, Kaoutar rút ra: một con chip nhanh hơn không nhất thiết đồng nghĩa với workload nhanh hơn, nhất là khi chúng ta không đưa dữ liệu vào cho nó kịp với tốc độ nó cần. Đó là toàn bộ ý tưởng đằng sau memory wall. Thêm compute không tự động cải thiện hiệu năng.
Lý do, theo chị, nằm ở một tỷ số duy nhất gọi là arithmetic intensity. Arithmetic intensity được định nghĩa là số phép toán bạn thực hiện trên mỗi đơn vị byte, tức là FLOPs per byte.
- Nếu bạn làm được rất, rất nhiều phép toán trên mỗi byte dữ liệu chuyển từ bộ nhớ lên, bạn đang ở vùng gọi là compute-bound (bị giới hạn bởi khả năng tính toán).
- Nếu bạn không làm được nhiều phép toán trên mỗi byte di chuyển, tức là bạn làm ít phép toán hơn hẳn so với lượng dữ liệu kéo từ bộ nhớ, bạn đang ở vùng memory-bound (bị giới hạn bởi bộ nhớ).
5. Vẽ roofline model
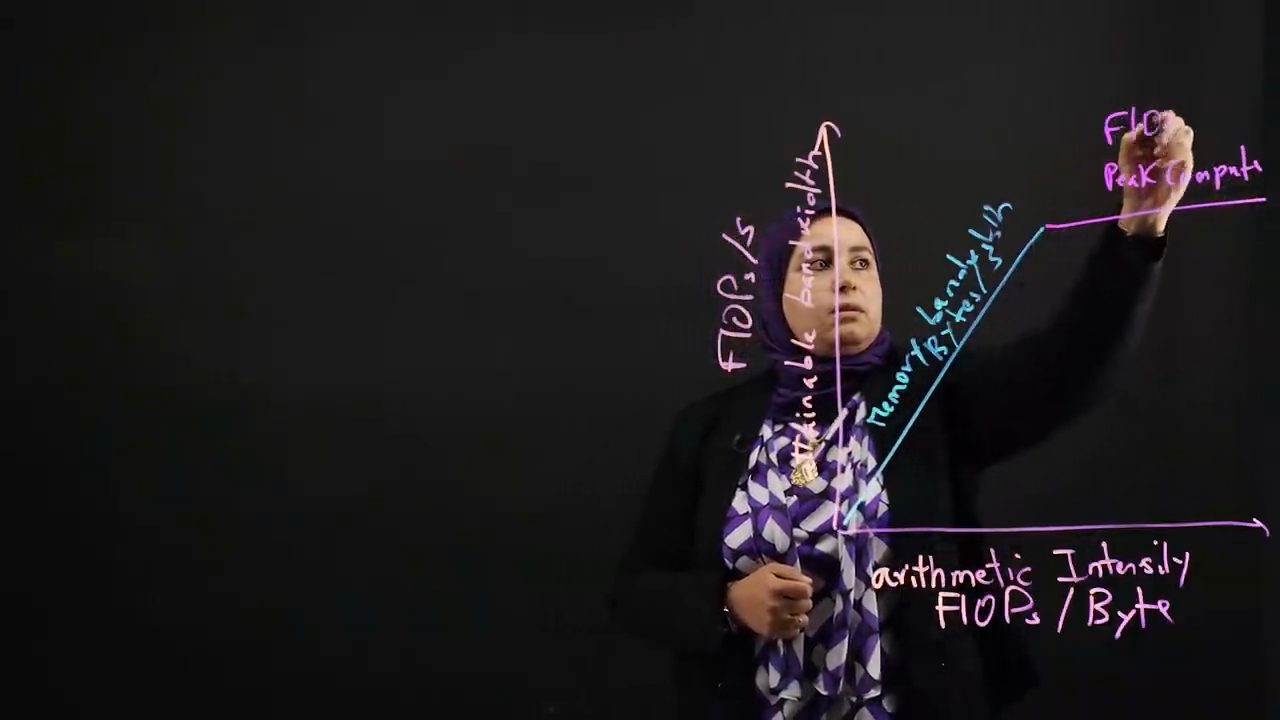
Để thấy rõ hơn, Kaoutar vẽ một mô hình gọi là roofline model. Trục ngang (x-axis) là arithmetic intensity, đo như chị vừa nói bằng FLOPs per byte, tức số FLOPs chia cho số byte. Trục dọc (y-axis) chị gọi là attainable bandwidth, đo bằng FLOPs per second.
Lên trên đó, chị vẽ đúng hai đại lượng đã vẽ ở biểu đồ trước:
- Memory bandwidth, đo bằng byte mỗi giây: một đường xiên đi lên từ gốc toạ độ.
- Peak compute, lại đo bằng FLOPs per second: một đường nằm ngang ở phía trên.
Chị nhấn mạnh một điểm: thứ được đo trên trục ngang là một thuộc tính của workload (workload property), không phải của chip.
6. Ridge point và giới hạn vật lý của chip
Hai đường đó cắt nhau tại một điểm gọi là ridge point. Kaoutar đưa ví dụ: với một GPU B200, giá trị ridge point là 281 (chị đọc là "281 flops per second", trên bảng ghi "281 F/s"; con số và cách tính theo video đăng ngày 18/10/2026). Đây là một thuộc tính của con chip.
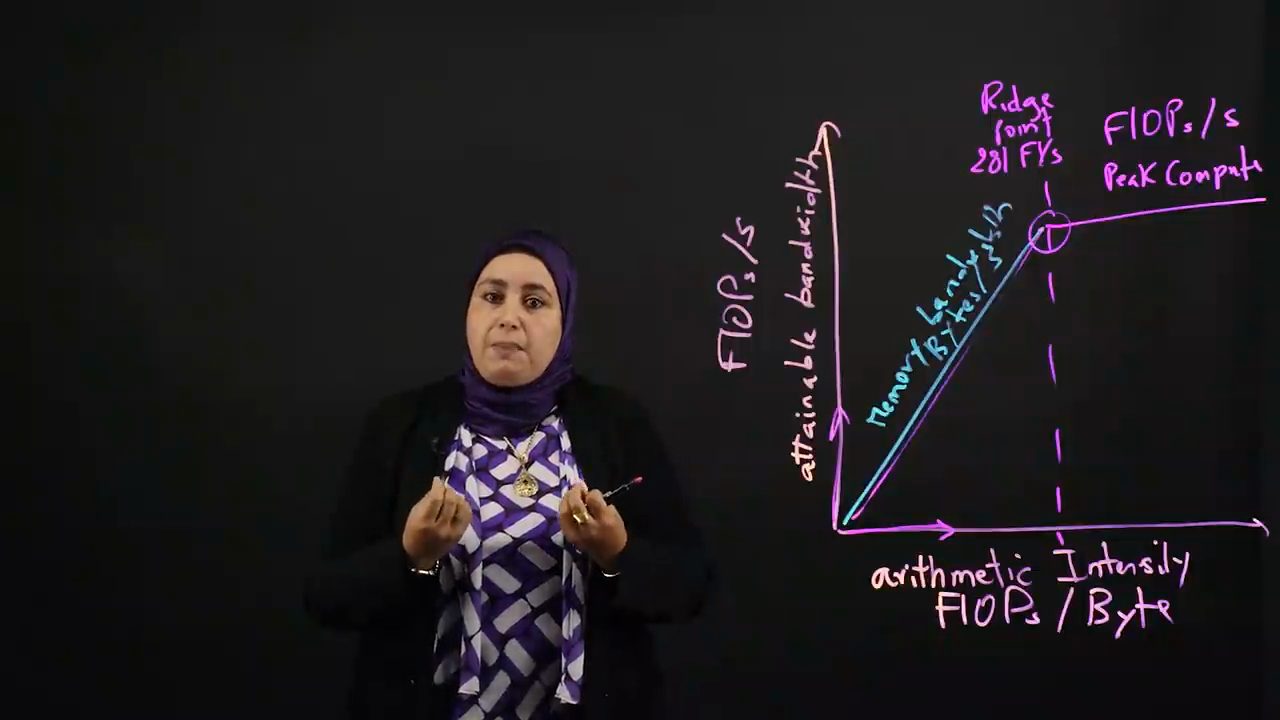
Chị giải thích hai phần của biểu đồ: đoạn nằm ngang là peak compute mà con chip làm được, còn đoạn xiên chính là memory bandwidth của bạn. Ý tưởng là: nếu bạn cải thiện arithmetic intensity, bạn cũng cải thiện attainable bandwidth, tức là số FLOPs con chip làm được mỗi giây. Nhưng càng tiến gần tới ridge point, bạn càng bắt đầu chạm vào giới hạn vật lý của những gì con chip làm được, về cơ bản là peak bandwidth của chip.
Vì vậy, khi tính arithmetic intensity, một đặc tính phụ thuộc vào workload, bạn cần so nó với ridge point, xem nó nằm ở đâu so với điểm đó.
7. Con số 281 của B200 đến từ đâu
Kaoutar quay lại xem con số 281 ở đâu ra. Theo spec mà chị dùng (video đăng ngày 18/10/2026), một GPU B200 có peak compute khoảng 2,25 petaFLOPs mỗi giây, còn bộ nhớ đạt 8 terabyte mỗi giây. Chị tính ridge point bằng cách lấy 2,25 petaFLOPs chia cho 8 terabyte mỗi giây, và ra khoảng 281.
Trên bảng, kết quả được ghi là "281 FLOPs/s", đúng như chị đọc.
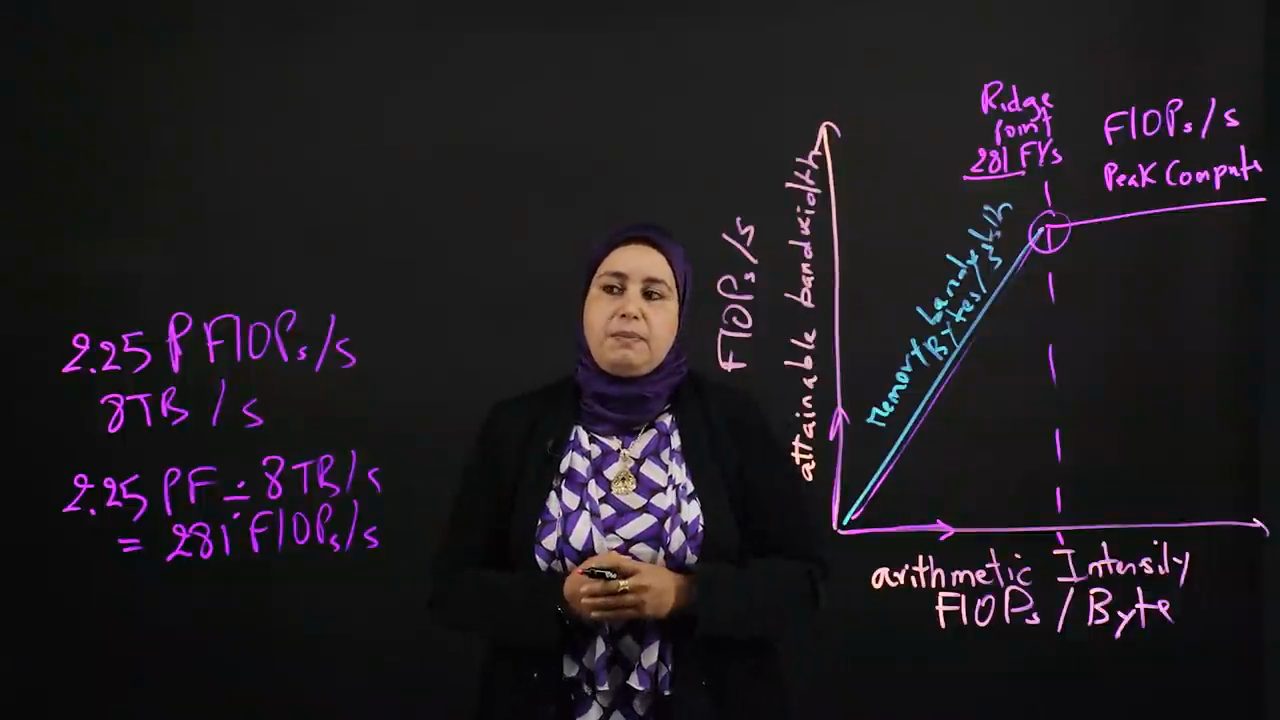
Chị thêm một lưu ý nhỏ (video đăng ngày 18/10/2026): trên spec GPU của NVIDIA, con số ghi là 36 petaFLOPs mỗi giây, nhưng đó là cho 8 GPU, và cũng là con số cho BF16 ở dạng sparse. Nên cách làm là chia đôi con số đó, rồi chia tiếp cho 8, ra xấp xỉ 2,25: đó là con số bạn cần cho một chip GPU đơn lẻ. Và từ đó mới có con số 281.
Đối chiếu với trang HGX của NVIDIA (đọc ngày 22/10/2026): cấu hình HGX B200 gồm 8 GPU Blackwell SXM, dòng FP16/BF16 Tensor Core ghi 36 PFLOPS, kèm chú thích đó là spec sparse và spec dense bằng một nửa.
8. Đọc biểu đồ: memory bound hay compute bound
Vậy điều này có nghĩa gì với workload của bạn? Kaoutar đọc biểu đồ:
- Nếu arithmetic intensity của workload nằm ở vùng bên trái ridge point, bạn memory bound: bạn không xử lý được nhiều phép toán như mong muốn trên mỗi byte bộ nhớ được di chuyển.
- Nếu arithmetic intensity lớn hơn ridge point, ở đây là con số 281, bạn compute bound.
Và cách đọc này cũng cho bạn biết workload cụ thể của mình đang vướng nút thắt cổ chai (bottleneck) nào.
9. Decode và prefill: hai giai đoạn của một LLM
Chị lấy hai ví dụ: giai đoạn decode và giai đoạn prefill trong một large language model.
Kaoutar giải thích: ở giai đoạn decode, chúng ta phải đọc một lượng lớn weights từ bộ nhớ để sinh ra từng token một, khi dùng batch size bằng 1. Vì thế, arithmetic intensity của decode thường nằm ở vùng tận cùng bên trái so với ridge point, và điều đó đặt bạn vào vùng memory bound. Đó là workload decode.
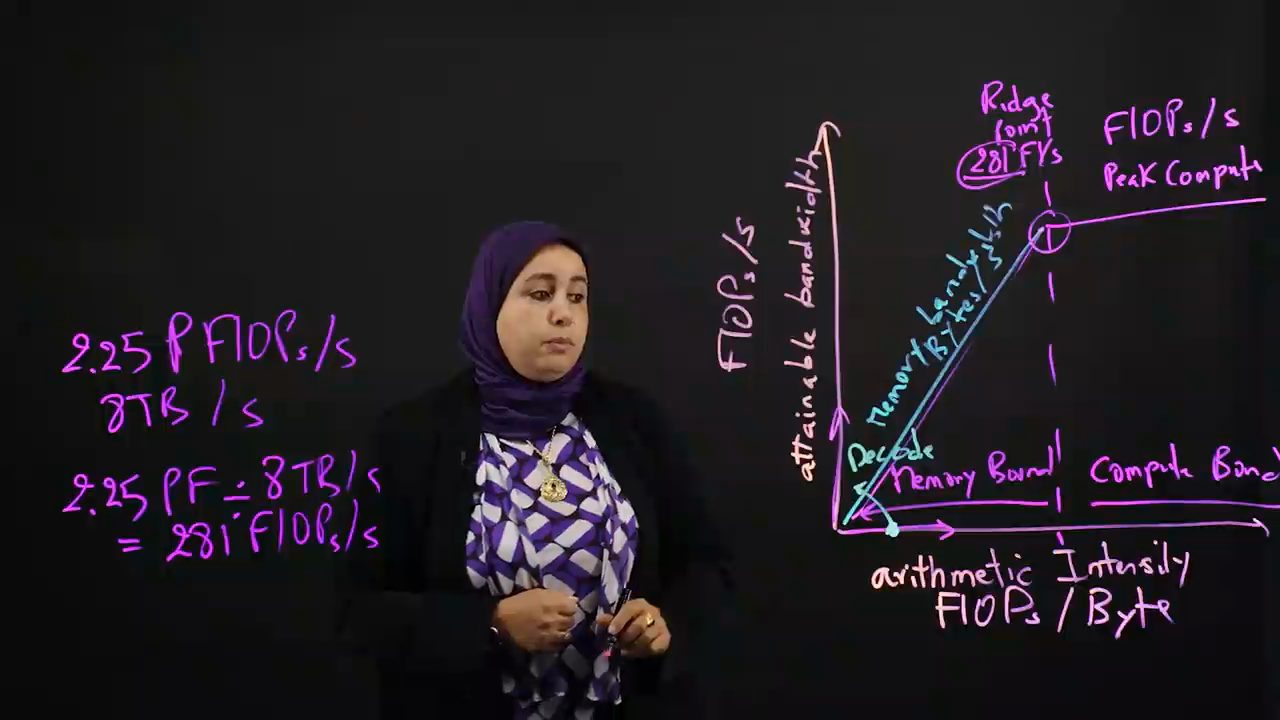
Còn prefill thì khác. Theo Kaoutar (video đăng ngày 18/10/2026), ở prefill, ta thực hiện những phép GEMM (nhân ma trận) lớn. Chị nói ở đây ta làm hơn một nghìn FLOPs, arithmetic intensity lớn hơn 1.000, trong khi ở decode, arithmetic intensity chỉ vào khoảng 1 (chị đọc cả hai con số với đơn vị "flops per second"; trên bảng, cạnh decode ghi "1 FLOP", còn mũi tên về bên phải ghi ">>1000 FLOPs"). Con số của prefill lớn hơn rất nhiều so với ridge point, và điều đó đặt prefill vào vùng compute bound.
Kết luận của chị: nếu bạn đang memory bound, thì dù có ném thêm compute vào workload cũng không giúp được bao nhiêu. Bạn cần đưa dữ liệu tới chip nhanh hơn.
10. Batching kéo decode về phía ridge point
Một kỹ thuật được dùng để giúp giải quyết vấn đề này là batching. Batching giúp dịch chuyển arithmetic intensity của bạn: nó tăng arithmetic intensity và đẩy nó lại gần ridge point hơn.
Batching làm gì? Nó cho phép bạn serve nhiều request cùng một lúc. Khi đó, bạn dùng lại cùng những weights đã nạp trong bộ nhớ nhiều lần để thực hiện nhiều lượt sinh token. Nói cách khác, bạn làm nhiều phép toán hơn hẳn với cùng một lượng bộ nhớ đã di chuyển. Điều đó cải thiện arithmetic intensity, đưa bạn lại gần ridge point, và cải thiện hiệu năng.
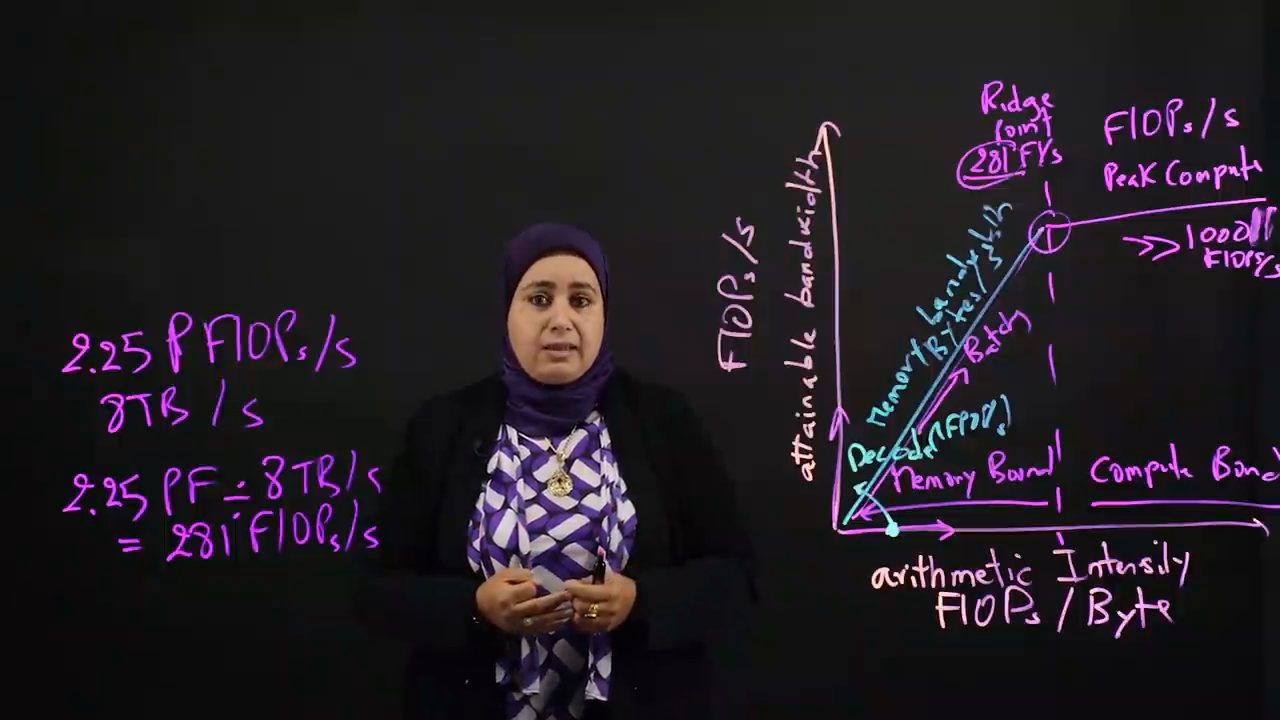
Theo Kaoutar (video đăng ngày 18/10/2026), đó là lý do nhiều môi trường LLM serving đã trưởng thành như vLLM, SGLang và TensorRT-LLM đều dùng batching và continuous batching để cải thiện hiệu năng.
11. Phần cứng không đổi, workload đổi
Kaoutar chỉ ra điều cần để ý trong ví dụ batching: con chip, tức phần cứng, vẫn giữ nguyên. Thứ thay đổi là workload. Chị gọi đây là một điểm rất quan trọng.
Arithmetic intensity cho bạn một đặc trưng của workload, cho bạn biết workload của mình nằm ở đâu so với ridge point. Nó cũng giúp giải thích bottleneck của bạn đến từ đâu: bạn cần ném thêm compute, hay bạn cần cải thiện phía bộ nhớ.
12. Tóm lại: ước lượng trước khi benchmark
Tổng kết lại, đó là memory wall. Ý chính, theo Kaoutar: để workload chạy nhanh hơn, chúng ta cần đưa dữ liệu tới chip nhanh hơn. Và có vài điều cần nắm:
- Trước khi benchmark, hãy ước lượng workload của bạn bằng arithmetic intensity để hiểu nó.
- Lấy từ spec sheet của phần cứng hai con số: peak memory bandwidth là bao nhiêu, và peak compute bạn có thể đạt là bao nhiêu.
- Dùng kỹ thuật roofline modeling như trên bảng để có ý niệm sơ bộ workload của mình đang nằm ở đâu.
Làm vậy, bạn hiểu mình cần tối ưu ở đâu, và nên dành thêm thời gian tối ưu workload vào chỗ nào. Chị cảm ơn mọi người đã xem.
Nguồn và liên kết 9 nguồn
- Tên gốc: The AI Memory Wall: Why LLMs & AI Accelerators Hit a Bottleneck
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=4b6KpFN7Rio youtube.com
- Kênh YouTube IBM Technology (Kaoutar El Maghraoui): youtube.com/channel/UCKWaEZ-_VweaEx1j62do_vQ youtube.com
- Trang IBM Research mà phần mô tả video dẫn tới để tìm hiểu thêm về memory wall, bài "Materials Design of Phase Change Memory for Analog In-Memory Computing Applications" (MRS Fall Meeting 2024): research.ibm.com/publications/... research.ibm.com
- Trang NVIDIA HGX, bảng spec có HGX B200 (8 GPU, FP16/BF16 Tensor Core 36 PFLOPS ở dạng sparse; đọc ngày 22/10/2026): nvidia.com/en-us/data-center/hgx nvidia.com
- vLLM: github.com/vllm-project/vllm github.com
- SGLang: github.com/sgl-project/sglang github.com
- TensorRT-LLM: github.com/NVIDIA/TensorRT-LLM github.com
Related talks
Tự fine-tune embedding model không khó như bạn nghĩ
Muhammad Farooq · Prompt Engineering · 13 min
Fine-tune EmbeddingGemma 2 bằng LoRA và Unsloth trên dữ liệu riêng: cặp câu hỏi và đoạn văn, in-batch negatives, chia test theo nguồn, đo cái giá.
Kimi K3.1 Pro trên KingBench 4: gần bằng Opus hay không
AICodeKing · AICodeKing · 14 min
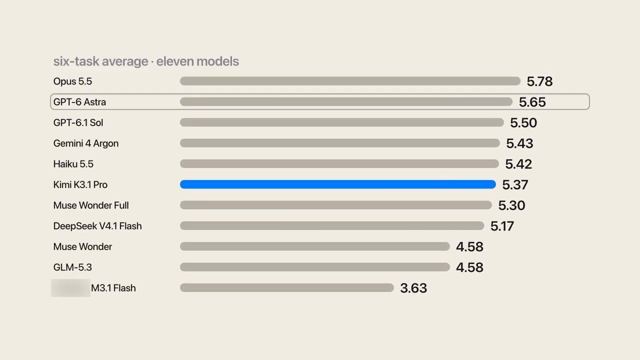
Chạy Kimi K3.1 Pro qua sáu task KingBench 4 bằng PandaCode: điểm từng project, bảng mười một model, chi phí $31.88 và open weights.
Không cần để laptop mở nữa: Codex giờ chạy trên cloud, trong Slack và cả trên điện thoại
Dominik Kundel · OpenAI · 22 min
OpenAI đưa Codex lên cloud, vào Slack, Teams, trình duyệt và terminal, để giao việc cho agent ở đâu cũng được mà không phải tự lo máy móc.