The Missing Layer After Launch
AI Engineer World's Fair 2026: Online Track · Video gốc
Sau khi ship agent: bốn operating agent (log-monitor, PR-review, session-analyzer, QA computer-use) giúp khép vòng loop, đo sức khoẻ và sửa lỗi production.
1. Bạn đã ship agent. Rồi sao nữa?
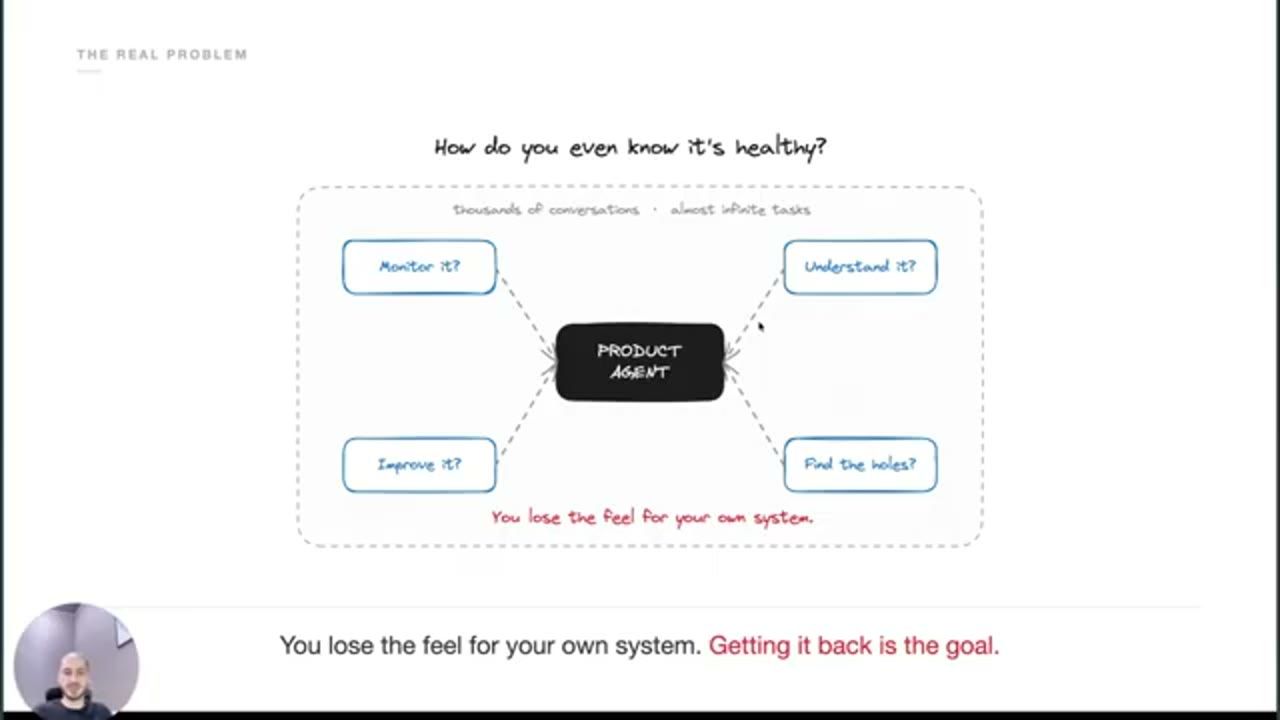
Raphael mở đầu bằng một kịch bản rất quen: bạn đã build một agent, bạn đã launch nó, mọi thứ chạy khá tốt trong demo, và ai cũng vui. Nhưng giờ anh muốn hỏi vài câu đơn giản. Làm sao bạn biết agent đó thật sự đang chạy tốt ngoài kia? Làm sao bạn theo dõi được hàng trăm, hàng nghìn cuộc hội thoại thật mỗi ngày? Làm sao bạn cảm nhận, hiểu được sức khoẻ (health) của hệ thống? Làm sao bạn làm nó tốt hơn? Và làm sao bạn tìm ra những lỗ hổng mà bạn còn chưa biết là chúng tồn tại?
Theo anh, đó chính là vấn đề. Phần lớn các talk về agent kết thúc đúng vào khoảnh khắc bạn ship: chúng tôi build nó, nó chạy, hết. Nhưng Raphael nghĩ rằng ship mới là lúc công việc thật sự bắt đầu. Vậy mà không hiểu sao chỉ có rất ít người nói về giai đoạn này. Anh gọi nó là "the missing layer", tầng còn thiếu, và cả talk là để đi sâu vào tầng đó.
2. Ship bây giờ là phần dễ
Anh mô tả thế giới chúng ta đang sống: bạn có thể tạo ra cả một sản phẩm, thậm chí cả một startup, trong vài ngày hoặc vài tuần. Bạn có thể viết hàng trăm nghìn dòng code. Bạn có thể tiêu rất nhiều token. Và thành thật mà nói, với sự trợ giúp của các model mới nhất, đó là phần dễ nhất hiện nay.
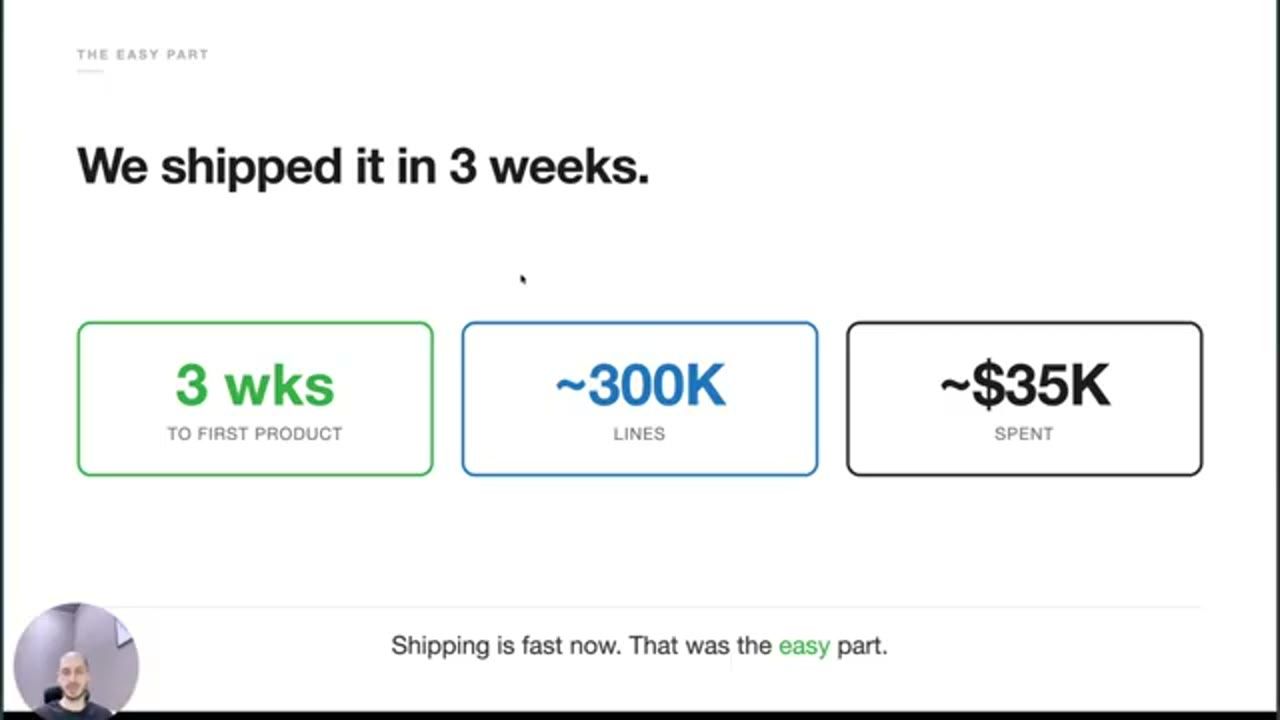
Nhưng anh nhắc lại: ship là lúc công việc thật sự bắt đầu, vì bạn cần khép vòng loop (close the loop) càng sớm càng tốt. Sau khi launch, bạn cần có một mức kiểm soát và hiểu biết nhất định về hệ thống. Từ kinh nghiệm của Raphael, vòng loop đó ít nhất cũng quan trọng ngang với chính sản phẩm, đôi khi còn quan trọng hơn, vì chính vòng feedback chặt (tight feedback) là thứ giúp bạn làm sản phẩm tốt hơn từng ngày. Đó là tầng còn thiếu, và phần còn lại của talk nói về nó.
3. Sau launch: những câu hỏi cũ, độ khó mới
Vậy điều gì xảy ra sau khi bạn launch? Anh nói thẳng là không có gì bất ngờ ở đây. Phần mềm cổ điển cũng có đúng những câu hỏi này: bạn cần monitor những gì đang xảy ra, bạn cần hiểu hệ thống hành xử ra sao, bạn cần có log để phát hiện vấn đề và sửa chúng. Có điều với hệ thống agentic, từng việc một trong số đó đều khó hơn, và đôi khi chúng biến thành một thứ thật sự mới.
Câu hỏi tiếp theo là vì sao việc này khó, và vì sao nó khó ngay bây giờ. Agent không phải phần mềm bình thường. Bạn không có vài tính năng và vài cái nút. Bạn không có một luồng định sẵn (predefined flow) để test trước khi lên live. Và phạm vi bao phủ (coverage) là vô tận. Hãy nghĩ tới Claude Code hay Codex: chúng làm được một dải việc khổng lồ, bất cứ thứ gì user cần. Phần lớn agent khác cũng vậy: bạn đưa instruction, và chúng xử lý. Bạn không thể viết trước tất cả các cuộc hội thoại.
4. Bạn mất cảm giác về chính hệ thống của mình
Điều này dẫn tới phần sâu nhất của vấn đề, phần khiến Raphael mất ngủ cả đêm: bạn mất cảm giác (lose the feel) về chính hệ thống của mình. Sau khi build sản phẩm, bạn cần có một kiểu hiểu biết nào đó: nó đang tốt lên hay tệ đi? Bạn cần monitor, cần hiểu những gì đang diễn ra.
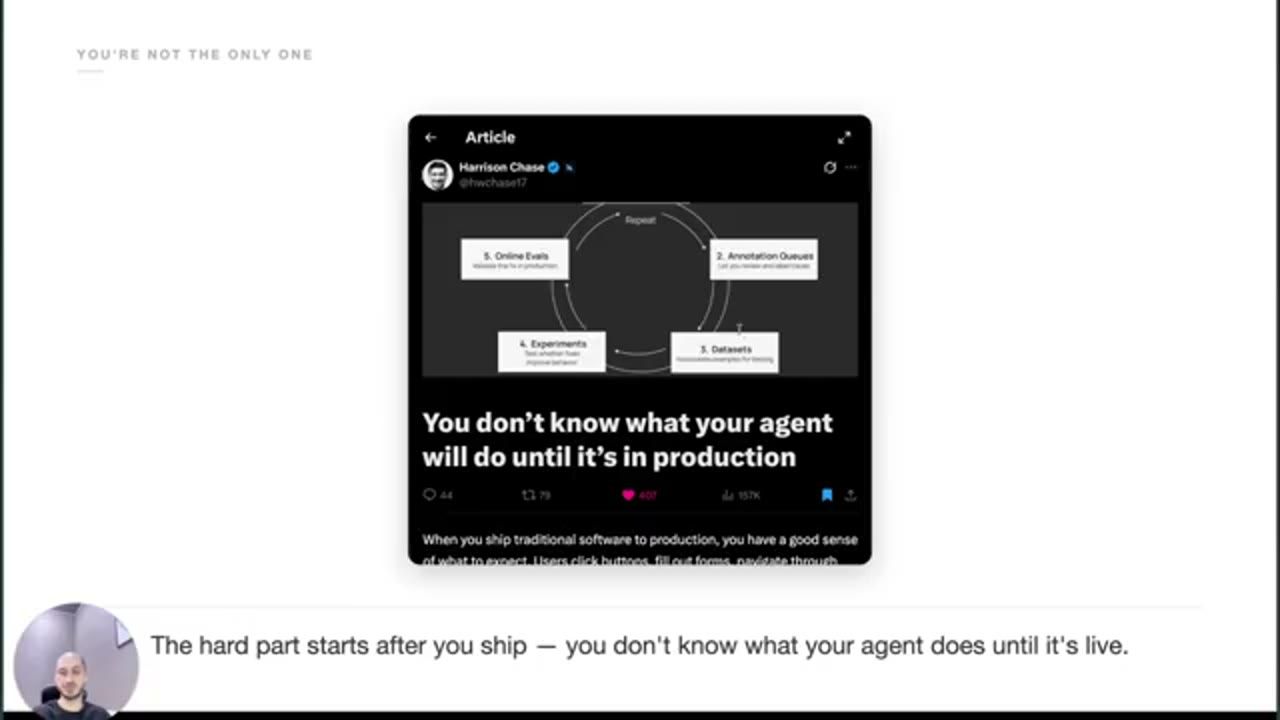
Và vấn đề là các lưới an toàn (safety net) thông thường không cứu được bạn ở đây. Anh kể đội anh đã thử khá nhiều thứ: viết unit test, dùng regex, dùng các check dựa trên rule (rule-based check), thậm chí viết script để mô phỏng cuộc hội thoại của khách hàng. Những thứ đó có giúp theo một số cách. Nhưng rốt cuộc, mỗi thứ chỉ là một lát cắt của toàn bộ vấn đề, vì khách hàng luôn làm điều gì đó khác. Bạn không thể viết ra hết. Chúng quá nhiều, và chúng đều khác nhau. Đường chân trời (horizon) của task cũng vậy. Bạn không biết agent của mình sẽ làm gì cho tới khi nó ở production.
5. Lý do thứ nhất: non-deterministic, task vô tận
Vậy vì sao đây là một vấn đề mới? Như mọi người đã biết, LLM không có tính tất định (non-deterministic). Cùng một input có thể đi theo một đường khác. Ngay cả một chỉnh sửa nhỏ trên input cũng có thể dẫn tới một trajectory khác. Cộng thêm việc coverage là vô tận: bạn không thể liệt kê hết, nên bạn không thể test trước cho tới khi đi vào production.
6. Lý do thứ hai: failure tự giấu mình
Lý do thứ hai, và là lý do đáng sợ nhất: failure tự giấu mình. Hãy nghĩ xem điều gì xảy ra khi agent chạy trong một thời gian dài. Nó vật lộn ở giữa task. Nó gặp vấn đề, nhưng nó gặp may và hồi phục được. Nó tìm ra một cách đi vòng (workaround), thử vài tool call khác hay gì đó, và bạn không nhận được cảnh báo đỏ nào, không có vấn đề gì trên dashboard. Mọi thứ trông ổn.
Nhưng thật ra, đây là một cảnh báo sớm cho bạn. Đây là một vấn đề bị giấu kín, đang sống trong codebase của bạn, và bạn cần sửa nó càng sớm càng tốt. Vì nếu ta đang nói về agent đáng tin cậy (reliable agent), thì nó không được phép phụ thuộc vào may mắn.
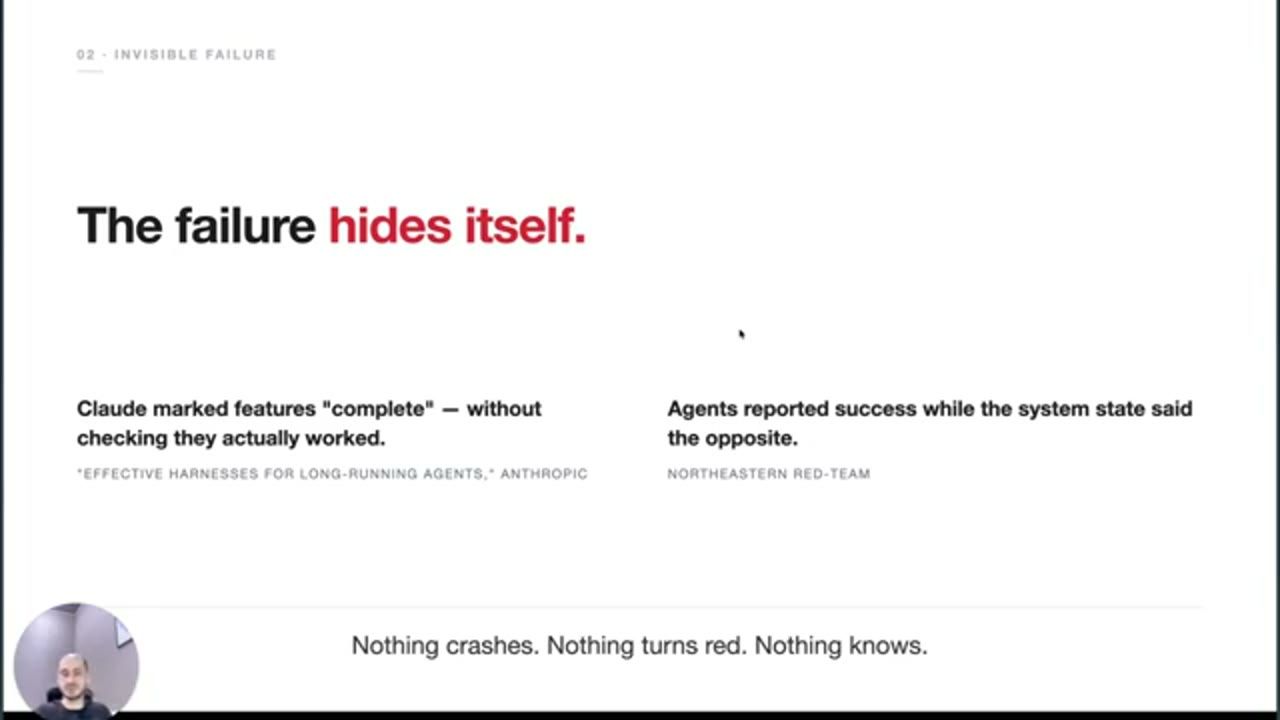
Anh dẫn thêm: như Anthropic đã viết trong một bài blog, đôi khi agent rất thích đánh dấu một tính năng là đã hoàn thành mà không kiểm tra xem nó có thật sự chạy hay không.
7. Lý do thứ ba: tool surface khổng lồ, và "finished" chưa chắc là "helpful"
Lý do tiếp theo là tool calling. Bề mặt tool (tool surface) rất lớn. Một task chạy dài cần hàng trăm tool, thậm chí hàng nghìn. Đôi khi giữa chừng có vài lần summarization. Nó dùng sub-agent, viết rất nhiều code, chắc chắn có dùng terminal. Nó gọi dịch vụ của các công ty khác, các thư viện bên thứ ba, và những thứ đó lúc nào cũng hoạt động theo cách khác nhau. Nói cách khác, bạn thật ra không biết mình đang tìm cái gì.
Đôi khi "finished" không có nghĩa là có ích cho user. Có thể chẳng có vấn đề gì cả: agent chạy xong, mọi thứ trông ổn, câu trả lời được ghi là thành công. Nhưng anh lấy ví dụ từ chính use case của Wandero: đôi khi user nhờ dựng một lịch trình (itinerary), agent chạy flow và dựng ra một chuyến đi, nhưng nó lại book một dịch vụ khác, và tính giá sai rất nhiều chỗ, nên user không vui. Về mặt kỹ thuật thì thành công, nhưng vẫn thất bại ở chính task đó.
Và như anh đã nói, unit test không cứu bạn ở đây. Production mới là nơi bạn học được mình cần test cái gì ngay từ đầu.
8. Logs là source of truth, và vận hành agent là một bài toán agent
Vậy sau khi launch sản phẩm, bạn cần monitor, cần hiểu, và cần cải thiện hệ thống. Source of truth ở đây là gì? Là logs. Ai cũng có logs, ai cũng yêu logs. Bạn có thông tin có cấu trúc (structured). Và các cỗ máy hiện nay là thứ giỏi nhất để hiểu và khám phá logs, giỏi hơn bất kỳ con người nào, nhanh hơn nhiều. Chúng có thể viết script để lọc cả một bức tường log khổng lồ. Đây là thứ hiển nhiên nhất mà bạn có thể giao cho agent.
Nhưng ngay khi bắt đầu làm việc đó, có thể bạn build một agent, một skill hay gì đó, bạn sẽ nhanh chóng hiểu ra là nó không dễ như bạn tưởng, vì nó cần rất nhiều reasoning. Bạn cần hiểu vấn đề để phân biệt đâu là bug thật và đâu là nhiễu (noise), để đào sâu vào trace hay trajectory của nó, để hiểu đó là triệu chứng (symptom) hay nguyên nhân gốc (root cause). Thế là bạn nhận ra rằng chính việc vận hành một agent cũng là một bài toán agent.
9. Vòng loop khép kín: từ trace tới pull request
Vậy là bạn có một vòng loop đầu cuối (end-to-end). Bạn có traces, có trajectories, bạn cho agent quyền truy cập codebase. Nó chẩn đoán vấn đề, hiểu chuyện gì đã xảy ra, rồi gửi một PR. Sau đó bạn có thể có một skill, một sub-agent hay bất cứ thứ gì kiểm soát PR đó, vì như mọi người biết, phần lớn agent đều rất hăng gửi PR. Chúng thích sửa vấn đề.
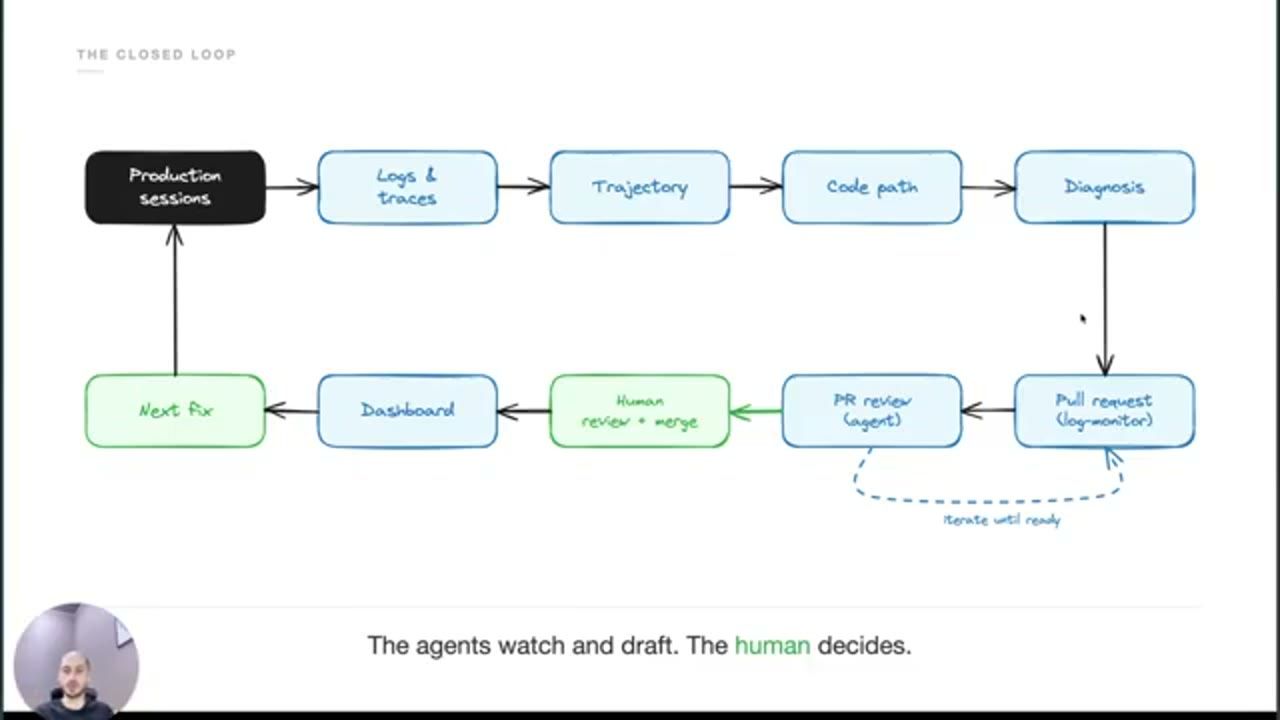
Đội anh thích có một agent riêng với context mới (fresh context). Nó cố gắng kiểm PR từ một góc khác, một cách nhìn khác, chạy các test tập trung (focused test). Nó không bị thiên kiến bởi chính vấn đề ban đầu. Nó cố gắng phê bình, chấm điểm PR, và đôi khi yêu cầu thay đổi. Có thể nó đóng thẳng PR, và như vậy giúp đội lọc bớt những vấn đề đó. Rồi sau đó có human-in-the-loop. Đôi khi thì không có, và anh hẹn sẽ nói thêm về chuyện này sau.
Đây là thứ hiển nhiên nhất mà bạn có thể giao cho agent, và nó có vẻ khá hiển nhiên với phần lớn mọi người. Nhiều đội cũng làm theo cùng cách này. Nhưng anh cho rằng người ta không đánh giá đúng tầm quan trọng của nó. Bạn cần bỏ thời gian vào đó. Bạn cần calibrate, cần làm nó reliable, để có thể tin vào vòng loop. Và đây là vòng loop nhanh nhất mà đội anh từng có.
Sau khi dựng hệ thống đơn giản này, bạn đã có cảm giác và hiểu biết về cách nó hành xử, chuyện gì đang diễn ra. Bạn phát hiện vấn đề và tìm cách sửa càng sớm càng tốt. Bạn có thể có một PR sẵn sàng trong nửa tiếng, và dễ dàng hiểu được chuyện gì đang xảy ra.
10. Cách Raphael làm: bốn operating agent
Tiếp theo anh dẫn người nghe qua cách chính anh xử lý chuyện này. Có thể nó không tối ưu, anh nói, nhưng nó sẽ giúp mọi người nắm được ý.
Về cơ bản, đội anh có hai luồng chính. Luồng thứ nhất là vòng loop nhanh nhất, giúp phát hiện và sửa vấn đề càng sớm càng tốt. Luồng thứ hai thì nhìn rộng hơn (zoom out), giúp bạn có hiểu biết ở mức cao, giúp bạn luôn bắt mạch (hand on the pulse) của hệ thống.
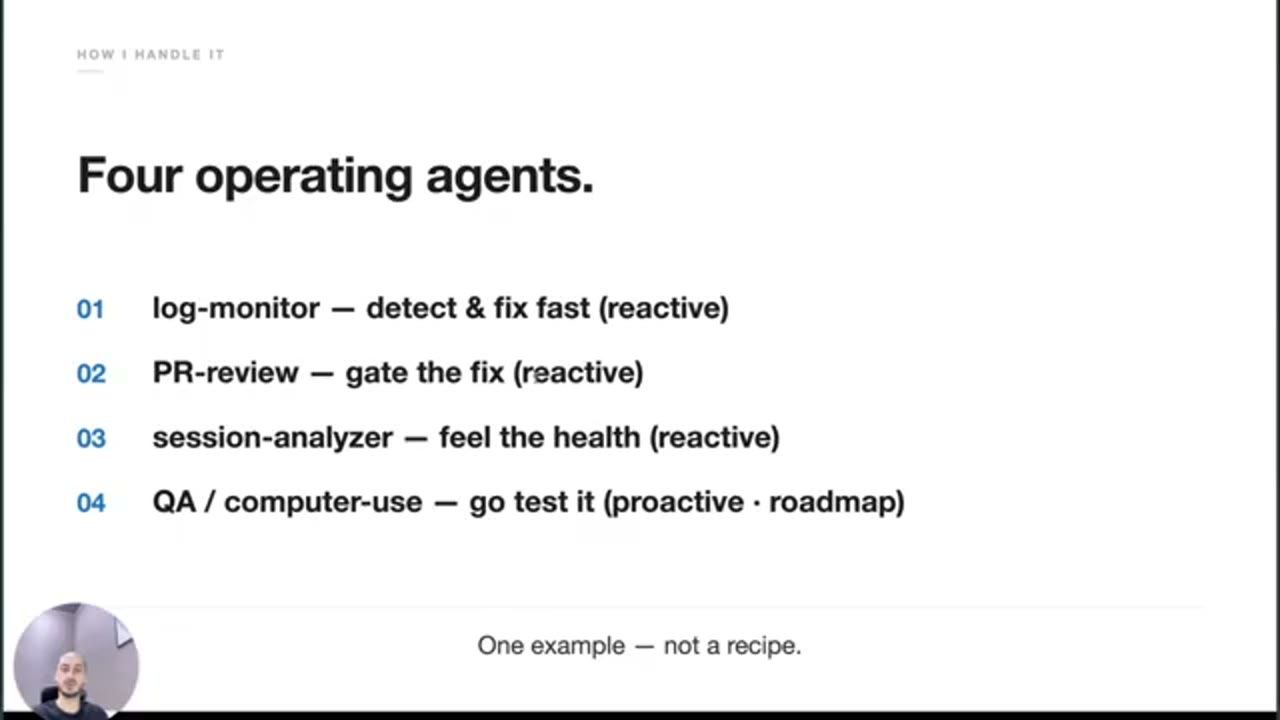
Luồng thứ nhất là log monitoring agent, cái anh đã nhắc tới ở trên. Bạn có trajectories, có logs, có quyền truy cập codebase, và agent này chạy mỗi giờ, hoặc mỗi mười lăm phút một lần.
11. Log-monitor: PR và cảnh báo Slack
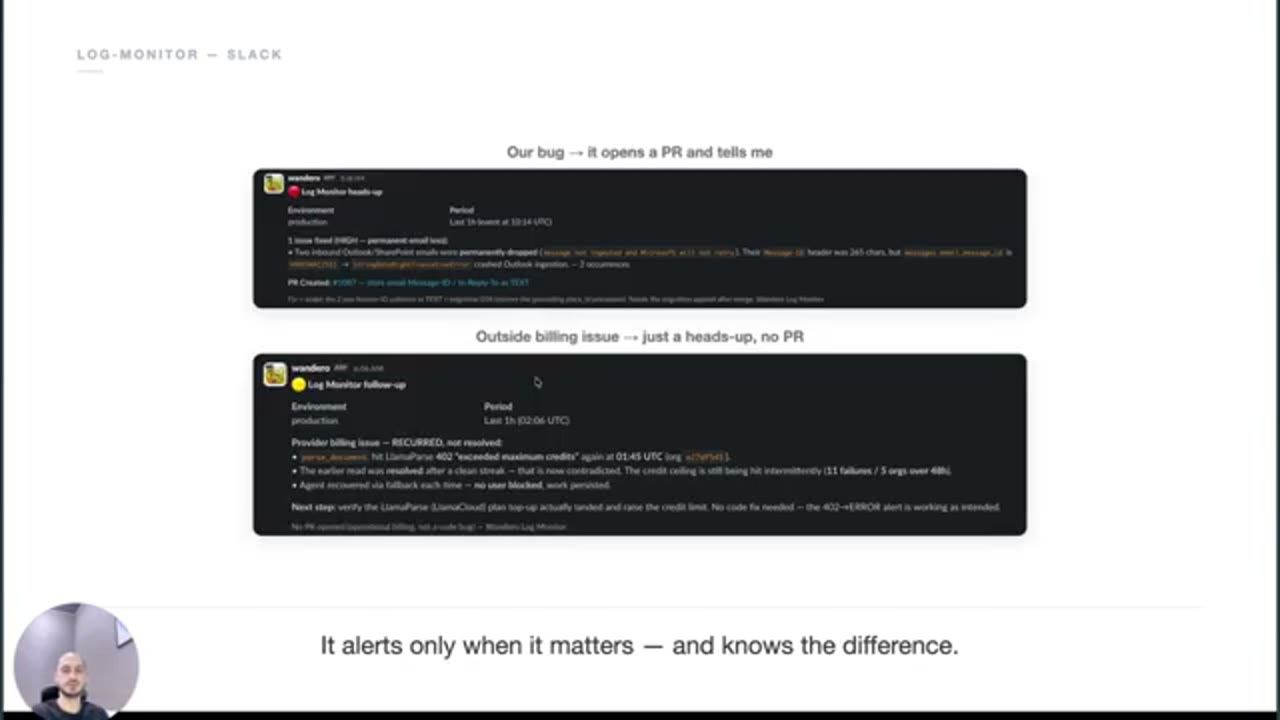
Log-monitor cố gắng hiểu vấn đề. Nó đào sâu vào logs, xem user có bị kẹt (stuck) ở đâu không, rồi gửi PR, hoặc đôi khi gửi cảnh báo qua Slack. Phần Slack này khá quan trọng, vì có những vấn đề nghiêm trọng tới mức đội cần sửa ngay lập tức. Và theo anh, nó chạy khá tốt.
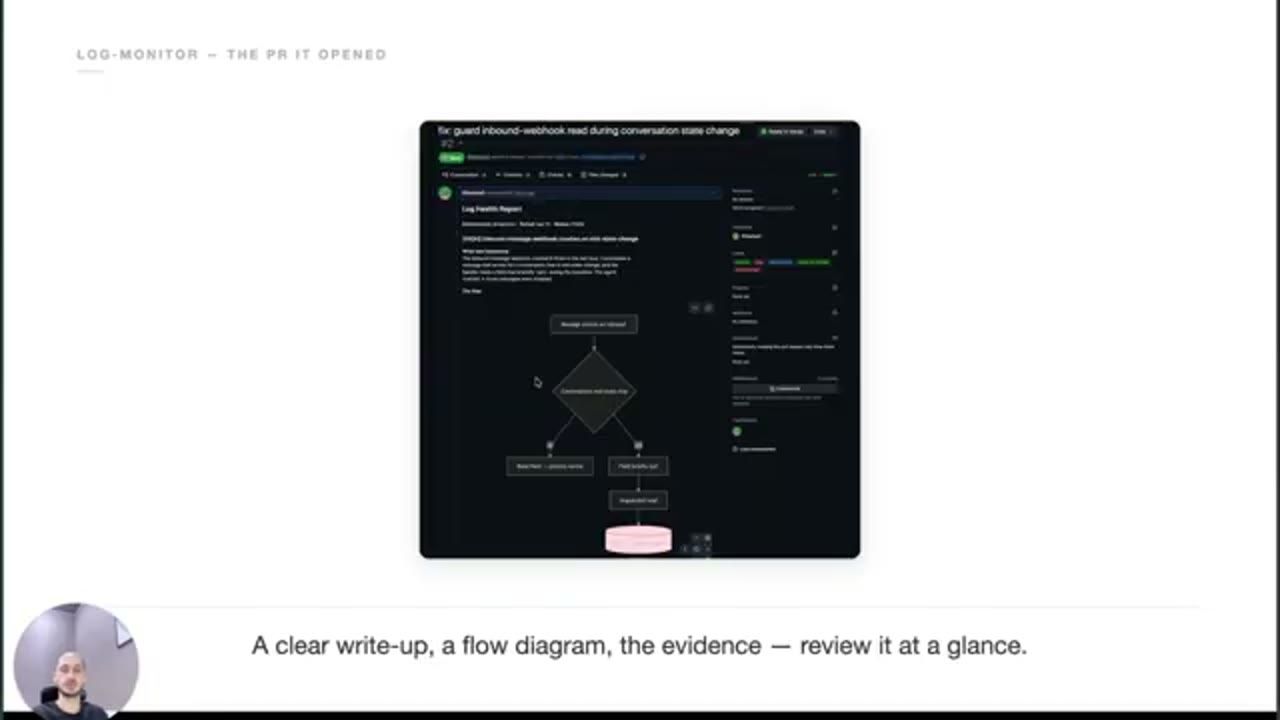
Đây là một ví dụ PR trông ra sao. Bạn có một phần mô tả gọn, một lời giải thích ngắn về chuyện gì đang xảy ra. Bạn có metadata. Bạn có sơ đồ đẹp, dạng Mermaid hoặc bảng ASCII. Có thể bạn còn có một HTML artifact giúp bạn nhìn lướt qua vấn đề và nhanh chóng hiểu PR này để làm gì.
Còn đây là ví dụ một thông báo Slack trông ra sao. Nó cho bạn feedback nhanh, giúp phát hiện nếu có vấn đề nghiêm trọng. Đôi khi nó chỉ là một lời báo trước (heads-up): bạn biết có vài cảnh báo, vài vấn đề, và bạn sẽ kiểm chúng khi có thời gian.
12. PR-review và câu hỏi con người có phải bottleneck
Như đã nói, review agent cực kỳ quan trọng, vì nó cố gắng kiểm vấn đề từ một góc khác. Nó luôn cố phê bình, chấm điểm, và khi đã sẵn sàng thì nó gửi PR cho con người.
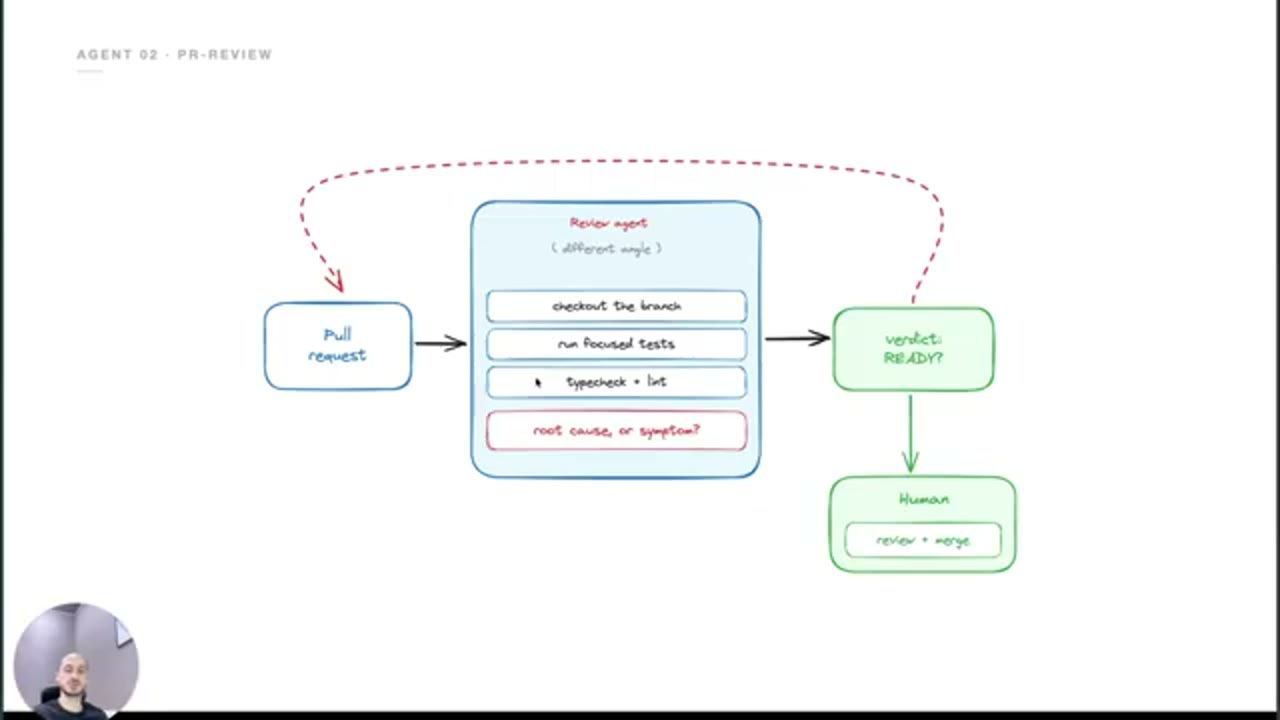
Có người đặt vấn đề là liệu bạn có cần human-in-the-loop không, vì trong trường hợp này con người vẫn là bottleneck. Ở Wandero, PR agent và review agent gửi số PR mỗi ngày gấp mười lần ba người trong đội cộng lại. Nên bạn cần một hệ thống gọn gàng để xử lý lượng đó, để mình không trở thành bottleneck của hệ thống.
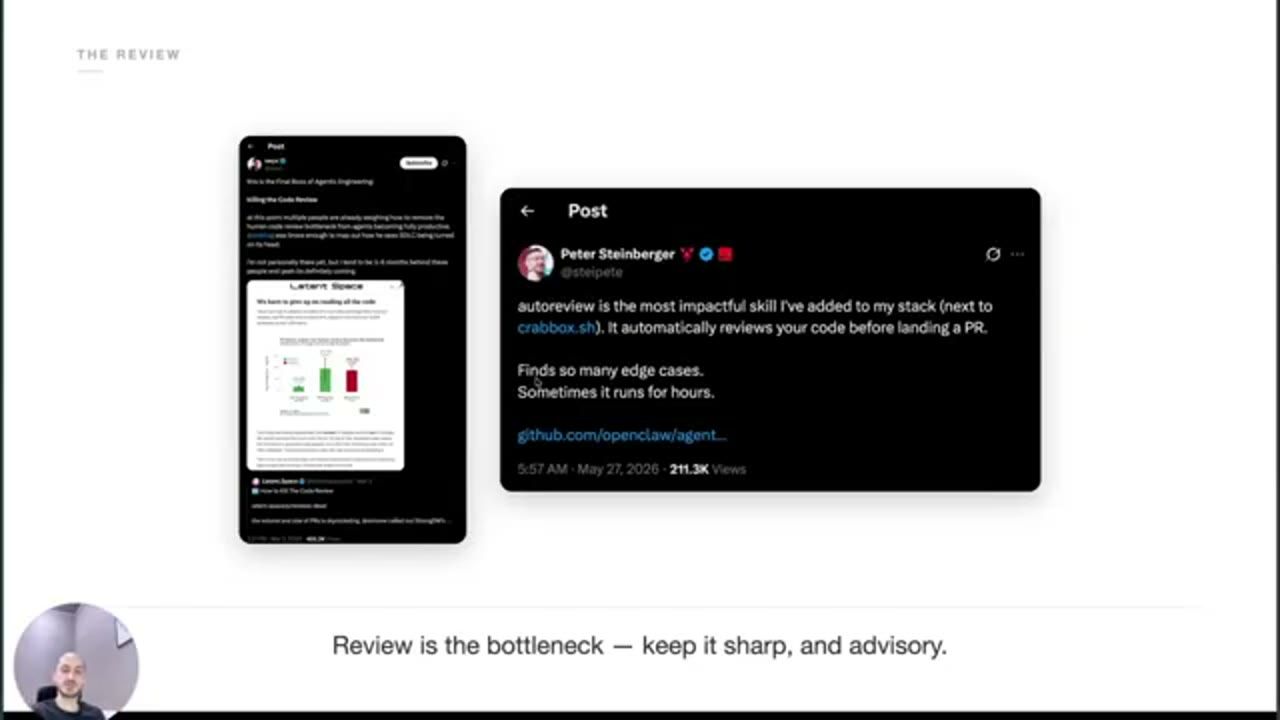
Nhưng từ kinh nghiệm của anh, như đã nói, PR agent và review agent giúp anh có phần mô tả đẹp và vài artifact để nhanh chóng hiểu vấn đề. Có thể anh bỏ ra vài phút để ít nhất hiểu chuyện gì đang xảy ra. Anh nghĩ hiện tại như vậy là ổn, nhưng có thể sau này đội sẽ bỏ bước đó. Người ta đang bàn về chuyện này: bạn không nên là bottleneck của bài toán, và một số người chọn bỏ hẳn con người khỏi vòng loop. Nhưng xu hướng là bạn cần khép vòng loop trước. Hãy để bài toán đi tới chỗ chính bạn là bottleneck, rồi sau đó bạn có thể tự rút mình ra khá dễ dàng.
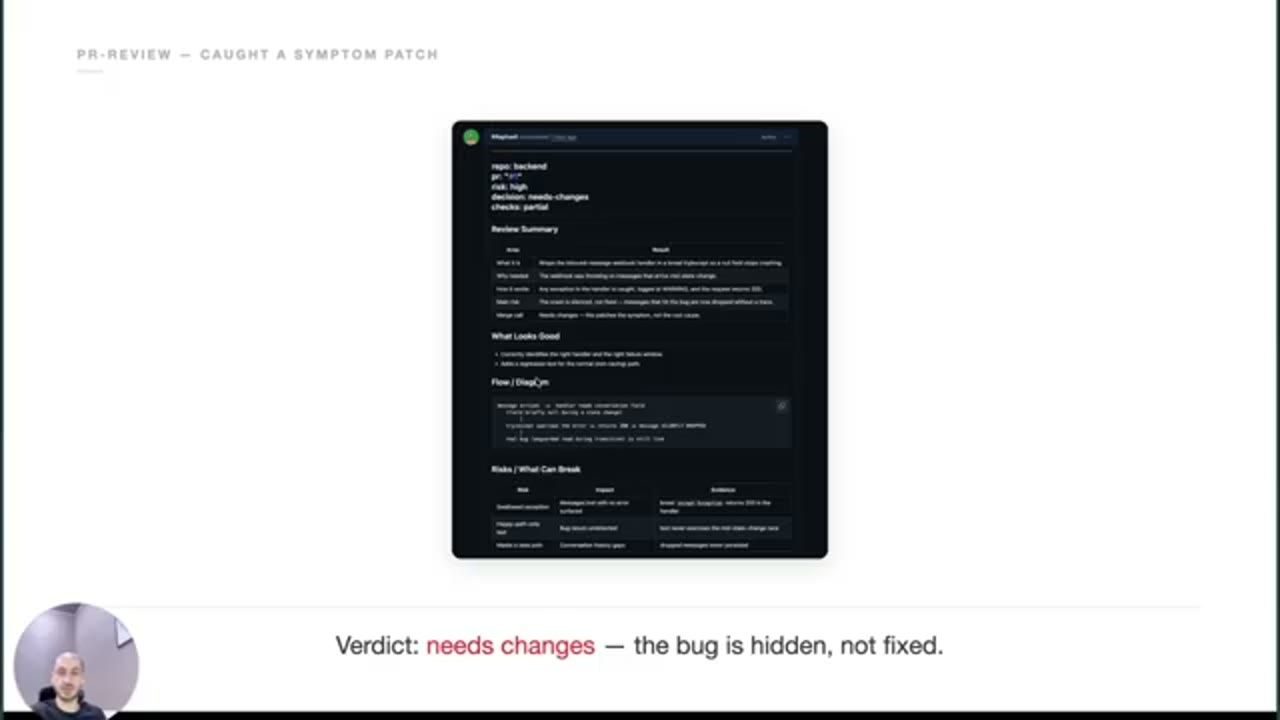
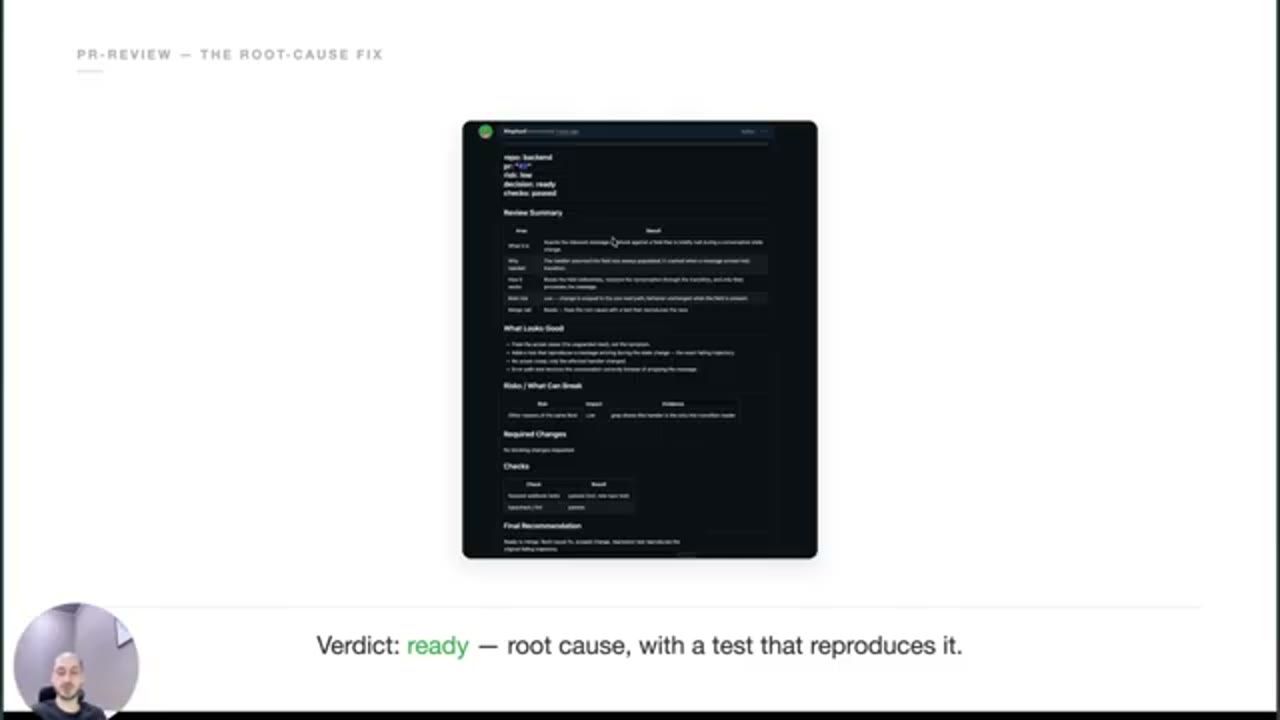
Anh cho xem vài ví dụ feedback của review agent. Như mọi người thấy, nó yêu cầu một số thay đổi. Có phần tóm tắt, có sơ đồ, có giải thích những chỗ có rủi ro, những edge case. Đôi khi sau vài vòng lặp, hai agent đi vào vòng loop cho tới khi code sẵn sàng và không cần thay đổi gì thêm. Sau đó con người mới nhảy vào vòng loop.
13. Session-analyzer: cảm nhận sức khoẻ của cả hệ thống
Agent trước đó, như anh đã nói, đặc biệt tốt khi bạn muốn sửa các vấn đề cục bộ. Trong trường hợp của Wandero, nó chạy mỗi giờ, chỉ kiểm một cửa sổ log dài một giờ, và nó không có hiểu biết ở mức cao về vấn đề. Nên đội nhận ra họ cần một hệ thống khác, giúp có được lời giải thích ở mức cao hơn, một kiểu sức khoẻ của hệ thống.
Và visibility, khả năng nhìn thấy, là mảnh dễ nhất. Trước khi có agent, việc đó là bất khả: bạn không thể đào sâu hay tóm tắt hàng trăm cuộc hội thoại. Nhưng giờ thì bạn có thể có một hệ thống chấm điểm mọi cuộc hội thoại, hiểu chuyện gì đang xảy ra, và cho bạn một góc nhìn tổng thể về hệ thống. Trên slide, anh trích lời Dev Shah: visibility là mảnh dễ nhất, phần khó là phân tích và hiểu những gì bạn đang quan sát; nhiều đội ghi hơn 100 nghìn trace mỗi ngày nhưng gần như không làm gì với chúng, vì không con người nào đọc và tóm tắt được 100 nghìn trace. Đó là việc của agent tiếp theo.
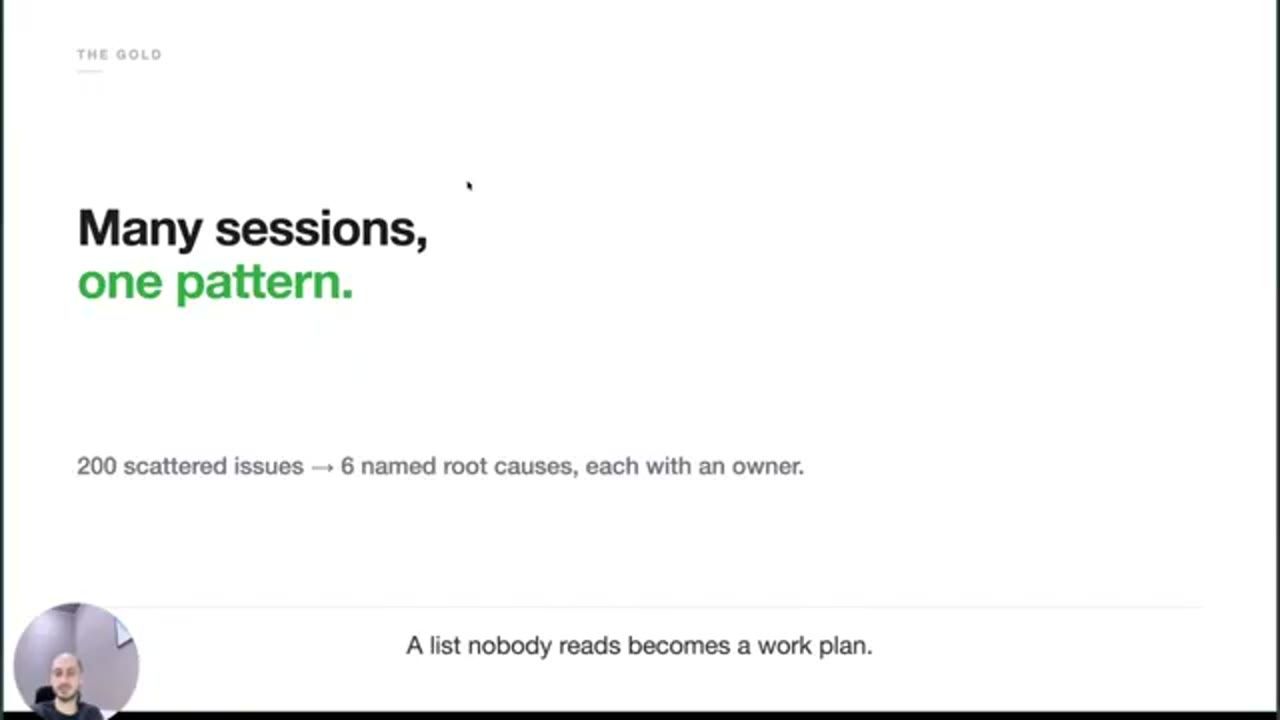
Đó là session-analyzer, và mục tiêu chính của nó chỉ là cho anh điểm sức khoẻ của hệ thống. Đội cố gắng kiểm tra từng cuộc hội thoại, cho chạy qua rất nhiều sub-agent. Nó tiêu rất nhiều token. Nhưng nó giúp đội phát hiện các pattern, nối các điểm lại với nhau (connecting the dots), và hiểu các pattern ở mức cao. Nó cũng phát hiện các cụm vấn đề (cluster problems): nguyên nhân là gì, dùng bao nhiêu tool call, bao nhiêu sub-agent, bao nhiêu lần summary đã xảy ra, vân vân. Và nó còn đưa ra AI insights, các entity, để đội hiểu được vấn đề.
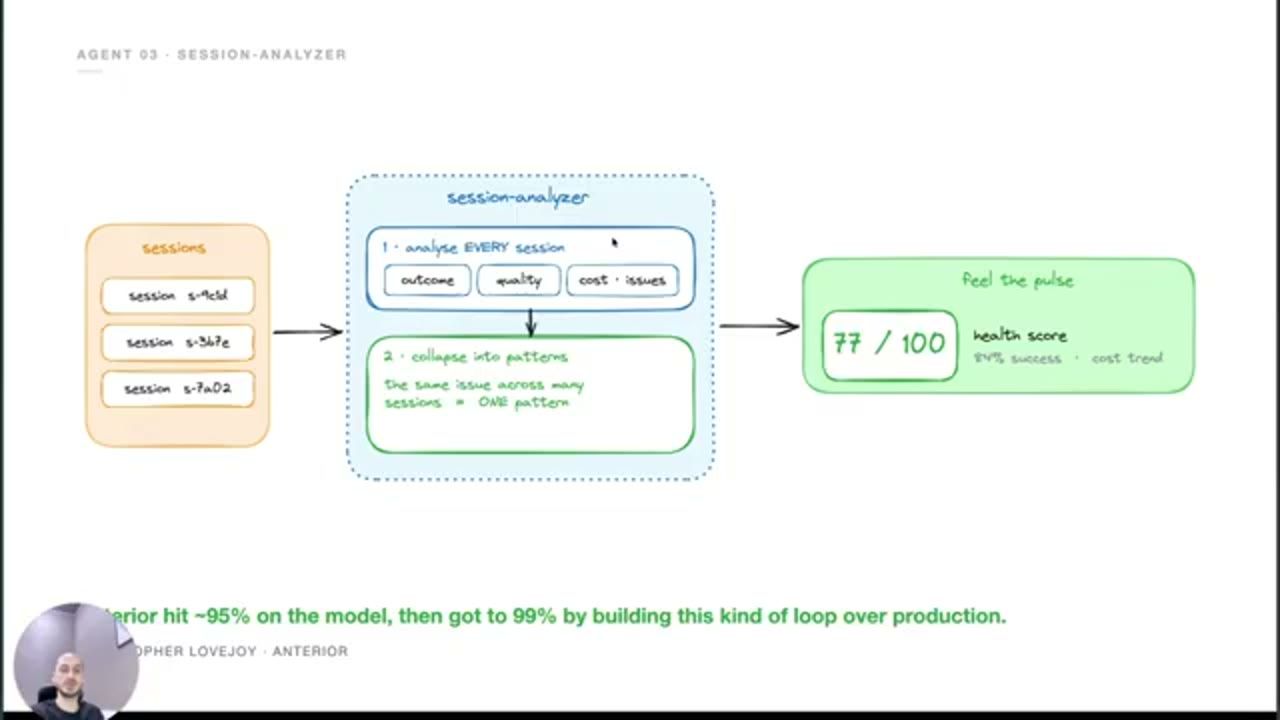
Như anh đã nói, một trong những vấn đề chính là bạn mất kiểm soát sau khi launch lên production. Nên bạn cần một hệ thống giúp bạn kiểm soát, ít nhất là có chút hiểu biết về những gì đang xảy ra, nó trông ra sao, nó có khoẻ hay không.
14. Bên trong dashboard tự build
Rồi anh cho xem hệ thống trông ra sao trong thực tế. Đội tự build nó. Có rất nhiều công ty và công cụ khác cung cấp đúng kiểu hệ thống này, nhưng anh thích tự build hơn, vì anh biết mình quan tâm tới cái gì, mình đang tìm cái gì.
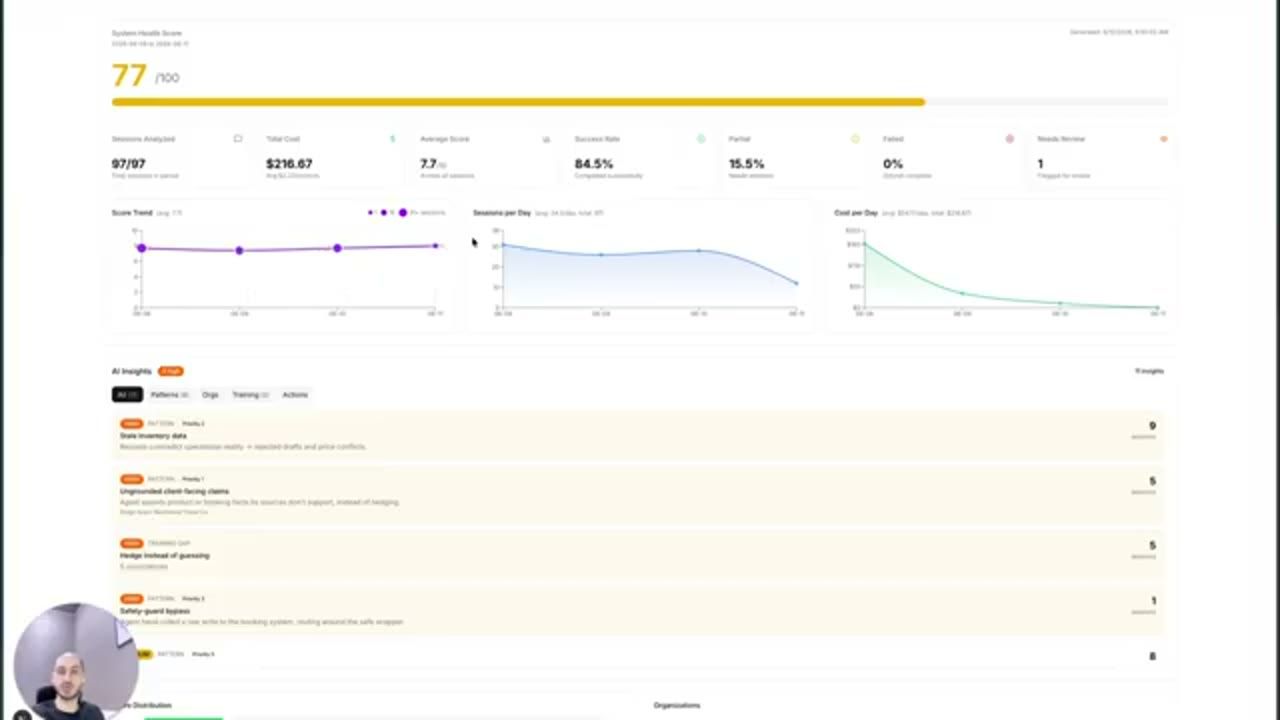
Như mọi người thấy, ở đây có sức khoẻ của hệ thống, số session đã được phân tích, chi phí, điểm trung bình, tỉ lệ thành công. Có các xu hướng (trends), có AI insights, và đây là phần quan trọng nhất: khi AI, hay chính xác là khi agent, cố gắng nối các điểm và tìm ra pattern. Nếu có cái nào nghiêm trọng, bạn có mô tả cho từng cái: nó là gì, vì sao quan trọng, root cause là gì, tất cả các session bị ảnh hưởng, và một đề xuất sửa (recommendation fix).
Anh lưu ý rằng dữ liệu đang chiếu là dữ liệu đã được ẩn danh (anonymized), nhưng nó đến từ các cuộc hội thoại thật. Có phân bố điểm (score distribution), số session và chi phí theo từng công ty khách hàng. Có sentiment analysis, có các entity. Có analytics về tool call: tỉ lệ thành công, bao nhiêu cái bị từ chối và vì sao. Và có phân tích chi tiết từng session: hệ thống xếp hạng từng session, chấm điểm, nó chạy bao nhiêu lần, bao nhiêu message, bao nhiêu tool call, bao nhiêu lần summary, kèm một lời giải thích chi tiết cho mỗi session, vấn đề là gì, có phải thứ bạn cần xem kỹ hay không. Anh bảo mọi người hãy tin anh, nó giúp rất nhiều, và nó giúp bạn kiểm tra, theo dõi được hàng trăm cuộc hội thoại.
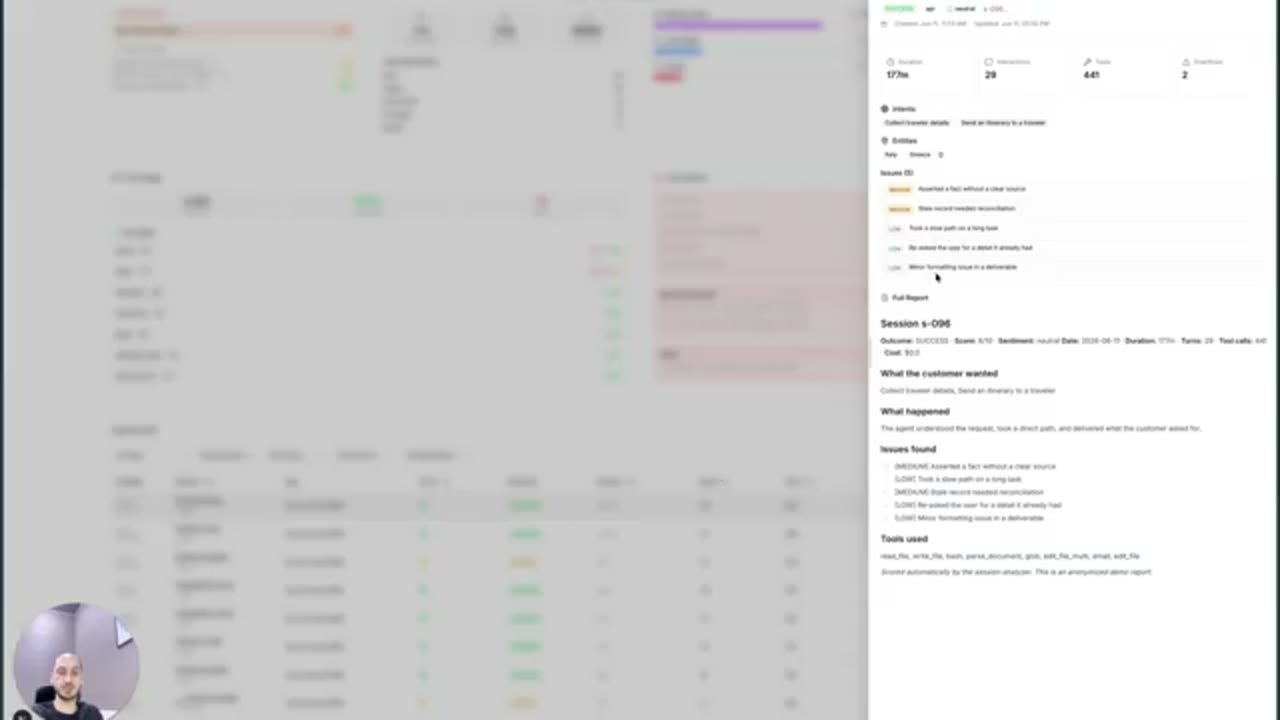
Mục tiêu chính của dashboard và của hệ thống này không phải là sửa một vấn đề hay một bug cụ thể. Nó ở mức cao hơn, giúp bạn theo dõi hàng trăm hay hàng nghìn cuộc hội thoại thật. Bạn có thể chạy nó mỗi tuần một lần, hai lần một tuần, hay tương tự.
15. QA / computer-use: đi tìm thứ sắp hỏng
Đến agent tiếp theo. Vấn đề của hai agent trước là thế này: agent thứ nhất giúp bạn phát hiện các vấn đề cụ thể, agent thứ hai cho bạn hiểu biết ở mức cao, nhưng cả hai đều làm việc từ góc nhìn của logs, của code, hay của chính session. Bạn vẫn cần một góc nhìn từ phía user.
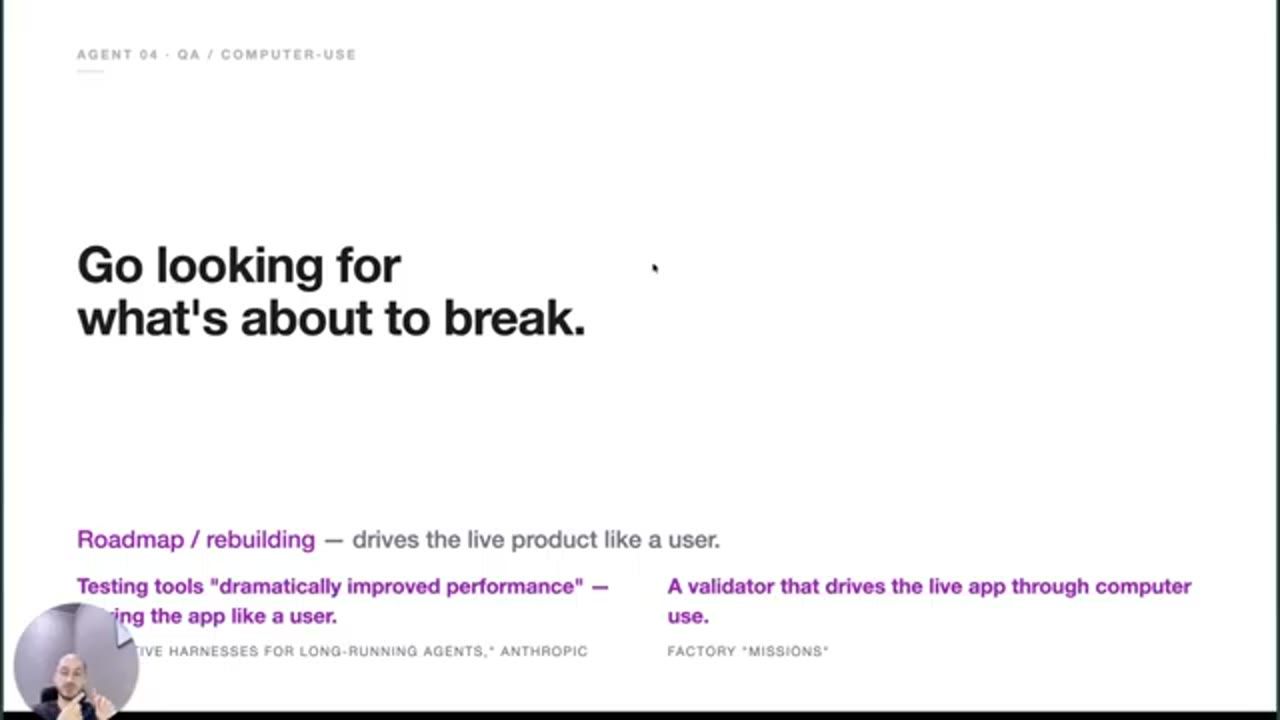
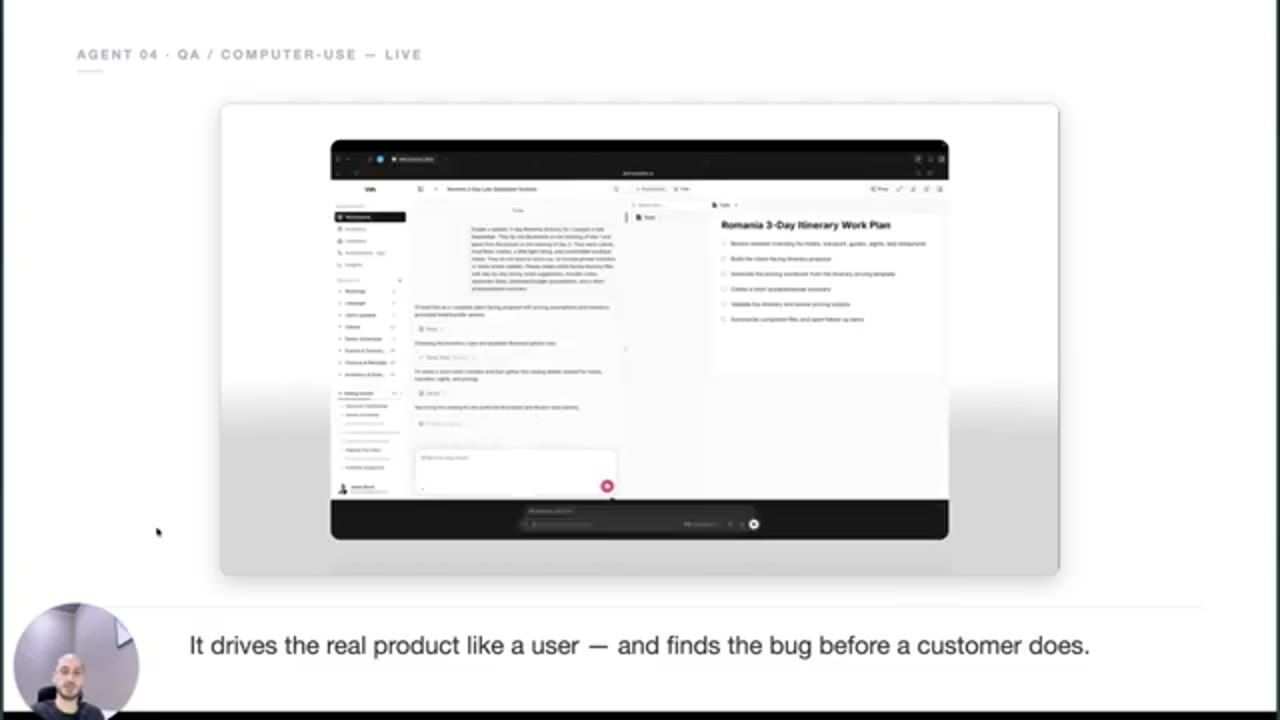
Vì vậy đội có một computer use agent: nó mở browser, đăng nhập, và cố gắng mô phỏng chính khách hàng, vì đôi khi bạn có vấn đề ở UI. Bạn cần kiểm xem mọi thứ trông có ổn không, và đôi khi code với logs không giúp bạn được ở mặt này.
Anh cho xem ví dụ. Đôi khi đội dùng Codex, và nó dùng chính browser. Thật ra cách này khá chậm. Nên đội thử build một skill riêng biết website của họ, biết DOM của họ trông ra sao, và như vậy nhanh hơn nhiều. Agent có thể mở website, đăng nhập, mở một session, gửi message, kiểm tra chuyện gì đang xảy ra, và kiểm cả giao diện trông thế nào, các artifact ra sao. Nó chạy khá tốt. Nhưng anh nhắc bạn cần biết rằng nó sẽ tiêu rất, rất nhiều token.
16. Meta harness: đừng đưa agent một lỗ khoá
Với tất cả những bài toán trên, anh nhắc rằng bạn cần cho agent quyền truy cập mọi loại tool cần thiết. Bạn cần có logs, trajectories và metrics, database, UI, đúng những thứ mà con người cần. Bạn cần đưa toàn bộ context, mọi khả năng, để agent hiểu được chuyện gì đang xảy ra. Ví dụ với computer use agent, khi phát hiện vấn đề, nó phải có khả năng phân tích trajectories, kiểm database để hiểu chuyện gì đã thật sự xảy ra.
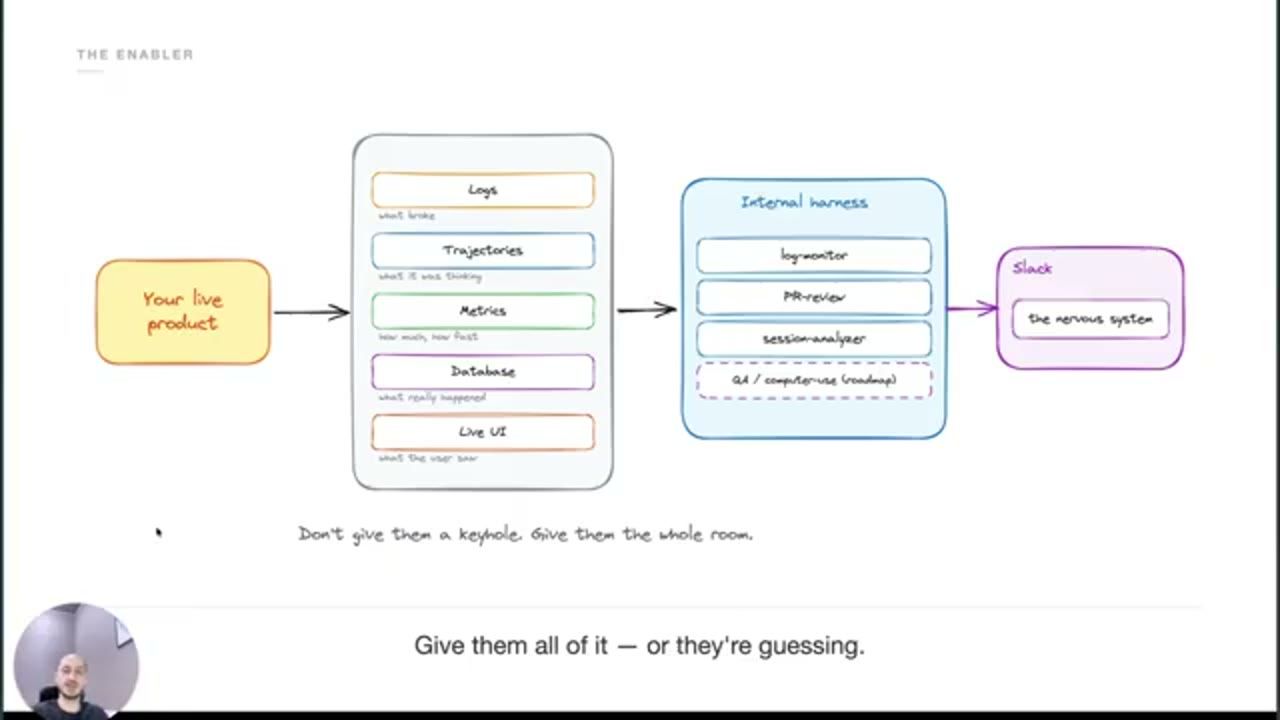
Đó là lý do anh gọi cả hệ thống này là meta harness: khi mọi thứ được nối lại với nhau, và PR hay câu trả lời từ agent dựa trên vấn đề thật, chứ không phải đoán xem chuyện gì đang xảy ra.
Sơ đồ dưới đây gom bốn operating agent theo hai trục mà Raphael mô tả: vòng nhanh để sửa cục bộ và vòng zoom out để cảm nhận sức khoẻ, cộng thêm góc nhìn của user.
17. Moat không nằm ở model: hãy khép vòng loop trước
Vậy moat, lợi thế phòng thủ, không nằm riêng ở model. Bạn cần build một agent, một hệ thống, hay một harness bao quanh model, thứ tự theo dõi chính nó, tự hiểu, tự cải thiện, và ít nhất là giúp bạn monitor những gì đang xảy ra. Còn trong trường hợp lý tưởng thì nó khép vòng loop: gửi PR tự động, gửi thông báo tới bất cứ đâu, và giúp bạn tăng tốc cả quá trình.
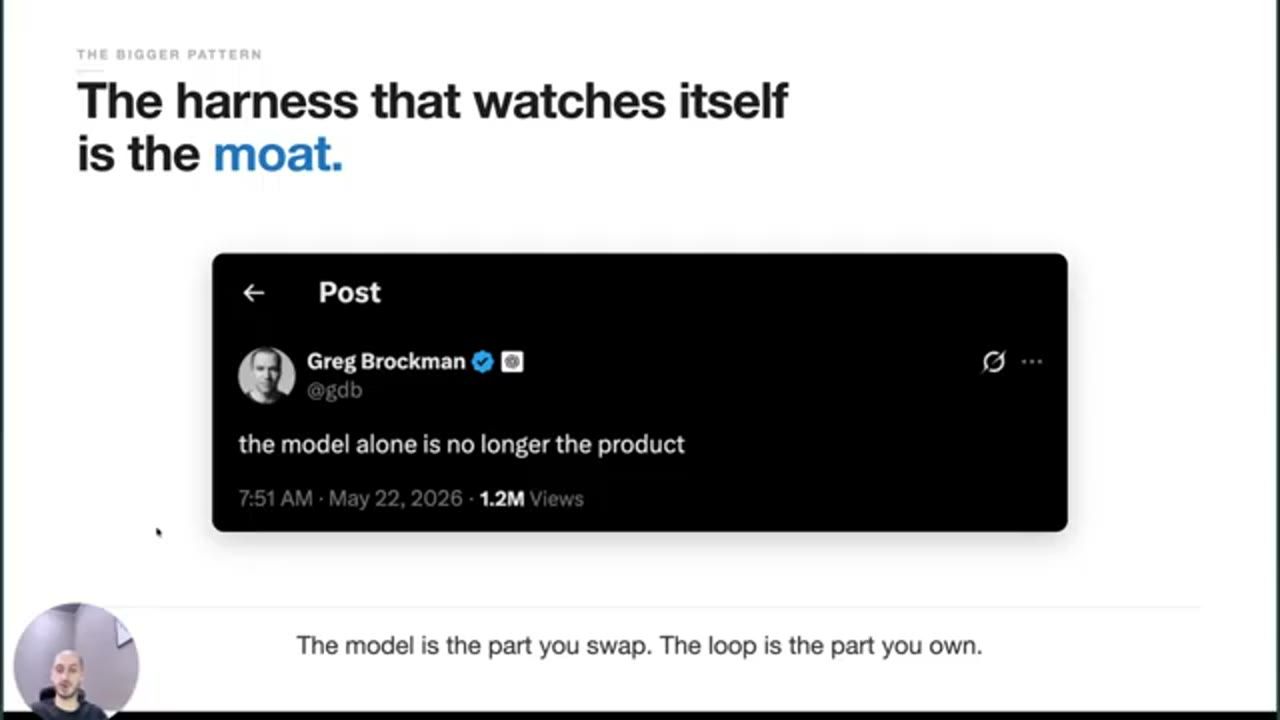
Ship là phần dễ nhất hôm nay. Nếu bạn muốn build một production agent, bạn cần khép vòng loop trước, vì không hiểu sao người ta không nói về chuyện nó quan trọng thế nào, về những gì xảy ra sau khi bạn launch. Ai cũng có thể có cùng một model, ai cũng có thể có cùng một agent hay harness. Nhưng bạn cần có một hệ thống nội bộ giúp bạn trong quá trình này: phát hiện vấn đề, cho bạn cảm giác về những gì đang diễn ra, và giúp sản phẩm tốt lên. Raphael kết thúc bằng lời cảm ơn.
Nguồn và link
- Wandero AI, nền tảng AI-native cho sales và vận hành doanh nghiệp, với agent cho ngành du lịch và khách sạn: wandero.ai
- Trang diễn giả Raphael Kalandadze: ai.engineer/speakers/raphael-kalandadze · X: @RaphaelKalan
- Anthropic, "Effective harnesses for long-running agents", nguồn của hai trích dẫn trên slide: anthropic.com/engineering
- Claude Code: anthropic.com/claude-code · Codex: github.com/openai/codex
- Computer use của Claude: tài liệu chính thức
- Mermaid, cú pháp sơ đồ trong mô tả PR: mermaid.js.org · sơ đồ trên GitHub
- Factory: factory.ai · Anterior: anterior.com
- crabbox.sh và OpenClaw, nhắc trong bài đăng về autoreview: crabbox.sh · github.com/openclaw/openclaw
Related talks
Every Solo Agent Builder Eventually Reinvents a Worse Version of CI/CD
Sumaiya Shrabony · University of Colorado Denver · 11 min
Solo builder sẽ tự dựng lại 5 thứ của CI/CD; demo 3 cách agent nói dối (voice drift, claim không nguồn, hook trùng) và gate chặn từng cách.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.