The Pipeline Is Dead
AI Engineer World's Fair 2026: Online Track · Video gốc
Vì sao mô hình một artifact đóng băng cho mọi user đang hết lý do tồn tại, và kiến trúc stem cộng divergence riêng cho từng user giải các phần khó ra sao.
1. Cả một stack chỉ để chuyển phần mềm từ máy này sang máy khác
Iris mở đầu bằng một câu hỏi cho khán giả online: vì đang ở trên mạng nên không ai giơ tay được, vậy hãy gật đầu trước màn hình. Bao nhiêu người trong số các bạn đã dành một phần đáng kể sự nghiệp để làm cho phần mềm di chuyển từ một máy tính sang một máy tính khác? CI pipeline, package registry, container image, quy trình duyệt trên app store. Theo chị, toàn bộ stack đó tồn tại để giải đúng một bài toán: đưa một artifact đã đóng băng, tức đoạn code đó, từ cái máy nơi nó được build sang cái máy nơi nó chạy, một cách an toàn, tái lập được (reproducible), và chỉ một lần.
Và đây là điều chị nghĩ mọi người đang bỏ lỡ. Toàn bộ stack ấy được xây quanh một ý tưởng cũ tới mức chúng ta không còn nhìn thấy nó là một lựa chọn nữa: một version phần mềm cho tất cả mọi người. Ta ship phần mềm theo cách đó lâu tới mức gần như không ai hỏi "tại sao" nữa.
2. Iris, Noam và Differ
Iris giới thiệu mình là một trong các co-founder của Differ. Co-founder còn lại, Noam Tenne, là engineer đầu tiên của JFrog, công ty làm hạ tầng quản lý artifact và binary. Noam đã giúp xây chính cái pipeline mà chị sắp nói là đang chết dần. Chị thì đi tới vấn đề này từ đầu bên kia: chị làm Fintech mười năm, có mặt từ sớm ở một ngân hàng số được scale lên rồi exit, tức là ship phần mềm trong những môi trường ít chịu đựng nhất với thứ chị sắp đề xuất.
Vì vậy chị hoàn toàn hiểu mọi sự dè dặt, chính chị cũng từng có những dè dặt đó. Tuy vậy, chị khẳng định chuyện này vẫn sẽ tới, và đó không phải một lời cảnh báo. Theo chị, đây là điều tốt nhất xảy ra với phần mềm trong một thời gian dài.
3. Giả định nằm dưới mọi hạ tầng distribution: artifact bị đóng băng
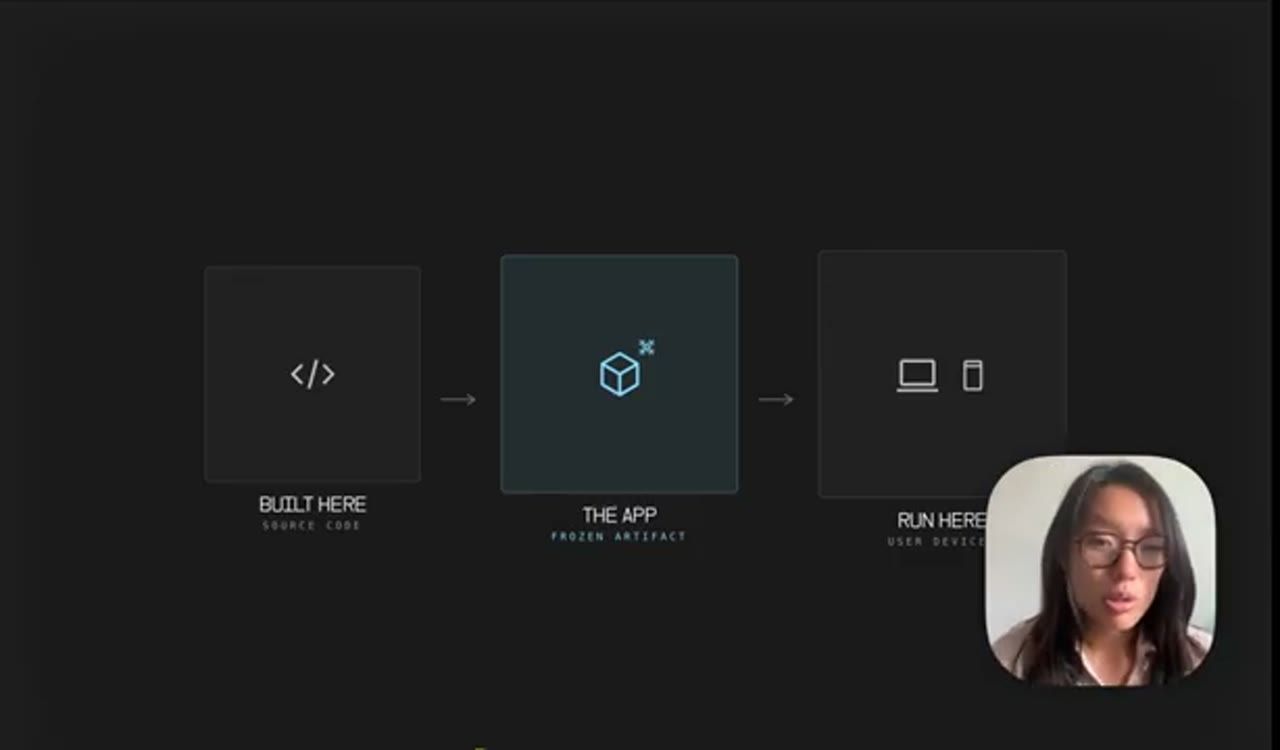
Mọi mảnh hạ tầng distribution mà bạn từng đụng tới đều mã hoá cùng một giả định: phần mềm được sản xuất ở một nơi, chạy ở một nơi khác, và thứ nằm ở giữa, tức artifact, thì bị đóng băng. Giả định đó từng đúng. Trong nhiều thập kỷ nó đơn giản là sự thật.
Tại sao? Vì sản xuất ra một thay đổi đúng (a correct change) rất đắt. Nó cần những con người có tay nghề làm hàng giờ hoặc hàng ngày, nên bạn làm việc đó hiếm khi. Đó là một sự kiện tập trung: bạn verify nó, đóng băng nó, rồi ship cái thứ đã đóng băng đó cho tất cả mọi người. Nên pipeline một chiều không phải tuỳ tiện. Nó là hệ quả trực tiếp của việc sản xuất phần mềm vừa đắt vừa rủi ro.
Và dĩ nhiên artifact đóng băng có những lợi thế: reproducibility (tái lập được), reviewability (review được), rollback, và mọi đảm bảo mà ta dựa vào trong production đều chảy ra từ một sự thật duy nhất: chỉ có một artifact, và nó không đổi sau khi ta ship. Đó là thoả thuận: một version cho tất cả, đóng băng. Ta có được độ tin cậy, nhưng cái giá là phần mềm không thể thật sự dành cho bất kỳ ai cụ thể. Và không ai từng đưa ra quyết định đó.
4. Không ai chọn "một version cho tất cả"
Chưa từng có một cuộc họp nào mà ai đó đặt lên bàn hai phương án, "một version cho tất cả" và "một version cho mỗi người", rồi chọn phương án đầu. Và lý do không phải vì phương án thứ hai, mỗi người một version, tệ hơn. Đơn giản là nó không phải một lựa chọn. Cho hai user hai phần mềm khác nhau nghĩa là fork codebase và bảo trì cả hai bằng tay. Một version cho mỗi user ở bất kỳ quy mô thực tế nào đều không khả thi, nên "một version cho tất cả" chưa bao giờ phải thắng một cuộc tranh luận nào. Nó chỉ là như vậy. Nó là hình dạng duy nhất mà phần mềm có thể có.
Rồi ta bắt đầu coi đó là một sự thật về phần mềm, giống như trọng lực, một thứ đương nhiên đúng. Nhưng nó chưa bao giờ thật sự là sự thật về phần mềm. Nó là sự thật về chi phí, ngân sách, kinh tế học. Và chi phí đó vừa thay đổi.
5. Điều thú vị không phải là "AI biết code"
Iris nói khán giả có lẽ đang chờ chị chuyển sang "AI biết code rồi". Nhưng ai cũng đã nói điều đó, nó là table stakes, và với chị đó không phải phần thú vị. Phần thú vị là ở chỗ chi phí để sản xuất ra một thay đổi đúng và có phạm vi rõ ràng (a correct and scoped change) đang sụp về gần bằng không, và nó sụp ở đâu, theo cách nào.
Quan trọng không kém: việc sản xuất phần mềm không còn phải diễn ra ở một nơi, từ trước, trước khi bất kỳ ai chạy nó. Một phần có thể chạy trên server, một phần trên client, một phần ngay trong live session của user. Khi từng bước thôi là một quyết định bạn đóng băng lúc build và bắt đầu trở thành một quyết định real-time, thì mỗi mảnh cũng có thể được đặt ở nơi hợp lý nhất, kể cả ngay trước mặt user, trong context của họ.
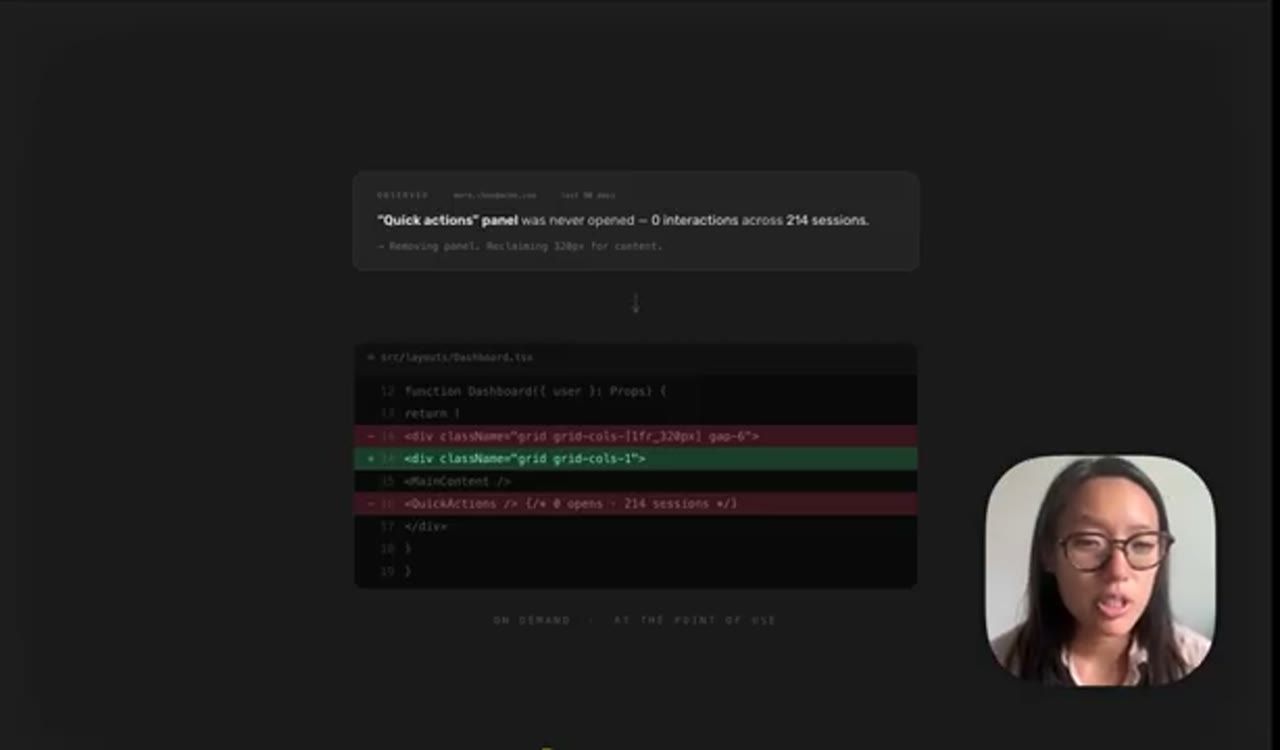
src/layouts/Dashboard.tsx: grid hai cột đổi thành một cột và component QuickActions bị xoá.6. Vì sao development và distribution từng phải tách nhau
Toàn bộ pipeline một chiều tồn tại vì làm ra phần mềm là sự kiện đắt đỏ, tập trung và hiếm, còn chạy nó thì rẻ. Nên ta tách development ra khỏi distribution. Nhưng giờ, khi tạo ra một thay đổi rẻ ngang với chạy một thay đổi, và nó có thể xảy ra ngay tại nơi phần mềm đang chạy, thì lý do để tách hai thứ đó ra đang tan biến.
7. Phía cầu: người dùng luôn muốn phần mềm vừa với mình
Tới đây chị mới nói về phía cung: sản xuất code đã trở nên rẻ và dễ, ta có thể tạo thay đổi cho từng user. Nhưng chị cũng muốn nói về phía cầu. Con người luôn muốn phần mềm vừa với họ, và ta có hàng thập kỷ bằng chứng cho điều đó. Chỉ là với phần lớn các loại phần mềm thì điều đó không khả thi vì chi phí.
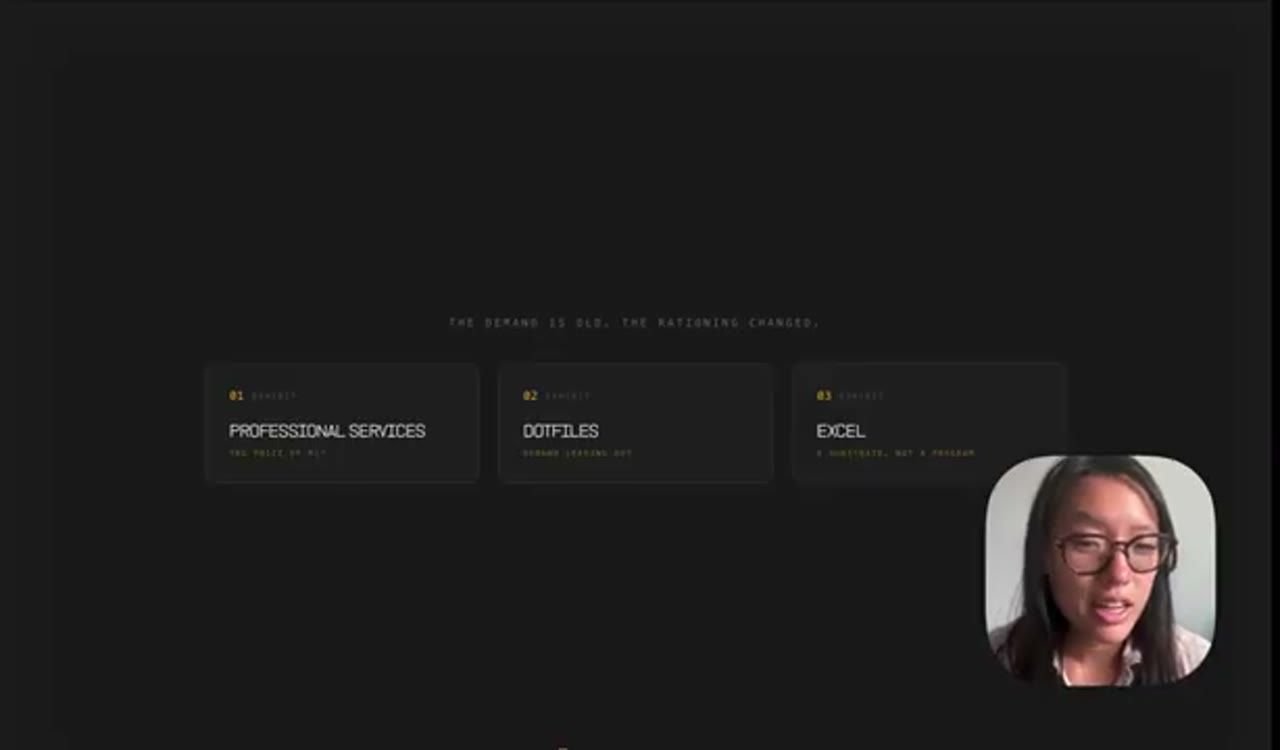
Ví dụ đầu tiên: forward-deployed engineer. Phần mềm enterprise luôn có một dòng chi phí gọi là professional services, và cả một ngành công nghiệp tồn tại quanh nó. Nếu bạn là khách hàng lớn của một công ty như Salesforce, có lẽ bạn có consultant giúp bạn triển khai setup và cấu hình riêng. Bạn có một engineer sống luôn trong Slack channel của bạn. Không phải các khách hàng nhỏ hơn không được lợi từ kiểu customization này; chỉ là cho tới hôm nay nó không hợp lý về tài chính.
Ví dụ thứ hai, chắc sẽ chạm tới các bạn là engineer: dotfiles của bạn, editor config, key bindings. Bạn tự tay dựng lại mọi công cụ mình đụng vào thành công cụ của riêng bạn, trên mọi máy. Đó là một ví dụ khác về nhu cầu phần mềm được cá nhân hoá.
Cuối cùng, Excel, phần mềm doanh nghiệp thành công nhất từng được tạo ra. Excel không thật sự là một chương trình tĩnh. Nó là hàng triệu người, ai cũng xây chương trình của riêng mình bên trên nó. Như vậy rõ ràng: hãy trao cho con người sức mạnh làm ra phần mềm, làm cho phần mềm của họ thành của họ, và họ sẽ nắm lấy.
8. Social feed, feature flag và những cái bucket khai báo trước
Ta cũng đã thấy trên social feed rằng cá nhân hoá theo từng user thắng kiểu one-size-fits-all trên mọi metric quan trọng. Chị thừa nhận đây là ví dụ về content hơn là về phần mềm. Nhưng giờ, khi đã có coding agent và coding agent ngày càng tốt hơn, ta có thể đưa điều này xuống cả tầng phần mềm.
Ý chị là không có nhu cầu nào ở đây thật sự mới. Ta đã thấy nó hàng thập kỷ. Đã có những thứ đi trước như feature flag, segmentation, A/B testing, với cả một ngành công nghiệp khổng lồ xoay quanh chúng. Ta đã cố làm cho phần mềm phân nhánh từ nhiều năm nay, nhưng bị ép vào một hình dạng cụ thể: tạo ra những bucket và segment phải khai báo từ trước. Và giờ, lần đầu tiên, ta có thể làm phần mềm thật sự adaptive.
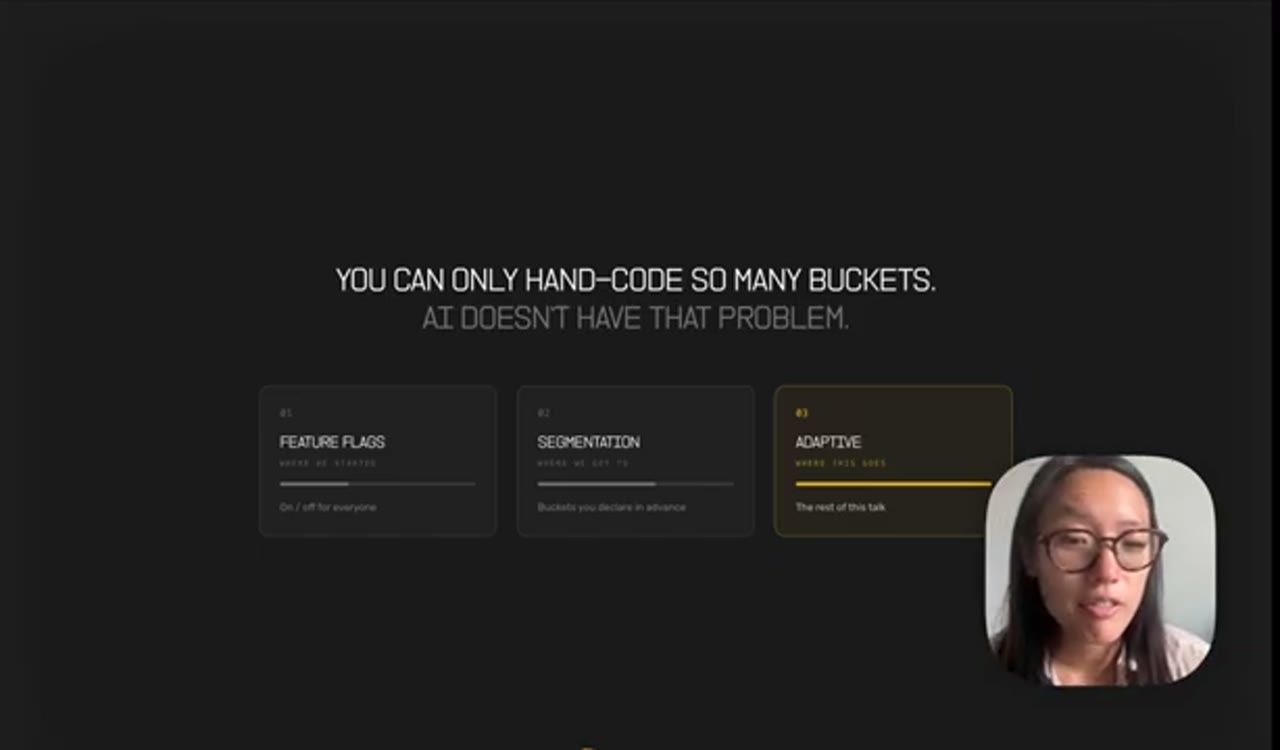
9. Khi agent là runtime: một stem, mỗi user một divergence
Quay lại tiêu đề talk: khi agent là runtime, khi chính thứ đang chạy phần mềm của bạn cũng có thể sửa nó, thì development và distribution thôi là hai giai đoạn. Ranh giới mờ đi, rồi biến mất.
Hình dạng mà Differ đặt cược là thế này: thay vì một codebase được chặn bởi các flag và ship cho tất cả mọi người, bạn deploy một canonical stem (thân gốc chuẩn), và mỗi user chạy divergence riêng của nó. Cùng một gốc, nhưng được điều chỉnh live cho từng cá nhân. Đó là đi từ "version ít tệ nhất cho tất cả" sang "version tốt nhất cho bất kỳ ai".
10. Lời phản bác của một CTO và câu trả lời
Nếu bạn là dân infrastructure, có lẽ bạn đang hơi lo, bụng đang cồn cào, vì chị vừa xoá đi cái frozen artifact, mà frozen artifact lại chính là thứ đang chống đỡ cả toà nhà. Differ có nhận những phản bác như vậy. Ví dụ, trong một cuộc gọi gần đây, một CTO, và theo chị ông ấy hoài nghi là đúng, đã nói đại ý: "Tôi đã gần như không thể suy luận nổi về một codebase do AI sinh ra, giờ cô muốn tôi chạy hàng triệu cái như thế? Cô không mô tả một năng lực. Cô đang mô tả vấn đề tồi tệ nhất của tôi, nhân lên."
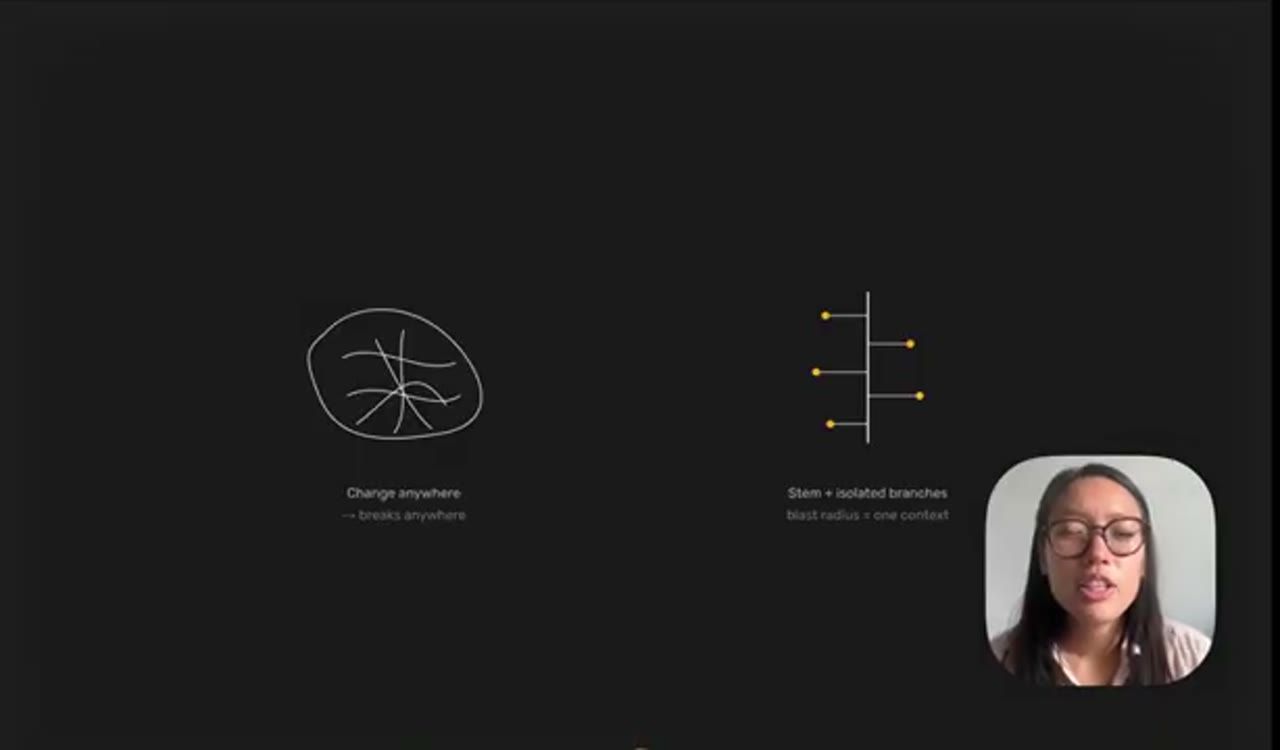
Nếu đó là phản ứng của bạn thì không có gì lạ. Đó là bản năng đúng, chỉ có điều có lẽ nó đang nhắm sai mục tiêu. Đây là sự phân biệt mà Differ đưa ra. Sự giòn gãy (brittleness) bạn đang hình dung là một failure mode cụ thể: sự phân nhánh không được quản lý bên trong một artifact duy nhất. File dài cả nghìn dòng, mọi thứ đều có thể chạm vào mọi thứ khác, không có ranh giới. Thứ đó giòn không nhất thiết vì nó do AI sinh ra. Nó giòn vì không có cấu trúc nào tách các thứ ra.
Trong tầm nhìn của Differ, các divergence theo từng user, nếu làm đúng, là điều ngược lại. Bạn có một stem cộng các divergence. Các divergence bị giới hạn phạm vi (bounded), cô lập (isolated), và đảo ngược được riêng lẻ (individually reversible). Một variant tệ không thể âm thầm làm hỏng stem hay lan sang user khác, nghĩa là blast radius của một thay đổi không phải cả hệ thống mà chỉ là một context, và bất kỳ divergence nào cũng có thể rollback live mà không cần deploy.
Nên câu trả lời cho lời phản bác kia không phải là "hãy tin chúng tôi, AI giỏi coordination hay giỏi code". Câu trả lời thật là: bạn giòn vì có một artifact rối rắm không có ranh giới. Differ không ship cho bạn một nghìn artifact rối rắm. Differ ship một stem và các divergence có giới hạn, mỗi cái cô lập, mỗi cái đảo ngược được. Thứ bạn đang sợ chính là thứ kiến trúc này sinh ra để ngăn.
11. Developer vẫn đặt ranh giới: ví dụ cái form
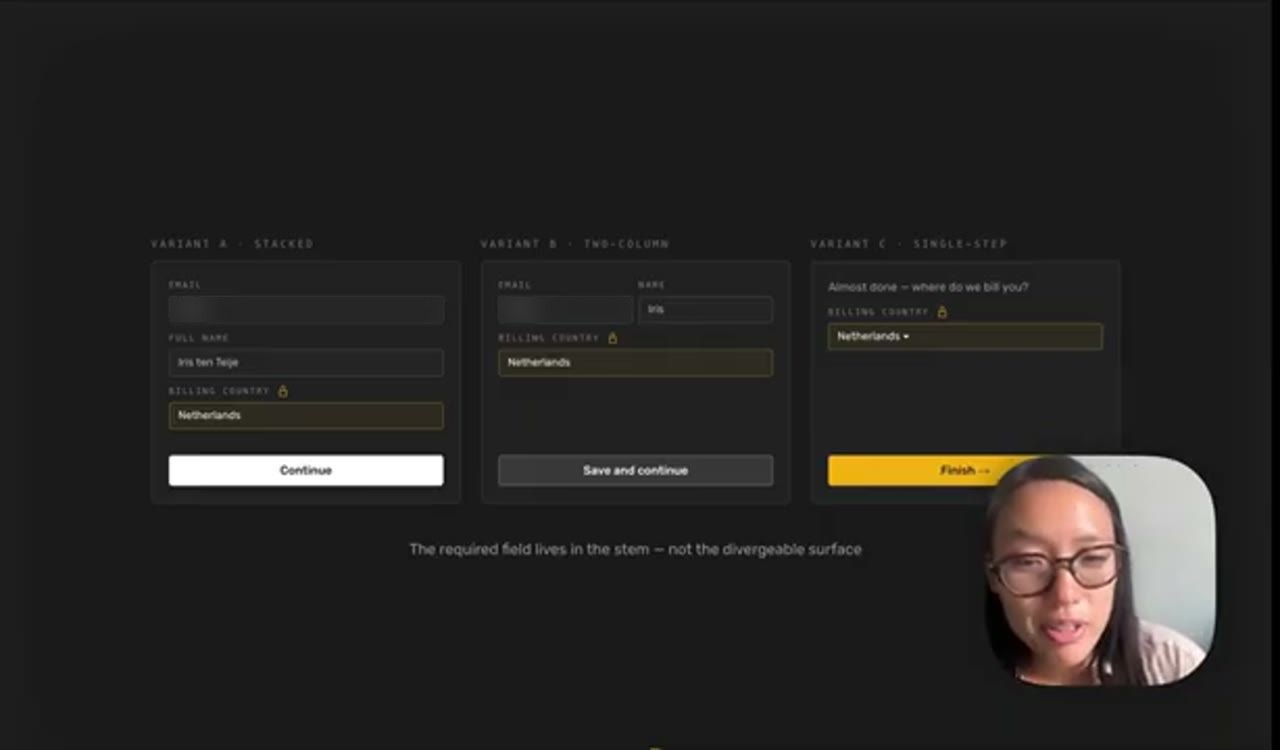
Là developer, bạn cũng có thể đặt control và ranh giới: cái gì được và không được adapt. Một ví dụ nhỏ: có một cái form, và form đó có thể được điều chỉnh để tăng conversion rate. Tuy vậy, developer luôn có thể chỉ định rằng một số field cụ thể không bao giờ được bỏ đi, hoặc những phần của app như auth hay payments luôn nằm ngoài giới hạn của mọi kiểu adaptation.
12. Ví dụ CRM: một nhà đầu tư dùng phần mềm viết cho dân sales
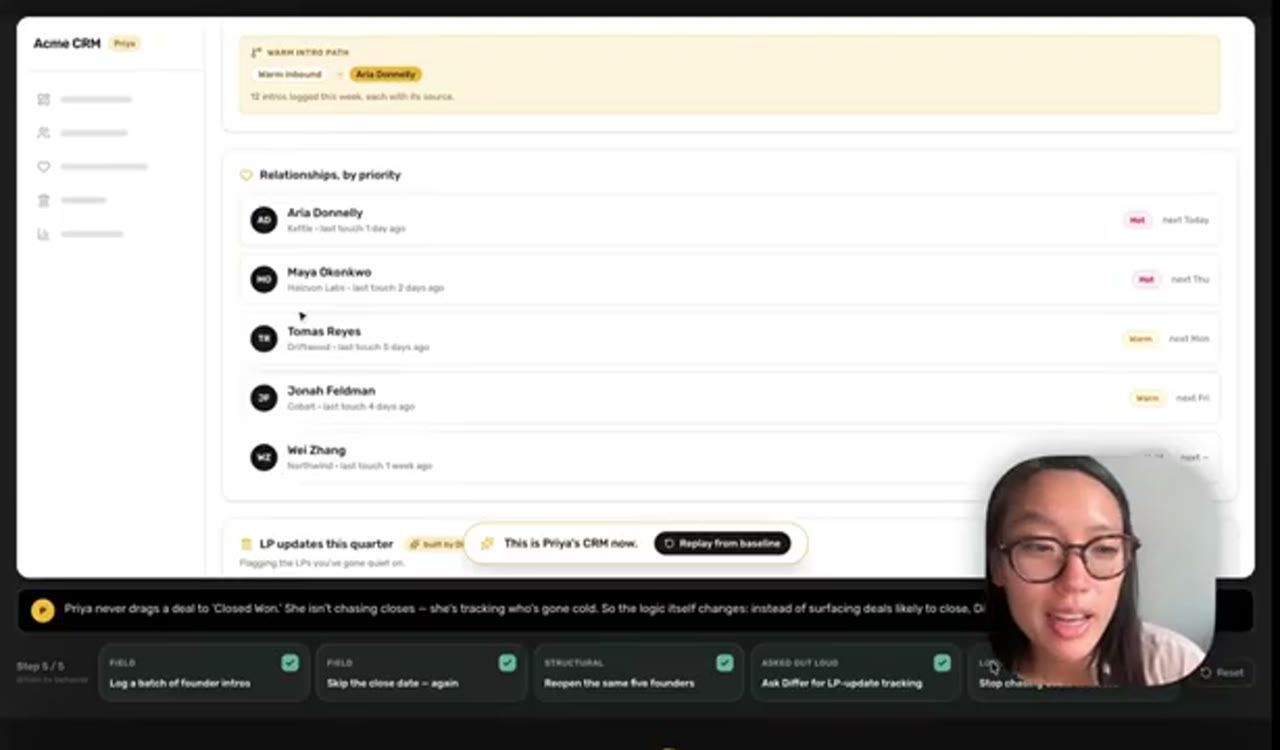
Để adaptive software cụ thể hơn, Iris lấy ví dụ một CRM. Ở đây có một nhà đầu tư đang dùng CRM, trong khi CRM chủ yếu được xây với hình mẫu người dùng là một salesperson. Là nhà đầu tư, chị ấy dùng nó hơi khác. Nhà đầu tư này thường xuyên ghi lại các lượt giới thiệu founder (founder intros), và luôn ghi ai đã giới thiệu mình tới deal nào. Hệ thống quan sát điều đó và tạo ra một "intro path", con đường giới thiệu.
Hệ thống cũng quan sát thấy chị ấy luôn bỏ qua một số field nhất định, không bao giờ điền. Nên theo thời gian hệ thống học được và không hiện các field đó nữa, mà thay vào đó hiện những field chị ấy quan tâm hơn. Một ví dụ khác: chị ấy luôn kiểm tra những loại deal hay founder cụ thể, và việc đó không đi theo đúng thứ tự ưu tiên mà hệ thống đặt mặc định. Vậy một lần nữa, ta có thể học và làm cho nó thông minh hơn, để thông tin mà user quan tâm được đưa lên trước không?
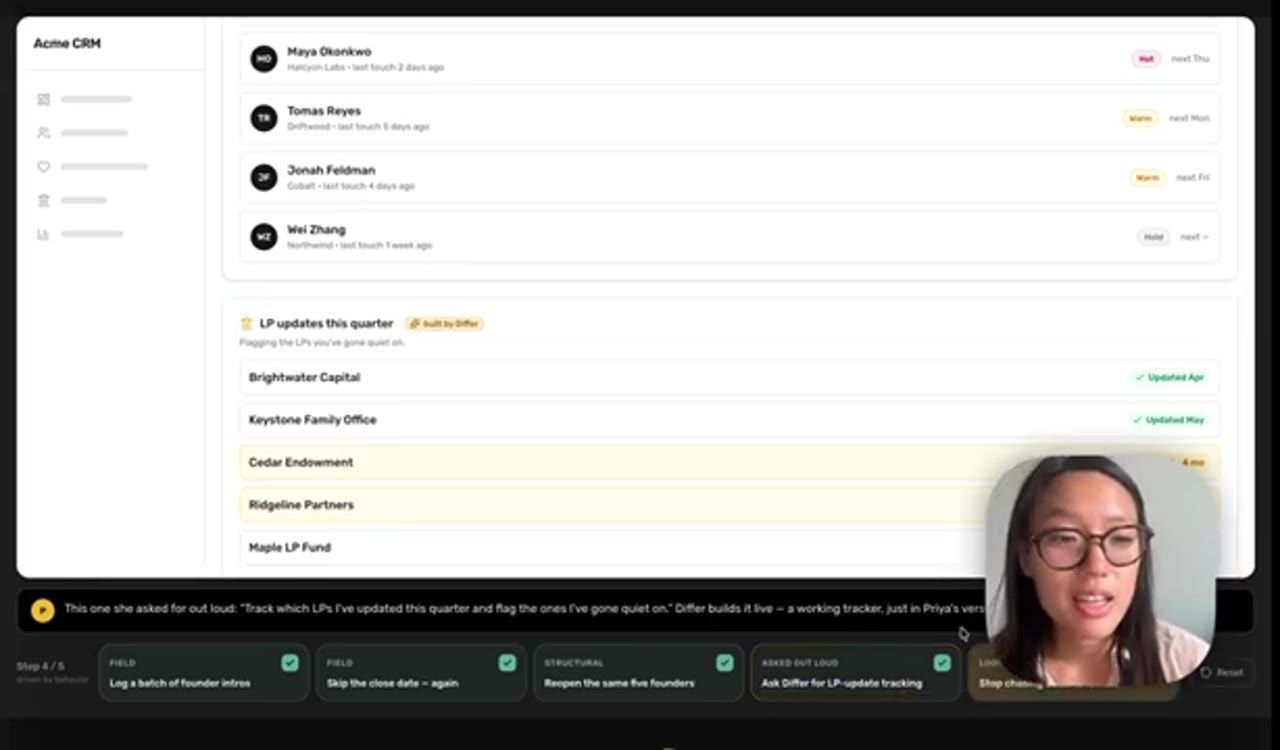
Không chỉ hệ thống quan sát. Ý tưởng là user cũng có thể chủ động yêu cầu thay đổi, và miễn là những thay đổi đó nằm trong ranh giới mà developer đặt ra, miễn là chúng nằm trong tinh thần của phần mềm, tức trong mục đích mà phần mềm ban đầu được làm ra, thì chúng có thể được hiện thực mà không cần quay lại tìm developer. Hãy hình dung với một horizontal SaaS như CRM, bạn có thể phục vụ một dải customer persona rộng hơn nhiều mà không tăng chi phí R&D.
13. Phần khó số 1: source of truth và observability
Dĩ nhiên có rất nhiều phần khó để đưa điều này vào đời thật. Iris bàn về một vài thách thức và bài toán khó mà Differ đang làm khi biến adaptive software thành hiện thực ở quy mô lớn. Họ chưa giải được tất cả, nhưng có quan điểm về từng cái, và đó chính là thứ họ làm ngày này qua ngày khác.
Vậy điều gì thay đổi khi không còn một artifact duy nhất? Trước hết là source of truth. Khi không có artifact duy nhất, bạn có thể tự hỏi: phần mềm là cái gì? Differ coi phần mềm là stem cộng toàn bộ các divergence immutable. Nhưng điều đó tạo ra một bài toán lineage (dòng dõi): user này đang chạy cái gì, và tại sao? Câu hỏi đó giờ giống một graph query hơn là một version number. Một bug report mô tả một chương trình chỉ tồn tại cho riêng user đó. Bạn debug hay inspect nó thế nào?
Câu trả lời là mọi divergence đều immutable, inspectable (kiểm tra được) và attributable (truy được nguồn gốc). Ta cũng cần truy được bất kỳ version nào ngược về chuỗi: tín hiệu này dẫn tới recommendation cụ thể này, rồi tới adaptation chính xác này. Đó là một trong những phần Differ đang làm.
14. Phần khó số 2 và 3: correctness và desirability
Thứ hai là correctness. Làm sao bạn test được rằng code change vừa hiện thực hoạt động, rằng UI đúng? Test ở quy mô user lớn hơn nhiều nghĩa là bạn phải suy luận về stem và cả mọi divergence có thể có của nó.
Rồi tới desirability, vì có thể bạn tạo ra một code change hoàn toàn đúng và chạy tốt, nhưng bạn còn cần biết nó có đáng mong muốn không, nó có thật sự là một thay đổi tốt không. Giờ ai cũng tạo được code change, phần khó là biết mình có thật sự tìm ra một cải thiện, một uplift hay không. Đó là thứ cực kỳ quan trọng để theo dõi, đo đạc, và cân nhắc theo mục tiêu của công ty. Mục tiêu này sẽ không giống nhau cho mọi phần mềm. Có trường hợp là retention, hoặc giảm churn, hoặc giảm số support ticket. Nên phải theo dõi thật sát ta đang đuổi theo những mục tiêu nào với adaptive software, và các adaptation có thật sự cải thiện những metric quan trọng hay không.
15. Phần khó số 4: autonomy hay control
Tiếp theo là autonomy versus control. Câu trả lời bảo thủ ở đây sẽ là: bắt đầu chỉ với recommendation, đừng thực hiện thay đổi tự động nào. Đó không phải chiến lược sai, nhưng với Differ thì đó không phải tầm nhìn. Tầm nhìn là một hệ thống hiểu user đủ rõ để hành động mà không cần lần nào cũng xin phép developer trước.
Nên với họ, thách thức không phải là xây thêm control, mà là giành đủ niềm tin để bạn không cần tới control. Đó là bài toán khó, nhưng cũng rất thú vị: làm sao để một hệ thống đủ tốt, đủ dễ hiểu (legible), đủ đáng tin để những con người đang ở trong vòng lặp (human in the loop) tự chọn lùi lại? Đó chắc chắn là điều Differ đang hướng tới.
16. Phần khó số 5: coordination, merge intent chứ không merge code
Cuối cùng là coordination. Ai cũng ở trên version riêng của mình, vậy bạn đẩy update mới thế nào? Các thay đổi lan tới, chẳng hạn, một triệu version khác nhau ra sao? Đây là một trong những thách thức Differ nghĩ nhiều nhất. Câu trả lời họ cứ quay lại mãi là: "Đừng merge code, hãy merge intent, merge outcome." Nghĩa là không phải ai cũng phải chạy cùng một commit hay đúng cùng một đoạn code, nhưng mọi người đều hội tụ về cùng một mục tiêu theo con đường riêng của mình.
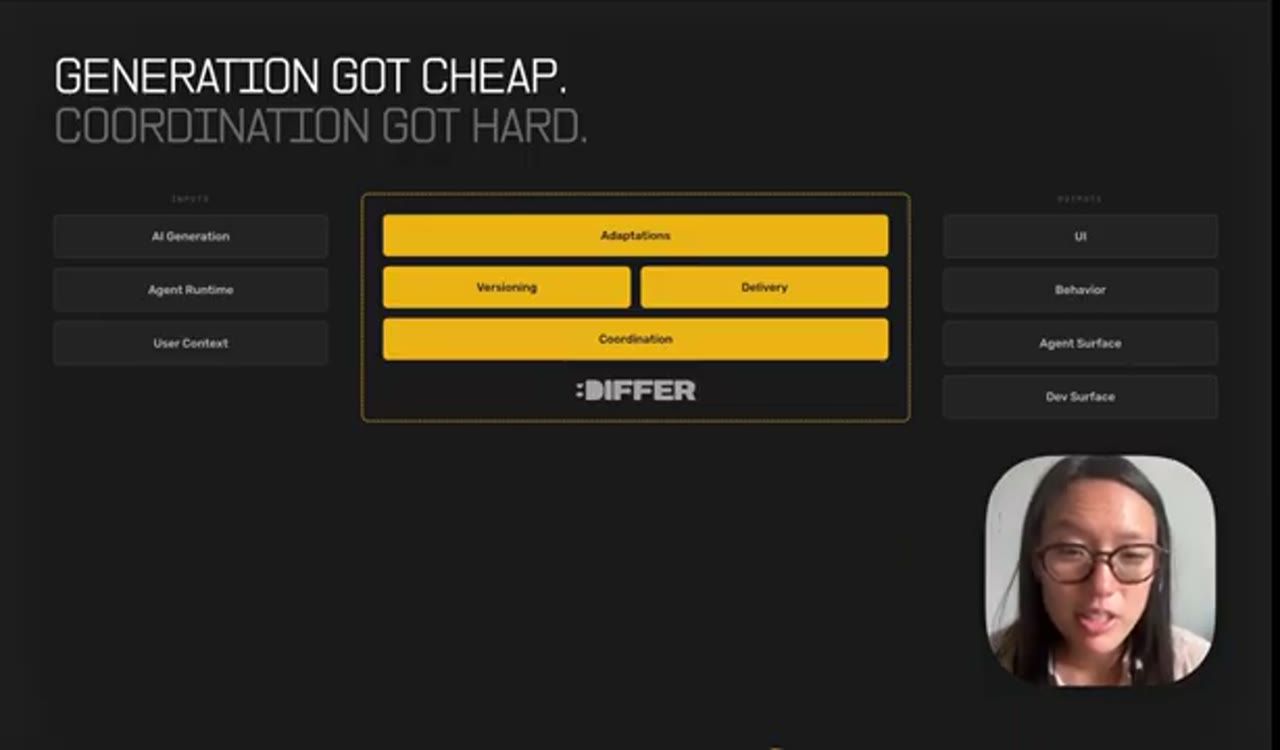
17. Generation là 80% dễ, phần còn lại mới là cả doanh nghiệp
Nếu chưa đủ rõ thì những thách thức vừa nêu mới là phần khó. Generation đã trở nên dễ, và chị nói đó thật ra là 80% dễ. Gọi một model để viết ít code là việc ai cũng làm được. Phần còn lại, observability, validation, coordination, đó mới là toàn bộ việc kinh doanh. Ai cũng gọi được một LLM, nhưng cái substrate, tức stem cộng các divergence, provenance (nguồn gốc), validation, mới là phần thật sự khó và là thứ Differ làm mỗi ngày.
18. Kết: ngân hàng không chi nhánh, build server năm 2008
Để khép lại, Iris kể: khi chị bắt đầu làm fintech, một ngân hàng không có chi nhánh nghe có vẻ liều lĩnh. Một thập kỷ sau, chi nhánh mới là thứ kỳ quặc. Co-founder Noam của chị từng phải tranh cãi với các engineer về chuyện tại sao cần build và CI. Ta đã thấy những cú chuyển như thế trước đây, và adaptive software cũng là kiểu chuyển dịch như vậy. Nó không có vẻ hiển nhiên, cho tới khi nó trở nên hiển nhiên.
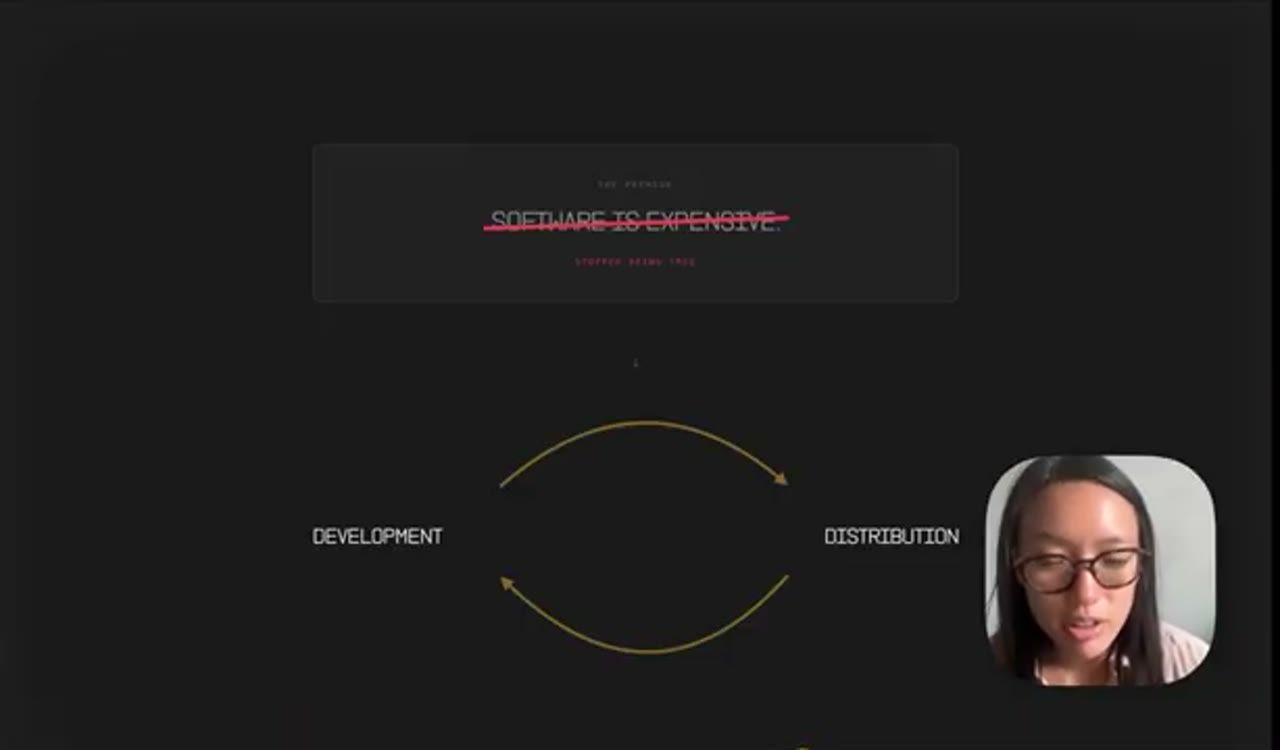
Quay lại điểm đầu talk: pipeline không thất bại vì nó không còn chạy được, mà vì ràng buộc mà nó được xây ra để phục vụ đã biến mất. Giả định bên dưới nó, rằng phần mềm đắt nên ta cần đóng băng và ship một lần, đã thôi còn đúng. Và khi làm ra phần mềm rẻ ngang với chạy nó, đường ranh giữa distribution và development không còn là một đường ranh nữa.
Ta đã dành hai mươi năm để trở nên giỏi trong việc ship một version cho tất cả mọi người. Hai mươi năm tới là về việc ship đúng version cho bất kỳ ai, với sự cô lập (isolation) và provenance khiến chuyện đó an toàn thay vì đáng sợ. "Tôi là Iris, đây là Differ, và đó là thứ chúng tôi đang xây." Chị cảm ơn mọi người đã theo dõi.
Nguồn và liên kết
- Trang talk chính thức trên ai.engineer
- Video gốc trên kênh AI Engineer
- Differ, hạ tầng cho adaptive software
- JFrog, nơi Noam là engineer đầu tiên
- Iris ten Teije trên X: x.com/iristenteije
Related talks
Browser Agents Don't Need Better Models. They Need Better Eyes.
Kushan Raj · Sarvam AI · 4 min
Browser agent chậm và hay kẹt vì nhìn trang quá tệ: một bản markdown cả trang (~1.800 token) cộng feedback sau mỗi click giúp model rẻ chạy nhanh và đúng.
Your Agent Failed in Prod. Good Luck Reproducing It.
Tisha Chawla & Susheem Koul · Microsoft · 14 min
Vì sao temperature 0 không làm agent deterministic, và cách record ở boundary để replay một lỗi prod, stub LLM rồi biến trace thành test case.
MCP Apps: Primitives, Discovery, and the Future of Software
Pietro Zullo · Manufact · 29 min
MCP Apps: tool trả UI vào chat, các primitive setState, ui/message, streaming input, giấu dữ liệu khỏi model, và cách submit lên store của ChatGPT, Claude, Cursor.