Turn 10,994 Notes Into Your Agents' Memory
AI Engineer World's Fair 2026: Online Track · Video gốc
Biến hơn 10.000 note thành memory cho agent bằng plain file: deep research trên second brain, ba layer raw, index.yaml, wiki, không cần vector DB.
1. Mười nghìn note và một reading list thành nghĩa địa
Paul Iusztin mở đầu bằng một câu: anh đã dành 18 tháng để biến second brain của mình thành một living research memory, một bộ nhớ research còn sống. Trong second brain của anh hiện có hơn năm nghìn note trong Obsidian, thêm khoảng năm nghìn note nữa trong Readwise, và một ít nằm rải rác ở Notion và Google Drive. Tất cả những thứ đó vẫn đang lớn lên, trung bình khoảng hai trăm năm mươi file mỗi tháng.
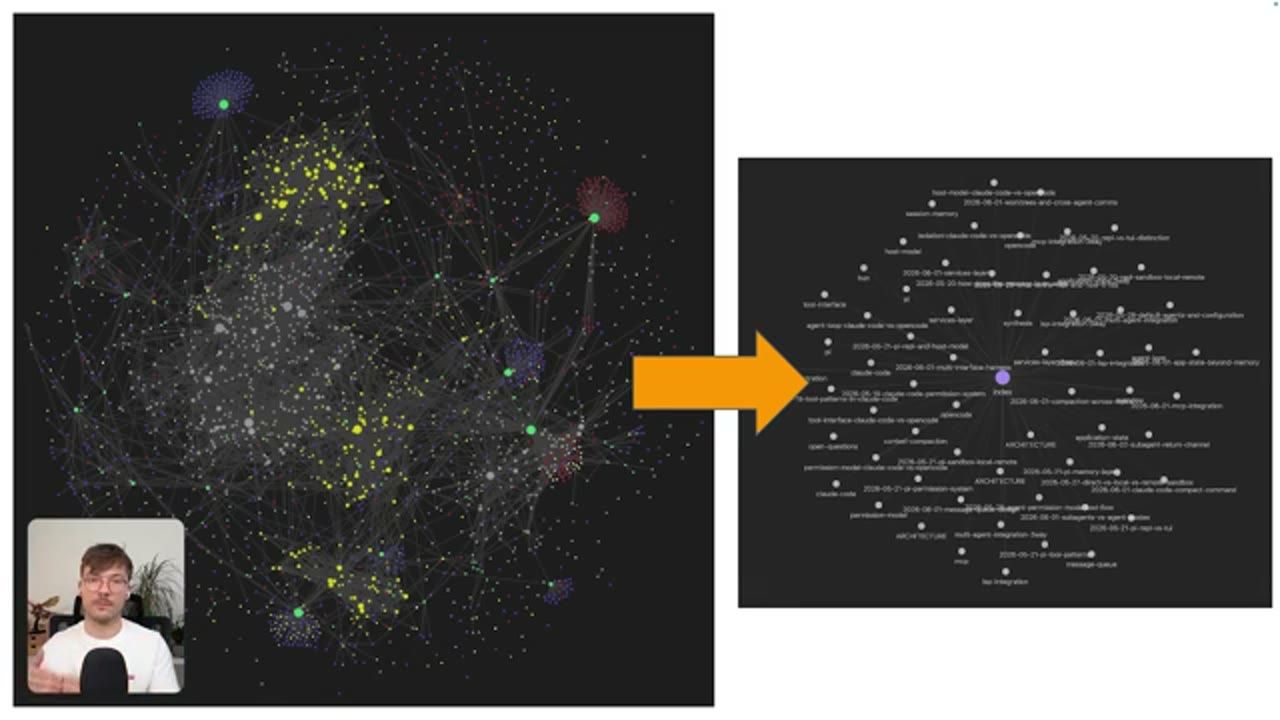
Thứ anh muốn có thể hình dung như sau. Bên trái là toàn bộ vault Obsidian của anh, một mớ hỗn độn khổng lồ. Mỗi khi anh bắt đầu làm một việc gì đó, có thể là một bài viết, một project mới, một code base mới, một feature mới, hay bất cứ thứ gì, anh muốn kéo ra được đúng những note có high signal, những note thật sự hữu ích cho công việc đang làm. Bên phải là kết quả mong muốn: một subgraph nhỏ, gọn, chỉ chứa phần liên quan.
Câu hỏi tự nhiên là: sao không dùng thẳng Codex, Claude hay NotebookLM? Paul trả lời rằng anh có dùng, nhưng cần một hệ thống nằm ở giữa những harness đó và second brain của mình.
Quay về gốc của vấn đề: Paul luôn đánh mất research của chính mình. Ví dụ, reading list của anh là một nghĩa địa. Khi lướt mạng xã hội và lưu lại một post hay trên X, một bài báo mới, một video YouTube mới, một GitHub repository, loại nào cũng vậy, thì tới lúc thật sự bắt đầu làm việc, anh không bao giờ nhớ ra mình đang có gì trong second brain. Hoặc anh phải tốn rất nhiều thời gian chỉ để tìm ra vài note có ý nghĩa dùng được cho công việc.
Vấn đề thứ hai: anh muốn hệ thống được neo vào chính note cá nhân của anh, vào giá trị cá nhân, vào gu của anh. Anh muốn hệ thống mang tính cá nhân, phản ánh suy nghĩ của chính anh. Vì thế trong talk này, Louis-François và Paul sẽ dạy cách xây một AI Research OS của riêng bạn, kèm theo code để bạn tự chạy thử.
Paul giới thiệu mình là founder và CEO của Decoding AI, nơi anh làm rất nhiều content và course về cách ship sản phẩm AI. Anh cũng là đồng tác giả cuốn bestseller LLM Engineer's Handbook. AI Research OS mà anh sẽ trình bày chính là hệ thống anh dùng trong công việc hằng ngày. Rồi anh chuyển lời cho Louis-François.
Louis-François Bouchard cảm ơn Paul và tự giới thiệu: anh là co-founder và CTO của Towards AI, nơi họ xây các khoá học. Anh cũng là người làm What's AI, một kênh YouTube giải thích các kỹ thuật AI engineering.
2. Louis-François, và câu hỏi: dùng công cụ nào, khi nào
Trước đây kênh của Louis giải thích AI research, giờ thì tập trung vào AI engineering. Anh cũng là tác giả cuốn Building LLMs for Production. Trước tất cả những việc đó, anh là nghiên cứu sinh PhD. Nên nói thật, anh làm research để kiếm sống: từng làm PhD về AI, làm rất nhiều nghiên cứu. Bây giờ anh xây course, viết video, research cho video, và xây chương trình đào tạo cho các công ty. Tất cả những việc đó đều bắt đầu từ một khâu research thật tốt, và từ việc tận dụng rất nhiều kiến thức và insight mà Towards AI thu được khi build cho khách hàng.
Nên Louis cũng có rất nhiều note, giống Paul, và cả hai cố tận dụng chúng tốt nhất có thể. Họ đã xây một công cụ để khai thác second brain, và như sẽ thấy trong talk, cách Louis dùng nó khác với cách Paul dùng. Đó cũng chính là mục tiêu cốt lõi của repository họ xây trong project này: họ muốn bạn điều chỉnh nó theo nhu cầu của mình. Câu hỏi lớn là làm sao research tốt hơn, nhưng cụ thể hơn: làm sao tận dụng tốt hơn những gì mình đã có.
Việc đầu tiên là xác định nên dùng công cụ nào và khi nào, vì hệ thống research này không dành cho mọi câu hỏi. Nếu bạn chỉ cần một câu trả lời nhanh, vài câu hỏi ngắn, hay một thứ mà bình thường bạn sẽ Google, thì cứ Google, hoặc hỏi ChatGPT, Claude, hệ thống nào bạn thích. Vấn đề của cách đó là khi bạn có nhiều câu hỏi follow-up, hoặc đó là một project lớn mà bạn phải xây tiếp trên nó, cần một context rất dài hay rất nhiều thông tin để chia sẻ, thì dựa vào ChatGPT không lý tưởng. Nó còn có nghĩa là bạn phụ thuộc hoàn toàn vào kiến trúc mà đội OpenAI hay ChatGPT đã xây.
Bước tiếp theo: với một vấn đề phức tạp hơn, bạn cần hành động nhanh, hay bạn muốn xây feature tiếp theo và làm một việc rất khó? Nếu bạn chỉ có một repo nhỏ cần sửa nhanh, hay viết một bài báo, một việc bạn biết sẽ không lặp lại nhiều, thì cứ dùng Codex, Claude Code hay một agent nào bạn tin.
3. Khi nào NotebookLM, khi nào RAG, và vì sao cả hai chưa đủ
Có lúc bạn phải đào tiếp để làm cho tốt hơn, tăng hiệu quả, tối ưu thêm. Khi phải làm như vậy, bạn muốn các nguồn research của mình ở lại, để sau này còn tham chiếu được. Nếu bạn muốn một quy trình mà những nguồn bạn tìm được, những note bạn ghi lại tồn tại theo thời gian, và có một agent tận dụng chúng hiệu quả, quay lại được với thông tin đó, hỏi thêm câu follow-up, tiêu hoá nội dung sâu hơn, thì bạn cần một thứ khác.
Louis lấy ví dụ của chính mình: khi làm một video mới, anh muốn agent và hệ thống hiểu luôn những video anh đã làm trước đó, để không trùng nội dung, không lặp lại chính mình, và để trỏ sang những nội dung khác của anh.
Với nhu cầu đó, có những công cụ rất thú vị mà có thể bạn đã thử, như NotebookLM. Nó cực mạnh để research, để tiêu hoá nội dung hiệu quả và quay lại với nó. Nhưng vấn đề lớn nhất của NotebookLM là bạn không sở hữu nó. Bạn không làm được mọi thứ mình muốn với nó, không cá nhân hoá được tối đa. Nó không agent native, và rõ ràng là yếu cho các task coding, vì nó chỉ chạy trên browser. Nên nó còn xa so với thứ Paul và Louis cần, và thứ mà phần lớn AI engineer cần.
Nếu bạn cần agent của mình tận dụng được mọi thứ bạn làm, dù là một research lớn, một video mới, bất cứ thứ gì bạn viết, làm hay code, thì bạn thường muốn các agent khác và các project khác của mình tận dụng được những gì bạn vừa học được từ việc đó.
Một thứ họ khuyên dùng, nhất là cho production, cho một sản phẩm, là xây một pipeline retrieval kiểu RAG với vector database. Nhưng cái đó cần infrastructure. Nó không thân thiện với con người: khó đọc lướt nhanh, khó kiểm note, khó sửa. Khó soi bằng tay. Bạn phải xây mọi thứ xung quanh nó. Rõ ràng là xa lý tưởng nếu chỉ là thứ anh muốn dùng hằng ngày. Ở quy mô lớn nó cực mạnh, rất thú vị, nhất là trong một sản phẩm. Nhưng như Louis nói, project này là cho chính họ: anh không cần một thứ chạy live, chuyên nghiệp như một sản phẩm. Anh chỉ muốn một thứ mình sẽ thật sự dùng, và các agent cùng các project của anh tận dụng được tốt nhất có thể.
4. Mỗi phiên research bắt đầu từ số không
Câu hỏi cuối cùng cần tự hỏi: nếu bạn muốn có tất cả những thứ trên nhưng cá nhân hoá hơn, tức là một trợ lý research cá nhân xây nên một kiểu Wikipedia tích luỹ theo thời gian, dễ soi và dễ dùng, nơi bạn có rất nhiều nguồn, tài liệu, video, so sánh, implementation, research mới, chủ đề mới mà bạn liên tục thêm vào và liên tục muốn tận dụng và xem lại dễ dàng, thì đây là lúc bạn nên tự xây một thứ của mình.
Trong trường hợp của họ, họ đã xây một personalized research OS, và talk này chia sẻ chính xác họ đã xây gì và xây thế nào. Cái giá là nó cần setup nhiều hơn một chút so với chỉ mở Claude Code.
Hiện tại, vấn đề chính của việc dùng Claude Code và các công cụ agentic khác là: bạn đưa cho Codex link, PDF, đủ loại thông tin. Ví dụ, cho video gần nhất của Louis về loop engineering. Rồi tới phiên Codex tiếp theo, bạn phải dán lại tất cả, hoặc bảo nó dùng skill. Và bất kỳ cấu trúc nào mà Codex, ChatGPT hay công cụ nào bạn dùng tự dựng ra tại chỗ để tận dụng những gì bạn đã làm, những script nó chạy, những script nó có, bạn đều mất hết, hoặc chỉ còn giữ được bên trong một skill mà bạn phải nhớ bảo nó dùng lại. Cách đó thường không lý tưởng, và nó cứ phình mãi theo thời gian.
Vấn đề là: toàn bộ thông tin bạn đưa cho model không phải nút thắt. Nút thắt là làm sao tận dụng được nó trong tương lai. Với một agent, context window trở thành tất cả: database, file system, memory, không gian để suy luận. Nó phải gánh hết. Và khi bạn dừng cuộc hội thoại, nó mất sạch.
Điều quan trọng là để research tốt hơn, chúng ta không nhất thiết phải đưa thêm, thêm nữa, thêm mãi context. Bạn cần quản lý memory và context cho đúng, và lý tưởng là có chút cá tính đi kèm, nhất là trong trường hợp của Louis khi làm video. Nên họ quyết định xây một hệ thống bằng plain file, phần lớn là file markdown, thứ mà cả người lẫn agent đều tận dụng dễ dàng. Louis không đi sâu ở đây vì Paul sẽ nói kỹ phần đó.
Anh nhắc lại: Paul có khoảng năm nghìn note, còn Louis chỉ có vài trăm. Nhưng điều anh muốn nói là cả hai không bắt đầu từ con số không. Cả hai đều đã có sẵn một kiểu database khá lớn.
5. Hệ thống của Louis không bắt đầu từ số không
Louis đã làm hàng trăm video và ghi rất nhiều note. Anh vẫn cần tận dụng nhiều năm nội dung mình đã làm, cùng hàng tấn cuộc họp với team và với khách hàng khi build cho họ, vì họ học được rất nhiều khi build cho người khác. Anh có highlight từ những tweet hay, những bài báo hay. Và anh muốn mọi project của mình đều tận dụng được agent skill của anh.
Nên anh quyết định chuyển hướng. Thay vì một thư mục chứa skill của Claude Code, recap cuộc họp nằm trong Granola, nhiều năm note nằm trong Apple Notes, và tweet nằm trong một tab Chrome đã lưu, anh chuyển tất cả, một cách tự động, vào Obsidian. Obsidian chỉ là một trình đọc note, nên bạn không bắt buộc dùng nó, có thể chỉ lưu file local. Anh dùng Codex để setup mọi thứ, để Granola tự động lưu vào đó. Note của anh giờ ở Obsidian chỉ vì giao diện đẹp, anh thích nó, và dùng được từ điện thoại, máy tính, Windows, Mac, mọi nơi.
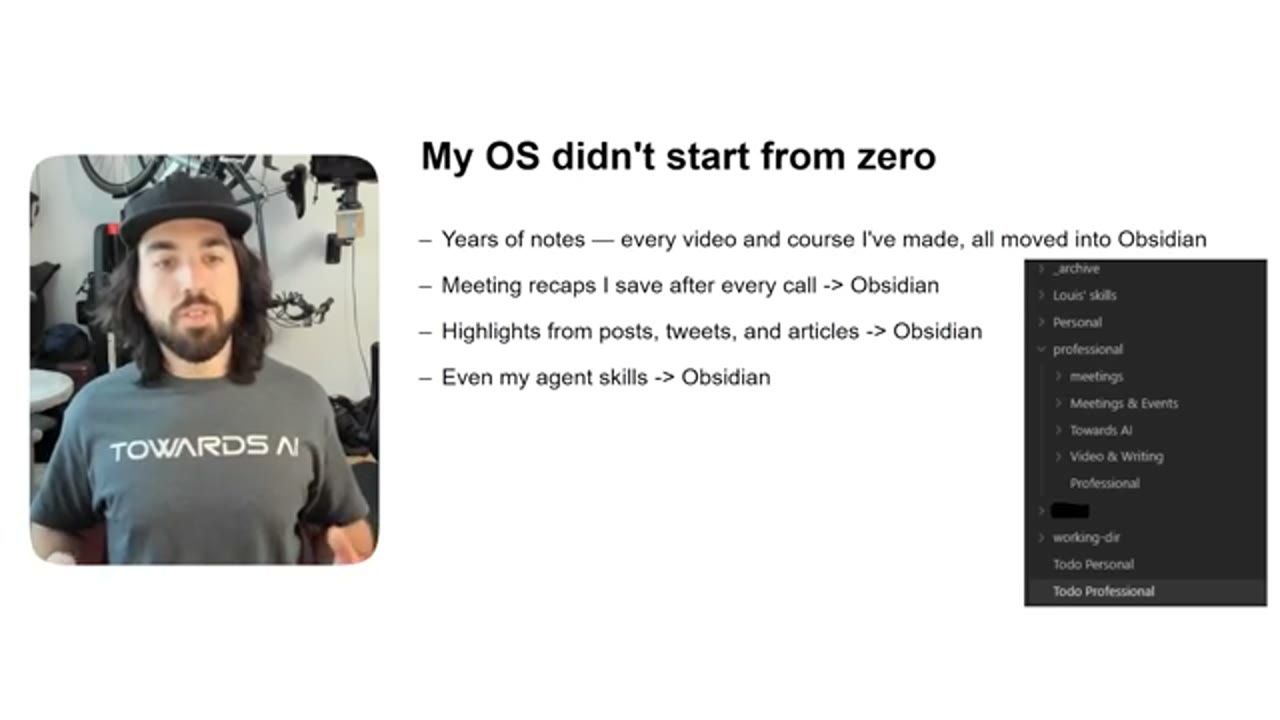
Vì đã chuyển hết vào Obsidian, mọi thứ được lưu local trên file system của anh, và vault đó về cơ bản trở thành người bạn đồng hành để anh research và build mọi thứ anh làm bây giờ. Thứ họ xây tận dụng chính điều đó.
Cho workshop này, họ xây một repo tên AI Research OS. Về cơ bản nó chỉ là các skill cho Claude Code và Codex, đóng gói dạng plugin, để làm một deep research rất sâu về một chủ đề, hoặc một lần search đơn giản hơn. Có nhiều công cụ khác nhau để dùng; cái hữu ích và đầy đủ nhất là công cụ research mà Louis dùng, ví dụ, khi bắt đầu một chủ đề video mới.
Mục tiêu của repo là để bạn cài đặt nó, cài các Claude plugin trong đó, rồi tinh chỉnh theo nhu cầu. Hiện nó kết nối được với Obsidian chứa note local, với Readwise, NotebookLM, các GitHub repo của bạn, mọi link GitHub hay video YouTube bạn gửi, link web, và tài liệu. Nhưng còn rất nhiều thứ thiếu, sẽ nói ở cuối, mà bạn tự thêm dễ dàng chỉ bằng cách bảo Claude Code hay Codex làm. Ví dụ, Louis thêm phần lấy transcript video YouTube, nói thật, chỉ trong vài giây, bằng đúng một prompt. Với Codex, thêm cái đó cực dễ.
6. Ba layer, và V1: một research.md tĩnh
Louis tổng kết phần của mình: cả repository và cả project này là một người bạn đồng hành rất hữu ích cho công việc của anh. Nhưng nó cũng hiện thực rất nhiều kỹ thuật context management và memory management state-of-the-art mà anh tin là AI engineer cần biết. Giờ Paul sẽ đi sâu vào hệ thống ba layer họ đã xây: raw content, index mà Louis đã nhắc, và phiên bản kiểu wiki, đã được tổng hợp, của toàn bộ note, research và công việc của bạn. Paul sẽ nói hết những gì họ đã làm, kết quả ra sao, và cách dùng.
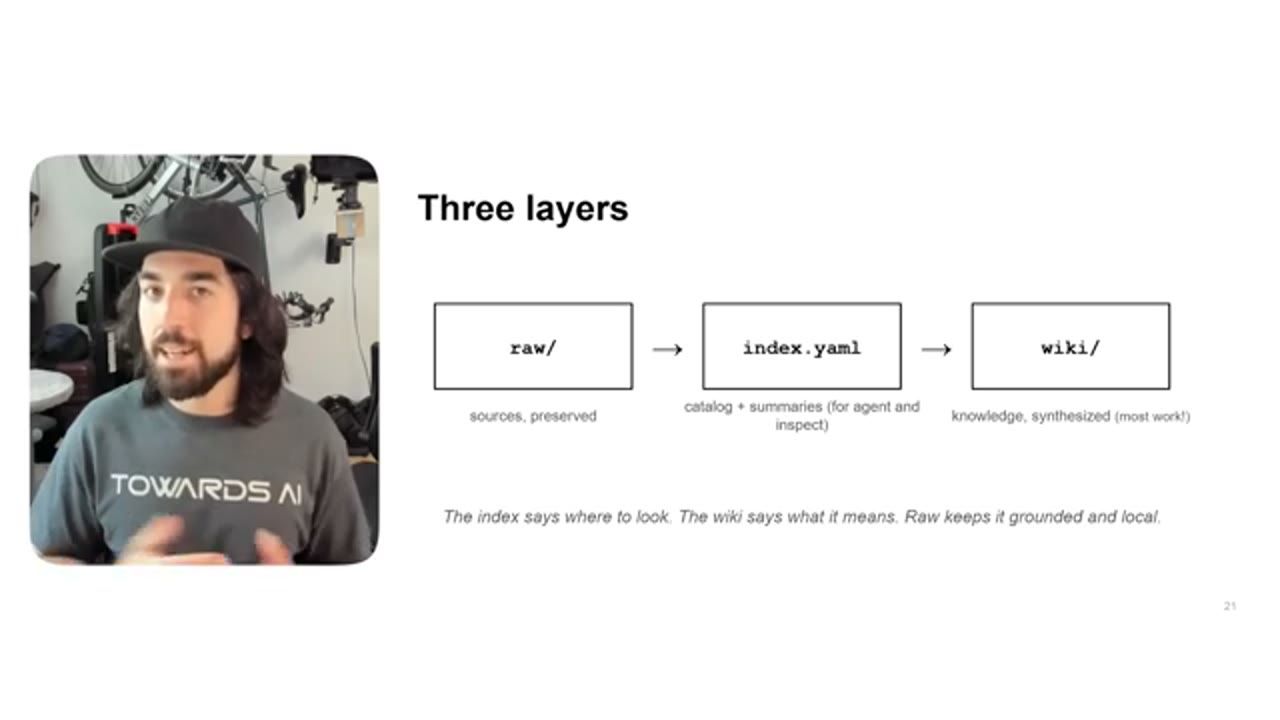
raw/ chứa nguồn, giữ nguyên; index.yaml là catalog kèm tóm tắt, cho agent đọc và cho người soi; wiki/ là kiến thức đã tổng hợp, nơi phần lớn công việc diễn ra. Dòng dưới cùng: index cho biết tìm ở đâu, wiki cho biết điều đó nghĩa là gì, raw giữ mọi thứ có căn cứ và nằm ở local.Paul đi qua ba phiên bản của hệ thống, nó tiến hoá ra sao theo thời gian, và quan trọng nhất là vì sao họ thêm độ phức tạp.
Ở phiên bản đầu tiên, họ chỉ muốn giới hạn nó vào việc tạo bài học cho course agent engineering của họ. Nên họ giữ nó cực kỳ đơn giản: input là một topic, output là một file research.md. Input gồm topic cộng một bộ golden link, những link do chính họ chọn tay. Họ chạy thuật toán deep research này, và output là một file research.md tĩnh.
Phóng to vào kiến trúc: trước tiên họ scrape các golden link, vì đã biết sẵn chúng, và dùng chúng làm seed context cho thuật toán deep research. Đây là một kỹ thuật rất mạnh, vì có thêm context thì biết cách đặt câu hỏi tốt hơn.
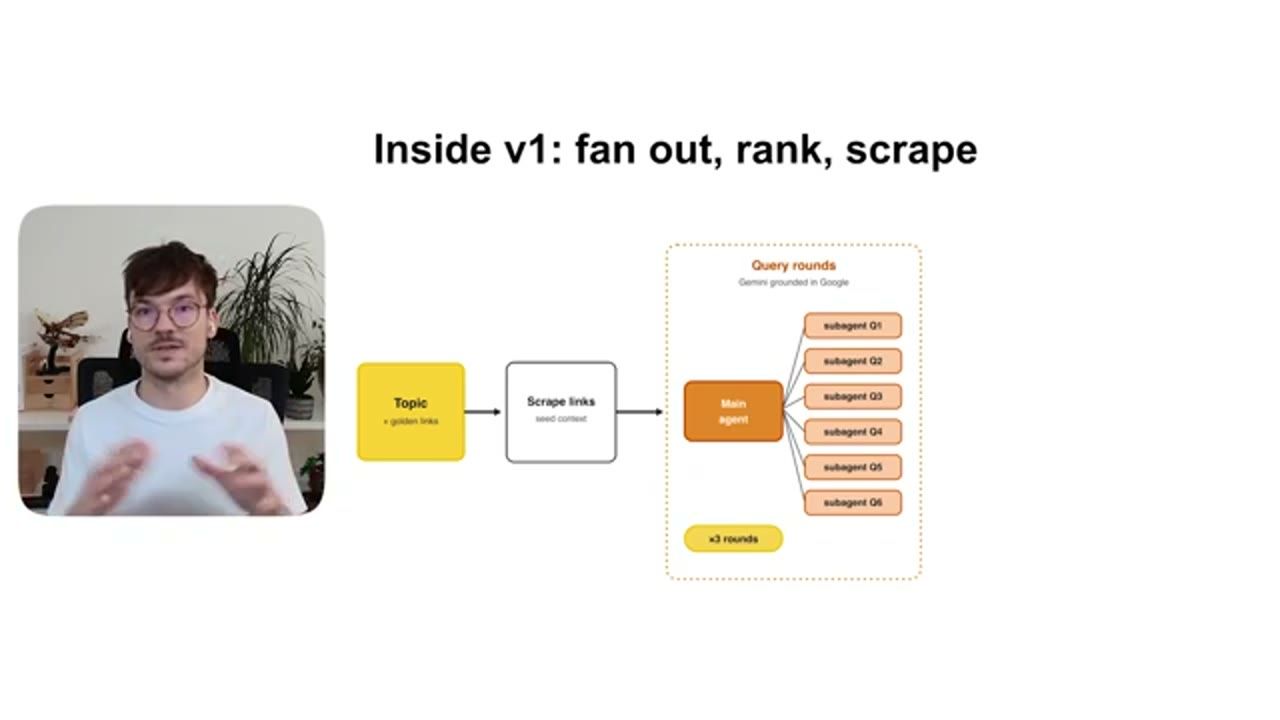
Trong các query round, họ dùng một thuật toán deep research rất kinh điển. Có một main agent làm orchestrator, tạo ra nhiều câu hỏi dựa trên topic ban đầu và context đã scrape. Mỗi agent con giữ một câu hỏi và dùng Gemini grounded in Google để query Google, gom nhiều nguồn. Mỗi agent con thu về nhiều link và viết một executive summary cho từng link. Rồi nó gửi toàn bộ thông tin đó về main agent. Main agent gộp tất cả lại dưới dạng tóm tắt, để context không bị nổ tung.
7. Ranking, 35 bài học, và V2: chĩa deep research vào second brain
Họ chạy như vậy ba vòng. Sau ba vòng, mỗi vòng sáu query, họ có khoảng bốn mươi, năm mươi link. Có thể hình dung là có rất nhiều nhiễu ở đó. Nên họ thêm một thuật toán ranking để tìm ra thông tin có signal cao nhất: so từng nguồn với topic ban đầu của người dùng. Rồi họ chỉ scrape đầy đủ top K phần tử theo điểm ranking; với các link còn lại thì chỉ giữ bản tóm tắt. Cuối cùng họ gộp tất cả vào file research.md, một file phẳng duy nhất, dùng cho từng bài học của course trong trường hợp của họ.
Nhưng như bạn đoán được, nó khá hạn chế. Với course thì nó chạy rất tốt: họ tạo ra 35 bài học rất nhanh. Nhưng họ muốn nhiều hơn.
Nên họ bắt đầu chĩa vòng lặp deep research này vào cả second brain. Trước đó, nó chỉ nhắm vào public web, khiến kết quả khá chung chung, và họ phải tự tay tìm tất cả golden link. Khi chĩa vòng deep research vào second brain, nơi họ vốn đã tự nhiên lưu lại mọi research họ thật sự muốn, đã được chính họ lọc, thì họ gom được golden link một cách tự nhiên vào thuật toán deep research.
Thuật toán mới trông thế nào? Về cơ bản vẫn là vòng lặp cũ, nhưng giờ nhắm vào nguồn của chính mình chứ không chỉ public web. Input giờ chỉ còn topic, vì không cần golden link nữa. Như Paul nói, golden link thật ra là một phản chiếu của hệ thống second brain. Về lý thuyết bạn vẫn có thể thêm chúng nếu thật sự muốn, nhưng cái đẹp của chiến lược mới là bạn chỉ cần đưa vào một topic, và nó sẽ tự tìm mọi thứ nó cần.
8. V3: research.md tĩnh là vấn đề, thêm wiki layer
Topic chỉ còn dùng làm seed cho context để sinh query. Rồi họ chạy đúng thuật toán deep research cũ, cùng các query round, nhưng thay vì chỉ nhắm vào public web, giờ họ cắm vào toàn bộ second brain: Obsidian, Readwise, NotebookLM, GitHub. Bạn cũng có thể dùng, ví dụ, Gemini deep research cho việc này, tương tự cách họ dùng NotebookLM. Hoặc mở rộng với bất cứ thứ gì bạn muốn: YouTube, Google Drive, Notion, hay thứ gì hợp với infrastructure của bạn. Ý tưởng là giờ các query từ thuật toán deep research nhắm vào second brain cộng public web. Sau đó vẫn áp dụng cùng các bước: ranking, scrape đầy đủ, tóm tắt, rồi gộp tất cả vào file research.md.
Nhưng giờ lại có vấn đề khác: file research.md này tĩnh. Nó là một đống dữ liệu tĩnh, mà research thường không tĩnh. Sau khi có file đó, bạn thường nhận ra mình muốn hỏi thêm một câu, hoặc có thông tin đã cũ và không cần nữa, hoặc đơn giản là bạn muốn nhiều hơn từ file đó. Nghĩa là bạn phải chạy lại tất cả từ đầu. Mà thao tác vừa mô tả là một thao tác đắt: nó tốn rất nhiều token và rất nhiều thời gian, nên bạn không muốn chạy lại từ đầu.
Vì thế cần thêm một wiki layer lên trên. V3 của hệ thống chính là thuật toán deep research cộng một LLM knowledge base ở trên, hay còn gọi là wiki layer.
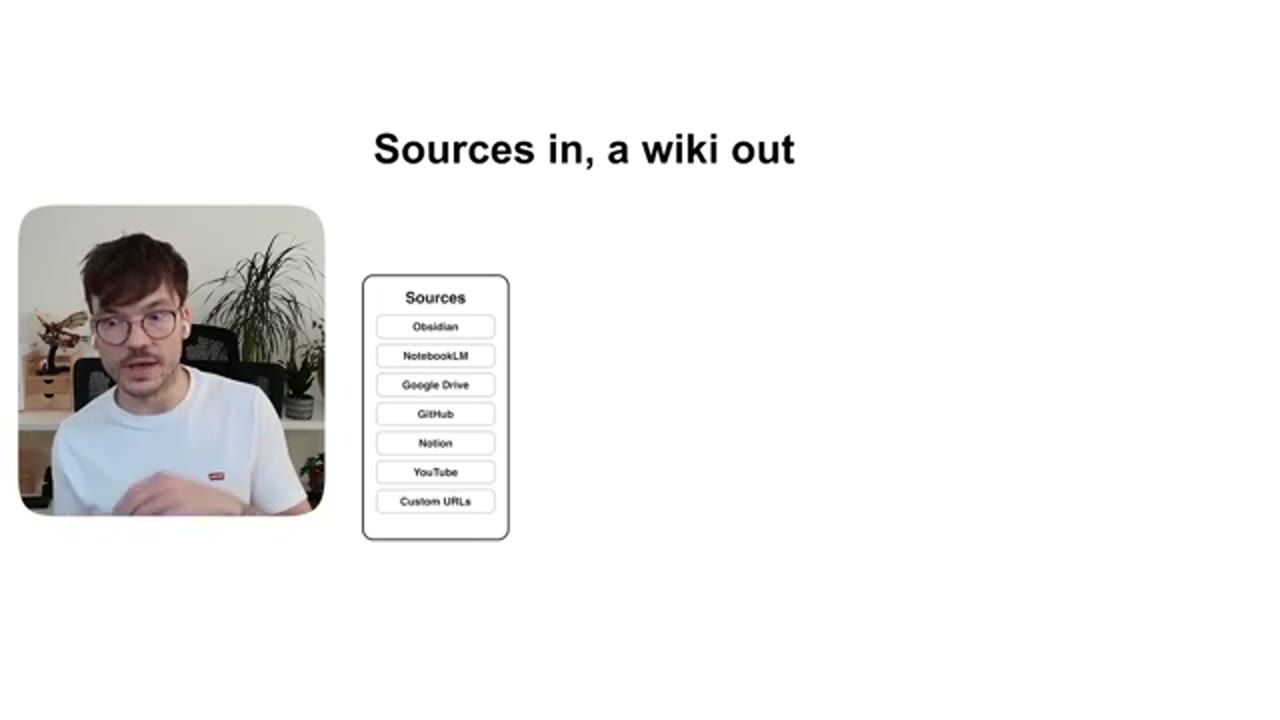
Thuật toán mới: nguồn vào, wiki ra. Nguồn, như đã nói, có thể là Obsidian, NotebookLM, Google Drive, YouTube, Notion, thậm chí custom URL. Cái này cũng mạnh: bạn dùng các công cụ như Bright Data để parse gần như mọi single page application, mọi loại site, mọi thông tin công khai ngoài kia, đưa vào được hết. Rồi áp dụng cùng thuật toán deep research. Nhưng thay vì gộp tất cả vào một file research.md, giờ mỗi nguồn được lưu riêng thành raw file. Họ tạo một index cho tất cả các file đó, và cuối cùng sinh ra một wiki ở trên, để query. Bạn query được wiki cộng index.
Đó là kiến trúc high level của hệ thống mới. Giờ phóng to vào. Điều đầu tiên Paul muốn nói: hãy quên đi infrastructure mà bạn nghĩ mình cần, như vector database, knowledge graph, semantic search, text search. Những thứ đó rất đẹp nhưng thêm rất nhiều độ phức tạp, nhất là với những personal wiki, những research operating system cá nhân mà bạn muốn dùng thật nhẹ nhàng. Anh muốn một hệ thống chỉ dựa trên file, một cơ chế đơn giản, bám rất sát cách máy tính của bạn vận hành. Vì thế cả hệ thống được xây chỉ dựa trên file và reference. Không database, chỉ một index đơn giản dựa trên reference.
9. Không database, chỉ có index.yaml
Cơ chế thế này: có một agent đọc file index.yaml, về cơ bản là một catalog của toàn bộ dữ liệu, cộng với tóm tắt của từng nguồn và chút metadata quanh nó.
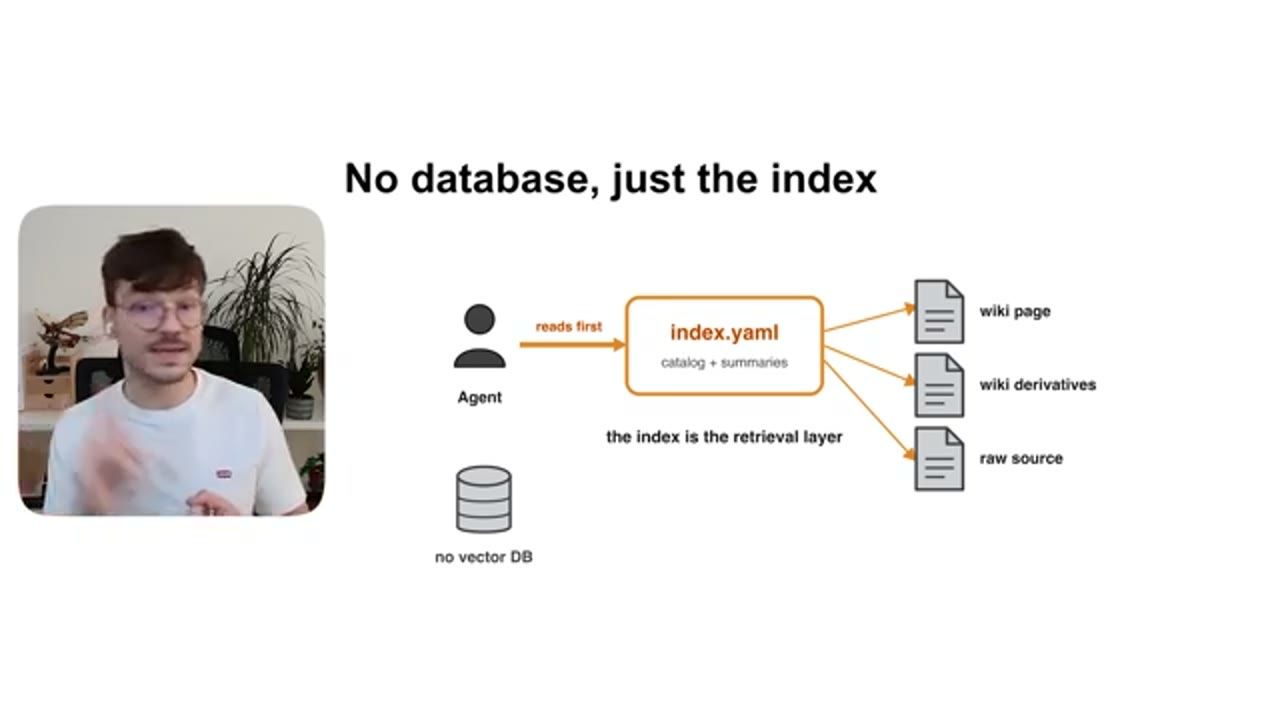
index.yaml trước (catalog cộng tóm tắt), từ đó trỏ tới wiki page, wiki derivative và raw source. Không vector DB; index chính là retrieval layer.Ví dụ Paul đưa ra là một phần của file index.yaml chứa mười nguồn và 38 wiki page, là những derivative sinh ra từ các nguồn đó. Trong danh sách sources của file YAML, nguồn đầu tiên có link tới file gốc cộng metadata như origin, tiêu đề, tác giả, ngày xuất bản, tóm tắt, và những thứ tương tự. Phần metadata này linh hoạt.
Bước tiếp theo: từ file index.yaml đó, phải trỏ được tới mọi wiki page, mọi wiki derivative, mọi raw source. Tức là file index.yaml này là entry point cho agent: đó là thứ đưa cho agent để nó suy luận cách tìm dữ liệu. Rốt cuộc nó chính là một cái index.
Tiếp theo là hiểu wiki thật sự trông thế nào. Cấu trúc high level có ba phần: thư mục raw, thư mục wiki, và index. Trong thư mục raw chỉ có dữ liệu thô, bất biến: bạn không muốn đụng vào nó. Index trỏ tới mọi thứ cần thiết. Trong wiki là các derivative do LLM tạo ra: so sánh giữa nhiều concept, entity, hay đơn giản là note phản chiếu các câu hỏi của bạn, hoặc các repository đã ingest, và từ một repository có thể tạo ra nhiều note. Có cả open question, những câu hỏi mà LLM chưa trả lời được, và mọi thứ khác bạn có thể phân tích trên dữ liệu thô.
Nhìn trong Obsidian, có thể thấy subgraph được dựng chỉ từ index này. Đó mới là lần lặp đầu tiên, nhưng khi wiki lớn dần, bạn sẽ thấy các kết nối hình thành giữa entity và concept. Ví dụ, concept là những thứ như tool registry, context compaction, sandboxing; còn entity là OpenCode, Claude Code, MCP. Như vậy, bạn bắt đầu tạo ra các kết nối một cách trực quan và thực tế, rất đẹp.
Câu hỏi hiển nhiên tiếp theo: làm sao query wiki này?
10. Query wiki theo bậc, và mỗi câu hỏi để lại dấu vết
Như đã nói, agent nhận input là file index.yaml, chứa tóm tắt và metadata về từng nguồn. Nhưng chuyện gì xảy ra sau đó? Bước tiếp theo là xem source wiki page. Source wiki page giống một executive summary của từng nguồn: không chỉ là một bản tóm tắt, mà là một bản tóm tắt mở rộng hơn của mỗi nguồn. Đôi khi agent chỉ cần xem chỗ này, lấy được thứ nó cần rồi quay về, và cách đó rất tiết kiệm token.
Nếu không tìm thấy trong source wiki page, cần có link sang các wiki derivative như concept, entity, note, comparison, vân vân. Và chỉ khi tới đây mà vẫn chưa có thông tin cần thiết, agent mới đọc toàn bộ raw source: cả bài báo, cả paper, cả video, hay bất cứ thứ gì. Chỉ nhờ reference thuần tuý và một thứ bậc đơn giản như vậy, mọi thứ trở nên rất tiết kiệm token.
Phần đẹp nhất là wiki này còn sống. Mỗi câu hỏi để lại một dấu vết trong wiki. Với mỗi câu hỏi, LLM có thể tạo một file concept mới, một file note mới, một file comparison mới, và mọi câu hỏi đều được ghi vào một log. Nghĩa là wiki không chỉ tiến hoá khi bạn ingest dữ liệu mới hay chạy một vòng deep research. Nó tiến hoá ngay khi bạn bắt đầu nói chuyện với nó. Đó thật sự là phần đẹp nhất. Nhờ vậy bạn thấy được một phản chiếu chân thật của chính mình: những gì mình chưa hiểu, mọi câu hỏi của mình trong quá khứ.
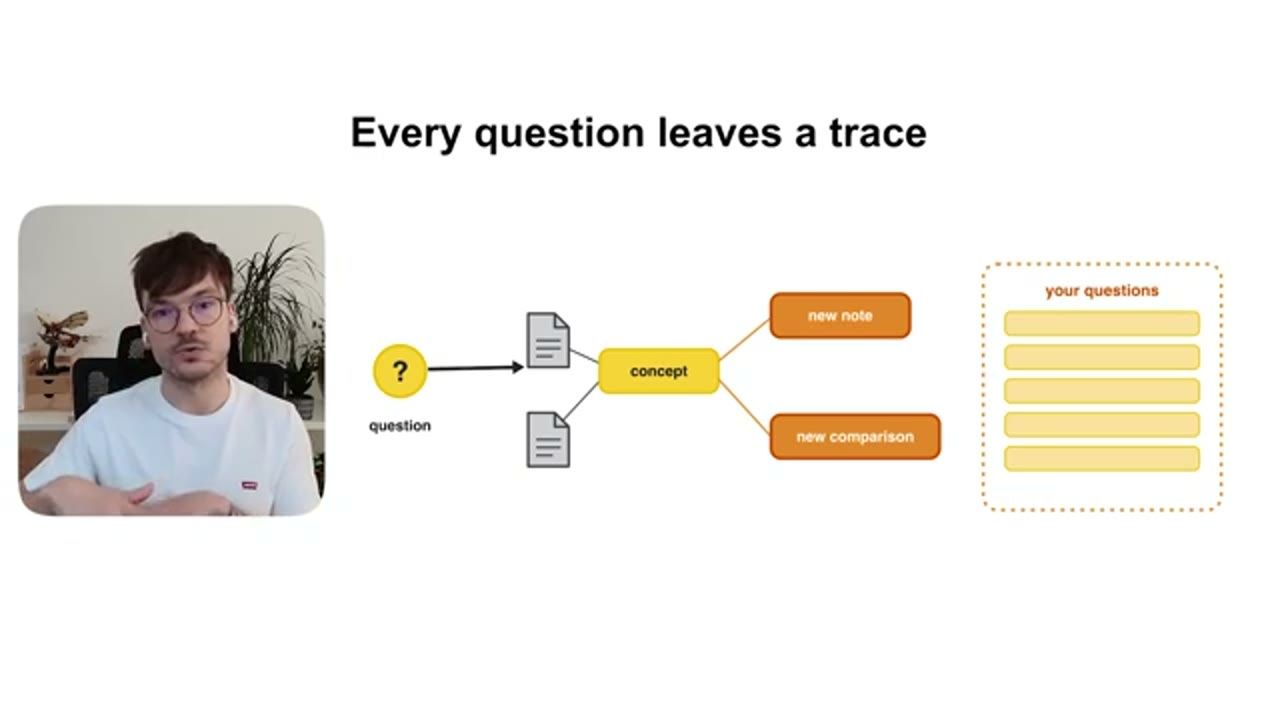
Và wiki không bao giờ bị đóng băng như các file research.md trước kia. Bất cứ lúc nào bạn cũng có thể ingest thêm một custom link bạn thấy cần, hoặc chạy thêm một vòng deep research. Hoặc, như đã nói, wiki cứ thế tiến hoá chỉ dựa trên các câu hỏi của bạn.
Một điều quan trọng nữa: wiki này không nằm trên toàn bộ second brain của bạn. Ví dụ trong trường hợp của Paul, anh dùng phương pháp PARA do Tiago Forte đặt ra, trong đó toàn bộ dữ liệu được chia thành projects, areas, resources và archive. Mọi note, mọi tài nguyên anh lưu, mọi nguồn anh lưu, PDF, bài báo hay bất cứ thứ gì, đều được đổ thẳng vào resources, một danh sách phẳng.
11. PARA, Obsidian bất biến, và một project một wiki
Khi cần thứ gì, Paul chỉ việc reference chúng vào projects và areas. Nhờ vậy, Obsidian chỉ là một snapshot bất biến mà LLM không bao giờ đụng vào. Đó là dữ liệu của anh. Anh thật sự không muốn LLM đụng vào những note cá nhân anh tự tay viết.
Vậy làm sao đưa wiki này vào sử dụng? Có một snapshot Obsidian lớn, là second brain toàn cục. Mỗi khi bắt đầu một project mới, họ reference second brain này thông qua thuật toán deep research đã mô tả, và thu hẹp phạm vi xuống project của riêng mình. Tức là mỗi khi muốn bắt đầu làm một việc, họ chạy vòng deep research, hoặc bắt đầu ingest một số repository, bài báo, note nhất định, vân vân. Và thường họ làm việc đó qua một bộ skill cắm vào một harness.
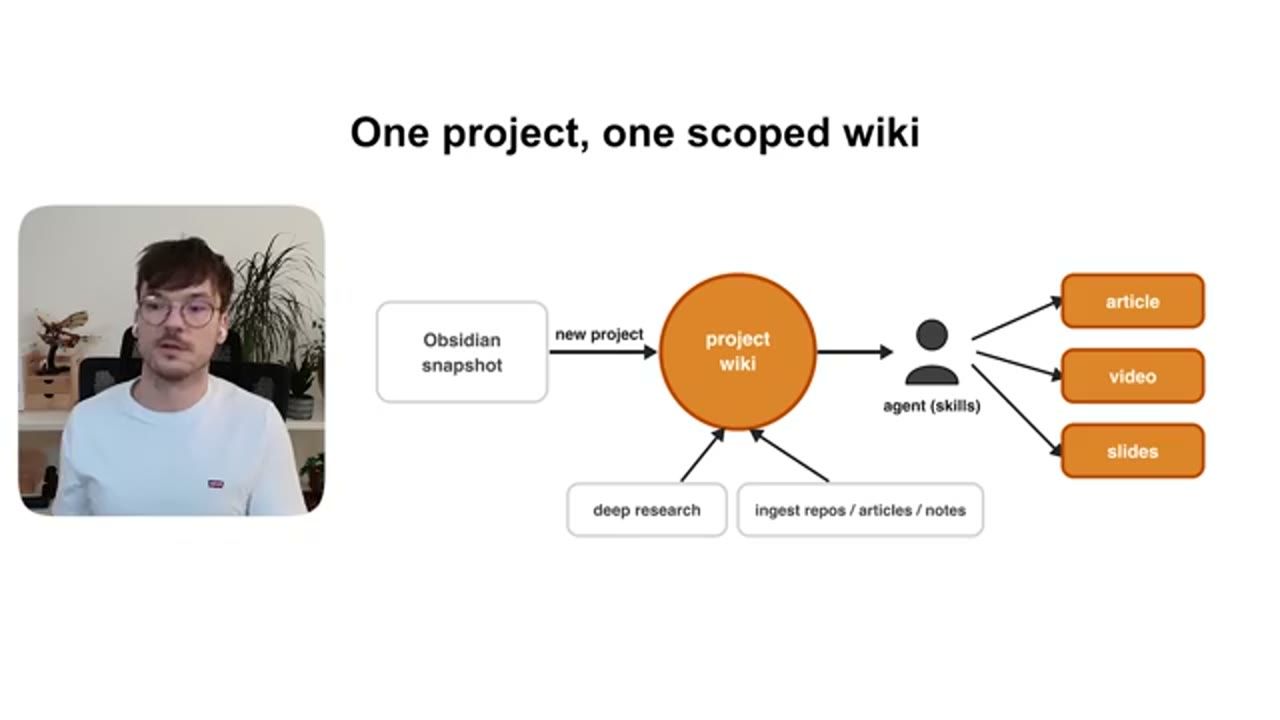
Một project có thể là bất cứ thứ gì: viết một bài báo mới, làm một video mới, làm một bộ slide. Paul áp dụng chính kỹ thuật này để làm bộ slide của talk. Hoặc bạn áp dụng cho thứ phức tạp hơn: viết một cuốn sách, làm một course, hay theo dõi cả một code base. Bạn cũng dùng được cho việc đó. Nói gọn, project là bất cứ thứ gì mà, như Paul nói từ đầu, bạn muốn biến research thành công việc. Project là công việc, second brain là research.
Giờ tới phần demo. Việc cần làm là vào repository AI Research OS workshop. Ở đó có mọi skill cần để chạy những gì đã trình bày. Mọi thứ được đóng gói thành một Claude Code plugin, nhưng bạn rất dễ tinh chỉnh và cài nó vào bất kỳ harness nào khác.
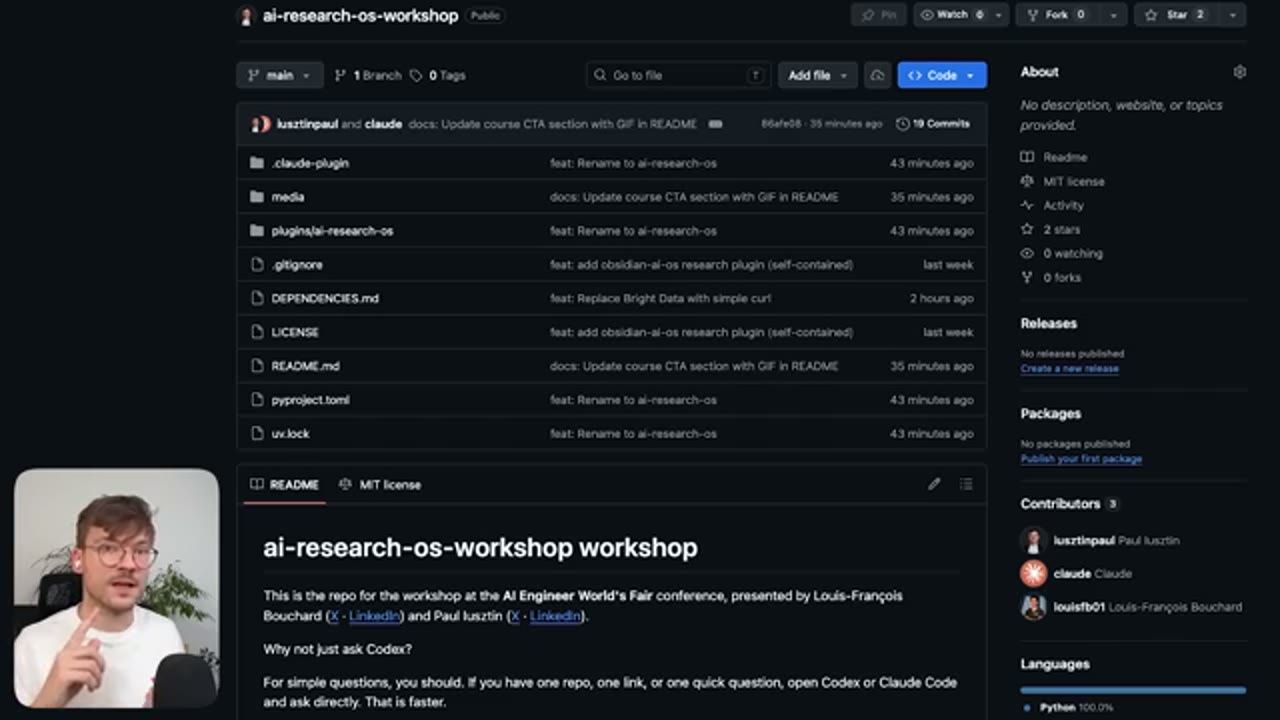
ai-research-os, và README hướng dẫn cài đặt các phụ thuộc.Trong README có chi tiết cách cài mọi phụ thuộc khác, vì hệ thống này phụ thuộc vào các công cụ như Obsidian, Readwise, NotebookLM, vân vân. Bạn phải setup các CLI cụ thể, hoặc xử lý chuyện xác thực. Nhưng Paul không muốn lãng phí thời gian của người xem vào chuyện setup, nên anh đi thẳng vào ví dụ.
Anh chuẩn bị ba ví dụ. Ví dụ đầu tiên là research cho một bài viết trước đây của anh về agentic engineering. Trong các file đó, anh có một bản brain dump mọi thứ anh biết là mình muốn nói về chủ đề này.
12. Demo 1: research một bài viết về agentic engineering
Ngoài brain dump, Paul còn thêm vài reference mà anh chắc chắn một trăm phần trăm là muốn có trong wiki. Để kích hoạt thuật toán trên các file này, chỉ cần mở một phiên Claude, gọi skill research, trỏ nó vào file đó, thế là xong. Mọi thứ khác đã được nướng sẵn vào skill. Nó sẽ hiểu ý định của anh là muốn tạo một wiki về agentic harness engineering, chỉ bằng cách nhìn các file này và nhìn topic. Và nó sẽ biết rằng trước khi chạy thuật toán deep research, nó phải scrape các thông tin này để dùng làm context khi đặt câu hỏi cho thuật toán.
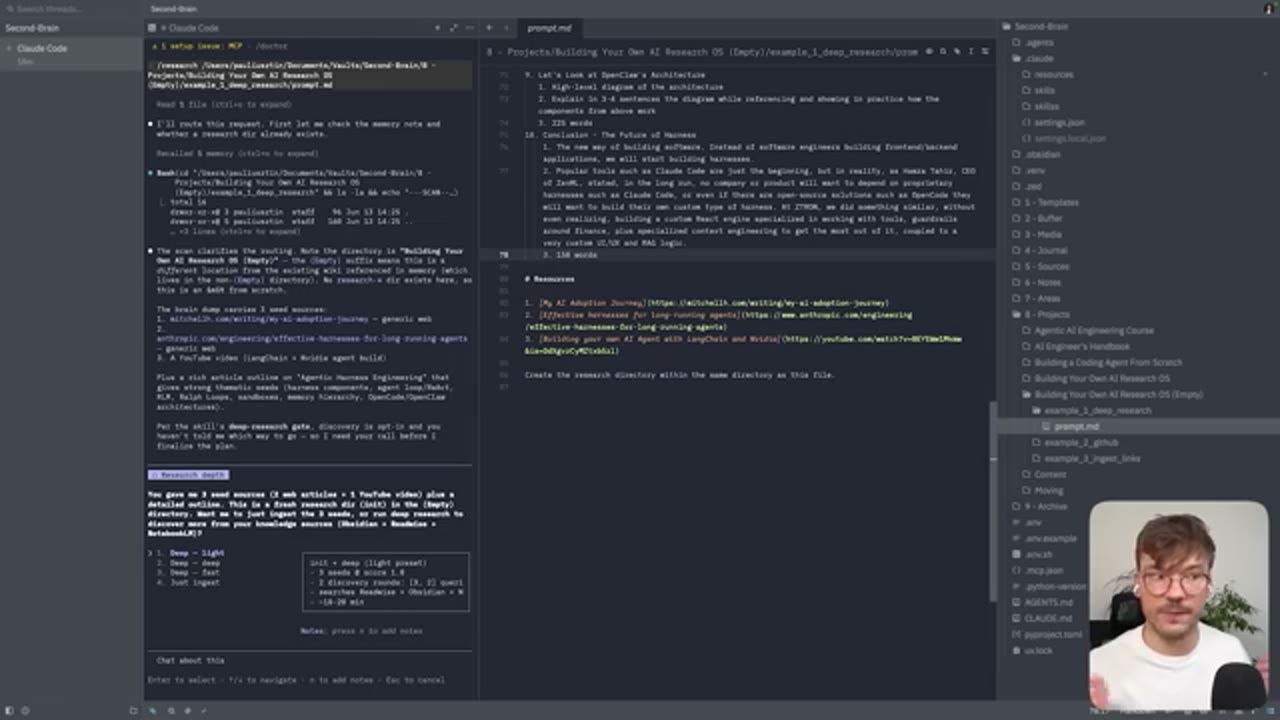
Giờ phải chờ một chút để agent suy luận. Paul bật auto mode cho nhanh. Anh đã dùng cái này hàng trăm lần, nên biết nó sẽ không xoá gì trên máy anh (anh cười) hay làm gì kỳ quặc.
Và đây là phần quan trọng nhất: nó hỏi anh muốn thuật toán deep research sâu tới đâu. Có light, deep, fast. Lựa chọn này chủ yếu điều khiển số câu hỏi chạy trong một vòng và số vòng chạy. Thường thì light hoặc fast là quá đủ, vì nhớ rằng quá trình này tốn rất nhiều token. Bạn chỉ nên chọn deep khi thật sự muốn quét qua hàng đống note.
Với ca này anh chọn light cho nhanh. Light chỉ chạy một vòng ba query. Fast chạy hai vòng, mỗi vòng ba query. Lời khuyên của anh là cứ giữ quanh khoảng đó.
Quá trình này mất khoảng mười tới hai mươi phút để đi qua Obsidian, Readwise, NotebookLM của anh và chạy các query trên đó. Anh đã chạy sẵn rồi. Giờ mở wiki tạo ra từ prompt vừa rồi trong Obsidian để xem bên trong có gì.
Có ba nhóm lớn: các raw file, về cơ bản là bản sao thô của những gì đã tìm thấy; index, chứa mọi reference tới wiki; và wiki.
13. Kết quả demo 1, và demo 2: học harness từ code
Trong Obsidian còn có một subgraph rất đẹp giúp hiểu rất nhanh chuyện gì đang diễn ra, và nó được dựng hoàn toàn từ file index. Phần thú vị nhất là bên trong wiki, nơi có comparisons, concepts, entities và sources.
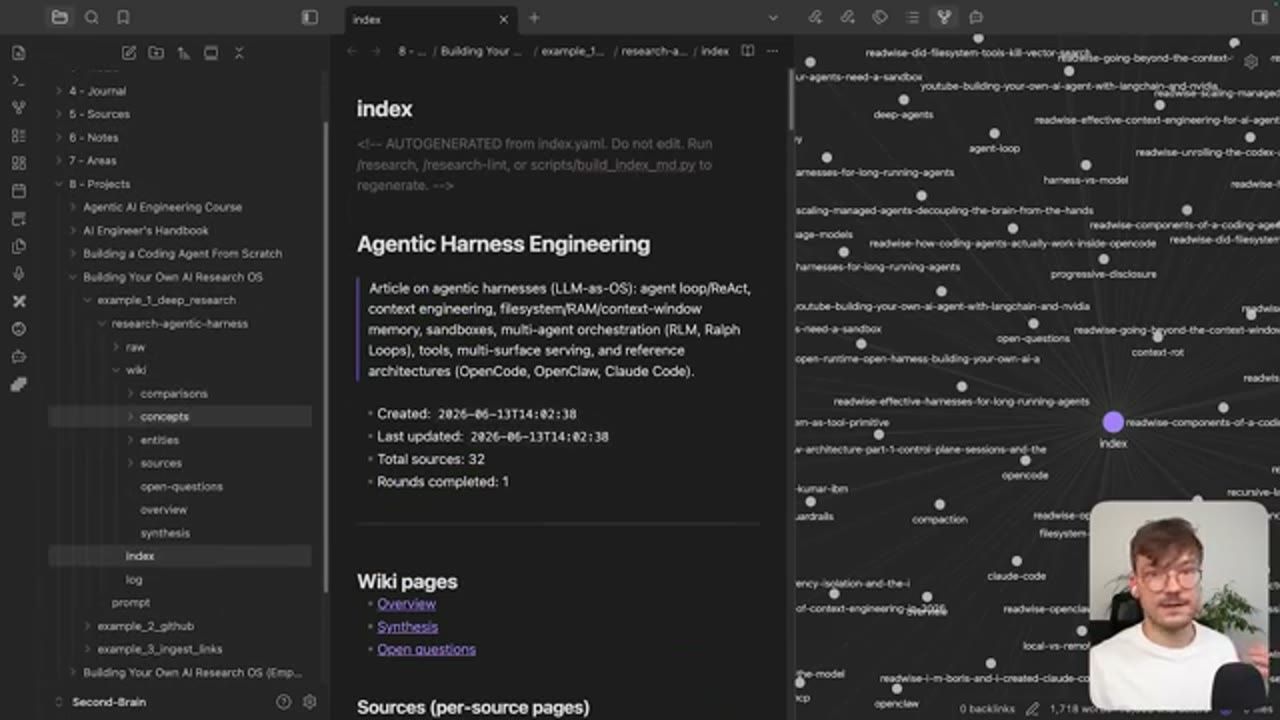
Sources chứa executive summary của các raw source, để LLM không phải đọc lại raw source mỗi lần, mà chỉ cần đọc executive summary, thứ được tính đúng một lần lúc ingest.
Với comparisons, nó tự hiểu ngay rằng cần so sánh những cặp như agentic RAG với file system, hay compaction với recursive language model, hay bất cứ thứ gì đáng quan tâm dựa trên các nguồn.
Phần thú vị nhất thật ra là concepts. Nó tự động rút ra mọi concept cần hiểu từ đống tài nguyên đó. Ví dụ, mở concept agent loop, ta tự động có một bản tóm tắt rất đẹp, có graph, có chữ, giải thích mọi thứ cần biết về chủ đề này. Làm tương tự được với mọi concept trong wiki, với các entity, vân vân.
Sang ví dụ thứ hai, một ví dụ đơn giản: Paul muốn học thêm về harness engineering và cách các harness hoạt động. Trong prompt này, anh chỉ muốn ingest ba open source repository: OpenCode, Pi và Hermes. Anh không muốn deep research chút nào. Anh chỉ muốn ingest những repository đó và khám phá các chủ đề như kiến trúc tổng thể, kiến trúc agent, sub-agent, memory system, và permission flow của agent.
Chạy research trên prompt này, nó sẽ tự clone tất cả các repository, đi khám phá từng repository theo các chủ đề đã cho. Nó sẽ tạo note ở cấp từng repository, giải thích repository đó hoạt động thế nào, kiến trúc ở cấp repository ra sao. Rồi tạo được những note ở cấp cao hơn trong wiki derivative: so sánh các kiến trúc, hoặc tổng hợp thành kiến trúc chung về xu hướng của tất cả các harness đó. Nói gọn là khám phá và học mọi thứ mình muốn về harness engineering trực tiếp từ code.
14. Kết quả demo 2, và demo 3: chỉ vài link
Thường thì Paul cứ bật auto mode và để nó tự chạy, nhưng anh đã chạy sẵn rồi. Đây là wiki cho các GitHub repository. Vẫn có raw file, index và wiki. Trong phần repos có cả ba repository. Ví dụ, bên trong repository OpenCode có các file MD giải thích mọi thứ cần biết về từng chủ đề, như permission flow, memory system, vân vân. Các repository khác cũng vậy.
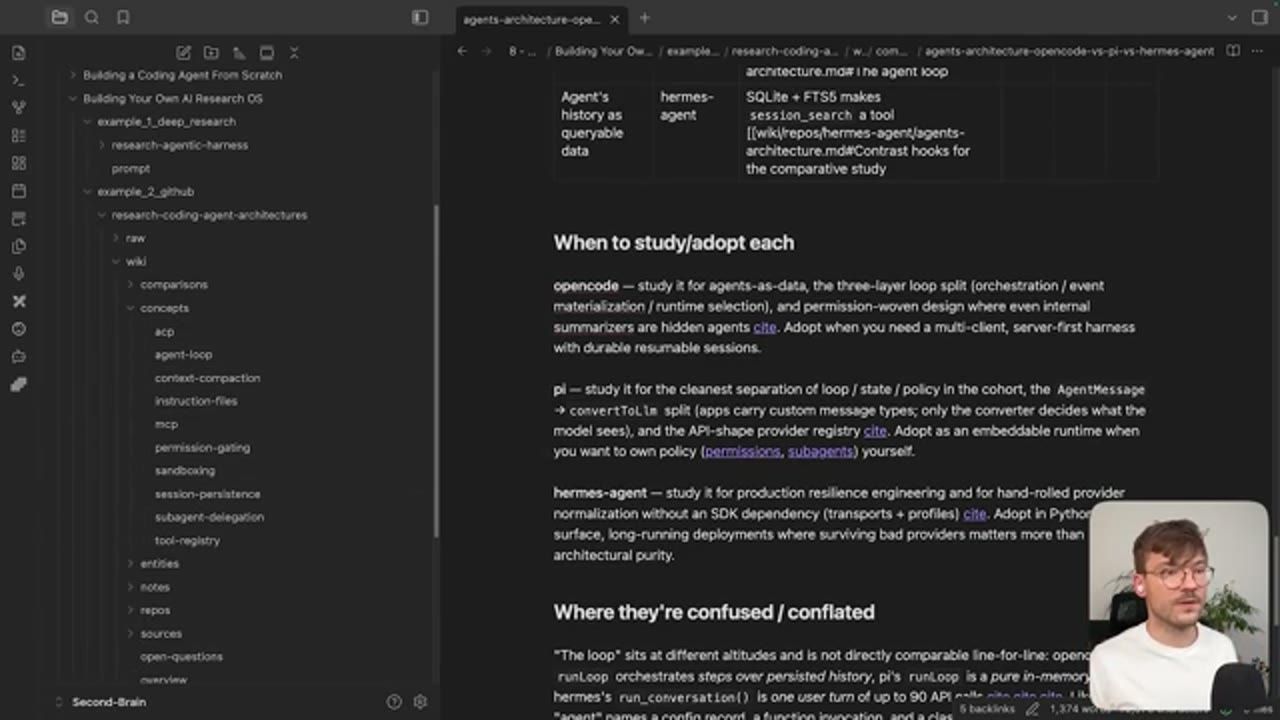
Phần thú vị nhất ở đây là có các comparison giữa tất cả chúng, nên thật sự hiểu được khác biệt kiến trúc giữa các harness này. Cũng có mọi concept được rút ra từ các repository, để hiểu những quyết định kiến trúc then chốt của chúng là gì. Với cái này có thể làm tới bến, và nó cực hữu ích nếu bạn muốn, ví dụ, tự viết harness của riêng mình.
Ví dụ thứ ba thật ra là đơn giản nhất: chỉ ingest vài link đơn giản. Paul thoát lượt chạy trước và chạy ví dụ này từ đầu. Anh muốn cho thấy bạn dùng được nó với một setup rất cơ bản: chỉ ingest ba custom link ngẫu nhiên. Như trước, anh dán prompt và nó bắt đầu quá trình research.
Anh nhấn mạnh: ví dụ hai, trên các GitHub repository, và ví dụ này chạy được không cần setup gì thêm, không cần Obsidian, Readwise hay bất cứ thứ gì khác. Bạn chỉ cần cài plugin này và chạy các ví dụ đó, vì ở đây nó không phụ thuộc dịch vụ nào ngoài Git và dùng curl để lấy các URL.
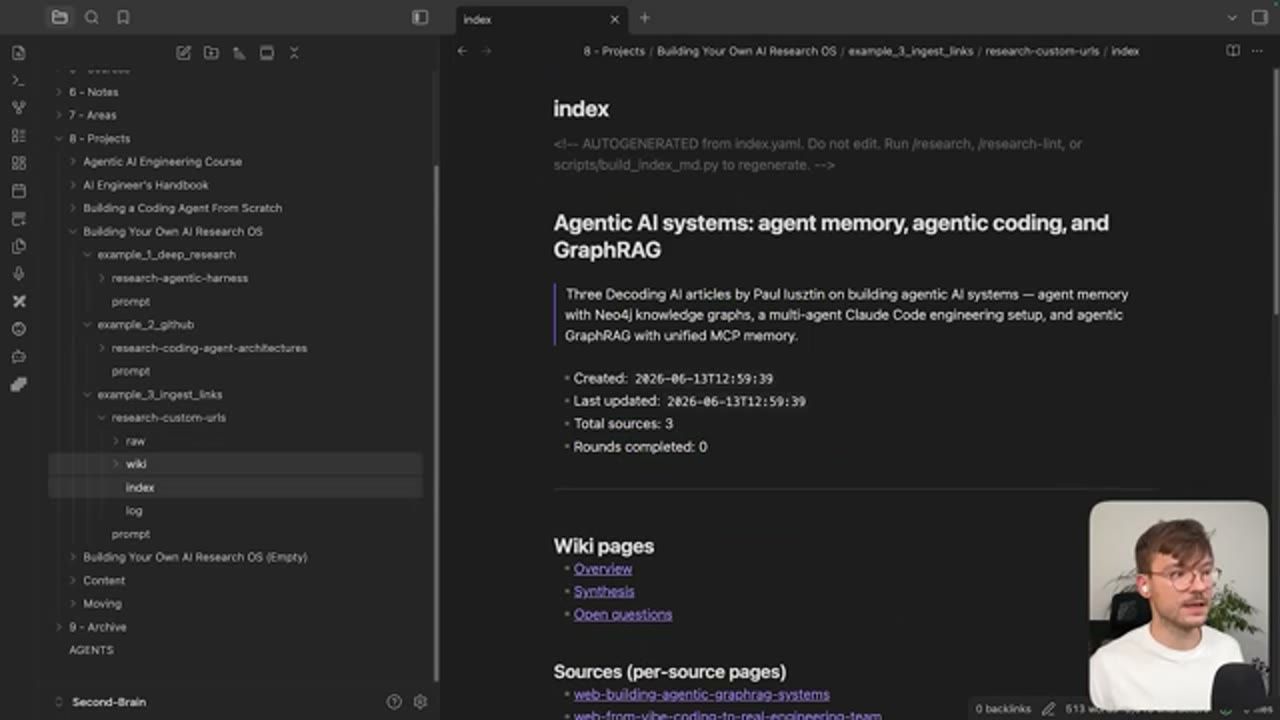
Vào Obsidian và mở wiki tạo ra từ ví dụ ba, ta thấy index, thấy wiki với tất cả nguồn, mỗi nguồn một executive summary, cùng mọi concept, entity đã rút ra, vân vân. Và ý tưởng là khi bạn bắt đầu đặt câu hỏi trên đó, mọi thứ bắt đầu thú vị hơn.
Giả sử muốn hỏi một câu về harness engineering, dựa trên wiki tạo ra từ các GitHub repository.
15. Hỏi wiki, chỗ còn thô, và việc sắp làm
Việc cần làm lại chỉ là gọi skill research, trỏ nó vào wiki vừa tạo, rồi hỏi. Giả sử Paul muốn học thêm về sandboxing, cụ thể là remote sandboxing hoạt động thế nào và được cắm vào harness ra sao. Câu hỏi có thể là bất cứ gì. Khi đó nó sẽ query wiki, đưa ra câu trả lời, và dựa trên đó bạn có thể bắt đầu tạo note, comparison, hoặc nó sẽ tìm ra entity mới mà bạn quan tâm. Tức là nó bắt đầu cập nhật wiki.
Louis quay lại cho phần kết: project này đang đi về đâu, nó là gì, bạn nên làm gì.
Trước hết, nó vẫn còn thô ở vài chỗ. Nó cần thêm connector, như bạn đã thấy: Google Drive, Notion, Slack và rất nhiều connector khác có thể hữu ích cho bạn. Nhưng nói thật, chúng không thật sự hữu ích cho workflow hiện tại của Louis hay của Paul, nên họ chưa thêm, vì cốt lõi của project là hữu ích cho chính họ, và để bạn tự tiếp quản và thêm bất cứ thứ gì bạn cần. Mục tiêu chính còn lại của project là dạy memory và context management, nên những tính năng phụ đó không thật sự phục vụ mục đích ấy.
Còn vài điểm yếu khác, như khó biết nguồn nào đã cũ, nguồn nào yếu hay mạnh so với một hệ thống khác mà họ từng xây. Họ biết mình cải thiện được chỗ này, nhưng một lần nữa, đó không phải ưu tiên ở đây.
Cuối cùng, rõ ràng nó vẫn là một workflow cho builder. Bạn dùng nó qua Claude Code và Codex, nó chỉ chạy trong terminal, và Louis thì thật sự thích vậy. Nó không phải sản phẩm hoàn chỉnh với UI, UX đẹp, và nói thật, đó là chủ ý. Họ không bận tâm chuyện đó vì mục tiêu của họ là dạy AI engineering, không phải xây sản phẩm tốt nhất tiếp theo.
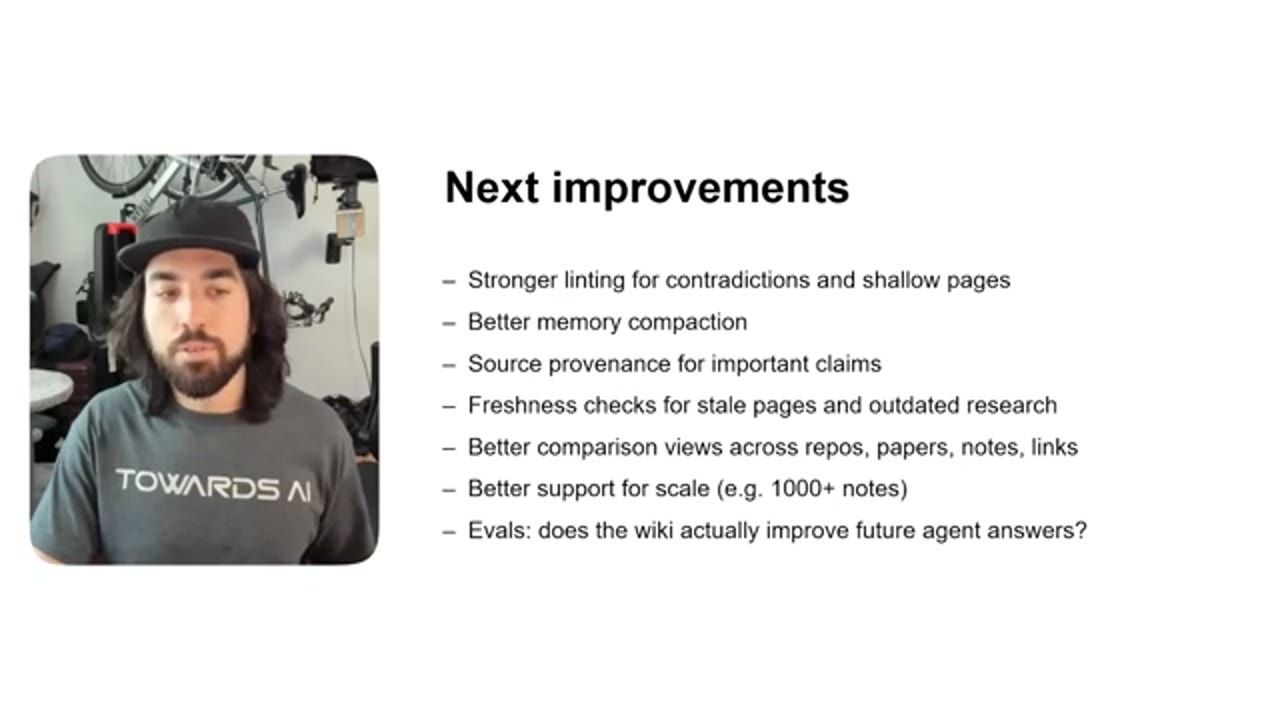
Dù vậy, họ có vài cải tiến muốn làm rất sớm: từ linting mạnh hơn tới memory compaction tốt hơn, vì đó là một vấn đề lớn: quản lý memory cho đúng nói chung rất phức tạp, và state-of-the-art ở mảng này luôn thay đổi. Như đã nói, họ cũng cần source provenance tốt hơn để tin được các nguồn, để rank chúng cho đúng và dùng lại cho đúng khi cần, và để người dùng biết nhanh nhất có thể một nguồn có liên quan hay không.
16. Course Agent Engineering
Họ còn những cải tiến khác phải làm, nhưng phần lớn là để tối ưu và cho tương lai. Điều đáng nói là họ đã xây tất cả những thứ đó vào một sản phẩm khác mà bạn thậm chí tự xây được: họ làm một course tên Agent Engineering, trong đó xây một hệ thống deep research tương tự, có một agent viết và một agent research, với cùng mục tiêu là học được những best practice tốt nhất của AI engineering.
Đó là một course rất sâu, Louis ước tính mất khoảng sáu mươi giờ để hoàn thành, với project cuối là chính hệ thống multi-agent vừa mô tả, do bạn tự xây. Nếu talk này và repo demo bạn vừa xem thấy thú vị, hãy xem Towards AI Academy với các course ở đó, gồm course Agent Engineering, để học thêm best practice khi xây xung quanh agent và cùng với agent.
Sources and links
- Repository của talk, AI Research OS workshop (skill, plugin, ví dụ, README cài đặt): github.com/iusztinpaul/ai-research-os-workshop
- Course Agent Engineering: Building Multi-Agent Systems tại Towards AI Academy: academy.towardsai.net
- Decoding AI, của Paul Iusztin: decodingai.com · kênh YouTube: @itsdecodingai
- Towards AI: towardsai.net · kênh What's AI của Louis-François Bouchard: @WhatsAI
- Phương pháp PARA của Tiago Forte: fortelabs.com/blog/para
- Các nguồn mà hệ thống kết nối: Obsidian · Readwise · NotebookLM · Granola · Bright Data
- Ba harness open source trong demo 2: OpenCode · Pi · Hermes Agent
Related talks
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Agents in Production: How OpenGov Built and Scaled OG Assist
Gabe De Mesa · OpenGov · 19 min
OpenGov chạy OG Assist trong production: agent loop Effect-native thay LangGraph, A2A, evals, human approval, sandbox, rolling summary và tracing.
Building an AI-Native Development Workflow
Vanessa Minik · GitHub · 20 min
AI native khác AI embedded: nghĩ lại SDLC quanh một workforce nhiều agent, context engineering, và việc cần làm ngay sáng thứ Hai.