Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
✓ Đã duyệt độc lập · cập nhật 13/10/2026 · 18 min
1. Agent làm xong là quên
Will mở đầu bằng một nhận xét: suốt hội nghị, ai cũng nói về "loop", tức vòng lặp làm việc của agent: suy nghĩ, hành động, xem kết quả, rồi lặp lại. Anh đùa rằng thật ra agent đang mắc kẹt trong một "vòng lặp mất trí nhớ". Nó làm xong một việc rất tốt, nhưng sau đó quên sạch những gì vừa học được. Lần sau gặp việc tương tự, nó lại bắt đầu từ con số không.
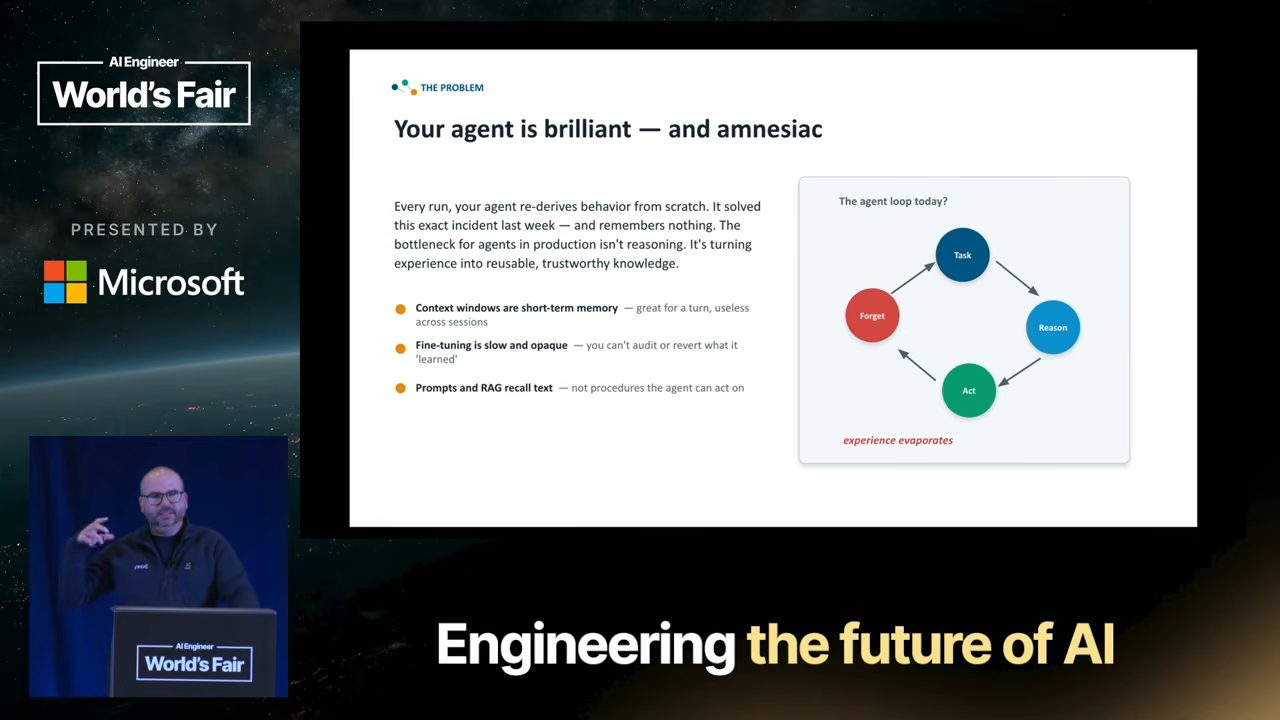
Phần lớn hệ thống trí nhớ hiện nay đang vận hành thế này: cắt các cuộc hội thoại thành nhiều đoạn nhỏ và lưu lại. Khi agent cần, hệ thống tìm những đoạn có nội dung giống câu hỏi nhất, đưa cho agent đọc, rồi hy vọng agent tự hiểu và làm được việc. Cách này gọi là retrieval (truy xuất lại thông tin).
2. Nhớ lại được chưa chắc đã dùng được
Vấn đề là tìm lại được thông tin không có nghĩa là dùng được thông tin đó.
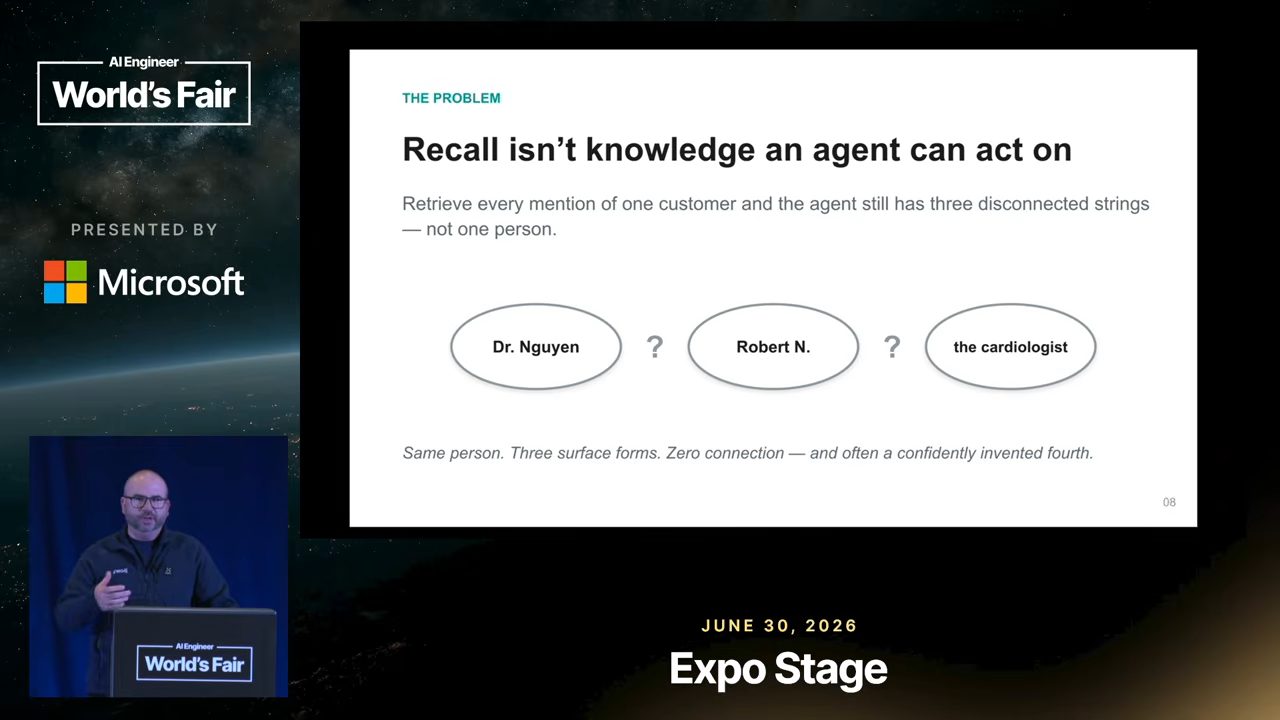
Một ví dụ: trong các cuộc trò chuyện, cùng một bác sĩ tim mạch có lúc được gọi bằng họ tên đầy đủ, lúc gọi tắt, lúc chỉ là "bác sĩ tim mạch". Con người hiểu ngay đó là một người. Nhưng nếu hệ thống chỉ lưu các đoạn văn rời rạc, agent không biết ba cách gọi này cùng chỉ một người.
Agent cần kiến thức có ba đặc điểm:
- Có liên kết: biết thứ này liên quan tới thứ kia thế nào.
- Có phân loại rõ: biết đây là một người, một bệnh nhân hay một lần khám.
- Truy được nguồn gốc: biết thông tin này đến từ đâu.
Tìm lại được thông tin chỉ là một phần nhỏ của bài toán.
3. Ba loại trí nhớ của agent
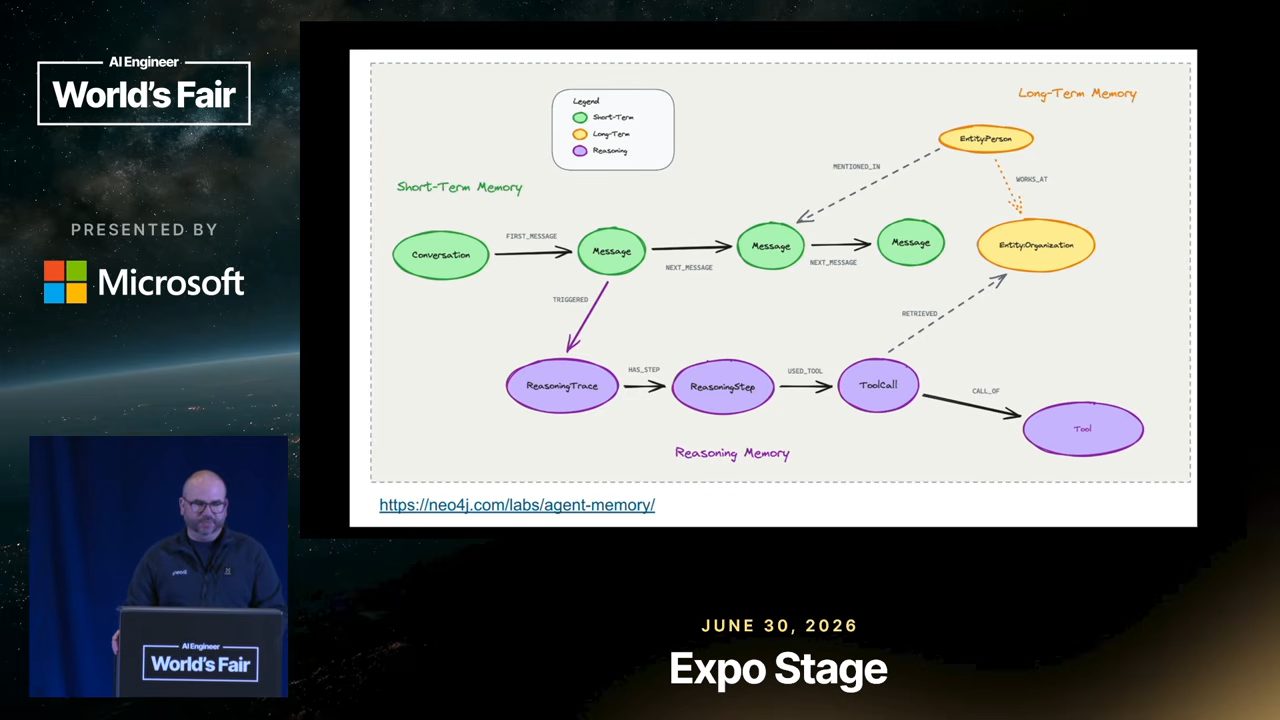
Neo4j xem trí nhớ của agent là một mạng lưới gồm ba loại:
- Trí nhớ ngắn hạn: các tin nhắn trong cuộc trò chuyện hiện tại.
- Trí nhớ dài hạn: những thứ được rút ra từ hội thoại và giữ lại lâu dài, như con người, địa điểm, sự việc.
- Trí nhớ về cách suy nghĩ (reasoning memory): agent đã quyết định thế nào, đã làm gì.
Họ gọi cả mạng lưới này là context graph, tức "bản đồ bối cảnh" của agent.
4. Biến hội thoại thành mạng lưới kiến thức
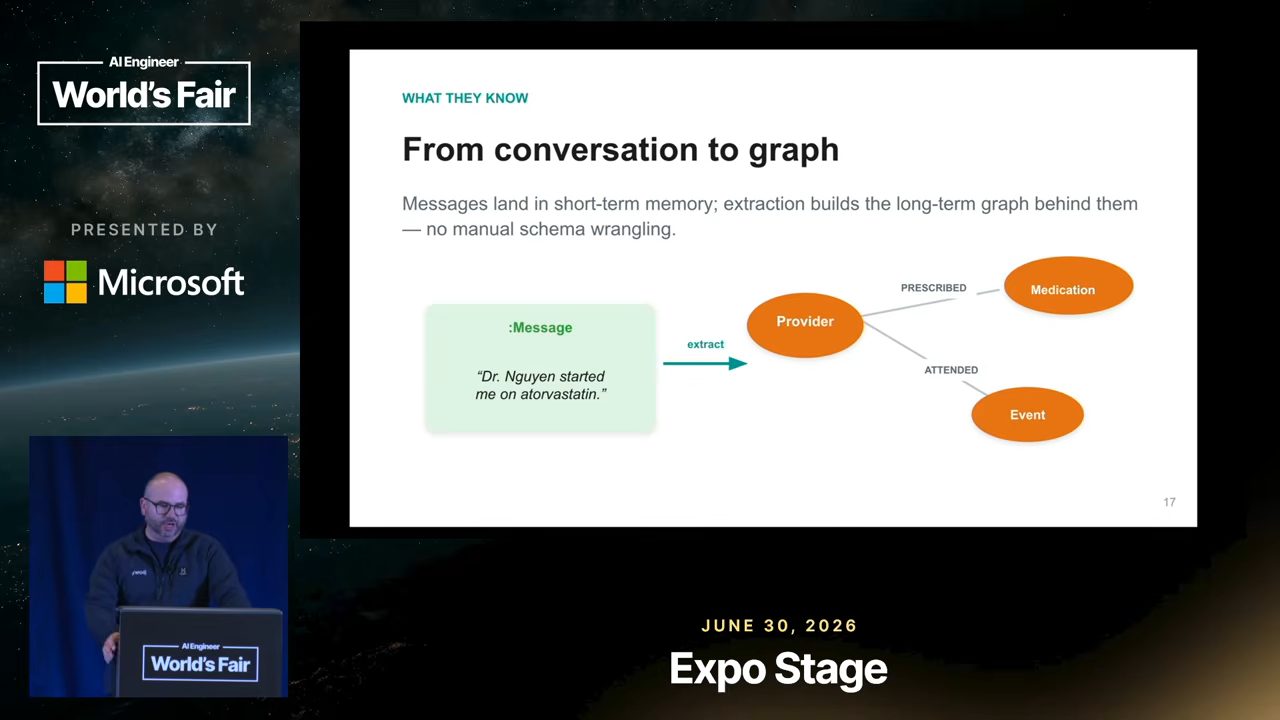
Bước đầu tiên là biến các cuộc hội thoại (văn bản tự do, không có cấu trúc) thành một mạng lưới kiến thức. Hệ thống đọc tin nhắn của cả người dùng lẫn agent, nhặt ra các đối tượng được nhắc tới, như người, bệnh, lần khám, rồi xác định chúng liên quan với nhau thế nào. Mỗi đường nối đều ghi rõ quan hệ, ví dụ "bác sĩ A khám cho bệnh nhân B".
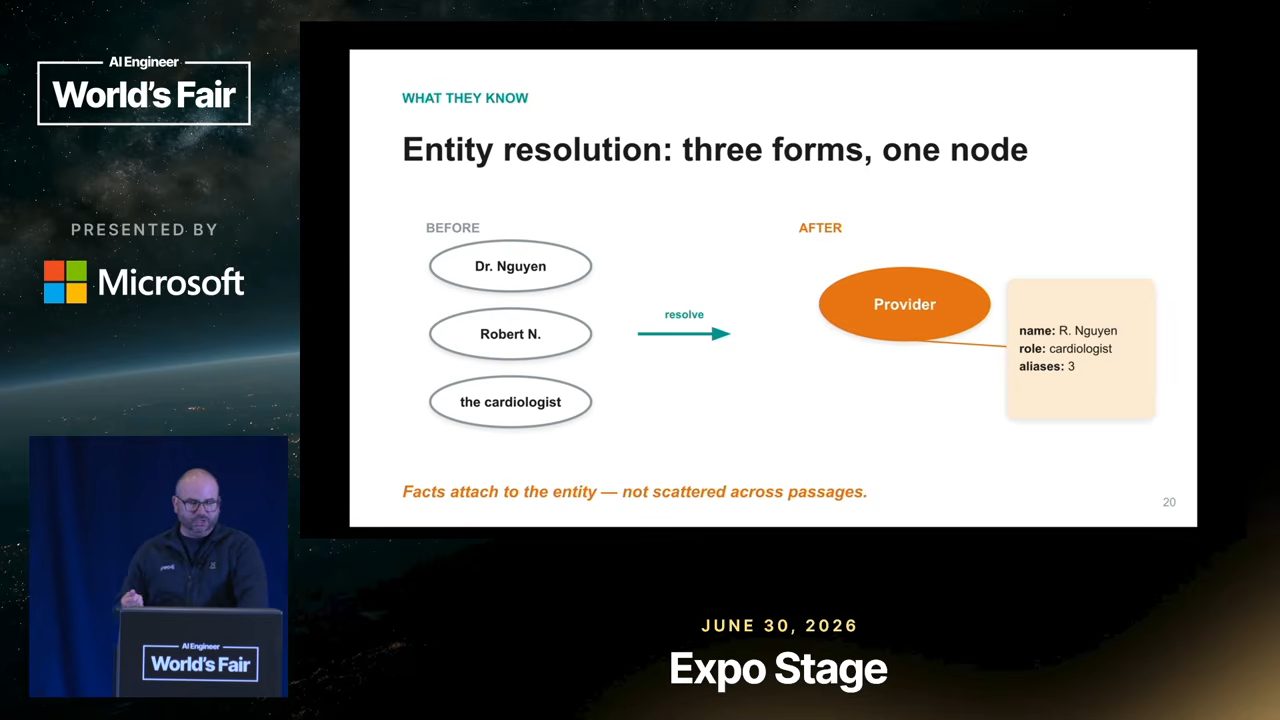
Bước quan trọng nhất là gộp trùng: nhận ra các cách gọi khác nhau cùng chỉ một đối tượng, và gộp lại thành một. Quay lại ví dụ bác sĩ: sau bước này, hệ thống biết đó là một người, là bác sĩ, tên gì, chuyên khoa gì, và mọi cách gọi đều trỏ về đúng người đó.
Phần còn lại là một bộ khung mô tả lĩnh vực, giới chuyên môn gọi là ontology. Đó là bản quy định trong lĩnh vực này có những loại đối tượng nào và chúng được phép liên quan với nhau ra sao. Ví dụ trong y tế có bệnh nhân, bác sĩ, lần khám. Có bộ khung này thì việc chuyển hội thoại thành mạng lưới mới nhất quán.
5. Ghi lại cả cách agent suy nghĩ
Đây là phần quan trọng nhất. Trí nhớ ngắn hạn và dài hạn mới chỉ lưu "chuyện gì đã được nói". Nhưng còn agent đã làm gì, và vì sao nó làm vậy? Vì vậy cần lưu cả cách agent suy nghĩ, không chỉ lưu dữ liệu.
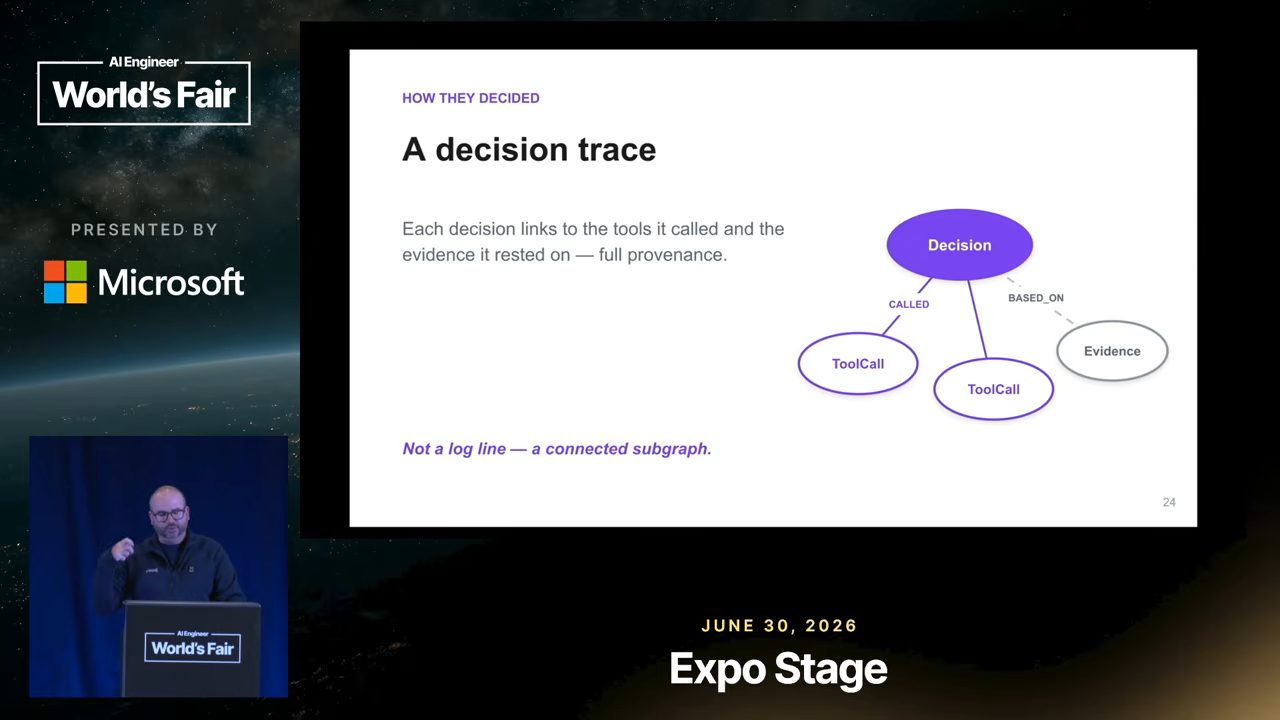
Cách làm là ghi lại nhật ký quyết định (decision traces). Với mỗi quyết định của agent, hệ thống lưu:
- lý do agent quyết định như vậy, và bằng chứng nó dựa vào;
- quy định nào được áp dụng;
- agent đã dùng công cụ nào và công cụ trả về gì;
- tốn bao nhiêu token (đơn vị tính chi phí khi dùng AI) và mất bao lâu.
6. Một bộ nhớ chung cho cả đội agent
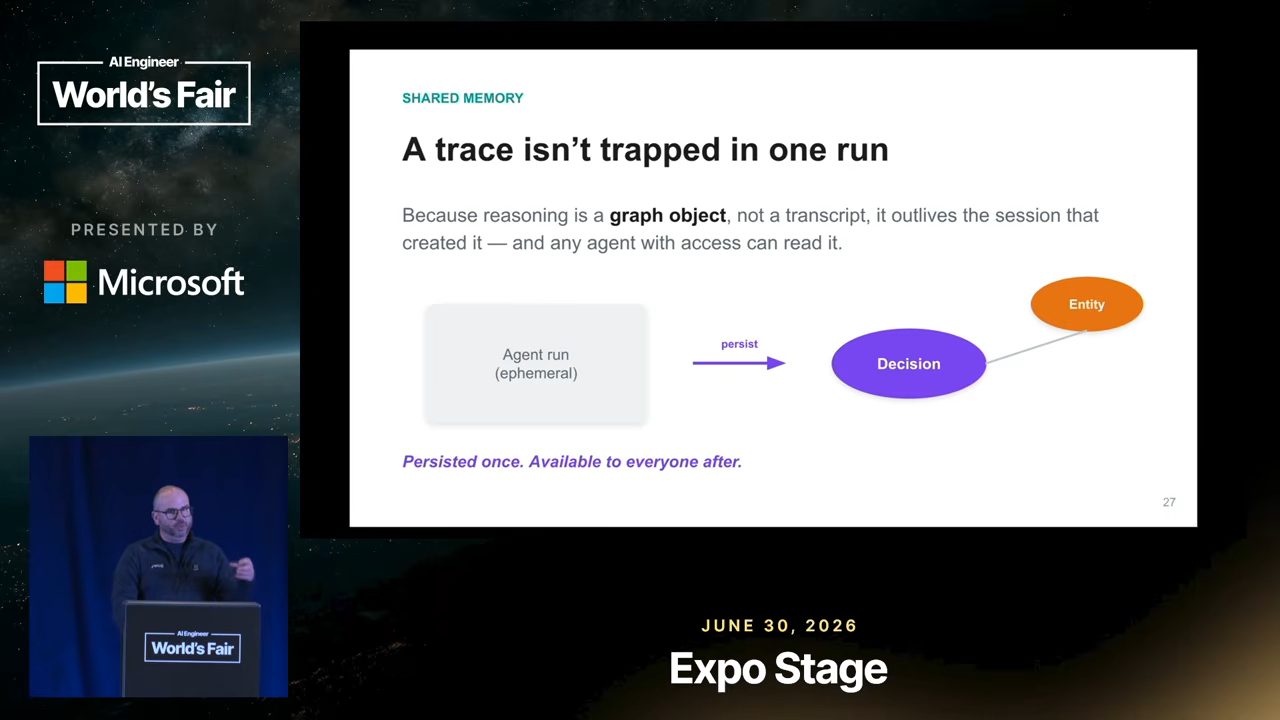
Hãy hình dung một công ty có hàng trăm, hàng nghìn agent dùng chung một bộ công cụ. Nếu mọi lần chạy đều được lưu vào cùng một mạng lưới, các agent có thể học kinh nghiệm của nhau: agent này đã giải quyết một tình huống thế nào thì agent khác cũng biết.
Vì vậy một bộ nhớ chung không chỉ giúp một agent làm tốt hơn, mà giúp cả đội agent tốt dần lên sau mỗi lần chạy.
7. Từ trí nhớ sang skill
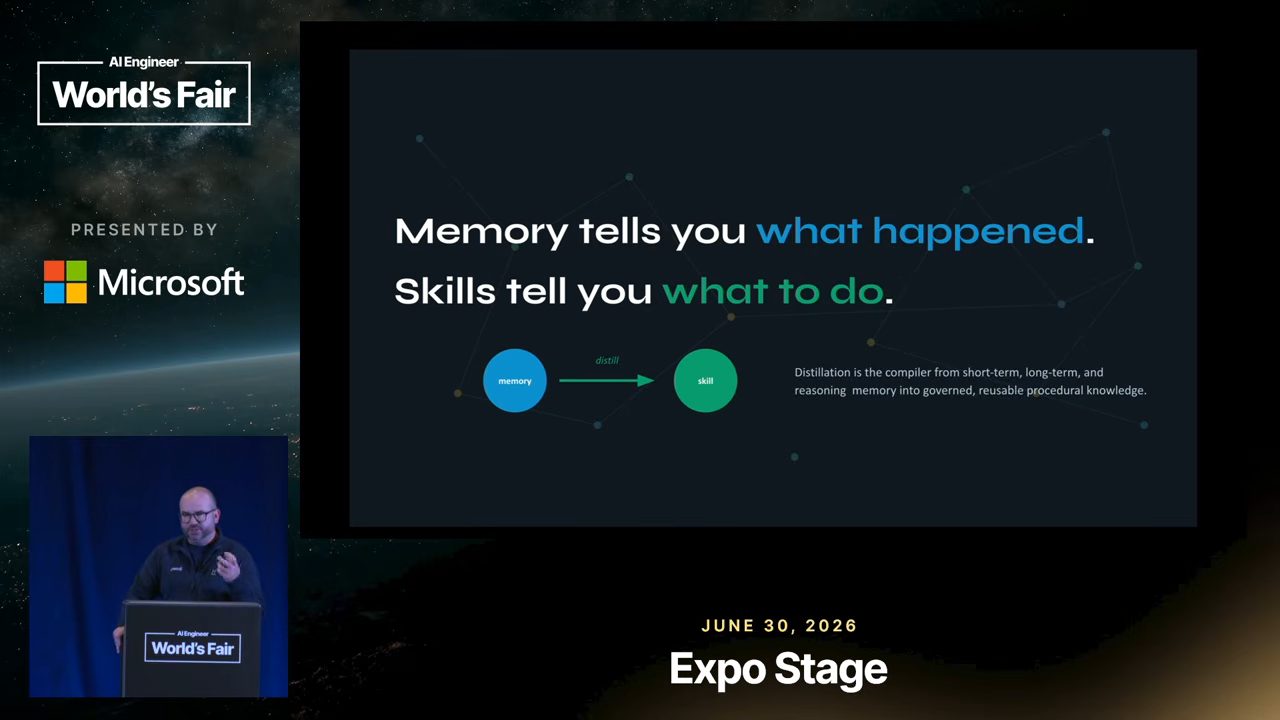
Có trí nhớ rồi, câu hỏi tiếp theo là làm sao để agent dùng nó mà hành động. Will coi trí nhớ là bản ghi chép chuyện đã xảy ra: ai được nhắc tới, họ liên quan thế nào, agent đã quyết định gì. Bước tiếp theo thường là tạo skill.
Anh hỏi khán giả: ai đang dùng skill cho agent? Gần như cả phòng giơ tay. Ai từng tự viết skill? Phần lớn. Ai từng để chính agent viết skill? Cũng rất nhiều. Đó chính là chủ đề của talk: đi từ trí nhớ tới những skill bám vào dữ liệu thật và chạy được.
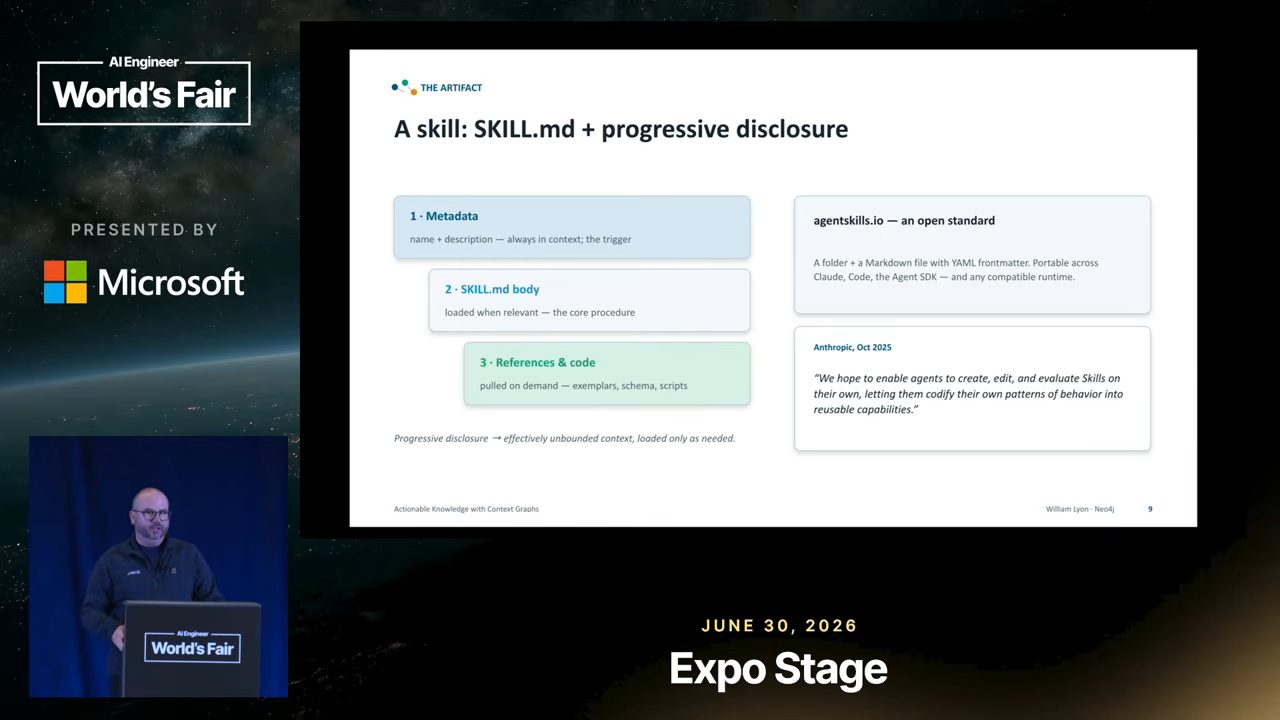
Skill là một chuẩn mở do Anthropic (công ty làm ra Claude) đưa ra. Mỗi skill có một phần mô tả ngắn cho biết skill dùng để làm gì. Phần chi tiết nằm trong các file đính kèm, và agent chỉ mở file nào khi thật sự cần. Cách "cần tới đâu mở tới đó" này gọi là progressive disclosure (mở dần thông tin), giúp agent không bị nhồi quá nhiều thứ một lúc. Nhờ đóng gói như vậy, một skill có thể chia sẻ và dùng lại cho nhiều agent khác nhau.
8. Skill viết bằng văn xuôi cũng có vấn đề
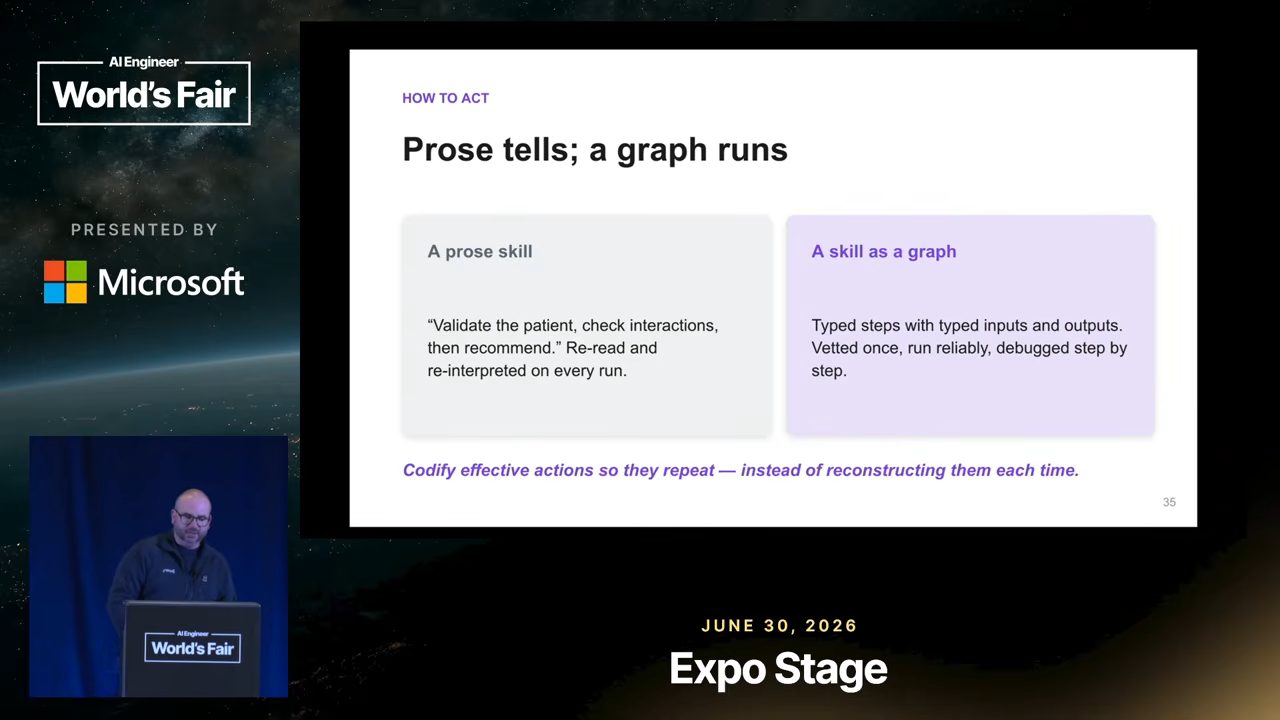
Vấn đề là skill thường được viết bằng văn xuôi, giống như viết một bài hướng dẫn. Nên nó gặp lại đúng vấn đề của trí nhớ: không chắc thứ được nhắc tới là thứ nào, và khó kiểm tra từng bước xem agent làm đúng hay sai.
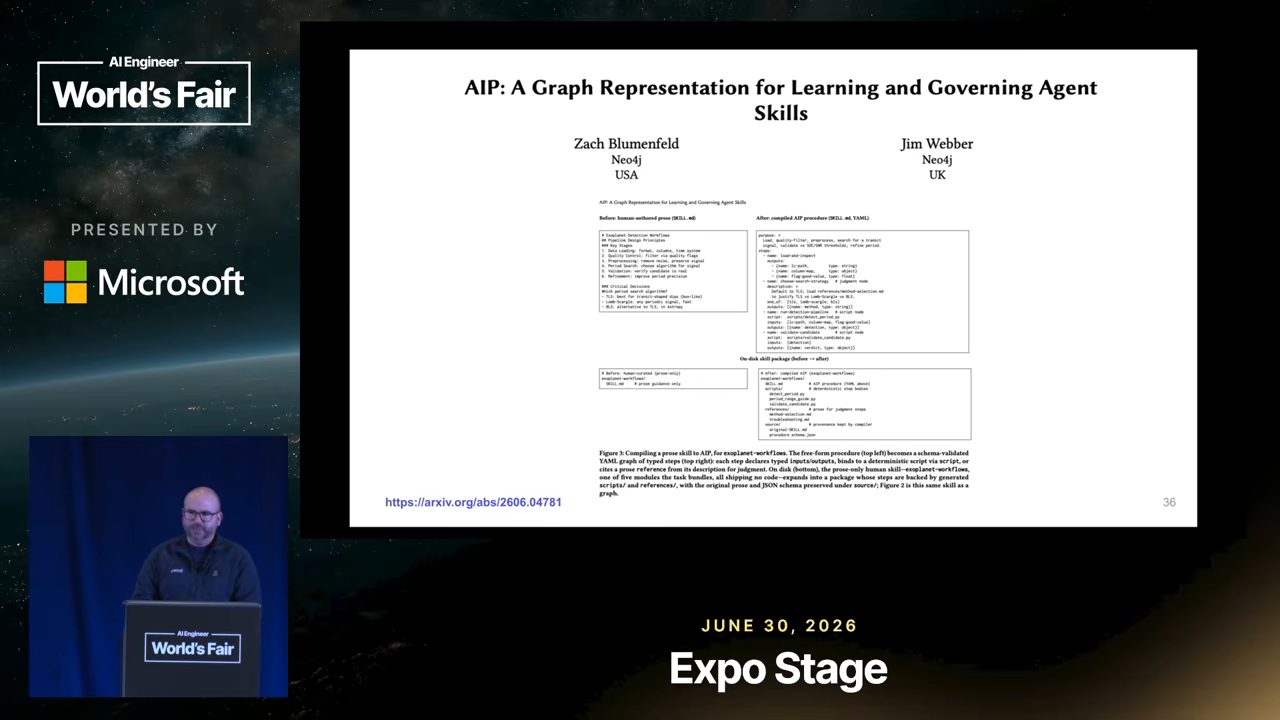
Để giải quyết, nhóm nghiên cứu của Neo4j (Zach Blumenfeld và Jim Webber) công bố một paper về AIP (Agent Instruction Protocol, tạm hiểu là "chuẩn viết hướng dẫn cho agent"). Ý tưởng là thay vì viết skill thành một đoạn văn, hãy viết nó thành sơ đồ các bước: mỗi bước là một ô, có quy định chặt về cách mô tả, để agent làm theo được và người kiểm tra được. AIP mở rộng thêm từ chuẩn skill của Anthropic chứ không thay thế.
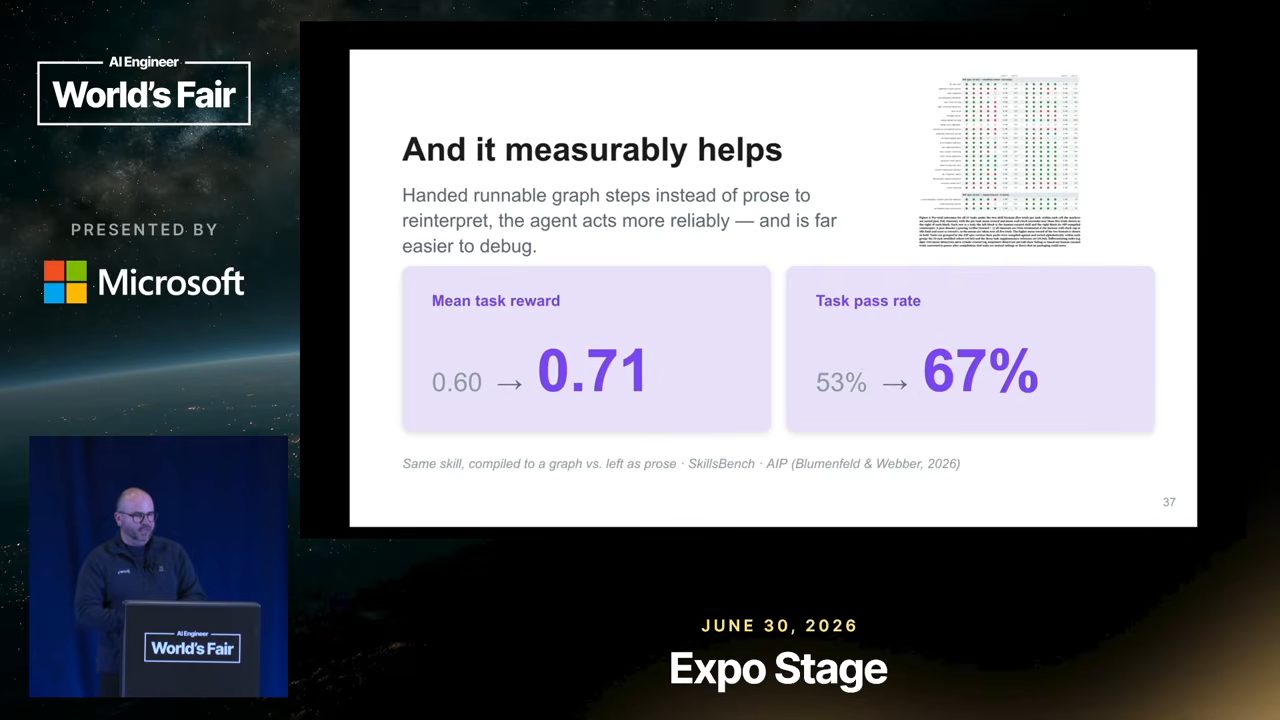
Khi thử trên bộ bài kiểm tra SkillsBench, việc chuyển các skill do người viết sang dạng AIP giúp agent hoàn thành nhiều việc hơn rõ rệt. Theo blog của Neo4j, tỉ lệ thành công là 67,4% với skill dạng sơ đồ, so với 53,3% với skill viết bằng văn xuôi.
9. Rút skill ra từ trí nhớ: ba phép kiểm tra
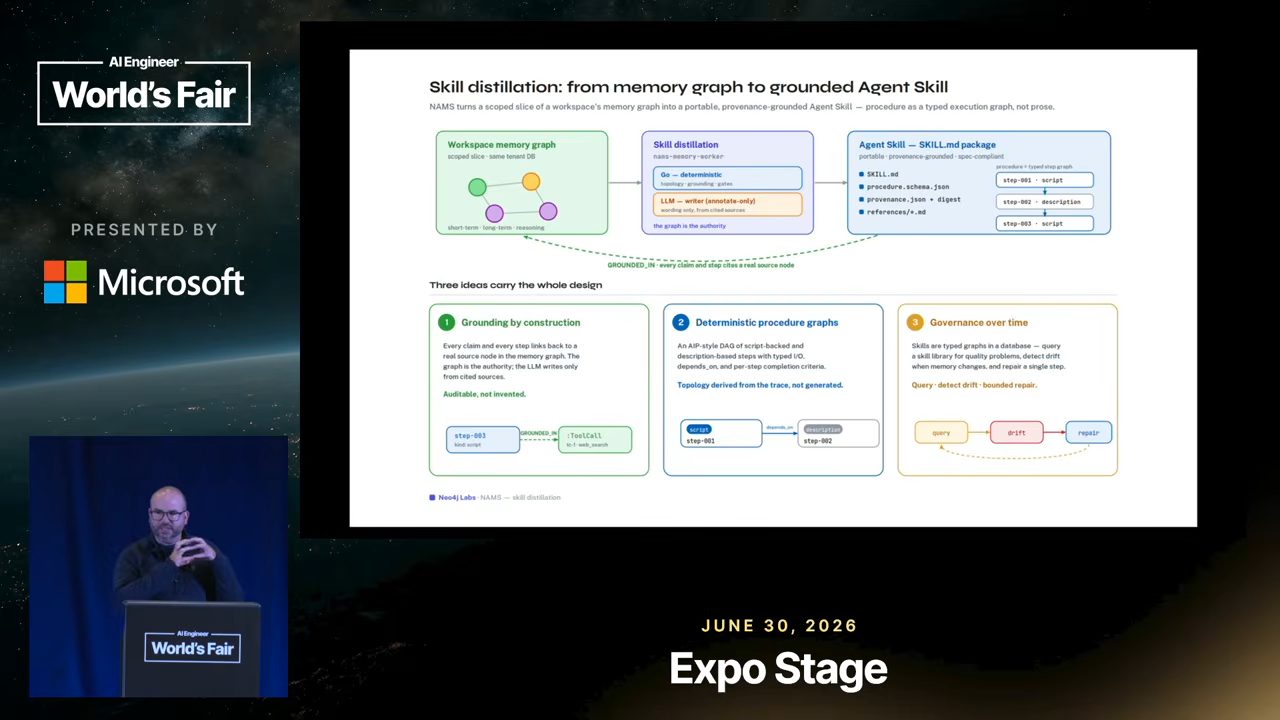
Từ đây, Neo4j áp ý tưởng đó vào việc rút skill ra từ trí nhớ, tức là lấy mạng lưới trí nhớ của một nhóm làm việc hay một dự án rồi chắt lọc thành skill. Nhưng sản phẩm không chỉ là một file văn bản. Will đặt ra ba yêu cầu:
- Skill phải dựa trên những gì đã thực sự xảy ra, có trong dữ liệu.
- Các bước phải rõ ràng, chạy lần nào cũng ra cùng một cách.
- Phải theo dõi được theo thời gian: dữ liệu gốc thay đổi thì phải biết.
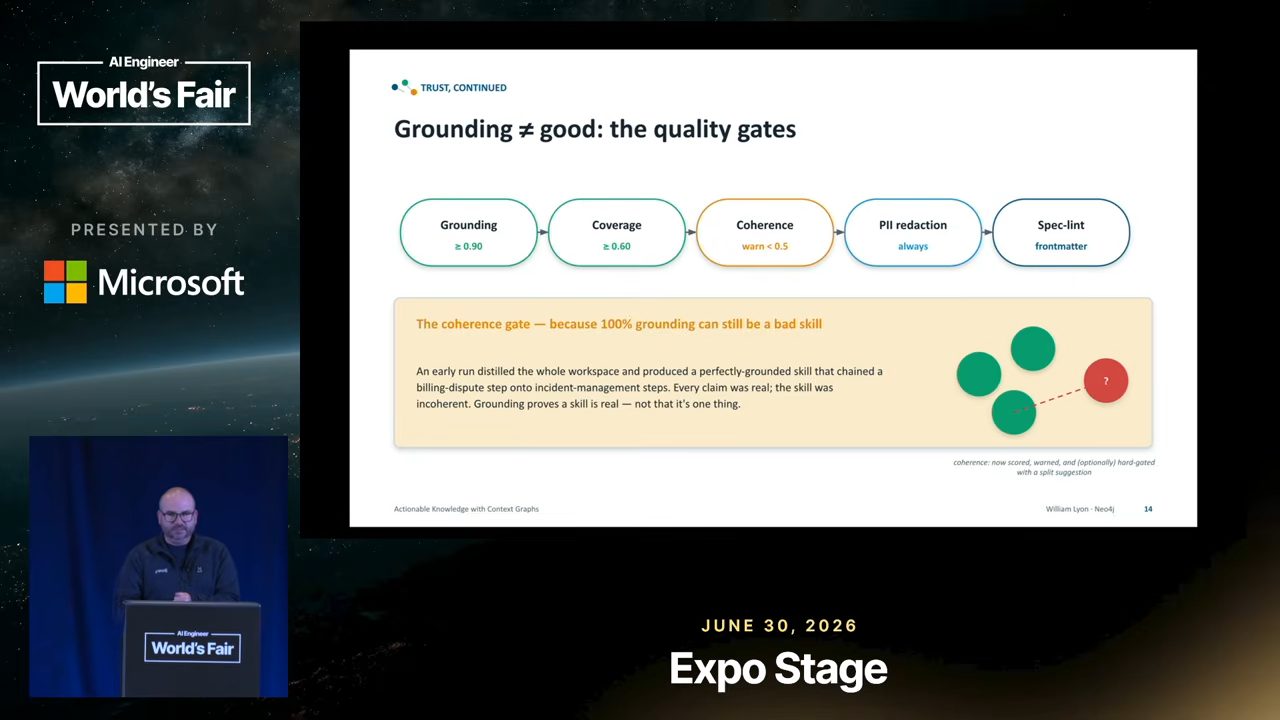
Trước khi tạo skill, hệ thống chạy ba phép kiểm tra:
- Có căn cứ (grounding): mỗi nội dung trong skill phải có dữ liệu thật làm chỗ dựa.
- Đủ bao phủ (coverage): mọi bước và mô tả trong skill đều có căn cứ, không chỉ vài chỗ.
- Đúng một chủ đề (coherence): nếu phần dữ liệu đưa vào bị lẫn nhiều chủ đề khác nhau, hệ thống gợi ý tách thành nhiều skill nhỏ. Will thấy đây là phần thú vị nhất.
10. Giữ cho skill luôn cập nhật
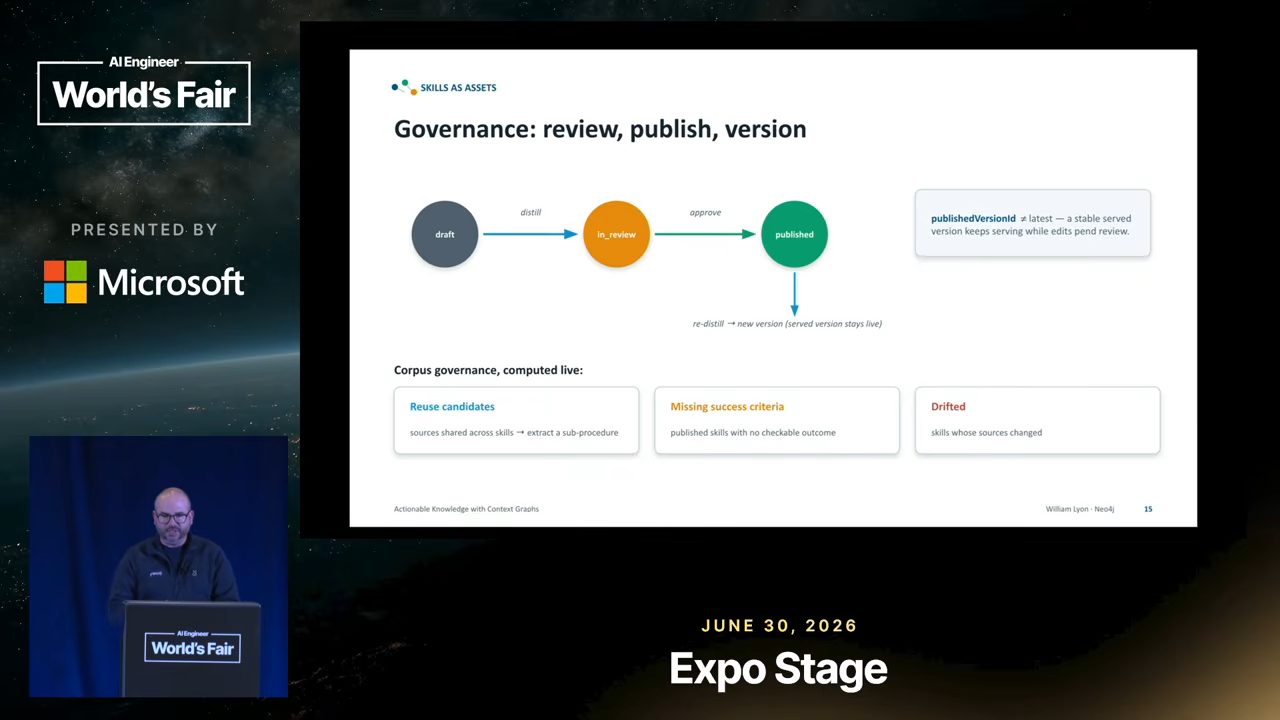
Skill tạo ra rồi còn phải được quản lý. Khi dữ liệu gốc thay đổi, skill có được cập nhật theo không? Will hình dung một kho skill có kiểm soát: agent nào cần thì vào lấy bản mới nhất, và kho sẽ báo khi một skill đã lỗi thời hoặc không còn khớp với dữ liệu thật.
11. Quy trình 7 bước rút skill từ trí nhớ
Neo4j đã làm ra cách này trong NAMS (Neo4j Agent Memory Service), dịch vụ lưu trí nhớ cho agent.
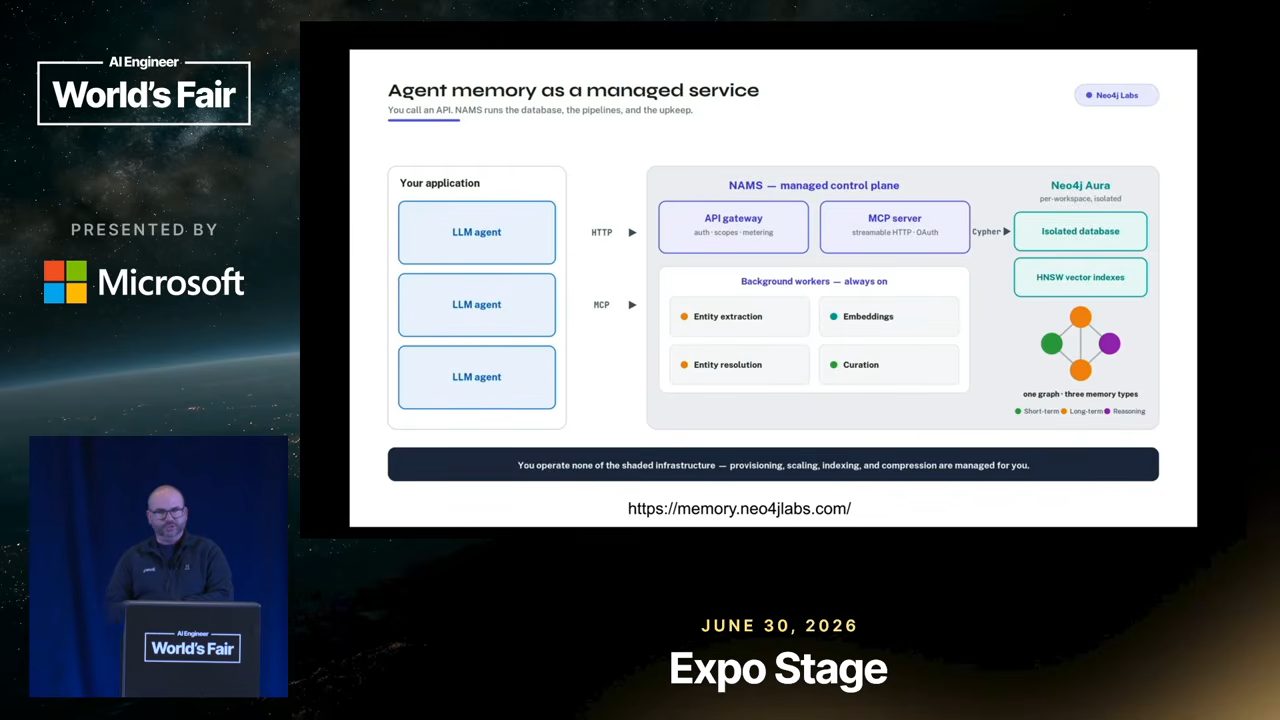
Cách hoạt động:
- Mỗi nhóm làm việc có một mạng lưới trí nhớ riêng, đủ ba loại: ngắn hạn, dài hạn và cách suy nghĩ.
- Các tiến trình chạy ngầm lo việc rút skill ra từ trí nhớ.
- Một tiến trình khác thường xuyên rà soát, báo khi skill đã cũ so với dữ liệu.
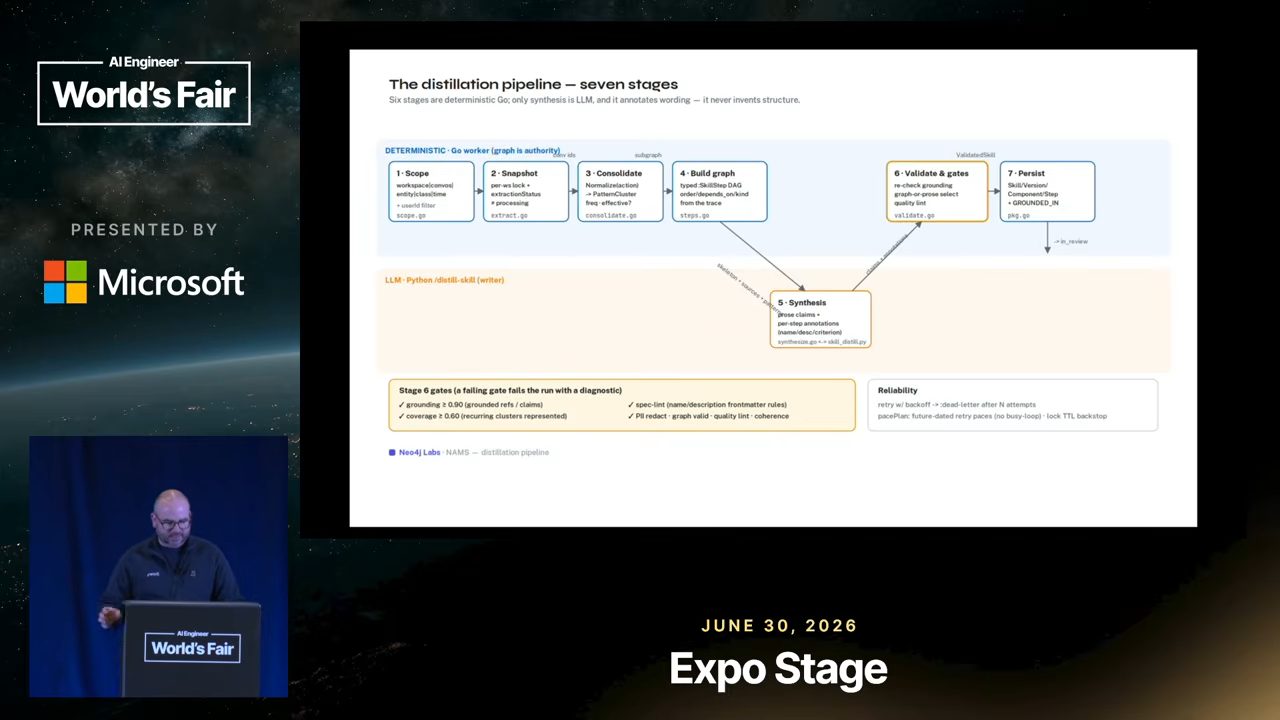
Theo blog Neo4j, 7 bước là: chọn phạm vi, chụp dữ liệu, gộp, dựng sơ đồ, viết mô tả, kiểm tra, lưu lại.
Điểm đáng chú ý là hầu hết các bước chạy theo quy tắc cố định. AI chỉ được dùng ở một chỗ: tổng hợp và viết phần mô tả cho skill. Nhờ vậy kết quả ổn định và dễ kiểm tra.
Bước đầu tiên là chọn phạm vi: rút skill từ đâu, ví dụ quanh một đối tượng cụ thể hay từ một cuộc hội thoại. Mỗi phần của skill đều gắn với dữ liệu gốc của nó. Đây là cách hệ thống biết khi nào skill đã cũ: dữ liệu gốc bị sửa, bị xoá, hoặc mâu thuẫn với nhau.
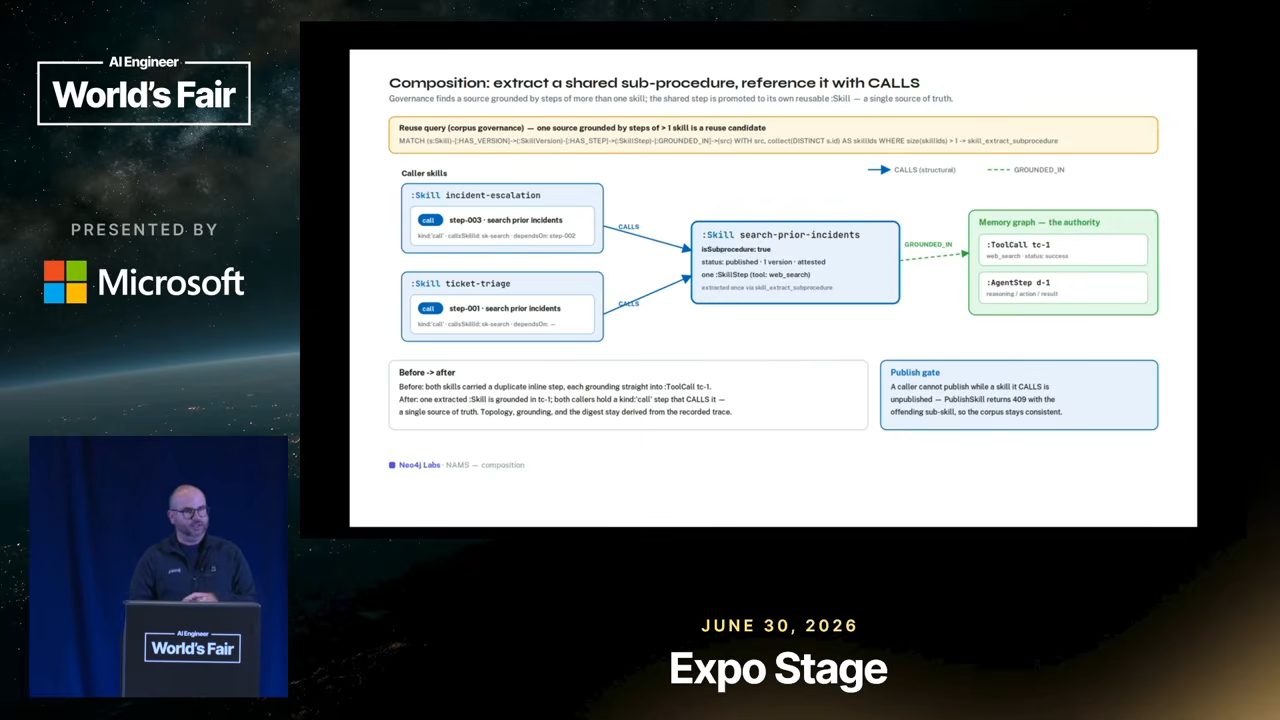
Skill cũng có thể ghép với nhau. Đây là chỗ phép kiểm tra "đúng một chủ đề" phát huy tác dụng: hệ thống dùng thuật toán phát hiện các nhóm chủ đề trong mạng lưới. Nếu một skill trộn nội dung từ nhiều nhóm, đó là dấu hiệu nên tách nó ra, và bước rà soát sẽ phát hiện.
12. Demo: tạo skill tiếp nhận bệnh nhân
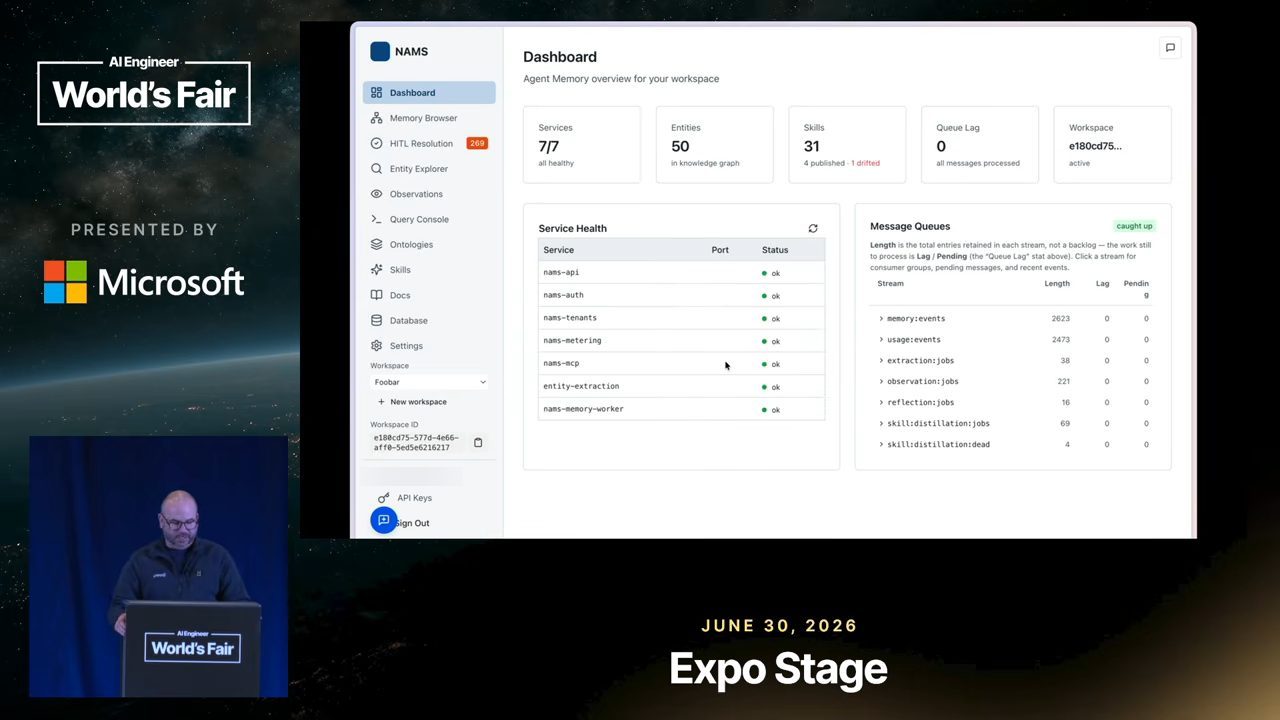
Demo chạy trên NAMS, hiện miễn phí để dùng thử.
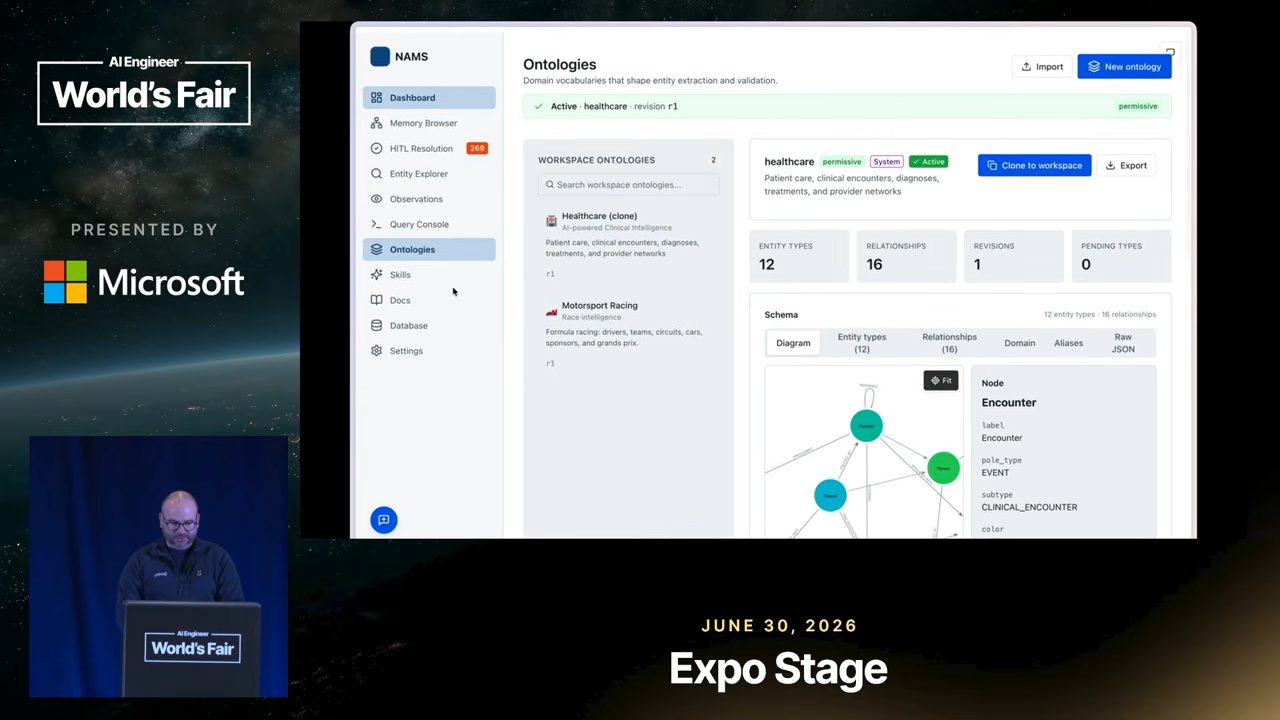
Demo dùng bộ khung lĩnh vực y tế, với các loại đối tượng như lần khám và bác sĩ. Will đã nạp sẵn nhiều cuộc hội thoại của một agent y tế.
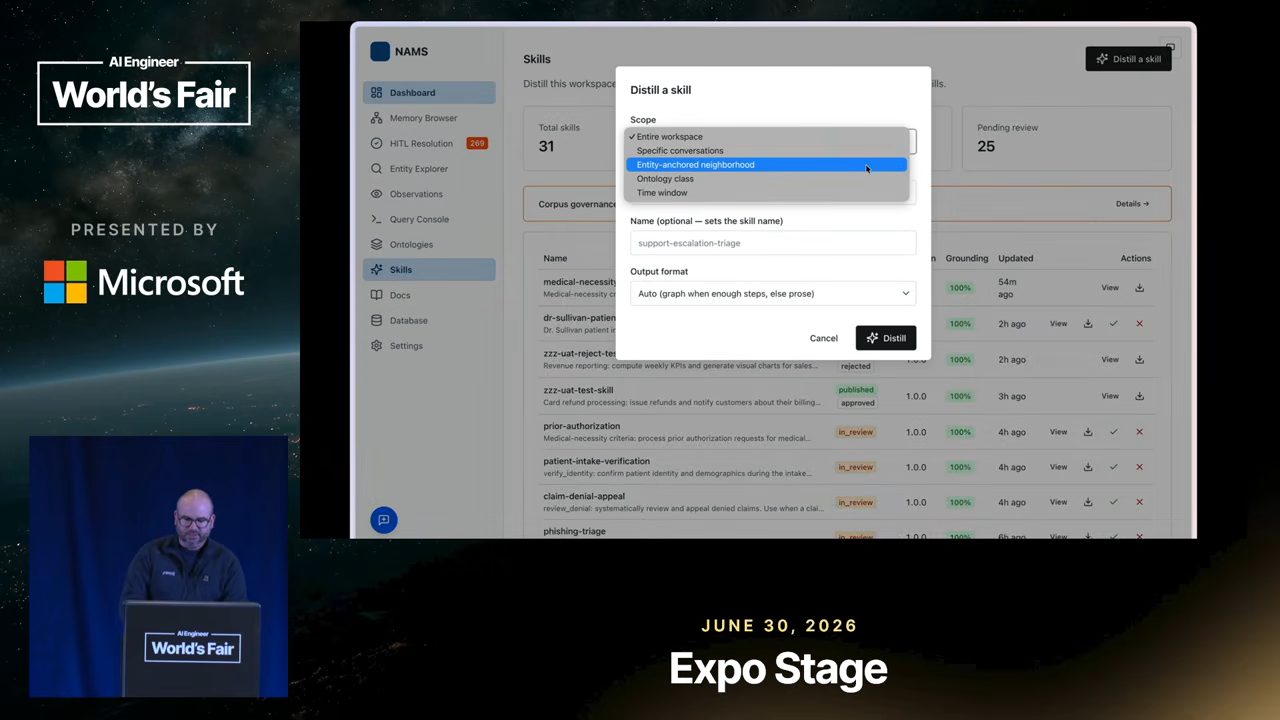
Bước đầu là chọn phạm vi. Có thể chọn cả nhóm làm việc, nhưng thường không cần rộng như vậy. Có thể chọn quanh một đối tượng, vài cuộc hội thoại, hoặc một loại đối tượng. Will chọn cuộc hội thoại gần nhất. Yêu cầu được đưa vào hàng đợi, chạy qua quy trình 7 bước, dựng skill thành sơ đồ rồi đóng gói lại.
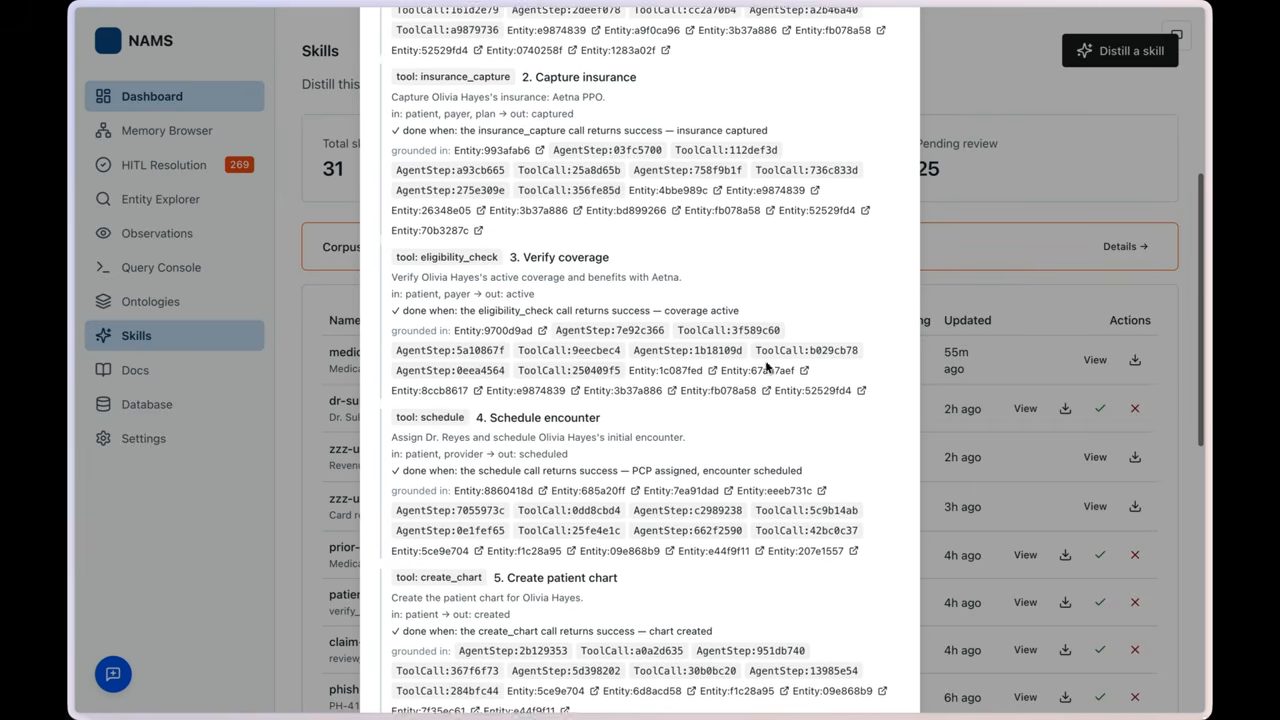
Trong lúc chờ, anh mở một skill đã tạo từ trước, rút ra từ một cuộc hội thoại tiếp nhận bệnh nhân. Skill liệt kê các bước từ lúc tiếp nhận bệnh nhân cho tới khi ghi hồ sơ bệnh án.
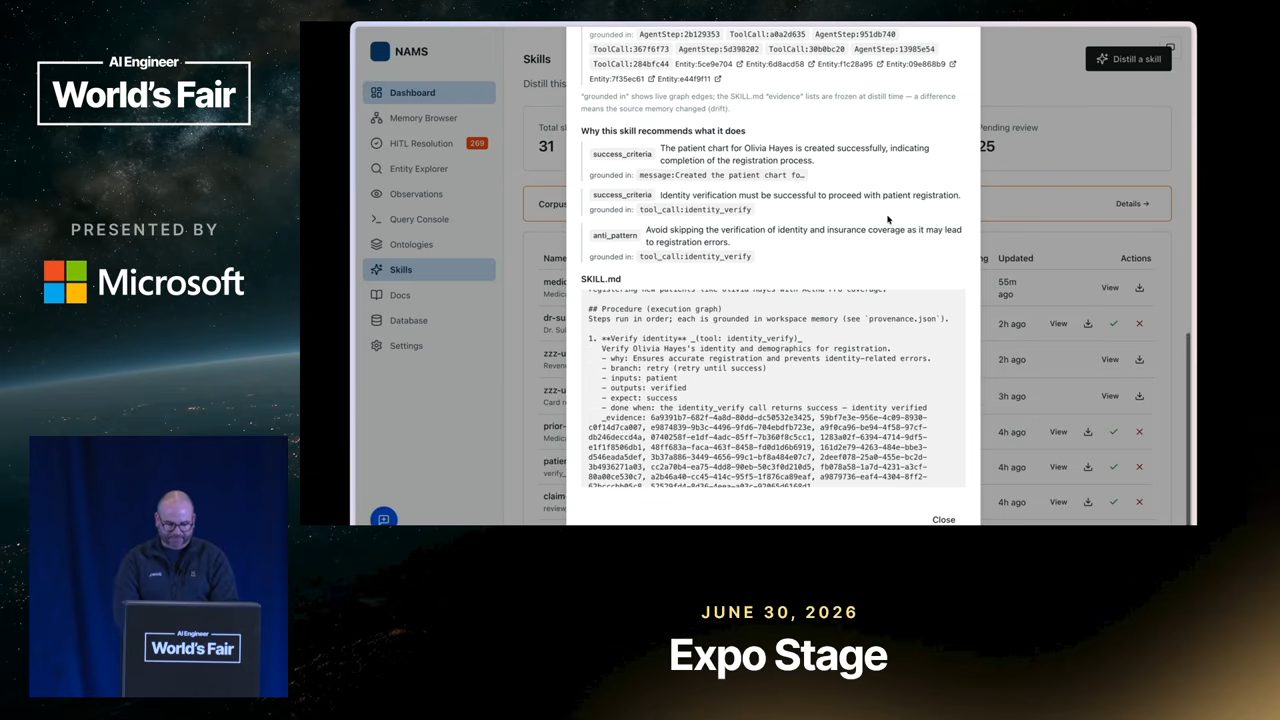
Điểm đáng chú ý: mỗi bước đều gắn với công cụ mà agent đã thực sự gọi và các đối tượng thật trong dữ liệu. Skill được đóng gói thành file SKILL.md, kèm các file tài liệu, đúng chuẩn skill của Anthropic, nên có thể tải về và đưa cho agent khác dùng.
13. Lời kết
Đó là cách xây trí nhớ của agent như một mạng lưới, rồi từ mạng lưới đó tạo ra skill. Thay vì để agent làm xong là quên, mỗi lần làm việc đều trở thành kinh nghiệm cho lần sau.
Nguồn và liên kết 6 nguồn
- Talk gốc: Turning Agent Memory Into Skills That Work, Will Lyon (Neo4j), AI Engineer World's Fair 2026, San Francisco · Video gốc youtube.com
- Bài blog của Will Lyon cùng chủ đề: From Agent Memory to Portable Skills (Neo4j, 06/08/2026) neo4j.com
- Neo4j Agent Memory Service (NAMS): memory.neo4jlabs.com · Tài liệu Agent Memory của Neo4j Labs memory.neo4jlabs.com
- Paper: AIP: A Graph Representation for Learning and Governing Agent Skills (arXiv 2606.04781) arxiv.org
- Chuẩn skill của Anthropic: agentskills.io agentskills.io
- Speaker: lyonwj.com lyonwj.com
Chưa tìm được nguồn: trang session chính thức của talk trên ai.engineer.
Nguồn và liên kết 3 nguồn
- Tên gốc: Turning Agent Memory Into Skills That Work
- Sự kiện: AI Engineer World's Fair 2026
- Video gốc: https://www.youtube.com/watch?v=XPj3mIKEtI4 youtube.com
Related talks
Tín hiệu từ user chết ở ranh giới retrieval
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.
Cách chúng tôi dạy agent dùng retrieval cho tốt
Hanna Lichtenberg & Aamir Shakir · Mixedbread · 14 min
Vì sao agent viết query keyword vô nghĩa, và cách Mixedbread dùng harness bốn search tool cùng SFT và RL để dạy agent dùng semantic search đúng cách.
Build hệ thống, đừng build code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.