User Signal Dies at the Retrieval Boundary
AI Engineer World's Fair 2026: Online Track · Video gốc
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.
1. Lộ trình của talk
Sonam Pankaj mở đầu bằng lời chào và tự giới thiệu: chị là CEO và co-founder của StarlightSearch. Tên talk của chị là "user signal dies at the retrieval boundary", tức là tín hiệu từ người dùng chết ngay tại ranh giới của bước retrieval.
Chị nêu trước lộ trình. Đầu tiên là nhắc lại agent là gì. Sau đó là vì sao agent thất bại, và cụ thể hơn, nguyên nhân thất bại nằm ở retrieval như thế nào. Tiếp theo là cách làm cho tín hiệu thật sự vượt qua được ranh giới retrieval đó. Cuối cùng là cách biến agent của bạn thành một agent "outcome-aware", tức là agent biết đến kết quả của chính những lần chạy trước.
2. Agent là gì, và vòng loop nào đang bị thiếu
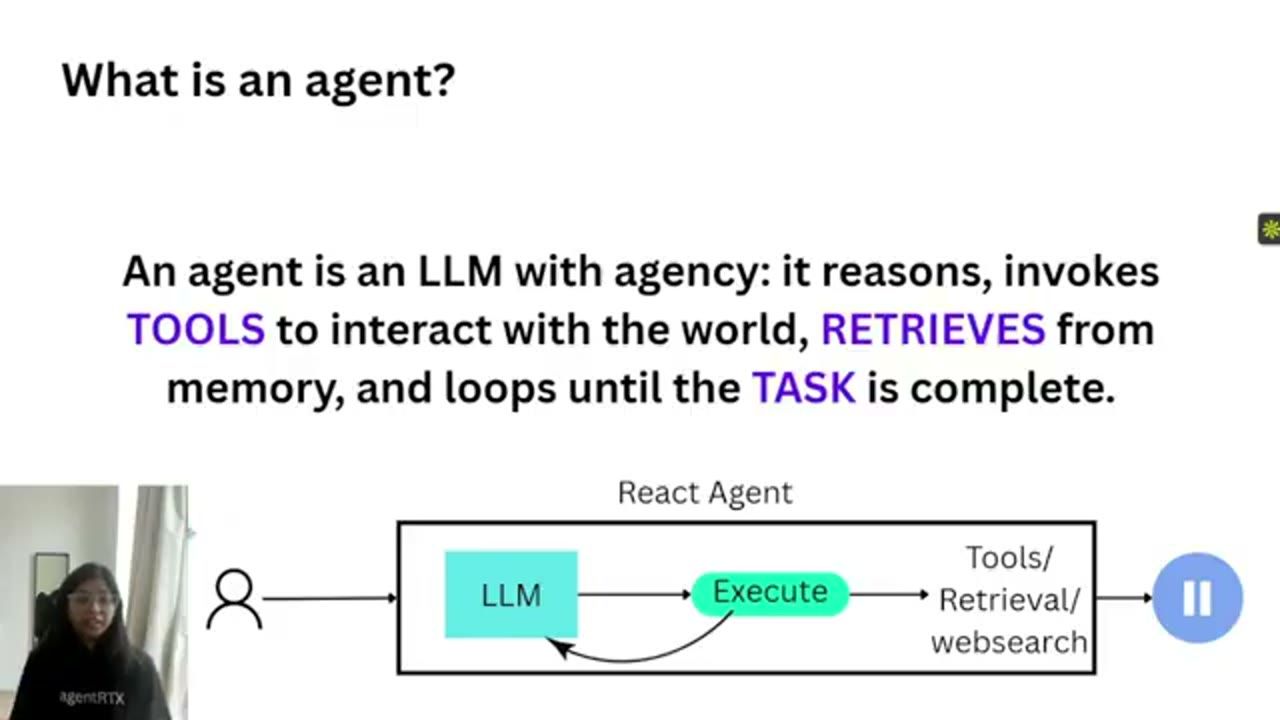
Định nghĩa của Sonam: agent là một LLM có agency, tức là có quyền tự hành động. Nó có thể reason, gọi tool, tương tác với thế giới thật và retrieve từ memory để hoàn thành một task. Nhưng theo chị, trong bức tranh đó đang thiếu một vòng loop lớn: learning. Agent lẽ ra phải học được từ những gì đã chạy tốt và những gì đã không chạy được.
Để giải thích agent một cách cụ thể, chị dùng kiến trúc ReAct. Người dùng đưa prompt cho agent. Agent chạy trong một vòng loop: gọi tool, gọi retrieval, gọi search, rồi dừng lại khi task đã hoàn thành. Đây là kiến trúc ReAct rất cơ bản. Thứ còn thiếu trong vòng loop này là cơ chế để agent học từ outcome, tức là từ kết quả cuối cùng của mỗi lần chạy.
3. Agent cứ thất bại ở cùng một task
Hệ quả của việc thiếu vòng learning là agent cứ thất bại ở cùng một task, lần này qua lần khác. Sonam dẫn số liệu: Gartner báo cáo rằng 85% dự án AI thất bại trong production, và báo cáo năm 2025 của McKinsey cũng cho thấy bức tranh tương tự.
Theo chị, khi đào vào nguyên nhân thì phần lớn thời gian vấn đề nằm ở chỗ retrieval là static, đứng yên, không thay đổi theo kết quả. Chị đưa ra con số: 73% số RAG pipeline thất bại là vì retrieval, chứ không phải vì generation. Vấn đề thứ hai là context stuffing: nhồi thật nhiều thứ vào context với hy vọng model tự tìm ra cái cần.
Sonam trích một bài post gần đây của Ram Sriharsha, cựu CTO của Pinecone. Ý chính chị đọc lại: bạn đang trả rất nhiều tiền cho memory của agent, và memory đó nhiều khả năng đang hỏng; cả ngành đã tối ưu sai thứ, chúng ta làm cho câu trả lời sai xuất hiện nhanh hơn và rẻ hơn, nhưng lại quên làm cho retrieval biết học. Trên slide, bài post còn đặt thêm một câu hỏi: vì sao coding agent tiên tiến nhất hiện nay, Claude Code của Anthropic, lại dùng grep, một tool có từ năm 1973, thay vì vector search; và tác giả nói ông đã viết về chuyện cả ngành sửa quá tay, vì sao context stuffing là một cái hố tiêu tiền, và bước tiếp theo cho agentic memory là gì.
4. Tầng còn thiếu giữa eval và hành động
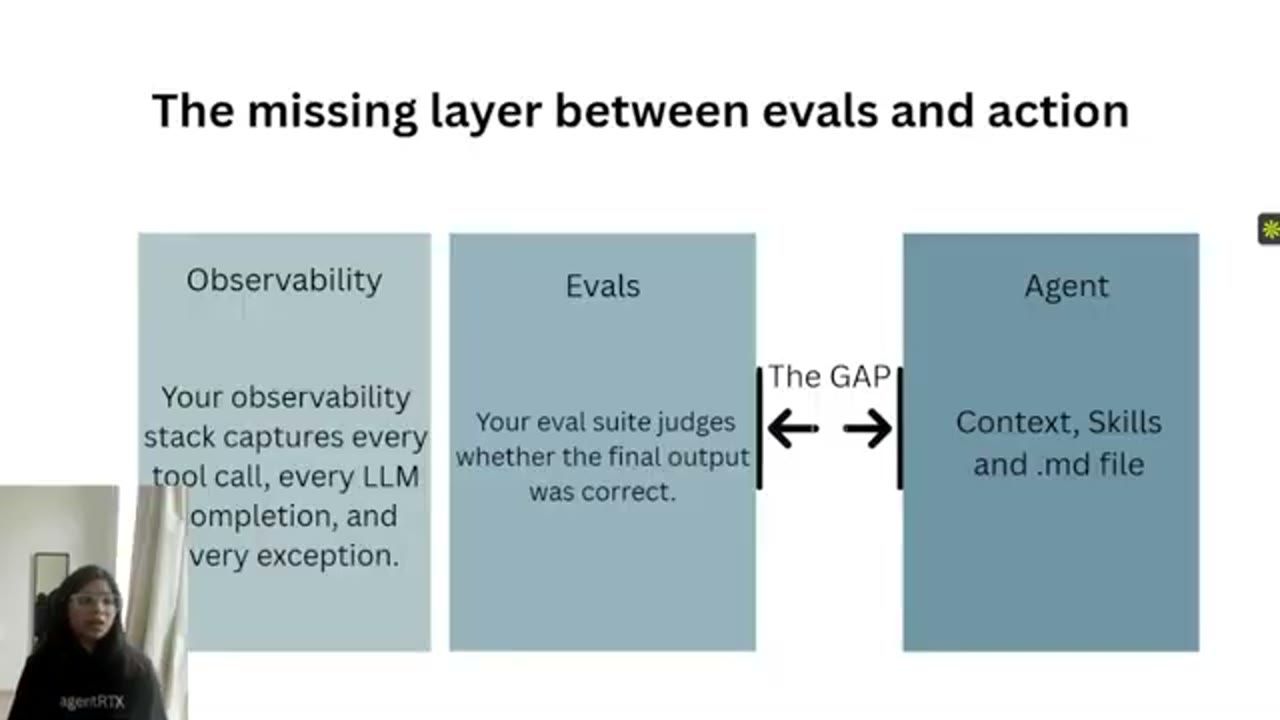
Sonam đặt câu hỏi vì sao chuyện này quan trọng, rồi đi tới vấn đề thứ ba: agent không được outcome-informed. Giữa eval và hành động của agent có một tầng bị thiếu.
Chị mô tả các mảnh đang có. Observability của bạn có toàn bộ trace: đó là cả một stack ghi lại mọi tool call, mọi LLM completion, mọi exception. Eval suite của bạn thì chấm xem output cuối cùng đúng hay sai, nói gọn là pass hay fail. Nhưng kết quả eval đó không hề được phản ánh vào context của agent, vào các file SKILL.md, hay vào hành động của agent theo bất kỳ cách nào.
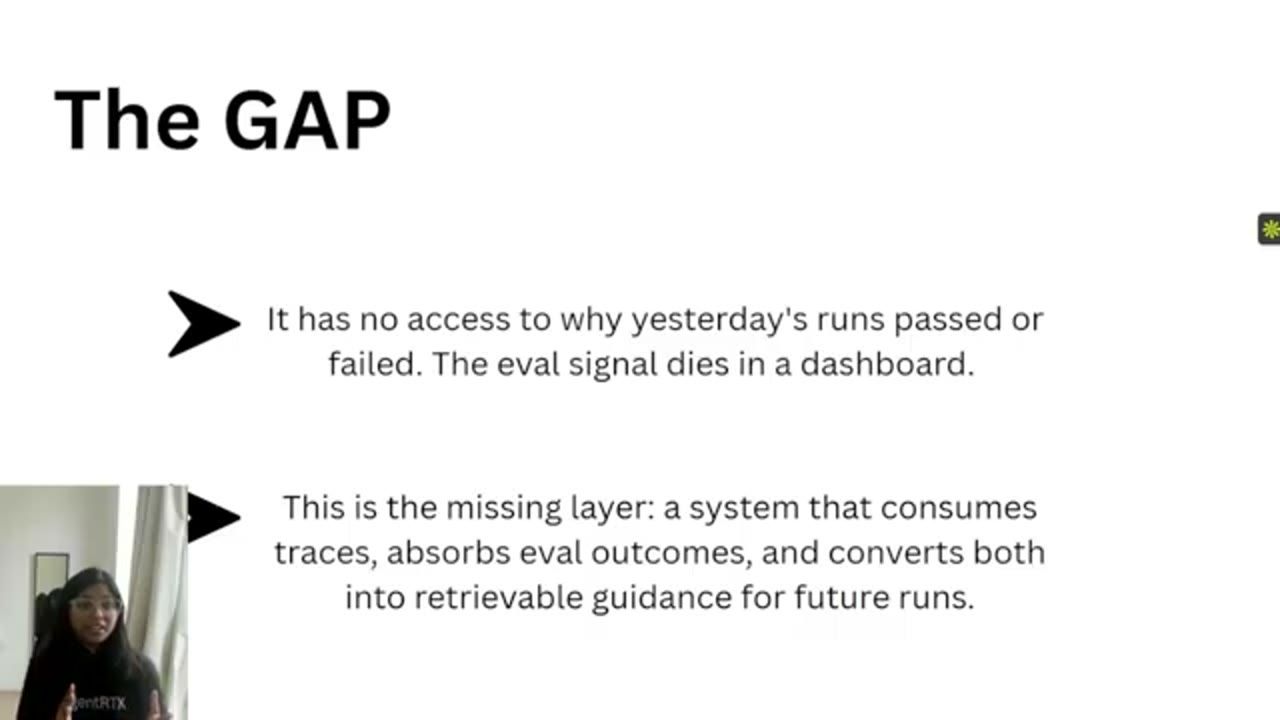
Như vậy agent không có cách nào biết vì sao những lần chạy hôm qua đã pass hoặc fail. Tín hiệu eval chết trong dashboard. Đó chính là tầng còn thiếu: một hệ thống tiêu thụ trace, hấp thụ kết quả eval, rồi biến cả hai thành retrieval guidance, tức là chỉ dẫn có thể retrieve được cho những lần chạy sau.
5. Thuế cải tiến thủ công
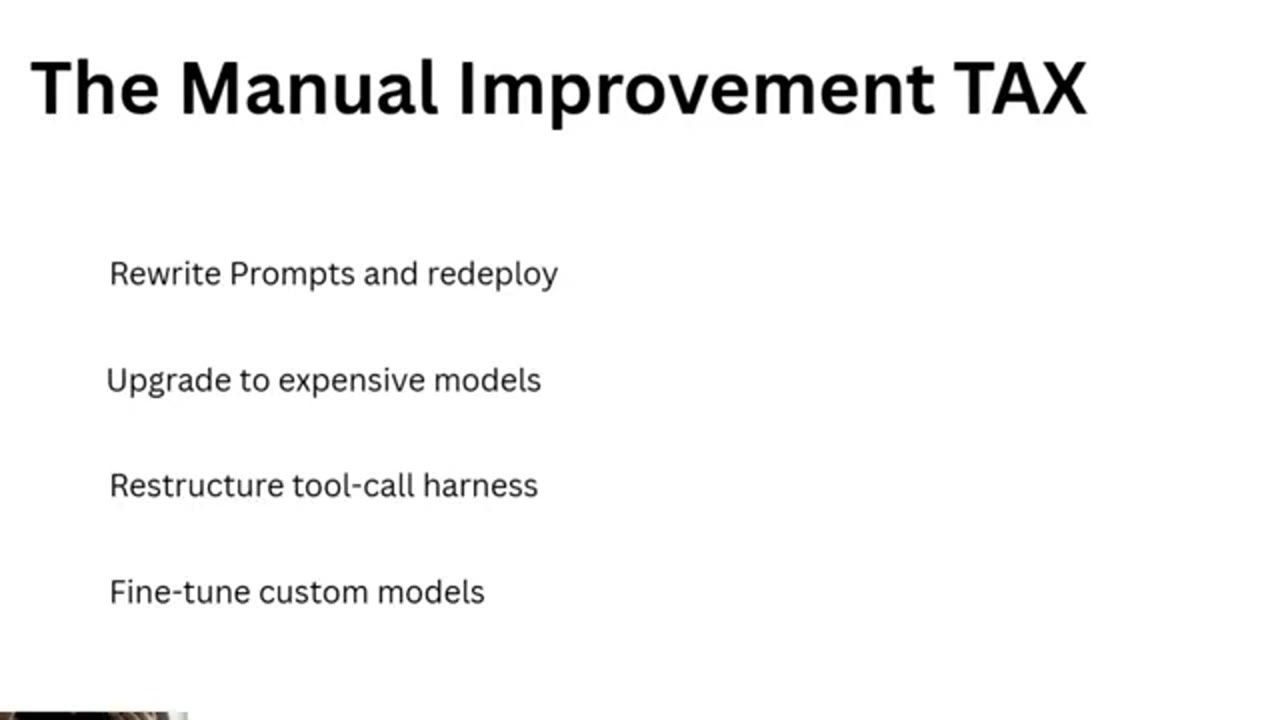
Khi tầng đó không tồn tại, người phải lấp vào là kỹ sư. Sonam gọi đây là "manual improvement tax", thuế cải tiến thủ công. Một engineer phải ngồi xem eval và observability để biết hệ thống chạy tốt hay không, rồi chọn một trong mấy cách quen thuộc: viết lại prompt và deploy lại; nâng lên một model đắt hơn; tái cấu trúc tool hoặc harness; hoặc fine-tune một model riêng.
6. Vì sao memory hiện nay không giải được bài này
Memory vốn được thiết kế ra để giải đúng loại vấn đề này, nhưng theo Sonam thì nó không làm được. Chị nhìn vào các hệ thống hiện có: memory hiện nay về cơ bản lưu preference của người dùng, profile, lịch sử hội thoại, hoặc personalization dài hạn. Đó là trải nghiệm chat, chứ không phải một hệ thống learning tự cải tiến dành cho agent chạy production.
Chị điểm qua các cách tiếp cận đang có trên thị trường, như LangChain và Mem0. Những hệ thống này lưu fact đã trích xuất và preference, còn tín hiệu dùng để retrieve là embedding similarity. Câu hỏi then chốt: chúng có học từ outcome không? Câu trả lời là không.
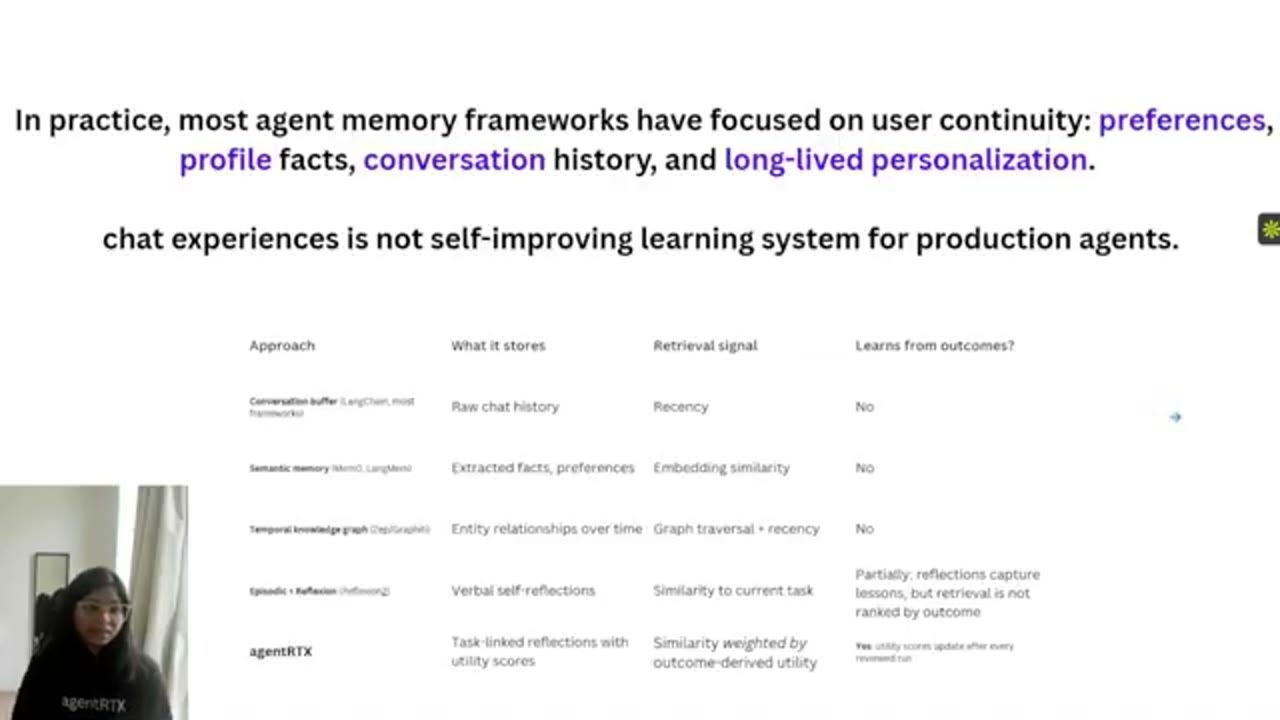
Từ đó StarlightSearch đưa ra khái niệm utility score: vẫn là similarity, nhưng được đánh trọng số theo mức độ hữu ích của memory đó đối với agent khi thực thi task. Điểm này mang theo lịch sử của các trace trước và các outcome trước.
7. agentRTX: agent có runtime experience
Sản phẩm họ làm ra tên là agentRTX, viết tắt cho "agents with runtime experience". Đây là một tầng runtime cho phép agent chạy production tự cải tiến từ kinh nghiệm, mà không cần pre-training, fine-tuning hay prompt engineering thủ công.
Sonam phân biệt nó với cách làm ở compile time như DSPy. Với cách compile time, bạn bake toàn bộ bài học vào trong prompt trước khi chạy. Ở đây thì khác: agent cải tiến ngay trong lúc đang thực thi task.
8. Utility score và memory như reasoning
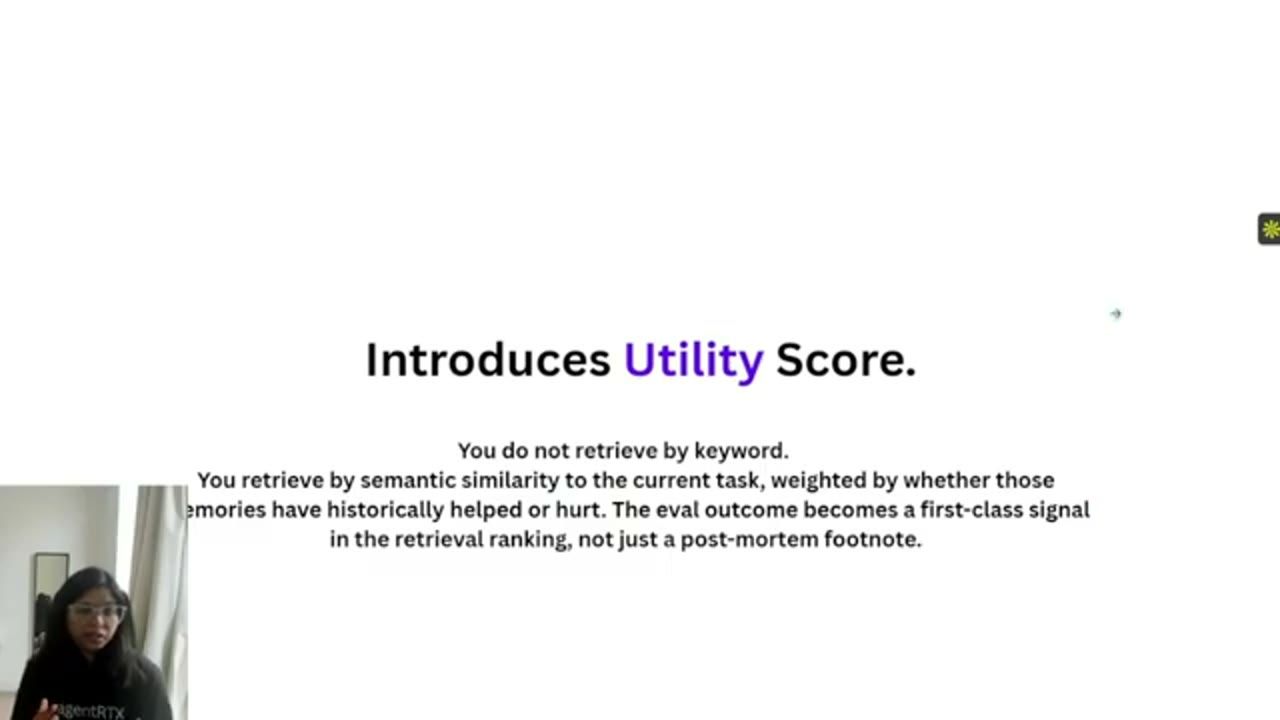
Sonam quay lại khái niệm utility score để giải thích kỹ hơn. Bạn không retrieve theo keyword. Bạn retrieve theo semantic similarity với task hiện tại, nhưng có đánh trọng số theo việc những memory đó trong quá khứ đã giúp hay đã làm hại quá trình thực thi, hay outcome. Kết quả eval trở thành một tín hiệu hạng nhất trong bước re-ranking của retrieval, chứ không chỉ dừng lại ở vai trò feedback.
Một điểm then chốt khác: hệ thống coi memory là reasoning chứ không phải fact. Fact là thứ static, không có context, không có lịch sử. Lấy ví dụ một bot chăm sóc khách hàng đang xử lý yêu cầu hoàn tiền. Memory kiểu fact sẽ chỉ nói những thứ như "người dùng thích dark theme" hay "người dùng thích được gọi bằng tên ngắn". Còn memory kiểu reasoning thì lập luận về chính câu hỏi: nếu ai đó yêu cầu refund, bạn nên kiểm tra settlement trước khi hoàn tiền, để khách hàng không bị hoàn tiền hai lần.
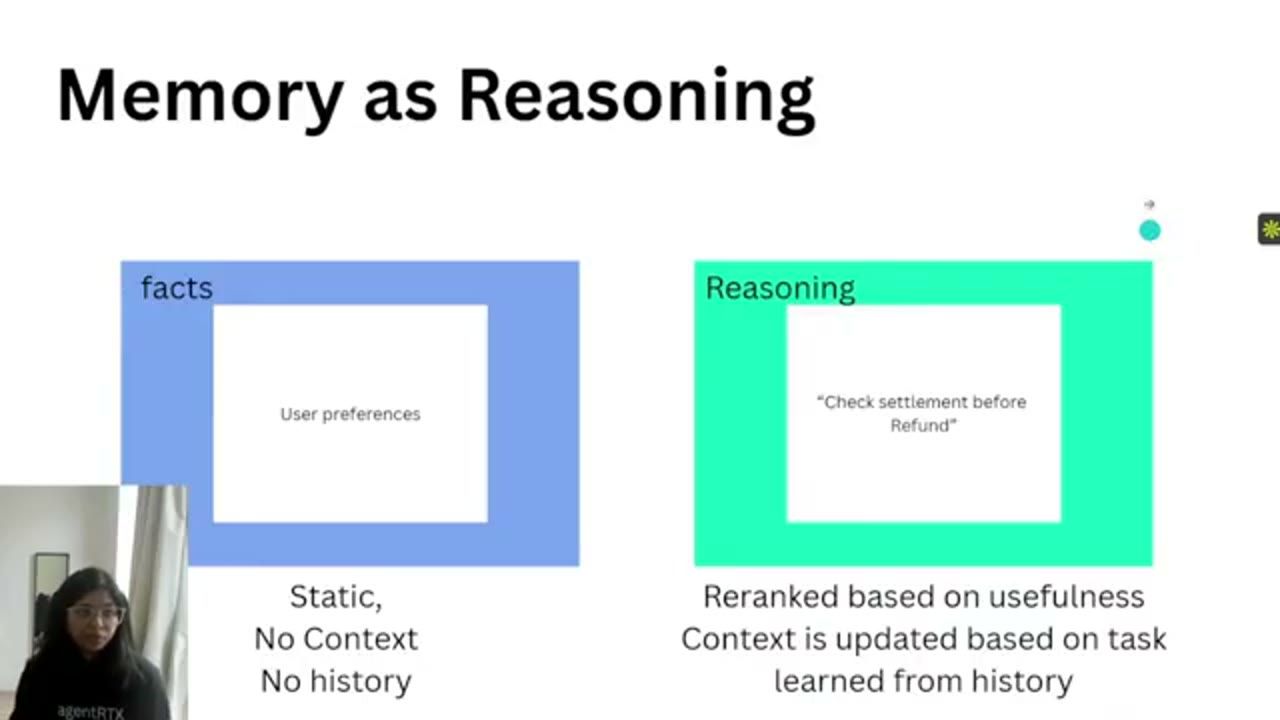
Như vậy memory được re-rank theo mức độ hữu ích, và context được cập nhật dựa trên task. Theo Sonam đây là điểm rất lớn, vì phần lớn agent thất bại do context stuffing; còn ở đây, thứ được đưa vào context là những gì đã được nêu ra trong quá khứ, được học từ lịch sử và có reasoning đi kèm.
9. Benchmark trên τ²-bench và việc bake memory thành skill
Sang phần benchmark. StarlightSearch đã benchmark hệ thống memory của họ, tên là Reflect, trên τ-bench, một benchmark đo xem agent có tuân thủ policy tốt hay không. Theo Sonam, hiệu năng tăng từ 66% lên 76% mà chưa cần bake thêm skill nào. Khi có skill, Reflect đạt 80%.
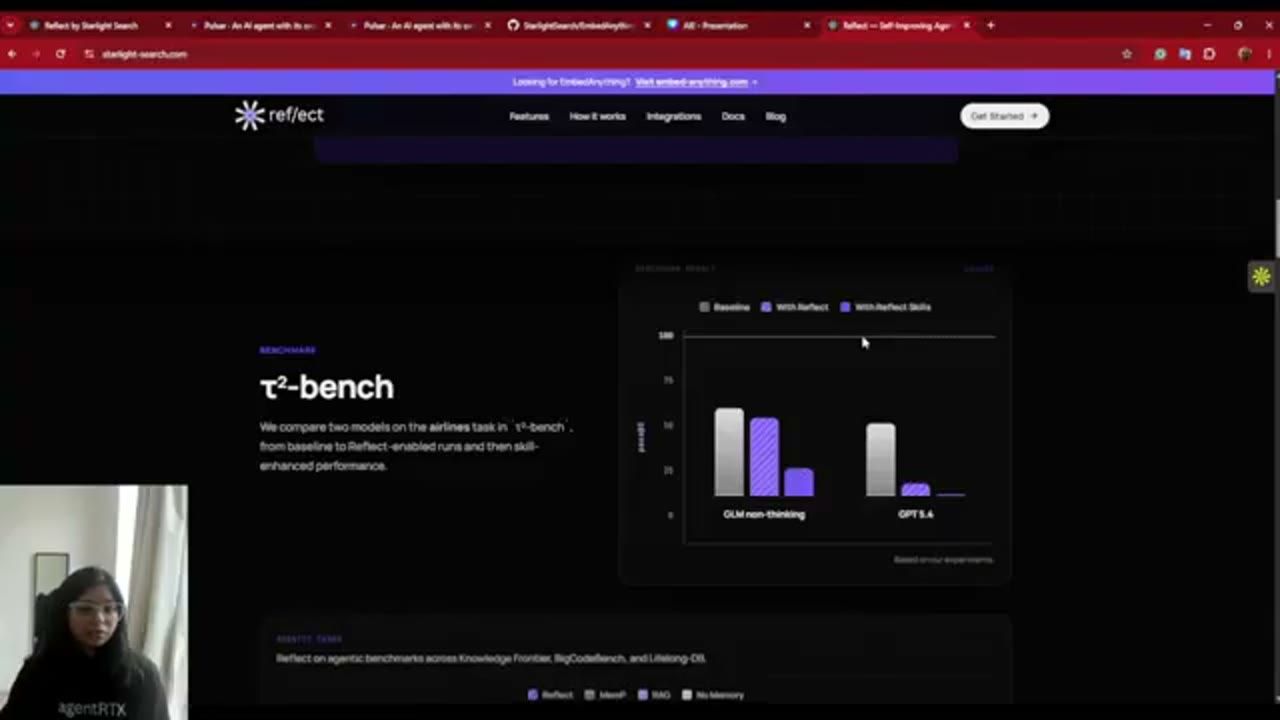
Cơ chế skill hoạt động thế này: khi đã có đủ memory, chị lấy ví dụ khoảng mười memory, họ bake phần reasoning và hiểu biết tích lũy được vào skill, để agent của bạn luôn được cập nhật.
Sonam giải thích vì sao việc này quan trọng bằng một tình huống họ gặp rất thường xuyên. Giả sử bạn có một product SQL agent, và trong system prompt có nhắc tới một cột. Dù cột đó không còn dùng nữa, nó vẫn nằm nguyên trong system prompt. Hiện chưa có hệ thống nào tự cập nhật được kiểu "này, bây giờ không còn cột nào tên như vậy nữa, có lẽ sau này bạn không nên xử lý nó". Với skill thì làm được, vì agent luôn gọi skill, và gọi đúng bản skill đã được cập nhật. Chị cho biết hành vi tương tự cũng đã được thấy với GPT-5.4.
10. Benchmark trên các agentic task
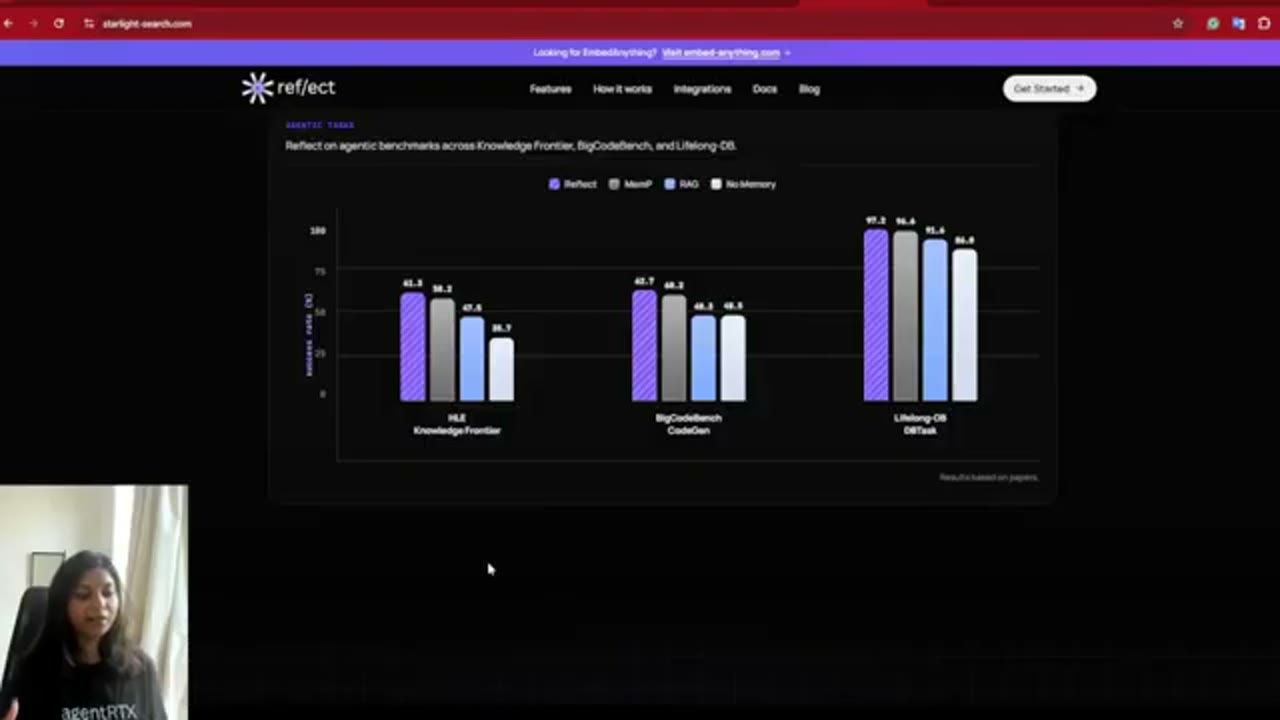
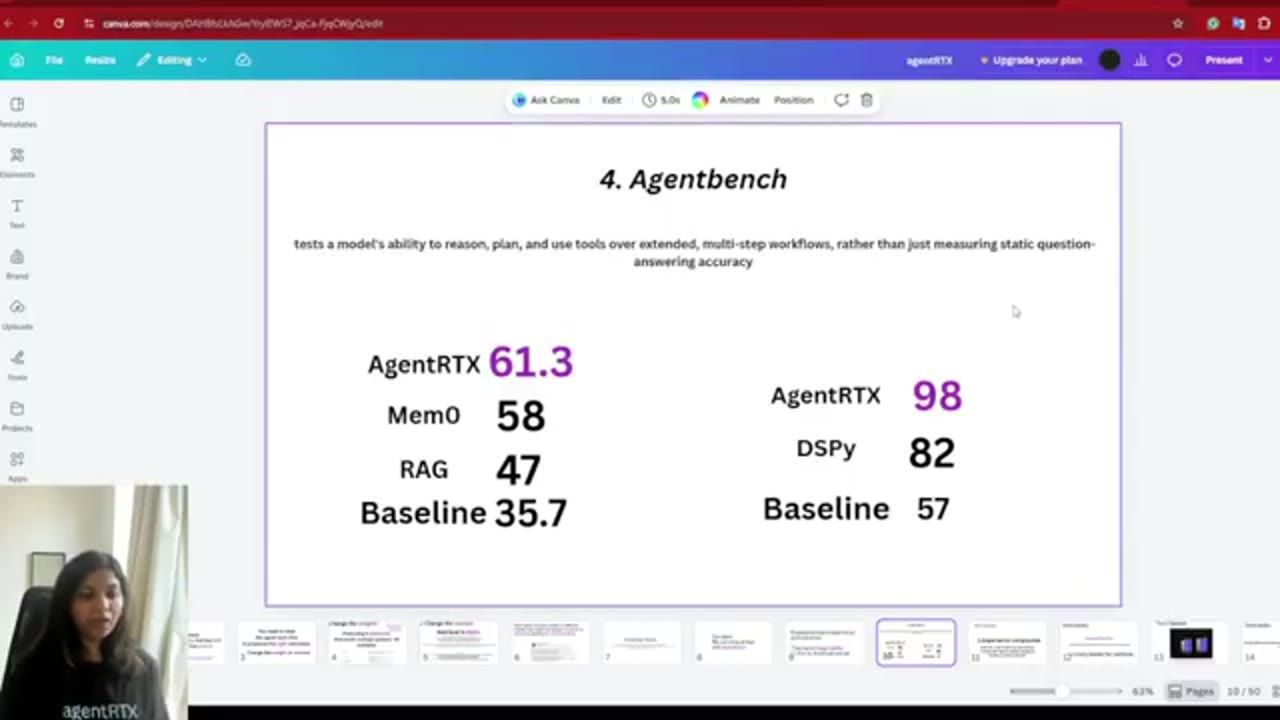
Họ cũng benchmark trên các agentic task: loại bài kiểm tra khả năng của model trong việc reason, lập kế hoạch và dùng tool qua những workflow dài, nhiều bước, thay vì chỉ đo độ chính xác hỏi đáp tĩnh.
Sonam đọc các con số trên Humanity's Last Exam. Baseline xuất phát ở 35.7. Với RAG, điểm lên 47.5. Với hệ thống memory, điểm lên 58.2. Còn với Reflect Memory System, điểm đạt 61.3%. Theo chị, xu hướng này lặp lại ở các agentic benchmark khác, như BigCodeBench và Lifelong-DB.
11. Giới hạn của cách làm này
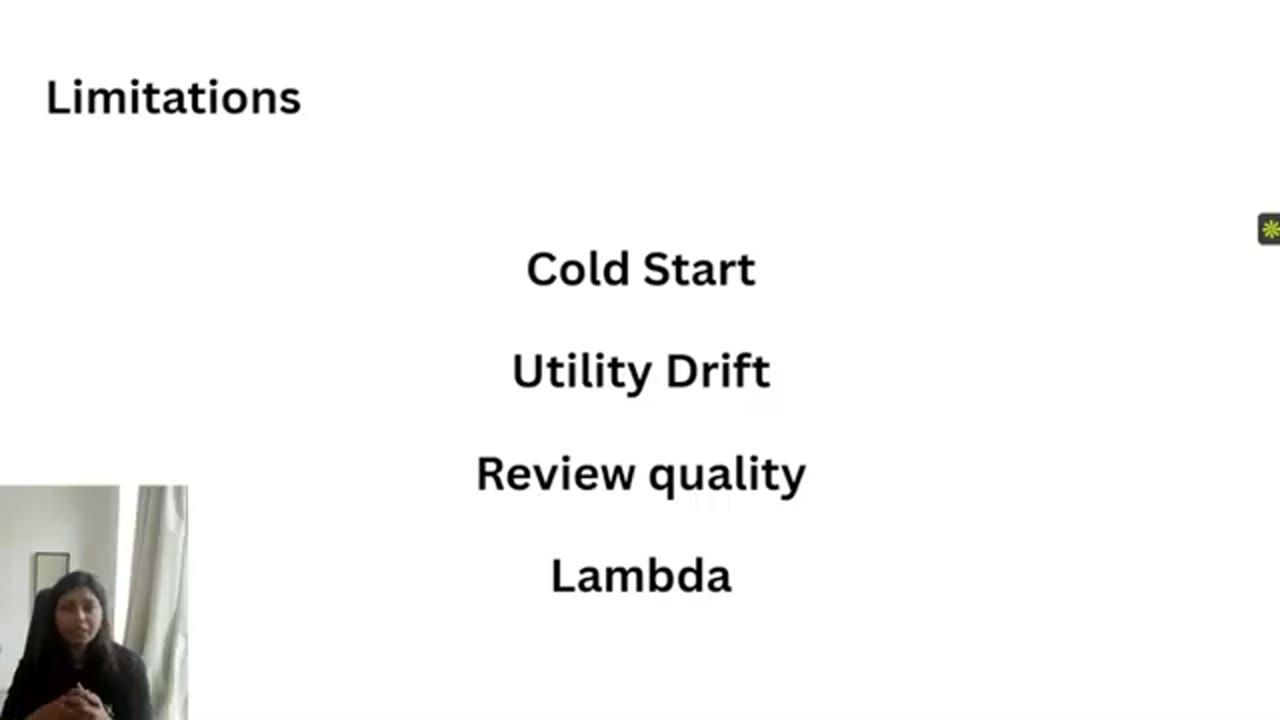
Sonam nói thẳng rằng cách tiếp cận này có giới hạn. Thứ nhất là cold start: lúc ban đầu, hệ thống chỉ là semantic search thuần túy cho tới khi tích lũy đủ review. Thứ hai là utility drift: đôi khi các memory na ná nhau có thể cùng nổi lên. Chị thừa nhận có rất nhiều vấn đề có thể xuất hiện khi chạy loại experience này ở quy mô lớn, nhưng họ đã xử lý được phần lớn.
Thứ ba là chất lượng review: label nhiễu sẽ làm cho utility cũng nhiễu theo. Thứ tư là một hyperparameter tên lambda, gắn với việc gán credit và re-ranking. Theo Sonam, Reflect được xây sao cho phần lớn những vấn đề và giới hạn này đã được giảm bớt, trừ cold start, thứ mà họ không làm được gì nhiều.
12. Demo phần một: "find me a gaming mouse" thất bại
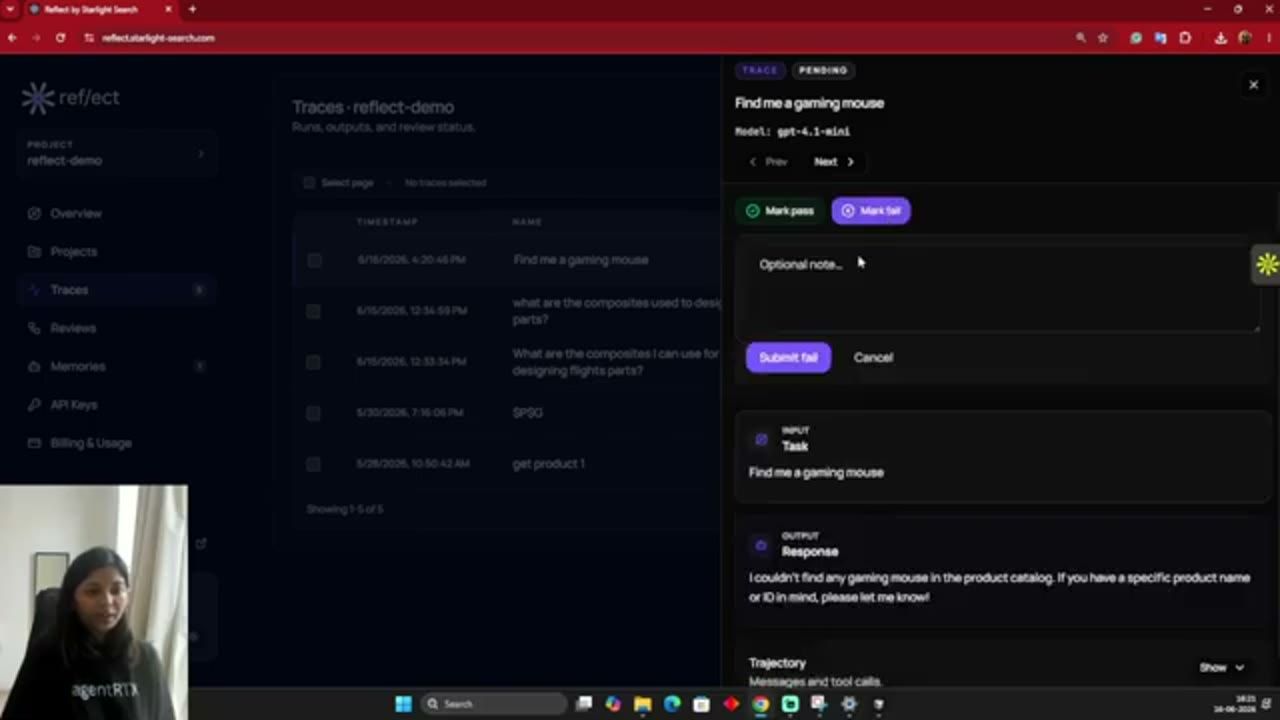
Tiếp theo là demo. Đây là một product SQL agent: Sonam sẽ yêu cầu nó tìm một sản phẩm trong database SQL và xem nó có tìm ra không. Trong file demo, phần comment ghi lại các lựa chọn tích hợp: framework là OpenAI Agents SDK, agent có dạng product-sql-agent với các tool truy vấn một database SQLite cục bộ, nguồn review là con người và được hoãn lại (không có bước judge chạy inline, người review chấm trace sau qua dashboard), còn định nghĩa thế nào là pass hay fail thì để cho người chấm quyết theo rubric của team.
Chị gõ: "Find me a gaming mouse." Hệ thống báo không retrieve được memory nào, và agent trả lời rằng nó không tìm thấy gaming mouse nào. Chị mở dashboard để xem chuyện gì đã xảy ra.
Trong lúc chờ, chị quay lại phần benchmark, lần này là AgentBench, một benchmark đo xem agent có thật sự reason, lập kế hoạch đúng và đi theo đúng các bước hay không. Chị nhắc lại rằng loại benchmark này kiểm tra khả năng reason, plan và dùng tool qua những workflow dài, nhiều bước, chứ không đo hỏi đáp tĩnh, và đọc lại các con số trên Humanity's Last Exam: baseline 35.7, RAG 47.5, hệ thống memory 58.2, Reflect Memory System 61.3%, với xu hướng tương tự ở BigCodeBench và Lifelong-DB.
Quay lại agent: nó vẫn trả lời là không tìm thấy gaming mouse nào trong product catalog. Vì trong database thật ra có một con wireless mouse, Sonam đánh dấu lần chạy này là fail và gõ ghi chú "Give any relevant", tức là hãy đưa ra bất kỳ sản phẩm nào liên quan, rồi gửi failure đi. Trên dashboard có đủ input, response "I couldn't find any", cùng trajectory và các tool call mà agent đã đi qua; có thể thấy với query này thì danh sách product trả về là rỗng.
13. Demo phần hai: trajectory đổi ngay trong production
Sonam chạy lại để xem bây giờ chuyện gì xảy ra. Lần này agent search một wireless mouse. Lần chạy retrieve được hai memory, và agent trả lời rằng nó tìm thấy một sản phẩm liên quan tới mouse, đúng như yêu cầu "hãy đưa ra bất kỳ thứ gì liên quan" mà chị đã gửi làm feedback.
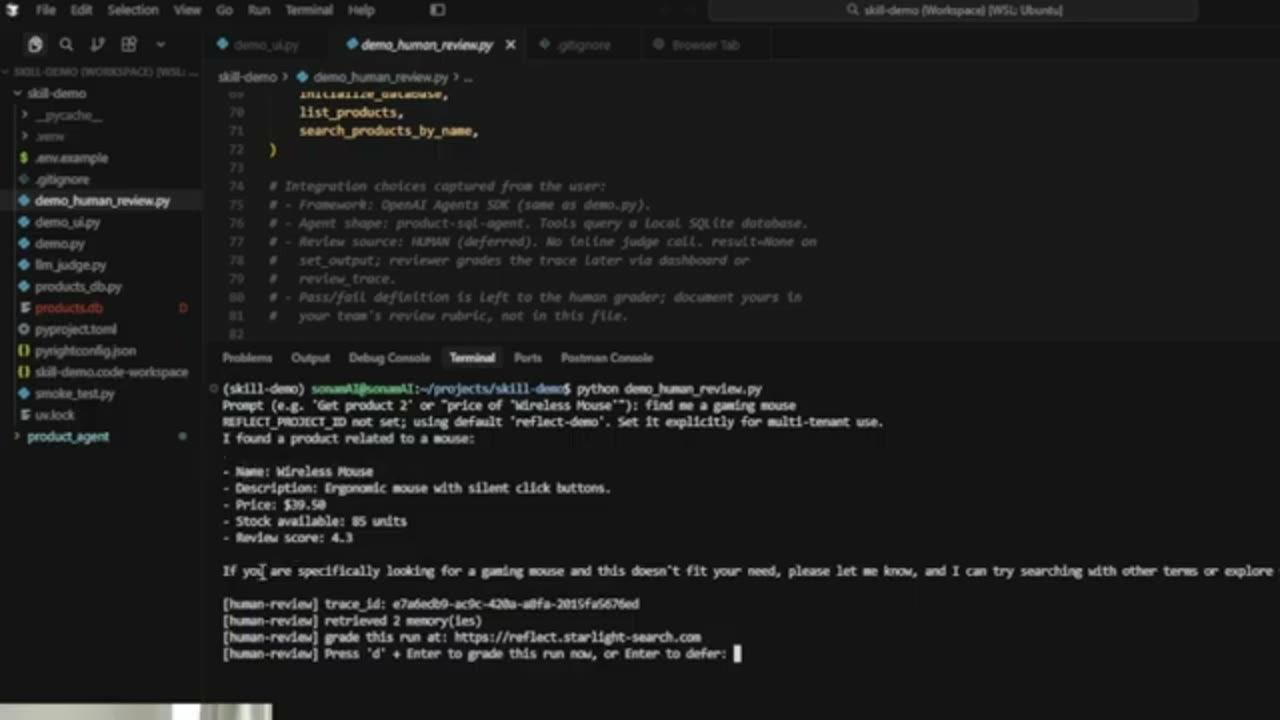
Trên dashboard, input là mouse, response là "I found a product related to mouse". Nhưng theo Sonam, điều quan trọng nhất là cách tool call đã thay đổi. Trước đây trajectory chỉ có một lần search: agent gọi tool search products và nhận về danh sách rỗng. Bây giờ trajectory đã đổi ngay trong production. Agent vẫn gọi tool search product, nhưng lần này nó nhận được câu trả lời, nhờ phần feedback mà chị đã đưa vào.
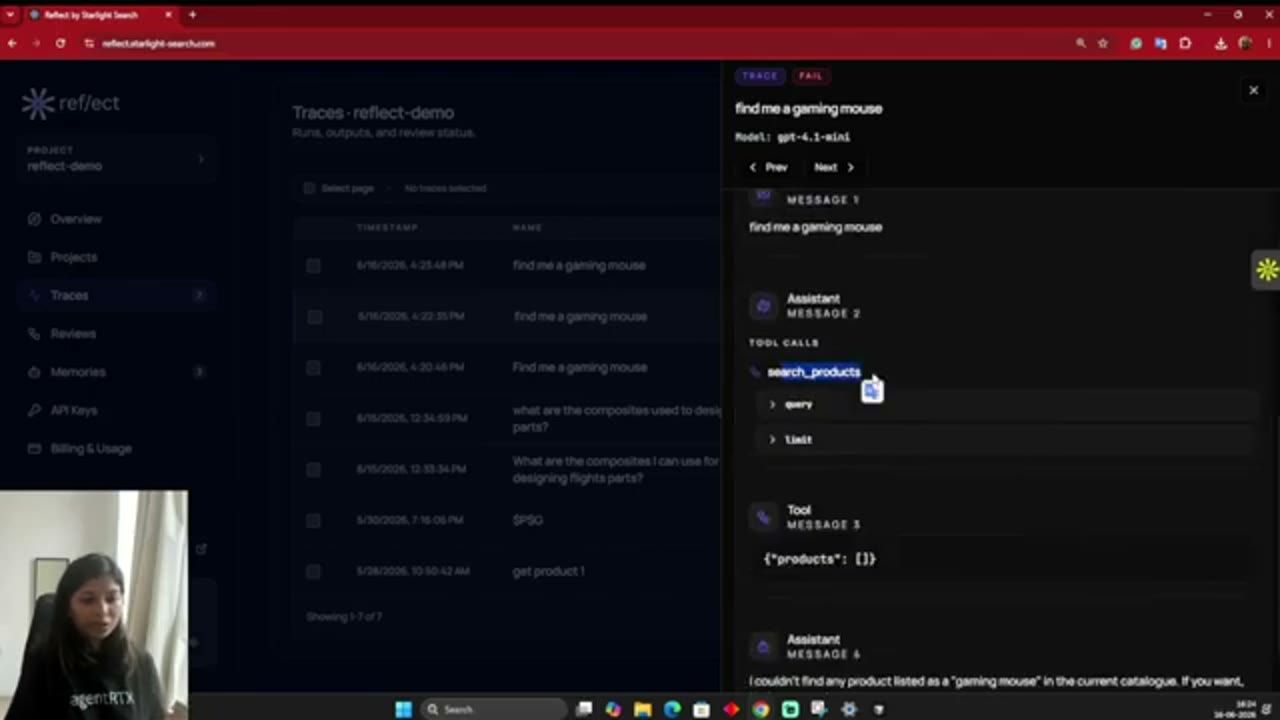
search_products với tham số query và limit, tool trả về {"products": []}, và assistant kết luận không có sản phẩm nào được liệt kê là "gaming mouse" trong catalogue.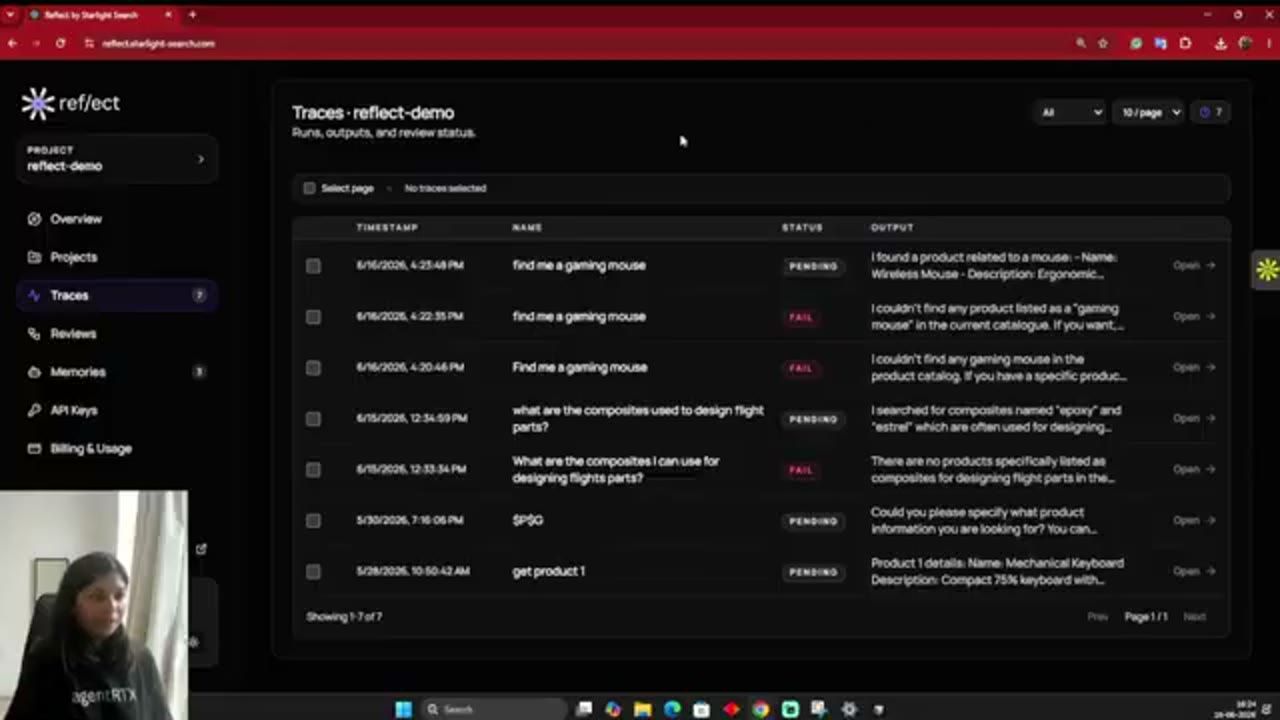
14. Memory, utility score và Project Skill
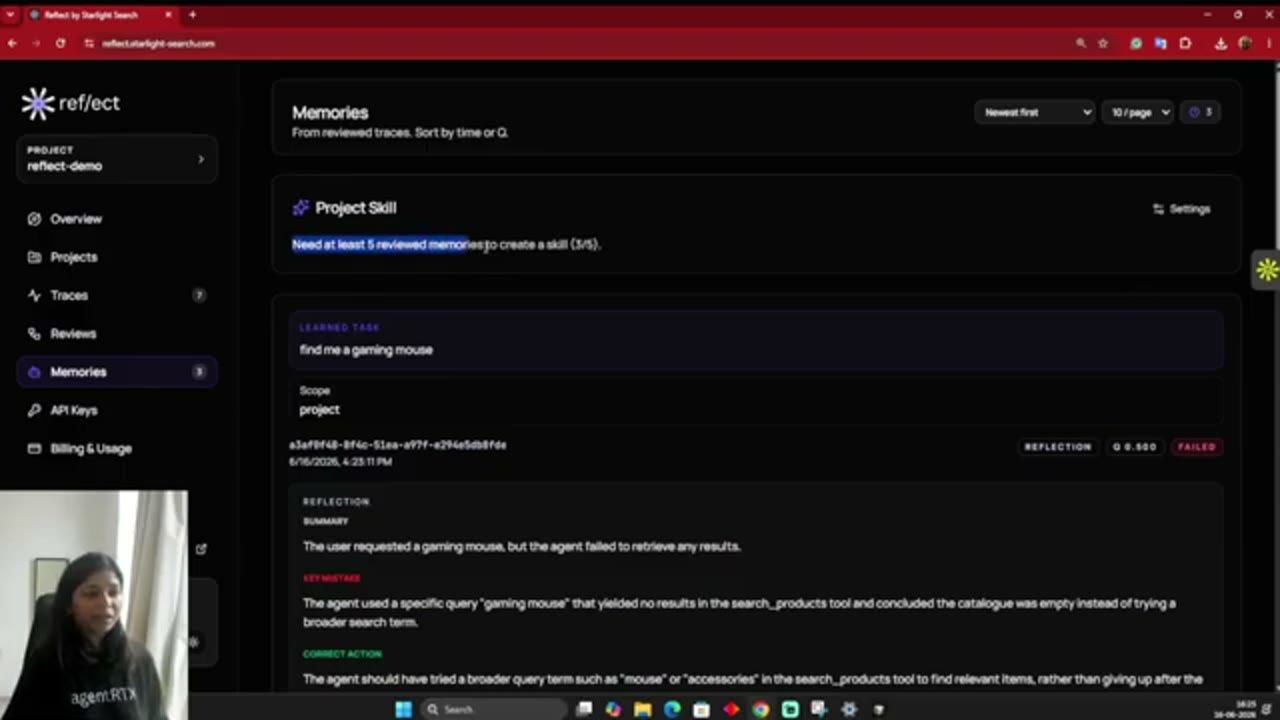
Sonam tóm lại điều đang diễn ra phía sau: hệ thống đang hình thành memory, và memory được retrieve dựa trên utility score. Đây là điểm số liên tục cải thiện, hay nói đúng hơn là liên tục tự re-rank, dựa trên việc memory đó đã hữu ích tới đâu. Từ các trace trước, bạn thấy được memory nào đã được dùng.
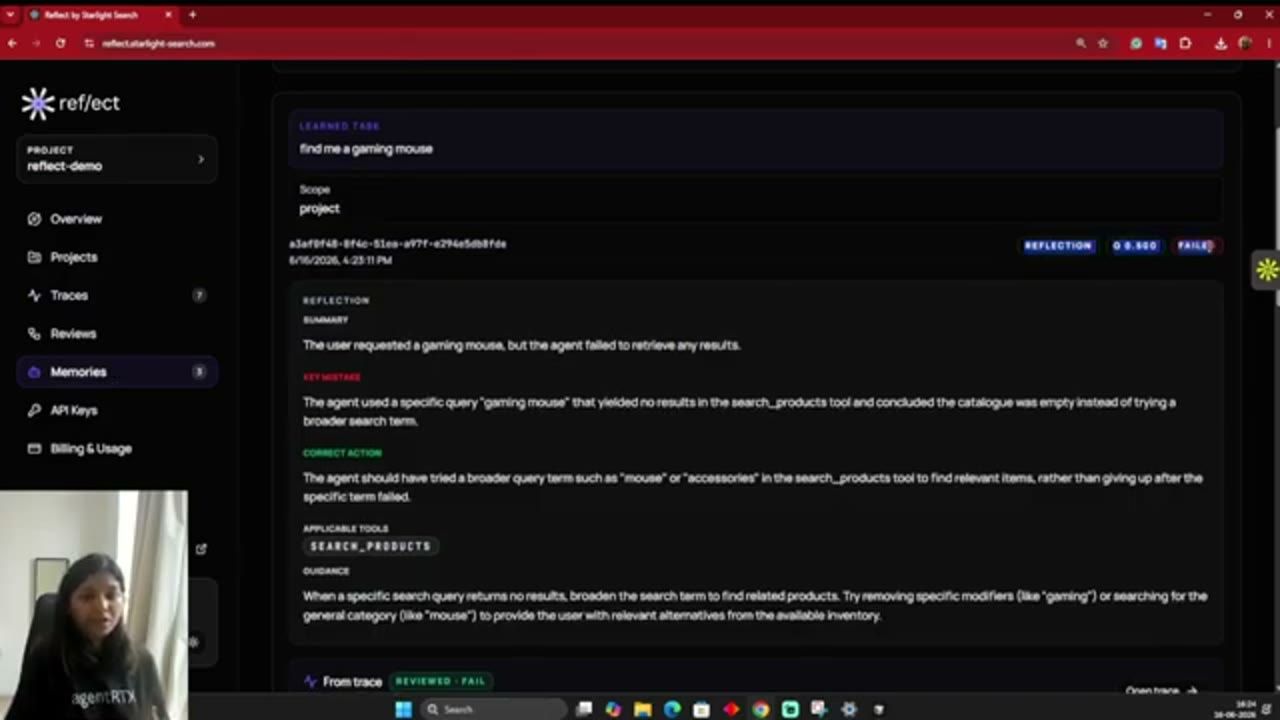
Phần guidance của memory này là đúng loại "memory như reasoning" Sonam nói ở đầu talk, một chỉ dẫn mà agent có thể dùng lại cho những query tương tự:
When a specific search query returns no results, broaden the search term to find related products. Try removing specific modifiers (like "gaming") or searching for the general category (like "mouse") to provide the user with relevant alternatives from the available inventory.
Điểm của các memory thay đổi liên tục. Sau một thời gian, chị lấy ví dụ khi đã có năm review, bạn có thể bake những phát hiện hay cập nhật mới này vào một skill. Như vậy, không cần sửa system prompt, bạn vẫn cập nhật được những thứ mà agent dựa vào rất nhiều. Theo chị, việc cập nhật được skill theo cách này là một điều rất hay.
Sonam kết thúc bằng lời mời mọi người thử tính năng runtime experience mới này. Muốn biết thêm chi tiết thì vào website của StarlightSearch hoặc liên hệ trực tiếp với chị. Chị cảm ơn mọi người.
Nguồn và link
- StarlightSearch: starlight-search.com · dashboard Reflect trong demo: reflect.starlight-search.com
- EmbedAnything, pipeline RAG viết bằng Rust do Sonam đồng sáng lập: github.com/StarlightSearch/EmbedAnything
- Trang diễn giả Sonam Pankaj: ai.engineer/speakers/sonam-pankaj
- ReAct (Yao và cộng sự): arxiv.org/abs/2210.03629 · Reflexion: arxiv.org/abs/2303.11366
- Mem0: mem0.ai · LangMem: github.com/langchain-ai/langmem · DSPy: dspy.ai
- τ²-bench: github.com/sierra-research/tau2-bench · AgentBench: github.com/THUDM/AgentBench
- Humanity's Last Exam: lastexam.ai · BigCodeBench: github.com/bigcode-project/bigcodebench
Related talks
The Miranda Hypothesis: How Hamilton (the Musical) Poisoned Your Persona Evals
Jacob E. Thomas · Results Generation · 58 min
Vì sao persona eval chấm fluency không bắt được persona ghép lẫn văn hoá sai thời đại, và instrument pre-registered với nhà sử học để đo fidelity.
Continual Learning for AI Agents: From Failures to Durable Improvements
Soheil Feizi · RELAI · 22 min
Biến log và feedback production thành learning environment replay được, sửa agent ở đúng layer (model, harness, memory) mà không gây regression.
How we taught agents to use good retrieval
Hanna Lichtenberg & Aamir Shakir · Mixedbread · 14 min
Vì sao agent viết query keyword vô nghĩa, và cách Mixedbread dùng harness bốn search tool cùng SFT và RL để dạy agent dùng semantic search đúng cách.