We Cut 94% of Our AI Coding Tokens With a Local Code Index. Here's the Architecture.
AI Engineer World's Fair 2026: Online Track · Video gốc
90% chi phí AI coding là input: local code index với Tree-sitter, hybrid search và confidence score đơn giản cắt 94% token gửi lên model.
1. Hoá đơn AI tăng vọt, và tiền không nằm ở chỗ AI "suy nghĩ"
Raj mở đầu bằng một câu chuyện. Anh và người bạn tên Faz cùng nhau build một project. Hai người dùng AI coding tool mỗi ngày, toàn những thứ bình thường: Claude Code, Cursor, Copilot, Codex. Có một tháng, hoá đơn AI vẫn ổn. Tháng tiếp theo, hoá đơn tăng vọt. Họ không làm gì khác cả: cùng project, cùng bộ tool, chỉ là dùng nhiều hơn. (Phần giới thiệu diễn giả trong mô tả video gốc ghi con số cụ thể: hoá đơn AI coding của nhóm nhảy từ £15 lên £200 chỉ trong một tháng.)
Hai người hoảng. Họ ngồi xem chuyện gì đang xảy ra, và phát hiện một điều bất ngờ: phần lớn tiền không phải trả cho việc AI suy nghĩ. Phần lớn tiền trả cho việc gửi quá nhiều context, những file mà AI không hề cần. Raj nhấn mạnh: context là quan trọng, nhưng ở đây là code không liên quan, vẫn bị gửi đi mỗi lần. Thế là anh và Faz bắt tay build một thứ để sửa chuyện đó. Talk này kể lại họ đã build gì và học được gì.
2. 45.000 token gửi đi, chỉ khoảng 5.000 token có ích
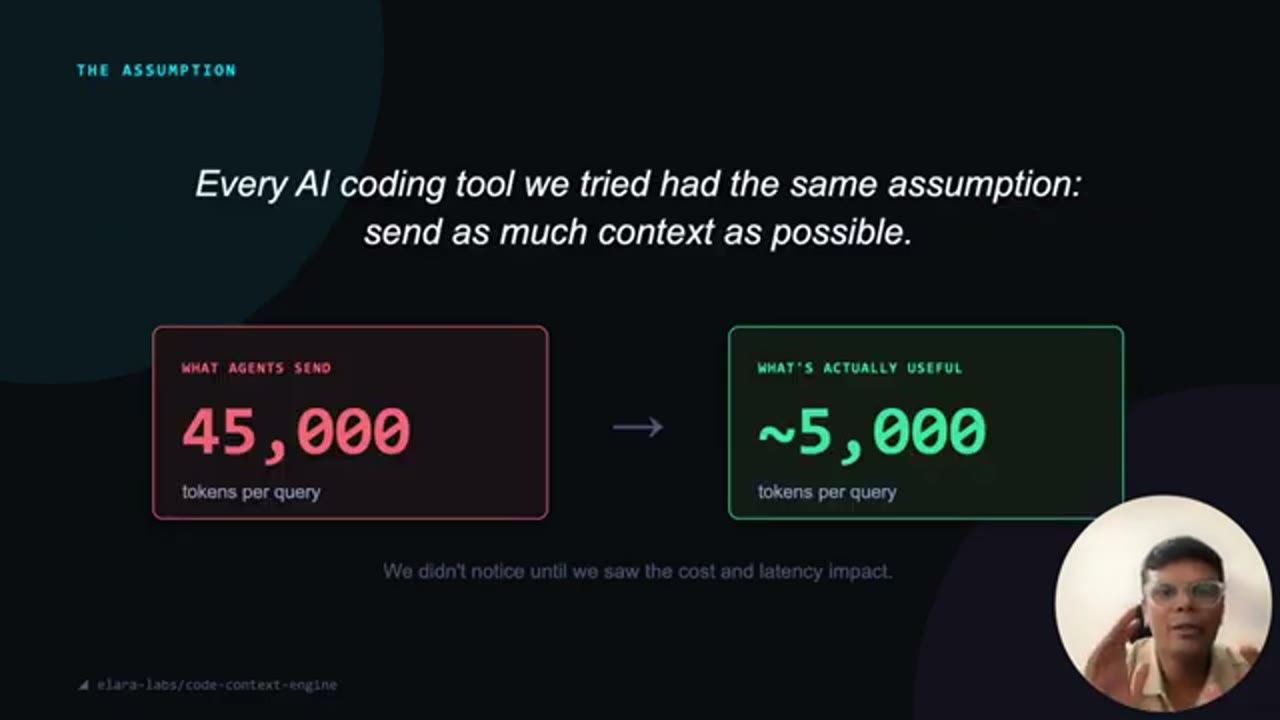
Theo Raj, mọi AI coding tool đều làm cùng một việc: gửi code của bạn lên model làm context, và tool nào cũng mặc định rằng càng nhiều context càng tốt. Nhóm đo một query điển hình trên project của mình. Tool gửi đi 45.000 token context, nhưng phần thật sự có ý nghĩa chỉ khoảng 5.000 token. Bốn mươi nghìn token còn lại vô dụng, vậy mà họ trả tiền cho chúng ở từng query một.
Anh so sánh: giống như gọi một chiếc pizza, nhưng lần nào cũng trả tiền thêm chín chiếc pizza mà bạn không ăn.
3. Ba cách đã thử trước khi tìm ra cách đúng
Trước khi tìm ra cách hiệu quả, nhóm thử ba thứ.
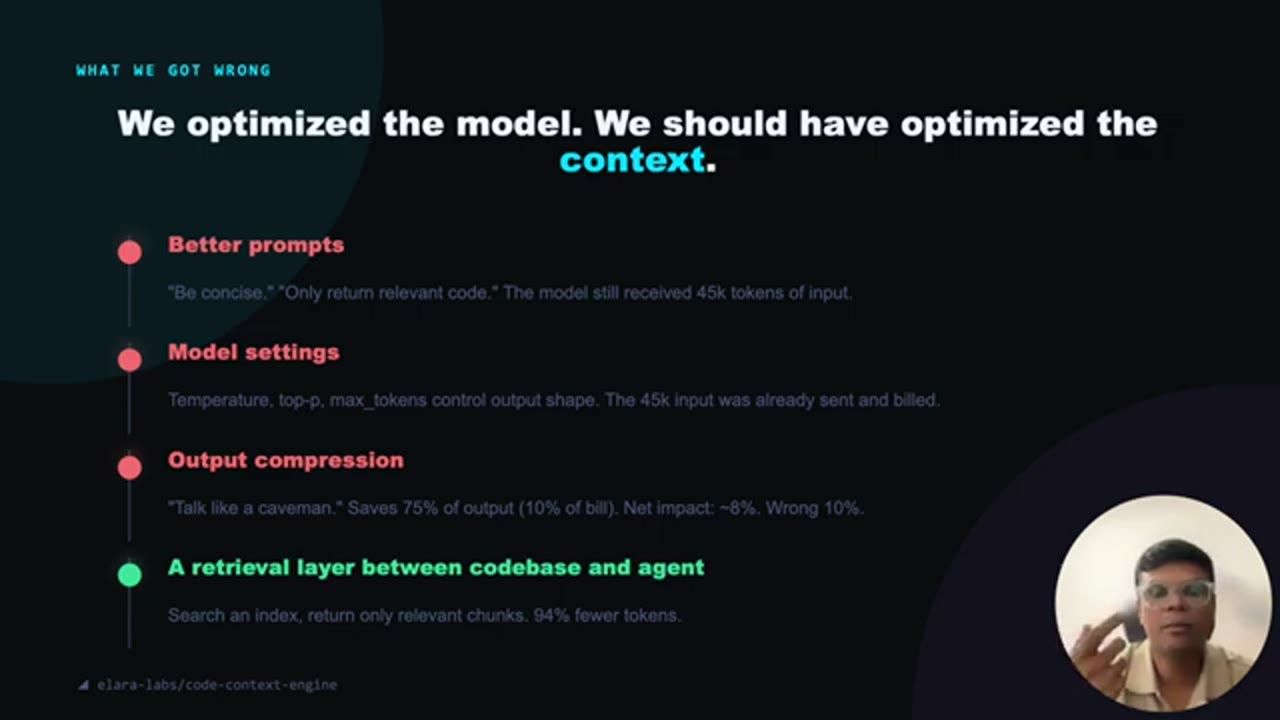
Thứ nhất, sửa prompt. Họ dặn model: hãy ngắn gọn, chỉ đưa ra code liên quan. Nghe thì hay, nhưng không có tác dụng. Model đã nhận đủ 45.000 token trước khi kịp đọc tới prompt. Chi phí đã phát sinh rồi.
Thứ hai, đổi setting của model như max token hay temperature. Cùng một vấn đề: các setting này thay đổi output, không thay đổi input. Mà tiền thì nằm ở input.
Thứ ba, output compression. Cách này thật sự có tác dụng. Họ bảo model viết câu trả lời ngắn lại, và output giảm được 75%. Nhưng output chỉ chiếm khoảng 10% chi phí. Bảy mươi lăm phần trăm của một con số nhỏ thì vẫn là một con số nhỏ, không đủ. Kết luận của nhóm: phải sửa input.
4. Slide quan trọng nhất: 90% chi phí là input
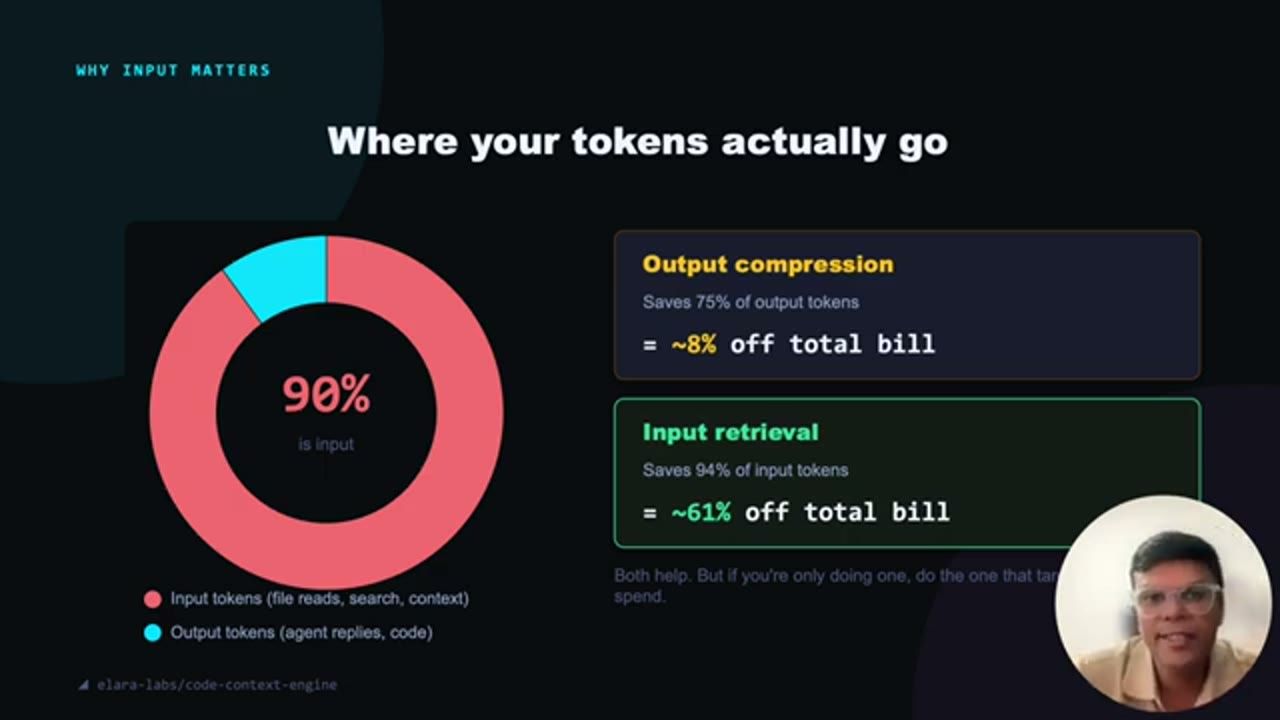
Raj gọi đây là slide quan trọng nhất của talk. Chín mươi phần trăm chi phí AI của bạn là input: file, kết quả search, context bạn gửi vào. Chỉ mười phần trăm là output, tức phần code AI viết trả lại.
Vậy nếu cắt output đi 75%, bạn tiết kiệm được khoảng 8% tổng chi phí. Còn nếu cắt input đi 94%, theo slide bạn tiết kiệm được khoảng 61% tổng. Cùng một phép tính, nhưng kết quả khác hẳn. Thông điệp của anh: hãy sửa input, vì đó là chỗ tiền của bạn đang chảy đi.
Với tỉ lệ 90/10 trên slide, giảm 75% output cho ra 7,5% tổng (khớp "khoảng 8%"); còn phép nhân thẳng 90% × 94% cho ra khoảng 84,6%, trong khi slide ghi khoảng 61%.
5. Một local search layer, năm bước
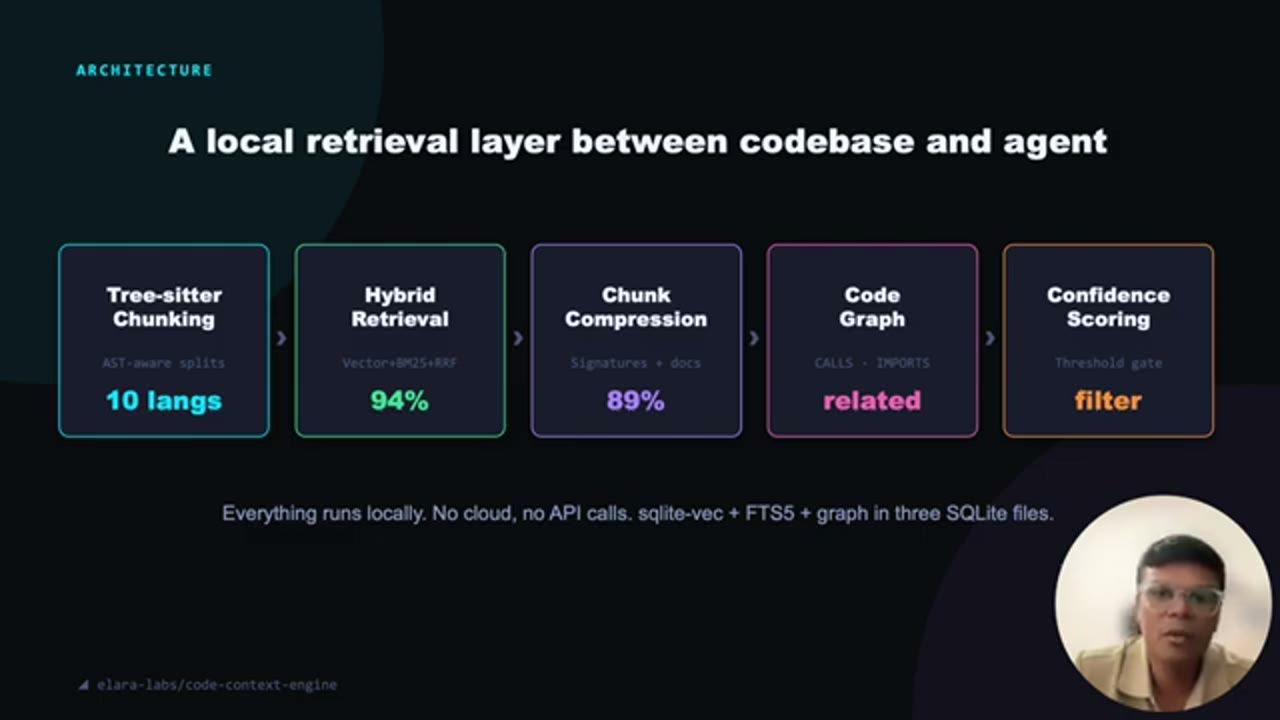
Thứ nhóm build là một local search layer. Nó nằm giữa codebase của bạn và AI. Thay vì gửi nguyên cả file, AI search trong một index và chỉ nhận về đúng mẩu code nhỏ nó cần. Cách hoạt động gồm năm bước.
Bước một: đọc code và chia thành các mẩu nhỏ: function, class, method. Không phải các chunk cắt ngẫu nhiên theo số dòng, mà là những mẩu có nghĩa trọn vẹn. Slide ghi rõ phần này dùng Tree-sitter để cắt theo cấu trúc AST, hỗ trợ 10 ngôn ngữ.
Bước hai: chạy hai search cùng lúc. Một search tìm code theo ý nghĩa, một search tìm code theo đúng từ khoá, rồi gộp kết quả lại. Raj nói đây là chỗ tạo ra phần tiết kiệm lớn.
Bước ba: có thể thu nhỏ kết quả hơn nữa. Chỉ giữ tên function và phần mô tả, cắt một function 50 dòng xuống còn 5 dòng.
Bước bốn: theo dõi các mối liên kết, function nào gọi function nào. Nhờ vậy khi tìm được một mẩu code, bạn có thể tìm ra mọi thứ nối với nó.
Bước năm: mỗi kết quả đều được chấm điểm. Điểm quá thấp thì không gửi đi. Không có context tồi.
Tất cả chạy trên máy của bạn, không có gì đi lên cloud. Raj gọi đó là cái hay nhất của thiết kế này. (Nói chính xác: việc index và search diễn ra cục bộ; mẩu code đã chọn thì vẫn được coding tool gửi lên model như bình thường, chỉ là ít hơn nhiều.)
6. Vì sao chạy hai search thay vì một
Tại sao lại chạy hai search? Vì mỗi loại có một điểm yếu riêng.
Search theo ý nghĩa (semantic search) giỏi tìm các ý tưởng liên quan, nhưng hay trượt tên chính xác. Bạn tìm function authenticate user, nó có thể đưa ra một function auth khác, chỉ vì hai cái có nghĩa gần nhau.
Search theo từ (keyword search) giỏi bắt đúng tên, nhưng lại bỏ sót các ý tưởng liên quan. Bạn tìm "login flow", nó bỏ qua mọi đoạn code gọi là "sign in".
Đứng riêng, mỗi loại search bỏ sót khoảng một trên bốn kết quả. Gộp lại, chúng chỉ bỏ sót khoảng một trên mười. Hai cái vá điểm mù cho nhau.
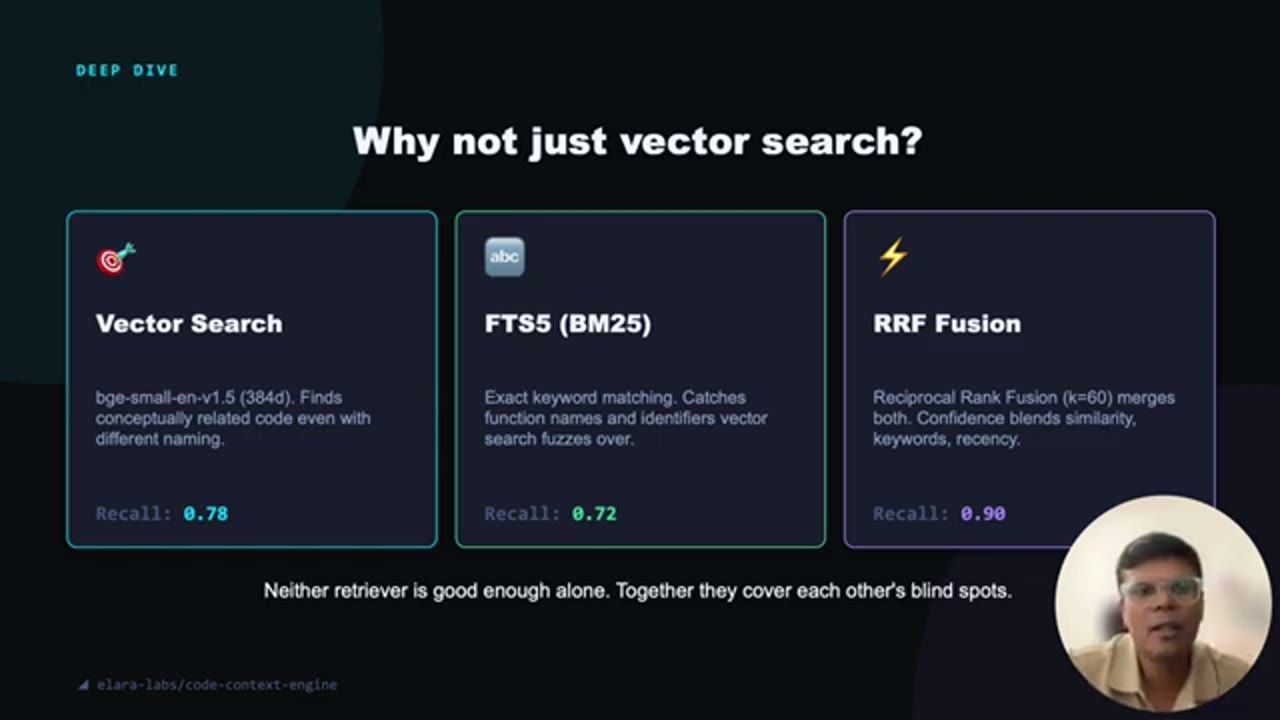
Reciprocal Rank Fusion là cách gộp hai danh sách xếp hạng đơn giản: mỗi kết quả được cộng điểm theo nghịch đảo thứ hạng của nó trong từng danh sách (thường dạng 1/(k + thứ hạng)), nên một mẩu code đứng cao ở cả hai danh sách sẽ nổi lên đầu mà không cần chuẩn hoá điểm của hai loại search về cùng thang. Phần keyword chạy trên SQLite FTS5, phần vector chạy trên sqlite-vec, embedding model là BAAI/bge-small-en-v1.5.
7. Phần khó nhất: biết khi nào retrieval sai
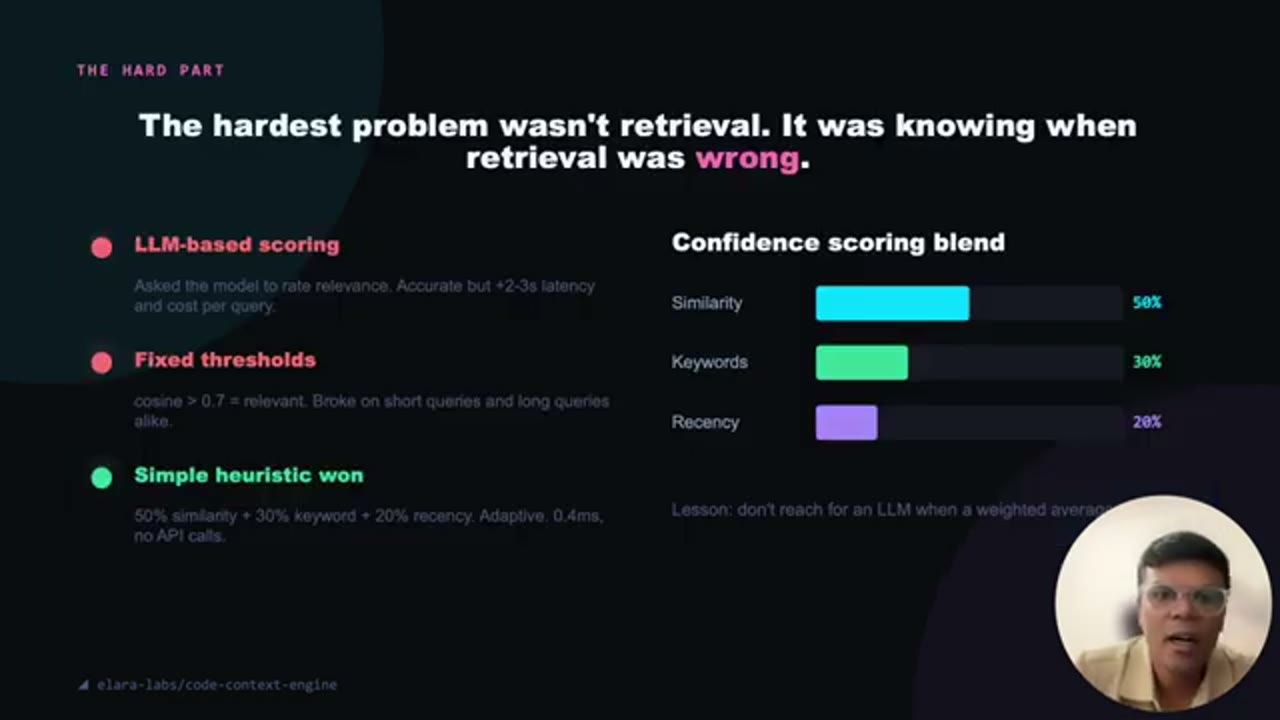
Đây là phần khó mà Raj và Faz tốn nhiều thời gian nhất. Search tìm ra kết quả, nhưng kết quả đó có thật sự liên quan không? Có lúc search trả về mười kết quả và không cái nào đúng. Nếu AI dùng kết quả tồi, nó sẽ đưa ra một câu trả lời sai mà rất tự tin. Thứ đó còn tệ hơn là không có câu trả lời nào (anh bật cười khi nói câu này).
Lần đầu, nhóm thử nhờ AI tự chấm kết quả của chính nó. Quá chậm: mỗi lần thêm hai, ba giây. Lần hai, nhóm thử một ngưỡng điểm cố định. Quá đơn giản: câu hỏi ngắn bị chấm điểm thấp ngay cả khi khớp hoàn hảo.
Cách hiệu quả hoá ra là một công thức đơn giản: 50% điểm theo ý nghĩa, 30% điểm keyword, 20% độ mới của code. Ngưỡng thì tự điều chỉnh theo chính bộ kết quả hiện tại. Nó chạy trong khoảng 0,4 mili giây, không cần thêm lần gọi AI nào.
Bài học nhóm rút ra: phần lớn trường hợp, một công thức đơn giản thắng một model phức tạp.
confidence = 0.50 × similarity + 0.30 × keyword + 0.20 × recency
(adaptive threshold: không dùng một mức cố định cho mọi câu hỏi)
8. Benchmark trên FastAPI: con số thật, ai cũng chạy lại được
"Chúng tôi cần con số, không chỉ câu chuyện", Raj nói, và đây là số của nhóm. Họ test trên một project mã nguồn mở có thật, FastAPI: 53 file, 20 câu hỏi thật mà một developer sẽ hỏi.
- Không dùng tool của nhóm: khoảng 83K token mỗi câu hỏi.
- Dùng tool: khoảng 4,9K token mỗi câu hỏi. Tức là ít hơn 94%.
- Bật thêm compression bên trên: 523 token mỗi câu hỏi.
Và độ chính xác vẫn giữ được: tool vẫn tìm ra đúng code ở 90% trường hợp. Raj khẳng định các con số này là thật, bài test công khai, bạn có thể tự chạy lại, lệnh nằm ngay trên màn hình.
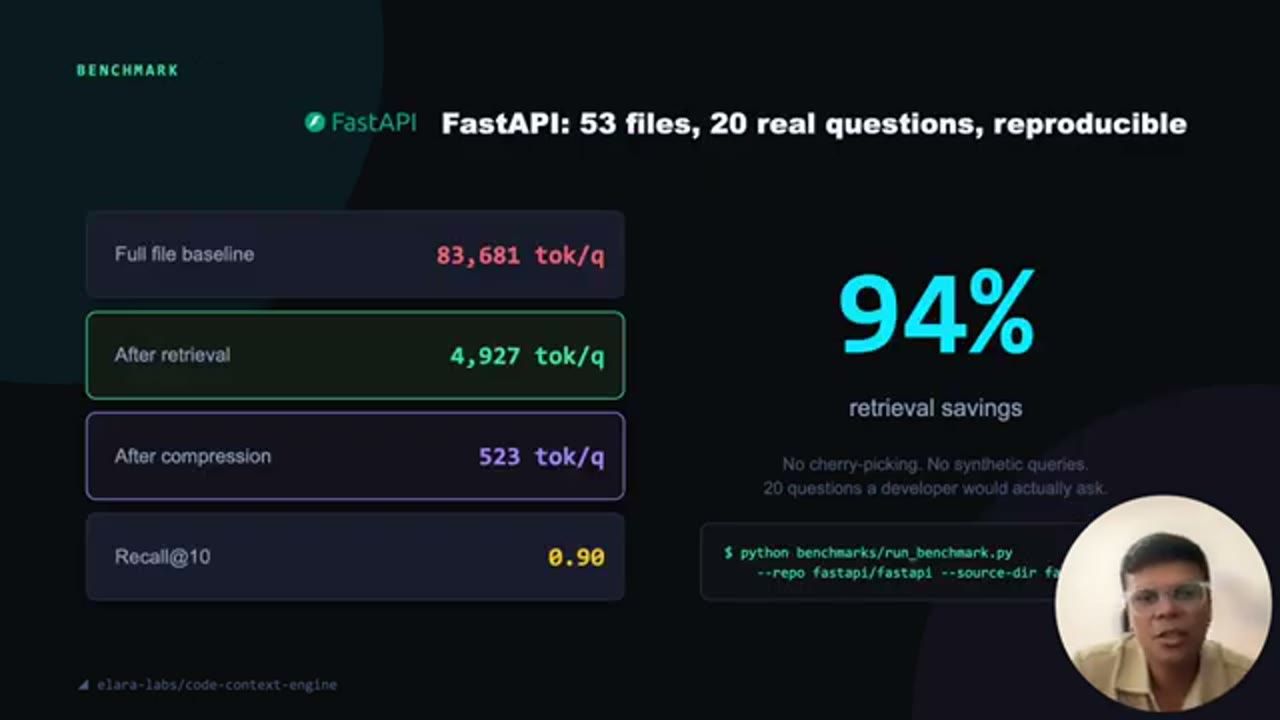
Lệnh chạy lại benchmark, theo README của repo:
python benchmarks/run_benchmark.py --repo https://github.com/fastapi/fastapi.git --source-dir fastapi
Khi đọc bảng kết quả FastAPI, cần hiểu đúng "90%": đó là Recall@10, tức tỉ lệ các file cần tìm có mặt trong mười chunk lấy về, không phải tỉ lệ câu trả lời hay code sinh ra là đúng. Cùng bảng đó còn ghi Precision@10 là 0,24 và latency p50 là 0,4 ms.
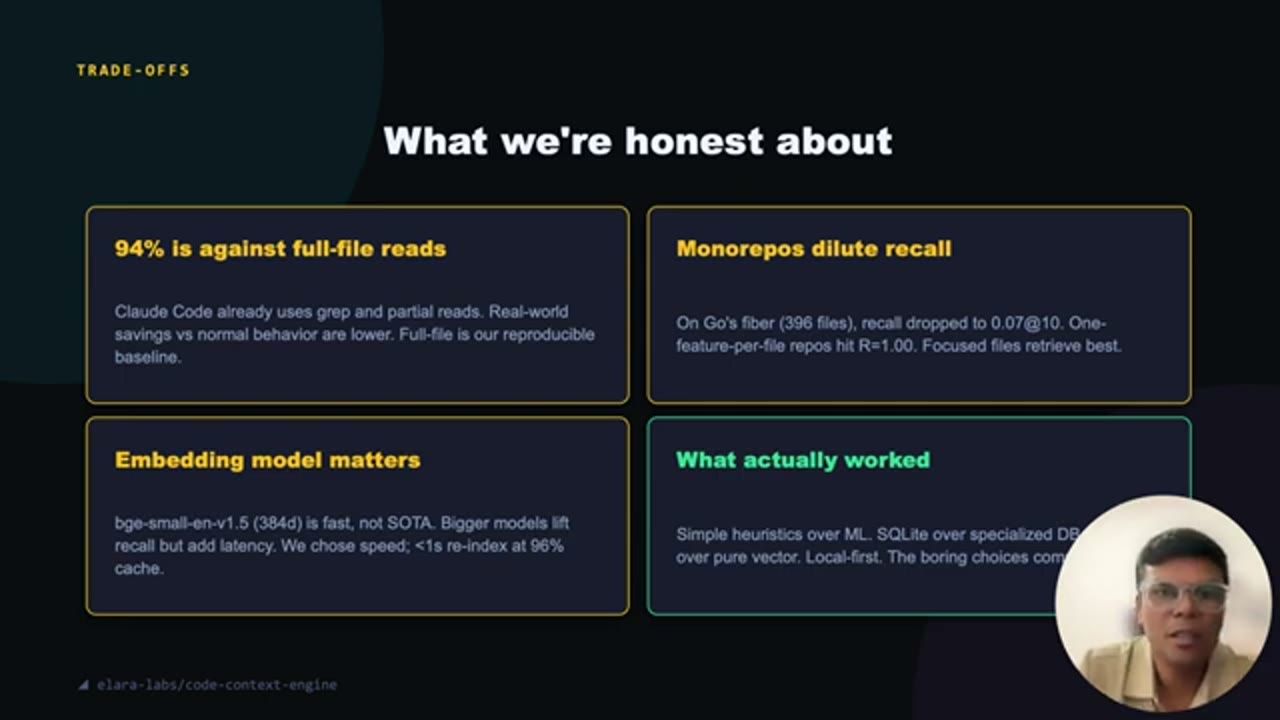
9. Thẳng thắn về giới hạn
Raj muốn nói thật về các giới hạn.
Con số 94% là trường hợp xấu nhất làm mốc: đọc nguyên file mỗi lần. Ngoài đời, các tool như Claude Code đã thông minh hơn thế. Mức tiết kiệm thật sẽ thấp hơn 94%. Nhóm dùng mốc full-file vì đó là mốc duy nhất đo được theo cùng một cách ở mọi lần.
Codebase lớn và lẫn lộn thì khó. Nhóm test trên một sản phẩm lớn hơn với 396 file, và recall tụt xuống gần như bằng không. Nếu mỗi file của bạn chỉ làm một việc, tool chạy tốt. Nếu mỗi file làm nhiều việc, nó gặp khó.
Embedding model. Nhóm dùng một model nhỏ và nhanh cho search. Nó nhanh, re-index mất chưa tới một giây. Một model lớn hơn sẽ tìm được nhiều hơn, nhưng nhóm chọn tốc độ thay vì sự hoàn hảo.
Những lựa chọn đơn giản thắng lựa chọn phức tạp: database nhỏ thay vì hạ tầng lớn, hai search thay vì một search cầu kỳ, local thay vì cloud. Đơn giản.
10. Một index chung cho mọi tool, cộng memory
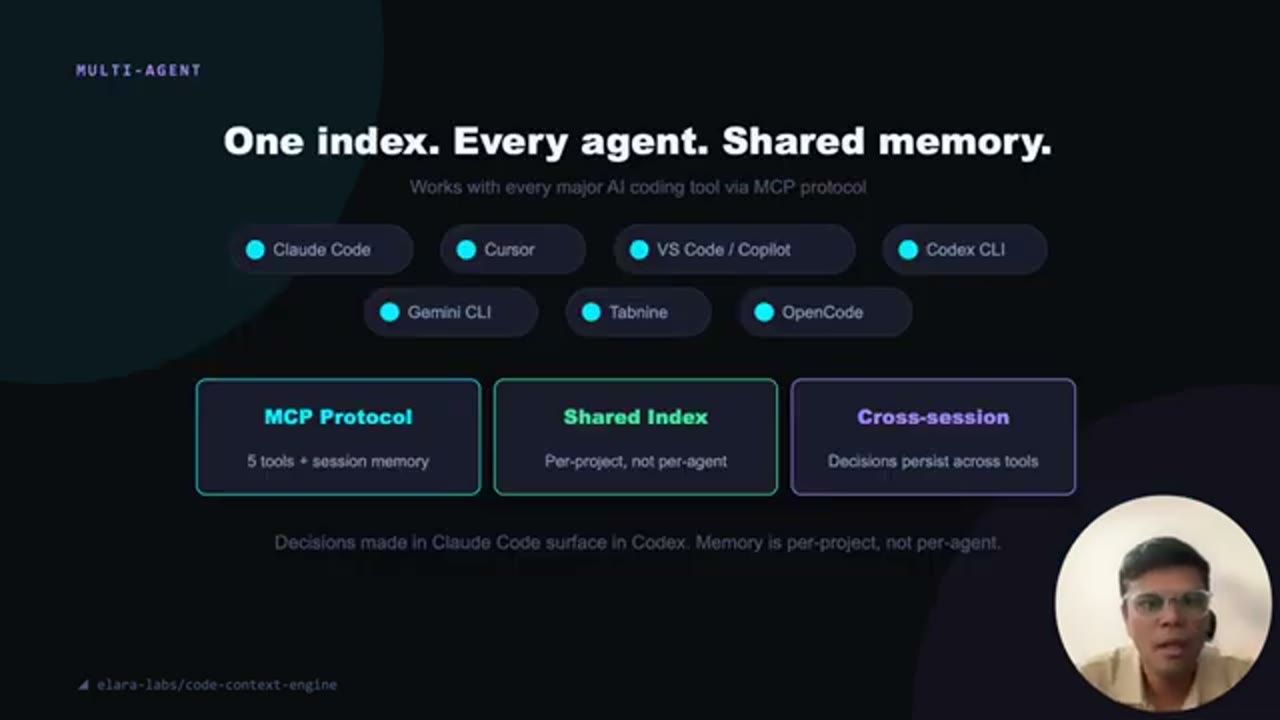
Có một điều Faz chỉ ra từ sớm. Nhóm dùng nhiều tool: Claude Code cho các vấn đề khó, Cursor cho các chỉnh sửa nhanh, Copilot cho các completion nhỏ. Mỗi tool bắt đầu lại từ đầu mỗi lần. Chúng không chia sẻ gì với nhau. Bạn giải thích cùng một codebase cho ba AI khác nhau.
Vì vậy nhóm build một index dùng chung, mọi tool của bạn đều kết nối vào đó. Cùng một search, cùng một kết quả cho tất cả. Họ còn thêm memory: khi một tool học được điều gì đó về project, kiến thức đó ở lại. Phiên sau, dù là tool khác, cùng project, context đã có sẵn. Giải thích codebase một lần, tool nào cũng nhớ.
11. Báo cáo tiết kiệm trên một project thật
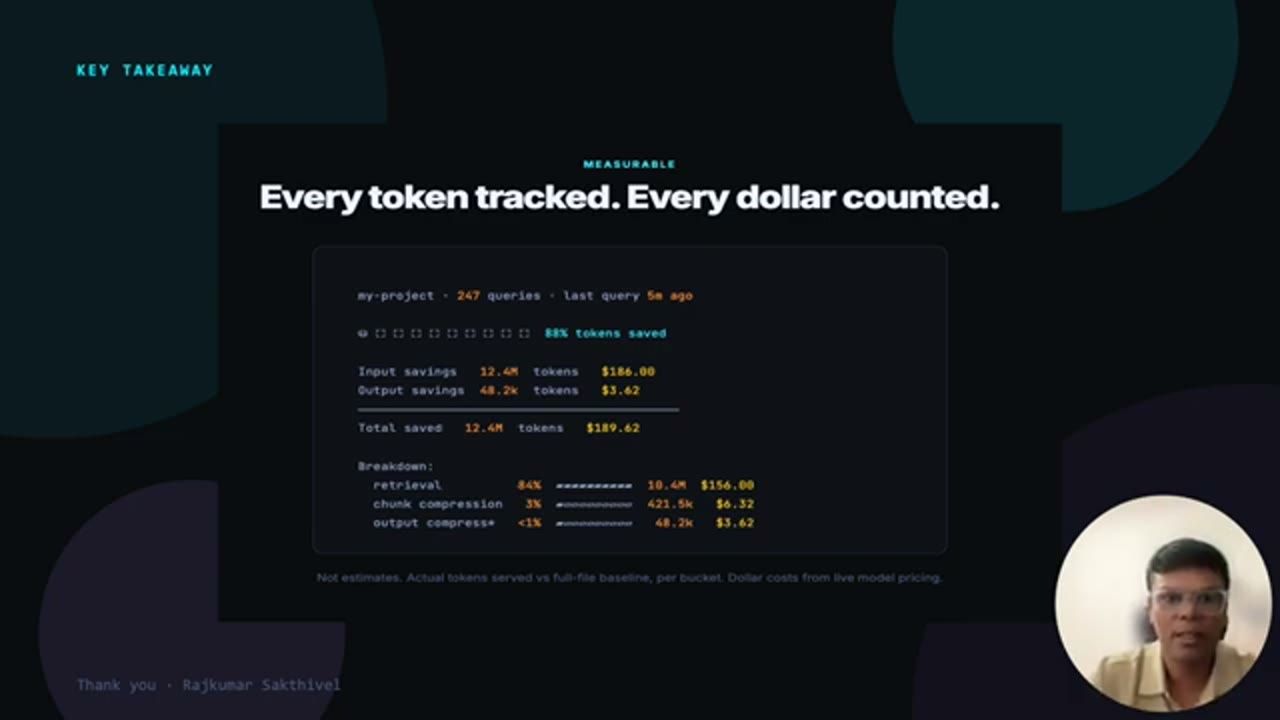
Đây là báo cáo tiết kiệm trên một project thật: 247 query, 12,4 triệu token tiết kiệm được, gần 186 đô la không phải chi. Phần lớn tiết kiệm, 84%, đến từ search layer. Phần còn lại đến từ compression.
Raj nhấn mạnh đây không phải ước lượng. Tool theo dõi từng query: nó so thứ lẽ ra sẽ bị gửi đi với thứ thực sự được gửi đi, rồi nhân phần chênh với giá của model. Lời mời của anh: chạy nó trên project của bạn một tuần, rồi xem con số của chính bạn.
12. Câu trả lời không phải model tốt hơn, mà là gửi ít hơn
Raj và Faz build thứ này vì họ có một hoá đơn khổng lồ và không có câu trả lời nào tốt. Câu trả lời hoá ra không phải là một model tốt hơn. Câu trả lời là gửi ít hơn.
Mọi người cãi nhau xem model nào tốt nhất, Opus hay Sonnet. Nhưng theo anh, model có lẽ chỉ chiếm khoảng 30% chi phí; 70% còn lại là thứ bạn đưa vào nó. Hãy sửa input. Lựa chọn model ít quan trọng hơn bạn nghĩ.
Tool tên là CCE (Code Context Engine), miễn phí, mã nguồn mở, có QR code trên màn hình. Chỉ một lệnh để thử. "Hãy thử, xem con số, rồi kể cho chúng tôi bạn tiết kiệm được bao nhiêu. Cảm ơn. Happy coding."
uvx --from "code-context-engine[local]" cce init
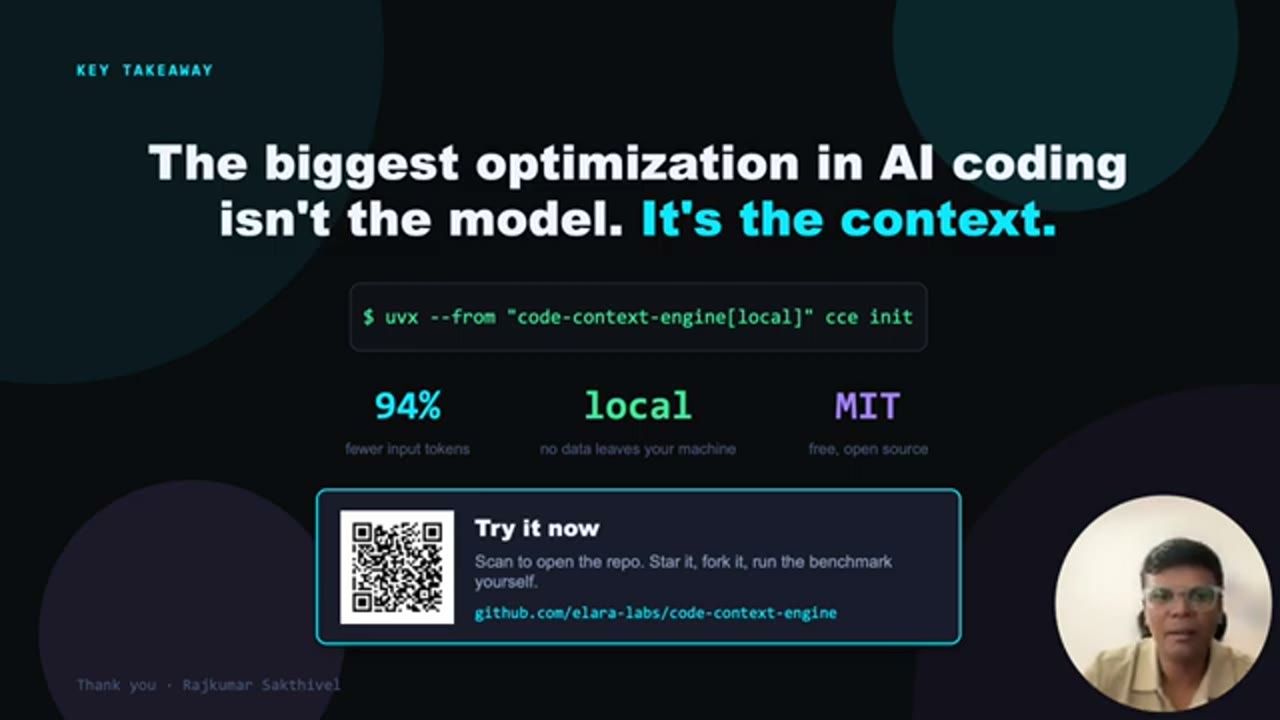
Theo README, lệnh trên vừa cài, vừa index project, vừa cấu hình cho coding tool trong một lần chạy; uvx tải CCE khi cần nên không phải cài sẵn package Python. Package cũng có trên PyPI.
Nguồn và link
- Code Context Engine (CCE) trên GitHub, repo mã nguồn mở, license MIT
- code-context-engine trên PyPI
- Kết quả benchmark FastAPI và script run_benchmark.py
- Kết quả benchmark trên fiber (Go, 396 file)
- Tree-sitter, SQLite FTS5, sqlite-vec, bge-small-en-v1.5
- Model Context Protocol (MCP)
- Rajkumar Sakthivel: X, GitHub, LinkedIn: linkedin.com/in/rajkumar-sakthivel
Related talks
A Genius With Amnesia
Victor Savkin · Nx · 20 min
Agent bị giới hạn trong một repo và quên mọi session cũ; Polygraph gỡ cả hai bằng synthetic monorepo và trace dùng chung giữa các agent.
Browser Agents Don't Need Better Models. They Need Better Eyes.
Kushan Raj · Sarvam AI · 4 min
Browser agent chậm và hay kẹt vì nhìn trang quá tệ: một bản markdown cả trang (~1.800 token) cộng feedback sau mỗi click giúp model rẻ chạy nhanh và đúng.
Structuring the Unstructured: Advanced Document Parsing for AI Workflows
Cedric Clyburn · Red Hat · 21 min
Biến PDF, bảng, hình ảnh thành Markdown/JSON cho RAG và agent bằng Docling: chạy local trên CPU, chunkless RAG, Docling Serve và MCP server.