Vì sao ít ai nói về model này của Google?
Matt Wolfe so Fable 5.1 với Gemini 3.8 Flash qua benchmark, chi phí mỗi task và test riêng, rồi nói về Astra và recurrent depth (video 03/09/2026).
✓ Đã duyệt độc lập · cập nhật 19/11/2026 · 26 min
1. Một tuần nhiều model mới, và nỗi bực của Matt
Matt Wolfe mở đầu: tuần này có cả loạt thông báo về model mới. Anh nghĩ một số model đã được thổi phồng quá mức, một số lại bị nói tới quá ít, và có vài điều anh thật sự chưa thấy ai khác bàn tới. Anh muốn điểm lại những gì ra mắt trong tuần và chia sẻ nhanh vài suy nghĩ về các model mới này. Anh cũng đã chạy thử chúng và sẽ cho xem một số kết quả sau vài phút nữa (video đăng ngày 03/09/2026).
Theo Matt, tuần đó có hai model mới của Anthropic, các model mới của Google DeepMind, và từ OpenAI thì có "thông báo về một thông báo sắp tới", về model Astra sắp ra của họ (video đăng ngày 03/09/2026).
Anh nói sẽ nói một điều mà có lẽ anh sẽ bị chê vì nói ra: anh thật ra đang hơi bực với tất cả những lần ra mắt model này. Tốc độ ra model mới chưa hề chậm lại, nhưng đồng thời anh cũng có cảm giác là cuộc sống của chúng ta không thật sự thay đổi nhiều mỗi lần một model mới ra. Theo Matt, người dùng ChatGPT hay Claude bình thường đã có những model khá ổn từ lâu, kiểu làm được đúng những gì phần lớn mọi người muốn chúng làm. Phần lớn những bước nhảy lớn ta đang thấy nằm ở các mảng như toán, khoa học và năng lực coding (nhận định của Matt, video đăng ngày 03/09/2026).
Vì thế anh cảm thấy những người đang chịu tác động nhiều nhất và thật sự cảm nhận rõ nhất là dân coder. Nhưng ngay cả với coding, theo anh, các model này cũng đã khá tốt từ lâu; giờ chúng chỉ kiểu như làm cho việc đi tới kết quả cuối cần ít prompt hơn một chút. Dù anh luôn có cảm giác đây không còn là những bước nhảy lớn nhất thế giới nữa, anh liên tục thấy nội dung trên mạng nói rằng thứ này thay đổi mọi thứ, và với anh nó giống một cỗ máy hype khổng lồ (video đăng ngày 03/09/2026).
Nên anh muốn thật sự đi sâu vào vài model này và nói một chút về chuyện gì đang diễn ra với chúng.
2. Fable 5.1 và các benchmark Anthropic chọn để khoe
Matt bắt đầu với Fable 5.1. Theo anh, đúng là Mythos 5.1 cũng đã ra, nhưng chỉ dành cho một nhóm rất nhỏ, kiểu các công ty phòng thủ an ninh mạng hay đại loại vậy. Fable 5.1 là model mà nếu bạn đang ở một gói trả phí của Anthropic thì giờ bạn đã được dùng (video đăng ngày 03/09/2026).
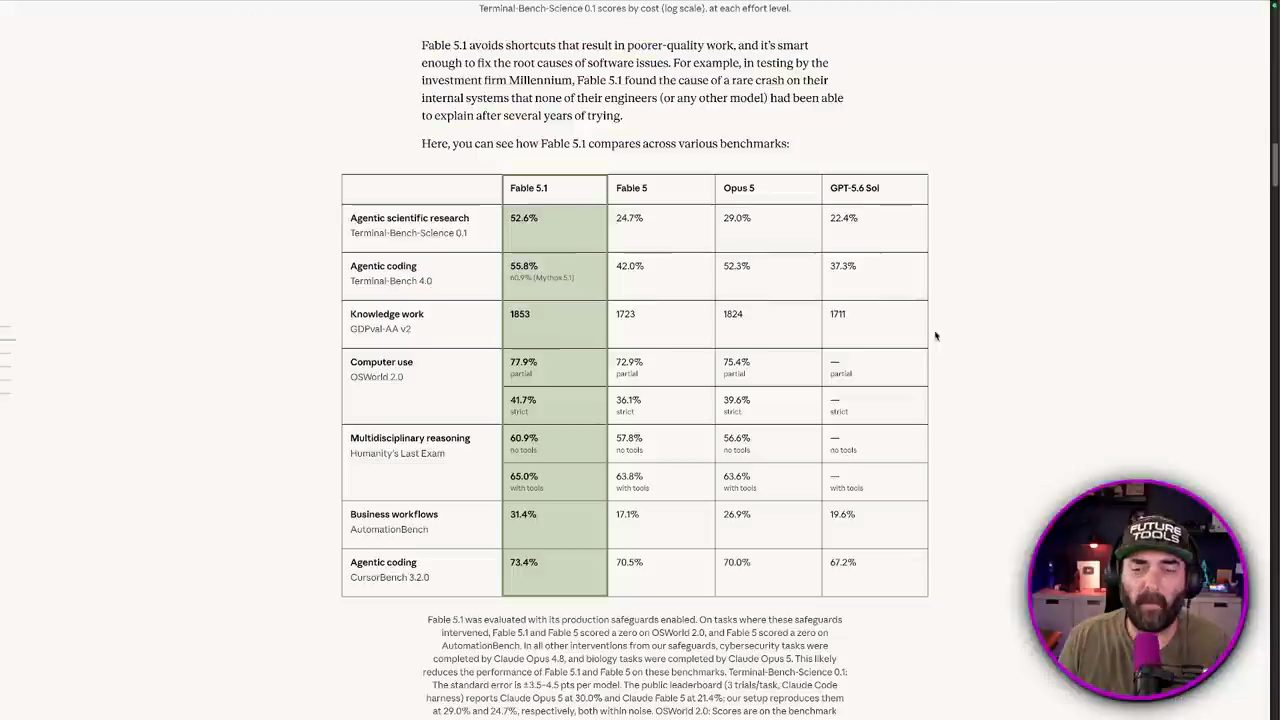
Kéo xuống phần benchmark của Fable 5.1, Matt nhận xét Anthropic đã chọn lọc một nhóm benchmark để khoe, cụ thể là những benchmark mà model mới nhảy vọt so với kết quả của GPT-5.6 Sol (nhận định của Matt, video đăng ngày 03/09/2026).
Theo anh, với agentic scientific research, model mới gần như gấp đôi mọi model đi trước. Với agentic coding, đó gần như là một bước nhảy lớn so với GPT-5.6 Sol. Với knowledge work, đó là một bước khá lớn, không phải khổng lồ, nhưng khá lớn so với GPT-5.6 Sol. Và anh cho rằng trên những benchmark họ tự chọn, họ đã chọn những cái khiến GPT-5.6 Sol trông yếu khi đặt cạnh (video đăng ngày 03/09/2026).
3. Ít can thiệp hơn, và cơ chế chống distillation
Một điểm cần lưu ý về Fable 5.1, theo Matt, là model này được cho là sẽ từ chối ít thứ hơn. Trước bản này, với khá nhiều prompt, chúng bị từ chối và bị đẩy xuống model Opus tốt nhất đang có, và Fable 5 thì sẽ từ chối chúng (lời Matt, video đăng ngày 03/09/2026).
Anh đọc đoạn trong bài ra mắt: với Fable 5.1, Anthropic cập nhật các safeguard về cybersecurity cho chính xác hơn, và giờ cho phép dùng Fable 5.1 để tìm lỗ hổng phần mềm. Bài viết ghi rằng người dùng Claude Code có thể kỳ vọng trung bình khoảng 60% ít lần can thiệp hơn mỗi phiên từ các safeguard cyber, so với safeguard trước đó trên Fable 5. Tuy vậy, các safeguard vẫn chuyển hướng vài loại task cybersecurity lưỡng dụng sang các model Opus (theo bài ra mắt của Anthropic mà Matt đọc trong video đăng ngày 03/09/2026).
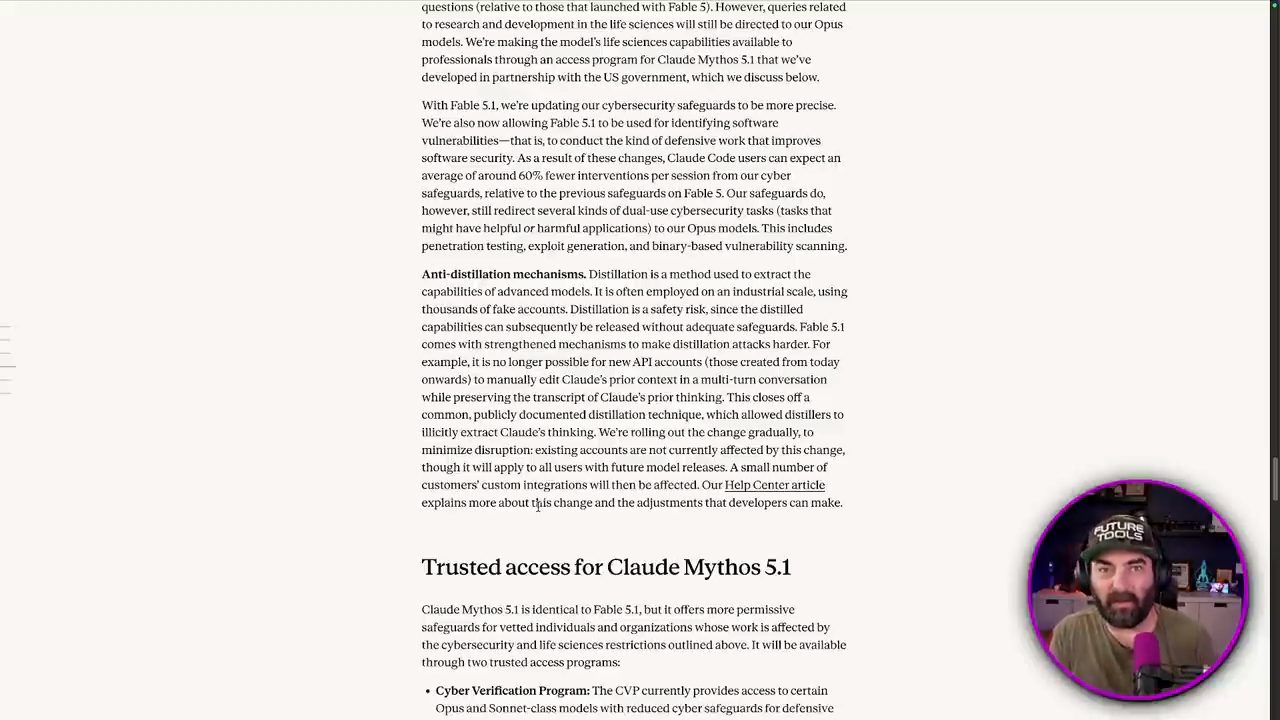
Anthropic cũng dựng các cơ chế chống distillation. Matt giải thích: nếu bạn chưa quen với distillation, về cơ bản đó là dùng một model lớn làm thầy để train một model mới hơn theo cách mà model lớn kia lẽ ra sẽ làm. Anh nói đó là cách nói đơn giản hóa quá mức, nhưng nó giống như dùng một model đang có để train một model khác. Model đang có là model thầy, còn model mới giống model học trò, lấy prompt và output của model thầy để train ra model mới. Anh nhắc lại đó là đơn giản hóa, nhưng về cơ bản distillation là như vậy (video đăng ngày 03/09/2026).
Theo Matt, Anthropic đang làm cho việc đó khó hơn. Bài viết ghi, ví dụ, các tài khoản API mới (tạo từ hôm đó trở đi) không còn có thể tự sửa context trước đó của Claude trong một cuộc hội thoại nhiều lượt mà vẫn giữ lại phần suy nghĩ trước đó của Claude. Matt nói họ làm vậy để ngăn việc trích xuất phần suy nghĩ của Claude rồi dùng nó để train model mới (theo bài ra mắt mà Matt đọc, video đăng ngày 03/09/2026).
Anh nói đã có nhiều lời bàn rằng các model ra từ Trung Quốc đang distill model của Anthropic và OpenAI để train model của mình, và đó là cách chúng giỏi lên nhanh như vậy; về cơ bản, các model mới đang chép bài tập về nhà của các model ở frontier lab đi trước (lời Matt, video đăng ngày 03/09/2026).
Và theo anh, đúng là có một chút đạo đức giả ở đây, khi nghĩ tới việc các model của Anthropic, OpenAI và gần như mọi model của frontier lab đã được train bằng cách cào mọi thứ trên internet về làm dữ liệu train. Họ đã chép bài của mọi người khác để làm ra model, và giờ họ lại nói: bạn không được chép bài của chúng tôi để làm model của bạn (nhận định của Matt, video đăng ngày 03/09/2026).
4. Giá của Fable 5.1
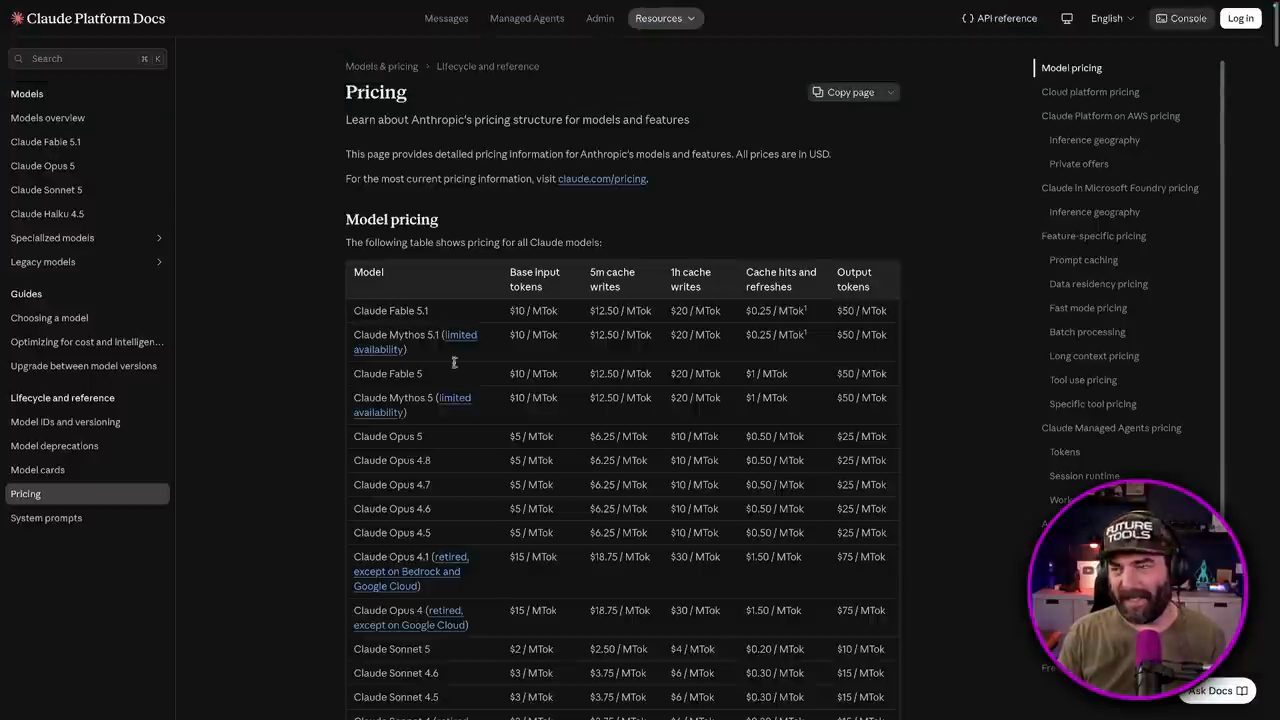
Về giá, Matt đọc rằng Anthropic tuyên bố Fable 5.1 sẽ tốn ước tính ít hơn 25% so với Fable 5 cho các workload điển hình. Anthropic nói điều đó là do họ hạ giá cache read. Anh giải thích, về cơ bản đó là khi model đọc những input đã được xử lý và lưu lại; nó không phải xử lý lại những input đó, nên xử lý chúng rẻ hơn nhiều (theo bài ra mắt mà Matt đọc, video đăng ngày 03/09/2026).
Còn giá thật, theo Matt, Anthropic giữ giá Fable 5.1 bằng đúng giá Fable 5: cả hai đều 10 đô mỗi triệu token input và 50 đô mỗi triệu token output. Anh nói vẫn rất đắt, nhưng giá không tăng với model mới, thông minh hơn (video đăng ngày 03/09/2026).
Matt nói thêm, đây không phải một model train mới hoàn toàn với bộ weight nền mới. Nó vẫn kiểu như Fable 5 được làm thêm post-training. Theo anh, Anthropic làm thêm reinforcement learning và những thứ tương tự để cố cải thiện nó và để nó từ chối ít hơn những việc cybersecurity như trên (video đăng ngày 03/09/2026).
5. Hai benchmark Matt hay xem
Matt nói có hai benchmark anh thích để ý nhất. Thứ nhất là DeepSWE, vì theo anh DeepSWE là benchmark software engineering có kiểu tương quan lớn nhất giữa cảm giác khi bạn code với một model và điều benchmark cho thấy: model càng làm tốt trên DeepSWE thì thường có vẻ càng làm tốt ở các project coding (nhận định của Matt, video đăng ngày 03/09/2026).
Benchmark thứ hai anh thích xem là Artificial Analysis, vì theo anh nó giống kiểu một benchmark "model nào khách quan là thông minh nhất lúc này": nó lấy cả loạt benchmark khác, gộp lại và đặt trọng số khác nhau cho từng benchmark để xác định model nào là tốt nhất về tổng thể ở thời điểm đó (lời Matt, video đăng ngày 03/09/2026).
Đáng tiếc là tại thời điểm Matt quay, Fable 5.1 chưa xuất hiện trên DeepSWE. Có vẻ benchmark đó chưa được chạy cho nó, nên chưa thể xem được. Nhưng có thể xem Artificial Analysis (video đăng ngày 03/09/2026).
Theo Matt, Artificial Analysis cho thấy Claude Fable 5.1 gần như là model thông minh nhất đang có lúc đó: nó được 66, trong khi mức tốt nhất trước đó là Claude Opus 5 với 63. Anh cho rằng một bước nhảy ba điểm thật ra khá lớn: đó là khoảng cách giữa GLM 5.3 và Claude Opus 5, một bước ba điểm. Nên xét trong bức tranh lớn, theo anh đó là một bước nhảy khá đáng kể giữa hai model này (số trên Artificial Analysis theo video đăng ngày 03/09/2026).
6. Chi phí mỗi task trên Artificial Analysis
Matt quay lại một câu Anthropic viết trong bài: Fable 5.1 sẽ tốn ước tính ít hơn 25% so với Fable 5 cho workload điển hình. Nhưng khi quay lại Artificial Analysis, anh chỉ ra một điều mà anh nói đã thấy Matthew Berman cũng nhắc tới: phần chi phí mỗi task (video đăng ngày 03/09/2026).
Xét theo chi phí mỗi task, theo số trên Artificial Analysis mà Matt đọc, Claude Fable 5.1 có chi phí mỗi task đắt nhất. Trung bình tốn khoảng 3,69 đô để hoàn thành một task với Fable 5.1, trong đó 1,48 đô dành cho reasoning. Còn Claude Fable 5 thì khoảng 3,14 đô mỗi task. Anh nhắc lại: Anthropic nói 5.1 sẽ rẻ hơn 25% so với Fable 5 cho workload điển hình, nhưng dữ liệu benchmark thực tế lại cho thấy khác, rằng tính theo task thì 5.1 thật ra đắt hơn (số trên Artificial Analysis theo video đăng ngày 03/09/2026).
Khi xem biểu đồ intelligence index so với chi phí mỗi task, Matt nói ta thấy Claude Fable 5.1 là model thông minh nhất trong danh sách, nhưng vẫn cũng là model đắt nhất trong danh sách (theo Artificial Analysis, video đăng ngày 03/09/2026).
7. Fable 5.1 trên BuseyBench và bản clone Megabonk
Matt nói anh đã test một chút. Anh cho model chạy qua BuseyBench và nó tạo ra một ảnh SVG Gary Busey thật sự khá ổn. Tuy nhiên, theo anh, riêng một ảnh này đã tốn của anh 4,35 đô và mất 18 phút để xử lý (số đo của Matt, video đăng ngày 03/09/2026).
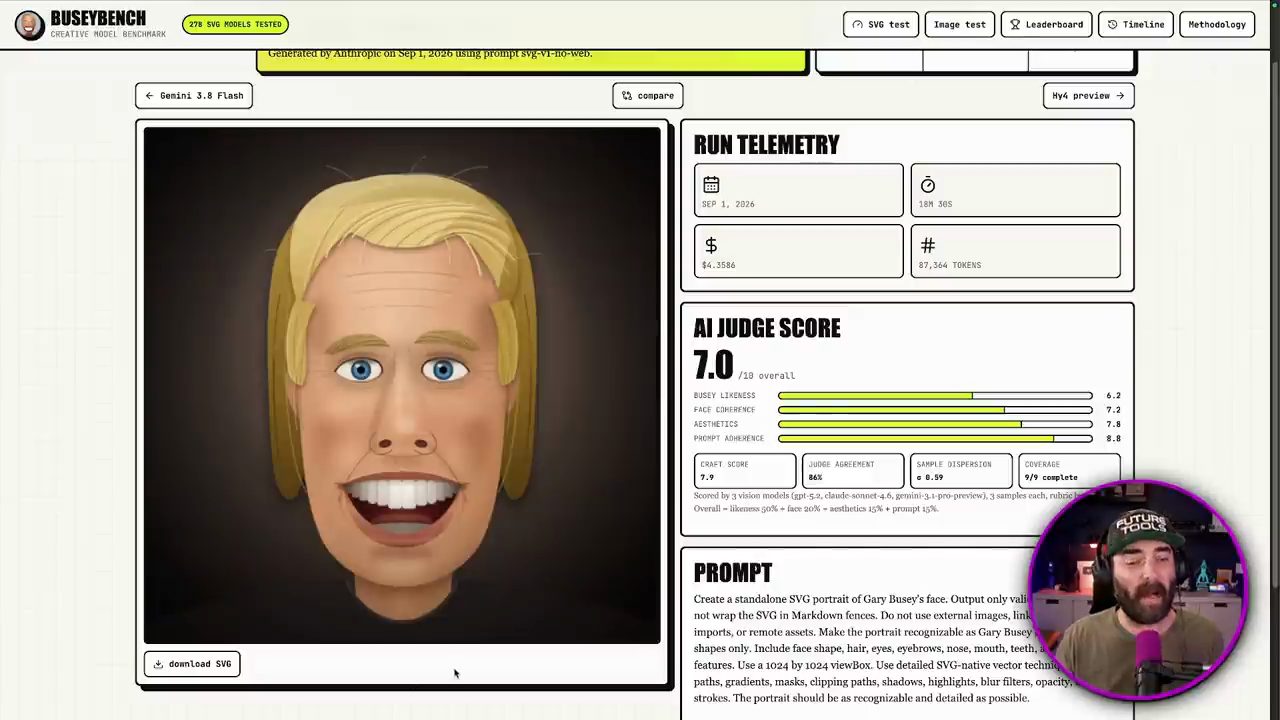
Theo Matt, ảnh đó thắng trên leaderboard: nó đang đứng chắc ở vị trí số một, nơi AI làm giám khảo đã quyết định đây là ảnh Gary Busey tốt nhất. Nhưng anh nói cái giá thì kiểu điên rồ (demo trong video đăng ngày 03/09/2026).
Anh cũng cho model làm một bản clone Megabonk, một bài test vui anh thích làm. Và theo anh, đây chắc chắn là bản clone Megabonk tốt nhất anh từng thấy tính tới lúc đó, kể cả việc nó làm ra cả loạt nhân vật mà bạn có thể thật sự gặp trong Megabonk. Nó có một shop khá ổn, một loạt settings, có phần records, có phần controls; anh nói nhìn rất đẹp. Game có cả âm thanh, nhưng anh tắt tiếng tab này vì âm thanh khá khó chịu (demo trong video đăng ngày 03/09/2026).
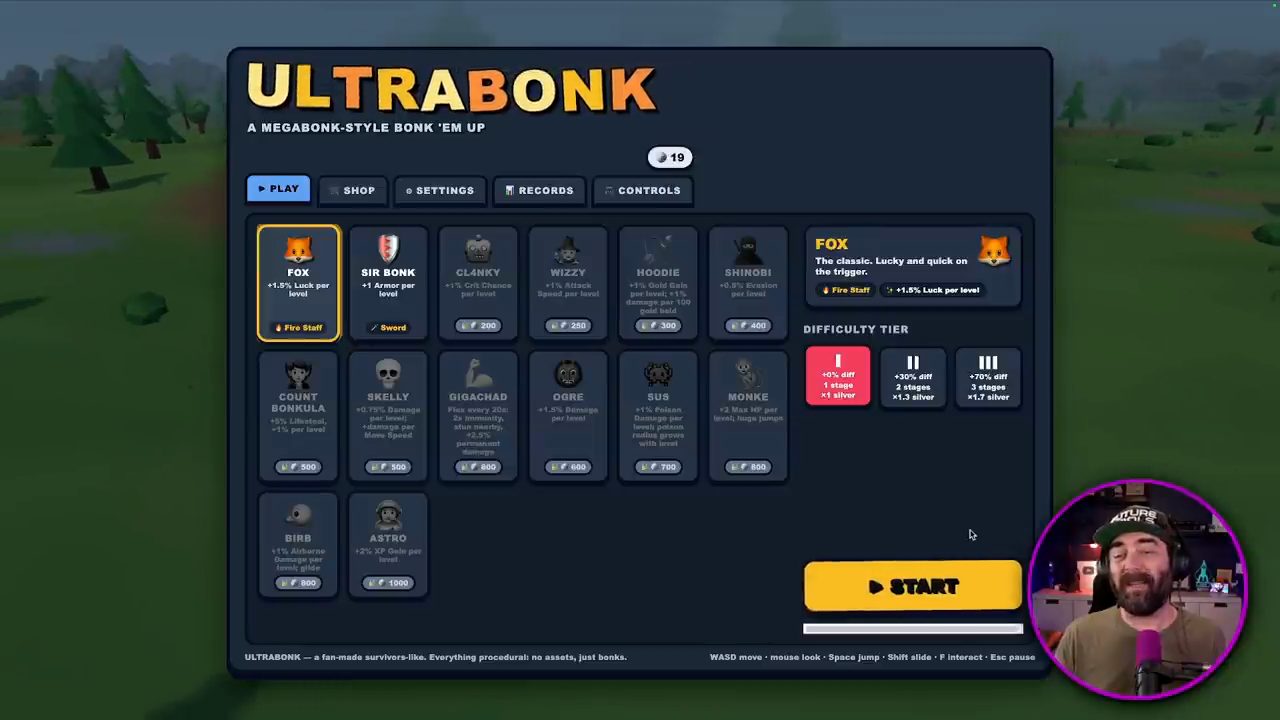
Vào chơi thử, Matt nói nhân vật trông đẹp, giống một nhân vật nhỏ dạng con cáo, đang bắn, và kẻ địch thật sự trông không chỉ là khối vuông, khối tròn hay cục blob như ở vài game anh có được trong các lần thử khác. Những hình ảnh nhỏ và animation bật lên khi lên cấp cũng trông khá đẹp. Anh nói không biết tại sao đồ vật cứ biến mất, nhưng nhìn ổn. Và nhìn chung, theo anh, nó đã làm rất, rất tốt bản clone Megabonk này. Đây là một prompt duy nhất, lần thử đầu tiên, không phải nhiều lượt (demo trong video đăng ngày 03/09/2026).
Matt nói anh khá ấn tượng. Anh thật ra nghĩ Opus 5 vẫn làm game tốt hơn, nhưng anh cảm thấy bản này nắm thêm được một chút chi tiết, và vài kẻ địch, nhân vật trông chi tiết hơn một chút. Theo anh, đây là một bản clone Megabonk thật sự tốt, không thể chê gì được (nhận định của Matt, video đăng ngày 03/09/2026).
8. Cái giá của bản game trong Claude Code
Rồi Matt rút lại câu vừa nói: anh có rất nhiều điều để than phiền, nhưng không liên quan gì tới output hay bản game được tạo ra. Mở Claude Code của anh ra, anh nói anh đã phạm sai lầm khi để nó ở chế độ Ultracode để code thứ này. Đây là thứ đầu tiên anh code trong Claude Code sau khoảng vài tuần. Anh đang ở gói 200 đô mỗi tháng của Claude, gói 20X, và có thể thấy nó vẫn đang code: nó đã chạy hơn một tiếng rưỡi và đang dùng usage credit của anh (demo trong video đăng ngày 03/09/2026).
Vào phần usage, Matt cho thấy phiên hiện tại còn 2 giờ 18 phút mới reset. Đây là thứ duy nhất anh code trong đó hôm đó. Nó dùng hết 100% phiên rồi bắt đầu chuyển sang usage credit để build, và vẫn chưa xong: nó còn đang làm QA, kiểu mất mãi không xong (demo trong video đăng ngày 03/09/2026).
Anh gõ lệnh usage để xem thứ này thật sự tốn bao nhiêu (lệnh trên màn hình trong video đăng ngày 03/09/2026):
/usage
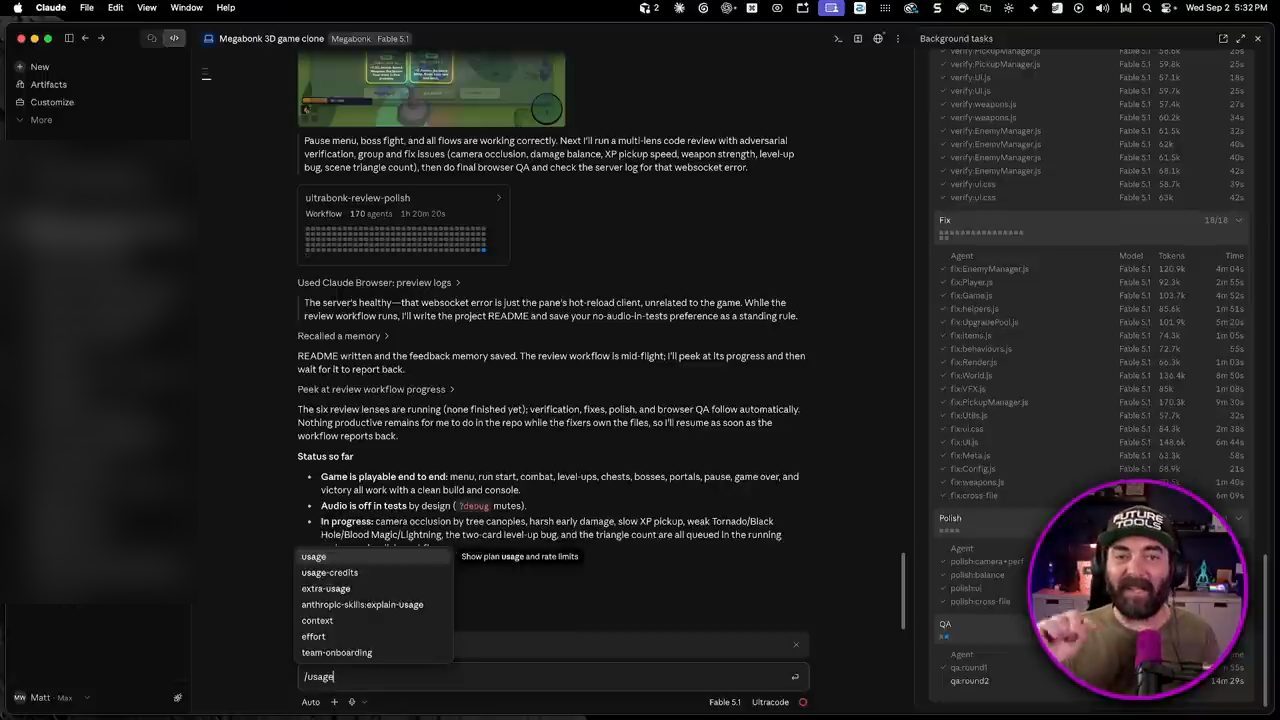
Kết quả, theo Matt: bản Megabonk đó, đúng là khá ấn tượng, đã tốn của anh 114 đô và vẫn còn tăng. Nên dù đúng là nó code Megabonk rất tốt, nó đốt hết usage của anh nhanh một cách điên rồ, rồi chuyển sang extra usage, và tốn của anh cỡ một trăm đô để làm ra thứ này (số đo của Matt, video đăng ngày 03/09/2026).
Theo Matt, nói lại lần nữa, đúng là Fable 5.1 khách quan là model tốt nhất, thông minh nhất, xuất sắc nhất ta từng thấy tính tới lúc đó, nhưng quá đắt để phần lớn mọi người làm điều họ muốn với nó. Anh nói bạn có thể dùng model khác như GPT-5.6 Sol với chi phí thấp hơn khá nhiều, và có thể bạn sẽ mất thêm vài prompt, nhưng bạn vẫn đi tới được kết quả này (nhận định của Matt, video đăng ngày 03/09/2026).
9. Gemini 3.8 Flash, model Matt cho là bị nói tới quá ít
Nhưng Fable 5.1 không phải model duy nhất Matt muốn nói tới. Tuần đó còn có Gemini 3.8 Flash, và anh nghĩ đây là một model bị nói tới quá ít. Theo anh, 5.1 đã bị thổi phồng quá mức, còn 3.8 Flash thì bị nói tới quá ít (nhận định của Matt, video đăng ngày 03/09/2026).
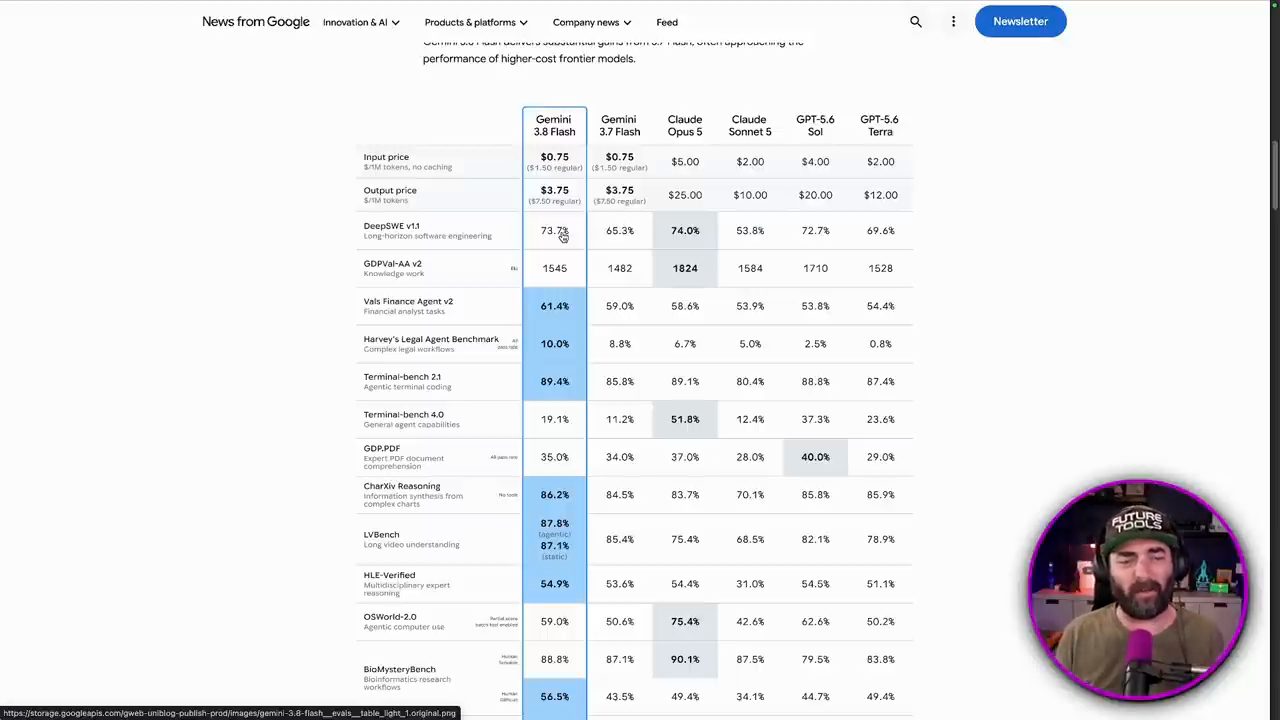
Nhìn vào benchmark, Matt nói Google có chạy model này qua DeepSWE, và nó được 73.7. Anh nhắc rằng chỉ vài tháng trước, Fable 5 là model tốt nhất mà ai cũng từng thấy; theo lời anh, nó từng bị hạn chế, và Anthropic đã rút nó lại vì chính phủ yêu cầu rút lại, vì nó là một model quá giỏi, quá thông minh (lời Matt, video đăng ngày 03/09/2026).
10. Bảng DeepSWE: ngang Opus 5, rẻ hơn nhiều
Matt mở lại trang chính thức của DeepSWE và nói: nhìn này, Gemini 3.8 Flash thông minh hơn Claude Fable. Trên biểu đồ, trục dọc là mức model làm được trên DeepSWE. Theo số anh đọc, Claude Fable nằm ở khoảng 69% với chi phí trung bình mỗi task 9,18 đô, còn Gemini 3.8 Flash đi lên trên thang thông minh tới 74% với chi phí trung bình mỗi task 2,36 đô (số trên DeepSWE theo video đăng ngày 03/09/2026).
Trên bảng xếp hạng của DeepSWE, theo Matt, Gemini 3.8 Flash mới đang ở 74%, ngang Claude Opus 5. Về cơ bản hai model thông minh như nhau, nhưng một model có chi phí trung bình 2,36 đô, model kia 11,84 đô. Còn Claude Fable 5, model mà theo lời anh là tốt nhất thế giới từng thấy khoảng sáu tuần trước, ở mức 70% với chi phí trung bình 21,63 đô. Vậy theo anh, ta đang có một model gần như giỏi code ngang Fable 5 với khoảng một phần mười chi phí (số trên DeepSWE theo video đăng ngày 03/09/2026).
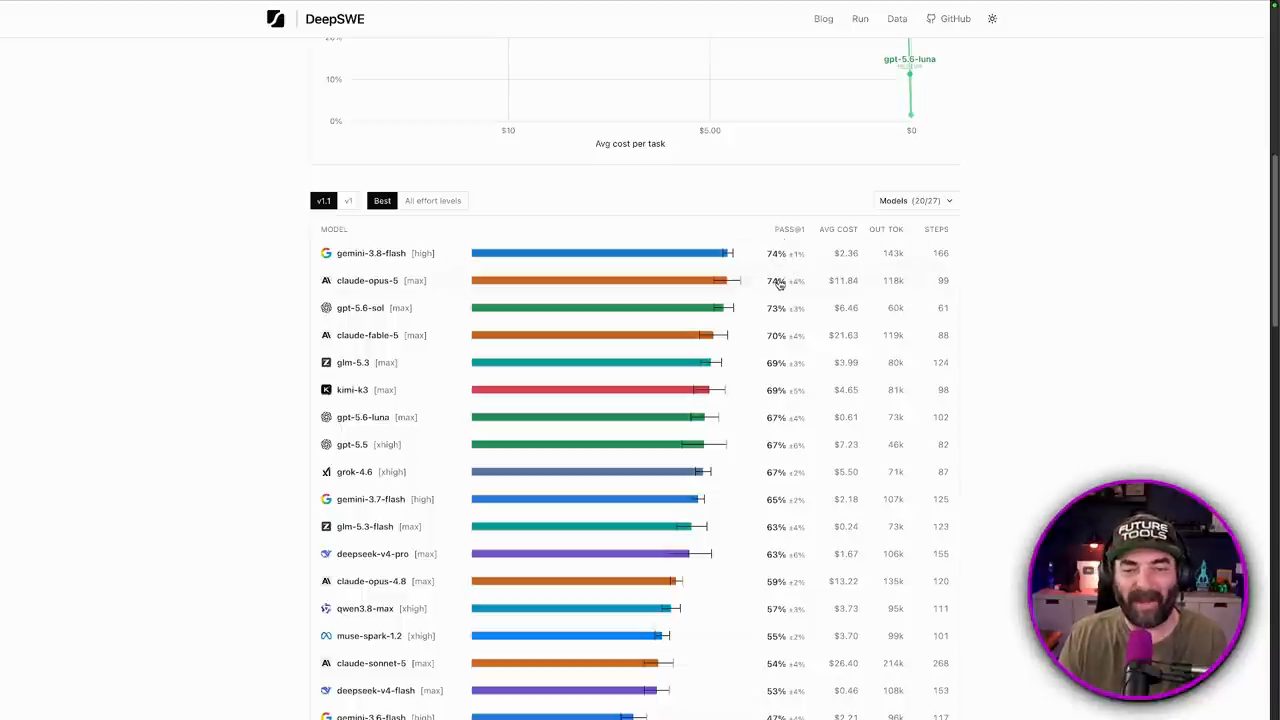
Nhưng Matt cảm thấy Google đã đứng ngoài cuộc quá lâu, và gần đây mọi người không bàn về model của họ, tới mức chẳng ai thật sự nói về chuyện này. Anh nói có vài điểm cần lưu ý và anh sẽ nói tới ngay sau. Nhưng khi nói tới một model code thật sự thông minh, thật sự hiệu quả và rất rẻ để dùng, theo anh model này thật sự, thật sự ấn tượng (nhận định của Matt, video đăng ngày 03/09/2026).
Với Fable 5.1 vừa xem ở trên, Matt nói chưa biết nó nằm ở đâu trên DeepSWE; anh chắc là có lẽ nó sẽ tốt hơn Gemini 3.8 Flash. Nhưng nó có giá 10 đô mỗi triệu token input và 50 đô mỗi triệu token output, bằng đúng giá Fable 5 vì Anthropic không tăng giá. Nên theo anh, riêng về coding, model này (Gemini 3.8 Flash) là model tốt hơn Fable 5 theo benchmark DeepSWE, nhưng rẻ hơn rất, rất nhiều khi dùng (nhận định của Matt, video đăng ngày 03/09/2026).
Matt cũng chỉ ra: bảng của Google ghi Gemini 3.8 Flash ở 73.7 so với 74.0 của Opus 5, còn trang DeepSWE thì ghi cả hai ở 74. Anh nói có lẽ nó được làm tròn lên một chút, nhưng gần như nó giỏi ngang Claude Opus 5. Và anh cảm thấy, với mức giá này, model này rất tốt (video đăng ngày 03/09/2026).
11. Gemini 3.8 Flash trên BuseyBench và Megabonk
Matt cũng chạy Gemini 3.8 Flash qua một số bài test giống trên BuseyBench. Theo anh, kết quả không tệ, nhưng tốn của anh chín xu, trong khi với Fable, theo lời anh là "Fable 5", gần năm đô; và nó tạo ra ảnh trong một phút 32 giây. Anh nói model này nhanh (số đo của Matt, video đăng ngày 03/09/2026).
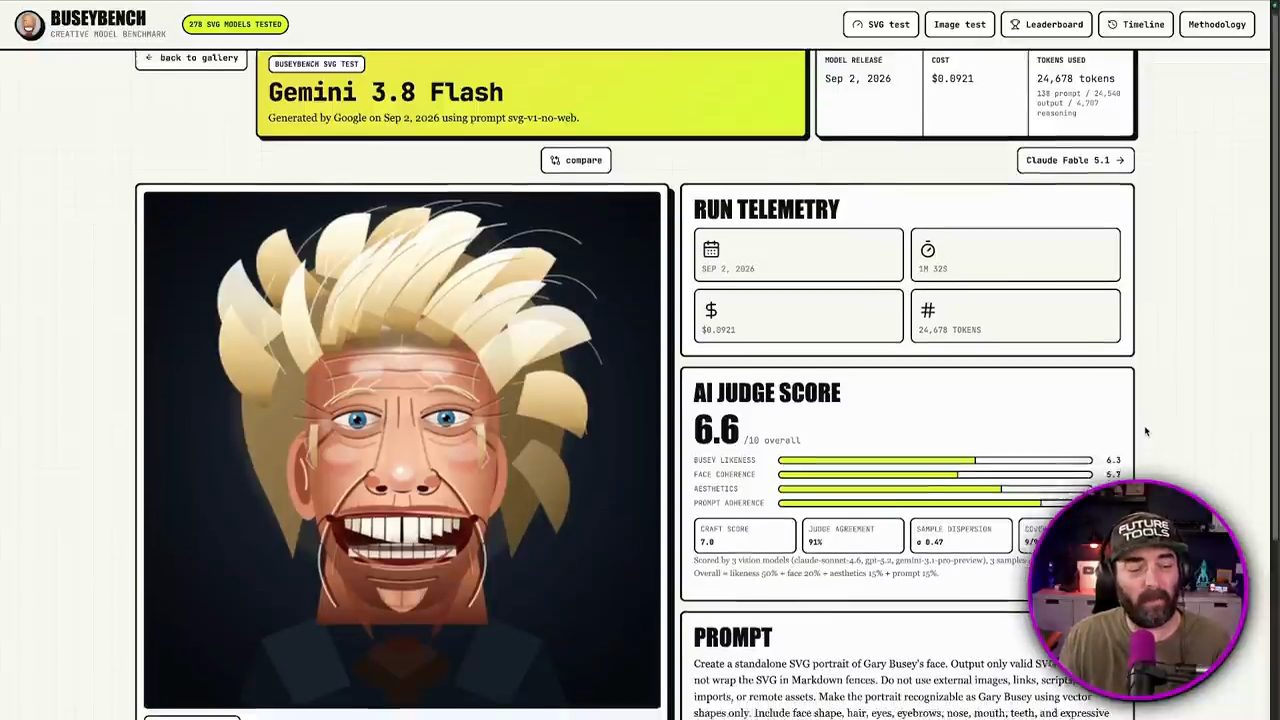
Trên leaderboard, theo Matt, nó gần như hòa với 3.7 Flash. Anh nói đây là một model khá ổn với SVG, dù đôi khi nó vẽ ra kiểu tóc hơi kỳ quặc (nhận định của Matt, video đăng ngày 03/09/2026).
Anh cũng cho nó tạo phiên bản Megabonk của riêng nó. Theo Matt, bản này không tệ. Nó chắc chắn trông không đẹp bằng bản của Fable 5.1, và anh nói chắc chắn anh thừa nhận điều đó. Tuy nhiên, theo anh, bản này tốt hơn nhiều so với bản đầu tiên anh nhận được từ Fable: với bản đó, nhân vật của anh trông như một củ khoai tây nhỏ, một quả cầu nâu chạy quanh, còn kẻ địch chỉ là những khối vuông lao vào tấn công. Ở bản của Gemini 3.8 Flash, kẻ địch trông như có cái đầu goblin nhỏ, và anh xoay được camera (demo trong video đăng ngày 03/09/2026).
Một lần nữa, Matt nói đây chỉ là one-shot, một prompt để có cả bản game này. Theo anh, nó trông rất đẹp, nhất là khi so với những gì Fable 5 cho anh ở lần test đầu tiên: Gemini 3.8 Flash làm được điều này với một prompt và trông đẹp hơn nhiều so với những gì Fable cho anh lần đầu (nhận định của Matt, demo trong video đăng ngày 03/09/2026).
12. Artificial Analysis: giữa bảng, nhưng giỏi code
Trên Artificial Analysis, theo Matt, model này rơi vào kiểu giữa bảng: nó được 59, về cơ bản ở vị trí thứ mười. Tuy nhiên, anh cảm thấy model này đã thật sự được tối ưu để giỏi, rẻ và nhanh ở coding. Anh nói không biết đó có phải ý định của Google không, nhưng để đạt thứ hạng trên DeepSWE ngang Opus 5 và cao hơn Fable 5, anh thật sự cảm thấy đây là một model rất tốt cho coding, và nó rẻ, và nó thật sự nhanh (nhận định của Matt, số trên Artificial Analysis theo video đăng ngày 03/09/2026).
Nên về intelligence index, theo Matt, không, nó không phải model thông minh nhất thế giới. Với những thứ như GDPval cho knowledge work, nó không xuất sắc. Nhưng nó thật sự giỏi code. Ở τ²-Banking, SciCode, Terminal-Bench v2.1, Humanity's Last Exam và nhiều mảng khác, nó không theo kịp những model tốt hơn. Nhưng nếu bạn cần một model thật sự, thật sự giỏi coding, giờ gần như ngang mức state of the art về coding, thì theo anh model này nằm ngay trong nhóm đó (nhận định của Matt, video đăng ngày 03/09/2026).
13. Chi phí, thời gian và token mỗi task
Matt xem tiếp chi phí mỗi intelligence task trên Artificial Analysis. Fable 5.1 là 3,69 đô mỗi task, Claude Fable 5 là 3,14 đô. Anh nói ta đã biết model 3.8 Flash này giỏi code hơn Fable 5. Claude Opus 5 là 2,34 đô mỗi task, và gần như ngang Gemini 3.8 Flash trên DeepSWE. GPT-5.6 thì anh gọi là một model coding tuyệt vời, có lẽ là daily driver của anh, model anh dùng nhiều nhất để code, ở mức 0,95 đô mỗi task. Còn Gemini 3.8 Flash nằm tít dưới thấp với 0,58 đô mỗi task (số trên Artificial Analysis theo video đăng ngày 03/09/2026).
Theo Matt, đây là một model rất, rất rẻ cho coding, nhưng giỏi ngang những model đứng gần đầu Artificial Analysis khi nói tới coding trên benchmark DeepSWE (nhận định của Matt, video đăng ngày 03/09/2026).
Về thời gian mỗi task, theo Matt, Gemini 3.8 Flash trung bình 2,5 phút mỗi task, thật sự, thật sự nhanh. Opus 5 ở tít trên với trung bình 7,4 phút mỗi task; Fable cũng 7,4 phút trung bình mỗi task; GPT-5.6 là 3,9 phút. Nên theo anh, nó rẻ, nhanh và tốt (số trên Artificial Analysis theo video đăng ngày 03/09/2026).
Tuy vậy, Matt nói nó dùng nhiều output token hơn nhiều. Xét về việc dùng token, nó gần như là model kém hiệu quả nhất, nằm tít bên phải biểu đồ anh đang xem: nó dành nhiều thời gian reasoning trước khi đưa ra câu trả lời (theo biểu đồ output token trên Artificial Analysis mà Matt xem, video đăng ngày 03/09/2026).
Nhưng theo Matt, điều đó không thật sự quan trọng, vì thứ ta thật sự muốn biết là làm một việc sẽ tốn bao nhiêu tiền. Và ta biết model này khá rẻ để dùng: đúng là nó có thể dùng nhiều token hơn, nhưng rốt cuộc nó chỉ tốn 58 xu mỗi task (nhận định của Matt, video đăng ngày 03/09/2026).
Matt nói anh muốn chia sẻ điều này vì ai cũng đang nói về Fable 5.1: họ nói đây là model tốt nhất từ trước tới nay, là thứ điên rồ nhất, bạn cần nó ngay, ôi trời, nó thay đổi cuộc chơi, hay bất kỳ từ hype nào bạn muốn dùng. Và anh không thật sự cảm thấy có ai đang nói nhiều về Gemini 3.8 Flash (video đăng ngày 03/09/2026).
Theo anh, Gemini 3.8 Flash là một bước nhảy lớn về hiệu năng coding với chi phí thấp hơn nhiều, hiệu quả hơn nhiều; không hẳn là hiệu quả về token, mà là hiệu quả về chi phí cho kết quả bạn muốn có. Và nó thật sự, thật sự giỏi coding (nhận định của Matt, video đăng ngày 03/09/2026).
Còn 5.1, theo Matt, tuyệt vời ở coding: không bàn cãi, là model tốt nhất hiện có lúc đó về coding, về knowledge work, về gần như mọi thước đo có ý nghĩa, trừ chi phí. Anh nói bạn sẽ dùng nó, bạn sẽ ấn tượng với nó, rồi bạn sẽ thấy dùng nó một cách thường xuyên là không kinh tế (nhận định của Matt, video đăng ngày 03/09/2026).
14. Path to Astra: OpenAI báo trước một model
Còn một điều cuối Matt muốn nói tới. Anh nói sẽ không đi quá sâu, vì nó thật ra không phải một lần ra mắt model mới, mà giống một thông báo rằng một model sắp ra. OpenAI đăng bài "Path to Astra", trong đó theo lời anh, về cơ bản họ nói họ đã làm chậm lại và giữ Astra lại vì muốn chắc chắn nó thật sự an toàn (video đăng ngày 03/09/2026).
Matt đọc đoạn trong bài: OpenAI viết rằng với đúng công cụ và quyền truy cập, model này có thể tìm ra những lỗ hổng bảo mật chưa ai biết và phát triển cách khai thác chúng trên nhiều hệ thống được bảo vệ tốt mà không cần người hướng dẫn từng bước. Bài viết ghi đây là model đầu tiên họ xếp vào mức này. Trong vài tuần qua, họ đã hoãn một phần việc phát triển và phát hành Astra trong khi tăng cường và test các biện pháp bảo vệ chống lạm dụng cyber và hành động trái phép của model. Tuy vậy, họ có viết: "We plan to make Astra available soon" (theo bài của OpenAI mà Matt đọc, video đăng ngày 03/09/2026).
Theo Matt, nhiều người đang đoán nó sẽ ra trong tuần này hoặc tuần sau. Anh nói anh không có thông tin gì về chuyện đó, nhưng anh không nghĩ OpenAI sẽ để Fable 5.1 và các model Gemini 3.8 Flash mới làm kẻ đứng đầu, được bàn tán nhiều nhất, quá lâu (nhận định của Matt, video đăng ngày 03/09/2026).
Matt cho rằng biểu đồ trong bài nói lên nhiều điều về model này. Theo cách anh hiểu, về cơ bản trục ở đó là tỷ lệ thành công trong việc tìm và khai thác lỗ hổng. Với GPT-5.6 Sol, model tốt nhất OpenAI đang có lúc đó, tỷ lệ thành công lên tới 11,5%, và để làm được vậy nó dùng rất nhiều token, gần 140.000 token để đạt 11,5% (số trên biểu đồ của OpenAI mà Matt đọc, video đăng ngày 03/09/2026).
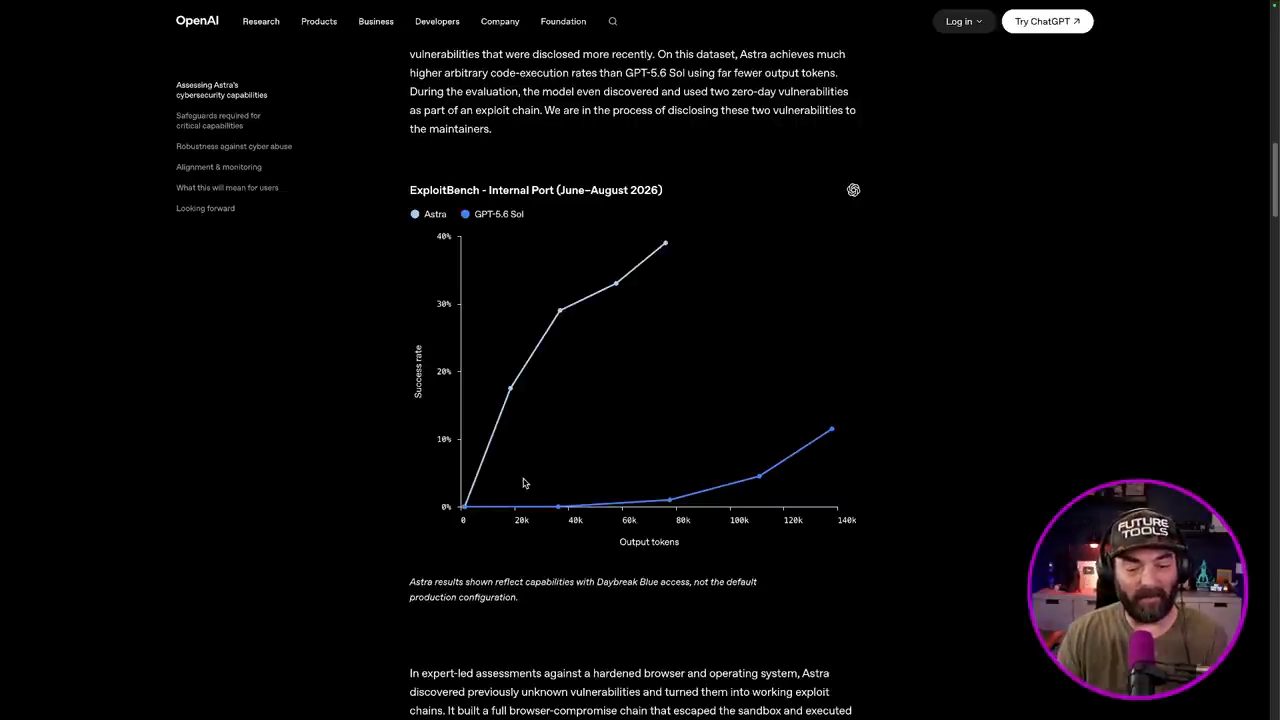
Còn model Astra sắp ra, theo Matt, kể một câu chuyện khá khác: ít token hơn nhiều, 18.535 token để đạt tỷ lệ thành công 17,5%, và lên tới gần 40% với 76.188 token. Nên theo anh, nó vừa thành công hơn trong việc khai thác lỗ hổng, vừa hiệu quả hơn nhiều khi khai thác những lỗ hổng đó, bằng cách dùng ít token hơn nhiều để làm được (số trên biểu đồ mà Matt đọc, video đăng ngày 03/09/2026).
15. Recurrent depth và chain of thought
Matt nói cũng có vài mối lo khác bắt đầu được nêu ra về model này, mà anh mới đọc trên trang The Information. Theo bài viết, OpenAI đang dùng một kiểu training mới để làm Astra ngày càng tốt hơn, và kỹ thuật mới đó gọi là recurrent depth, hay looped transformer. Bài viết ghi kỹ thuật này cho phép một model AI cải thiện câu trả lời bằng cách xử lý cùng một đoạn văn bản nhiều lần (theo bài của The Information mà Matt đọc, video đăng ngày 03/09/2026).
Bài viết cũng ghi: khác với các model state of the art đang bán thương mại, vốn viết ra cách chúng đang nghĩ về một task trước khi hoàn thành nó, kỹ thuật mới vận hành theo cách che khuất một phần hoặc toàn bộ quá trình reasoning của AI, còn gọi là chain of thought (theo bài của The Information mà Matt đọc, video đăng ngày 03/09/2026).
Matt giải thích: khi bạn đưa model một prompt và thấy cả đoạn chữ kiểu như chạy ra trong lúc nó đang nghĩ trước khi đưa output cuối, thì đó là chain of thought bạn đang thấy. Nhưng theo anh, phương pháp mới này khiến con người không thể dễ dàng đọc được chain of thought (video đăng ngày 03/09/2026).
Anh nói cả kỹ thuật mới này khiến một số người lo, vì như bài viết ghi, kỹ thuật mới có thể mâu thuẫn với việc OpenAI ủng hộ giữ cho phần suy nghĩ của model hoàn toàn đọc được với con người; OpenAI đã nói khả năng theo dõi quá trình suy nghĩ của AI sẽ giúp họ ngăn những sự cố như vụ hack hồi tháng Bảy (theo bài của The Information mà Matt đọc, video đăng ngày 03/09/2026).
Matt đề nghị nghĩ theo cách này: khi bạn đưa model một prompt, bạn thấy được chain of thought, thấy nó kiểu lập luận qua mọi thứ và cố tìm cách giải bài toán theo thời gian thực, rồi nó đưa bạn output. Và nếu muốn, thường bạn có thể mở chain of thought đó ra xem nó đi tới kết luận ra sao, và điều đó cho phép bạn kiểu như audit nó. Nếu output không như bạn mong, bạn có thể quay lại xem chỗ nào mà logic có thể đã sai, rồi chỉnh hướng model AI (lời giải thích của Matt, video đăng ngày 03/09/2026).
Còn với recurrent depth, theo Matt, bạn đưa model một prompt, và thay vì thấy chain of thought, thấy logic và cách nó đi tới kết luận, thì ở phía sau nó chỉ đang chạy cả loạt thuật toán phức tạp về toán, về cơ bản giống tính nhẩm ở phía sau mà con người không thật sự đọc và hiểu được. Rồi ta nhận output (lời giải thích của Matt, video đăng ngày 03/09/2026).
16. Điều khiến một số nhà khoa học lo
Theo Matt, với phần lớn prompt thông thường, khi bạn chỉ hỏi một câu tiêu chuẩn và nó trả lời một câu tiêu chuẩn, thì đó không phải chuyện lớn. Nhưng khi đi vào coding, cybersecurity và những thứ kiểu sinh học, việc không hiểu rõ nó đang nghĩ gì sẽ khiến các nhà khoa học, nhà nghiên cứu và những người dùng các model này khó hơn nhiều trong việc lái nó đi đúng hướng và đảm bảo nó không đi vào những hướng độc hại và những thứ tương tự (nhận định của Matt, video đăng ngày 03/09/2026).
Anh nói nếu ta không thấy được chain of thought và không biết vì sao nó đang đi theo hướng nó đang đi, điều đó có thể dẫn tới một số vấn đề, và điều đó khiến các nhà khoa học kiểu như lo (lời Matt, video đăng ngày 03/09/2026).
Theo Matt, OpenAI có nói họ đang cố hạn chế điều này hết mức có thể và đang đặt cả loạt safeguard. Anh nói để xem mọi chuyện diễn ra thế nào (video đăng ngày 03/09/2026).
Nhưng nếu kiểu kỹ thuật này trở nên phổ biến, theo anh, điều đó không ngăn được các hãng làm model khác, các hãng làm model ở Trung Quốc và các hãng làm model open source dùng những kỹ thuật tương tự, cũng đáng sợ không kém, nhưng có thể không nghĩ về an toàn theo cùng cách mà một số frontier lab nghĩ (nhận định của Matt, video đăng ngày 03/09/2026).
17. Kết luận của Matt: quá nhiều bản nâng cấp nhỏ
Matt nói đó là phần rant của anh về các model mới. Nếu phải tóm lại mọi thứ bằng suy nghĩ của anh lúc đó và đưa ra một kết luận: ta đang nhận cả loạt model mới, và anh cảm thấy mình đang kiểu hơi bực với những lần ra model này, vì chúng đều được hype lên cực kỳ, như những bản phát hành thay đổi thế giới, thay đổi cuộc chơi (video đăng ngày 03/09/2026).
Anh nói anh cho rằng phần lớn điều đó là do các content creator chứ không hẳn do các lab. Nhưng anh gần như kiểu ước các lab cứ chờ tới khi có bước nhảy lớn rồi mới phát hành, kiểu GPT-5 rồi GPT-6, những model nhảy vọt, thay vì những cải tiến nhỏ từng bước. Theo anh, đúng là 5.1 tốt hơn 5, nhưng với phần lớn thế giới, bạn sẽ không nhận ra khác biệt. Nếu bạn là coder, bạn sẽ được tăng một chút, nhưng đó cũng là một model thật sự, thật sự đắt, trong khi những model rẻ hơn sẽ đưa bạn tới cùng chỗ (nhận định của Matt, video đăng ngày 03/09/2026).
Rồi có Gemini 3.8 Flash, mà anh nghĩ vì là của Google nên không được nói tới nhiều bằng, nhưng là một model đã trở nên thật sự, thật sự thông minh và thật sự hiệu quả ở coding, rất, rất nhanh (nhận định của Matt, video đăng ngày 03/09/2026).
Nhưng theo Matt, số lượng bản phát hành đang trở nên kiểu mệt mỏi. Một phần trong anh kiểu ước: được rồi, với phần lớn những gì ta đang làm, các model này đã đủ tốt; hãy chờ một chút cho tới khi có một model thật sự, thật sự tốt khác để cho mọi người xem, thay vì mỗi model "chấm x" tăng một phần trăm trên một benchmark. Với anh, chuyện đó đang kiểu thành bực bội và hơi giống bánh xe chuột hamster: tuần nào cũng có một model mới tốt hơn nửa phần trăm trên một benchmark nào đó mà phần lớn mọi người vốn không quan tâm (nhận định của Matt, video đăng ngày 03/09/2026).
Anh nói anh chỉ muốn rant một chút và nói về chuyện này trong một phút.
Matt cảm ơn mọi người đã cùng anh nerd out, và nói đó là tất cả những gì anh có.
Nguồn và liên kết 11 nguồn
- Tên gốc: Why Aren't People Talking About This Google Model?
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=Po_Dh7WLgmM youtube.com
- Kênh YouTube Matt Wolfe (Matt Wolfe): youtube.com/channel/UChpleBmo18P08aKCIgti38g youtube.com
- Anthropic, "Introducing Claude Fable 5.1 and Claude Mythos 5.1", bài ra mắt có các đoạn Price (ước tính rẻ hơn 25% so với Fable 5 cho workload điển hình) và anti-distillation (đọc ngày 19/11/2026): anthropic.com/claude-fable-and-mythos-5-1 anthropic.com
- Claude Platform Docs, trang Pricing với bảng giá theo model (đọc ngày 19/11/2026): platform.claude.com/docs/en/about-claude/pricing platform.claude.com
- Google, "Introducing Gemini 3.8 Flash and 3.8 Flash Cyber", ghi giá 0,75 đô mỗi triệu token input và 3,75 đô mỗi triệu token output (đọc ngày 19/11/2026): blog.google/…/3-8-flash-and-3-8-flash-cyber blog.google
- The Information, "OpenAI Technique in 'Astra' Model Sparks Security Concerns", bài về recurrent depth (trang có tường phí; đọc tiêu đề ngày 19/11/2026): theinformation.com/articles/secret-technique-behind-openais-astra-model-sparks-security-concerns theinformation.com
- Artificial Analysis, trang phân tích model với Intelligence Index và chi phí mỗi task (đọc ngày 19/11/2026): artificialanalysis.ai artificialanalysis.ai
- DeepSWE của Datacurve, benchmark "measuring frontier coding agents on original, long-horizon engineering tasks" (đọc ngày 19/11/2026): deepswe.datacurve.ai deepswe.datacurve.ai
- BuseyBench, benchmark vẽ chân dung SVG Gary Busey (đọc ngày 19/11/2026): buseybench.com buseybench.com
Related talks
Gemini 4 Carbon: chậm, hay bịa, nhưng bất ngờ tốt ở việc bảo mật
Theo Browne · Theo - t3․gg · 30 min
Theo Browne đánh giá Gemini 4 Carbon: claim sai, tốc độ, giá và cache, UI, 3D, và vì sao nó lại xử lý tốt một báo cáo bảo mật thật trong T3 Code.
Skill-creator mới: test, đo và tối ưu Claude skill
Ray Amjad · Ray Amjad · 13 min
Skill-creator mới của Anthropic: hai loại skill, chạy evals và A/B test mù có/không skill, benchmark, tối ưu description để skill trigger ổn định.
Sáu skill Claude Code đáng dùng nhất sau hơn 100 skill đã thử
Tim Ruscica · Tech With Tim · 19 min
Cài và dùng thử sáu skill cho Claude Code: gstack, Hostinger MCP, Firecrawl, Humanizer, Composio và VibeSec, mỗi cái một demo thật.