Vì sao AI agent thất bại
Bảy lý do AI agent thất bại theo John Savill trên bảng trắng, từ fuzzy goal tới flying blind, cách sửa từng lý do và improvement loop.
✓ Đã duyệt độc lập · cập nhật 31/10/2026 · 43 min
1. Demo tuyệt vời, vài tuần sau thì hỏng
John Savill mở đầu bằng một pattern mà anh nói mình cứ gặp đi gặp lại (video đăng ngày 26/10/2026). Ai đó build một agent, bản demo tuyệt vời, mọi người đều hào hứng, agent được đưa lên production. Vài tuần sau, nó lặng lẽ đưa ra câu trả lời sai, hoặc kẹt trong một vòng lặp đốt token, hoặc đã làm một việc mà lẽ ra nó thật sự không được làm.
Phản xạ lúc đó lúc nào cũng là đổ lỗi cho model: "ta chỉ cần một model tốt hơn". Theo John (video đăng ngày 26/10/2026), thật lòng mà nói, đó hiếm khi là câu trả lời. Vì vậy trong video này anh muốn xem vì sao AI agent thất bại, và dĩ nhiên, những việc ta thật sự có thể làm được là gì. Anh nói nếu không có phần đó thì video này sẽ chẳng hữu ích lắm.
2. Model ở giữa, mọi thứ bao quanh nó, và bảy lý do thất bại
Thứ ta nghe nhiều nhất hiện nay là các model. John vẽ chữ MODEL ở chính giữa bảng trắng: đúng vậy, model chắc chắn sẽ nằm ở trung tâm bức tranh, và theo anh (video đăng ngày 26/10/2026), các model này vẫn đang tiếp tục cải thiện, tăng thêm năng lực. Nhưng theo John, mấu chốt thật sự là những gì được bọc quanh model. Đồng thời, khi build agent, điều tối quan trọng là ta không build chúng với tư duy tin tưởng model.
Mục tiêu, theo John (video đăng ngày 26/10/2026), là những gì ta đặt quanh model phải giúp ta không cần tin model chút nào. Anh nhấn mạnh đó thật sự là mục tiêu. Anh cũng lưu ý: anh nói "model" (số ít), nhưng thực tế nhiều agent có thể dùng nhiều model, tuỳ vào độ phức tạp của request, kích thước context, yêu cầu về tool, latency và việc ta muốn chi bao nhiêu. Chúng sẽ dùng các model frontier lớn hơn, đôi khi là model nhỏ hơn, đôi khi có thể là một số loại model mới chuyên về phán đoán (judgment).
Theo John (video đăng ngày 26/10/2026), thứ thật sự hay khiến AI agent thất bại là: thiếu rõ ràng về mục tiêu, tool không đáng tin cậy, reasoning không được kiểm tra, mất state, quá nhiều sự tin tưởng hoặc quyền truy cập, và thiếu khả năng quan sát. Từ đó anh bắt đầu dựng dần bức tranh trên bảng.
Câu hỏi đầu tiên là: cái gì bao quanh model để tạo nên một agent thật sự? Ở lõi là ý tưởng agent loop. John vẽ một vòng tròn quanh chữ MODEL và giải thích vòng lặp đó làm gì: nó lên kế hoạch (plan) sẽ làm gì, nó hành động (act), gọi tool, tra cứu thông tin, kiểm tra kết quả (result), rồi lại đi tiếp một vòng nữa cho tới khi nó quyết định rằng "ta đã xong". Theo John (video đăng ngày 26/10/2026), vòng lặp đó là phần cốt lõi của thứ ta gọi là harness, và nó làm cho hệ thống trở thành một agent chứ không chỉ là một chatbot trả lời hết prompt này tới prompt khác.
Khi nhìn cả hệ thống, đầu vào là goal và instruction. John định vẽ một cái bia (target board) và nói mình sẽ không vẽ nổi, nhưng trên bảng anh vẫn vẽ một hình tròn đồng tâm, ghi "GOALS + INSTRUCTIONS". Thường thì ta gói chúng vào một prompt, kèm theo thành công nên trông như thế nào (video đăng ngày 26/10/2026).
Rất quan trọng với tất cả những thứ này là context. Theo John (video đăng ngày 26/10/2026), có thể chia context thành vài phần. Một phần là knowledge: thông tin mà agent có thể retrieve. Một phần là memory: những gì đã xảy ra trước đó, có thể qua một context dài, và có thể vẫn còn liên quan. Và có state: những gì đã xảy ra tới giờ trong chính bộ goal mà agent đang làm. State có thể gồm những việc đã làm và những việc còn phải làm. Tất cả những thứ này là input, và state sẽ được cập nhật khi agent làm các việc khác nhau.
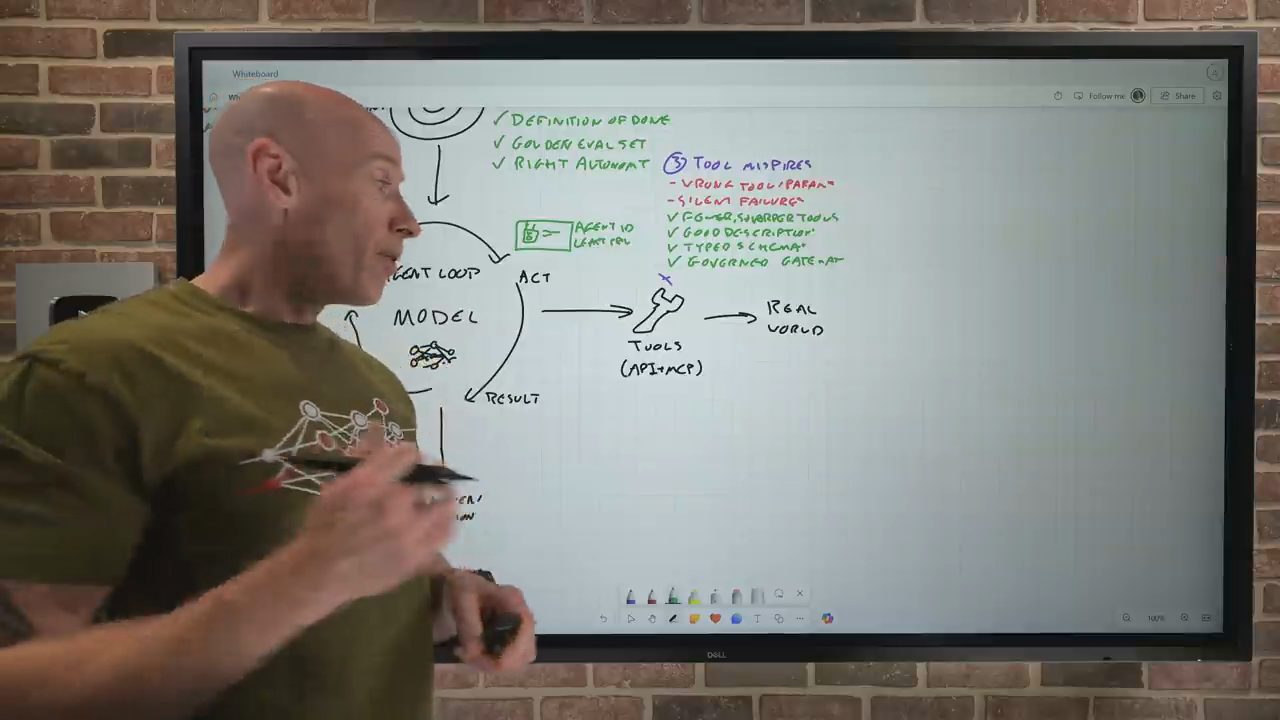
Rồi ta muốn agent làm được việc, thực hiện hành động: tra một đơn hàng, gửi một email. Từ chữ ACT, John vẽ một hình mà anh nói là cái cờ lê (spanner) tượng trưng cho tools. Theo anh (video đăng ngày 26/10/2026), ngày nay các tool này rất hay là gọi API, gọi MCP server, có thể là computer use, và danh sách còn dài nữa. Các tool này có thể thay đổi mọi thứ ngoài thế giới thật (REAL WORLD trên bảng).
Một thứ khác mà theo John hiện nay (video đăng ngày 26/10/2026) ta nghe nhiều là skills. Skill nói cho agent biết làm một việc như thế nào: bước một, bước hai, bước ba. Và các skill đó có thể dùng chính những tool kia. Cuối cùng là kết quả của tất cả: một câu trả lời, hoặc có thể là một hành động, đánh dấu điểm kết thúc của agentic loop. Kết quả đó có thể đi tới một con người, tới một agent khác, hoặc một ứng dụng khác.
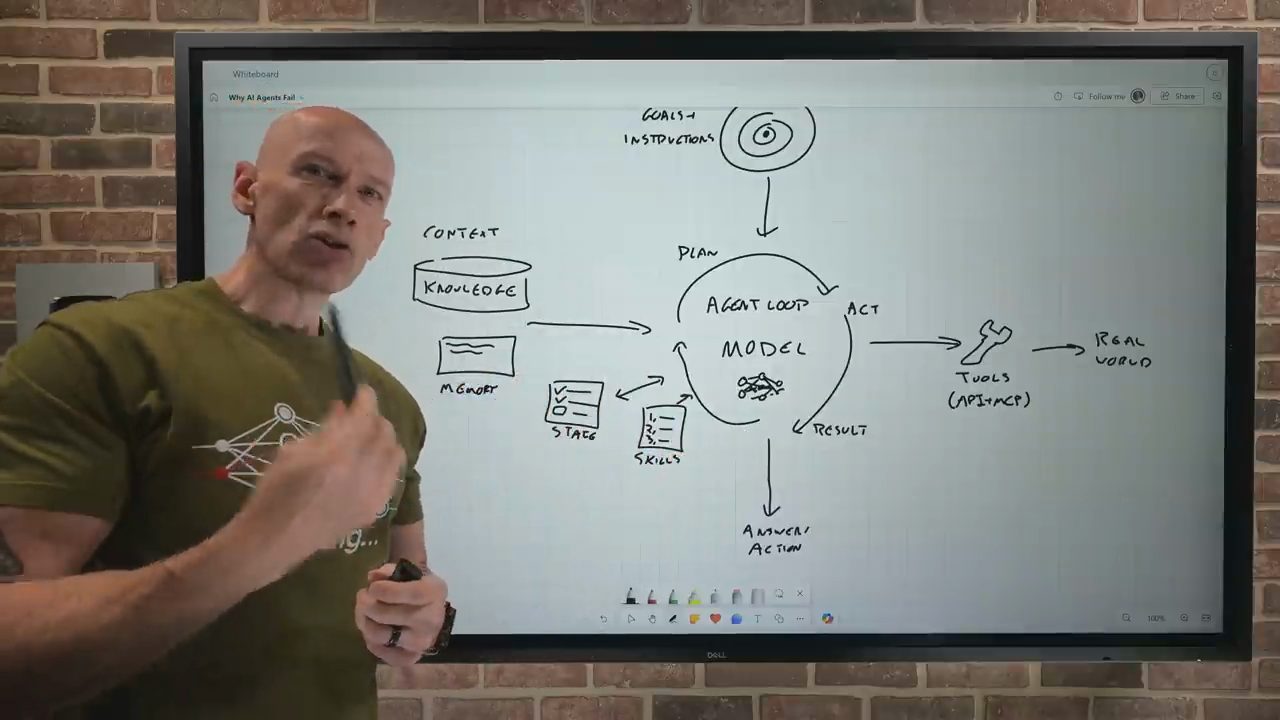
Với bức tranh đó, John muốn đi qua bảy lý do thất bại hàng đầu mà theo anh (video đăng ngày 26/10/2026) ta hay gặp, cùng những việc có thể làm với từng lý do. Nhưng anh nói ta không chỉ muốn chặn thất bại: ta muốn không chỉ sửa, mà build những agent tiếp tục tốt lên theo thời gian.
Khi đi qua bảy lý do này, một điều ta sẽ thấy là chỉ một trong số đó thật sự là về model (video đăng ngày 26/10/2026). Rồi anh bắt đầu đi vào từng lý do.
3. Số 1: Fuzzy goal, mục tiêu mơ hồ
Đầu tiên, theo John (video đăng ngày 26/10/2026), có trường hợp mà bạn có thể nói agent về mặt kỹ thuật vẫn chạy, nhưng nó làm sai việc, hoặc làm một phiên bản mơ hồ của đúng việc. Ta không biết một response có tốt hay không. Ta không biết nó có đang tốt lên hay không. Điều đó khiến rất khó để chứng minh giá trị kinh doanh.
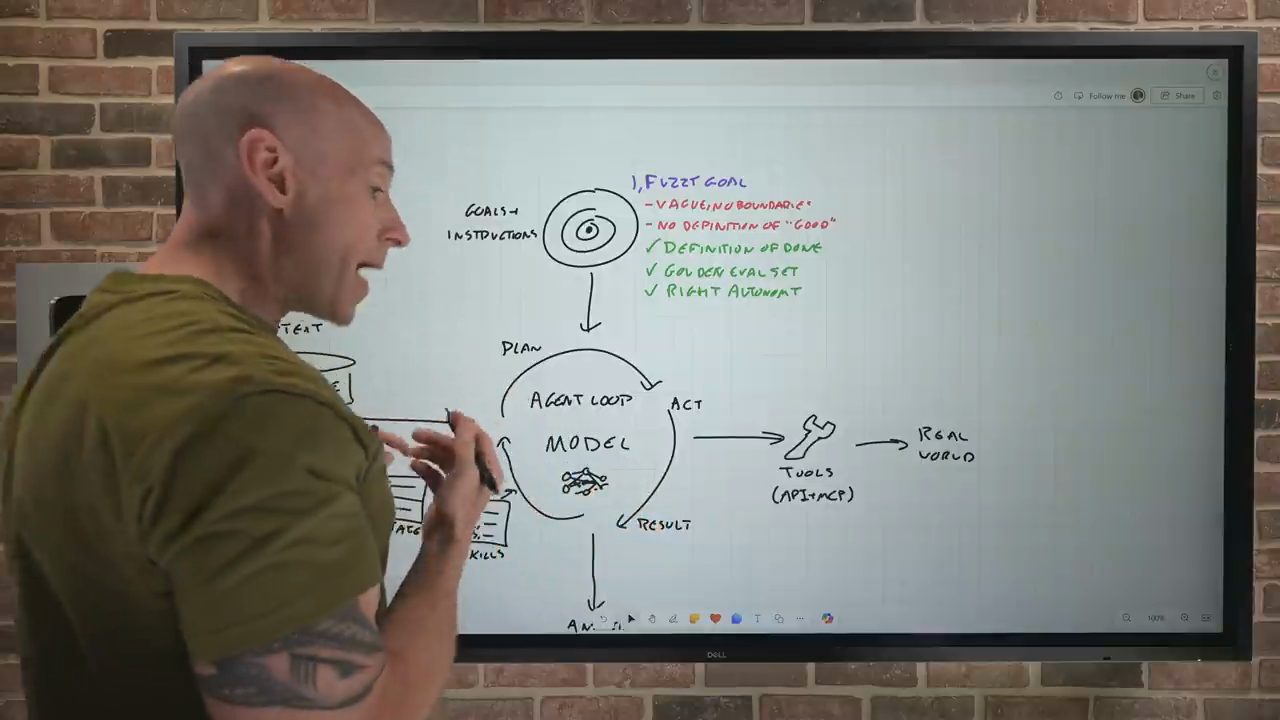
Lý do, theo anh (video đăng ngày 26/10/2026), là ta có một fuzzy goal (mục tiêu mơ hồ). Đây là số một. Instruction thì mơ hồ. Không có ranh giới rõ ràng cho công việc hay cho các bước phải làm. Không có quy tắc escalation. Không có định nghĩa thế nào là xong (done), thế nào là tốt, hay có lẽ thế nào là tệ.
Thế nên, theo John (video đăng ngày 26/10/2026), chất lượng chỉ được đánh giá theo cảm tính: làm demo thì có vẻ ổn. Ta có một kịch bản setup được định nghĩa rất gọn gàng mà sẽ chẳng thật sự được dùng, và ta không nhìn kỹ vào nó. John gọi đây rõ ràng là những vấn đề rất lớn. Trên bảng, cạnh "1. FUZZY GOAL", anh ghi bằng mực đỏ: mơ hồ, không có ranh giới (VAGUE, NO BOUNDARIES), không có định nghĩa "tốt" (NO DEFINITION OF "GOOD"). Anh nói không biết tốt thật sự trông thế nào có lẽ là phần quan trọng nhất của gần như mọi thứ ta sắp làm.
Giải pháp theo John (video đăng ngày 26/10/2026): trước cả khi bắt đầu viết agent, cần có một định nghĩa có chất lượng về thế nào là xong, mục đích của agent là gì, và nó làm việc cho ai. Nó phải làm gì? Nó tuyệt đối không bao giờ được làm gì? Khi nào nó nên chuyển giao (hand off)? Một câu trả lời đúng gồm những gì? Lý tưởng là goal đó gắn với các mục tiêu đo được. Anh nghĩ tới resolution rate, có thể là handle time, chi phí, một giá trị mà sau này ta chứng minh được.
4. Golden eval set và evaluator tự tạo trong Foundry
Vậy cần một định nghĩa về thế nào là xong. Làm sao biết tốt trông thế nào? Theo John (video đăng ngày 26/10/2026), nên có một evaluation set, một golden evaluation set mô tả tốt trông thế nào, xây trên ít nhất 20 case nhưng lý tưởng là nhiều hơn thế rất nhiều, có cả edge case, và mọi thay đổi ta từng làm đều được chấm điểm dựa trên nó. Anh viết "GOLDEN EVAL SET" lên bảng.
Rồi anh chuyển nhanh sang màn hình Microsoft Foundry để cho thấy một việc rất hay ta có thể làm. Trong Foundry có một evaluator catalog, với cả loạt evaluator dựng sẵn cho những việc rất phổ biến ta muốn làm (demo trong video đăng ngày 26/10/2026). Nhưng anh cũng có thể tạo evaluator của riêng mình: chỉ vào agent của mình, mô tả điều mình muốn, có thể thêm context và các năng lực nâng cao, và nó sẽ dựng một rubric tuỳ chỉnh, một bảng chấm điểm (grading sheet) mô tả "tốt" thật sự trông thế nào với agent của anh.
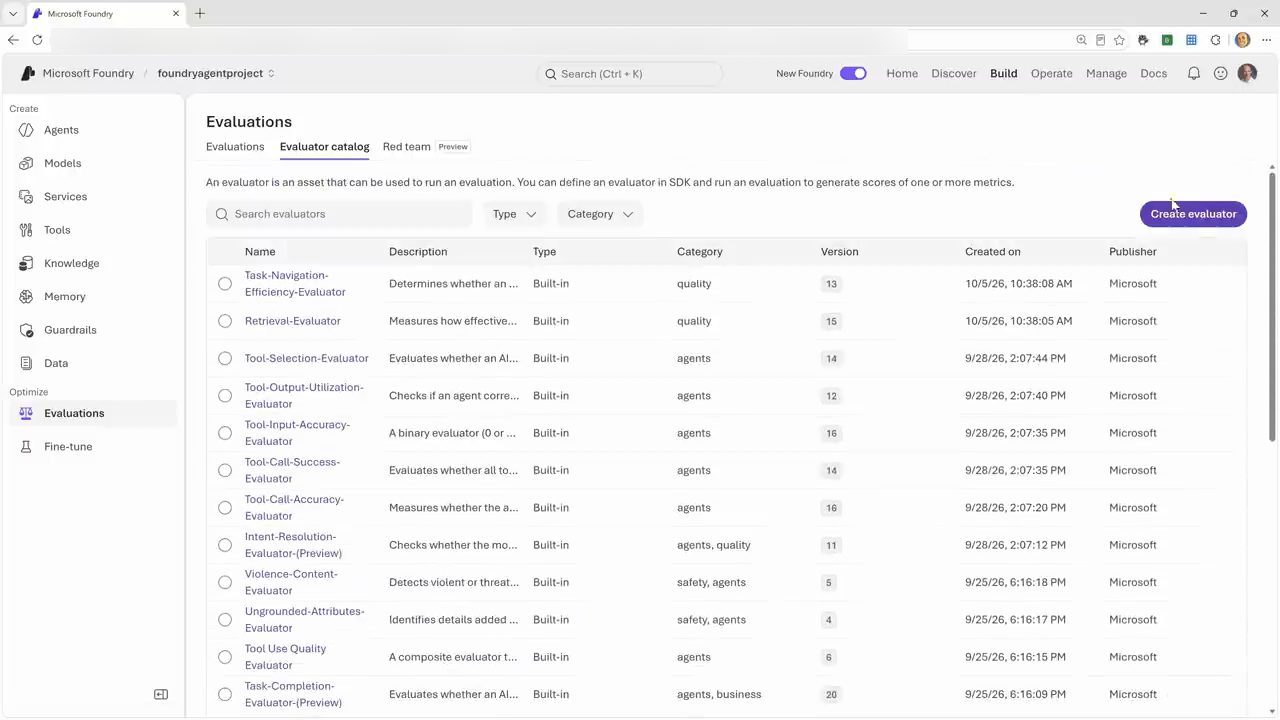
Theo John (video đăng ngày 26/10/2026), evaluator đó có thể dùng trong lúc phát triển agent, nhưng rồi cũng chạy liên tục trong production dựa trên các signal ta thu thập. Vì vậy, đúng, ta muốn dựng các evaluation đó ngay từ đầu.
Anh nói việc này mạnh tới mức nó giúp ta hiểu agent đang làm gì và làm có tốt không, để mỗi khi thay đổi, ta chắc rằng agent đang cải thiện chứ không đi lùi (video đăng ngày 26/10/2026).
5. Chọn đúng mức autonomy
Khi định nghĩa các goal, John nói anh cũng phải đảm bảo mình đang dùng đúng mức autonomy. Ý anh là: theo John (video đăng ngày 26/10/2026), không phải thứ gì cũng nên là một agent non-deterministic dùng reasoning model. Nếu có những quy tắc rất rõ, một tập bước được định nghĩa rất rõ, hãy dùng một workflow deterministic. Dùng agent khi cần một mức phán đoán nào đó, khi thật sự cần một mức reasoning nào đó. Và nếu cần trách nhiệm giải trình (accountability), thì nên có một con người là một phần của quy trình.
Vậy là xong fuzzy goal. Giờ agent đã biết việc của nó và anh có thể đánh giá nó làm có tốt không. Nhưng theo John (video đăng ngày 26/10/2026), agent vẫn phải biết các dữ kiện.
6. Số 2: Bad context
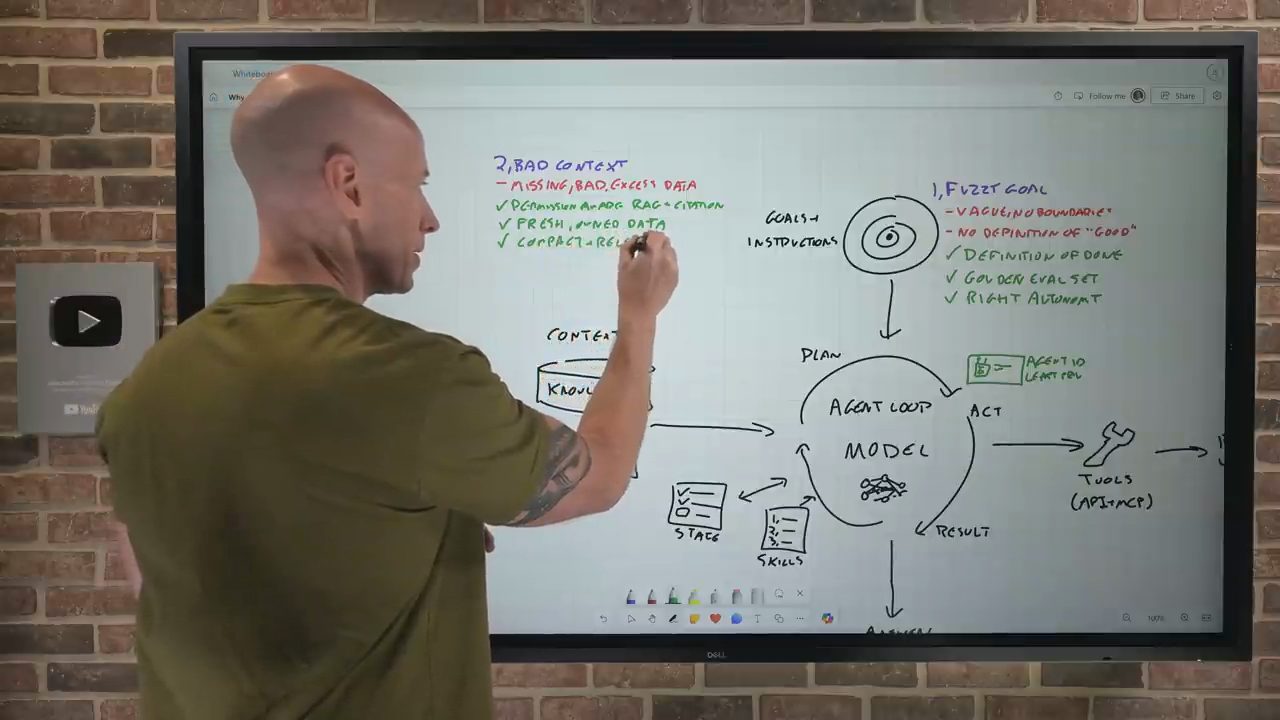
Thử thách tiếp theo, số hai, là bad context. Với ý tưởng context đã có trên bảng, John nói ở đây ta dùng khái niệm garbage in, garbage out. Theo John (video đăng ngày 26/10/2026), điều đó đúng với agent cũng như mọi thứ khác, chỉ có điều với agent, khi rác đi vào, agent sẽ rất tự tin và sáng tạo ra những bộ rác rất hoành tráng, mà có thể rất, rất khó phát hiện.
Theo anh, việc này có thể là nhiều thứ khác nhau. Có thể là thiếu dữ liệu (missing data). Có thể là dữ liệu sai (bad data). Có thể là dữ liệu cũ (stale data). Có thể là thiếu quyền truy cập dữ liệu, hoặc ngược lại agent có quyền vào quá nhiều dữ liệu, nếu dữ liệu chưa được phân quyền hay bảo vệ quyền đúng cách, hoặc agent đang chạy với sai identity: có thể đang dùng identity của một user, có thể đang dùng một identity dùng chung. Agent cũng có thể đang gửi đi quá nhiều dữ liệu không liên quan, làm phình context và theo John (video đăng ngày 26/10/2026) làm giảm chất lượng response của agent. Thiếu dữ liệu, dữ liệu sai, dữ liệu thừa: theo anh, tất cả đều là những thách thức rất lớn.
7. Cách sửa bad context
Cách giải, theo John (video đăng ngày 26/10/2026): trước hết, agent phải có identity riêng của nó. Anh nói điều này thật sự tối quan trọng, và ta sẽ thấy nó xuyên suốt video. Agent phải luôn có least privilege, tức là chỉ có quyền vào đúng những gì nó cần để làm việc. Anh vẽ một khung nhỏ cạnh agent loop ghi "AGENT ID, LEAST PRIV".
Trong mọi hành động khác nhau, anh muốn có permission-aware retrieval kèm citation, để khi agent tạo output, anh thật sự biết vì sao nó tạo ra thứ đó, vì sao nó nói như vậy. Anh tóm lại thành permission-aware RAG dựa trên identity của agent: nó chỉ lấy dữ liệu, cộng thêm citation, để anh tin vào kết quả (video đăng ngày 26/10/2026). Trên bảng anh ghi "PERMISSION AWARE RAG + CITATION".
Có đúng dữ liệu, có đúng quyền trên dữ liệu đó rồi, nhưng anh còn muốn knowledge được đối xử như một sản phẩm. Theo John (video đăng ngày 26/10/2026), dữ liệu phải có người sở hữu, có version, được làm mới. Nếu có dữ liệu cũ, nó phải được cho nghỉ hưu (retire). Anh ghi "FRESH, OWNED DATA".
Và khi context lớn dần, cần có một quy trình để compact hoặc tóm tắt khi cần. Theo anh (video đăng ngày 26/10/2026), chỉ nên gửi đúng phần context thật sự cần, và ít hơn thì tốt hơn. Anh nói ta thấy điều này ở nhiều năng lực về knowledge, nơi chỉ phần dữ liệu liên quan và sát nhất được gửi đi. Với web, hãy gửi đoạn văn của trang chứ không gửi cả trang. Vì vậy ý tưởng compaction và chỉ gửi phần cần là tối quan trọng. Anh ghi "COMPACT + RELEVANT": khi gửi dữ liệu, hãy giảm bớt, chỉ gửi những thứ thật, thật sự quan trọng.
Anh nhắc lại phần evals lúc trước, về việc đánh giá goal và hiểu tốt trông thế nào. Theo John (video đăng ngày 26/10/2026), cũng có các eval cho những thứ như groundedness và chất lượng retrieval, để đo chất lượng của những gì ta đang làm. Anh quay lại Foundry một chút, gõ tìm "retr" trong evaluator catalog, và trên màn hình hiện ra các retrieval evaluator khác nhau, cùng Groundedness-Evaluator (demo trong video đăng ngày 26/10/2026). Nhờ đó khi tạo output, anh kiểm được nó có thật sự dựa trên knowledge đúng hay không. Theo anh, đó là một trong những thứ lớn giúp tránh để hallucination lọt qua. Trên bảng, anh thêm dòng "GROUNDEDNESS EVAL".
8. Số 3: Tool misfires
Vậy là agent biết việc, có dữ kiện. Giờ nó phải thật sự làm một việc gì đó. Số ba trong danh sách là phần tooling: tool misfires. Theo John (video đăng ngày 26/10/2026), chỗ này bị hỏng theo các kiểu: agent chọn sai tool, hoặc gọi đúng tool nhưng sai tham số, hoặc tool lỗi mà agent cứ tiếp tục như thể nó đã chạy được. Anh ghi lên bảng "WRONG TOOL/PARAM" và "SILENT FAILURES".
Theo anh (video đăng ngày 26/10/2026), chuyện này hay xảy ra khi ta nhồi cho agent quá nhiều tool, khi các tool chồng lấn nhau, làm những việc rất giống nhau, hoặc được mô tả kém. Anh nói MCP giúp giải quyết một phần chuyện này, nhưng chỉ một phần: nếu tác giả MCP server làm kém thì mô tả kém vẫn sẽ phản ánh vào đó. Nếu ta đưa agent tới nhiều tool và MCP server khác nhau, nó vẫn sẽ có sự chồng lấn ấy.
Vì vậy một việc có thể nghĩ tới là có ít tool hơn, sắc hơn (fewer, sharper tools), không chồng lấn nhau; gộp chúng lại nếu cần. Ngoài ra, nếu tool có schema lỏng lẻo, anh không muốn input dạng free text. Theo John (video đăng ngày 26/10/2026), ta muốn tham số có kiểu (typed) và được validate. Anh ghi "GOOD DESCRIPTIONS" và "TYPED SCHEMAS", kèm kết quả trả về rất rõ: tool nên trả về lỗi cụ thể, không chỉ là đoạn text mà model có thể hiểu sai hoặc bỏ qua.
Ta cũng có thể giúp giải quyết chuyện này thay vì bắt từng agent tự xử lý: có một governed gateway cho tool. Theo John (video đăng ngày 26/10/2026), với gateway đó việc xác thực, logging, retry sẽ nhất quán. Các thực hành thông thường như circuit breaker pattern, tránh lỗi dây chuyền (cascading failure), vẫn áp dụng. Và hãy evaluate cả việc dùng tool: theo anh, cũng có các evaluator cho việc chọn tool, độ chính xác khi gọi tool, input của tool. Anh nói ý tưởng governed gateway khi dùng tooling là rất hữu ích ở đây.
Thế là ta đã có việc rõ ràng, đúng dữ kiện, tool đáng tin cậy.
9. Số 4: Bad reasoning
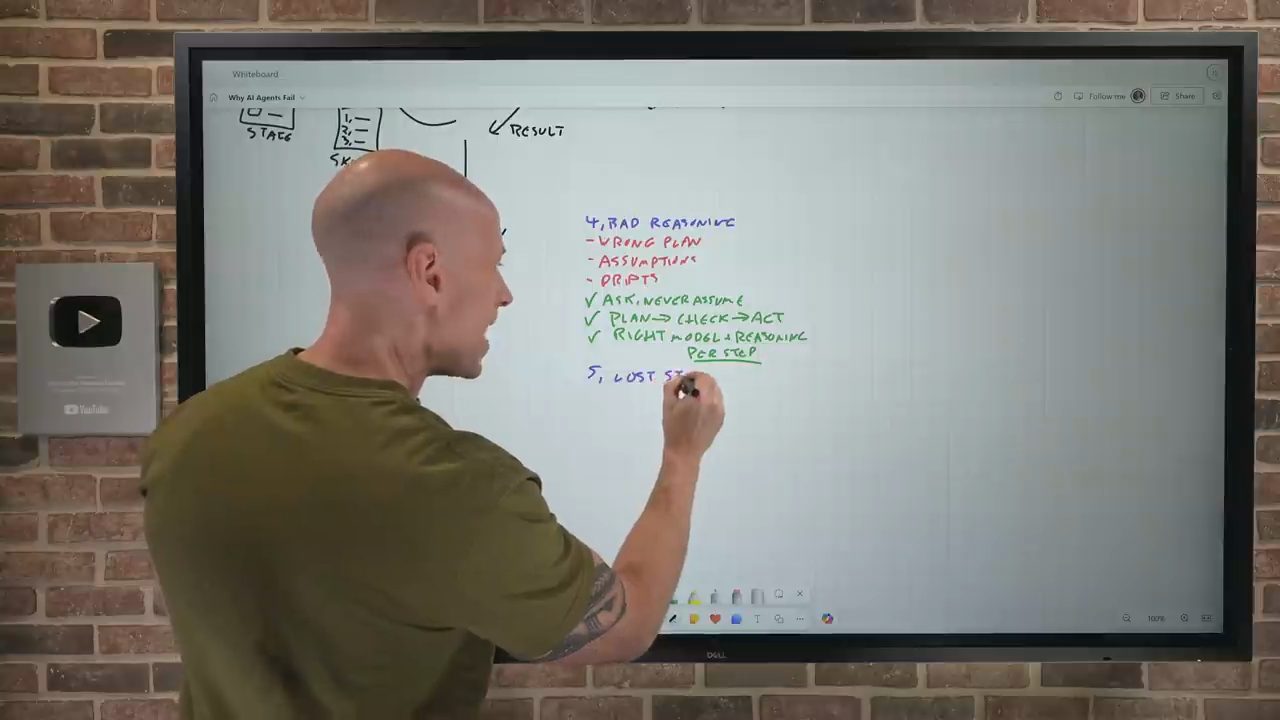
Giờ John nhìn vào cái hộp mà anh nói thường không phải là vấn đề: chính model. Số bốn là bad reasoning: model tự xoáy vòng (spirals) và không làm điều ta mong đợi (video đăng ngày 26/10/2026).
Anh nhắc lại lúc trước mình đã nói model chỉ là một hộp, một phần của hệ thống, và đúng là như vậy. Nhưng theo John (video đăng ngày 26/10/2026), đó là một hộp thật sự quan trọng, và nó có thể hỏng. Bad reasoning có thể trông như nhiều thứ khác nhau. Agent lập một kế hoạch thật ra không khớp với bài toán. Có thể nó đoán trong khi lẽ ra nó nên hỏi. Theo anh, xưa nay các model được thưởng cho việc đưa ra phản hồi, ra một output, nên chúng sẽ thiên theo cách chúng được thưởng. Ta phải thay đổi điều đó, phải nói rằng: "này, hỏi lại là được". Agent cũng có thể đi lạc khỏi nhiệm vụ: nó lập luận ra một câu trả lời, rồi đi làm một việc hoàn toàn khác.
Và nếu xét rằng nhiều nhiệm vụ có nhiều bước, có kế hoạch, thì theo phép tính John đưa ra trong video (đăng ngày 26/10/2026): nếu mỗi bước đúng 95% và có 20 bước, các lỗi đó cộng dồn (compound). Có thể anh chỉ đúng 36% số lần với một việc 20 bước mà mỗi bước đúng 95%. Đó là một thách thức.
10. Hỏi thay vì đoán, plan rồi check rồi mới act
Trên bảng, cạnh "4. BAD REASONING", anh ghi các vấn đề: kế hoạch sai (WRONG PLAN), agent tự giả định (ASSUMPTIONS), và nó trôi dần theo thời gian (DRIFTS) (video đăng ngày 26/10/2026).
Theo John (video đăng ngày 26/10/2026), ta cần đảm bảo instruction và tuning bắt agent phải hỏi câu hỏi làm rõ khi có điểm mơ hồ, và đưa các case mơ hồ vào golden eval set. Anh muốn agent được phép nói "tôi không chắc", cho nó một đường escalation, và chấm một lần handoff là đạt (pass) với những case mà nó không nên tự trả lời một mình. Anh ghi "ASK, NEVER ASSUME": cứ để nó hỏi, đừng bao giờ giả định, và việc đó không phải là thất bại.
Khi agent lập kế hoạch, hãy đảm bảo kế hoạch được kiểm tra rồi mới hành động. Anh có thể thêm một bước checker. Theo John (video đăng ngày 26/10/2026), với Microsoft Agent Framework và các framework khác, những pattern này thật sự dễ dựng: một planner và một reviewer. Anh ghi "PLAN → CHECK → ACT": plan, rồi check, chỉ khi đó mới thật sự act.
Và đúng, hãy dùng đúng model, đúng độ sâu reasoning cho từng bước, chứ không chọn một mẫu số chung cao nhất cho tất cả các bước. Theo John (video đăng ngày 26/10/2026), việc đó lãng phí tiền, nhưng nó còn có thể thật sự dẫn tới output sai. Anh hỏi: bạn đã bao giờ nghĩ quá nhiều về một chuyện chưa? Có thể câu trả lời đầu tiên của anh là đúng, rồi càng nghĩ anh càng đi tới chỗ sai. Hãy khớp model và độ sâu reasoning với từng bước.
Cụ thể, theo anh: một reasoning model với reasoning effort cao hơn cho việc lập kế hoạch và các edge case, một model nhỏ hơn cho các bước thường lệ hơn. Anh nói đó là lý do Foundry có một model router (theo video đăng ngày 26/10/2026): nó giúp bạn chọn model. Anh ghi "RIGHT MODEL + REASONING PER STEP", gạch chân "PER STEP", và nói đó là một phần cực kỳ quan trọng.
11. Số 5: Lost state
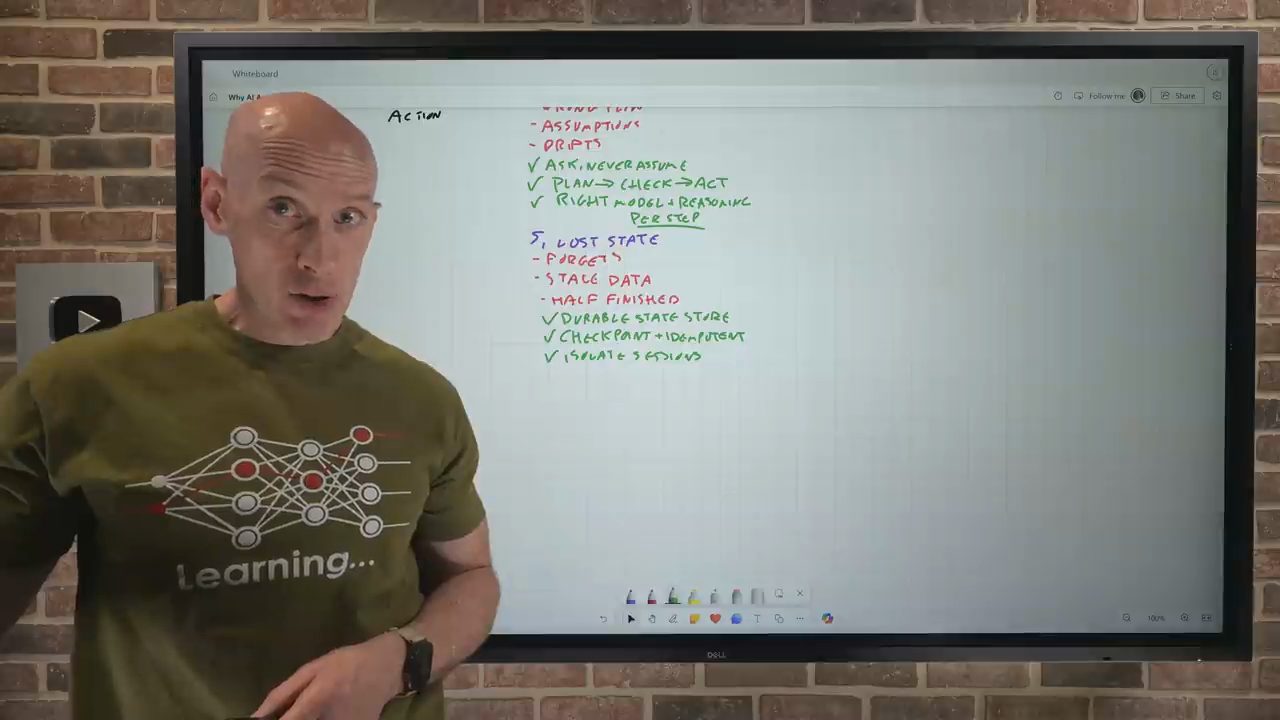
Vậy là giờ mỗi bước đều chắc chắn. Nhưng theo John (video đăng ngày 26/10/2026), một nhiệm vụ dài có thể gồm hàng chục bước, và agent phải nhớ nó đang ở đâu. Số năm là lost state, và theo anh đây đặc biệt là vấn đề cắn vào những agent chạy dài.
Anh nhắc: context là những gì model đang nhìn thấy lúc này. Còn state là bản ghi của hệ thống về cái gì là đúng, cái gì đã xong, cái gì đang chờ, cái gì đã được làm ngoài thế giới thật. Theo John (video đăng ngày 26/10/2026), khi hai thực tại đó trôi lệch nhau, agent sẽ thất bại.
Theo John (video đăng ngày 26/10/2026), kết quả rất phổ biến là agent lặp lại một bước đã được làm rồi. Nó có thể quên một quyết định đưa ra trước đó. Nó hành động dựa trên một trạng thái từ quá khứ mà sau đó đã thay đổi. Hoặc trường hợp xấu nhất, nó dừng giữa chừng. Anh lấy ví dụ: hãy tưởng tượng agent đã hoàn tiền (refund) nhưng không ghi log, hoặc không gửi email, rồi nó làm lại, và thế là hoàn tiền hai lần. Trên bảng, các vấn đề là FORGETS, STALE DATA, HALF FINISHED.
Theo John (video đăng ngày 26/10/2026), phần mấu chốt để giải là: đừng giữ state trong prompt. Anh nói đó thật sự là phần quan trọng nhất. Anh muốn một durable state store: đừng chỉ để state quan trọng nằm trong prompt, hãy để nó trong một state store mà hệ thống sở hữu, rồi mỗi lượt hệ thống đưa cho model một bản tóm tắt ngắn.
Theo John (video đăng ngày 26/10/2026), hãy checkpoint công việc và gán cho mỗi hành động một ID để một lần retry không thể xảy ra hai lần. Làm cho các lần retry trở nên idempotent. Anh ghi "CHECKPOINT + IDEMPOTENT": nếu có làm lại thì cũng không thành vấn đề.
Và theo anh (video đăng ngày 26/10/2026), cần nghĩ tới isolation: cô lập các session, để context của một khách hàng không bao giờ có thể tràn sang khách hàng khác. Anh nói mình luôn muốn isolation mạnh như vậy, và ghi "ISOLATE SESSIONS".
12. Số 6: Hijack và overprivileged
Tới đây anh đã giải được nhiều thứ: agent làm đúng việc, có đúng dữ kiện, tool đáng tin cậy, reasoning chắc chắn, theo dõi được nó đang ở đâu. Nhưng theo John (video đăng ngày 26/10/2026), một agent có giá trị sẽ khiến nó trở thành mục tiêu.
Vì vậy ở số sáu, người ta sẽ cố hijack agent của ta, và theo anh, chuyện này càng nặng thêm nếu agent bị cấp quá nhiều quyền (overprivileged). Anh ghi "6. HIJACK + OVER PRIV". Kiểu tấn công này có nhiều dạng. Một trong những dạng ta nghe nhiều nhất là prompt injection (video đăng ngày 26/10/2026).
Nó có thể là gián tiếp. Theo John (video đăng ngày 26/10/2026), thứ hiện rất phổ biến là agent truy cập một trang web, một mẩu dữ liệu, hoặc có một email được gửi tới, và bất kể nội dung đó là gì, bên trong có những instruction ẩn. Kẻ tấn công cố đưa nó vào context. Đó là nội dung agent không tự viết ra, và nó thậm chí có thể đến từ một tool bên thứ ba, một MCP server. Anh vẽ một tờ giấy màu đỏ ghi "HIDDEN INSTRUCTIONS" đi vào phía context, và nói các instruction ẩn này là một rủi ro rất lớn.
Ngoài prompt injection, anh nhắc lại identity của agent đã nói lúc trước: chuyện quyền truy cập thừa (EXCESS ACCESS). Với con người, theo anh, từ lâu lắm rồi, nhất là ngày nay với zero trust, lúc nào cũng là least privilege. Theo John (video đăng ngày 26/10/2026), điều tối quan trọng là agent không nên dùng credential của một người, cũng không nên dùng một credential dùng chung, vì khi đó nó sẽ có tổng mọi quyền cần cho tất cả những thứ đang dùng credential đó. Anh phải nghĩ tới việc agent có identity riêng, và chỉ được cấp quyền vào đúng những tool và knowledge nó cần để làm việc.
Anh cũng nhắc lúc trước có nói tới việc xin con người đồng ý. Theo anh (video đăng ngày 26/10/2026), nếu làm việc đó quá nhiều thì sự mệt mỏi sẽ xuất hiện, và người ta sẽ chỉ bấm "ừ, đồng ý". Anh lấy ví dụ các bản Windows đời đầu, anh không nhớ có phải Windows Vista không, có User Access Control khi bạn cố dùng quyền admin, nhưng nó hỏi liên tục, nên bạn cứ bấm yes. Anh nói mình không thể để chuyện đó xảy ra.
13. Prompt shield, spotlighting, guardrail và red teaming
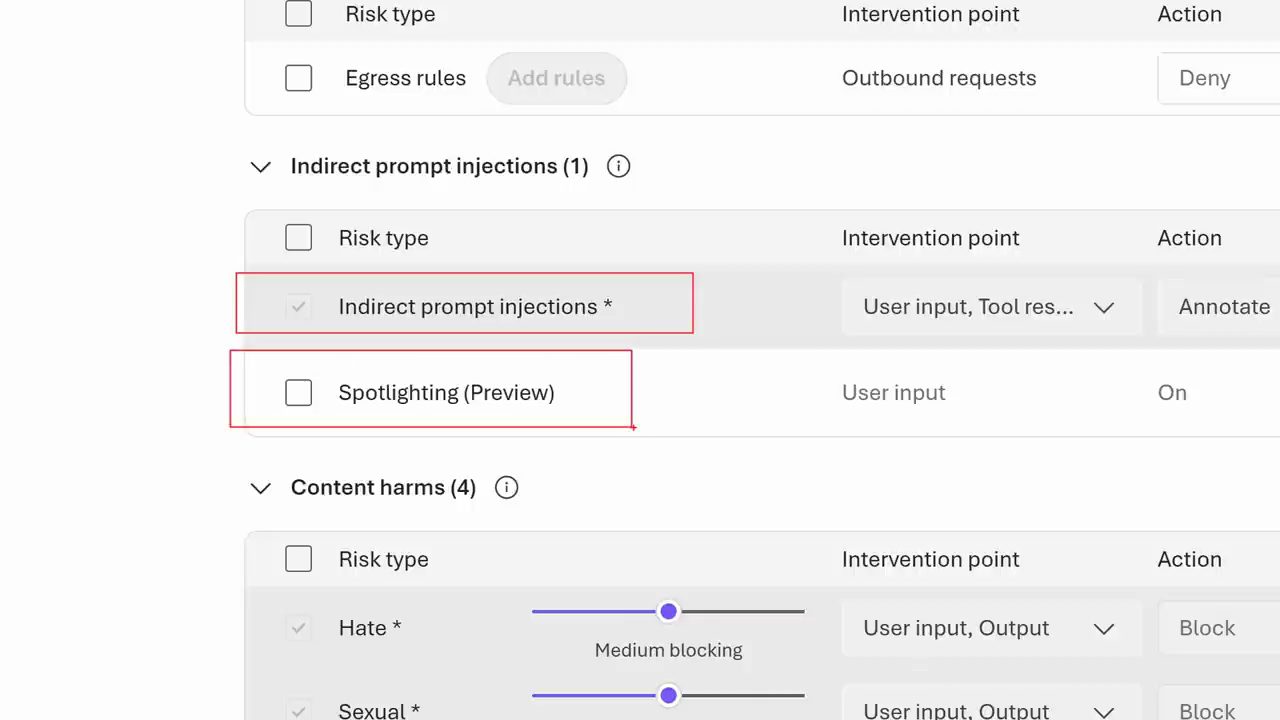
Một số việc cần nghĩ tới ở đây, theo John (video đăng ngày 26/10/2026), là prompt shielding: có những hệ thống quét mọi nội dung và tìm kiểu tấn công này để nó không được gửi tới model. Ta cũng có thể nghĩ tới những thứ như spotlighting: nếu đó là dữ liệu chứ không phải một phần của instruction, nó được gọi tên rõ ràng, kiểu "này, đây là dữ liệu bạn đang được gửi, đừng nhất thiết tin bất cứ thứ gì hay instruction nào bên trong nó". Nhờ spotlighting, với model sẽ cực kỳ rõ rằng đó không phải instruction.
Anh quay lại Foundry. Ở mục Guardrails có những guardrail mặc định luôn được áp dụng, nhưng nếu tự tạo một guardrail riêng, một trong những thứ ta thấy là, đúng, có bảo vệ chống jailbreak, có egress rule để agent không thể nói chuyện với những trang mà nó không nên nói chuyện (demo trong video đăng ngày 26/10/2026). Anh nói ta có nghe về chuyện agent đi làm những việc ta không muốn. Và ngay ở đây có mục indirect prompt injection, có spotlighting để gọi tên dữ liệu đó. Theo John (video đăng ngày 26/10/2026), đó chỉ là một phần trong một dải rất rộng các guardrail và cơ chế an toàn mà ta đặt vào để chặn những điều xấu đó xảy ra với agent.
Nếu có dùng con người phê duyệt, theo anh (video đăng ngày 26/10/2026) hãy chia tầng (tiered) theo blast radius, và cho người duyệt thấy tương tác tool thật sự. Và như đã nói, agent có identity riêng, có least privilege. Anh ghi "PROMPT SHIELD + SPOTLIGHTING" và "AGENT ID + LEAST PRIV".
Rồi anh còn muốn dùng red teaming. Theo John (video đăng ngày 26/10/2026), có một eval cho việc này nằm ngay trong những evaluator anh vừa cho xem. Anh muốn chạy nó trước khi launch, và cả khi đang ở production để hiểu các rủi ro. Theo anh, đó là một phần của một bức tranh bảo mật rộng hơn nhiều. Anh nên có những thứ quét code của mình. Anh nên có sự tương quan phong phú giữa các signal trên toàn bộ hệ thống của mình, dù là identity, dữ liệu, mạng, các lời gọi, mọi thứ đang diễn ra. Anh muốn gom tất cả signal đó lại, hiểu các mối đe doạ mới nhất (theo video đăng ngày 26/10/2026), để phát hiện sự cố và chặn chúng. Anh muốn phân tích mối đe doạ liên tục, tương quan với trạng thái tài nguyên của bạn, và giúp giảm thiểu. Anh gọi chúng là những thứ tối quan trọng, nhưng hãy có red teaming, và theo anh nó lại là một phần có sẵn trong đó (video đăng ngày 26/10/2026). Anh ghi "RED TEAMING".
14. Số 7: Flying blind
Đến đây đã làm được rất nhiều. Kiểu thất bại cuối cùng John muốn nói tới là: agent rất tốt lúc launch, nhưng nó lặng lẽ xuống cấp. Có thể nó vẫn chạy, nhưng tốn hơn nhiều so với ta nghĩ. Về cơ bản vấn đề là ta đang bay mù: flying blind, số bảy (video đăng ngày 26/10/2026).
Theo John (video đăng ngày 26/10/2026), agent không deterministic. Anh nhắc: về cơ bản chúng là một cỗ máy dự đoán trên một phân phối xác suất. Cùng một câu hỏi có thể đi những con đường khác nhau. Câu trả lời hôm nay có thể không phải câu trả lời ngày mai.
Và hãy nhìn mọi thứ xung quanh model: thế giới quanh chúng đang thay đổi. Có thể model được cập nhật. Có thể một API thay đổi. Ai đó sửa một policy. User bắt đầu hỏi những thứ mới. Theo John (video đăng ngày 26/10/2026), rất nhiều khi drift diễn ra rất im lặng. Thử thách ở đây là drift, và theo thời gian có thể có cost creep: agent dần dần đắt hơn. Rồi chỉ còn câu "ừ thì, nó đã chạy được, trong demo". Trên bảng: DRIFT, COST CREEP, "WORKED IN DEMO".
Theo anh (video đăng ngày 26/10/2026), cách duy nhất để xử lý là: với mọi thứ ta làm, phải truy vết được từng bước. Anh nói mình quên vẽ cho mục này, rồi vẽ một hình nhỏ mà anh nói đáng lẽ là một tấm khiên (shield) để bảo vệ mình. Nhưng tất cả những thứ này, mọi thành phần, mọi khía cạnh: state store, skills, những gì đang chạy, những gì đi vào, mọi lời gọi tool, mọi thứ đang diễn ra, cuối cùng đều phải đi tới ý tưởng observability. Anh muốn thấy được từng bước. Anh vẽ thêm một con mắt và chữ "EVERY STEP", rồi nói câu "Every step you make, I'll be watching you", và nói đó không phải điều anh định ý.
Nhưng rõ ràng là anh muốn truy vết được mọi bước đang xảy ra: mọi lời gọi prompt, mọi lời gọi model, mọi lời gọi tool, mọi token, chi phí. Có observability đầy đủ. Trên màn hình Foundry lúc này là một trace của một agent tên contract-policy-expert, liệt kê từng span với thời lượng (demo trong video đăng ngày 26/10/2026).
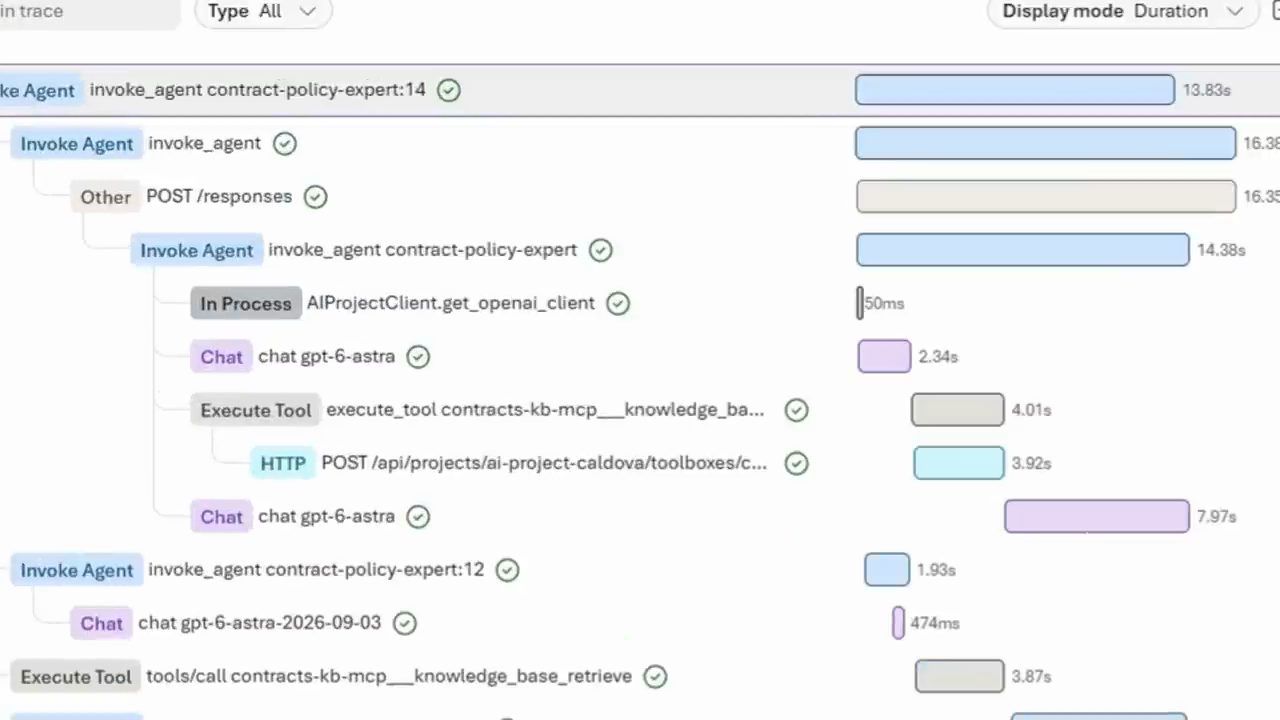
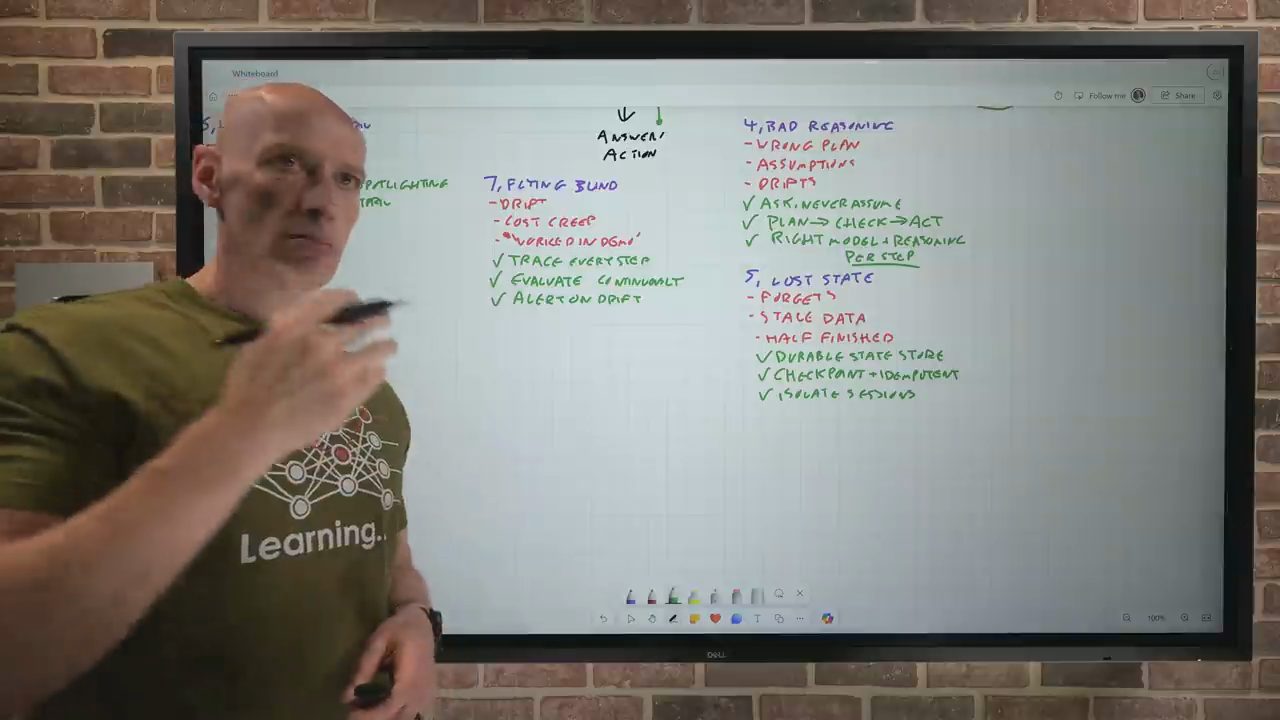
Các evaluation từ lúc trước, theo John (video đăng ngày 26/10/2026), sẽ chạy trên live traffic, trên mọi signal ta thu thập. Vậy ý tưởng ở đây là truy vết mọi bước (TRACE EVERY STEP) và evaluate liên tục (EVALUATE CONTINUOUSLY), không chỉ lúc tạo agent mà theo cách liên tục. Anh nói điều đó mạnh vì nó cho phép ta hoán đổi, thay đổi mọi thứ và thấy: nó đang tốt lên hay tệ đi, đắt hơn hay rẻ hơn.
Theo John (video đăng ngày 26/10/2026), ta cảnh báo (ALERT ON DRIFT) với bất kỳ loại drift nào: chất lượng giảm, chi phí tăng, latency tăng. Nhờ đó ta có một hiểu biết rất mạnh về những gì đang diễn ra trong môi trường.
15. Mỗi thứ phát ra một signal, đi kèm một lever
John nhắc lại lúc đầu anh có nói chuyện này còn nhiều hơn là chỉ giảm thất bại. Và đây, theo anh, là điều tuyệt nhất. Đúng, ta đang cố giúp agent tránh thất bại, một trăm phần trăm, đó là một mục tiêu then chốt. Nhưng theo John (video đăng ngày 26/10/2026), tất cả những thứ này, từng việc ta làm ở đây, đều phát ra một signal: một signal anh đo được, và đi kèm là một lever (cần gạt) tương ứng mà anh có thể kéo.
Anh đi lại từng mục:
- Fuzzy goal: đo mức hoàn thành nhiệm vụ so với định nghĩa xong và tốt của bạn; lever là thay instruction, thay evaluator (video đăng ngày 26/10/2026).
- Bad context: có groundedness detection; lever là chỉnh knowledge (video đăng ngày 26/10/2026).
- Tools: có độ chính xác của tool; lever là mô tả tool, anh có thể cập nhật chúng (video đăng ngày 26/10/2026).
- Reasoning: intent resolution và việc kế hoạch có đứng vững không; lever là model, độ sâu reasoning (video đăng ngày 26/10/2026).
- State: có bước nào bị lặp không, reset ở đâu, dữ liệu cũ ở đâu; lever là state store, các checkpoint (video đăng ngày 26/10/2026).
- Security: số cuộc tấn công bị chặn; lever là các policy và các bài test red teaming (video đăng ngày 26/10/2026).
- Flying blind: drift, chi phí, ROI; lever là độ phủ của evaluation (video đăng ngày 26/10/2026).
Theo John (video đăng ngày 26/10/2026), với mọi thứ đã làm ở đây, có thứ để đo và có lever để kéo. Và những signal ta thu thập để quan sát agent đó, anh thật sự có một mục tiêu là dùng chúng để cải thiện agent.
16. Improvement loop: observe, evaluate, improve, gate, deploy
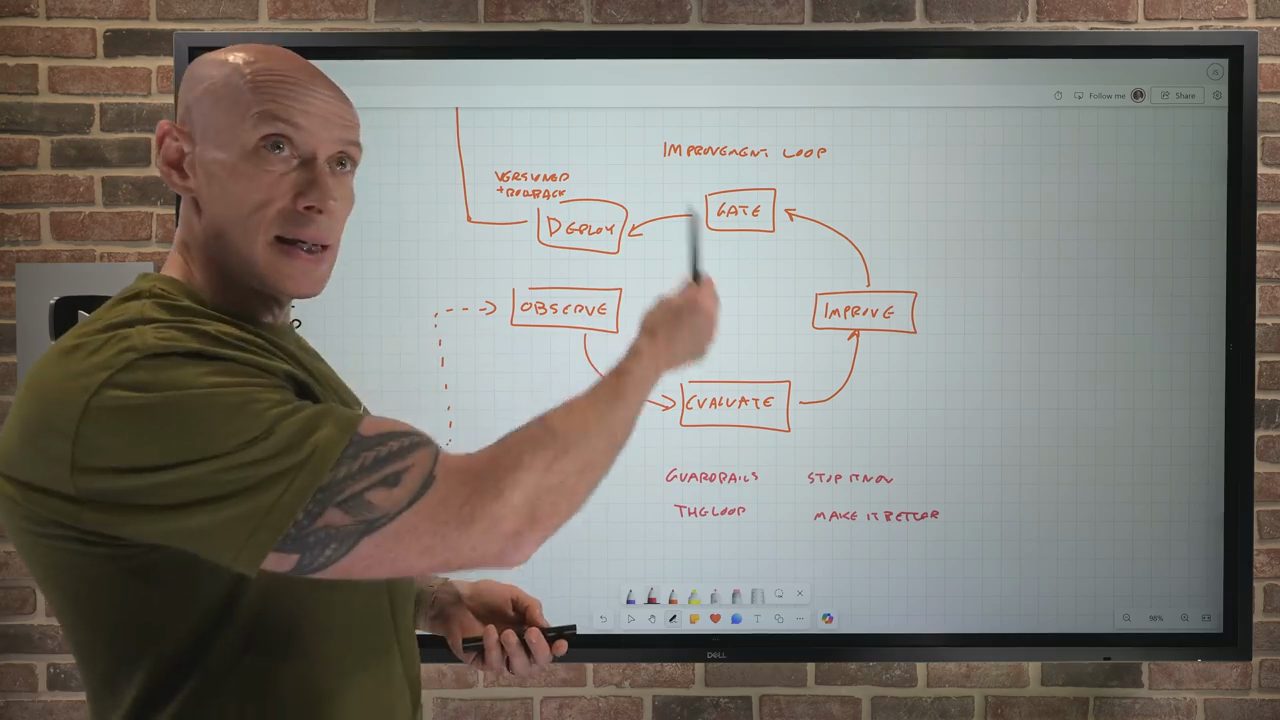
John nói anh sẽ đổi màu bút, và lấy chính những signal đó dựng thành một vòng lặp mới: improvement loop, vẽ bằng mực cam.
Bước đầu là observe: theo John (video đăng ngày 26/10/2026), ta quan sát các production trace, feedback, các lần chạm guardrail. Ta có thể biến trace thành test case, nhờ đó eval của ta, cái golden set đó, lớn lên theo thực tế.
Rồi tất nhiên là evaluate: chấm điểm bằng cùng những evaluator đó cho mọi phân đoạn, rồi gom cụm các thất bại, tìm những pattern đáng sửa. Từ đó dẫn tới improve, nhưng mỗi lần một thứ. Theo John (video đăng ngày 26/10/2026), ta thay một lever mỗi lần. Có thể là thay instruction, có thể là thay rubric, có thể là thay nguồn knowledge, các tool, mô tả tool; thay model, độ sâu reasoning; có thể fine-tune một model; có thể thay state store, checkpoint, policy, các bài test red team, độ phủ evaluation. Dù là gì thì cũng mỗi lần một thứ.
Làm những việc đó xong, anh đi tới một gate, và theo anh (video đăng ngày 26/10/2026) điều này tối quan trọng. Anh có cả một bộ regression suite đầy đủ, các case red team, chạy trong pipeline phát triển liên tục, pipeline CI/CD của anh. Anh muốn đảm bảo không có regression, và một con người sẽ phê duyệt việc promote.
Sau đó dĩ nhiên là deploy. Theo John (video đăng ngày 26/10/2026), các lần deploy này có version, có rollback, và chúng quay ngược vào toàn bộ agentic loop của anh. Trên bảng, một mũi tên từ DEPLOY ("VERSIONED + ROLLBACK") vòng ngược về phía agent loop. Anh liên tục cải thiện.
Ngay lúc đó John dừng lại: anh nói anh không biết cái đó từ đâu ra, nó làm anh phát điên, và nói đã có một bản update nào đó. Rồi anh tiếp tục (video đăng ngày 26/10/2026): dù sao thì toàn bộ mục tiêu ở đây là có một improvement loop, những cải thiện nhỏ, liên tục.
Theo John (video đăng ngày 26/10/2026), anh có thể làm tất cả những việc này trong Foundry. Anh đã cho xem vài mẩu, nhưng anh nói tất cả đều thật sự làm được, kể cả theo kiểu low code với Copilot Studio. Anh nhắc lúc trước đã nói thất bại cộng dồn, nhưng ta biết cải thiện cũng cộng dồn. Theo anh, mỗi tuần tốt hơn một chút là cách anh đã thấy mọi thứ đi từ một bản demo tới những production agent mà doanh nghiệp có thể tin tưởng.
17. Hai lưu ý để không học sai bài
Nhưng có hai lưu ý, vì anh đã nói hai điều khác nhau và không muốn chúng bị lẫn vào nhau, hay để người xem rút ra sai bài học.
Thứ nhất, theo John (video đăng ngày 26/10/2026), vòng lặp cải thiện liên tục này không thay thế guardrail. Guardrail, về cơ bản, là "tôi muốn chặn một thứ ngay bây giờ". Có thể hình dung trong logic của anh: chặn một lần hoàn tiền sai cho request này. Còn vòng lặp ta đang nói là để làm cho mọi thứ tốt lên theo thời gian, để ngay từ đầu ta không rơi vào tình huống hoàn tiền sai đó. Theo anh, bạn cần cả hai. Trên bảng: GUARDRAILS, STOP IT NOW; THE LOOP, MAKE IT BETTER.
Thứ hai, như anh đã chỉ rõ ở bước gate: cải thiện liên tục không có nghĩa là agent tự viết lại chính nó trong production. Theo John (video đăng ngày 26/10/2026), khi đó một memory bị đầu độc (poisoned memory) sẽ trở thành hành vi vĩnh viễn. Mọi cải thiện đều đi qua gate, và con người promote nó, nên ta có một chuỗi cải thiện rất có chủ đích.
Theo anh (video đăng ngày 26/10/2026), có những năng lực trong Foundry cho việc này: các agent optimizer dựng sẵn sẽ giúp bạn làm những việc đó, cho thấy các phương án có thể, rồi phương án mà nó khuyến nghị promote.
18. Tổng kết: nếu chỉ làm một việc, hãy làm evaluation
John nói anh hy vọng khi nhìn lại tất cả, dù có rất nhiều thứ trên bảng, câu hỏi vì sao agent thất bại có câu trả lời như sau, theo anh (video đăng ngày 26/10/2026): ta có fuzzy goal. Ta có bad context. Ta có tool bắn trượt. Ta có reasoning không ai kiểm tra. Ta mất dấu state. Agent bị hijack hoặc có quá nhiều quyền. Ta bay mù. Anh nhắc lại: chỉ một trong số đó là về chính model, và ngay cả lý do đó, phần lớn bạn sửa bằng cách thay đổi hệ thống bao quanh nó.
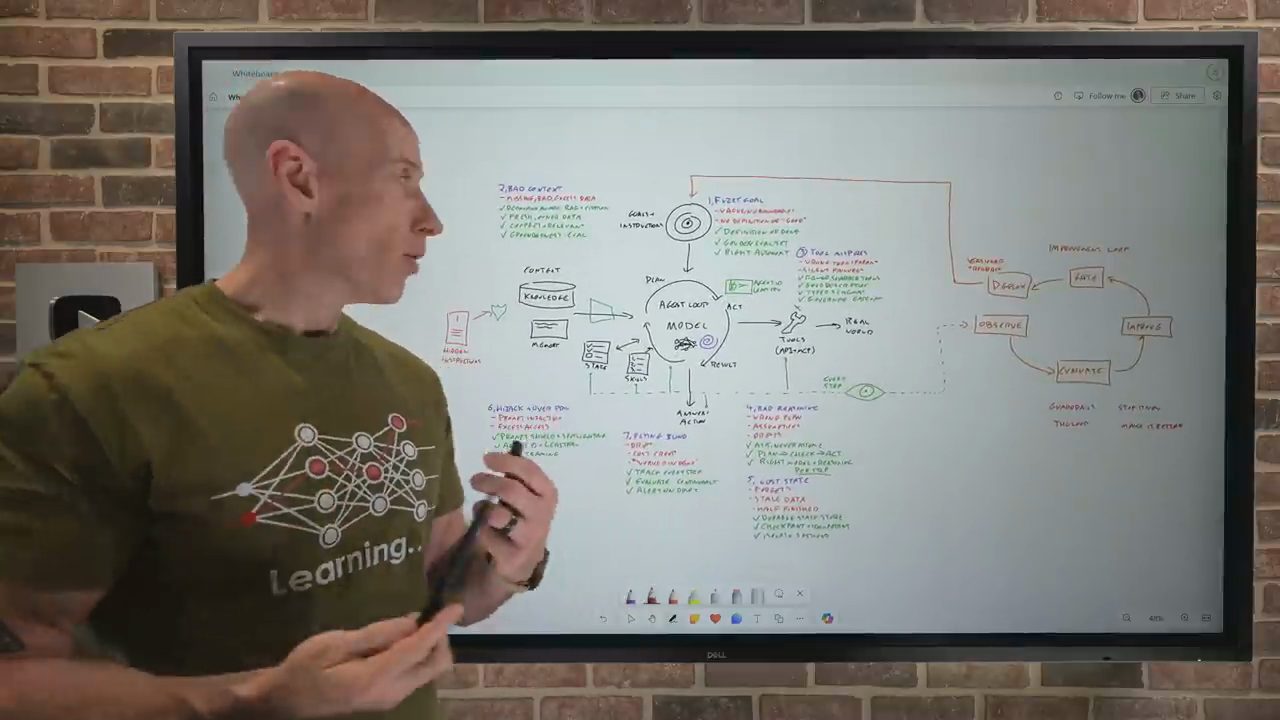
Nếu phải nói làm một việc, nếu bạn chỉ mang một điều về từ video này, theo John (video đăng ngày 26/10/2026) đó là các evaluation. Hãy viết định nghĩa thế nào là xong, viết định nghĩa tốt trông thế nào, biến chúng thành golden set các test case. Theo anh, chỉ một artifact đó sẽ cấp năng lượng cho hầu hết mọi thứ trên bảng này, từ lần evaluation đầu tiên khi bạn đang test, tới production, tới toàn bộ improvement loop.
Anh nói hy vọng video hữu ích, và chào mọi người.
Nguồn và liên kết 8 nguồn
- Tên gốc: Why do AI Agents Fail
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=xKgY5vnzjMQ youtube.com
- Kênh YouTube John Savill's Technical Training (John Savill): youtube.com/channel/UCpIn7ox7j7bH_OFj7tYouOQ youtube.com
- Microsoft Learn, Agent Evaluators trong Microsoft Foundry (các evaluator cho agent như intent resolution, tool call accuracy, task completion; đọc ngày 31/10/2026): learn.microsoft.com/…/agent-evaluators learn.microsoft.com
- Microsoft Learn, Observability in Generative AI trong Microsoft Foundry (đọc ngày 31/10/2026): learn.microsoft.com/…/observability learn.microsoft.com
- Microsoft Learn, Model router cho Microsoft Foundry (đọc ngày 31/10/2026): learn.microsoft.com/…/model-router learn.microsoft.com
- Repo Microsoft Agent Framework, framework build và điều phối AI agent và multi-agent workflow cho Python và .NET theo mô tả repo (đọc ngày 31/10/2026): github.com/microsoft/agent-framework github.com
Related talks
20 khái niệm nền tảng để build AI agent production, kèm code
Maryam Miradi · Dr. Maryam Miradi · 26 min
20 khái niệm AI agent qua năm layer: agent loop, planning, memory, sandbox, tool retrieval, multi-agent, guardrails, eval, prompt injection, tracing, mỗi cái kèm code.
AI agent thực sự hoạt động thế nào: kiến trúc, tool, memory và MCP
Tech Architecture Explained · Tech Architecture Explained · 27 min
Theo một yêu cầu xếp lịch họp qua model, runtime, tool, memory, MCP, approval, xử lý lỗi và kiểm thử để hiểu một AI agent vận hành ra sao.
Vì sao agent bất đồng với chính nó, và nên làm gì
Diane Lin · Datadog · 26 min
Agent flip-flop là dấu hiệu của gray zone: dùng disagreement để chọn ca cho người review, rồi thêm semantic và episodic memory thay vì fine-tune.