Vì sao nên bỏ Claude Code để dùng OMP (Oh-My-Pi)
Vì sao harness quan trọng hơn model: handoff thay auto-compaction, compact ở 40%, keep-alive giữ cache ấm và role/agent tự chỉnh trong OMP.
✓ Đã duyệt độc lập · cập nhật 19/10/2026 · 12 min
1. Cùng một model, vậy khác nhau ở đâu? Ở harness
Video mở đầu bằng một câu hỏi mà một đồng nghiệp của người nói (kênh exit node) đặt ra cho anh trong ngày hôm đó: cô ấy không hiểu việc mình dùng Claude Code thì khác gì với dùng OMP (Oh-My-Pi), vì đằng nào phía sau cũng là cùng một model.
Câu trả lời của anh: chuyện không nằm ở model bạn dùng. Nó nằm ở cách những model đó được dẫn dắt (navigated), và ở mức tự do cũng như mức bạn được tiếp xúc với mọi thứ bên trong. Vì vậy, theo anh, cần nói về harness, tức lớp phần mềm bọc quanh model và quyết định model nhìn thấy công việc của bạn như thế nào.
Anh cho rằng harness bạn dùng trực tiếp nhào nặn cách bạn nhìn thế giới AI mà bạn đang sống trong đó. Cách bạn trải nghiệm agent, context, skill và mọi thứ khác gắn chặt, trực tiếp với harness. Với anh, harness là lựa chọn lớn nhất mà một người có thể đưa ra ở thời điểm này (theo video đăng ngày 14/10/2026), và anh nghĩ nó góp phần trực tiếp vào việc mỗi người có một ý kiến rất khác nhau về tương lai của ngành software engineering.
Trong video, anh nói sẽ đưa ra suy nghĩ của mình về từng điểm và hy vọng thuyết phục người xem rằng cuối cùng chỉ có một câu trả lời đúng: tự mình tìm hiểu kỹ (do your own due diligence), hiểu mình đang thay đổi cái gì và vì sao. Anh hứa rằng nếu bạn tự tay áp dụng hết những điều này, bạn sẽ thấy cải thiện ở sức khỏe tinh thần, ở niềm vui khi làm việc và ở chất lượng output bạn tạo ra.
2. Harness phổ thông được làm cho số đông
Điều đầu tiên anh muốn bàn: các harness phổ biến, gồm Codex, Claude Code, các bản desktop và những thứ tương đương, kể cả Cursor và các công cụ cùng loại, đều được làm cho đại chúng (the general public).
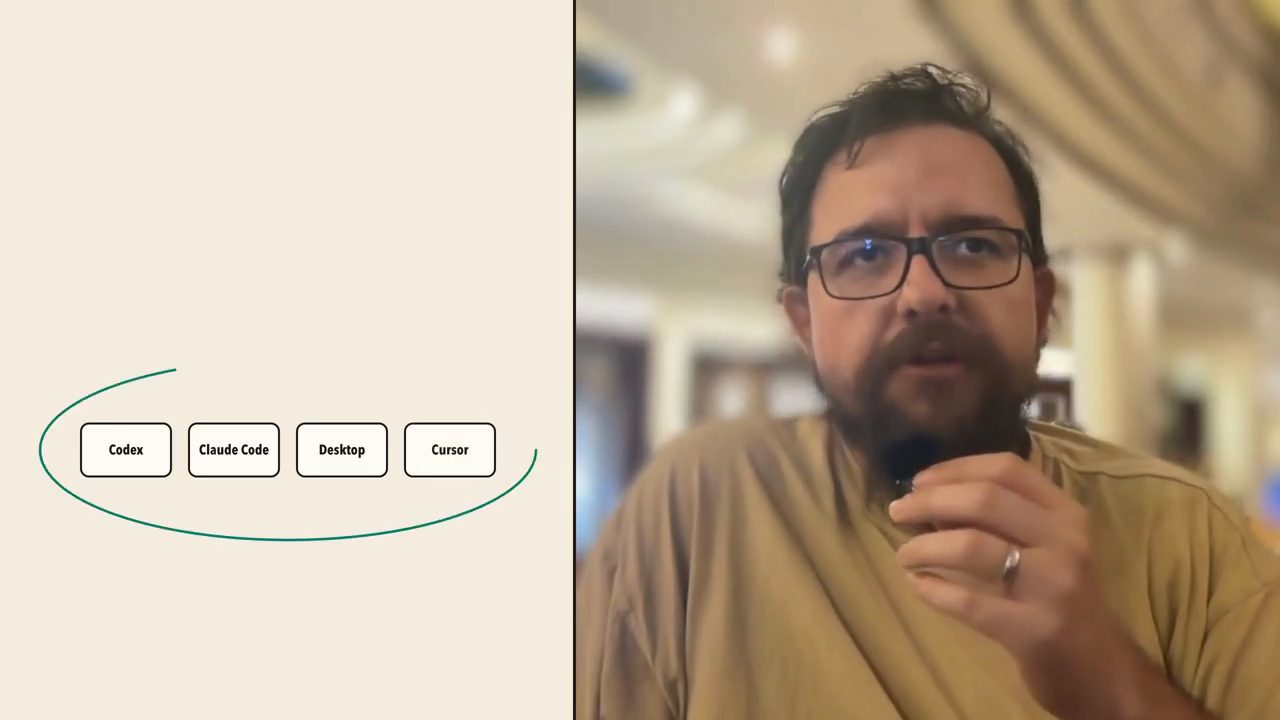
Nghĩa là mỗi harness trong số đó đang cố giải một biển vấn đề vô cùng mơ hồ, trong khi theo anh, những vấn đề ấy chỉ giải được bằng những nỗ lực tập trung cao độ, nhắm thẳng vào từng vấn đề một. Một sản phẩm phải phục vụ tất cả mọi người thì buộc phải chọn hộ bạn rất nhiều thứ.
3. Harness lo ba việc: context, message và điều phối agent
Theo anh, những vấn đề chính mà một harness giải cho bạn là: xử lý context, trao đổi message, và điều phối agent (agent orchestration). Ngoài ra còn một loạt lợi ích và phần thưởng khác, nhưng phần lớn trong số đó thì harness nào cũng có, lặp lại giữa các harness.
Thứ thật sự tạo ra khác biệt giữa một harness tốt và một harness tệ là chuyện quản lý context và cache. Anh lấy ví dụ Pi ở dạng thô (raw Pi, harness tối giản mà OMP được fork từ đó): anh cho rằng nó là một harness khá tệ cho tới khi bạn ngồi xuống và tự gắn thêm các giải pháp vào. Nó tệ vì nó không quản lý context cho bạn, và cũng không quản lý cache cho bạn.
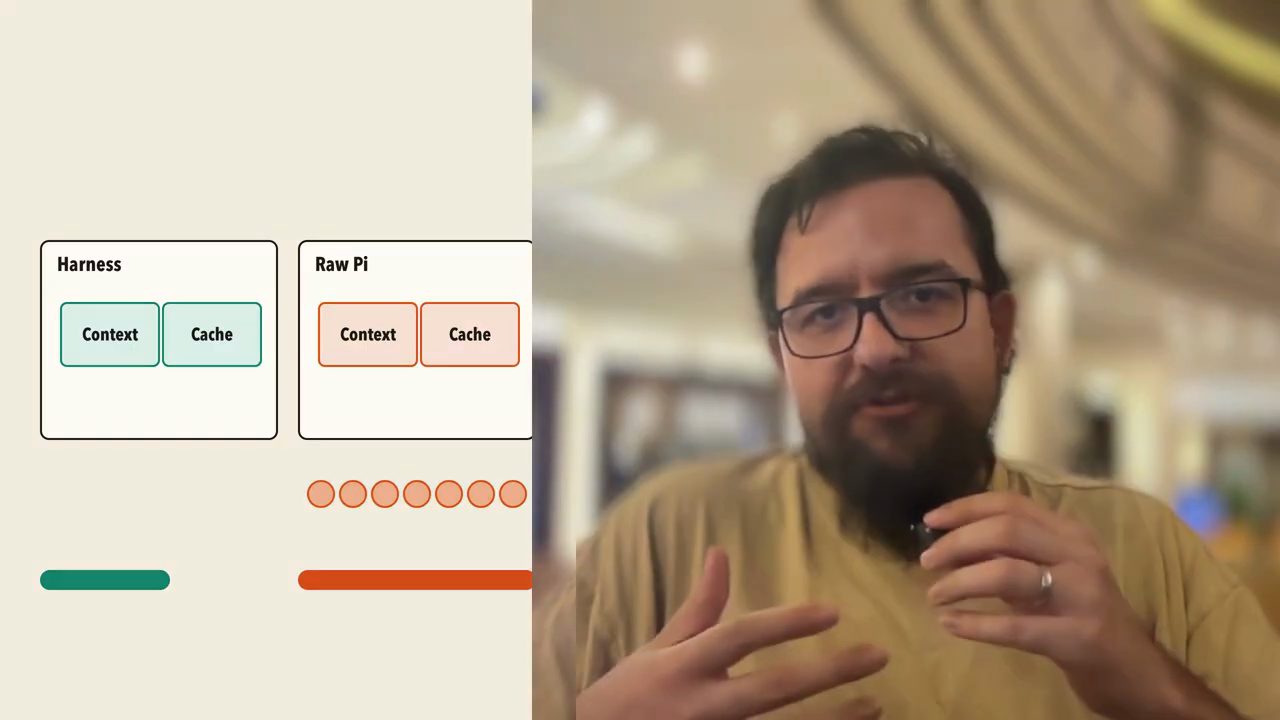
Hệ quả, theo lời anh: nó sẽ làm thủng ví của bạn và làm chậm tốc độ xử lý. Vậy rốt cuộc, làm sao ngồi xuống và giải từng vấn đề một? Phần còn lại của video lần lượt đi qua context, cache và cách tổ chức agent.
4. Compaction hay handover document
Với bản thân context, trước mặt chúng ta có nhiều lựa chọn. Lựa chọn thứ nhất là compaction, thứ mà phần lớn người dùng đã biết. Claude Code làm việc này tự động, và hầu hết các harness khác cũng vậy: khi bạn chạm tới một tỉ lệ phần trăm context đã dùng, auto-compaction nhảy vào và được kích hoạt.
Anh kể đã có vài thuật toán auto-compaction khác nhau trở thành giải pháp chuẩn của ngành. Nhưng cách mà anh thấy tốt nhất tính đến video đăng ngày 14/10/2026, và anh nói rõ đây hoàn toàn dựa trên cảm nhận (purely vibes based), là làm một handover document: LLM viết ra một bản bàn giao, rồi context bị xóa sạch hoàn toàn. Message đầu tiên LLM nhận được trong context mới là: đây là handover document của bạn, hãy đọc hết toàn bộ.
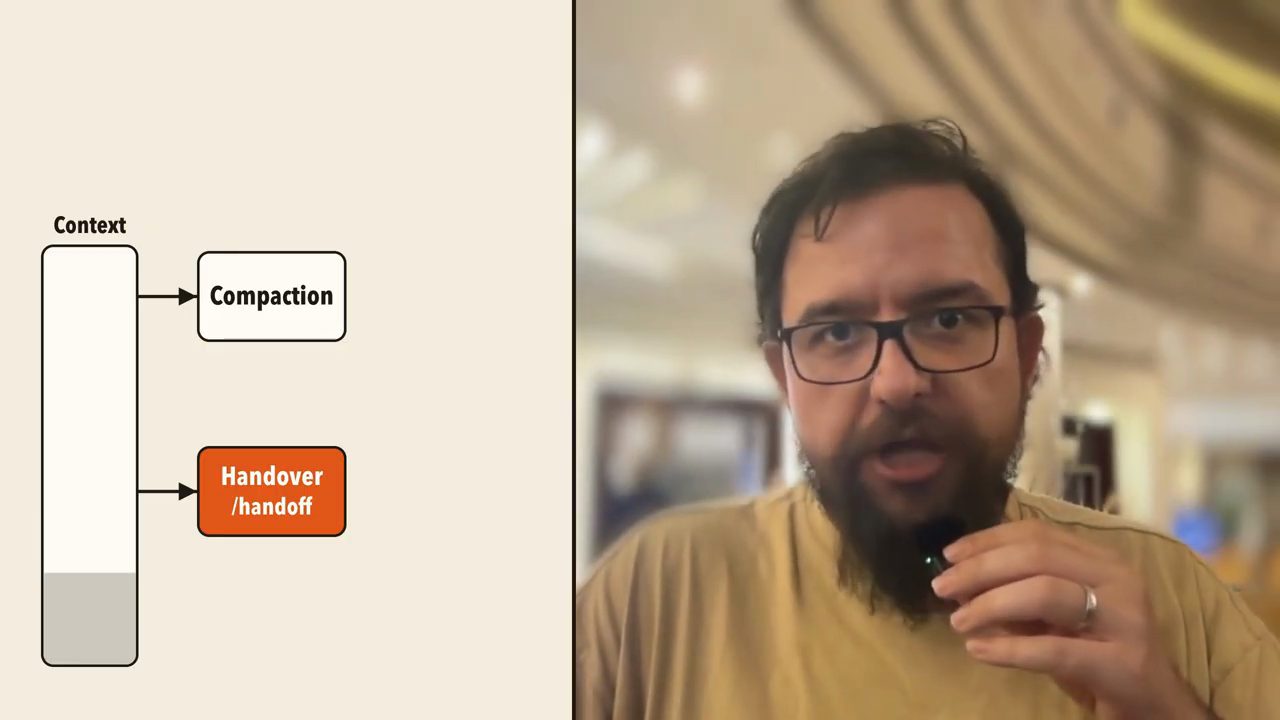
Anh gọi đó là một giải pháp cực kỳ mạnh và là giải pháp đáng tin cậy nhất trong các cách anh từng dùng.
Here is your handover document, please read it in full.
5. /handoff có sẵn trong OMP, và tự viết cách compaction của riêng bạn
Trong OMP, theo anh, việc này có sẵn miễn phí: bạn có lệnh /handoff và mọi thứ được làm cho bạn.
Auto-compaction thì là một con quái vật hoàn toàn khác. Cách compaction hoạt động liên tục thay đổi và tiến hóa, nhưng về cơ bản là một LLM đi qua context của nó và cố gắng nén các mẩu kiến thức riêng lẻ lại với nhau. Với anh, cách đó kém tin cậy hơn nhìn chung, nhất là khi bạn đang vật lộn với một context window lớn. Nếu context window của bạn đã gần 60, 70, hoặc tệ hơn nữa là 80%, bạn sẽ gặp rất nhiều rắc rối khi compaction, kể cả khi việc nén được làm theo từng dòng hay từng lượt (turn by turn) như anh nghĩ là ở một số harness; điều này còn tùy vào từng harness.
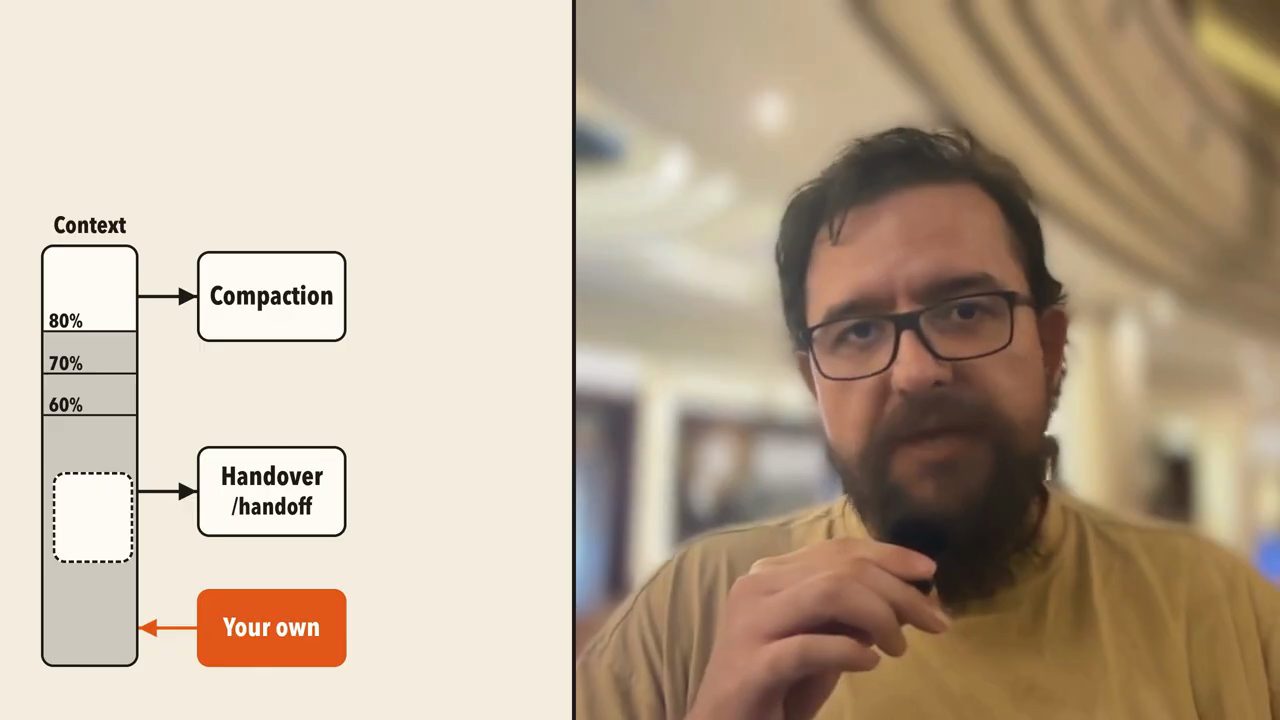
Đây là một điểm nữa mà trong OMP bạn có toàn quyền kiểm soát cách compaction được thực hiện. Nếu muốn, bạn có thể tự viết một quy trình compaction hay handover hoàn toàn do mình làm ra. Anh nói đó là điều bạn không làm được, theo những gì anh biết, trên Claude Code, Codex và tất cả các harness còn lại, và anh mời mọi người sửa lại cho anh nếu anh sai.
Tài liệu của OMP có trang riêng mô tả compaction và quy trình tạo handoff (xem phần nguồn ở cuối trang).
6. Model kém đi từ khoảng 30 đến 40% context window
Vẫn về compaction, anh muốn bàn thêm một sự thật: theo anh, phần lớn model không làm tốt khi context window đã đầy quá khoảng 30 đến 40%.
Khi context vượt 30%, model bắt đầu chậm lại và độ chính xác bắt đầu giảm. Anh nói đã có rất nhiều nghiên cứu về chuyện này (phần mô tả video dẫn bài Context Rot của Chroma, 2025), và vấn đề đã được cải thiện, bào mòn dần qua mỗi bản phát hành mới. Nhưng thật lòng, tính đến video đăng ngày 14/10/2026, anh vẫn chưa thấy model nào đáng tin cậy khi vượt mốc 30%.
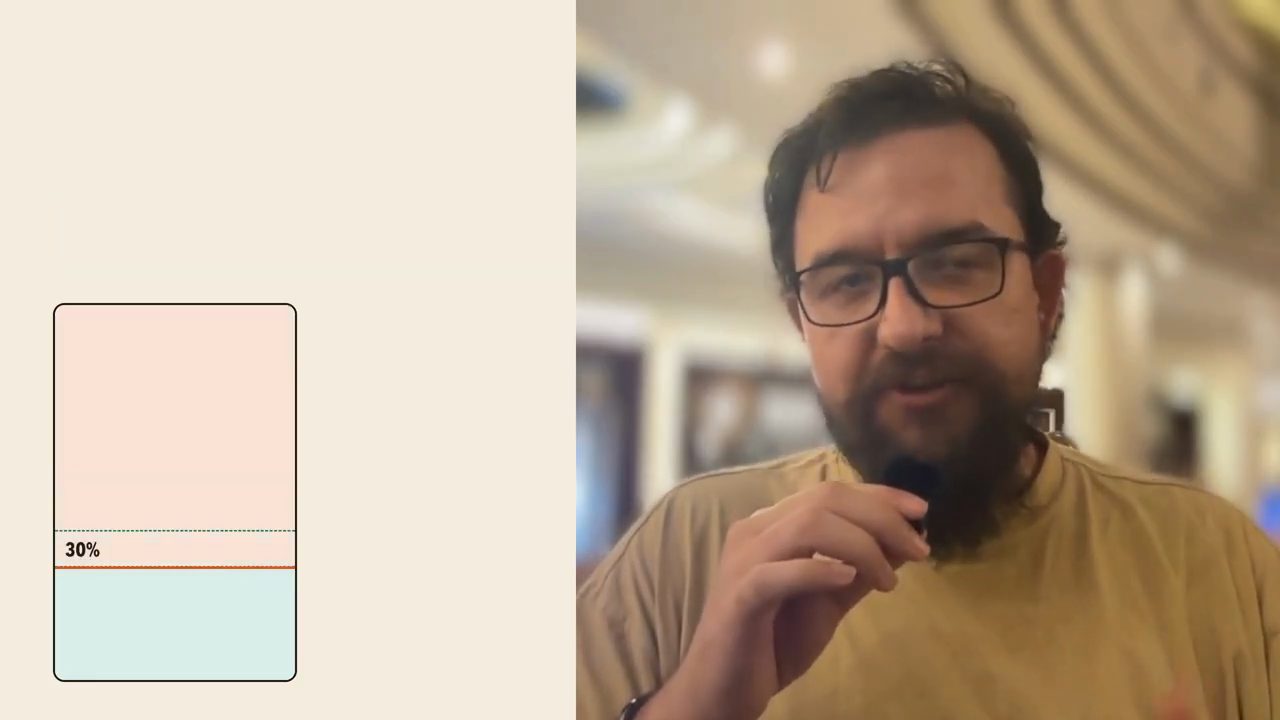
Anh đưa ra vài con số theo cảm nhận của mình (theo video đăng ngày 14/10/2026): với các model open-weights, khoảng 300K token dường như là giới hạn; với một số model khác thì quanh 40%; Opus và Sonnet thì cỡ 35%, có thể 40%.
7. Hạ ngưỡng auto-compaction từ 80% xuống 40%
Để tham khảo, anh kể gần đây (tính đến video đăng ngày 14/10/2026) anh đã chuyển auto-compaction của mình sang 40% và vô cùng hài lòng. Anh thấy mẹo này trên một Discord server mấy hôm trước và lúc đầu rất ngần ngại khi thử.
Lý do là các tác vụ chạy dài. Anh đang chạy rất nhiều benchmark, cho kênh và cho công việc, chạy qua đêm. Khi bạn để các agent chạy rất, rất lâu, anh nói tới cỡ sáu tiếng trở lên, thì dù bạn cố tới đâu để chúng tự điều phối và dùng các agent khác để chia việc cho nhau, context vẫn sẽ phình ra (bloat). Và nếu không auto-compact ở 40%, anh trước đây để ở 80%, bạn sẽ chỉ trả nhiều tiền hơn, chịu nhiều hallucination hơn và độ chính xác của output giảm, vì trí thông minh của model cũng tụt theo.
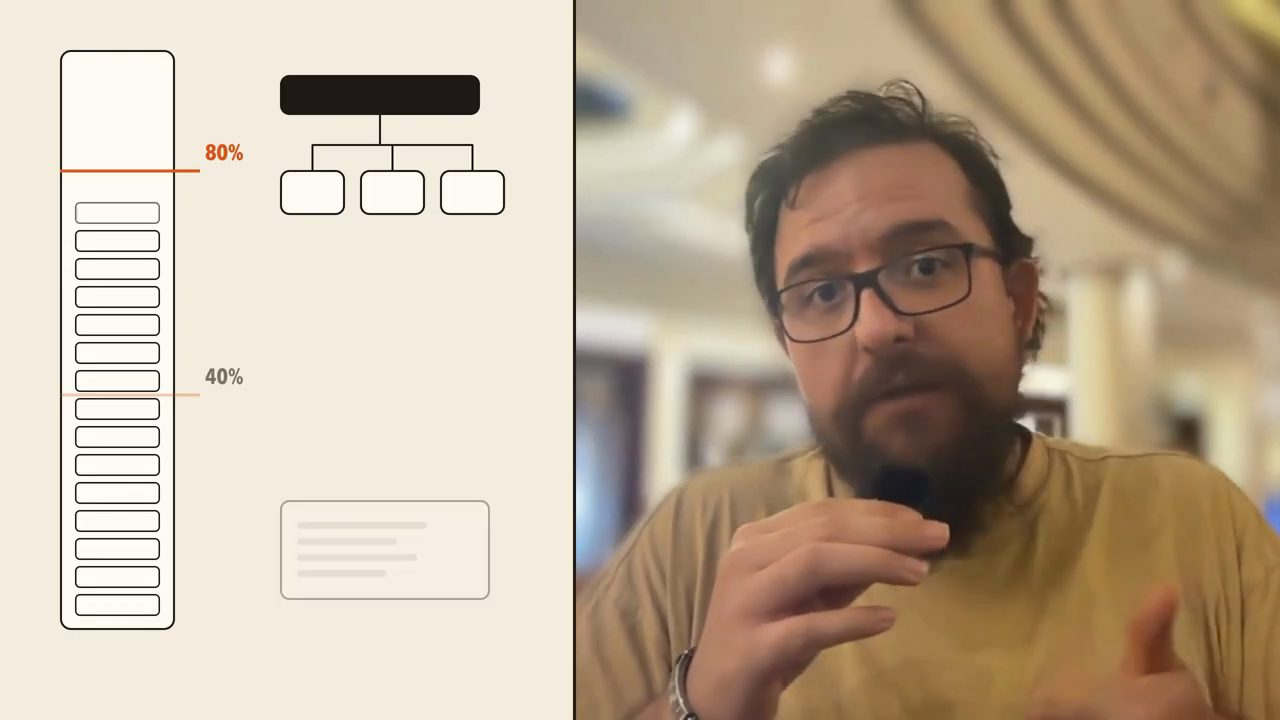
Vì sao trước đây anh để 80% nếu nó là vấn đề như vậy? Vì trước đây anh thường tự làm handoff trong OMP, như đã kể: tạo handoff document, sinh nó ra rồi xóa sạch context. Cách đó khá ổn với anh. Nhưng từ khi bắt đầu chạy các tác vụ dài, anh không có mặt ở đó để làm handoff, đúng không? Nên dù cố thế nào thì kết quả vẫn tệ.
Rồi có người nhắc anh chuyện này, và anh đã rất, rất hài lòng với mức 40%. Anh khuyến khích người xem tự thử. Anh không thấy ảnh hưởng lớn nào tới hiệu năng hay bất cứ thứ gì khác, nhất là trong các harness trưởng thành hơn một chút, nơi có nhiều agent tự chạy "automagically".
8. Cache: rời máy một lúc là trả tiền nạp lại, và nhịp keep-alive
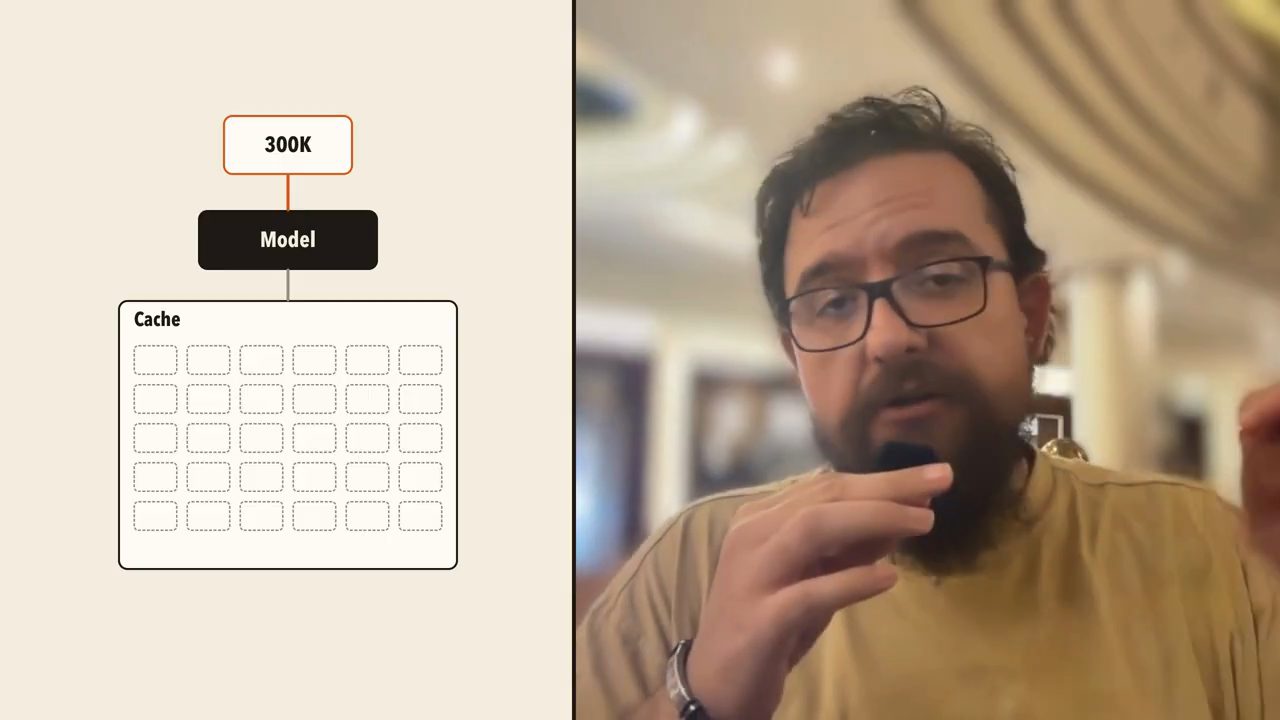
Điều tiếp theo anh đã nhắc ở đầu là caching và cách cache được xử lý. Mỗi harness xử lý khác nhau. Ví dụ khi bạn AFK, tức rời khỏi một session hoặc không gửi message mới trong một khoảng thời gian dài, thì tùy harness, cache của bạn sẽ bị vô hiệu (invalidated).
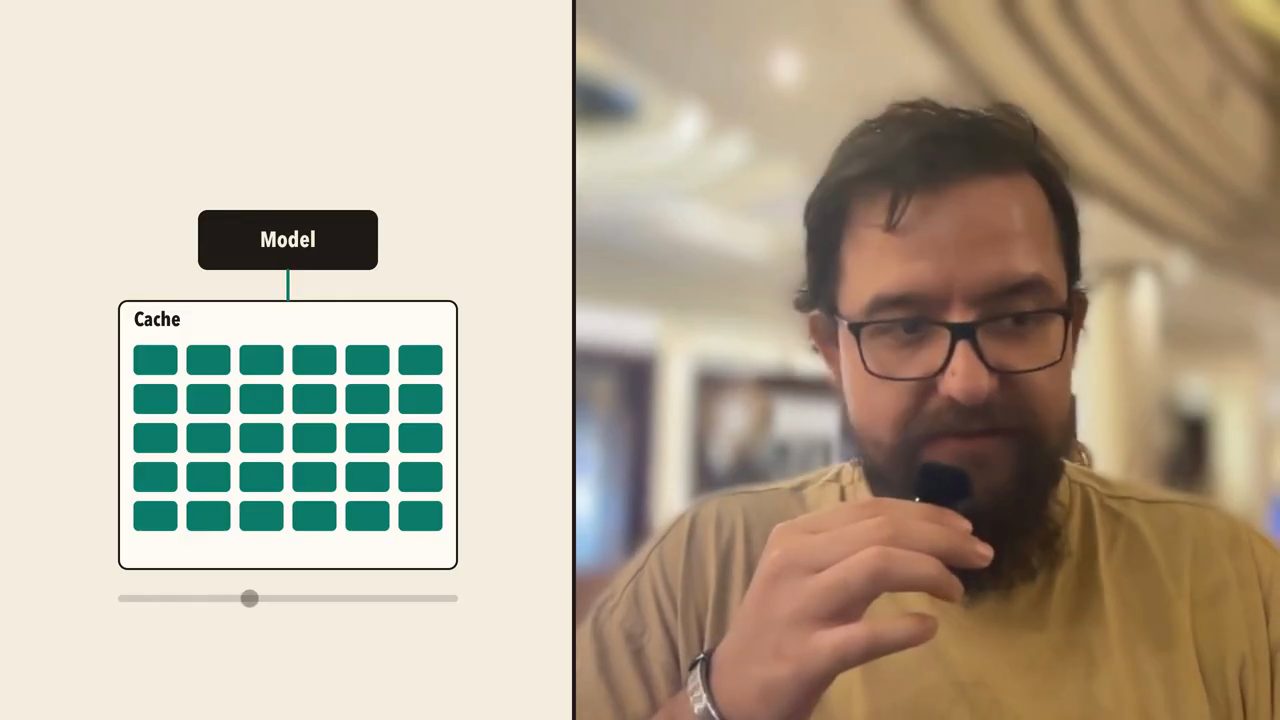
Vậy là mỗi khi bạn gửi lại message nặng 300K token đó, bạn lập tức trả vài đô la nếu đang dùng các model frontier của Mỹ (theo video đăng ngày 14/10/2026). Ở phía các model khác, anh nói bạn cũng ngay lập tức trả rất nhiều tiền chỉ để nạp lại cache.
Anh kể đã thấy một đường xu hướng rất rõ ở cache hit rate của mình khi dùng một dịch vụ API trung gian cho model, vì dịch vụ đó báo lại con số này. Khi anh mới dùng Pi, cache hit rate khá thấp, vì như đã nói, xử lý cache và mọi thứ khác bạn gần như phải tự gắn vào. So với khi anh chuyển sang OMP có xử lý cache: một keep-alive message, về cơ bản là một nhịp tim (heartbeat), liên tục gửi đi một lượng token nhỏ chỉ để giữ cache luôn ấm.
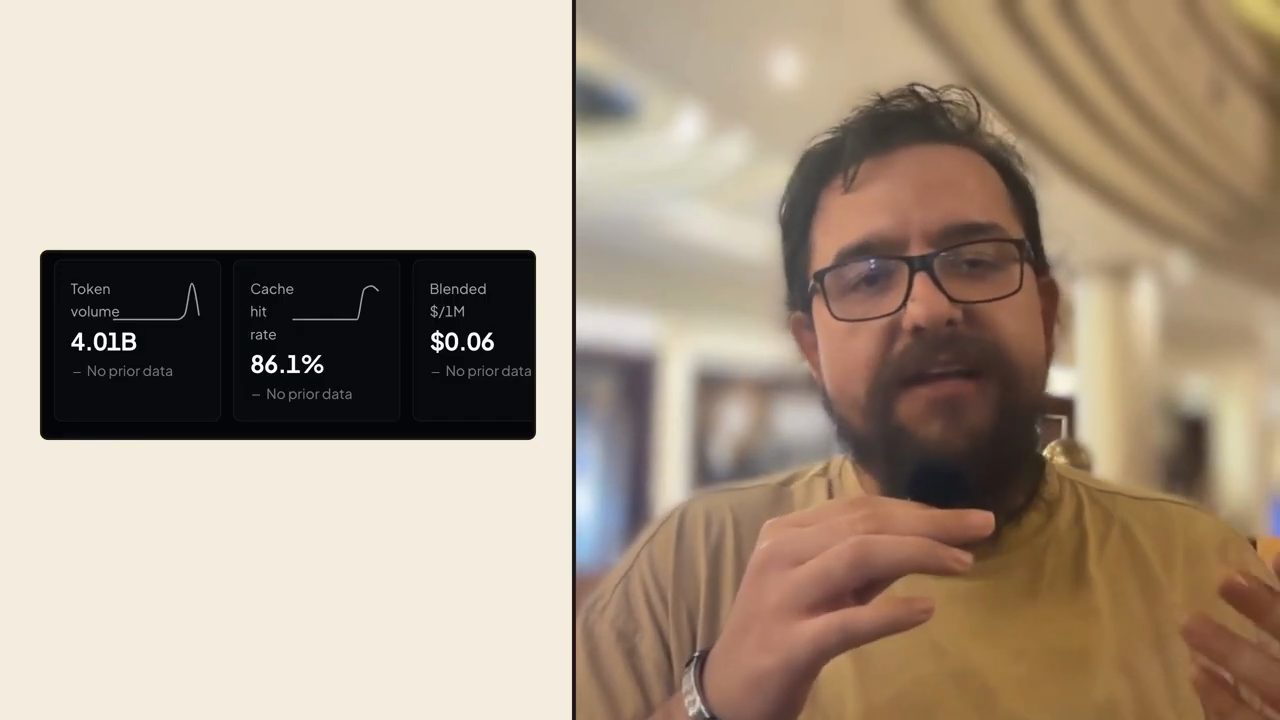
Anh gọi thứ đó là vô giá. Tất nhiên bạn phải trả giá cache cho những nhịp giữ ấm ấy, nhưng đó là một cải thiện chất lượng trải nghiệm (quality of life) rất dễ chịu, và bạn có thể đặt nó chạy giữa các task. Với anh, nó có sẵn ngay khi cài (out of the box), và nó cực kỳ có giá trị.
9. Mô hình role, alias và agent của OMP
Một điều cực kỳ hữu ích khác mà anh muốn người xem nhớ, thứ OMP cho bạn còn các harness khác thì không: mô hình của nó siêu đơn giản. Mental model của OMP là bạn có các role, mỗi model có một role cụ thể. Có default, scout, task, small, big, reviewer và những thứ tương tự. Anh nói mình đã tự thêm vài role nữa. Về bản chất, một role là một alias (tên gọi thay thế) cho một model.
Sau đó các role được gắn vào agent. Mỗi khi bạn chạy agent, nó có một role ưu tiên, và có các fallback cho role đó. Bản thân agent có system prompt riêng của nó, tức các chỉ dẫn tĩnh, và quyền truy cập vào các tool cụ thể được giới hạn.
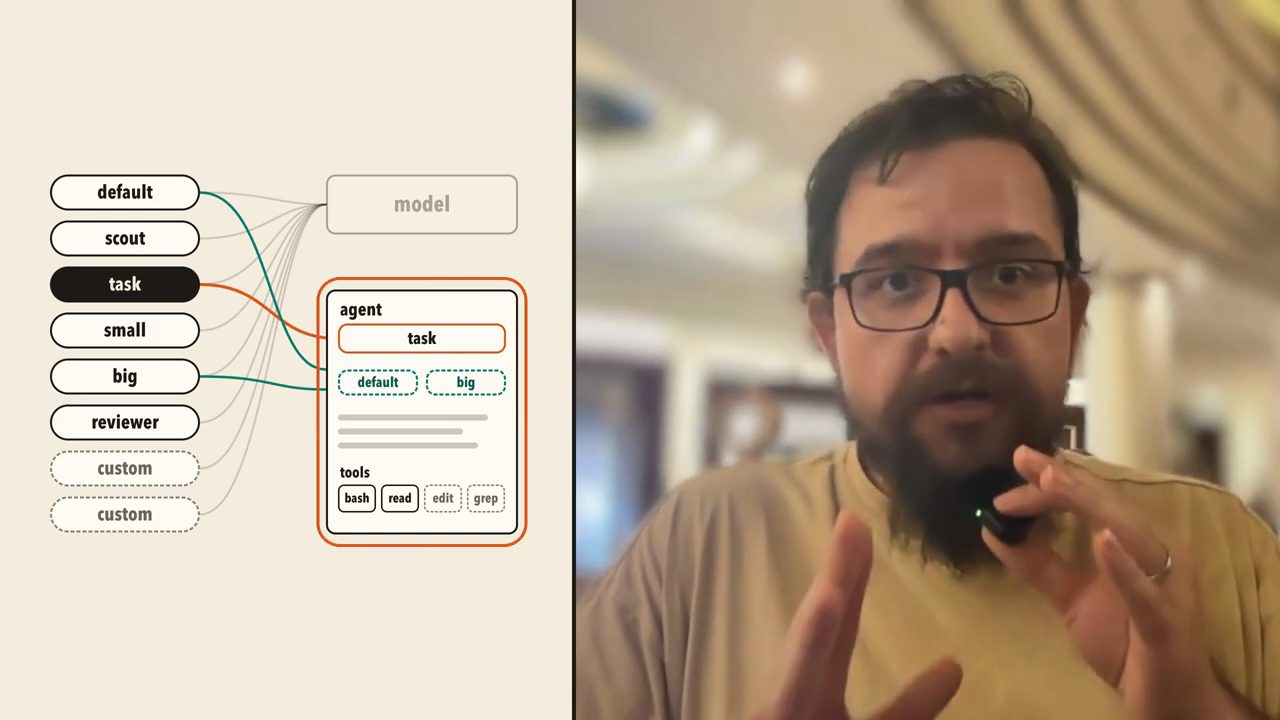
Có những thứ cơ bản đó trước mặt và được toàn quyền kiểm soát chúng, theo anh, ngay lập tức đẩy đầu óc bạn nghĩ theo hướng: làm sao để cái này tốt hơn, làm sao tối ưu tốc độ của nó, làm sao biết mình đúng.
(Trong README của OMP tính đến 10/2026, danh sách role được mô tả với các tên như default, smol, slow, plan, commit, vision, task, advisor và tiny; các tên role trên sơ đồ là cách người nói trình bày.)
10. Có quyền điều khiển thì bắt đầu đo: vibes, benchmark và một chiếc laptop
Đó chính là vị trí của anh lúc làm video (14/10/2026): anh đang benchmark rất nhiều vì có quá nhiều ý tưởng, và anh có vibes. Vibes quan trọng vì chúng dẫn hướng cho việc anh sẽ nghiên cứu và benchmark theo hướng nào. Nhưng rốt cuộc, bạn không thật sự biết mình đúng hay sai, và điều đó phụ thuộc rất nhiều vào độ chính xác của benchmark.
Mà đi tới được những benchmark đó thì khá tốn kém, nhất là khi bạn không chạy trên máy cloud hoặc không có phần cứng, phần mềm khủng. Anh nói mình chỉ có một chiếc laptop. Trên chiếc laptop đó anh phải khá cẩn thận với tài nguyên, vì anh liên tục chạy nhiều job song song cùng lúc, và chúng ngốn tài nguyên khá nặng vì nhiều job dùng Docker, mà bản thân Docker cũng khá "đói" tài nguyên.
11. Fan-out sub-agent trong Claude Code và một harness đóng
Nhưng sự thật là, theo anh, những thứ này bị cho qua loa (hand-waved) ở các harness khác như Claude Code. Ví dụ ở đó bạn có fan-out sub-agent: các sub-agent sẽ được tỏa ra chạy song song. Anh đã thử, và anh đã làm một video riêng về việc đó thất bại hoành tráng như thế nào với anh, khi cố làm agentic workflow trong Claude Code.
Lý do, theo anh, về bản chất là bạn không có quyền điều khiển cốt lõi, và những điều khiển cốt lõi ấy cũng không được đưa ra cho bạn, vì bản thân harness không open source và bạn không thật sự có tự do để vào sửa nó.
Bạn được kỳ vọng dùng model của họ theo đúng cách họ dự định. Và cách họ dự định thì thay đổi liên tục.
12. Ngành quá biến động để harness ra lệnh cho bạn
Nhìn chung, anh nghĩ có một quy trình chuẩn để hành động thì cũng ổn. Nhưng tình thế của chúng ta với tư cách software engineer, và của cả ngành ở thời điểm video (10/2026), là quá biến động: mọi thứ cứ lỗi thời tuần này qua tuần khác.
Điều anh muốn nói là: mọi thứ quá biến động để một harness được quyền áp đặt (prescriptive) cách làm lên bạn. Bạn mới là người phải tìm ra cái gì hiệu quả với mình, đặc biệt là cái gì hợp với workflow của mình, và bạn nên tự tay thực hiện những thay đổi đó. Đó là lý do anh nghĩ bạn nên dùng OMP và thật sự thử nó một lần. Anh tin bạn sẽ thích nó hơn nhiều so với bạn nghĩ.
Anh nói thêm: skill về cơ bản đã được làm cho người dùng nhìn thấy được, và skill của họ rất tuyệt. Nhưng còn agent thì sao? Còn việc kết hợp từng model riêng với từng mức effort riêng cho mỗi agent thì sao? Còn việc định nghĩa chức năng nền tảng của một agent cụ thể thì sao? Theo anh, đó đều là những thứ bạn không kiểm soát được ở các harness phổ thông, còn khi dùng một harness như OMP thì bạn có.
Anh hy vọng video hữu ích, mời mọi người cứ hỏi bất kỳ câu nào và nói anh rất vui được thảo luận về chủ đề này. Nếu không, bạn có thể bấm vào video anh gợi ý tiếp theo. Anh cảm ơn và chào tạm biệt.
Nguồn và liên kết 9 nguồn
- Tên gốc: Why You Should DROP CLAUDE CODE for OMP (Oh-My-Pi)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=PtS2EdUsMeo youtube.com
- Kênh YouTube exit node (exit node): youtube.com/channel/UCASjrPJfHsvX-0AVz9eSfAQ youtube.com
- OMP (Oh-My-Pi), repo open source, fork của Pi: github.com/can1357/oh-my-pi github.com
- Tài liệu compaction của OMP (ngưỡng tự động, phương thức handoff, giữ cache ấm khi rảnh): docs/compaction.md github.com
- Tài liệu quy trình tạo handoff của OMP: docs/handoff-generation-pipeline.md github.com
- Pi, harness gốc của Mario Zechner mà OMP fork từ đó: github.com/badlogic/pi-mono github.com
- Hong, Troynikov, Huber: Context Rot (Chroma, 2025), nghiên cứu được dẫn trong mô tả video: trychroma.com/research/context-rot trychroma.com
Related talks
Giữ AI trả lời đúng với Microsoft Learn MCP Server
Ben Brauer & Eric Imasogie · Microsoft Developer · 12 min
Vì sao coding agent trả lời lỗi thời, và cách Microsoft Learn MCP Server đưa tài liệu chính thức vào agent qua ba tool, kèm demo trong VS Code.
Deep dive Cursor: cách senior engineer dùng Cursor từ Tab tới agent
Himalay Majumdar · ByteMonk · 27 min
Cách dùng Cursor end to end: Tab, Command K, Chat với @, plan mode trước agent, rules, commands, parallel và background agents, Bugbot, MCP, Context7.
Pi thêm Codemode: MCP chạy trong JavaScript sandbox
George Kintu · kintu · 11 min
Codemode của Pi chạy MCP tool trong QuickJS sandbox, chỉ trả kết quả gọn cho model; hai test đo token, chi phí, và phản ứng của cộng đồng.