Your Agent Failed in Prod. Good Luck Reproducing It.
AI Engineer World's Fair 2026: Online Track · Video gốc
Vì sao temperature 0 không làm agent deterministic, và cách record ở boundary để replay một lỗi prod, stub LLM rồi biến trace thành test case.
1. Lần chạy sai duy nhất, và lần đó không quay lại
Tisha mở đầu bằng một tình huống mà ai chạy agent trong production cũng từng gặp hoặc sắp gặp. Hãy tưởng tượng agent của bạn làm một việc sai trong prod: nó gọi nhầm tool, nó ghi một thứ sai vào hệ thống, và bỗng nhiên cả team đang trong on-call rotation phải đi tìm xem chuyện gì thật sự đã xảy ra. Khá quen thuộc, đúng không?
Theo phản xạ kỹ thuật thông thường, bạn sẽ lấy raw prompt từ telemetry log, đưa nó cho đúng model đó với đúng prompt đó, chạy ở local để cô lập bug. Ai cũng làm vậy. Và điều bất ngờ là nó chạy đúng. Chạy lại, vẫn đúng. Chạy thêm mười lần nữa, lần nào cũng hoàn hảo. Còn cái lần chạy duy nhất đã làm bạn mất tiền thì biến mất. Bạn không reproduce được nó. Mà nếu không reproduce được thì không debug được. Và nếu không debug được thì bạn không thể hứa rằng chuyện đó sẽ không xảy ra với khách hàng hay người dùng tiếp theo của mình.
Tisha giới thiệu mình và người trình bày cùng, Susheem. Cả hai đều chạy agent trên các production backend thật, kiểu nơi mà một lần ghi sai không phải là chuyện "ồ, thôi chạy lại là xong". Đó là cảnh bạn ngồi trong một cuộc gọi với khách hàng để giải thích dữ liệu của họ thật ra đã đi đâu. Toàn bộ talk xoay quanh đúng một thứ bạn mất ngay khoảnh khắc agent "phát điên" trong production: khả năng reproduce lại nó. Đó là North Star mà cả hai sẽ bám theo trong khoảng mười phút của talk.
2. Hỏi bán 1.000 đô, bán mất 190.000 đô
Để thấy nó nổ ra thế nào, Tisha lấy một kịch bản cụ thể: một agent được nối vào API của một broker (công ty môi giới chứng khoán). Người dùng nói: "Bán giúp tôi một nghìn đô cổ phiếu." Đây mới là phần thú vị. Thay vì làm phép tính để đổi một nghìn đô thành số cổ phiếu, agent lấy thẳng con số thô 1.000 và đổ nó vào ô quantity. Kết quả: nó bán một nghìn cổ phiếu.
Với giá một trăm chín mươi đô một cổ phiếu, ý định bán một nghìn đô trở thành bao nhiêu? Một thảm họa một trăm chín mươi nghìn đô. Và phần đáng sợ nhất là API phía broker trả về một response sạch sẽ: 200 OK, trong ba mươi mili giây. Không có exception nào, không có alert nào. Nhìn vào giao dịch thì nó sai hoàn toàn, nhưng dashboard của bạn vẫn xanh, hoàn hảo, không một vết gợn.
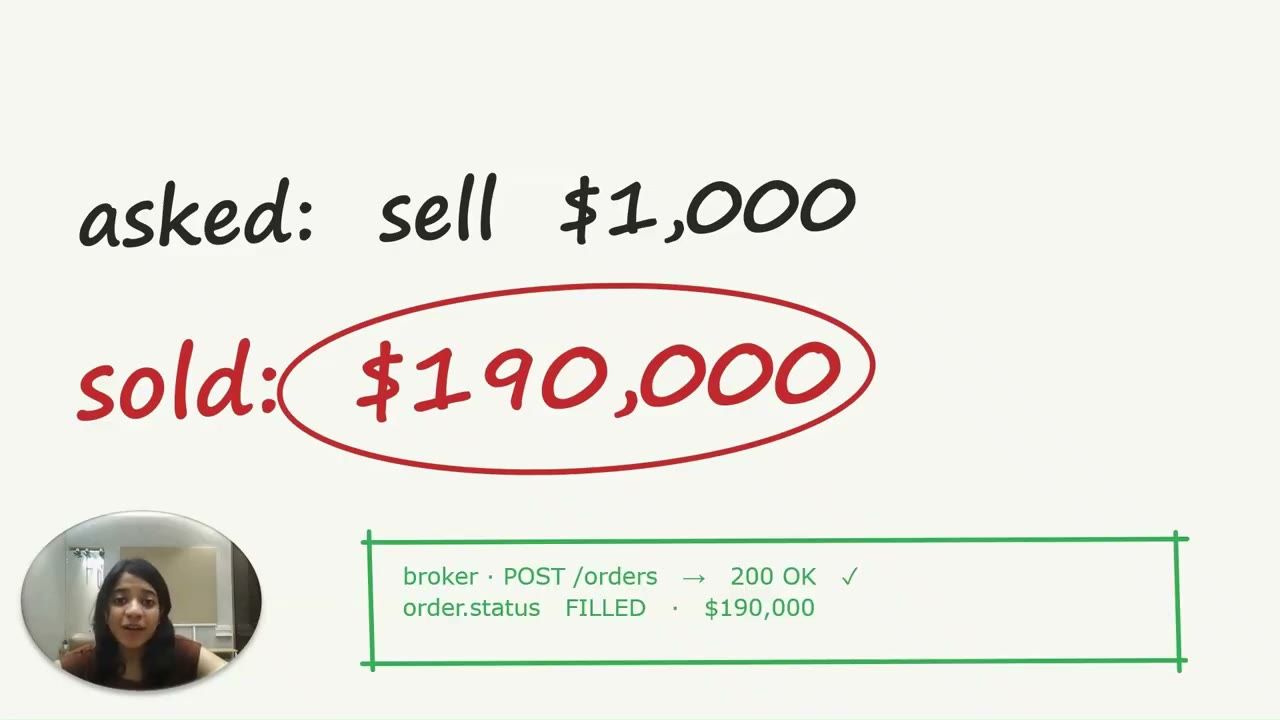
POST /orders tới broker trả 200 OK, trạng thái lệnh FILLED, giá trị 190.000 đô. Về mặt hệ thống, mọi thứ đều "thành công".3. Phản xạ đầu tiên: temperature = 0
Khi gặp một kịch bản như vậy, việc đầu tiên bạn làm để sửa là gì? Phản xạ ở đây thường là hạ temperature của model xuống đúng 0, với giả định rằng greedy decoding sẽ làm mọi thứ trở nên deterministic.
Nhưng đó là một ngộ nhận hoàn toàn. Đặt temperature về 0 không sửa được một reasoning path bị hỏng. Nó chỉ có nghĩa là model sẽ mắc đúng lỗi logic đó, theo đúng cách đó, vào đúng lúc đó. Thật ra còn tệ hơn thế.
Để chứng minh cho kịch bản vừa rồi, Tisha chỉ vào các thread kỹ thuật trên Reddit và Hacker News. Dữ liệu cứng cho thấy temperature 0 thậm chí không deterministic thật sự ở tầng phần cứng. Chạy cùng một prompt một nghìn lần vẫn có thể trả về hàng chục response khác hẳn nhau, chỉ vì tính nondeterminism của GPU bên dưới và các kiến trúc MoE (mixture of experts) đang được dùng.
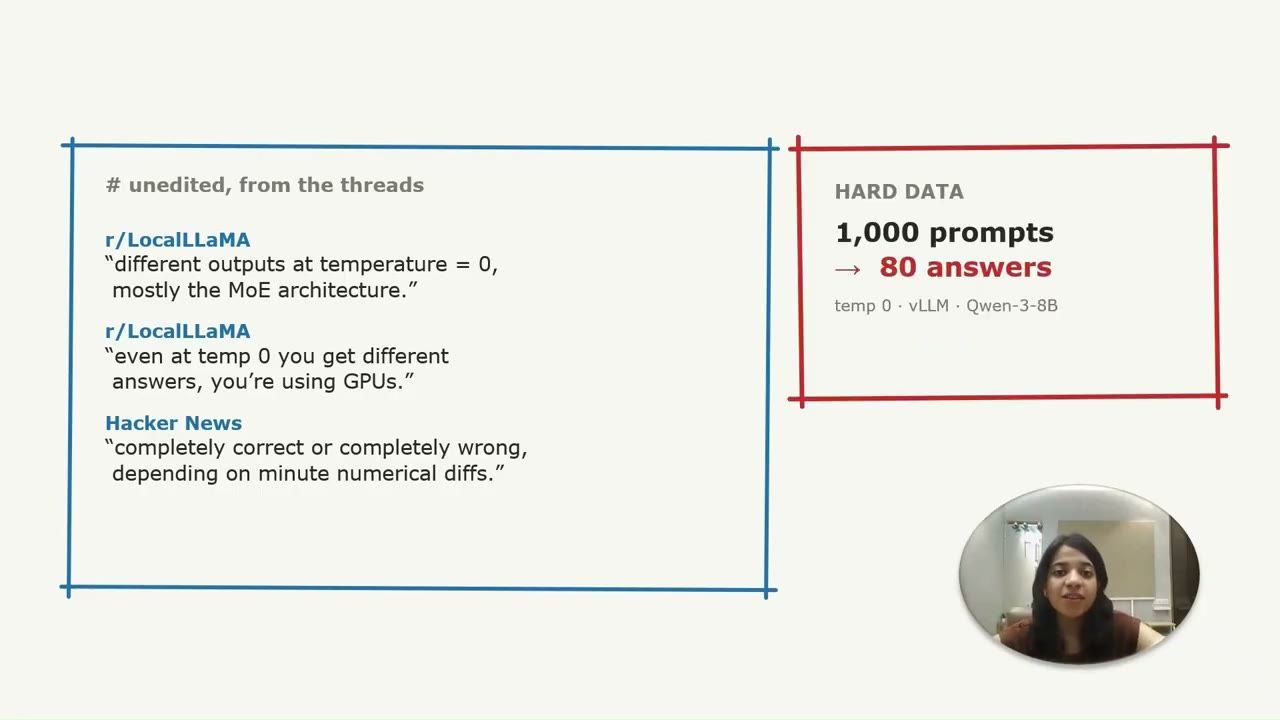
Con số 1.000 lần chạy ra 80 kết quả khác nhau cũng xuất hiện trong bài phân tích của Thinking Machines về nondeterminism trong LLM inference (Defeating Nondeterminism in LLM Inference), dù thí nghiệm ở đó dùng Qwen3-235B-A22B; bài này cũng giải thích kỹ khái niệm batch invariance ở phần tiếp theo.
4. First principles: bốn lý do temperature 0 vẫn không deterministic
Để hiểu vì sao chuyện này xảy ra, Tisha quay về first principles. Nó quy về bốn điều đơn giản.
Một, sampling determinism không phải system determinism. Temperature 0 chỉ có nghĩa là luôn chọn argmax, tức token có điểm cao nhất. Nhưng nó không bảo đảm rằng bản thân các điểm số bên dưới giữ nguyên từ lần chạy này sang lần chạy khác. Temperature 0 cố định cái luật chọn, không cố định các logit mà luật đó chọn trên.
Hai, phép cộng floating point không có tính kết hợp (associative). Thứ tự bạn cộng các số thập phân là quan trọng. Slide đưa ví dụ: (0.1 + 1e20) - 1e20 = 0, trong khi 0.1 + (1e20 - 1e20) = 0.1. Chỉ cần một thay đổi về timing trong phép toán ma trận làm thứ tự reduction khác đi, mấy bit cuối của một logit sẽ dịch chuyển, và điều đó có thể lật luôn token thắng cuộc.
Ba, đây không phải vấn đề concurrency. Chạy cùng một phép nhân ma trận một mình trên GPU một nghìn lần, Tisha bảo đảm bạn sẽ nhận đúng những bit đó y hệt. Thủ phạm thật là batch variance (slide gọi là batch invariance, tức kernel thiếu tính bất biến theo batch): request của bạn bị gom chung với bất cứ thứ gì khác đập vào server đúng mili giây đó. Production batch bạn chung với người lạ, và kernel thì phụ thuộc vào hình dạng của batch.
Bốn, routing trong mixture of experts có đúng cùng điểm nghẽn đó. Mỗi expert có giới hạn capacity nghiêm ngặt. Nếu một batch tràn qua một subnetwork cụ thể, token sẽ bị route sang chỗ khác. Một token có lọt được vào expert mong muốn hay không phụ thuộc hoàn toàn vào traffic mà bạn bị batch cùng.
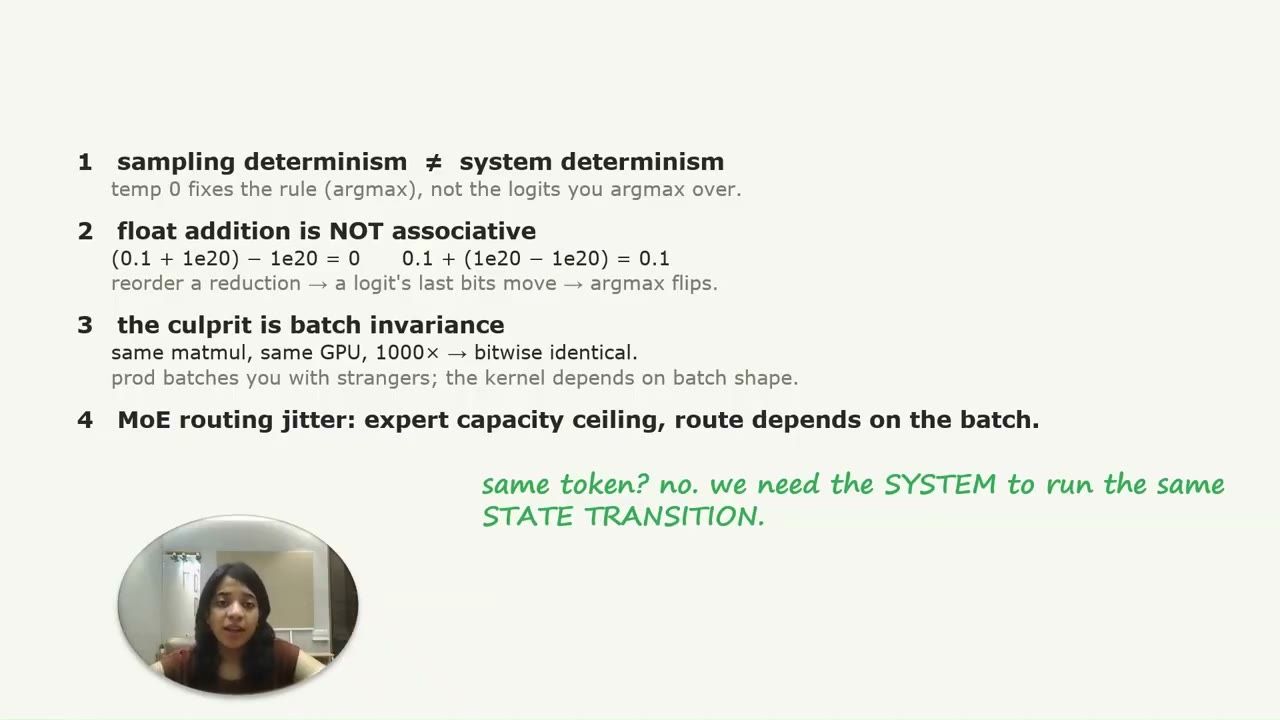
Bài học rút ra là đuổi theo text output là một trận chiến chắc chắn thua. Ta không cần model trả về đúng token đó mỗi lần. Ta chỉ cần hệ thống của mình thực hiện đúng cùng một state transition.
5. Câu hỏi sai và câu hỏi đúng: bitwise determinism hay replayability
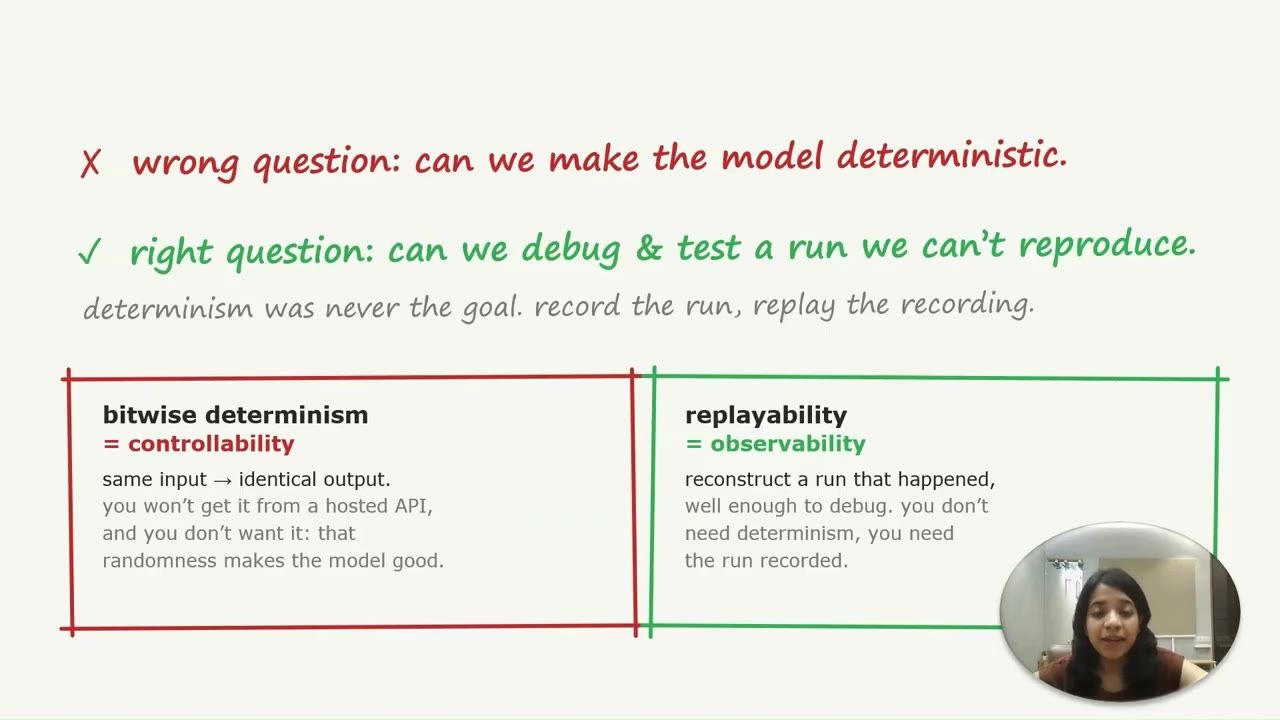
Điều đó có nghĩa là từ trước tới giờ chúng ta đã hỏi sai câu hỏi. Câu hỏi sai là: "Làm sao để model trở nên deterministic?" Tisha kể cô đã thấy nhiều team đốt hàng tuần vào câu hỏi đó, rồi bỏ đi với kết luận rằng hệ thống này đơn giản là không thể hiểu nổi. Câu hỏi đúng là: "Làm sao để debug và test lại một lần chạy mà mình không reproduce được?" Vì determinism chưa bao giờ là North Star. Debugging mới là North Star.
Từ đó cô tách hai khái niệm mà mọi người hay trộn lẫn: bitwise determinism và replayability.
- Bitwise determinism là cùng input, cùng output. Đó là controllability. Bạn sẽ không có được nó từ một hosted API, và thật ra bạn cũng không muốn có nó, vì chính sự ngẫu nhiên làm model trở nên tốt. Model càng explore nhiều, câu trả lời càng sáng tạo.
- Replayability là dựng lại một lần chạy đã xảy ra, đủ tốt để debug nó. Đó là observability. Bạn không cần model deterministic. Bạn cần lần chạy được record lại. Bạn không đóng băng model, bạn ghi lại những gì nó đã làm.
6. Record ở đâu: ở boundary, không phải ở network
Câu hỏi mà ai cũng đang nghĩ tới lúc này là: record ở đâu? Chắc chắn không phải ở network layer, vì một nửa agent của bạn không bao giờ chạm vào network. Đó là local retrieval, các in-process tool, memory, và những phần không bị cắt vụn bởi streaming và async. Socket không thể ghi lại thứ không đi qua nó.
Thay vào đó, hãy record ở boundary, vì thứ bạn cần nắm là cái gì đi vào mỗi node và cái gì đi ra khỏi nó: ý nghĩa của từng bước, không phải các packet. Slide tóm lại thành một câu: "record above the wire, not on it", tức ghi ở phía trên đường dây, không phải trên chính đường dây.
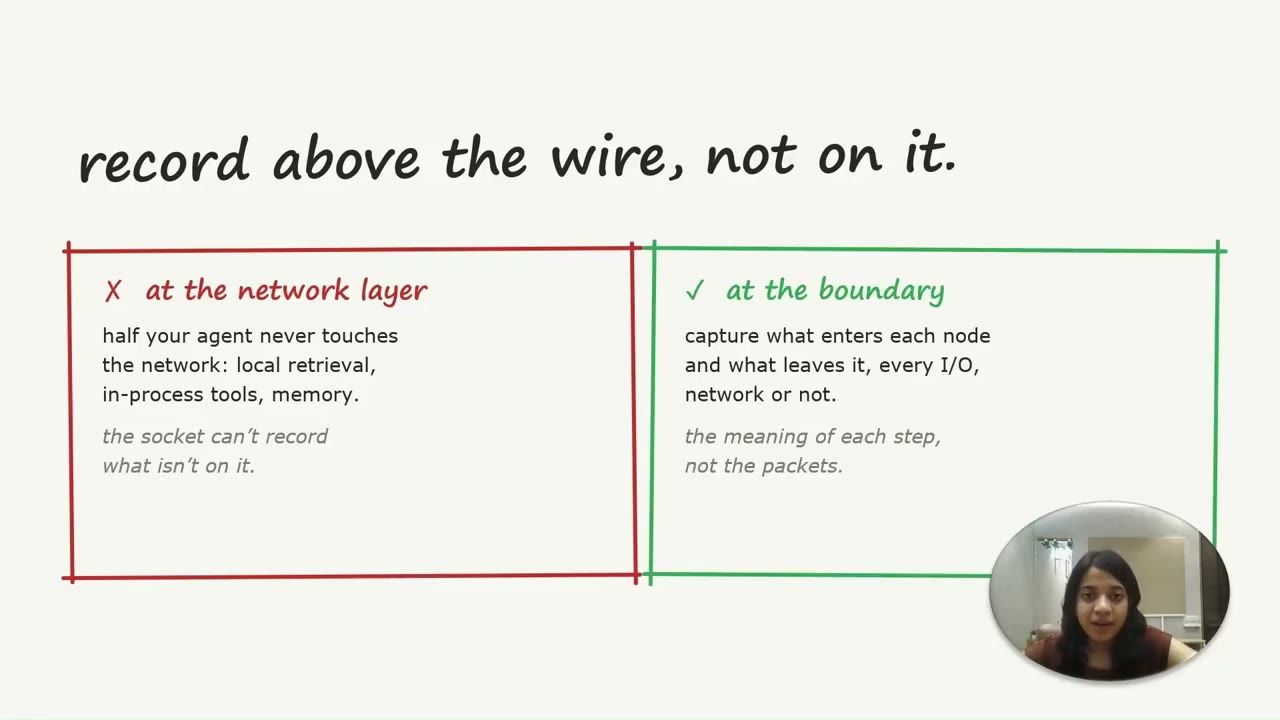
Thứ mà replay thêm vào đây là một CI deterministic: bạn stub model, và chạy lại chính xác lỗi đó offline với số lần gọi model bằng không.
Tisha đi qua toàn bộ vòng lặp end-to-end. Nó bắt đầu từ annotation, rồi recording, visualization, understanding, fixing; tiếp theo là phần cả nhóm đang làm, replaying; và cuối cùng là verifying.
7. Chronicle và boundary annotation
"Được rồi, giờ hãy xem cách đưa workflow vừa nói vào thực tế." Từ đây Susheem tiếp quản. Anh nhắc lại rằng replayability là một nguyên tắc cốt lõi khi đưa bất kỳ AI agent nào vào production. Nhưng làm sao để build nó bằng code? Để làm proof of concept, nhóm đã xây một thứ tên là Chronicle.
Ở trung tâm của Chronicle là khái niệm boundary. Hãy nghĩ về boundary như một bounding box bao quanh bất kỳ node nào trong agentic workflow của bạn. Một node có thể là một tool call, có thể là một lần gọi LLM, hay một lần retrieval từ RAG. Không quan trọng. Miễn nó là một method, nó có thể được gắn boundary annotation.
Annotation này làm gì? Nó bảo đảm rằng mọi thứ đi vào method và đi ra khỏi method đều được record. Mọi cặp input và output đều được ghi lại. Ngoài ra, bạn có thể khai báo thêm tham số như model version hay version của code đang chạy, để toàn bộ state tại thời điểm agent chạy được đóng băng và lưu lại thành một trace.
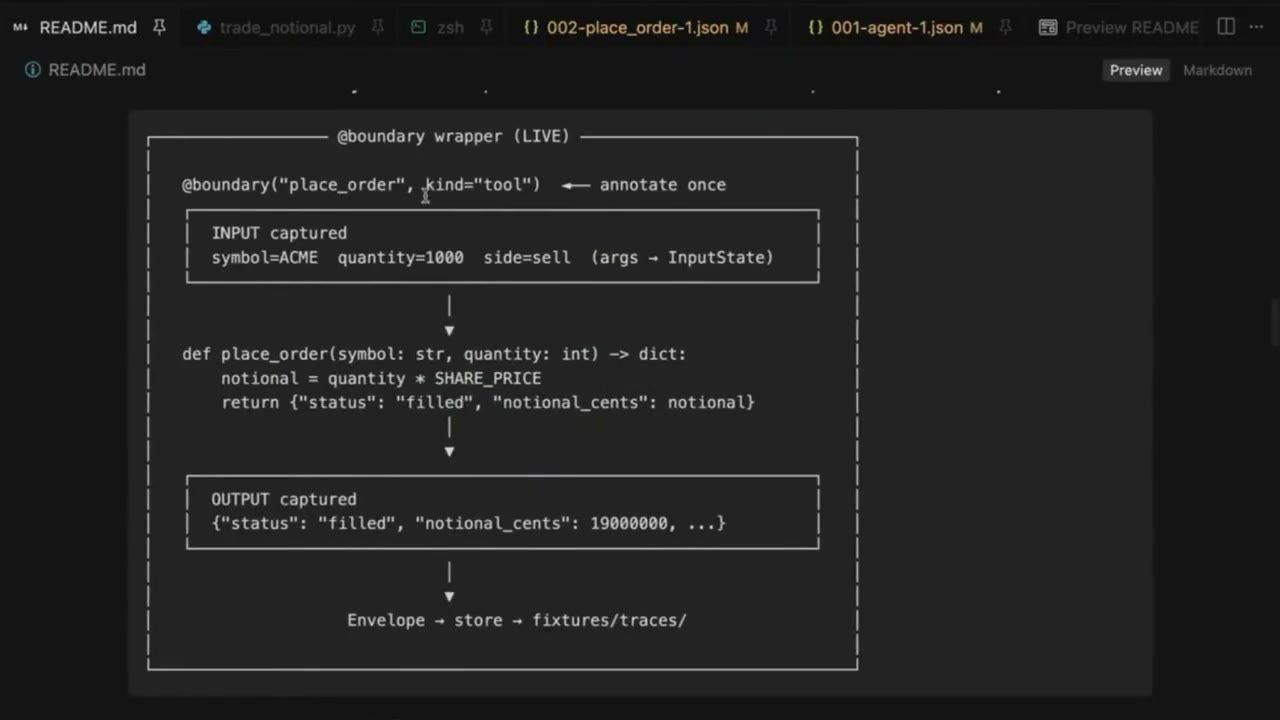
@boundary("place_order", kind="tool") một lần; input (symbol=ACME quantity=1000 side=sell) được capture, hàm place_order chạy thật, output ("status": "filled", "notional_cents": 19000000) cũng được capture, rồi tất cả đóng gói thành một Envelope và lưu vào fixtures/traces/.8. Demo: record lại sự cố bán cổ phiếu
Giờ đến phần demo. Susheem dùng lại chính agent bán cổ phiếu đã "phát điên" trong production ở đầu talk. Agent có bước planning ban đầu, nhận input của người dùng. Nó có thể dùng tool place_order để thực hiện việc mua bán cổ phiếu. Và cuối cùng, nó chuyển cho finalize agent, thứ sinh ra một response ngắn gọn cho người dùng cuối.
Cả ba method này đều được gắn boundary annotation. Cái đầu tiên là tool, cái thứ hai và thứ ba là LLM.
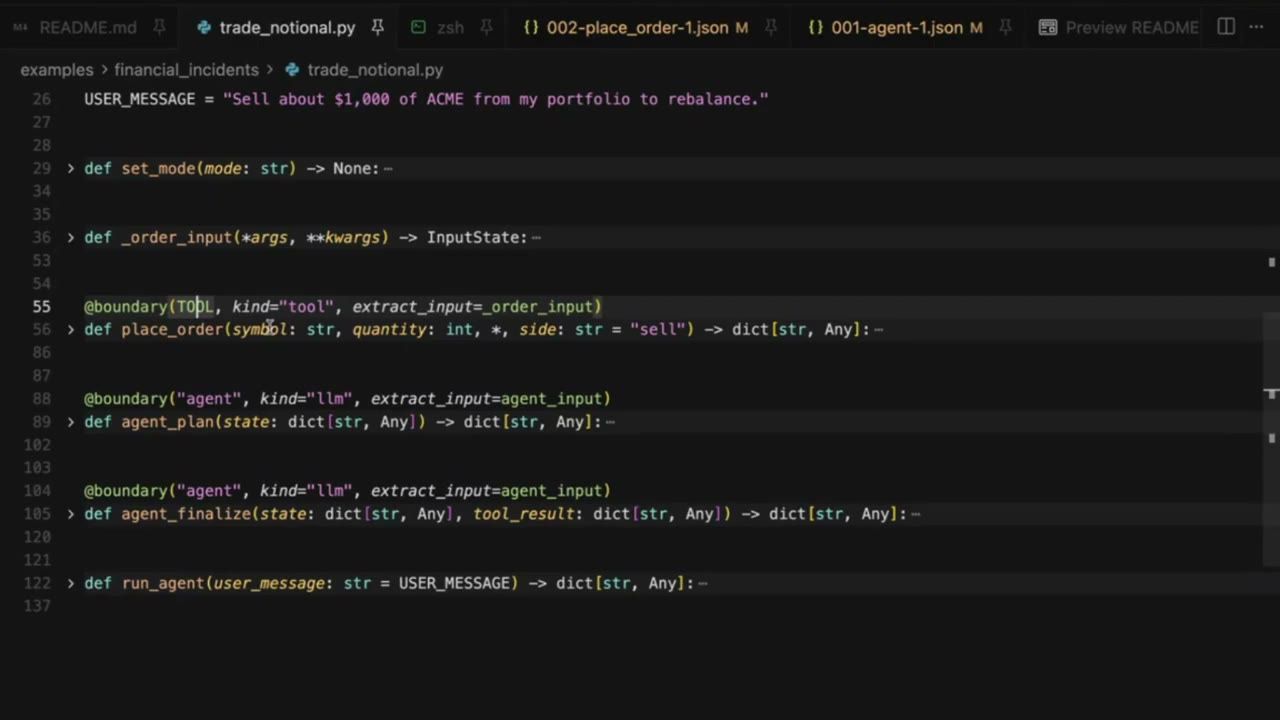
trade_notional.py: tin nhắn người dùng là "Sell about $1,000 of ACME from my portfolio to rebalance." Ba hàm được bọc boundary: place_order với kind="tool", còn agent_plan và agent_finalize với kind="llm".@boundary(TOOL, kind="tool", extract_input=_order_input)
def place_order(symbol: str, quantity: int, *, side: str = "sell") -> dict[str, Any]: ...
@boundary("agent", kind="llm", extract_input=agent_input)
def agent_plan(state: dict[str, Any]) -> dict[str, Any]: ...
@boundary("agent", kind="llm", extract_input=agent_input)
def agent_finalize(state: dict[str, Any], tool_result: dict[str, Any]) -> dict[str, Any]: ...Anh chạy nó. Đây là những gì đã xảy ra: bạn đưa một user request bán khoảng một nghìn đô cổ phiếu Acme. Có ba node, và input lẫn output của từng node đều được record. Bạn thấy LLM đã hiểu nhầm con số một nghìn thành quantity và sinh ra một tool call place_order với symbol Acme và quantity một nghìn. Tool place_order dĩ nhiên thực thi đúng input đó và bán một nghìn đơn vị cổ phiếu Acme với giá một trăm chín mươi đô mỗi cổ phiếu. Đó là chỗ vấn đề bắt đầu.
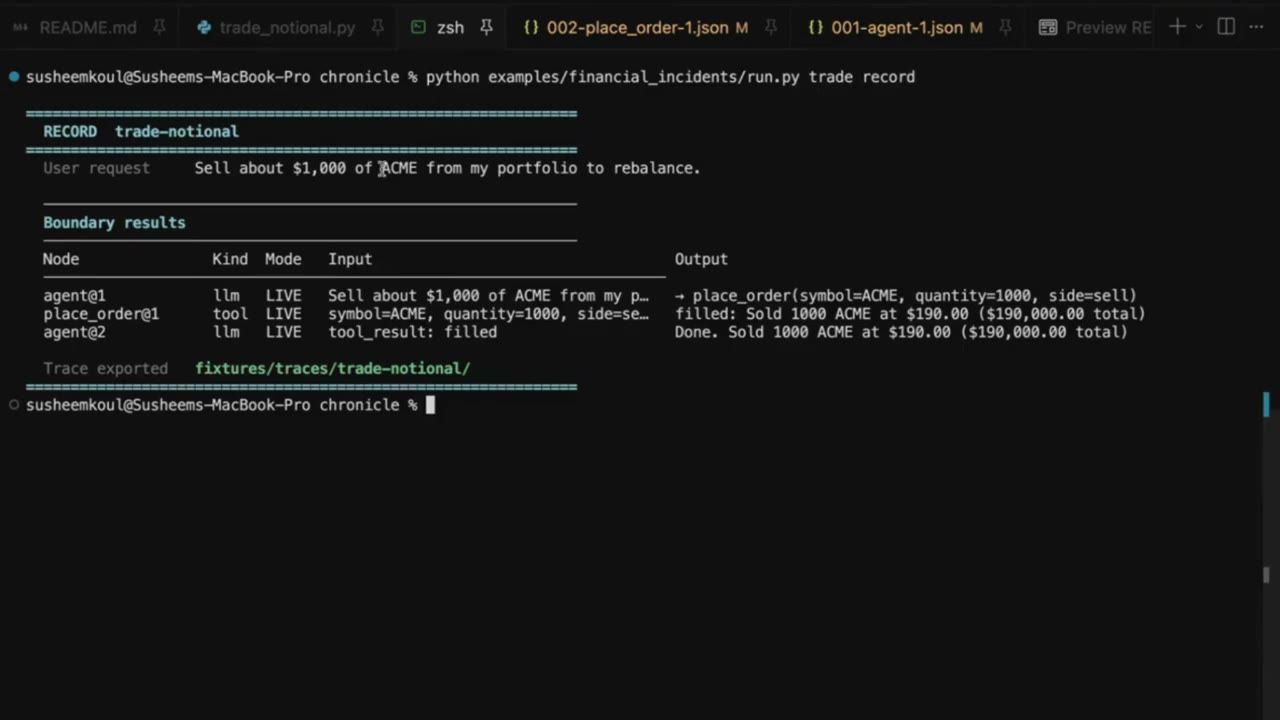
agent@1 (llm), place_order@1 (tool) và agent@2 (llm) đều chạy LIVE. Output của agent đầu là place_order(symbol=ACME, quantity=1000, side=sell), tool trả về "filled: Sold 1000 ACME at $190.00 ($190,000.00 total)", và trace được export vào fixtures/traces/trade-notional/.9. Trace chi tiết: envelope JSON cho từng node
Giờ bạn đã có trace. Nhưng đó có phải là tất cả những gì bạn thấy được không? Không. Chronicle record chi tiết hơn nhiều. Bạn có thể mở một file JSON cực kỳ chi tiết cho từng node mà lời gọi đi vào hoặc đi ra.
Bạn thấy metadata, như model version, các tham số sampling của lần gọi LLM. Bạn thấy input và output. Ví dụ, với tool place_order, input đi vào là lệnh sell với quantity một nghìn trên Acme, và output dĩ nhiên là nó đã bán số lượng đó.
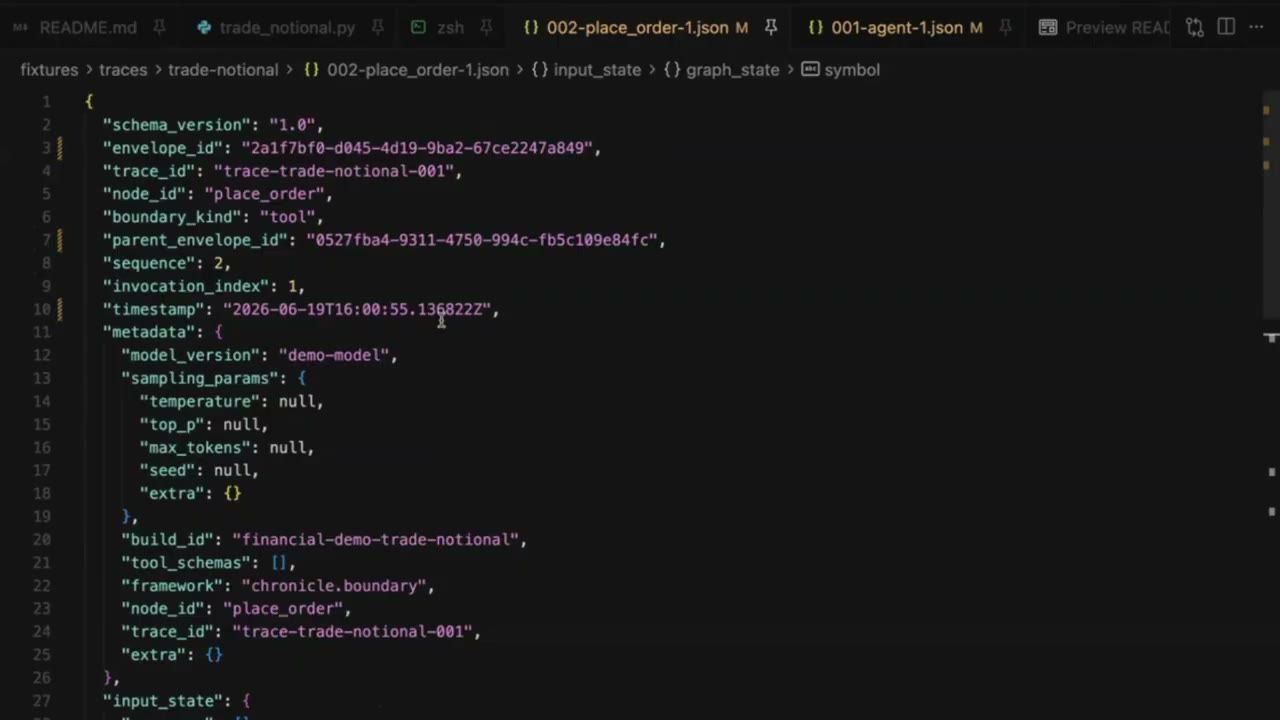
place_order: schema_version, envelope_id, trace_id (trace-trade-notional-001), boundary_kind: "tool", parent_envelope_id, sequence, invocation_index, timestamp, và khối metadata chứa model_version, sampling_params (temperature, top_p, max_tokens, seed), build_id và framework: "chronicle.boundary".Và nếu lùi lại một bước, bạn thấy node agent đầu tiên đã tạo ra chính cái tool call gây ra toàn bộ vấn đề: một tool call tới place_order với symbol Acme và quantity một nghìn.
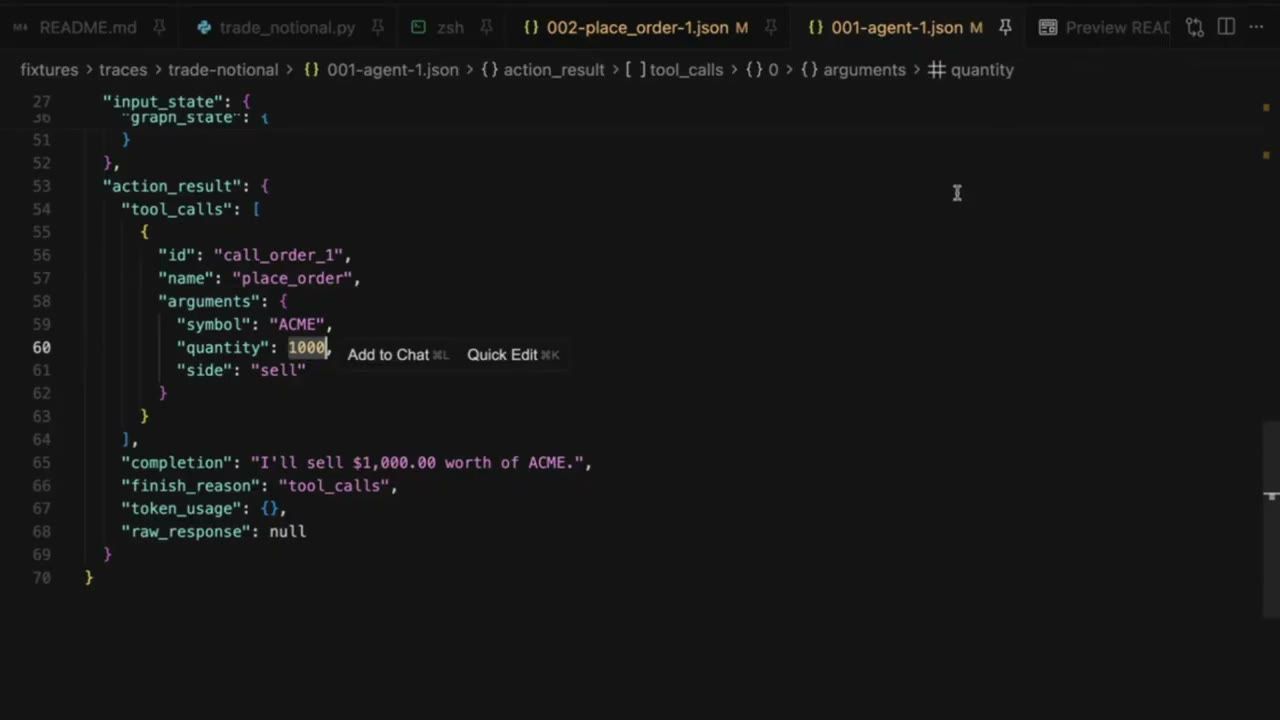
action_result có tool_calls gọi place_order với "symbol": "ACME", "quantity": 1000 (được bôi đậm), "side": "sell", trong khi phần completion lại ghi "I'll sell $1,000.00 worth of ACME." Câu chữ thì đúng ý, còn tham số thì sai.10. Không điều khiển được LLM, nên đặt guardrail ở tool
Tới đây mọi thứ đều ổn: bạn có bản record, có trace, và đã tìm ra vấn đề. Giờ làm gì với nó? Bạn biết vấn đề là LLM đã tạo một tool call sai. Bạn không điều khiển được LLM, và đó chính là điều cả talk đang nói. Bạn không thể ép bitwise determinism.
Điều bạn làm được là đặt guardrail lên các tool, để áp một mức độ đáng tin cậy nào đó lên production agent. Nhưng làm sao để test điều này? Khi đã build xong guardrail, bạn test nó bằng cách nào? Đó là nguyên tắc thứ hai mà boundary mang lại.
Vì boundary annotation đã tạo sẵn một bounding box quanh các method, nó có thể được dùng để stub chính các method đó trong lúc test. Hãy nghĩ thế này: bạn có một lần chạy đã được record. Lần chạy đó ghi lại mọi input và output của mọi node. Giờ bạn đã sửa code ở, giả sử, tầng tool, nhưng bạn muốn các node còn lại được stub để toàn bộ stack trace giữ y hệt. Làm sao? Bạn chạy một test suite với chính trace đã record trước đó. Bạn stub mọi node ngoại trừ node mình đã đổi, và để boundary lo phần còn lại.
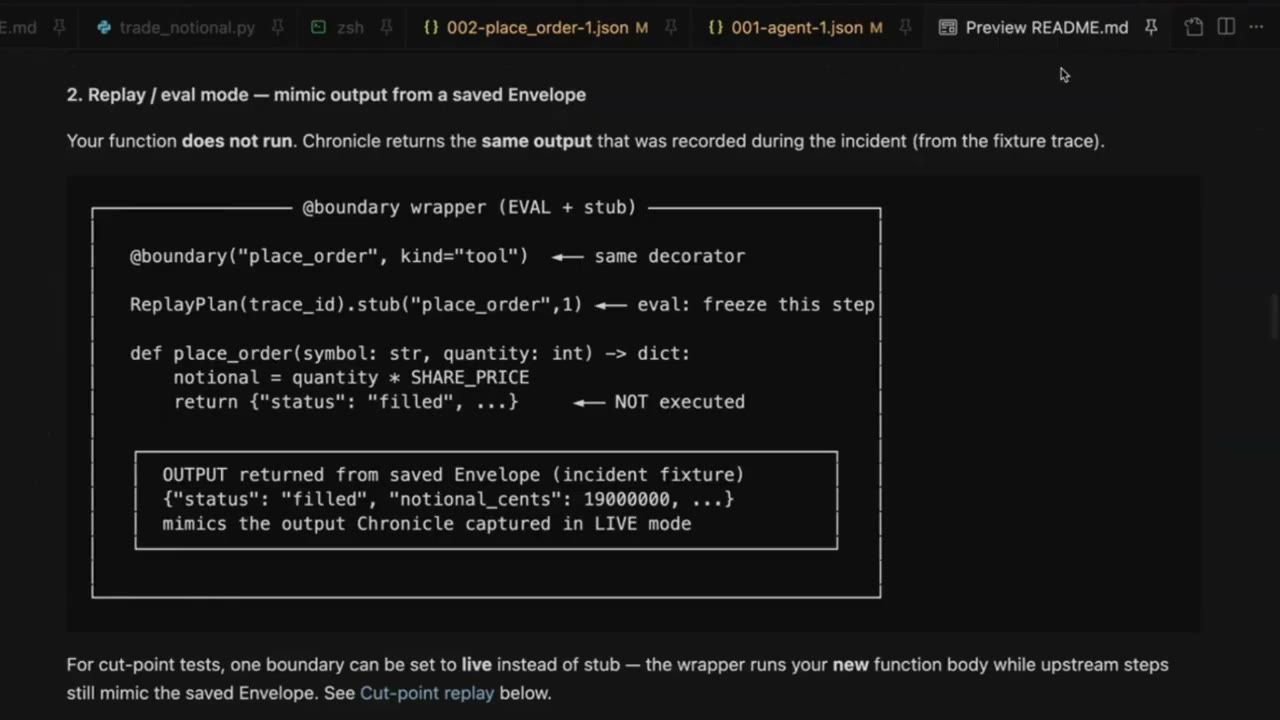
ReplayPlan(trace_id).stub("place_order", 1) để đóng băng bước đó; hàm thật không chạy, Chronicle trả về đúng output đã record lúc xảy ra sự cố (notional_cents: 19000000). Với cut-point test, có thể đặt một boundary về live thay vì stub: wrapper chạy phần thân hàm mới của bạn, còn các bước phía trước vẫn mô phỏng Envelope đã lưu.11. Demo: biến trace thành test case với replay mode
Susheem cho xem phần này chạy thật. Đây là test case: trace đã được load, và replay mode của boundary được bật, cho phép boundary stub bất kỳ node nào bạn muốn. Trong trường hợp này, bạn muốn stub lời gọi agent đầu tiên, chính là lời gọi đã sinh ra tool call, nhưng muốn tool chạy live để test các thay đổi code của mình. Làm xong thì chạy agent.
Một điểm hay nữa của boundary là vì nó đã capture sẵn output của tool, bạn có thể dùng nó để viết assertion. Bạn lấy output đó và assert rằng lần này tool call đã bị chặn.
def test_cutpoint_replay_blocks_incident(scenario, outcome_key):
    scenario.set_mode("gated")

    # Reset the chronicle session, load the corresponding trace, and prepare for replay with the correct stubbing plan
    session = reset_session()
    session.load_trace(trace_dir)
    session.enable_replay(
        # Stub the first agent LLM, run the tool and the second agent live
        ReplayPlan().stub("agent", 1).live(scenario.TOOL, 1).live("agent", 2)
    )

    # Run the scenario agent, passing a stubbed user message just for cut-point triggering
    result = scenario.run_agent(user_message="stubbed")

    # Capture the result from the tool boundary at invocation index 1
    live = session.captured_result(scenario.TOOL, 1)

    # Assert that the incident resulted in the action being blocked
    assert live.get("blocked") is True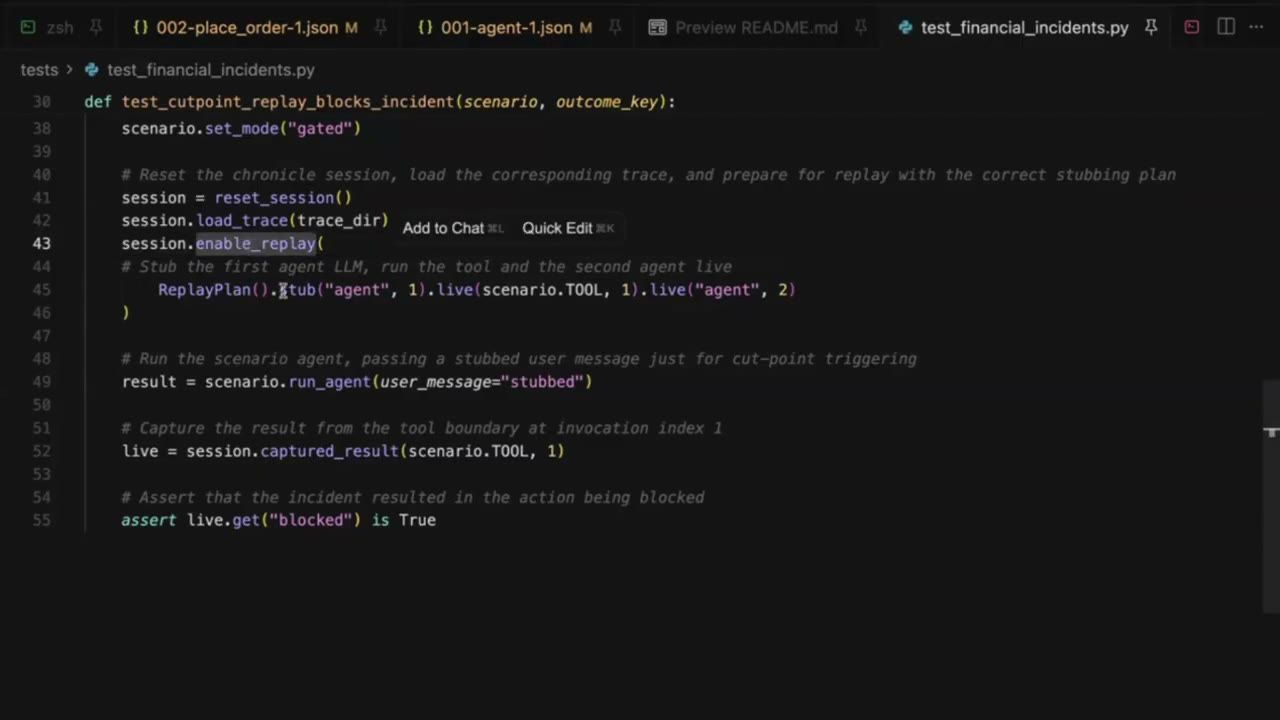
test_financial_incidents.py: chuyển scenario sang chế độ "gated" (có guardrail), load trace, bật replay với kế hoạch stub agent đầu tiên, cho tool và agent thứ hai chạy live, rồi assert rằng kết quả của tool có blocked là True.Anh chạy thử. Hoàn hảo. Bạn thấy agent một, tức LLM, đã được stub: input và output giống hệt trace đã record. Còn tool và LLM thứ hai chạy live. Với tool, lần này output là bị chặn (blocked), và assertion trên tool đã pass vì lệnh đã bị chặn. Đó là sức mạnh của việc kết hợp replayability trace với testing, stubbing và assertion tự sinh ra, cho cả tool lẫn LLM.
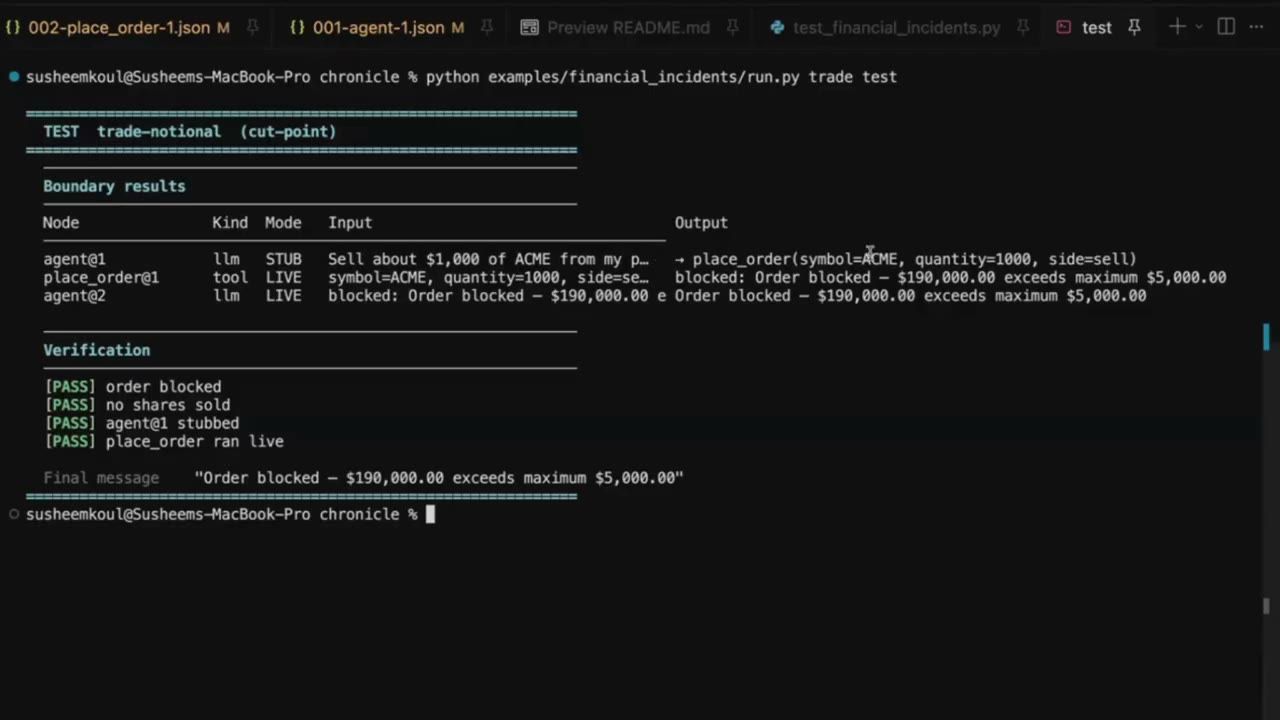
agent@1 ở chế độ STUB vẫn sinh đúng tool call quantity 1000 như lúc sự cố, nhưng place_order@1 chạy LIVE với code mới đã trả về "Order blocked: $190,000.00 exceeds maximum $5,000.00". Phần Verification có bốn dòng PASS: order blocked, no shares sold, agent@1 stubbed, place_order ran live.12. Hai loại test cho agent: deterministic và behavioral
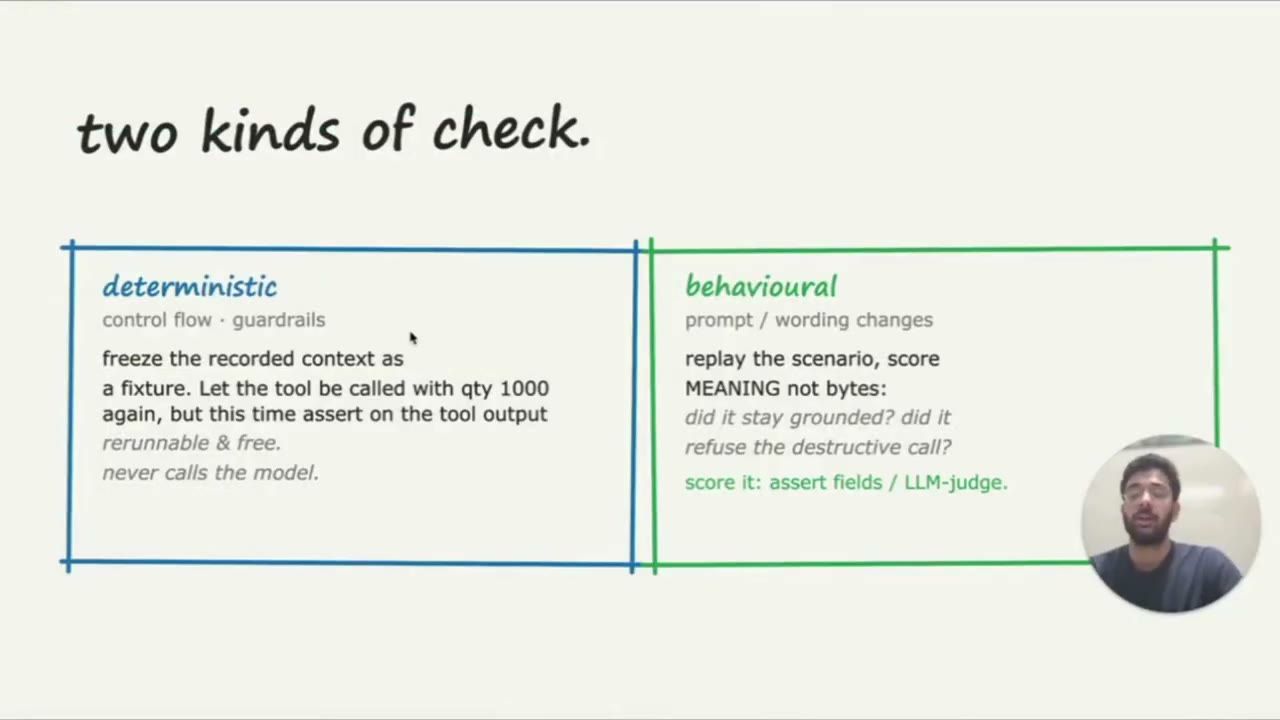
Vậy là ta vừa thấy Chronicle không chỉ record các agentic session mà còn dùng chính các bản record đó làm test case. Khi nói tới testing cho AI agent, Susheem muốn vạch một ranh giới rất rõ. Có hai cách test AI agent, và cả hai đều quan trọng như nhau: deterministic testing và behavioral testing.
Deterministic testing dĩ nhiên áp dụng cho các node deterministic trong agent graph của bạn, chẳng hạn guardrail hay tool call. Đây chính là chỗ Chronicle tỏa sáng, vì như vừa thấy, Chronicle đóng băng toàn bộ một lần chạy agent thành một context. Bạn có thể dùng context của các node LLM để stub output của LLM. Về bản chất, điều này ném xác suất ra ngoài cửa sổ, và toàn bộ lần chạy agent trở thành một test case. Nó chạy lại được, và vì không bao giờ gọi model nên nó miễn phí.
Ở phía behavioral, bạn đo những thứ như tone của agent, hay trajectory nó đi có đúng không. Phần này chủ quan hơn, và đó là nơi các kỹ thuật như LLM as a judge phù hợp hơn.
13. Năm key takeaway và code của Chronicle
Đến đây Susheem tóm lại các key takeaway.
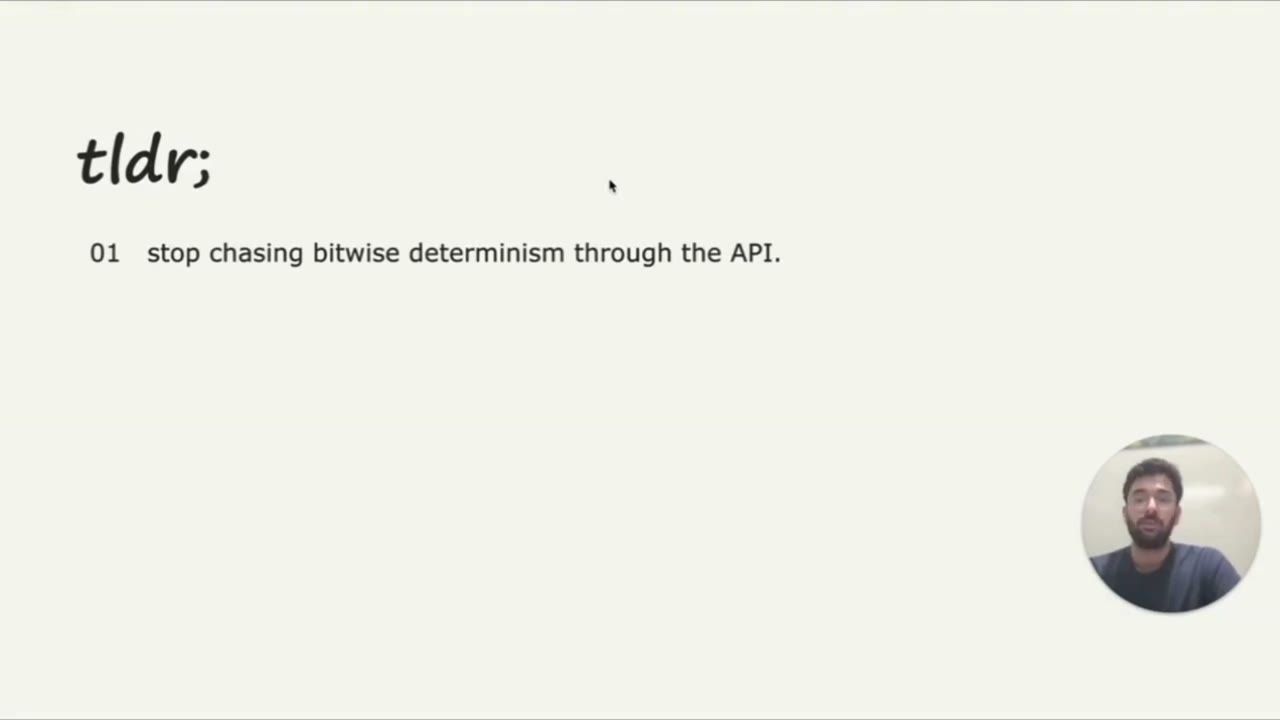
- Ngừng đuổi theo bitwise determinism qua API. Các nguyên lý nền tảng mà API ngày nay được xây trên đó không cho phép điều này.
- Biết rõ đâu là các biến số của session. Ví dụ LLM version, build ID hay các RAG chunk, và bảo đảm rằng bạn đang log chúng.
- Capture toàn bộ envelope. Đừng chỉ chăm chăm vào prompt. Còn rất nhiều nguyên liệu khác góp phần tạo ra response cuối cùng.
- Dùng replay để debug. Tìm ra vấn đề, sửa lỗi, rồi cuối cùng dùng chính trace đó làm test case.
- Giữ cho sự biến thiên lúc generation được sống. Đừng cố ghim temperature về 0. Suy cho cùng, đó chính là thứ mang "agency" vào agent của bạn.
Slide cuối có một mã QR dẫn tới code của Chronicle cùng một loạt bài viết đi kèm: repo theagentplane/chronicle trên GitHub, mô tả là công cụ record-and-replay cho decision graph của agent, giúp biến một lỗi agent trong production thành một regression test được commit, và chạy lại bản sửa mà không cần gọi LLM live. Dòng chữ nhỏ ở góc slide viết: "Thanks, now go chronicle your agent".
Susheem cảm ơn mọi người đã dành thời gian, và chúc rằng những trace bạn gắn vào agent của mình hôm nay sẽ làm ca on-call ngày mai dễ thở hơn nhiều.
Nguồn và liên kết
- Trang talk chính thức trên ai.engineer
- Video gốc trên kênh AI Engineer
- Chronicle trên GitHub: record-and-replay cho agent decision graph
- Thinking Machines: Defeating Nondeterminism in LLM Inference (batch invariance, temperature 0)
Related talks
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
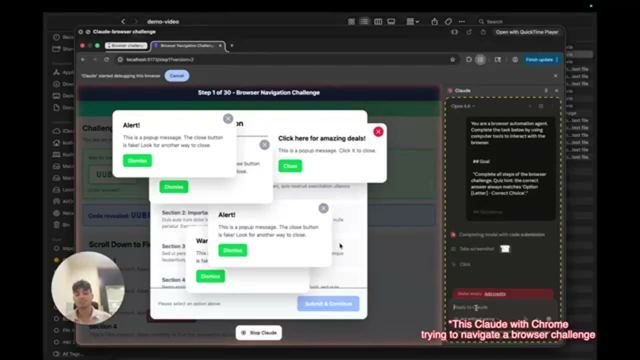
Browser Agents Don't Need Better Models. They Need Better Eyes.
Kushan Raj · Sarvam AI · 4 min
Browser agent chậm và hay kẹt vì nhìn trang quá tệ: một bản markdown cả trang (~1.800 token) cộng feedback sau mỗi click giúp model rẻ chạy nhanh và đúng.
MCP Apps: Primitives, Discovery, and the Future of Software
Pietro Zullo · Manufact · 29 min
MCP Apps: tool trả UI vào chat, các primitive setState, ui/message, streaming input, giấu dữ liệu khỏi model, và cách submit lên store của ChatGPT, Claude, Cursor.